В данном исследовании с помощью интегрированного машинного обучения, секвенирования РНК отдельных клеток и экспериментальной валидации выявлено пять биомаркеров, связанных с купроптозом и ферроптозом при язвенном колите, что дает представление о клинической диагностике и таргетной иммунотерапии.
Для просмотра этого контента требуется подписка на JoVE. Войдите или начните свой бесплатный пробный период.
Исследовательская статья
Таргетирование ферроптоза и купроптоза при язвенном колите: результаты комплексного биоинформатического анализа и экспериментальной валидации
В этой статье
Краткое содержание
Аннотация
Язвенный колит (ЯК) представляет собой стойкое заболевание кишечника с не до конца определенным патогенезом, характеризующееся ростом распространенности и показателей госпитализации в странах с развивающейся промышленностью. При ЯК избыточная гибель эпителиальных клеток кишечника нарушает слизистый барьер и запускает воспалительные реакции. Ферроптоз и купроптоз являются двумя недавно описанными формами регулируемой гибели клеток. В большинстве исследований ЯК эти процессы изучались по отдельности; однако их совместная роль в прогрессировании ЯК остается недостаточно охарактеризованной. Чтобы исследовать их синергическую роль в патогенезе ЯК, мы использовали поэтапный подход, включающий широкомасштабное транскриптомное профилирование для идентификации потенциальных мишеней с последующей валидацией на моделях in vitro. Гены с дифференциальной экспрессией (DEGs) были сопоставлены с генами, связанными с ферроптозом (FRGs), и генами, связанными с купроптозом (CRGs). Пересекающиеся мишени были приоритизированы с использованием консенсуса алгоритмов машинного обучения и анализа сетей коэкспрессии генов с весовыми коэффициентами (WGCNA). Пять биомаркеров — LCN2, IDO1, CXCL2, NOS2 и CD274 — были значительно повышены при ЯК. Анализ на уровне отдельных клеток позволил охарактеризовать их экспрессию в различных типах клеток, при этом LCN2 и NOS2 были преимущественно обогащены в эпителиальных клетках. Механистическая значимость этих маркеров была дополнительно оценена с помощью анализов in vitro. Обработка ингибиторами ферроптоза или купроптоза облегчала воспаление, связанное с ЯК, и модулировала экспрессию биомаркеров в моделях клеток Caco-2. Эти результаты позволяют идентифицировать пять биомаркеров, связанных с прогрессированием ЯК, и предоставляют экспериментальные данные, подтверждающие возможность их применения в клинической диагностике и терапевтическом вмешательстве.
Введение
Язвенный колит (ЯК) представляет собой рецидивирующее воспалительное заболевание кишечника, которое характеризуется растущим глобальным бременем и значительными затратами на долгосрочное лечение1,2. Несмотря на то, что аминосалицилаты, кортикостероиды, биологические препараты и низкомолекулярная терапия расширили возможности лечения, достижение стойкой ремиссии остается сложной задачей для многих пациентов3,4. Эта неудовлетворенная клиническая потребность подчеркивает важность выявления воспроизводимых молекулярных маркеров и доступных механизмов, которые могли бы способствовать более ранней диагностике и терапии, основанной на понимании механизмов заболевания5.
Ферроптоз представляет собой железозависимую форму регулируемой клеточной гибели, обусловленную перекисным окислением липидов, истощением запасов глутатиона и нарушением активности GPX46. Повышенные уровни железа и малонового диальдегида при язвенном колите (UC) согласуются с ферроптозным повреждением эпителия, в то время как экспериментальная активация оси SLC7A11–GSH–GPX4 или прямое ингибирование ферроптоза могут обеспечить защиту кишечного барьера7,8.
Купроптоз, описанный в 2022 году, запускается при связывании меди с липоилированными митохондриальными белками, что приводит к агрегации белков и протеотоксическому стрессу9. Поскольку кишечник играет центральную роль в метаболизме меди, нарушение этого пути может усиливать окислительное и воспалительное повреждение эпителия при ЯК10.
Ферроптоз и купроптоз могут сходиться через дисбаланс ионов металлов, митохондриальный метаболизм, истощение запасов глутатиона и окислительный стресс11. Однако остается неясным, создает ли это взаимодействие воспроизводимую молекулярную сигнатуру при язвенном колите и реагирует ли такая сигнатура на специфическое ингибирование соответствующих путей.
Гипотеза исследования заключалась в том, что нарушение перекрестного взаимодействия между ферроптозом и купроптозом при язвенном колите (UC) приводит к формированию воспроизводимой сигнатуры биомаркеров, которую можно выделить в массивах данных объемного и одноклеточного транскриптомного анализа и нивелировать с помощью специфического ингибирования путей в модели повреждения эпителия кишечника. Соответственно, для идентификации и функциональной оценки потенциальных биомаркеров были интегрированы методы биоинформатики по нескольким когортам, машинное обучение, одноклеточный анализ и направленные эксперименты на клетках Caco-2 (Рисунок 1).
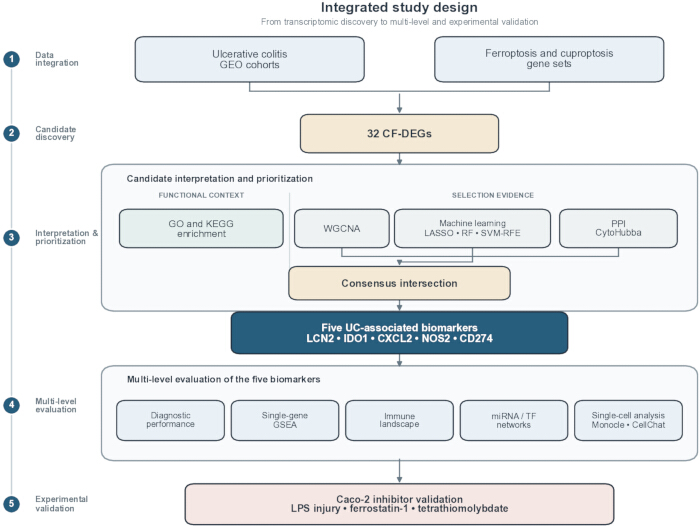
Рисунок 1: Схема исследования. Интегрированный рабочий процесс для многокогортного транскриптомного скрининга, приоритизации биомаркеров на основе машинного обучения и сетевого анализа, локализации на уровне отдельных клеток и валидации с использованием ингибиторов в клетках Caco-2. UC: язвенный колит; GEO: Gene Expression Omnibus; WGCNA: взвешенный анализ сетей коэкспрессии генов; PPI: белок-белковое взаимодействие; ROC: рабочая характеристика приемника; GSEA: анализ обогащения наборов генов. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Протокол
В данном исследовании использовались общедоступные наборы данных и коммерчески доступные клеточные линии человека. Участие людей, использование вновь собранных тканей человека или позвоночных животных не предусматривалось, в связи с чем одобрение комитета по этике учреждения не требовалось. Инструменты исследования, программное обеспечение и онлайн-ресурсы, использованные в протоколе, перечислены в Таблице материалов.
1. Обработка данных для анализа дифференциальной экспрессии
Для формирования когорт транскриптомного поиска и валидации был выполнен поиск в базе данных Gene Expression Omnibus (GEO) по запросу «ulcerative colitis». Четыре набора данных — GSE87466, GSE92415, GSE107499 и GSE75214 — были использованы в качестве обучающей выборки, в то время как GSE47908 был зарезервирован для внешней валидации. Обучающие наборы данных были нормализованы и подвергнуты коррекции пакетного эффекта с помощью ComBat в Sangerbox 3.0, тогда как валидационный набор данных обрабатывался независимо.
Всего из базы данных FerrDB было получено 583 гена, связанных с ферроптозом (FRGs), список которых был дополнен генами из литературы для минимизации систематической ошибки одного источника12. Набор из 96 генов, связанных с купроптозом (CRGs), был составлен на основе опубликованных исследований12,13,14. Анализ дифференциальной экспрессии проводили с помощью пакета limma с пороговыми значениями |log₂ fold change| > 1 и скорректированным по методу Бенджамини–Хохберга P < 0.05. Диагностические графики нормализации, коррекции пакетного эффекта, дифференциальной экспрессии и кластеризации представлены на Дополнительном рисунке 1. Состав образцов, использованные платформы и распределение по когортам приведены в Дополнительной таблице 1.
2. Идентификация CF-DEG в UC
Корреляционный анализ Пирсона был проведен с использованием пороговых значений |r| > 0.5 и P < 0.05 для выявления коэкспрессируемых FRG и CRG. Полученный набор генов был пересечен с дифференциально экспрессируемыми генами (DEG) для определения дифференциально экспрессируемых генов, коэкспрессируемых при купроптозе и ферроптозе (CF-DEG).
3. Анализ обогащения
Анализы обогащения по Gene Ontology (GO) и Kyoto Encyclopedia of Genes and Genomes (KEGG) были выполнены с помощью clusterProfiler и платформы Bioinformatics.com.cn. В качестве порога значимости использовалось значение P < 0.05 с поправкой Бенджамини — Хохберга. Графики обогащения представлены на Дополнительном рисунке 2.
4. Взвешенный анализ сетей коэкспрессии генов (WGCNA)
Модульная структура, лежащая в основе профилей экспрессии генов, была проанализирована с помощью взвешенного анализа сетей коэкспрессии генов (WGCNA). Аномальные образцы были выявлены и исключены с помощью иерархической кластеризации в сочетании с функцией goodSamplesGenes. Впоследствии была определена подходящая мощность мягкого порога (β), удовлетворяющая критерию безмасштабной топологии для построения сети.
Обработанные данные экспрессии были использованы для построения матрицы топологического перекрытия (TOM) для анализа коэкспрессии генов. С помощью метода динамического отсечения дерева гены с высокосогласованными паттернами экспрессии были объединены в генные модули, каждый из которых содержал не менее 100 генов. Связи между собственными генами модулей (MEs) и фенотипами анализировались для выявления модулей, связанных с патологическим процессом, и извлечения соответствующих наборов генов. Диагностика скрининга WGCNA представлена на Дополнительном рисунке 3.
5. Подбор биомаркеров
Для приоритизации кандидатов для последующих экспериментов параллельно были применены три алгоритма машинного обучения15. Для отбора признаков использовалась регрессия LASSO (метод наименьших абсолютных отклонений с выбором признаков), для ранжирования значимости генов — случайный лес (random forest) с ntree = 500, а для определения подмножества признаков с минимальной ошибкой перекрестной проверки — метод рекурсивного исключения признаков на основе метода опорных векторов (SVM-RFE). Полные диагностические данные скрининга представлены на Дополнительном рисунке 5.
Значимость генов оценивали на основе вклада отдельных генов в точность классификации, и гены с высоким рангом были отобраны для формирования предварительного набора генов16. Алгоритм SVM-RFE осуществлял скрининг признаков и оптимизацию модели путем итеративного исключения признаков, что позволило определить оптимальный поднабор признаков для классификации17. Гены, общие для всех трех алгоритмов, были признаны потенциальными биомаркерами, выявленными с помощью машинного обучения.
CF-DEGs были использованы для построения сети белок-белковых взаимодействий (PPI), а программа CytoHubba — для ранжирования основных узлов. Пересечение ключевых модулей WGCNA, результатов трех методов машинного обучения и основного набора PPI позволило определить пять интегрированных потенциальных биомаркеров: LCN2, IDO1, CXCL2, NOS2 и CD274. Эти гены были классифицированы как диагностические кандидаты, связанные с язвенным колитом (UC). Последующие эксперименты с ингибиторами позволили дополнительно классифицировать LCN2, IDO1, CXCL2 и NOS2 как маркеры, чувствительные к ингибированию ферроптоза, а CD274 — как маркер, чувствительный к ингибированию купроптоза. Данные гены не рассматривались как доказанные апстрим-регуляторы любого из этих путей.
6. Разработка прогностической модели и многометодовая оценка
Для оценки потенциала клинического применения выявленной генной сигнатуры с помощью пакета rms была построена номограмма для анализа диагностической эффективности. Эффективность модели оценивали с помощью калибровочной кривой, теста Хосмера–Лемешоу (HL) и индекса конкордации Харрелла (C-index).
Калибровка модели оценивалась с помощью теста Хосмера-Лемешоу (HL) и средней абсолютной ошибки (MAE). В качестве пороговых значений для приемлемого соответствия и точности модели были установлены значение P > 0.05 и MAE < 0.1 соответственно. Для оценки прогностической способности номограммы при UC были построены ROC-кривые (рабочая характеристика приемника) и рассчитана площадь под кривой (AUC). Для оценки обобщающей способности и стабильности модели использовался независимый набор данных.
7. Анализ обогащения наборов генов (GSEA)
В обучающей выборке был проведен корреляционный анализ Спирмена между каждым биомаркером и всеми остальными генами. Результаты корреляции были ранжированы для создания упорядоченного набора генов. Анализ обогащения наборов генов (GSEA) проводился с использованием набора генов c2.cp.kegg_medicus.v2025.1.Hs.symbols из базы данных молекулярных сигнатур (MSigDB) в качестве эталона. Биологические пути с P < 0,05 считались статистически значимо обогащенными.
8. Анализ иммунного ландшафта
Для проведения деконволюционного анализа данных экспрессии и оценки пропорций 22 подтипов иммунных клеток использовались инструмент CIBERSORT и сигнатурная матрица LM22. Впоследствии был проведен корреляционный анализ Спирмена для оценки взаимосвязей между пятью биомаркерами и подтипами иммунных клеток.
9. Анализ регуляторных сетей
Информация о регуляции со стороны связанных с генами факторов транскрипции (TF) и микроРНК (miRNA) была получена из интегрированных баз данных ChEA3 и TarBase 9.0 с помощью платформы NetworkAnalyst. В регуляторную сеть были включены микроРНК, связанные как минимум с двумя узлами.
10. Секвенирование РНК единичных клеток (scRNA-seq)
Были интегрированы наборы данных одноклеточного секвенирования при Язвенном Колите (UC) GSE116222, включающий три образца здоровых тканей и три образца с UC, и GSE214695, включающий шесть образцов здоровых тканей и шесть образцов с UC. Клетки были отобраны при условии наличия 200–5,000 детектированных генов, >1,000 уникальных молекулярных идентификаторов (UMI), < 30% митохондриальных транскриптов, < 3% транскриптов гемоглобина и < 50% рибосомальных транскриптов. Для нормализации использовалась функция NormalizeData, а для коррекции эффекта батча перед кластеризацией и аннотацией применялся метод Harmony.
После фильтрации данные были нормализованы с помощью функции NormalizeData. Для минимизации батч-эффектов между образцами использовался алгоритм Harmony. Для снижения размерности и кластеризации клеток с целью характеристики локальных и глобальных структур в клеточной популяции применялись методы аппроксимации и проекции однородного многообразия (UMAP) и стохастического вложения соседей с t-распределением (t-SNE). Для дальнейшего анализа было отобрано в общей сложности 31 712 высококачественных клеток. Аннотация типов клеток проводилась на основе канонических генов-маркеров.
Анализ псевдовремени был выполнен с помощью Monocle 2 для исследования изменений состояний эпителиальных и миелоидных клеток в тканях при НЯК. Были оценены траектории развития клеток и межгрупповые различия, а также визуализированы паттерны экспрессии биомаркеров вдоль траектории псевдовремени.
Для оценки межклеточного взаимодействия между эпителиальными клетками и подмножествами миелоидных клеток использовали CellChat. Паттерны экспрессии, специфичные для каждой субпопуляции, были интегрированы для определения вероятности взаимодействий и ключевых сигнальных путей между эпителиальными и миелоидными клетками, а также для характеристики их потенциальных межклеточных регуляторных сетей.
11. Эксперименты на клетках
Клетки аденокарциномы толстой кишки человека Caco-2 культивировали в модифицированной среде Игла в модификации Дульбекко, содержащей 10% фетальной бычьей сыворотки, 100 U/mL пенициллина и 100 µg/mL стрептомицина, при 37 °C в атмосфере 5% CO₂. Клетки Caco-2 были выбраны в качестве воспроизводимой модели эпителиального монослоя для анализа кишечного барьера и воспалительного повреждения; однако их злокачественное происхождение ограничивает возможность прямого обобщения результатов на незалокачественный эпителий толстой кишки. Данные о количестве пассажей в архивных записях эксперимента отсутствовали.
Модель воспалительного повреждения in vitro была создана путем воздействия на клетки липополисахарида (LPS) в концентрации 1 µg/mL в течение 24 h. Клетки были распределены по группам: контрольная группа (растворитель диметилсульфоксид), группа только с LPS, группа LPS + 4 µM ферростатина-1 или группа LPS + 40 µM тетратиомолибдата, при этом конечные концентрации растворителей были выровнены. Группа только с LPS служила положительным контролем повреждения/модели для сравнения с группами, получавшими ингибиторы.
- Жизнеспособность клеток
Жизнеспособность клеток оценивали с помощью теста на жизнеспособность клеток в соответствии с инструкциями производителя. После инкубации при 37 °C в течение примерно 2 ч измеряли оптическую плотность при 450 nm с использованием микропланшетного ридера. - Измерение уровней MDA и Fe²⁺
Внутриклеточные уровни малонового диальдегида (MDA) и Fe2⁺ измеряли с использованием соответствующих наборов для анализа согласно инструкциям производителей. Общее содержание белка определяли с помощью метода бицинхониновой кислоты, и каждое значение нормировали по содержанию белка в соответствующем образце. - Анализ с использованием флуоресцентного зонда на ионы меди
После удаления культуральной среды добавляли специфичный на Cu2⁺ флуоресцентный зонд до конечной концентрации 1 µM и инкубировали в течение 30 min при 37 °C. Изображения получали сразу после инкубации без промывки с помощью инвертированного флуоресцентного микроскопа при длинах волн возбуждения и эмиссии 510 и 578 nm соответственно. Настройки получения изображений были одинаковыми для всех групп, масштабная линейка изображения была откалибрована на 50 µm. - RT-qPCR
Общую РНК выделяли с использованием реагента для экстракции РНК на основе фенола и гуанидиния. Комплементарную ДНК синтезировали из 1 µg РНК с помощью набора для синтеза первой цепи кДНК, а для ПЦР в реальном времени использовали реагенты на основе SYBR Green. Каждую реакцию проводили в трех технических повторностях. Последовательности праймеров приведены в Дополнительной таблице 2, а относительное содержание матричной РНК рассчитывали по методу 2⁻ΔΔCt.
12. Статистический анализ
Нормальность распределения и гомогенность дисперсии оценивали с помощью тестов Шапиро–Уилка и модифицированного теста Ливена (с центрированием по медиане) соответственно. Данные, соответствующие обоим допущениям, анализировали с использованием непарного двухстороннего t-критерия или однофакторного дисперсионного анализа с последующим тестом Тьюки для определения наименьшей значимой разности. В случаях, когда одно из допущений не соблюдалось, использовали t-критерий Уэлча или дисперсионный анализ Уэлча с последующим сравнением по критерию Геймса–Хауэлла.
Результаты представлены как среднее значение ± стандартное отклонение. Фактическое количество биологических повторов, точные двусторонние значения P и результаты проверки допущений приведены в Дополнительной таблице 3. В архивном исходном листе для Рисунка 13 содержится меньше контрольных повторов для панелей A (n = 4), C (n = 4) и F (n = 2), тогда как для всех остальных комбинаций панелей/групп n = 6.
Вычислительный анализ проводили с использованием языка R и инструментов limma, WGCNA, clusterProfiler, glmnet, randomForest, e1071, pROC, rms, Seurat v4, Harmony, Monocle 2, CellChat и Cytoscape/CytoHubba. В качестве онлайн-ресурсов использовались FerrDB, GEO, STRING, ChEA3, TarBase 9.0, NetworkAnalyst, CIBERSORT/LM22, MSigDB, Bioinformatics.com.cn и Sangerbox 3.0.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Результаты
Идентификация и функциональная аннотация совместно экспрессируемых генов купроптоза и ферроптоза
Были интегрированы четыре обучающих набора данных, включающих 421 образец с язвенным колитом (UC) и 97 здоровых контролей. Всего было выявлено 551 дифференциально экспрессируемых ген, из которых 362 гена имели повышенную экспрессию, а 189 — пониженную. Корреляционный анализ позволил определить 444 гена, коррелирующих с ферроптозом и купроптозом, а пересечение с дифференциально эксп...
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Обсуждение
В данном исследовании были интегрированы методы массивного транскриптомного анализа, машинного обучения, анализа единичных клеток и направленных клеточных экспериментов для изучения перекрестных связей между ферроптозом и купроптозом при язвенном колите (UC). Пять диагностических кандидатов, ассоциированных с UC, были воспроизведены в когортах обнаружения и валидации; они локализовались преимущественно в эпителиальном и миелоидном компартментах и демонстрировали экспрессию, чувствительную к ингибированию путей, в клетках...
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Раскрытие информации
Авторы не имеют конфликтов интересов, подлежащих раскрытию.
Благодарности
Данная работа была поддержана проектом «Молодой ученый Цихуан» Национального управления традиционной китайской медицины (грант № 2022256). Выражается благодарность всем членам исследовательских групп Ляонинского университета традиционной китайской медицины и Третьей аффилированной больницы Ляонинского университета традиционной китайской медицины за техническую поддержку, а также вклад в курирование данных и биоинформатический анализ.
OpenAI Codex (OpenAI) использовался в процессе доработки исключительно для помощи в редактировании английского языка, форматировании документа и проверке качества рисунков. Все научное содержание, анализы, цитаты и окончательный вариант представления были проверены и подтверждены авторами, которые несут полную ответственность за рукопись.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.
Материалы
| Имя | Компания | Каталожный номер | Комментарии |
|---|---|---|---|
| BCA Protein Assay Kit | Beyotime Institute of Biotechnology | P0010 | Количественное определение белка для нормализации. |
| Bioinformatics.com.cn | Bioinformatics.com.cn | Онлайн-платформа; доступ в 2026 г. | Платформа для визуализации и анализа GO/KEGG. |
| Линия клеток Caco-2 | ATCC | HTB-37 | Линия клеток аденокарциномы толстой кишки человека, используемая для модели эпителиального повреждения. |
| Cell Counting Kit-8 | GLPBio | GK10001 | Анализ жизнеспособности клеток при 450 nm. |
| CIBERSORT с сигнатурой LM22 | CIBERSORT developers | LM22 | Деконволюция фракций 22 типов иммунных клеток. |
| ChEA3 | Ma'ayan Laboratory | Онлайн-платформа; доступ в 2026 г. | Анализ обогащения факторами транскрипции и прогнозирование регуляторных сетей. |
| Инкубатор CO2 | Не указан | Н/Д | Увлажненный инкубатор для культивирования при 37 °C и 5% CO2. |
| Флуоресцентный зонд на Cu2+ | BIOFOUNT | CAS 98907-26-7 | Детекция внутриклеточной флуоресценции Cu2+ . |
| Cytoscape с CytoHubba | Cytoscape Consortium | Версия не указана | Визуализация PPI и ранжирование центральных узлов. |
| Модифицированная среда Игла в модификации Дульбекко | Gibco | 11965092 | Среда для культивирования клеток Caco-2. |
| Диметилсульфоксид | Не указан | Н/Д | Контроль растворителя. |
| Фетальная бычья сыворотка | Не указан | Н/Д | Добавка к среде в концентрации 10%. |
| Набор для анализа Fe2+ | Abcam | ab83366 | Измерение содержания внутриклеточного Fe2+. |
| FerrDB | FerrDB developers | Онлайн-база данных; доступ в 2026 г. | Источник генов, связанных с ферроптозом. |
| Ферростатин-1 | Sigma-Aldrich | SML0583 | Ингибитор ферроптоза; конечная концентрация 4 µM. |
| Harmony | Broad Institute/community | Версия не указана | Коррекция пакетного эффекта для одноклеточного секвенирования. |
| Инвертированный флуоресцентный микроскоп | Olympus | IX71 | Флуоресцентная визуализация Cu2+ при возбуждении/эмиссии 510/578 nm. |
| Липополисахарид | Не указан | Н/Д | Стимул воспалительного повреждения в концентрации 1 µg/mL в течение 24 h. |
| Набор для анализа малонового диальдегида | Beyotime Institute of Biotechnology | S0131S | Измерение перекисного окисления липидов. |
| Микропланшетный ридер | Не указан | Н/Д | Измерение абсорбции при 450 nm. |
| Monocle | Bioconductor/community | Версия 2 | Анализ псевдовремени для одноклеточного секвенирования. |
| Molecular Signatures Database | Broad Institute | c2.cp.kegg_medicus.v2025.1.Hs | Эталонный набор генов для GSEA. |
| NetworkAnalyst | NetworkAnalyst developers | Онлайн-платформа; доступ в 2026 г. | Интеграция сетей факторов транскрипции и миРНК. |
| Пенициллин–стрептомицин | Не указан | Н/Д | 100 U/mL пенициллина и 100 µg/mL стрептомицина. |
| R | R Foundation for Statistical Computing | Версия не указана | Среда для биоинформатического анализа. |
| Набор пакетов R | CRAN/Bioconductor | Сборки пакетов не указаны | Рабочие процессы limma, WGCNA, clusterProfiler, glmnet, randomForest, e1071, pROC и rms. |
| Система ПЦР в реальном времени | Не указан | Н/Д | Прибор для RT-qPCR с использованием SYBR Green. |
| RevertAid First Strand cDNA Synthesis Kit | Thermo Fisher Scientific | K1622 | Синтез первой цепи кДНК из 1 µg РНК. |
| Sangerbox | Sangerbox developers | 3.0 | Нормализация и коррекция пакетного эффекта ComBat. |
| Seurat | Satija Lab/community | Версия 4 | Контроль качества, нормализация, кластеризация и визуализация данных одноклеточного секвенирования. |
| Программное обеспечение для статистического анализа | Не указан | Н/Д | Статистический анализ исходных экспериментов на клетках. |
| STRING | STRING Consortium | Онлайн-база данных; доступ в 2026 г. | Построение сети белок–белковых взаимодействий. |
| Реагенты для ПЦР в реальном времени SYBR Green | Takara | RR820A | Количественная ПЦР в реальном времени. |
| TarBase | DIANA Tools | 9.0 | Экспериментально подтвержденные взаимодействия миРНК–генов. |
| Тетратиомолибдат | Sigma-Aldrich | 323446 | Хелатор меди; конечная концентрация 40 µM. |
| Реагент TRIzol | Takara | 9108 | Экстракция общей РНК. |
Ссылки
- Fu M, Wang QW, Liu YR, Chen SJ. The role of the three major intestinal barriers in ulcerative colitis in the elderly. Ageing Res Rev. 2025;108:102752. https://doi.org/10.1016/j.arr.2025.102752.
- Le Berre C, Honap S, Peyrin-Biroulet L. Ulcerative colitis. Lancet. 2023;402:571–584.
- Wangchuk P, Yeshi K, Loukas A. Ulcerative colitis: Clinical biomarkers, therapeutic targets, and emerging treatments. Trends Pharmacol Sci. 2024;45:892–903.
- Kobayashi T, et al. Ulcerative colitis (primer). Nat Rev Dis Primers. 2020;6:74. https://doi.org/10.1038/s41572-020-0205-x.
- Huang J, et al. Comprehensive analysis of cuproptosis-related genes in immune infiltration and diagnosis in ulcerative colitis. Front Immunol. 2022;13:1008146. https://doi.org/10.3389/fimmu.2022.1008146.
- Liu Y, et al. Development and experimental validation of machine learning-based disulfidptosis-related ferroptosis biomarkers in inflammatory bowel disease. Genes. 2025;16:496. https://doi.org/10.3390/genes16050496.
- Hu W, et al. HIF-1α alleviates ferroptosis in ulcerative colitis by regulation of GPX4. Cell Death Dis. 2025;16:542. https://doi.org/10.1038/s41419-025-07883-8.
- Zhao C, et al. FXR acts as a therapeutic target for ulcerative colitis via suppressing ferroptosis. Mol Med. 2025;31:258. https://doi.org/10.1186/s10020-025-01305-3.
- Tsvetkov P, et al. Copper induces cell death by targeting lipoylated TCA cycle proteins. Science. 2022;375:1254–1261.
- Liu J, et al. Unveiling the cuproptosis in colitis and colitis-related carcinogenesis: A multifaceted player and immune moderator. Research (Wash D C). 2025;8:0698. https://doi.org/10.34133/research.0698.
- Liu N, Chen M. Crosstalk between ferroptosis and cuproptosis: From mechanism to potential clinical application. Biomed Pharmacother. 2024;171:116115. https://doi.org/10.1016/j.biopha.2023.116115.
- Hao S, et al. Development of prognostic model incorporating a ferroptosis/cuproptosis-related signature and mutational landscape analysis in muscle-invasive bladder cancer. BMC Cancer. 2024;24:958. https://doi.org/10.1186/s12885-024-12716-1.
- Wang Z, et al. Exosomes secreted by macrophages upon copper ion stimulation can promote angiogenesis. Mater Sci Eng C Mater Biol Appl. 2021;123:111981. https://doi.org/10.1016/j.msec.2021.111981.
- Zou M, Zhang W, Zhu Y, Xu Y. Identification of 6 cuproptosis-related genes for active ulcerative colitis with both diagnostic and therapeutic values. Medicine (Baltimore). 2023;102:e35503. https://doi.org/10.1097/MD.0000000000035503.
- Chen W, Miao J, Chen J, Chen J. Development of machine learning models for diagnostic biomarker identification and immune cell infiltration analysis in PCOS. J Ovarian Res. 2025;18:1. https://doi.org/10.1186/s13048-024-01582-8.
- Lv JH, et al. WGCNA combined with machine learning to find potential biomarkers of liver cancer. Medicine (Baltimore). 2023;102:e36536. https://doi.org/10.1097/MD.0000000000036536.
- Wu Q, Yang C, Huang C, Lin Z. Screening key genes for intracranial aneurysm rupture using LASSO regression and the SVM-RFE algorithm. Front Med. 2025;11:1487224. https://doi.org/10.3389/fmed.2024.1487224.
- Tang D, Pu B, Liu S, Li H. Identification of cuproptosis-associated subtypes and signature genes for diagnosis and risk prediction of ulcerative colitis based on machine learning. Front Immunol. 2023;14:1142215. https://doi.org/10.3389/fimmu.2023.1142215.
- Yang C, et al. Identification of cuproptosis hub genes contributing to the immune microenvironment in ulcerative colitis using bioinformatic analysis and experimental verification. Front Immunol. 2023;14:1113385. https://doi.org/10.3389/fimmu.2023.1113385.
- Yadav SK, et al. Fecal Lcn-2 level is a sensitive biological indicator for gut dysbiosis and intestinal inflammation in multiple sclerosis. Front Immunol. 2022;13:1015372. https://doi.org/10.3389/fimmu.2022.1015372.
- Luo Q, et al. Bioinformatics analysis reveals potential crosstalk genes and molecular mechanisms between ulcerative colitis and psoriasis. Arch Dermatol Res. 2024;317:118. https://doi.org/10.1007/s00403-024-02856-1.
- Nielsen OH, et al. Rectal dialysate and fecal concentrations of neutrophil gelatinase-associated lipocalin, interleukin-8, and tumor necrosis factor-alpha in ulcerative colitis. Am J Gastroenterol. 1999;94:2923–2928.
- Sun Y, et al. Natural polyphenol rutin inhibits ferroptosis in ulcerative colitis by regulating lipid metabolism via blocking the LCN2-ALOX15 axis. Food Funct. 2025;16:7169–7186.
- Sofia MA, et al. Tryptophan metabolism through the kynurenine pathway is associated with endoscopic inflammation in ulcerative colitis. Inflamm Bowel Dis. 2018;24:1471–1480.
- Shon WJ, et al. Severity of DSS-induced colitis is reduced in Ido1-deficient mice with down-regulation of TLR-MyD88-NF-kB transcriptional networks. Sci Rep. 2015;5:17305. https://doi.org/10.1038/srep17305.
- Zeng T, et al. Indoleamine 2, 3-dioxygenase 1 enhances hepatocytes ferroptosis in acute immune hepatitis associated with excess nitrative stress. Free Radic Biol Med. 2020;152:668–679.
- Pavlidis P, et al. Interleukin-22 regulates neutrophil recruitment in ulcerative colitis and is associated with resistance to ustekinumab therapy. Nat Commun. 2022;13:5820. https://doi.org/10.1038/s41467-022-33333-3.
- Urzua U, et al. The ovarian transcriptome of reproductively aged multiparous mice: Candidate genes for ovarian cancer protection. Biomolecules. 2020;10:113. https://doi.org/10.3390/biom10010113.
- Zahn A, et al. Transcript levels of different cytokines and chemokines correlate with clinical and endoscopic activity in ulcerative colitis. BMC Gastroenterol. 2009;9:13. https://doi.org/10.1186/1471-230X-9-13.
- Yi Q, et al. Application of genomic selection and experimental techniques to predict cell death and immunotherapeutic efficacy of ferroptosis-related CXCL2 in hepatocellular carcinoma. Front Oncol. 2022;12:998736. https://doi.org/10.3389/fonc.2022.998736.
- Kolios G, Valatas V, Ward SG. Nitric oxide in inflammatory bowel disease: A universal messenger in an unsolved puzzle. Immunology. 2004;113:427–437.
- Cheng F, et al. Identification of differential intestinal mucosa transcriptomic biomarkers for ulcerative colitis by bioinformatics analysis. Dis Markers. 2020;2020:8876565. https://doi.org/10.1155/2020/8876565.
- Tratensek A, et al. Oxidative stress-related biomarkers as promising indicators of inflammatory bowel disease activity: A systematic review and meta-analysis. Redox Biol. 2024;77:103380. https://doi.org/10.1016/j.redox.2024.103380.
- Zhang JL, et al. Jatrorrhizine alleviates ulcerative colitis via regulating gut microbiota and NOS2 expression. Gut Pathog. 2022;14:41. https://doi.org/10.1186/s13099-022-00516-7.
- Li H, et al. Development of a prognostic model based on ferroptosis-related genes for colorectal cancer patients and exploration of the biological functions of NOS2 in vivo and in vitro. Front Oncol. 2023;13:1133946. https://doi.org/10.3389/fonc.2023.1133946.
- Seibt TM, Proneth B, Conrad M. Role of GPX4 in ferroptosis and its pharmacological implication. Free Radic Biol Med. 2019;133:144–152.
- Holland T, Mattner J. Intestinal eosinophils: Characterization of elusive granulocytes as anti-bacterial and immunomodulatory effector cells in colitis. Signal Transduct Target Ther. 2023;8:321. https://doi.org/10.1038/s41392-023-01588-4.
- Nguyen J, et al. Overexpression of programmed death ligand 1 in refractory inflammatory bowel disease. Hum Pathol. 2022;126:19–27.
- Shen Z, et al. Exploration of a screening model for intrahepatic cholangiocarcinoma patients prone to cuproptosis and mechanisms of the susceptibility of CD274-knockdown intrahepatic cholangiocarcinoma cells to cuproptosis. Cancer Gene Ther. 2023;30:1663–1678.
- Niu Y, et al. Platelet activation stimulates macrophages to enhance ulcerative colitis through PF4/CXCR3 signaling. Int J Mol Med. 2025;55:78. https://doi.org/10.3892/ijmm.2025.5499.
- Qu F, et al. The role of macrophage polarization in ulcerative colitis and its treatment. Microb Pathog. 2025;199:107227. https://doi.org/10.1016/j.micpath.2025.107227.
- Danne C, Skerniskyte J, Marteyn B, Sokol H. Neutrophils: From IBD to the gut microbiota. Nat Rev Gastroenterol Hepatol. 2024;21:184–197.
- Zhao Q, et al. CD4+ T cell activation and concomitant mTOR metabolic inhibition can ablate microbiota-specific memory cells and prevent colitis. Sci Immunol. 2020;5:eabc6373. https://doi.org/10.1126/sciimmunol.abc6373.
- Chen E, et al. Inflamed ulcerative colitis regions associated with MRGPRX2-mediated mast cell degranulation and cell activation modules, defining a new therapeutic target. Gastroenterology. 2021;160:1709–1724.
- Xu H, Wu C, Wang D, Wang H. Alleviating effect of Nexrutine on mucosal inflammation in mice with ulcerative colitis: Involvement of the RELA suppression. Immun Inflamm Dis. 2024;12:e1147. https://doi.org/10.1002/iid3.1147.
- Luo Y, et al. Rab27A promotes cellular apoptosis and ROS production by regulating the miRNA-124-3p/STAT3/RelA signalling pathway in ulcerative colitis. J Cell Mol Med. 2020;24:11330–11342.
- Pace F, Watnick PI. The interplay of sex steroids, the immune response, and the intestinal microbiota. Trends Microbiol. 2021;29:849–859.
- Rodriguez J, Olivares M, Delzenne NM. Implication of the gut microbiota in metabolic inflammation associated with nutritional disorders and obesity. Mol Nutr Food Res. 2021;65:e1900481. https://doi.org/10.1002/mnfr.201900481.
- Ojha R, et al. Emerging role of circulating microRNA in the diagnosis of human infectious diseases. J Cell Physiol. 2019;234:1030–1043.
- Tian Y, et al. LncRNA CDKN2B-AS1 relieved inflammation of ulcerative colitis via sponging miR-16 and miR-195. Int Immunopharmacol. 2020;88:106970. https://doi.org/10.1016/j.intimp.2020.106970.
- Kulkarni N, Pathak M, Lal G. Role of chemokine receptors and intestinal epithelial cells in the mucosal inflammation and tolerance. J Leukoc Biol. 2017;101:377–394.
- Stadnyk AW. Intestinal epithelial cells as a source of inflammatory cytokines and chemokines. Can J Gastroenterol. 2002;16:241–246.
- Xu Y, Chen N. DUOX2-mediated innate immune hyperactivation drives macrophage M1 polarization via the APP-CD74 axis in inflammatory bowel disease. Presented at: 19th Congress of the European Crohn’s and Colitis Organisation (ECCO 2026); Stockholm, Sweden; 2026. https://academic.oup.com/ecco-jcc/article/20/Supplement_1/jjaf231.232/8432779.
- Shi CL, et al. Single-nucleus transcriptome unveils the role of ferroptosis in ischemic stroke. Heliyon. 2024;10:e32727. https://doi.org/10.1016/j.heliyon.2024.e32727.
- Tu H, et al. Integrated single-cell analysis with experimental validation reveals ANXA2 as a therapeutic target for ferroptosis in inflammatory bowel disease. Am J Transl Res. 2026;18:91–111.
- Yan C, et al. Exploring the anti-ferroptosis mechanism of Kai-Xin-San against Alzheimer's disease through integrating network pharmacology, bioinformatics, and experimental validation strategy in vivo and in vitro. J Ethnopharmacol. 2024;326:117915. https://doi.org/10.1016/j.jep.2024.117915.
- Shaik JP, Ahmad A. Pharmacological mechanism of cinnamic acid in the treatment of prostate cancer by network pharmacology. Archives of Medical Reports. 2024;1(2):1–6. https://doi.org/10.26524/amr.2024.2.1.
- Nimmagadda S, Patel S, MR Vishwathika. Targeting ferroptosis: A novel therapeutic avenue in osteoarthritis and bone degeneration. Archives of Medical Reports. 2025;2(5):6–9. https://doi.org/10.26524/amr.2025.5.2.
Доступ ограничен. Войдите в систему или начните пробный период, чтобы просмотреть этот контент.