Данный протокол объединяет деидентификацию, нормализацию терминологии, верификацию источников и воспроизводимую визуализацию для создания проверяемых агрегированных результатов на основе реальных амбулаторных записей пациентов, получавших традиционную китайскую медицину.
Методическая статья
Верифицированный по источникам майнинг и визуализация реальных записей клинических случаев применения формулы Хэгань Цзяньпи в традиционной китайской медицине
* These authors contributed equally
В этой статье
Краткое содержание
Аннотация
Реальные записи амбулаторных больных из практики традиционной китайской медицины (ТКМ) содержат лонгитюдную информацию о диагнозах, элементах синдромов, описаниях симптомов и индивидуальных назначениях, однако их полуструктурированный формат затрудняет воспроизводимый анализ. В данной статье представлен прошедший аудит протокол преобразования деидентифицированных записей случаев в прослеживаемые сводные таблицы и визуализации, готовые к публикации. Рабочий процесс определяет критерии отбора и единицы анализа, сохраняет сопоставления между оригинальной и нормализованной терминологией, верифицирует все отчетные числители и знаменатели, а также воссоздает рисунки на основе версионных исходных таблиц. При применении к записям за период с января 2015 по июнь 2024 года в соответствии с протоколом было выявлено 555 подходящих визитов с назначениями от 396 пациентов. Итоговый набор данных содержал 324 нормализованных наименования трав и 9 339 случаев использования трав. В ходе работы были сформированы параллельные спектры заболеваний по западной медицине и ТКМ, эксплицитный спектр элементов синдромов и матрица совместной встречаемости, профили частоты использования трав и фармакогнозии (materia medica), спектр симптомов из истории болезни, состоящий из 37 терминов, 15 направленных ассоциативных правил, иерархическая кластеризация и тепловые карты использования трав, стратифицированные по диагнозам. По крайней мере одно заранее заданное ключевое слово из истории болезни было обнаружено в 474 визитах (85,41%). Если это разрешено политикой учреждения, вариант использования искусственного интеллекта (ИИ) под контролем человека может помочь в проверке терминологии, анализе согласованности между файлами и сопоставлении подписей с рисунками. Любое использование ИИ должно быть задокументировано в отдельном аудиторском отчете и не может заменить проверку исходных данных. Интегрируя управление, нормализацию, вычисления, клиническую интерпретацию и визуальный вывод в единый воспроизводимый рабочий процесс, данный метод превращает разрозненную клиническую документацию в проверяемый исследовательский ресурс. Протокол может быть адаптирован для других наборов данных экспертной практики, многоцентровых терминологических проектов и платформ проспективных клинических данных.
Введение
Реальные амбулаторные записи традиционной китайской медицины (ТКМ) сохраняют лонгитюдную клиническую логику через описание симптомов, параллельные диагностические системы, характеристики синдромов и индивидуальные рецепты. Ранние работы по поиску знаний определили записи случаев как сложные эмпирические данные, требующие специальных информатических методов для надежного изучения их паттернов1. Последующие исследования показали, что синонимичные выражения симптомов, детализированные сущности и локально документированные диагностические термины должны быть нормализованы без удаления оригинальных формулировок2,3,4,5,6. Данные электронных медицинских карт (ЭМК) также могут поддерживать компьютерные исследования назначений и использование повторно применимых аналитических инструментов при условии сохранения видимости клинического контекста и происхождения данных7,8. Таким образом, необходимы авторитетные справочники по фармакогнозии (materia-medica) для стандартизации названий трав, способов обработки, свойств, вкусов и привязки к меридианам9,10. На уровне отчетности стандарты RECORD и STROBE требуют прозрачного описания источников данных, критериев отбора, переменных и аналитических решений, в то время как принципы FAIR подчеркивают необходимость прослеживаемости и повторного использования объектов исследования11,12,13. Эти соображения особенно важны, когда записи содержат сведения о повторных визитах, пропуски в полях, перекрывающуюся терминологию и свободный текст. Оценка пригодности к использованию должна охватывать полноту, соответствие, правдоподобность и согласованность источников14,15. Деидентификация свободного текста также требует четких процедур и проверки человеком, поскольку автоматизированные методы могут сохранить полезный клинический контент, оставив при этом остаточные риски для конфиденциальности16,17,18.
После установления правил управления данными и терминологии, профилирование частоты, поиск ассоциативных правил и иерархическая кластеризация могут обеспечить взаимодополняющее представление структуры назначений19,20,21. Методы сетевого анализа и картирования науки дополнительно демонстрируют, как скоординированные визуальные представления могут выявить взаимосвязи, которые невозможно зафиксировать с помощью одного ранжированного списка22,23,24,25. Недавние исследования ревматоидного артрита с депрессией, применения ингибиторов янус-киназ при язвенном колите и ревматоидного артрита с фибромиалгией иллюстрируют ценность критериев поиска с фиксированной версией, сетей совместного появления, кластеризации, временной интерпретации и явного указания аналитических ограничений26,27,28. Настоящее исследование адаптирует эти переносимые принципы проектирования к анализу клинических записей, а не к библиометрике литературы. В исходных записях формулой Hegan Jianpi Formula обозначается эмпирическая формула, связанная с практикой профессора Nai-li Yao29,30. В соответствующих публикациях описывается его более широкий клинический подход к гармонизации печени и селезенки, а также селезенки и желудка29,30. В данной статье по методике название формулы служит только для идентификации контекста исходной записи и не устанавливает фиксированного состава, дозы, показаний к лечению или заявленной эффективности. Вычислительный рабочий процесс использует детерминированные правила и статистические методы общего назначения. Воспроизводимая вычислительная практика дополнительно требует сохранения входных данных, документирования параметров, использования скриптов для преобразований и наличия проверяемых выходных данных31,32. Опция использования искусственного интеллекта (ИИ) под наблюдением человека может помочь в проверке терминологии, анализе согласованности между файлами и визуальном контроле качества при условии документирования его применения. Клинический опыт, гарантии конфиденциальности и ответственное принятие решений человеком должны оставаться первичными (Supplementary Table 1)33,34. Общая цель данного метода заключается в преобразовании обезличенных записей случаев TCM в проверенную цепочку выходных данных, стратифицированных по заболеванию, синдрому, симптомам, использованию трав, ассоциациям, кластерам и диагнозам. В практическом примере используются 555 подходящих визитов с назначениями от 396 пациентов, чтобы продемонстрировать, как управление данными, нормализация, вычисления, клиническая интерпретация и визуальный выпуск результатов могут быть интегрированы без раскрытия записей на уровне пациентов, точных деталей состава, соотношений доз или инструкций по назначению.
Протокол
Данный ретроспективный анализ деидентифицированных клинических записей был рассмотрен и одобрен Медицинским этическим комитетом больницы Гуананьмэнь Академии медицинских наук Китая (номер одобрения 2026-108-KY; 13 июля 2026 г.). Требование о получении информированного согласия было отменено Комитетом.
1. Определение этических норм, принципов управления и обеспечения безопасности данных
- Назначьте ответственного за хранение данных, аналитика исходных данных, рецензента по клинической терминологии, количественного рецензента и исследователя, уполномоченного одобрить выпуск агрегированных данных. Зафиксируйте каждую роль в журнале проекта.
- Подготовьте план управления данными с указанием разрешенной исходной системы, периода исследования, полей, места хранения, прав доступа, процедуры резервного копирования, срока хранения и ограничений по ключам связей.
- Экспортируйте только минимальный набор переменных, необходимых для заранее определенного анализа. Включите локальный идентификатор пациента, дату визита, возраст или дату рождения (если разрешено), пол, западный диагноз, название заболевания согласно ТКМ, обезличенный текст анамнеза, описание языка, пульса, синдрома и поля с назначением трав.
- Удалите имена, государственные идентификационные номера, номера телефонов, подробные адреса, страховые идентификаторы, контактную информацию и другие прямые идентификаторы внутри контролируемой институциональной среды. Замените каждый номер медицинской карты специфическим для проекта идентификатором пациента.
- Просканируйте текстовые поля на наличие остаточных идентификаторов и замаскируйте каждый обнаруженный элемент. Храните любой ключ связей отдельно от аналитического набора данных и исключите его из рабочих папок, папок для совместной работы и папок для подачи материалов.
- Сохраните первоначальный обезличенный экспорт в виде снимка исходных данных только для чтения. Зафиксируйте его имя файла, дату создания, количество строк, количество столбцов, размер файла и контрольную сумму в манифесте исходных данных.
- Создайте отдельные каталоги для исходных файлов, рабочих файлов, словарей, агрегированных таблиц, рисунков, скриптов и записей аудита.
- Ограничьте объем публикуемых или совместно используемых материалов агрегированными таблицами, одобренными обезличенными словарями, скриптами и рисунками для публикации. Не загружайте идентифицируемые или потенциально реидентифицируемые записи в общедоступные генеративные системы ИИ, неодобренные облачные сервисы или публичные репозитории.
ПРИМЕЧАНИЕ: Если политика учреждения разрешает использование ИИ под надзором человека, предоставляйте только обезличенные фрагменты текста или агрегированные таблицы. Зафиксируйте цель, проверенный результат, принятое исправление, рецензента и дату в журнале аудита.
2. Определение правила идентификации записей и единиц анализа
- Определите медицинское учреждение, амбулаторные условия, ответственную клиническую группу, систему электронных медицинских карт и исходный период до начала скрининга. Для приведенного примера используйте записи за период с января 2015 года по июнь 2024 года.
- Сохраните правило идентификации когорты в ограниченном файле с контролем версий до изучения результатов анализа. Зафиксируйте принятые варианты терминологии, а также все критерии включения и исключения, не раскрывая в рукописи конфиденциальных деталей формулировок.
- Примените заблокированное по версии правило идентификации записей на уровне посещений с назначением препаратов после нормализации названий трав. Сформируйте итоговый набор данных, включающий исходные файлы, словари, правило формирования когорты и параметры анализа, в виде единого релиза.
- Создавайте новую версию и заново генерируйте все зависимые выходные данные при любом изменении компонента с заблокированной версией. Не изменяйте правило идентификации когорты после изучения распределения заболеваний, частоты использования трав, правил ассоциации или кластеров.
- Включите амбулаторный визит, если он попадает в заблокированный период исследования, соответствует действительному идентификатору пациента проекта, содержит интерпретируемую запись о назначении и удовлетворяет ограниченному правилу идентификации записей.
- Исключите точные дубликаты выгрузок, записи вне периода исследования, записи без интерпретируемого назначения и строки, не прошедшие проверку по заблокированному правилу идентификации. Назначьте одну основную причину исключения для каждой исключенной строки.
- Отличайте повторные выгрузки данных от фактических повторных визитов. Удаляйте только точные системные дубликаты или дубликаты выгрузок, сохраняя при этом сведения о реальных повторных визитах.
- Присвойте стабильные идентификаторы пациентов и визитов с назначением препаратов. Создайте манифест когорты, содержащий версию источника, версию правила, статус скрининга, причину включения или исключения, идентификатор пациента, идентификатор визита и статус рецензирования.
- Для сводных демографических данных, включая возраст и пол, используйте по одной записи на каждого уникального пациента. Используйте визит с назначением препаратов в качестве единицы анализа для изучения заболеваний, синдромов, ключевых слов анамнеза, показателей языка, пульса, трав, правил ассоциации и кластерного анализа.
- Разграничьте соответствие критериям включения в когорту и доступность переменных. Сохраняйте визит, соответствующий критериям включения, даже при отсутствии данных в конкретном поле переменной, и указывайте оцениваемый знаменатель для каждого анализа.
- Зафиксируйте манифест когорты перед проведением описательного анализа. Запишите количество подходящих визитов с назначениями и число уникальных пациентов; при любом изменении решения о соответствии критериям включения заново генерируйте все зависимые выходные данные.
3. Нормализация терминологии и сохранение контрольного журнала
- Создайте отдельные словари с контролем версий для трав, западных диагнозов, названий заболеваний ТКМ, элементов синдромов, ключевых слов анамнеза, терминов описания языка, терминов описания пульса и атрибутов фармакопеи (materia-medica).
- В каждом словаре укажите исходный термин, нормализованный термин, категорию термина, поле источника, правило, справочный источник, версию словаря, рецензента, дату рецензирования и комментарии. Сохраняйте каждый исходный термин после нормализации.
- Нормализуйте названия китайских лекарственных средств (CMM), используя авторитетные номенклатурные справочники9,10. Исправляйте типографские варианты и системные сокращения, сохраняя при этом клинически значимые формы обработки.
- Сохраняйте квалификаторы обработки, включая обжаривание, обработку уксусом, обжаривание с медом, обработку имбирем, обработку вином, обугливание и сырое состояние, в виде отдельных меток.
- Держите орфографически или клинически различные травы раздельно. Не объединяйте Bai Shao с Bai Zhu и не делайте выводов о виде травы на основании неоднозначного сокращения без проверки источника.
- Сохраняйте исходную дозу и единицу измерения в отдельных полях, если они доступны. Удаляйте текст дозы только при создании переменных наличия трав на уровне визита.
- Не интерпретируйте частоту возникновения как кумулятивную дозу или интенсивность лечения.
- Нормализуйте названия заболеваний западной медицины и ТКМ независимо друг от друга. Сохраняйте диагностическую систему и статус основного диагноза; не переводите метку заболевания ТКМ в западный диагноз, если оба варианта не зафиксированы в источнике явным образом.
- При необходимости для ориентации читателя при первом использовании определите транслитерированную метку заболевания ТКМ. Сохраняйте исходную метку источника.
- Разделите многозначный явный текст синдромов, используя фиксированные версии разделителей, и сопоставьте исходные выражения с нормализованными элементами синдромов. Удалите дубликаты каждого нормализованного элемента в рамках одного визита.
- Держите явный текст синдромов отдельно от столбцов индикаторов, полученных по наследству или на основе баллов.
- Сохраняйте исходные поля описания языка, пульса, структурированных симптомов и деидентифицированного анамнеза как отдельные информационные продукты. Не считайте совпадение по ключевым словам анамнеза эквивалентным структурированному симптому, введенному клиницистом.
- Поручите одному рецензенту предложить вариант для каждого неоднозначного или много-к-одному сопоставления, а второму клиническому рецензенту — проверить его. Исключайте неуверенные сопоставления из публикуемых анализов до тех пор, пока проверка источника не разрешит противоречия.
- Проверьте наличие пустых нормализованных меток, сопоставлений один-ко-многим, сопоставлений многие-к-одному, дубликатов записей в словаре, непроверенных терминов и случайной потери меток обработки. Зафиксируйте версии словарей перед генерацией сводных таблиц.
4. Проверка исходных полей и блокировка отчетных выходных данных
- Создайте реестр доказательств, в котором будет одна строка для каждого утверждения в рукописи, таблицы и панели рисунка. Зафиксируйте единицу анализа, исходное поле, версию источника, версию словаря, версию скрипта, числитель, знаменатель, выходной файл, рецензента и утвержденную формулировку.
- Пересчитайте количество подходящих визитов и уникальных пациентов, демографические сводки, количество случаев заболеваний, количество явных синдромов, количество ключевых слов в анамнезе, частоту использования объединенных травяных препаратов и общие итоги применения трав непосредственно из файлов с заблокированной версией.
- Сравните каждое пересчитанное значение с соответствующим значением в рукописи, электронной таблице или на рисунке. Исправьте рукопись и заново создайте зависимые выходные данные в каждом случае подтверждения расхождения.
- Устраните каждое расхождение на уровне исходного поля. Запишите причину, исправление, рецензента и дату в реестр доказательств перед публикацией затронутого результата.
- Убедитесь, что каждая сводная таблица содержит нормализованную метку, числитель, знаменатель, определение процента, единицу анализа и идентификатор источника, необходимые для воспроизведения соответствующего утверждения.
- Проверьте знаменатель, используемый для каждого процента. Используйте количество уникальных пациентов для фиксированных демографических характеристик и количество визитов с назначением препаратов для динамических клинических переменных и переменных назначения.
- Сравните подписи к рисункам, значения, порядок и определения панелей с их соответствующими сводными таблицами с заблокированной версией. Пересоздавайте каждый рисунок после внесения исправлений в таблицу, а не редактируйте значения на графиках вручную.
- Попросите клинического рецензента проверить соответствие терминологии. Попросите количественного рецензента проверить подсчеты, показатели, метрики правил и знаменатели тепловых карт.
- Заблокируйте реестр доказательств, сводные таблицы и источники рисунков под единым идентификатором версии перед сборкой рукописи.
5. Получение описательных спектров и результатов анализа совместной встречаемости
- Сформируйте сводные данные по возрасту и полу на уровне пациентов, используя одну строку для каждого уникального пациента. Сохраните и эксплицитно укажите категории с неизвестными значениями.
- Сформируйте спектры заболеваний согласно западной медицине и традиционной китайской медицине (ТКМ) отдельно на уровне визитов с назначением лекарств. Сохраните исходную систему диагностики и рассчитайте ведущие нормализованные метки, используя общий знаменатель визитов.
- Сформируйте спектр синдромов-элементов на основе поля с эксплицитно нормализованным текстом синдрома. Разделите термины с помощью фиксированных разделителей версии, удалите дубликаты каждого термина в рамках одного визита и рассчитайте частоту встречаемости на уровне визитов.
- Постройте матрицу совместной встречаемости синдромов на основе тех же наборов токенов в рамках одного визита. Закодируйте размер узла частотой визитов, а ширину ребра или интенсивность тепловой карты — количеством парных совместных случаев.
- Заранее определите точный словарь ключевых слов анамнеза для случаев, когда информация о симптомах представлена преимущественно в повествовательной форме. Сканируйте только деидентифицированное поле анамнеза и учитывайте каждое понятие не более одного раза за визит.
- Рассчитайте долю подходящих визитов, содержащих хотя бы одно ключевое слово анамнеза, и ранжируйте количество всех ключевых слов. Экспортируйте полную таблицу и построенный на ее основе подмножество данных.
- Сформируйте частоты объединенных трав на основе нормализованных данных о назначениях. Учитывайте каждую нормализованную метку травы не более одного раза за визит и сохраняйте клинически значимые формы обработки в качестве отдельных меток.
- Сформируйте профили «Четырех энергий» (Four-Qi), пяти вкусов и меридианного тропизма, используя фиксированный словарь materia-medica. Рассматривайте «Четыре энергии» как категорию с одним значением для каждого случая встречаемости травы с соответствующим кодом свойства.
- Рассматривайте пять вкусов и меридианный тропизм как многозначные атрибуты. Укажите знаменатель по кодам свойств и сохраните отдельную единицу анализа.
- Экспортируйте одну машиночитаемую агрегированную таблицу для каждой описательной области перед созданием итоговых графиков.
6. Проведение анализа ассоциативных правил и иерархической кластеризации
- Постройте бинарную матрицу «визит по рецепту — лекарственное растение» на основе нормализованной таблицы рецептов с зафиксированной версией. Используйте одну строку для каждого подходящего визита и один столбец для каждого нормализованного названия растения.
- Рассчитайте поддержку (support), достоверность (confidence) и lift для направленных правил ассоциации по одному растению19. Сохраняйте направление каждого правила, так как достоверность зависит от антецедента.
- Примените заранее определенные пороги: поддержка ≥ 0.30, достоверность ≥ 0.70 и lift > 1.0. Экспортируйте каждое сохраненное правило вместе с количеством совместных появлений и всеми тремя метриками.
- Изобразите полный набор сохраненных правил в виде направленной двухдольной сети правил и упорядоченного профиля силы правил. Кодируйте ширину ребер сети поддержкой, а цвет ребер — показателем lift.
- Кодируйте размер точек поддержкой и укажите значение достоверности в упорядоченном профиле.
- Убедитесь, что оба способа отображения правил содержат один и тот же набор сохраненных правил и сохраняют направление правил. Перед публикацией устраните каждое несоответствие, сверяясь с экспортированной таблицей правил.
- Выберите 20 переменных наличия растений с наибольшей частотой для иерархической кластеризации. Рассчитайте попарные расстояния Жаккара и примените метод средней связи (average linkage).
- Подпишите дендрограмму нормализованными названиями растений. Интерпретируйте близость ветвей исключительно как сходство паттернов встречаемости на уровне визитов.
- Перед созданием рисунков экспортируйте спецификацию бинарной матрицы, таблицу правил, список ребер сети, порядок входных данных для кластеризации, матрицу расстояний и матрицу связей.
- Попросите количественного рецензента вручную воспроизвести одну метрику правила. Сравните каждое ребро сети с таблицей правил.
- Повторно запускайте весь рабочий процесс вычисления правил и кластеризации при любом изменении когорты, словаря терминов или матрицы наличия растений.
- Для практического примера проведите детерминированный анализ чувствительности «один визит на одного пациента», сохранив самую раннюю запись по исходному порядку для каждого пациента. Сравните полученные 12 правил с 15 правилами, полученными в результате анализа на уровне визитов.
- Представьте этот результат как описательный показатель робастности, а не как валидацию на уровне пациентов. Используйте детерминированный пересчет, представленный в Supplementary File 1.
7. Создание паттернов, стратифицированных по диагнозу, и структуры клинической интерпретации
- Выберите клинически значимые основные страты по западным диагнозам перед анализом распределения трав для конкретных диагнозов.
- Подсчитывайте каждую нормализованную метку травы не более одного раза за один визит внутри каждой страты диагноза. Рассчитайте распространенность как отношение количества визитов, содержащих данную метку, к общему количеству подходящих визитов в этой страте.
- Используйте один и тот же набор отображаемых трав и фиксированную цветочную шкалу от 0% до 100% для всех страт диагнозов. Отображайте значения ячеек для сохранения точности интерпретации.
- Укажите числитель и знаменатель для каждой отображаемой ячейки в отдельной сводной таблице.
- Создайте отдельную панель клинической интерпретации после завершения описательной тепловой карты. Визуально разграничьте вычисленные результаты и экспертную интерпретацию.
- Заполняйте слой подсказок только терминами, которые можно отследить в таблице ключевых слов истории, зафиксированной по версии, или в явном нормализованном тексте синдрома.
- Поручите двум клиническим рецензентам согласовать краткие контекстуальные интерпретации выбранных подсказок. Запишите имена рецензентов и окончательную формулировку в реестр доказательств.
- Свяжите каждую контекстуальную интерпретацию с целью исследования, такой как выбор переменных, проспективная валидация или генерация гипотез.
- Используйте пунктирные ненаправленные соединители для слоя интерпретации. Исключите данные о дозировке, составе с фиксированным соотношением компонентов и рекомендации по лечению.
- Проанализируйте тепловую карту и панель интерпретации совместно. Убедитесь, что вычисленная распространенность, экспертный контекст и цели будущих исследований остаются четко разделенными.
8. Сборка и проверка пакета для воспроизведения
- Экспортируйте исходный манифест, манифест когорты, версии словаря, реестр доказательств, скрипты анализа, сводные таблицы, исходные данные рисунков и итоговые рисунки в отдельные директории.
- Присваивайте каждому файлу имя, содержащее стабильный номер рисунка или таблицы и дату версии. Сохраняйте одну официальную текущую версию, а устаревшие результаты архивируйте отдельно.
- Создавайте каждый рисунок в виде одного многопанельного файла изображения. Экспортируйте PDF-файл высокого разрешения и PNG-файл с разрешением 300 dpi для проверки.
- Размещайте подрисуночные подписи в рукописи, вне файлов изображений. Описывайте каждую панель, единицу анализа, знаменатель и визуальное кодирование.
- Подготовьте отдельный файл XLSX для каждой таблицы.
- Попросите независимого рецензента сравнить числовые данные в рукописи со сводными таблицами, а проценты — их числителями и знаменателями.
- Сравните границы правил с таблицей правил, а ячейки тепловой карты — с исходной матрицей.
- Выполните автоматическую проверку согласованности имен файлов, наличия обязательных разделов, размеров рисунков, количества таблиц, количества ссылок, остатков шаблонов и использования запрещенных формулировок.
- Попросите группу авторов-клиницистов проверить терминологию, интерпретацию, границы интеллектуальной собственности, данные об авторах, порядок финансирования, формулировки по этике и итоговый набор рисунков.
- Удалите из пакета материалов для подачи файлы с данными на уровне пациентов, ключи связей, нередактируемый свободный текст, внутреннюю переписку и временные артефакты рецензирования.
- Зафиксируйте финальный пакет материалов и запишите его версию, дату, контрольную сумму, версию рукописи и статус одобрения авторами. Создавайте новую версию и журнал изменений для каждой последующей правки.
Результаты
Успешное применение протокола позволило создать отслеживаемую цепочку, объединяющую деидентифицированный исходный снимок данных, манифест когорты, словари терминологии, сводные таблицы, скрипты и итоговые рисунки. Процедура скрининга с зафиксированной версией позволила выявить 555 подходящих визитов с назначением препаратов от 396 уникальных пациентов. На Рисунке 1 обобщены три скоординированных этапа метода: управление данными, нормализация терминологии и анализ с клиническим обзором. Соответствующая документация по прозрачности и аудиту, включая границы использования только агрегированных данных для обзора с помощью ИИ, представлена в Дополнительной таблице 1.
Итоговая когорта состояла из 555 подходящих визитов с назначением препаратов от 396 уникальных пациентов (Рисунок 2 и Таблица 1). Подлинные повторные визиты были сохранены для анализа динамических клинических переменных и переменных назначения препаратов, в то время как данные о возрасте и поле были обобщены после удаления дубликатов на уровне пациентов. Возраст пациентов варьировался от 13 до 94 лет, при среднем значении 47,11 лет и стандартном отклонении 14,88 лет. В когорта decomposed входила 228 женщин (57,58%), 167 мужчин (42,17%) и 1 пациент с неизвестным полом (0,25%). Такое разделение единиц анализа позволило сохранить лонгитюдные наблюдения, не завышая при этом демографический знаменатель.
Спектры заболеваний согласно западной и традиционной китайской медицине (ТКМ) обобщены на рисунке 3. Западные диагнозы были сосредоточены на желудочно-кишечных, гепатобилиарных и панкреатических расстройствах. В результате иерархической группировки 271 визит был отнесен к желудочно-кишечным заболеваниям, 222 — к заболеваниям печени, желчевыводящих путей или поджелудочной железы и 62 — к заболеваниям других систем (рисунок 3A). Основными отдельными диагнозами были хронический гастрит в 133 визитах (23,96%), жировая болезнь печени в 77 визитах (13,87%) и цирроз печени в 46 визитах (8,29%), за которыми следовали хронический атрофический гастрит, боли в животе, хронический гепатит B, диспепсия, рефлюкс-эзофагит, хронический поверхностный гастрит и хронический панкреатит (рисунок 3C и таблица 2).
Соответствующий спектр названий заболеваний по ТКМ организовал те же визиты в соответствии с параллельной диагностической системой. Названия заболеваний селезенки-желудка или кишечника составили 280 визитов, заболеваний печени-желчного пузыря — 223, расстройств ци-крови-жидкостей — 26, расстройств разума-груди-головы — 12, расстройств каналов или конечностей — 5, гинекологических расстройств — 4, и другие категории — 5 визитов (Рисунок 3B). Wei pi, сохраненный термин заболевания ТКМ для обозначения чувства распирания или дискомфорта в эпигастрии, был зафиксирован в 163 визитах (29,37%). Ji disease (исходный термин ТКМ для заболеваний накопительного типа), Gan zhuo (буквально «фиксация печени»; сохраненный классический термин заболевания ТКМ), Bi disease (заболевание-преграда) и Xiao ke (истощающая жажда) были сохранены в качестве исходных терминов ТКМ и не были преобразованы в современные биомедицинские диагнозы. Gan pi, термин заболевания ТКМ, используемый в современном китайском консенсусе для расстройств жировой печени, был зафиксирован в 77 визитах (13,87%)35. Исходные поля западной медицины и ТКМ оставались независимыми и не заменяли друг друга (Рисунок 3D и Таблица 3). Xie xie (рыхкий или водянистый стул) и Fu xie (диарея) были отдельными исходными терминами заболеваний ТКМ, зафиксированными 6 и 2 раза соответственно, и ни один из них не был приравнен к современному биомедицинскому диагнозу. Отображение двух спектров рядом позволило сохранить логику каждой диагностической системы, демонстрируя при этом клинический охват исходных записей.
Поле с явным нормализованным текстом синдрома содержало 555 подходящих строк посещений. После дедупликации внутри посещений ведущими элементами были селезенка в 362 посещениях (65,23%), печень в 304 (54,77%), дефицит ци в 295 (53,15%), желудок в 171 (30,81%), сырость в 151 (27,21%) и застой ци в 109 (19,64%; Рисунок 4A и Таблица 4). Остальную часть представленного спектра составили жар, задержка жидкости, кровь, стаз крови, каналы, почки, сердце и дефицит инь. Проценты не были взаимоисключающими, так как при одном посещении могли присутствовать несколько элементов синдрома.
Сеть и матрица подсчета были сформированы на основе одних и тех же наборов токенов на уровне визитов (Рисунок 4B,C). Частое совместное упоминание было сосредоточено вокруг селезенки, печени и дефицита ци, с дополнительными связями с желудком, сыростью, застоями ци, жаром и задержкой жидкости. Использование одной матрицы с фиксированной версией для графика частот, сети и тепловой карты гарантировало, что все три панели представляют одну и ту же лежащую в основе доказательную базу с разной степенью детализации. В ходе проведенного аудита было выявлено 0 точных совпадений между текстом синдрома и индикатором среди 555 строк, а средний коэффициент сходства Жаккара между текстом и индикатором составил 0,1806. Таким образом, столбцы индикаторов были исключены из основного отчета. Сохраненные материалы не содержали реконструируемых векторов распределения до очистки; следовательно, стабильность распределения между версиями не оценивалась. Вместо этого анализ чувствительности с учетом одного визита на пациента позволил оценить влияние повторных визитов. Результаты аудита источников и качества данных представлены в Дополнительной таблице 2.
После нормализации терминологии и сохранения клинически значимых форм обработки в 555 визитах было выявлено 324 отдельных объединенных наименования трав и 9 339 случаев применения трав. Bai Shao был зафиксирован в 531 визите (95,68%), далее следовали Fu Ling в 520 (93,69%), Dang Gui в 510 (91,89%), Chi Shao в 467 (84,14%) и обжаренный Bai Zhu в 361 (65,05%; Рисунок 5A и Таблица 5). Кривая рангового распределения частот для 36 основных наименований продемонстрировала крутой высокочастотный сегмент, за которым следовал постепенно расширяющийся «хвост» (Рисунок 5B), что дает компактное представление о компонентах общего фона и индивидуальных рецептов. Соответствия исходных наименований нормализованным, квалификаторы обработки, стандартные названия CMM, исходные виды и границы доказательств, лежащие в основе номенклатуры трав, документально зафиксированы в Дополнительной таблице 3.
Вспомогательный словарь materia-medica содержал 9 115 случаев использования трав с кодировкой свойств. Ведущими категориями «Четырех энергий» (Four-Qi) были теплая (2 588, 28,39%), слегка холодная (2 339, 25,66%), нейтральная (2 330, 25,56%) и холодная (1 221, 13,40%; Рисунок 5C). После нормализации терминологии вкусов сложных источников ведущими категориями «Пяти вкусов» были горький (4 488, 49,24%), сладкий (4 377, 48,02%) и острый (2 893, 31,74%) (Рисунок 5D). В кодировании меридианного тропизма лидировали селезенка (5 541, 60,79%), печень (4 801, 52,67%), легкие (3 358, 36,84%), желудок (2 988, 32,78%) и сердце (2 702, 29,64%; Рисунок 5E). На Рисунке 5F зафиксированы отдельные единицы анализа на уровне визитов и единицы с кодировкой свойств, а также связь их воспроизводимости. В совокупности эти панели демонстрируют, как можно обобщить частоту назначения препаратов и стандартизированные дескрипторы materia-medica, не объединяя специфическую терминологию обработки.
Предварительно определенный словарь анамнеза содержал 37 точных концепций симптомов. По крайней мере одна концепция была выявлена в 474 из 555 подходящих визитов (85,41%). Основными терминами были: сухость в горле в 178 визитах (32,07%), утомляемость в 151 (27,21%), плохой сон в 139 (25,05%), вздутие живота в 115 (20,72%), кислотный рефлюкс в 100 (18,02%), горький вкус во рту в 99 (17,84%), изжога в 90 (16,22%), икота в 87 (15,68%), отрыжка в 87 (15,68%) и неоформленный стул в 77 (Рисунок 6A,B и Таблица 6)).
Полная кривая распределения рангов и частот отображает полное распределение из 37 терминов, в то время как кумулятивная линия суммирует концентрацию всех обнаружений ключевых слов по рангам (Рисунок 6C). На Рисунке 6D зафиксирована воспроизводимая последовательность действий, использованная для создания спектра: фиксация словаря, сканирование деидентифицированного текста истории болезни, удаление дубликатов концепций внутри каждого визита, а также экспорт совокупных подсчетов и показателей частоты.
Для поиска ассоциативных правил использовалась матрица присутствия трав в визитах с назначениями из 555 строк с зафиксированной версией. Пятнадцать направленных правил для одного вида трав соответствовали критериям: поддержка ≥ 0,30, достоверность ≥ 0,70 и подъем (lift). > 1.0 (Рисунок 7A,B и Таблица 7). Значения сохраненной поддержки варьировались от 0,3009 до 0,7892, значения уверенности — от 0,7302 до 0,9748, а значения лифта — от 1,0010 до 1,1226.
Наиболее часто регистрируемой направленной парой была Chi Shao > Fu Ling (на основе 438 визитов) с поддержкой 0,7892, уверенностью 0,9379 и лифтом 1,0010. Обратное правило имело такую же поддержку и уверенность 0,8423, что демонстрирует необходимость сохранения направленности правила. Чувствительность порога позволила сохранить 18, 11, 21, 14, 7 и 4 правила при поддержке ≥ 0,25 или ≥ 0,35, уверенности ≥ 0,65 или ≥ 0,75 или лифте > 1,02 или > 1,05 соответственно. В анализе с учетом одного визита на одного пациента эта же пара встречалась в 316 визитах с поддержкой 0,7980, уверенностью 0,9489 и лифтом 0,9994; следовательно, она не была сохранена по критерию лифта > 1,0. Результаты пертурбации порогов и чувствительности к повторным визитам представлены в Дополнительной таблице 4, а детерминированный пересчет приведен в Дополнительном файле 1. Соответственно, высокую поддержку на уровне визитов не следует интерпретировать как подтверждение на уровне пациентов.
Наибольшие значения lift были наблюдаться для пар Gan Cao > stir-fried Bai Zhu (1,1226) и Gan Cao > Chi Shao (1,1200). Рисунок 7A объединяет все 15 отобранных правил в направленной двухдольном сети, где ширина ребра кодирует поддержку, а цвет ребра — lift. Рисунок 7B ранжирует те же правила по значению lift, масштабирует каждую точку по поддержке и указывает уровень достоверности (confidence). Таким образом, две панели позволяют разграничить топологию сети и количественную силу правил, а не просто дублируют одно и то же визуальное представление.
Для иерархической кластеризации 20 переменных состава трав с наибольшей частотой использования применялись расстояние Жаккара и метод среднего связывания (Рисунок 7C). Дендрограмма дает глобальное представление о сходстве паттернов присутствия на уровне визитов, что дополняет локальную направленную информацию, полученную с помощью правил ассоциации. Вместе эти панели демонстрируют, как взаимодополняющие аналитические подходы могут быть приведены к единой фиксированной по версии бинарной матрице.
Распространенность с учетом стратификации по диагнозам была рассчитана для жирового гепатоза печени (77 визитов), цирроза печени (46 визитов) и хронического гастрита (133 визита; Рисунок 8A и Таблица 8). Bai Shao, Fu Ling и Dang Gui продемонстрировали высокую распространенность во всех трех стратах. При визитах по поводу цирроза печени отмечалось значительное назначение Dan Shen (95,65%), E Zhu, обработанного уксусом (86,96%), Bie Jia, обработанного уксусом (84,78%), и Sheng Huang Qi (60,87%). При визитах по поводу жирового гепатоза печени наблюдалась более высокая распространенность Yin Chen (41,56%) и Ze Xie (31,17%) по сравнению с другими стратами, в то время как при визитах по поводу хронического гастрита часто назначались Huang Lian (44,36%), Mu Xiang (34,59%) и Chai Hu (36,09%). Таким образом, тепловая карта обеспечивает компактное описательное сравнение совокупных структур назначений в основных клинических контекстах.
Рисунок 8B разделяет вычисления и интерпретацию. Проверенные исторические данные связаны с краткими экспертными контекстами, которые, в свою очередь, связаны с целями исследования, включая контекстуализацию элементов синдрома, сравнение паттернов, стратифицированных по диагнозу, выбор переменных для проспективной валидации и формулирование последующих вопросов. Эта финальная панель демонстрирует, как клинический опыт может дополнить результаты анализа, оставаясь при этом четко отделенным от вычисленной распространенности.
Рисунок 8C суммирует воспроизводимость и границу высвобождения, отделяя проверенные по источнику или повторно проанализированные компоненты от элементов, требующих осторожности или дальнейшего подтверждения. Этот заключительный уровень аудита предотвращает представление неразрешенных или нереконструируемых аналитических продуктов в качестве валидированных результатов.
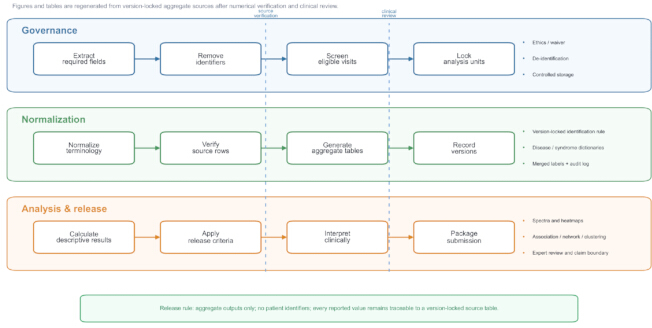
Рисунок 1Рабочий процесс извлечения данных из историй болезни с аудитом источников. Управление, нормализация терминологии, агрегатный анализ, клинический обзор и подготовка пакета для выпуска представлены как последовательные этапы рабочего процесса. Синие, зеленые и оранжевые полосы разграничивают области рабочего процесса, а вертикальные пунктирные линии обозначают контрольные точки аудита. Стрелки указывают последовательность рабочего процесса и не подразумевают биологическую причинно-следственную связь. Правило выпуска определяет, что выпускаются только агрегированные результаты, идентификаторы пациентов исключаются, а каждое зарегистрированное значение остается отслеживаемым до исходной таблицы с зафиксированной версией. Планки погрешностей не применяются. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
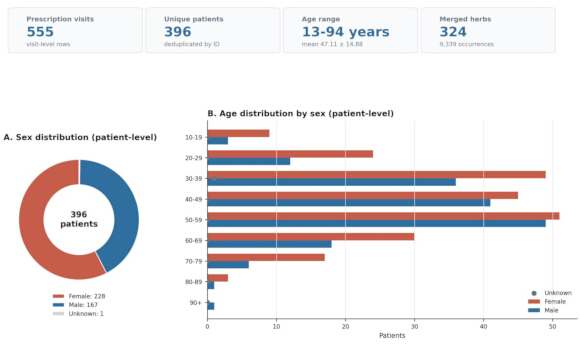
Рисунок 2: Профиль набора данных и демографические характеристики пациентов. В сводных блоках указаны 555 визитов с назначением препаратов, 396 уникальных пациентов, возрастной диапазон пациентов от 13 до 94 лет со средним возрастом 47,11 ± 14,88 лет, а также 324 объединенных названия трав, представляющих 9 339 случаев применения трав. (A) Распределение пациентов по полу среди 396 уникальных пациентов, включая категории «женский», «мужской» и «неизвестно». (B) Возрастное распределение пациентов по полу среди тех же 396 пациентов. В сводных блоках используются соответствующие знаменатели на уровне визитов или на уровне пациентов. Цвета используются для разграничения категорий пола и элементов сводки и не имеют статистического значения. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
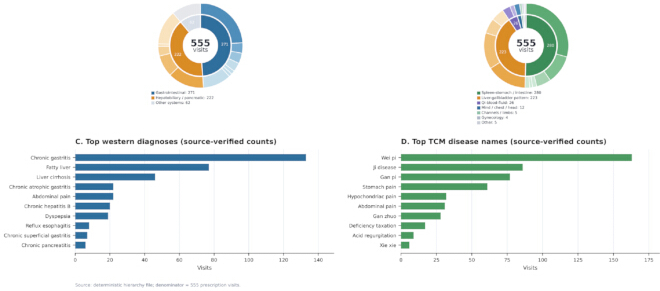
Рисунок 3: Спектры заболеваний, выявленные по данным визитов с назначением лекарственных средств. (A) Иерархические группы заболеваний по западной медицине и (B) иерархические группы заболеваний по ТКМ, выведенные на основе 555 подходящих визитов с назначением лекарств. (C) Основные нормализованные диагнозы по западной медицине и (D) основные нормализованные названия заболеваний по ТКМ для того же общего количества визитов. Сегменты кольца и столбцы представляют количество визитов; цвета разграничивают диагностические системы или категории и не отражают эффект лечения. Сохраненные исходные обозначения ТКМ определены в Таблице 3: Wei pi (чувство распирания или дискомфорта в эпигастрии), Ji disease (обозначение заболевания ТКМ типа аккумуляции/застоя), Gan pi (обозначение заболевания ТКМ, используемое при расстройствах жировой печени), Gan zhuo (буквально «фиксированность печени»; сохраненное классическое обозначение заболевания ТКМ), Bi disease (болезнь препятствия/застоя), Xiao ke (истощающая жажда), Xie xie (рыхлый или водянистый стул) и Fu xie (диарея). Данные пояснения не переводят исходные обозначения в современные биомедицинские диагнозы. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
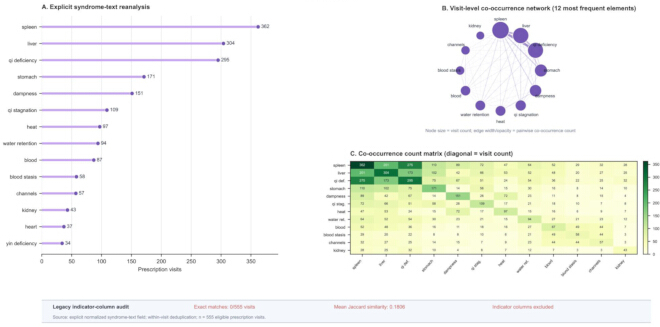
Рисунок 4Явный спектр «синдром — текст» и структура совместной встречаемости. (A) Частоты 14 нормализованных элементов синдрома на уровне визитов после удаления дубликатов внутри каждого визита, при использовании 555 подходящих амбулаторных визитов в качестве знаменателя. (B) Сеть совместной встречаемости 12 наиболее частотных элементов синдрома; размер узла соответствует частоте визитов, а ширина и прозрачность ребра — количеству парных совместных встречаний. (C) Соответствующая симметричная матрица подсчета совместного появления; диагональные ячейки представляют частоту отдельных визитов, а внедиагональные — количество парных совместных появлений. Контрольная полоса показывает 0 точных совпадений текста синдрома/индикатора по 555 строкам и среднее сходство Жаккара между текстом и индикатором, равное 0,1806; следовательно, столбцы устаревших индикаторов были исключены из основной отчетности. В матрице Qi def. означает дефицит ци, Qi stag. — стаз ци, а Water ret. — задержку жидкости. Цветовая палитра носит описательный характер. Планки погрешностей не применимы. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
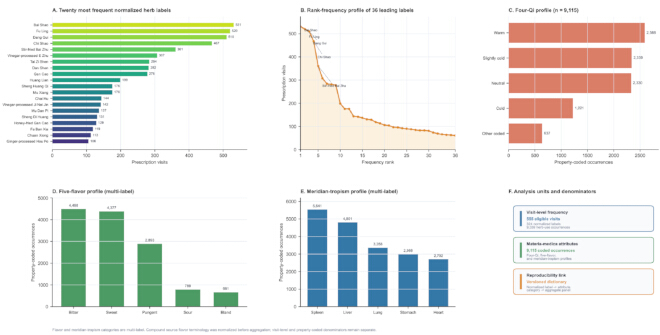
Рисунок 5: Часто встречающиеся лекарственные травы и нормализованные профили атрибутов materia-medica. (A) Двадцать наиболее часто встречающихся нормализованных названий трав среди 555 подходящих визитов с назначениями. (B) Профиль ранговой частоты 36 основных нормализованных названий трав. (C) Распределение по системе «четырех энергий» (Four-Qi) на основе 9 115 случаев использования трав с кодировкой свойств; для каждого закодированного случая Four-Qi имеет одно значение. (D) Распределение по «пяти вкусам» и (E) распределение по меридиальному тропизму на основе того же знаменателя с кодировкой свойств; оба атрибута являются многозначными, поэтому подсчеты по категориям не являются взаимоисключающими. (F) Единицы анализа на уровне визита и с кодировкой свойств, а также связь их воспроизводимости. Длина столбцов соответствует количеству, разные цвета различают панели. Планки погрешностей не применимы. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
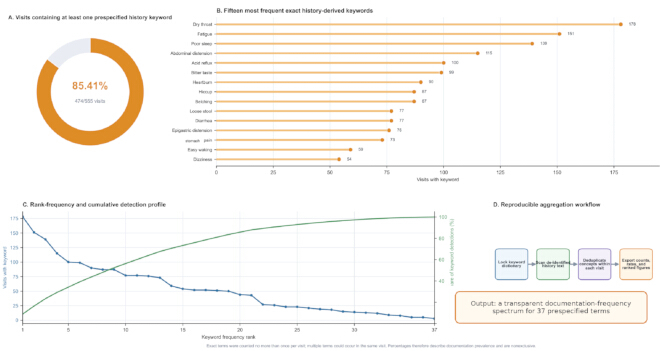
Рисунок 6: Спектр ключевых слов симптомов, полученных из анамнеза, и воспроизводимый рабочий процесс агрегации. (A) Доля 555 подходящих визитов для назначения препаратов, содержащих как минимум одно заранее определенное ключевое слово из анамнеза; в 474 визитах (85,41%) содержалось как минимум одно ключевое слово. (B) Пятнадцать наиболее часто встречающихся точных концепций симптомов, полученных из анамнеза. (C) Полное распределение ранга и частоты для 37 терминов и совокупная доля обнаружений ключевых слов. (D) Фиксированная по версии версия рабочего процесса: от заранее определенного словаря до агрегированных результатов. Каждая концепция учитывалась не более одного раза в рамках одного визита, в то время как в одном визите могли встречаться несколько концепций. Оранжевые столбцы представляют количество ключевых слов, а цвета рабочего процесса разграничивают этапы обработки. Планки погрешностей не применяются. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
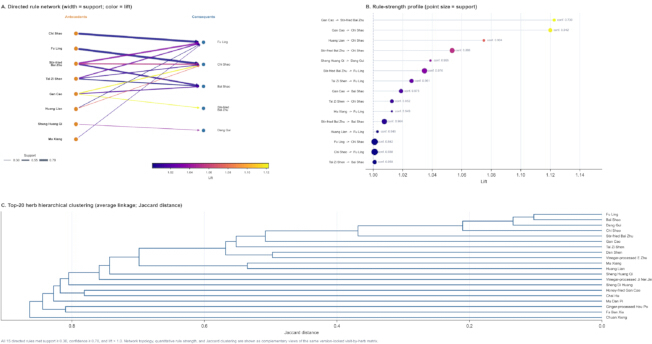
Рисунок 7: Направленные правила ассоциации трав и иерархическая кластеризация. (A) Направленная бипартитная сеть всех 15 правил ассоциации одного вида трав, соответствующих заранее заданным порогам: support ≥ 0.30, confidence ≥ 0.70 и lift > 1.0. Ширина ребра соответствует значению support, а цвет ребра — значению lift. (B) Профиль силы правил для тех же 15 правил, ранжированных по значению lift; размер точки соответствует значению support, а соседние подписи указывают значение confidence (conf.). (C) Иерархическая кластеризация с использованием среднего сцепления (average-linkage) для 20 наиболее часто встречающихся переменных присутствия трав с использованием расстояния Жаккара. На всех панелях в качестве единицы анализа используются визиты за рецептами; данные описывают закономерности совместного назначения, а не эффективность, синергию или рекомендованную фиксированную комбинацию. Планки погрешностей не применимы. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
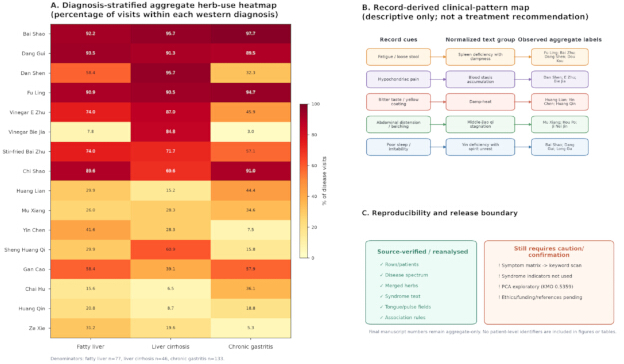
Рисунок 8: Агрегированные паттерны применения трав, стратифицированные по диагнозу, карта клинических паттернов и граница публикации. (A) Тепловая карта, стратифицированная по диагнозу, показывающая распространенность 16 нормализованных наименований трав на уровне визитов при жировой болезни печени (n = 77), циррозе печени (n = 46) и хроническом гастрите (n = 133). Каждая ячейка представляет процент соответствующих визитов в рамках данной страты западного диагноза с использованием фиксированной цветовой шкалы 0%–100%. (B) Карта клинических паттернов, выведенная из записей, связывающая верифицированные признаки в записях с нормализованными текстовыми группами и наблюдаемыми агрегированными наименованиями трав. Пунктирные ненаправленные соединители отделяют этот слой описательной интерпретации от вычисленной распространенности; данная панель не является рекомендацией по лечению. (C) Воспроизводимость и граница публикации, разделяющая компоненты, подтвержденные источником или повторно проанализированные, и элементы, требующие осторожности или подтверждения. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
| Метрика | Значение | Единица измерения/знаменатель | Статус |
| Визиты для выписки рецептов | 555 | 555 визитов для выписки рецептов | подтверждено на основе восстановленного файла XLSX |
| Уникальные пациенты | 396 | 396 уникальных пациентов | подтверждено на основе восстановленного файла XLSX |
| Диапазон возраста пациентов | 13-94 | годы | подтверждено |
| Средний возраст пациентов +/- SD | 47.11 +/- 14.88 | годы | верифицировано |
| Средний возраст на уровне визита +/- SD | 48.22 +/- 15.82 | лет | подтверждено |
| Пол пациента | Женщины: 228; мужчины: 167; неизвестно: 1 | 396 пациентов | подтверждено |
| Пол пола на уровне визита | Женщины: 327; мужчины: 227; не определено: 1 | 555 посещений | подтверждено |
| Смешанные травы | 324 | различные объединенные названия | подтверждено |
| Объединенные случаи использования трав | 9339 | 555 визитов за рецептурными препаратами | подтверждено |
Таблица 1: Профиль набора данных. Демографические характеристики на уровне пациентов и переменные на уровне визитов за рецептами представлены с использованием соответствующих знаменателей. Также приведены нормализованные общие показатели по лекарственным травам.
| Название заболевания | Количество | Процент визитов |
| Хронический гастрит | 133 | 24 |
| Жировой гепатоз печени | 77 | 13.9 |
| Цирроз печени | 46 | 8.3 |
| Хронический атрофический гастрит | 22 | 4 |
| Боль в животе | 22 | 4 |
| Хронический гепатит B | 20 | 3.6 |
| Диспепсия | 19 | 3.4 |
| Рефлюкс-эзофагит | 8 | 1.4 |
| Хронический поверхностный гастрит | 7 | 1.3 |
| Хронический панкреатит | 6 | 1.1 |
| Язвенный колит | 6 | 1.1 |
| Полип желчного пузыря | 6 | 1.1 |
| Постхолецистэктомический синдром | 6 | 1.1 |
| Кишечная дисфункция | 6 | 1.1 |
| Желчнокаменная болезнь | 6 | 1.1 |
| Хронический гепатит | 5 | 0.9 |
| Усталость | 5 | 0.9 |
| Желудочно-кишечная дисфункция (неопределенная исходная метка) | 5 | 0.9 |
| Хронический гастрит (неопределенная исходная метка) | 5 | 0.9 |
| Аутоиммунный цирроз печени | 4 | 0.7 |
Таблица 2: Основные нормализованные западные диагнозы. Количество и процент основного нормализованного западного диагноза, зафиксированного в ходе 555 подходящих визитов с назначением рецептурных препаратов. Процентное соотношение рассчитано относительно общего числа подходящих визитов с назначением рецептурных препаратов.
| название заболевания согласно ТКМ | Подсчет | Процент визитов |
| Вэй пи (чувство распирания или дискомфорта в эпигастральной области) | 163 | 29.4 |
| Болезнь Джи (метка ТКМ типа накопительного источника) | 86 | 15.5 |
| Гань пи (термин традиционной китайской медицины, используемый для обозначения заболеваний жировой печени) | 77 | 13.9 |
| Боли в желудке | 61 | 11 |
| Боли в подреберье | 32 | 5.8 |
| Боль в животе | 31 | 5.6 |
| Гань чжо (буквально «застой печени»; сохранившееся классическое обозначение заболевания в традиционной китайской медицине) | 28 | 5 |
| Налогообложение дефицита | 17 | 3.1 |
| Заброс кислоты (кислотный рефлюкс) | 9 | 1.6 |
| Xie xie (жидкий стул или диарея) | 6 | 1.1 |
| Бессонница | 4 | 0.7 |
| Дизентерия | 4 | 0.7 |
| Головная боль | 4 | 0.7 |
| Болезнь Би (болезнь-препятствие) | 4 | 0.7 |
| Менструальные расстройства | 3 | 0.5 |
| Препятствие в грудной клетке | 3 | 0.5 |
| Нарушение потоотделения | 3 | 0.5 |
| Запор | 3 | 0.5 |
| Фу се (диарея) | 2 | 0.4 |
| Сяо кэ (истощающая жажда) | 2 | 0.4 |
Таблица 3: Основные нормализованные названия заболеваний в ТКМ. Количество и процент основного нормализованного перечня названий заболеваний в ТКМ, зафиксированных в ходе 555 подходящих визитов за рецептами. Проценты рассчитаны с использованием количества подходящих визитов за рецептами в качестве знаменателя. Сохраненные исходные метки и пояснительные глоссы не подразумевают эквивалентности современным биомедицинским диагнозам.
| Ранг | Элемент синдрома | Визиты с назначением | Подходящие визиты | Процент визитов |
| 1 | селезенка | 362 | 555 | 65.23% |
| 2 | печень | 304 | 555 | 54.77% |
| 3 | дефицит ци | 295 | 555 | 53.15% |
| 4 | желудок | 171 | 555 | 30.81% |
| 5 | сырость | 151 | 555 | 27.21% |
| 6 | застой ци | 109 | 555 | 19.64% |
| 7 | жар | 97 | 555 | 17.48% |
| 8 | задержка жидкости | 94 | 555 | 16.94% |
| 9 | Кровь | 87 | 555 | 15.68% |
| 10 | стаз крови | 58 | 555 | 10.45% |
| 11 | каналы | 57 | 555 | 10.27% |
| 12 | почки | 43 | 555 | 7.75% |
| 13 | сердце | 37 | 555 | 6.67% |
| 14 | дефицит инь | 34 | 555 | 6.13% |
Таблица 4: Основные нормализованные элементы синдрома. Элементы синдрома были извлечены из явного текста нормализованного синдрома и дедуплицированы для каждого визита с выпиской рецепта. Подсчеты основаны на знаменателе из 555 подходящих визитов с выпиской рецепта; проценты не являются взаимоисключающими, так как в рамках одного визита может присутствовать несколько элементов синдрома.
| Объединенное наименование травы | Количество | Процент визитов |
| Bai Shao | 531 | 95.7 |
| Fu Ling | 520 | 93.7 |
| Dang Gui | 510 | 91.9 |
| Chi Shao | 467 | 84.1 |
| Обжаренный Bai Zhu | 361 | 65 |
| Обработанный уксусом E Zhu | 307 | 55.3 |
| Tai Zi Shen | 284 | 51.2 |
| Dan Shen | 282 | 50.8 |
| Gan Cao | 278 | 50.1 |
| Huang Lian | 199 | 35.9 |
| Sheng Huang Qi | 176 | 31.7 |
| Mu Xiang | 176 | 31.7 |
| Chai Hu | 144 | 25.9 |
| Обработанный уксусом Ji Nei Jin | 142 | 25.6 |
| Mu Dan Pi | 137 | 24.7 |
| Sheng Di Huang | 131 | 23.6 |
| Обжаренный с медом Gan Cao | 129 | 23.2 |
| Fa Ban Xia | 119 | 21.4 |
| Chuan Xiong | 113 | 20.4 |
| Обработанный имбирем Hou Po | 106 | 19.1 |
| Yin Chen | 104 | 18.7 |
| Sheng Bai Zhu | 97 | 17.5 |
| Dou Kou | 96 | 17.3 |
| Sheng Long Gu | 92 | 16.6 |
| Zhe Bei Mu | 90 | 16.2 |
| Huang Qin | 88 | 15.9 |
| Dang Shen | 85 | 15.3 |
| Обработанный уксусом Bie Jia | 83 | 15 |
| Gui Zhi | 83 | 15 |
| Sheng Mu Li | 81 | 14.6 |
| Jiao Zhi Zi | 74 | 13.3 |
| He Huan Hua | 69 | 12.4 |
| Обработанный вином Huang Jing | 66 | 11.9 |
| Chen Pi | 64 | 11.5 |
| Ze Xie | 63 | 11.4 |
| Jin Qian Cao | 61 | 11 |
Таблица 5: Ведущие нормализованные названия трав по частоте назначения за визит. Каждое нормализованное название травы учитывалось не более одного раза за один визит с назначением. Подсчеты и проценты рассчитаны с использованием 555 соответствующих критериям визитов с назначениями в качестве знаменателя; клинически значимые формы обработки сохранены в качестве отдельных наименований.
| Ранг | Ключевое слово из истории болезни | Визиты с назначением | Применимые визиты | Процент визитов |
| 1 | Сухость в горле | 178 | 555 | 32.07% |
| 2 | Усталость | 151 | 555 | 27.21% |
| 3 | Плохой сон | 139 | 555 | 25.05% |
| 4 | Вздутие живота | 115 | 555 | 20.72% |
| 5 | Кислотный рефлюкс | 100 | 555 | 18.02% |
| 6 | Горький вкус | 99 | 555 | 17.84% |
| 7 | Изжога | 90 | 555 | 16.22% |
| 8 | Икота | 87 | 555 | 15.68% |
| 9 | Отрыжка | 87 | 555 | 15.68% |
| 10 | Жидкий стул | 77 | 555 | 13.87% |
| 11 | Диарея | 77 | 555 | 13.87% |
| 12 | Вздутие в эпигастральной области | 76 | 555 | 13.69% |
| 13 | Боль в желудке | 73 | 555 | 13.15% |
| 14 | Легкое пробуждение | 59 | 555 | 10.63% |
| 15 | Головокружение | 54 | 555 | 9.73% |
| 16 | Рвота | 52 | 555 | 9.37% |
| 17 | Тошнота | 52 | 555 | 9.37% |
| 18 | Тупая боль | 51 | 555 | 9.19% |
| 19 | Распирающая боль | 50 | 555 | 9.01% |
| 20 | Плохой аппетит | 44 | 555 | 7.93% |
| 21 | Боль в животе | 43 | 555 | 7.75% |
| 22 | Сдавленность в груди | 27 | 555 | 4.86% |
| 23 | Раздражительность | 26 | 555 | 4.68% |
| 24 | Головная боль | 23 | 555 | 4.14% |
| 25 | Борборигмус | 23 | 555 | 4.14% |
| 26 | Дискомфорт в эпигастральной области | 21 | 555 | 3.78% |
| 27 | Сердцебиение | 19 | 555 | 3.42% |
| 28 | Желтая моча | 18 | 555 | 3.24% |
| 29 | Ощущение инородного тела | 15 | 555 | 2.70% |
| 30 | Колющая боль | 14 | 555 | 2.52% |
| 31 | Запор | 13 | 555 | 2.34% |
| 32 | Сонливость | 12 | 555 | 2.16% |
| 33 | Ощущение инородного тела в глотке | 9 | 555 | 1.62% |
| 34 | Повышенное потоотделение | 8 | 555 | 1.44% |
| 35 | Подреберная боль | 5 | 555 | 0.90% |
| 36 | Тенезмы | 5 | 555 | 0.90% |
| 37 | Сухой стул | 3 | 555 | 0.54% |
Таблица 6: Основные ключевые слова симптомов, извлеченные из анамнеза. Точные понятия симптомов, обнаруженные в деидентифицированном тексте анамнеза. Каждое понятие учитывалось не более одного раза в рамках одного визита за назначением препарата, при этом в рамках одного визита могли встречаться несколько понятий. Количество и проценты рассчитаны с использованием 555 соответствующих критериям визитов за назначением в качестве знаменателя.
| Антецедент | Консеквент | Сопутствующие визиты | Поддержка | Доверие | Lift (подъем) |
| Chi Shao | Fu Ling | 438 | 0.7892 | 0.9379 | 1.0010 |
| Fu Ling | Chi Shao | 438 | 0.7892 | 0.8423 | 1.0010 |
| Обжаренный Bai Zhu | Fu Ling | 350 | 0.6306 | 0.9695 | 1.0348 |
| Обжаренный Bai Zhu | Bai Shao | 348 | 0.6270 | 0.9640 | 1.0076 |
| Обжаренный Bai Zhu | Chi Shao | 320 | 0.5766 | 0.8864 | 1.0535 |
| Tai Zi Shen | Fu Ling | 273 | 0.4919 | 0.9613 | 1.0260 |
| Tai Zi Shen | Bai Shao | 272 | 0.4901 | 0.9577 | 1.0010 |
| Gan Cao | Bai Shao | 271 | 0.4883 | 0.9748 | 1.0189 |
| Gan Cao | Chi Shao | 262 | 0.4721 | 0.9424 | 1.1200 |
| Tai Zi Shen | Chi Shao | 242 | 0.4360 | 0.8521 | 1.0127 |
| Gan Cao | Обжаренный Bai Zhu | 203 | 0.3658 | 0.7302 | 1.1226 |
| Huang Lian | Fu Ling | 187 | 0.3369 | 0.9397 | 1.0029 |
| Huang Lian | Chi Shao | 180 | 0.3243 | 0.9045 | 1.0750 |
| Sheng Huang Qi | Dang Gui | 168 | 0.3027 | 0.9545 | 1.0388 |
| Mu Xiang | Fu Ling | 167 | 0.3009 | 0.9489 | 1.0127 |
Таблица 7: Правила направленной ассоциации трав, соответствующие заданным пороговым значениям. Правила были сформированы на основе 555 бинарных строк «назначение-визит» с использованием показателей support ≥ 0.30, confidence ≥ 0.70 и lift > 1.0. В качестве знаменателя для support использовались 555 визитов с назначениями; направление правила сохранено, так как показатель confidence является направленным.
| Наименование травы | Жировой гепатоз (n) | Жировой гепатоз (N) | Жировой гепатоз (%) | Цирроз печени (n) | Цирроз печени (N) | Цирроз печени (%) | Хронический гастрит (n) | Хронический гастрит (N) | Хронический гастрит (%) |
| Bai Shao | 71 | 77 | 92.21% | 44 | 46 | 95.65% | 130 | 133 | 97.74% |
| Dang Gui | 72 | 77 | 93.51% | 42 | 46 | 91.30% | 119 | 133 | 89.47% |
| Dan Shen | 45 | 77 | 58.44% | 44 | 46 | 95.65% | 43 | 133 | 32.33% |
| Fu Ling | 70 | 77 | 90.91% | 43 | 46 | 93.48% | 126 | 133 | 94.74% |
| E Zhu (обработанный уксусом) | 57 | 77 | 74.03% | 40 | 46 | 86.96% | 61 | 133 | 45.86% |
| Bie Jia (обработанный уксусом) | 6 | 77 | 7.79% | 39 | 46 | 84.78% | 4 | 133 | 3.01% |
| Bai Zhu (обжаренный) | 57 | 77 | 74.03% | 33 | 46 | 71.74% | 76 | 133 | 57.14% |
| Chi Shao | 69 | 77 | 89.61% | 32 | 46 | 69.57% | 121 | 133 | 90.98% |
| Huang Lian | 23 | 77 | 29.87% | 7 | 46 | 15.22% | 59 | 133 | 44.36% |
| Mu Xiang | 20 | 77 | 25.97% | 13 | 46 | 28.26% | 46 | 133 | 34.59% |
| Yin Chen | 32 | 77 | 41.56% | 13 | 46 | 28.26% | 10 | 133 | 7.52% |
| Sheng Huang Qi | 23 | 77 | 29.87% | 28 | 46 | 60.87% | 21 | 133 | 15.79% |
| Gan Cao | 45 | 77 | 58.44% | 18 | 46 | 39.13% | 77 | 133 | 57.89% |
| Chai Hu | 12 | 77 | 15.58% | 3 | 46 | 6.52% | 48 | 133 | 36.09% |
| Huang Qin | 16 | 77 | 20.78% | 4 | 46 | 8.70% | 25 | 133 | 18.80% |
| Ze Xie | 24 | 77 | 31.17% | 9 | 46 | 19.57% | 7 | 133 | 5.26% |
Таблица 8: Распространенность использования лекарственных трав в зависимости от диагноза. Числители, знаменатели и распространенность на уровне визитов для 16 нормализованных названий трав при жировой болезни печени (n = 77), циррозе печени (n = 46) и хроническом гастрите (n = 133). Каждое название травы учитывалось не более одного раза за один соответствующий визит с назначением.
Дополнительная таблица 1: Запись о прозрачности и аудите с применением ИИ. Документация, разграничивающая запись исходного анализа и проверку согласованности на этапе пересмотра, проведенную 21 августа 2026 года. В таблице зафиксированы инструмент/модель/версия, объем входных данных, цель, выявленное несоответствие кардинальности Four-Qi, исправления, внесенные человеком, ограничения использования, сведения о рецензенте, решение и шаблон промпта. В систему ИИ не передавались необработанные данные по отдельным пациентам. Пожалуйста, нажмите здесь, чтобы скачать этот файл.
Дополнительная таблица 2: Результаты проверки качества исходных данных. Приведены данные о полноте восстановленных полей, результатах аудита, аналитических действиях и статусах выпуска для исходных клинических полей и унаследованных аналитических структур. В таблице задокументировано исключение не согласованных унаследованных индикаторов синдромов, корректировка более ранних общих показателей содержания трав, отсутствие восстановимых векторов распределения до очистки для оценки стабильности между версиями, а также величины, которые не удалось восстановить. Пожалуйста, нажмите здесь, чтобы скачать этот файл.
Дополнительная таблица 3: Сопоставление номенклатуры лекарственных трав. Контролируемые отображаемые метки трав связаны с квалификаторами обработки, стандартными названиями китайского лекарственного сырья (CMM), исходной терминологией, ботаническими, зоологическими или минеральными источниками, версиями справочников, указателями доказательств и границами доказательств. Метки, специфичные для обработки, сохранены там, где они имеют клиническое значение. Пожалуйста, нажмите здесь, чтобы скачать этот файл.
Дополнительная таблица 4: Анализ чувствительности пороговых значений и повторных визитов. Представлены данные по возмущениям порогов правил ассоциации, сравнению наборов правил при условии одного визита на пациента, метрики чувствительности Chi Shao > Fu Ling и сравнение расстояний входных данных для кластеризации 190 пар. Пожалуйста, нажмите здесь, чтобы скачать этот файл.
Дополнительный файл 1: Скрипт для определения детерминированного порога и чувствительности к повторным визитам. Детерминированный скрипт, используемый для воспроизведения совокупных показателей порога и чувствительности к повторным визитам на основе исходного набора данных с фиксированной версией. Файл не содержит данных на уровне пациентов. Пожалуйста, нажмите здесь, чтобы скачать этот файл.
Обсуждение
Основным вкладом данного протокола является создание полного и проверяемого пути от деидентифицированных записей случаев ТКМ до совокупных исследовательских данных. Наиболее важными этапами являются: фиксация правила идентификации когорты до анализа результатов, разграничение уникальных пациентов и визитов за назначением препаратов, сохранение каждого сопоставления оригинального термина с нормализованным, а также проверка каждого числителя и знаменателя перед визуализацией. Эти меры контроля превращают очистку данных из невидимой предварительной деятельности в документированный компонент метода. Они также приводят рабочий процесс в соответствие со стандартами RECORD, STROBE, FAIR и установленными принципами контроля качества данных ЭМК11,12,13,14,15. Результат считается готовым к публикации только тогда, когда его исходное поле, единица анализа, версия словаря, правило расчета, знаменатель, таблица, рисунок и решение рецензента могут быть отслежены в реестре доказательств.
Данный метод является инновационным, поскольку управление, терминологический инжиниринг, вычисления, визуализация и клинический обзор интегрированы, а не рассматриваются как отдельные задачи. Единая явная матрица синдромов позволяет генерировать спектр частот, сеть совместной встречаемости и тепловую карту. Единая матрица «визит с рецептом — лекарственное растение» служит основой для сводок по частоте, направленных правил ассоциации и иерархической кластеризации19,20,21. Единая таблица, стратифицированная по диагнозам, используется как для расчета точных процентных показателей, так и для построения итоговой тепловой карты. Аналитический рабочий процесс основан на скриптовых воспроизводимых инструментах с открытым исходным кодом36,37,38,39,40, что позволяет любым исправлениям в исходном словаре или решениям по когорте распространяться на все зависимые выходные данные. Предыдущие работы с хранилищами клинических данных также демонстрируют важность предобработки с привязкой к источнику и повторного использования структурированных данных41,42. Такая архитектура сокращает объем ручного переписывания данных, поддерживает согласованность между графическим кодированием и исходными таблицами, а также облегчает аудит, обучение и передачу методов другим исследовательским группам.
Три недавних исследования по анализу баз данных предлагают полезные принципы построения, хотя единицей анализа в них является публикация, а не клинический визит. Исследование ревматоидного артрита и депрессии сочетает в себе заранее определенную стратегию поиска с анализом по странам, учреждениям, авторам, журналам, ключевым словам и временным интервалам26. В исследовании язвенного колита и ингибиторов Янус-киназ используются скоординированный анализ сотрудничества, коцитирования, кластеризации и анализа всплесков (burst analysis) для разграничения устойчивых тем и новых фронтов исследований27. Исследование ревматоидного артрита и фибромиалгии расширяет библиометрическое картирование за счет биоинформатики, сохраняя при этом различие между двумя уровнями доказательств28. Настоящий протокол применяет тот же принцип скоординированных, но не взаимозаменяемых аналитических ракурсов. Перенос метода в гинекологию, респираторную медицину, ревматологию или другую специальность требует реконструкции специфических для данной области полей, словарей терминологии, правил включения и исключения, показателей исхода и процедур клинического обзора перед повторным использованием набора правил. Спектры заболеваний, сети синдромов, ключевые слова симптомов, правила ассоциации, кластеризация и паттерны, стратифицированные по диагнозу, основаны на источниках с фиксированной версией, однако каждый из этих элементов отвечает на отдельный вопрос и имеет свой собственный знаменатель и границу интерпретации.
ИИ под контролем человека может обеспечить дополнительный уровень контроля качества, если его использование ограничено утвержденными деидентифицированными выдержками или агрегированными материалами. В рамках данного рабочего процесса ИИ может сравнивать терминологию в разных файлах, отмечать несоответствия между подписями и таблицами, выявлять метки, выходящие за границы рисунка, проверять наличие допустимого ребра у каждого отображаемого узла сети и предлагать более четкие формулировки. ИИ не определяет соответствие когорты критериям включения, не придумывает сопоставления терминов, не делает выводов об эффектах лечения и не заменяет анализ исходных данных. Такое разделение обязанностей согласуется с более широким представлением о том, что медицинский ИИ должен дополнять человеческие суждения, а не скрывать ответственность33. Это также отражает акцент DECIDE-AI на прозрачности человеческого фактора, обработке ошибок и подотчетной оценке34. Следовательно, при использовании помощи ИИ в журнале аудита должны сохраняться цель каждого промпта, проверенный результат, принятое исправление, данные о рецензенте и дата.
Поиск и устранение неисправностей особенно важны в случаях, когда результат кажется клинически правдоподобным, но не проходит проверку на соответствие исходным данным. В таких ситуациях следует приостановить последующую интерпретацию до тех пор, пока причина расхождения не будет отслежена до этапа определения соответствия критериям включения, дедупликации, сопоставления терминологии, выбора полей, выбора знаменателя или сборки графических данных. После исправления все зависимые результаты должны быть перегенерированы. Рассматриваемый пример представляет собой набор данных одного центра, полученный ретроспективно из экспертной амбулаторной практики, в котором повторные визиты не являются независимыми друг от друга. Анализ чувствительности с учетом одного визита на одного пациента позволил сократить набор сохраненных правил с 15 до 12, сохранив при этом присутствие всех 20 основных лекарственных трав. Для всех 190 неупорядоченных пар среди этих 20 общих переменных корреляция Пирсона составила 0,9944, коэффициент корреляции Спирмена (rho) — 0,9836, среднее абсолютное изменение расстояния Жаккара составило 0,0146, а максимальное изменение — 0,0528 (Дополнительная таблица 4). Соответственно, высокая поддержка на уровне визитов не должна интерпретироваться как валидация на уровне пациентов. Спектр «история-ключевое слово» отражает буквальную документацию, а не валидированную шкалу симптомов. Сводки Materia Medica взвешены по частоте случаев, а не по дозировке. Правила ассоциации описывают совместную регистрацию, а не причинно-следственную связь. Тепловые карты, стратифицированные по диагнозам, носят описательный характер и не устанавливают сравнительную эффективность, специфичность заболевания или необходимость лечения.
Данный протокол может быть применен в исследованиях наследования экспертного клинического опыта, описания когорт специализированных амбулаторных пациентов, многоцентровой гармонизации терминологии, обзора качества документации, отбора переменных для проспективных регистров и подготовки агрегированных наборов данных для совместной работы с соблюдением конфиденциальности. В будущих работах могут быть внедрены проспективный структурированный сбор симптомов, модели с кластеризацией пациентов, явные переменные дозировки, заранее определенные сравнительные гипотезы, внешняя валидация, версионные сервисы терминологии, вычисления с сохранением конфиденциальности и интерактивные реестры доказательств. Обработка естественного языка и проверка с помощью ИИ могут дополнительно сократить объем повторяющейся курации при условии управления с помощью зафиксированных версий правил и верификации человеком. В более широком смысле, протокол позволяет преобразовать рассредоточенный клинический опыт в прозрачный объект исследования, который можно проверять, воспроизводить, подвергать сомнению и расширять. Этот метод не превращает частоту в эффективность; напротив, он переводит недокументированные аналитические решения в видимые доказательства, закладывая основу для более строгих клинических вопросов и более устойчивых реальных исследований в области TCM.
Раскрытие информации
Авторы заявляют об отсутствии конфликта интересов.
Благодарности
OpenAI Codex (gpt-5.6-luna и gpt-5.6-sol) использовался исключительно в процессе доработки рукописи для проверки согласованности данных между файлами на агрегированном уровне и получения рекомендаций по формулировкам. Записи на уровне отдельных пациентов в систему ИИ не предоставлялись. Все результаты, полученные с помощью ИИ, были независимо проверены Тянь Ся (Tian Xia) на основе исходных материалов 21 августа 2026 года. Авторы изучили и утвердили окончательное содержание и несут полную ответственность за рукопись. Данный проект был поддержан Национальной ключевой программой исследований и разработок Китая, Ключевым специальным проектом по модернизации традиционной китайской медицины (№ 2025YFC3512800); Национальным крупным научно-техническим проектом Китая (проект № 2026ZD0554100; подпроект № 2026ZD0554101); Центральным проектом по повышению потенциала клинических исследований и внедрения достижений в высокоуровневых больницах традиционной китайской медицины, Специальным проектом по сохранению академического опыта выдающихся старших экспертов по традиционной китайской медицине (№ HLCMHPP2023016); и Фондом естественных наук Синьцзян-Уйгурского автономного района (№ 2025D01C213).
Материалы
| Имя | Компания | Каталожный номер | Комментарии |
|---|---|---|---|
| Таблицы повторного анализа совокупных данных | Локальные файлы, созданные автором | Неприменимо | Использовались для подсчета совокупных данных, создания таблиц и рисунков. |
| Экспорт обезличенных записей амбулаторных случаев | Институциональная система электронных медицинских карт | Неприменимо | Использовались только в контролируемой институциональной среде; записи на уровне пациентов не являются материалами для подачи. |
| lxml | lxml project | 6.1.1 | Версия программного обеспечения, использованная для сериализации с сохранением пространств имен при повторной генерации на этапе пересмотра; не является исторической версией первоначального анализа. |
| Matplotlib | Matplotlib project (matplotlib.org) | 3.11.1 | Версия, зафиксированная в среде повторной генерации на этапе пересмотра и в метаданных SVG Рисунка 3; не является исторической версией первоначального анализа. |
| NetworkX | NetworkX project | PyPI package: networkx | Зафиксирован идентификатор пакета; точная версия на этапе пересмотра не была подтверждена в унаследованной среде. |
| NumPy | NumPy project | 2.3.5 | Версия программного обеспечения, использованная для повторной генерации пересмотренных совокупных результатов; не является исторической версией первоначального анализа. |
| openpyxl | openpyxl project | 3.1.5 | Версия программного обеспечения, использованная для записи пересмотренных совокупных выходных данных в формате XLSX; не является исторической версией первоначального анализа. |
| pandas | pandas project | 3.0.1 | Версия программного обеспечения, использованная для повторной генерации пересмотренных совокупных результатов; не является исторической версией первоначального анализа. |
| PyMuPDF | PyMuPDF project | 1.28.2 | Версия программного обеспечения, использованная для повторной генерации пересмотренных рисунков на этапе пересмотра; не является исторической версией первоначального анализа. |
| Python | Python Software Foundation | 3.13.15 | Версия программного обеспечения, использованная для повторной генерации пересмотренных совокупных результатов; не является исторической версией первоначального анализа. |
| SciPy | SciPy project | PyPI package: scipy | Зафиксирован идентификатор пакета; точная версия на этапе пересмотра не была подтверждена в унаследованной среде. |
Ссылки
- Wang YH, et al. Study on knowledge discovery in traditional Chinese medical case records [in Chinese]. Zhong Xi Yi Jie He Xue Bao. 2007;5(4):368-372.
- Wang Y, et al. Automatic symptom name normalization in clinical records of traditional Chinese medicine. BMC Bioinformatics. 2010;11:40.
- Zhou L, et al. Natural language processing algorithms for normalizing expressions of synonymous symptoms in traditional Chinese medicine. Evid Based Complement Alternat Med. 2021;2021:6676607.
- Chu X, et al. Quantitative knowledge presentation models of traditional Chinese medicine (TCM): a review. Artif Intell Med. 2020;103:101810.
- Zhang T, et al. Constructing fine-grained entity recognition corpora based on clinical records of traditional Chinese medicine. BMC Med Inform Decis Mak. 2020;20:64.
- Wang Q, et al. A study of entity-linking methods for normalizing Chinese diagnosis and procedure terms to ICD codes. J Biomed Inform. 2020;105:103418.
- Zhang H, et al. Transformer- and generative adversarial network-based inpatient traditional Chinese medicine prescription recommendation: development study. JMIR Med Inform. 2022;10(5):e35239.
- Dan W, et al. SinoMedminer: an R package and Shiny application for mining and visualizing traditional Chinese medicine herbal formulas. Chin Med. 2025;20:80.
- Chinese Pharmacopoeia Commission. Pharmacopoeia of the People's Republic of China. 2025 ed. China Medical Science and Technology Press; Beijing; 2025.
- Editorial Committee of Zhonghua Bencao, State Administration of Traditional Chinese Medicine. Zhonghua Bencao. 10 vols. Shanghai Scientific and Technical Publishers; Shanghai; 1999. ISBN: 7532351068. Available from: National Diet Library record
- Benchimol EI, et al. The REporting of studies Conducted using Observational Routinely-collected health Data (RECORD) statement. PLoS Med. 2015;12(10):e1001885.
- von Elm E, et al. The Strengthening the Reporting of Observational Studies in Epidemiology (STROBE) statement: guidelines for reporting observational studies. Lancet. 2007;370(9596):1453-1457.
- Wilkinson MD, et al. The FAIR Guiding Principles for scientific data management and stewardship. Sci Data. 2016;3:160018.
- Weiskopf NG, Weng C. Methods and dimensions of electronic health record data quality assessment: enabling reuse for clinical research. J Am Med Inform Assoc. 2013;20(1):144-151.
- Kahn MG, et al. A harmonized data quality assessment terminology and framework for the secondary use of electronic health record data. EGEMS (Wash DC). 2016;4(1):18.
- Kovačević A, Bašaragin B, Milošević N, Nenadić G. De-identification of clinical free text using natural language processing: a systematic review of current approaches. Artif Intell Med. 2024;151:102845.
- Meystre SM, et al. Text de-identification for privacy protection: a study of its impact on clinical text information content. J Biomed Inform. 2014;50:142-150.
- Neamatullah I, et al. Automated de-identification of free-text medical records. BMC Med Inform Decis Mak. 2008;8:32.
- Agrawal R, Srikant R. Fast algorithms for mining association rules in large databases. Presented at: 20th International Conference on Very Large Data Bases; Santiago, Chile; 1994. p. 487-499.
- Hahsler M, Grün B, Hornik K. arules: a computational environment for mining association rules and frequent item sets. J Stat Softw. 2005;14(15):1-25.
- Murtagh F, Contreras P. Algorithms for hierarchical clustering: an overview. WIREs Data Min Knowl Discov. 2012;2(1):86-97.
- van Eck NJ, Waltman L. Software survey: VOSviewer, a computer program for bibliometric mapping. Scientometrics. 2010;84(2):523-538.
- Chen C. CiteSpace II: detecting and visualizing emerging trends and transient patterns in scientific literature. J Am Soc Inf Sci Technol. 2006;57(3):359-377.
- Aria M, Cuccurullo C. bibliometrix: an R-tool for comprehensive science mapping analysis. J Informetr. 2017;11(4):959-975.
- Donthu N, et al. How to conduct a bibliometric analysis: an overview and guidelines. J Bus Res. 2021;133:285-296.
- Zhao Y, Chen GY, Fang M. Research trends of rheumatoid arthritis and depression from 2019 to 2023: a bibliometric analysis. J Multidiscip Healthc. 2024;17:4465-4474.
- Wang Y, et al. Research trends and hotspots in JAK inhibitors for ulcerative colitis: a bibliometric analysis from 2015 to 2024. J Multidiscip Healthc. 2025;18:6755-6771.
- Chen G, Yan Z, Wang Y, Tao Q. Rheumatoid arthritis and fibromyalgia syndrome: a bibliometric and bioinformatics perspective on comorbidity research. J Multidiscip Healthc. 2025;18:6811-6827.
- Wang SL, et al. Yao Naili's experience in applying the harmonizing liver and spleen method. Journal of Traditional Chinese Medicine. 2008;49(7):596-597.
- Wang L, et al. Analysis of Professor Naili Yao's experience in treating spleen-stomach diseases [in Chinese]. Lishizhen Med Mater Med Res. 2022;33(6):1436-1438.
- Sandve GK, Nekrutenko A, Taylor J, Hovig E. Ten simple rules for reproducible computational research. PLoS Comput Biol. 2013;9(10):e1003285.
- Munafò MR, et al. A manifesto for reproducible science. Nat Hum Behav. 2017;1:0021.
- Topol EJ. High-performance medicine: the convergence of human and artificial intelligence. Nat Med. 2019;25(1):44-56.
- Vasey B, et al. Reporting guideline for the early-stage clinical evaluation of decision support systems driven by artificial intelligence: DECIDE-AI. Nat Med. 2022;28(5):924-933.
- Branch of Gastrointestinal Diseases, China Association of Chinese Medicine. Expert consensus on traditional Chinese medicine diagnosis and treatment of Gan pi (2023). Chinese Journal of Integrative Digestive Diseases. 2024;32(9):741-747.
- McKinney W. Data structures for statistical computing in Python [conference paper]. Presented at: 9th Python in Science Conference; Austin, TX; 2010. p. 56-61. doi:10.25080/Majora-92bf1922-00a.
- Harris CR, et al. Array programming with NumPy. Nature. 2020;585(7825):357-362.
- Virtanen P, et al. SciPy 1.0: fundamental algorithms for scientific computing in Python. Nat Methods. 2020;17(3):261-272.
- Hunter JD. Matplotlib: a 2D graphics environment. Comput Sci Eng. 2007;9(3):90-95.
- Hagberg AA, Schult DA, Swart PJ. Exploring network structure, dynamics, and function using NetworkX. Presented at: 7th Python in Science Conference; Pasadena, CA; 2008. p. 11-15. doi:10.25080/TCWV9851.
- Zhou X, et al. Development of traditional Chinese medicine clinical data warehouse for medical knowledge discovery and decision support. Artif Intell Med. 2010;48(2-3):139-152.
- Liu B, et al. Data processing and analysis in real-world traditional Chinese medicine clinical data: challenges and approaches. Stat Med. 2012;31(7):653-660.