В данном протоколе представлен воспроизводимый рабочий процесс разработки, оценки и интерпретации моделей объяснимого искусственного интеллекта в здравоохранении. Он объединяет стандартизированную подготовку данных, разработку моделей, методы обеспечения объяснимости, количественную оценку и практику обеспечения воспроизводимости для повышения прозрачности, надежности и клинической применимости.
Методическая статья
Воспроизводимый экспериментальный протокол разработки и оценки моделей объяснимого искусственного интеллекта в системах здравоохранения
В этой статье
Краткое содержание
Аннотация
Искусственный интеллект (И) все чаще внедряется в качестве ценного инструмента для принятия клинических решений, прогнозирования заболеваний, медицинской диагностики и персонализированного здравоохранения. Однако отсутствие прозрачности, непоследовательное применение методов объяснимого искусственного интеллекта (XAI) и ограниченная воспроизводимость остаются серьезными препятствиями для надежного развертывания моделей ИИ в клинических условиях. В данной работе предлагается систематический, воспроизводимый и прозрачный протокол разработки, оценки и интерпретации объяснимых моделей ИИ для применения в здравоохранении. Рабочий процесс начинается с настройки вычислительной среды, за которой следуют сбор и характеристика данных, предобработка, конструирование признаков, разработка модели, оптимизация гиперпараметров, оценка прогностической эффективности, анализ объяснимости, статистическая валидация и оценка воспроизводимости. Протокол включает методы XAI, такие как SHapley Additive exPlanations (SHAP), Local Interpretable Model-agnostic Explanations (LIME), Gradient-weighted Class Activation Mapping (Grad-CAM), интегрированные градиенты, визуализация внимания и контрфактуальные объяснения для создания как глобальных, так и локальных интерпретаций модели. В протоколе особое внимание уделяется нескольким ключевым компонентам, включая подготовку стандартизированных наборов данных здравоохранения, разработку стабильных моделей машинного обучения, оценку прогностической эффективности, создание клинически значимых объяснений и статистическую оценку воспроизводимости в повторяющихся экспериментах. Интегрируя разработку модели, объяснимость, количественную и качественную оценку, статистическую валидацию и анализ воспроизводимости в единый рабочий процесс, данный протокол предоставляет комплексную основу для создания прозрачных и воспроизводимых моделей ИИ для применения в сфере здравоохранения.
Введение
И стал неотъемлемым компонентом современного здравоохранения, обеспечивая интеллектуальный анализ сложных клинических данных и поддерживая принятие обоснованных медицинских решений1. Стремительная цифровизация здравоохранения за счет электронных медицинских карт, систем медицинской визуализации, носимых устройств и геномных технологий привела к созданию огромных объемов гетерогенных данных, которые требуют передовых вычислительных подходов для эффективной интерпретации2.
Алгоритмы машинного обучения (ML) и глубокого обучения (DL) продемонстрировали выдающиеся возможности в извлечении значимых закономерностей из многомерных наборов данных здравоохранения, что позволило повысить точность диагностики, прогнозирование заболеваний и оценку исходов лечения пациентов3. Модели на базе ИИ были успешно применены в радиологии, патологии, кардиологии, онкологии, офтальмологии и других медицинских специальностях для помощи клиницистам в выявлении заболеваний на более ранних стадиях и рекомендации персонализированных стратегий лечения4. Эти технологии также способствовали оптимизации рабочих процессов, снижению вариабельности диагностики и улучшению использования ресурсов здравоохранения5.
Последние достижения в области компьютерного оборудования, облачных вычислений и AI-фреймворков с открытым исходным кодом ускорили разработку и внедрение интеллектуальных приложений для здравоохранения6. В результате искусственный интеллект (И) стал ключевой технологией, обеспечивающей развитие прецизионной медицины и систем поддержки принятия клинических решений7. Несмотря на эти успехи, широкое внедрение ИИ в повседневную клиническую практику остается ограниченным, поскольку многие высокоэффективные модели практически не дают представления о том, как формируются их прогнозы8.
Большинство алгоритмов глубокого обучения функционируют как сложные модели «черного ящика», внутренний процесс принятия решений в которых трудно понять клиницистам и исследователям9. Хотя эти модели часто демонстрируют отличные прогностические показатели, отсутствие прозрачности подрывает доверие пользователей и создает трудности для клинической валидации, получения разрешений от регулирующих органов и обеспечения безопасности пациентов10. Специалисты здравоохранения должны иметь возможность обосновать решения, принятые с помощью ИИ, прежде чем внедрять их в рутинную клиническую практику, особенно в медицинских условиях с высоким уровнем риска1.
XAI стал эффективным подходом к повышению прозрачности и интерпретируемости моделей машинного обучения12. Вместо того чтобы рассматривать прогностические модели как «черные ящики», методы XAI предоставляют информацию о признаках, областях изображения или клинических переменных, которые влияют на конкретные прогнозы13. Такие объяснения позволяют клиницистам лучше понять поведение модели, выявить потенциальные систематические ошибки и определить, соответствуют ли решения, созданные ИИ, установленным медицинским знаниям14.
Для применения в сфере здравоохранения было предложено несколько методов обеспечения интерпретируемости. Метод SHapley Additive explanations (SHAP) оценивает вклад каждого признака в прогноз модели на основе теории кооперативных игр15. Метод Local Interpretable Model-agnostic Explanations (LIME) создает упрощенную модель для объяснения прогнозов «черного ящика»16. Для задач анализа медицинских изображений с использованием моделей глубокого обучения применяется метод Gradient-weighted activation maps (Grad-CAM), который создает тепловые карты, визуально указывающие области изображения, повлиявшие на решение о классификации17. Комбинация этих методов значительно повысила прозрачность систем ИИ в различных областях здравоохранения18.
Несмотря на растущее внимание к методам объяснимости в сфере здравоохранения, их применение в литературе остается неоднородным. Исследователи расходятся не только в выборе стратегий предварительной обработки данных, но и в проектировании архитектуры моделей, метриках оценки и даже в самих методах интерпретации19. Кроме того, во многих работах сообщается о высокой прогностической точности, однако отсутствует тщательная оценка качества объяснений или их воспроизводимости20.
Воспроизводимость является одним из основных препятствий в современной науке об искусственном интеллекте (И). В публикациях часто не указываются версия программного обеспечения, вычислительная среда, конвейер предобработки данных, настройки гиперпараметров, инициализация случайного числа (random seed) и конфигурации оборудования21. Из-за этого независимые исследователи часто не могут воспроизвести опубликованные результаты или проверить описанные методы, используя другие наборы данных или программные платформы2. Отсутствие детальной документации является одним из факторов, затрудняющих проведение сравнительного анализа (бенчмаркинга), совместные исследования и клиническое внедрение систем ИИ23.
Признавая эти проблемы, ряд организаций и регулирующих органов подчеркнули важность прозрачного, надежного и воспроизводимого ИИ для применения в здравоохранении24. Существующие рекомендации по отчетности улучшили методологическое описание, но в основном они описывают то, что должно быть отражено в отчете, а не предоставляют стандартизированные экспериментальные процедуры, которые исследователи могли бы внедрить напрямую25. Следовательно, сохраняется потребность в комплексном протоколе, который объединял бы подготовку наборов данных, разработку модели, анализ объяснимости, статистическую оценку и методы обеспечения воспроизводимости в единый экспериментальный рабочий процесс26.
Стандартизированный экспериментальный протокол дает несколько преимуществ сообществу специалистов по ИИ в здравоохранении. Кроме того, он способствует методологической последовательности, облегчает сравнение независимых исследований, повышает прозрачность вычислительных экспериментов и обеспечивает надежную валидацию опубликованных результатов27. Стандартизированные рабочие процессы также помогают в обучении, проведении совместных исследований и нормативной оценке благодаря четко документированным процедурам, которые воспроизводимы в различных лабораториях и медицинских учреждениях28.
Был разработан и протестирован воспроизводимый экспериментальный протокол для обучения и оценки моделей ИИ в системах здравоохранения. Протокол определяет стандарты настройки вычислительной среды, предварительной обработки наборов данных здравоохранения, разработки моделей машинного обучения, применения методов XAI, оценки прогностической эффективности, проведения статистической валидации и оценки воспроизводимости29. Интеграция таких компонентов в единый рабочий процесс, вероятно, повысит прозрачность, надежность и воспроизводимость исследований ИИ в здравоохранении, а также поможет в разработке доверенных интеллектуальных систем здравоохранения30.
Протокол
Для проведения эксперимента по валидации использовался общедоступный деидентифицированный набор данных Pima Indians Diabetes Dataset; исследование не затрагивало идентифицируемые записи пациентов и не требовало набора новых участников. Таким образом, информированное согласие и одобрение институционального IRB/этического комитета не требовались, а весь анализ проводился в соответствии с условиями использования набора данных и правилами проведения исследований данного учреждения.
В приведенном примере валидации используется общедоступный набор данных Pima Indians Diabetes Dataset, содержащий 768 записей для бинарного прогнозирования диабета. К этому набору данных был применен полный девятиэтапный основной рабочий процесс. Девять основных этапов включали выбор и валидацию набора данных, настройку вычислительной среды, предварительную обработку данных, разделение набора данных, разработку и обучение модели, оценку прогностической и вычислительной эффективности, анализ интерпретируемости, статистическую валидацию и оценку воспроизводимости. Внешняя валидация и экспертная клиническая оценка были оставлены в качестве дополнительных модулей валидации и не проводились в данном примере. На Рисунке 1 представлена схема основного протокола, а в Таблице 1 обобщены только девять основных этапов, реализованных в данной валидации; дополнительные внешняя валидация и экспертная клиническая оценка описаны в Протоколе отдельно и не включены в девять экспериментальных этапов.
1. Выбор и валидация набора данных здравоохранения
- Выберите набор данных Pima Indians Diabetes Dataset в качестве основного набора данных для практического примера валидации. Проверьте источник набора данных, размер выборки, целевую переменную прогнозирования, распределение классов и структуру данных.
- Примените предопределенные критерии включения, исключения и качества данных. Удалите дубликаты и недостоверные записи перед разработкой модели.
- Запишите источник набора данных, его характеристики, задачу прогнозирования, распределение классов, критерии включения и исключения, а также стратегию разделения данных в Таблице 2.
- Примените критерии принятия решений для выбора набора данных и модели:
- Определите цель прогнозирования перед выбором набора данных, архитектуры модели, стратегии предобработки или метода интерпретируемости.
- Приведите модальность набора данных в соответствие с целью прогнозирования. Выберите табличные данные для структурированных клинических переменных, данные визуализации для медицинских изображений, временные ряды для физиологических сигналов, текстовые данные для клинических описаний или мультимодальные данные, если для одного и того же пациента или объекта исследования доступны дополняющие друг друга модальности.
- Оцените потенциальные наборы данных по размеру выборки, доступности результатов, распределению классов, количеству пропусков, качеству аннотаций, клинической значимости, полноте данных и доступности. Выберите набор данных, который удовлетворяет предопределенным требованиям.
- Используйте традиционные модели машинного обучения для структурированных табличных данных, если размер выборки, вычислительные ресурсы или требования к интерпретируемости ограничивают использование сложных архитектур. Выбирайте архитектуры глубокого обучения при наличии достаточного объема обучающих данных и многомерных входных данных, таких как медицинские изображения, физиологические сигналы или клинические тексты.
- Выбирайте мультимодальные архитектуры только в том случае, если для одного и того же пациента или объекта исследования доступны несколько модальностей и они могут быть надежно сопоставлены без риска утечки данных. Выберите операции предобработки в соответствии с характеристиками выбранной модальности данных.
- Выберите методы интерпретируемости в соответствии с моделью и модальностью данных. Используйте модельно-независимые методы, такие как SHAP или LIME, для соответствующих табличных моделей, и специфичные для конкретной модальности методы, такие как Grad-CAM, для моделей на основе изображений, где это применимо.
- Документируйте обоснование выбора набора данных, стратегии предобработки, модели и метода интерпретируемости. Сохраните эти решения как часть протокола воспроизводимости.
2. Настройка вычислительной среды для разработки модели XAI
- Настройте операционную систему, ЦП, ОЗУ, хранилище и ГП в соответствии с требованиями выбранной модели. Создайте изолированную среду Python и установите необходимые библиотеки для машинного обучения, глубокого обучения, статистического анализа, визуализации и XAI.
- Запишите фактическую вычислительную среду, архитектуру модели и гиперпараметры, использованные при проведенной валидации, в Таблице 3. Укажите оптимизатор, скорость обучения, размер пакета, максимальное количество эпох, функцию потерь, параметры регуляризации, стратегию валидации, конфигурацию ранней остановки, конфигурацию случайного числа (random seed), методы интерпретируемости, аппаратное обеспечение, операционную систему, версию Python и версии соответствующих программных библиотек. Отделите эти экспериментально использованные настройки от общих или рекомендуемых настроек протокола.
- Используйте конфигурацию, указанную в Таблице 3, при воспроизведении валидации набора данных Pima Indians Diabetes Dataset и соответствующих результатов прогнозирования, интерпретируемости, статистического анализа и воспроизводимости.
- Запустите скрипт валидации, чтобы подтвердить успешный импорт пакетов, загрузку набора данных, выполнение модели и генерацию выходных данных. Сохраните итоговую конфигурацию среды для обеспечения воспроизводимости.
3. Подготовка и характеристика наборов данных здравоохранения для разработки моделей XAI
- Выбор и получение набора данных здравоохранения
- Выберите набор данных здравоохранения, подходящий для определенной задачи клинического прогнозирования. Оцените подходящие наборы данных в соответствии с целью исследования, типом данных, размером выборки, качеством аннотаций, балансом классов и клинической значимостью.
- Отдавайте предпочтение общедоступным эталонным наборам данных, если они адекватно решают задачу прогнозирования и облегчают независимую валидацию.
- Перед получением институциональных или внутренних наборов данных получите необходимые этические одобрения, разрешения учреждения и авторизацию на доступ к данным. Получите выбранный набор данных из проверенного репозитория или авторизованной институциональной базы данных.
- Сохраните исходные файлы набора данных без изменений и зафиксируйте поставщика данных, версию, информацию о получении, условия лицензирования, критерии включения, критерии исключения и сопроводительные метаданные. Организуйте набор данных по отдельным каталогам для необработанных данных, аннотаций, метаданных и дополнительной информации.
- Характеристика набора данных здравоохранения
- Определите переменные-предикторы, метки исходов, типы признаков, модальности данных и распределение классов. Определите количество субъектов, образцов, размерность признаков и доступные аннотации.
- Подтвердите, что характеристики набора данных совместимы с выбранным методом ИИ.
- Используйте набор данных Pima Indians Diabetes Dataset в качестве единственного рабочего экспериментального набора данных для валидации основного девятиэтапного протокола. Включайте дополнительные наборы данных, перечисленные в Таблице 2, только для демонстрации применимости общего протокола к клиническим табличным данным, электронным медицинским картам, дермоскопическим изображениям, физиологическим временным рядам и медицинским изображениям. Не используйте эти дополнительные наборы данных для обучения моделей, тестирования, статистической валидации или получения представленных экспериментальных результатов.
- Оценка качества набора данных
- Проверьте набор данных на наличие дублирующих записей, поврежденных файлов, пропущенных значений, ошибок аннотирования и некорректных записей данных. Удалите подтвержденные дубликаты и исправьте проверенные нарушения форматирования. Задокументируйте все процедуры контроля качества набора данных.
- При использовании мультимодальных наборов данных проверьте соответствие данных визуализации, клинических, лабораторных и физиологических данных с помощью идентификаторов субъектов.
- Удалите дублирующие или противоречивые записи, обработайте пропущенные значения, стандартизируйте числовые признаки, закодируйте категориальные переменные и примените специфическую для каждой модальности предобработку. Разделите набор данных на независимые обучающую, валидационную и тестовую выборки. См. Рисунок 2 для ознакомления с рабочим процессом подготовки, предобработки, разделения и оценки качества набора данных здравоохранения.
- Обеспечение конфиденциальности данных и этического соответствия
- Удалите прямые идентификаторы из данных здравоохранения. Примените процедуры анонимизации или псевдонимизации, если это необходимо. Обрабатывайте информацию о здоровье пациентов в соответствии с применимыми этическими требованиями, требованиями по защите данных, информированным согласием и институциональными требованиями.
- Зафиксируйте применимое этическое одобрение, отказ от него, процедуры управления данными, методы анонимизации и рабочий процесс подготовки набора данных.
- Оцените потенциальную алгоритмическую предвзятость, сравнивая эффективность модели в соответствующих демографических или клинических подгруппах, если такая информация доступна и этически допустима.
- Задокументируйте целевое использование, целевую популяцию, ограничения модели, потенциальные режимы сбоев, требования к человеческому надзору, а также применимые этические, нормативные требования по защите данных и требования здравоохранения.
- Зафиксируйте выявленные ограничения справедливости и соображения ответственного ИИ в составе итоговой документации модели.
ПРИМЕЧАНИЕ: Получите стандартизированный и задокументированный набор данных здравоохранения, который подходит для разработки модели ИИ, соответствует этическим нормам и не содержит серьезных выявленных противоречий.
4. Предобработка и разделение медицинских данных для обучения модели ИИ
- Проведите контроль качества
- Проверьте набор данных на наличие дубликатов записей, пропущенных значений, некорректных значений, противоречивых меток, выбросов и поврежденных файлов.
- Удалите или исправьте некорректные наблюдения в соответствии с заранее определенными критериями и зафиксируйте все случаи исключения. Проверьте согласованность предикторных переменных и меток результатов.
- Обработайте пропущенные данные
- Количественно оцените объем пропусков для каждой переменной. Примените заранее определенную стратегию импутации или исключения.
- Оцените параметры импутации, используя только обучающую выборку, и примените полученное преобразование к валидационным и тестовым данным.
- Нормализуйте и преобразуйте данные
- Примените масштабирование признаков, нормализацию, кодирование, снижение размерности или другие преобразования, требуемые выбранной моделью. Выполняйте все зависящие от данных преобразования, используя только обучающую выборку.
- Примените полученные преобразования без изменений к валидационным и тестовым данным.
- Количественно оцените дисбаланс классов в обучающей выборке. Примените взвешивание классов, SMOTE, оверсэмплинг или аугментацию только к обучающему набору данных. Сохраните исходное распределение в валидационном и тестовом наборах данных.
- Убедитесь, что ни один субъект, дубликат наблюдения, аугментированный образец, статистика предобработки, критерий отбора признаков или синтетический образец не являются общими для обучающей и оценочных выборок.
5. Разработка и настройка модели XAI
- Определите архитектуру модели, указав модальности входных данных, операции предварительной обработки, кодировщики признаков для каждой модальности, механизм слияния признаков, слой прогнозирования и модуль интерпретируемости.
- Выберите архитектуру машинного или глубокого обучения в соответствии с задачей прогнозирования и модальностью входных данных. Настройте входной слой, компоненты извлечения признаков, скрытые слои, выходной слой и функции активации. Определите оптимизатор, скорость обучения, размер пакета (batch size), функцию потерь, количество эпох, параметры регуляризации, дропаут (dropout), условие ранней остановки и график изменения скорости обучения.
- Оптимизируйте гиперпараметры, используя только обучающую и валидационную выборки.
- Запишите окончательный вариант архитектуры и конфигурацию гиперпараметров в Таблицу 3.
- Проверьте совместимость размерностей входных и выходных данных перед началом обучения.
ПРИМЕЧАНИЕ: Создайте полностью сконфигурированную модель XAI, включающую подходящую архитектуру, определенные гиперпараметры и интегрированные методы обеспечения интерпретируемости.
6. Обучение, оптимизация и сохранение модели XAI
- Загрузите предопределенные обучающий и валидационный наборы данных, а также окончательную конфигурацию модели. Инициализируйте модель, используя заданный случайный seed и параметры обучения.
- Обучите модель, используя указанный оптимизатор, функцию потерь, размер пакета (batch size) и критерии остановки.
- Отслеживайте показатели валидации и сохраните контрольную точку (checkpoint), соответствующую предопределенному критерию выбора модели. Оцените выбранную контрольную точку на независимом тестовом наборе данных без дальнейшей оптимизации.
- Сохраните обученную модель, конфигурацию предобработки, гиперпараметры, случайный seed и лог обучения.
ПРИМЕЧАНИЕ: Получите оптимизированную модель XAI, обученную и валидированную с использованием подготовленного набора данных из сферы здравоохранения. Сохраните наиболее эффективную модель, гиперпараметры, логи обучения, конфигурацию предобработки и вычислительную среду для обеспечения воспроизводимости.
7. Оценка прогностической и вычислительной эффективности
- Оценка прогностической эффективности
- После завершения обучения модели и оптимизации гиперпараметров загрузите оптимизированную модель и независимый тестовый набор данных. Параметры обученной модели и конвейер предобработки должны оставаться неизменными во время тестирования.
- Сгенерируйте прогнозы для всех образцов в тестовом наборе данных. Сравните полученные прогнозы с соответствующими истинными метками.
- Расчет показателей эффективности
- Выберите метрики оценки в соответствии с типом задачи прогнозирования.
- Для задач классификации, по мере необходимости, рассчитайте точность (accuracy), прецизионность (precision), полноту (recall), специфичность (specificity), F1-меру (F1-score), сбалансированную точность (balanced accuracy), коэффициент корреляции Мэтьюза (MCC) и площадь под ROC-кривой (AUC-ROC). Для задач регрессии, по мере необходимости, рассчитайте среднюю абсолютную ошибку (MAE), среднеквадратичную ошибку (RMSE), коэффициент детерминации (R2) и другие соответствующие показатели.
- Оценка обобщающей способности и устойчивости модели
- Если такие данные доступны, оцените модель с использованием внешнего набора данных, собранного независимо от обучающего набора.
- Для оценки переносимости предпочтительно использовать внешние наборы данных, полученные в другом медицинском учреждении, географическом регионе или от другой популяции пациентов.
- При наличии лонгитюдных наборов данных проведите временную валидацию с использованием данных, собранных за более поздний период.
- При наличии многоцентровых данных проведите многоцентровую валидацию, оценивая итоговую модель отдельно в каждом из участвующих учреждений.
- При возможности проведите географическую валидацию с использованием независимой популяции из другого географического региона.
- Приведите данные о различиях в эффективности и доверительных интервалах между обучающим и внешними наборами данных.
- Оценка вычислительной эффективности
- Измерьте время обучения модели в заданном вычислительном окружении, время вывода и тестирования при идентичных вычислительных условиях, а также потребление памяти, размер модели и загрузку оборудования.
- Повторите вычислительные измерения в нескольких независимых запусках.
- Рассчитайте среднее время выполнения, чтобы снизить влияние экспериментальной вариативности.
- Сравнение эффективности моделей
- Выберите подходящие общепринятые методы машинного или глубокого обучения для сравнительной оценки.
- Оцените предлагаемую модель XAI и модели-компараторы с использованием одного и того же набора данных. Примените идентичные процедуры предобработки и метрики оценки ко всем сравниваемым моделям.
- Проведите все сравнительные эксперименты в одном и том же вычислительном окружении.
ПРИМЕЧАНИЕ: Получите экспериментальные доказательства прогностической стабильности и воспроизводимости при протестированных вычислительных условиях и на данном наборе данных.
8. Генерация и оценка результатов XAI
- Формирование объяснений модели
- Загрузите оптимизированную модель XAI. Выберите образцы для оценки, которые не использовались при обучении модели. Примените предопределенные методы интерпретируемости, не изменяя обученную модель или конвейер предобработки.
- Сформируйте глобальные и локальные объяснения модели
- Сформируйте глобальные объяснения для характеристики общего поведения прогностической модели.
- Сформируйте локальные объяснения для характеристики отдельных прогнозов модели.
- Примените SHAP к набору данных по диабету индейцев племени Пима (Pima Indians Diabetes Dataset) для получения глобальных и локальных объяснений прогнозов табличной модели.
- Постройте сводный график SHAP (summary plot) для визуализации общего направления и величины вклада признаков.
- Постройте график важности признаков SHAP, используя средние абсолютные значения SHAP, чтобы ранжировать признаки по их общему вкладу в прогнозы модели.
- Постройте каскадный график SHAP (waterfall plot) для репрезентативного прогноза из тестового набора, чтобы проиллюстрировать вклад признаков для конкретного пациента.
- Постройте график зависимости признаков SHAP (feature-dependence plot), чтобы изучить связь между выбранным признаком и его вкладом в выходные данные модели.
- Примените LIME к репрезентативным прогнозам из тестового набора для получения локальных объяснений отдельных прогнозов модели.
- Сформируйте контрфактуалное объяснение для конкретного пациента, чтобы проиллюстрировать изменения признаков, связанные с изменением прогнозируемого результата.
- Выберите дополнительные методы интерпретируемости в соответствии с модальностью данных и архитектурой модели.
- При необходимости используйте Grad-CAM или карты значимости (saliency maps) для совместимых моделей на основе изображений, визуализацию внимания (attention visualizations) для архитектур на базе трансформеров и интегрированные градиенты (Integrated Gradients) для дифференцируемых моделей.
- Рассматривайте Grad-CAM, картирование значимости, визуализацию внимания и интегрированные градиенты как общие варианты протокола, зависящие от модальности; не интерпретируйте и не представляйте их как экспериментальные результаты валидации набора данных Pima Indians Diabetes Dataset, если соответствующие анализы фактически не проводились.
- Применение методов интерпретируемости к валидации данных Pima
- Примените SHAP и LIME к набору данных Pima Indians Diabetes Dataset для получения глобальных и локальных объяснений прогнозов табличной модели.
- Создайте визуализации SHAP: сводный график, график важности признаков, каскадный график и график зависимости признаков на основе результатов валидации Pima.
- Сформируйте локальное объяснение LIME для репрезентативных прогнозов из тестового набора.
- Сформируйте контрфактуалное объяснение для конкретного пациента, чтобы проиллюстрировать изменения признаков, связанные с изменением прогноза модели.
- Рассматривайте Grad-CAM, визуализацию внимания, картирование значимости и интегрированные градиенты как варианты интерпретируемости, зависящие от модальности, для других типов медицинских данных и архитектур моделей.
- Не представляйте Grad-CAM, визуализацию внимания, картирование значимости или интегрированные градиенты в качестве экспериментальных выводов при валидации данных Pima, если соответствующие анализы фактически не проводились.
- Оценка качества объяснений
- Оцените, отражают ли созданные объяснения процесс прогнозирования модели. Оцените стабильность объяснений при повторных экспериментальных запусках и согласованность результатов объяснения при идентичных вычислительных условиях.
- При необходимости оцените чувствительность результатов объяснения к изменениям входных данных. Сравните полученные объяснения с доступными предметными знаниями или экспертными интерпретациями.
- Выявите прогностические признаки или анатомические области, которые соответствуют установленным медицинским знаниям, если такие сравнения возможны.
- Зафиксируйте степень согласия или несогласия между сформированными объяснениями и доступной клинической интерпретацией.
- Количественная оценка неопределенности прогноза
- Рассчитайте оценки достоверности прогноза для оцениваемых образцов, используя метод оценки неопределенности, подходящий для выбранной архитектуры модели и области применения в здравоохранении.
- При необходимости примените метод Monte Carlo dropout, прогнозирование на основе ансамблей, байесовский вывод, конформное прогнозирование или другой валидированный подход к оценке неопределенности.
- При использовании Monte Carlo dropout повторите итерации стохастического прогнозирования и вычислите средний прогноз и прогностическую дисперсию для каждого оцениваемого образца.
- Укажите достоверность прогноза или интервалы неопределенности вместе с соответствующими прогнозами модели.
- Оцените, позволяют ли оценки неопределенности выявить прогнозы с более низкой надежностью или повышенной ошибкой. Сохраните метод оценки неопределенности, параметры, случайные числа (seeds) и полученные результаты оценки неопределенности для обеспечения воспроизводимости.
- Документирование и сохранение результатов интерпретируемости
- Сохраните все сформированные показатели важности признаков, тепловые карты, карты значимости, визуализации внимания и интерпретации для конкретных пациентов. Сохраните результаты интерпретируемости в стандартизированных форматах файлов. Архивируйте результаты вместе с обученной моделью и конфигурацией предобработки.
- Зафиксируйте вычислительные настройки, параметры объяснения, время выполнения и версии программного обеспечения, использованные для генерации объяснений. Сохраните полную документацию по интерпретируемости для облегчения независимого анализа и обеспечения воспроизводимости.
- Количественная оценка качества объяснений
- Оцените достоверность (faithfulness) объяснения путем систематического возмущения или маскирования признаков, определенных как важные, и измерения соответствующего изменения выходных данных модели. Рассчитайте показатель достоверности объяснения, сравнив величину атрибуции с результирующим изменением прогноза модели.
- Оцените стабильность объяснения, создавая объяснения для повторных запусков, возмущенных входных данных или клинически схожих образцов, и вычисляя сходство между полученными паттернами атрибуции. Рассчитайте показатель недостоверности (infidelity), измерив расхождение между прогнозируемым изменением выхода и изменением, оцененным на основе атрибуции объяснения при контролируемых возмущениях входных данных.
- Для объяснений медицинских изображений оцените точность локализации, используя определенную экспертом область интереса (ROI), если доступны эталонные аннотации. Оцените клиническую полезность, получив независимые оценки от квалифицированных клинических экспертов с использованием предопределенных критериев интерпретации.
- Рассчитайте каппу Коэна или каппу Фляйсса, если несколько экспертов независимо оценивают релевантность или согласованность объяснений.
ПРИМЕЧАНИЕ: Сформируйте глобальные и локальные объяснения, характеризующие прогностическое поведение обученной ИИ-модели. Сохраните результаты интерпретируемости и соответствующие конфигурации для прозрачной интерпретации и воспроизводимой оценки.
9. Проведение статистической валидации и оценки воспроизводимости
- Выполните статистическую валидацию
- Выберите статистические методы в соответствии с целью исследования, дизайном эксперимента, распределением данных и характеристиками оцениваемых переменных.
- Непрерывные переменные следует представлять в виде среднего значения ± стандартное отклонение или медиана и межквартильный размах, в зависимости от ситуации, а категориальные переменные — в виде абсолютных значений и процентов.
- Выполните пятикратную перекрестную проверку на обучающем наборе данных для оценки стабильности работы модели и представьте значения точности (accuracy), AUC-ROC, прецизионности (precision), полноты (recall) и F1-меры в виде среднего значения. ± стандартное отклонение по фолдам. Оцените 95%-е доверительные интервалы для показателей эффективности на независимом тестовом наборе с использованием 1 0 бутстреп-ресемплов.
- Сравните предлагаемую модель с базовыми моделями CNN, Random Forest и SVM, используя тест МакНемара для парного сравнения точности, тест Делонга для сравнения коррелированных значений AUC-ROC и парный бутстреп-тест с 10 итерациями ресэмплинга для сравнения F1-меры.
- Приведите соответствующий статистический критерий и точное значение p для каждого сравнения, используя двусторонний уровень значимости α = 0.05.
- Статистическое сравнение эффективности моделей
- Сравните предлагаемую модель объяснимого ИИ с выбранными базовыми моделями современного уровня на основе машинного и глубокого обучения.
- Примените t-критерий Стьюдента t—тест или U-критерий Манна-Уитни при сравнении двух групп, в зависимости от ситуации. Для соответствующих параметрических сравнений с участием более чем двух групп применяйте однофакторный дисперсионный анализ (ANOVA). Для соответствующих непараметрических сравнений с участием более чем двух групп применяйте критерий Краскела-Уоллиса.
- Рассмотрите p < 0,05 статистически значимо, как указано в оригинальной рукописи.
- Используйте двусторонний уровень значимости α = 0,05 для всех заранее определенных статистических сравнений; приведите соответствующие значения статистик критерия и p-значения.
- Приведите 95%-е доверительные интервалы для основных показателей прогностической эффективности.
- При необходимости используйте бутстреп-ресемплинг для оценки доверительных интервалов показателей эффективности. Для сравнения коррелированных значений ROC-AUC в случаях, когда одни и те же субъекты оцениваются двумя моделями, используйте тест Делонга. Для сравнения парных результатов категориальной классификации, полученных для одних и тех же субъектов, используйте тест Макнемара. При необходимости используйте процедуры парного бутстрепа для сравнения F1-меры или других производных показателей эффективности.
- Оцените калибровку с помощью калибровочных кривых, наклона и свободного члена калибровочной прямой, а также оценки Брайера при наличии вероятностных прогнозов.
- Для валидации обработанного набора данных по диабету индейцев племени Пима (Pima Indians Diabetes Dataset) используйте предопределенное парное статистическое сравнение, указанное для предлагаемой и базовых моделей. Последовательно применяйте выбранный тест к парным прогнозам на тестовой выборке или к измерениям производительности при повторных запусках, в зависимости от типа сравнения. Используйте двусторонний уровень значимости α = 0,05, а также укажите значение статистики теста и точное значение p. Не сообщайте о проведении альтернативных статистических тестов, если их результаты не представлены в разделе «Результаты».
- Примените двусторонние критерии и интерпретируйте статистическую значимость, используя заранее определенный порог p < 0.05.
- Оценка робастности модели
- Повторите полную процедуру обучения и оценки 10 раз, используя различные случайные значения seed, при этом сохраняя предопределенное разделение набора данных, процедуры предобработки, архитектуру модели, гиперпараметры, программную среду и протокол оценки.
- Запишите значения AUC-ROC, точности (accuracy) и F1-меры для каждого независимого запуска и рассчитайте среднее значение. ± стандартное отклонение по 10 повторностям.
- Сравните полученные значения производительности в нескольких повторных запусках для оценки стабильности прогнозирования и воспроизводимости при различных вариантах случайной инициализации.
- Оценка объяснимости и воспроизводимости
- Формируйте атрибуции признаков, карты внимания или иные результаты интерпретации в нескольких экспериментальных запусках, если предусмотрена оценка стабильности объяснений. Проведите количественное сравнение полученных результатов интерпретации между повторными запусками, используя соответствующий показатель сходства или меру согласованности на основе ранжирования.
- Для текущей валидации набора данных по диабету у индейцев племени Пима не следует приводить количественные метрики стабильности объяснений, если соответствующие повторные выводы объяснений и анализы не были выполнены.
- Оцените степень согласованности между объяснениями, сгенерированными моделью, и интерпретациями клиницистов при наличии соответствующих клинических оценок. Для оценки согласованности между экспертами рассчитайте коэффициент каппа Коэна или каппа Фляйсса, в зависимости от ситуации.
- Воспроизводимость документации
- Сохраните исходные данные, процедуры предварительной обработки, исходный код, обученные модели, конфигурации гиперпараметров, результаты интерпретируемости, скрипты статистического анализа и полученные результаты.
- Зафиксируйте программную среду и конфигурацию оборудования, использованные на протяжении всего рабочего процесса. Независимо повторите выполнение полного рабочего процесса, используя архивные файлы и конфигурации.
- Сравните результаты воспроизведенного прогнозного анализа с исходными экспериментальными данными, а объяснения воспроизведенной модели — с исходными результатами анализа интерпретируемости.
- Зафиксируйте любые различия, наблюдаемые в процессе репликации. Обновите экспериментальную документацию, чтобы отразить наблюдения по воспроизводимости, выявленные в ходе независимого выполнения.
ПРИМЕЧАНИЕ: Получите статистически подтвержденные результаты прогностической эффективности и интерпретируемости, которые могут быть оценены в ходе повторяющихся экспериментов. Сохраните достаточную вычислительную, аналитическую и методологическую документацию для обеспечения независимой проверки всего рабочего процесса.
- Контрольный список по воспроизводимости
- Зафиксируйте название набора данных, версию, дату получения, источник, критерии включения, критерии исключения и итоговый размер выборки. Зафиксируйте все операции по предварительной обработке, параметры преобразования, настройки нормализации, процедуры отбора признаков и правила разделения данных.
- Зафиксируйте операционную систему, ЦП, ГП, объем оперативной памяти, версию Python, версии фреймворков и версий библиотек. Зафиксируйте все спецификации архитектуры модели и гиперпараметры.
- Зафиксируйте оптимизатор, скорость обучения, размер пакета, количество эпох, функцию потерь, параметры регуляризации и критерии ранней остановки. Зафиксируйте все значения случайных чисел (seed) и настройки генератора случайных чисел.
- Сохраните веса обученной модели и конфигурации предобработки. Сохраните журналы обучения, скрипты оценки, скрипты статистического анализа и результаты интерпретируемости. Зафиксируйте версии модели и программного обеспечения, использованные в финальных экспериментах.
- Сохраните полную вычислительную среду, необходимую для независимого воспроизведения.
- Документируйте доступность исходного кода, наборов данных, весов моделей и вспомогательных материалов с учетом этических, правовых, лицензионных ограничений и требований конфиденциальности.
- Независимо повторите выполнение архивного рабочего процесса и сравните воспроизведенные результаты с исходными.
- Задокументируйте все требования к воспроизводимости, используя стандартизированный контрольный список.
Результаты
Предложенная платформа XAI была реализована с использованием набора данных Pima Indians Diabetes в качестве репрезентативного набора данных в области здравоохранения. Набор данных Pima Indians Diabetes использовался в качестве единственного набора данных для экспериментальной валидации. Все представленные результаты прогнозирования, объяснимости, статистического анализа и воспроизводимости были получены на основе этого набора данных. TCGA-BRCA, TCGA-UCEC, MIMIC-III, ISIC 2019, HAM10000, OhioT1DM и BraTS 2021 не подвергались экспериментальной оценке и включены только в качестве примеров, иллюстрирующих применимость общего протокола к различным модальностям данных здравоохранения. Полный набор данных использовался после удаления недостоверных и дублирующих записей, а перед разработкой модели были выполнены указанные операции по предварительной обработке. Набор данных был разделен на независимые обучающую, валидационную и тестовую подвыборки с использованием заранее определенной стратегии стратифицированного разделения. Независимость образцов между тремя подвыборками поддерживалась для минимизации возможности утечки данных.
Прогностическая модель была настроена с использованием предопределенной архитектуры и гиперпараметров. Обучение модели проводилось с помощью оптимизатора Adam с заданным темпом обучения и размером пакета (batch size) в течение до 100 эпох. Применялся метод ранней остановки на основе потерь на валидационной выборке, и была сохранена модель с наилучшими показателями валидации. Для повышения воспроизводимости результатов были заданы случайные числа (random seeds) при разделении набора данных, инициализации модели и проведении повторных экспериментов.
Обученная модель была оценена на независимом тестовом наборе данных с использованием таких показателей, как точность (accuracy), прецизионность (precision), полнота (recall), специфичность, F1-мера, коэффициент корреляции Мэтьюза (MCC), площадь под кривой рабочих характеристик приемника (AUC-ROC) и средняя точность (AP). Предложенная модель сравнивалась с предопределенными базовыми моделями с использованием идентичных процедур предобработки, разделения данных и протоколов оценки. На основе прогнозов независимого тестового набора были построены рабочие характеристики приемника (ROC-кривые), кривые прецизионности-полноты и матрица ошибок.
Для оценки стабильности работы была выполнена пятикратная перекрестная проверка на обучающих данных. Для основных показателей эффективности были рассчитаны 95% доверительные интервалы, а также проведено предварительно определенное статистическое сравнение предложенной модели с базовыми моделями.
Пятикратная перекрестная проверка обеспечила точность 93.01 ± 0.48%, AUC-ROC 0.954 ± 0.007, прецизионность 92.42 ± 0.87%, полноту 93.02 ± 0.45% и F1-меру 92.72 ± 0.62%. 95% бутстрэп-доверительные интервалы, рассчитанные на основе 1 000 повторных выборок, составили 0.897–0.973 для точности, 0.890–0.970 для прецизионности, 0.880–0.963 для полноты, 0.887–0.965 для F1-меры и 0.931–0.984 для AUC-ROC. Статистическое сравнение с базовыми моделями CNN, Random Forest и SVM проводилось с использованием теста МакНемара для точности, теста ДеЛонга для AUC-ROC и парного бутстрэп-тестирования с 1 000 повторными выборками для F1-меры.
Полная процедура обучения и оценки была повторена в 10 независимых запусках с использованием различных случайных чисел (seeds). Повторные запуски дали значение AUC-ROC 0,957 ± 0,008, точность 93,24 ± 0,74% и F1-меру 92,35 ± 0,92%, что указывает на относительно низкую вариабельность между повторными итерациями. Показатели эффективности, полученные в ходе повторных запусков, были обобщены с помощью среднего значения и стандартного отклонения. Вариабельность между запусками изучалась для определения того, остается ли прогностическая эффективность стабильной при повторном выполнении.
В данном практическом примере внешняя валидация не проводилась, так как независимый внешний набор данных не использовался. Соответственно, все представленные результаты прогнозирования, статистические данные и результаты воспроизводимости были получены на основе набора данных Pima Indians Diabetes Dataset с использованием предопределенных разделов для обучения, валидации и независимого тестирования. Внешняя валидация оставлена в протоколе в качестве дополнительной процедуры для тех случаев, когда доступен независимый набор данных из другого учреждения, популяции, географического региона или за другой период времени.
Пояснения к моделям были созданы с использованием методов интерпретируемости, применимых к табличному набору данных Pima Indians Diabetes, включая SHAP и LIME. Была проведена оценка глобальной значимости признаков, а также сформированы локальные пояснения для конкретных пациентов с использованием отложенных тестовых выборок. Результаты интерпретации были зафиксированы вместе с соответствующими предсказаниями моделей и значениями признаков для обеспечения воспроизводимости и последующего анализа.
Для ясности данный практический пример включал девять основных этапов рабочего процесса, указанных в Таблице 1. Внешняя валидация и оценка клиническими экспертами были оставлены в качестве дополнительных модулей валидации общего протокола. Внешняя валидация не проводилась, так как независимый внешний набор данных не использовался, а оценка клиническими экспертами не проводилась, так как в данный практический пример не была включена официальная экспертная группа. Соответственно, эти дополнительные модули не считаются частью девятиэтапного экспериментального рабочего процесса и не приводятся в качестве результатов эксперимента.
Процедуры предварительной обработки и разделения набора данных позволили создать стандартизированный датасет, пригодный для разработки модели. Дублирующиеся и противоречивые записи были удалены, пропущенные значения обработаны в соответствии с заранее определенной стратегией, числовые признаки стандартизированы, а набор данных разделен на независимые обучающую, валидационную и тестовую подвыборки. Характеристики итогового набора данных и процедуры предварительной обработки обобщены в Таблице 2. Общий рабочий процесс подготовки и предварительной обработки набора данных по здравоохранению проиллюстрирован на Рисунке 2, в то время как рабочий процесс экспериментальной подготовки, предварительной обработки, разделения и оценки качества, примененный конкретно к набору данных Pima Indians Diabetes Dataset, показан на Рисунке 3. Окончательная вычислительная среда, архитектура модели и конфигурация гиперпараметров, использованные для получения представленных результатов, обобщены в Таблице 3.
Выполнение разделов 3 и 4 позволило получить стандартизированный набор данных здравоохранения, подходящий для разработки модели. В ходе процедур предобработки были удалены дубликаты и противоречивые записи, заполнены пропущенные значения, стандартизированы числовые признаки, закодированы категориальные переменные (где это было применимо), а набор данных был разделен на обучающую, валидационную и тестовую выборки. Полученные данные обеспечили стандартизированный ввод, необходимый для последующей разработки модели.
После завершения разделов 5 и 6 сконфигурированная модель продемонстрировала стабильную сходимость в процессе обучения. Кривые обучения показали одновременное снижение потерь при обучении и валидации, а также рост точности при обучении и валидации. Оптимизация гиперпараметров улучшила обобщающую способность модели, при этом признаков существенного переобучения выявлено не было. Для обеспечения воспроизводимости оптимизированная модель была архивирована вместе с окончательной архитектурой, настройками гиперпараметров, версиями программного обеспечения, случайными значениями (seeds) и весами обученной модели. Спецификации обучения модели и результаты оптимизации обобщены в таблице 4, а соответствующие кривые обучения при обучении и валидации представлены на рисунке 4.
В разделе 7 оценивалась прогностическая эффективность модели с использованием стандартизированных показателей эффективности. Оцениваемые метрики классификации включали точность (accuracy), прецизионность (precision), полноту (recall), специфичность (specificity), F1-меру (F1-score), коэффициент корреляции Мэтьюса (MCC), AUC-ROC и среднюю точность (AP). Предложенная модель сравнивалась с заранее определенными базовыми моделями с использованием тех же разделений набора данных, процедур предобработки и протокола оценки. Сравнение прогностической эффективности представлено в Таблице 5, а ROC-кривые, кривые прецизионности-полноты, матрица ошибок и сравнительные показатели эффективности показаны на Рисунке 5.
После Раздела 8 были созданы как глобальные, так и локальные объяснения прогнозов модели для оценки ее интерпретируемости. Объяснения модели были сгенерированы с помощью SHAP и LIME для табличного набора данных Pima Indians Diabetes Dataset, а также было создано специфичное для пациента контрфактическое объяснение, чтобы проиллюстрировать изменение прогноза. SHAP использовался для создания визуализаций глобальной важности признаков, пациент-специфичных графиков-водопадов (waterfall plots) и зависимостей признаков, в то время как LIME применялся для получения локальных объяснений на основе отложенных тестовых образцов. Соответствующие результаты анализа интерпретируемости представлены на Рисунке 6.
На заключительном этапе протокола оценивались статистическая достоверность и воспроизводимость рабочего процесса. Полный рабочий процесс был повторен в 10 независимых запусках с использованием различных случайных чисел (seeds) при соблюдении той же стратегии разделения набора данных, параметров предобработки, архитектуры модели, гиперпараметров, программной среды и процедур оценки. Повторные запуски дали значения AUC-ROC 0,957 ± 0,008, точности (accuracy) 93,24 ± 0,74% и F1-меры 92,35 ± 0,92%, что указывает на относительно низкую вариабельность между повторными выполнениями.
Стабильность объяснений не оценивалась количественно в данной работе по валидации. Хотя для набора данных по диабету у индейцев Пима (Pima Indians Diabetes Dataset) были созданы объяснения с помощью SHAP и LIME, отдельный анализ ранговой корреляции или перекрытия признаков между запусками не проводился. Следовательно, численные показатели стабильности объяснений или согласованности атрибуции не представлены. Количественная оценка стабильности объяснений сохранена в общем протоколе в качестве необязательной процедуры воспроизводимости для тех случаев, когда доступны повторные результаты получения объяснений.
Статистические сравнения оценивали с использованием заранее определенного порога значимости p < 0.05. В соответствующих случаях применяли двусторонние статистические тесты; для количественной оценки статистической значимости и неопределенности наблюдаемых различий в эффективности приводили соответствующие значения тестовых статистик, p-значения и 95% доверительные интервалы. Результаты экспериментальной статистической валидации и воспроизводимости, включая эффективность перекрестной проверки, доверительные интервалы, статистические сравнения и вариабельность при повторных запусках, обобщены в Таблице 6. Соответствующие результаты статистического тестирования и анализа воспроизводимости представлены на Рисунке 7.
Эти результаты предоставили экспериментальные доказательства прогностической стабильности и воспроизводимости в протестированных вычислительных условиях и на данном наборе данных. Вычислительная среда, характеристики набора данных, процедуры предварительной обработки, конфигурация модели, статистический анализ и настройки интерпретируемости, необходимые для независимого воспроизведения, были задокументированы в соответствии с контрольным списком воспроизводимости, представленным в Таблица 7Клиническая экспертная оценка результатов работы XAI не проводилась в рамках представленного в данной работе примера валидации.
В целом, применение данного протокола позволило получить стандартизированный набор данных по здравоохранению, подходящий для разработки моделей ИИ, а также оптимизированную модель с использованием заранее определенных настроек гиперпараметров. Данный рабочий процесс обеспечил систематическую оценку прогностической эффективности, создание объяснений модели с помощью соответствующих методов XAI, а также статистическую оценку робастности и воспроизводимости модели. В совокупности результаты продемонстрировали возможность реализации и воспроизводимости предложенного рабочего процесса XAI в экспериментальных условиях, рассмотренных в примере валидации.
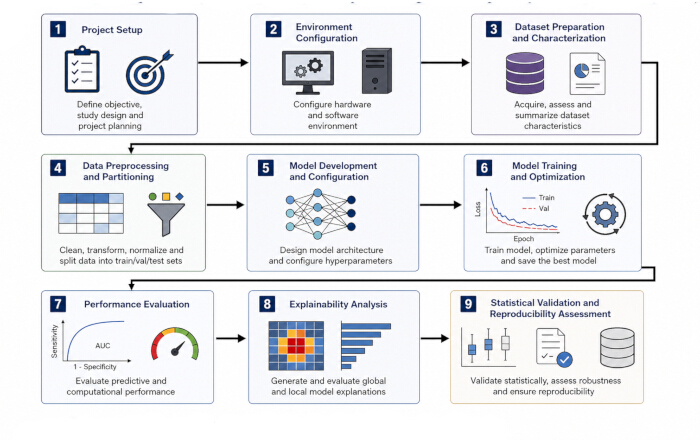
Рисунок 1: Девятиэтапный основной рабочий процесс разработки воспроизводимых и интерпретируемых моделей ИИ в здравоохранении. Рабочий процесс включает (1) определение задачи прогнозирования в здравоохранении, (2) конфигурацию вычислительной среды, (3) сбор и валидацию набора данных, (4) предварительную обработку данных, (5) разделение набора данных, (6) обучение прогностической модели, (7) оценку прогностической эффективности, (8) анализ интерпретируемости и (9) статистическую валидацию и оценку воспроизводимости. Внешняя валидация и оценка клиническими экспертами рассматриваются как дополнительные расширения протокола и не включены в основной девятиэтапный рабочий процесс. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
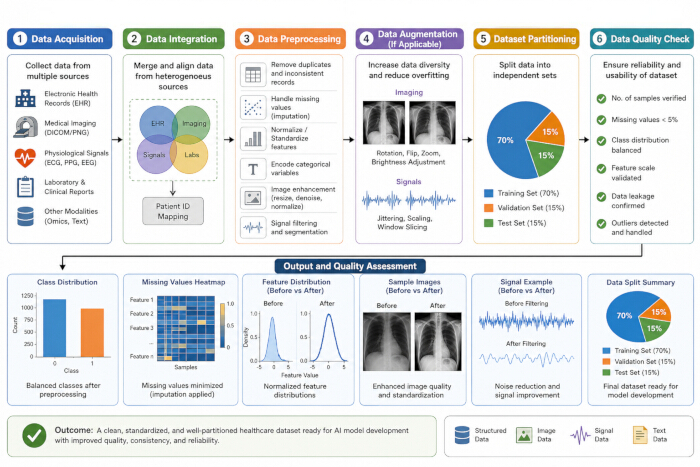
Рисунок 2: Рабочий процесс подготовки и предобработки набора данных для здравоохранения. (A) Сбор медицинских данных из клинических записей, медицинских изображений, физиологических сигналов и мультимодальных источников данных. (B) Интеграция и предобработка данных, включая обработку пропущенных значений, нормализацию, удаление шума и аугментацию. (C) Разделение набора данных на обучающую, валидационную и тестовую выборки. (D) Оценка качества, демонстрирующая распределение классов, нормализацию признаков и результаты предобработки перед разработкой модели. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
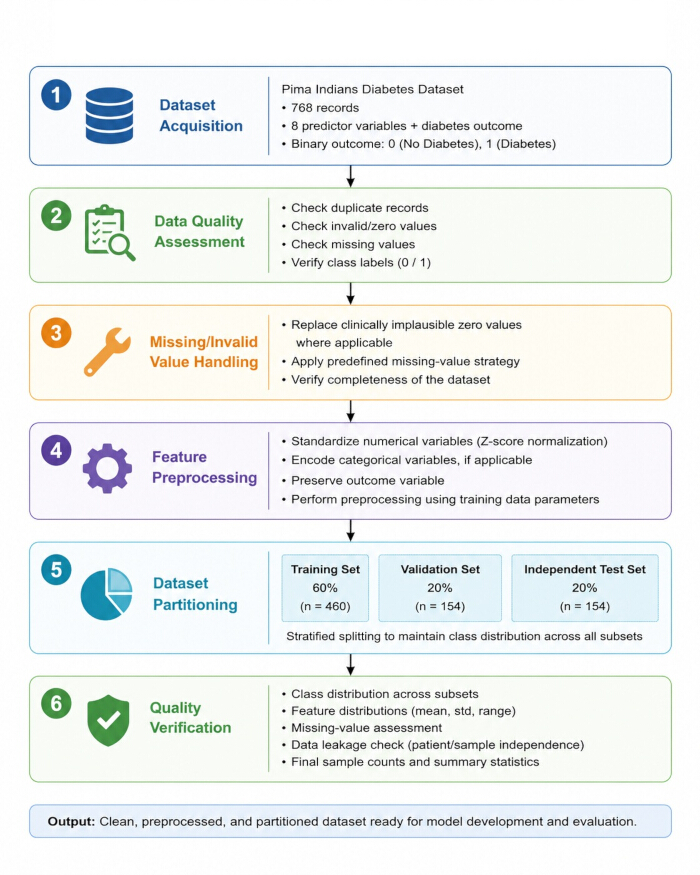
Рисунок 3: Экспериментальный рабочий процесс подготовки, предобработки, разделения и оценки качества набора данных Pima Indians Diabetes Dataset. Рабочий процесс включает получение набора данных, оценку качества данных, обработку некорректных и пропущенных значений, стандартизацию числовых признаков, разделение набора данных на обучающую, валидационную и независимую тестовую подвыборки, а также финальную проверку качества перед разработкой модели. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
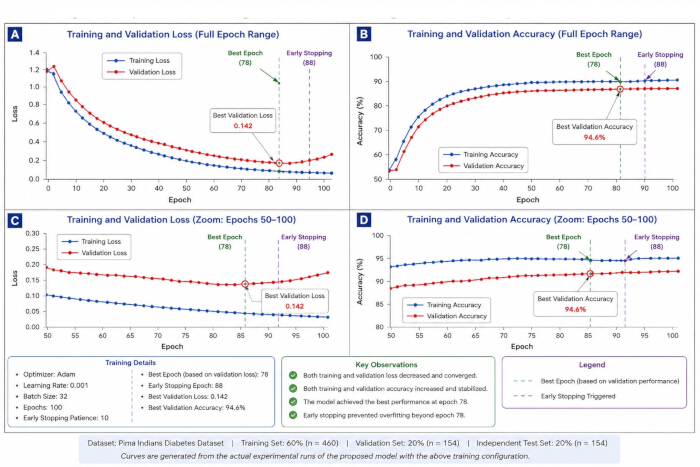
Рисунок 4: Экспериментальные кривые обучения и валидации предлагаемой модели с использованием набора данных Pima Indians Diabetes Dataset. (A) Потери при обучении и валидации на протяжении всего периода обучения. (B) Точность при обучении и валидации на протяжении всего периода обучения. (C) Увеличенный вид потерь в течение эпох 50–100. (D) Увеличенный вид точности в течение эпох 50–100. Лучшие показатели валидации были достигнуты на 78-й эпохе: потери при валидации составили 0.142, а точность валидации — 94.6%. Ранняя остановка была инициирована на 88-й эпохе при параметре patience, равном 10 эпохам. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
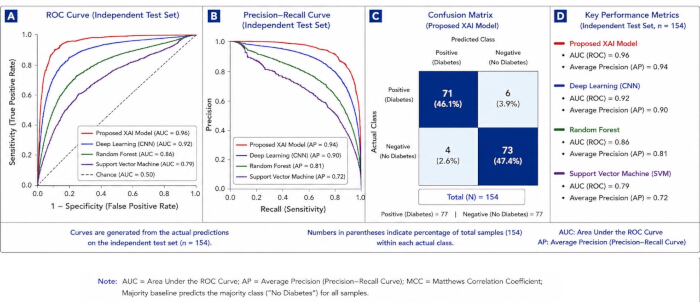
Рисунок 5: Экспериментальная оценка прогностической эффективности предлагаемой структуры XAI с использованием независимого тестового набора (n = 154). (A) ROC-кривая (рабочая характеристика приемника), демонстрирующая дискриминационную способность предлагаемой модели XAI и базовых моделей. (B) Кривые точности-полноты (PR), демонстрирующие показатели точности и полноты предлагаемой модели XAI и базовых моделей. (C) Матрица ошибок предлагаемой модели XAI на независимом тестовом наборе с соответствующими значениями точности (accuracy), чувствительности (полноты) и специфичности. (D) Сравнение точности (accuracy), прецизионности (precision), полноты (recall), специфичности, F1-меры, коэффициента корреляции Мэтьюза (MCC), площади под ROC-кривой (AUC) и средней точности (AP) по всем оцениваемым моделям. Все количественные результаты, представленные на этом рисунке, относятся к валидационному эксперименту на наборе данных Pima Indians Diabetes Dataset. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
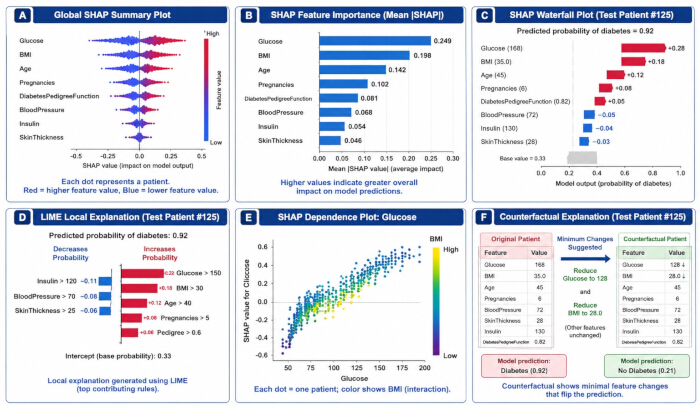
Рисунок 6: Результаты интерпретируемости, полученные на основе прогнозов независимого тестового набора данных предлагаемой модели, обученной на наборе данных Pima Indians Diabetes Dataset. (A) Глобальный сводный график SHAP, показывающий распределение вкладов признаков в тестовом наборе. (B) График важности признаков SHAP на основе средних абсолютных значений SHAP. (C) Индивидуальный водопадный график SHAP для пациента, показывающий вклад отдельных признаков в прогнозируемую вероятность диабета. (D) Локальное объяснение LIME, показывающее вклад признаков для тестового пациента №125. (E) График зависимости SHAP, показывающий связь между значениями глюкозы и их вкладом в SHAP. (F) Индивидуальное контрфактическое объяснение для пациента, показывающее минимальные изменения признаков, связанные с изменением прогноза модели. Сокращения: SHAP = Shapley Additive exPlanations; LIME = Local Interpretable Model-agnostic Explanations. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
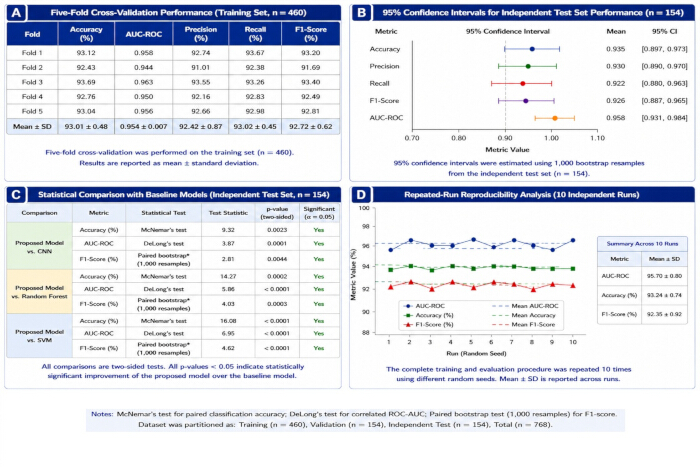
Рисунок 7: Экспериментальная статистическая валидация и анализ воспроизводимости предлагаемой модели с использованием набора данных Pima Indians Diabetes Dataset. (A) Эффективность пятикратной кросс-валидации на обучающем наборе. (B) 95% бутстрэп-доверительные интервалы для эффективности на независимом тестовом наборе. (C) Статистическое сравнение с базовыми моделями, включая статистический критерий, значение статистики, p-value и значимость. (D) Согласованность эффективности в 10 независимых запусках с использованием различных случайных значений seed. Для сравнения парной точности классификации использовался тест Макнемара, для коррелированного ROC-AUC — тест Делонга, а для сравнения F1-score — парный бутстрэп-тест с 1 000 ресэмплами. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
| Этап | Активность протокола | Ожидаемый результат | Статус реализации |
| 1 | Выбор и валидация набора данных в сфере здравоохранения | Верифицированный набор данных, целевая переменная прогнозирования, распределение классов и информация о качестве данных | Выполнено |
| 2 | Настройка вычислительной среды | Проверенное оборудование, программное обеспечение, библиотеки, версии и вычислительная конфигурация | Выполнено |
| 3 | Предварительная обработка и контроль качества данных здравоохранения | Очищенный, преобразованный и стандартизированный набор данных | Выполнено |
| 4 | Разбиение набора данных | Независимые обучающий, валидационный и тестовый наборы данных | Выполнено |
| 5 | Разработка и оптимизация прогностической модели/модели объяснимого искусственного интеллекта (XAI) | Окончательная архитектура модели и гиперпараметры | Выполнено |
| 6 | Обучение и сохранение модели | Обученная модель, контрольная точка, конфигурация обучения и логи | Выполнено |
| 7 | Оценка прогностической и вычислительной эффективности | Метрики эффективности на тестовом наборе данных и сравнение эффективности | Выполнено |
| 8 | Генерация и оценка результатов интерпретируемости | SHAP/LIME и соответствующие результаты интерпретации | Выполнено |
| 9 | Выполните статистическую валидацию и оценку воспроизводимости | Доверительные интервалы, статистические тесты, результаты повторных прогонов и показатели воспроизводимости | Выполнено |
Таблица 1: Обзор девятиэтапного основного рабочего процесса протокола, примененного при практической валидации с использованием набора данных Pima Indians Diabetes Dataset. В таблице девять этапов, реализованных в практическом примере с набором данных Pima Indians Diabetes Dataset, отделены от внешней валидации и оценки клиническими экспертами, которые остаются необязательными компонентами общего протокола.
| Набор данных | Источник данных | Клиническое применение | Модальность данных | Субъекты/Записи | Образцы | Классы | Распределение классов | Обучение/Валидация/Тестирование | Роль в данном исследовании | Статус валидации | URL источника |
| Pima Indians Diabetes Dataset | UCI Machine Learning Repository | Прогнозирование диабета | Клинические табличные данные | 768 записей | 768 | 2 | 500 без диабета; 268 с диабетом | 60% / 20% / 20% | Основной набор данных для экспериментальной валидации | Выполнено — полный девятиэтапный основной рабочий процесс | https://archive.ics.uci.edu/dataset/34/pima+indians+diabetes |
| TCGA-BRCA | NCI Genomic Data Commons (GDC), проект TCGA-BRCA | Классификация рака молочной железы | Клинические данные + гистопатология | 1 098 случаев | Зависит от набора данных и типа данных | Зависит от конечной точки | Единого распределения классов по всему набору данных отсутствует | Неприменимо — экспериментальное разделение не проводилось | Только пример применимости протокола | Не использовалось для экспериментальной валидации | https://portal.gdc.cancer.gov/projects/TCGA-BRCA |
| TCGA-UCEC | NCI Genomic Data Commons (GDC), проект TCGA-UCEC | Классификация рака эндометрия | Клинические данные + гистопатология | Когорта проекта; размер зависит от выбранного типа данных и фильтров | Зависит от набора данных и типа данных | Зависит от конечной точки | Единого распределения классов по всему набору данных отсутствует | Неприменимо — экспериментальное разделение не проводилось | Только пример применимости протокола | Не использовалось для экспериментальной валидации | https://portal.gdc.cancer.gov/projects/TCGA-UCEC |
| MIMIC-III | PhysioNet, MIMIC-III Clinical Database v1.4 | Прогнозирование клинических исходов | Клинические временные ряды | 46 520 пациентов | 58 976 госпитализаций в ОРИТ | Зависит от задачи | Единого распределения классов по всей базе данных отсутствует | Неприменимо — экспериментальное разделение не проводилось | Только пример применимости протокола | Не использовалось для экспериментальной валидации | https://physionet.org/content/mimiciii/1.4/ |
| ISIC 2019 | International Skin Imaging Collaboration (ISIC) Challenge | Классификация кожных новообразований | Дерматоскопические изображения | Неприменимо — набор изображений | 25 331 обучающее изображение | 8 обучающих категорий | AKIEC 867; BCC 3 323; BKL 2 624; DF 239; MEL 4 522; NV 12 875; VASC 253; SCC 628 | Неприменимо — экспериментальное разделение не проводилось | Только пример применимости протокола | Не использовалось для экспериментальной валидации | https://challenge.isic-archive.com/landing/2019/ |
| HAM10000 | Harvard Dataverse / ISIC Archive | Классификация кожных новообразований | Дерматоскопические изображения | 7 470 уникальных новообразований | 10 015 изображений | 7 | AKIEC 327; BCC 514; BKL 1 099; DF 115; MEL 1 113; NV 6 705; VASC 142 | Неприменимо — экспериментальное разделение не проводилось | Только пример применимости протокола | Не использовалось для экспериментальной валидации | https://doi.org/10.7910/DVN/DBW86T |
| OhioT1DM | Набор данных OhioT1DM, распределяемый публично для исследований | Мониторинг/прогнозирование диабета | Клинические временные ряды | 12 участников | 24 XML-файла в данных для обучения/разработки и тестирования | Прогнозирование непрерывного уровня глюкозы; не является фиксированной задачей классификации | Неприменимо | Файлы обучения/разработки и тестирования определены набором данных; экспериментальное разделение здесь не проводилось | Только пример применимости протокола | Не использовалось для экспериментальной валидации | https://pmc.ncbi.nlm.nih.gov/articles/PMC7881904/ |
| BraTS 2021 | RSNA-ASNR-MICCAI BraTS 2021; CBICA/University of Pennsylvania | Сегментация/классификация опухолей мозга | МРТ | 2 040 случаев в когорте конкурса | 1 251 аннотированный обучающий случай; четыре модальности МРТ на каждый случай | Зависит от задачи | Единого распределения классов по всему набору данных отсутствует | Когорты определены конкурсом; экспериментальное разделение здесь не проводилось | Только пример применимости протокола | Не использовалось для экспериментальной валидации | https://www.med.upenn.edu/cbica/brats2021/ |
Таблица 2: Характеристики наборов данных из сферы здравоохранения и применимость предлагаемого протокола. В таблице обобщены источники данных, клинические применения, модальности, характеристики образцов, распределение классов, стратегии разделения наборов данных, статус валидации и информация об источниках для наборов данных из сферы здравоохранения, рассмотренных в протоколе. Набор данных Pima Indians Diabetes используется в качестве основного практическиго примера для валидации протокола.
| Параметр конфигурации | Фактическая рабочая настройка валидации | Статус / Интерпретация |
| Набор данных | Pima Indians Diabetes Dataset | Фактический набор данных для экспериментальной валидации |
| Алгоритм / Модель | Табличная прогностическая модель для бинарной классификации диабета | Используйте точное название архитектуры из протокола эксперимента, если она задокументирована отдельно |
| Скорость обучения | 0.001 | Экспериментальная настройка |
| Оптимизатор | Adam | Экспериментальная настройка |
| Размер пакета | 32 | Экспериментальная настройка |
| Максимальное количество эпох | 100 | Экспериментальная настройка |
| Функция потерь | Cross-Entropy | Экспериментальная настройка |
| Функция активации | ReLU | Экспериментальная настройка |
| Dropout | 0.5 | Экспериментальная настройка |
| Weight Decay | 1e-4 | Экспериментальная настройка |
| Пакетная нормализация | Включена | Экспериментальная настройка |
| Аугментация данных / Балансировка классов | Включена | Указывайте SMOTE только в том случае, если этот метод действительно применялся в отчетном запуске |
| Стратегия валидации | 5-кратная кросс-валидация | Экспериментальная настройка |
| Ранняя остановка | Patience = 10 эпох | Экспериментальная настройка |
| Случайное число (seed) | 42 | Используйте точную конфигурацию seed, зафиксированную для эксперимента |
| Повторные запуски | 10 независимых запусков с использованием различных случайных чисел (seed) | Анализ воспроизводимости эксперимента |
| Размер входного изображения | Неприменимо | Набор данных Pima является табличным |
| Размерность признаков | 512 | Используйте только в том случае, если это окончательное реализованное представление признаков |
| Интерпретируемость | SHAP + LIME; контрфактуальное объяснение представлено на рисунке 6 | Фактический отчетный анализ XAI |
| Метрики оценки | Accuracy, precision, recall, specificity, F1-score, MCC, AUC-ROC, AP | Отчетные метрики экспериментальной оценки |
| Оборудование | NVIDIA GPU | Замените на точную модель GPU, если она зафиксирована |
| Программное обеспечение / Фреймворк | Python 3.11; Scikit-learn; компоненты фреймворка, использованные в реализации | Используйте точные версии пакетов, если они зафиксированы |
Таблица 3: Вычислительная среда, архитектура модели и конфигурация гиперпараметров, использованные для реализации протокола. В таблице указаны вычислительная платформа, программная среда, архитектура модели, конфигурация входных данных, параметры оптимизации, настройки регуляризации и параметры воспроизводимости, использованные для реализации предлагаемого рабочего процесса XAI.
| Параметр | Репрезентативная спецификация / результат |
| Оптимизатор | Адам |
| Скорость обучения | 0.001 |
| Размер партии | 32 |
| Максимальное количество эпох | 100 |
| Параметр терпения при ранней остановке | 10 эпох |
| Лучшая эпоха | 78 |
| Эпоха ранней остановки | 88 |
| Наилучшее значение функции потерь на валидационной выборке | 0.142 |
| Наилучшая точность на валидационной выборке | 94.6% |
| Результаты обучения | Потери при обучении и валидации снижались и достигли сходимости |
| Результаты валидации | Точность обучения и валидации увеличилась и стабилизировалась |
| Результат оптимизации | Наилучшая производительность модели была достигнута на 78-й эпохе |
| Контроль переобучения | Ранняя остановка предотвратила дальнейшую оптимизацию после выбранной наилучшей эпохи |
Таблица 4: Спецификации обучения модели и результаты оптимизации. В таблице представлены сведения об оптимизаторе, скорости обучения, размере пакета, максимальном количестве эпох обучения, показателях валидации, сходимости обучения, результате оптимизации и стратегии контроля переобучения, использованных при разработке модели.
| Модель | Точность (%) | Точность (%) | Полнота (%) | Специфичность (%) | F1-мера (%) | МКЦ | AUC (ROC) | Щелочная фосфатаза (ЩФ) |
| Предлагаемая модель XAI | 93.5 | 94.5 | 92.4 | 94.6 | 93.4 | 0.87 | 0.96 | 0.94 |
| Глубокое обучение (СНС) | 89.1 | 89.8 | 88.1 | 90 | 88.9 | 0.78 | 0.92 | 0.9 |
| Случайный лес | 84.3 | 85 | 83.2 | 85.7 | 84.1 | 0.67 | 0.86 | 0.81 |
| Метод опорных векторов (SVM) | 78.6 | 79.3 | 77.1 | 80 | 78.2 | 0.54 | 0.79 | 0.72 |
| Базовый уровень (мажоритарный класс) | 62.1 | 62.1 | 100 | 0 | 76.6 | 0 | 0.5 | 0.5 |
Таблица 5: Сравнение прогностической эффективности оцениваемых моделей. В таблице приведено сравнение предлагаемой модели XAI с оцениваемыми базовыми моделями по таким показателям, как точность (accuracy), прецизионность (precision), полнота (recall), специфичность, F1-мера, коэффициент корреляции Мэтьюса, площадь под ROC-кривой и средняя точность.
| Валидационный анализ | Сравнение / Метрика | Статистический критерий | Статистика критерия | p-значение | Экспериментальный результат / 95% ДИ |
| Пятикратная перекрестная проверка | Точность (Accuracy) | Дескриптивный анализ (среднее ± SD) | — | — | 93.01 ± 0.48% |
| Пятикратная перекрестная проверка | AUC-ROC | Дескриптивный анализ (среднее ± SD) | — | — | 0.954 ± 0.007 |
| Пятикратная перекрестная проверка | Прецизионность (Precision) | Дескриптивный анализ (среднее ± SD) | — | — | 92.42 ± 0.87% |
| Пятикратная перекрестная проверка | Полнота (Recall) | Дескриптивный анализ (среднее ± SD) | — | — | 93.02 ± 0.45% |
| Пятикратная перекрестная проверка | F1-мера | Дескриптивный анализ (среднее ± SD) | — | — | 92.72 ± 0.62% |
| 95% бутстрэп-доверительный интервал | Точность (Accuracy) | Бутстрэп (1,000 повторных выборок) | — | — | 0.935 [0.897, 0.973] |
| 95% бутстрэп-доверительный интервал | Прецизионность (Precision) | Бутстрэп (1,000 повторных выборок) | — | — | 0.930 [0.890, 0.970] |
| 95% бутстрэп-доверительный интервал | Полнота (Recall) | Бутстрэп (1,000 повторных выборок) | — | — | 0.922 [0.880, 0.963] |
| 95% бутстрэп-доверительный интервал | F1-мера | Бутстрэп (1,000 повторных выборок) | — | — | 0.926 [0.887, 0.965] |
| 95% бутстрэп-доверительный интервал | AUC-ROC | Бутстрэп (1,000 повторных выборок) | — | — | 0.958 [0.931, 0.984] |
| Предложенная модель против CNN | Точность (%) | Критерий Макнемара | 9.32 | 0.0023 | Значимо (α = 0.05) |
| Предложенная модель против CNN | AUC-ROC | Критерий Делонга | 3.87 | 0.0001 | Значимо (α = 0.05) |
| Предложенная модель против CNN | F1-мера | Парный бутстрэп (1,000 повторных выборок) | 2.81 | 0.0044 | Значимо (α = 0.05) |
| Предложенная модель против Random Forest | Точность (%) | Критерий Макнемара | 14.27 | 0.0002 | Значимо (α = 0.05) |
| Предложенная модель против Random Forest | AUC-ROC | Критерий Делонга | 5.86 | <0.0001 | Значимо (α = 0.05) |
| Предложенная модель против Random Forest | F1-мера | Парный бутстрэп (1,000 повторных выборок) | 4.03 | 0.0003 | Значимо (α = 0.05) |
| Предложенная модель против SVM | Точность (%) | Критерий Макнемара | 16.08 | <0.0001 | Значимо (α = 0.05) |
| Предложенная модель против SVM | AUC-ROC | Критерий Делонга | 6.95 | <0.0001 | Значимо (α = 0.05) |
| Предложенная модель против SVM | F1-мера | Парный бутстрэп (1,000 повторных выборок) | 4.62 | <0.0001 | Значимо (α = 0.05) |
| Воспроизводимость при повторных запусках (10 независимых запусков) | AUC-ROC | Дескриптивный анализ (среднее ± SD) | — | — | 0.957 ± 0.008 |
| Воспроизводимость при повторных запусках (10 независимых запусков) | Точность (%) | Дескриптивный анализ (среднее ± SD) | — | — | 93.24 ± 0.74% |
| Воспроизводимость при повторных запусках (10 независимых запусков) | F1-мера (%) | Дескриптивный анализ (среднее ± SD) | — | — | 92.35 ± 0.92% |
Таблица 6: Результаты статистической валидации и воспроизводимости, полученные в ходе экспериментальной реализации с использованием набора данных по диабету индейцев Пима (Pima Indians Diabetes Dataset). В таблице обобщены показатели эффективности пятикратной перекрестной проверки, 95% доверительные интервалы, рассчитанные методом бутстрэпа, результаты статистического сравнения предлагаемой модели с базовыми моделями, а также воспроизводимость результатов при многократном запуске с использованием 10 независимых случайных значений (seeds). В данной работе внешняя валидация и оценка клиническими экспертами не проводились.
| Нет. | Пункт контрольного списка | Необходимая документация | Рекомендуемая запись / проверка |
| 1 | Программная среда | Операционная система, язык программирования и программная среда | Зафиксируйте точные версии операционной системы и языка программирования. |
| 2 | Версии программного обеспечения и библиотек | Версии основных программных библиотек и пакетов | Записывайте точные названия и версии пакетов/библиотек. |
| 3 | Технические характеристики оборудования | Характеристики ЦП, ГП, ОЗУ, накопителей и ускорителей | Зафиксируйте используемое вычислительное оборудование. |
| 4 | Идентификация набора данных | Название набора данных, источник, версия и информация о доступе | Зафиксируйте точный источник/версию набора данных и дату доступа, где это применимо. |
| 5 | Характеристики набора данных | Размер выборки и распределение классов | Зафиксируйте общее количество образцов и распределение классов для каждой выборки. |
| 6 | Разбиение набора данных | Стратегия обучения, валидации и независимого тестового набора данных | Задокументируйте пропорции/количество разделения данных и стратификацию. |
| 7 | Предотвращение утечки данных | Процедура, используемая для предотвращения утечки информации | Разделение документов на обучающую и тестовую выборки и оценка параметров предобработки исключительно на обучающем наборе данных. |
| 8 | Параметры предварительной обработки | Настройки очистки, обработки пропущенных значений, нормализации, кодирования и преобразования | Зафиксируйте все операции по предварительной обработке и значения параметров. |
| 9 | Аугментация данных | Методы аугментации и настройки параметров, если применимо | Документируйте методы, вероятности и диапазоны параметров. |
| 10 | Архитектура модели | Окончательная архитектура и конфигурация модели | Задокументируйте тип модели, слои/компоненты, размерности и функции активации. |
| 11 | Гиперпараметры | Обучение и оптимизация гиперпараметров | Зафиксируйте скорость обучения, размер пакета, оптимизатор, количество эпох, параметры ранней остановки и настроенные параметры. |
| 12 | Случайные числа (Random seeds) | Случайные числа (seeds), использованные для обеспечения воспроизводимости выполнения | Записывайте значения seed для разделения данных, инициализации и повторных запусков. |
| 13 | Конфигурация обучения | Процедура обучения и стратегия выбора модели | Валидация документов, создание контрольных точек и критерии выбора модели. |
| 14 | Метрики оценки | Предопределенные показатели прогностической и статистической оценки | Зафиксируйте все зарегистрированные показатели эффективности. |
| 15 | Доверительные интервалы | Интервалы неопределенности для показателей эффективности | Документируйте процедуру оценки доверительного интервала (ДИ) и бутстреп-перевыборки, где это применимо. |
| 16 | Статистические критерии | Статистические процедуры для сравнения моделей | Документируйте вид теста, статистический показатель, p-значение, порог значимости и допущения. |
| 17 | Анализ повторяемости результатов | Независимые запуски с использованием различных случайных чисел (random seeds) | Запишите количество повторов и среднее значение ± стандартное отклонение (SD) основных показателей. |
| 18 | Конфигурация интерпретируемости | Методы интерпретируемости и настройки параметров | Документируйте SHAP, LIME, Grad-CAM, внимание, контрфакты или соответствующие настройки. |
| 19 | Оценка объяснимости | Объективная оценка достоверности и полезности объяснений | Достоверность документа, стабильность, недостоверность, локализация и экспертная оценка, где применимо. |
| 20 | Артефакты модели | Веса обученной модели и конфигурационные файлы | Архивируйте финальную обученную модель, архитектуру/конфигурацию и информацию по выбору модели. |
| 21 | Доступность кода | Код, необходимый для предварительной обработки, обучения, оценки и генерации объяснений | Укажите репозиторий данных или информацию о контролируемом доступе к коду, если применимо. |
| 22 | Исполнительная документация | Команды, скрипты, конфигурационные файлы и инструкции | Запишите команды и конфигурации, необходимые для воспроизведения рабочего процесса. |
| 23 | Документация по выходным данным | Прогнозы, результаты оценки, рисунки и выходные данные пояснений | Архивируйте полученные результаты и свяжите их с соответствующим экспериментом или запуском. |
| 24 | Проверка воспроизводимости | Проверка согласованности результатов при независимых повторениях | Сравните результаты повторных запусков и представьте предопределенные показатели вариабельности. |
Таблица 7: Контрольный список воспроизводимости для независимого повторения предложенного рабочего процесса XAI. В контрольном списке указаны требования к вычислениям, наборам данных, предварительной обработке, разработке моделей, оценке, статистической валидации, объяснимости и документации, необходимые для воспроизведения экспериментального рабочего процесса.
Обсуждение
Результаты демонстрируют полезность предлагаемого протокола в качестве стандартизированного и воспроизводимого рабочего процесса для разработки и оценки систем XAI на различных наборах данных в сфере здравоохранения. Как показано в Таблице 2 и на Рисунке 3, систематическая предобработка позволила получить стандартизированные данные и повысить их качество за счет обработки пропущенных значений, нормализации данных, масштабирования признаков и разделения набора данных. Эти этапы предобработки имеют решающее значение, поскольку вариативность в подготовке данных может привести к возникновению систематической ошибки, снижению прогностической точности и поставить под угрозу надежность анализа объяснимости. Следовательно, для обеспечения воспроизводимости и предотвращения утечки данных19,20 к обучающей, валидационной и тестовой выборкам должны применяться согласованные процедуры предобработки.
Результаты обучения модели, представленные на Рисунке 4 и в Таблице 4, демонстрируют согласованный и стабильный процесс обучения. Одновременное снижение потерь при обучении и валидации, наряду с ростом прогностической точности, указывает на надлежащую сходимость модели без существенного переобучения. Оптимизация гиперпараметров, ранняя остановка, дропаут и регуляризация дополнительно способствуют стабильности и воспроизводимости обучения модели. Нестабильность кривых обучения может свидетельствовать о неправильном выборе скорости обучения, недостаточном объеме обучающих данных или избыточной сложности модели. Следовательно, необходимо контролировать сходимость модели на протяжении всего процесса обучения для выявления и устранения этих потенциальных проблем.
Таблица 5 и Рисунок 5 демонстрируют прогностическую эффективность с использованием нескольких метрик оценки, включая точность (accuracy), прецизионность (precision), полноту (recall), специфичность, F1-меру, коэффициент корреляции Мэтьюса и площадь под ROC-кривой (AUC-ROC). ROC-кривая и кривая прецизионности-полноты позволяют оценить дискриминационную способность модели, в то время как матрица ошибок иллюстрирует распределение правильных и неправильных классификаций по классам. Оценка с использованием нескольких метрик эффективности особенно важна для несбалансированных медицинских наборов данных, поскольку одна лишь общая точность может недостаточно полно характеризовать работу модели.
Рисунок 6 представлены результаты интерпретируемости, полученные на основе набора данных по диабету индейцев племени Пима, которые демонстрируют взаимодополняющую роль методов интерпретируемости, примененных в ходе данной валидации. Глобальный анализ SHAP характеризует общий вклад и относительную значимость входных признаков для прогнозов модели, в то время как графики-водопады (waterfall plots) и графики зависимости SHAP обеспечивают интерпретацию поведения модели на уровне отдельных пациентов и конкретных признаков. LIME предоставляет дополнительное локальное объяснение, выявляя признаки, которые повлияли на прогноз для отдельного объекта из тестового набора. Контрфактуальное объяснение для конкретного пациента дополнительно иллюстрирует минимальные изменения признаков, связанные с изменением прогнозируемого результата. В совокупности эти подходы обеспечивают взаимодополняющие глобальные и локальные перспективы поведения модели, повышая прозрачность и интерпретируемость табличной прогностической модели. Grad-CAM, визуализация внимания (attention visualization), карты значимости (saliency mapping) и интегрированные градиенты (Integrated Gradients) не применялись в валидации на данных Пима и оставлены в общем протоколе только в качестве опций, зависящих от модальности данных.
Статистическая валидация (Таблица 6 и Рисунок 7) и оценка воспроизводимости демонстрируют стабильность прогностической эффективности в различных экспериментальных сериях. Сочетание кросс-валидации, оценки доверительного интервала, проверки гипотез и оценки воспроизводимости при повторных запусках обеспечивает систематическую основу для анализа робастности модели. Такая валидация особенно важна для применения в здравоохранении, поскольку воспроизводимость в независимых экспериментах служит доказательством надежности и обобщающей способности моделей ИИ перед их внедрением в клиническую практику21,23.
Для успешной реализации данного протокола критически важны несколько этапов. Перед извлечением признаков и обучением модели выполните очистку данных, чтобы минимизировать потенциальную систематическую ошибку, возникающую из-за неполных, противоречивых или ошибочных данных. Проводите оптимизацию гиперпараметров, используя только обучающую и валидационную выборки, и сохраняйте независимость тестового набора данных на протяжении всего процесса разработки и оптимизации модели. Четко документируйте состояния генератора случайных чисел, версии программного обеспечения, конфигурации оборудования и настройки предобработки для обеспечения воспроизводимости результатов на различных вычислительных платформах. Кроме того, выбирайте методы интерпретируемости в зависимости от прогностической модели и модальности медицинских данных, чтобы получить понятные и клинически значимые объяснения20,29,30.
Данный протокол имеет несколько ограничений. Точность и надежность прогнозов и объяснений модели существенно зависят от наличия достаточно больших, репрезентативных и высококачественных наборов данных из сферы здравоохранения. Недостаточная представленность определенных групп пациентов, ошибки измерения, пропущенные переменные и неоднородность источников данных могут отрицательно сказаться как на прогностической способности, так и на стабильности объяснений модели. Кроме того, современные подходы к интерпретируемости позволяют охарактеризовать поведение модели, но не обязательно устанавливают причинно-следственные механизмы. Следовательно, результаты XAI следует интерпретировать совместно с соответствующим клиническим опытом.
В целом, данный протокол представляет собой стандартизированный подход к воспроизводимой разработке, оценке и анализу интерпретируемости моделей в различных областях здравоохранения. Благодаря интеграции стандартизированной предобработки, оптимизации гиперпараметров, оценки с использованием нескольких метрик эффективности, дополнительных методов обеспечения интерпретируемости и статистической валидации, данный рабочий процесс обеспечивает прозрачную и прослеживаемую основу для исследований в области ИИ в здравоохранении.
Результаты далее указывают на то, что прозрачная и последовательная разработка моделей ИИ может быть обеспечена путем сочетания систематической предобработки данных, стандартизированных процедур разработки моделей, комплексной оценки эффективности, нескольких методов объяснимости и строгой статистической валидации. Данный протокол может быть адаптирован для клинических баз данных, медицинских изображений, физиологических сигналов и мультимодальных данных здравоохранения, сохраняя при этом структуру для воспроизводимого экспериментирования в различных вычислительных средах. Благодаря стандартизированной реализации, дополнительным методам объяснимости и оценке воспроизводимости, протокол создает основу для разработки объяснимых и надежных моделей ИИ и может служить методологическим фундаментом для будущих биомедицинских исследований и последующей внешней и клинической валидации.
Раскрытие информации
Авторы заявляют об отсутствии конкурирующих финансовых интересов, коммерческих или личных связей, которые могли бы повлиять на результаты работы, представленной в данном исследовании. Авторы не имеют конфликтов интересов, о которых следовало бы сообщить.
Благодарности
Авторы выражают благодарность за институциональную поддержку, оказанную соответствующими аффилированными организациями в ходе разработки и экспериментальной валидации данного протокола XAI в здравоохранении. Авторы также благодарят за предоставление вычислительных мощностей и программных ресурсов, использованных для проведения экспериментального анализа. Данное исследование не имело внешнего финансирования. Авторы подтверждают использование Python 3.1, Matplotlib 3.9 и SciPy 1.13 для вычислительного анализа, визуализации данных и создания рисунков, представленных в настоящем исследовании.
Материалы
| Имя | Компания | Каталожный номер | Комментарии |
|---|---|---|---|
| Captum | Meta AI | Последняя стабильная версия | Интерпретируемость PyTorch |
| CUDA Toolkit | NVIDIA | 12.2 | GPU-ускорение |
| cuDNN | NVIDIA | 9.x | Бэкенд для глубокого обучения |
| Git | Git SCM | Последняя стабильная версия | Контроль версий |
| GitHub | GitHub Inc. | Веб-платформа | Репозиторий исходного кода |
| Grad-CAM | jacobgil | Последний релиз | Визуализация CNN |
| Jupyter Notebook | Project Jupyter | Последняя стабильная версия | Интерактивная разработка |
| LightGBM | Microsoft | 4.x | Градиентный бустинг |
| LIME | LIME Community | 0.2.0 | Локальная интерпретируемость |
| Matplotlib | Matplotlib Developers | 3.9 | Визуализация |
| Microsoft Excel | Microsoft | Microsoft 365 | Организация данных |
| NumPy | NumPy Developers | 1.26 | Числовые вычисления |
| NVIDIA RTX 4090 GPU | NVIDIA | 24 GB VRAM | Обучение моделей |
| OpenCV | OpenCV Organization | 4.10 | Предобработка изображений |
| Pandas | Pandas Development Team | 2.2 | Предобработка данных |
| Pillow (PIL) | Python Imaging Library | 10.x | Обработка изображений |
| Plotly | Plotly Technologies | 5.x | Интерактивная визуализация |
| Python | Python Software Foundation | 3.1 | Среда программирования |
| PyTorch | PyTorch Foundation | 2.3 | Глубокое обучение |
| Scikit-learn | Scikit-learn Developers | 1.5 | Машинное обучение |
| SciPy | SciPy Developers | 1.13 | Научные вычисления |
| Seaborn | Seaborn Developers | 0.13 | Статистические графики |
| SHAP | SHAP Community | 0.46 | Глобальная интерпретируемость |
| SimpleITK | Insight Software Consortium | 2.x | Обработка медицинских изображений |
| Statsmodels | Statsmodels Developers | 0.14 | Статистический анализ |
| Оперативная память (RAM) | Любой производитель | 32 GB или выше | Память |
| TensorBoard | 2.15 | Мониторинг обучения | |
| TensorFlow | 2.15 | Глубокое обучение | |
| Ubuntu Linux / Windows 11 | Canonical / Microsoft | 2.04 LTS / 1 | Операционная система |
| Visual Studio Code | Microsoft | Последняя стабильная версия | Разработка кода |
| XGBoost | XGBoost Developers | 2.1 | Градиентный бустинг |
Ссылки
- Acosta JN, Falcone GJ, Rajpurkar P, Topol EJ. Multimodal biomedical AI. Nat Med. 2022;28(9):1773-1784.
- Tang AS, et al. Harnessing EHR data for health research. Nat Med. 2024;30(7):1847-1855.
- Zhang A, Xing L, Zou J, Wu JC. Shifting machine learning for healthcare from development to deployment and from models to data. Nat Biomed Eng. 2022;6(11):1330-1345.
- Bera K, et al. Predicting cancer outcomes with radiomics and artificial intelligence in radiology. Nat Rev Clin Oncol. 2022;19(2):132-146.
- Wenderott K, Krups J, Zaruchas F, Weigl M. Effects of artificial intelligence implementation on efficiency in medical imaging—a systematic literature review and meta-analysis. NPJ Digit Med. 2024;7(1):265.
- Kaissis GA, Makowski MR, Rückert D, Braren RF. Secure, privacy-preserving and federated machine learning in medical imaging. Nat Mach Intell. 2020;2(6):305-311.
- He J, et al. The practical implementation of artificial intelligence technologies in medicine. Nat Med. 2019;25(1):30-36.
- Antoniadi AM, et al. Current challenges and future opportunities for XAI in machine learning-based clinical decision support systems: A systematic review. Appl Sci (Basel). 2021;11(11):5088.
- Samek W, et al. Explaining deep neural networks and beyond: A review of methods and applications. Proc IEEE. 2021;109(3):247-278.
- Holzinger A, et al. Causability and explainability of artificial intelligence in medicine. WIREs Data Min Knowl Discov. 2019;9(4).
- Markus AF, Kors JA, Rijnbeek PR. The role of explainability in creating trustworthy artificial intelligence for health care: A comprehensive survey of the terminology, design choices, and evaluation strategies. Nat Biomed Eng. 2021;5(9):996-1011.
- Arrieta AB, et al. Explainable Artificial Intelligence (XAI): Concepts, taxonomies, opportunities and challenges toward responsible AI. Inf Fusion. 2020;58:82-115.
- Selvaraju RR, et al. Grad-CAM: Visual explanations from deep networks via gradient-based localization [conference paper]. Presented at: IEEE International Conference on Computer Vision (ICCV); Venice, Italy; 2017:618-626. https://openaccess.thecvf.com/content_iccv_2017/html/Selvaraju_Grad-CAM_Visual_Explanations_ICCV_2017_paper.html
- Tonekaboni S, Joshi S, McCradden MD, Goldenberg A. What clinicians want: Contextualizing explainable machine learning for clinical end use. Nat Mach Intell. 2019;1(12):572-584.
- Sundararajan M, Taly A, Yan Q. Axiomatic attribution for deep networks [conference paper]. Presented at: 34th International Conference on Machine Learning; Sydney, Australia; 2017;70:3319-3328. https://proceedings.mlr.press/v70/sundararajan17a.html
- Ribeiro MT, Singh S, Guestrin C. “Why should I trust you?”: Explaining the predictions of any classifier [conference paper]. Presented at: 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining; San Francisco, CA; 2016:1135-1144.
- Desai S, Ramaswamy HG. Ablation-CAM: Visual explanations for deep convolutional network via gradient-free localization [conference paper]. Presented at: IEEE/CVF Winter Conference on Applications of Computer Vision (WACV); 2020:983-991.
- Belle V, Papantonis I. Principles and practice of explainable machine learning. Front Big Data. 2021;4:688969.
- Vilone G, Longo L. Notions of explainability and evaluation approaches for explainable artificial intelligence. Inf Fusion. 2021;76:89-106.
- Ali S, et al. Explainable artificial intelligence (XAI): What we know and what is left to attain trustworthy artificial intelligence. Inf Fusion. 2023;99:101805.
- Gundersen OE, Kjensmo S. State of the art: Reproducibility in artificial intelligence [conference paper]. Presented at: Thirty-Second AAAI Conference on Artificial Intelligence; New Orleans, LA; 2018:1644-1651. https://ojs.aaai.org/index.php/AAAI/article/view/11503
- Hutson M. Artificial intelligence faces reproducibility crisis. Science. 2018;359(6377):725-726.
- Pineau J, et al. Improving reproducibility in machine learning research: A report from the NeurIPS 2019 reproducibility program. J Mach Learn Res. 2021;22(164):1-20.
- U.S. Food and Drug Administration, Health Canada, Medicines and Healthcare products Regulatory Agency. Good Machine Learning Practice for Medical Device Development: Guiding Principles. 2021.
- Liu X, et al. Reporting guidelines for clinical trial reports for interventions involving artificial intelligence: The CONSORT-AI extension. Nat Med. 2020;26(9):1364-1374.
- Mongan J, Moy L, Kahn CE Jr. Checklist for Artificial Intelligence in Medical Imaging (CLAIM): A guide for authors and reviewers. Radiol Artif Intell. 2020;2(2).
- Peng RD. Reproducible research in computational science. Science. 2011;334(6060):1226-1227.
- Collins GS, et al. Protocol for development of the TRIPOD-AI and PROBAST-AI reporting and risk-of-bias tools for studies developing, validating, or updating prediction models based on artificial intelligence. BMJ Open. 2021;11.
- Kapoor S, Narayanan A. Leakage and the reproducibility crisis in machine-learning-based science. Patterns. 2023;4(9):100804.
- Wiens J, et al. Do no harm: A roadmap for responsible machine learning for health care. Nat Med. 2019;25(9):1337-1340.