Данный рабочий процесс объединяет массивную и одноклеточную транскриптомику с предварительными анализами тканей пациентов для приоритизации MMP1 при диабетической язве стопы. MMP1 продемонстрировал паттерн экспрессии, сосредоточенный на фибробластах, и более высокую концентрацию в тканях, что подтверждает связь с ремоделированием матрикса, при этом вопросы причинно-следственной связи и клинической значимости остаются нерешенными.
Исследовательская статья
Интегративный анализ транскриптомики всего образца и отдельных клеток с валидацией на тканях выявляет приоритетную роль MMP1 при диабетической стопе
* These authors contributed equally
В этой статье
Краткое содержание
Аннотация
Клеточные источники воспроизводимых транскриптомных изменений при язве диабетической стопы (ЯДС) остаются определенными не полностью. В данном исследовании были интегрированы анализ дифференциальной экспрессии, анализ сетей коэкспрессии генов, взвешенный по модулям (WGCNA), скрининг генов диабетической периферической нейропатии (ДПН), исследовательский отбор признаков с помощью машинного обучения, два внешних набора данных массового транскриптомного анализа, одноклеточный анализ, сетевой анализ традиционной китайской медицины (ТКМ), количественная полимеразная цепная реакция (qPCR) на тканях пациентов и вестерн-блоттинг. В наборе GSE199939 (10 образцов ЯДС и 11 контрольных образцов) было выявлено 3 691 дифференциально экспрессируемых гена, при этом «синий» модуль WGCNA был сильно ассоциирован с ЯДС (r = 0,97, p = 5 × 10-13). Пересечение дифференциально экспрессируемых генов, хабовых генов синего модуля и 1 062 генов, связанных с ДПН, позволило выделить 77 кандидатов. CCL7, CHEK1, MKI67, MMP1, MMP13 и TRPV2 были подтверждены как минимум двумя методами отбора признаков; полное разделение при рекурсивном исключении признаков методом опорных векторов вызвало опасения по поводу переобучения на когорте обнаружения. MMP1 продемонстрировал наибольшее изменение экспрессии в когорте обнаружения (log2 fold change = 9,854; скорректированный p = 1,24 × 10⁻²⁹). В объединенной матрице GSE68183/GSE80178 MMP1 имел скорректированный p = 0,0159 и площадь под ROC-кривой (AUC) = 0,981. В GSE134431 экспрессия MMP1 была номинально выше при ЯДС, чем в коже диабетической стопы без язв (p = 0,0225; скорректированный p = 0,135; AUC = 0,808). Анализ 69 944 клеток из 24 образцов показал самую высокую среднюю экспрессию MMP1 в фибробластах, при этом более высокая экспрессия на уровне образцов наблюдалась в фибробластах, кератиноцитах и эндотелиальных клетках при ЯДС. Анализы тканей пациентов показали более высокое содержание мРНК MMP1 в четырех парных образцах (парный тест по ΔCq, p = 3,04 × 10⁻⁵) и более высокое содержание белка в трех парных образцах (парный p = 0,0107). Статистическая репликация была неполной. Полученные данные указывают на ассоциацию с ремоделированием матрикса, центрированную на фибробластах, с учетом ограничений, связанных с использованием данных TPM (транскриптов на миллион) в анализе обнаружения на основе подсчетов, неполными записями предварительной обработки одноклеточных данных и малыми когортами анализа тканей. Причинно-следственная связь и клиническая значимость остаются не установленными.
Введение
Диабетическая язва стопы представляет собой тяжелое и рецидивирующее осложнение сахарного диабета, которое возникает в результате сочетания нейропатии, повторяющейся механической нагрузки, заболеваний периферических артерий, предрасположенности к инфекциям и нарушения регенерации тканей. Согласно современным оценкам, миллионы людей во всем мире ежегодно страдают от этого заболевания; заживление часто затягивается, что сопряжено со значительными рисками рецидива, госпитализации, ампутации нижних конечностей и летального исхода1. Таким образом, профилактика и лечение зависят не только от местного ухода за раной, но и от выявления потери защитной чувствительности, снижения подошвенного давления, лечения инфекции и ишемии, а также коррекции системных факторов риска1,2. Диабетическая периферическая нейропатия имеет особое значение, поскольку прогрессирующая сенсорная дисфункция может снизить чувствительность к давлению, травмам и повреждениям тканей, в то время как двигательные и вегетативные нарушения могут дополнительно изменить биомеханику стопы и целостность кожи2,3. На уровне тканей нейропатическое повреждение может сосуществовать с нейровоспалением, микрососудистой дисфункцией, метаболическим стрессом и дефектной репарацией, что создает среду раны, в которой повреждение сохраняется, несмотря на стандартную терапию1,3.
Успешное заживление кожи требует скоординированного воспаления, реэпителизации, ангиогенеза, активации фибробластов, отложения внеклеточного матрикса (ВКМ) и последующего ремоделирования матрикса. При диабете эти процессы могут стать временно дезорганизованными: воспалительные сигналы могут оставаться активными, миграция кератиноцитов может быть нарушена, эндотелиальные ответы могут быть недостаточными, а фибробласты могут вырабатывать или организовывать аномальный матрикс. Фибробласты играют центральную роль в стромальной фазе восстановления, поскольку они синтезируют белки матрикса, регулируют архитектуру коллагена, взаимодействуют с иммунными и эпителиальными клетками и способствуют сокращению раны. Исследования с использованием фибробластов из диабетических язв стопы (DFU), полученных от пациентов, выявили стойкие отклонения в транскрипции, связанной с ВКМ, и в сборке матрикса, что подтверждает мнение о том, что состояние фибробластов является важным компонентом биологии хронических ран4. Матриксные металлопротеиназы (MMP) участвуют в этом процессе, расщепляя субстраты ВКМ и обеспечивая миграцию клеток, обновление тканей и ремоделирование; однако их эффекты зависят от локализации, времени, доступности субстрата и регуляции тканевыми ингибиторами металлопротеиназ (TIMP)5. Таким образом, дисбаланс между протеолизом и замещением матрикса может быть связан с нарушением восстановления, но повышенная экспрессия отдельной MMP сама по себе не определяет вредную или благоприятную роль. Было сообщено, что матриксная металлопротеиназа 1 (MMP1), интерстициальная коллагеназа, способная участвовать в обмене фибриллярного коллагена, изменена в тканях DFU, а предыдущие клинические исследования связали профили MMP/TIMP с состоянием раны или траекториями заживления6,7. Эти наблюдения обосновывают необходимость дальнейшего изучения MMP1 при DFU.
Транскриптомное профилирование обеспечивает систематический подход к выявлению молекулярных программ, связанных с диабетической язвой стопы (ДЯС), однако ряд методологических ограничений затрудняет интерпретацию данных. Наборы данных общего анализа тканей (bulk-tissue datasets) усредняют сигналы кератиноцитов, фибробластов, эндотелиальных клеток, иммунных клеток и других компонентов, что затрудняет определение того, отражает ли конкретный кандидат-маркер изменение экспрессии внутри определенного типа клеток, сдвиг в клеточном составе или и то, и другое. Сопоставимость различных наборов данных также может быть снижена из-за различий в платформах, стратегиях нормализации, местах забора проб тканей, степени тяжести язвы, наличии инфекции, стадии заболевания и контрольной ткани. Важно отметить, что неязвенная кожа стопы при диабете представляет собой клинически значимый компаратор диабетической ткани, но не является взаимозаменяемой со здоровой кожей. Секвенирование РНК отдельных клеток позволяет частично решить проблему определения клеточного источника за счет разделения гетерогенных популяций клеток и их транскрипционных состояний. Предыдущее исследование ДЯС с использованием одноклеточного и пространственного транскриптомного анализа позволило выявить отдельные популяции фибробластов и продемонстрировало, что программы фибробластов различаются в зависимости от контекста раны и статуса заживления8. Эти результаты обосновывают использование анализа с разрешением до отдельной клетки для дополнения данных общего транскриптомного анализа.
Методы отбора признаков могут помочь в приоритизации кандидатов на основе многомерных данных экспрессии, однако биомедицинские исследования с малым объемом выборки особенно подвержены завышенным оценкам и нестабильному выбору генов. Когда количество измеряемых переменных значительно превышает количество биологических образцов, может возникнуть кажущееся идеальное разделение даже при ограниченности обобщаемой прогностической информации. Повторное использование одних и тех же наблюдений для отбора признаков, настройки параметров и оценки эффективности приводит к дальнейшему завышению AUC, что делает вложенную перекрестную проверку, «заблокированные» модели и действительно независимые тестовые когорты необходимыми для оценки прогностической способности9,10. Эти проблемы актуальны для исследований DFU, так как общедоступные когорты часто малы и неоднородны. Базы данных компонентов, мишеней и трав традиционной китайской медицины дополнительно использовались только для генерации гипотез.
В данном исследовании были интегрированы методы общего транскриптомного анализа, WGCNA, скрининга генов, связанных с DPN, отбора признаков с помощью машинного обучения, оценки на внешних наборах данных, одноклеточного анализа, сетевого анализа TCM и валидации на тканях пациентов. Гены-кандидаты, выявленные в открывательной когорте, оценивались на дополнительных транскриптомных наборах данных, а ведущий кандидат был локализован в конкретных типах клеток с использованием данных одноклеточного анализа. Затем экспрессия MMP1 на уровнях мРНК и белка в тканях пациентов изучалась с помощью qPCR и вестерн-блоттинга. Данная схема была разработана для выявления воспроизводимого кандидата, связанного с DFU, и характеристики его клеточного и биологического контекста.
Протокол
Дизайн исследования и источники данных
Исследование, включая сбор и использование образцов тканей пациентов для валидации методами qPCR и вестерн-блоттинга, было рассмотрено и одобрено Комитетом по этике Четвертой больницы Уханя (номер одобрения KY2024-161-01). Все процедуры с использованием тканей человека проводились в соответствии с утвержденным протоколом и применимыми этическими принципами. В транскриптомной части исследования использовались общедоступные деидентифицированные наборы данных. От всех участников, чьи образцы тканей использовались для экспериментальной валидации, было получено письменное информированное согласие. Общедоступные транскриптомные наборы данных анализировались в деидентифицированном виде; процедуры получения согласия для исследований, в которых генерировались исходные данные, осуществлялись соответствующими учреждениями.
В данном исследовании были интегрированы методы общего транскриптомного анализа, сетевого анализа, отбора признаков, анализа единичных клеток, прогнозирования сетей традиционной китайской медицины (TCM) и валидации на тканях пациентов. Когорта для поиска включала набор данных Gene Expression Omnibus (GEO) GSE199939 (10 образцов DFU и 11 контрольных образцов). Внешняя общая транскриптомная оценка включала объединенную матрицу GSE68183/GSE80178 (9 образцов DFU и 6 контрольных образцов), а также GSE134431 (13 образцов DFU и 8 образцов кожи стопы при сахарном диабете без изъязвлений [DFS]). Для анализа единичных клеток использовался предварительно обработанный объект Seurat с аннотацией SingleR, полученный из GSE165816 и содержащий 69 944 клетки из 24 образцов (14 DFU и 10 контрольных). Оценка тканей включала четыре пары соответствующих образцов DFU и перивульнарной области одного и того же пациента для qPCR и три соответствующие пары для вестерн-блоттинга, на основании восстановленных протоколов анализа и подтвержденного авторами сопоставления. Все материалы и оборудование, использованные в данном исследовании, перечислены в Таблице материалов.
Формирование набора генов, связанных с DPN
Гены, связанные с DPN, были получены из базы данных генов Национального центра биотехнологической информации (NCBI) с помощью rentrez. Поисковые запросы включали «diabetic peripheral neuropathy», «diabetic neuropathy», «diabetic polyneuropathy», «painful diabetic neuropathy» и «diabetic sensorimotor polyneuropathy», ограниченные видом Homo sapiens. Полученные идентификаторы были сопоставлены с официальными символами генов, переведены в верхний регистр, очищены и дедуплицированы. Гены, полученные из базы данных, были объединены с курируемым по литературе списком генов DPN и дедуплицированы, в результате чего было получено 1 062 гена, связанных с DPN. Полные строки поиска и код очистки идентификаторов включены в сопровождающие скрипты; они также включают диабетическую нейропатию, сочетание диабета с дистальной симметричной полинейропатией или периферической нейропатией, а также термин MeSH «Diabetic Neuropathies». Компонент, полученный из литературы, по-прежнему требует подтверждения происхождения на уровне цитирования.
Предварительная обработка когорты открытия и анализ дифференциальной экспрессии
Матрица экспрессии GSE199939 была сопоставлена с таблицей фенотипов по идентификатору образца. Дублирующиеся идентификаторы генов были сделаны уникальными. В архивном первичном анализе значения экспрессии были округлены, и была применена модель отрицательного биномиального распределения с использованием DESeq2 (версия 1.48.2), где в качестве фактора дизайна выступала группа, а в качестве контраста — DFU в сравнении с контролем. Гены с отсутствующими скорректированными значениями p были исключены. Контроль множественного тестирования осуществлялся с помощью процедуры Бенджамини–Хохберга (BH). В архивном списке дифференциально экспрессируемых генов (DEG) использовались абсолютное значение log2 кратности изменения более 1 и скорректированное по BH значение p < 0,05. Сравнение с открытым источником GEO подтвердило, что входными данными были TPM, а не необработанные количества чтений (raw read counts). Округление TPM не соответствует требованию DESeq2 к использованию необработанных количеств чтений. Оригинальные оценки сохранены, однако достоверность статистики первичного анализа, а также зависимых результатов WGCNA и отбора признаков остается неопределенной до проведения соответствующего повторного анализа. Сравнение источников задокументировано в дополнительном архиве.
Для визуализации применялось преобразование стабилизации дисперсии (VST) пакета DESeq2 с параметром blind = FALSE. Анализ главных компонентов (PCA) проводился на основе матрицы экспрессии после VST. Для тепловой карты использовалось построчное z показатели для 50 генов с наименьшими скорректированными значениями p значения. При реализации метода главных компонент (PCA) преобразованные значения были центрированы и масштабированы по генам с использованием функции prcomp с параметром scale = TRUE.
Взвешенный анализ сетей коэкспрессии генов
Для WGCNA были отобраны гены, количество чтений которых превышало 5 как минимум в трех образцах GSE199939. Факторы размера были рассчитаны с помощью DESeq2, применено VST с параметром blind = TRUE, и были выбраны 5 000 генов с наибольшей вариабельностью между образцами. Качество образцов и генов оценивалось с помощью функции goodSamplesGenes, а для оценки качества на уровне образцов использовалась иерархическая кластеризация с использованием метода средней связи.
Подписанная сеть была сконструирована с помощью WGCNA (версия 1.74). Кандидатные значения степеней от 1 до 10 и от 12 до 30 с шагом 2 были оценены с помощью pickSoftThreshold; целевое значение соответствия безмасштабной топологии составило 0.85, и выбранная степень мягкого порога составила 18. Модули были идентифицированы с помощью blockwiseModules с использованием подписанной матрицы смежности и подписанной матрицы топологического перекрытия, корреляции Пирсона, минимального размера модуля 30, высоты слияния (merge cut height) 0.25, порога переназначения 1 × 10⁻⁶, pamRespectsDendro = FALSE и максимального размера блока 10 000.
Собственные гены модулей коррелировали с бинарным признаком DFU. Несерые модули с |r| > 0,5 и p < 0,05 считались связанными с DFU. Для каждого связанного модуля значимость гена (GS) определялась как корреляция Пирсона между экспрессией гена и статусом DFU, а принадлежность к модулю (MM) — как корреляция Пирсона между экспрессией гена и соответствующим собственным геном модуля. Хаб-гены определялись по критериям |MM| > 0,8 и |GS| > 0,5. Для дальнейшего анализа был выбран синий модуль, который показал наиболее сильную положительную связь с DFU. Его хаб-гены были пересечены с дифференциально экспрессируемыми генами (DEGs) и набором генов, связанных с DPN. Таким образом, указанный порог для хаб-генов использует абсолютные значения как MM, так и GS, независимо от знака корреляции.
Приоритизация признаков на основе машинного обучения
77 генов, общих для наборов дифференциально экспрессируемых генов (DEG), хаб-генов синего модуля и генов, связанных с DPN, были проанализированы в наборе данных GSE199939. Дубликаты символов генов объединялись путем вычисления среднего значения их экспрессии. Матрица генов-кандидатов подвергалась log2-преобразованию в случаях, когда максимальное значение превышало 50; признаки с нулевой дисперсией удалялись, а оставшиеся признаки стандартизировались. Использовалось случайное число (seed) 123. Реализованная последовательность действий включала скрининг кандидатов по всей когорте, объединение дублирующихся символов, условное логарифмическое преобразование, фильтрацию по нулевой дисперсии, центрирование и масштабирование по всей когорте, а также выбор признаков специфичный для конкретного алгоритма. Скрининг DEG и WGCNA проводился на полной когорте открытия до перекрестной проверки на уровне алгоритма. Таким образом, описанный рабочий процесс не обеспечивает вложенную валидацию без утечки данных, и его внутренние показатели AUC не могут быть использованы в качестве несмещенных оценок прогностической эффективности.
Было применено три процедуры отбора признаков. Во-первых, была выполнена логистическая регрессия методом LASSO (least absolute shrinkage and selection operator) с помощью пакета glmnet (версия 5.0) с использованием биномиального семейства, alpha = 1, ошибки классификации в качестве меры перекрестной проверки, без дополнительной стандартизации и пятикратной перекрестной проверки с ограничением по размеру меньшего класса. Были выбраны признаки при lambda.1se; lambda.min использовался только в том случае, если при lambda.1se не был выбран ни один ген. Во-вторых, с помощью пакета randomForest (версия 4.7-1.2) был построен случайный лес из 1 000 деревьев; были сохранены гены, у которых среднее снижение индекса Джини было не меньше среднего значения значимости среди всех генов-кандидатов. В-третьих, было реализовано рекурсивное исключение признаков с помощью линейного метода опорных векторов (SVM-RFE) с использованием пакета e1071 (версия 1.7-17), при котором признаки ранжировались по квадрату линейного веса на всей когорте перед оценкой последовательно уменьшающихся подмножеств признаков по значению AUC при перекрестной проверке с исключением по одному объекту (LOOCV). Ранжирование не пересчитывалось внутри каждой обучающей выборки. При подгонке линейного SVM использовались параметры scale = FALSE и probability = TRUE без явной сетки настройки стоимости. Выбор штрафа LASSO осуществлялся с помощью внутренней перекрестной проверки без отдельного внешнего цикла оценки, а значимость в случайном лесу рассчитывалась на основе всей когорты.
Ни один ген не был выбран всеми тремя методами; следовательно, были оставлены гены, подтвержденные как минимум двумя методами. Метод SVM-RFE обеспечил значение AUC 1,00 для всех оцениваемых размеров подмножеств, и было выбрано наименьшее из них с таким же показателем. Поскольку такое полное разделение вызвало опасения по поводу переобучения и завышенной оценки в небольшой обнаружительской когорте, значение AUC для SVM-RFE не интерпретировалось как оценка клинической эффективности. Никакая фиксированная мультигенная модель не тестировалась на внешней когорте; экспрессия отдельных генов-кандидатов оценивалась с помощью внешнего анализа рабочих характеристик приемника (ROC). Проверка скрипта анализа подтвердила, что предварительная обработка и ранжирование признаков SVM не были ограничены обучающими выборками. Одни и те же результаты LOOCV использовались для выбора размера подмножества без внешнего цикла оценки. Следовательно, данный рабочий процесс содержит утечку данных и служит только для предварительного определения приоритетности признаков.
Анализ функционального обогащения
Для панели из шести генов были проведены анализы гиперпредставленности Gene Ontology (GO) и Kyoto Encyclopedia of Genes and Genomes (KEGG). Символы генов были сопоставлены с идентификаторами Entrez с помощью org.Hs.eg.db (версия 3.21.0). Анализ GO проводили с использованием clusterProfiler (версия 4.16.0) по онтологиям биологических процессов, клеточных компонентов и молекулярных функций. Для обогащения KEGG использовался код организма человека (hsa). Значимыми считались термины с номинальным p < 0.05 и скорректированным по методу BH p < 0.05. Поскольку в анализ было включено всего шесть генов, анализ обогащения использовался преимущественно для функциональной аннотации. В скрипте KEGG использовались локальные аннотации KEGG.db с функцией enrichKEGG(use_internal_data = TRUE); выпуск аннотации должен быть задокументирован. В скриптах GO и KEGG не был задан пользовательский набор генов (universe), поэтому в качестве фоновых значений использовались базы данных аннотаций по умолчанию.
Внешняя оценка общего транскриптома
Для объединенной матрицы GSE68183/GSE80178 символы генов были стандартизированы, а дублирующиеся символы объединены путем вычисления среднего значения экспрессии по соответствующим строкам. Шесть генов-кандидатов были сопоставлены с файлом фенотипов. Поскольку имеющиеся файлы не полностью документировали процедуру предварительного объединения и коррекции пакетного эффекта, этот набор данных анализировался в предоставленном виде и интерпретировался с осторожностью. Следовательно, на основании предоставленного протокола обработки невозможно подтвердить ни удаление пакетных эффектов, ни независимость группового сигнала от эффектов конкретных исследований. Данная матрица служит для предварительного подтверждения данных между наборами данных, а не для окончательной репликации.
Для GSE134431 шесть генов-кандидатов были извлечены из матрицы количества прочтений на килобазу на миллион картированных прочтений (RPKM) и преобразованы как log2(RPKM + 1). В качестве контрольной группы использовалась DFS, а в качестве сравнительной — DFU. DFS представляет собой кожу стопы при сахарном диабете без изъязвлений. На первоначальном Рисунке 4C были отложены исходные значения RPKM; на пересмотренной панели используется указанная шкала log2(RPKM + 1). Двусторонние критерии Вилкоксона с нормальной аппроксимацией и поправкой на непрерывность, а также автоматически ориентированные ROC-анализы были проверены по обеим шкалам и дали идентичные значения p и AUC, так как данное преобразование является строго монотонным.
В каждом наборе данных для массовой валидации различия в экспрессии между группами оценивали с помощью двухстороннего критерия суммы рангов Вилкоксона, а для шести генов применяли поправку BH. ROC-кривые рассчитывали с помощью pROC (версия 1.19.0.1), используя направление, выбранное пакетом автоматически. Для сравнения дискриминационных паттернов в разных наборах данных рассчитывали AUC и соответствующие 95% доверительные интервалы (CI). Автоматический выбор направления ROC для каждого набора данных может привести к оптимистичной оценке дискриминации; данные значения AUC для отдельных генов носят описательный характер и не служат валидацией заранее определенной модели клинического прогнозирования.
Локализация на уровне отдельных клеток и анализ на уровне образца
Для анализа единичных клеток использовался сохраненный объект Seurat biofsci_SingleR_annotated_MMP1_analyzed.rds из набора GSE165816, содержащий 22 889 генов и 69 944 клетки в анализе RNA. В анализе RNA был сохранен слой неотрицательных целочисленных подсчетов и слой данных, созданный с помощью LogNormalize с коэффициентом масштабирования 10 000 с последующим преобразованием log1p; последний не являлся TPM. Объект содержал 2 000 вариабельных генов, отобранных методом vst (loess.span = 0.3; 20 интервалов равной ширины), масштабированную экспрессию для всех сохраненных генов (центрирование и масштабирование включены; scale.max = 10) и 50 главных компонентов, рассчитанных на основе вариабельных признаков с seed 42. В сохраненной истории команд для построения ближайших соседей и аппроксимации и проекции многообразий (UMAP) использовались размерности Harmony с 1 по 20. Параметры соседей включали k = 20, Annoy с 50 деревьями и евклидовым расстоянием, а также порог отсечения общих ближайших соседей (SNN) 1/15. Для кластеризации использовались разрешение 0.8, алгоритм 1, n.start = 10, n.iter = 10 и random.seed = 0. Для UMAP использовалась реализация uwot, 30 соседей, две выходные размерности, метрика косинусного расстояния, min.dist = 0.3, spread = 1, learning.rate = 1 и seed 42. Объект сохранил редукцию Harmony, однако исходные пороги контроля качества, полный вызов RunHarmony, включая ковариаты пакетов, а также настройки референса и аннотации SingleR для этого проанализированного объекта восстановить не удалось. Метки типов клеток, метки групп и идентификаторы образцов хранились в SingleR_label, Group и orig.ident соответственно. Было сохранено десять аннотированных типов клеток: B-клетки, CD8+ T-клетки, эндотелиальные клетки, эпителиальные клетки, фибробласты, гемопоэтические стволовые клетки, кератиноциты, макрофаги, моноциты и нейроны.
MMP1 экспрессия была обобщена по типам клеток. Клетки с нормализованной экспрессией MMP1 более нуля классифицировались как MMP1-положительные. Для анализа на уровне образцов для каждой комбинации «образец — тип клеток» рассчитывалась средняя нормализованная экспрессия. Образцы с DFU и контрольные образцы сравнивались внутри каждого типа клеток с помощью двухстороннего рангового суммарного критерия Вилкоксона с последующей поправкой BH для всех протестированных типов клеток. В качестве единицы в данных сравнениях использовался номер доступа образца в GEO, а не отдельная клетка. 24 номера доступа не рассматривались как доказательство наличия 24 независимых доноров. Сохраненный объект не содержал проверенного идентификатора донора, и повторный забор тканей у доноров не моделировался; следовательно, тесты на уровне образцов интерпретируются как предварительные. В данных обобщениях приведено среднее значение нормализованной экспрессии внутри образца и типа клеток; они не являются моделями дифференциальной экспрессии в псевوبалке (pseudobulk) на основе суммы подсчетов.
Для десяти наборов функциональных генов были рассчитаны баллы с помощью функции Seurat AddModuleScore. Были вычислены корреляции Спирмена между экспрессией MMP1 в каждой клетке и баллами модулей с последующей поправкой по методу Бенджамина-Хохберга (BH). Для эксплораторного анализа группы с высокой экспрессией MMP1 были выбраны три типа клеток с наиболее высоким средним уровнем экспрессии MMP1 среди типов клеток, содержащих не менее 50 клеток. Глобальный порог определялся как медиана экспрессии среди MMP1-положительных клеток, если количество таких клеток превышало 10; в противном случае скрипт использовал общий 75-й процентиль. Клетки с экспрессией выше этого порога были отнесены к группе MMP1-high, а остальные — к группе MMP1-low. Для функции FindMarkers использовался критерий Вилкоксона, logfc.threshold = 0.25 и min.pct = 0.1. Гены с повышенной экспрессией и скорректированным значением p < 0.05 были подвергнуты анализу обогащения биологических процессов GO. Поскольку группы были определены по экспрессии MMP1, данный анализ использовался для описания путей, связанных с состоянием MMP1-high. Поклеточные корреляции, их скорректированные значения p и результаты обогащения MMP1-high по сравнению с MMP1-low носят описательный характер, так как зависимость внутри образца не моделировалась. Отдельные клетки не интерпретировались как независимые биологические повторности.
Предсказание связей «ингредиент — мишень — лекарственное растение» в традиционной китайской медицине
Шесть приоритетных генов были сопоставлены со столбцом 4 локальной таблицы взаимодействий «химическое вещество — ген» базы данных Comparative Toxicogenomics Database (CTD). В столбце 7 записи были ограничены видом Homo sapiens. Названия ингредиентов были обрезаны и приведены к нижнему регистру для сопоставления, а дубликаты связей «ингредиент — мишень» и «трава — ингредиент» были удалены. Ингредиенты были связаны с травами с помощью справочной таблицы «трава — ингредиент». Для обогащения базы данных использовались номинальное значение p < 0.05 и скорректированное p < 0.05. Дубликаты записей «трава — ингредиент — мишень» были удалены перед проведением суммирования на основе охвата. Для анализа обогащения трав использовалась функция clusterProfiler::enricher с сопоставлением «трава — ингредиент» в качестве TERM2GENE, параметрами minGSSize = 1, maxGSSize = 500, pvalueCutoff = 1 и qvalueCutoff = 1 перед применением номинальных и скорректированных по методу Бенджамини-Хохберга (BH) порогов значимости. Данные связи в базе данных могут описывать изменения экспрессии или активности и не устанавливают прямого связывания или единого направления эффекта.
Рейтинг трав был определен с использованием следующего показателя охвата:
S = 3R + 5L +2T + 3C + 2I + N (1)
Здесь R — количество записей MMP1, L — число ингредиентов, связанных с MMP1, T — число охваченных мишеней, C — количество основных ингредиентов, I — индикатор осей матрицы, а N — общее количество ингредиентов.
Основными ингредиентами были кверцетин, лютеолин и берберин. Индикатор оси матрицы устанавливался в значение 1, если растение воздействовало и на MMP1, и на MMP13, и в значение 0 в противном случае. Для включения в список потенциальных растений требовалось наличие как минимум одной записи, связанной с MMP1, и либо как минимум двух ингредиентов, связанных с MMP1, либо как минимум четырех мишеней плюс один основной ингредиент. Полученный балл использовался для обобщения охвата базы данных и не рассматривался как показатель фармакологической эффективности. Коэффициенты определяют пользовательское эвристическое правило охвата, в котором особое внимание уделяется записям и ингредиентам, связанным с MMP1, более широкому охвату мишеней, трем назначенным ингредиентам и совместному охвату MMP1/MMP13. Данные коэффициенты не были подогнаны под клинические результаты или подтверждены экспериментально, и использование альтернативных весов могло бы изменить рейтинг растений.
Сбор тканей пациентов и предварительная оценка методом кПЦР и вестерн-блоттинга
Пациенты с клинически диагностированными диабетическими язвами стопы, которым в больнице Ухань Fourth Hospital были проведены показанные клинически дебридмент или хирургическая операция, были включены в исследование при условии доступности тканей стопы и получения письменного информированного согласия. Критериями исключения являлись наличие злокачественного новообразования в месте забора проб, недиабетическая причина возникновения язвы, а также недостаточное количество или качество ткани для запланированных анализов. Ткани диабетической язвы стопы (DFU) и неязвенные ткани, окружающие рану, были получены от одного и того же пациента в соответствии с утвержденным протоколом исследования. Последние служили подходящим периwound-компаратором; при этом они не являлись здоровой кожей пациента без диабета. Анализ методом qPCR включал четыре подходящие пары (четыре образца DFU и четыре соответствующих периwound-образца), а вестерн-блоттинг включал три подходящие пары. Соответствие пар было подтверждено авторами для каждого анализа; идентичность между разными анализами не использовалась при статистических сравнениях. Биологической единицей считался каждый пациент, а технические лунки ПЦР представляли собой повторные измерения внутри одного образца. Эти предварительные анализы были направлены на оценку экспрессии MMP1 на уровне тканей и не были предназначены для установления диагностической эффективности, причинно-следственной связи или обобщаемости результатов для различных фенотипов DFU.
Для валидации методом qPCR общую РНК экстрагировали из образцов тканей пациентов, полученных от пациентов, используя реагент для экстракции общей РНК в соответствии с инструкциями производителя. Концентрацию и чистоту РНК оценивали спектрофотометрически; для последующих анализов использовали образцы с соотношением A260/A280 от 1,8 до 2,1. Обратную транскрипцию общей РНК (1 µg) проводили с использованием набора для обратной транскрипции на основе вируса лейкоза мышей Молони (M-MLV) в конечном объеме реакции 20 µL. В доступном проекте прибора указана система ПЦР в реальном времени. Количественную ПЦР проводили с использованием 2x SYBR Green PCR master mix в реакции объемом 20 µL, содержащей 10 µL 2x SYBR Green master mix, по 0,4 µL прямого и обратного праймеров, 2 µL комплементарной ДНК (cDNA) и 7,2 µL воды, свободной от нуклеаз. Программа амплификации состояла из начальной денатурации при 95 °C в течение 30 s, после чего следовали 40 циклов: 95 °C в течение 5 s и 60 °C в течение 30 s. Для проверки специфичности амплификации проводили анализ кривых плавления. Обилие транскриптов MMP1 измеряли с использованием β-актина (ACTB) в качестве референсного гена. Последовательности праймеров приведены в Таблице 1. Для пересмотренного парного анализа значения пяти технических лунок на одну мишень в каждом образце усреднялись перед расчетом ΔCq, а относительная экспрессия MMP1 рассчитывалась с помощью метода 2-ΔΔCq , где в качестве калибратора использовалась группа неязвенной перивульварной ткани. Восстановленные пары образцов составили NC–DFU, NC1–DFU1, NC2–DFU2 и NC3–DFU3, что было подтверждено авторами как четыре пары, сопоставленные по пациентам. На предыдущем графике qPCR использовались значения пяти технических лунок только для NC и DFU; на пересмотренном графике показано одно значение на уровне образца после усреднения технических лунок для каждой из четырех пар. Для парного вывода использовалось значение ΔCq = среднее Cq(MMP1) − среднее Cq(ACTB), а не значения кратности изменения на уровне лунок. Данные в архивном проекте прибора также отличаются от зарегистрированного объема реакции и программы циклирования, и соответствие этого проекта представленному эксперименту остается неустановленным.
Для валидации методом вестерн-блоттинга (WB) образцы тканей гомогенизировали в ледяном буфере для радиоиммунопреципитационного анализа с добавлением ингибиторов протеаз. Лизаты инкубировали на льду в течение 30 мин и центрифугировали при 12,000 x g в течение 15 мин при 4 °C. Супернатанты собирали, и концентрацию белка определяли с помощью бицинхонинового метода. Равные количества белка (20 µg на лунку) разделяли на градиентных 4%–20% полиакриламидных гелях с додецилсульфатом натрия и переносили на поливинилиденфторидные мембраны с размером пор 0.22 µm. Мембраны блокировали 5% раствором обезжиренного молока в трис-солевом буфере, содержащем 0.1% Tween-20, в течение 1 ч при комнатной температуре и инкубировали в течение ночи при 4 °C с поликлональными антителами к MMP1 (1:1,000) и кофилину (1:6,000). После трехкратной промывки трис-солевым буфером, содержащим 0.1% Tween-20, мембраны инкубировали с козьими антителами против кроличьего иммуноглобулина G (IgG), конъюгированными с пероксидазой хрена (1:5,000), в течение 1 ч при комнатной температуре. Полосы белков визуализировали с помощью усиленного хемилюминесцентного субстрата и регистрировали на системе хемилюминесцентного анализа с использованием соответствующего программного обеспечения (версия 1.2.0), что зафиксировано в метаданных изображений. Количественную оценку полос проводили с помощью программного обеспечения ImageJ. Кофилин использовали в качестве контроля загрузки, а содержание белка MMP1 нормировали по кофилину для межгруппового сравнения.
Статистический анализ и программное обеспечение
Все тесты были двусторонними, если не указано иное. В качестве основного порога для множественного тестирования использовалось значение p < 0,05 с поправкой Бенджамина-Хохгана (BH). Точный размер выборки варьировался в зависимости от набора данных, а для анализа образцов на уровне отдельных клеток — в зависимости от наличия определенного типа клеток в каждом образце. Сводные данные по непрерывной экспрессии представлены в виде отдельных наблюдений с диаграммами размаха (boxplots), отображающими медиану и межквартильный размах; «усы» простираются на 1,5 межквартильный размаха. Для вестерн-блоттинга шесть полученных соотношений MMP1 к кофилину были проанализированы с помощью двустороннего парного t-критерия для трех подтвержденных авторами пар пациентов (df = 2; p = 0,0107). Для кПЦР пять значений Cq для ACTB и пять значений Cq для MMP1 усреднялись отдельно внутри каждого образца перед расчетом ΔCq. Двусторонний парный t-критерий использовался для сравнения значений ΔCq в DFU и соответствующих перифокальных зонах для четырех подтвержденных авторами пар пациентов (df = 3; p = 3,04 × 10⁻⁵). Среднее значение ΔCq перифокальной зоны использовалось в качестве общего калибратора для отображения относительной экспрессии. Геометрическое среднее кратности изменения (fold change) внутри пациента и его 95% ДИ были получены путем обратного преобразования среднего парного различия ΔCq и его ДИ на основе t-критерия. Отдельные биологические наблюдения показаны линиями, соединяющими соответствующие ткани; технические лунки не увеличивают размер биологической выборки. Значения p для анализа тканей являются номинальными и исследовательскими. При наличии трех или четырех пациентов нормальность парных различий не может быть надежно оценена, и результаты анализов остаются предварительными. Биоинформатический анализ и построение графиков выполнялись в R 4.5.2 на Windows 11. Версии основных пакетов включали DESeq2 1.48.2, WGCNA 1.74, glmnet 5.0, randomForest 4.7-1.2, e1071 1.7-17, pROC 1.19.0.1, clusterProfiler 4.16.0, Seurat 5.5.0, SingleR 2.10.0, rentrez 1.2.4 и ggplot2 4.0.3. Сводный перечень программного обеспечения, баз данных и параметров представлен в Дополнительной таблице 1.
Результаты
Первичный транскриптомный анализ выявляет обширную программу экспрессии, связанную с DFU
В качестве когорты для первичного анализа использовался набор данных GSE199939, который включал 10 образцов с диабетической язвой стопы (DFU) и 11 контрольных образцов (Рисунок 1A). Анализ главных компонентов экспрессии, нормализованной с помощью VST, показал четкое разделение групп; главные компоненты 1 и 2 объясняли 34,8% и 15,1% общей дисперсии соответственно (Рисунок 1B).
При использовании критериев |log2 fold change| > 1 и скорректированного по методу Бенджамини-Хохберга (BH) p < 0.05, анализ дифференциальной экспрессии выявил 3 691 дифференциально экспрессируемый ген (DEG), включая 1 247 генов с повышенной экспрессией при диабетической язве стопы (DFU) и 2 444 гена с пониженной экспрессией при DFU (Рисунок 1C). Топ-50 DEG сформировали четко выраженный групповой паттерн экспрессии (Рисунок 1D). Среди шести впоследствии отобранных генов MMP1 продемонстрировал наибольшее изменение в открывающей когорте (log2 fold change = 9.854; adjusted p = 1.24 × 10⁻²⁹).
Модуль ко-экспрессии, связанный с СДУ, пересекается с дифференциально экспрессируемыми генами (ДЭГ) и генами, связанными с ДПН
WGCNA была выполнена для 5 000 наиболее вариабельных генов после VST-преобразования. Для знаковой сети была выбрана мягкая мощность порога, равная 18, что обеспечило баланс между соответствием безмасштабной топологии и связностью (Рисунок 2A). С помощью иерархической кластеризации и динамического обнаружения модулей было выявлено несколько модулей коэкспрессии (Рисунок 2B). Синий модуль имел наиболее сильную положительную связь с DFU (Pearson r = 0.97, p = 5 × 10-13; Рисунок 2C). Соответствующие сводные данные контроля качества кластеризации образцов и размера модулей представлены на Дополнительном рисунке 1A,B.
В синем модуле 689 генов соответствовали критериям хабов |MM| > 0,8 и |GS| > 0.5 (Рисунок 2D). Пересечение 3 691 ДЭГ (дифференциально экспрессируемых генов), 689 хабовых генов синего модуля и 1 062 генов, связанных с DPN, позволило выявить 77 общих генов-кандидатов (Рисунок 2E). На рисунке представлены разреженное представление сети хабов синего модуля и статистика хабов с наивысшим рангом в Дополнительный рисунок 2A,B.
Многометодологический отбор признаков позволяет выделить шесть приоритетных генов, однако выявляет переобучение на когорте открытия
77 пересекающихся генов были проанализированы с помощью методов LASSO, случайного леса (random forest) и SVM-RFE. Метод LASSO при выбранном значении штрафа выявил семь генов: MMP1, MMP13, TRPV2, CCL7, AURKA, MKI67 и CHEK1 (Рисунок 3A). Фильтрация методом случайного леса позволила оставить 41 ген, значимость которых была равна или превышала среднее значение, при этом пять членов итоговой панели оказались среди наиболее высокоранжированных признаков (Рисунок 3B). Метод SVM-RFE показал AUC 1,00 для каждого оцениваемого вложенного подмножества; согласно правилу выбора минимального размера при равенстве показателей, CHEK1 был выбран в качестве подмножества из одного гена (Рисунок 3C), что вызывает опасения относительно переобучения и оптимистичной оценки в открывающей когорте. Соответствующие данные по экспрессии в открывающей когорте, тепловая карта и ROC-кривые представлены на Дополнительном рисунке 3A–C.
Ни один ген не был выбран всеми тремя методами. Сохранение генов, подтвержденных как минимум двумя методами, позволило выявить CCL7, CHEK1, MKI67, MMP1, MMP13 и TRPV2 (Рисунок 3D). GO-аннотация этих шести генов выявила такие функции, как разборка внеклеточного матрикса, катаболические и метаболические процессы коллагена, конденсация хромосом и функции, связанные с металлоэндопептидазами (все значения p с поправкой по Бенджамини-Хохбергу < 0,05; Рисунок 3E). Анализ KEGG выявил сигнализацию интерлейкина-17 (IL-17) (CCL7/MMP1/MMP13; скорректированное p = 1,81 × 10⁻⁴) и сигнализацию релаксина (MMP1/MMP13; скорректированное p = 0,0175; Рисунок 3F). Эти результаты обогащения были использованы для характеристики биологических функций, представленных панелью из шести генов.
Оценка по нескольким наборам данных демонстрирует неоднородную поддержку MMP1
В объединенной матрице GSE68183/GSE80178 (9 образцов DFU и 6 контрольных образцов) экспрессия CCL7, MMP1 и MMP13 значимо различалась между группами после поправки Бенджамини-Хохберга (BH) для шести генов (скорректированное p = 0,0168, 0,0159 и 0,0431 соответственно; Рисунок 4A). CHEK1, MKI67 и TRPV2 не достигли порога скорректированной значимости (скорректированное p = 0,259, 0,680 и 0,259). ROC-анализ по отдельным генам показал значения AUC, равные 0,944 для CCL7 (95% ДИ, 0,825–1,000), 0,704 для CHEK1 (0,403–1,000), 0,574 для MKI67 (0,243–0,905), 0,981 для MMP1 (0,930–1,000), 0,870 для MMP13 (0,686–1,000) и 0,722 для TRPV2 (0,447–0,997; Рисунок 4B). Данные значения ROC считались предварительными, поскольку процедура предварительного объединения и коррекции пакетного эффекта не была полностью документирована.
В наборе данных GSE134431 (13 образцов DFU и 8 образцов DFS без изъязвлений) экспрессия MMP1 была выше в группе DFU, чем в группе DFS, согласно критерию Вилкоксона при номинальном уровне значимости (p = 0.0225), хотя эта связь перестала быть значимой после поправки Бенджамини-Хохберга (скорректированное p = 0.135; Рисунок 4C). Остальные пять генов не показали значимых межгрупповых различий. MMP1 также продемонстрировал самое высокое дескриптивное значение AUC, которое составило 0.808 (95% ДИ, 0.589–1.000), в то время как значения AUC для других кандидатов варьировались от 0.529 до 0.635 (Рисунок 4D). В целом, MMP1 показал наиболее стабильный дескриптивный паттерн среди шести кандидатов, однако статистическая репликация была неполной.
Одноклеточный анализ локализует MMP1 преимущественно в фибробластах
Набор данных одноклеточного секвенирования содержал 69 944 клетки из 24 образцов (14 с диабетической язвой стопы (DFU) и 10 контрольных), включавших 10 аннотированных типов клеток (Рисунок 5A). Визуализация признаков с помощью UMAP показала, что экспрессия MMP1 локализована в ограниченных клеточных областях, а не распределена равномерно по всему атласу (Рисунок 5B). В целом, в 3 799 клетках (5,43%) нормализованный уровень экспрессии MMP1 был больше нуля. Фибробласты имели самый высокий средний нормализованный уровень экспрессии (0,181) и самую большую общую долю MMP1-положительных клеток (7,88%; Рисунок 5C).
На уровне образцов средняя экспрессия MMP1 была выше в образцах с диабетической стопой (DFU), чем в контрольных образцах, в кератиноцитах, фибробластах и эндотелиальных клетках. После коррекции по методу Бенджамини-Хохберга (BH) для всех исследованных типов клеток скорректированное значение p для каждого из этих сравнений составило 0,0214 (кератиноциты: 9 контрольных и 14 образцов DFU; фибробласты: 10 и 14; эндотелиальные клетки: 10 и 14; Рисунок 5D). Доля MMP1-положительных клеток увеличилась с 5,86% до 9,29% в фибробластах, с 0,026% до 6,68% в кератиноцитах и с 0,29% до 2,67% в эндотелиальных клетках (Рисунок 5E).
Корреляции показателей модулей на уровне отдельных клеток были умеренными. Наибольшая положительная корреляция наблюдалась для показателя модуля старения/секреторного фенотипа, ассоциированного со старением (SASP) (rho Спирмена = 0,274), за которым следовали ремоделирование внеклеточного матрикса (rho = 0,240), ферроптоз (rho = 0,197) и активация фибробластов (rho = 0,170); Рисунок 5F). Сравнение ММР1-высокий и ММП-1-фибробласты с низким уровнем экспрессии демонстрировали обогащение терминами «организация внеклеточного матрикса», «организация внеклеточных структур», «организация коллагеновых фибрилл», «процессинг гликопротеинов» и «фолдинг белков» (Рисунок 5G). Эти описательные данные связали ММП1—высокое состояние фибробластов, связанное с процессами ремоделирования матрикса. Дополнительные графики UMAP на уровне групп, сводные данные по образцам для всех типов клеток и контекст функциональных показателей представлены в Дополнительная фигура 4A–CСвязи на уровне отдельных клеток не рассматривались как независимые от донора доказательства.
Покрытие сети приоритизирует ингредиенты, связанные с MMP1, и перспективные лекарственные травы
Отфильтрованная таблица связей «трава — ингредиент — мишень» содержала 561 уникальную запись, объединяющую 99 трав, 14 ингредиентов и пять из шести потенциальных мишеней. Наиболее частой мишенью был MMP1 (156 записей), за которым следовали CHEK1 (120), MMP13 (102), MKI67 (100) и TRPV2 (83; Рисунок 6A). Среди ингредиентов кверцетин и лютеолин имели самый широкий охват трав и были связаны с 83 и 62 травами соответственно. Берберин был связан с 10 травами; эти три ингредиента использовались в качестве основных компонентов в правиле приоритизации (Рисунок 6B).
Согласно показателю охвата, Guanhuangbo, Mahuang и Niuxi заняли совместно первые места (балл = 38 для каждого; Рисунок 6C). Каждое из этих растений охватывало все пять доступных мишеней и содержало два ингредиента, связанных с MMP1. Матрица «ингредиент-мишень» показала, что кверцетин обеспечил наиболее широкий охват панели мишеней, в то время как лютеолин и берберин обеспечили дополнительную связность, сосредоточенную на MMP1 (Рисунок 6D). Специализированная сеть связала ведущие травы с репрезентативными ингредиентами и пятью доступными мишенями (Рисунок 6E). Эти результаты позволили определить комбинации «трава-ингредиент-мишень» с высоким уровнем охвата в базе данных для дальнейшей оценки. Матрицы охвата «трава-мишень» и основных ингредиентов представлены на Дополнительном рисунке 5A,B.
Предварительные анализы парных образцов тканей демонстрируют более высокое содержание мРНК и белка MMP1
Анализ методом вестерн-блоттинга показал более высокое содержание MMP1 в образцах диабетических язв стопы (DFU), чем в соответствующих им неязвенных образцах кожи вокруг раны (Рисунок 7A,B). Для трех соответствующих пар средняя разница между DFU и периферической зоной в соотношении MMP1/кофилин составила 0,3553 (95% ДИ: 0,1959–0,5147; двусторонний парный t-критерий, t(2) = 9,592, p = 0,0107). Парные измерения для каждого пациента представлены на Рисунке 7B. После усреднения результатов пяти технических лунок для каждого гена в каждом образце, qPCR показала более высокое нормализованное содержание мРНК MMP1 в каждом из четырех образцов DFU по сравнению с соответствующим образцом кожи вокруг раны (Рисунок 7C). Средняя внутрипациентная разница ΔCq между DFU и периферической зоной составила −2,6035 (95% ДИ: от −2,8024 до −2,4046; двусторонний парный t-критерий, t(3) = −41,663, p = 3,04 × 10⁻⁵), что соответствует увеличению среднего геометрического в 6,08 раза (95% ДИ: 5,30–6,98). Эти наблюдения на малых выборках являются предварительными и не устанавливают функциональный эффект.
Среди наборов данных для первичного поиска и внешних массивов данных объемных измерений ген MMP1 демонстрировал наиболее стабильный описательный паттерн из шести приоритетных генов, хотя статистическая репликация была неполной. Анализ данных на уровне отдельных клеток показал самый высокий средний уровень экспрессии в фибробластах, а парные измерения методом вестерн-блоттинга (WB) у трех пациентов и парные измерения методом кПЦР у четырех пациентов выявили более высокое содержание MMP1. Эти наблюдения подтверждают, что MMP1 является перспективным кандидатом, связанным с диабетической язвой стопы (DFU), для дальнейшего изучения. Общий рабочий процесс оценки от вычислительного анализа до исследования тканей обобщен на Дополнительной фигуре 6.
ДОСТУПНОСТЬ ДАННЫХ:
Публичные транскриптомные наборы данных доступны в базе данных NCBI Gene Expression Omnibus под номерами доступа GSE199939, GSE68183, GSE80178, GSE134431 и GSE165816. Доступные скрипты для анализа и построения графиков, таблицы обработанной экспрессии и результатов, количественные исходные таблицы для графиков, таблицы статистических данных, исходный рабочий файл и проект прибора qPCR, а также предоставленные неотредактированные изображения вестерн-блоттинга включены в Supplementary File 1. Архив также содержит извлеченные метаданные клеток и историю команд из восстановленного объекта single-cell, отчеты о проверке типа матриц и манифест файлов. Supplementary File 1 содержит исторические исходные файлы и папку R2_Updates с пересмотренными исходными таблицами парных анализов, статистическими результатами, кодом для построения графиков и исправленным перечнем параметров. Полный проанализированный файл Seurat RDS указан в документации архива, но не встроен в данный дополнительный ZIP-архив. Полная история объединения данных bulk-sequencing, исходные настройки фильтрации и аннотации single-cell, а также исходные сведения о вычитании фона блотов и переходе от дорожек к количественному анализу доступны не в полном объеме; эти ограничения описаны в протоколе и обсуждении. Локально восстановленный файл RDS не был помещен в публичный репозиторий.
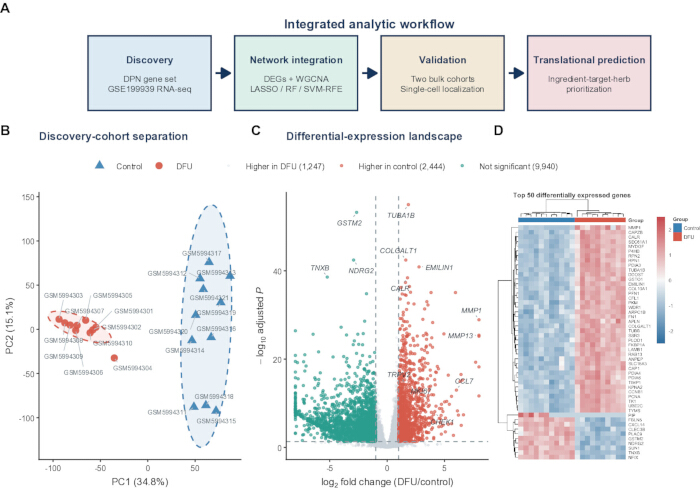
Рисунок 1: Поисковый транскриптомный анализ выявляет программу экспрессии, связанную с СДЯ. (A) Обзор вычислительного рабочего процесса, включающего построение набора генов DPN и поисковый анализ GSE199939, интеграцию сетей и машинного обучения, оценку на уровне всей ткани (bulk) и отдельных клеток, а также прогнозирование связей «ингредиент TCM — мишень — лекарственное растение». (B) Анализ главных компонентов стабилизированных по дисперсии профилей экспрессии GSE199939 из 10 образцов с СДЯ и 11 контрольных образцов. Эллипсы обозначают 90% области групп; проценты указывают долю дисперсии, объясненную каждым компонентом. (C) Вулкан-плот результатов дифференциальной экспрессии DESeq2 для СДЯ по сравнению с контролем. Красные и бирюзовые точки обозначают гены, экспрессия которых повышена в группе СДЯ и контрольной группе соответственно, с использованием |log2 fold change| > 1 и скорректированного по BH p < 0.05; серые точки не соответствуют обоим порогам. (D) Теплокарта z-показателей по строкам для 50 генов с наименьшими скорректированными значениями p. Столбцы представляют биологические образцы, а полоса аннотации указывает на группу. DEGs, дифференциально экспрессируемые гены; DFU, диабетическая язва стопы (СДЯ); DPN, диабетическая периферическая нейропатия; VST, стабилизирующая дисперсию трансформация. Окончательная экспериментальная оценка описана в протоколе и на Рисунке 7. qPCR, количественная полимеразная цепная реакция; TCM, традиционная китайская медицина; RF, случайный лес; LASSO, метод наименьшей абсолютной усадки и отбора; SVM-RFE, рекурсивное исключение признаков методом опорных векторов. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
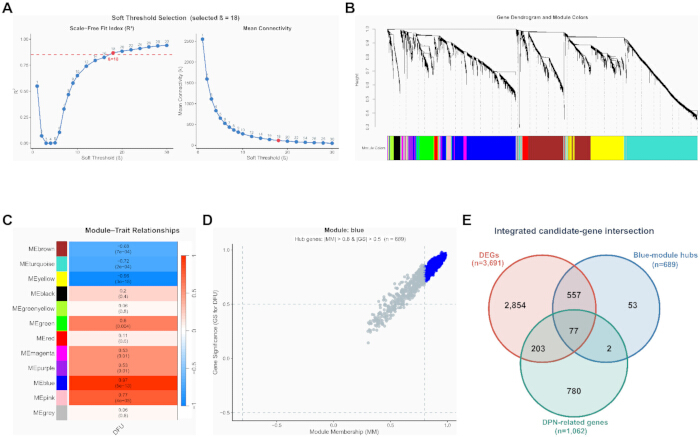
Рисунок 2: Результаты WGCNA и имеющиеся данные о DPN позволяют выделить 77 генов-кандидатов. (A) Оценка мягкого порога знаковой сети для 5 000 наиболее вариабельных генов с VST-преобразованием. Выбранная степень была beta = 18; пунктирная линия обозначает целевой показатель соответствия безмасштабной топологии 0,85. (B) Дендрограмма генов с использованием метода средней связи и динамическим присвоением цветов модулям. (C) Корреляции Пирсона между собственными генами модулей и бинарным признаком DFU. В каждой ячейке указан коэффициент корреляции и соответствующее двустороннее значение p; цвет указывает направление и величину. (D) Значимость генов для DFU в сравнении с принадлежностью к синему модулю. Синие точки соответствуют условиям |принадлежность к модулю| > 0,8 и |значимость гена| > 0,5; n = 689 хаб-генов. (E) Пересечение трех наборов: 3 691 DEG, 689 хаб-генов синего модуля и 1 062 генов, связанных с DPN, что в итоге дало 77 общих кандидатов. DFU — диабетическая язва стопы; DPN — диабетическая периферическая нейропатия; GS — значимость гена; MM — принадлежность к модулю; WGCNA — анализ взвешенных сетей коэкспрессии генов. Дискавери-когорта включала 21 образец (10 DFU и 11 контролей). Аннотация на Рисунке 2D использует |MM| > 0,8 и |GS| > 0,5, что соответствует критерию абсолютного значения, подтвержденному в исходном коде отбора. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
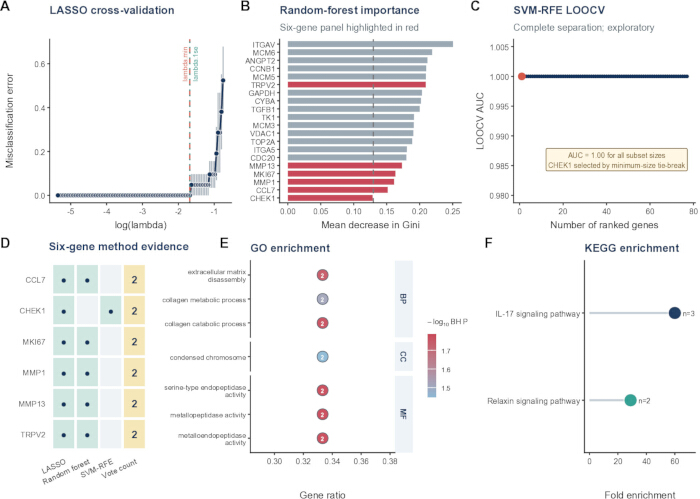
Рисунок 3: Приоритизация признаков с помощью нескольких методов позволила выделить панель из шести генов. (A) Кривая пятикратной перекрестной проверки для биномимальной регрессии LASSO. Вертикальные пунктирные линии обозначают lambda.min и lambda.1se; выбранные ненулевые признаки определялись при lambda.1se, за исключением случаев, когда такой штраф не приводил к выбору признаков. (B) Среднее снижение индекса Джини в случайном лесе для 20 наиболее значимых генов в модели из 1 000 деревьев. Красные столбцы обозначают гены, вошедшие в итоговую панель из шести генов; пунктирная линия отмечает среднюю значимость, использованную в качестве порога отбора для всего набора кандидатов. (C) AUC при LOOCV для линейного SVM-RFE в различных вложенных подмножествах признаков. Все размеры подмножеств дали AUC = 1,00; CHEK1 был выбран согласно правилу выбора подмножества минимального размера, что указывает на переобучение в когорте обнаружения. (D) Матрица поддержки методов для CCL7, CHEK1, MKI67, MMP1, MMP13 и TRPV2. Точки обозначают выбор с помощью LASSO, случайного леса или SVM-RFE; последний столбец указывает количество поддерживающих методов. (E) Выбранные термины Gene Ontology, обогащенные среди шести генов. Положение точки показывает отношение генов, метки точек — количество сопоставленных генов, цвет — -log10 BH-скорректированного значения p, а боковая полоса обозначает онтологию. (F) Пути KEGG, обогащенные среди сопоставленных генов. Положение точки показывает кратность обогащения, метки размера точек — количество сопоставленных генов, а цвет разграничивает пути. Обогащение требовало номинального p < 0,05 и BH-скорректированного p < 0,05. AUC, площадь под ROC-кривой; BH, метод Бенджамини-Хохберга; BP, биологический процесс; CC, клеточный компонент; KEGG, Киотская энциклопедия генов и геномов; LOOCV, перекрестная проверка с исключением одного объекта; MF, молекулярная функция; SVM-RFE, рекурсивное исключение признаков методом опорных векторов. LASSO, метод наименьшего абсолютного сжатия и отбора. На панелях A–D использованы 21 образец из группы обнаружения (10 DFU и 11 контролей). На панели A планки погрешностей обозначают стандартную ошибку ошибки перекрестной проверки. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
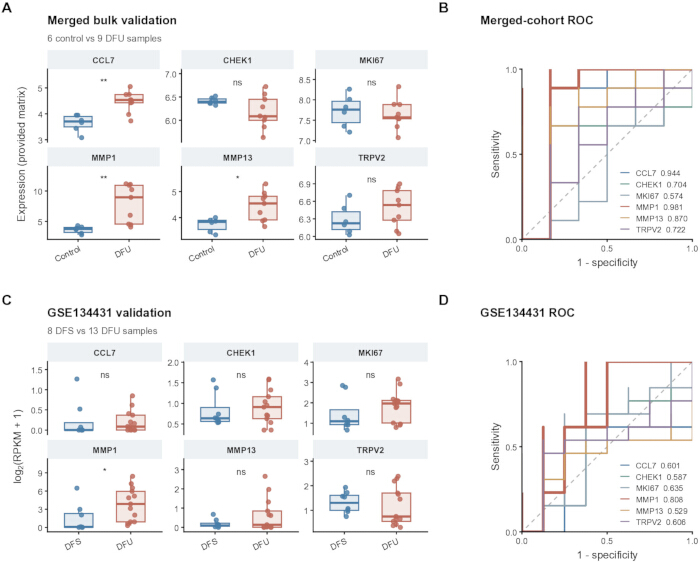
Рисунок 4: Междатасетная балк-транскриптомная оценка панели из шести генов. (A>) Экспрессия шести генов в объединенной матрице GSE68183/GSE80178 (6 контрольных образцов и 9 образцов DFU). (B>) Соответствующие ROC-кривые для отдельных генов со значениями AUC; 95% доверительные интервалы приведены в таблице исходных данных. Поскольку предварительное объединение и коррекция пакетного эффекта не были полностью задокументированы, эти результаты интерпретировались как предварительные. (C>) Экспрессия log2(RPKM + 1) в GSE134431 (8 образцов неязвенной кожи DFS и 13 образцов DFU). (D>) Соответствующие ROC-кривые для отдельных генов и значения AUC. На графиках (A>) и (C>) прямоугольники отображают медиану и межквартильный размах, «усы» extending до 1,5 межквартильного размаха, а точки представляют биологические образцы. Звездочки указывают на номинамую значимость по результатам двухсторонних ранговых суммовых критериев Вилкоксона (*p < 0.05, **p < 0.01); значения p, скорректированные по методу Бенджамини-Хохберга (BH) для шести генов, приведены в тексте и таблице исходных данных. Направление ROC-кривой было выбрано автоматически с помощью pROC. AUC, площадь под ROC-кривой; DFS, неязвенная кожа стопы при диабете; DFU, диабетическая язва стопы; RPKM, количество чтений на килобазу на миллион картированных чтений; ROC, рабочая характеристика приемника. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
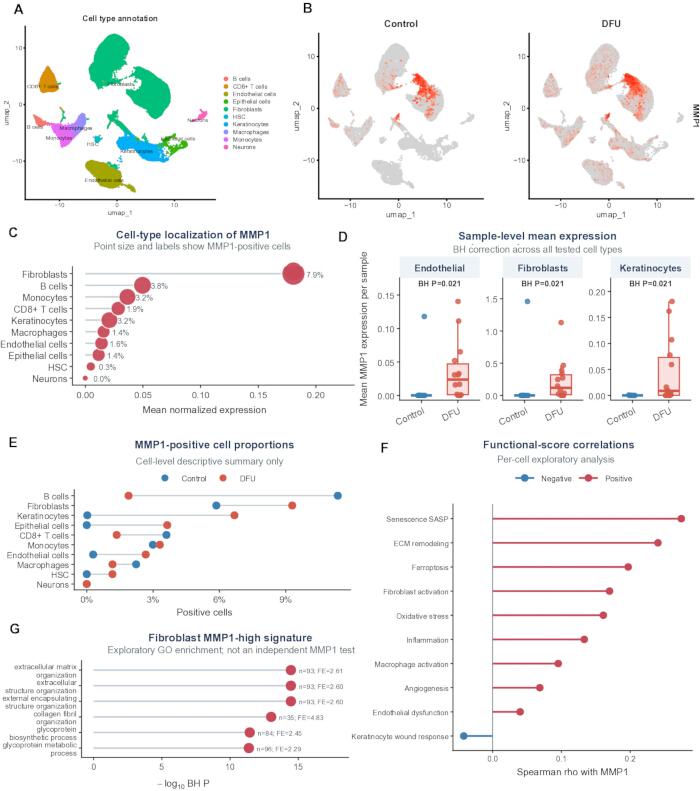
Рисунок 5: Локализация на уровне отдельных клеток связывает MMP1 с сигналами фибробластов и ремоделирования матрикса. (A) UMAP 69 944 клеток из 24 образцов (10 контрольных и 14 образцов с DFU), окрашенных согласно 10 аннотациям типов клеток, полученным с помощью SingleR. (B) Графики признаков UMAP, показывающие нормализованную экспрессию MMP1 в контрольных клетках и клетках DFU. (C) Сводка по типам клеток средней нормализованной экспрессии MMP1; размер точек и подписи обозначают общую долю MMP1-положительных клеток, определяемую как нормализованная экспрессия > 0. (D) Средняя экспрессия MMP1 на уровне образцов в эндотелиальных клетках, фибробластах и кератиноцитах. Прямоугольники показывают медиану и межквартильный размах; точки — биологические образцы. Двусторонние ранговые суммы тесты Вилкоксона с последующей коррекцией BH для всех исследуемых типов клеток. Доступное количество образцов составило 10 контрольных и 14 DFU для эндотелиальных клеток и фибробластов, а также 9 контрольных и 14 DFU для кератиноцитов. (E) Доли MMP1-положительных клеток по группам и типам клеток. (F) Поклеточные корреляции Спирмена между экспрессией MMP1 и показателями функциональных модулей. (G) Обогащение биологических процессов GO среди генов, экспрессия которых повышена в фибробластах с высоким уровнем MMP1 по сравнению с фибробластами с низким уровнем MMP1. BH — коррекция Бенджамини-Хохберга; DFU — диабетическая язва стопы; ECM — внеклеточный матрикс; GO — генная онтология; HSC — гемопоэтические стволовые клетки; UMAP — равномерное приближение и проекция многообразия. Поклеточные корреляции и обогащение, обусловленное экспрессией на панелях F и G, являются описательными исследованиями без подтверждающего вывода с учетом доноров. Независимость на уровне образцов требует верификации идентификаторов доноров. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
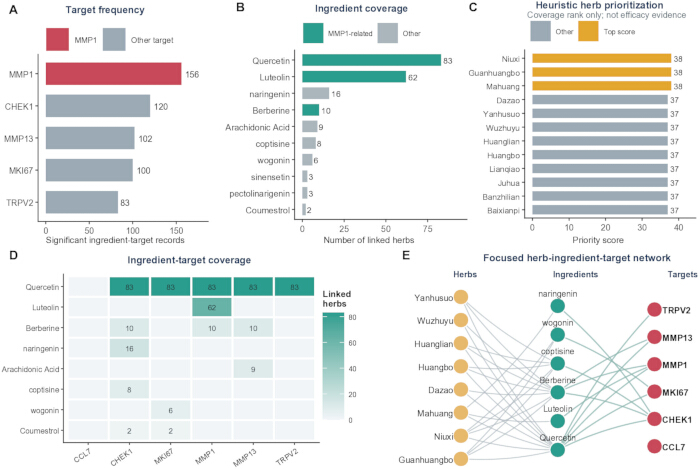
Рисунок 6: Прогнозирование связей «ингредиент — мишень — лекарственное растение» в ТКМ на основе охвата с центром на MMP1. (A) Количество отфильтрованных записей «растение — ингредиент — мишень» из базы данных для каждой доступной мишени-кандидата. (B) Количество связанных растений для наиболее часто встречающихся ингредиентов; бирюзовым цветом отмечены ингредиенты, связанные с MMP1. (C) Основные лекарственные растения, ранжированные по показателю охвата; золотистыми полосами отмечены три самых высоких совместных показателя. (D) Матрица «ингредиент — мишень» для репрезентативных ингредиентов с высоким охватом. Значения в ячейках показывают количество связанных растений; пустые ячейки указывают на отсутствие записи в отфильтрованной таблице связей. (E) Фокусная сеть, объединяющая репрезентативные высокоранжированные растения, ингредиенты и мишени-кандидаты. Цвет узла обозначает тип объекта; серые ребра «растение — ингредиент» обозначают содержание, а бирюзовые ребра «ингредиент — мишень» — связи в базе данных. Отфильтрованная таблица связей содержала 561 уникальную запись, 99 растений, 14 ингредиентов и пять мишеней с соответствующими связями; CCL7 отображен как изолированный шестой узел-кандидат. ТКМ — традиционная китайская медицина. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
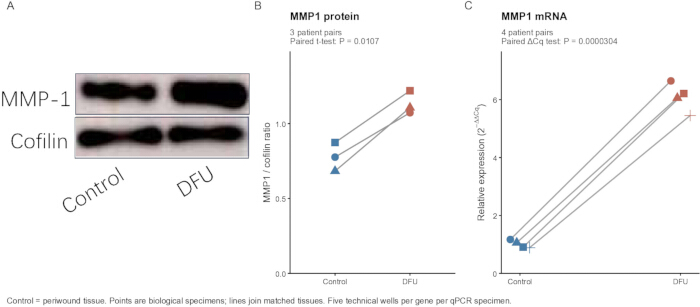
Рисунок 7: Предварительная оценка экспрессии MMP1 в тканях пациентов с диабетической язвой стопы (DFU) с помощью кПЦР и вестерн-блоттинга. (A) Ранее предоставленный репрезентативный вестерн-блот, демонстрирующий содержание белка MMP1 в неизъязвленной перивульнарной ткани и ткани DFU; в качестве контроля нагрузки использован кофилин. (B) Отношения MMP1 к кофилину, полученные из исходного проекта построения графиков. Символы обозначают отдельные биологические измерения для трех пар пациентов; линии соединяют соответствующие образцы перивульнарной ткани и DFU. Двусторонний парный t-критерий дал значения t(2) = 9.592 и p = 0.0107. (C) Относительное содержание мРНК MMP1 в четырех подтвержденных авторами парах пациентов: NC–DFU, NC1–DFU1, NC2–DFU2 и NC3–DFU3. Средние значения для пяти технических лунок ACTB и пяти технических лунок MMP1 вычислялись отдельно для каждого образца перед расчетом ΔCq. Относительная экспрессия рассчитывалась методом 2−ΔΔCq, где среднее значение ΔCq для перивульнарной ткани использовалось в качестве общего калибратора. Каждый символ представляет один биологический образец; линии соединяют соответствующие ткани. Двусторонний парный t-критерий применялся к значениям ΔCq на уровне образцов (t(3) = −41.663; p = 3.04 × 10⁻⁵), а не к кратности изменения в технических лунках. Звездочки значимости не используются. Технические лунки не являются биологическими повторами. Control означает неизъязвленную перивульнарную ткань. Cq — цикл квантификации. Значения p для анализа тканей являются номинальными и предварительными. Пожалуйста, нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
| Ген | номер доступа RefSeq | Прямой праймер от 5' к 3' концу | Реверсивный праймер (5' $\rightarrow$ 3') |
| ММР1 | NM_002421 | ATGAAGCAGCCCAGATGTGGAG | TGGTCCACATCTGCTCTTGGCA |
| ACTB | NM_001101.5 | CACCATTGGCAATGAGCGGTTC | AGGTCTTTGCGGATGTCCACGT |
Таблица 1: Последовательности праймеров для количественной ПЦР-валидации MMP1. Приведены прямые и обратные олигонуклеотидные последовательности (5′–3′) и номера записей транскриптов NCBI RefSeq для человеческих MMP1 (NM_002421) и ACTB (NM_001101.5). ACTB (β-актин) использовался в качестве референсного гена для определения относительной экспрессии MMP1.
Дополнительный рисунок 1: Резюме контроля качества WGCNA. (A) Иерархическая кластеризация образцов GSE199939 методом средней связи (average-linkage) на основе 5 000 наиболее вариабельных генов со стабилизированной дисперсией. Метки образцов окрашены по группам; пунктирная горизонтальная линия представляет собой направляющую высоты дендрограммы на уровне 95-го процентиля, используемую для визуальной оценки выбросов. (B) Количество генов, отнесенных к каждому модулю WGCNA. Бирюзовые столбцы обозначают восемь несерых модулей, соответствующих критерию ассоциации с DFU; серые столбцы обозначают другие модули. DFU — диабетическая язва стопы; VST — стабилизирующая дисперсию трансформация; WGCNA — взвешенный анализ сетей коэкспрессии генов. Пожалуйста, нажмите здесь, чтобы скачать этот файл.
Дополнительный рисунок 2: Подтверждение коэкспрессии «синего» модуля. (A) Упрощенная сеть коэкспрессии 25 наиболее значимых хабовых генов «синего» модуля. Среди попарных корреляций с |r| > 0.70 представленная сеть содержит совокупность двух самых сильных связей каждого гена. Размер узла обозначает степень связи в данной отображенной разреженной сети, а заливка узла — значимость гена для DFU. (B) Значимость генов и принадлежность к «синему» модулю для 15 наиболее значимых хабов. Подмножество ребер было выбрано для удобства чтения и не представляет все подходящие корреляции. DFU — диабетическая стопа; GS — значимость гена; MM — принадлежность к модулю. Пожалуйста, нажмите здесь, чтобы скачать этот файл.
Дополнительный рисунок 3Демонстрация результатов машинного обучения для внутренней когорты исследования. (AМасштабированная экспрессия CCL7, CHEK1, MKI67, ММР1, ММП13и TRPV2 в когорте обнаружения GSE199939. Прямоугольники отображают медиану и межквартильный размах, точки представляют собой биологические образцы. (B) Строка на уровне образца-zтепловая карта z-показателей для тех же шести генов. Краткие метки образцов сопоставлены с идентификаторами GEO в ключе исходных данных. (C) ROC-кривая построенной многогенной модели для когорты обнаружения. Значение AUC 1,00 было получено в результате подгонки и оценки модели на одних и тех же 21 образцах, что указывает на переобучение в когорте обнаружения. AUC — площадь под ROC-кривой; ROC — рабочая характеристика приемника. Когорта обнаружения включала 21 образец (10 с диабетической язвой стопы и 11 контрольных). Пожалуйста, нажмите здесь, чтобы скачать этот файл.
Дополнительный рисунок 4: Контекст экспрессии на уровне отдельных клеток. (A) UMAP 69 944 клеток, раскрашенных по контрольной группе и группе DFU. (B) Средняя экспрессия MMP1 на уровне биологических образцов для всех 10 аннотированных типов клеток; точки представляют образцы, для оси x используется преобразование квадратного корня для визуализации. (C) Тепловая карта показателей функциональных модулей, суммированных по клеткам внутри каждого аннотированного типа клеток и стандартизированных внутри каждого модуля. DFU — диабетическая язва стопы; UMAP — равномерное многомерное приближение и проекция. Пожалуйста, нажмите здесь, чтобы скачать этот файл.
Дополнительный рисунок 5: Подтверждающие матрицы охвата ТКМ. (A) Количество записей в базе данных «трава-мишень» для 18 наиболее высокоранжированных трав с охватом, связанным с MMP1, и пяти потенциальных мишеней, представленных в отфильтрованной таблице связей. (B) Количество записей в базе данных, связывающих те же травы с основными ингредиентами: кверцетином, лютеолином и берберином. Значения в ячейках обозначают количество уникальных записей базы данных после дедупликации. ТКМ — традиционная китайская медицина. Пожалуйста, нажмите здесь, чтобы скачать этот файл.
Дополнительный рисунок 6: Схема рабочего процесса вычислительной оценки и анализа тканей. На схеме обобщены этапы: входные данные для поиска, пересечение DEG/WGCNA, предварительный отбор признаков, внешняя оценка общего анализа экспрессии (bulk assessment), контекст на уровне отдельных клеток, расширение TCM и оценка экспрессии в соответствующих образцах тканей. Для qPCR были использованы четыре пары соответствующих образцов пациентов, для вестерн-блоттинга — три пары. Количество кандидатов и представленные результаты вычислений сохранены из исходного анализа. Ограничениями остаются использование TPM в рабочем процессе поиска на основе подсчета, неполные записи исходной предобработки данных отдельных клеток и малые когорты при анализе тканей. Данная схема не подразумевает, что результаты первичного поиска были повторно валидированы. Пожалуйста, нажмите здесь, чтобы скачать этот файл.
Дополнительная таблица 1: Перечень программного обеспечения для анализа, баз данных, параметров и ограничений. В этой рабочей книге задокументировано 26 этапов анализа с указанием самого этапа, используемого инструмента или базы данных, версии, входных данных, основных параметров, выходных данных, а также недостающей информации или ограничений. Она охватывает транскриптомный анализ для поиска биомаркеров, WGCNA, скрининг генов и отбор признаков, анализ обогащения, внешние анализы объемного (bulk) и одноклеточного секвенирования, сетевой анализ ТКМ (традиционной китайской медицины) и отчетность по анализам тканей. В таблице зафиксирована доступная методологическая информация; сама по себе она не обеспечивает независимую воспроизводимость. Пожалуйста, нажмите здесь, чтобы скачать этот файл.
Дополнительный файл 1: Архив данных, кода анализа, исходных данных для рисунков и анализа. Этот архив содержит доступные скрипты для анализа и генерации рисунков, таблицы обработанных данных экспрессии и результатов, количественные рисунки и исходные статистические данные, оригинальную рабочую книгу и проект прибора для qPCR, предоставленные неотрезанные изображения вестерн-блоттинга, извлеченные метаданные отдельных клеток и историю команд, отчеты о верификации типов матриц, а также опись файлов. Исторические файлы сохранены; папка R2_Updates содержит исправленный анализ парных анализов, обновленные исходные данные для рисунков и пересмотренный перечень параметров. Пожалуйста, нажмите здесь, чтобы скачать этот файл.
Обсуждение
В ходе этого комплексного рабочего процесса ген MMP1 был выбран в качестве приоритетного на основании данных массового транскриптомного анализа, WGCNA, скрининга генов, связанных с DPN, и предварительного отбора признаков, после чего были изучены его клеточный контекст и экспрессия в тканях. Шесть генов были подтверждены как минимум двумя методами отбора, при этом MMP1 продемонстрировал наибольшее изменение экспрессии в открывающей когорте. Внешние данные оказались неоднородными: MMP1 оставался значимым в объединенной матрице GSE68183/GSE80178, тогда как его связь в GSE134431 была номинальной (p = 0.0225) и не сохранилась после коррекции Бенджамина-Хохберга (скорректированное p = 0.135). Значение AUC 0,808 в GSE134431 является описательным, в особенности потому, что направление ROC-кривой было выбрано внутри оценочного набора данных. Соответственно, определение «наиболее последовательный» описывает наблюдаемую закономерность среди шести кандидатов и не подразумевает полной статистической репликации или наличия валидированного диагностического биомаркера.
Панель кандидатных генов была аннотирована по категориям обновления коллагена, разборки внеклеточного матрикса (ВКМ), активности металлоэндопептидаз, а также сигнализации IL-17 и релаксина. Эти аннотации согласуются с биологией хронических ран, однако затрагивают лишь несколько генов. В более ранних исследованиях на людях сообщалось об изменении профилей MMP и их ингибиторов в диабетических ранах6, в то время как в проспективном исследовании диабетических язв стопы (DFU) более высокое соотношение MMP1 к тканевому ингибитору металлопротеиназ 1 (TIMP1) ассоциировалось с заживлением7. Таким образом, повышенная экспрессия MMP1 не обязательно указывает на однозначно вредный эффект; ее значимость может зависеть от стадии регенерации, доступности субстрата и баланса ингибиторов. Экспериментальные наблюдения относительно MMP13, CCL7 и IL-17 предоставляют дополнительный контекст11,12,13,14, однако нельзя предполагать, что их функции при DFU у человека будут эквивалентны.
Анализ данных на уровне отдельных клеток показал, что самая высокая средняя экспрессия MMP1 локализована в фибробластах, при этом более высокая экспрессия на уровне образцов наблюдалась в фибробластах, кератиноцитах и эндотелиальных клетках при диабетических язвах стопы (DFU). Эта закономерность согласуется с сообщениями об изменении организации внеклеточного матрикса (ECM) в фибробластах, полученных из DFU4, гетерогенности состояний фибробластов в исследованиях с разрешением до одной клетки и пространственных исследованиях8, а также о программах заживления фибробластов, связанных с макрофагами15. Однако идентификаторы образцов требуют верификации на уровне донора, а корреляции баллов модулей на уровне клеток и обогащение, обусловленное экспрессией, остаются описательными, поскольку зависимость внутри донора не моделировалась. Вклад эпителиальных и эндотелиальных популяций также свидетельствует против исключительно автономного механизма фибробластов. Пространственная транскриптомика, гибридизация РНК in situ или иммуноокрашивание обеспечили бы дополнительную локализацию16.
Методологическая ценность заключается в сочетании дифференциальной экспрессии, коэкспрессии, имеющихся данных о генах, обобщений на уровне отдельных клеток и независимых модальностей анализа для приоритизации кандидатов. Она не заключается в прогностической точности для когорты открытия. Скрининг всей когорты предшествовал кросс-валидации на уровне алгоритма, и единообразное значение AUC SVM-RFE, равное 1.00, вызывает опасения относительно утечки данных, переобучения и оптимистичной оценки. Таким образом, панель следует рассматривать как результат приоритизации признаков. Для прогностической оценки потребовалась бы полностью вложенная предварительная обработка, отбор и настройка с последующим закрытым независимым тестом9,10. Входные данные для открытия были верифицированы как TPM, несмотря на их использование в модели на основе подсчетов; следовательно, полученная статистика открытия и последующий отбор остаются неверифицированными до проведения надлежащего повторного анализа. Объединенная матрица bulk-секвенирования не имеет полной истории предварительной обработки. Восстановленный объект Seurat содержит настройки нормализации, выбора вариабельных признаков, PCA, поиска ближайших соседей, кластеризации и UMAP, хотя исходная фильтрация, полный вызов Harmony и справочник аннотаций задокументированы не полностью. Гармонизированная повторная обработка исходных данных, задокументированная оценка пакетного эффекта, а также анализ псевобулька с учетом доноров или использование смешанных моделей являются альтернативными подходами для дальнейшей оценки.
Анализы тканей пациентов предоставляют предварительные ортогональные доказательства более высокого содержания MMP1. В качестве компаратора использовалась неизъязвленная ткань вокруг раны тех же пациентов, поэтому контраст отражает локальные различия в диабетической ткани, связанные с изъязвлением, а не сравнение со здоровой кожей. Данные вестерн-блоттинга (WB), полученные от трех пар соответствующих пациентов, и данные кПЦР от четырех подтвержденных авторами соответствующих пар были проанализированы с использованием парных тестов, при этом представлены индивидуальные биологические наблюдения. Для кПЦР значения технических лунок усреднялись внутри каждого образца, а вывод основывался на ΔCq; технические лунки не увеличивали размер биологической выборки. Согласованное направление парных наблюдений подтверждает предварительное сравнение экспрессии, однако малые когорты не позволяют установить обобщаемость или достоверно оценить допущения о распределении. Общее содержание белка в ткани не определяет клеточную локализацию белка, ферментативную активность или причинно-следственную связь с заживлением. Необходимы более крупные клинически охарактеризованные когорты. Другие ограничения включают неполные клинические ковариаты, различные ткани-компараторы, не полностью задокументированный набор генов DPN, полученный из литературы, и неполные записи по вычитанию фона оригинальных блоттов. Здоровую ткань, контрольную ткань, определенную в исследовании, и неизъязвленную кожу стопы при диабете не следует рассматривать как взаимозаменяемые.
Сеть TCM представляет собой расширение для генерации гипотез. Ее настраиваемые веса характеризуют охват базы данных, а не степень взаимодействия с мишенью или эффективность, и ранжирование может меняться в зависимости от содержимого базы данных и выбора весов. Кверцетин и берберин также обладают вариабельной или ограниченной системной экспозицией17,18. Следовательно, потенциальные ингредиенты и травы требуют прямого тестирования мишени, зависимости «доза-ответ», фармакокинетики, токсичности и функциональной активности. В будущих работах следует сочетать хорошо задокументированные независимые когорты с пространственной локализацией и пертурбацией MMP1 в первичных фибробластах или многоклеточных моделях ран. Полученные результаты подтверждают роль MMP1 как кандидата, связанного с DFU, в контексте ремоделирования матрикса с участием фибробластов, не устанавливая при этом причинно-следственной связи или клинической значимости.
Раскрытие информации
Авторы заявляют об отсутствии конфликта интересов.
Благодарности
Данное исследование было поддержано Муниципальным медицинским научно-исследовательским проектом города Ухань (направляющий проект, грант № WX23Z77) при административном управлении Комиссии здравоохранения города Ухань.
Авторы благодарят участников, предоставивших образцы тканей для данного исследования, а также исследователей, которые создали и разместили общедоступные наборы данных в базе NCBI Gene Expression Omnibus.
Материалы
| Имя | Компания | Каталожный номер | Комментарии |
|---|---|---|---|
| Полоски из 8 прозрачных тонкостенных ПЦР-пробирок объемом 0,2 mL | Axygen / Corning | PCR-0208-C | URL: https://ecatalog.corning.com/life-sciences/b2b/TW/en/Genomics-%26-Molecular-Biology/PCR-Consumables/PCR-Tubes-and-Strip-Tubes/Axygen%C2%AE-PCR-Strip-Tubes/p/PCR-0208-C |
| Стерильные наконечники для дозатора с фильтром объемом 1 000-μL | Axygen / Corning | TF-1000-R-S | URL: https://ecatalog.corning.com/life-sciences/b2b/SEA/en/Liquid-Handling/Pipette-Tips-and-Accessories/Pipette-Tips/Axygen%C2%AE-Universal-Fit-Filter-Pipette-Tips/p/TF-1000-R-S |
| Стерильные микроцентрифужные пробирки объемом 1,5 mL, без DNase/RNase | Solarbio Life Sciences | YA0430 | URL: https://www.solarbio.com/goodsInfo?id=305429 |
| Стерильные наконечники для дозатора с фильтром объемом 10-μL | Axygen / Corning | TF-300-L-R-S | URL: https://ecatalog.corning.com/life-sciences/b2b/CALAOther/en/Liquid-Handling/Pipette-Tips-and-Accessories/Pipette-Tips/Axygen%C2%AE-Aerosol-Barrier-Tips/p/TF-300-L-R-S |
| 2× мастер-микс для ПЦР с SYBR Green | Solarbio Life Sciences | SR1110 | URL: https://www.solarbio.com/goodsInfo?id=994 |
| 20× Трис-буферный физраствор | Solarbio Life Sciences | T1080 | URL: https://www.solarbio.com/goodsInfo?id=1309 |
| Стерильные наконечники для дозатора с фильтром объемом 200-μL | Axygen / Corning | TF-200-R-S | URL: https://ecatalog.corning.com/life-sciences/b2b/CALAOther/en/Liquid-Handling/Pipette-Tips-and-Accessories/Pipette-Tips/Axygen%C2%AE-Universal-Fit-Filter-Pipette-Tips/p/TF-200-R-S |
| Пара праймеров для кПЦР ACTB | Solarbio Life Sciences (синтез олигонуклеотидов на заказ) | Custom | RefSeq NM_001101.5; F: CACCATTGGCAATGAGCGGTTC; R: AGGTCTTTGCGGATGTCCACGT; URL: https://www.solarbio.com/ |
| Amersham Imager 600 | GE Healthcare Bio-Sciences AB, Uppsala, Sweden | Amersham Imager 600 | Модель указана во всех 22 предоставленных TIFF-файлах; программное обеспечение Ver.1.2.0; URL: https://cdn.cytivalifesciences.com/api/public/content/digi-17089-original |
| Набор для белкового анализа с бицинхониновой кислотой | Solarbio Life Sciences | PC0020 | URL: https://www.solarbio.com/goodsInfo?id=64504 |
| clusterProfiler | Bioconductor | https://bioconductor.org/packages/clusterProfiler/ | Версия 4.16.0 |
| Поликлональные антитела к кофилину (кроличьи анти-Cofilin) | Proteintech Group (Wuhan Sanying Biotechnology Co., Ltd., Wuhan, China) | 10960-1-AP | Разведение для WB, использованное в исследовании: 1:6 000; URL: https://www.ptgcn.com/; RRID:AB_2291830 |
| Comparative Toxicogenomics Database | CTD | https://ctdbase.org/ | Ресурс «ингредиент-мишень» |
| DESeq2 | Bioconductor | https://bioconductor.org/packages/DESeq2/ | Версия 1.48.2 |
| Вода, без DNase/RNase | Solarbio Life Sciences | R1600 | URL: https://www.solarbio.com/goods.php?id=1085 |
| e1071 | CRAN / авторы e1071 | https://cran.r-project.org/package=e1071 | Версия 1.7-17 |
| Хемилюминесцентный субстрат ECL Plus | Solarbio Life Sciences | PE0010 | URL: https://www.solarbio.com/pdf/2-DBYMY/1-ZW/PE0010.pdf |
| Gene Expression Omnibus: GSE134431 | National Center for Biotechnology Information | GSE134431 | URL: https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE134431 |
| Gene Expression Omnibus: GSE165816 | National Center for Biotechnology Information | GSE165816 | URL: https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE165816 |
| Gene Expression Omnibus: GSE199939 | National Center for Biotechnology Information | GSE199939 | URL: https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE199939 |
| Gene Expression Omnibus: GSE68183 | National Center for Biotechnology Information | GSE68183 | URL: https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE68183 |
| Gene Expression Omnibus: GSE80178 | National Center for Biotechnology Information | GSE80178 | URL: https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE80178 |
| Gene Ontology | Gene Ontology Consortium | https://geneontology.org/ | GO |
| ggplot2 | разработчики ggplot2 | https://ggplot2.tidyverse.org/ | Версия 4.0.3 |
| glmnet | CRAN / авторы glmnet | https://cran.r-project.org/package=glmnet | Версия 5.0 |
| Справочная таблица «трава-ингредиент» | Источник не указан в рукописи | Не указано | Не задокументировано: точное название базы данных/файла, версия/дата и URL публичного доступа |
| Козьи антитела против IgG кролика (H+L), конъюгированные с HRP | Proteintech Group (Wuhan Sanying Biotechnology Co., Ltd., Wuhan, China) | SA00001-2 | Разведение для WB, использованное в исследовании: 1:5 000; URL: https://www.ptgcn.com/products/HRP-conjugated-Goat-Anti-Rabbit-IgG-H-L-SA00001-2.htm; RRID:AB_2722564 |
| Образцы тканей трофических язв стопы человека | Wuhan Fourth Hospital, Wuhan, China | Н/Д | Сопоставимые с пациентом образцы DFU; кПЦР n=4 образца; WB n=3 образца; утвержденный протокол KY2024-161-01 |
| Образцы тканей перифокальной зоны без язв у человека | Wuhan Fourth Hospital, Wuhan, China | Н/Д | Сопоставимый с пациентом перифокальный контрольный образец; кПЦР n=4 образца; WB n=3 образца; утвержденный протокол KY2024-161-01 |
| ImageJ | National Institutes of Health | https://imagej.net/ij/ | Версия не задокументирована |
| Kyoto Encyclopedia of Genes and Genomes | KEGG | https://www.genome.jp/kegg/ | Код организма человека hsa |
| Список генов DPN, отобранный по литературе | Компонент, полученный из литературы; таблица источников на уровне генов не полностью задокументирована | Не указано | Происхождение на уровне генов не полностью задокументировано |
| Микрообъемный УФ-видимый спектрофотометр | Производитель/модель не указаны в рукописи | Не указано | Не задокументировано: точный производитель, модель и URL продукта; заявленное применение: определение концентрации РНК и оценка A260/A280 |
| Поликлональные антитела к MMP1 (кроличьи анти-MMP1) | Proteintech Group (Wuhan Sanying Biotechnology Co., Ltd., Wuhan, China) | 10371-2-AP | Разведение для WB, использованное в исследовании: 1:1 000; URL: https://www.ptgcn.com/Products/MMP1-Antibody-10371-2-AP.htm; RRID:AB_2297741 |
| Пара праймеров для кПЦР MMP1 | Solarbio Life Sciences (синтез олигонуклеотидов на заказ) | Custom | RefSeq NM_002421; F: ATGAAGCAGCCCAGATGTGGAG; R: TGGTCCACATCTGCTCTTGGCA; URL: https://www.solarbio.com/ |
| NCBI Gene | National Center for Biotechnology Information | https://www.ncbi.nlm.nih.gov/gene/ | База данных генов человека |
| Обезжиренное сухое молоко, блокирующий реагент | Solarbio Life Sciences | D8340 | URL: https://www.solarbio.com/goodsInfo?id=1488 |
| org.Hs.eg.db | Bioconductor | https://bioconductor.org/packages/org.Hs.eg.db/ | Версия 3.21.0 |
| Готовый гель для SDS-PAGE, градиент 4%–20% | Solarbio Life Sciences | PG42010-S | URL: https://www.solarbio.com/goodsInfo?id=12646 |
| pROC | CRAN / авторы pROC | https://cran.r-project.org/package=pROC | Версия 1.19.0.1 |
| Смесь ингибиторов протеаз, 100× | Solarbio Life Sciences | P6730 | URL: https://www.solarbio.com/goodsInfo?id=25748 |
| Система переноса белков | Производитель/модель не указаны в рукописи | Не указано | Не задокументировано: точный производитель, модель и URL продукта; заявленное применение: перенос на мембрану PVDF 0,22-μm |
| Мембрана PVDF, 0,22 μm | Solarbio Life Sciences | YA1690 | URL: https://www.solarbio.com/goodsInfo?id=228106 |
| R | R Foundation for Statistical Computing | https://www.r-project.org/ | Версия 4.5.2 |
| randomForest | CRAN / авторы randomForest | https://cran.r-project.org/package=randomForest | Версия 4.7-1.2 |
| Прибор для ПЦР в реальном времени | Roche Diagnostics | LightCycler 96 | Версия ПО не подтверждена. Объем проекта/циклирование отличается от заявленного протокола; точная связь с экспериментом требует проверки. |
| Охлаждаемая микроцентрифуга | Производитель/модель не указаны в рукописи | Не указано | Не задокументировано: точный производитель, модель и URL продукта; заявленное применение: 12 000 × g в течение 15 мин при 4 °C |
| rentrez | CRAN / авторы rentrez | https://cran.r-project.org/package=rentrez | Версия 1.2.4 |
| Буфер для лизиса RIPA, высокой концентрации | Solarbio Life Sciences | R0010 | URL: https://www.solarbio.com/goodsInfo?id=1163 |
| Система электрофореза SDS-PAGE | Производитель/модель не указаны в рукописи | Не указано | Не задокументировано: точный производитель, модель и URL продукта; заявленное применение: разделение белков на градиентных гелях 4%–20% |
| Seurat | Satija Lab / разработчики Seurat | https://satijalab.org/seurat/ | Версия 5.5.0 |
| SingleR | Bioconductor | https://bioconductor.org/packages/SingleR/ | Версия 2.10.0 |
| Гомогенизатор тканей | Производитель/модель не указаны в рукописи | Не указано | Не задокументировано: точный производитель, модель и URL продукта; заявленное применение: гомогенизация тканей в ледяном буфере для лизиса |
| Реагент TriQuick для экстракции общей РНК | Solarbio Life Sciences | R1100 | URL: https://www.solarbio.com/goodsInfo?id=1083 |
| Tween-20 | Solarbio Life Sciences | T8220 | URL: https://www.solarbio.com/goodsInfo?id=102 |
| Ультрапрозрачные плоские крышки для полосок ПЦР-пробирок 0,2 mL | Axygen / Corning | PCR-2CP-RT-C | URL: https://ecatalog.corning.com/life-sciences/b2b/TW/en/Genomics-%26-Molecular-Biology/PCR-Consumables/PCR-Tubes-and-Strip-Tubes/Axygen%C2%AE-PCR-Strip-Caps/p/PCR-2CP-RT-C |
| Универсальный набор для ОТ-ПЦР (M-MLV) | Solarbio Life Sciences | RP1100 | URL: https://www.solarbio.com/goodsInfo?id=992 |
| WGCNA | CRAN / авторы WGCNA | https://cran.r-project.org/package=WGCNA | Версия 1.74 |
| Windows | Microsoft | https://www.microsoft.com/windows/windows-11 | Windows 11 |
Ссылки
- Armstrong DG, Tan TW, Boulton AJM, Bus SA. Diabetic foot ulcers: a review. JAMA. 2023;330(1):62–75.
- Bus SA et al. Guidelines on the prevention of foot ulcers in persons with diabetes (IWGDF 2023 update). Diabetes Metab Res Rev. 2024;40(3):e3651.
- Sloan G, Selvarajah D, Tesfaye S. Pathogenesis, diagnosis and clinical management of diabetic sensorimotor peripheral neuropathy. Nat Rev Endocrinol. 2021;17(7):400–20.
- Maione AG et al. Altered ECM deposition by diabetic foot ulcer-derived fibroblasts implicates fibronectin in chronic wound repair. Wound Repair Regen. 2016;24(4):630–43.
- Caley MP, Martins VLC, O'Toole EA. Metalloproteinases and wound healing. Adv Wound Care (New Rochelle). 2015;4(4):225–34.
- Lobmann R et al. Expression of matrix-metalloproteinases and their inhibitors in the wounds of diabetic and non-diabetic patients. Diabetologia. 2002;45(7):1011–6.
- Muller M et al. Matrix metalloproteinases and diabetic foot ulcers: the ratio of MMP-1 to TIMP-1 is a predictor of wound healing. Diabet Med. 2008;25(4):419–26.
- Theocharidis G et al. Single cell transcriptomic landscape of diabetic foot ulcers. Nat Commun. 2022;13(1):181.
- Vabalas A, Gowen E, Poliakoff E, Casson AJ. Machine learning algorithm validation with a limited sample size. PLoS One. 2019;14(11):e0224365.
- Lewis MJ et al. nestedcv: an R package for fast implementation of nested cross-validation with embedded feature selection designed for transcriptomics and high-dimensional data. Bioinform Adv. 2023;3(1):vbad048.
- Hattori N et al. MMP-13 plays a role in keratinocyte migration, angiogenesis, and contraction in mouse skin wound healing. Am J Pathol. 2009;175(2):533–46.
- Pang J, Maienschein-Cline M, Koh TJ. Monocyte/macrophage heterogeneity during skin wound healing in mice. J Immunol. 2022;209(10):1999–2011.
- Finley PJ et al. Diabetic wounds exhibit decreased Ym1 and arginase expression with increased expression of IL-17 and IL-20. Adv Wound Care (New Rochelle). 2016;5(11):486–94.
- Moon JY et al. IL-17A is increased in diabetic wounds and impairs keratinocyte function via histone demethylase JMJD3. Nat Commun. 2026;17(1):780.
- Xiao Y et al. Macrophages regulate healing-associated fibroblasts in diabetic wound. Mol Biol Rep. 2024;51(1):203.
- Theocharidis G et al. Integrated skin transcriptomics and serum multiplex assays reveal novel mechanisms of wound healing in diabetic foot ulcers. Diabetes. 2020;69(10):2157–69.
- Almeida AF et al. Bioavailability of quercetin in humans with a focus on interindividual variation. Compr Rev Food Sci Food Saf. 2018;17(3):714–31.
- Khoshandam A, Imenshahidi M, Hosseinzadeh H. Pharmacokinetic of berberine, the main constituent of Berberis vulgaris L.: a comprehensive review. Phytother Res. 2022;36(11):4063–79.