تقدم هذه الدراسة إطار عمل لأتمتة تصميم النماذج الأولية لواجهات المستخدم، يدمج بين مبادئ التصميم المعرفي، ونمذجة الألوان الإدراكية، والتعلم العميق. يعمل النظام على تحسين إمكانية الوصول، ووضوح التخطيط، والتناغم اللوني، والاتساق عبر الشاشات المختلفة، مما يؤدي إلى تصميمات واجهة متماسكة ومركزة حول المستخدم.
يتطلب اشتراك JoVE لعرض هذا المحتوى. تسجيل الدخول أو ابدأ نسخة تجريبية مجانية
مقالة بحثية
إطار عمل مؤتمت لإنشاء النماذج الأولية لواجهات المستخدم يدمج مبادئ التصميم المعرفي والبصري لتحسين قابلية الاستخدام ووضوح التخطيط
في هذه المقالة
ملخص
الملخص
يتطلب التصميم الفعال لواجهة المستخدم (UI) توازناً متناغماً بين الجاذبية البصرية، وسهولة الاستخدام المعرفية، واتساق التخطيط. ومع ذلك، تركز نهج توليد واجهات المستخدم التلقائية الحالية بشكل أساسي على المظهر البصري أو اكتشاف المكونات، وتفتقر إلى إطار عمل موحد يدمج المبادئ المعرفية، والذكاء اللوني، والاستدلال الهيكلي. علاوة على ذلك، تعاني الطرق الحالية من محدودية تعميم التخطيط، وضعف القابلية للتفسير، واختيار ألوان ثابت، وسلوك غير متسق عبر الشاشات. وفي هذا السياق، يقترح هذا العمل إطار عمل مؤتمت للنماذج الأولية لواجهة المستخدم يدمج اكتشاف المكونات القائم على الشبكة العصبية الالتفافية القائمة على المناطق الأسرع (Faster R-CNN) والنمذجة اللونية الإدراكية الموجهة بفضاء الألوان الموحد CIECAM02 (CAM02-UCS)، والمعززة بمبادئ التصميم المعرفي والبصري. تُستخدم Faster R-CNN لتحديد مكونات واجهة المستخدم واستنتاج الهياكل الهرمية من مجموعات بيانات الواجهات واسعة النطاق. كما تقوم وحدة توليد ألوان محسنة بتحليل صور العلامة التجارية أو الصور المرجعية لضمان سمات لونية متناغمة، وموحدة إدراكياً، ومتوافقة مع معايير سهولة الاستخدام باستخدام CAM02-UCS. ويتم تحسين هذه المخرجات بشكل أكبر من خلال قواعد التصميم المعرفي، بما في ذلك تجميع جشتالت (Gestalt grouping)، وقانون فيتس (Fitts’ law)، وقانون هيك (Hick’s law)، والتباعد القائم على الانتباه، ونمذجة التسلسل الهرمي البصري، وذلك لتوليد تخطيطات واجهة مستخدم منقحة وموجهة نحو المهام تلقائياً. وتظهر التجارب التي أُجريت على مجموعات بيانات RICO وENRICO وGuo’s UI Color أن النظام المقترح يحقق دقة اكتشاف للمكونات بنسبة 92.4%، ويحسن وضوح التخطيط ودقة ترتيب القراءة بنسبة 18.7%، وينتج لوحات ألوان صنفها المصممون بأنها أكثر تناغماً بنسبة 24.5% مقارنة بالطرق المرجعية. كما تشير تقييمات المستخدمين إلى انخفاض بنسبة 31% في الحمل المعرفي المدرك وزيادة بنسبة 28% في اتساق التصميم عبر الشاشات. وتثبت هذه النتائج أن الجمع بين الفهم الهيكلي القائم على التعلم العميق والنمذجة اللونية المرتكزة إدراكياً ومبادئ التصميم المعرفي ينتج نماذج أولية لواجهة المستخدم عالية الكفاءة، ومتماسكة جمالياً، وسهلة الاستخدام. ويؤسس هذا الإطار نهجاً مبتكراً وشاملاً للنماذج الأولية المؤتمتة لواجهة المستخدم الذكية والمتمركزة حول الإنسان.
المقدمة
تُعد واجهات المستخدم الرسومية (GUIs) وسيطاً أساسياً للتواصل بين البشر وأنظمة الكمبيوتر، حيث تؤثر بشكل كبير على سهولة الاستخدام، وإمكانية الوصول، وتجربة المستخدم (UX) بشكل عام1,2. وتعتمد أنظمة البرمجيات الحديثة على واجهات بديهية وجذابة بصرياً لجذب المستخدمين والحفاظ عليهم. وتقليدياً، يتضمن تصميم واجهة المستخدم إنشاء مخططات رسومية يقوم المهندسون لاحقاً بترجمتها إلى كود برمجي للواجهة الأمامية (front-end code). ومع ذلك، فإن الاختلافات في البروتوكولات الخاصة بكل منصة عبر أنظمة التشغيل المختلفة تتطلب تكييفاً متكرراً، مما يزيد من تعقيد عملية التطوير والجهد المبذول فيها. وبناءً على ذلك، برز التوليد الآلي لكود واجهة المستخدم كاتجاه بحثي مهم، مما يقلل من الجهد اليدوي ويعزز كفاءة التطوير.
تجمع النهج المبكرة لتوليد واجهات المستخدم (UI) آلياً بين تقنيات معالجة الصور التقليدية ونماذج التعلم العميق للكشف عن المناطق وتصنيفها3,4. وفي الوقت الحالي، تطبق الاستراتيجيات السائدة لتوليد أكواد واجهات المستخدم الرسومية (GUI) تقنيات الرؤية الحاسوبية لتحليل صور واجهة المستخدم وتحويلها إلى تمثيلات هيكلية للواجهة الأمامية (front-end)5,6,7. وبينما تعتمد طرق معالجة الصور على ميزات مصممة يدوياً، تعمل نهج التعلم العميق على استخراج تمثيلات هرمية من مجموعات بيانات واسعة النطاق. ونتيجة لذلك، استكشف الباحثون نهجاً هجينة تجمع بين التعلم العميق وتقنيات معالجة الصور المتخصصة في المجال لتحسين المتانة والدقة.
يعد اللون عاملاً حاسماً آخر في تصميم واجهة المستخدم (UI)، حيث يؤثر على إدراك المستخدم، وسهولة الاستخدام، والجاذبية الجمالية1. ويصبح الحفاظ على الاتساق بين محتوى الصورة ومخططات ألوان واجهة المستخدم أمراً صعباً عندما تختلف المدخلات المرئية في التدرج اللوني والسياق8,9,10. وبناءً على ذلك، ركزت أبحاث مكثفة على التوليد الآلي للوحات الألوان ونمذجة الألوان الإدراكية. وتشمل الطرق الحالية لتوليد الألوان تقنيات تعتمد على فضاء الألوان CIELAB11. وتستخدم مناهج أخرى خوارزميات التجميع، مثل k-means، لاستخراج الألوان السائدة من الصور12. ونتيجة لذلك، اعتمدت الأعمال الحديثة بشكل متزايد على مناهج قائمة على البيانات وتعلم الآلة لنمذجة الألوان.
بالتوازي مع ذلك، أدت مناهج التعلم العميق إلى تحسين اكتشاف مكونات واجهة المستخدم وفهم التخطيط بشكل كبير. فقد مكنت الشبكات العصبية من إجراء تحليل هيكلي أكثر دقة لواجهات الهاتف المحمول13. ومع ذلك، تركز هذه الطرق بشكل أساسي على دقة الاكتشاف وغالباً ما تغفل عن جوانب أعلى مستوى مثل سهولة الاستخدام المعرفية، والتسلسل الهرمي للتخطيط، وكفاءة التفاعل. كما تم اقتراح نماذج توليدية لتخليق تخطيط واجهة المستخدم14,15، ولكنها تواجه تحديات في الحفاظ على الاتساق عبر الشاشات وتقديم قرارات تصميم قابلة للتفسير16. وتركز مناهج أخرى على التشابه البصري أو جودة العرض ولكنها تفتقر إلى إطار عمل موحد يجمع بين دلالات المكونات، والتناغم اللوني، وقيود سهولة الاستخدام17. ويعد التعرف على النصوص أمراً مهماً أيضاً لفهم محتوى واجهة المستخدم؛ حيث تتيح تقنيات مثل الشبكات العصبية التكرارية الالتفافية (CRNNs) التعرف الدقيق على أنماط النصوص المعقدة في شاشات الواجهة18,19,20.
تم اقتراح عدة أنظمة لتوليد كود واجهة المستخدم (UI) من المخططات أو الصور. يستخدم نظام Sketch2Code تقنية اكتشاف الكائنات لتحويل المخططات إلى تمثيلات برمجية21,22، إلا أنه يتأثر بجودة الصور. بينما يوفر نظام REDRAW مساراً مؤتمتاً لجمع البيانات وتدريب النماذج، حيث يدمج بين الشبكات العصبية التلافيفية والمتكررة لتوليد تمثيلات هيكلية لواجهة المستخدم23,24. وقد قدمت أعمال لاحقة مقاييس تقييم محسنة لتقدير جودة واجهة المستخدم المولدة25. وتشمل المنهجيات الأكثر حداثة نماذج قائمة على الانتشار (diffusion-based) ونماذج قائمة على المحولات (transformer-based) لتوليد التخطيطات، مثل محولات تخطيط الانتشار دون استخدام طرق المشفر التلقائي، وتوليد تخطيط واجهة المستخدم الرسومية باستخدام رسوم ترتيب واجهة المستخدم الرسومية القائمة على المحولات، وتوليد تخطيط واجهة المستخدم بتوجيه من النماذج اللغوية الكبيرة26,27,28. ويقدم الجدول 1 نظرة عامة مقارنة لهذه المنهجيات.
| المراجع والمنهج(ات) الرئيسية | الهدف | المزايا | العيوب |
| توليد سمات ألوان واجهة المستخدم بناءً على الصور بشكل آلي: استخراج الألوان البارزة + نمذجة الألوان الإدراكية CAM02-UCS¹ | توليد سمات ألوان واجهة المستخدم تلقائياً من الصور المرجعية مع تحسين التناغم وسهولة الاستخدام. | تأسيس إدراكي قوي (CAM02-UCS)؛ يوازن بشكل صريح بين التناغم وسهولة الاستخدام (التباين والتنوع)؛ يتضمن تنفيذاً قائماً على الويب وتقييماً من قبل المصممين. | يركز فقط على اللون/السمة (وليس على التخطيط أو هيكلية المكونات)؛ يعتمد على القواعد/الاستدلالات بدلاً من التركيب الآلي لواجهة المستخدم المتعلم بالكامل. |
| توحيد توليد التخطيط باستخدام نموذج انتشار مفكك (LDGM)²⁵ | توليد تخطيطات موحدة ومرنة للمشاهد الرسومية وواجهات المستخدم. | تنوع وقابلية تحكم متطورة في توليد التخطيطات؛ يدعم التوليد الشرطي وأنواعاً متعددة من السمات. | قد تظهر مخرجات نماذج الانتشار مشكلات في المحاذاة أو تفاصيل التخطيط الدقيقة ما لم يتم تقييدها؛ تعقيد أعلى في النموذج وتكلفة أكبر في الاستنتاج. |
| محولات تخطيط الانتشار بدون طرق الترميز التلقائي: محول + انتشار لتوليد التخطيط (بدون ترميز تلقائي)²⁶ | تحسين الدقة والمحاذاة لمعايير توليد التخطيط (مقاييس FID والمحاذاة والتداخل). | التقاط أفضل للارتباطات الدلالية بين الكائنات المتجاورة؛ أداء قوي في مقاييس FID والمحاذاة. | يركز بشكل أساسي على هندسة التخطيط (المواقع، الأحجام، الفئات) بدلاً من دلالات واجهة المستخدم. |
| توليد تخطيط واجهة المستخدم الرسومية باستخدام نماذج قائمة على المحولات من رسوم ترتيب واجهة المستخدم الرسومية (GUI-AGs)²⁷ | إنشاء تخطيطات لواجهة المستخدم الرسومية من قيود موضعية/بيانية لمساعدة المصممين. | تلتقط التمثيلات البيانية القيود العلاقاتية؛ يتيح المحول توليداً مرناً مشروطاً بالقيود. | قد يتطلب رسوماً بيانية صريحة للقيود من المصممين؛ تركيز محدود على مقاييس الألوان وسهولة الاستخدام. |
| توليد تخطيط واجهة المستخدم باستخدام النماذج اللغوية الكبيرة الموجهة بقواعد واجهة المستخدم: النماذج اللغوية الكبيرة (LLMs) + قواعد واجهة مستخدم هرمية²⁸ | استكشاف النماذج اللغوية الكبيرة لتوليد التخطيطات وتحسين القابلية للتفسير/التحكم عبر تمثيلات القواعد. | قابلية تحكم وتفسير عالية المستوى؛ يمكن الاستفادة من التعلم في السياق من النماذج اللغوية الكبيرة (من نوع GPT). | عمل في مراحله الأولى مع تحقق تجريبي محدود؛ تصميم القواعد ومدى متانتها عبر واجهات المستخدم |
الجدول 1: مقارنة بين الطرق الحالية لنمذجة ألوان واجهة المستخدم وتوليد التخطيط. يلخص الجدول النهج التمثيلية لتصميم واجهة المستخدم، بما في ذلك توليد سمات الألوان، وتوليد التخطيط القائم على الانتشار، والطرق القائمة على المحولات (transformer)، وتوليد التخطيط الموجه بنماذج اللغات الكبيرة. ويتم عرض التقنية الأساسية، والهدف، والمزايا، والقيود لكل طريقة، مع تسليط الضوء على الاختلافات في النمذجة الإدراكية، والقدرة على توليد التخطيط، وقابلية التحكم، واعتبارات سهولة الاستخدام.
على الرغم من هذه التطورات، لا يزال هناك قصور أساسي: إذ لا يوجد نظام حالي يدمج بشكل مشترك بين اكتشاف المكونات، ونمذجة الألوان الإدراكية، ومبادئ التصميم المعرفي، واتساق التخطيط عبر الشاشات المتعددة ضمن إطار عمل واحد متكامل من البداية إلى النهاية1. وعادةً ما تعمل النهج الحالية على تحسين جانب واحد أو جانبين فقط — مثل الاكتشاف أو التخطيط أو اللون — دون النظر في الاعتمادات المتبادلة بينها. ويسلط هذا التجزؤ الضوء على فجوة بحثية حرجة في تطوير أنظمة مؤتمتة وموحدة لعمل نماذج أولية لواجهات المستخدم تكون متمحورة حول الإنسان. وبشكل خاص، غالباً ما يتم التعامل مع مبادئ التصميم المعرفي، مثل قوانين Gestalt، وقانون Fitts، وقانون Hick، من منظور مفاهيمي بدلاً من دمجها رسمياً في النماذج الحسابية.
لمعالجة هذه المحدوديات، تقترح هذه الدراسة إطار عمل مؤتمتاً وشاملاً لإنشاء نماذج أولية لواجهات المستخدم يدمج بين اكتشاف المكونات، ونمذجة الألوان الإدراكية، ومبادئ التصميم المعرفي ضمن نظام موحد. وقد صُمم إطار العمل هذا لتحسين جودة المخطط، وتقليل العبء المعرفي، وتعزيز التناغم اللوني، وزيادة القابلية العامة للاستخدام. وقد تم التحقق من هذه التحسينات من خلال تجارب أجريت على مجموعات بيانات RICO وENRICO وGuo’s UI Color، مما أظهر فعالية الدمج بين الجوانب الهيكلية والإدراكية والمعرفية ضمن مسار مؤتمت واحد لإنشاء نماذج واجهات المستخدم الأولية. وتفترض الدراسة أن دمج اكتشاف المكونات القائم على التعلم العميق، ونمذجة الألوان الإدراكية، ومبادئ التصميم المعرفي ضمن إطار عمل موحد سيؤدي إلى تحسين جودة النماذج الأولية لواجهات المستخدم بشكل كبير مقارنة بالنهج الحالية. وتحديداً، تقترح الفرضية H1 أن إطار العمل يعزز جودة المخطط، بما في ذلك المحاذاة، والتجميع، وترتيب القراءة. وتفترض الفرضية H2 أن إطار العمل يقلل من العبء المعرفي للمستخدم. بينما تشير الفرضية H3 إلى أن نمذجة الألوان الإدراكية تحسن تنسيق الألوان والتناغم البصري. وتنص الفرضية H4 على تحسن القابلية العامة للاستخدام والجودة الجمالية للنماذج الأولية لواجهات المستخدم.
الوصول مقيد. يرجى تسجيل الدخول أو بدء فترة تجريبية لعرض هذا المحتوى.
البروتوكول
تستخدم هذه الدراسة مجموعات بيانات متاحة للعامة ولا تتضمن مشاركين من البشر أو الحيوانات.
يدمج إطار عمل النمذجة الأولية الآلي لواجهة المستخدم المقترح بين الفهم الهيكلي القائم على التعلم العميق، ونمذجة الألوان الموحدة إدراكيًا، ومبادئ التصميم المعرفي لإنشاء نماذج أولية لواجهات متماسكة ومركزة حول المستخدم. تبدأ المنهجية ببنية Faster R-CNN مدربة على مجموعتي بيانات RICO وENRICO للكشف عن مكونات واجهة المستخدم واستخراج علاقاتها الهرمية، مما يتيح تفسيرًا دقيقًا لمخططات الشاشات المتنوعة. ثم تتم معالجة المكونات المكتشفة بواسطة وحدة ذكاء الألوان، التي تستخرج دلالات الألوان القائمة على العلامة التجارية أو الصور، وتنمذج التشابه الإدراكي باستخدام CAM02-UCS، وتنشئ لوحات ألوان متناغمة وواعية بالتباين ومتوافقة مع معايير إمكانية الوصول. لاحقًا، يتم تطبيق مبادئ التصميم المعرفي — بما في ذلك قوانين تجميع Gestalt، وقانون Fitts، وقانون Hick، والتباعد القائم على الانتباه، وقيود التسلسل الهرمي البصري — من خلال محرك تحسين معرفي لتنقيح التنظيم المكاني ومحاذاة المكونات. وأخيرًا، تقوم طبقة استدلال المخطط بدمج القيود الهيكلية والإدراكية والمعرفية لإنشاء نماذج أولية لواجهات مستخدم متسقة عبر شاشات متعددة توازن بين سهولة الاستخدام والجماليات والوضوح الوظيفي. يضمن مسار العمل المتكامل هذا التماسك الإدراكي، ويقلل من العبء المعرفي، ويلتزم بمبادئ التصميم المتمحور حول الإنسان. يوضح الشكل 1 سير العمل الكامل للطريقة المقترحة.
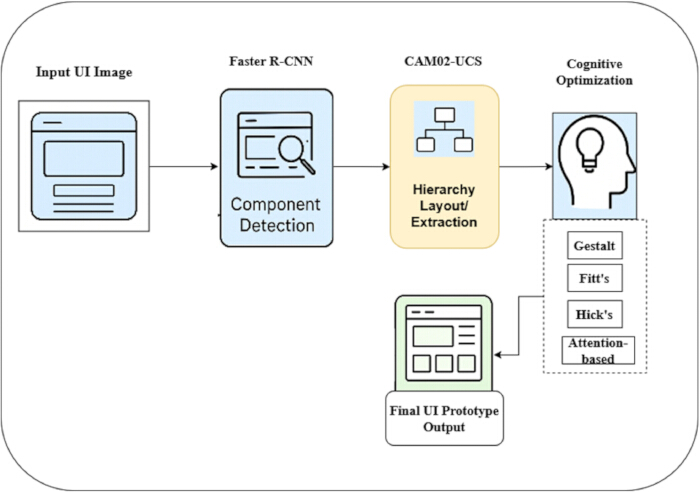
الشكل 1. البنية العامة لإطار عمل النمذجة الأولية الآلي لواجهة المستخدم المقترح. يوضح المخطط التسلسل الكامل للعملية، بدءاً من صورة واجهة المستخدم المدخلة. يتم إجراء الكشف عن المكونات باستخدام Faster R-CNN لتحديد عناصر الواجهة. ثم تُعالج المكونات المكتشفة باستخدام النمذجة الإدراكية القائمة على CAM02-UCS لاستخراج التسلسل الهرمي والتخطيط. بعد ذلك، يُطبق التحسين المعرفي باستخدام مبادئ Gestalt وقانون Fitts وقانون Hick والتعديلات القائمة على الانتباه. وتشير الأسهم إلى تدفق البيانات بين الوحدات، مما يؤدي في النهاية إلى مخرج النموذج الأولي لواجهة المستخدم. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
نظرة عامة على الإطار العملي
الشكل 1 يوضح سير العمل الكامل لإطار عمل بناء نماذج واجهة المستخدم الآلي المقترح، والذي يحول لقطة شاشة خام لواجهة المستخدم إلى نموذج أولي منقح معرفياً. تبدأ العملية بصورة واجهة المستخدم المدخلة، والتي تُمرر إلى وحدة اكتشاف المكونات القائمة على Faster R-CNN. تحدد هذه الوحدة عناصر الواجهة مثل الأزرار والأيقونات وحقول النصوص والحاويات، وتستخرج المربعات المحيطة وتسميات الفئات المقابلة لها. يتم بعد ذلك معالجة المكونات المكتشفة في مرحلة استخراج التسلسل الهرمي والتخطيط. وبناءً على العلاقات المكانية والأنماط الهيكلية، يقوم النظام ببناء شجرة تخطيط هرمية تعكس كيفية إدراك المستخدمين لتنظيم الشاشة بشكل طبيعي. يجسد هذا التمثيل التجميع البصري والتبعيات الهيكلية بين عناصر واجهة المستخدم. ثم يتم تنقيح التخطيط المستخرج من خلال التحسين المعرفي عبر تطبيق مبادئ التصميم المتمحور حول الإنسان. وتشمل هذه المبادئ تجميع "جشتالت" (Gestalt) للتكتل البصري، وقانون "فيتس" (Fitts’ law) لتحسين حجم أهداف اللمس وإمكانية الوصول، وقانون "هيك" (Hick’s law) لتقليل تعقيد اتخاذ القرار، والتباعد القائم على الانتباه لتحسين التسلسل الهرمي البصري. ونتيجة لذلك، يصبح التخطيط أكثر بديهية وقابلية للقراءة وكفاءة في تفاعل المستخدم. وأخيراً، يتم دمج التخطيط المُحسَّن مع نمذجة الألوان الإدراكية لإنشاء نموذج أولي متسق لواجهة المستخدم. وتكون الواجهة الناتجة دقيقة هيكلياً، ومنسجمة بصرياً، ومتوافقة مع توقعات سهولة الاستخدام البشرية.
تم تنفيذ إطار العمل باستخدام PyTorch 2.0 على نظام Ubuntu 22.04. وأُجريت التجارب على نظام مجهز بوحدة معالجة رسومات NVIDIA RTX 4090 GPU (بذاكرة وصول عشوائي للفيديو 24 GB VRAM). استخدم نموذج Faster R-CNN هيكل ResNet-50 مدرباً مسبقاً على مجموعة بيانات ImageNet. نُفذ التدريب باستخدام مُحسن الانحدار الاشتقاقي العشوائي (SGD) بمعدل تعلم قدره 0.001، وحجم دفعة 16، ولمدة تصل إلى 60 دورة (epoch). طُبق التوقف المبكر لمنع الإفراط في التخصيص باستخدام مجموعة تحقق تشمل 20% من البيانات. ورغم أن التدريب استمر لما يصل إلى 60 دورة، إلا أن التقارب كان يتحقق عادةً في وقت أبكر من خلال التوقف المبكر بناءً على فقدان مجموعة التحقق. وتم ضبط الزخم واضمحلال الوزن على 0.9 و0.0005 على التوالي. وتضمنت عملية زيادة البيانات التسوية، والقلب الأفقي العشوائي، والقص العشوائي وتغيير الحجم.
تحضير مجموعة البيانات
لدعم إطار عمل النمذجة الأولية المؤتمتة لواجهات المستخدم المقترح، تم استخدام ثلاث مجموعات بيانات متكاملة: ENRICO29، وRICO30، ومجموعة بيانات Guo لألوان واجهات المستخدم1. تحتوي مجموعة بيانات RICO على 66,261 شاشة واجهة مستخدم لنظام Android تم جمعها من 9,700 تطبيق، مما يوفر تنوعاً واسع النطاق للكشف عن المكونات واستخراج التخطيط الهرمي. وتتضمن ENRICO 1,464 لقطة شاشة عالية الجودة لواجهات المستخدم مصنفة يدوياً إلى 20 نمط تصميم، مما يتيح تحسين التعميم للاستدلال الهيكلي ونمذجة اتساق التخطيط. أما مجموعة بيانات Guo لألوان واجهات المستخدم فتتكون من 128 صورة منسقة لواجهات المستخدم مع سمات ألوان مشروحة، والتي تُستخدم في نمذجة الألوان الإدراكية وتقييم لوحات الألوان. ومع ذلك، ونظراً لحجمها الصغير نسبياً، قد تؤدي مجموعة البيانات هذه إلى إدخال بعض التباين في خصائص التخطيط. ولأغراض هذه الدراسة، تم إعداد مجموعة بيانات مجمعة مكونة من 5,128 شاشة للتدريب والتقييم. وتحديداً، تم استخدام ما يقرب من 4,000 صورة من RICO لتدريب نموذج Faster R-CNN للكشف عن المكونات، واستخدام 1,000 صورة من ENRICO لتعلم أنماط التخطيط ونمذجة الاتساق الهيكلي، واستخدام 128 صورة من مجموعة بيانات Guo لمهام تقييم الألوان. وقد تم توحيد جميع الصور بدقة 480 × 800 بكسل، وتحويلها إلى فضاء ألوان sRGB موحد، وإعادة شرحها بصناديق إحاطة موحدة وبيانات وصفية هرمية لضمان التوافق بين مجموعات البيانات. ويرد عرض عام لمجموعات البيانات المستخدمة في هذه الدراسة في الجدول 2. تدعم مجموعة بيانات RICO الكشف واسع النطاق عن مكونات واجهة المستخدم والتحليل الهيكلي، بينما تعزز ENRICO قدرة النموذج على التعرف على أنماط التخطيط وفرض الاتساق عبر الشاشات. وتلعب مجموعة بيانات Guo لألوان واجهات المستخدم، رغم صغر حجمها، دوراً حاسماً في تقييم التناغم اللوني الإدراكي ونمذجة التباين. وتوفر هذه المجموعات معاً أساساً شاملاً ومتوازناً لتدريب والتحقق من وتقييم إطار عمل النمذجة الأولية المؤتمتة لواجهات المستخدم المقترح.
| مجموعة البيانات | إجمالي الصور المتاحة | الصور المستخدمة في الدراسة | الغرض في الإطار المقترح |
| RICO Dataset30 | 66,261 | 4,000 | كشف مكونات واجهة المستخدم، استخراج المخطط الهيكلي |
| ENRICO Dataset29 | 1,464 | 1,000 | تعلم أنماط التصميم، نمذجة اتساق المخطط |
| Guo’s UI Color Dataset1 | 128 | 128 | استخراج سمات الألوان، التقييم الإدراكي للألوان |
| الإجمالي المدمج | 67,853 | 5,128 | مجموعة بيانات شاملة للكشف، والمخطط، ونمذجة الألوان |
الجدول 2: ملخص لمجموعات البيانات المستخدمة في الإطار المقترح. يعرض الجدول مجموعات البيانات المستخدمة للتدريب والتقييم، بما في ذلك مجموعات بيانات RICO وENRICO وGuo’s UI Color. ويوضح الجدول العدد الإجمالي للصور المتاحة، والمجموعة الفرعية المستخدمة في هذه الدراسة، والدور المحدد لكل مجموعة بيانات في اكتشاف المكونات، ونمذجة التخطيط، وتحليل الألوان الإدراكي ضمن الإطار المقترح.
تم استخدام استراتيجية أخذ عينات طبقية للحفاظ على التنوع في مكونات واجهة المستخدم، وهياكل التخطيط، وتوزيعات الألوان عبر مجموعات بيانات RICO وENRICO وGuo. تم تقسيم مجموعة البيانات إلى مجموعات فرعية للتدريب (70%)، والتحقق (15%)، والاختبار (15%) باستخدام أخذ العينات الطبقية. وتم تطبيع الصور باستخدام المتوسط (0.485 و0.456 و0.406) والانحراف المعياري (0.229 و0.224 و0.225). شمل تعزيز البيانات قلباً أفقياً عشوائياً (الاحتمالية = 0.5) واقتصاصاً عشوائياً (نطاق المقياس: 0.8–1.0)، متبوعاً بتغيير الحجم إلى 224 × 224 بكسل طُبق أثناء التدريب.
توصيف المكونات والمعالجة المسبقة
تدعم مجموعات بيانات RICO وENRICO وGuo’s UI Color مجتمعة المكونات الوظيفية الأساسية الثلاثة لإطار عمل النمذجة الأولية التلقائية لواجهة المستخدم المقترح، وهي: اكتشاف المكونات، ونمذجة المخطط، وتحسين الألوان الإدراكي. تحتوي مجموعة بيانات RICO على مجموعة واسعة النطاق تضم أكثر من 66,000 شاشة واجهة مستخدم للهواتف المحمولة، وتُستخدم بشكل أساسي لتدريب وحدة اكتشاف المكونات؛ حيث تتيح تنوعاتها نموذج Faster R-CNN لتعلم تمثيلات قوية لعناصر واجهة المستخدم الشائعة مثل الأزرار والصور وحقول النصوص عبر نطاق واسع من التطبيقات، مما يضمن دقة الاكتشاف وتحديد مواقع مكونات واجهة المستخدم في ظل ظروف تصميم متنوعة. وتوفر مجموعة بيانات ENRICO شاشات واجهة مستخدم عالية الجودة وموسومة بالأنماط لتعلم العلاقات الهيكلية وأنماط المخططات، مما يمكن النظام من فهم العلاقات بين المكونات، والتنظيم الهرمي، وقوالب التصميم الشائعة؛ وتلعب هذه المجموعة دوراً حاسماً في نمذجة هياكل المخططات وفرض الاتساق عبر الشاشات المتعددة، مما يسمح لإطار العمل بتوليد مخططات تتماشى مع اتفاقيات التصميم المعتمدة. وفي المقابل، تُستخدم مجموعة بيانات Guo’s UI Color خصيصاً للنمذجة اللونية الإدراكية والمعرفية، وبخلاف RICO وENRICO اللتين تركزان على الجوانب الهيكلية، تحتوي هذه المجموعة على صور مختارة لواجهات المستخدم مع سمات لونية مشروحة، وتُستخدم هذه الشروحات لتدريب وحدات استخراج الألوان وتقييم التناغم اللوني. ومن خلال رسم خرائط العلاقات اللونية في مساحات لونية إدراكية مثل CAM02-UCS، يتعلم إطار العمل توليد لوحات ألوان توازن بين التباين، وإمكانية الوصول، والتماسك الجمالي. تشكل هذه المجموعات معاً مساراً متكاملاً: حيث تدعم RICO اكتشاف المكونات، وتتيح ENRICO فهم أنماط المخططات والاتساق الهيكلي، وتسهل مجموعة بيانات Guo التحسين اللوني الإدراكي. ويضمن هذا التكامل أن تكون النماذج الأولية لواجهة المستخدم المُولدة دقيقة هيكلياً، ومتناغمة بصرياً، ومحسنة معرفياً.
تم إجراء التسوية باستخدام متوسط [0.485, 0.456, 0.406] وانحراف معياري [0.229, 0.224, 0.225]. كما طُبقت تقنيات تعزيز البيانات، بما في ذلك الاقتصاص العشوائي، والقلب الأفقي، والتدوير، لتحسين تعميم النموذج. بالإضافة إلى ذلك، تم تغيير مقياس قيم البكسل لتصبح ضمن النطاق [0, 1]، وتم تغيير حجم جميع الصور إلى دقة 480 × 800 بكسل لضمان الاتساق عبر مجموعات البيانات. وتُستخدم الصور التي تم تغيير حجمها إلى 224 × 224 بكسل لعملية التعزيز أثناء التدريب، بينما يتم الحفاظ على الدقة الأصلية 480 × 800 بكسل لتحليل المخطط. كما تم ضبط المربعات المحيطة لتصفية التعليقات التوضيحية غير ذات الصلة باستخدام عتبات محددة مسبقاً. ولتحقيق التوحيد عبر مجموعات البيانات، تم وضع تعليقات توضيحية يدوياً لجميع عناصر واجهة المستخدم باستخدام أداة التعليق التوضيحي LabelImg. كما تم وضع مخطط محدد مسبقاً قبل عملية التعليق التوضيحي لتصنيف عناصر واجهة المستخدم إلى فئات مثل الزر، والنص، والصورة، والأيقونة، والحاوية. ولتمثيل المربعات المحيطة، تم تطبيق نظام إحداثيات موحد، وبناء معلومات هرمية بناءً على العلاقات المكانية بين العناصر وارتباطات الأب والابن ضمن شجرة المخطط. بالإضافة إلى ذلك، تم وضع إرشادات لضمان اتساق التعليقات التوضيحية للعناصر، والتعامل السليم مع المكونات المتداخلة، وفرض عتبات الحد الأدنى للحجم عبر مجموعات بيانات RICO وENRICO وGuo.
تتوفر الصيغ الرياضية المفصلة لتدريب الكشف عن المكونات واستخلاص نمط المخطط في الملف التكميلي 1.
تم تدريب نموذج Faster R-CNN باستخدام خوارزمية SGD بزخم قدره 0.9 واضمحلال وزني قدره 0.0005. تم تعيين معدل التعلم الأولي عند 0.001، وجرى تعديله باستخدام سياسة اضمحلال تدريجي (step decay) بناءً على أداء التحقق. استمر التدريب لمدة تصل إلى 60 حقبة (epochs) بحجم دفعة قدره 16. كما تم تطبيق التوقف المبكر لمنع فرط التخصيص، وذلك باستخدام مجموعة تحقق تشمل 20% من بيانات التدريب.
تأخذ دالة التعيين f(.) عناصر واجهة المستخدم المكتشفة كمدخلات وتُنتج تمثيلاً تخطيطياً هرمياً كمخرجات. وتقوم الدالة بحساب علاقات التجاور بين عناصر واجهة المستخدم بناءً على المسافة المكانية ومعايير المحاذاة، وتنشئ مصفوفة تجاور لتمثيل هذه العلاقات. بعد ذلك، يتم تطبيق خوارزمية تجميع، مثل DBSCAN، لتجميع المكونات ذات الصلة. وأخيراً، تُنظم العناصر المجمعة في هياكل هرمية بناءً على علاقات الأب والابن، مما يشكل تمثيلاً تخطيطياً منظماً.
تتوفر الصيغ التفصيلية لنمذجة التناغم اللوني وهدف التحسين الموحد في الملف التكميلي 1.
تضع دالة الهدف هذه صياغة رياضية لعملية دمج الكشف الهيكلي، والاستدلال بالتخطيط، ونمذجة الألوان الإدراكية، مما يضمن مساهمة جميع مكونات الإطار عمل معاً في إنشاء نماذج أولية لواجهة المستخدم تكون متماسكة ومركزة على المستخدم. يتم إجراء التحسين بطريقة نمطية لكل مكون من مكونات الإطار. يُستخدم خوارزمية SGD لتدريب وحدة الكشف عن المكونات، بينما يُستخدم محسن Adam أثناء التحسين المشترك للهدف الموحد. ويُستخدم الهدف المدمج لتوجيه الأداء العام للنظام. وفي مراحل التحسين المشترك، يتم تقليل دالة الهدف باستخدام محسن Adam بمعدل تعلم قدره 0.001 وحجم دفعة يبلغ 16. يتم تنفيذ التدريب لمدة تصل إلى 60 حقبة (epochs)، مع تطبيق التوقف المبكر عندما يكون التغير في خسارة التحقق أقل من 10−4 لخمس حقبات متتالية.
كشف المكونات باستخدام Faster R-CNN
يستخدم الإطار المقترح نموذج Faster R-CNN للكشف التلقائي عن مكونات واجهة المستخدم (UI)، بما في ذلك الأزرار، والأيقونات، وحقول النصوص، والصور، والحاويات. ويعد Faster R-CNN مناسباً جداً لهذه المهمة لأنه يجمع بين الدقة العالية في اكتشاف الكائنات والتوليد الفعال لمقترحات المناطق، وهو أمر ضروري للتعامل مع تخطيطات واجهة المستخدم المعقدة التي تحتوي على عناصر متراصة بكثافة. يعتمد النموذج على هيكل ResNet-50 مدرب مسبقاً على مجموعة بيانات ImageNet لاستخراج خرائط الميزات التلافيفية من كل شاشة واجهة مستخدم. وأثناء التدريب، تم تجميد الطبقات المبكرة للحفاظ على الميزات البصرية العامة، بينما تم ضبط الطبقات العليا (conv4_x و conv5_x) بدقة للكشف عن المكونات الخاصة بواجهة المستخدم. وتعمل خرائط الميزات هذه على التقاط الهياكل البصرية، والحواف، والأنسجة، وحدود المكونات. وأثناء عملية الكشف، تحدد شبكة مقترحات المناطق (RPN) المناطق المرشحة (anchors) التي يُحتمل أن تحتوي على مكونات واجهة المستخدم. وتُحدد هذه المرابط باستخدام مقاييس متعددة (128 و 256 و 512) ونسب عرض إلى ارتفاع (1:1 و 1:2 و 2:1) لاستيعاب عناصر واجهة المستخدم ذات الأحجام المختلفة. وأثناء التدريب، يتم تصنيف المرابط التي تزيد قيمة التقاطع فوق الاتحاد (IoU) فيها عن 0.7 مقارنة بصناديق الحقيقة الأرضية (ground truth boxes) على أنها إيجابية، بينما تُصنف تلك التي تقل قيمة IoU فيها عن 0.3 على أنها سلبية؛ ويتم تجاهل المرابط ذات قيم IoU المتوسطة. ويتم تعيين احتمالية لكل مرابط تشير إلى وجود مكون ما. بعد ذلك، يتم تطبيق تقنية كبت غير القيم القصوى (NMS) لإزالة المقترحات المكررة والمتداخلة، مما يضمن تحديداً فعالاً لعناصر واجهة المستخدم ذات الدلالة حتى في الواجهات المزدحمة. وبمجرد توليد المناطق المرشحة، يتم تصنيف كل مقترح ضمن فئات مكونات محددة مسبقاً، ويتم تحسين إحداثيات صندوق الإحاطة الخاص به. وتقوم عملية محاذاة منطقة الاهتمام (ROI Align) باستخراج تمثيلات ميزات ذات حجم ثابت لكل مقترح، والتي يتم معالجتها بعد ذلك بواسطة طبقات متصلة بالكامل للتصنيف والانحدار. ويُخرج فرع التصنيف احتمالات الفئة، بينما يتنبأ فرع الانحدار بإحداثيات دقيقة لصندوق الإحاطة. يتم تدريب نموذج Faster R-CNN بالكامل من البداية إلى النهاية عن طريق تحسين دالة خسارة مشتركة تجمع بين خسارة RPN وخسارة الكشف النهائية. وهذا يمكن النظام ليس فقط من التعرف بدقة على مكونات واجهة المستخدم، ولكن أيضاً من تحديد موقعها بدقة عبر هياكل الواجهات المتنوعة. ويتوفر وصف تفصيلي للكشف عن مكونات Faster R-CNN، بما في ذلك مرحلة RPN، وتصنيف ROI، وتحسين صندوق الإحاطة، وهدف التحسين النهائي، في الملف التكميلي 1.
الخوارزمية S1 توفر سير عمل مفصلاً للكشف عن المكونات والاستخراج الهيكلي (الملف التكميلي 1). وهي تصف العملية الكاملة للكشف التلقائي عن مكونات واجهة المستخدم والاستخراج الهيكلي من صورة شاشة خام. يتم أولاً معالجة الصورة المدخلة مسبقاً وتمريرها عبر هيكل CNN لاستخراج الميزات البصرية العميقة. وتستخدم هذه الميزات بواسطة RPN لإنشاء مربعات إحاطة مرشحة، والتي يتم تحسينها بعد ذلك من خلال التصنيف والانحدار. وتقوم NMS بإزالة عمليات الكشف الزائدة لضمان التحديد الدقيق للمواقع. وعقب عملية الكشف، يتم تجميع المكونات بناءً على التقارب المكاني باستخدام التجميع المكاني القائم على الكثافة للتطبيقات مع الضوضاء (DBSCAN). تتيح خطوة التجميع هذه بناء شجرة واجهة مستخدم هرمية تلتقط علاقات الأب والابن والمجموعات المنطقية بين المكونات. ويشكل هذا التمثيل الهرمي الأساس لتحليل التخطيط وفهم واجهة المستخدم اللاحق. توضح الشكل 2 عملية الكشف عن المكونات باستخدام Faster R-CNN على شاشة واجهة مستخدم للهاتف المحمول. تحتوي الواجهة المدخلة (يساراً) على عناصر واجهة مستخدم مثل الأزرار والكتل النصية، والتي يتم إحاطتها تلقائياً داخل مربعات إحاطة. ثم يتم تصنيف هذه المناطق المكتشفة إلى فئات من المكونات (على سبيل المثال، الزر والنص)، كما هو موضح من خلال الوصلات المصنفة. وتقوم وحدة الكشف Faster R-CNN (يميناً) بتحسين إحداثيات مربعات الإحاطة، وتعيين التسميات الدلالية، وإخراج معلومات مهيكلة على مستوى المكونات. وتعمل هذه الخطوة كقاعدة أساسية للعمليات اللاحقة، بما في ذلك استخراج التخطيط، والتحسين المعرفي، وإنشاء نماذج أولية لواجهة المستخدم، من خلال توفير تمثيلات دقيقة وذات معنى دلالي لمكونات واجهة المستخدم.
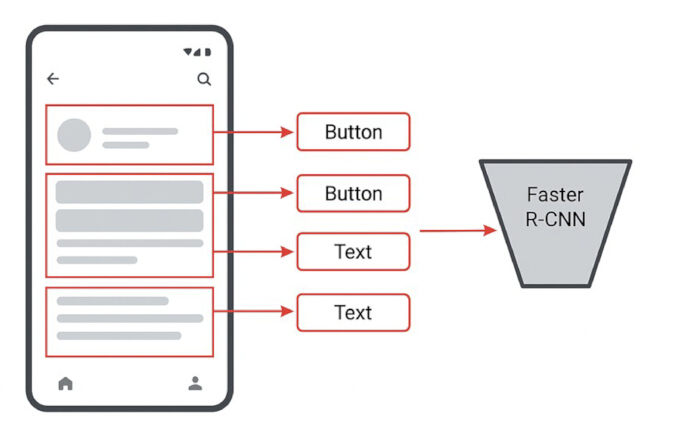
الشكل 2. الكشف عن مكونات عناصر واجهة المستخدم باستخدام Faster R-CNN. يوضح الشكل عملية الكشف عن مكونات واجهة المستخدم من لقطة شاشة لواجهة إدخال. يتم تحديد المناطق ذات الأهمية باستخدام مربعات الإحاطة، ويتم تصنيف العناصر مثل الأزرار وحقول النصوص باستخدام Faster R-CNN. وتشير الأسهم إلى تعيين المكونات المكتشفة إلى تسمياتها الدلالية المقابلة. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
استخراج نمط التخطيط والنمذجة الهرمية
بعد الكشف عن المكونات باستخدام Faster R-CNN، يتم تمثيل كل عنصر من عناصر واجهة المستخدم بواسطة مربع إحاطة. ومع ذلك، فإن مربعات الإحاطة هذه وحدها لا توضح كيفية تنظيم العناصر هيكلياً داخل الواجهة، على سبيل المثال، أي العناصر تنتمي إلى الترويسات، أو أشرطة التنقل، أو مناطق المحتوى المجمعة. ولمعالجة هذا القصور، يتم تحويل المكونات المكتشفة إلى شجرة واجهة مستخدم منطقية، حيث يتم التعامل مع كل مكون كعقدة، وتُجمع المكونات المرتبطة وظيفياً أو بصرياً تحت عقد أصل مشتركة. ولتحديد مجموعات التخطيط ذات الدلالة، يتم تطبيق تقنيات التجميع مثل DBSCAN أو التجميع الهرمي التراكمي. وتحلل هذه الطرق التقارب المكاني وأنماط المحاذاة بين المكونات للكشف عن العلاقات بين عناصر واجهة المستخدم. وبأسلوب مشابه لممارسات التصميم البشري، يتعلم النظام التعرف على الأنماط الهيكلية الشائعة مثل الترويسات، والتذييلات، والشبكات، وكتل المحتوى. وبمجرد إنشاء التجميع، يتم تحليل خصائص هيكلية إضافية — بما في ذلك المحاذاة، والتنظيم الشبكي، وترتيب القراءة — لبناء تمثيل شامل للتخطيط. فعلى سبيل المثال، قد تشير المكونات المحاذية في أعمدة متساوية العرض إلى تخطيط قائم على البطاقات، بينما قد تشير العناصر المكدسة رأسياً إلى واجهة قائمة على النماذج أو الخلاصات. ومن خلال دمج التجميع، والاستنتاج المكاني، وقواعد المحاذاة، يبني الإطار شجرة واجهة مستخدم هرمية تلتقط كلاً من التجميع البصري والعلاقات الوظيفية. ويعمل هذا التمثيل الهرمي كأساس لعمليات تحسين التخطيط اللاحقة ونمذجة الاتساق عبر الشاشات المتعددة، مما يمكن النظام من توليد تصميمات واجهة منظمة ومتماسكة ومرتكزة على المستخدم.
تتوفر الصيغ التفصيلية للمسافة المكانية وتشابه المحاذاة في الملف التكميلي 1.
التجميع لغرض تجميع المخطط (DBSCAN)
يتم تطبيق خوارزمية DBSCAN لتحديد مجموعات التخطيط. تستخدم DBSCAN معاملين هما: (1) ε = المسافة القصوى بين المكونات المتجاورة، و(2) MinPts = الحد الأدنى لعدد المكونات المطلوبة لتكوين عنقود. وفي هذا التحليل، تم اختيار معاملات DBSCAN تجريبياً بناءً على دقة واجهة المستخدم المعيارية (480 × 800 pixels). وقد تم ضبط معامل مسافة الجوار على ε = 50 pixels لرصد التقارب المكاني بين مكونات واجهة المستخدم المتجاورة. كما تم ضبط الحد الأدنى لعدد النقاط المطلوبة لتكوين عنقود على MinPts = 3 لتجنب تكوين مجموعات غير مؤثرة أو زائفة من مكونات واجهة المستخدم.
تتوفر صيغة بناء شجرة واجهة المستخدم المنطقية المفصلة في الملف التكميلي 1.
نمذجة الألوان الإدراكية باستخدام CAM02-UCS
يضمن نمذجة الألوان الإدراكية أن تكون الألوان المستخدمة في واجهة المستخدم (UI) المُنشأة متناغمة، ومقروءة، وفعالة إدراكياً. يتم استخراج الألوان السائدة من مصادر الإدخال، مثل صور واجهة المستخدم، باستخدام تقنيات التجميع (clustering). وتحديداً، يتم تطبيق تجميع K-means مع تهيئة K-means++ لمدة 300 تكرار للحصول على لوحات ألوان تمثيلية. ومع ذلك، فإن فضاء الألوان RGB لا يعكس بدقة الإدراك البصري البشري، مما يعني أن الألوان المتشابهة رقمياً قد تظهر مختلفة إدراكياً. ولمعالجة هذا القصور، يتم تحويل جميع الألوان المستخرجة إلى CAM02-UCS، وهو فضاء منتظم إدراكياً. وفي هذا الفضاء، تتوافق المسافات المتساوية مع اختلافات لونية متساوية من حيث الإدراك، مما يجعله مناسباً لنمذجة التناغم والتباين اللوني. وبمجرد تعيينها في CAM02-UCS، يتم حساب الاختلافات اللونية الإدراكية باستخدام المسافة الإقليدية، مما يتيح للنظام قياس التباين، والتناغم، والتباين بين الألوان. يتم الفصل بين الألوان شديدة التشابه لتحسين المقروئية، بينما يتم تخفيف حدة الألوان شديدة التباين لتجنب الإزعاج البصري. كما تلتزم لوحة الألوان المُنشأة بمعايير إمكانية الوصول مثل WCAG AA و AAA، مما يضمن وجود تباين كافٍ بين عناصر المقدمة والخلفية. علاوة على ذلك، يتم فرض التناغم اللوني من خلال تقييد علاقات لوحة الألوان لتتبع مخططات مكملة أو متناغمة أو ثلاثية، اعتماداً على سمة واجهة المستخدم المقصودة. ويضمن ذلك أن تكون لوحة الألوان الناتجة جذابة بصرياً، ومتاحة وظيفياً، ومحسنة إدراكياً. ولإجراء مزيد من التحسين على لوحة الألوان، يتم تطبيق عملية تحسين تحت قيود التشابه الإدراكي، والتباين، والتناغم، واتساق العلامة التجارية. يتم اختيار لون أساسي (على سبيل المثال، من هوية العلامة التجارية)، وتُعدل الألوان الثانوية من حيث السطوع والكروم لالحفاظ على التسلسل الهرمي البصري. وتقوم آلية تقييم قائمة على القواعد بفحص لوحات الألوان المرشحة بناءً على المسافات الإدراكية ومقاييس إمكانية الوصول، مما يقلل من الجهد الإدراكي مع الحفاظ على التوازن الجمالي. ونتيجة لذلك، ينتج هذا الإطار مخططات ألوان لواجهة المستخدم تتميز بتماسك ومقروئية واتساق إدراكي على مستوى احترافي.
تتوفر التعبيرات الرياضية التفصيلية لنمذجة اللون الإدراكي القائمة على CAM02-UCS في الملف التكميلي 1.
الخوارزمية S2 (الملف التكميلي 1) تصف سير عمل استخراج الألوان الإدراكي وتحسينه بناءً على CAM02-UCS تحت قيود التناغم وإمكانية الوصول. في البداية، يتم استخراج الألوان السائدة من الصورة المدخلة وتحويلها إلى CAM02-UCS لضمان أن الفروق اللونية تتوافق مع الإدراك البشري. بعد ذلك، يتم حساب المسافات الإدراكية بين الألوان وتقييدها ضمن حدود محددة مسبقاً للحفاظ على كل من الوضوح والتناغم. لاحقاً، يتم فرض إمكانية الوصول من خلال تقييم نسب تباين السطوع وفقاً لإرشادات WCAG. يتم الحصول على لوحة الألوان النهائية عن طريق تحسين دالة هدف مدمجة توازن بين التباعد الإدراكي، ومتطلبات التباين، وقيود التناغم اللوني. يضمن ذلك أن مخططات ألوان واجهة المستخدم الناتجة ليست جذابة بصرياً فحسب، بل هي أيضاً مقروءة، ومتاحة، ومتسقة إدراكياً.
تحسين التصميم المعرفي
يضمن تحسين التصميم المعرفي ألا تكون نماذج واجهة المستخدم المُنشأة تلقائيًا متسقة بصريًا فحسب، بل أن تكون أيضًا سهلة الفهم والتفاعل. تدمج هذه الوحدة مبادئ التصميم المعرفي الأساسية، بما في ذلك مبادئ "جشتالت" (Gestalt)، وقانون فيتس (Fitts’ law)، وقانون هيك (Hick’s law)، لتوجيه ترتيب مكونات واجهة المستخدم وتجميعها وتوزيع المسافات بينها. تتوفر الصيغ الرياضية التفصيلية لتحسين التصميم المعرفي في الملف التكميلي 1.
الهدف المتكامل لتحسين الإدراك
يتوفر التعبير الرياضي لهدف التحسين المعرفي المتكامل في الملف التكميلي 1. يُرمز للمعاملات التي تمثل أهمية التجميع البصري، وكفاءة التفاعل، وتعقيد اتخاذ القرار بـ alpha و beta و gamma على التوالي. في هذه الدراسة، تم تحديد قيم alpha و beta و gamma تجريبياً باستخدام مجموعة بيانات التحقق. وبالنسبة للتجربة الحالية، تم تعيين المعاملات كما يلي: α = 0.5، و β = 0.3، و γ = 0.2. يوفر هذا التكوين توازناً فعالاً بين التجميع البصري وكفاءة التفاعل وبساطة اتخاذ القرار.
اتساق الشاشات المتعددة وتوليد واجهة المستخدم
يضمن نمذجة اتساق الشاشات المتعددة أن تشترك الشاشات المختلفة داخل التطبيق في هوية بصرية وتخطيط هيكلي ونمط تفاعل متماسك. فبينما يتنقل المستخدمون عبر الشاشات، تتكون لديهم توقعات بشأن مواضع العناصر، وطباعة النصوص، والتباعد، والتسلسل الهرمي البصري. ولتلبية هذه التوقعات، يقوم النظام بتحليل الأنماط العابرة للشاشات باستخدام قوالب مشتقة من مجموعات بيانات RICO وENRICO. تلتقط هذه القوالب هياكل واجهة المستخدم الشائعة مثل تخطيطات (الصفحة الرئيسية–التفاصيل)، وأنماط (القائمة–التفاصيل)، والنماذج متعددة الخطوات، وتدفقات لوحات التحكم. ومن خلال مقارنة مواضع المكونات وسلوك التجميع، يبني النظام ملفاً هيكلياً عابراً للشاشات يحدد العناصر التي يجب أن تظل متسقة وتلك التي يمكن أن تختلف. وبمجرد تحديد الأنماط الهيكلية، يفرض الإطار الاتساق في مقاييس الطباعة، ونسب التباعد، وتخطيطات الشبكة، ومراسي التنقل. على سبيل المثال، تحافظ أشرطة العناوين على ارتفاع ثابت، وتحتفظ الأزرار الأساسية بحجم ومحاذاة موحدين، وتتبع كتل المحتوى ترتيباً بصرياً متوقعاً. ويتم تحقيق ذلك من خلال عملية تسوية التخطيط التي تقيم كل شاشة مقابل قيود هيكلية عالمية. وإذا انحرفت شاشة ما عن القوالب المتعلمة — مثل وجود حواشي غير متسقة أو عناوين غير محاذية — يقوم النظام بتعديل التخطيط تلقائياً لاستعادة التماسك. تساعد هذه التصحيحات في ضمان تجربة مستخدم (UX) سلسة وتقليل تكاليف التبديل المعرفي بين الشاشات. علاوة على ذلك، يحلل الإطار مخطط التنقل بين الشاشات للحفاظ على الاتساق في تدفق التفاعل. ويتم تحديد وفرض أنماط التنقل الشائعة، بما في ذلك الانتقالات الأمامية/الخلفية، والتنقل المبوب، وسير العمل متعدد الخطوات. ويتم التحقق من صحة كل انتقال لضمان توافقه مع النموذج الذهني للمستخدم، مما يؤدي إلى تحسين سهولة الاستخدام وتقليل الارتباك. ونتيجة لذلك، يقلل نموذج اتساق الشاشات المتعددة من الضجيج البصري، ويعزز الألفة، ويرتقي بتجربة تفاعل موحدة.
تتوفر الصيغ الرياضية التفصيلية للاتساق متعدد الشاشات وإنشاء واجهة المستخدم في الملف التكميلي 1.
أخيراً، يقوم محرك الصيرورة بإنشاء مخرجات مرئية بتنسيقات مثل المخططات الهيكلية SVG، أو النماذج الأولية HTML/CSS، أو نماذج واجهة المستخدم القائمة على البكسل. وتُظهر شاشات واجهة المستخدم الناتجة ترتيباً صحيحاً للقراءة، وعلاقات لونية متناغمة، ومحاذاة دقيقة للشبكة، وتسلسلاً هرمياً بصرياً متسقاً عبر شاشات متعددة.
الخوارزمية S3 توفر سير عمل تحسين المخطط الإدراكي-البصري والاتساق عبر الشاشات المتعددة (الملحق 1). تصف الخوارزمية S3 عملية التحسين الإدراكي والهيكلي المتكاملة المستخدمة لإنشاء مخططات واجهة مستخدم سهلة الاستخدام. وهي تجمع بين التجميع الإدراكي (مبادئ Gestalt)، وكفاءة التفاعل (قانون Fitts)، وبساطة اتخاذ القرار (قانون Hick) ضمن إطار تحسين موحد. في البداية، يتم تقييم العلاقات المكانية بين المكونات لإنشاء مجموعات إدراكية. ثم يتم تحسين كفاءة التفاعل عن طريق ضبط حجم المكونات ومواقعها، بينما يتم التحكم في تعقيد القرار من خلال الحد من عدد الخيارات المقدمة للمستخدمين. بالإضافة إلى ذلك، تفرض الخوارزمية الاتساق عبر الشاشات المتعددة من خلال مواءمة كل شاشة مع قوالب تخطيط متعلمة، مما يضمن التوحيد في الطباعة، والتباعد، والتنظيم الهيكلي. بعد ذلك، تقوم دالة تحسين متعددة الأهداف بتنقيح المخطط من خلال الموازنة بين المحاذاة والتباعد والتكلفة الإدراكية، مما ينتج عنه واجهة متماسكة بصرياً وفعالة إدراكياً. وبوجه عام، تضمن هذه الخوارزمية أن تحافظ المخططات الناتجة للشاشات المتعددة على مستويات عالية من الاتساق البصري، وسهولة الاستخدام، والوضوح الإدراكي.
الوصول مقيد. يرجى تسجيل الدخول أو بدء فترة تجريبية لعرض هذا المحتوى.
النتائج
تم تقييم إطار عمل النمذجة الأولية الآلية لواجهات المستخدم المقترح باستخدام مجموعة بيانات متكاملة تضم 5,128 شاشة واجهة مستخدم من ثلاثة مصادر: 4,000 صورة من RICO، و1,000 شاشة من ENRICO، و128 عينة واجهة مستخدم مشروحة بالألوان من مجموعة بيانات Guo لـ UI Color. وتوفر مجموعة البيانات المختلطة هذه معيارًا متوازنًا لتقييم دقة اكتشاف المكونات، ووضوح الهيكل التخطيطي، والاتساق عبر الشاشات المتعددة، والتناغم اللوني الإدراكي.
تظهر النتائج التجريبية أن نموذج الكشف القائم على Faster R-CNN يحقق دقة في الكشف ع...
الوصول مقيد. يرجى تسجيل الدخول أو بدء فترة تجريبية لعرض هذا المحتوى.
المناقشة
تُظهر النتائج تحسنات ذات دلالة إحصائية في سهولة الاستخدام، والتنظيم الهيكلي، والجودة الإدراكية (p < 0.05)، مما يؤكد فعالية دمج مبادئ التصميم المعرفي في النمذجة الأولية المؤتمتة لواجهات المستخدم. وبخلاف أنظمة توليد واجهات المستخدم التقليدية التي تعتمد بشكل أساسي على الكشف البصري أو الاستدلالات القائمة على القواعد، يدمج الإطار المقترح تجميع "جشتالت"، ونمذجة التسلسل الهرمي، وقيود التباعد، والقابلية للقراءة الإدراكية طوال عملية إعادة بناء واجهة المستخدم بأكملها. كما تؤكد التحسينات الملحوظة في مقاييس NASA-TLX وSUS وSET حد...
الوصول مقيد. يرجى تسجيل الدخول أو بدء فترة تجريبية لعرض هذا المحتوى.
الإفصاحات
ليس لدى المؤلفين أي تضارب في المصالح.
شكر وتقدير
يقر المؤلفون بالدعم الأكاديمي والمؤسسي المقدم من كلية ووهان للغات الأجنبية &؛ وزارة الشؤون الخارجية، وجامعة Keimyung، ومعهد شنغهاي للتجارة واللغات الأجنبية أثناء إتمام هذا البحث.
الوصول مقيد. يرجى تسجيل الدخول أو بدء فترة تجريبية لعرض هذا المحتوى.
المواد
| الاسم | الشركة | رقم فهرسي | التعليقات |
|---|---|---|---|
| وحدة المعالجة المركزية (المعالج) | AMD Ryzen 9 7950X (16-core, 32-thread, 4.5–5.7 GHz) | Advanced Micro Devices (AMD), USA | Ryzen 9 7950X |
| مجموعة أدوات CUDA Toolkit | الإصدار 11.8 | NVIDIA Corporation, USA | CUDA Toolkit 11.8 |
| cuDNN | الإصدار 8.9 | NVIDIA Corporation, USA | cuDNN v8.9 |
| Faster R-CNN | نموذج لكشف الأشياء (مع شبكة اقتراح المناطق) | Meta AI Research / Detectron2 | Detectron2 framework |
| Matplotlib | الإصدار 3.7 | Matplotlib Development Team | v3.7.0 |
| وحدة معالجة الرسوميات NVIDIA RTX 4090 GPU | بطاقة رسوميات 24 GB GDDR6X | NVIDIA Corporation, Santa Clara, CA, USA | RTX 4090 |
| NumPy | الإصدار 1.24 | NumPy Developers | v1.24.0 |
| OpenCV | الإصدار 4.8 | OpenCV Foundation | v4.8.0 |
| PyTorch | الإصدار 2.0 | PyTorch Foundation (Meta AI) | v2.0.0 |
| ResNet-50 مع FPN | شبكة عصبية تلافيفية أساسية مع شبكة هرم الميزات | Microsoft Research / Detectron2 | ResNet-50-FPN |
| Scikit-learn | الإصدار 1.3 | Scikit-learn Developers | v1.3.0 |
| SciPy | الإصدار 1.10 | SciPy Community | v1.10.0 |
| ذاكرة النظام (RAM) | 64 GB DDR5 | Corsair / Kingston (أو ما يعادلها) | DDR5 64GB Kit |
| نظام التشغيل Ubuntu | الإصدار 22.04 LTS | Canonical Ltd., UK | Ubuntu 22.04 LTS |
المراجع
- Weingerl P. Automated image-based user interface color theme generation. Appl Sci. 2024;14:2850.
- Feng Z, Fang J, Cai B, Zhang Y. Guis2Code: Computer vision tool to generate code automatically from graphical user interface sketches. In: Proc Int Conf Artif Neural Netw; 2021; p. 53–65.
- Chen C, Zhang X, Yang Y, Li Y. GalleryDC: Design search knowledge discovery through auto-created GUI component gallery. Proc ACM Hum Comput Interact. 2019;3:1–22.
- Chen J, et al. Object detection for graphical user interface: Old-fashioned deep learning combination. In: Proc ACM Eur Softw Eng Conf Symp Found Softw Eng; 2020; p. 1202–1214.
- Xie M, et al. UIED: Hybrid tool for GUI element detection. In: Proc ACM Eur Softw Eng Conf Symp Found Softw Eng; 2020; p. 1655–1659.
- Gijsenij A, et al. Determining key colors from a design perspective using dE-means color clustering. Color Res Appl. 2023;48:69–87.
- Yuan LP, et al. InfoColorizer: Interactive recommendation of color palettes for infographics. IEEE Trans Vis Comput Graph. 2022;28:4252–4266.
- Cao Y, et al. Influences of color salience and location of website links on user performance and affective experience. Int J Hum Comput Interact. 2021;37:547–559.
- Liu W, Cao Y, Proctor RW. App icon color and border shape influence visual search efficiency and user experience. Int J Ind Ergon. 2021;84:103160.
- Yamin PAR, Park J, Kim HK, Hussain M. Effects of button colour and background on augmented reality interfaces. Behav Inf Technol. 2023;43:663–676.
- Deng L, Zhang ZR, Zhou FY, Liu RY. Effects of app icon border form and interface background color saturation. Adv Multimed. 2022;2022:1166656.
- Weingerl P, Hladnik A, Javoršek D. Machine learning model for extracting image prominent colors. Color Res Appl. 2020;45:409–426.
- Huang K, et al. WovenProbe: Probing possibilities for on-skin systems. In: Proc ACM Des Interact Syst Conf; 2021; p. 1193–1207.
- Dewez D, Guillemot C, Bailly G, Isenberg T. Dual body representations during an isomorphic 3D manipulation. IEEE Trans Vis Comput Graph. 2022;28:2047–2057.
- Kim J, Kim C, Nam KY. ThinkWrite: Design interventions for online petition deliberation. In: Proc CHI Conf Hum Factors Comput Syst Ext Abstr; 2022.
- Gao L, Wang Y, Müller S, Hudson SE. DataLev: Mid-air data physicalisation using acoustic levitation. In: Proc CHI Conf Hum Factors Comput Syst; 2023; p. 1–14.
- Khorsandi PM, Ogata M, Rekimoto J, Inami M. FabriCar: In-car media interactions using e-textile sensors. In: Proc ACM Des Interact Syst Conf; 2023; p. 764–776.
- Zhang Z, Ding Y, Huang C. Automatic front-end code generation via multi-head attention. In: Proc Int Conf Comput Eng Appl; 2023; p. 869–872.
- Jain V, et al. Sketch2code: Transformation of sketches to UI using deep neural network [preprint]. arXiv:1910.08930; 2019.
- Chai Y, et al. Dynamic prototype network for few-shot malware detection. IEEE Trans Knowl Data Eng. 2023;35:4754–4766.
- Qiu J, et al. AI security in 5G networks: Adversarial examples. IEEE Veh Technol Mag. 2020;15:95–100.
- Qiu J, et al. Automatic concept extraction from big data in smart city. IEEE Trans Comput Soc Syst. 2020;7:225–233.
- Xie M. UI2CODE: Computer vision-based reverse engineering of UI design [Internet]. GitHub; 2021. Available from: https://github.com
- Wang C, Bochkovskiy A, Liao HYM. CSPNet: Backbone enhancing learning capability of CNNs. In: Proc IEEE Conf Comput Vis Pattern Recognit Workshops; 2020; p. 1571–1580.
- Hui M, et al. Unifying layout generation with decoupled diffusion model. In: Proc IEEE Conf Comput Vis Pattern Recognit; 2023; p. 18434–18443.
- Wang Y, et al. Dolfin: Diffusion layout transformers without autoencoder. In: Proc Eur Conf Comput Vis; 2024; p. 513–530.
- Sobolevsky A, et al. GuiLGet: GUI layout generation with transformer [preprint]. arXiv:2304.09012; 2023.
- Lu Y, et al. UI layout generation with LLMs guided by UI grammar [preprint]. arXiv:2310.15455; 2023.
- Leiva LA, Hota A, Oulasvirta A. ENRICO: A dataset for mobile UI design modeling. In: Proc Int Conf Hum Comput Interact Mobile Devices Serv; 2020.
- Li G, et al. Learning to denoise mobile UI layouts. In: Proc CHI Conf Hum Factors Comput Syst; 2022; p. 1–15.
- Beltramelli T. pix2code: Generating code from a GUI screenshot. In: Proc ACM SIGCHI Symp Eng Interact Comput Syst; 2018.
- Zheng G, et al. LayoutDiffusion: Controllable diffusion model. In: Proc IEEE Conf Comput Vis Pattern Recognit; 2023; p. 18424–18433.
الوصول مقيد. يرجى تسجيل الدخول أو بدء فترة تجريبية لعرض هذا المحتوى.