细胞三维电子显微镜技术的瓶颈在于高度复杂的三维密度图中的特征提取(分割)。我们已制定了一套标准,可指导针对不同类型的数据选择最合适的分割方法(手动、半自动或全自动),从而为高效分割提供起点。
本文内容
摘要
摘要
近年来,现代三维电子显微镜技术使得人们对细胞和组织的三维超微结构组织获得了前所未有的深入认识,能够可视化大分子复合体(如黏附复合物)以及更高层级的结构(如细胞骨架和细胞器)在其特定的细胞和组织环境中的分布。鉴于细胞体积固有的复杂性,必须首先提取出感兴趣的特征,才能实现对其三维结构的可视化、定量分析,进而理解其组织规律。每个数据集都具有不同的特征,例如,信噪比、数据的清晰度(锐度)、特征的异质性、特征的密集程度、是否存在易于识别的特征性形状,以及特定感兴趣区域在整个体积中所占的百分比。在选择分割方法时,必须综合考虑所有这些特征。
本文展示了六组不同的三维超微结构数据集,这些数据集通过三种不同的成像方法获得:树脂包埋染色电子断层扫描,以及分别对轻度染色和重度染色样品进行的聚焦离子束-扫描电镜(FIB-SEM)和连续块面-扫描电镜(SBF-SEM)成像。针对这些数据集,应用了四种不同的分割方法:(1)完全手动建模,仅进行模型可视化;(2)手动追踪分割数据后进行表面渲染;(3)半自动化方法后进行表面渲染;或(4)采用定制的自动化分割算法,随后进行表面渲染和定量分析。根据数据集特征的不同组合,通常这四种类别方法中的一种表现优于其他方法,但根据具体判断标准的顺序,也可能有多种方法均取得成功。基于这些数据,我们提出了一种分诊方案,用于对客观的数据集特征和主观的个人分析标准进行分类,以指导不同数据集的分析工作。
引言
传统上,电子显微镜(EM)领域分为两个分支:1)结构生物学分支,使用高分辨率和超高分辨率透射电子显微镜(TEM),通常结合隐式或显式的数据平均技术,用于研究组成明确且通常尺寸相对较小的大分子复合物的三维(3D)结构1-4;以及 2)细胞成像分支,用于可视化完整的细胞场景1,5,6。尽管结构生物学分支在过去四十年中取得了显著进展,细胞生物学分支则大多局限于二维成像,且常基于保存状态欠佳的样品。直到近十年电子断层扫描技术的出现,细胞生物学的超微结构成像才拓展至第三维度5,7,而在此维度中通常无法进行数据平均,因为细胞场景及其所关注的结构特征通常是独一无二的。
尽管可视化细胞场景通常具有极佳的视觉效果,但对这些高度复杂的细胞三维体积中感兴趣特征的有效提取以及后续的定量分析却相对滞后,部分原因在于蛋白质的精确组成通常未知,因此难以解释这些细胞的三维体积结构。迄今为止,解读复杂的断层图像,甚至识别三维体积中的重要区域和关键组分,往往需要大量的生物学专业知识。此外,三维体积的可视化本身也极具挑战性。三维体积可被视为一系列堆叠的二维图像并据此进行可视化。逐层检查连续的二维图像虽可降低复杂性,但也限制了特征提取和定量分析仅限于二维层面。然而,对于大多数三维对象而言,将三维体积简单地表示为连续切片的堆叠,会导致对特定系统三维特性的理解不完整且存在偏差。其他可视化方式则需要体渲染或表面渲染,而鉴于细胞体积通常结构密集,这些方法容易导致内部嵌套结构被遮挡,或使用户完全难以分辨,从而使交互式手动分割变得困难。
为解决这些障碍,已开发出多种自动特征提取(分割)方法,这些方法通常基于密度或梯度8-10。然而,这些方法倾向于对整个体积进行分割,而不论专家所关注的具体区域或特征为何,尽管一些较新的方法能够针对特定感兴趣的特征(如肌动蛋白丝)进行分割11。此外,执行自动分割的程序有时会产生大量子体积(例如,在应用分水岭浸没分割时),这些子体积通常需要手动合并回完整的感兴趣特征,或需进一步分割。对于复杂且密集的数据集尤其如此,因此大多数渲染计算机算法无法保真地仅提取感兴趣的特征,通常需要专家投入大量策展工作才能获得理想的分割体积。
此外,针对高度特定问题的定制化解决方案通常以学术会议论文的形式发表,很少强调将其开发为广泛且全面的工具,使得那些对数学、计算机科学和/或计算机图形学领域缺乏深入了解的研究人员难以使用。一个包含多种图像分析库的可定制编程软件环境,可以成为一套强大的工具,使用户能够高效地编写自己的模块以实现精确的图像分割。然而,要充分利用该环境在图像分析方面的众多功能或能力,需要接受 extensive 的培训并具备计算机科学背景。对于某些特征较为稀疏的数据集,可以在这样的多功能软件环境中开展工作,例如,利用基于形状的强大方法,通过“模板”的独特几何结构将目标对象与其周围环境分离开来12,13。
目前存在多种用于交互式手动分割和模型构建的计算机图形可视化软件包。部分软件为商业产品,而另一些则源自学术机构并免费分发,例如:加州大学旧金山分校的 Chimera14、科罗拉多大学的 IMOD15 以及德克萨斯大学奥斯汀分校的 VolumeRover16。然而,这些程序所具备的广泛功能和复杂特性使得每款软件的学习曲线较为陡峭。某些可视化软件可提供简单的几何模型(如不同尺寸的球体和棍状结构),可将其置入密度图中以构建复杂三维体积的简化模型。此类模型支持进行基本的几何与体积测量,因而超越了单纯的“美观图像”功能。这种手动追踪方法适用于仅需追踪和提取少量对象的体积数据。然而,近年来利用聚焦离子束扫描电子显微镜(FIB-SEM)17-20 或连续块面扫描电子显微镜(SBF-SEM)21 实现的大体积三维超微结构成像技术迅速发展,带来了新的挑战:三维数据集的规模可从数吉字节(GB)到数十乃至数百吉字节,并可达到太字节(TB)级别。因此,如此庞大的三维体积数据几乎无法通过人工方式进行特征提取,故而在可预见的未来,高效且由用户引导的半自动特征提取将成为三维体积数据分析的主要瓶颈之一。
本文展示了四种常用于多种生物图像类型的分割方法。随后,通过比较这些方法在不同类型数据集上的有效性,汇总形成一份指南,以帮助生物学家确定最适合其自身数据有效特征提取的分割方法。由于大多数所述软件程序均有详尽的用户手册,本文的目的并非使潜在用户熟悉其中任何一个特定软件包,而是通过将这些不同的分割策略应用于六个具有不同特征的示例数据集,展示各自的优势与局限性。通过这一比较,建立了一套评估标准,这些标准或基于三维数据集的客观图像特征(如数据对比度、清晰度、密集程度和复杂性),或源于主观考量因素(如分割的目标、待分割特征的形态、感兴趣特征的种群密度——即感兴趣特征所占体积比例,以及在时间与人员等有限资源条件下如何进行最优操作)。这些不同的示例数据集展示了如何依次组合应用上述客观与主观标准,从而实现特定特征提取方法与特定类型数据集之间的匹配。所提供的建议有望帮助初学者在面对众多分割选项时,选择出最适合其自身三维体数据的分割方法。
尽管本文的重点是特征提取,但数据采集和预处理对于高效的分割至关重要。样本染色常常不均匀,因此在分割过程中应考虑潜在的染色伪影。然而,染色通常能提供更高的信噪比,因而对细胞体积数据所需的滤波及其他数学处理较少,而这些处理本身也可能引入伪影。相应的原始图像数据集需要在正确的对比度和相机像素设置下获取,并进行对齐,然后重建为三维体数据。对于断层图像,通常采用加权反投影法对对齐后的图像进行重建,随后数据集通常会经过去噪算法处理,例如非线性各向异性扩散22、双边滤波23或递归中值滤波24。FIB-SEM 和 SBF-SEM 成像数据则通过使用 ImageJ25 等程序在 XY 平面上对连续切片进行互相关来实现对齐。可应用对比度增强和滤波方法以增强目标特征,从而降低图像堆栈的噪声。滤波可在选取子区域之前对整个体数据进行,也可在选定的子区域上进行,因为某些滤波方法计算成本较高。数据的降采样(binning)有时用于降低噪声和/或减小文件大小,但仅当数据的采样密度显著高于预期分辨率时才建议使用。
经过降噪处理后,可采用多种方法对图像进行分割,本研究重点关注以下四种方法:(1)通过构建球棍模型手动抽象生成模型,(2)手动追踪感兴趣特征,(3)基于自动阈值的密度分割,(4)通过脚本实现针对特定项目的定制化自动分割。边界分割8和沉浸式分水岭分割10是比简单阈值法更优的替代方案,但它们属于同一类别,因此未在本文中单独列出讨论。
手动追踪密度需要逐层勾画出感兴趣区域的特征,从而保留各个亚细胞区域原有的密度信息。该方法能够对分割过程实现最大程度的控制,但过程繁琐且耗费大量人力。
基于阈值(及相关)的自动密度分割方法属于半自动方法,其算法根据用户定义的一组参数来选择像素。目前有多种学术性(免费)可视化软件包可供使用,例如 UCSF Chimera、IMOD、Fiji26 和 VolumeRover,同时也存在商业性软件包(需购买许可证),这两类软件通常都包含一种或多种此类分割方法。本研究中用于演示这些不同方法的软件包既包括商业程序,也包括学术开源程序,可用于手动构建抽象模型,以及进行手动和自动密度分割。然而,开源软件有时可通过定制化提供更高级的功能选项。
使用不同类型数据集对这些技术进行比较,得出了关于如何处理具有不同特征的生物数据三维体分割的规则与指导原则,据我们所知,该内容尚未被发表。因此,这是首次系统性地比较各种方法在不同数据集上的适用性,以满足具有不同研究目标的用户需求。
方案
1. 手动抽象模型生成
注意:下述方法的详细步骤专用于 Chimera,但也可使用其他软件包。当唯一目标是创建几何模型(例如,球棍模型)以进行几何测量,而非显示对象的体积形状时,可采用此方法。
- 将数据体导入合适的程序以进行手动抽象模型的生成。
- 选择 文件 > 打开地图,以调出“打开文件”对话框。导航至所需地图文件的存储位置。
- 调出“体数据查看器”(工具 > 体数据 > 体数据查看器),然后选择 功能 > 显示样式,以使用不同的渲染样式显示数据。
- 在“体数据查看器”窗口中,通过拖动直方图中的垂直条来调整显示的阈值。
- 浏览三维体数据(例如,逐层浏览),选择用于分割的目标区域,必要时裁剪出一个较小的子体积。
- 在“体数据查看器”对话框中,点击 轴,然后选择 X、Y 或 Z。
- 在“体数据查看器”对话框中,选择 功能 > 平面。点击 单个 以设置 深度,显示左侧框中数字对应的平面;点击 全部 以显示所有平面。
- 在“体数据查看器”对话框中,选择 功能 > 子区域选择。
- 点击并拖动,在目标区域周围创建一个矩形框。
- 沿目标特征放置标记,并在适当位置用连接线将其连接(通常由程序自动完成),直至模型完成。
- 从“体数据查看器”菜单栏中选择 工具 > 体数据追踪器 对话框,以打开“体数据追踪器”对话框。在该对话框中,选择 文件 > 新建标记集。
- 在“体数据追踪器”对话框中,勾选 鼠标 > 在高质量位置放置标记、在数据平面上放置标记、移动和调整标记大小、将新标记连接到所选标记,以及 连续选择的标记自动连接。
- 点击 标记颜色 色块,选择一种颜色。对 连接线颜色 重复此步骤。
- 输入用于构建标记和连接线模型的半径值。
- 在“体数据追踪器”窗口中,使用[右键]鼠标选择 放置标记,并输入标记和连接线的半径。
- 在体数据上右键单击,开始放置标记。标记将自动连接。
- 在“体数据追踪器”对话框中,选择 文件 > 保存当前标记集,然后选择 文件 > 关闭标记集。
- 打开一个新的标记集(步骤 1.3.1),开始对第二个目标特征构建模型。使用不同标记集之间的对比色,以突出特征差异。
2. 手动追踪感兴趣特征
注意:下述方法学的细节特定于 Amira 软件,但也可使用其他软件包。当种群密度相对较低且特征提取的准确性至关重要时,可采用此方法,因为手动追踪是一种耗时的方法。
- 将体数据导入具备手动描记功能的软件中。具备此类功能的软件通常至少提供基础的画笔工具。
- 对于大体积或断层扫描图像(例如16位 2,048 × 2,048 或更大尺寸的 .rec 或 .mrc 断层图像(在 IMOD 中生成):选择 开放数据 > 右键单击文件名.rec > 格式… >选择 Raw 作为 LargeDiskData > 好的 > 加载. 从标题信息中选择适当的原始数据参数 > 好的切换和 另存为 一种新的 filename.am 用于后续步骤的文件。
- 对于较小的 3D 图像堆栈文件(例如,3D .tif 或 .mrc 或 .rec: 开放数据 > 选择文件名.tif 或 文件名.mrc。切换并右键单击 > 另存为 filename.am如果出现错误或程序无响应,可能是文件过大,可按照步骤 2.1.1 打开文件。
- 浏览切片以选择用于分割的三维子区域,然后裁剪至该目标区域。
- 在 3D 查看器窗口中,选择 正交切片 打开图像文件。使用底部的滑块浏览切片。
- 在“资源池”窗口中切换文件名以裁剪作为 LargeDiskData 打开的较大数据 > 右键单击 > LatticeAccess. 输入所需的方框尺寸 > 应用. 保存新文件。
- 创建分割文件。
- 在资源池窗口中切换文件 > 右键单击 > 标记 > 标签字段将创建一个新文件,并自动在分割编辑器选项卡中加载。
- 描画出第一个感兴趣特征的边界,然后通过手动或使用特定软件的命令填充该轮廓。在所有切片中追踪该感兴趣特征,并重复进行手动描画分割。使用 Amira 时,请采用以下命令:
- 使用画笔工具时,根据需要调整画笔大小,然后用鼠标指针描绘目标特征的边界。
- 使用快捷键“f”填充已描边的区域。通过点击带有加号的按钮或使用快捷键“a”来添加选区。如有需要,按“u”撤销操作,按“s”进行减选或擦除。
- 根据软件用户指南的说明,生成表面渲染图像以进行可视化及基本的定性或定量分析。
- 在对象池选项卡中,切换池窗口中的 filename-labels.am 文件 > 右键单击 > SurfaceGen.
- 选择所需 表面性质 > 应用将在Pool中创建一个新文件filename.surf。
- 为了可视化分割后的体积,在池窗口中切换 filename.surf > 右键单击 > 表面视图.
- 使用 3DViewer 窗口中的工具对 3D 图像进行移动、旋转和缩放。
- 提取精确的密度值,并测定体积或表面积等参数。导出至其他程序以进行更高级的显示、分析和模拟。
- 在 3DViewer 窗口中,点击 测量工具 > 选择合适的选项 (在单个二维平面上进行测量时使用二维长度和二维角度,在三维体积上进行测量时使用三维长度和三维角度)。
- 单击网格表面以测量所需的长度、距离和角度。测量值将显示在属性窗口中。
3. 基于密度的自动分割
注意:下述方法学的详细信息专指 Amira 软件,但也可使用其他软件包替代。
- 可将此方法应用于具有各种对比度、清晰度或密集程度的数据集,以提取感兴趣的密度区域。
- 将体数据导入具备阈值分割、魔棒工具或其他基于密度的自动分割功能的软件中。具体操作步骤请参照手动描记指南中的 2.1–2.1.2 节。
- 浏览各切片并选择用于分割的区域。如有必要,可裁剪出一个较小的三维子体积进行分割。具体操作步骤请参照手动描记指南中的 2.2–2.2.2 节。
- 选择感兴趣特征的密度,通常通过在该特征上点击或放置标记点或锚点来实现。若软件支持,可输入包含该特征像素强度的数值范围,并根据需要调整容差。系统将依据锚点像素的强度值或设定的容差范围自动选取属于该特征的密度区域。使用 Amira 软件时,请使用以下命令:
- 对于边界清晰的特征,使用魔棒工具。
- 点击感兴趣区域,然后调节“Display”和“Masking”中的滑块,以捕获正确的数值范围,使特征被完整高亮显示。使用快捷键“a”添加选区。
- 对于边界不清晰的特征,使用阈值工具。
- 选择阈值图标,调节滑块以调整密度范围,确保仅将感兴趣的特征进行掩膜。点击“Select”按钮,然后使用快捷键“a”添加选区。
- 如需对整个体积进行分割,在添加选区前请先选择 All slices。
- 为去除噪声,选择 Segmentation > Remove Islands 和/或 Segmentation > Smooth labels。
- 对于边界清晰的特征,使用魔棒工具。
- 按照手动描记部分 2.6–2.6.2 节所述方法生成表面,用于可视化和定性分析。如需要,可导出至其他程序进行更佳的三维显示、定量分析及模拟计算。
4. 定制化自动分割
注意:使用此方法可创建用于自动分割的自定义脚本,该方法需要具备计算机科学方面的背景知识,但能够从大量数据中构建精确的密度模型。
- 工具(MATLAB27 中形状监督分割的具体示例)
- 图像预处理:通过以下流程执行去噪、背景去除和图像增强:
- 使用 imread 命令加载图像。
- 在命令行中输入:>> im = imread($image_path),其中 $image_path 为待分析图像的路径。
- 从图像处理工具箱中调用维纳滤波器(Wiener Filter),使用估计或已知的噪声功率与信号比(NSR)。
- 在先前处理的图像上,调用图像开运算函数 imopen 以估计背景层,然后将结果分配为不同的掩膜。
- 在命令行中输入:>> background = imopen(im,strel($shape_string,$size)),此方法中 $shape_string 等于 'disk',变量 $size 由分析者设定。例如:>> background = imopen(im,strel('disk',15))。
- 从原始图像中减去背景。
- 在命令行中输入:>> im2 = im - background
- 根据结果质量,选择是否采用自适应 Otsu 方法28 进行图像归一化,可通过图像处理工具箱中的 imadjust 函数调用。
- 在命令行中输入:>> im3 = imadjust(im2)
- 为分割准备感兴趣的特征,通过裁剪归一化图像来限定感兴趣区域。
- 使用 imtool 命令探索待裁剪的感兴趣区域,并向命令提供坐标:>> im3_crop = imcrop(im3, [x1 y1 x2 y2]),其中向量 [x1 y1 x2 y2] 对应待裁剪的矩形区域。
- 使用 imread 命令加载图像。
- 形状识别/监督式形状分类:通过为每类对象提供特定示例来训练算法(在二维图像中沿感兴趣特征的线性轨迹)。
- 确认 VLFEAT29 API 已成功安装,并访问 VLFEAT 官方网站以获取更详细的文档。
- 在命令行中输入:>> [TREE,ASGN] = VL_HIKMEANS(im3_crop,$K,$NLEAVES),其中 $K 为使用的聚类数量或观察者希望将数据划分的类别数,$NLEAVES 为期望的叶级聚类数量。例如:>> [TREE,ASGN] = VL_HIKMEANS(im3_crop,4,100)
- 使用手动分割的特征作为 VLFeat 的输入。
注:该开源的 C 语言库将根据所选方法的类型,执行像素块拼接、块聚类和聚类中心定位。可选方法包括从 k 均值聚类到基于纹理元(texton)的方法30,输出为一个数值数组,描述基于给定示例的所需特征。
- 图像预处理:通过以下流程执行去噪、背景去除和图像增强:
- 分割:使用这种完全自动化但计算成本较高的方法,同时分割多个类别的对象,结果将以独立图层形式输出,用于进一步可视化和分析。
- 加载先前生成的数值数组(模型)。
- 调用 VLFeat 中的支持向量机(SVM)函数,将模型和待分割图像作为输入。
- 在命令行中输入:>> [w, b] = vl_svmtrain(x, y, 0.1),其中 x 为原始裁剪图像 im2_crop,y 为目标图像(即已手动分割的图像)。使用 >> ISEG = VL_IMSEG(I,LABELS) 根据聚类生成的标签对结果着色。
注:根据模型特性,VLFeat 将基于最初指定的类别数(感兴趣特征)对图像进行分类。根据所需精度,可将此方法与其他方法结合,或估计如凸包和聚类中心等聚类参数。SVM 算法的输出为概率模型,以及新数据集中各目标类别的多个二值掩膜。
- 在命令行中输入:>> [w, b] = vl_svmtrain(x, y, 0.1),其中 x 为原始裁剪图像 im2_crop,y 为目标图像(即已手动分割的图像)。使用 >> ISEG = VL_IMSEG(I,LABELS) 根据聚类生成的标签对结果着色。
- 通过输入命令保存结果:>> imwrite(im, $format, $filename),其中 $format 为 'tiff',$filename 为输出文件路径。
- 为可视化图像,输入命令:>> imshow(im)。
结果
图1展示了一个典型的三维电子显微镜细胞成像工作流程,包括电子断层扫描、聚焦离子束-扫描电子显微镜(FIB-SEM)以及连续切片块面扫描电子显微镜(SBF-SEM)。该流程包括原始数据采集、数据配准并重建为三维体数据、通过滤波降低噪声,以及在必要时裁剪至感兴趣区域,以最大化所选分割软件的处理效率。经过此类预处理的数据即可用于特征提取或分割。
图2 展示了 图1 中所示的工作流程,使用了四个不同的数据集(将在下文进一步介绍),其中两个数据集来自通过电子断层扫描记录的树脂包埋样品(图2A、图2B),另外两个分别来自聚焦离子束-扫描电镜(FIB-SEM)和连续切片块面扫描电镜(SBF-SEM)(图2C、图2D)。图2 第1列分别为投影视图(图2A1、图2B1)和样品块表面图像(图2C1、图2D1),这些图像经过对齐和重构后被组合成一个三维体数据。第2列显示了对这些三维体数据的切片,经过滤波处理(第3列)后,噪声显著减少,因此图像通常显得更加清晰。在将大尺寸的三维体数据选择并裁剪至感兴趣区域后(第4列),可获得感兴趣分割特征的三维渲染图像(第5列),并可进一步进行观察、颜色编码以及定量分析。
共使用了六个三维数据集,每个数据集包含通过电子断层扫描(3个数据集)、聚焦离子束-扫描电镜(FIB-SEM,2个数据集)或连续块面扫描电镜(SBF-SEM,1个数据集)获得的图像堆栈,用于比较四种分割方法的性能(图3)。这些数据集来源于实验室内的多个不同研究项目,因此提供了一组具有合理多样性的典型实验数据集。所有数据集均由四位独立的研究人员进行分析,每位研究人员各自最熟悉其中一种特定方法,并被要求为这六个数据集分别提供尽可能最佳的分割结果。
数据集来自以下样品:1. 图3A1-3A5:经高压冷冻、冷冻置换并树脂包埋的鸡内耳毛细胞静纤毛31;2. 图3B1-3B5:经高压冷冻、冷冻置换并树脂包埋的植物细胞壁(未发表);3. 图3C1-3C5:经高压冷冻、冷冻置换并树脂包埋的内耳毛细胞动纤毛(未发表);4. 图3D1-3D5:经高压冷冻、冷冻置换并树脂包埋的人乳腺上皮细胞HMT-3522 S1腺泡中的线粒体块,该细胞培养于富含层粘连蛋白的细胞外基质中32,33;5. 图3E1-3E5:未经染色、台式处理并树脂包埋的硫酸盐还原菌生物膜样品(论文在准备中);6. 图3F1-3F5:HMT-3522 S1腺泡中相邻细胞的膜边界。
从图3可以看出,不同的分割方法对于某些类型的数据集可能产生大致相似的结果,但对于其他类型的数据则可能产生完全不同的结果。例如,毛细胞静纤毛数据集(图3A)使用四种方法均能得到合理的分割体积,其中由专家用户生成的手动抽象模型最易于解释和测量。在此情况下,该模型可快速测量纤丝之间的距离,统计细长纤丝之间连接结构的数量,并确定密度图中缺失的部分,这些缺失区域对应于样品制备过程中受损的部位34。若采用其余三种分割方法,获取此类信息将困难得多,尽管定制化的自动分割方法相比单纯的基于密度的阈值分割能提供更好的结果。
对于植物细胞壁(图3B),手动建模在呈现细胞壁结构有序性方面似乎最为有效,而其他方法均未能实现这一点。然而,抽象化模型未能反映数据集中对象的拥挤程度。手动勾画感兴趣特征似乎比基于密度或形状监督的方法获得更好的结果。另一方面,手动勾画非常耗时,且特征边界的识别具有一定的主观性。因此,在分割大体积数据时,可能更倾向于采用自动化方法,以在精度与手动分割所耗费的资源之间取得权衡。
对于动纤毛数据集(图3C),手动抽象模型生成可获得最清晰的结果,并揭示了动纤毛中心存在由三条微管组成的意外结构;该细节在裁剪后的数据中清晰可见,但在其他所有方法中均丢失,可能归因于染色的异质性。然而,在手动生成抽象模型的过程中,密度图中其他潜在的重要特征可能被遗漏。这是因为手动建模具有主观性,容易对实际观测到的密度信号进行理想化和抽象化处理,从而在模型构建过程中引入主观解释。因此,本例很好地说明了手动抽象模型生成方法如何使人聚焦于三维体积数据中的特定结构特征。但这种选择性感知和简化处理无法全面呈现数据集中存在的全部蛋白质复合物。因此,若目标是展示数据的复杂性,则采用其余三种方法中的任意一种更为合适。
对于3D基质培养的乳腺腺泡(图3D),高对比度的线粒体可被所有四种方法轻松分割,手动追踪特征的结果不出所料最佳,污染程度最低(图 3D3)。然而,手动追踪非常耗时费力,因此在处理大体积数据时应用受限。基于密度阈值和形状监督的自动分割方法均能较好地提取线粒体,若进一步采用优化策略进行清理,可实现近乎完美的分割效果。例如,消除低于特定体素密度阈值的所有对象)在不同软件包中的可用功能。在此情况下,手动抽象建模未能取得理想结果,部分原因是线棒模型难以有效近似线粒体的形态。
针对细菌土壤群落/生物膜(图3E),四种方法中有三种产生了合理的结果,而手动模型生成效果不佳,原因是难以用几何形状准确表示细菌等生物结构。在自动分割方法中可检测到细菌发出的胞外附属结构,但在手动特征追踪中效果较差。在密度相似的情况下,基于形状监督的定制化自动分割方法仍可将胞外结构与细菌区分开来(数据未显示),从而实现对极大样本数据集的便捷量化分析。由于原始数据集规模非常大,定制化自动分割方法明显优于其他所有方法,但其优势可能也得益于样本中目标结构的复杂度较低且分布相对稀疏(拥挤度低)。
在考察组织样环境中两个真核细胞之间的界面时(图3F),只有手动追踪感兴趣特征才能获得良好结果。基于密度的自动分割方法完全无法识别相邻细胞之间的膜边界,即使是定制化的方法也部分失败,原因在于细胞的形状难以用某种几何形状近似或等同,尽管该方法在生物膜中的细菌分割上取得了明显成功(图3E5)。
从图3的观察结果可知,分割方法在某些数据集上表现良好,但在其他数据集上则不然,这引发了以下问题:这些数据集各自的特征是什么?是否有可能对与各类方法相匹配的数据特征类型或个人研究目标进行分类。该主题此前尚未系统研究,因此作为第一步,建立一份图像特征与个人研究目标的经验清单,可为新手在为其特定数据集选择最优特征提取方法时提供指导。
确定了八个重要标准,如图4所示,这些标准可分为两大类:(1)数据集本身固有的特征;(2)研究者个人的研究目标及其他较为主观但同样重要的考量因素。所示示例主要来自图3中的六个数据集,并额外引入了三个新的数据集:第一个(图4A1)为拟南芥(Arabidopsis thaliana)植物细胞壁冷冻切片的冷冻断层扫描图像;第二个(图4A2、图4B1、图4D1)为耳蜗血管纹的聚焦离子束/扫描电镜(FIB/SEM)数据集,该组织结构高度复杂且曲折,虽可归入图3F1-3F5所示类别,但复杂程度更为显著;第三个(图4B2、图4D2)为耳蜗毛细胞静纤毛树脂切片的断层扫描图像,呈横截面视图,其样本内容与图2A1-2A5和图3A1-3A5中所示的纵切面视图类似。
对于图像特征等客观标准类别,提出了数据集中四个内在特征作为重要指标:
- 数据对比度可能较低(图4A1),这是冷冻电镜断层成像的典型特征;也可能为中等(图4A2),例如在细胞环境中无明显细胞器或其他显著特征突出的情况;亦可能较高(图4A3),如动纤毛的断层图像或静纤毛的横截面图像,这是由于在z轴方向上清晰分离的丝状结构排列所致。
- 数据可能模糊(图4B1),即两个位置相近的物体之间无明显清晰的边界,例如组织中的细胞;也可能清晰(图4B2),即具有明确定义的边界。这在一定程度上取决于数据集的分辨率,电子断层成像的分辨率通常比聚焦离子束扫描电镜(FIB-SEM)固有地高出约2至4倍。自然地,更清晰的边界对于手动和自动分割方法均有利,但对后者尤为关键。
- 密度图可能较为密集(图4C1),如紧密排列的植物细胞壁组分所示;也可能较为稀疏(图4C2),如菌落中的细菌,这种分离状态使得自动图像分割显著更容易实现。
- 密度图可能高度复杂,包含形状各异且常不规则的多种不同特征,例如血管周围的血管纹组织(图4D1);也可能包含结构相似、形态明确的类细胞器样物体,例如静纤毛的横截面(图4D2)。
还需注意所有不同示例中的尺度差异极大,这使得比较变得有些困难。
除了图像特征等更为客观的标准外,还提出了四个高度主观的标准,用于指导合适路径的选择:
- 期望目标:该目标可能是可视化毛束静纤毛的复杂结构,并确定和观察该物体的形态图 4E1),或创建一个简化的、抽象的球棍模型,该模型构建于密度图中,可快速计数和测量几何对象(如纤维长度、距离以及连接数量)图 4E2).
- 特征形态可能高度不规则且复杂,类似于细胞,例如细胞-细胞相互作用区域(图 4F1),形状大致相似但略有变化,例如线粒体(图 4F2),或形状基本相同,例如纵向排列的毛细胞束中的肌动蛋白丝及其交联结构图 4F3).
- 目标特征(种群密度)的比例很重要,因为有时可能需要对三维数据集中的所有特征进行分割,植物细胞壁的研究即属于这种情况图 4G1),或仅占细胞体积的极小部分,例如在异质性细胞环境中线粒体的情况(图 4G2)。根据数据集的大小以及需要分割的体积百分比,使用手动方法可能是最有效的方式。在其他情况下,例如当研究者关注多种特征时,半自动分割方法则是唯一可行的选择。
- 另一个关键的主观标准是研究者愿意在分割过程中投入多少资源,以及回答特定生物学问题所需的保真度水平。研究者可能需要量化某一特征的体积参数(如大小、体积、表面积、长度、与其他特征的距离) 等等。),在这种情况下,可能需要更加谨慎以获得准确的定量信息(图 4H1),或者目的可能仅仅是拍摄其3D形状的图像(图 4H2)。在一个资源无限的理想世界中,人们显然不会希望做出任何妥协,而会倾向于选择最精确的用户辅助手动特征提取方法。尽管这种方法对许多数据集是可行的,但在不久的将来,三维数据体积将达到10k × 10k × 10k或更高量级,手动分割将无法在如此庞大的空间分割任务中继续发挥重要作用。根据数据的复杂性及其他数据特征,半自动分割可能将成为必要选择。
在图5中,简要列出了四种分割方法的优势与局限性。同时概述了图4中所确定的可与每种方法相匹配的个人研究目标和图像特征。在图6中,通过六个数据集的个人研究目标和图像特征示例,说明了如何对数据进行分类并选择最合适的方法。图5和图6的内容将在讨论部分进一步展开。

图1. 生物成像重建与分析的工作流程。 本图概述了通过断层扫描、聚焦离子束扫描电镜(FIB-SEM)和连续块面扫描电镜(SBF-SEM)采集和处理图像所涉及的各个步骤。原始数据采集产生二维倾斜系列图像或连续切片图像。这些二维图像集必须经过配准并重建为三维结构,然后进行滤波以降低噪声,并增强感兴趣特征的对比度。最后,可对数据进行分割与分析,最终生成三维模型。请点击此处查看该图的高清版本。

图 2. 来自断层扫描和聚焦离子束-扫描电镜(FIB-SEM)的不同数据类型工作流程示例。 数据采集后的每个工作流程步骤通过四组数据集(行 A-D)展示:纵向切片的毛细胞静纤毛树脂包埋染色断层扫描、植物细胞壁纤维素树脂包埋染色断层扫描、乳腺上皮细胞线粒体的FIB-SEM成像,以及大肠杆菌(E. coli)的SBF-SEM成像。第一列显示原始数据的二维切片,第二列显示数据经过配准和三维重建后的图像。第三列应用的滤波技术分别为:中值滤波(A3)、非各向异性扩散滤波(B3)、高斯模糊(C3)以及MATLAB的imadjust滤波(D3)。第四列展示了从感兴趣裁剪区域获得的最佳分割结果示例,第五列则以三维渲染形式呈现。 比例尺:A1-A3 = 200 nm,A4 = 150 nm,A5 = 50 nm,B1-B3 = 200 nm,B4-B5 = 100 nm,C1-C3 = 1 mm,C4-C5 = 500 nm,D1-D3 = 2 mm,D4-D5 = 200 nm。 请点击此处查看该图的放大版本。
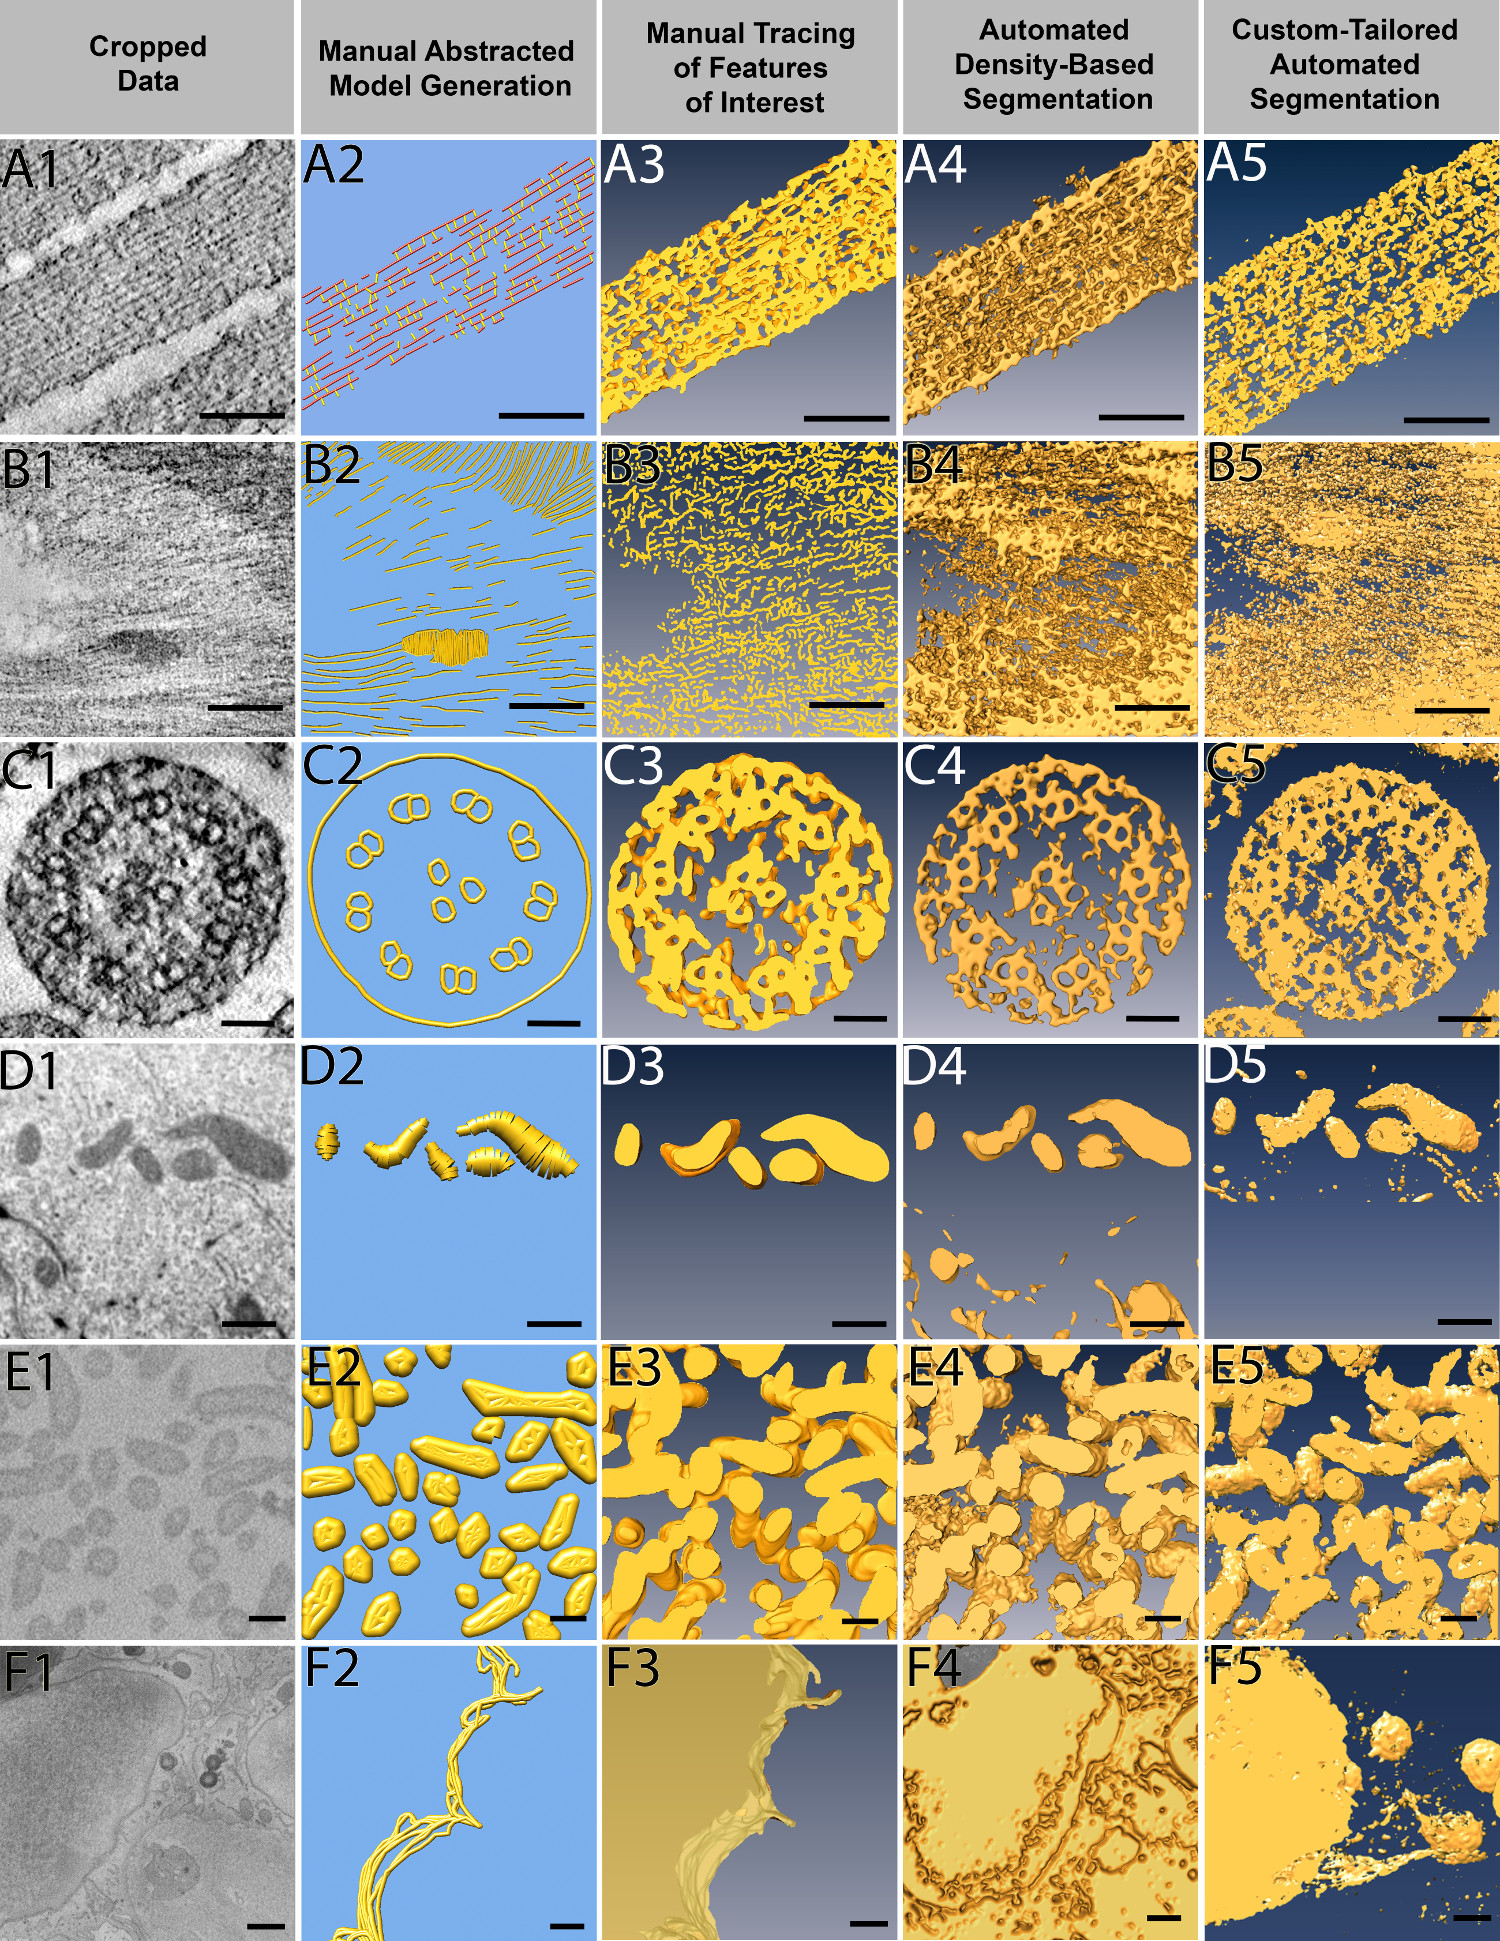
图 3. 四种分割方法在示例数据集上的应用。 六组示例数据集均采用以下四种方法进行分割:手动抽象模型生成、手动描记、自动化密度依赖分割以及定制化自动化分割。对于毛细胞静纤毛的树脂包埋染色断层成像(A),手动抽象模型生成方法效果最佳,因为其目标是构建用于定量分析的模型,而非提取密度信息。对于植物细胞壁的树脂包埋染色断层成像(B),自动化密度依赖分割方法在快速提取多个切片中的纤维素结构方面最为有效,而手动方法仅能处理少量切片且耗时更长。在纤毛基体染色断层成像(C)中,仅手动抽象模型生成成功重建出微管三联体结构,其他分割方法未能实现;然而两种自动化方法在密度提取速度上更快,因此更受青睐。由于乳腺上皮细胞线粒体在FIB-SEM图像中具有特定形态(D),手动描记获得了最清晰的结果,且因线粒体分布稀疏并结合插值方法的使用,实现了快速分割。对于需要分割大体积数据的SBF-SEM细菌图像(E),定制化自动化分割方法被证明效率最高,但两种自动化方法表现相近。尽管耗时较长,但提取乳腺上皮细胞膜的FIB-SEM图像(F)唯一可行的方法仍是手动描记。比例尺:A1-A5 = 100 nm,B1-B5 = 100 nm,C1-C5 = 50 nm,D1-D5 = 500 nm,E1-E5 = 200 nm,F1-F5 = 500 nm。请点击此处查看该图的高清版本。

图 4. 数据集分类的客观图像特征与主观个人目标。 通过数据集特征的示例,提出用于指导选择何种分割方法的判断标准。在客观特征方面,数据本身可能具有低、中或高对比度(A1-A3),图像模糊或清晰(B1-B2),结构分布稀疏或密集(C1-C2),以及特征结构复杂或简单有序(D1-D2)。主观个人目标包括期望实现的目标是构建简化模型还是提取精确密度(E1-E2),将复杂的片状结构、复杂的三维体积结构或线性形态作为感兴趣特征进行识别(F1-F3),选择感兴趣特征的高或低种群密度(G1-G2),以及在高保真度与高资源投入之间权衡,以应对时间等投入要素的边际效益递减(H1-H2)。比例尺:A1 = 50 nm,A2 = 1500 nm,A3 = 100 nm,B1 = 1500 nm,B2 = 200 nm,C1 = 100 nm,C2 = 200 nm,D1 = 10 mm,D2 = 200 nm,E1 = 100 nm,E2 = 50 nm,F1-F2 = 500 nm,F3 = 50 nm,G1 = 100 nm,G2 = 1 mm,H1-H2 = 100 nm。请点击此处查看该图的放大版本。
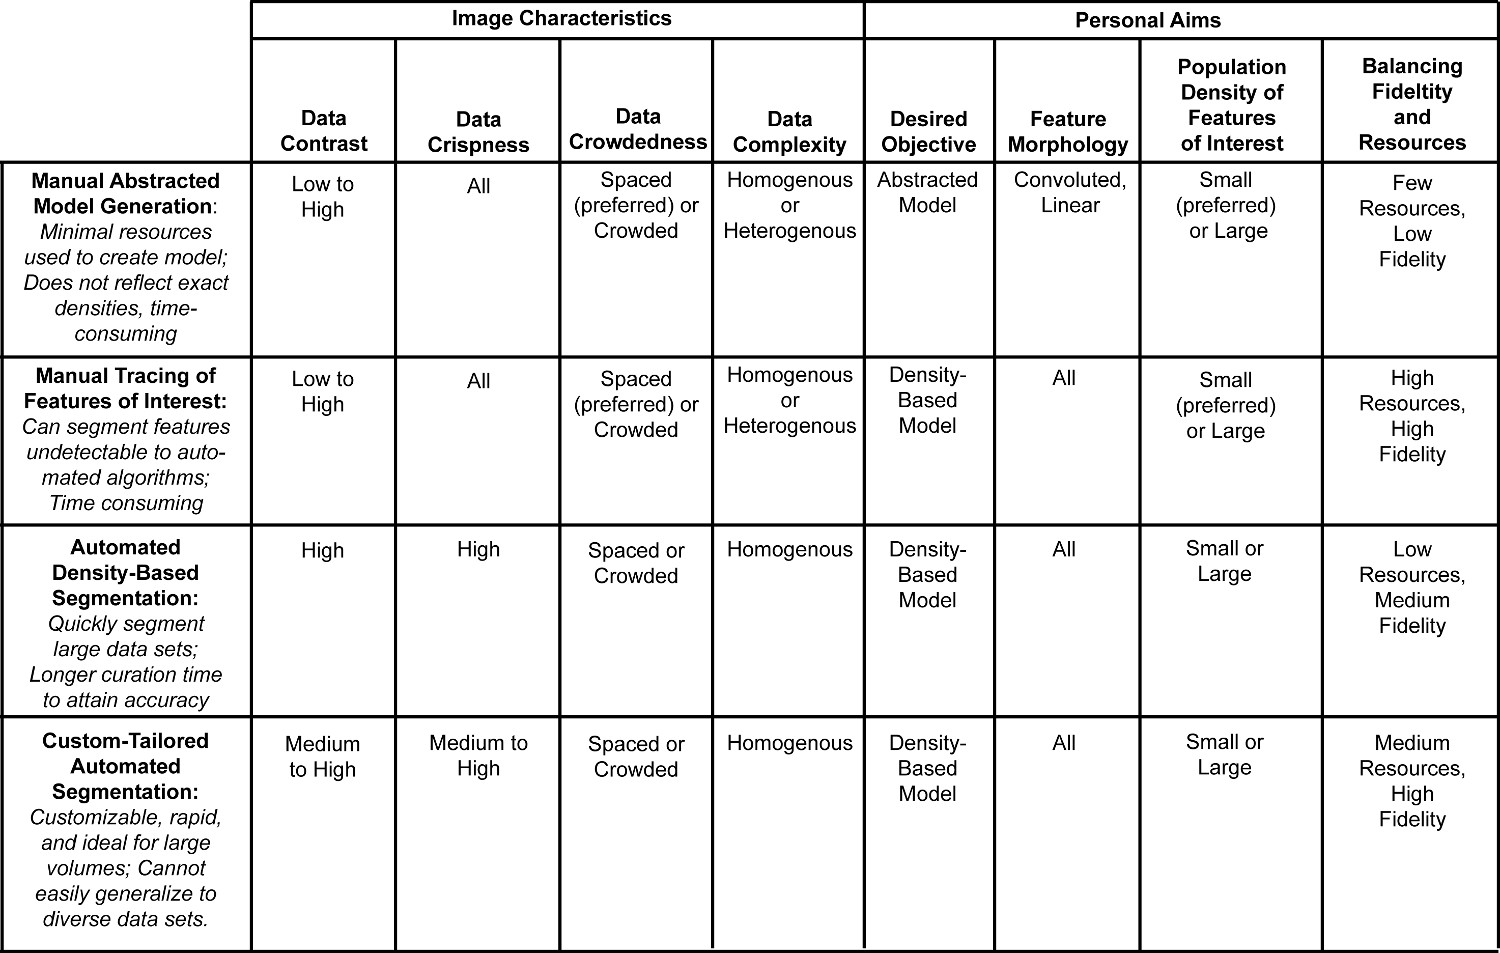
图 5. 不同分割方法适用的数据特征与主观目标的比较表。 本表总结了每种分割方法的优势与局限性。图 4 中的判据可用于判断哪些数据集适用于哪种分割方法。这些客观图像特征与主观个人目标的选择旨在使每种方法达到最佳使用效果,但不同的组合可能会影响分割效率,或对效率产生促进作用。请点击此处查看该图的高清版本。

图6. 针对不同特征数据集的分割方法高效分诊的决策流程图。 基于图4中强调的特征,本图展示了哪四项标准对图3中每个数据集的最佳分割方法的最终决策贡献最大。每个数据集均以颜色编码,以便快速追踪代表主要决策路径的粗线,以及反映可能通向相同或不同方法的备选路径的虚线。动纤毛、细菌和植物细胞壁数据集最适合采用两种自动化方法进行分割。相比之下,由于细胞膜和线粒体数据集的分割难度较高,其路径始终指向手动追踪。请点击此处查看该图的放大版本。
讨论
为了应对近期生物成像领域出现的数据洪流,迫切需要有效的策略,以从三维电子显微镜(3D EM)数据体中提取出相关特征。尽管数据可以在数小时或数天内生成,但对三维数据体进行深入分析却可能耗时数月。因此,图像分析已成为科学发现的主要瓶颈;若无法妥善解决这些问题,成像科学家将陷入因自身成功而带来的困境。这一问题部分源于数据本身的高复杂性,以及生物细胞中典型的生物大分子拥挤现象——蛋白质及其复合物彼此相邻,几乎呈现出连续的灰度密度梯度。此外,样品制备和成像过程中的不完美性,以及在某些情况下存在的图像重建伪影,导致获得的体数据并非理想状态,给完全自动化的分析方法带来挑战。然而最重要的是,擅长样品制备、成像及生物学解释的专家通常并不精通计算科学,因此亟需指导,以有效开展特征提取与分析工作。为此,本实验方案通过多个实例,详细说明了如何准备用于分割的数据,以及如何进行手动抽象模型构建、基于密度的自动分割、感兴趣特征的手动追踪,以及定制化的自动分割等步骤。本流程中所述的手动与自动方法广泛存在于多种分割软件中,本文提及其中部分软件,但其他软件亦具备类似功能,同样适用。
结果表明,三种不同的3D分割方法在处理不同类型的数据集时,其有效性各不相同。尽管不同方法最终生成的3D渲染图像在视觉上较为相似,但在分割过程中所需的时间和精力投入却存在显著差异。图5总结了每种分割方法所适用的图像特征及个人目标,其具体内容将在以下四个小节中进一步说明。这些标准已应用于六个数据集,如图6的决策流程图所示。尽管图5和图6仅旨在为每个数据集的选择提供依据,并说明各项标准在决策过程中的权重,但它们并不能提供绝对可靠的指导,而仅作为一个起点。影响决策过程的标准实际上非常多:其中一些是客观标准,例如数据集的特征;另一些则是较为主观的标准,例如预期目标。可以认为,对于具有高对比度、边界清晰锐利、特征之间分离良好且相对均质(即特征种类不过于多样)的数据集,若其处理目标是为大量对象构建密度模型,则自动化方法将更具优势,否则手动方法会因资源(时间)消耗过大而不可行。相反,若图像对比度较低、数据模糊因而需要专家知识进行判断、目标对象密集拥挤,且特征表现出高度多样性因而具有异质性,则可能别无选择,只能采用手动特征提取/分割方法。
手动抽象模型生成
手动抽象模型追踪在分割线性结构方面尤为有效,可提供作为种子点的球状标记(球),这些标记可被自动连接形成杆状结构(杆)。此类球杆模型在测量模型的长度和方向方面具有强大优势,同时为定性观察和定量分析提供了充分简化的抽象模型。当分析过程中优先考虑最小化资源消耗,而非完全忠实还原原始数据的形态时,通常采用手动抽象模型生成方法。该方法在处理线性且均质的目标特征时最为成功。例如、丝状物、管状物)。数据的对比度、清晰度和密集程度对该方法的成功影响不大,只要人眼能够识别出目标对象即可。有时,此类模型还可作为骨架,用于分割骨架周围区域的三维图谱。尽管该模型是抽象的,并不反映精确的密度信息,但它代表了三维密度的骨架化形式,从而实现了无杂乱的可视化和定性分析。此外,还可基于该近似模型进行长度等定量测量。有关支持手动抽象模型生成的软件示例,请访问 Chimera 在线详细用户指南 http://www.cgl.ucsf.edu/chimera/current/docs/UsersGuide/index.html.
目标特征的手动追踪
手动画笔描记法几乎适用于所有数据特征,但也是最耗时的方法。有时,对于包含大量不同类型特征的复杂图像数据集(例如纤细且曲折的细胞膜),这是提取目标特征的唯一技术。某些程序中提供的一种有用工具允许在间断分割的切片之间进行插值,前提是目标特征的变化较为平滑。当数据清晰且具有中等到高对比度时,手动描记法可以最高效地应用;但只要用户熟悉目标对象,该方法也可用于更具挑战性的数据集。数据的复杂性可涵盖从离散物体到复杂且密集的数据集,其中物体紧密排列。在这种情况下,手动分割可能是唯一可行的选择,因为自动方法通常难以准确分割出所需体积,容易过度或不足提取。对于形态复杂的特征,例如扭曲的片层或三维结构,该方法同样能够实现提取。然而,用户应牢记,只有当目标特征的种群密度较低时,才可能对具有多种复杂特性的数据集进行分割,因为当目标特征的密度较高时,分割所需时间将变得不可接受。有关支持手动描记的软件示例,请访问 Amira 在线详细用户指南:http://www.vsg3d.com/sites/default/files/Amira_Users_Guide.pdf。
基于密度的自动分割
与手动方法相比,自动化方法通常耗时更少,这在分割大量图像堆栈时是一个需要重点考虑的因素。然而,简单的阈值分割可能准确性较低,后续可能需要花费更多时间对自动分割得到的体积数据进行优化和校正。基于密度的自动化分割在处理包含大量相似目标特征且均需分割的数据集时效果最佳。如果数据更为复杂,这些自动化技术仍可作为初始步骤,但后续很可能需要一定程度的人工干预,以精确划定包含目标特征的子体积区域。该策略通常对线性形态或结构复杂的体积数据效果良好,但在处理如细胞膜等纤薄且高度折叠的片状结构时,成功率较低。自动化方法所需的人工干预极少,因而能够在消耗较少用户资源(如时间)的前提下,实现对大体积或小体积数据的高保真分割。有关支持自动化基于密度分割的软件示例,请访问 Amira 在线详细用户指南:http://www.vsg3d.com/sites/default/files/Amira_Users_Guide.pdf。
定制化自动分割
定制化的自动分割技术允许针对特定数据集对算法进行灵活定制,但通常局限于特定数据集或数据类型,仅适用于有限数量的特征属性,且难以推广。本文展示的方法不同于一般的自动分割方法(如流域浸没法和其他水平集方法),后者依赖于程序化地确定关键种子点,然后从这些种子点出发进行快速行进立方体扩展。此类方法的一种变体是边界分割,其中梯度矢量信息用于界定特征边界。相比之下,本文所使用的定制脚本依赖于一个训练阶段,即用户手动勾画若干示例。通过机器学习,特定算法将检测并学会独立识别在这些轨迹中一致出现的属性和数据特征。专家用户可通过添加更多示例轨迹以提供更丰富的特征判断依据,从而重新训练算法并提高分割的准确性。总体而言,阈值分割及相关方法,甚至定制化方法,在从包含复杂多样细胞器或形态的图像中提取单一感兴趣特征时可能效果有限,因为其后期校正工作量可能与手动勾画相当。
数据分诊策略与分割方法的选择
根据图4中呈现的主观与客观标准,以及图5中对适用数据集的总结,图6所示的决策流程可帮助有效评估多种数据集的特征提取策略。数据集通过四个连续的决策步骤进行分类,每个步骤均可包含四项相应目标中的任意一项,以及图4中介绍的四项主观标准。例如,图6即为对图3所示六个数据集各自进行分类决策的合理依据。显然,对于每个数据集而言,并不存在唯一确定的路径,而是可能依据不同的决策标准在该矩阵中选择不同路径,从而得出相同或不同的数据分割建议。尽管每个数据集都有其独特的属性,难以预先全面预测,本文仍提供了六个示例,每个示例均附有对首选特征提取/分割方法背后逻辑的解释。其中大多数示例还提出了一条替代性决策路径,该路径可能导致采用相同或不同的分割方法(图6)。
动纤毛具有清晰明确边界的高质量数据集,这使得自动化方法更有可能成功。所有目标特征之间均分离良好,同样有利于采用自动化方法。此外,这些目标特征彼此相似,构成一个相对均一的数据集,非常适合定制化的分割处理。最后,研究目标是提取完整的特征结构,因此倾向于采用半自动化方法。因此,最终得出结论:自动阈值分割法(实绿色线)以及定制设计的例如,形状监督分割)方法(绿色虚线)在这组数据上均可能表现良好。
类似的准则在细菌案例中同样适用,尽管其在决策网络中的排序有所不同。推荐采用定制化方法,部分原因是该数据集非常庞大,因此有限的资源无法支持耗时费力的人工干预/分割方法。虽然阈值分割法也能获得可接受的结果,但定制化方法能够更好地实现研究的核心目标,即区分近似圆形的细菌形态与位于细菌之间或紧邻细菌的胞外金属沉积物,因此优先选择了定制化方法。
对于静纤毛数据集,首要考虑的是预期目标:目标可能是展示整个密度,也可能是创建几何模型。感兴趣区域为密集区域,目标是将大量对象分割为相互分离的个体,以便后续进行定量体积分析,包括长度、数量、距离和方向等参数。 等等。 值得注意的是,感兴趣的对象主要呈线性,这使得基于几何模型的追踪成为首选方法。然而,如果目标是展示整个密度分布,那么线性特征的形态以及具有清晰边界且对比度相对较高的特点,将使自动阈值分割方案成为可行的选择。
细胞膜和线粒体的数据案例对自动化方法而言具有挑战性,原因在于其特征形态的类别分别为复杂的片层结构和三维体积。目标是精确追踪细胞或线粒体的轮廓,但可用资源有限。此外,感兴趣的目标特征结构复杂,难以通过自动方式检测或以形状编码进行识别;尽管如此,针对细菌数据集所采用的定制化脚本方法,或许经过进一步调整后可用于线粒体数据集。幸运的是,膜结构和线粒体本身仅占整个体积的很小一部分,因此手动追踪虽耗时,却是一种直接可行的方法。当图像对比度较低且边界模糊时,手动追踪更是此类数据集的首选方法。因此,即使这些复杂的片层结构在数据集中占比较大,仍必须采用手动追踪,根本原因在于目前尚无更优的替代方案。
植物数据集提出了其自身的挑战,因为目标是分割所有物体,而这些物体间距密集,构成了一幅拥挤的场景。直接显示密度可用于测量物体的形状和排列方式,但由于手动分割每个丝状物体成本过高,因此采用了自动阈值分割方法。
创建三维模型的各个步骤及相应结果已在此展示,但更重要的是,影响分割路径选择的关键图像数据特征及个人判断标准也已阐明。图像数据本身的重要特征包括此处所述的对比度、密集程度、清晰度以及不同形态或结构特征(如细胞器、丝状结构、膜结构)的数量。需考虑的主观标准包括分割的预期目标(测量/计数、数据的骨架化表示、三维渲染中体积的展示)、感兴趣结构的形态学特征(线性、细长、网络状、复杂或高度折叠)、感兴趣结构在整个体积中的密度(需要提取的重要对象所占比例),以及在分割保真度与资源投入之间权衡取舍,即随着资源投入大幅增加,分割效果的提升却逐渐趋于平缓。
近年来,图像分割领域已取得显著发展,但仍不存在一种万能的算法或程序能够解决所有问题。数据集的规模已从数百兆字节增长到 routinely 数十吉字节,如今开始超过太字节级别,使得手动分割几乎不可能实现。因此,需要投入更多资源来开发巧妙且高效的时间特征提取方法,以模拟人类的决策过程。这些努力需要与以下四个方面相结合:(1)基于地理信息系统(GIS)的语义层次数据库(类似于 Google Earth);(2)数据抽象技术(即,从体素向几何/体积表示形式的转换),该技术需兼容计算机辅助设计(CAD)软件,以显著减少数据量,从而实现更大体积数据的可视化35;(3)仿真技术,这类技术在工程学科中已被广泛使用;以及(4)先进的动画与影视制作能力,包括穿行动画(类似于游戏行业所开发的技术)。
显然,高效的特征提取与分割是即将到来的细胞高分辨率成像革命的核心所在。尽管未来始终需要更优的方法,但本文所阐述的原理以及针对不同类型数据所采用方法的实例,将为选择何种方法提供有价值的参考信息。
披露
作者声明不存在任何竞争性经济利益。
致谢
我们谨向加利福尼亚大学旧金山分校的 Tom Goddard 致以诚挚感谢,感谢他在 Chimera 软件使用方面提供的持续帮助;感谢 Gatan 公司的 Joel Mancuso 和 Chris Booth 在细菌数据集的 SBF-SEM 数据采集方面提供的协助;感谢 Zeiss 公司的 Doug Wei 在上皮细胞数据集的 FIB-SEM 数据采集方面提供的帮助;感谢加利福尼亚大学伯克利分校电子显微镜实验室的 Kent McDonald 在样品制备、透射电子显微镜(TEM)成像及断层扫描技术方面的宝贵建议;感谢劳伦斯伯克利国家实验室的 Roseann Csencsits 在获取冷冻透射电镜(cryo-TEM)图像方面的协助;感谢 Elena Bosneaga 对植物数据集进行的冷冻切片工作;感谢俄勒冈健康与科学大学的 Jocelyn Krey 对耳石器官组织进行的解剖;感谢国家能源研究科学计算中心(NERSC)的 David Skinner 以及加利福尼亚大学伯克利分校的 Jitendra Malik 在软件基础设施方面提供的建议;并感谢加利福尼亚大学伯克利分校的 Pablo Arbelaez 为本文所展示的定制化脚本提供的代码贡献 。
本研究得到了美国能源部科学办公室合同号 DE-AC02-05CH11231 [David Skinner] 的支持,以及美国国立卫生研究院(NIH)资助号 P01 GM051487 [M.A.] 对内耳毛细胞项目和显微成像仪器使用的资助。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| Amira | FEI Visualization Sciences Group | http://www.vsg3d.com/amira/overview | |
| Chimera | 加州大学旧金山分校(UCSF) | http://www.cgl.ucsf.edu/chimera/ | |
| Fiji/ImageJ | 美国国立卫生研究院 | http://fiji.sc/Fiji, http://rsbweb.nih.gov/ij/ | |
| IMOD | 细胞三维电子显微镜博尔德实验室 | http://bio3d.colorado.edu/imod/ | |
| Photoshop | Adobe | http://www.adobe.com/products/ photoshopfamily.html | |
| MATLAB | MathWorks | http://www.mathworks.com/ | |
| VLFeat | VLFeat | http://www.vlfeat.org/ |
参考文献
- Auer, M. Three-dimensional electron cryo-microscopy as a powerful structural tool in molecular medicine. J Mol Med (Berl). 78 (4), 191-202 (2000).
- Johnson, M. C., Rudolph, F., Dreaden, T. M., Zhao, G., Barry, B. A., Schmidt-Krey, I. Assessing two-dimensional crystallization trials of small membrane proteins for structural biology studies by electron crystallography. Journal of visualized experiments JoVE. (44), e1846(2010).
- Jun, S., Zhao, G., Ning, J., Gibson, G. A., Watkins, S. C., Zhang, P. Correlative microscopy for 3D structural analysis of dynamic interactions. Journal of visualized experiments JoVE. (76), e50386(2013).
- Meng, X., Zhao, G., Zhang, P. Structure of HIV-1 capsid assemblies by cryo-electron microscopy and iterative helical real-space reconstruction. Journal of visualized experiments JoVE. (54), e3041(2011).
- Chen, S., McDowall, A., et al. Electron Cryotomography of Bacterial Cells. Journal of visualized experiments JoVE. (39), e1943(2010).
- Meyerson, J. R., White, T. A., et al. Determination of molecular structures of HIV envelope glycoproteins using cryo-electron tomography and automated sub-tomogram averaging. Journal of visualized experiments JoVE. (58), e2770(2011).
- Lucic, V., Forster, F., Baumeister, W. Structural studies by electron tomography: from cells to molecules. Annu Rev Biochem. 74, 833-865 (2005).
- Bajaj, C., Yu, Z., Auer, M. Volumetric feature extraction and visualization of tomographic molecular imaging. J Struct Biol. 144 (1-2), 132-143 (2003).
- Lin, G., Adiga, U., Olson, K., Guzowski, J. F., Barnes, C. A., Roysam, B. A hybrid 3D watershed algorithm incorporating gradient cues and object models for automatic segmentation of nuclei in confocal image stacks. Cytometry A. 56 (1), 23-36 (2003).
- Volkmann, N. A novel three-dimensional variant of the watershed transform for segmentation of electron density maps. Journal of Structural Biology. 138 (1), 123-129 (2002).
- Rigort, A., Günther, D., et al. Automated segmentation of electron tomograms for a quantitative description of actin filament networks. Journal of structural biology. 177 (1), 135-144 (2012).
- Cremers, D., Rousson, M., Deriche, R. A Review of Statistical Approaches to Level Set Segmentation. Integrating Color, Texture, Motion and Shape. International Journal of Computer Vision. 72 (2), 195-215 (2007).
- Lin, Z., Davis, L. S. Shape-based human detection and segmentation via hierarchical part-template matching. IEEE Trans Pattern Anal Mach Intell. 32 (4), 604-618 (2010).
- Pettersen, E. F., Goddard, T. D., et al. UCSF Chimera--a visualization system for exploratory research and analysis. J Comput Chem. 25 (13), 1605-1612 (2004).
- Kremer, J. R., Mastronarde, D. N., McIntosh, J. R. Computer visualization of three-dimensional image data using IMOD. J Struct Biol. 116 (1), 71-76 (1996).
- Zhang, Q., Bettadapura, R., Bajaj, C. Macromolecular structure modeling from 3D EM using VolRover 2.0. Biopolymers. 97 (9), 709-731 (2012).
- Giannuzzi, L. A., Stevie, F. A. A review of focused ion beam milling techniques for TEM specimen preparation. Micron. 30 (3), 197-204 (1999).
- Heymann, J. A. W., Hayles, M., Gestmann, I., Giannuzzi, L. A., Lich, B., Subramaniam, S. Site-specific 3D imaging of cells and tissues with a dual beam microscope. Journal of structural biology. 155 (1), 63-73 (2006).
- Knott, G., Rosset, S., Cantoni, M. Focussed ion beam milling and scanning electron microscopy of brain tissue. Journal of visualized experiments JoVE. (53), e2588(2011).
- Wirth, R. Focused Ion Beam (FIB) combined with SEM and TEM: Advanced analytical tools for studies of chemical composition, microstructure and crystal structure in geomaterials on a nanometre scale. Chemical Geology. 261 (3-4), 217-229 (2009).
- Denk, W., Horstmann, H. Serial block-face scanning electron microscopy to reconstruct three-dimensional tissue nanostructure. PLoS Biol. 2 (11), e329(2004).
- Frangakis, A. S., Hegerl, R. Noise reduction in electron tomographic reconstructions using nonlinear anisotropic diffusion. Journal of structural biology. 135 (3), 239-250 (2001).
- Jiang, W., Baker, M. L., Wu, Q., Bajaj, C., Chiu, W. Applications of a bilateral denoising filter in biological electron microscopy. Journal of Structural Biology. 144 (1), 114-122 (2003).
- Van der Heide, P., Xu, X. P., Marsh, B. J., Hanein, D., Volkmann, N. Efficient automatic noise reduction of electron tomographic reconstructions based on iterative median filtering. Journal of structural biology. 158 (2), 196-204 (2007).
- Schneider, C. A., Rasband, W. S., Eliceiri, K. W. NIH Image to ImageJ: 25 years of image analysis. Nat Methods. 9 (7), 671-675 (2012).
- Schindelin, J., Arganda-Carreras, I., et al. Fiji: an open-source platform for biological-image analysis. Nat Methods. 9 (7), 676-682 (2012).
- MathWorks. MATLAB. , (2012).
- Otsu, N. A Threshold Selection Method from Gray-Level Histograms. Systems, Man and Cybernetics, IEEE Transactions on. 9, 62-66 (1979).
- Vedaldi, A., Fulkerson, B. VLFeat: An Open and Portable Library of Computer Vision Algorithms. , (2008).
- Zhu, S. C., Guo, C., Wang, Y., Xu, Z. What are Textons? International Journal of Computer Vision. 62 (1-2), 121-143 (2005).
- Gagnon, L. H., Longo-Guess, C. M., et al. The chloride intracellular channel protein CLIC5 is expressed at high levels in hair cell stereocilia and is essential for normal inner ear function. The Journal of neuroscience the official journal of the Society for Neuroscience. 26 (40), 10188-10198 (2006).
- Briand, P., Petersen, O. W., Van Deurs, B. A new diploid nontumorigenic human breast epithelial cell line isolated and propagated in chemically defined medium. In vitro cellular & developmental biology journal of the Tissue Culture Association. 23 (3), 181-188 (1987).
- Petersen, O. W., Rønnov-Jessen, L., Howlett, A. R., Bissell, M. J. Interaction with basement membrane serves to rapidly distinguish growth and differentiation pattern of normal and malignant human breast epithelial cells. Proceedings of the National Academy of Sciences of the United States of America. 89 (19), 9064-9068 (1992).
- Shin, J. B., Krey, J. F., et al. Molecular architecture of the chick vestibular hair bundle. Nature neuroscience. 16 (3), 365-374 (2013).
- Yang, W., Zeng, Z., Max, N., Auer, M., Crivelli, S. Simplified Surface Models of Tubular Bacteria and Cytoskeleta. Journal of Information & Computational Science. 9 (6), 1589-1598 (2012).
重印与许可
