基于共识基序的合成蛋白质序列通常忽略共进化残基,而共进化残基意味着残基间的相互依赖性(IPDs)。IPDs 可能对蛋白质活性至关重要,若设计中忽略这些依赖性,可能导致效果欠佳。本实验方案利用 StickWRLD 识别残基间的相互依赖性,并指导合理的蛋白质设计,从而获得更高效的结果。
本文内容
摘要
摘要
蛋白质序列比对常用于评估蛋白质残基的相似性,并据此生成共有序列以识别功能单元(例如,结构域)。传统的共序构建模型未能考虑残基位点间的相互依赖性——即在进化过程中及在整个系统发育树中共同出现的功能性残基共变现象。这些关系可为蛋白质折叠、热稳定性以及功能位点形成等过程提供重要线索,进而指导合成蛋白质的设计。然而,这些关系实际上构成了亚模体(sub-motifs),无法通过简单的“多数规则”或基于隐马尔可夫模型(HMM)的共序模型进行准确预测,其结果可能产生在生物学上无效的“共有序列”——这种序列不仅在自然界中从未出现,且其活性甚至低于任何现存的蛋白质。我们开发了一种可视化分析工具 StickWRLD,该工具可生成蛋白质比对的交互式三维可视化表示,并清晰展示共变残基。用户可对图像进行平移和缩放操作,并可动态调整用于识别共变残基的统计阈值。此前,StickWRLD 已成功应用于识别腺苷酸激酶等蛋白质以及内切酶靶位点等 DNA 序列中的功能依赖性共变残基。
引言
蛋白质序列比对长期以来被用于评估蛋白质家族中残基的相似性。通常,蛋白质最有趣的特征(例如,催化位点或其他结合位点)是由于蛋白质折叠将线性序列中相距较远的区域拉近并相互接触所致;因此,这些在比对中看似无关的区域往往以协调的方式共同进化和变化。在其他情况下,蛋白质的功能可能依赖于其静电特征,影响电子偶极的突变会通过远端带电残基的改变得到补偿。别构效应也可能在残基身份之间引发长程的序列和空间依赖性。无论其来源如何,这些功能上必需的残基共变——即残基间的相互位置依赖性(IPDs)——在比对的视觉检查中可能并不明显(图1)。识别IPDs,以及识别在这些位置中哪些特定残基倾向于作为一个整体共同变化,可以揭示有关蛋白质折叠过程和功能位点形成的的重要线索。这些信息随后可用于优化合成(工程化)蛋白质的热稳定性和活性。长期以来人们已知,并非所有向共识序列发展的点突变都能提高稳定性或活性。最近研究表明,设计时利用其序列中已知IPDs的蛋白质,其活性优于仅基于共识序列设计的相同蛋白质1,2(论文在准备中),这一理念类似于稳定性的点突变策略3。
遗憾的是,传统的共识构建模型(例如多数规则)只是偶然地捕捉到残基间的相互依赖性(IPDs)。共识法和位置特异性评分矩阵方法均未考虑IPDs,仅当某个位点上依赖性残基恰好也是该蛋白家族中最常见的残基时,这些方法才会“正确”地将其纳入模型。马尔可夫链模型可以在残基相互依赖性在序列上邻近时捕捉到此类关系,但其典型实现仅考虑直接的序列相邻残基,而忽略其他所有信息;即使在最佳情况下,当依赖残基在序列中相隔十几个以上的位置时,隐马尔可夫模型的计算(见图2)也会变得难以处理4。由于这些IPDs实质上形成了“亚基序”,无法通过简单的“多数规则”甚至基于隐马尔可夫模型的共识模型预测5,6,其结果可能产生一种在生物学上无效的“共识”序列——这种序列不仅在自然界中从未出现,而且其活性甚至低于任何现存的蛋白质。基于马尔可夫随机场的系统(如GREMLIN7)试图克服这些问题。此外,尽管复杂的生物学/生物化学技术(如非连续重组3,8)可通过区域分析识别关键蛋白元件,但要实现单碱基对精度,仍需耗费大量时间和实验操作。
StickWRLD9 是一个基于 Python 的程序,可生成蛋白质比对的交互式三维可视化图,使共进化依赖性(IPD)清晰且易于理解。比对中的每个位点在显示中表示为一列,每列由一组球体堆叠而成,每个球体代表该位点可能出现的 20 种氨基酸之一。球体的大小取决于相应氨基酸出现的频率,因此用户只需观察球体大小,即可快速识别该位点的共识残基或氨基酸的相对分布情况。代表每个位点的列被环绕排列在一个圆柱体上,从而使代表每个位点所有可能氨基酸的球体,能够清晰地“视线可见”其他每个位点的所有其他氨基酸可能性。在可视化之前,StickWRLD 会计算所有可能残基组合之间的相关性强弱,以识别共进化依赖性(IPD)9。为了表示 IPD,在共同进化程度高于或低于随机独立分布预期的残基之间绘制连线(即 IPD)。
这种可视化不仅能够显示哪些序列位点在进化上存在相互作用,而且由于IPD的边线绘制在每一列的氨基酸球体之间,用户可以快速确定在每个位点倾向于共同进化的具体氨基酸。用户可以旋转并探索可视化的IPD结构,还能动态调整控制相关性显示的统计阈值,这使得StickWRLD成为研究IPD的有力发现工具。
GREMLIN7等应用同样展示了残基之间的复杂关系信息——但这些关系是通过更传统的马尔可夫模型计算得出的,而此类模型并非用于确定任何条件性关系。因此,这些关系能够以二维投影形式呈现。相比之下,StickWRLD能够计算并展示多节点条件依赖关系,而这些关系若以二维图形式渲染则可能被遮蔽(这一现象称为边遮挡)。
StickWRLD 的三维视图还具有其他多个优势。通过允许用户对可视化图像进行平移、旋转和缩放操作,原本在二维表示中可能被遮蔽或不够直观的特征,在 StickWRLD 的三维圆柱视图中可以更清晰地呈现。StickWRLD 本质上是一种可视化分析工具,它利用人类大脑强大的模式识别能力来发现数据中的模式与趋势,而多角度探索数据的能力进一步增强了这一效果。
方案
1. 软件下载 & 安装
- 使用配备 Intel i5 或更高版本处理器、至少 4 Gb 内存,并运行 Mac OS X 或 GNU/Linux 操作系统的计算机例如, Ubuntu)操作系统。此外,Python 2.7.610 以及 wxPython 2.811,SciPy12和 PyOpenGL13 需要安装 Python 库——请从各自的代码仓库下载并安装每一个库。
- 下载 StickWRLD 作为包含所有相关 Python 脚本的压缩包下载。下载“fasta2stick.sh”脚本,用于将标准 FASTA 格式的 DNA/蛋白质序列比对文件转换为 StickWRLD 格式。
- 解压归档文件,并将生成的 StickWRLD 文件夹放置在桌面上。同时将“fasta2stick.sh”脚本文件也放在桌面上。
2. 准备样品的排列
- 使用任何标准的序列比对软件(例如 ClustalX14)创建蛋白质序列的比对结果。将比对文件以 FASTA 格式保存在桌面上。
- 在 Mac 或 GNU/Linux 计算机上打开终端应用程序,通过输入 cd ~/Desktop 并按回车键,导航至桌面(即“fasta2stick.sh” shell 脚本所在的位置)。在终端中输入 ./fasta2stick.sh 来执行该脚本。如果脚本无法执行,请确保其具有可执行权限——在终端中输入 chmod +x fasta2stick.sh 以赋予脚本可执行权限。
- 根据脚本提供的屏幕提示,指定输入文件名(即上述步骤 1.2 中创建的文件)和期望的输出文件名。将输出文件(现已为 StickWRLD 所需的正确格式)保存在桌面上。
3. 启动 StickWRLD
- 使用 Mac 或 GNU/Linux 计算机的终端应用程序,进入 StickWRLD 可执行文件文件夹。例如,如果 StickWRLD 文件夹位于桌面,则在终端中输入 cd ~/Desktop/StickWRLD/exec。
- 在终端中输入 python-32 stickwrld_demo.py 以启动 StickWRLD。
- 确认屏幕上显示 StickWRLD 数据加载器面板(图 3)。
4. 加载数据
- 点击“Load Protein…”按钮,加载已转换的蛋白质序列比对文件。
- 选择上方第3步中创建的文件,然后点击“Open”。StickWRLD 将打开多个新窗口,包括“StickWRLD Control”(图4)和“StickWRLD - OpenGL”(图5)。
- 选择“StickWRLD – OpenGL”窗口。从“OpenGL”菜单中选择“Reset View”,以在可调整大小的 OpenGL 窗口中,通过表示数据的圆柱体以“自上而下”的视角显示 StickWRLD 的默认可视化效果。
5. 查看选项
- 在“StickWRLD Control”面板中(图4),选中“Column Labels”和“Ball Labels”复选框,以显示列和球的数值。
- 在“StickWRLD Control”面板中,取消选中“Column Edges”复选框,以隐藏列边缘线。
- 在“StickWRLD Control”面板中,将“Column Thickness”设置为0.1,以在列中绘制细线,便于浏览三维视图。按回车键确认更改。
- 在“StickWRLD – OpenGL”窗口中重置视图(如上文步骤5.3所述),然后点击“full screen”按钮以最大化显示视图。
6. 导航
- 按住鼠标左键并任意方向移动鼠标,以旋转3D StickWRLD显示画面。
- 按住鼠标右键并上下移动鼠标,以缩放3D StickWRLD显示画面。
7. 寻找插入位置依赖性(IPDs)
- 通过平移和缩放浏览视图,操作方法如步骤 6 所述。在满足 p 值和残差阈值要求的共进化残基之间,将通过边线连接,如图 6所示。如果连接残基的边线过多或过少,可在“StickWRLD Control”面板中调整残差阈值,以显示更少或更多的边线。
- 在 StickWRLD Control 面板中逐步提高残差阈值,直至 IPD 边线完全消失,然后缓慢降低阈值,直到出现关联关系。继续调整残差阈值,直至获得足够数量的关联关系用于分析。
- 识别涉及以下两类残基之间的关联关系:一是已知感兴趣的残基(例如,位于某个基序或结合/功能位点内的残基);二是在线性序列比对中相距较远的残基(提示它们在折叠后的蛋白质结构中空间位置邻近)。
8. 选择并保存结果
- 使用 Command 键 + 左键单击任意感兴趣的边。StickWRLD 控制面板将显示相应的列并连接特定残基。 例如, “(124|G) (136|H)”图7实线表示正相关;虚线表示负相关。
- 按下“StickWRLD 控制”面板上的“输出边缘”按钮,以保存一个纯文本格式的文件(edge_residual.csv所有可见边缘的(包括连接的残基及其实际残余值) /StickWRLD/exec/ 目录
结果
StickWRLD 之前已被用于检测 DNA 中残基之间的互作位置依赖性(IPDs)3 和蛋白15-17 比对。这些共同进化的残基在序列比对中通常相距较远,但在折叠后的蛋白质结构中往往彼此靠近。StickWRLD 可实现对这类位点上残基特异性共现的快速发现, 例如., 位置“x”上的丙氨酸与位置“y”上的苏氨酸之间存在强相关性。此类相关性可能提示可验证的结构关系,通常代表在进化过程中必须共进化的位点。StickWRLD 能够检测到这些关系,即使使用隐马尔可夫模型(HMM)来描述基序的传统方法失效时亦然。例如,利用 StickWRLD 分析 ADK 盖域的 PFAM 比对结果,揭示了位置 4 和 8 的半胱氨酸(C)之间存在强烈的正相关,以及位置 35 和 38 的一对协同出现的半胱氨酸(C)。同时,StickWRLD 显示位置 4 和 8 的组氨酸(H)与丝氨酸(S)之间也存在类似的强正相关关系,而这些残基与位于 4、8、35 和 38 的半胱氨酸四联体之间则呈现强烈的负相关,并且与位置 35 的天冬氨酸(D)和位置 38 的苏氨酸(T)分别表现出强烈的正相关。在 H、S、D、T 基序与枯草芽孢杆菌(b subtilis)中位置 ****10 和 29 的苏氨酸(T)和甘氨酸(G)之间还存在额外的成对差异指标(IPDs),突显了这些 IPDs 的条件依赖性——四半胱氨酸基序对这两个位置的残基身份“无要求”,而亲水性的 H、S、D、T 三联基序则几乎绝对需要这两个位置上的特定残基。这两种完全不同的位置依赖性残基基序均可发挥 ADK 盖域的相同功能。如图所示 图6,一个包含多个相互作用位点的大簇清晰可见,其中包括第132位的甘氨酸(G)、第135位的酪氨酸(Y)与第141位的脯氨酸(P)之间的三节点关联,位于前景中(图6A)。在 图6B,视图已调整为从略高于圆柱体的位置观察,显示出位于第136位的组氨酸(H)与第29位的甲硫氨酸(M)之间的相互作用界面(IPD),两者相距107个残基。该结构域中由PFAM HMM推导出的一个基序(motif)(图2),然而,不仅无法特异性地检测到这些共同出现的基序变体,而且其定义的整体分组方式也缺乏生物学依据16.
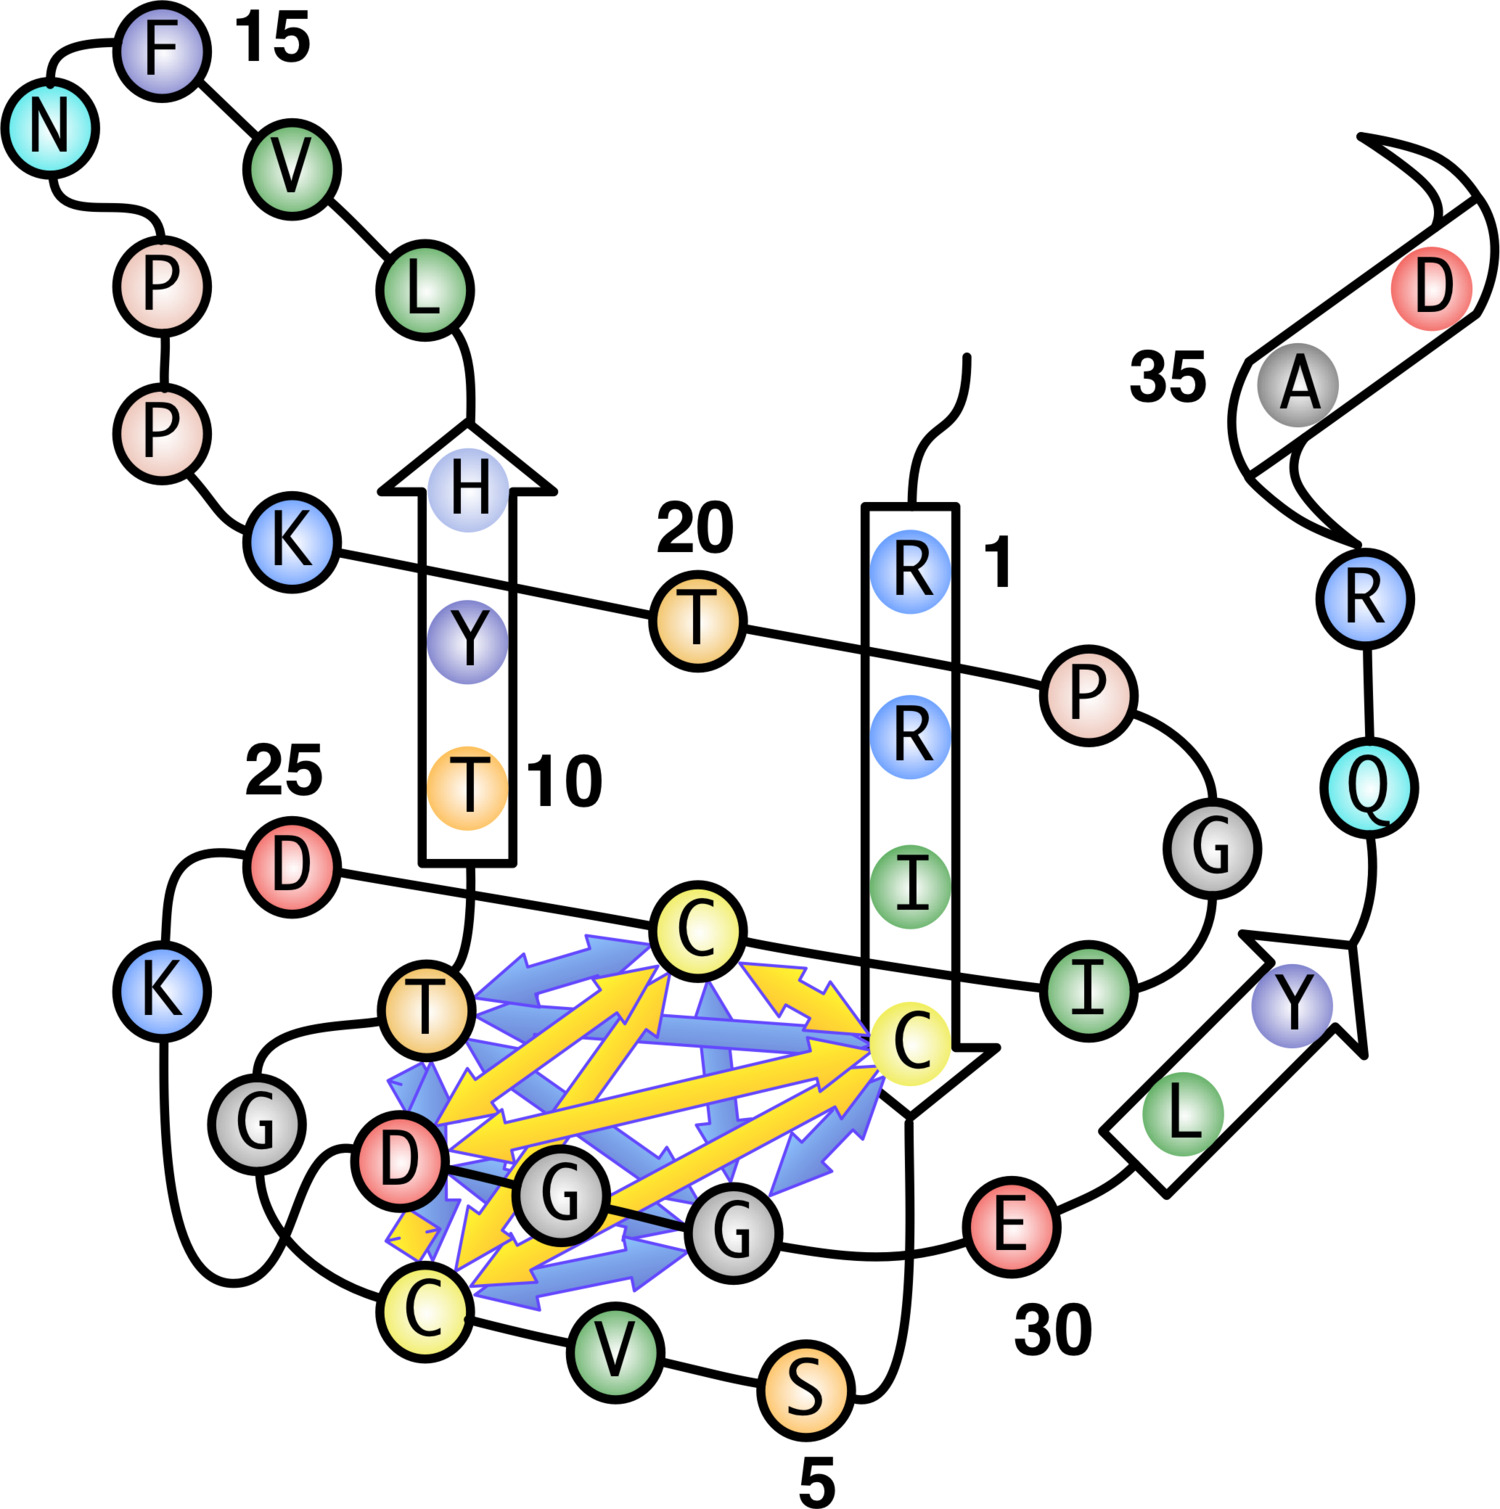
图1. 枯草芽孢杆菌(B. subtilis)腺苷激酶(ADK)Lid结构域的“地铁图”表示。 箭头表示StickWRLD在ADK Lid结构域的PFAM比对中识别出的相互作用位点对(IPD)。StickWRLD能够准确识别在折叠蛋白中空间上邻近的一簇残基内的IPD。特别值得注意的是位于第9和29位的T和G残基对,只有当第4、7、24和27位的四联残基不为C,C,C,C时,该对才会形成IPD。图中显示的残基编号对应于枯草芽孢杆菌(B. subtilis)的序列位置,而非PFAM比对中的位置。请点击此处查看该图的高清版本。
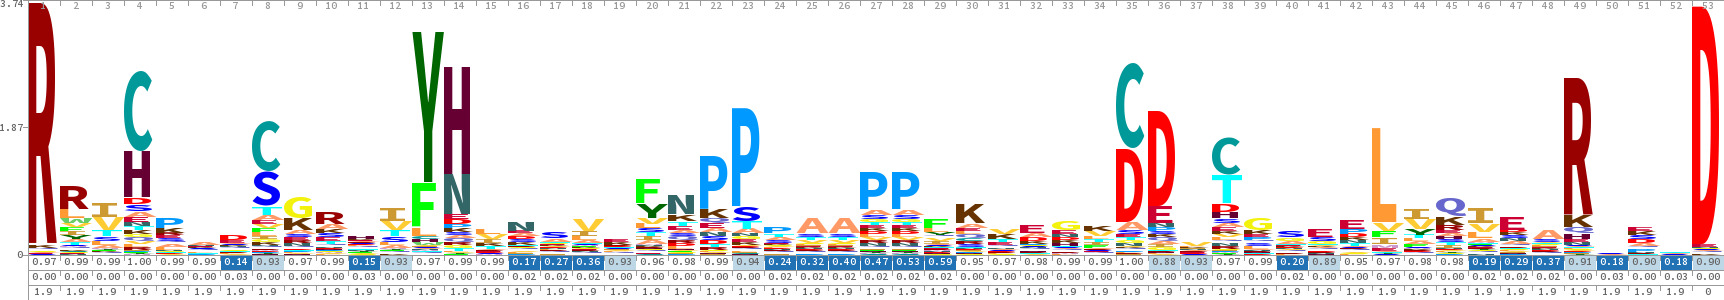
图 2. ADK 盖域的 Skylign18 隐马尔可夫模型(HMM)序列标志图。 尽管隐马尔可夫模型(HMM)是确定每个位点概率以及各位点对整体模型贡献的有力工具,但其位点独立性使其不适合检测相互依赖性(IPD)。该模型未提示在 StickWRLD 表示中观察到的任何依赖关系(图 6)。请点击此处查看此图的放大版本。
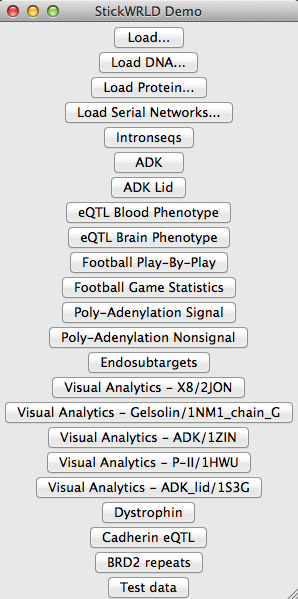
图 3. StickWRLD 数据加载器。 用户可选择使用现有的示例数据,或以 DNA 或蛋白质序列比对的形式加载自己的数据。
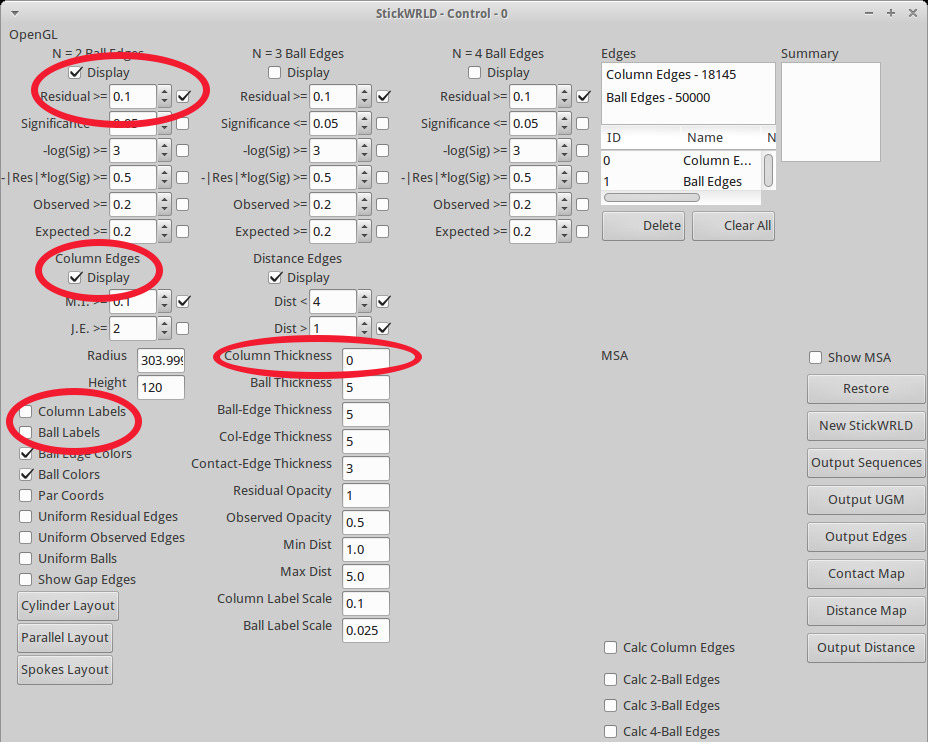
图 4. StickWRLD 控制窗口。 控制面板允许用户更改各种视图属性,并调节控制显示残基间关系(IPD)的边线显示阈值。用红色圆圈标出的是通常需要调整以获得最佳数据集显示效果的默认设置。残差值(Residual value)设定绘制连接线或关联线的(观测值-期望值)阈值。列标签(Column)和球状标签(Ball labels)的控制选项用于确定是否显示列位置及残基值(例如,精氨酸的“A”)。列边缘线控制(Column Edge Line)用于开启或关闭连接各列之间的边线显示——对于密集的数据集,建议关闭此功能。列粗细控制(Column Thickness)决定是否显示列本身——将其设置为非常小的值(例如,0.1)将在该列的球体之间绘制一条细线,便于区分不同列。 请点击此处查看该图的放大版本。
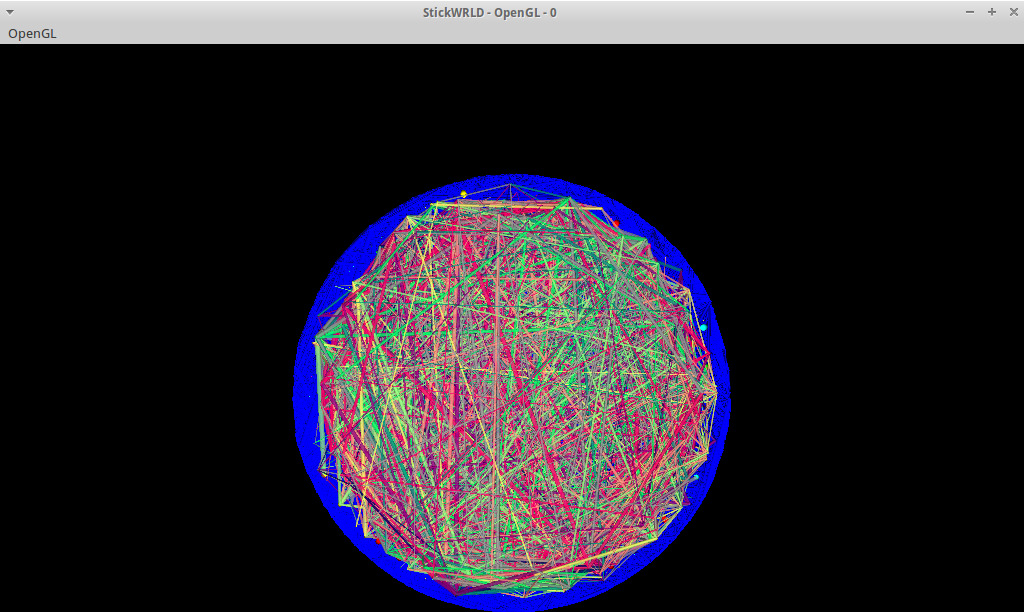
图 5. 加载腺苷酸激酶盖域蛋白数据集后 StickWRLD OpenGL 窗口的初始视图。 初始视角从上向下穿过由序列比对位置组成的圆柱体。用户可通过鼠标左键拖动旋转圆柱体,通过鼠标右键拖动实现缩放。由于默认显示模式会呈现即使很弱的共进化速率,因此初始视图较为密集。对于许多蛋白质而言,在此设置下可识别出明显的模块结构;而对于共进化程度较高的蛋白质,也可通过 StickWRLD 界面快速、交互式地简化显示,以找出最重要的 IPD。 请点击此处查看该图的高清版本。
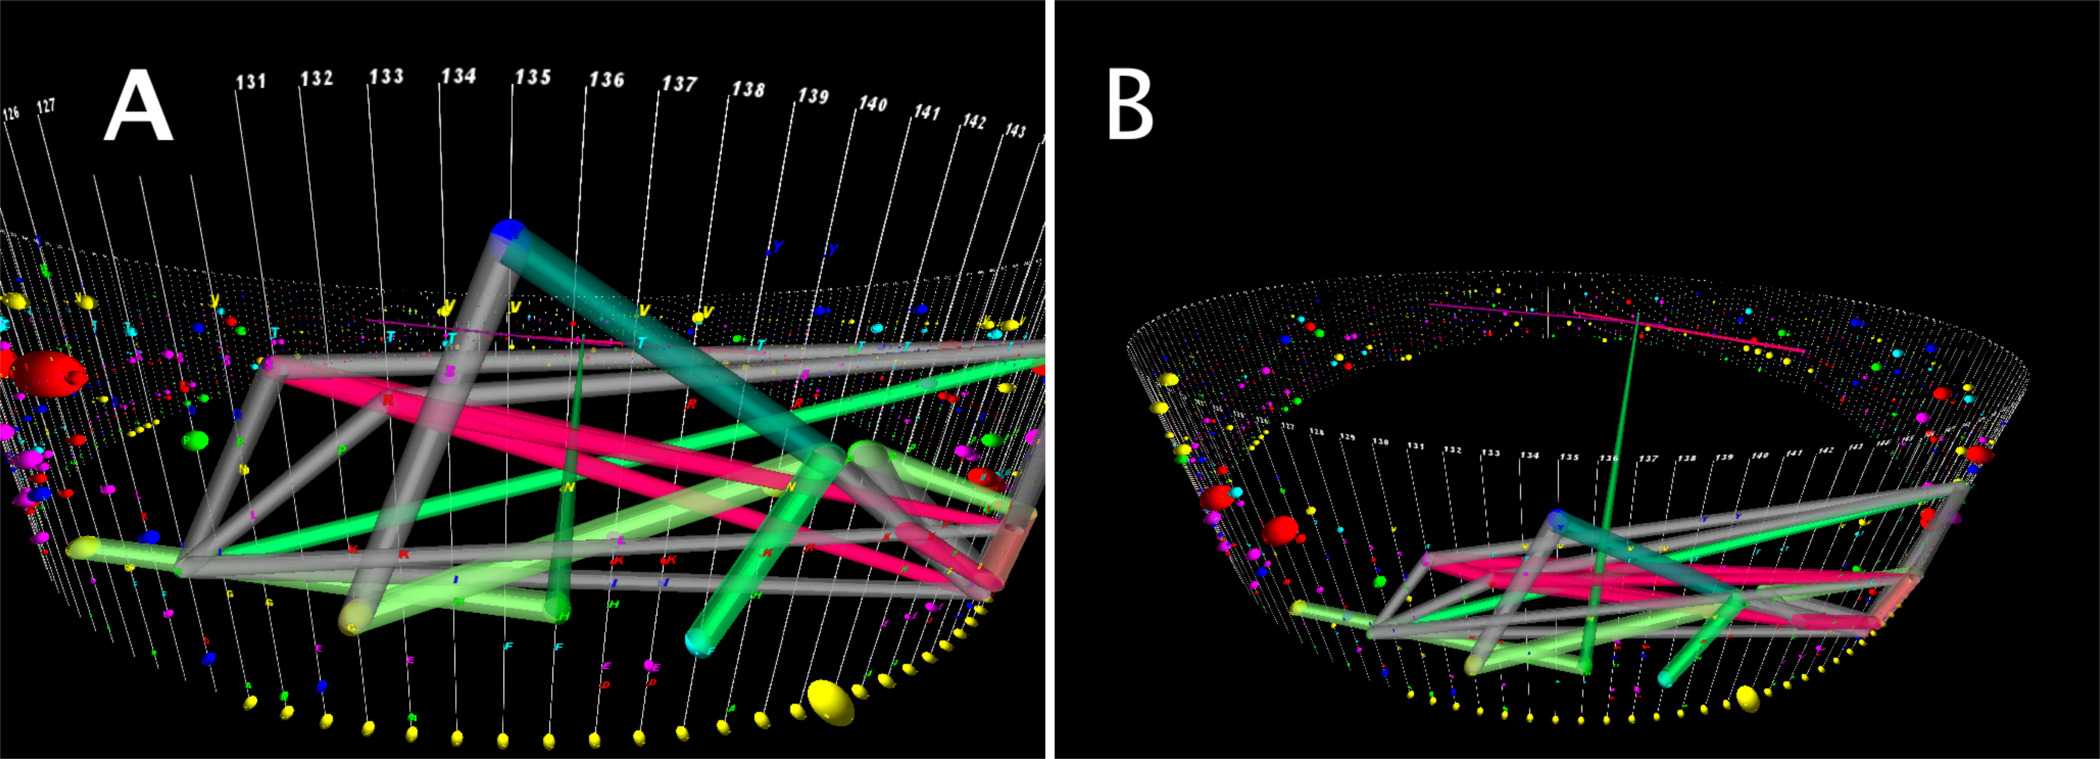
图6. 腺苷酸激酶盖域蛋白在StickWRLD中的可视化局部放大图。 此处我们将默认的残基阈值(Residual)更改为0.2,从而提高了残基间连接边的显示阈值,导致显示的边数量减少。保留的边表示强烈关联的IPD。此外,视图已旋转并放大,以便更清晰地观察这些边。(A) 前景中可见一个较大的IPD簇,其中包括位于第132位的G(甘氨酸)、第135位的Y(酪氨酸)和第141位的P(脯氨酸)之间形成的三节点关联。(B) 视图已倾斜,使观察者视角略高于圆柱体上方,揭示出第136位的H(组氨酸)与相距107个残基的第29位的M(甲硫氨酸)之间存在一个IPD。 请点击此处查看该图的高清版本。
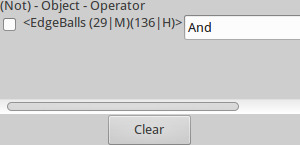
图 7. StickWRLD 控制窗口右下角信息视图。 在 OpenGL 窗口中按住 Ctrl 键并左键点击某个对象(例如 球体或边)时,会在 StickWRLD 控制窗口的右下角显示该对象的信息。此处显示的是位于第 29 位的甲硫氨酸与位于第 136 位的组氨酸之间 IPD 边的信息。
讨论
StickWRLD 已成功用于鉴定腺苷酸激酶盖域中的此类插入缺失模式16,以及 rho 依赖型终止子中的相关 DNA 碱基9,还有古菌 tRNA 内含子核酸内切酶6靶位点中的一种新型剪接位点特异性。这些插入缺失模式无法通过直接比对分析检测到。
StickWRLD 将比对中的每个位点显示为一列包含 20 个“球体”的图形,每个球体代表 20 种氨基酸残基中的一种,球体的大小表示该残基在对应列中出现的频率(图 4)。各列排列成圆柱形,通过边缘线连接不同列中的残基(表示一个 IPD)。仅当相应残基的共变频率超过 p 值(显著性)和残差(预期值 - 观测值)阈值时,才会绘制这些边缘线。
在DNA或蛋白质序列比对的远端区域中,使用标准序列比对工具检测共同出现且相互依赖的残基(即IPDs)十分困难6。尽管这些工具能够生成一个共识序列(或称模体序列),但这种共识序列在许多情况下仅基于简单的多数规则平均,无法反映可能形成一个或多个亚模体的共变关系——即倾向于共同进化的残基群组。即使是能够检测邻近依赖关系的隐马尔可夫模型(HMM),也无法准确建模具有远端IPDs的序列模体5。其结果是,所计算出的共识序列实际上可能是一种自然界中并不存在的“合成”序列——基于此类计算共识设计的工程蛋白实际上可能并非最优。事实上,ADK的Pfam HMM模型会提示:一个包含半截四半胱氨酸模体和半截H,S,D,T模体的嵌合蛋白,在功能上与其他真实存在的ADK蛋白同样可接受。然而事实并非如此,此类嵌合体(以及这些模体的许多其他组合)均无催化活性4,19。
在寻找相关性时,必须调整残差阈值,以确保能够发现相关关系:首先将阈值设置在出现任何连接边的水平之上,然后逐步降低阈值。这样可确保最初仅考虑最显著的连接边。
另一种方法是从极低的残差阈值开始,这将显示所有显著的边。随后可逐步提高残差阈值,使边逐渐消失,直至出现明显的模式。尽管这种方法在需要纳入特定节点(例如,应用领域知识)时作用有限,但可将StickWRLD作为可视化分析工具,用于在数据可视化中发现意外的关联关系和新兴模式。
StickWRLD 的性能主要受限于运行该程序的系统内存以及显示设备的分辨率。尽管 StickWRLD 在理论上可分析的数据点数量没有限制,且已测试过长达 20,000 个位点的序列,但在实际应用中,StickWRLD 处理长度在 1,000 个位点以内的序列时表现最佳。
StickWRLD 的主要优势在于其能够识别彼此共同变异的残基群组。这一优势显著优于传统的统计学共识序列方法,后者仅进行简单的统计平均,未考虑共进化因素。尽管在某些情况下,共同变异的残基可能仅仅是系统发育的产物,但这些残基仍经受住了“选择压力的检验”,因此不太可能影响任何经工程化设计而包含它们的蛋白质的功能性。
尽管在设计合成变体之前,使用 StickWRLD 识别标准 DNA 或蛋白质序列共识/基序中的插入缺失位点(IPD)可降低出错风险,并支持功能的快速优化,但需注意的是,StickWRLD 是一种通用的相关性识别工具,不仅限于蛋白质数据。StickWRLD 可用于在任何经过适当编码的数据集中直观地发现任意变量之间的共现关系。
披露
作者声明不存在任何竞争性经济利益。
致谢
StickWRLD 的开发部分得益于 Nationwide 儿童医院研究所向 Ray 博士提供的资助,以及美国国家科学基金会(NSF)授予的 DBI-1262457 项目基金。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| Mac 或 Ubuntu 操作系统的计算机 | 各种 | 任何 Mac 或 GNU/Linux(例如, 能够运行 Python 的 Ubuntu 计算机 &和相关 shell 脚本 | |
| Python 编程语言 | python.org | 建议使用 Python 2.7.6 或更高版本 | |
| wxPython 库 | wxpython.org | 推荐使用最新版本 | |
| SciPy 库 | scipy.org | 推荐使用最新版本 | |
| PyOpenGL 库 | pyopengl.sourceforge.net | 推荐使用最新版本 | |
| StickWRLD Python 脚本 | NCH BCCM | 可从以下获取 http://www.stickwrld.org | |
| fasta2stick.sh 文件转换器 | NCH BCCM | 可从以下渠道获取 http://www.stickwrld.org | |
| 蛋白质和/或DNA序列数据 | 样品可获取于 http://www.stickwrld.org |
参考文献
- Ray, W. C. Addressing the unmet need for visualizing conditional random fields in biological data. BMC. 15, 202(2014).
- Sullivan, B. J., Durani, V., Magliery, T. J. Triosephosphate isomerase by consensus design: dramatic differences in physical properties and activity of related variants. Journal of molecular biology. 413, 195-208 (2011).
- Smith, M. A., Bedbrook, C. N., Wu, T., Arnold, F. H. Hypocrea jecorina cellobiohydrolase I stabilizing mutations identified using noncontiguous recombination. ACS synthetic biology. 2, 690-696 (2013).
- Ray, W. C. Understanding the sequence requirements of protein families: insights from the BioVis 2013 contests. BMC proceedings. 8, S1(2014).
- Eddy, S. R. What is a hidden Markov model? Nature biotechnology. 22, 1315-1316 (2004).
- Ray, W. C., Ozer, H. G., Armbruster, D. W., Daniels, C. J. Beyond identity - when classical homology searching fails, why, and what you can do about it. Proceedings of the 4th Ohio Collaborative Conference on Bioinformatics. , IEEE Press. New York, NY. 51-56 (2009).
- Ovchinnikov, S., Kamisetty, H., Baker, D. Robust and accurate prediction of residue-residue interactions across protein interfaces using evolutionary information. eLife. 3, e02030(2014).
- Trudeau, D. L., Lee, T. M., Arnold, F. H. Engineered thermostable fungal cellulases exhibit efficient synergistic cellulose hydrolysis at elevated temperatures. Biotechnology and bioengineering. 111, 2390-2397 (2014).
- Ray, W. C. MAVL and StickWRLD: visually exploring relationships in nucleic acid sequence alignments. Nucleic acids research. 32, W59-W63 (2004).
- Python Language Reference v.2.7.6. , Available from: https://www.python.org/download/releases/2.7.6/ (2014).
- Talbot, H. wxPython, a GUI Toolkit. Linux Journal. , Available from: http://www.linuxjournal.com/article/3776 (2000).
- Jones, E., Oliphant, T., Peterson, P., et al. SciPy: Open Source Scientific Tools for Python. , Available from: http://www.scipy.org/ (2001).
- PyOpenGL The Python OpenGL Binding. , Available from: http://pyopengl.sourceforge.net/ (2014).
- Larkin, M. A. Clustal W and Clustal X version 2.0. Bioinformatics. 23, 2947-2948 (2007).
- Ozer, H. G., Ray, W. C. MAVL/StickWRLD: analyzing structural constraints using interpositional dependencies in biomolecular sequence alignments. Nucleic acids research. 34, W133-W136 (2006).
- Ray, W. C. MAVL/StickWRLD for protein: visualizing protein sequence families to detect non-consensus features. Nucleic acids research. 33, W315-W319 (2005).
- Ray, W. C. A Visual Analytics approach to identifying protein structural constraints. IEEE. , Ohio State Univ. Biophys. Program. Columbus, OH. 249-250 (2010).
- Wheeler, T. J., Clements, J., Finn, R. D. Skylign: a tool for creating informative, interactive logos representing sequence alignments and profile hidden Markov models. BMC bioinformatics. 15, 7(2014).
- Perrier, V., Burlacu-Miron, S., Bourgeois, S., Surewicz, W. K., Gilles, A. M. Genetically engineered zinc-chelating adenylate kinase from Escherichia coli with enhanced thermal stability. The Journal of biological chemistry. 273, 19097-19101 (1998).
重印与许可
