全长单个前病毒测序(FLIPS)是一种高效、高通量的方法,可用于扩增和测序单个接近全长的(完整和有缺陷的)HIV-1前病毒,并可评估其潜在的复制能力。FLIPS克服了以往用于测序潜伏HIV-1储存库的检测方法的局限性。
本文内容
摘要
摘要
全长单个前病毒测序(FLIPS)检测是一种高效、高通量的方法,旨在扩增并测序单个接近全长的(完整与有缺陷的)HIV-1前病毒。FLIPS可用于确定细胞群体中整合型HIV-1的遗传组成。通过识别在逆转录过程中产生的HIV-1前病毒序列中的缺陷,例如大的内部缺失、有害的终止密码子/超突变、移码突变以及病毒颗粒成熟所必需的顺式作用元件中的突变或缺失,FLIPS能够鉴定出无法复制的整合前病毒。FLIPS检测可用于识别缺乏上述缺陷且具有复制能力的HIV-1前病毒 因此可能具有复制能力。FLIPS 试剂盒包括:HIV-1 感染细胞的裂解,针对接近全长的 HIV-1 前病毒进行巢式 PCR(使用靶向 HIV-1 5' 和 3' LTR 的引物),DNA 纯化与定量,下一代测序(NGS)文库构建,NGS 测序 从头合成 前病毒重叠群的组装,以及通过简单的排除法鉴定具有复制能力的前病毒。FLIPS 相较于传统的整合型 HIV-1 前病毒测序方法(如单前病毒测序)具有优势。FLIPS 可扩增并测序接近全长的前病毒,从而判断其复制能力,同时使用更少的扩增引物,避免了引物错配带来的影响。FLIPS 是研究整合型 HIV-1 前病毒遗传特征的有力工具,尤其适用于潜伏病毒库的分析,但其应用范围可扩展至任何需要解析整合型 HIV-1 遗传组成的研究领域。
引言
对长期接受抗逆转录病毒治疗(ART)个体中持续存在的潜伏性HIV-1储存库进行遗传学表征,对于理解整合前病毒的特性至关重要;研究发现,大多数整合的前病毒存在缺陷且不具备复制能力1,2。在逆转录过程中,错误会被引入整合的前病毒序列中。导致前病毒序列缺陷的机制包括易出错的HIV-1逆转录酶3、模板转换4和/或APOBEC介导的超突变5,6。最近两项研究发现,从长期接受ART的个体中分离出的HIV-1前病毒中,约有5%在基因结构上是完整的,可能具有复制能力,并可在停用ART后导致血浆HIV-1水平迅速反弹1,2,7。既往研究已证实,具有复制能力的HIV-1前病毒可在初始型和静息记忆型CD4+ T细胞亚群(包括中央记忆、过渡记忆和效应记忆T细胞)中长期存在,提示在未来的根除策略中靶向这些细胞的重要性2,8,9。
通过利用单原病毒测序(SPS)方法对 HIV-1 基因组的亚基因组区域进行遗传学表征,研究人员早期获得了关于潜伏性 HIV-1 储库分布、动态变化及维持机制的重要认识10,11,12,13。SPS 是一种多功能工具,能够从单个感染细胞中对单个 HIV-1 原病毒进行测序。然而,由于 SPS 仅测序亚基因组区域,且会遗漏引物结合位点内含有大片段缺失的原病毒,因此无法确定原病毒的复制能力。先前一项研究显示,SPS 通过选择性地测序完整的亚基因组区域,使复制能力型储库的估计值被高估了 13 至 17 倍2。
为解决SPS的局限性,Ho et al.4 和 Bruner et al.1 开发了可测序接近全长HIV-1前病毒的检测方法。这使得研究人员能够确定长期接受抗逆转录病毒治疗(ART)个体体内基因组完整且可能具有复制能力的HIV-1前病毒的频率。这些检测方法通过扩增并测序(采用Sanger测序)前病毒的亚基因组区域,再将这些序列拼接,以获得完整(完整或缺陷型)HIV-1前病毒序列。该方法存在三个局限性:1)使用多个测序引物会增加无意中将序列缺陷引入前病毒序列的风险;2)引物不匹配可能导致某些前病毒无法扩增;3)由于这些方法的技术复杂性,往往难以获得完整的前病毒序列。
为了克服现有全长 HIV-1 前病毒测序检测方法的局限性,我们开发了全长个体前病毒序列(FLIPS)检测法。FLIPS 是一种基于高通量测序(NGS)的技术,能够以高通量且高效的方式扩增并测序接近全长的(完整或缺陷型)HIV-1 前病毒。与以往的检测方法相比,FLIPS 具有优势,因为它减少了所用引物的数量,从而降低了引物错配的可能性,避免了因错配而遗漏部分前病毒群体或在病毒序列中无意引入假性缺陷。此外,FLIPS 的技术难度也低于以往方法,主要包括六个步骤:1)裂解 HIV-1 感染细胞;2)通过巢式 PCR 在极限稀释条件下扩增单个 HIV-1 前病毒,所用引物特异性针对高度保守的 HIV-1 5' 和 3' U5 LTR 区域(图 1A);3)纯化并定量扩增产物;4)为 NGS 构建扩增后前病毒的文库;5)进行 NGS 测序;6)对测序获得的前病毒序列进行de novo 组装,以获得每个个体前病毒的重叠群序列(contig)。
FLIPS 生成的序列可经过严格的筛选流程,以鉴定出基因组完整且可能具有复制能力的序列(图 1C)2。基因组完整的前病毒缺乏所有已知会导致复制缺陷型前病毒产生的缺陷,这些缺陷包括:序列倒位、大片段内部缺失、超突变/有害终止密码子、移码突变,或 5' 包装信号及主要剪接供体(MSD)位点的突变。
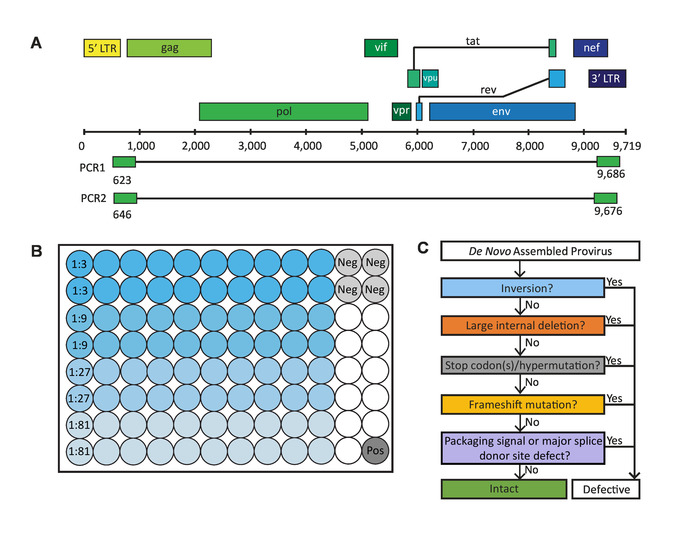
图1:全长单个前病毒测序(FLIPS)检测中的关键步骤。(A)HIV-1 DNA基因组,其5'和3' U5 LTR区域含有FLIPS所用的引物结合位点,通过巢式PCR扩增接近全长的(缺陷型和完整型)HIV-1前病毒。(B)96孔PCR板的布局,包含80个样本孔(每个稀释度20孔)、4个阴性对照孔和1个阳性对照孔。(C)用于鉴定基因组完整且可能具有复制能力的HIV-1前病毒的排除流程。本图经Hiener et al.2. 修改。 请点击此处查看此图的放大版本。
方案
本文所述所有方法均已获得加利福尼亚大学旧金山分校和包括威斯特米德医学研究所在内的西悉尼地方卫生区机构审查委员会的批准。
1. 裂解 HIV-1 感染的细胞
注意:细胞可从外周血、白细胞分离样本、骨髓活检或组织活检中分离获得。细胞群体可使用荧光激活细胞分选(FACS)进行分选。
- 配制裂解缓冲液,其中含有 10 mM Tris-HCl、0.5% Nonidet P-40、0.5% Tween-20 和 0.3 mg/mL 蛋白酶 K。每 1 × 10⁶ 个细胞,向细胞沉淀中加入 100 µL 裂解缓冲液。用移液器吹打混匀。先在 55 °C 孵育 1 小时,再于 85 °C 孵育 15 分钟,以裂解细胞并释放基因组 DNA 用于 PCR 扩增。
注意:细胞裂解足以获得可用于扩增的基因组 DNA,无需进行 DNA 分离或纯化。本方案可在该步骤暂停,基因组 DNA 可无限期保存于 -20 °C。
2. 通过巢式PCR扩增单个HIV-1 DNA前病毒
- 配制第一轮 PCR(PCR1)所需的试剂,试剂列表见表1(参见材料表)。将38 µL预混液加入96孔PCR板的85个孔中(80个样本、4个阴性对照、1个阳性对照)(按照图1B中的布局)。将此板标记为“PCR1”。
| 试剂 | 终浓度 | PCR1 板所需体积 (µL) | PCR2 板所需体积 (µL) |
| 正向引物 | 1 µM | 32.3 | 23.8 |
| 反向引物 | 1 µM | 32.3 | 23.8 |
| 缓冲液 (10x) | 1x | 323 | 238 |
| MgSO4 (50 mM) | 2 mM | 129.2 | 95.2 |
| dNTP (10 mM) | 0.2 mM | 64.6 | 47.6 |
| DNA 聚合酶 (5 U/µL) | 0.025 U/µL | 16.2 | 11.9 |
| 超纯 H2O | 2632.5 | 1939.7 |
表1: PCR反应主混合液的试剂及体积。
注意:PCR1 使用的引物如下:
BLOuterF:5’-AAATCTCTAGCAGTGGCGCCCGAACAG-3’(HXB2 位置 623-649)
BLOuterR:5’-TGAGGGATCTCTAGTTACCAGAGTC-3’(HXB2 位置 9662-9686)
- 配制好主混合液后,将PCR1板转移至专门用于添加基因组DNA的洁净区域。
- 用Tris-HCl(5 mM,pH 8)将基因组DNA从1:3到1:81进行系列稀释,每种稀释度准备45 µL(每种稀释度足够20个孔使用)。向每个样本孔中加入2 µL稀释后的基因组DNA,向每个阴性对照孔中加入2 µL Tris-HCl(5 mM,pH 8)(参见图1B中的布局)。使用透明粘性封膜密封PCR1板的所有孔,阳性对照孔除外(见材料表)。
注意:上述推荐的稀释度仅作为确定终点稀释度的起始参考。实际稀释度取决于样品中整合的HIV-1 DNA浓度。
- 用Tris-HCl(5 mM,pH 8)将基因组DNA从1:3到1:81进行系列稀释,每种稀释度准备45 µL(每种稀释度足够20个孔使用)。向每个样本孔中加入2 µL稀释后的基因组DNA,向每个阴性对照孔中加入2 µL Tris-HCl(5 mM,pH 8)(参见图1B中的布局)。使用透明粘性封膜密封PCR1板的所有孔,阳性对照孔除外(见材料表)。
- 转移至专门用于添加阳性对照的区域。向PCR1板的阳性对照孔中加入2 µL阳性对照(pNL4-3稀释至105 拷贝/µL),然后密封该板。将PCR1板短暂离心(在PCR板离心机或离心机中以400 × g、室温离心10秒),使附着在孔壁上的液体沉至孔底。
- 在热循环仪中运行PCR1板程序:94 °C 预变性2分钟;然后94 °C 变性30秒,64 °C 退火30秒,68 °C 延伸10分钟,进行3个循环;94 °C 30秒,61 °C 30秒,68 °C 10分钟,进行3个循环;94 °C 30秒,58 °C 30秒,68 °C 10分钟,进行3个循环;94 °C 30秒,55 °C 30秒,68 °C 10分钟,进行21个循环;最后68 °C 延伸10分钟(共30个循环)。程序结束后保持在4 °C。
注意:此步骤可暂停,PCR1板可在4 °C保存最多2天。 - 配制第二轮PCR(PCR2)所需的试剂,具体见表1。将28 µL混合液加入新的96孔PCR板的85个孔中(80个样本孔、4个阴性对照孔、1个阳性对照孔)(参见图1B中的布局)。将此板标记为“PCR2”。
注意:PCR2 使用的引物如下:
275F:5’-ACAGGGACCTGAAAGCGAAAG-3’(HXB2 位置 646-666)
280R:5’-CTAGTTACCAGAGTCACACAACAGACG-3’(HXB2 位置 9650-9676)
- 短暂离心PCR1板,使用PCR板离心机或离心机(400 × g) g 室温下离心10秒,以收集管壁残留液体。向PCR1板的每个孔中加入80 µL Tris-HCl(5 mM,pH 8)。
- 使用多通道移液器将2 µL PCR1板中的样品转移至PCR2板。确保样品逐孔准确转移(即, 将PCR1板A1孔中的2 µL转移至PCR2板A1孔。使用透明粘性封膜密封PCR2板(参见 材料表).
- 短暂地在PCR板离心机或离心机中离心PCR2板(400 x g 室温下离心10秒,以收集管壁残留液体。使用热封膜密封PCR1板,于-20 °C长期保存(参见 材料表).
- 将PCR2板放入PCR仪中运行:94 °C预变性2 min;随后进行3个循环:94 °C变性30 s,64 °C退火30 s,68 °C延伸10 min;再进行3个循环:94 °C变性30 s,61 °C退火30 s,68 °C延伸10 min;接着进行3个循环:94 °C变性30 s,58 °C退火30 s,68 °C延伸10 min;然后进行31个循环:94 °C变性30 s,55 °C退火30 s,68 °C延伸10 min;最后68 °C终延伸10 min(共40个循环)。反应结束后置于4 °C保存。
注意:此处可暂停实验方案,将PCR2板置于4 °C保存最多2天。 - 轻轻旋转PCR2板,使用PCR板旋转器或离心机将管壁残留液体甩至管底。使用多通道移液器向每孔加入60 µL Tris-HCl(5 mM,pH 8)。
- 在含有溴化乙锭(0.1‒0.3 µg/mL)的2块48孔预制1%琼脂糖凝胶上,每孔加样15 µL(见 材料表)。使用范围可达10 kb的DNA分子量标准(参见 材料表观察以确定含有扩增产物的孔及其大致大小。保存凝胶图像。
注意:确保阳性对照孔中含有扩增产物。如果阴性对照孔中出现扩增产物,提示可能存在污染,应弃用该板。
- 在含有溴化乙锭(0.1‒0.3 µg/mL)的2块48孔预制1%琼脂糖凝胶上,每孔加样15 µL(见 材料表)。使用范围可达10 kb的DNA分子量标准(参见 材料表观察以确定含有扩增产物的孔及其大致大小。保存凝胶图像。
- 确定扩增产物阳性孔数不超过30%的稀释度。
注意:此为终点稀释,其中大多数(80%)孔中含有来自单一模板的扩增产物。应制备并使用该稀释度进行后续PCR,以获得更多的前病毒扩增子。记录每个扩增产物的近似大小。
3. DNA 纯化与定量
- 轻轻旋转PCR2板,使用PCR板旋转器或离心机短时离心,使管壁残留液体沉降至管底。从含有扩增产物(处于或低于终点稀释浓度)的孔中转移40 µL至新的96孔中型板(每孔体积0.8 mL,参见 材料表).
注意:在电子表格中记录每种扩增产物的原始孔位和新的孔位,作为每种待测序扩增产物的记录。 - 使用基于磁珠的PCR纯化试剂盒(见材料表)纯化扩增后的DNA产物,以去除引物、核苷酸、酶、油类和盐分。操作前将磁珠恢复至室温,并配制新鲜的80%乙醇。在适当情况下使用新的移液器吸头,以避免DNA样本之间的交叉污染。
- 涡旋振荡磁珠,确保充分重悬。使用多通道移液器将40 µL磁珠加入含40 µL扩增产物的0.8 mL 96孔深孔板中。轻柔吹打混合10次。或者,密封反应板后置于微量振荡仪上,以1,800 rpm振荡2分钟进行混匀。室温孵育5分钟。
- 将培养板置于磁力架上(参见 材料表静置2分钟。移除并弃去上清液。
- 用 200 µL 80% 的溶液洗涤磁珠 将乙醇加入置于支架上的各孔中。室温孵育30秒。移除并弃去上清液。重复一次。使用带细尖的多通道移液器,在第二次洗涤后除去残留的乙醇。将板置于支架上,使磁珠在空气中干燥15分钟。
- 从支架上取下培养板。加入 30 µL 洗脱缓冲液(参见 材料表向每孔中加入)溶液,轻轻吹吸混匀10次。或者,密封酶标板后,在微型振荡器上以1,800 rpm振荡2分钟以混匀溶液。室温孵育2分钟。
- 将平板置于磁力架上静置 2 分钟。使用多通道移液器,将 25 µL 上清液(纯化后的 DNA)转移至新的 96 孔 PCR 板中。确保样品逐孔准确转移(即, 将0.8 mL板中A1孔的上清液转移至新的96孔板的A1孔。
注意:保留5 μL洗脱样品,以确保不转移残留的纯化珠。
- 使用分光光度计(在260 nm波长处测定吸光度)测定并记录每种扩增后DNA产物在纯化后的近似浓度。
注意:此阶段需测定每种扩增产物的大致浓度,以确保在纯化步骤中无样品损失,且其大致浓度处于下一阶段所用标准曲线的范围之内(100 µL 体积中 DNA 浓度为 0.001–1 ng/µL)。本实验方案可在此暂停,纯化后的样品可在 -20 °C 下保存长达 6 个月。 - 使用双链DNA定量试剂盒(见材料表)测定每种纯化产物的DNA浓度。
注意:本步骤涉及使用标准曲线测定样品中双链DNA(dsDNA)的浓度。试剂盒包含缓冲液(10 mM Tris-HCl,1 mM EDTA,pH 7.5)、λ双链DNA标准品和荧光染料。所有试剂需置于冰上保存。盛装染料的离心管须用铝箔包裹,避免光照。每种扩增产物需进行三次重复测定以测量其浓度。- 将缓冲液用无菌无DNase的H稀释至1x2O. 向适量的空孔中加入 99 µL 缓冲液(待测量扩增产物数量的 3 倍,参见 表 2 (示例布局)使用平底组织培养板。向3个空白孔中每孔加入100 µL缓冲液。
- 对于每种待检测的扩增产物,将步骤 3.2.5 中纯化的 DNA 各 1 µL 一式三份加入含有缓冲液的每个孔中(参见 表 2 示例布局)。
- 为制备标准品,将λ双链DNA从2 ng/µL按10倍稀释至0.002 ng/µL。每种双链DNA标准品各取100 µL加入3个孔中。
注意:完成步骤 3.4.4 后,标准品的最终浓度范围为 1 至 0.001 ng/µL - 用缓冲液将荧光染料按1:200稀释。迅速向每孔(含样品、空白孔和标准品孔)加入100 µL。用移液器上下吹打混匀。用铝箔覆盖酶标板,避免光照。
- 在酶标仪上读取荧光发射信号(激发波长480 nm,发射波长520 nm)。将结果记录在电子表格中。
- 使用记录的荧光测量值确定每个样品中双链DNA(dsDNA)的浓度。从样品和标准品的荧光值中减去空白孔的荧光值。根据三个重复孔的测量结果,计算每个样品和标准品的平均荧光值。根据标准品的荧光测量值绘制标准曲线。相对于标准品确定各样品的浓度。
| 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 | 11 | 12 | |
| A | 标准品 (1 ng/mL) | 标准品 (0.1 ng/mL) | 标准品 (0.01 ng/mL) | 标准品 (0.001 ng/mL) | 空白 | |||||||
| 100 mL | 100 mL | 100 mL | 100 mL | 100 mL 缓冲液 | ||||||||
| B | 标准品 (1 ng/mL) | 标准品 (0.1 ng/mL) | 标准品 (0.01 ng/mL) | 标准品 (0.001 ng/mL) | 空白 | |||||||
| 100 mL | 100 mL | 100 mL | 100 mL | 100 mL 缓冲液 | ||||||||
| C | 标准品 (1 ng/mL) | 标准品 (0.1 ng/mL) | 标准品 (0.01 ng/mL) | 标准品 (0.001 ng/mL) | 空白 | |||||||
| 100 mL | 100 mL | 100 mL | 100 mL | 100 mL 缓冲液 | ||||||||
| D | 样品 1: | 样品 2: | 样品 3: | 样品 4: | 样品 5: | 样品 6: | 样品 7: | 样品 8: | 样品 9: | 样品 10: | 样品 11: | 样品 12: |
| 1 mL DNA + 99 mL 缓冲液 | 1 mL DNA + 99 mL 缓冲液 | 1 mL DNA + 99 mL 缓冲液 | 1 mL DNA + 99 mL 缓冲液 | 1 mL DNA + 99 mL 缓冲液 | 1 mL DNA + 99 mL 缓冲液 | 1 mL DNA + 99 mL 缓冲液 | 1 mL DNA + 99 mL 缓冲液 | 1 mL DNA + 99 mL 缓冲液 | 1 mL DNA + 99 mL 缓冲液 | 1 mL DNA + 99 mL 缓冲液 | 1 mL DNA + 99 mL 缓冲液 | |
| E | 样品 1: | 样品 2: | 样品 3: | 样品 4: | 样品 5: | 样品 6: | 样品 7: | 样品 8: | 样品 9: | 样品 10: | 样品 11: | 样品 12: |
| 1 mL DNA + 99 mL 缓冲液 | 1 mL DNA + 99 mL 缓冲液 | 1 mL DNA + 99 mL 缓冲液 | 1 mL DNA + 99 mL 缓冲液 | 1 mL DNA + 99 mL 缓冲液 | 1 mL DNA + 99 mL 缓冲液 | 1 mL DNA + 99 mL 缓冲液 | 1 mL DNA + 99 mL 缓冲液 | 1 mL DNA + 99 mL 缓冲液 | 1 mL DNA + 99 mL 缓冲液 | 1 mL DNA + 99 mL 缓冲液 | 1 mL DNA + 99 mL 缓冲液 | |
| F | 样品 1: | 样品 2: | 样品 3: | 样品 4: | 样品 5: | 样品 6: | 样品 7: | 样品 8: | 样品 9: | 样品 10: | 样品 11: | 样品 12: |
| 1 mL DNA + 99 mL 缓冲液 | 1 mL DNA + 99 mL 缓冲液 | 1 mL DNA + 99 mL 缓冲液 | 1 mL DNA + 99 mL 缓冲液 | 1 mL DNA + 99 mL 缓冲液 | 1 mL DNA + 99 mL 缓冲液 | 1 mL DNA + 99 mL 缓冲液 | 1 mL DNA + 99 mL 缓冲液 | 1 mL DNA + 99 mL 缓冲液 | 1 mL DNA + 99 mL 缓冲液 | 1 mL DNA + 99 mL 缓冲液 | 1 mL DNA + 99 mL 缓冲液 | |
| G | ||||||||||||
| H |
表2:用于dsDNA定量的96孔板示例布局。
- 将每种纯化产物(步骤 3.2.5 中获得)用 H2O 稀释至 0.2 ng/µL。
4. 测序文库制备
- 使用NGS DNA文库构建试剂盒(参见材料表)制备扩增并纯化的前病毒DNA用于下一代测序。按照生产商说明进行所有片段化(tagmentation)、PCR扩增和纯化步骤[但反应体系体积(包括步骤3.5中的输入DNA)可减半,以延长文库构建试剂的使用]。
- 使用基于qPCR的NGS文库定量试剂盒(参见材料表)手动均一化文库,以确定各个前病毒的浓度。将各个前病毒文库按等摩尔量混合,最终浓度为4 nM,或根据测序服务提供商的要求进行调整。
注意:此步骤后可暂停实验流程,将混合文库储存于-20 °C。 - 使用步骤3.4中相同的双链DNA定量试剂盒对最终混合文库进行定量,遵循生产商说明。通过自动化电泳系统(使用适当的试剂盒,参见材料表)上样1 µL混合文库,测定平均片段长度。结合浓度与平均片段长度计算混合文库的摩尔浓度。
- 取5 µL混合文库与5 µL 0.2 N NaOH混合以变性文库,随后加入5 µL 200 mM Tris-HCl中和。在测序前立即用预冷的杂交缓冲液(随DNA文库构建试剂盒提供)将最终文库稀释至12.5 pM。
- 在适当的NGS平台上进行2 × 150核苷酸(nt)的双端测序(参见材料表)。
注意:当每次运行中包含96个前病毒文库索引时,每轮测序可获得约2000万条双端读长,经去多重化后每个前病毒文库可获得约20万条读长用于分析。步骤4.4和4.5通常由测序机构完成。
5. 从头合成 组装已测序的HIV-1前病毒
注意:为了获得每个扩增出的前病毒的遗传序列,需进行重叠序列的拼接组装 从头合成 来自成对末端测序读段。许多平台(例如,CLC Genomics Workbench14),可实现自定义工作流程的设计 从头合成 组装。其他开源软件如 FastQC15,Trimmomatic16,Cutadapt17,以及 FLASH18 也可用于处理测序读段,以及诸如Bowtie2之类的工具19 和 SPAdes20 用于读段比对和 从头合成 组装。步骤如下: 从头合成 使用特定商业平台组装HIV-1重叠群(见文末) 材料表如下所述(图2). 定制化工作流程文件可根据要求提供。
- 导入序列并检查质量:将成对的序列读段(fastq.gz 格式)导入软件中,软件会将其合并为一组成对读段。生成序列质量控制报告,并检查数据的质量。
- 质量控制
- 根据质量控制报告进行读段修剪。去除任何接头序列和不确定的核苷酸。修剪 5’端 15 个和 3’端 2 个末端核苷酸。丢弃长度小于 50 个核苷酸的读段。使用严格的质量阈值 0.001,对应于质量值(Phred 分数)30。
- 合并重叠读段
- 通过合并具有重叠区域的成对正向和反向读段,形成单个延伸读段。
- 从头组装
- 使用 CLC Genomics 自带的从头组装工具,设置词长(k-mer)为 30 nt,最大气泡大小为 65 nt,对 10,000 条非重叠成对读段的随机子集进行组装。对于约 9 kb 的序列,预期的从头组装重叠群覆盖度约为 200x。
注:此子抽样可降低计算负担,使大多数标准台式计算机能够完成组装与分析;鉴于每个前病毒具有克隆性(一个文库对应一个前病毒),该方法不会限制多样性。
- 使用 CLC Genomics 自带的从头组装工具,设置词长(k-mer)为 30 nt,最大气泡大小为 65 nt,对 10,000 条非重叠成对读段的随机子集进行组装。对于约 9 kb 的序列,预期的从头组装重叠群覆盖度约为 200x。
- 将所有读段重新比对至重叠群
- 为获得每个前病毒的最终多数一致性序列,将全部读段集合比对至从头组装的重叠群。仅保留平均覆盖度不低于 1,000x 的重叠群,并确保最终重叠群长度与原始琼脂糖凝胶上条带大小一致(步骤 2.8.1)。将最终多数一致性序列保存为 .fasta 文件。
注:大多数重叠群可通过上述步骤完成组装。但在某些情况下,单个前病毒可能产生多个覆盖度相近的重叠群。此时,应将这些重叠群与来自同一名受试者的近全长(约 9 kb)一致性序列进行比对,并 手动拼接为单一重叠群。随后将所有读段比对至该手动拼接的重叠群,若组装区域读段覆盖度均匀且无单核苷酸多态性(SNP)频率> 40%,则接受该最终一致性序列。
- 为获得每个前病毒的最终多数一致性序列,将全部读段集合比对至从头组装的重叠群。仅保留平均覆盖度不低于 1,000x 的重叠群,并确保最终重叠群长度与原始琼脂糖凝胶上条带大小一致(步骤 2.8.1)。将最终多数一致性序列保存为 .fasta 文件。
- 进一步质量控制
- 为确保每个重叠群代表单一前病毒,而非单个孔中多个前病毒扩增所致,需对最终重叠群的读段覆盖度和变异检测结果进行筛查。
- PCR 过程中若存在多个前病毒模板,通常会在比对至同一名受试者的全长一致性序列时表现出极不均匀的读段覆盖度(由于不同大小前病毒共扩增),或出现频率>40% 的 SNP(参见代表性结果,图 4)。在后续分析中应排除混合种群。
- 序列比对
- 将每个前病毒序列的最终一致性序列导入序列查看软件(如分子进化遗传分析软件 MEGA 721),并手动将其与 HXB2 参考序列比对。将 5’和 3’端修剪至 HXB2 的第 666–9650 位,以去除引物序列。
- 以 fasta 格式导出序列列表,然后使用 MAFFT 版本 722 进行比对,并在必要时进行人工编辑,以获得最终比对结果。
注:若某些序列无法比对,首先尝试取其反向互补序列。若仍无法比对,应进行 BLAST 搜索以确认其是否为 HIV-1。有可能扩增出非 HIV-1 模板,此类序列可在本阶段被识别。若序列确属 HIV-1 但无法比对,应考虑是否存在序列倒位(参见步骤 6.1)。
6. 确定HIV-1前病毒序列的潜在复制能力
注意:为了鉴定基因结构完整且可能具有复制能力的HIV-1前病毒序列,需遵循严格的排除流程(图1C)。若前病毒序列未出现倒位、大的内部缺失、有害的终止密码子/超突变、移码突变,以及主要剪接供体位点(MSD位点)或包装信号的缺陷,则被视为基因结构完整且可能具有复制能力。
- 倒位
- 在比对阶段识别倒位。倒位是指序列无法与参考序列HXB2比对的区域,除非对该区域进行反向互补处理。
注:根据数据的应用目的,含有倒位的序列可能需要从后续分析中剔除。
- 在比对阶段识别倒位。倒位是指序列无法与参考序列HXB2比对的区域,除非对该区域进行反向互补处理。
- 大的内部缺失
- 在比对阶段识别具有较大内部缺失(>600 bp)的重叠群。除非缺失位于nef基因内,否则该序列可被定义为有缺陷。
注:任何内部缺失小于<600 bp的序列将由Gene Cutter工具(步骤6.3.1)识别为基因序列不完整。
- 在比对阶段识别具有较大内部缺失(>600 bp)的重叠群。除非缺失位于nef基因内,否则该序列可被定义为有缺陷。
- 有害终止密码子、移码突变和缺失
- 使用洛斯阿拉莫斯国家实验室HIV序列数据库的Gene Cutter工具23,检测所有长度大于>8400个核苷酸的重叠群中是否存在有害终止密码子、移码突变和不完整的基因序列。
注:Gene Cutter工具将前病毒序列划分为gag, pol, vif, vpr, tat, rev, vpu, env和nef等基因,并将其翻译为氨基酸序列。随后,Gene Cutter会筛查是否存在终止密码子和由插入或缺失引起的移码突变。在任意基因中(nef24除外)含有终止密码子或移码突变的重叠群均被归类为有缺陷。Gene Cutter还会识别不完整的基因序列;若除nef外的任何基因中存在小于<600 bp的缺失,则可因存在大的内部缺失而重新归类为有缺陷。
- 使用洛斯阿拉莫斯国家实验室HIV序列数据库的Gene Cutter工具23,检测所有长度大于>8400个核苷酸的重叠群中是否存在有害终止密码子、移码突变和不完整的基因序列。
- 超突变
- 使用洛斯阿拉莫斯国家实验室HIV序列数据库的Consensus Maker工具(简单共识生成器)25,生成剩余全长前病毒序列的共识序列。将该共识序列添加至仅包含剩余全长前病毒序列的比对文件的顶部。利用此比对结果及洛斯阿拉莫斯国家实验室HIV序列数据库的Hypermut工具26,识别剩余全长前病毒序列中由APOBEC诱导的G-A超突变。
- MSD和包装信号中的缺陷
- 逐一检查剩余的重叠群,查找MSD和包装信号(HXB2区域670-810)中的缺陷,这些缺陷会导致前病毒序列功能失常4。重点关注MSD位点(序列GT,HXB2 744-745)的点突变,或包装信号四个茎环结构(SL1(HXB2 691-734)、SL2(HXB2 736-754)、SL3(HXB2 766-779)和SL4(HXB2 790-810))中的任何缺失。
结果
FLIPS 检测可扩增并测序单个接近全长的 HIV-1 前病毒。该方案包含 6 个步骤以获得接近全长的前病毒序列,具体步骤包括:感染细胞的裂解、全长(完整和缺陷型)HIV-1 前病毒的巢式 PCR、DNA 纯化与定量、测序文库制备、高通量测序(NGS)以及测序前病毒的从头(de novo)组装。每个步骤的结束均可视为一个检查点,在进入下一步之前可对产物质量(例如 扩增的 DNA、纯化的 DNA、测序文库或序列)进行评估。下文概述了在每个步骤结束后所进行的评估内容及预期结果。
巢式PCR扩增后,将扩增产物在1%琼脂糖凝胶上进行电泳(图3)。通过观察阴性对照和阳性对照可以初步判断PCR扩增的质量。若阴性对照孔中出现扩增产物,表明存在污染;若阳性对照孔中无扩增产物,则表明扩增不充分。接下来,选择含有扩增产物的孔用于测序。为避免选择含有多种不同前病毒扩增产物混合物的孔,仅考虑在终点稀释条件下获得扩增产物的孔进行测序。根据泊松分布,当30%的孔呈现扩增产物阳性时,即达到终点稀释。在此稀释度下,这些孔中含有单一扩增前病毒的概率为80%。此外,在此阶段还可通过凝胶上出现多条条带而识别出含有不同长度的多种前病毒扩增产物的孔。此类孔不应被选用于测序(图3)。
在对选定测序的扩增前病毒进行纯化后,定量可确保纯化过程中无前病毒DNA丢失。若扩增前病毒的DNA浓度为 <0.2 ng/µLPCR2板中剩余的样本可进行纯化。文库构建完成后也会进行类似的质控检查,即对每个单独的文库进行定量,以确保在测序前每个前病毒已得到适当的片段化、加标签和扩增。各个前病毒文库按等摩尔量混合,最终文库浓度为4 nM(或根据测序服务提供方的具体要求)。若某个前病毒文库浓度过低,可将其从测序文库混合物中剔除,或重新制备该文库。在测序前需对混合后的文库进行最终浓度检测,并确认其平均片段长度。
实验前的质量控制步骤 从头合成 组装阶段可确保用于组装最终前病毒重叠群的测序读段质量。这些步骤包括:去除接头序列、切除5'和3'端核苷酸、设定严格的质控阈值,以及剔除过短的读段。CLC Genomics Workbench 可提供质量控制报告,可用于在修剪前评估读段的初始质量并指导修剪参数设置,以及在修剪后判断是否已充分去除低质量区域。此外,对于 从头合成 组装后,可通过足够的测序深度来评估组装所得重叠群的质量(>1000X)以及覆盖均匀性(图 4A)。在此阶段也可识别混合群体。通过存在多个频率超过40%的单核苷酸多态性(SNP),可鉴定出多种全长(约9 kb)前病毒的混合物;而短型(含有大片段内部缺失)与全长前病毒的混合物,则可通过将测序读段比对至同一受试者的全长参考序列后所呈现的不均匀读段覆盖度来识别。图4B).
根据具体应用,可使用诸如 ggtree 等工具对最终比对结果进行可视化,ggtree 是“R:用于统计计算的语言和环境”中的一个软件包27。在最近的一项研究中,FLIPS 被用于对长期接受抗逆转录病毒治疗(ART)个体中分离出的初始型、中央记忆型、过渡记忆型和效应记忆型 CD4+ T 细胞中的 HIV-1 前病毒进行测序,旨在确定某些特定细胞亚群是否含有更高比例的基因组完整且可能具有复制能力的 HIV-12。此处展示了该研究中一名参与者(参与者 2026)所获得序列的可视化图示(图 5)。在该参与者中,绝大多数序列(97%)存在缺陷,仅在效应记忆型和过渡记忆型 CD4+ T 细胞中检测到完整的序列。该可视化工具可用于展示具有大片段内部缺失的序列数量及其在基因组中的位置。此外,还可进一步标注含有有害终止密码子、移码突变以及 MSD 位点和/或包装信号区域缺失/突变的序列。
FLIPS 检测的一个应用是鉴定基因组完整且可能具有复制能力的 HIV-1 前病毒。在一项近期研究中,从6名接受长期抗逆转录病毒治疗(ART)的参与者CD4+ T 细胞中分离出的531条序列中,鉴定出26条(5%)基因组完整的 HIV-1 前病毒2。其余有缺陷的前病毒包括含有倒位序列的前病毒(6%)、大片段内部缺失的前病毒(68%)、有害终止密码子/超突变的前病毒(9%)、移码突变的前病毒(1%),以及包装信号缺陷和/或 MSD 位点突变的前病毒(11%)。
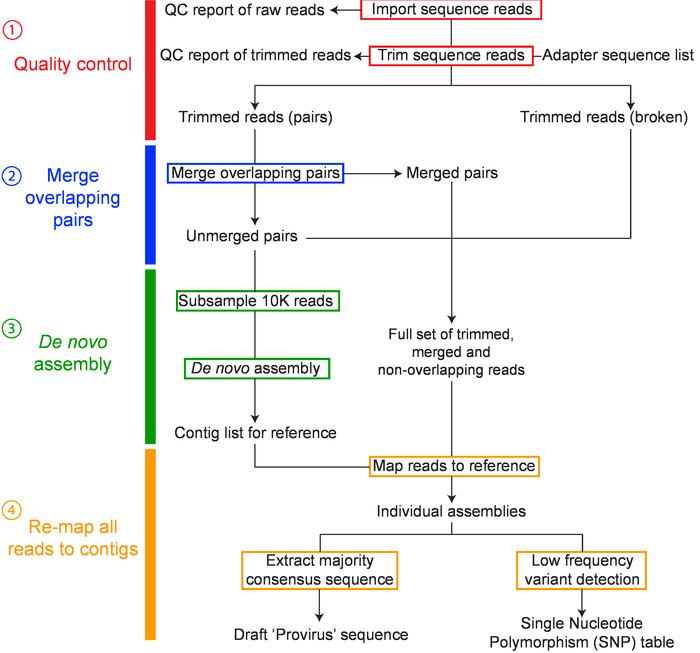
图2:工作流程概览 从头合成 HIV-1 前病毒的组装 工作流程中的主要步骤包括:1)序列读长的质量控制,2)合并重叠的配对,3) 从头合成 组装,以及 4) 重定位与共识构建分别用红色、蓝色、绿色和橙色表示。该图已根据 Hiener 修改 等2. 请点击此处以查看此图的放大版本。
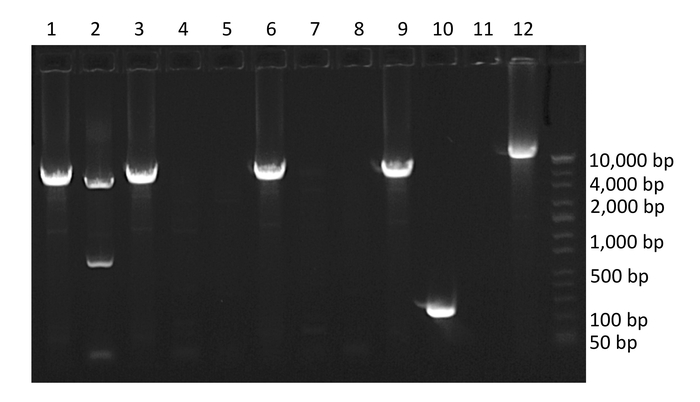
图3:PCR扩增HIV-1前病毒的琼脂糖凝胶示例。 第1、2、3、6、9和10孔含有扩增的HIV-1前病毒。第10孔含有一个具有大片段内部缺失的前病毒,第2孔含有两种不同长度的HIV-1前病毒共扩增产物(混合物),第12孔为阳性对照。注意,含有扩增产物的孔比例为60%,高于分离单模板所需的最低比例。请点击此处查看该图的放大版本。
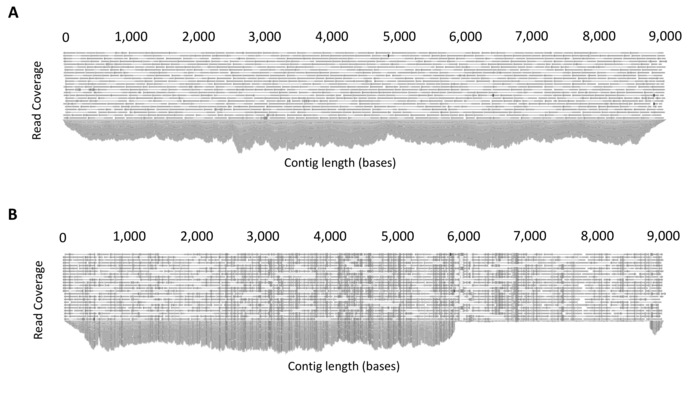
图4:读长比对结果示例。(A)示例显示由于单个全长HIV-1前病毒的扩增而产生的均匀覆盖度。在进行从头组装(de novo assembly)后,所有读长均比对至组装出的重叠群(contig),以生成一致序列。软件平台允许检查比对后的读长是否具有足够且均匀的覆盖度。(B)示例显示两个不同长度的HIV-1前病毒共扩增(混合物)。为确定是否存在混合物,将读长比对至来自同一样本的全长(约9 kb)参考序列,并检查读长比对情况。覆盖度不均表明存在混合物。本图经Qiagen许可复制14。请点击此处查看此图的放大版本。
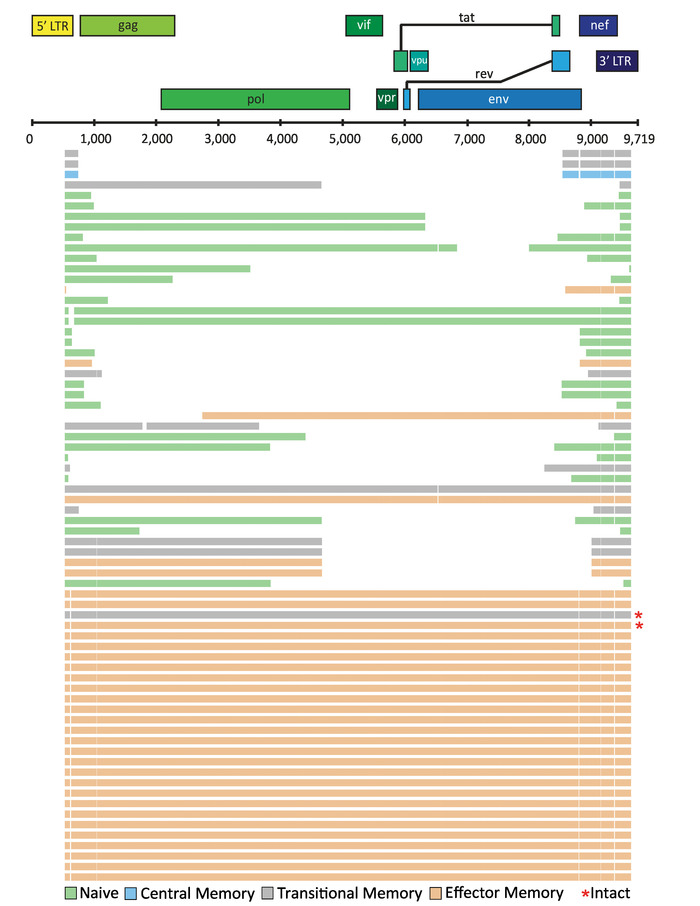
图5:来自长期接受抗逆转录病毒治疗(ART)个体的CD4+ T细胞亚群中分离出的HIV-1前病毒序列的可视化示例。单个HIV-1前病毒序列以水平线表示。本图经Hiener et al.2. 修改。 请点击此处查看此图的放大版本。
讨论
FLIPS 检测是一种高效且高通量的方法,用于扩增和测序单个接近全长的 HIV-1 前病毒。已确定该实验方案中多个影响所获得序列数量和质量的因素及关键步骤。首先,细胞数量以及细胞群体中 HIV-1 的感染频率会影响扩增出的前病毒数量。例如,在之前的一项研究中,从相同数量的初始型 CD4+ T 细胞中获得的序列数量大约仅为效应记忆型 CD4+ T 细胞的一半。这是因为初始型细胞的感染频率通常低于效应记忆型细胞2。其次,与基于柱子的提取方法相比,细胞裂解法更适用于基因组 DNA 的提取,因为该方法在提取过程中不存在 DNA 丢失的风险。最后,与所有基于 PCR 的检测一样,防止污染至关重要。应划分独立的洁净区域,分别用于配制预混液、处理基因组 DNA、添加阳性对照、DNA 纯化与定量以及文库制备。这对于本研究中所述的单拷贝检测尤为重要。
实施FLIPS检测时,应首先使用阳性对照(如pNL4-3质粒),而非受试者样本。这可在使用HIV-1阳性细胞前进行必要的故障排查,因为所获得的序列可与这些质粒的已知参考序列进行比对。当使用HIV-1阳性细胞时,若扩增出的前病毒极少或未扩增出,需考虑HIV-1亚型(FLIPS所设计的引物特异性针对B亚型)以及细胞群体的感染频率。可根据需要对引物序列进行修改或重新设计,以适配其他亚型。此外,每次进行PCR时,均应设置包含阳性对照的反应孔。
FLIPS 克服了先前测序检测方法(包括 SPS)的局限性。通过扩增并测序接近全长的 HIV-1 前病毒,FLIPS 能够确定 HIV-1 前病毒潜在的复制能力。而 SPS 仅能测序基因组的部分区域,因此倾向于选择具有完整引物结合位点的序列,无法实现这一目标。此外,与以往全长测序方法所采用的多种扩增和测序引物策略相比,FLIPS 克服了由此带来的局限性1,4。FLIPS 通过针对 HIV-1 LTR 区域进行两轮 PCR 扩增,并结合高通量测序(NGS),减少了所需引物的数量和复杂性。因此,FLIPS 对引物错配所导致的问题具有更强的抗性,例如错误地将缺陷型前病毒识别为完整型,或无法扩增群体中的某些前病毒。此外,FLIPS 实验方案效率更高,相较于以往方法可实现更高的测序通量。
显然,FLIPS 相较于现有的确定 HIV-1 前病毒遗传组成的方法具有优势。然而,必须认识到 FLIPS 的局限性。首先,FLIPS 检测尚未被开发用于测量潜伏性 HIV-1 储存库的大小,因为尚未完成用于确定 FLIPS 是否能够扩增细胞群体中所有存在的 HIV-1 前病毒的分析。FLIPS 更适用于在不同细胞群体之间对储存库组成的相对比较2。其次,在缺乏诸如 Ho et al.4 所进行的 in vivo 分析的情况下,无法确切判断完整 HIV-1 前病毒的复制能力。第三,FLIPS 并未设计用于确定 HIV-1 前病毒的整合位点。
对FLIPS方案进行微小调整可扩大其应用范围。例如,改变引物序列可实现对不同及多种HIV-1亚型的扩增与测序。通过在巢式PCR之前增加cDNA合成步骤,可对血浆中的HIV-1病毒颗粒进行测序。未来采用单分子测序技术将无需进行从头组装(de novo assembly)。
整合的HIV-1前病毒的基因测序加深了我们对潜伏HIV-1储存库的理解。FLIPS是未来阐明潜伏储存库组成与分布研究中的重要工具。然而,FLIPS的应用不仅限于储存库研究。未来的研究可利用FLIPS确定CRISPR-Cas技术的特定靶点,或协助识别使病毒对潜伏逆转剂更敏感的编码区与非编码区。通过分析大段内部缺失的连接位点,可更深入地理解病毒重组机制。
披露
作者无任何利益冲突需要披露。
致谢
本研究得到了寻找艾滋病治愈方法的戴兰尼艾滋病研究企业(Delaney AIDS Research Enterprise, DARE)(项目编号:1U19AI096109 和 1UM1AI126611-01);美国艾滋病研究基金会(amfAR)艾滋病根除研究联盟(ARCHE)协作研究资助(amfAR 108074-50-RGRL);澳大利亚艾滋病和肝炎病毒学研究中心(ACH2);加州大学旧金山分校-全球传染病与疫苗研究所(UCSF-GIVI)艾滋病研究中心(P30 AI027763);以及澳大利亚国家卫生与医学研究理事会(AAP1061681)的支持。我们衷心感谢西米德医学研究所基因组学设施经理Joey Lai博士在文库构建方面的培训及其设施的使用支持,并感谢新南威尔士大学拉马乔蒂基因组学中心(澳大利亚悉尼)完成测序工作。我们怀着感激之情感谢为本研究捐赠样本的各位参与者。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| UltraPure 1 M Tris-HCl,pH 8.0 | Invitrogen | 15568025 | 稀释至 5 mM 用于巢式 PCR |
| Nonidet P-40 替代溶液 | Sigma | 98379 | |
| Tween-20 | Sigma | P9416 | |
| 蛋白酶 K 溶液(20 mg/mL) | Promega | AM2548 | |
| 96 孔 PCR 仪 | 任何 96 孔 PCR 仪均可使用 | ||
| Platinum Taq DNA 聚合酶高保真酶 | Invitrogen | 11304011 | |
| 10x 高保真缓冲液 [600 mM Tris-SO4 (pH 8.9), 180 mM (NH4)2SO4] | Invitrogen | 11304011 | |
| 50 mM MgSO4 | Invitrogen | 11304011 | |
| PCR 核苷酸混合液,10 mM | Promega | C1141 | |
| 超纯 H2O | Invitrogen | 10977023 | |
| PCR1 和 PCR2 引物 | 脱盐处理。用 H2O 稀释至 100 µM | ||
| 96 孔半裙边透明 PCR 板,单缺口角 | Axygen | PCR-96M2-HS-C | |
| Microseal 'B' 粘性封膜 | BioRad | MSB1001 | 用于密封 96 孔 PCR 板 |
| HIV-1 NL4-3 感染性分子克隆(pNL4-3) | 以下试剂由美国国家卫生研究院艾滋病试剂计划、艾滋病司、NIAID、NIH 提供:HIV-1 NL4-3 感染性分子克隆(pNL4-3),来自 Malcolm Martin 博士(货号 114)。 | 稀释至 105 拷贝/mL,作为阳性对照使用 | |
| PCR 板旋转器或台式离心机 | |||
| E-GEL 48 1% 琼脂糖凝胶 | Invitrogen | G800801 | 预制 1% 琼脂糖凝胶(每 96 孔板使用两块)。可用任何 1% 琼脂糖凝胶替代。含溴化乙锭。 |
| DirectLoad 宽范围 DNA Marker | Sigma | D7058 | 可用范围达 10 kb 的任意 DNA ladder 替代 |
| Mother E-Base 装置 | Invitrogen | EBM03 | 用于运行预制 48 孔 1% 琼脂糖凝胶 |
| Gel Doc EZ 凝胶成像系统 | BioRad | 1708270 | 任何可用于含溴化乙锭琼脂糖凝胶的成像系统均可使用 |
| PlateMax 可剥离热封膜 | Axygen | HS-200 | 用于长期储存的热封膜 |
| 96 孔 0.8 mL 储存板 | ThermoFisher Scientific | AB0765 | 磁珠法 PCR 纯化所需的 0.8 mL 96 孔板 |
| Agencourt AMPure XP(PCR 纯化试剂盒) | Beckman Coulter | A63880 | 基于磁珠的 PCR 纯化试剂盒。此处可使用其他 PCR 纯化试剂盒替代(例如 QIAquick PCR 纯化试剂盒(Qiagen 货号 28106)) |
| 乙醇,纯级,200 proof,分子生物学用 | Sigma | E7023 | |
| 96 孔磁力架 | Invitrogen | AM10027 | |
| 微孔板振荡器 | 可选 | ||
| Buffer EB | Qiagen | 19086 | 洗脱缓冲液 |
| Quant-iT PicoGreen dsDNA 检测试剂盒 | Invitrogen | P11496 | 一种基于荧光的双链 DNA 浓度检测染料 |
| 微孔板读数仪 | |||
| Nextera XT DNA 文库制备试剂盒 | Illumina | FC-131-1096 | |
| Nextera XT Index 试剂盒 | Illumina | FC-131-2001 | |
| Hard-Shell 96 孔 PCR 板 | Biorad | HSP9601 | Nextera XT DNA 文库制备试剂盒必需 |
| 文库定量试剂盒 - Illumina/通用型 | Kapa Biosystems | KK4824 | 可使用其他文库定量试剂盒替代(例如 JetSeq DNA 文库定量 Lo-Rox 试剂盒(Bioline 货号 BIO-68029)) |
| 2100 Bioanalyzer | Agilent Technology | 自动化电泳系统。需与高灵敏度 DNA 试剂盒联用 | |
| 高灵敏度 DNA 试剂盒 | Agilent Technology | 5067-4626 | |
| Illumina MiSeq 测序平台 | Illumina |
参考文献
- Bruner, K. M., et al. Defective proviruses rapidly accumulate during acute HIV-1 infection. Nature Medicine. 22 (9), 1043-1049 (2016).
- Hiener, B., et al. Identification of Genetically Intact HIV-1 Proviruses in Specific CD4(+) T Cells from Effectively Treated Participants. Cell Reports. 21 (3), 813-822 (2017).
- Abram, M. E., Ferris, A. L., Shao, W., Alvord, W. G., Hughes, S. H. Nature, position, and frequency of mutations made in a single cycle of HIV-1 replication. Journal of Virology. 84 (19), 9864-9878 (2010).
- Ho, Y. C., et al. Replication-competent noninduced proviruses in the latent reservoir increase barrier to HIV-1 cure. Cell. 155 (3), 540-551 (2013).
- Harris, R. S., et al. DNA deamination mediates innate immunity to retroviral infection. Cell. 113 (6), 803-809 (2003).
- Lecossier, D., Bouchonnet, F., Clavel, F., Hance, A. J. Hypermutation of HIV-1 DNA in the absence of the Vif protein. Science. 300 (5622), 1112(2003).
- Chun, T. W., et al. Rebound of plasma viremia following cessation of antiretroviral therapy despite profoundly low levels of HIV reservoir: implications for eradication. AIDS. 24 (18), 2803-2808 (2010).
- Chomont, N., et al. HIV reservoir size and persistence are driven by T cell survival and homeostatic proliferation. Nature Medicine. 15 (8), 893-900 (2009).
- Soriano-Sarabia, N., et al. Quantitation of replication-competent HIV-1 in populations of resting CD4+ T cells. Journal of Virology. 88 (24), 14070-14077 (2014).
- Josefsson, L., et al. The HIV-1 reservoir in eight patients on long-term suppressive antiretroviral therapy is stable with few genetic changes over time. Proceedings of the National Academy of Sciences USA. 110 (51), E4987-E4996 (2013).
- Evering, T. H., et al. Absence of HIV-1 evolution in the gut-associated lymphoid tissue from patients on combination antiviral therapy initiated during primary infection. Public Library of Science Pathogens. 8 (2), e1002506(2012).
- von Stockenstrom, S., et al. Longitudinal Genetic Characterization Reveals That Cell Proliferation Maintains a Persistent HIV Type 1 DNA Pool During Effective HIV Therapy. Journal of Infectious Diseases. 212 (4), 596-607 (2015).
- Palmer, S., et al. Multiple, linked human immunodeficiency virus type 1 drug resistance mutations in treatment-experienced patients are missed by standard genotype analysis. Journal of Clinical Microbiology. 43 (1), 406-413 (2005).
- Qiagen. CLC Genomics Version 10. , Available from: https://www.qiagenbioinformatics.com/products/clc-genomics-workbench (2018).
- Andrews, S. FastQC: a quality control tool for high throughput sequence data. , Available from: https://www.bioinformatics.babraham.ac.uk/projects/fastqc/ (2010).
- Bolger, A. M., Lohse, M., Usadel, B. Trimmomatic: a flexible trimmer for Illumina sequence data. Bioinformatics. 30 (15), 2114-2120 (2014).
- Martin, M. Cutadapt removes adapter sequences from high-throughput sequencing reads. EMBnet.journal. 17 (1), (2011).
- Magoc, T., Salzberg, S. L. FLASH: fast length adjustment of short reads to improve genome assemblies. Bioinformatics. 27 (21), 2957-2963 (2011).
- Langmead, B., Salzberg, S. L. Fast gapped-read alignment with Bowtie 2. Nature Methods. 9 (4), 357-359 (2012).
- Bankevich, A., et al. SPAdes: a new genome assembly algorithm and its applications to single-cell sequencing. Journal of Computational Biology. 19 (5), 455-477 (2012).
- Kumar, S., Stecher, G., Tamura, K. MEGA7: Molecular Evolutionary Genetics Analysis Version 7.0 for Bigger Datasets. Molecular Biology and Evolution. 33 (7), 1870-1874 (2016).
- Katoh, K., Standley, D. M. MAFFT multiple sequence alignment software version 7: improvements in performance and usability. Molecular Biology and Evolution. 30 (4), 772-780 (2013).
- Laboratory, L. A. N. HIV Sequence Database - Gene Cutter tool. , Available from: https://www.hiv.lanl.gov/content/sequence/GENE_CUTTER/cutter.html (2018).
- Foster, J. L., Garcia, J. V. Role of Nef in HIV-1 replication and pathogenesis. Advances in Pharmacology. 55, 389-409 (2007).
- Laboratory, L. A. N. HIV Sequence Database - Consensus Maker tool. , Available from: https://www.hiv.lanl.gov/content/sequence/CONSENSUS/consensus.html (2018).
- Laboratory, L. A. N. HIV Sequence Database - Hypermut tool. , Available from: https://www.hiv.lanl.gov/content/sequence/HYPERMUT/hypermut.html (2018).
- Yu, G., Smith, D. K., Zhu, H., Guan, Y., Lam, T. T. Y. ggtree: an r package for visualization and annotation of phylogenetic trees with their covariates and other associated data. Methods in Ecology and Evolution. , (2016).
重印与许可
