本实验方案的目的是结合计算研究与实验研究,寻找那些难以从共纯化序列中分离出来的新型序列,这些共纯化序列可能仅有部分被知晓。
本文内容
摘要
摘要
在旨在鉴定嵌入于较大基因组背景中的基因、蛋白质或一般区域序列的任何研究中,均可使用减法基因组学。减法基因组学使研究人员能够通过全面测序并去除已知遗传元件(参考序列,R),从而分离出目标序列(T)。该方法可用于鉴定线粒体、叶绿体、病毒或生殖系限制性染色体等新序列,尤其适用于T难以从R中轻易分离的情况。该方法从完整的基因组数据(R + T)出发,利用基本局部比对搜索工具(BLAST)比对参考序列或多个参考序列,以去除匹配的已知序列(R),从而留下目标序列(T)。为了使减法效果最佳,R应为相对完整的草图,且不包含T。由于减法后剩余的序列将通过定量聚合酶链式反应(qPCR)进行验证,因此R无需完全完整,该方法仍可有效运行。本文将计算步骤与实验步骤结合为一个可重复迭代的循环过程,依次去除多个参考序列,并逐步优化对T的搜索。减法基因组学的优势在于,即使在物理纯化困难、不可能或成本高昂的情况下,也能鉴定出完全新颖的目标序列。该方法的局限性在于难以找到合适的参考序列,以及获取用于qPCR检测的T阳性与阴性样本。我们在此描述了该方法在鉴定斑胸草雀生殖系限制性染色体上首个基因中的具体应用。在该案例中,计算过滤涉及三个参考序列(R),在三个循环中依次去除:一个不完整的基因组组装、原始基因组数据以及转录组数据。
引言
该方法的目的是从基因组背景或参考序列(R)中鉴定出新的目标(T)基因组序列,该序列可以是DNA或RNA(图1)。当目标序列无法通过物理手段分离,或分离成本较高时,该方法尤为适用。目前仅有少数生物具有可用于消减分析的完整基因组,因此本方法的关键创新之处在于将计算分析与实验操作相结合,形成一个循环流程,使研究人员能够在参考基因组不完整或仅为非模式生物的草图基因组时,仍能分离出目标序列。每个循环结束后,通过qPCR检测判断是否需要进一步进行消减。经验证的候选T序列应在已知T阳性样本中表现出显著更高的qPCR检出信号。
该方法已被应用于发现不存在宿主同源物的新型细菌药物靶点1,2,3,4,以及从受感染宿主中鉴定新型病毒5,6。除了可用于鉴定目标序列T外,该方法还可提升参考基因组R的完整性:我们近期利用该方法从斑胸草雀参考基因组中鉴定出936个缺失基因,并发现了一个位于生殖系特异性染色体(T)上的新基因7。当目标序列T与已知序列高度分歧,或其身份尚不明确时(例如斑胸草雀的生殖系限制性染色体),减法基因组学尤其具有价值7。
减法基因组学的一个关键优势在于其无偏性,即无需事先对T进行阳性鉴定。在最近的一项研究中,Readhead et al. 探讨了阿尔茨海默病与四种脑区中病毒丰度之间的关系。在病毒鉴定过程中,Readhead et al. 构建了一个包含515种病毒的数据库8,这严重限制了该研究可识别的病毒种类。若采用减法基因组学方法,则可比较健康个体与阿尔茨海默病患者的基因组,从而分离出可能与该疾病相关的新病毒,而无需考虑这些病毒与已知病原体的相似性。目前已知有263种可感染人类的病毒,但据估计,尚有约167万种未被发现的病毒物种存在,其中约63.1万至82.7万种具有感染人类的潜力9。
分离新病毒是减法基因组学特别有效的研究领域,但某些研究可能无需如此严格的方法。例如,已有研究通过非偏向性高通量测序结合逆转录和BLASTx分析来鉴定新病毒序列。5 或富集病毒核酸以提取并反转录病毒序列6. 尽管这些研究采用了 从头合成 测序与组装过程中未使用减法法,因为目标序列已通过BLAST得到明确鉴定。若病毒为完全新型且与其他病毒无关联或仅有远缘关系,则减法基因组学将是一种有用的技术。减法基因组学的优势在于能够获得全新的序列。若宿主生物的基因组已知,可将其序列扣除,从而保留所有病毒序列。例如,在我们已发表的研究中,尽管并非最初目的,但仍通过减法基因组学从斑胸草雀中分离出一条 novel 病毒序列7.
减法基因组学在细菌疫苗靶点的鉴定中也显示出重要价值,这主要是由于抗生素耐药性的急剧上升1,2,3,4。为了最大限度地降低自身免疫反应的风险,研究人员通过剔除在人类宿主中具有同源蛋白的任何蛋白,进一步缩小潜在疫苗靶点的范围。一项针对Corynebacterium pseudotuberculosis的研究中,通过将多种细菌基因组与脊椎动物宿主基因组进行比对并剔除共有序列,以确保可能的药物靶点不会影响宿主中的蛋白,从而避免不良反应1。这类研究的基本工作流程包括:下载细菌的蛋白质组,确定关键蛋白,去除冗余蛋白,利用BLASTp筛选出必需蛋白,并通过与宿主蛋白质组进行BLASTp比对,剔除任何具有宿主同源性的蛋白1,2,3,4。在此背景下,减法基因组学可确保所开发的疫苗在宿主体内不会产生脱靶效应1,2,3,4。
我们利用减法基因组学鉴定了生殖系限制性染色体(GRC)(本例中为T染色体)上的首个蛋白质编码基因,该染色体存在于两性的生殖系中,但不存在于体细胞组织中10。在此项研究之前,关于GRC唯一已知的基因组信息是一个重复区域11。我们对成年斑胸草雀的卵巢和睾丸组织(R+T)进行RNA测序,并进行了从头转录组组装(de novo assembly)。通过比对已发表的体细胞(肌肉)基因组序列(R1)12、其原始(Sanger)测序读段数据(R2)以及体细胞(脑组织)转录组数据(R3)13,在计算层面逐步剔除共有序列。三个参考数据集的依次使用是基于每个循环第5步qPCR检测结果(图2A)的提示,表明需要进一步过滤。所发现的α-SNAP基因通过DNA和RNA的qPCR、克隆及测序得到了验证。本示例表明,该方法具有良好的灵活性:不依赖于核酸类型(DNA与RNA)的匹配,且减法过程可使用由基因组组装结果或原始测序读段构成的参考数据集(R)。
方案
1. 从头 组装起始序列
注意:任何下一代测序(NGS)数据均可使用,只要能够基于这些数据生成组装结果即可。合适的输入数据包括已组装成 fasta 文件的 Illumina、PacBio 或 Oxford Nanopore 测序读段。为具体说明,本节描述的是我们针对斑胸草雀研究所完成的基于 Illumina 的转录组组装7;但需注意,不同项目的具体细节会有所差异。在本示例项目中,原始数据来自 MiSeq 平台,每个样本大约获得 1000 万条成对读段。
- 使用 Trimmomatic 0.3214 去除Illumina接头序列和低质量碱基。在命令行中输入:
java -jar trimmomatic-0.32.jar PE -phred33 正向.fq.gz 反向.fq.gz -baseout 质量与接头修剪 ILLUMINACLIP:TruSeq3-PE.fa:2:30:10 LEADING:3 TRAILING:3 SLIDINGWINDOW:4:20 MINLEN:40 - 使用 PEAR15 v. 0.9.6,使用默认参数对 trimmomatic 输出的成对读段进行高质量合并。在命令行中输入:
梨 -f <quality_and_adaptor_trimmed_1P.fastq> - r <quality_and_adaptor_trimmed_2P.fastq> - 使用 Reptile v. 1.116 对通过 PEAR 产生的测序读段进行纠错。遵循文中所述的逐步操作方案17.
- 使用 Trinity v. 2.4.018 默认模式下组装校正后的序列。对于链特异性文库,使用 -SS_lib_type 参数。输出为一个 fasta 文件(your_assembly.fasta)。在命令行中输入:
Trinity --seqType fq --SS_lib_type FR –max_memory 10G –output Trinity_output --left quality_and_adaptor_trimmed_forward_paired_reads.fq –right quality_and_adaptor_trimmed_reverse_paired_reads.fq –CPU 10
注意:输出结果将保存在一个名为 Trinity_output 的新目录中,组装结果将被命名为“Trinity.fasta”,可根据需要重命名为 Your_assembly.fasta。更多详细信息请参见 Trinity 官方网站:https://github.com/trinityrnaseq/trinityrnaseq/wiki/Running-Trinity。
2. 将组装序列与参考序列进行BLAST比对
注意:当参考序列是组装序列或长读长序列(如 Sanger 测序结果)时,使用此步骤;如果参考序列由原始 Illumina 测序读段组成,请参见下方步骤 3,以将读段比对至查询序列。所有 BLAST 步骤均使用版本 2.2.29+ 完成,但这些命令应在任何较新的 BLAST 版本上均可正常运行。
- 在命令行中为参考序列(nucleotide_reference.fasta)创建BLAST数据库。在命令行中输入以下命令:
makeblastdb -dbtype nucl -in nucleotide_reference.fasta -out nucleotide_reference.db - 将查询组装序列(在步骤1中生成)与参考数据库进行BLAST比对。若要生成输出文件,请使用 [-out BLAST_results.txt];若要生成表格格式输出(后续使用Python脚本处理所必需),请使用 [-outfmt 6]。这些选项可按任意顺序组合,例如完整的命令为 [blastn -query your_assembly.fasta -db nucleotide_reference.db -out BLAST_results.txt -outfmt 6]。如果需要设置e值,请使用 -evalue 选项并指定合适的数值,例如 [-evalue 1e-6]。但请注意,如讨论部分所述,减法循环实际上会反转e值的筛选效果。
- 为提高严谨性,建议使用组装序列中的蛋白质序列作为BLAST查询序列,并采用翻译核苷酸BLAST(tBLASTn),该方法会对(核苷酸)数据库进行六框翻译。此方法推荐用于大多数非模式生物系统,可避免蛋白质注释不完整的问题。
- 使用 -db_gencode 选项确保为所研究的生物选择正确的遗传密码。为获得查询用的蛋白质序列,运行TransDecoder包(v. 3.0.1)中的TransDecoder.LongOrfs命令,以识别组装查询序列中最长的开放阅读框。命令为 [TransDecoder.LongOrfs -t your_assembly.fasta];输出将保存在名为 'transcripts.transdecoder_dir' 的目录中,其中包含一个名为 longest_orfs.pep 的文件,该文件含有来自 your_assembly.fasta 每条序列的最长预测蛋白质序列。
- 使用tBLASTn时,运行命令 [tblastn -query longest_orfs.pep -db nucleotide_reference.db -out BLAST_results.txt -outfmt 6]。如果有高质量的蛋白质参考序列,建议使用BLASTp进行蛋白质-蛋白质比对,而非tBLASTn。
- 为蛋白质参考序列创建BLAST数据库 [makeblastdb -dbtype prot -in protein_reference.fasta -out protein_reference.db],然后执行 [blastp -query longest_orfs.pep -db protein_reference.db -out BLAST_results.txt -outfmt 6]。请务必保存结果文件以供下游分析使用,并采用表格格式(outfmt 6),确保Python脚本能够正确解析。
3. 将测序读段比对到基因组组装结果
注意:如果参考数据集由原始基因组测序读段组成,而非组装后的序列或桑格测序序列,则可使用本方法;在此情况下,请使用 BLAST(步骤 2.1)。
- 使用 BWA-MEM v. 0.7.1219 或 bowtie220,将下载的原始测序读段(raw_reads.fastq)比对到查询组装序列上。输出结果为 .sam 格式。操作命令如下:首先对组装序列建立索引:[bwa index your_assembly.fasta],然后比对测序读段 [bwa mem your_assembly.fasta raw_reads.fastq >mapped.sam]。(注意:此处的 '>' 符号并非大于号,而是指示将输出结果写入 mapped.sam 文件中)。
4. 使用 Python 脚本去除任何匹配序列
注意:提供的脚本适用于 Python 2.7。
- 完成步骤2后,使用命令 [./Non-matching_sequences.py your_assembly.fasta BLAST_results.txt] 运行减法Python脚本。在运行脚本前,请确保BLAST输出文件为格式6(表格形式)。该脚本将输出一个包含不匹配序列的fasta格式文件,命名为your_assembly.fasta_non-matching_sequences_BLAST_results.txt.fasta,同时还会生成一个包含匹配序列的文件以供记录,命名为your_assembly.fasta_matching_sequences_BLAST_results.txt.fasta。其中,不匹配序列文件最为重要,可作为潜在T序列的来源,用于后续测试及进一步的减法基因组学循环。
- 完成步骤3后,运行Python脚本removeUnmapped.py,输入为步骤3.1生成的.sam文件,该脚本将识别出没有任何匹配读段的查询序列名称,并将其保存至一个新的文本文件中。使用命令 [./removeUnmapped.py mapped.sam],输出文件名为mapped.sam_contigs_with_no_reads.txt。(该程序还将生成一个已移除所有未比对读段的简化版sam文件;本实验方案中可忽略此文件,但其可能对其他分析有用。)
- 由于上一步的输出是一个名为mapped.sam_contigs_with_no_reads.txt的文本文件,其中包含序列名称列表,因此需提取出这些序列以生成一个fasta文件:使用命令 [./getContig.py your_assembly.fasta mapped.sam_contigs_with_no_reads.txt]。输出文件将命名为mapped.sam_contigs_with_no_reads.txt.fasta。
5. 为剩余序列设计引物
注意:此时已获得一个包含候选 T 序列的 fasta 文件。本部分描述通过 qPCR 实验验证这些序列是来源于 T,还是来源于此前未知的 R 区域。如果在步骤 4 的扣除过程中移除了所有序列,则可能是因为初始组装未能包含 T,或者扣除条件可能过于严格。
- 使用 Geneious21 手动确定最佳引物序列。
- 选择一段 21-28 bp 的候选序列作为正向引物。避免出现 4 个或更多相同碱基的连续序列。尽量选择碱基组成相对均匀的区域。在 3' 端包含单个 G 或 C 有助于引物的锚定。
- 在屏幕右侧点击 Statistics 选项卡,当候选区域被选中时,查看该序列的估计熔解温度(Tm)。目标熔解温度应为 55-60 °C,同时避免重复序列和过长的 G/C 连续序列。
- 按照步骤 5.1.1 和 5.1.2 选择反向引物,其位置应位于正向引物 3' 端下游 150-250 个碱基对处。虽然引物长度无需完全一致,但预测的 Tm 应尽可能接近正向引物的 Tm。务必对序列进行反向互补(在 Geneious 中选中序列后右键点击即可找到该选项)。
- 使用序列窗口顶部工具栏中的 Primer Design 功能。
- 点击 Primer Design 按钮,在 Target Region 下输入待扩增的区域。
- 在 Characteristics 选项卡下,输入所需的产物大小、熔解温度(Tm)和 %GC 含量(参见步骤 5.1.1)。
- 点击 OK 生成引物,并通过定制寡核苷酸服务订购引物。
- 使用对照 DNA(编码 T 和 R)验证引物,以优化 Tm 和延伸时间。可使用普通 Taq 酶结合凝胶电泳检测条带大小,也可按照步骤 6 的方法通过 qPCR 进行优化。
- 将正向和反向引物分别进行 10 倍稀释,使引物终浓度为 10 μM。
- PCR 反应体系为:0.5 μL dNTP、0.5 μL 正向引物、0.5 μL 反向引物、0.1 μL Taq 聚合酶、2 μL 模板、0.75 μL 镁离子、2.5 μL 缓冲液和 18.15 μL 水,每份反应总体积为 25 μL,模板浓度为 5 ng/μL。
- 在 PCR 程序中测试不同熔解温度下的引物表现。通常最佳扩增效果出现在略低于引物预测 Tm 的温度,但一般不超过 60 °C。同时根据以下指南测试最佳延伸时间:每 1000 bp 延伸 1 分钟(因此通常根据扩增子长度选择 10-30 秒)。
- 进行终点凝胶电泳,确认引物能扩增出预期序列。取 25 μL qPCR 产物与 5 μL 6X 甘油染料混合,在 2% TAE 琼脂糖凝胶上以 200 V 电压电泳 20 分钟。
6. qPCR 验证剩余序列
注意:此步骤需要使用在步骤5中已验证的引物和建立的PCR条件。
- 每个模板设置三个重复,反应体系如下:12.5 μL PowerSYBR Green 主混合液,0.5 μL 浓度为 10 μM 的正向引物,0.5 μL 浓度为 10 μM 的反向引物,10.5 μL 水,以及 1 μL 模板 DNA(浓度为 2 ng/μL),使每孔总体积为 25 μL。
- 采用步骤 4 中已验证的退火温度和延伸时间设置 qPCR 程序。我们设计并验证了所有引物均适用于两步循环程序:95 °C 初始变性 10 分钟,随后进行 40 个循环(95 °C 变性 30 秒,60 °C 退火/延伸 1 分钟)。然而,对于某些引物,三步循环程序(变性-退火-延伸)可能更为优化,应根据需要进行调整。我们建议在首次使用引物进行 qPCR 时,至少进行一次最终的熔解曲线分析,以确认仅扩增出单一 DNA 产物。
- 通过 Ct 值测定 qPCR/SYBR Green 信号相对于肌动蛋白(或任何其他合适的“R”对照)的表达水平。在所有情况下,计算 2-(目标基因 Ct - β-actin Ct) 的平均值和标准差。
- (可选)进行终点法凝胶电泳,以确认 qPCR 检测到的产物大小正确。具体操作为:将 25 μL qPCR 产物与 5 μL 6x 甘油加样缓冲液混合,在 2% TAE 琼脂糖凝胶上以 200 V 电压电泳 20 分钟。
7. 使用新的参考样本进一步筛选数据。
注意:如果第6步已验证了从T中鉴定出的序列,则在此结束循环(图2A)。然而,多种因素可能促使继续该循环,例如当文件中仍存在大量R序列,或在第6步中未通过qPCR验证任何候选T序列时。
- 获取新的参考序列。此步骤可启动循环的新一轮迭代,可能包括原始基因组数据、原始RNA测序数据或其他已组装的数据集。参考数据的有用资源包括美国国家生物技术信息中心(NCBI)的基因组数据库(https://www.ncbi.nlm.nih.gov/genome),该数据库通过FTP(ftp://ftp.ncbi.nlm.nih.gov/genomes/)提供可访问的已组装基因组;以及基因表达综合数据库(Gene Expression Omnibus,https://www.ncbi.nlm.nih.gov/geo/),其中存储了原始的下一代测序读段。基因组项目也可能通过其他与项目相关的网站和数据库提供其原始序列数据。
结果
运行 BLAST 后,输出文件将包含查询序列中与数据库匹配的序列列表。经过 Python 减法分析后,将获得一批不匹配的序列,并通过 qPCR 进行验证。相关结果及后续步骤如下所述。
阴性结果。在将序列比对到参考序列后,可能出现两种阴性结果。一种情况是没有比对结果,意味着该总序列与参考序列之间没有任何相似序列。这可能是由于为测序样本选择了错误的参考序列所致。另一种可能是起始组装中不存在独特序列(所有序列均被扣除),因此无法找到目标序列对应的基因。请核查参考序列的来源,并确保其并非来自与查询组装相同的组织。
经过计算过滤后,qPCR 可能产生阴性结果,示例见图 3A、3B、C,其中在不同鸟类组织间的检测结果无差异。图 A 至 C 展示了来自不同扣除循环的代表性基因,这促使我们进一步增加扣除循环次数并优化该方法(图 2A、2B)。
阳性结果。当基因组 DNA qPCR 检测显示目标组织/样本中的信号显著高于对照时,即可确认为阳性结果——即真实靶序列的鉴定(图3D)。本案例中的减法基因组学研究起始于对成年雄性和雌性斑胸草雀生殖组织 RNA 的测序,每种性别各获得一千万对读长。为简洁起见,此处仅描述卵巢序列的处理过程:通过从头组装(de novo assembly)获得 167,929 条转录本。采用减法基因组学方法(BLASTn)去除与已发表的体细胞基因组序列相匹配的所有序列12,剩余 5,060 条转录本,对应 598 种独特蛋白质,表明其中许多转录本为非编码序列。随后,利用生成该组装结果所用的 Sanger 原始读长,通过 tBLASTn 进行下一轮减法分析,得到 78 种蛋白质。最后一步减法使用来自听觉叶13 的 RNA-seq 原始读长进行,最终保留八种蛋白质。将这些蛋白质在 NCBI nr 数据库中进行 BLAST 分析后发现,其中六种为病毒来源,一种为鸟类中的重复区域,最后一种为仅限于生殖系表达的 α-SNAP 蛋白7(图2B)。在此过程中,还鉴定出 935 个此前未被纳入全基因组注释的体细胞基因;其中多个基因在不同组织中表现出一致的 qPCR 扩增信号(图3A、3B、3C)。通过 qPCR 验证,α-SNAP 基因确为生殖系特异性表达,因其在体细胞组织中的含量显著低于睾丸 DNA,而在睾丸 DNA 中其表达水平与肌动蛋白相当(图3D)。
可能出现的问题。 使用该方法时必须克服的主要问题是确保使用正确的参考序列。最佳的参考序列应最广泛地涵盖目标序列(T)所嵌入的基因组复杂性。这可能意味着需要使用不同形式的序列作为参考,例如转录组、基因组组装结果、原始数据或来自多个研究的数据(图1)。在斑胸草雀的研究中,我们根据RNA测序数据设计了引物;然而,由于DNA中引物结合位点之间或内部存在内含子,这些引物并不总能成功扩增。我们通过PCR对睾丸基因组DNA进行每对引物的测试,该DNA同时包含目标序列(T)和参考序列(R),因此可作为合适的阳性对照。若在此阶段引物失败,则必须重新设计并测试新的引物,直至找到合适的一组。基于PCR的方法常见的技术陷阱同样适用:必须优化扩增条件,通过检测和/或克隆验证扩增特异性,并且所有实验均需设置无模板对照。有关qPCR检测的更多详细信息,请参见22。
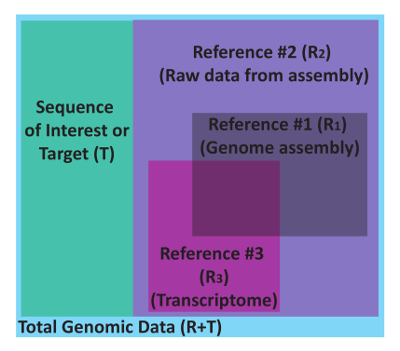
图1。通过减法策略可迭代去除多个参考序列(R),从而从全部基因组数据中仅回收感兴趣的目标序列(T)。 各项研究中的参考序列可能并非完全以图示方式重叠,且可能包含图中未标明的数据集。请点击此处查看该图的放大版本。
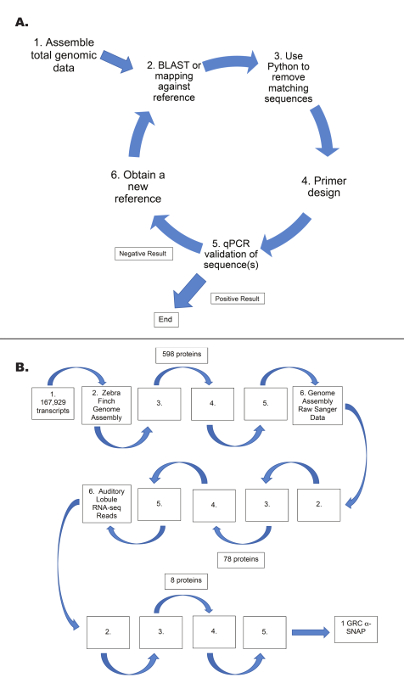
图2. 可视化方法。(A)减法循环示意图。该循环可根据需要重复多次,每次使用不同的参考序列,以获得最佳结果。(B)Biederman et al.7研究中执行的减法循环步骤的具体示例,步骤编号与(A)中一致,并显示了每个阶段剩余的序列数量。请点击此处查看该图的放大版本。
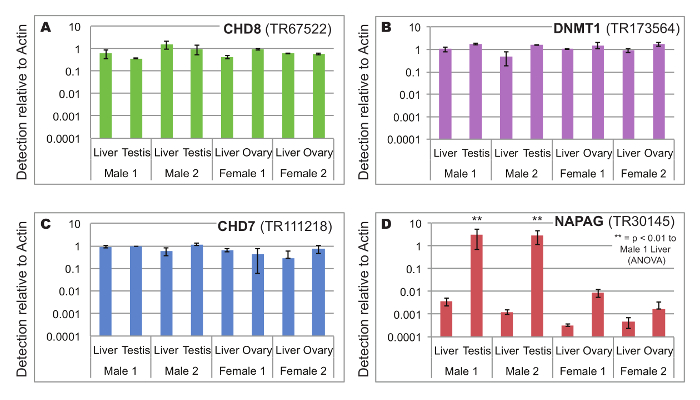
图 3.qPCR 结果示例数据,包含阴性和阳性结果。 (A)CHD8 的基因组 DNA qPCR,结果为阴性。(B)DNMT1 的基因组 DNA qPCR,结果为阴性。(C)CHD7 的基因组 DNA qPCR,结果为阴性。(D)NAPAG 的基因组 DNA qPCR,证实其在睾丸样本中特异性存在,而在肝脏和卵巢中相对于肌动蛋白显著减少,结果为阳性。所有图示数据均表示三次测量的平均值 ± 标准差。请点击此处查看该图的放大版本。
讨论
尽管减法基因组学功能强大,但它并非一种千篇一律的方法,需要在多个关键步骤上进行定制化处理,并仔细选择参考序列和测试样本。如果查询组装的质量较差,过滤步骤可能仅能分离出组装过程中的假象。因此,使用适合特定项目的验证方案对从头(de novo)组装结果进行充分验证至关重要。对于RNA-seq数据,Trinity网站提供了相关指南18;而对于DNA数据,则可使用如REAPR23之类的工具。使用BLAST时另一个关键步骤是选择合适的e值,这将决定减法过程是宽松还是严格。然而,该方法中存在一个反向逻辑:与参考序列的匹配越严格,实际上意味着减法越不严格,因为未匹配的序列不会被剔除。因此,为了实现更严格的减法,应在BLAST中使用更大的(即更宽松的)e值。本方案最后的关键步骤是参考序列的选择。为了达到最高效率,参考序列应尽可能完整;但其并不需要完美,因为qPCR检测可以确认剩余序列是否来源于T或R,以及是否需要进一步过滤。在实施该方案过程中,可引入新的参考序列以进一步缩小待验证基因的范围。我们注意到,有时匹配方法可能会发生变化:在最后一次减法步骤中,我们使用BWA算法将原始测序读段比对到查询序列上,并利用自定义的Python脚本识别那些无匹配读段的查询序列(图2B)。
该方法的局限性包括需要有参考序列可供使用。例如,Meyer 等 评估了一种新人类物种的线粒体基因组;他们使用人类和丹尼索瓦人探针捕获线粒体DNA,随后进行测序并比对至人类参考基因组24在此情况下,研究人员无法利用已有的核基因组参考数据进行扣除以获得线粒体基因组,因此必须采用读段比对的替代策略。24与人类线粒体参考序列相比,任何高度分歧的新型线粒体区域都会因测序读段比对而丢失。减法基因组学相较于读段比对具有更低的偏倚性,但其适用性取决于具体的研究问题;在此案例中,古DNA含量过低,无法达到减法基因组学所需的序列覆盖度要求 从头合成 基因组减法组装(减法基因组学的第一步)
物理纯化为减法基因组学提供了另一种替代方法。由于细胞器基因组远小于核基因组,DNA或RNA的纯化常被用于对完整的叶绿体和线粒体基因组进行测序25,26,27,28。人类及其他较小的线粒体基因组可通过使用两组引物扩增后纯化的方法进行分离测序25。然而,在线粒体基因组异常庞大、引物结合位点高度分化或无法覆盖全基因组的情况下,减法基因组学可能更具优势。纤毛虫即为一例,其具有较大且呈线性的高度分化线粒体基因组29。由于不同物种间序列高度分化,甚至属间都缺乏同源序列,因此参考基因组比对法在纤毛虫中并不可行30。通过采用减法基因组学方法,可在最大程度减少基因组片段遗漏风险的前提下,实现对纤毛虫线粒体基因组的分离与分析。类似地,在对锡特卡云杉叶绿体基因组进行从头组装时,虽采用了de novo组装策略,但填补序列间隙时依赖于与白云杉的比对读段映射,可能在这些位点引入偏差31。
根据具体项目,相较于纯化或作图方法,减法基因组学可能在时间和成本上更具优势,同时在发现过程中引入更少的偏差。在某些情况下,目标序列难以被有效分离,原因可能是其完全未知、对细胞存活至关重要(如线粒体),或片段过大而无法通过标准凝胶电泳分离。基于大小的电泳纯化方法速度较慢,需要大量起始材料(可能成本较高),并且需经过多次尝试以优化条件。脉冲场凝胶电泳(PFGE)能够分离长达107 bp(10 Mb)的DNA片段,但耗时2至3天,需要大量样品,有时还需使用非商业化供应的专用设备32。在Biederman et al.的研究中,从生殖系限制性染色体上唯一已知的序列是一个非编码重复序列7。由于该染色体是鸟类中最大的染色体,长度超过100 Mb10,因此对其进行纯化几乎不可能;因此,减法基因组学实现了其他方法无法完成的任务。在基因组时代,如今测序往往更便宜且更快,后续可通过计算机进行数据筛选。减法基因组学能够发现全新的序列,它结合多种方法,即使在缺乏完美参考序列的情况下,也能有效分离出新颖序列。
披露
作者无任何利益冲突需要披露。
致谢
作者感谢 Michelle Biederman、Alyssa Pedersen 和 Colin J. Saldanha 在斑胸草雀基因组项目不同阶段提供的帮助。我们还感谢 Evgeny Bisk 在计算集群系统管理方面的支持,以及美国国立卫生研究院(NIH)提供的资助 1K22CA184297(授予 J.R.B.)和 NIH NS 042767(授予 C.J.S)。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| Accustart II Taq DNA 聚合酶 | Quanta Bio | 95141 | |
| BLAST(局部序列比对搜索工具) | https://github.com/trinityrnaseq/trinityrnaseq/wiki/Transcriptome-Assembly-Quality-Assessment | ||
| Bowtie 2 | https://www.python.org/download/releases/2.7/ | ||
| BWA-MEM v. 0.7.12 | https://github.com/BenLangmead/bowtie2 | ||
| Geneious | https://blast.ncbi.nlm.nih.gov/Blast.cgi | ||
| PEAR v. 0.9.6 | http://www.mybiosoftware.com/reptile-1-1-short-read-error-correction.html | ||
| 个人计算机 | Biomatters | http://www.geneious.com/ | |
| PowerSYBR qPCR 混合液 | ThermoFisher | 4367659 | |
| Python v. 2.7 | https://sco.h-its.org/exelixis/web/software/pear/ | ||
| Reptile v.1.1 | https://alurulab.cc.gatech.edu/reptile | ||
| Stratagene Mx3005P | Agilent Technologies | 401456 | |
| TransDecoder v. 3.0.1 | https://sourceforge.net/projects/bio-bwa/files/ | ||
| Trinity v. 2.4.0 | https://github.com/TransDecoder/TransDecoder/wiki |
参考文献
- Barh, D., et al. A Novel Comparative Genomics Analysis for Common Drug and Vaccine Targets in Corynebacterium pseudotuberculosis and other CMN Group of Human Pathogens. Chemical Biology & Drug Design. 78 (1), 73-84 (2011).
- Sarangi, A. N., Aggarwal, R., Rahman, Q., Trivedi, N. Subtractive Genomics Approach for in Silico Identification and Characterization of Novel Drug Targets in Neisseria Meningitides Serogroup B. Journal of Computer Science & Systems Biology. 2 (5), (2009).
- Kaur, N., et al. Identification of Druggable Targets for Acinetobacter baumannii Via Subtractive Genomics and Plausible Inhibitors for MurA and MurB. Applied Biochemistry and Biotechnology. 171 (2), 417-436 (2013).
- Rathi, B., Sarangi, A. N., Trivedi, N. Genome subtraction for novel target definition in Salmonella typhi. Bioinformation. 4 (4), 143-150 (2009).
- Epstein, J. H., et al. Identification of GBV-D, a Novel GB-like Flavivirus from Old World Frugivorous Bats (Pteropus giganteus) in Bangladesh. PLoS Pathogens. 6 (7), (2010).
- Kapoor, A., et al. Identification of Rodent Homologs of Hepatitis C Virus and Pegiviruses. MBio. 4 (2), (2013).
- Biederman, M. K., et al. Discovery of the First Germline-Restricted Gene by Subtractive Transcriptomic Analysis in the Zebra Finch, Taeniopygia guttata. Current Biology. 28 (10), 1620-1627 (2018).
- Readhead, B., et al. Multiscale Analysis of Independent Alzheimer's Cohorts Finds Disruption of Molecular, Genetic, and Clinical Networks by Human Herpesvirus. Neuron. 99, 1-19 (2018).
- Carroll, D., et al. The global virome project. Science. 359 (6378), 872-874 (2016).
- Pigozzi, M. I., Solari, A. J. Germ cell restriction and regular transmission of an accessory chromosome that mimics a sex body in the zebra finch. Taeniopygia guttata. Chromosome Research. 6, 105-113 (1998).
- Itoh, Y., Kampf, K., Pigozzi, M. I., Arnold, A. P. Molecular cloning and characterization of the germline-restricted chromosome sequence in the zebra finch. Chromosoma. 118, 527-536 (2009).
- Warren, W. C., et al. The genome of a songbird. Nature. 464, 757-762 (2010).
- Balakrishnan, C. N., Lin, Y. C., London, S. E., Clayton, D. F. RNAseq transcriptome analysis of male and female zebra finch cell lines. Genomics. 100, 363-369 (2012).
- Bolger, A. M., Lohse, M., Usadel, B. Trimmomatic: a flexible trimmer for Illumina sequence data. Bioinformatics. 30 (15), 2114-2120 (2014).
- Zhang, J., Kobert, K., Flouri, T., Stamatakis, A. PEAR: a fast and accurate Illumina Paired-End reAd mergeR. Bioinformatics. 30, 614-620 (2014).
- Yang, X., Dorman, K. S., Aluru, S. Reptile: representative tiling for short read error correction. Bioinformatics. 26, 2526-2533 (2010).
- MacManes, M. D., Eisen, M. B. Improving transcriptome assembly through error correction of high-throughput sequence reads. PeerJ. 1 (113), (2013).
- Grabherr, M. G., et al. Full-length transcriptome assembly from RNA-seq data without a reference genome. Nature Biotechnology. 29, 644-652 (2011).
- Li, H. Aligning sequence reads, clone sequences and assembly contigs with BWA-MEM. arXiv. , (2013).
- Langmead, B., Salzberg, S. Fast gapped-read alignment with Bowtie 2. Nature Methods. 9, 357-359 (2012).
- Kearse, M., et al. Geneious Basic: an integrated and extendable desktop software platform for the organization and analysis of sequence data. Bioinformatics. 28 (12), 1647-1649 (2012).
- Peirson, S. N., Butler, J. N. Quantitative polymerase chain reaction. Methods in Molecular Biology. 362, 349-362 (2007).
- Hunt, M., Kikuchi, T., Sanders, M., Newbold, C., Berriman, M., Otto, T. D. REAPR citation: REAPR: a universal tool for genome assembly evaluation. Genome Biology. 14 (5), (2013).
- Meyer, M., et al. A mitochondrial genome sequence of a hominin from Sima de los Huesos. Nature. 505 (7483), 403-406 (2013).
- Gunnarsdóttir, E. D., Li, M., Bauchet, M., Finstermeier, K., Stoneking, M. High-throughput sequencing of complete human mtDNA genomes from the Philippines. Genome Research. 21 (1), 1-11 (2010).
- King, J. L., et al. High-quality and high-throughput massively parallel sequencing of the human mitochondrial genome using the Illumina MiSeq. Forensic Science International: Genetics. 12, 128-135 (2014).
- Yao, X., et al. The First Complete Chloroplast Genome Sequences in Actinidiaceae: Genome Structure and Comparative Analysis. Plos One. 10 (6), (2015).
- Zhang, Y., et al. The Complete Chloroplast Genome Sequences of Five Epimedium Species: Lights into Phylogenetic and Taxonomic Analyses. Frontiers in Plant Science. 7, (2016).
- Swart, E. C., et al. The Oxytricha trifallax Mitochondrial Genome. Genome Biologyogy and Evolution. 4 (2), 136-154 (2011).
- Barth, D., Berendonk, T. U. The mitochondrial genome sequence of the ciliate Paramecium caudatum reveals a shift in nucleotide composition and codon usage within the genus Paramecium. BMC Genomics. 12 (1), (2011).
- Coombe, L., et al. Assembly of the Complete Sitka Spruce Chloroplast Genome Using 10X Genomics' GemCode Sequencing Data. Plos One. 11 (9), (2016).
- Herschleb, J., Ananiev, G., Schwartz, D. C. Pulsed-field gel electrophoresis. Nature Protocols. 2 (3), 677-684 (2007).
重印与许可
