OpenProt 是一个可免费访问的数据库,致力于推行真核生物基因组的多顺反子模型。本文介绍了一种在分析质谱数据集时使用 OpenProt 数据库的实验方案。利用 OpenProt 数据库进行蛋白质组学实验分析,有助于发现新颖且以往难以检测到的蛋白质。
本文内容
摘要
摘要
基因组注释在当今的蛋白质组学研究中至关重要,因为它勾勒出了蛋白质组景观的基本轮廓。传统的开放阅读框(ORF)注释模型施加了两个任意标准:至少包含100个密码子,并且每条转录本仅有一个ORF。然而,越来越多的研究报告指出,蛋白质可从所谓的非编码区域表达,这挑战了当前基因组注释的准确性。这些新发现的蛋白质被发现编码于非编码RNA、mRNA的5'或3'非翻译区(UTRs),或与已知编码序列(CDS)在替代ORF中重叠。OpenProt是首个在真核生物基因组中实施多顺反子模型的数据库,允许对每条转录本上的多个ORF进行注释。OpenProt可免费访问,并提供跨越10个物种的蛋白质序列自定义下载。在蛋白质组学实验中使用OpenProt数据库有助于发现新蛋白质,并揭示真核基因的多顺反子特性。OpenProt数据库(包含所有预测蛋白质)规模较大,在分析时需予以考虑。然而,通过设置适当的假阳性发现率(FDR)或使用受限版本的OpenProt数据库,用户可以获得更真实的蛋白质组景观视图。总体而言,OpenProt是一个可免费获取的工具,将推动蛋白质组学的新发现。
引言
近几十年来,基于质谱(MS)的蛋白质组学已成为解析真核细胞蛋白质组的金标准技术1,2,3,4,5。该方法依赖于当前的基因组注释,以构建参考蛋白质序列数据库,从而界定可能存在的蛋白质范围6,7,8。然而,基因组注释对开放阅读框(ORF)的界定采用了一些人为设定的标准,例如至少包含100个密码子,以及每条转录本仅含有一个ORF9,10。越来越多的研究对现有的注释模型提出挑战,报道了在真核生物基因组中存在大量未被注释的功能性ORF8,11,12,13,14。这些新发现的蛋白质被编码于所谓的非编码RNA、mRNA的5'或3'非翻译区(UTR),或与经典编码序列(cCDS)在不同的阅读框上重叠。尽管这些发现大多具有偶然性,但它们揭示了当前基因组注释的局限性以及真核基因的多顺反子特性8。
本文重点介绍 OpenProt 数据库在基于质谱的蛋白质组学中的应用。OpenProt 是首个为真核生物转录组提供多顺反子注释模型的数据库,可免费访问 www.openprot.org15。这些预测的开放阅读框(ORF)中有一部分可能是随机且无功能的,因此 OpenProt 汇集了实验和功能证据以提高可信度。实验证据包括蛋白质表达(通过质谱法检测)和翻译证据(通过核糖体谱型分析)15。功能证据包括蛋白质直系同源关系(采用类似 In-Paranoid 的方法)以及功能结构域预测15。
OpenProt 提供了下载多个数据库的选项,这些数据库从仅包含高可信度蛋白质的集合到自定义数据库不等。本文将介绍利用 OpenProt 数据库的分析流程,并针对不同的实验目标,指导如何选择合适的数据库。此处展示的蛋白质组学分析流程基于 Galaxy 框架,因其具有开放获取和易于使用的特点,但这些数据库可兼容任何工作流程16,17,18。我们还将介绍如何利用 OpenProt 网站获取质谱检测到的新蛋白质的进一步信息。使用 OpenProt 数据库将更全面地揭示蛋白质组的复杂图景,并以比现有方法更系统的方式推动蛋白质组学和生物标志物的发现。
本方案重点介绍在分析质谱(MS)数据集时使用 OpenProt 数据库的方法15;不涉及实验设计本身的讨论,相关内容已在其他文献中得到充分综述20,21,22。为保持完全开源,本方案可免费获取(补充材料 S1–S4)。为便于阅读,OpenProt 中使用及本方案中涉及的所有术语均在表1中予以定义。
方案
1. OpenProt 数据库下载
注意:例如,也可获取基于 RNA-seq 数据的自定义数据库,本方案的第二部分将详细说明该流程。如果需要自定义数据库,请跳至下一节。
- 访问 OpenProt 网站: www.openprot.org,并通过页面顶部菜单中的链接打开“Downloads”页面。
- 根据分析的实验数据,点击感兴趣的物种。
- 点击所需的目标蛋白类型。
注意:OpenProt 提供三种分类:RefProt、Isoforms 和 AltProt。如图1所示,该参数将根据研究目标的不同而有所变化。- 点击仅 RefProt,以生成仅包含已知蛋白的文件。
- 点击AltProt 和 Isoforms,以生成仅包含新蛋白的文件——这些新蛋白可能是已知蛋白的新异构体(Isoforms),或由替代开放阅读框编码的蛋白(AltProts)。请注意,OpenProt 要求开放阅读框的最小长度为 30 个密码子15。
- 点击AltProts、Isoforms 和 RefProts,以生成包含 OpenProt 数据库中所有蛋白类型的文件——包括已知蛋白和新蛋白。
- 如有可选项目,请点击用于提取蛋白序列的注释版本。
注意:OpenProt 通过整合多个注释来源,提供了更全面的蛋白质组景观。由于转录组注释之间的重叠度较低,所选注释可能显著影响可视化蛋白质组谱型15,23。 - 点击蛋白筛选所需的支持证据等级。如图1所示,该参数将根据研究目标的不同而有所变化。
- 点击至少检测到两个唯一肽段,以生成仅包含置信度最高蛋白的文件。
注意:目前蛋白质组学中普遍将“至少两个唯一肽段”作为蛋白表达的金标准。如果实验目标是检测已知且支持充分的蛋白,建议使用此参数。 - 点击至少检测到一个唯一肽段,以生成包含在 OpenProt 重新分析的质谱实验中至少被检测到一次的蛋白的文件。
注意:此选项可兼顾 AltProts 蛋白长度较短的特点,并考虑到其中部分蛋白可能仅包含一个唯一的胰蛋白酶肽段8,11。 - 点击所有预测结果,以生成包含 OpenProt 所有预测蛋白的文件。
注意:仅当实验目标为发现新蛋白时,才建议使用此设置(图1)。此设置将显著增加搜索空间,因此需要采用下文所述的适配分析流程7,15。
- 点击至少检测到两个唯一肽段,以生成仅包含置信度最高蛋白的文件。
- 点击所需的文件格式进行下载。对于蛋白质组学分析,请选择 Fasta(蛋白)文件。readme 文件包含有关文件格式的全部必要信息。
2. 自定义 OpenProt 数据库下载
注意:本节详细介绍如何获取自定义数据库。如果不需要自定义数据库,请跳至下一节。
- 访问 OpenProt 网站(www.openprot.org),并通过首页菜单中的链接打开“搜索”页面。
- 根据所分析的实验数据,点击感兴趣的物种。
- 输入感兴趣的基因或转录本列表。
- 若使用基因列表,请将其输入至基因查询框中。
- 若使用转录本列表,请将其输入至转录本查询框中。
- 勾选适用于目标数据库的所有选项。
- 若不勾选任何选项,则将获得一个包含 OpenProt 支持的所有类型蛋白的表格:RefProt、Isoforms 和 AltProts。
- 勾选仅显示具有实验证据的蛋白,以获得一个包含所有已被质谱(MS)至少检测到一次,或已从核糖体谱分析数据中收集到翻译证据的蛋白类型(RefProts、Isoforms 和 AltProts)的表格。
- 类似地,勾选仅显示由质谱检测到的蛋白或仅显示由核糖体谱分析检测到的蛋白,以分别获得一个包含所有至少被质谱或核糖体谱分析检测到一次的蛋白类型的表格。
- 勾选仅显示 AltProts或仅显示 isoforms,以分别获得一个仅包含 AltProts 或仅包含 Isoforms 的表格。
- 同时勾选仅显示 AltProts和仅显示 isoforms,以获得一个同时包含这两类蛋白的表格。
注意:所有筛选条件的组合均可使用。
- 设置完所有所需参数后,点击“搜索”。搜索结果表格将显示在查询字段下方。
- 点击输出表格右上角的下载 Fasta按钮。系统将生成一个包含所查询基因或转录本列表对应的所有蛋白的 Fasta 文件。
- 请注意,出于计算效率考虑,OpenProt 每次最多支持查询 2,000 个元素(基因或转录本)。若列表超过此限制,可生成多个 Fasta 文件后再进行合并(如下所述);或者直接下载完整的 OpenProt 数据库,并按需对所得文件进行筛选。
- 将完整的基因或转录本列表划分为每组不超过 2,000 条的子列表。针对每个子列表,按照上述步骤(3.3 至 3.6)下载一个 Fasta 文件。
- 登录欧洲 Galaxy 实例(或其他提供蛋白质组学工具的实例), https://usegalaxy.eu/。
- 创建一个新的 history,并通过点击屏幕左上方的上传图标,导入所有已下载的 OpenProt 数据库(每个子列表对应一个)。
- 使用 GalaxyP 开发者开发的Fasta 合并文件并筛选唯一序列工具(https://github.com/galaxyproteomics/)。选择合并所有 Fasta选项,并输入所有已导入的 OpenProt 数据库。
注意:可通过屏幕左侧的查询框搜索每个工具。 - 选择仅使用登录号选项以评估序列唯一性,并复制 OpenProt 标识符解析规则(>(.*)\|),然后点击执行。
- 请注意,所有文件已合并为一个无冗余的唯一 Fasta 文件,该文件现显示在屏幕右侧的历史记录面板中。此即为工作数据库。
3. 数据库处理
注意:此后将使用 Galaxy 平台,但相同的原则也可应用于其他蛋白质组学软件。
- 登录欧洲 Galaxy 实例(或任何其他提供蛋白质组学工具的实例), https://usegalaxy.eu/。
- 创建一个新的历史记录,并通过点击屏幕左上角的上传图标导入下载的 OpenProt 数据库。
- 进入工作流页面,通过点击中间面板左上角的上传图标,导入数据库处理工作流(补充材料 S1)。
- 点击 运行工作流,并选择已导入的 OpenProt 数据库作为输入。
注意:该工作流会将 CRAPome 仓库添加到 OpenProt fasta 文件中,并生成反向序列作为诱饵序列(decoy sequences)24。如果需要生成随机打乱的诱饵列表,可通过修改 DecoyDatabase 工具中的相应参数实现。 - 将生成的 Fasta 文件重命名为具有明确意义的名称。该数据库现已可用于蛋白质组学分析。
4. 质谱文件制备
注意:Galaxy 实例上提供的大多数蛋白质组学工具使用 mzML 格式,且肽段搜索引擎更倾向于使用质心模式的数据。
- 打开 ProteoWizard 套件中免费提供的 MSConvert 工具,并上传待分析的数据文件25。
- 选择输出目录,并将目标文件格式设置为 mzML。
- 在 MS1 和 MS2 水平上使用基于小波的算法(CWT)设置峰提取滤波器,然后开始转换26。
5. 肽段与蛋白质鉴定/定量
注意:该流程的这一部分使用了 OpenMS 工具包中的工具,这是一个多功能且易于使用的框架18。
- 登录欧洲 Galaxy 实例(或任何其他提供蛋白质组学工具的实例), https://usegalaxy.eu/。
- 创建一个新的历史记录,并通过拖放操作将先前创建的数据库(步骤 3.5)转移至该新历史记录中。
- 点击屏幕左上方的 上传 图标,导入已转换的 mzML 数据文件(步骤 4.3)。
- 进入工作流页面,点击中间面板左上方的上传图标,导入所需的工作流。
注意:质谱实验的设计根据预期的最终结果而有所不同。本文提供了两种常见设计的工作流:蛋白质鉴定和基于稳定同位素标记(SIL)的蛋白质定量。然而,Galaxy 实例包含许多其他工具,可支持其他类型的蛋白质组学分析27,28。- 对于蛋白质鉴定设计,请导入 补充材料 S2 中提供的工作流。 使用此工作流时,请勿在转换文件时使用 zlip 压缩(步骤 4.2)
- 对于基于稳定同位素标记设计的蛋白质定量,请导入 补充材料 S3 中提供的工作流。
- 选择 运行工作流,并检查各项参数。
- 选择已导入的 mzML 数据文件作为输入,将先前创建的数据库(步骤 3.5)作为数据库 Fasta 文件。
- 由于该工作流使用 X!Tandem 搜索引擎,请点击屏幕左上方的上传图标,导入 X!Tandem 默认配置文件(见 补充材料 S4)29。
- 该工作流使用多个搜索引擎(MS-GF+ 和 X!Tandem)。可通过在工作流中添加或移除工具,轻松添加其他搜索引擎或仅使用单一引擎30,31。
注意:建议使用多个搜索引擎,以提高分析的覆盖度和灵敏度32。 - 为应对使用完整 OpenProt 数据库时数据量的显著增加,应采用严格的错误发现率(FDR)15。默认情况下,所提供的工作流设置为 0.001% 的 FDR,适用于完整 OpenProt 数据库的使用。对于其他数据库,可将其修改为任意所需值。
注意:请务必根据所使用的质谱仪和实验方案(前体离子和碎片误差、固定和可变修饰、所用酶等)调整各个工具的参数。
- 可选操作:如需存储或进行质量控制分析,可在历史记录面板中点击选定的步骤,然后点击下方出现的 保存 图标,下载工作流每一步的输出结果。
6. 质量控制
注意:由于基于质谱的蛋白质组学是复杂流程的结果,每一步骤均需优化以获得可重复的结果,因此质量控制是工作流程中必要的步骤33。
- 常用的性能评估指标包括肽段-谱图匹配数(PSM)、鉴定出的肽段数量和蛋白质数量等。对 IDFilter 的输出结果(如图2中绿色标注所示)运行File Info工具,即可获得这些指标。
- 尽管该方法并非适用于所有鉴定情况,尤其是处理大规模数据集时,但对新发现蛋白质的报告应始终进行仔细评估。检查蛋白质得分、序列覆盖率以及支持该发现的质谱图至关重要。可使用 OpenMS 框架中的 TOPPview 工具完成此项工作,该工具免费提供,且具有完善的文档支持18,34,35。
7. OpenProt 数据库挖掘
注意:一旦成功鉴定出由 OpenProt 预测的新型蛋白质(AltProts 的登录号以 IP_ 开头,新异构体的登录号以 II_ 开头),即可从 OpenProt 网站获取更多生物学信息15。
- 访问 OpenProt 网站: www.openprot.org,并通过页面顶部菜单中的链接打开搜索页面。
- 点击感兴趣的物种(与鉴定蛋白所用物种相同),并在Protein查询框中输入蛋白的登录号。
- 点击搜索,将出现一个包含所查询蛋白基本信息的表格。表格内容包括:蛋白长度(氨基酸数目)、分子量(kDa)、等电点、质谱(MS)或核糖体谱型分析支持的翻译实验证据(Translation Evidence, TE),以及功能预测信息,如预测的结构域和蛋白直系同源关系(涵盖 OpenProt v1.3 支持的10个物种)。表格还包含相关基因与转录本的信息,以及蛋白在转录本中的定位。
- 点击Details链接以获取更多详细信息。新打开的页面包含一个以所查询蛋白为中心的基因组浏览器,以及基因组和转录组坐标信息、是否存在 Kozak 序列或高效翻译起始位点(TIS)基序36,37等信息。
- 在信息标签页中点击Protein或DNA链接,分别获取蛋白或DNA序列。
- 通过点击顶部标签页15,浏览有关质谱证据、核糖体谱型检测、保守性以及已鉴定蛋白结构域的详细信息。
结果
上述工作流程已应用于 PRIDE 仓库中可获取的一个质谱(MS)数据集38,39。原始研究开发了一种方法(iMixPro),利用细胞培养中的氨基酸稳定同位素标记(SILAC),以消除亲和纯化质谱(AP-MS)实验中的假阳性结果38。简而言之,AP-MS 实验包括使用连接有抗体的磁珠捕获目标蛋白(诱饵)及其相互作用蛋白(猎物)。收集到的蛋白质随后被消化并制备用于质谱分析。样品制备方法和仪器参数详见原始研究及 PRIDE 仓库(PXD004246)。此类实验的一个挑战是存在大量假阳性,尤其是那些与磁珠结合而非与诱饵蛋白结合的蛋白质。在此,我们利用 SILAC 技术使真实猎物蛋白与假阳性蛋白产生不同的同位素比例:3 个在轻培养基中培养的对照样本(无诱饵蛋白),1 个在轻培养基中表达诱饵蛋白的样本,以及 1 个在重培养基中表达诱饵蛋白的样本,均与磁珠共同孵育,并进行后续质谱分析。在此实验设计下,非特异性结合于磁珠的蛋白质其重链与轻链比例为 1:4;而真实猎物蛋白的比例则为 1:138。
我们使用 OpenProt 数据库重新分析了他们的 AP-MS 数据;诱饵蛋白包括三种内源性蛋白(PTPN14、JIP3 和 IQGAP1)以及两种过表达蛋白(RAF1 和 RNF41)。由于实验采用了 SILAC 标记,因此使用了用于蛋白质定量的 Galaxy 工作流程(补充材料 S3,图 2)。该工作流程分别基于完整的 OpenProt 数据库(OpenProt_all)或受限的 OpenProt 数据库(OpenProt_2pep,仅包含此前检测到的、至少具有两个唯一肽段的蛋白质)运行。
在不同使用的数据库之间,蛋白质鉴定与定量结果良好且具有可重复性。如图3所示,原始论文中鉴定出的大多数蛋白质在使用OpenProt_2pep或OpenProt_all数据库时同样被鉴定到(详细列表见补充材料S5)。该结果表明,本文所述的分析流程结合OpenProt数据库能够实现与基于UniProtKB数据库的现有方法相当的蛋白质鉴定与定量能力40。然而,使用OpenProt数据库具有独特优势,即可检测出新颖的以及此前无法检测的蛋白质,本案例研究已证实了这一点。
在所有数据集中,利用 OpenProt_2pep 数据库鉴定出 11 种高置信度支持的蛋白质(1 种异构体和 10 种替代蛋白质),这些蛋白质目前尚未在数据库中注释,且均具有高置信度肽段证据(所有蛋白质的登录号及其支持肽段数量详见补充材料 S5)。由于该数据库的搜索空间增长适中,因此允许采用传统的 1% 错误发现率(FDR)。这 11 种蛋白质在原始研究中未被鉴定出,原因是它们在当时所用数据库中不存在。
在所有数据集中,使用 OpenProt_all 数据库共发现了 29 种新蛋白质(包括 16 种同种型和 13 种 AltProt),且均具有高置信度肽段支持(所有蛋白质的登录号及其支持肽段数量详见补充材料 S6)。如图 3所示,推荐的严格错误发现率(FDR)并未影响最高置信度的蛋白质鉴定结果,尽管其确实减少了鉴定到的蛋白质总数。与 OpenProt_2pep 数据库相比,使用 OpenProt_all 数据库可更可靠地鉴定出更多的新蛋白质。所有这些新蛋白质在 OpenProt_2pep 数据库中均不存在。这凸显了数据库选择在基于质谱的蛋白质组学研究中的关键作用。
发现了一种新的蛋白质,可作为RAF1蛋白的相互作用蛋白(IP_637643)。通过OpenProt网站可以发现,该蛋白质此前从未通过质谱(MS)或核糖体谱分析检测到(OpenProt v1.3)。该蛋白质由46个氨基酸组成,经胰蛋白酶消化后仅能产生两个独特的肽段。在RAF1免疫共沉淀-质谱(AP-MS)数据集(第18组分)中检测到的肽段具有高质量的质谱图,如图4所示,其重链与轻链的比值为1.09。该蛋白质由NANOGNBP1基因编码,该基因是NANOGNB的假基因。根据GTEx数据库的记录,该转录本(ENST00000448444)目前被注释为非编码转录本,但在多种组织中均有检测到40。该蛋白质包含一个预测的与DNA结合相关的功能结构域(基因本体GO:0003677)41。

图1:蛋白质组学分析的数据库选择流程图。 质谱数据的分析,特别是数据库的选择,取决于研究目标。图中以蓝色(经典蛋白质组学流程)、绿色(全面蛋白质组搜索)和橙色(蛋白质组学发现)标出了三种常见的研究目标。每种目标均依赖于合适的数据库和分析流程。对于全面性和经典蛋白质组学流程,可使用单一的鉴定工具。而对于蛋白质组学发现流程,我们强烈推荐使用多个鉴定引擎。推荐的错误发现率(FDR)以红色标注,蛋白质数据库的大小以灰色框标注。请点击此处查看该图的放大版本。

图 2:所用 Galaxy 工作流程的图示。逐步展示用于重新分析 Eyckerman 等人数据的蛋白质组学分析工作流程38。输入文件、肽段搜索和蛋白质定量以橙色框表示。蓝色框对应所使用的工具,灰色框对应生成的输出文件。不同的搜索引擎(MS-GF+ 和 X!Tandem)以不同颜色表示(分别为红色和紫色),指示其所需输入和输出的箭头亦如此。绿色框突出显示生成蛋白质鉴定列表的工具。当生成多个输出时,最靠近箭头的输出表示用于后续步骤的文件。该工作流程可在补充材料 S2中免费获取。X!Tandem 默认参数配置文件可在补充材料 S4中获取。请点击此处查看该图的放大版本。
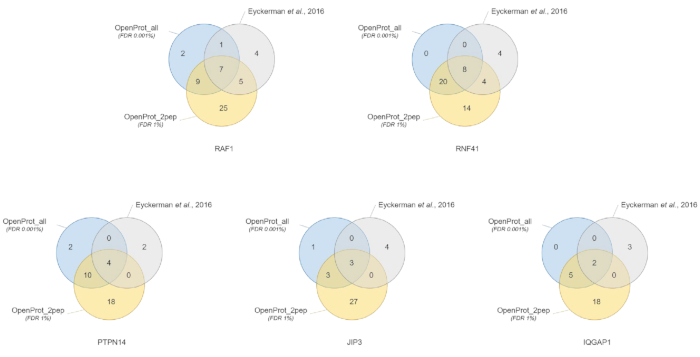
图3:使用不同数据库按诱饵蛋白进行互作蛋白鉴定的比较。 使用置信度最高的OpenProt数据库(橙色,至少支持2个独特肽段的证据,OpenProt_2pep)并设定1%错误发现率(FDR),或使用完整的OpenProt数据库(蓝色,OpenProt_all)并设定0.001% FDR,或引用原始文献中报告的结果(灰色)38,所得到的蛋白质鉴定结果的维恩图。每个图对应于指定诱饵蛋白所鉴定出的互作蛋白:RAF1、RNF41、PTPN14、JIP3 和 IQGAP1。请点击此处查看该图的放大版本。

图 4:新蛋白 IP_637643 中鉴定出的 MDNLWAK(13C6) 肽段的 MS/MS 谱图。强度为相对值(0 至 100%)。选中的峰以红色标出,y 离子标注为深红色,b 离子标注为绿色。数据来源于 TOPPview 软件34。前体离子误差 = 2.70 ppm,PEP 评分 = 0.12。 请点击此处查看此图的放大版本。
| 术语 | 定义 | 参考文献 |
| 替代开放阅读框 (AltORF) | 目前未在基因组注释中注释的非经典开放阅读框,但在 OpenProt 中已注释。 | 15 |
| 参考开放阅读框 (RefORF) | 在基因组注释和 OpenProt 中均已注释的经典开放阅读框。 | 15 |
| 替代蛋白 (AltProt) | 由 AltORF 编码的新型蛋白,与 RefProt 无显著相似性。登录号前缀:IP_。 | 15 |
| 参考蛋白 (RefProt) | 目前在 UniProtKB、Ensembl 或 NCBI RefSeq 等蛋白质序列数据库中注释,并且也在 OpenProt 中注释的蛋白质。 | 15 |
| 新型异构体 | 由 AltORF 编码的新型蛋白,与 RefProt 具有显著相似性。登录号前缀:II_。 | 15 |
| OpenProt_2pep 数据库 | 包含所有 RefProt 和 OpenProt 预测的新型蛋白序列,且这些蛋白已被至少 2 个唯一肽段检测到。 | 15 |
| OpenProt_1pep 数据库 | 包含所有 RefProt 和 OpenProt 预测的新型蛋白序列,且这些蛋白已被至少 1 个唯一肽段检测到。 | 15 |
| OpenProt_all 数据库 | 包含所有 RefProt 和 OpenProt 预测的新型蛋白序列。 | 15 |
表1:OpenProt及本实验方案中所用术语的定义
补充材料 S1:用于数据库处理的 Galaxy 工作流程。 该流程将 CRAPome 序列和诱饵序列(反向)添加到输入数据库中。输出为 Fasta 文件。请点击此处下载。
补充材料 S2:用于蛋白质鉴定的 Galaxy 工作流程。 该工作流程将使用两种搜索引擎(MS-GF+ 和 X!Tandem)从质谱数据文件中鉴定蛋白质。在运行工作流程之前,可根据需要调整每个参数。请点击此处下载。
补充材料 S3:使用稳定同位素标记(SIL)进行蛋白质定量的 Galaxy 工作流程。 该工作流程将利用两个搜索引擎(MS-GF+ 和 X!Tandem)从质谱数据文件中鉴定并定量蛋白质。在运行工作流程前,可根据需要调整各个参数。请点击此处下载。
补充材料 S4:X!Tandem 默认参数配置文件。 该 XML 文件是在 Galaxy 平台上运行 X!TandemAdapter 工具所必需的。请点击此处下载。
补充材料 S5:iMixPro 数据集中的定量蛋白质。 对 Eyckerman 等人 2016 年38的数据文件使用 OpenProt 数据库进行处理,并列出了每种条件下的定量蛋白质。诱饵蛋白为 PTPN14、JIP3、IQGAP1、RAF1 和 RNF41。以绿色标注的基因名称对应于在原始论文中也鉴定到的蛋白质38。以橙色标注的基因名称对应于 BioGrid 数据库中记录的已知互作蛋白,但在原始论文中未被报道。以浅蓝色标注的基因名称对应于新鉴定出的互作蛋白(括号中为相应的蛋白质登录号)。以浅灰色和斜体标注的基因名称对应于可能的污染物(角蛋白类蛋白)。请点击此处下载。
补充材料 S6:来自 iMixPro 数据集鉴定出的新蛋白质。 对 Eyckerman 等人 2016 年38的数据文件使用 OpenProt 数据库进行处理,并列出了每种条件下鉴定出的新蛋白质。诱饵蛋白为 PTPN14、JIP3、IQGAP1、RAF1 和 RNF41。列出了蛋白质的登录号,其中以 II_ 开头的表示已知蛋白质的新异构体,以 IP_ 开头的表示来自替代开放阅读框(AltProt)的新蛋白质。支持肽段的数量以括号标注。请点击此处下载。
讨论
在分析质谱仪数据时,蛋白质鉴定的质量在一定程度上依赖于所用数据库的准确性6,20。目前的方法通常使用UniProtKB数据库,但这些数据库基于每条转录本仅对应一个开放阅读框(ORF)且最小长度为100个密码子的基因组注释模型(先前已证实的例外情况除外)40。多项研究指出,此类数据库的局限性与从所谓非编码区发现功能性开放阅读框密切相关8,11,12,13。如今,OpenProt通过整合多个转录组注释来源的蛋白质序列,实现了更全面的蛋白质鉴定。OpenProt获取NCBI RefSeq(GRCh38.p7)和Ensembl(GRCh38.83)转录组以及UniProtKB注释(UniProtKB-SwissProt,2017-09-27)40,42,43。由于当前各类注释之间的重叠较少,OpenProt相较于仅依赖单一注释的方法,能够更全面地呈现潜在的蛋白质组景观15。
此外,由于 OpenProt 采用多顺反子模型,因此允许每个转录本存在多个蛋白质注释。出于统计学和计算方面的考虑,OpenProt 仍设定最小长度阈值为 30 个密码子15。然而,它能够预测数千种全新的蛋白质序列,从而拓展了蛋白质鉴定的可能性范围。通过这一方法,OpenProt 更加系统地支持蛋白质组学的发现。
蛋白质鉴定的质量也可能受到所用参数的影响。基于质谱的蛋白质组学分析通常设定1%的蛋白质错误发现率(FDR)。然而,整个OpenProt数据库包含的条目数量约为其6倍(图1)。为应对搜索空间的显著增加,我们建议采用更为严格的0.001% FDR阈值。该参数通过基准研究和对随机选择谱图的手动评估进行优化15。尽管如此,仍可能存在假阳性结果,因此我们建议对新鉴定蛋白质的支持性证据进行仔细检查和验证。推荐的标准之一是在两次不同的质谱运行中均鉴定到该蛋白质,因为背景数据和假阳性在不同数据集之间可能存在差异15。
本文提供的流程及案例研究中所使用的流程可根据实验设计和参数随意修改。我们建议使用多种搜索引擎,因为这可以提高肽段鉴定的灵敏度和特异性32。此外,我们建议使用与实验目标最匹配的数据库(图1)。由于使用完整的OpenProt数据库会带来严格的FDR控制,可能导致真实的鉴定结果丢失。因此,完整的数据库应主要用于新蛋白的发现,而经典的蛋白质组学分析则应使用较小的OpenProt数据库(例如案例研究中使用的OpenProt_2pep)。
OpenProt 目前仅预测以 ATG 密码子起始的序列,然而已有若干研究指出翻译起始可发生在其他密码子44,45。当一种新蛋白质通过一个或多个独特肽段被鉴定时,其真实的起始密码子可能并非假定的 ATG。用户可在 OpenProt 网站上查找相关的翻译证据。目前,OpenProt 仅在翻译事件覆盖整个预测蛋白质序列(即 100% 重叠)时才予以报告15。因此,缺乏翻译证据并不意味着该蛋白质未被翻译,而可能表明起始密码子并非所推测的 ATG。
尽管目前仍存在一些局限性,OpenProt 为真核生物基因组的编码潜力提供了更为全面的视角。OpenProt 数据库有助于推动蛋白质组学的发现,并加深对蛋白质组功能及其相互作用的理解。未来,OpenProt 数据库的进一步发展将包括对其他物种的注释、非 ATG 起始密码子的翻译证据整合,以及开发一条分析流程,用于在全基因组和外显子组测序研究中纳入新蛋白质。
披露
作者声明无利益冲突。
致谢
感谢 Vivian Delcourt 在本研究中提供的帮助、讨论和建议。X.R. 是魁北克卫生研究基金会(FRQS)支持的舍布鲁克大学医疗中心研究所的研究成员。本研究得到了加拿大功能蛋白质组学与新型蛋白质发现研究主席计划对 X.R. 的资助以及加拿大卫生研究院(CIHR)基金 MOP-137056 的支持。我们感谢魁北克计算网络(Calcul Québec)和加拿大计算网络(Compute Canada)团队为使用舍布鲁克大学的超级计算机 mp2 提供的支持。mp2 超级计算机的运行经费由加拿大创新基金会(CFI)、魁北克经济、科学与创新部(MESI)以及魁北克自然科学与技术研究基金会(FRQ-NT)共同资助。用于部分蛋白质组学计算的 Galaxy 服务器部分由德国合作研究中心 992 医学表观遗传学(DFG 基金 SFB 992/1 2012)以及德国联邦教育与研究部(BMBF 基金 031 A538A/A538C RBC、031L0101B/031L0101C de.NBI-epi、031L0106 de.STAIR (de.NBI))资助。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| OpenProt 网站 | 开源 | 不适用 | www.openprot.org |
| Galaxy 服务器 | 开源 | 不适用 | https://usegalaxy.eu/ |
| TOPPview 软件 | 开源 | 不适用 | www.openms.de |
参考文献
- Kim, M. S., et al. A draft map of the human proteome. Nature. 509 (7502), 575-581 (2014).
- Wilhelm, M., et al. Mass-spectrometry-based draft of the human proteome. Nature. 509 (7502), 582-587 (2014).
- Hein, M. Y., et al. A human interactome in three quantitative dimensions organized by stoichiometries and abundances. Cell. 163 (3), 712-723 (2015).
- Huttlin, E. L., et al. The BioPlex Network: A Systematic Exploration of the Human Interactome. Cell. 162 (2), 425-440 (2015).
- Huttlin, E. L., et al. Architecture of the human interactome defines protein communities and disease networks. Nature. 545 (7655), 505-509 (2017).
- Kumar, D., Yadav, A. K., Dash, D. Choosing an Optimal Database for Protein Identification from Tandem Mass Spectrometry Data. Proteome Bioinformatics. , 17-29 (2017).
- Jeong, K., Kim, S., Bandeira, N. False discovery rates in spectral identification. BMC Bioinformatics. 13 (Suppl 16), (2012).
- Brunet, M. A., Levesque, S. A., Hunting, D. J., Cohen, A. A., Roucou, X. Recognition of the polycistronic nature of human genes is critical to understanding the genotype-phenotype relationship. Genome Research. , (2018).
- Brent, M. R. Genome annotation past, present, and future: how to define an ORF at each locus. Genome Research. 15 (12), 1777-1786 (2005).
- Harrow, J., et al. GENCODE: The reference human genome annotation for The ENCODE Project. Genome Research. 22 (9), 1760-1774 (2012).
- Samandi, S., et al. Deep transcriptome annotation enables the discovery and functional characterization of cryptic small proteins. eLife. 6, e27860 (2017).
- Saghatelian, A., Couso, J. P. Discovery and characterization of smORF-encoded bioactive polypeptides. Nature Chemical Biology. 11 (12), 909-916 (2015).
- Delcourt, V., Staskevicius, A., Salzet, M., Fournier, I., Roucou, X. Small Proteins Encoded by Unannotated ORFs are Rising Stars of the Proteome, Confirming Shortcomings in Genome Annotations and Current Vision of an mRNA. Proteomics. , (2017).
- Plaza, S., Menschaert, G., Payre, F. In Search of Lost Small Peptides. Annual Review of Cell and Developmental Biology. 33 (1), (2017).
- Brunet, M. A., et al. OpenProt: a more comprehensive guide to explore eukaryotic coding potential and proteomes. Nucleic Acids Research. , (2018).
- Afgan, E., et al. The Galaxy platform for accessible, reproducible and collaborative biomedical analyses: 2016 update. Nucleic Acids Research. 44 (W1), W3-W10 (2016).
- Afgan, E., et al. The Galaxy platform for accessible, reproducible and collaborative biomedical analyses: 2018 update. Nucleic Acids Research. 46, W537-W544 (2018).
- Sturm, M., et al. OpenMS – An open-source software framework for mass spectrometry. BMC Bioinformatics. 9 (1), 163(2008).
- Carithers, L. J., et al. A Novel Approach to High-Quality Postmortem Tissue Procurement: The GTEx Project. Biopreservation and Biobanking. 13 (5), 311-319 (2015).
- Aebersold, R., Mann, M. Mass spectrometry-based proteomics. Nature. 422 (6928), 6928(2003).
- Domon, B., Aebersold, R. Mass Spectrometry and Protein Analysis. Science. 312 (5771), 212-217 (2006).
- Hu, J., Coombes, K. R., Morris, J. S., Baggerly, K. A. The importance of experimental design in proteomic mass spectrometry experiments: Some cautionary tales. Briefings in Functional Genomics. 3 (4), 322-331 (2005).
- Wu, P. Y., Phan, J. H., Wang, M. D. Assessing the impact of human genome annotation choice on RNA-seq expression estimates. BMC Bioinformatics. 14 (11), S8(2013).
- Mellacheruvu, D., et al. The CRAPome: a contaminant repository for affinity purification-mass spectrometry data. Nature Methods. 10 (8), 730-736 (2013).
- Adusumilli, R., Mallick, P. Data Conversion with ProteoWizard msConvert. Proteomics: Methods and Protocols. , 339-368 (2017).
- French, W. R., et al. Wavelet-Based Peak Detection and a New Charge Inference Procedure for MS/MS Implemented in ProteoWizard’s msConvert. Journal of Proteome Research. 14 (2), 1299-1307 (2015).
- Kuenzi, B. M., et al. APOSTL: An Interactive Galaxy Pipeline for Reproducible Analysis of Affinity Proteomics Data. Journal of Proteome Research. 15 (12), 4747-4754 (2016).
- Hoekman, B., Breitling, R., Suits, F., Bischoff, R., Horvatovich, P. msCompare: a framework for quantitative analysis of label-free LC-MS data for comparative candidate biomarker studies. Molecular & Cellular Proteomics: MCP. 11 (6), (2012).
- Bjornson, R. D., et al. X!!Tandem, an improved method for running X!tandem in parallel on collections of commodity computers. Journal of Proteome Research. 7 (1), 293-299 (2008).
- Kim, S., Pevzner, P. A. MS-GF+ makes progress towards a universal database search tool for proteomics. Nature Communications. 5, 5277(2014).
- Vaudel, M., Barsnes, H., Berven, F. S., Sickmann, A., Martens, L. SearchGUI: An open-source graphical user interface for simultaneous OMSSA and X!Tandem searches. Proteomics. 11 (5), 996-999 (2011).
- Shteynberg, D., Nesvizhskii, A. I., Moritz, R. L., Deutsch, E. W. Combining results of multiple search engines in proteomics. Molecular & Cellular Proteomics: MCP. 12 (9), 2383-2393 (2013).
- Bittremieux, W., et al. Quality control in mass spectrometry-based proteomics. Mass Spectrometry Reviews. 37 (5), 697-711 (2018).
- Bertsch, A., Gröpl, C., Reinert, K., Kohlbacher, O. OpenMS and TOPP: Open Source Software for LC-MS Data Analysis. Data Mining in Proteomics: From Standards to Applications. , 353-367 (2011).
- Pfeuffer, J., et al. OpenMS – A platform for reproducible analysis of mass spectrometry data. Journal of Biotechnology. 261, 142-148 (2017).
- Kozak, M. Pushing the limits of the scanning mechanism for initiation of translation. Gene. 299 (1-2), 1-34 (2002).
- Noderer, W. L., et al. Quantitative analysis of mammalian translation initiation sites by FACS-seq. Molecular Systems Biology. 10, 748(2014).
- Eyckerman, S., et al. Intelligent Mixing of Proteomes for Elimination of False Positives in Affinity Purification-Mass Spectrometry. Journal of Proteome Research. 15 (10), 3929-3937 (2016).
- Vizcaíno, J. A., et al. 2016 update of the PRIDE database and its related tools. Nucleic Acids Research. 44 (D1), D447-D456 (2016).
- Bateman, A., et al. UniProt: the universal protein knowledgebase. Nucleic Acids Research. 45 (D1), D158-D169 (2017).
- The Gene Ontology Consortium Expansion of the Gene Ontology knowledgebase and resources. Expansion of the Gene Ontology knowledgebase and resources. Nucleic Acids Research. 45 (D1), D331-D338 (2017).
- O’Leary, N. A., et al. Reference sequence (RefSeq) database at NCBI: current status, taxonomic expansion, and functional annotation. Nucleic Acids Research. 44, D733-D745 (2016).
- Zerbino, D. R., et al. Ensembl 2018. Nucleic Acids Research. 46 (D1), D754-D761 (2018).
- Andreev, D. E., et al. Translation of 5’ leaders is pervasive in genes resistant to eIF2 repression. eLife. 4, e03971(2015).
- Jackson, R., et al. The translation of non-canonical open reading frames controls mucosal immunity. Nature. 564, 434-438 (2018).
重印与许可
