一种名为miRDeep-P2(简称miRDP2)的生物信息学分析流程,采用了更新的植物miRNA标准并重构了算法,能够准确高效地分析植物中的microRNA转录组,尤其适用于基因组复杂且庞大的物种。
需要JoVE订阅才能观看此内容。 请登录或开始免费试用
方法文章
一种准确高效分析植物microRNA转录组的生物信息学流程
* These authors contributed equally
本文内容
摘要
摘要
microRNA(miRNA)是一类长度为20至24个核苷酸(nt)的内源性小RNA(sRNA),广泛存在于植物和动物中,在转录后水平上对基因表达起着重要的调控作用。过去十年中,通过高通量测序(NGS)方法对sRNA文库进行测序已被广泛用于鉴定和分析miRNA转录组,从而极大地促进了miRNA的发现。然而,随着sRNA测序文库深度的增加以及植物基因组在大小和复杂性上的提升,植物miRNA注释面临两个主要挑战。首先,许多其他类型的sRNA,特别是来自sRNA文库的短干扰RNA(siRNA),常被多种计算工具错误地注释为miRNA。其次,对于具有大而复杂基因组的植物物种,miRNA转录组的分析过程变得极为耗时。为应对这些挑战,我们近期将广泛使用的miRNA转录组分析工具miRDeep-P升级为miRDeep-P2(简称miRDP2),通过引入新的过滤策略、全面优化打分算法,并整合最新更新的植物miRNA注释标准。我们在五种基因组复杂性逐步增加的代表性植物——拟南芥、水稻、番茄、玉米和小麦的sRNA测序数据上测试了miRDP2。结果表明,miRDP2能够以极高的效率完成这些分析任务。此外,在灵敏度和准确性方面,miRDP2的表现优于其他预测工具。综上所述,我们的研究结果证明miRDP2是一种快速且准确的植物miRNA转录组分析工具,有助于科研界更精准地完成植物miRNA的注释工作。
引言
过去二十年中,生物学领域最令人振奋的发现之一是sRNA在调控基因组多种功能方面日益凸显的作用1。其中,miRNA是真核生物中一类重要的20至24个核苷酸长度的sRNA,主要作为关键的基因调控因子,在整个生命周期的发育阶段以及对刺激和胁迫反应中发挥转录后水平的调控作用2,3。在植物中,miRNA来源于被称为pri-miRNA的初级转录本,这些转录本通常由RNA聚合酶II作为独立的转录单位进行转录4,5。pri-miRNA通过进化上保守的细胞机制(动物中为Drosha RNase III,植物中为DICER-like蛋白)进行加工,被剪切为直接的miRNA前体pre-miRNA,后者包含可形成分子内茎环结构的序列6,7。随后,pre-miRNA被进一步加工为双链中间产物,即miRNA双链体(miRNA duplex),由具有功能的成熟miRNA链和较少发挥功能的互补链miRNA*组成2,8。成熟miRNA被装载到RNA诱导的沉默复合体(RISC)后,可通过序列互补性识别其mRNA靶标,从而实现负向调控功能2,8。miRNA可通过使靶标转录本不稳定或抑制靶标翻译来发挥作用,但在植物中以前者为主8,9。
自从在秀丽线虫中偶然发现第一个miRNA以来 秀丽隐杆线虫10,11,大量研究致力于miRNA的鉴定及其功能分析,尤其是在高通量测序(NGS)技术出现之后。NGS方法的广泛应用极大地推动了计算工具的使用,这些工具旨在捕捉miRNA的独特特征,例如前体的茎环结构以及测序读段在成熟miRNA及其互补链miRNA*上的优先富集。因此,研究人员已在多种物种中成功鉴定了大量miRNA。基于先前描述的概率模型12我们开发了miRDeep-P13,这是首个用于从高通量测序(NGS)数据中发现植物miRNA的计算工具。miRDeep-P 特别针对植物miRNA前体长度变异较大以及存在大量同源基因家族等解析难题而设计13,14,15该程序发布后已被下载数千次,并用于注释超过40种植物物种的miRNA转录组16得益于基于NGS的工具(如miRDeep-P)的推动,公共miRNA数据库miRBase中注册的miRNA数量显著增加17,目前收录了超过 38,000 个 miRNA 条目(版本 22.1),而 2008 年仅收录约 500 个 miRNA 条目(版本 2.0)18.
然而,植物miRNA注释面临两个新的挑战。首先,过高的假阳性率严重影响了植物miRNA注释的质量16,19,原因如下:1)由于缺乏严格的miRNA注释标准,NGS sRNA文库中大量内源性小干扰RNA(siRNAs)被错误地注释为miRNA;2)对于缺乏先验miRNA信息的物种,基于NGS数据预测出的假阳性结果难以排除。以miRBase为例,Taylor等20发现公共数据库21(第21版)中约三分之一的植物miRNA条目缺乏令人信服的支持证据,甚至高达四分之三的植物miRNA家族存疑。其次,对具有大而复杂基因组的植物进行miRNA预测变得极为耗时16。为应对这些挑战,我们通过引入新的过滤策略、全面改进评分算法并整合植物miRNA注释的新标准,对miRDeep-P进行了升级,并发布了新版本miRDP2。此外,我们使用基因组大小逐步增加的NGS sRNA数据集对miRDP2进行了测试,包括拟南芥、水稻、番茄、玉米和小麦。与其他五种广泛使用的工具及其旧版本相比,miRDP2能够更快地解析这些sRNA数据,并以更高的准确性和灵敏度分析miRNA转录组。
miRDP2 软件包的内容
miRDP2 软件包包含六个有文档说明的 Perl 脚本,应由准备好的 bash 脚本按顺序运行。这六个脚本中有三个(convert_bowtie_to_blast.pl、filter_alignments.pl 和 excise_candidate.pl)继承自 miRDeep-P。其余脚本则在原始版本基础上进行了修改。以下是对这六个脚本功能的描述:
preprocess_reads.pl 对输入的序列读段进行过滤,包括过长或过短的读段(<19 nt 或 >25 nt)、与 Rfam ncRNA 序列匹配的读段,以及每百万读段数(RPM, Reads Per Million)小于 5 的读段。随后,该脚本提取与已知 miRNA 成熟序列匹配的读段。输入文件为原始的 FASTA/FASTQ 格式读段数据,以及使用 bowtie2 将读段比对至 miRNA 和 ncRNA 序列所生成的输出结果。
计算转速(RPM)的公式如下:
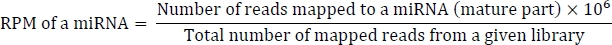
convert_bowtie_to_blast.pl 将 bowtie 格式转换为 BLAST 解析格式。BLAST 解析格式是一种自定义的制表符分隔格式,源自标准的 NCBI BLAST 输出格式。
filter_alignments.pl 用于筛选深度测序读段与基因组之间的比对结果,可过滤部分比对以及多次比对的读段(用户指定的频率阈值)。其基本输入为 BLAST 解析格式的文件。
excise_candidate.pl 利用比对好的测序读段作为指导,从参考序列中切除潜在的前体序列。基本输入为BLAST解析格式的文件和FASTA文件。输出为所有潜在前体序列的FASTA格式结果。
mod-miRDP.pl 需要两个输入文件:特征文件和结构文件,该程序通过使用植物特异性参数修改打分系统,对核心 miRDeep-P 算法进行了改进。输入文件为点括号表示的前体结构文件和读段分布特征文件。
mod-rm_redundant_meet_plant.pl 需要三个输入文件:chromosome_length、precursors 和由 mod-miRDP.pl 生成的 original_prediction。该程序生成两个输出文件:非冗余预测文件和根据最新更新的植物 miRNA 标准筛选后的预测文件。输出文件格式的详细信息见第 1.4 节。
访问受限。请登录或开始试用以查看此内容。
方案
1. 安装与测试
- 下载所需的依赖项:Bowtie222 和 RNAfold23。建议使用已编译的软件包。
- 从其官网(http://bowtie-bio.sourceforge.net/bowtie2/index.shtml)下载读段比对工具 Bowtie2。
- 从 http://www.tbi.univie.ac.at/~ivo/RNA/ 下载 Vienna 软件包中的 RNAfold 工具,用于预测 RNA 二级结构。
- 在安装 miRDP2 之前,请确保这两个依赖项已正确安装,并自定义 bash 环境文件(例如 .bashrc),为这两个依赖项设置正确的 PATH。
注意:其他比对工具(如 Bowtie24)也适用于 miRDP2;自版本 1.1.3 起,Bowtie 或 Bowtie2 均可使用。
- 要下载 miRDP2 软件包,请访问 https://sourceforge.net/projects/mirdp2/files/latest_version/ 并获取 tarball 文件。
- 在安装 miRDP2 之前,请确保 Perl 已位于 PATH 中。安装 miRDP2 时,将下载的 tarball 文件中的所有内容解压到一个文件夹中(命令行操作如 1.4.2 所示),然后将该文件夹路径添加至 PATH。
注意:建议使用至少配备 8 GB 内存和 100 GB 存储空间的计算机或计算节点来运行 miRDP2。 - 测试 miRDP2 分析流程。
- 为测试 miRDP2 是否已正确安装,请使用位于 https://sourceforge.net/projects/mirdp2/files/TestData/ 的测试数据及预期输出。测试数据包含一个格式化的 GSM 测序文件和一个 Arabidopsis thaliana 基因组文件。
- 将所有下载的文件移至当前工作目录:
mv miRDP2-v*.tar.gz TestData.tar.gz ncRNA_rfam.tar.gz <user_selected_folder>
cd <user_selected_folder> - 解压压缩的 tarball 文件:
tar –xvzf miRDP2-v*.tar.gz
tar –xvzf TestData.tar.gz
tar –xvzf ncRNA_rfam.tar.gz - 构建拟南芥基因组参考索引:
bowtie2-build -f ./TestData/TAIR10_genome.fa ./TestData/TAIR10_genome - 构建 ncRNA 参考索引:
bowtie2-build -f ./ncRNA_rfam.fa ./1.1.3/script/index/rfam_index - 运行 miRDP2 分析流程:
bash ./1.1.3/miRDP2-v1.1.3_pipeline.bash –g ./TestData/TAIR10_genome.fa -i ./TestData/TAIR10_genome –f ./TestData/GSM2094927.fa –o .
注意:所使用的 Linux 命令以粗体和斜体显示,命令行选项以斜体表示。* 表示 miRDP2 的版本(当前版本为 1.1.3)。bowtie2-build 命令大约需要 10 分钟完成,miRDP2 分析流程应在数分钟内完成。
- 检查测试输出结果。
- 注意,在 <user_selected_folder> 中会自动生成一个名为 'GSM2094927-15-0-10' 的文件夹,其中包含所有中间文件和结果。
- 检查制表符分隔的输出文件 GSM2094927-15-0-10_filter_P_prediction,该文件是预测 miRNA 的最终输出,应包含染色体 ID、链方向、代表性读段 ID、前体 ID、成熟 miRNA 位置、前体位置、成熟序列和前体序列等列。请注意,由此文件生成的附加 bed 文件可用于进一步分析。
- 检查文件“progress_log”,该文件提供已完成步骤的信息,以及包含程序输出和警告信息的文件“script_log”和“script_err”。
注意:目前我们已在两个 Linux 平台上测试了 miRDP2,包括集群服务器上的 CentOS release 6.5 和 PC Windows 系统上的 Cygwin 2.6.0,miRDP2 应可在支持 Perl 的类似系统上正常运行。
2. 鉴定新miRNA
- 在运行流程之前,需确保输入的测序读段已预处理为合适的格式。
注意:miRDP2 的新版本 1.1.3 可以接受原始 FASTQ 格式文件作为输入,尽管读段的格式化处理仍按之前版本的方式进行。- 首先,去除深 sequencing 读段 5' 和 3' 末端的接头序列(如果存在)。
- 第二,将深度测序读段解析为FASTA格式。
- 第三,去除冗余,使序列相同的读段仅以一条唯一的 FASTA 条目表示。
- 最后,确保所有 FASTA 标识符均唯一。每个序列标识符末尾必须带有“_x”及一个整数,用以表示该精确序列在深度测序数据集中被检索到的拷贝数。确保 FASTA 标识符唯一的一种方法是在标识符中包含连续编号。参考示例可查看测试数据中的文件 GSM2094927.fahttps://sourceforge.net/projects/mirdp2/files/TestData/).
- 请参见以下正确格式化测序读段的示例:
>read0_x29909
TTTGGATTGAAGGGAGCTCTA
>read1_x36974
TTCCACAGCTTTCTTGAACTG
>read2_x32635
TTCCACAGCTTTCTTGAACTT
- 构建参考索引。
- 对于基因组参考序列,为节省时间,可从 iGenomes 网站下载 Bowtie2 索引文件https://support.illumina.com/sequencing/sequencing_software/igenome.html)如果目标物种的基因组序列已被建立索引。否则,用户需对参考序列进行索引,并保留索引文件直至项目完成,因为基因组序列可能需要重新索引。有关如何对基因组参考序列进行索引的详细信息,请参见 bowtie2 手册(http://bowtie-bio.sourceforge.net/bowtie2/manual.shtml).
- 另一个非miRNA的非编码RNA索引也需用于过滤来自其他非编码RNA片段的噪声序列。该文件包含来自Rfam的主要非编码RNA序列集合,包括rRNA、tRNA、snRNA和snoRNA。构建此索引请参考第1.4部分,索引应正确放置并命名,即 <miRDP2_version>/script/index/rfam_index.
- 运行 miRDP2。
- 使用 miRDP2 从深度测序数据中检测新 miRNA 时,运行软件包中的 bash 脚本以启动分析流程(示例见步骤 1.4):
<path_to_miRDP2_folder>/miRDP2-v*.*_pipeline.bash –g <genome_file> - i <path_to_index/index_prefix> -f <seq_file > -o <output_folder>
其中 * 表示管道 bash 脚本的版本。有三个可修改的参数:1) 一条读段可比对到的不同位置数量,2) 运行 bowtie2 时允许的错配数,3) 每百万读段数(RPM, Reads Per Million)的阈值。分别使用 –L、-M 和 –R 选项进行修改。详细说明见第 3.1 节。
- 使用 miRDP2 从深度测序数据中检测新 miRNA 时,运行软件包中的 bash 脚本以启动分析流程(示例见步骤 1.4):
- 检查 miRDP2 的输出结果。
- 请注意,输出文件夹将自动生成于 <output_folder>,并命名为 '<seq_file_name>-15-0-10’;最后3个数字分别表示参数1、2和3的取值(此处为默认值)。该文件 <seq_file_name>_filter_P_prediction 包含满足新更新的植物 miRNA 注释标准的最终预测 miRNA 的信息。输出文件格式的详细说明见第 1.4 部分。
3. 使用 miRDP2 的修改说明与注意事项
- 可修改的参数
- 使用“-L”选项设置一条读段最多可比对到的位点数量(参数1)。比对到过多位点的读段可能与重复序列相关,不太可能是miRNA。默认值为15。对于特定物种,如果存在多个成员的miRNA家族,可根据基因组特征手动增加第一个参数以适应基因组情况。
- 使用“-M”选项设置bowtie允许的错配数(参数2)。默认值为0。
- 使用“-R”选项设置可能对应于成熟miRNA的读段丰度阈值(参数3)。为了减少耗时和假阳性,可通过每百万总读段中标准化计数(RPM)进行过滤。只有RPM超过特定阈值的读段才可能代表真正的成熟miRNA序列,而非背景噪音,才会被保留用于后续分析。默认值为10 RPM。
- 请注意,修改这些参数可能会影响分析性能和运行时间。通常情况下,增加参数1和参数2,或降低参数3,会导致结果更宽松、运行时间更长;反之则结果更严格、运行时间更短。
- 冗余性与miRNA*
- 请注意,miRDP2输出的miRNA可能与已知miRNA存在差异。我们发现这主要由两个原因导致:成熟miRNA的异质性,或miRNA与miRNA*的相对丰度差异。我们发现这些差异不会影响前体序列最优长度的选择,也不会影响已知miRNA基因的表达谱分析。
访问受限。请登录或开始试用以查看此内容。
结果
本文所述的miRNA注释流程miRDP2应用于来自5种植物物种的10个公开sRNA-seq文库,这些物种的基因组长度逐步增加,包括Arabidopsis thaliana、Oryza sativa(水稻)、Solanum lycopersicum(番茄)、Zea mays(玉米)和Triticum aestivum(小麦)(图1A)。总体而言,对每个物种,选择来自不同组织的两个代表性sRNA文库(合并为唯一序列,详见方案部分)及其索引的基因组序列作为两种输入数据(表1)。为进行比较,选用了五种miRNA计算预测工具:miRDeep-P13、miRPlant25、miR-PREFeR26、miRA27和miReNA
访问受限。请登录或开始试用以查看此内容。
讨论
随着下一代测序技术(NGS)的发展,从多种物种日益增长的小RNA测序数据中已鉴定出大量miRNA位点29,30。在集中管理的社区数据库miRBase21中,过去十年间收录的miRNA条目几乎增长了100倍。然而,与动物miRNA相比,植物miRNA具有许多独特特征,使得其鉴定和注释更为复杂13,14。
首先,植物miRNA前体在长度和结构上具有更高的变异性(补充文件2)16。与动物miRNA前体相对均一的长度(约70–90 nt)不同,植物前体的长度可相差数倍,甚至可达数百nt13,31。这种差异在预测mi...
访问受限。请登录或开始试用以查看此内容。
披露
作者无任何利益冲突需要披露。
致谢
本工作得到了北京市农林科学院(项目编号:KJCX201917、KJCX20180425 和 KJCX20180204)对 XY 的资助,以及国家自然科学基金(项目编号:31621001)对 LL 的资助。
访问受限。请登录或开始试用以查看此内容。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| 计算机/计算节点 | N/A | N/A | 需要 Perl;建议至少 8 GB 内存和 100 GB 存储空间 |
参考文献
- Ghildiyal, M., Zamore, P. D. Small silencing RNAs: an expanding universe. Nature Reviews Genetics. 10 (2), 94-108 (2009).
- Bartel, D. P. MicroRNAs: target recognition and regulatory functions. Cell. 136 (2), 215-233 (2009).
- Moran, Y., Agron, M., Praher, D., Technau, U. The evolutionary origin of plant and animal microRNAs. Nature Ecology Evolution. 1 (3), 27(2017).
- Xie, Z., et al. Expression of Arabidopsis MIRNA genes. Plant Physiology. 138 (4), 2145-2154 (2005).
- Zhao, X., Zhang, H., Li, L. Identification and analysis of the proximal promoters of microRNA genes in Arabidopsis. Genomics. 101 (3), 187-194 (2013).
- Bologna, N. G., Mateos, J. L., Bresso, E. G., Palatnik, J. F. A loop-to-base processing mechanism underlies the biogenesis of plant microRNAs miR319 and miR159. EMBO JOURNAL. 28 (23), 3646-3656 (2009).
- Rogers, K., Chen, X. Biogenesis, turnover, and mode of action of plant microRNAs. Plant Cell. 25 (7), 2383-2399 (2013).
- Voinnet, O. Origin, biogenesis, and activity of plant microRNAs. Cell. 136 (4), 669-687 (2009).
- Iwakawa, H. O., Tomari, Y. The Functions of MicroRNAs: mRNA Decay and Translational Repression. Trends in Cell Biology. 25 (11), 651-665 (2015).
- Lee, R. C., Feinbaum, R. L., Ambros, V. The C. elegans heterochronic gene lin-4 encodes small RNAs with antisense complementarity to lin-14. Cell. 75 (5), 843-854 (1993).
- Wightman, B., Ha, I., Ruvkun, G. Posttranscriptional regulation of the heterochronic gene lin-14 by lin-4 mediates temporal pattern formation in C. elegans. Cell. 75 (5), 855-862 (1993).
- Friedlander, M. R., et al. Discovering microRNAs from deep sequencing data using miRDeep. Nature Biotechnology. 26 (4), 407-415 (2008).
- Yang, X., Li, L. miRDeep-P: a computational tool for analyzing the microRNA transcriptome in plants. Bioinformatics. 27 (18), 2614-2615 (2011).
- Meyers, B. C., et al. Criteria for annotation of plant MicroRNAs. Plant Cell. 20 (12), 3186-3190 (2008).
- Yang, X., Zhang, H., Li, L. Global analysis of gene-level microRNA expression in Arabidopsis using deep sequencing data. Genomics. 98 (1), 40-46 (2011).
- Kuang, Z., Wang, Y., Li, L., Yang, X. miRDeep-P2: accurate and fast analysis of the microRNA transcriptome in plants. Bioinformatics. , (2018).
- Kozomara, A., Birgaoanu, M., Griffiths-Jones, S. miRBase: from microRNA sequences to function. Nucleic Acids Research. 47 (1), 155-162 (2019).
- Griffiths-Jones, S., Saini, H. K., van Dongen, S., Enright, A. J. miRBase: tools for microRNA genomics. Nucleic Acids Research. 36, Database issue 154-158 (2008).
- Axtell, M. J., Meyers, B. C. Revisiting Criteria for Plant MicroRNA Annotation in the Era of Big Data. Plant Cell. 30 (2), 272-284 (2018).
- Taylor, R. S., Tarver, J. E., Hiscock, S. J., Donoghue, P. C. Evolutionary history of plant microRNAs. Trends in Plant Science. 19 (3), 175-182 (2014).
- Kozomara, A., Griffiths-Jones, S. miRBase: annotating high confidence microRNAs using deep sequencing data. Nucleic Acids Research. 42, Database issue 68-73 (2014).
- Langmead, B., Salzberg, S. L. Fast gapped-read alignment with Bowtie 2. Nature Methods. 9 (4), 357-359 (2012).
- Lorenz, R., et al. ViennaRNA Package 2.0. Algorithms for Molecular Biology. 6, 26(2011).
- Langmead, B., Trapnell, C., Pop, M., Salzberg, S. L. Ultrafast and memory-efficient alignment of short DNA sequences to the human genome. Genome Biology. 10 (3), 25(2009).
- An, J., Lai, J., Sajjanhar, A., Lehman, M. L., Nelson, C. C. miRPlant: an integrated tool for identification of plant miRNA from RNA sequencing data. BMC Bioinformatics. 15, 275(2014).
- Lei, J., Sun, Y. miR-PREFeR: an accurate, fast and easy-to-use plant miRNA prediction tool using small RNA-Seq data. Bioinformatics. 30 (19), 2837-2839 (2014).
- Evers, M., Huttner, M., Dueck, A., Meister, G., Engelmann, J. C. miRA: adaptable novel miRNA identification in plants using small RNA sequencing data. BMC Bioinformatics. 16, 370(2015).
- Mathelier, A., Carbone, A. MIReNA: finding microRNAs with high accuracy and no learning at genome scale and from deep sequencing data. Bioinformatics. 26 (18), 2226-2234 (2010).
- Zhu, Q. H., et al. A diverse set of microRNAs and microRNA-like small RNAs in developing rice grains. Genome Research. 18 (9), 1456-1465 (2008).
- Fahlgren, N., et al. MicroRNA gene evolution in Arabidopsis lyrata and Arabidopsis thaliana. Plant Cell. 22 (4), 1074-1089 (2010).
- Fromm, B., et al. A Uniform System for the Annotation of Vertebrate microRNA Genes and the Evolution of the Human microRNAome. Annual Review of Genetics. 49, 213-242 (2015).
- Blevins, T., et al. Identification of Pol IV and RDR2-dependent precursors of 24 nt siRNAs guiding de novo DNA methylation in Arabidopsis. Elife. 4, 09591(2015).
- Zhai, J., et al. A One Precursor One siRNA Model for Pol IV-Dependent siRNA Biogenesis. Cell. 163 (2), 445-455 (2015).
- Werner, S., Wollmann, H., Schneeberger, K., Weigel, D. Structure determinants for accurate processing of miR172a in Arabidopsis thaliana. Current Biology. 20 (1), 42-48 (2010).
- Mateos, J. L., Bologna, N. G., Chorostecki, U., Palatnik, J. F. Identification of microRNA processing determinants by random mutagenesis of Arabidopsis MIR172a precursor. Current Biology. 20 (1), 49-54 (2010).
- Vitsios, D. M., et al. Mirnovo: genome-free prediction of microRNAs from small RNA sequencing data and single-cells using decision forests. Nucleic Acids Research. 45 (21), 177(2017).
访问受限。请登录或开始试用以查看此内容。
重印与许可
