本文建立并描述了一种由质谱引导的基因组挖掘方案。该方案基于基因组序列信息和液相色谱-串联质谱(LC-MS/MS)分析,旨在促进从复杂的微生物和植物提取物中鉴定分子。
需要JoVE订阅才能观看此内容。 请登录或开始免费试用
本文内容
摘要
摘要
天然产物所涵盖的化学空间极为广阔,且在很大程度上尚未被充分认识。因此,亟需便捷的方法来广泛评估其在自然界中的功能以及对人类潜在的益处(例如在药物发现中的应用)。本实验方案描述了基因组挖掘(GM)与分子网络(MN)相结合的方法,这两种现代技术可将全基因组测序中基因簇编码的注释信息与粗制代谢提取物中的化学结构特征相匹配,这是发现新型天然产物的第一步。本文将这两种方法的联合应用定义为质谱引导的基因组挖掘(MS-guided genome mining)。在该方法中,主要成分先前已通过分子网络(MN)确定,而结构相关的新候选分子则通过基因组挖掘(GM)与基因组序列注释相关联。结合基因组挖掘与分子网络是一种高效的策略,可用于靶向发现新分子骨架,或获取代谢谱以从已知化合物中鉴定出类似物。
引言
次级代谢研究通常包括对粗提物进行特定生物活性的筛选,随后对活性组分中的化合物进行纯化、鉴定和表征。这一流程已被证明是高效的,促进了多种化学实体的分离。然而,如今这种方法被认为难以持续,主要原因是重复发现率过高。在制药工业发展的初期,由于缺乏对特化代谢物功能和作用机制的认识,其鉴定工作是在无法真实反映自然环境的实验室条件下进行的1。如今,人们对自然环境中信号调控、分泌机制以及大多数靶标分子在极低浓度下(难以检测)的存在状态有了更深入的理解。此外,对这些过程的调控将有助于学术界和制药行业充分利用这一知识,并推动与沉默生物合成基因簇(BGCs)相关的代谢物直接分离研究的发展2。
在此背景下,基因组测序技术的进步重新激发了人们对微生物代谢产物筛选的兴趣。这是因为分析尚未被揭示的生物合成基因簇的基因组信息,可以发现编码在实验室条件下未被观察到或未被产生的新型化合物的基因。如今已有大量微生物全基因组项目或草图可供利用,且数量逐年增长,为通过基因组挖掘发现新型生物活性分子提供了广阔前景3,4。
生物合成基因簇图谱(Atlas of Biosynthetic Gene Clusters)是联合基因组研究所综合微生物基因组平台(JGI IMG-ABC)中目前规模最大的自动挖掘基因簇集合2。最近,生物合成基因簇最小信息标准(Minimum Information for Biosynthetic Gene Clusters,MIBiG)标准化倡议推动了对生物合成基因簇(BGCs)的手动重新注释,提供了一个高度审编的参考数据集5。如今,已有大量工具可用于实现遗传数据的计算挖掘及其与已知次级代谢产物的关联分析。此外,研究人员已开发出多种策略以发现新的生物活性天然产物(例如异源表达、靶基因敲除、体外重建、基因组测序、同位素引导筛选[基因组-同位素联合方法]、局部及全局调控因子的调控、基于抗性靶标的挖掘、非培养依赖型挖掘,以及近年来兴起的质谱引导/编码方法2,6,7,8,9,10,11,12,13,14,15)。
作为一种单一策略,基因组挖掘需要投入大量工作来注释单个或少数几个分子,因此在新化合物的分离和结构解析优先级确定过程中仍存在空白。原则上,这些方法每次实验仅针对一条生物合成途径,导致发现速率较慢。从这一角度来看,将基因组挖掘(GM)与分子网络分析方法相结合,代表了天然产物研究领域的重要进展14,15。
液相色谱-质谱联用技术(LC-MS)因其多功能性、高准确性和高灵敏度,成为化合物鉴定的理想方法。目前,多个平台已开发并集成了用于非靶向代谢组学的算法和软件套件。16,17,18,19,20这些程序的核心包括特征检测(峰提取)21 峰对齐,可在一批样品中匹配相同的特征并搜索模式。基于质谱模式的算法22,23 比较特征性碎裂模式并匹配质谱2 通过生成具有结构特征的分子家族来揭示相似性。这些特征可被突出并聚类,从而赋予研究人员利用串联质谱技术从复杂的生物提取物中快速发现已知和未知分子的能力。2,24,25因此,串联质谱是一种多功能方法,可同时从大量数据中获取多种化学类型的结构信息。
全球天然产物社会分子网络(Global Natural Products Social Molecular Networking, GNPS)26 算法利用归一化的碎片离子强度构建多维向量,并通过余弦函数比较其相似性。不同母离子之间的关系以图示形式呈现,其中每个碎片化谱图被可视化为一个节点(圆形),而各节点之间的关联性由边(线条)定义。来自单一来源的分子的全局可视化被称为分子网络。结构差异较大的分子若具有独特的碎裂模式,将形成各自特有的簇或星群,而结构相关的分子则会聚集在一起。对化学类型进行聚类分析,有助于假定地将相似的结构特征与其生物合成起源相关联。
将化学型到基因型和基因型到化学型两种方法相结合,在建立生物合成基因簇(BGCs)与其小分子产物之间的生物信息学关联时具有强大优势27因此,质谱引导的基因组挖掘是一种快速且消耗材料少的方法,有助于在不同代谢和环境条件下,通过一种或多种菌株的全基因组测序将母离子与生物合成途径关联起来。
本实验方案的工作流程(图1)包括将全基因组测序数据(WGS)输入生物合成基因簇注释平台(如antiSMASH28,29,30),以评估基因组所编码的化合物种类及其化合物类别。需采用一种策略,靶向编码目标化学实体的生物合成基因簇,并可利用GNPS26,31对野生型菌株和/或含有该生物合成基因簇(BGC)的异源表达菌株的培养提取物进行分析,基于相似性对离子进行聚类。由此可鉴定出与目标BGC相关、但在数据库中尚未收录的新分子(主要是未知类似物,有时产量较低)。值得注意的是,用户可为这些平台贡献数据,且随着生物信息学与串联质谱(MS/MS)数据的迅速积累,推动了高效计算工具与算法的持续发展与升级,从而更有效地将复杂提取物与分子关联起来。
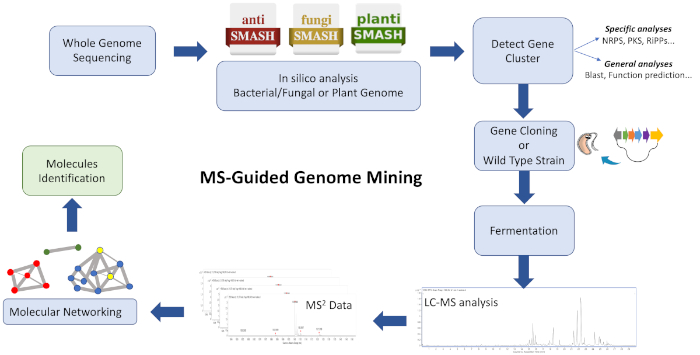
图1:整个工作流程的概述。 图示为生物信息学分析、克隆以及分子网络分析步骤的示意图,这些步骤属于所描述的质谱引导基因组挖掘方法,用于鉴定新的代谢产物。请点击此处查看该图的放大版本。
本方案描述了一种快速且高效的流程,将基因组挖掘与分子网络分析相结合,作为天然产物发现流程的起点。尽管已有多种应用能够在一个网络中可视化质谱可检测分子的组成及其相互关系,但本文采用了其中几种方法来可视化结构相似的聚类分子。利用该策略,成功鉴定出在Streptomyces sp. CBMAI 2042 的代谢提取物中观察到的新型环缩肽类产物。在基因组挖掘的指导下,识别出编码缬氨霉素的完整生物合成基因簇,并将其克隆至生产菌株Streptomyces coelicolor M1146 中。最后,基于质谱模式的分子网络分析将质谱检测到的分子与负责其生物合成的生物合成基因簇(BGCs)相关联32。
访问受限。请登录或开始试用以查看此内容。
方案
1. 生物合成基因簇的基因组挖掘
- 将全基因组测序(WGS)作为选择用于质谱引导基因组挖掘的生物合成基因簇(BCG)的第一步。可通过Illumina MiSeq技术,使用高质量的基因组DNA以及以下试剂盒制备鸟枪法TruSeq PCR-Free文库和Nextera Mate Pair文库,获得目标菌株(细菌)的全基因组草图33。
注意:测序完成后,可使用Newbler v3.0(Roche, 454)组装程序(见于 )对Illumina鸟枪法文库和Illumina配对末端文库进行组装,并采用基于FgeneSB的注释流程(见于 )进行注释,方法如前所述33。《微生物资源公告》(Microbiology Resource Announcements, MRA)是一本完全开放获取的期刊,发表存放在公开可用数据库中的各类微生物资源信息(见于 )。候选蛋白编码基因通过RAST服务器注释34进行识别,全基因组鸟枪法(WGS)项目数据已提交至DDBJ/ENA/GenBank(见于 )和Gold(见于 )序列数据库。 - 为从已完成测序的基因组中获得关于次级代谢基因簇注释的计算机预测信息,将序列文件(GenBank/EMBL或FASTA格式)提交至antiSMASH平台(见于 )。
- 根据与已知基因簇的相似性,从输出结果中选择感兴趣的基因簇(图2)。
注意:首先,常规做法是逐个基因进行分析,并开展独立的blastp搜索,以评估哪些功能与目标生物合成基因群相关。该步骤也有助于确定哪个BGC可能与目标化合物的产生相关,即使整体相似性较低。antiSMASH的预测基于簇内所有基因计算覆盖百分比,可能导致目标BGC的整体相似性百分比偏低。然而,在逐基因分析时,可借助最相似的已知基因簇获得更准确的信息。其次,antiSMASH提供两种优化搜索的选项:1)检测严格度:指生物合成基因簇被认定为有效匹配的严格程度。该选项包含以下参数:a)严格模式:仅检测包含所有必需区域的明确定义的基因簇,不易受遗传信息错误影响;b)宽松模式:可检测缺失一个或多个功能区域的部分基因簇,同时也能识别严格模式下的特征;c)松散模式:可检测定义不清的基因簇或可能与初级代谢产物匹配的基因簇,但可能导致假阳性或定义不清的BGC出现。另一选项为2)附加功能:指平台在输出结果中需搜索并展示的信息类型。通常,这两个选项可在预测后节省分析时间。然而,启用这些选项会延长antiSMASH任务的运行时间。
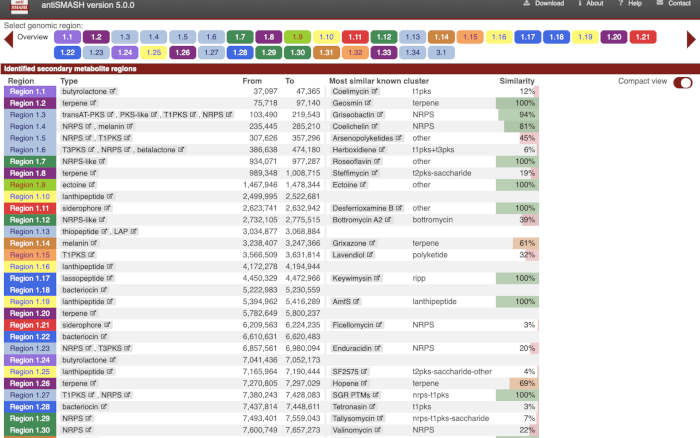
图 2:antiSMASH 平台的输出结果。 基于全基因组序列注释的次级代谢途径的生物信息学分析。 请点击此处查看该图的放大版本。
- 根据BGC的DNA序列信息,设计位于基因簇侧翼的引物(20–25 nt),用于ESAC(E. coli/Streptomyces 人工染色体)文库筛选。
注意:可采用不同方法35,36从DNA中捕获完整的生物合成基因簇。本文所用方法为构建一个来自Streptomyces sp. CBMAI 2042的代表性ESAC文库37,38,该文库包含平均片段大小约为95 kb的克隆。
2. 来自ESAC文库的整个生物合成基因簇的异源表达
- 将 ESAC 载体从 E. coli DH10B 转化为 E. coli 通过三亲本接合将质粒转入ET1256732.
- 接种 E. coli ET12567 (CamR),TOPO10/pR9604 (CarbR),DH10B/ESAC4H (AprR) 接种于 5 mL 含氯霉素的 Luria-Bertani (LB) 培养基中25 µg/mL),羧苄青霉素(carbenicillin)100 µg/mL),以及阿普拉霉素(apramycin)50 µg/mL).
- 37 °C过夜培养 37 °C 和 250 rpm。
- 接种 500 µL 过夜培养物接种于含半浓度抗生素的10 mL LB培养基中。
- 在培养箱中孵育培养物 37 °C 和 250 rpm 振荡培养至 A600 0.4–0.6
- 通过离心(2,200 x g)收集细胞 g 5 分钟。
- 用20 mL LB培养基洗涤细胞两次。
- 将细胞重悬于 500 µL LB 培养基
- 混合 20 μL 将各菌株分别加入微量离心管中,滴加至不含抗生素的LB培养基琼脂平板上。
- 将培养板置于培养箱中孵育 37 °C 过夜。
- 将培养的细胞划线接种于含抗生素的新鲜LB琼脂平板上,于37°C培养 37 °C 过夜。
3. 链霉菌/大肠杆菌 接合转化
- 为获得重组异源生物体,需在含有ESAC载体和辅助质粒pR9604的E. coli ET12567与Streptomyces coelicolor M1146或其他选定宿主菌株之间进行接合3239。
- 第1天:将S. coelicolor M1146的单菌落接种于装有不锈钢弹簧的250 mL三角瓶中的25 mL TSBY培养基中,在30 °C、200 rpm条件下培养48小时。
- 第2/3天:将ET12567/ESAC/pR9604接种于5 mL LB培养基中,培养基中添加氯霉素(25 µg/mL)、羧苄青霉素(100 µg/mL)和安普霉素(50 µg/mL),在37 °C、250 rpm条件下过夜培养。
- 第3/4天:取500 µL过夜培养物接种至含半工作浓度抗生素的10 mL 2TY培养基(置于50 mL锥形管中),在37 °C、250 rpm条件下培养至A600达到0.4–0.6。
- 将培养物(ET12567/ESAC/pR9604和M1146)在2200 x g条件下离心10分钟。
- 用20 mL 2TY培养基将沉淀洗涤两次,并重悬于500 µL 2TY培养基中。
- 取200 µL S. coelicolor M1146菌悬液,加入500 µL 2TY培养基进行稀释(悬液A)。
- 取200 µL悬液A,加入500 µL 2TY培养基进行稀释(悬液B)。
- 取200 µL悬液B,加入500 µL 2TY培养基进行稀释(悬液C)。
- 取200 µL ET12567/ESAC/pR9604菌悬液,与200 µL悬液C混合。
- 取150 µL接合混合液涂布于不含抗生素的SFM琼脂平板上。
- 在30 °C条件下培养16小时。
- 用1 mL抗生素溶液(根据质粒抗性选择)覆盖平板。待溶液干燥后,在30 °C条件下继续培养4–7天。
注:此处使用含硫链丝菌素1.0 mg/mL和萘啶酸0.5 mg/mL的溶液。 - 将疑似转化子划线接种至含硫链丝菌素(50 mg/mL)和萘啶酸(25 mg/mL)的SFM琼脂平板上,在30 °C条件下培养。
- 将转化子划线接种至仅含萘啶酸的SFM琼脂平板上。
- 对分离的单菌落进行PCR分析,以确认整个基因簇已成功转移至S. coelicolor M1146宿主中。
4. 菌株培养
- 为获得代谢谱,将菌株预培养物的1/100接种于适当的发酵培养基中,并在适宜的培养条件下进行培养。
- 在2200 × g 条件下离心培养物10分钟。
- 根据目标化合物的类别进行提取40。
5. 质谱数据采集及GNPS分析前准备
- 为获取 MS/MS 数据,使用控制软件编写合适的 HPLC 和质谱方法。可分析高分辨率和低分辨率的数据依赖型质谱分析(DDA)。
注意:通常情况下,1 mg/mL 的复杂粗提物样品溶液最为理想。对于复杂性较低的提取物,需要进行稀释。需注意,MS/MS 网络是在给定质谱条件下可检测到的分子网络。 - 使用 ProteoWizard 中的 MSConvert(位于 )将质谱数据转换为 .mzXML 格式。转换的输入参数如 图 3 所示。几乎所有公司软件生成的数据均兼容。
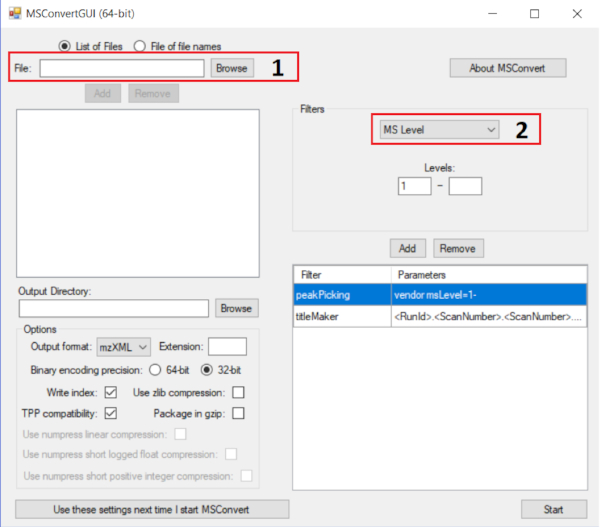
图 3:使用 MsConvert 将质谱文件转换为 mzXML 扩展名。 图中显示了用于 GNPS 分析的正确参数。操作步骤如下:在框 1 中添加所有质谱文件,并在框 2 中添加峰提取滤波器;对于此滤波器,请使用厂商算法;点击开始,随后将执行转换过程。请点击此处查看该图的放大版本。
- 将转换后的 LC-MS/MS 文件上传至 GNPS 数据库。有两种可选方式:使用文件传输协议(FTP)或通过在线平台直接在浏览器中上传。
注意:有关如何安装和向 GNPS 传输数据的详细信息,请访问 。
6. GNPS 分析
- 在GNPS网站(网址为 )创建账户后,登录该账户并选择创建分子网络,然后添加作业标题。
- 基本选项:选择用于构建分子网络的 mzXML 文件。这些文件最多可划分为六组。选择用于去重复分析的数据库(图4)。
注意:这些分组不会影响分子网络的构建过程,仅用于图形化展示。
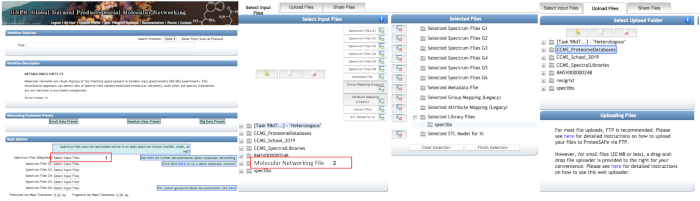
图 4:使用在线 GNPS 平台进行分子网络分析。 通过点击区域 1 完成 mzXML 文件的选择。在弹出的对话框中,可以从个人文件夹(区域 2)中选择文件,或在第二个标签页中使用拖放式文件上传器上传文件(小于 20 MB)。文件最多可分组为六组。 请点击此处查看此图的放大版本。
- 选择前体离子质量容差和碎片离子质量容差分别为 0.02 Da 和 0.05 Da。
注意:GNPS 提供不同严格程度的选项,具体取决于:1)MS/MS 数据的准确性;2)关联结果所需的准确程度。基本选项:在此文件夹中,可设置前体离子质量容差和碎片离子质量容差。这些参数用于指导确定前体离子和碎片离子所需达到的精确程度。所选的质量容差取决于所用质谱仪的分辨率和准确性。 - 高级网络参数:根据图 5选择相应参数。这些参数直接影响分子网络中聚类的大小和形态。其余标签页中的其他参数适用于高级用户,因此请保留默认值。
注意:高级参数的详细说明可在 GNPS 官方文档中查阅(网址:)。
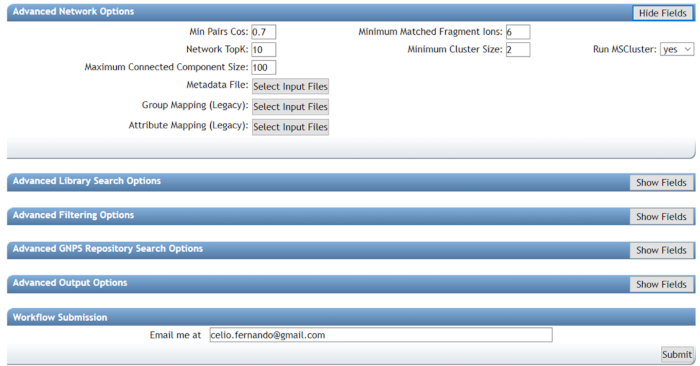
图5:使用GNPS进行分子网络分析(高级选项)。 最小配对余弦值(Min Pair Cos)将直接影响聚类的大小,较高的值会导致密切相关化合物被合并,而较低的值则会使远缘相关化合物被合并。应避免使用过低的数值。最小匹配碎片离子数表示两个碎片谱图在网络中连接所需共享的碎片数量。这两个参数共同决定了网络的结构:数值越低,越倾向于将远缘相关的化合物聚为一类,反之亦然。合理设置这些参数将极大有助于化合物的解析。请点击此处查看该图的放大版本。
- 选择一个电子邮件地址,以便在工作完成后接收提醒,然后提交任务。
7. GNPS 结果分析
- 登录 GNPS,依次选择 Jobs > Published job > Done 以打开任务。页面将如 图6 所示打开,所有通过分子网络分析获得的结果将在此显示。
- 选择 View Spectral Families (In Browser Network Visualizer) 以查看所有网络聚类(红色框,图6)。
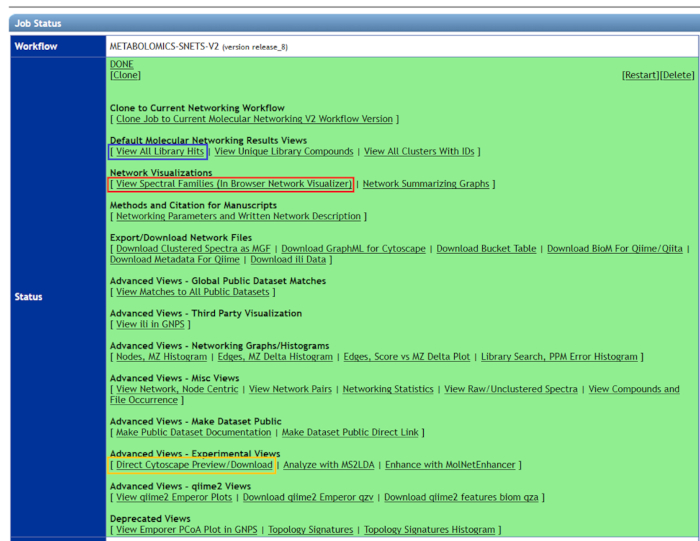
图6:使用GNPS可视化分子网络结果。 所有相关的化合物簇可在“谱图家族”视图中查看(红框)。若仅可视化文库匹配结果,应选择“查看所有文库匹配”(蓝框)。为了更佳地图形化展示分子网络结果,应下载“直接Cytoscape预览”(黄框),并使用最新版本的Cytoscape软件。请点击此处查看此图的放大版本。
- 将显示一个包含所有生成的分子网络簇的列表。如果已选择进行文库检索以生成结果,则在 AllIDs 中会显示暂定的分子鉴定结果。选择 显示 以查看这些结果。
注意:数据分析也可基于其他结果进行(例如基因组挖掘、生物活性测定、文库去重分子等)。 - 要分析分子网络簇,请选择 可视化网络。
注意:每个簇由节点(圆形)和边组成,分别代表分子及其分子相似性。在在线浏览器网络可视化工具中,去重后的分子将以蓝色节点突出显示。 - 在节点标签框中,选择 母体质量(红色框,图7)。
- 在边标签框中,分别选择 余弦值 或 DeltaMZ,以观察节点间的相似性或节点之间的质量差异(黄色框,图7)。
- 对于多组分析情况,可在节点着色框中点击 绘制饼图,以观察每个节点在各组中出现的频率(蓝色框,图7)。
注意:也可选择其他选项,但上述建议的设置最适用于注释簇节点并解析其结构。
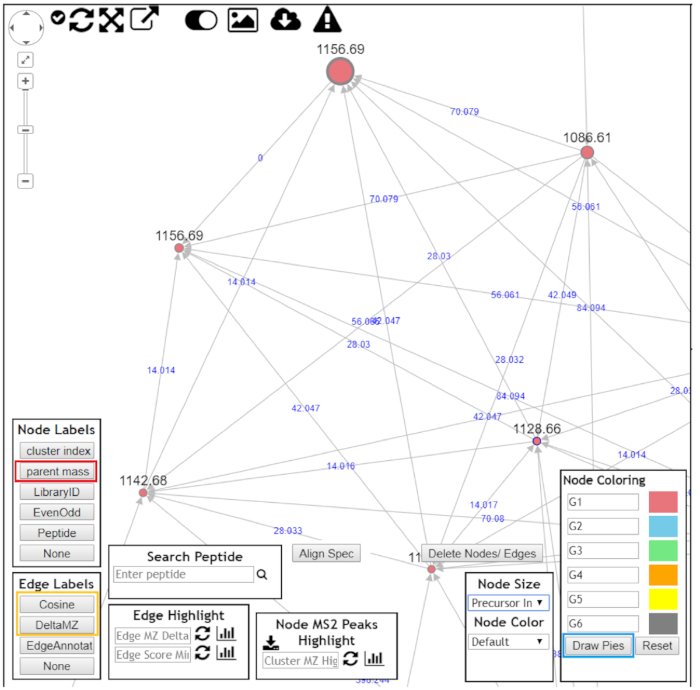
图 7:使用 GNPS 可视化分子聚类结果。 打开分子聚类以获得更好的数据可视化效果后,应选择以下选项:“Parent mass”作为节点标签(红色框);“DeltaMZ”作为边标签(黄色框);以及“Draw pies”作为节点着色(蓝色框)。浏览分子聚类图,并尝试注释所有节点。请点击此处查看该图的放大版本。
- 要查看所有文库匹配结果,请选择 查看所有文库匹配结果(蓝色框,图7)。
注意:此外,分子网络(MNW)可通过“直接在 Cytoscape 中预览/下载”(黄色框,图7)进行下载,并可在 Cytoscape 平台(网址:)中打开,以获得更丰富的图形结构分析选项。 - 需要对去重复化化合物进行人工确认,并对相关化合物进行结构解析。可直接在 GNPS 平台或原始的原始数据文件中打开碎片质谱图。
访问受限。请登录或开始试用以查看此内容。
结果
本研究通过结合基因组挖掘、异源表达以及质谱引导/编码方法,成功实现了对新型缬氨霉素类似物分子的获取。目标分子缬氨霉素(VLM)的“从基因组到分子”工作流程如图8所示。Streptomyces sp. CBMAI 2042的基因组草图经计算机分析后,鉴定出VLM基因簇并将其转移至异源宿主中。异源表达菌株与野生型菌株在适当的发酵条件下进行三重复培养,经乙酸乙酯萃取并浓缩后获得粗提物。对产物进行MS/MS检测,以生成串联质谱代谢物谱图用于分子网络分析。图9展示了来自Streptomyces sp. CBMAI 2042粗提物的MS/MS数据所获得的聚类离子,其中特征性裂解模式及相应的质谱相似性提示存在具有共同结构特征的分子家族2。基于已知的生物合成逻辑和生物信息学分析,并结合基于模式的MS/MS谱图,解析了四种首次报道的环缩肽酯类化合物的结构,并将其来源关联至负责VLM组装的相同生物合成基因簇32
访问受限。请登录或开始试用以查看此内容。
讨论
该方案最主要的优点在于能够快速去除代谢谱中的重复信息,并将基因组信息与质谱数据相结合,从而阐明新分子的结构,特别是结构类似物2。基于基因组信息,可研究多种天然产物的化学类型,如聚酮类(PK)、非核糖体肽类(NRP)、糖基化天然产物(GNP)以及隐性生物合成基因簇(BGC)。代谢组学筛选可提供证据,显示特定菌株在实验室条件下激活的BGC谱型及其产生的化学多样性。因此,可通过分子网络分析发现的相似性,克隆相应的BGC以定向生产新化合物,或获得与已知BGC相关的未知类似物。该方法有助于区分天然来源中有价值的化合物,并可为天然产物研究流程中常见的后续分离步骤提供指导。
基于质谱的基因组挖掘最初在肽类基因组学41和糖类基因组学42领域被描述。为了评估肽类天然产物化学多样性的范围,Dorrestein 及其同事开发了一种自动化方法,结合质谱(MS)与基因组学,用于可视化已表达的天然产物(化学型)与其基因簇(基因型)之间的关联。随后,该基于质谱的基因组挖...
访问受限。请登录或开始试用以查看此内容。
披露
作者无任何利益冲突需要披露。
致谢
本研究的经费由圣保罗研究基金会 - FAPESP(项目编号:2019/10564-5、2014/12727-5 和 2014/50249-8,授予 L.G.O;项目编号:2013/12598-8 和 2015/01013-4,授予 R.S.;项目编号:2019/08853-9,授予 C.F.F.A)提供。B.S.P、C.F.F.A. 和 L.G.O. 获得了国家科学技术发展委员会 - CNPq 的博士后奖学金资助(项目编号:205729/2018-5、162191/2015-4 和 313492/2017-4)。L.G.O. 还感谢“女性参与科学计划”(2008 年巴西版)提供的项目资助。所有作者均感谢巴西高等教育人员改进协调办公室(CAPES)对巴西研究生项目的资助支持。
访问受限。请登录或开始试用以查看此内容。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| 乙腈 | Tedia | AA1120-048 | HPLC 级 |
| 琼脂 | Oxoid | LP0011 | NA |
| 阿普拉霉素 | Sigma Aldrich | A2024 | NA |
| 羧苄青霉素 | Sigma Aldrich | C9231 | NA |
| 离心机 | Eppendorf | NA | 5804 |
| 氯霉素 | Sigma Aldrich | C3175 | NA |
| C18 柱 | Agilent Technologies | NA | ZORBAX RRHD Extend-C18, 80Å, 2.1 x 50 mm, 1.8 µm, 1200 bar 压力上限 P/N 757700-902 |
| 卡那霉素 | Sigma Aldrich | K1377 | NA |
| 甘露醇 P.A.- A.C.S. | Synth | NA | NA |
| 微量离心机 | Eppendorf | NA | 5418 |
| 萘啶酸 | Sigma Aldrich | N4382 | NA |
| Phusion Flash 高保真 PCR 预混液 | ThermoFisher Scientific | F548S | NA |
| Q-TOF 质谱仪 | Agilent technologies | NA | 6550 iFunnel Q-TOF LC/MS |
| 蔗糖 P.A.- A.C.S. | Synth | NA | NA |
| 摇床/培养箱 | Marconi | MA420 | NA |
| 氯化钠 | Synth | NA | P. A. - ACS |
| 大豆提取物 | NA | NA | NA |
| 蔗糖 | Synth | NA | P. A. - ACS |
| 热循环仪 | Eppendorf | NA | Mastercycler Nexus Gradient |
| 硫链丝菌素 | Sigma Aldrich | T8902 | NA |
| 胰蛋白胨 | Oxoid | LP0042 | NA |
| 胰蛋白胨大豆肉汤 | Oxoid | CM0129 | NA |
| 超高效液相色谱 | Agilent Technologies | NA | 1290 Infinity LC 系统 |
| 酵母提取物 | Oxoid | LP0021 | NA |
参考文献
- Davies, J. Specialized microbial metabolites: functions and origins. The Journal of Antibiotics. 66 (7), Tokyo. 361-364 (2013).
- Ziemert, N., Alanjary, M., Weber, T. The evolution of genome mining in microbes - a review. Natural Product Reports. 33 (8), 988-1005 (2016).
- Zerikly, M., Challis, G. L. Strategies for the Discovery of New Natural Products by Genome Mining. ChemBioChem. 10 (4), 625-633 (2009).
- Gomez-Escribano, J. P., Bibb, M. J. Heterologous expression of natural product biosynthetic gene clusters in Streptomyces coelicolor: from genome mining to manipulation of biosynthetic pathways. Journal of Industrial Microbiology & Biotechnology. 41 (2), 425-431 (2014).
- Medema, M. H., et al. Minimum Information about a Biosynthetic Gene cluster. Nature Chemical Biology. 11 (9), 625-631 (2015).
- Lautru, S., Deeth, R. J., Bailey, L. M., Challis, G. L. Discovery of a new peptide natural product by Streptomyces coelicolor genome mining. Nature Chemical Biology. 1 (5), 265-269 (2005).
- Chiang, Y. -M., et al. Molecular Genetic Mining of the Aspergillus Secondary Metabolome: Discovery of the Emericellamide Biosynthetic Pathway. Chemistry & Biology. 15 (6), 527-532 (2008).
- Huang, T., et al. Identification and Characterization of the Pyridomycin Biosynthetic Gene Cluster of Streptomyces pyridomyceticus NRRL B-2517. Journal of Biological Chemistry. 286 (23), 20648-20657 (2011).
- Udwary, D. W., et al. Genome sequencing reveals complex secondary metabolome in the marine actinomycete Salinispora tropica. Proceedings of the National Academy of Sciences. 104 (25), 10376-10381 (2007).
- Gross, H., et al. The Genomisotopic Approach: A Systematic Method to Isolate Products of Orphan Biosynthetic Gene Clusters. Chemistry & Biology. 14 (1), 53-63 (2007).
- Spohn, M., Wohlleben, W., Stegmann, E. Elucidation of the zinc-dependent regulation in Amycolatopsis japonicum enabled the identification of the ethylenediamine-disuccinate ([S,S ]-EDDS) genes. Environmental Microbiology. 18 (4), 1249-1263 (2016).
- Thaker, M. N., Waglechner, N., Wright, G. D. Antibiotic resistance-mediated isolation of scaffold-specific natural product producers. Nature Protocols. 9 (6), 1469-1479 (2014).
- Katz, M., Hover, B. M., Brady, S. F. Culture-independent discovery of natural products from soil metagenomes. Journal of Industrial Microbiology & Biotechnology. 43, 129-141 (2016).
- Quinn, R. A., et al. Molecular Networking as a Drug Discovery, Drug Metabolism, and Precision Medicine Strategy. Trends in Pharmacological Sciences. 38 (2), 143-154 (2017).
- Yang, J. Y., et al. Molecular Networking as a Dereplication Strategy. Journal of Natural Products. 76 (9), 1686-1699 (2013).
- Lommen, A. MetAlign: Interface-Driven, Versatile Metabolomics Tool for Hyphenated Full-Scan Mass Spectrometry Data Preprocessing. Analytical Chemistry. 81 (8), 3079-3086 (2009).
- Katajamaa, M., Miettinen, J., Oresic, M. MZmine: toolbox for processing and visualization of mass spectrometry based molecular profile data. Bioinformatics. 22 (5), 634-636 (2006).
- Pluskal, T., Castillo, S., Villar-Briones, A., Orešič, M. MZmine 2: Modular framework for processing, visualizing, and analyzing mass spectrometry-based molecular profile data. BMC Bioinformatics. 11 (1), 395(2010).
- Tautenhahn, R., Patti, G. J., Rinehart, D., Siuzdak, G. XCMS Online: A Web-Based Platform to Process Untargeted Metabolomic Data. Analytical Chemistry. 84 (11), 5035-5039 (2012).
- Kuhl, C., Tautenhahn, R., Böttcher, C., Larson, T. R., Neumann, S. CAMERA: An Integrated Strategy for Compound Spectra Extraction and Annotation of Liquid Chromatography/Mass Spectrometry Data Sets. Analytical Chemistry. 84 (1), 283-289 (2012).
- Katajamaa, M., Orešič, M. Data processing for mass spectrometry-based metabolomics. Journal of Chromatography A. 1158, 318-328 (2007).
- Liu, W. -T., et al. Interpretation of Tandem Mass Spectra Obtained from Cyclic Nonribosomal Peptides. Analytical Chemistry. 81 (11), 4200-4209 (2009).
- Ng, J., et al. Dereplication and de novo sequencing of nonribosomal peptides. Nature Methods. 6 (8), 596-599 (2009).
- Liaw, C., et al. Vitroprocines, new antibiotics against Acinetobacter baumannii, discovered from marine Vibrio sp. QWI-06 using mass-spectrometry-based metabolomics approach. Scientific Reports. 5 (1), 1-11 (2015).
- Kang, K. B., et al. Targeted Isolation of Neuroprotective Dicoumaroyl Neolignans and Lignans from Sageretia theezans Using in Silico Molecular Network Annotation Propagation-Based Dereplication. Journal of Natural Products. 81 (8), 1819-1828 (2018).
- Wang, M., et al. Sharing and community curation of mass spectrometry data with Global Natural Products Social Molecular Networking. Nature Biotechnology. 34 (8), 828-837 (2016).
- Doroghazi, J. R., et al. A roadmap for natural product discovery based on large-scale genomics and metabolomics. Nature Chemical Biology. 10 (11), 963-968 (2014).
- Medema, M. H., et al. antiSMASH: rapid identification, annotation and analysis of secondary metabolite biosynthesis gene clusters in bacterial and fungal genome sequences. Nucleic Acids Research. 39, 339-346 (2011).
- Weber, T., et al. antiSMASH 3.0-a comprehensive resource for the genome mining of biosynthetic gene clusters. Nucleic Acids Research. 43, 237-243 (2015).
- Blin, K., et al. antiSMASH 5.0: updates to the secondary metabolite genome mining pipeline. Nucleic Acids Research. 47, 81-87 (2019).
- Watrous, J., et al. Mass spectral molecular networking of living microbial colonies. Proceedings of the National Academy of Sciences. 109 (26), 1743-1752 (2012).
- Paulo, B. S., Sigrist, R., Angolini, C. F. F., De Oliveira, L. G. New Cyclodepsipeptide Derivatives Revealed by Genome Mining and Molecular Networking. ChemistrySelect. 4 (27), 7785-7790 (2019).
- Gonzaga de Oliveira, L., Sigrist, R., Sachetto Paulo, B., Samborskyy, M. Whole-Genome Sequence of the Endophytic Streptomyces sp. Strain CBMAI 2042, Isolated from Citrus sinensis. Microbiology Resource Announcements. 8 (2), 1-2 (2019).
- Aziz, R. K., et al. The RAST Server: Rapid Annotations using Subsystems Technology. BMC Genomics. 9 (1), 75(2008).
- Nah, H. -J., Pyeon, H. -R., Kang, S. -H., Choi, S. -S., Kim, E. -S. Cloning and Heterologous Expression of a Large-sized Natural Product Biosynthetic Gene Cluster in Streptomyces Species. Frontiers in Microbiology. 8, 1-10 (2017).
- Zhang, J. J., Tang, X., Moore, B. S. Genetic platforms for heterologous expression of microbial natural products. Natural Product Reports. 36 (9), 1313-1332 (2019).
- Alduina, R., et al. Artificial chromosome libraries of Streptomyces coelicolor A3(2) and Planobispora rosea. FEMS Microbiology Letters. 218 (1), 181-186 (2003).
- Jones, A. C., et al. Phage P1-Derived Artificial Chromosomes Facilitate Heterologous Expression of the FK506 Gene Cluster. PLoS One. 8 (7), 69319(2013).
- Gomez-Escribano, J. P., Bibb, M. J. Engineering Streptomyces coelicolor for heterologous expression of secondary metabolite gene clusters. Microbial Biotechnology. 4 (2), 207-215 (2011).
- Cannell, R. J. P. Natural Products Isolation. , Humana Press. Totowa, NJ. (1998).
- Kersten, R. D., et al. A mass spectrometry-guided genome mining approach for natural product peptidogenomics. Nature Chemical Biology. 7 (11), 794-802 (2011).
- Kersten, R. D., et al. Glycogenomics as a mass spectrometry-guided genome-mining method for microbial glycosylated molecules. Proceedings of the National Academy of Sciences. 110 (47), 4407-4416 (2013).
- Liu, W., et al. MS/MS-based networking and peptidogenomics guided genome mining revealed the stenothricin gene cluster in Streptomyces roseosporus. The Journal of Antibiotics. 67 (1), Tokyo. 99-104 (2014).
- Duncan, K. R., et al. Molecular Networking and Pattern-Based Genome Mining Improves Discovery of Biosynthetic Gene Clusters and their Products from Salinispora Species. Chemistry & Biology. 22 (4), 460-471 (2015).
- Cao, L., et al. MetaMiner: A Scalable Peptidogenomics Approach for Discovery of Ribosomal Peptide Natural Products with Blind Modifications from Microbial Communities. Cell Systems. , (2019).
- Chen, L. -Y., Cui, H. -T., Su, C., Bai, F. -W., Zhao, X. -Q. Analysis of the complete genome sequence of a marine-derived strain Streptomyces sp. S063 CGMCC 14582 reveals its biosynthetic potential to produce novel anti-complement agents and peptides. PeerJ. 7 (1), 6122(2019).
- Kim Tiam, S., et al. Insights into the Diversity of Secondary Metabolites of Planktothrix Using a Biphasic Approach Combining Global Genomics and Metabolomics. Toxins. 11 (9), 498(2019).
- Özakin, S., Ince, E. Genome and metabolome mining of marine obligate Salinispora strains to discover new natural products. Turkish Journal of Biology. 43 (1), 28-36 (2019).
- Trivella, D. B. B., de Felicio, R. The Tripod for Bacterial Natural Product Discovery: Genome Mining, Silent Pathway Induction, and Mass Spectrometry-Based Molecular Networking. mSystems. 3 (2), 00160(2018).
- Maansson, M., et al. An Integrated Metabolomic and Genomic Mining Workflow To Uncover the Biosynthetic Potential of Bacteria. mSystems. 1 (3), 1-14 (2016).
- Blin, K., Kim, H. U., Medema, M. H., Weber, T. Recent development of antiSMASH and other computational approaches to mine secondary metabolite biosynthetic gene clusters. Briefings in Bioinformatics. 20 (4), 1103-1113 (2019).
- Fisch, K. M. Biosynthesis of natural products by microbial iterative hybrid PKS-NRPS. RSC Advances. 3 (40), 18228-18247 (2013).
- Tatsuno, S., Arakawa, K., Kinashi, H. Analysis of Modular-iterative Mixed Biosynthesis of Lankacidin by Heterologous Expression and Gene Fusion. The Journal of Antibiotics. 60 (11), Tokyo. 700-708 (2007).
- Helfrich, E. J. N., Piel, J. Biosynthesis of polyketides by trans-AT polyketide synthases. Natural Product Reports. 33 (2), 231-316 (2016).
访问受限。请登录或开始试用以查看此内容。
重印与许可
