本文介绍了一组用于临床评估已升级至新型精细结构编码策略的青少年汉语普通话熟练人工耳蜗使用者听力表现的测试。该测试组包括安静条件下的言语识别、噪声环境下的言语识别、词汇声调识别以及音乐感知测试。
本文内容
摘要
摘要
人工耳蜗(CI)植入是恢复重度感音神经性听力损失(SNHL)患者听力功能最有效的临床治疗方法。该技术在改善言语感知能力方面已取得显著成效,尤其是在安静环境中。然而,在复杂听觉环境中的言语感知、声调识别以及音乐感知能力的提升,仅在采用较新的精细结构编码策略或相关技术后才得以实现。因此,用于评估噪声环境下的言语感知、声调识别和音乐感知的方法至关重要。这些评估不仅需反映术后效果,还应为编码策略的调试、康复训练及新技术的应用提供指导。本研究对一组熟练使用人工耳蜗的汉语普通话青少年使用者在升级至精细结构编码策略前后,在简单与复杂听觉情境下的听力表现进行了评估。临床评估流程全面,包括安静条件下的言语测试、噪声环境中的言语测试、声调识别测试以及音乐感知测试。本文详细阐述了从编码策略的选择到各项测试方法的具体内容,涵盖测试流程、测试环境、设备、材料及测试顺序。文中还讨论了需特别注意的细节,例如受试者的位置、扬声器的角度、声音强度、噪声类型、练习测试以及答题方式。针对言语、声调和音乐感知的各项测试步骤、方法与材料均被逐一详述。最后,本文对临床测试结果进行了讨论。
引言
人工耳蜗(CIs)技术的进步为使用者带来了日益显著的益处,尤其体现在安静和嘈杂环境中的言语理解能力提升,同时也包括耳鸣减轻和生活质量提高1,2,3,4。评估技术升级如何可能改变术后效果是常见且必要的。因此,建立一套严格的测试体系具有重要意义,因为它能够更好地实现不同医疗机构中不同类型听力植入使用者结果的直接比较。这有助于数据的整合,提供更可靠的结果,从而更好地为患者和医疗保健提供者在决策过程中提供依据。人工耳蜗音频处理器的声音编码策略是影响人工耳蜗使用者听觉表现的核心技术之一5,6,7。编码策略已从早期基于包络的连续交错采样(CIS)策略,发展到更新的FS4策略,即一种时间精细结构策略8,9,10,11,12。
声音编码策略负责将声音信号处理为电脉冲,并传递至植入体的电极通道。在连续间隔采样(CIS)策略中,阵列上的所有电极触点均以恒定频率刺激,施加由包络调制的脉冲串(即,不存在时间编码)。在精细结构编码中,耳蜗顶部区域(低频区)以可变频率进行刺激,以模拟正常(声学)听力中内毛细胞的相位锁定特性,从而尽可能接近地再现正常听觉感知。而耳蜗基部和中部区域的通道则与CIS相同,采用恒定频率进行刺激8,9,10,11,12,13。
本研究采用一系列严格的测试来评估使用FS4编码策略的性能表现。声调语言(如普通话和粤语)利用音高线索来表达词汇意义14。除了常用的言语测试外,该测试组合还能细致地考察大多数声调语言中所使用的音高线索。普通话包含四个声调,其特征在于语音中基频(F0或音高)的变化。因此,在评估使用普通话的人工耳蜗使用者时,能够识别这些频率和语音中的变化显得尤为关键15,16,17,18,19。
多年来,针对使用普通话的年轻人工耳蜗(CI)使用者的音乐感知评估测试一直严重缺乏。然而,精细结构编码策略必须有助于使用声调语言的CI使用者区分音高轮廓和词汇声调20。迄今为止,仅有两项研究探讨了编码策略对讲普通话的成年CI使用者在言语和声调感知方面的影响21,22。据我们所知,尚无研究评估过青少年普通话CI使用者在升级至FS4编码策略后的听觉表现。因此,本研究旨在建立一套测试方法,用于评估青少年普通话CI使用者从采用CIS+编码策略的音频处理器升级至采用FS4编码策略的音频处理器后的表现。
方案
本研究经山东省耳鼻喉医院医学伦理委员会批准(批准号:XYK20211201)。所有研究参与者均签署了知情同意书。
1. 仪器设备
- 使用标准隔音室(≤30 dB [A]),包括校准的听力计、计算机和两个扬声器。“A”表示通过加权滤波器对人耳听觉响应进行测量。测量单位为 dB SPL(声压级)。所有测试均使用扬声器进行。
- 使用映射软件对受试者进行测试。评估在安静条件下的单音节识别言语表现、安静条件下的双音节(重读音节)言语识别、安静条件下的句子识别以及噪声条件下的句子识别。本实验选取20个单音节词(即:cai、chu、fei、fen、feng、ge、mi、pi、qi、qiao、qing、sha、shen、shi、tao、tui、xiang、xie、xuan 和 zhe),由一名以普通话为母语的男性发音人说出,并结合四个声调。
- 使用声调测试软件评估声调识别能力。本实验选取每个单音节的四个声调,保留其自然时长变化。将所有语音样本归一化至相同的均方根(RMS)电平,以消除振幅的自然差异。
- 在普通话词汇声调任务中,从四个声调中选择一个正确答案。本实验中,25个单音节词分别以四种普通话词汇声调发音,每次测试生成80个声调语音样本,词语以简体中文书写。
- 使用音乐软件评估音乐音高感知能力。本实验采用包含六个客观子测试的测试组合,用于评估多个音乐感知领域。该测试组合包含约2,800个声音文件。
- 在音高排序程序中,使用频率范围为27–4,186 Hz的不同乐器。音高排序测试采用双区间、双选项、强制选择的自适应程序,以确定区分音高变化的阈值。
- 本实验中,将目标音高设定为F4正弦音(349 Hz),起始音高比目标音高高32个四分之一音。两个音之间的音程大小设定为1至26个四分之一音。四分之一音音程由最近的半音生成。
2. 受试者准备
注:共有10名参与者(七名男性,三名女性)自愿参加本研究,其中两人自愿参与实验方案的拍摄。所有参与者均为单侧人工耳蜗(CI)使用者,平均年龄为10.4 ± 1.2岁(范围:9–14岁),植入人工耳蜗的平均年龄为2.8 ± 1.2岁(范围:1–4岁),并至少有5年使用CIS+编码策略的经验(表1)。所有参与者均能流利使用普通话,并愿意配合本研究计划的所有实验流程。
- 纳入标准为:确保潜在受试者至少有5年使用CIS+编码策略配合TEMPO+音频处理器的经验,能够使用普通话交流,并愿意遵守本研究计划中的各项操作流程。
- 排除标准为:受试者不愿意或无法配合测试程序。
- 根据上述纳入和排除标准对受试者进行筛选。向所有受试者获取口头和书面的知情同意。
- 测试时,将受试者置于隔声室中,距离扬声器1 m,身体朝向与人工耳蜗侧呈45°角。
- 若对侧耳佩戴助听器,需将其取下;对于有残余听力的受试者,确保掩蔽措施(耳塞和耳罩)有效。
- 告知受试者将进行练习测试,直至其充分理解任务要求。当受试者理解任务后,即可开始正式测试。同时告知受试者可根据需要随时休息。
3. 实验方案
- 在以下四个时间点分别完成一组测试:(i)升级前(使用旧处理器和编码策略),(ii)升级后即刻(即更换为新处理器和编码策略的当天),(iii)升级后6周,(iv)升级后3个月。
- 升级后的即刻测试阶段,使用两种编码策略对每位受试者进行测试。随机化测试顺序,即随机安排先使用CIS或先使用FS4。对受试者设盲,使其不知晓正在测试的编码策略。
- 按照下述步骤进行作图。
注意:映射是指对数组中每个电极通道的12个刺激水平进行编程。在本研究中,映射根据每位人工耳蜗使用者的反应进行,从而使每位参与者获得个性化的调试映射图。- 将受试者及其监护人带至调试室(隔音室),让受试者在调试室内就座。
- 点击映射软件并输入密码。取下言语处理器,并将其连接到 MAX 盒 通过 编程电缆
- 在软件中选择受试者姓名,并选择阻抗选项。测试电极阻抗,确保电极阻抗处于正常范围(2.2–12 kΩ;典型值)。异常的电极阻抗会自动显示为开路或短路。
- 确保编码策略为 FS4,使用每通道 1,224 pps 的标准脉冲速率。将单电极刺激设置为三次扫描,让受试者通过指向响度/舒适度图片量表上的相应图像来区分每个电极的响度。采用上下法进行测试,将重复出现两次的相同结果作为最终的电刺激结果。确保受试者理解并能够完成此项任务。
- 使用上述方法(步骤 3.3.4)设定所有电极的最大舒适水平(MCL)。MCL 被定义为不引起不适的最高(即最响)刺激水平。在本研究中,受试者通过响度/舒适度的图示量表来标示该水平。
- 为了测试MCL水平在现实生活中的应用,通过按下按钮来激活地图 活体 按钮。这可使受试者听到周围环境的声音。将受试者返回至调试模式。根据其在实时模式下聆听的主观反馈,必要时调整最大舒适级(MCL)。
- 设置其他参数为默认值:刺激速率为 1,288 pps;通道特异性采样序列(CSSS)通道为 4;脉冲为双相脉冲;相位间隙(IPG)为 2.1 µs;输入和输出信号采用对数压缩,默认最大舒适响度(MCL)值设为 500;压缩比为 3:1;灵敏度为 75%;阈值(THR)为受试者无法听到的最高声音强度,通常为 MCL 的 10%。通过重复测试验证每个通道的 THR,方法与 MCL 测试相同;频率范围为 70–8,500 Hz。
- 按照下述方法进行言语测试。
- 按以下顺序测试言语感知能力:安静条件下的双音节词(spondee)言语识别、安静条件下的单音节词识别、安静条件下的句子识别,以及噪声条件下的句子识别。
- 将受试者安置在另一间隔音室中,使其位于扬声器一侧,与计算机相距1米,与人工耳蜗(CI)侧成45°角。
- 确保处理器已开启且程序正确。点击语音软件,仔细解读回答方式。要求参与者清晰地复述他们所听到的内容。注意确保练习测试流程正确无误。
- 打开听力计并选择听力测试选项。通过听力计将声音强度设定为高于500、1,000、2,000和4,000 Hz平均纯音听阈30 dB HL(听力级)。
- 在正式测试时提供练习清单23每次测试时,要求参与者重复他们所听到的单词或句子。每次测试的内容顺序应保持随机,且单词或句子仅播放一次。
- 在噪声环境下句子识别测试中,将信噪比(SNR)设为+10 dB,并使用四人背景嘈杂语作为噪声信号。
- 按照下述方法进行音调测试。
- 点击音调软件,将同一隔音室内的声压级(SPL)设置为 65 dB。仔细解读应答方法。
- 确认参与者熟悉所有被测试的词汇。在进行正式测试的同时,提供练习列表。21.
- 指导参与者复述他们所听到的内容一次。选择参与者重复内容时的语调,并在每次测试中随机调整内容的顺序。
- 按照下述方法进行音乐测试。
- 点击音乐软件并选择同一隔音间内的音高选项。在正式测试的同时呈现练习列表。24.
- 指导受试者依次聆听两个刺激音,两个刺激音之间间隔1秒的静默期。要求他们判断哪一个时间间隔内的音高呈现下降或上升的音调轮廓。
- 输入参与者的答案并重复。在练习测试和正式测试中均保持内容顺序的随机性。选择参与者所选的答案。
4. 数据分析
- 对于言语和语调测试,记录受试者回答正确的百分比,并对每项测试进行比较。对于音乐音高测试,记录四分之一音阶并进行比较。
- 根据数据分布情况,采用以时间为因子的重复测量方差分析(RM ANOVA),或使用弗里德曼检验(Friedman test)来考察随时间的变化。通过成对比较,分析升级后与升级前的表现差异,可选用配对样本t检验或威尔科xon符号秩检验。
- 结合使用柯尔莫哥洛夫-斯米尔诺夫检验(Kolmogorov-Smirnov test)与夏皮罗-威尔克检验(Shapiro-Wilk test)来检验数据分布。若两项检验均表明数据呈正态分布,则采用参数统计方法;否则采用非参数统计方法。统计显著性水平设定为 p ≤ 0.05。
- 由于存在多重比较(三次成对比较:升级前 vs. 升级后即刻、升级前 vs. 升级后6周、升级前 vs. 升级后3个月),在解释所得p值时应采用邦弗罗尼校正法(Bonferroni correction)。因此,应将p ≤ 0.017 而非p ≤ 0.05 视为具有统计学显著性。
结果
言语测试结果反映了在安静和噪声环境下的言语识别能力。声调测试结果反映了普通话声调的词汇声调辨别能力。音高测试结果反映了音乐辨别能力。对于言语和声调测试结果,所有结果均以百分比形式呈现。百分比越高,表示测试结果越好。对于言语测试,词语和句子的结果将分别列出,以便对结果进行独立分析和比较。音高测试的结果以可视化的分辨阈值形式显示,阈值越低表示结果越好。这些数据易于分析和比较。
安静条件下的双音节词识别
安静条件下单音节词识别率在升级后3个月较升级前显著提高(平均提高16.1%); z = 2.497; p = 0.013)。从升级前到升级后6周的改善未达到显著性(平均提高9.4%; z = 1.735; p = 0.083)或从升级前到升级后即刻(平均提高5.8%; z = 1.429; p = 0.153; 表2 和 图1).
安静条件下单音节词识别
安静条件下的单音节词识别能力从升级前到升级后即刻显著提高(平均提高8.2%;z = 2.494;p = 0.013),从升级前到升级后6周(平均提高11.8%;z = 2.570;p = 0.010),以及从升级前到升级后3个月(平均提高22.5%;z = 2.810;p = 0.005;表2 和 图2)。
安静条件下的句子识别
安静条件下的句子识别率在升级后3个月相比升级前显著提高(平均提高17.8%;z = 2.670;p = 0.008)。升级后6周相比升级前(平均提高13.0%;z = 2.314;p = 0.021),以及升级后即刻相比升级前(平均提高0.8%;z = 0.255;p = 0.798),均未观察到显著改善(表2 和 图3)。
噪声环境下的句子识别
从升级前到各次升级后会话的配对比较证实,在噪声环境下句子识别的差异无统计学意义(Wilcoxon符号秩检验:z = 1.355;p = 0.176 至 z = 0.674;p = 0.500)。然而,在升级后3个月,噪声环境下的句子识别率相比升级前平均提高了26%(表2)。
音调识别
从升级前到升级后6周,音调识别能力显著提高(平均提高5.0%;t = 11.180;p < 0.001);从升级前到升级后3个月,音调识别能力也显著提高(平均提高9%;t = 4.803;p = 0.001)。从升级前到升级后即刻的音调识别能力未见显著改善(平均提高1.6%;t = 1.652;p = 0.133;表2 和 图4)。
音乐音高感知
从升级前到升级后4个月,音乐音高感知能力显著提高(平均改善12.7个最小可觉差;z = 2.371;p = 0.018)。从升级前到升级后6周,观察到非显著性改善(平均改善5.5个最小可觉差;z = 0.840;p = 0.401);从升级前到升级后即刻,观察到非显著性下降(平均恶化7.2个最小可觉差;z = 0.491;p = 0.623;表2)。
| 编号 | 性别 | 植入耳侧 | 手术时年龄(岁) | 评估时年龄(岁) | 植入体类型 |
| S01 | M | R | 2.0 | 14.2 | COMBI 40+ |
| S02 | F | L | 1.5 | 10.3 | COMBI 40+ |
| S03 | M | L | 4.4 | 12.2 | COMBI 40+ |
| S04 | F | R | 1.6 | 9.4 | COMBI 40+ |
| S05 | M | R | 3.8 | 10.6 | COMBI 40+ |
| S06 | M | R | 4.2 | 11.1 | COMBI 40+ |
| S07 | F | R | 4.2 | 11.7 | COMBI 40+ |
| S08 | M | R | 2.3 | 9.8 | COMBI 40+ |
| S09 | M | R | 4.3 | 9.4 | COMBI 40+ |
| S10 | M | R | 3.7 | 9.3 | COMBI 40+ |
表1:所有参与者的 demographics 数据。 缩写:M = 男性;F = 女性;R = 右侧;L = 左侧。
| 测试项目 | 升级前 | 术后即刻 | 术后6周 | 术后3个月 |
| 单音节词识别(安静环境;%) | 59.6 (±14.3) | 67.8 (±17.6) | 71.4 (±13.3) | 82.1 (±12.2) |
| 双音节词识别(安静环境;%) | 69.2 (±16.1) | 75.0 (±14.5) | 78.6 (±14.1) | 85.3 (±10.0) |
| 句子识别(安静环境;%) | 78.0 (±19.4) | 78.8 (±19.2) | 91.0 (±7.8) | 95.8 (±7.9) |
| 句子识别(噪声环境;%) | 59.8 (±33.78) | 70.2 (±13.5) | 80.0 (±12.9) | 85.8 (±10.7) |
| 音调识别(%) | 75.4 (±13.3) | 77.0 (±14.8) | 80.4 (±13.1) | 84.4 (±12.3) |
| 音乐音高识别(四分之一音) | 16.5 (±11.5) | 23.7 (±20.4) | 11.0 (±13.2) | 3.8 (±3.4) |
表2:各时间点每项测试的听力表现。 所有数据均以平均值(±标准差)表示。在安静条件下的双音节词、单音节词和句子识别中,FS4编码策略的表现具有显著优势(p ≤ 0.017)。然而,在噪声条件下的句子识别测试中未发现显著差异(p > 0.05)。

图1:各时间点双音节词识别结果。 在安静条件下的双音节词识别能力从升级前到升级后3个月显著提高(p = 0.013)。数据以均值±标准差表示。*p < 0.05。圆圈、方块和三角形表示各受试者的个体结果。请点击此处查看该图的放大版本。
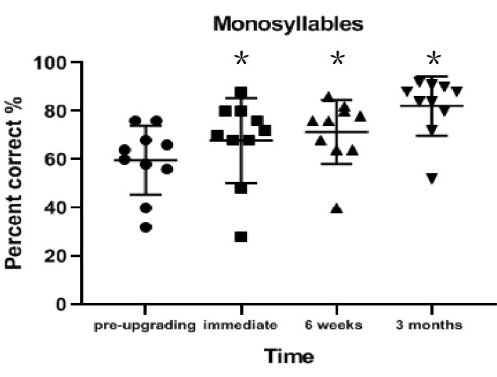
图2:各时间点的单音节识别结果。 在安静条件下的单音节识别能力从升级前到升级后即刻显著提高(p = 0.013),从升级前到升级后6周显著提高(p = 0.010),以及从升级前到升级后3个月也显著提高(p = 0.005)。数据以均值±标准差表示。*p < 0.05。圆圈、方块和三角形表示每位参与者的个体结果。 请点击此处查看此图的放大版本。
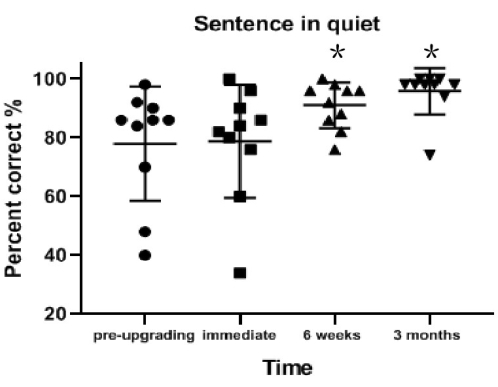
图3:各时间点安静条件下的句子识别结果。 安静条件下的句子识别率从升级前到升级后3个月显著提高(p = 0.008)。数据以均值 ± 标准差表示。*p < 0.05。圆圈、方块和三角形代表每位参与者的个体结果。请点击此处查看该图的放大版本。
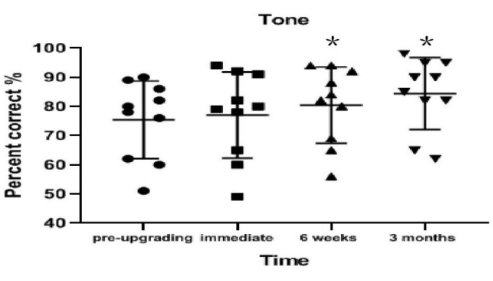
图 4:每个时间段的音调识别结果。 与升级前相比,升级后6周的音调识别能力显著提高(p < 0.001),升级后3个月也显著提高(p = 0.001)。数据以均值 ± 标准差表示。*p < 0.05。圆圈、方形和三角形表示各受试者的个体结果。请点击此处查看该图的放大版本。
讨论
本研究系统评估了使用中文普通话的青少年人工耳蜗使用者的听力表现。结果显示,从CIS+编码策略升级到FS4精细结构编码策略后,其在安静环境下的言语识别、声调识别以及音乐音高识别能力均显著提高。该方法有助于为探索临床评估工具提供指导,以评估新型精细结构编码策略在年轻中文普通话人工耳蜗使用者中的综合效果。
在本研究中,主要结局指标为言语表现,尤其是噪声环境下的言语表现。由于测试材料对年幼受试者难度较高,测试按从易到难的顺序进行:安静条件下的双音节词识别、安静条件下的单音节词识别、安静条件下的句子识别,以及噪声条件下的句子识别。在进行噪声条件下句子识别测试时,要求受试者集中注意力于目标言语内容,而非背景嘈杂声。所有受试者在噪声条件下句子识别测试中均表现良好。与升级前相比,在随后的三次测试中,安静条件下单音节词识别能力均显著提高。同样,安静条件下的双音节词识别和句子识别能力在升级前与升级后3个月之间也显著提升。这些结果与既往在成年普通话人工耳蜗使用者中的研究发现一致21,22。尽管本研究中噪声条件下句子识别测试的结果未达到统计学显著性,但平均得分从升级前的59.8%上升至使用3个月后的85.8%,这与既往报道的结果相符21。本测试流程及所呈现的结果验证了新型言语处理器在青少年普通话人工耳蜗使用者中的有效应用,同时证明了所提出测试方法的实用性。
言语表现测试完成后,进行声调测试。与噪声环境下的言语识别相比,声调测试对受试者而言似乎更有趣,且测试时间更短。所有受试者在经过一次练习后均理解了测试方法,并表现出良好的完成度。如前所述,声调识别对于普通话使用者的听觉和交流至关重要。正常听力儿童早在12个月大时即可以一种跨范畴的方式区分词汇声调17;然而,语前双侧重度耳聋儿童显然不具备这一能力。既往研究表明,语前聋的儿童人工耳蜗使用者在声调识别方面明显逊于听力正常的同龄人14,17。针对成年普通话人工耳蜗使用者的研究显示,采用FS4编码策略后,声调感知能力随时间推移显著提升22。同样,本研究也表明,在使用FS4策略6周和3个月后,声调识别能力均显著提高。
选择音乐软件是因为它所需时间较短,有助于保持整体测试时间的紧凑。如前所述,音高感知,尤其是音乐音高感知,连同音调识别,对人工耳蜗使用者至关重要。然而,这是整套测试中最困难且最繁琐的部分。由于测试本身难度较高,四名受试者需要进行多次练习,六名需要一次练习,三名需要两次练习,一名需要多次练习。通过练习环节,所有受试者均清楚理解了测试流程,并能够顺利完成测试。结果显示,在使用 FS4 三个月后,受试者的音高感知能力有显著提升。该结果与既往关于成年普通话人工耳蜗使用者的研究文献一致9。这证实了精细结构信息对于儿童普通话人工耳蜗使用者音乐识别的重要性,同时也表明该方法适用于评估任何语言背景的年幼儿童非普通话人工耳蜗使用者。
在本研究中,通过这一系列测试可充分验证并检验短期内升级至新编码策略的有效性。使用中文普通话的人工耳蜗使用者在除噪声环境下句子识别测试外的所有测试中均表现出显著更高的得分。除测试方法适用于受试者外,所有测试均简便直观,便于评估效果。除音乐音高感知结果外,其余结果均以百分比形式呈现。百分比得分越高,结果越好;而对于音乐音高测试,结果数值越低,效果越好。研究人员应确保所有测试软件均具备严格的实验前准备和正式测试表格,且测试内容无重复。
因此,本研究首次探索了一套可用于临床评估使用 FS4 编码策略升级后年轻普通话人工耳蜗使用者听力表现的测试方法。该方法提供了有效的测试材料、充分的准备工作、严格的测试顺序以及严谨的测试流程。然而,本研究也存在一定的局限性。首先,样本量较小,使得研究结果难以推广到更大的人群。未来的研究需要纳入更多的受试者。其次,未来的研究应测试各项测试所需的时间,以确定完成测试电池各部分所需时长,这对于年龄较小、注意力持续时间有限的人群尤为重要。一种能够缩短整体测试时间的更简便方法将具有临床应用价值。
总体而言,本研究结果表明,精细结构信息在安静条件下汉语普通话单侧人工耳蜗使用者的言语分辨、音高轮廓辨别以及词汇声调识别中起着至关重要的作用。这一系列测试可为人工耳蜗使用者、候选者及医生选择不同技术方案,以及指导临床康复提供依据。
披露
所有作者均无财务披露或利益冲突。
致谢
本工作得到国家自然科学基金(项目编号 81670932、81600803、82071053)的资助。Michael Todd(MED-EL)对本稿件进行了编辑。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| INVENTIS PIANO 听力计 | 俄罗斯 | 本研究中,该听力计主要用于行为测听。 | |
| HOPE 软件 | 中国人民解放军总医院 | 该软件用于语音表现测试,包含在安静环境中测试单音节识别、双音节(spondee)语音识别、句子识别,以及在噪声中进行句子识别的适当测试列表。 | |
| JAMO 扬声器 | 中国 | 这些扬声器用于隔声室内的所有测试。 | |
| 联想计算机 | 中国 | 它们用于运行和操作所有测试软件。 | |
| MAESTRO 编程设备 | MED-EL | 这些设备包括 MAX 盒和编程电缆,用于将处理器连接至编程软件。 | |
| MAESTRO 软件 | MED-EL | 该软件用于编程。 | |
| 普通话噪声中声调识别测试(MTINT) | 北京同仁医院 | 该软件用于测量声调识别能力。测试采用四选一强制选择法(4AFC)的普通话词汇声调任务。测试材料由25个单音节词组成,每个词分别以四种普通话词汇声调发音,从而为每位说话人生成100个不同的词语。 | |
| 人工耳蜗音乐声音测试(MuSIC) | MED-EL | MuSIC 测试套件包含六个客观子测试,用于评估多个音乐感知领域。选择该软件的原因是其耗时较短,有助于保持整体测试时间较为紧凑。该测试套件包含约2800个声音文件,由专业音乐家在皇家苏格兰音乐与戏剧学院使用真实乐器录制。 |
参考文献
- Wilson, B. S., Dorman, M. F. Cochlear implants: a remarkable past and a brilliant future. Hearing Research. 242 (1-2), 3-21 (2008).
- Carlyon, R. P., Goehring, T. Cochlear implant research and development in the Twenty-first Century: a critical update. Journal of the Association for Research in Otolaryngology. 22 (5), 481-508 (2021).
- Assouly, K. K. S., et al. Changes in tinnitus prevalence and distress after cochlear implantation. Trends in Hearing. 26, 23312165221128431(2022).
- Lassaletta, L., et al. Using generic and disease-specific measures to assess quality of life before and after 12 months of hearing implant use: a prospective, longitudinal, multicenter, observational clinical study. International Journal Environmental Research and Public Health. 19 (5), 2503(2022).
- Seligman, P., McDermott, H. Architecture of the Spectra 22 speech processor. The Annals of Otology, Rhinology & Laryngology. 166, 139-141 (1995).
- van Hoesel, R. J. M., Tyler, R. S. Speech perception, localization, and lateralization with bilateral cochlear implants. The Journal of the Acoustical Society of America. 113 (3), 1617-1630 (2003).
- Hochmair, I., et al. MED-EL cochlear implants: State of the art and a glimpse into the future. Trends in Amplification. 10 (4), 201-219 (2006).
- Helms, J., et al. Comparison of the TEMPO+ ear-level speech processor and the CIS PRO+ body-worn processor in adult MED-EL cochlear implant users. ORL; Journal for Oto-Rhino-Laryngology and its Related Specialties. 63 (1), 31-40 (2001).
- Arnoldner, C., et al. Speech and music perception with the new fine structure speech coding strategy: preliminary results. Acta Oto-Laryngologica. 127 (12), 1298-1303 (2007).
- Lorens, A., Zgoda, M., Polak, M., Skarzynski, H. FS4 for partial deafness treatment. Cochlear Implants International. 15, 78-80 (2014).
- Riss, D., et al. Effects of stimulation rate with the FS4 and HDCIS coding strategies in cochlear implant recipients. Otology & Neurotology. 37 (7), 882-888 (2016).
- Riss, D., et al. Effects of fine structure and extended low frequencies in pediatric cochlear implant recipients. International Journal of Pediatric Otorhinolaryngology. 75 (4), 573-578 (2011).
- Riss, D., et al. Envelope versus fine structure speech coding strategy: a crossover study. Otology & Neurotology. 32 (7), 1094-1101 (2011).
- Chen, A., Stevens, C. J., Kager, R. Pitch perception in the first year of life, a comparison of lexical tones and musical pitch. Frontiers in Psychology. 8, 297(2017).
- Holt, C. M., Lee, K. Y. S., Dowell, R. C., Vogel, A. P. Perception of Cantonese lexical tones by pediatric cochlear implant users. Journal of Speech, Language, and Hearing Research. 61 (1), 174-185 (2018).
- Gu, X., et al. A follow-up study on music and lexical tone perception in adult Mandarin-speaking cochlear implant users. Otology & Neurotology. 38 (10), 421-428 (2017).
- Mao, Y., Xu, L. Lexical tone recognition in noise in normal-hearing children and prelingually deafened children with cochlear implants. International Journal of Audiology. 56, 23-30 (2017).
- Tan, J., Dowell, R., Vogel, A. Mandarin lexical tone acquisition in cochlear implant users with prelingual deafness: A review. American Journal of Audiology. 25 (3), 246-256 (2016).
- Tang, P., Yuen, I., Rattanasone, N. X., Gao, L., Demuth, K. The acquisition of Mandarin tonal processes by children with cochlear implants. Journal of Speech, Language, and Hearing Research. 62 (5), 1309-1325 (2019).
- Vandali, A. E., Dawson, P. W., Arora, K. Results using the OPAL strategy in Mandarin speaking cochlear implant recipients. International Journal of Audiology. 56, 74-85 (2016).
- Chen, X. Q., et al. Cochlear implants with fine structure processing improve speech and tone perception in Mandarin-speaking adults. Acta Oto-Laryngologica. 133 (7), 733-738 (2013).
- Qi, B., Liu, Z. Y., Gu, X., Lin, B. Speech recognition outcomes in Mandarin-speaking cochlear implant users with fine structure processing. Acta Oto-Laryngologica. 137 (3), 286-292 (2017).
- Xi, X., et al. Development of a corpus of Mandarin sentences in babble with homogeneity optimized via psychometric evaluation. International Journal of Audiology. 51 (5), 399-404 (2012).
- Brockmeier, S. J., et al. The MuSIC perception test: a novel battery for testing music perception of cochlear implant users. Cochlear Implants International. 12 (1), 10-20 (2011).
重印与许可
