本文介绍了一种利用小型测试数据集评估同一天P300拼写脑-机接口(BCI)准确性的方法。
需要JoVE订阅才能观看此内容。 请登录或开始免费试用
本文内容
摘要
摘要
性能评估是脑机接口(BCI)系统开发与验证过程中的必要步骤。然而,即使是现代的BCI系统运行速度仍然较慢,导致收集足够的验证数据对最终用户和实验人员而言都是一项耗时的任务。若数据量不足,性能的随机波动可能导致对特定用户使用BCI效果的错误推断。例如,P300拼写系统通常以每分钟1-5个字符的速度运行。若要以5%的分辨率估计其准确率,则需要20个字符(耗时4-20分钟)。尽管投入了这一时间成本,基于20个字符所得准确率的置信区间仍可能高达±23%,具体取决于观测到的准确率水平。先前发表的一种方法——基于分类器的潜伏期估计(Classifier-Based Latency Estimation, CBLE)——已被证明与BCI准确率高度相关。本文提出了一种利用CBLE从少量输入字符(约3-8个)预测用户P300拼写系统准确率的实验方案。该方法所得置信区间比传统方法更窄,因此可用于更快速和/或更准确地评估BCI系统的性能。
引言
脑机接口(BCI)是一种非侵入性技术,可使个体通过机器直接进行交流,而不受身体施加的生理限制。BCI 可作为由大脑直接操控的辅助设备使用。BCI 利用使用者的脑部活动来判断其是否意图选择屏幕上显示的某个特定按键(字母、数字或符号)1。在典型的计算机系统中,用户通过物理方式按压键盘上的目标按键。然而,在配备视觉显示的 BCI 系统中,用户只需将注意力集中在目标按键上。随后,BCI 通过分析所测得的脑信号来选择该目标按键1。脑部活动可通过多种技术进行测量。尽管存在多种竞争性 BCI 技术,脑电图(EEG)因其非侵入性、高时间分辨率、可靠性以及相对较低的成本而被视为领先技术2。
脑机接口(BCI)的应用包括通信、设备控制以及娱乐3,4,5,6。其中最活跃的应用领域之一是P300拼写器,该技术由Farwell和Donchin提出7。P300是一种事件相关电位(ERP),在识别罕见但相关刺激时产生8。当个体识别出目标刺激时,会自动产生P300电位。P300是脑机接口中一种有效的信号,因为它能够在无需外部行为反应的情况下传递参与者对目标事件的识别信息9。
P300 脑-机接口(BCI)吸引了来自计算机科学、电气工程、心理学、人因工程学以及多个其他学科的研究人员。在信号处理、分类算法、用户界面、刺激方案以及许多其他领域已取得进展10,11,12,13,14,15。然而,无论研究领域如何,所有这些研究的共同核心在于必须评估 BCI 系统的性能。该任务通常需要生成测试数据集。这种需求不仅限于科研;作为一种辅助技术,未来在临床应用中很可能需要为每位最终用户建立独立的验证数据集,以确保系统能够实现可靠的通信。
尽管针对P300脑机接口(BCI)已开展了大量研究,但这类系统仍然相当缓慢。虽然大多数人都能够使用P300 BCI16,但大多数P300拼写系统每分钟仅能输出约1至5个字符。不幸的是,这种低速意味着生成测试数据集需要参与者、实验人员以及最终用户投入大量时间和精力。脑机接口系统准确率的测量属于二项分布参数估计问题,需要大量字符数据才能获得可靠的估计结果。
为了估计P300事件相关电位(ERP)的存在与否,大多数分类器采用二分类模型,即对每段脑电图(EEG)数据的试验或时间窗分配一个二元标签(例如“存在”或“不存在”)。大多数分类器所使用的通用方程可表示为:
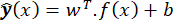
其中  称为分类器的得分,表示 P300 响应存在的概率,x 是从脑电(EEG)信号中提取的特征向量,b 为偏置项17。函数 f 是一种决策函数,用于将输入数据映射到输出标签,该函数通过监督学习算法从一组带标签的训练数据中学习得到17。在训练过程中,分类器使用一组带标签的脑电信号数据集进行训练,每个信号均被标注为包含或不包含 P300 响应。权重向量和偏置项经过优化,以最小化分类器预测输出与脑电信号真实标签之间的误差。分类器训练完成后,即可用于预测新脑电信号中是否存在 P300 响应。
不同的分类器可以采用不同的决策函数,例如线性判别分析(LDA)、逐步线性判别分析(SWLDA)、最小二乘法(LS)、逻辑回归、支持向量机(SVM)或神经网络(NNs)。最小二乘分类器是一种线性分类器,通过最小化预测类别标签与真实类别标签之间误差的平方和来实现分类。该分类器使用以下方程预测新测试样本的类别标签:
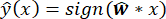 (1)
其中符号函数在乘积为正时返回 +1,在乘积为负时返回 -1,权重向量  是通过以下方程利用训练数据的特征集(x)和类别标签(y)求得的:
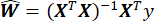 (2)
在早期研究中,我们提出基于分类器的潜伏期估计(Classifier-Based Latency Estimation, CBLE)可用于估计脑机接口(BCI)的准确性17,18,19。CBLE 是一种利用分类器时间敏感性来评估潜伏期变化的策略18。传统的 P300 分类方法通常采用与每个刺激呈现同步的单一时间窗口,而 CBLE 方法则通过生成多个时间偏移的刺激后时段副本,检测产生最大评分的时间偏移,从而估计 P300 反应的潜伏期17,18。本文提出了一种利用 CBLE 从小规模数据集中估计 BCI 性能的实验方案。作为代表性分析,通过改变字符数量来预测个体的整体性能。针对两个示例数据集,分别计算了 vCBLE 与实际 BCI 准确性的均方根误差(RMSE)。结果表明,基于 vCBLE 预测及其拟合数据所得的 RMSE 值,始终低于使用 1 至 7 个测试字符所获得的准确率对应的误差值。
我们开发了一个名为“CBLE性能估计”的图形用户界面(GUI),用于实现所提出的方法。同时提供了在MATLAB平台上运行的示例代码(补充编码文件1),该代码执行GUI中的所有步骤,但这些步骤的提供旨在帮助读者适应新的数据集。此代码采用了一个公开可用的数据集“使用干式脑电图电极的无需校准的基于P300的脑-机接口游戏Brain Invaders数据集(bi2014a)”来评估所提出的方法20。参与者最多进行了三轮Brain Invaders游戏,每轮游戏包含9个关卡。数据采集持续进行,直到所有关卡完成,或参与者完全失去对脑-机接口系统的控制为止。Brain Invaders界面包含36个符号,这些符号以12组、每组6个外星人的方式闪烁。根据Brain Invaders P300范式,每次呈现由12次闪烁组成,每组闪烁一次。在这12次闪烁中,有2次包含目标符号(称为目标闪烁),其余10次不包含目标符号(称为非目标闪烁)。有关该范式的更多详细信息可参见原始参考文献20。
CBLE 方法还在一个密歇根数据集上得以实施,该数据集包含来自 40 名参与者的数据18,19。其中,由于 8 名参与者的任务不完整,其数据被剔除。整个研究要求每位参与者进行三次访问。在第一天,每位参与者输入一条 19 个字符的训练句子,随后在第 1、2、3 天分别输入三条 23 个字符的测试句子。本示例中,键盘包含 36 个字符,分为六行六列。每行或每列闪烁持续 31.25 毫秒,闪烁之间间隔 125 毫秒。字符之间提供 3.5 秒的暂停时间。
图1展示了所提出方法的框图。详细步骤在实验方案部分中描述。
访问受限。请登录或开始试用以查看此内容。
方案
将"CBLE 性能估计"图形用户界面应用于两个数据集:"BrainInvaders"数据集和密歇根数据集。对于"BrainInvaders"数据集,数据采集已获得格勒诺布尔阿尔卑斯大学伦理委员会的批准20。密歇根数据的采集已获得密歇根大学机构审查委员会的批准19。数据分析在堪萨斯州立大学豁免协议7516下进行。若采集新数据,应遵循用户所在机构审查委员会(IRB)批准的知情同意采集流程。本文所提出的方法通过此前记录的、去标识化的数据的离线分析进行评估,因此无需额外获取知情同意。
本文所包含的图形用户界面(GUI)能够有效处理两种不同的数据集格式。第一种格式与 BCI2000 软件相关,第二种格式称为 "BrainInvaders" 数据集。若要使用 "Brain Invaders" 格式,数据必须按照方案部分第 1 步所述进行预处理。然而,在处理 "BCI2000" 数据集格式时,可省略第 1 步。
1. 数据准备
- 仅 BrainInvaders:生成输入数据文件 ".mat" 可用于的文件格式 "CBLE 性能评估" 图形用户界面(GUI)。示例脚本请参见 补充编码文件 2.
注意:每个数据文件包含一个二维矩阵,其行代表在不同时间采样点记录的观测值。矩阵的第2至第17列是来自16个脑电图(EEG)电极的记录。矩阵的第一列为每条观测的时间戳,第18列包含与实验事件相关的信息。第19列大多为零,但在非目标(或目标)闪烁开始时,该时刻的数值会变为一(或二)。详细说明可参见参考文献。20.
2. 下载并安装图形用户界面软件包
- 下载并安装 "CBLE Performance Estimation" 图形用户界面。
3. 将数据集存储在 GUI 位置的子文件夹中
- 确保数据集文件夹与图形用户界面(GUI)位于同一目录中。
- 例如,创建一个新文件夹并将 "CBLE 性能评估" GUI 内部。将所有数据集保存在子文件夹中 "CBLE 图形用户界面" 命名的 "数据集"
4. 打开已安装的图形用户界面
- 打开 MATLAB(参见材料表),将当前目录更改为 GUI 所在的文件夹,点击APPS 选项卡,然后选择MY APPS。
- 在"MY APPS"选项卡下,选择CBLE Performance Estimation。
5. 选择数据集格式
- 从下拉菜单选择数据集格式中选择一个数据集格式。
6. 加载脑电图(EEG)数据文件
- 单击选择输入文件夹按钮,以选择数据集所在的目录。
- 查看所选文件夹中数据文件的数量。
注意:在"Brain Invaders"格式中,每位参与者由一个单独的数据文件表示。因此,数据文件的总数即代表研究中参与者的数量。然而,对于"BCI2000"格式则并非如此,因为每位参与者可能拥有多个训练和测试文件。
7. 设置参数
- 输入用户拟用于估算过程的参与者数量 "参与者人数" 文本框
- 仅 BrainInvaders:指定数据集的采样率。
注意:BCI2000 文件包含采样率。 - 选择一个下采样倍率,将数据集降采样至约 20 Hz,以提高分类性能21例如,如果采样频率为 256 Hz,则选择 13 作为降采样值。
- 指定分类的时间窗口(毫秒)。
注意:建议的初始时间窗大小已指定,起始点可在 0 至 100 ms 之间变化,终止点可在 700 至 800 ms 之间变化。然而,应注意避免将时间窗设置得过大,以防与另一个 P300 事件发生重叠。 - 定义CBLE的偏移时间窗口(毫秒)。
注意:“位移窗口”指的是CBLE的扩展时间范围 方法搜索以找到P3反应。 分类器将应用于移位窗口第一个元素开始的时段。 然后将分类器依次应用于起始时间向后延迟一个样本的时段,直至该时段超出移位窗口范围。 因此,偏移窗口必须大于原始窗口;根据经验,两侧偏移值小于100毫秒时效果较好。 在任何情况下,间隔都应保持在 ISI 的一半以下。 - BC2000 仅适用:输入数据集文件中所示受试者 ID 的长度 "ID 长度" 领域
注意:图形用户界面(GUI)要求文件名的前 sub_len 个字符用于编码受试者编号。 - 仅适用于 BCI2000:在 "通道 ID" 字段,需注明通道总数,或明确指出分析所用的具体通道编号。
- 点击 设置参数 按钮以设置分析所需的所有参数。
8. 仅限 BrainInvaders:将数据集划分为训练集和测试集
- 选择代表训练集大小的目标数量。数据集的剩余部分将被视为测试数据集。
注意:为确保模型得到充分训练,必须具备足够大的训练样本。建议的最小训练样本量为 20,但该数值可能根据整体数据集的大小而有所调整。若在训练过程中出现回归错误,建议增加训练样本量。 - 按下 "分割数据集" 按钮,将数据集划分为训练集和测试集。
注意:每位参与者将拥有相同数量的训练数据。然而,由于任务过程中可能存在多次尝试,各参与者的测试数据量可能不相等。因此,每位参与者所呈现的目标或闪烁总数可能有所不同。
9. 使用训练数据集训练模型
注意:步骤 9.1 适用于 "Brain Invaders" 格式,步骤 9.2 适用于 "BCI2000" 格式。
- 仅 BrainInvaders:点击 训练模型 按钮,使用公式 2 对训练数据集应用线性回归,以训练分类器模型。
- 仅 BCI2000:指定训练和测试文件的文件名及其数据格式(.dat),以区分所有文件中的训练和测试文件。然后,点击 训练模型 按钮,对训练数据集应用线性回归。
10. 预测测试集的准确性
- 单击 预测准确率,将训练好的分类器模型应用于测试特征集,并使用公式 1 预测 准确率 。
11. 获取 X-目标准确率
- 选择测试集中要考虑的最大目标数 X。
- 仅 BCI2000:如果用户有多个测试文件,请选择一个测试文件编号。
- 按下 查找 X 目标准确率。
12. 计算 vCBLE
- 点击查找 vCBLE按钮,以获取所有靶标的 vCBLE。
13. 计算脑机接口准确率和vCBLE的均方根误差(RMSE)
- 点击计算 RMSE按钮,以计算基于vCBLE的预测与X-target预测在BCI准确率下的RMSE。
14. 可视化分析结果
- 点击 准确性 与 vCBLE 单击按钮以观察所有参与者总准确率与总vCBLE之间的关系。
- 按压 BCI的均方根误差 & vCBLE 按钮用于显示脑机接口准确率和vCBLE的均方根误差(RMSE)曲线。
15. 预测个体参与者的性能
- 为了预测单个参与者的准确性,将受试者编号填入“Sub ID”。
注意:此处将使用除测试参与者外所有参与者的数据集来训练一个线性回归模型。所有其他参与者的vCBLE分数及其对应的测试准确率将分别用作分类器的预测变量和标签。 - 选择一个目标数量 n。预测将基于 n 个测试字符的准确率进行。
- 点击 预测 按钮,以获得该测试参与者的预测准确率。
访问受限。请登录或开始试用以查看此内容。
结果
本方案已在两个不同的数据集上进行了测试:“BrainInvaders”数据集和密歇根大学数据集。这些数据集在引言部分已作简要介绍。用于这两个数据集的参数见表1。图2-4展示了使用“BrainInvaders”数据集获得的结果,而图5-7展示了密歇根大学数据集所取得的结果。
“BrainInvaders”数据集包含64名参与者。 图2展示了所有64名参与者的BCI准确率与vCBLE之间的关系。结果显示,vCBLE与BCI准确率呈高度负相关,尽管观察到少数离群值。图3展示了基于测试字符准确率进行预测时,vCBLE与实际准确率之间的均方根误差(RMSE...
访问受限。请登录或开始试用以查看此内容。
讨论
本文概述了一种利用小型P300数据集估算脑机接口(BCI)准确性的方法。此处,当前方案的制定基于 "bi2014a" 数据集,尽管该方案的有效性已在两个不同的数据集上得到验证。要成功实施该技术,必须确定若干变量,例如原始数据的 epoch 时间窗、时间偏移窗、下采样比例,以及训练集和测试集的大小。这些变量由所用数据集的特征决定,包括目标或字符数量、序列数量以及参与者的总人数。
研究结果 "bi2014a" 数据集结果表明,在所有测试条件下(少于10个字符),vCBLE的预测性能均优于基于字符级别的BCI准确率,这些条件涉及包含一至十个字符的测试数据集。然而,当测试数据集包含超过七个目标时,vCBLE的性能表现出极小的波动。 密歇根数据的结果表明,若测试数据集少于六个字符,则使用vCBLE预测当日表现将优于基于准确率的估计方法。有趣的是,用于构建该模型的数据量在初始几个字符之后,其增加仅带来边际性的性能提升。总体而言,这意味着预测当日准确率时无需收集大量数据。
根据"bi2014...
访问受限。请登录或开始试用以查看此内容。
披露
所有作者均声明不存在任何利益冲突。
致谢
代表性结果所用的数据来源于美国国家儿童健康与人类发展研究所(NICHD)、美国国立卫生研究院(NIH)资助项目R21HD054697,以及美国教育部国家残疾与康复研究中心(NIDRR)资助项目H133G090005和奖励编号H133P090008的支持。其余工作部分由美国国家科学基金会(NSF)资助,奖励编号#1910526。本研究中的发现与观点不一定反映NICHD、NIH、NIDRR或NSF的立场。
访问受限。请登录或开始试用以查看此内容。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| MATLAB 2021 | Matlab | N/A | 可使用任何较新版本的 MATLAB。 |
参考文献
- Rezeika, A., Benda, M., Stawicki, P., Gembler, F., Saboor, A., Volosyak, I. Brain-Computer Interface spellers: A review. Brain Science. 8 (4), 57(2018).
- Gannouni, S., Aledaily, A., Belwafi, K., Aboalsamh, H. Emotion detection using electroencephalography signals and a zero-time windowing-based epoch estimation and relevant electrode identification. Scientific Reports. 11 (1), 7071(2021).
- Daly, J. J., Wolpaw, J. R. Brain-computer interfaces in neurological rehabilitation. Lancet Neurology. 7 (11), 1032-1043 (2008).
- Birbaumer, N. Breaking the silence: brain-computer interfaces (BCI) for communication and motor control. Psychophysiology. 43 (6), 517-532 (2006).
- Riccio, A., Simione, L., Schettini, F., Pizzimenti, A., Inghilleri, M., Belardinelli, M. O. Attention and P300-based BCI performance in people with amyotrophic lateral sclerosis. Frontiers in Human Neuroscience. 7, 732(2013).
- Finke, A., Lenhardt, A., Ritter, H. The MindGame: a P300-based brain-computer interface game. Neural Network. 22 (9), 1329-1333 (2009).
- Farwell, L. A., Donchin, E. Talking off the top of your head: toward a mental prosthesis utilizing event-related brain potentials. Electroencephalogr. Clinical Neurophysiology. 70 (6), 510-523 (1988).
- Li, Q., Lu, Z., Gao, N., Yang, J. Optimizing the performance of the visual P300-speller through active mental tasks based on color distinction and modulation of task difficulty. Frontiers in Human Neuroscience. 13, 130(2019).
- McFarland, D. J., Sarnacki, W. A., Townsend, G., Vaughan, T., Wolpaw, J. R. The P300-based brain-computer interface (BCI): effects of stimulus rate. Clinical Neurophysiology. 122 (4), 731-737 (2011).
- Krusienski, D. J., Sellers, E. W., Cabestaing, F., Bayoudh, S., McFarland, D. J., Vaughan, T. M. A comparison of classification techniques for the P300 Speller. Journal of Neural Engineering. 3 (4), 299-305 (2006).
- Sellers, E. W., Donchin, E. A P300-based brain-computer interface: initial tests by ALS patients. Clinical Neurophysiology. 117 (3), 538-548 (2006).
- Donchin, E., Spencer, K. M., Wijesinghe, R. The mental prosthesis: assessing the speed of a P300-based brain-computer interface. IEEE Transactions on Rehabilitation Engineering. 8 (2), 174-179 (2000).
- Höhne, J., Schreuder, M., Blankertz, B., Tangermann, M. A novel 9-class auditory ERP paradigm driving a predictive text entry system. Frontiers in Neuroscience. 5, 99(2011).
- Acqualagna, L., Treder, M. S., Blankertz, B. Chroma Speller: Isotropic visual stimuli for truly gaze-independent spelling. 2013 6th International IEEE/EMBS Conference on Neural Engineering (NER), , (2013).
- Townsend, G., LaPallo, B. K., Boulay, C. B., Krusienski, D. J., Frye, G. E., Hauser, C. K. A novel P300-based brain-computer interface stimulus presentation paradigm: moving beyond rows and columns. Clinical Neurophysiology. 121 (7), 1109-1120 (2010).
- Guger, C., Daban, S., Sellers, E., Holzner, C., Krausz, G., Carabalona, R. How many people are able to control a P300-based brain-computer interface (BCI). Neuroscience Letters. 462 (1), 94-98 (2009).
- Mowla, M. R., Gonzalez-Morales, J. D., Rico-Martinez, J., Ulichnie, D. A., Thompson, D. E. A comparison of classification techniques to predict Brain-computer interfaces accuracy using classifier-based latency estimation. Brain Science. 10 (10), 734(2020).
- Thompson, D. E., Warschausky, S., Huggins, J. E. Classifier-based latency estimation: a novel way to estimate and predict BCI accuracy. Journal of Neural Engineering. 10 (1), 016006(2012).
- Thompson, D. E., Gruis, K. L., Huggins, J. E. A plug-and-play brain-computer interface to operate commercial assistive technology. Disability and Rehabilitation: Assistive Technology. 9 (2), 144-150 (2014).
- Korczowski, L., Ostaschenko, E., Andreev, A., Cattan, G., Coelho Rodrigues, P. L., Gautheret, V., Congedo, M. Brain Invaders calibration-less P300-based BCI using dry EEG electrodes Dataset (bi2014a) [Data set]. Zenodo. , (2019).
- Krusienski, D. J., Sellers, E. W., Cabestaing, F., Bayoudh, S., McFarland, D. J., Vaughan, T. M., Wolpaw, J. R. A comparison of classification techniques for the P300 Speller. Journal of Neural Engineering. 3 (4), 299-305 (2006).
访问受限。请登录或开始试用以查看此内容。
重印与许可
