本研究旨在比较从母语到第二语言的英语与从母语到第二语言的葡萄牙语,以检验外国口音在各项指标、韵律-声学参数以及在语音列队中选择目标声音时所产生的影响程度。
需要JoVE订阅才能观看此内容。 请登录或开始免费试用
本文内容
摘要
摘要
本研究旨在考察外语口音英语和外语口音巴西葡萄牙语的韵律-声学特征及其感知相关性,并分析说话人产出的外语与母语口音与其听者感知之间的关联。在方法部分,我们对一组以巴西葡萄牙语为第二语言的美国说话人和一组以英语为第二语言的巴西说话人进行了言语产出实验,同时开展了言语感知实验,针对两种语言分别实施了语音列队识别测试。在言语产出的统计分析中,我们采用广义加性模型(Generalized Additive Models),在控制对立类别(韵律或声学-韵律)协变量平滑效应的前提下,评估语言组别对每一类特征的影响。在言语感知的统计分析中,我们采用Kruskal-Wallis检验及事后Dunn检验,评估语音列队中不同声音对听者评分结果的影响。此外,我们还基于余弦距离和欧氏距离进行了声学(语音)相似性检验。结果显示,不同语言组在基频(f0)变异度、时长和嗓音质量方面存在显著的声学差异。在语音列队测试中,结果表明基频(f0)、强度和嗓音质量等韵律特征与听者的感知判断存在相关性。
引言
口音是语言交流和流利表达中一个显著且动态的方面,无论是在母语(L1)还是在第二语言(L2)中均如此1。外国口音 指的是第二语言学习者在目标语言中表现出的语音特征,它会随着说话者的第二语言经验、说话风格、输入质量、接触程度以及其他变量而发生变化(随时间推移)。外国口音可以被量化为外国说话者产出的第二语言语音与目标语言的本地或标准口音之间差异程度(标量)的度量2,3,4,5。
本研究旨在考察外国口音英语和外国口音巴西葡萄牙语(BP)的韵律-声学特征及其感知相关性,并检验说话人产出的外语口音与母语口音在多大程度上与听者的感知相关联。法医学领域的前期研究表明,元音和辅音在外国口音识别中具有较强的稳定性,这种稳定性要么体现在对个体进行长期分析时的稳定性(The Lo Case6),要么体现在说话人身份识别的高准确率上(The Lindbergh Case7)。然而,基于时长、基频(f0,即音高的声学对应参数)、强度以及嗓音质量(VQ)的韵律-声学特征研究正受到越来越多的关注8,9。因此,本研究选择韵律-声学特征作为分析对象,代表了法医语音学领域一个具有前景的研究方向8,10,11,12,13。
目前的研究得到了法医学领域关于外国口音作为声音伪装形式的相关研究的支持14,15,同时也得到了用于准备语音辨认听辨列队研究的支持16,17。例如,语速在识别以英语为第二语言的德国、意大利、日本和巴西说话者方面发挥了重要作用18,19,20,21,22。除了语速之外,长期频谱特征和基频(f0)特征也对熟悉目标语言的第二语言熟练使用者构成挑战,因为其大脑和认知基础在记忆、注意力和情绪方面存在不足,这些因素会在说话者进行较长语段表达时反映在语音表现上23。法医学领域对外国口音的看法是,某种语音是否真正听起来像外国口音,在很大程度上取决于听者的陌生感,而非说话者本身具有从无到极端程度的外国口音特征24。
在感知领域,自20世纪90年代中期以来,一种常用于识别罪犯的法庭科学工具是语音列队(听觉识别),其原理类似于通过视觉识别在犯罪现场辨认作案人16,25。在语音列队中,嫌疑人的声音会与若干干扰声音(foils)一同呈现,这些干扰声音在社会语言学特征方面(如年龄、性别、地理位置、方言和文化背景)与嫌疑人相似,供听觉证人进行辨认。语音列队的成功与否取决于语音样本的数量及每段样本的持续时间25,26。此外,对于真实场景中的语音样本,音频质量被普遍认为会持续影响语音识别的准确性。低质量的音频可能扭曲声音的独特特征27。当语音相似时,基于基频(f0)的细微语音细节可能在语音识别过程中使听者产生混淆28,29。此类声学特征不仅限于f0,还包括时长、强度谱特征以及声门波形(VQ)等要素30。这种多维度韵律特征的观点在法庭语音比对中至关重要,有助于确保说话人识别的准确性9,14,15,29,31。
总之,近几十年来,法医语音学在外国口音识别方面的研究显示出一些差异。一方面,外国口音似乎并不影响说话人识别的过程32,33(特别是当听者不熟悉目标外国口音时34)。另一方面,也有研究得出了相反的结果12,34,35。
访问受限。请登录或开始试用以查看此内容。
方案
本研究已获得人类研究伦理委员会的批准。此外,已获得所有参与本研究的受试者同意,允许使用并发表其数据。
1. 言语产生
注意:我们通过朗读任务收集了“L1英语-L2 BP”产出的言语数据 第1组:该 上午erican E英语(来自美国) S扬声器(AmE-S),以及由“L1 BP-L2 英语”产生的两者 第2组:该 Brazilian S扬声器(Bra-S)。参见 图1 用于言语产生的流程图。

图1:言语产生的示意图流程图。 请点击此处查看此图的放大版本。
- 参与者
- 确定 参与者人数,该 语言 (L1 英语,L2 葡萄牙语;L1 葡萄牙语,L2 英语), 性别 (女性或男性),该 年龄 (均值,标准差),的 群体特征 (专业人士或本科生),以及 L2 熟练水平 (高级或较高级)每个组别。
注意:在本研究中,美式英语-熟练者(AmE-S)和巴西葡萄牙语-熟练者(Bra-S)均被视为第二语言熟练者(两组均达到B2-C1水平)36)。AmE-S 组在实验进行时已在巴西居住两年。Bra-S 组在实验进行时已在美国居住超过两年。在海外居住期间,两组均每周至少6天使用其第二语言(L2)进行学习和工作,每天约4至5小时。 - 将参与者分配至舒适且安静的房间,并向各组提供相应的阅读材料。
- 确定 参与者人数,该 语言 (L1 英语,L2 葡萄牙语;L1 葡萄牙语,L2 英语), 性别 (女性或男性),该 年龄 (均值,标准差),的 群体特征 (专业人士或本科生),以及 L2 熟练水平 (高级或较高级)每个组别。
- 数据采集
注意:语音数据必须通过以下语言的朗读任务进行采集:L1-英语和L2-巴西葡萄牙语;L1-巴西葡萄牙语和L2-英语。如有必要,可让参与者提前阅读文本。- 记录程序
- 在声学条件适宜的安静环境中记录语音数据。
- 使用数字录音设备(参见 材料表)37 以及一个单向电磁隔离心形指向性麦克风(参见 材料表)38.
- 记录音频数据至“.wav“形式。
- 将采样率设置为 48 kHz,量化率为 16 位。
注意:步骤 1.2.1.3 和 1.2.1.4 中所述的音频格式以及采样和量化率的配置,旨在确保高质量并降低噪声,以保留用于后续声学分析的频谱特征。
- 记录程序
- 声学分析
注意:将声学分析流程分为三个步骤:强制对齐、重对齐和声学特征提取。- 编写语言转录(在“.txt每个音频文件的“文件”)
- 标记这对.txt'/'.wav' 文件名相同的文件(例如,'my_file.波'/ 'my_file.txt').
注意:为了提高第1.3.7节所述步骤的执行效果,强烈建议“.txt/.wav”文件标签的前三个字符代表 语言, 方言,或 口音,而第四到第六个字符表示 性别 例如, EL1FEM 用于 E英语 L1 雌性ale)。从第七个字符开始,用户应标明说话者编号(例如, 001 对于第一位说话者)。因此,第一个“txt/wav”配对是 EL1FEM001. - 为每种L1-L2语言创建一个文件夹。
注意:一个用于 L1-L2 英语的文件夹和一个用于 L1-L2 BP 的文件夹。 - 确认所有相同语言的文件对均位于同一文件夹中。
- 进行强制对齐。
- 访问慕尼黑自动分割(Munich Automatic Segmentation, MAUS)强制对齐工具的网页界面(网络MAUS39 在 https://clarin.phonetik.uni-muenchen.de/BASWebServices/interface/Pipeline。
- 拖放每一对。波 / .txt 将文件从文件夹拖动到虚线矩形中 文件 (或单击矩形区域内) 图 2A).
- 点击 上传 按钮,将文件上传至比对工具中(参见图中红色箭头所示) 图 2A).
- 选择以下选项 服务选项 菜单图2B): G2P-MAUS-PHO2SYL 用于 管道名称;英语(美国) (用于 语言)如果 L1-L2 英语数据; 意大利语 (用于 语言)如果 L1-L2 脑电数据.
注意:我们为巴西葡萄牙语(BP)数据选择了“意大利语”,因为 webMAUS 未提供用于 BP 强制对齐的预训练声学模型。语音学文献指出,意大利语的音系具有一个对称的七元音系统,与巴西葡萄牙语的元音系统在某种程度上具有可比性40以及辅音声学上的相似性41,42. - 保留“输出格式”和“保留所有内容”的默认选项。
- 检查 运行 接受使用条款的选项框(见绿色箭头所示) 图 2C).
- 点击 运行网络服务 单击按钮以在比对工具中运行已上传的文件。
注意:对于每个音频文件,MAUS 强制对齐工具会返回一个 Praat 文本网格 一个Praat预格式化的“.txt”文件,其中包含基于从1.3.1步骤所述“.txt”文件中提取的语言学转录信息对词语、音系音节和音素进行的标注。 - 点击 下载为 ZIP 文件 下载 TextGrid 文件的按钮,以压缩文件形式图 2C).
注意:确保将压缩的 TextGrid 文件与音频文件下载到同一文件夹中。 - 提取TextGrid文件,以供后续在语音分析软件中进行重新对齐43.
- 进行重新比对。
- 获取并下载 Praat VVUnitAligner 的脚本44 来自 https://github.com/leonidasjr/VVunitAlignerCode_webMAUS/blob/main/VVunitAligner.praat
- 确认所有相同语言的文件对及 VVUnitAligner 脚本位于同一文件夹中。
注意:一个文件夹用于存放 L1-L2 英文文件和 VVunitAligner,另一个文件夹用于存放 L1-L2 BP 文件和 VVunitAligner。 - 打开语音分析软件。
- 点击 Praat | 打开 Praat 脚本… 从脚本调用 对象窗口.
- 点击 运行 单击按钮一次。
注意:一种称为 音素音节对齐 包含使用该脚本的设置的窗口将弹出在屏幕上(图3A). - 点击 语言 按钮,从“英语(美国)”、“葡萄牙语(巴西)”、“法语(法国)”或“西班牙语(西班牙)”中选择语言。
- 点击 组织块分割 按钮以选择“自动”、“强制(手动)”或“无”分割程序。
- 检查 保存 TextGrid 文件 自动保存新 TextGrid 文件的选项。
- 点击 确定 | 运行 用于从步骤 1.3.5.7 重新对齐音素单元的按钮
注意:对于每个音频文件,VVUnitAligner 将为第 1.3.7 节生成一个新的 TextGrid 文件图3B).
- 进行声学特征的自动提取。
- 获取并下载脚本 SpeechRhythmExtractor45 来自 https://github.com/leonidasjr/SpeechRhythmCode/blob/main/SpeechRhythmExtractor.praat,用于自动提取韵律-声学特征。
- 创建一个新文件夹,并将 SpeechRhythmExtractor 以及所有语言的音频/TextGrid 文件对放入该文件夹中。
- 打开语音分析软件。
- 点击 Praat | 打开 Praat 脚本… 从脚本调用 对象窗口.
- 点击 运行 仅按一次按钮。
注意:屏幕上将弹出一个包含脚本设置的表单。在输出的“.txt”文件名输入框中,相应地重命名文件或保留默认文件名。 - 检查 嗓音质量参数 保存选项 输出文件 VQ 用于声音质量(图 3C).
注意:此第二个输出文件(该 输出文件 VQ) 包含了1之间的差异参数st 以及第2个nd 谐波(H1-H2)与倒谱显著峰(CPP)9. - 检查 语言目标 可从“语言”、“方言”或“口音”标签中进行选择(图3C).
- 检查 单位 选择以赫兹(Hz)或半音(Semitones)为单位的 f0 特征图3C).
- 设置以下数值 基频阈值,基频最小值与最大值阈值(图3C).
注意:除非研究有特定目的或预设了特定的音频特征,强烈建议将步骤 1.3.7.9 的参数保留为默认值。 - 点击 确定 | 运行 用于声学特征的自动提取。
注意:该脚本 语音节奏提取器 返回一个以制表符分隔的“.txt”文件(输出文件/输出文件 VQ) 包含从说话人提取的声学特征。
- 统计分析
- 将包含声学特征的电子表格上传到 R 中46 环境(或任何选定的统计软件/环境)。
- 执行广义加性模型(GAMs)非参数统计分析。
- 在 R 中执行 GAM
- 输入以下命令并按下 输入.
library(mgcv)
model = gam(模型 = 韵律/声学特征 在分析中 ~ 这一 语言 + s(所选的 计量特征,由 = 的 语言) + 其他 韵律/声学特征数据 = 数据框)
注意:我们选择使用 R 编程语言来执行本实验方案的统计检验,因为 R 在学术界中的语音学家(及语言学家)群体中日益流行。R 已被广泛应用于语音学田野调查研究中47请注意,步骤 1.4.2.2 包含一段伪代码。请根据研究变量编写代码。

图 2:使用 MAUS 强制对齐工具进行音素对齐的截图。(A)虚线矩形区域用于拖放 'my_file.wav' / 'my_file.txt' 文件,或点击内部以从文件夹中搜索此类文件;上传按钮由红色箭头指示。(B)来自面板 A 的已上传文件(见蓝色箭头)、将要使用的处理流程、文件对的语言、返回的文件格式,以及用于保留所有文件的“真/假”按钮。(C)使用条款的复选框(见绿色箭头)、运行网络服务 按钮,以及结果(可供下载的 TextGrid 文件)。请点击此处查看此图的放大版本。
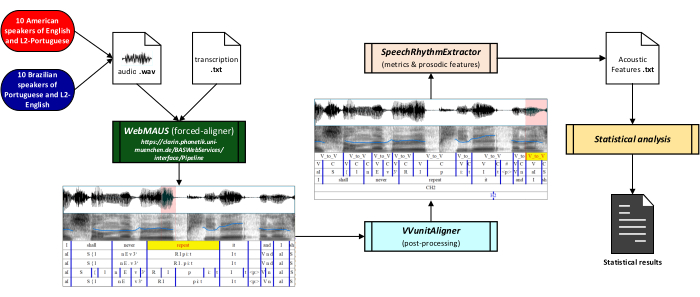
图3重定位过程的截图。 (A) 重定位程序的输入设置表单。B) 部分波形、宽带语谱图(含基频 f0 蓝色轮廓线),以及分段并标注的六个标注层 第一层级:元音起始点到下一个元音起始点的时间单位(V_to_V);元音起始点(V_to_V); 2级:元音(V)、辅音(C)和停顿(#)单位; 三级:语音表征 V_to_V; 4级:文本中的某些词语; 5级:文本中一些语音片段(CH);第6层:音调层,包含美国英语女性发音人产生的每个语音片段的最高(H)和最低(L)音调。C) 声学特征自动提取的输入设置。 请点击此处以查看此图的放大版本。
2. 语音感知
注意:我们使用美国听者进行了四次英语语音列队辨认实验,并使用巴西听者进行了四次巴西葡萄牙语(BP)语音列队辨认实验。语音感知实验流程图见图4。
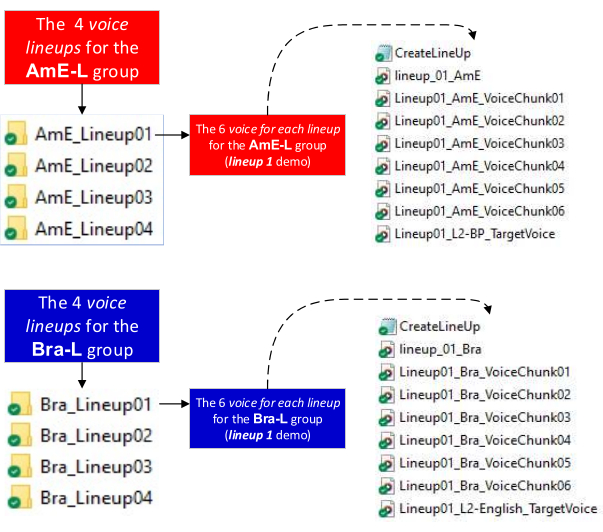
图4:言语感知的示意图流程图。 请点击此处查看此图的放大版本。
- 参与者
- 为每组选择与参与言语产生实验方案的受试者不同的新受试者。
注意:本部分实验方案选择了两组参与者: 第1组:该 上午erican E英语(美国) L听者(AmE-L),以及 第2组:该 文胸zilian L听者(Bra-L)。在本研究中,美式英语听者(AmE-L)和巴西听者(Bra-L)均被视为第二语言熟练者(两组均被评定为B2-C1水平)36 AmE-L 在进行实验程序时已在巴西生活了两年。Bra-L 在进行实验程序时已在美国生活了两年以上。在海外居住期间,两组均使用其第二语言(L2)进行学习和工作(每周至少六天,每天约4至5小时)。 - 确定 参与者人数,该 语言 (L1 英语,L2 BP;L1 BP,L2 英语), 性别 (女性或男性),该 年龄 (均值,标准差),该 群体特征 (专业人员或本科生)以及 L2 熟练水平 每组
- 为每组选择与参与言语产生实验方案的受试者不同的新受试者。
- 语音列队
注意:将语音列队的程序分为两个不同步骤:准备语音列队和实施语音列队。- 为英语准备四个语音列队,为巴西葡萄牙语准备四个语音列队。
- 从第1节“言语产生”的讲话者处获取音频文件。
- 确认每种语言因素的音频文件均存放在独立的文件夹中。
- 随机选择六段以英语为第一语言或以巴西葡萄牙语为第一语言的语音片段。
注意:队列中的六个声音代表 一个目标声音 和 五片箔材. - 从步骤 2.2.1.3 中包含的说话者中选择一段第二语言英语或第二语言巴西葡萄牙语的语音片段。
注意:步骤 2.2.1.4 中的语音片段是 参考声音片段时长应约为 20 秒。 - 访问并下载 Praat 创建音列的脚本48 来自 https://github.com/pabarbosa/prosody-scripts-CreateLineUp。
- 在运行 CreateLineup 脚本之前,请确认 L2 参考语音、L1 诱饵语音和 L1 目标语音均位于同一文件夹中图5).
- 打开语音分析软件。
- 从 对象窗口,点击 Praat | 打开 Praat 脚本… 调用脚本。
- 点击 运行 | 运行.
注意:该脚本返回的文件顺序如下:(L2参考语音)+(L1目标语音及干扰项随机分布)图5).
- 进行语音列队测试
- 创建一个在线空间,以在任意选定平台(例如 SurveyMonkey。参见 材料表用于远程进行语音列队辨认。
- 访问在线空间链接。
- 将 CreateLineup 脚本生成的文件上传至平台。
- 在参与者之前运行该程序,以测试每一步骤。
注意:建议预先访问该链接并运行队列,以检查一切是否正常运行。
- 为英语准备四个语音列队,为巴西葡萄牙语准备四个语音列队。
- 统计分析
- 将包含听者评分结果的电子表格上传至 R 环境(或其他选定的统计软件/环境)。
- 在 R 中执行 Kruskal-Wallis 检验。
- 输入以下命令并按下 输入.
模型 = kruskal.test(判断 ~ 每个 声音列队辨认,数据 = 该 数据框)
- 进行事后Dunn检验。
- 在 R 中执行 Dunn 检验。
- 输入以下命令并按下 输入.
library(FSA)
model = dunnTest(判断 ~ 每个 声音列队辨认,data = data,method = "bonferroni"
注意:步骤 2.3.1.2 和 2.3.2.2 中的代码为伪代码(参见注意 1.4.2.2)。
- 将包含听者评分结果的电子表格上传至 R 环境(或其他选定的统计软件/环境)。
- 声学相似性分析
- 选择在目标与任一干扰项之间无显著差异的队列(参见步骤 2.2.1.3 中的注释)。
- 重复执行步骤 1.3.1 至 1.3.7.5,以及步骤 1.3.7.8 至 1.3.7.10 的操作。
- 获取并下载 Python 脚本49,声学相似性_余弦_欧几里得50 来自 https://github.com/leonidasjr/AcousticSimilarity/blob/main/AcousticSmilarity_cosine_euclidean.py。
注意:该脚本返回三个矩阵(格式为“.txt”和“.csv”):一个用于余弦相似性51,52,一个用于欧几里得距离52,53以及一个用于转换后的欧氏距离值,并对目标声音与每个干扰项进行成对比较。 - 确认脚本已下载至与阵容数据集相同的文件夹中。
- 点击 打开文件… 单击按钮以调用脚本。
- 点击 运行 | 不调试运行 按钮。
注意:第二个 运行 按钮可能被标记为 运行或不调试运行 或 运行脚本。 它们都执行相同的命令,仅取决于所使用的 Python 环境。 - 基于声学特征进行语音相似性测试。
注意:余弦相似度(或余弦距离)是一种应用于人工智能(AI)中的技术,尤其用于自动语音识别(ASR)系统的机器学习。它是一种介于零和一之间的相似性度量。余弦相似度接近一时,表示两种声音很可能相似;余弦相似度接近零时,表示两种声音很可能不相似。52欧几里得距离,常被称为欧几里得相似度,也广泛应用于人工智能、机器学习和自动语音识别(ASR)中。它表示在欧几里得空间中两点之间的直线距离。53即点之间的距离越近(距离值越小),声音越相似。为了更清晰地理解两种技术的报告结果,我们将欧氏距离的原始得分转换为从0(声音相似性最低)到1(声音相似性最高)的数值。54.

图 5:言语感知实验的目录设置。 队列文件夹。每个文件夹包含六种母语者(L1)语音、一种目标第二语言(L2)语音、“CreateLineup”脚本以及运行脚本后生成的语音队列音频文件。请点击此处查看该图的放大版本。
访问受限。请登录或开始试用以查看此内容。
结果
言语产生的结果
在本节中,我们描述了具有统计学显著性的韵律-声学特征和节奏性指标的表现。这些韵律特征包括与持续时间相关的言语、发音和停顿速率,以及与声音质量相关的微扰(shimmer)。节奏性指标包括音节时长的标准差(SD)、辅音时长的标准差、元音或辅音时长的标准差,以及音节时长的变异系数(参见补充表 S1)。
对于英语为第二语言(L1-L2英语)的学习者,其语速(图6A)下降得比以巴西葡萄牙语为第二语言(L1-L2 BP)的学习者更迅速,尽管两种第二语言的语速均较低。该语速与三个指标相关:音节时长的标准差(SD-S)、元音时长的标准差(SD-V)以及音节变异系数(Varco-S)。还需注意的是,AmE-S组和Bra-S组的受试者对其第二语言均具有较高熟练度。似乎L1-L2 B...
访问受限。请登录或开始试用以查看此内容。
讨论
本方案在(法医)语音学领域具有创新性,分为两个阶段:一个基于发音(声学分析),另一个基于感知(听辨分析)。发音分析阶段包括数据准备、强制对齐、重新对齐以及韵律-声学特征的自动提取,此外还包括统计分析。该方案相较于主要依赖人工分段的传统方案,能够以更快且更高效的方式连接数据采集与数据分析阶段。
然而,重对齐过程(如方案步骤 1.3.6 至 1.3.6.9 所示)主要基于方案步骤 1.3.1 至 1.3.4 中生成的音素和词单元进行操作。该重对齐过程的创新之处在于,它生成了一个新的 TextGrid,其中包含三个新的文本层:一个音节层、一个语音语块层(可根据词自动或手动生成),以及一个声调层(可用于计算基频 f0 参数)。本方案所提出的重对齐准则此前已应用于二语语音节奏的研究21,69,70、利用机器学习技术检测外语口音程度的研究22,以及法医学领域的相...
访问受限。请登录或开始试用以查看此内容。
披露
作者声明无任何利益冲突。
致谢
本研究由国家科学技术发展委员会(CNPq)资助,第一作者获资助号 307010/2022-8,第二作者获资助号 302194/2019-3。作者谨向参与本研究的各位受试者致以诚挚的感谢,感谢他们慷慨的合作与宝贵贡献。
访问受限。请登录或开始试用以查看此内容。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| 创建队列 | 个人收藏 | # | 用于准备语音队列的 Praat 脚本 |
| Dell I3 (带固态硬盘 - SSD) | Dell | # | 笔记本电脑 |
| Praat | Paul Boersma & David Weenink | # | 语音学分析软件 |
| Python 3 | Python 软件基金会 | # | 解释型、高级、通用编程语言 |
| R | 统计计算 R 项目 | # | 用于统计计算的编程语言 |
| Shure Beta SM7B | Shure | # | 麦克风 |
| SpeechRhythmExtractor | 个人收藏 | # | 用于自动提取声学特征的 Praat 脚本 |
| SurveyMonkey | SurveyMonkey 公司 | # | 提供免费可自定义的调查问卷集合,以及一系列后端程序,包括数据分析、样本选择、去偏和数据呈现。 |
| Tascam DR-100 MKII | Tascam | # | 数字语音录音机 |
| 慕尼黑自动分割系统 MAUS | 慕尼黑大学 | # | 用于音频文件(.wav)和语言信息文件(.txt)的强制对齐工具 |
| VVUnitAligner | 个人收藏 | # | 用于语音单元自动重对齐和后处理的 Praat 脚本 |
参考文献
- Moyer, A. Foreign Accent: The Phenomenon of Non-native Speech. , Cambridge University Press. (2013).
- Munro, M., Derwing, T. Foreign accent, comprehensibility and intelligibility, redux. J Second Lang Pronunciation. 6 (3), 283-309 (2020).
- Levis, J. Intelligibility, Oral Communication, and the Teaching of Pronunciation. , Cambridge University Press. (2018).
- Munro, M. Applying Phonetics: Speech Science in Everyday Life. , Wiley-Blackwell. (2022).
- Gut, U. Speaker Classification. Muller, C. , Springer-Verlag. 75-87 (2007).
- Rogers, H. Foreign accent in voice discrimination: a case study. Forensic Linguistics. 5 (2), 203-208 (1998).
- Solan, L., Tiersma, P. Hearing Voices: Speaker Identification in Court. Hastings Law Journal. 54, 373-436 (2003).
- Alcaraz, J. The long-term average spectrum in forensic phonetics: From collation to discrimination of speakers. Estudios de Fonética Experimental / Journal o Experimental Phonetics. 32, 87-110 (2023).
- Silva, L. Jr, Barbosa, P. A. Voice disguise and foreign accent: Prosodic aspects of English produced by Brazilian Portuguese speakers. Estudios de Fonética Experimental / Journal o Experimental Phonetics. 32, 195-226 (2023).
- Munro, M., Derwing, T. Modeling perceptions of the accentedness and comprehensibility of L2 speech. Studies in Second Language Acquisition. 23 (4), 451-468 (2001).
- Keating, P., Esposito, C. Linguistic Voice Quality. Working Papers in Phonetics. , 85-91 (2007).
- Niebuhr, O., Skarnitzl, R., Tylečková, L. The acoustic fingerprint of a charismatic voice -Initial evidence from correlations between long-term spectral features and listener ratings. Proceedings of Speech Prosody. , 359-363 (2018).
- Segundo San, E. International survey on voice quality: Forensic practitioners versus voice therapists. Estudios de Fonética Experimental. 29, 8-34 (2021).
- Farrús, M. Fusing prosodic and acoustic information for speaker recognition. International Journal of Speech, Language and the Law. 16 (1), 169(2009).
- Farrús, M. Voice disguise in automatic speaker recognition. ACM Computing Surveys. 51 (4), 1-2 (2018).
- Nolan, F. A recent voice parade. The International Journal of Speech, Language and the Law. 10 (2), 277-291 (2003).
- McDougall, K. Ear-catching versus eye-catching? Some developments and current challenges in earwitness identification evidence. Speaker Individuality in Phonetics and Speech Sciences. Bernardasci, C., Dipino, D., Garassino, D., Negrinelli, S., Pellegrino, E., Schmid, S. , Officinaventuno. 33-56 (2021).
- Gut, U. Rhythm in L2 speech. Speech and Language Technology. 14 (15), 83-94 (2012).
- Urbani, M. Pitch Range in L1/L2 English. An Analysis of F0 using LTD and Linguistic Measures. Coop. , Libraria Editrice Università di Padova. (2012).
- Gonzales, A., Ishihara, S., Tsurutani, C. Perception modeling of native and foreign-accented Japanese speech based on prosodic features of pitch accent. J Acoust Soc Am. 133 (5), 3572(2013).
- Silva, L. Jr, Barbosa, P. A. Speech rhythm of English as L2: an investigation of prosodic variables on the production of Brazilian Portuguese speakers. J Speech Sci. 8 (2), 37-57 (2019).
- Foreign accent and L2 speech rhythm of English a pilot study based on metric and prosodic parameters. Silva, L. Jr, Barbosa, P. A. Proceedings of the II Brazilian Conference on Prosody (Anais II Congresso Brasileiro de Prosódia), 1, 41-50 (2023).
- Costa, A. El cerebro bilingüe: La neurociencia del lenguaje. , Penguin Randon House. (2017).
- Eriksson, A. Tutorial on forensic speech science: Part I. Forensic Phonetics. , (2005).
- Harvey, M., Giroux, M., Price, H. Lineup size influences voice identification accuracy. Applied Cognitive Psychology. 37 (5), 42-89 (2023).
- Pautz, N., et al. Identifying unfamiliar voices: Examining the system variables of sample duration and parade size. Q J Exp Psychol (Hove). 76 (12), 2804-2822 (2023).
- McDougall, K., Nolan, F., Hudson, T. Telephone transmission and earwitnesses: Performance on voice parades controlled for voice similarity. Phonetica. 72 (4), 257-272 (2015).
- Nolan, F., McDougall, K., Hudson, T. Some acoustic correlates of perceived (dis) similarity between same-accent voices. Proceedings of the International Congress of Phonetic Sciences (ICPhS 2011). , 1506-1509 (2011).
- Sheoran, S., Mahna, D. Voice identification and speech recognition: an arena of voice acoustics. Eur Chem Bull. 12 (5), 50-60 (2023).
- Hudson, T., McDougall, K., Hughes, V. Forensic phonetics. The Cambridge Handbook of Phonetics. Knight, R. -A., Setter, J. , Cambridge University Press. 631-656 (2021).
- Eriksson, A. The disguised voice: Imitating accents or speech styles and impersonating individuals. Language and identities. Llamas, C., Watt, D. , Edinburgh University Press. 86-96 (2010).
- Köster, O., Schiller, N. Different influences of the native language of a listener on speaker recognition. Forensic Linguistics. 4 (1), 18-27 (1997).
- The influence of native-language background on speaker recognition. Köster, O., Schiller, N., Künzel, H. Proceedings of the International Congress of Phonetic Sciences (ICPhS 1995), , 306-309 (1995).
- Thompson, C. P. A language effect in voice identification. Applied Cognitive Psychology. 1, 121-131 (1987).
- San Segundo, E., Univaso, P., Gurlekian, J. Sistema multiparamétrico para la comparación forense de hablantes. Estudios de Fonética Experimental. 28, 13-45 (2019).
- Council of Europe. Common European Framework of Reference for Languages: Learning, Teaching, Assessment. , Press Syndicate of the University of Cambridge. (2001).
- How to use Tascam DR-100 MKII: Getting started. , https://www.youtube.com/watch?v=O2E72uV9fWc (2018).
- Getting the most from your Shure SM58 microphone. , https://www.youtube.com/watch?v=wweNufW7EXA (2020).
- Kisler, T., Reichel, U. D., Schiel, F. Multilingual processing of speech via web services. Computer Speech & Language. 45, https://clarin.phonetik.uni-muenchen.de/BASWebServices/interface/WebMAUSBasic 326-347 (2017).
- Escudero, P., Boersma, P., Rauber, A., Bion, R. A cross-dialect acoustic description of vowels: Brazilian and European Portuguese. J Acoust Soc Am. 126 (3), 1379-1393 (2009).
- Post-aspiration in standard Italian: some first cross-regional acoustic evidence. Stevens, M., Hajek, J. Proceedings 11th Conference of the International Speech Communication Association (INTERSPEECH 2010), , 1557-1560 (2011).
- Barbosa, P., Madureira, S. Manual de Fonética Acústica Experimental: aplicações a dados do português. , Cortez. (2015).
- Boersma, P., Weenink, D. Praat: Doing phonetics by computer. (Version 6.1.38) [Computer program]. , https://www.praat.org/ (1992-2021).
- Silva, L. Jr VVUnitAligner. [Computer program]. , https://github.com/leonidasjr/VVunitAlignerCode_webMAUS (2022).
- Silva, L. Jr, Barbosa, P. A. SpeechRhythmExtractor [Computer program]. , https://github.com/leonidasjr/VowelCode (2019-2023).
- R Core Team. A language and environment for statistical computing. R Foundation for Statistical Computing. , https://www.R-project.org/ (2023).
- Pigoli, D., Hadjipantelis, P. Z., Coleman, J. Z., Aston, J. The statistical analysis of acoustic phonetic data. Journal of the Royal Statistical Society. 67 (5), 1103-1145 (2018).
- Barbosa, P. A. CreateLineup [Computer program]. , https://github.com/pabarbosa/prosody-scripts-CreateLineUp (2021).
- Van Rossum, G., Drake, F. L. Python 3 Reference Manual. , CreateSpace. (2009).
- Silva, L. Jr AcousticSimilarity_cosine_euclidean. [Computer program]. , https://github.com/leonidasjr/AcousticSimilarity/blob/main/AcousticSmilarity_cosine_euclidean.py (2024).
- Automatic assessment of voice similarity within and across speaker groups with different accents. Gerlach, L., McDougall, K., Kelly, F., Alexander, A. Proceedings of the International Congress of Phonetic Sciences (ICPhS 2023), , 3785-3789 (2023).
- Gahman, N., Elangovan, V. A comparison of document similarity algorithms. International Journal of Artificial Intelligence and Applications. 14 (2), 41-50 (2023).
- San Segundo, E., Tsanas, A., Gómez-Vilda, P. Euclidean distances as measures of speaker similarity including identical twin pairs: A forensic investigation using source and Filter voice characteristics. Forensic Science International. 270, 25-38 (2017).
- Speaker's voice characteristics and similarity measurement using Euclidean distances. Singh, M. K., Singh, N., Singh, A. K. Proceedings of the International Conference on Signal Processing and Communication (ICSC 2019), , 317-322 (2019).
- Darling-White, M., Banks, W. Speech rate varies with sentence length in typically developing children. J Speech Lang Hear Res. 64 (6), 2385-2391 (2021).
- Barbosa, P. A. Incursões em torno do ritmo da Fala. , Pontes Editores. (2006).
- Golestani, N., Pallier, C. Anatomical correlates of foreign speech sound production. Cereb Cortex. 17 (4), 929-934 (2007).
- Trouvain, J., Fauth, C., Möbius, B. Breath and non-breath pauses in fluent and disfluent phases of German and French L1 and L2 read speech. Proceedings of Speech Prosody. , 31-35 (2016).
- Waaning, J. The Lombard effect: the effects of noise exposure and being instructed to speak clearly on speech acoustic parameters. [Master's thesis]. , Radboud University. (2021).
- Villegas, J., Perkins, J., Wilson, I. Effects of task and language nativeness on the Lombard effect and on its onset and offset timing. J Acoust Soc Am. 149 (3), 1855(2021).
- Differences between native and non-native Lombard speech in terms of pitch range. Proceedings of the 23rd International Congress on Acoustics(ICA 2019). Marcoux, K., Ernestus, M. , 5713-5720 (2019).
- Marcoux, K., Ernestus, M. Pitch in native and non-native Lombard speech. Proceedings of the International Congress of Phonetic Sciences (ICPhS 2019). , 2605-2609 (2019).
- Marcoux, K., Ernestus, M. Acoustic characteristics of non-native Lombard speech in the DELNN corpus. Journal of Phonetics. 102, 1-25 (2024).
- Gil, J., San Segundo, E. La cualidad de voz en fonética judicial [Voice quality in judicial phonetics]. Lingüística Forense: la Lingüística en el ámbito legal y policial. Garayzábal, M., Jiménez, M., Reigosa, M. , Euphonía Ediciones. 154-199 (2014).
- Gil, J., San Segundo, E. El disimulo de la cualidad de voz en fonética judicial: Estudio perceptivo de la hiponasalidad [Voice quality disguise in judicial phonetics: A perceptual study of hyponasality. Panorama de la fonética española actual. Penas-báñez, M. A. , Arco Libros. 321-366 (2013).
- Passeti, R., Madureira, S., Barbosa, P. What can voice line-ups tell us about voice similarity. Proceedings of the International Congress of Phonetic Sciences (ICPhS 2023). , 3765-3769 (2023).
- Nolan, F. The DyViS database: Style-controlled recordings of 100 homogeneous speakers for forensic phonetic research. International Journal of Speech Language and the Law. 16 (1), 31-57 (2009).
- Caroll, D. Psychology of Language. , Wadsworth. (1994).
- Ortega-Llebaria, M., Silva, L. Jr, Nagao, J. Macro- and micro-rhythm in L2 English: Exploration and Refinement of Measures. Proceedings of the International Congress of Phonetic Sciences (ICPhS 2023). , 1582-1586 (2023).
- Fernández-Trinidad, M. Hacia la aplicabilidad de la cualidad de la voz en fonética judicial. Loquens. 9 (1-2), 1-11 (2022).
- Brouwer, S. The role of foreign accent and short-term exposure in speech-in-speech recognition. Atten Percep Psychophys. 81, 2053-2062 (2019).
- Love, R., Wright, D. Specifying challenges in transcribing covert recordings: Implications for forensic transcription. Front Commun. 6, 1-14 (2021).
- Meer, P. Automatic alignment for New Englishes: Applying state-of-the-art aligners to Trinidadian English. J Acoust Soc Am. 147 (4), 2283-2294 (2020).
- Montreal Forced Aligner: trainable text-speech alignment using Kaldi. McAuliffe, M., Socolof, M., Mihuc, S., Wagner, M., Sonderegger, M. Proceedings 18th Conference of the International Speech Communication Association (INTERSPEECH 2017), , 498-502 (2017).
- Chodroff, E. Montreal Forced Aligner: MFA Tutorial. , https://zenodo.org/records/7591607 (2023).
访问受限。请登录或开始试用以查看此内容。
重印与许可
