我们提出了一种灵活且可扩展的基于 Jupyter-lab 的工作流程,用于对复杂的多组学数据集进行无监督分析,该流程整合了不同的预处理步骤、多组学因子分析模型的估计以及多种下游分析方法。
需要JoVE订阅才能观看此内容。 请登录或开始免费试用
本文内容
摘要
摘要
疾病机制通常十分复杂,由多种不同的分子过程相互作用所决定。复杂且多维度的数据集是深入理解这些过程的宝贵资源,但由于高维度性(例如来自不同疾病状态、时间点以及在不同分辨率下获取的组学数据)使得此类数据集的分析具有挑战性。
本文展示了一种无监督分析方法,通过将多组学因子分析(MOFA)应用于来自血液样本的数据集,以分析和探索急性与慢性冠状动脉综合征中免疫应答的复杂多组学数据。该数据集包含多种不同分辨率的检测数据,包括样本水平的细胞因子数据、血浆蛋白质组学和中性粒细胞prime-seq,以及单细胞RNA测序(scRNA-seq) 数据。此外,每位患者在多个不同时间点进行了测量,并包含多个患者亚组,进一步增加了数据的复杂性。
分析工作流程概述了如何分多个步骤整合和分析数据:(1)数据预处理与标准化,(2)MOFA模型的估计,(3)下游分析。步骤1概述了如何处理不同数据类型的特征,过滤低质量特征,并对其进行标准化以统一其分布,为后续分析做准备。步骤2展示了如何应用MOFA模型,并探索在整个数据集所有组学数据和特征中主要的变异来源。步骤3介绍了多种针对所捕获模式的下游分析策略,将其与疾病状态及可能调控这些状态的分子过程相联系。
总体而言,我们提出了一种针对复杂多组学数据集的无监督数据探索工作流程,可用于识别由不同分子特征构成的主要变异轴,该方法也可应用于其他场景和多组学数据集(包括示例性应用案例中所示的其他检测方法)。
引言
疾病机制通常十分复杂,由多种不同的分子过程相互作用所决定。解析导致特定疾病或调控疾病进展的复杂分子机制是一项具有重要医学意义的任务,因为这可能为理解和治疗疾病提供新的见解。
近年来的技术进步使得能够在更高分辨率(例如单细胞水平)和多个生物层面(例如DNA、mRNA、染色质可及性、DNA甲基化、蛋白质组学)上同时测量这些过程。这导致了大规模多维生物数据集的不断增多,这些数据集可进行联合分析,从而更深入地揭示潜在的生物学过程。与此同时,以符合生物学意义的方式整合并分析不同数据来源仍是一项具有挑战性的任务1。
不同组学技术之间的技术限制、噪声水平以及变异范围差异构成了一个挑战。例如,单细胞RNA测序(scRNA-seq)数据通常非常稀疏,并常受到较大的技术偏差或批次效应影响。此外,其特征空间通常非常庞大,涵盖数千个被检测的基因或蛋白质,而样本量却有限。复杂的实验设计进一步加剧了这一问题,这些设计可能包含多种疾病状态、混杂因素、时间点以及不同分辨率。例如,在本展示的应用案例中,不同类型的数据分别来自单细胞水平或样本(批量)水平。除此之外,数据可能不完整,并非所有分析对象都具备全部测量值。
由于这些挑战,不同的组学及其包含的特征通常仍被单独分析2,尽管整合分析不仅能够提供对整个过程的全面认识,而且一种组学中的生物学或技术性噪声也可能被其他组学所补偿3,4。已有多种方法被提出用于开展多组学数据的整合分析,包括贝叶斯方法、基于网络的方法5,6、多模态深度学习7,以及通过矩阵分解实现的降维方法8,9。在这些方法中,一项大规模基准研究10的结果表明,当需要将数据与临床注释关联时,MOFA9(多组学因子分析)方法是较为适用的工具之一。
在复杂场景中,无监督矩阵分解方法是一种有效手段,可用于降低复杂性,并从不同数据源和特征中提取共有的及互补的信号。通过将复杂空间分解为低秩的潜在表征,可快速探索数据中的主要变异来源,并将其与已知的协变量关联起来。当多个特征(例如基因或蛋白质)之间存在相同的变异模式时,这些模式可被聚合为少数几个因子,同时降低噪声。正则化可用于提高模型系数的稀疏性,这使得该方法在特征空间较大而样本数量有限的情况下尤为适用9。
本方案介绍了一种灵活的分析工作流程,利用MOFA模型展示如何快速探索复杂的多组学数据集,并提取表征该数据集的主要变异模式。该工作流程包括三个主要步骤。第一步为数据预处理与标准化,介绍了针对不同输入数据类型(单细胞RNA测序、蛋白质组学、细胞因子、临床数据)的数据预处理策略。本方案详细阐述了如何处理不同输入数据集的特征,过滤低质量特征,并对其进行标准化以统一其分布。我们还展示了这些预处理决策可能对下游分析结果产生的影响。第二步是将MOFA模型应用于数据,所得的方差分解结果可用于评估不同数据集的整合效果。第三步展示了如何将提取出的潜在因子与协变量关联,进而揭示定义这些因子的分子程序。通过本工作流程,我们能够从冠状动脉综合征患者数据集中提取出多个与临床协变量相关的潜在因子,并从先前的研究项目中识别出潜在的多细胞免疫程序11。本文将以该数据集为例进行说明,但本方案也可轻松应用于其他场景,包括其他组学数据。
该数据集包含来自稳定型慢性冠状动脉综合征(CCS)患者、急性冠状动脉综合征(ACS)患者以及冠状动脉健康对照组(非CCS)的样本(图1)。ACS通常由既有的CCS斑块破裂引起,导致心肌血流急性中断,进而造成心肌缺血性损伤。这种损伤会引发免疫系统的炎症反应,随后进入修复阶段,该阶段可持续至急性事件发生后的数天12。为了表征ACS患者的免疫反应,分别在四个不同时间点采集了血液样本:急性期(TP1);再通后(14 [± 8] h)(TP2);再通后60 [± 12] h(TP3);出院前(6.5 [±1.5] 天)(TP4)(图1A)。对于CCS患者及冠状动脉健康者,仅有一个时间点的样本可用(TP0)。针对所有患者及各时间点,基于血液样本开展了多种检测:炎症临床标志物(肌酸激酶(CK)、CK-MB、肌钙蛋白、C反应蛋白(CRP))、外周血单个核细胞(PBMCs)的单细胞RNA测序(scRNA-seq)、细胞因子分析、血浆蛋白质组学以及中性粒细胞的prime-seq13数据。

图 1:心肌梗死多组学输入数据集。 输入数据集:分析的数据包括来自急性冠脉综合征(ACS)患者(n = 62)、慢性冠脉综合征(CCS)患者以及冠状动脉健康患者(非 CCS)的血液样本。ACS 患者的血液样本包含四个不同时间点(TP1–4),CCS 和非 CCS 患者的样本则仅包含一个时间点(TP0)。每个患者与时间点的组合在分析中被视为独立的样本。对样本进行了多种组学检测:临床血液检测(n = 125)、单细胞 RNA 测序(scRNA-seq,n = 121)、血浆蛋白质组学(plasma-proteomics,n = 119)、细胞因子检测(cytokine assay,n = 127)以及中性粒细胞 prime-seq(neutrophil prime-seq,n = 121)。随后,应用所述方案对所有组学数据进行整合,并利用 MOFA 模型及后续下游分析(因子分析、通路富集)对数据进行探索。请点击此处查看该图的放大版本。
在此工作流程中,我们采用经过 cellranger 处理并完成质控(QC)后的单细胞 RNA 测序(scRNA-seq)数据的原始计数作为输入,质控步骤例如参照 scanpy14 预处理教程所述。对于细胞类型注释,我们使用了自动化的 Azimuth15 分析流程。随后,针对每一样本和每种细胞类型,通过计算所有细胞的均值得到样本水平的计数汇总(伪批量聚合)。血浆蛋白质组学数据以归一化并经中位数中心化的强度值形式纳入分析;对于中性粒细胞,则采用 prime-seq 数据中的唯一分子标识符(UMI)外显子计数。细胞因子和临床指标数据未进行任何前期预处理。有关(实验)数据生成的更多细节详见相应研究论文11。由于本文所呈现的结果基于在 scRNA-seq 数据中使用自动化的 Azimuth 注释方法,而参考文献中采用的是基于标记基因的注释策略,因此本文结果与发表结果相似,但并不完全相同。原论文已表明,细胞类型注释策略不会改变分析的主要模式和生物学解释,但模型得出的具体数值可能存在细微差异。总体而言,输入数据是一个复杂的多维数据集,包含超过 10,000 个不同特征(基因、蛋白质、临床指标),并涵盖多个时间点以及不同测量层次(单细胞与批量)的数据。严格的预处理与数据标准化策略结合 MOFA 分析,已被证明是探索数据并提取相关免疫程序的有效且快速的工具。在 MOFA 分析中,每个时间点与患者的组合被视为一个独立的样本,每种数据类型和每种细胞类型均被视为一个独立的“视角”(view)。
本方案提供了准备工作流程输入数据、执行不同工作流程步骤、自定义配置参数、解读所得结果图以及根据解读结果迭代调整配置参数的操作说明。各步骤的技术流程概览(图2)展示了本方案各个步骤的总体流程、每步所需的输入数据集以及生成的图表和数据集。
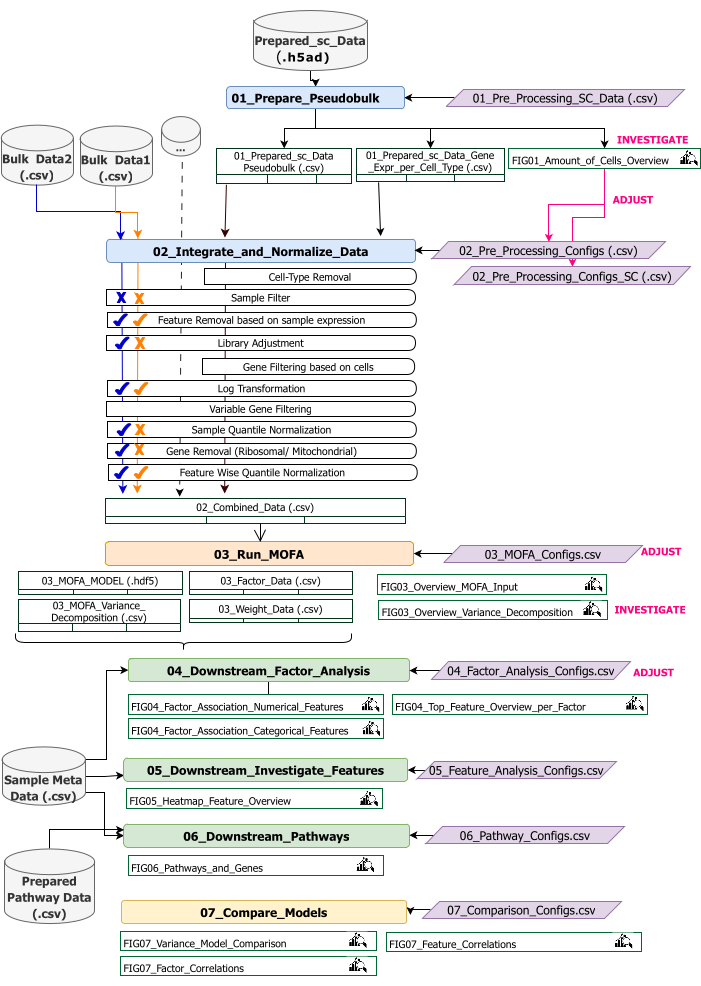
图2:技术工作流程概览。 多组学数据集分析的工作流程示意图。不同元素通过不同颜色和符号加以区分。属于“数据预处理与整合”(1)步骤的 Jupyter Notebook 以蓝色表示。属于“MOFA 模型”(2)步骤的 Jupyter Notebook 以橙色表示。属于“下游分析”(3)步骤的 Jupyter Notebook 以绿色表示。用于结果比较的一个 Jupyter Notebook 以黄色表示。可修改工作流程执行参数的配置文件以紫色突出显示。运行工作流程所需的输入数据集以数据集符号表示,并以灰色突出显示。工作流程执行过程中生成的所有图形输出均以放大镜符号表示。工作流程执行过程中生成的数据集以表格形式表示。总体而言,该工作流程按顺序执行:(1)数据预处理与整合包含两个步骤:首先基于单细胞 RNA 测序(scRNA-seq)输入数据生成伪批量数据表(01_Prepare_Pseudobulk),随后将该数据与其他所有样本水平(批量)输入数据进行整合与归一化(02_Integrate_and_Normalize_Data)。在此步骤中,可通过配置文件分别为每个数据集单独配置应应用哪些指定的预处理和归一化步骤(例如样本过滤)。(2)“MOFA 模型”:使用配置文件(03_MOFA_configs.csv)中指定的配置,对第一步生成的输入数据运行 MOFA 模型。(3)“下游分析”:包含三个不同的 Notebook,可独立运行,用于深入解析生成的 MOFA 结果,并将其与通过“Sample Meta Data.csv”文件提供的样本元数据(协变量)相关联。(4)“模型比较”:是一个独立的小步骤,可用于比较在步骤 2 中生成的不同模型。请点击此处查看该图的放大版本。
该工作流程包含多个使用 R 和 Python 编写的 Jupyter Notebook(运行流程无需掌握 R 或 Python 语言,但若出现错误,具备相关知识可能有所帮助)。在本实验方案的多个步骤中,参数通过配置文件(文件名中包含后缀“_Configs”的“.csv”文件)进行修改。在本方案中,我们仅说明从默认配置出发需要更改的参数。
其他多个参数也可进行调整,例如用于自定义预处理过程。这些参数的详细说明包含在下载的代码库所附带的文件“Documentation_Config_Parameter”中。
访问受限。请登录或开始试用以查看此内容。
方案
1. 准备工作:技术设置与安装
注意:运行此程序前,请确保设备上已预安装 wget、git 和 Apptainer。有关在不同系统(Linux、Windows、Mac)上安装 Apptainer 的指南,请访问:https://apptainer.org/docs/admin/main/installation.html。有关 git 安装的信息,请参见:https://git-scm.com/book/en/v2/Getting-Started-Installing-Git。根据输入数据集的大小,建议在配置合适的计算机上运行该工作流(16 核 CPU,64 GB 内存)。可使用提供的示例数据在本地机器上执行冒烟测试。在示例数据上运行本实验方案的操作说明及预期结果详见补充文件 1。有关在上述数据集上执行的关键实验步骤,请参见补充视频文件 1。
- 打开控制台,选择或创建一个文件夹用于存储所有分析代码和输出结果。在终端中输入命令:cd path_to_folder ,进入该文件夹。
- 从 Github 下载或克隆代码仓库(https://github.com/heiniglab/mofa_workflow),或在终端窗口中输入命令:git clone https://github.com/heiniglab/mofa_workflow.git。
- 在终端窗口中输入命令:wget https://zenodo.org/records/11192947/files/mofa_image.sif,从 Zenodo 下载包含所有必要安装程序的镜像文件。
- 在终端窗口中输入命令:mkdir results,创建一个用于存储所有结果数据的文件夹。
- 在终端窗口中输入命令:mkdir input_data,创建一个用于存放分析所需输入数据的文件夹。
- 在终端中输入以下命令以启动容器并开启 JupyterLab 会话:apptainer run mofa_image.sif。将命令返回的 URL 复制到浏览器中,即可打开 JupyterLab 会话(有关 JupyterLab 的更多信息,请参见软件文档16)。
注意:若在本地笔记本电脑上运行该工作流程,建议改用命令 apptainer exec mofa_image.sif jupyter-lab,该命令将直接返回本地主机地址。如果在集群计算环境中运行容器,可能需要通过 ssh 设置端口转发。
2. 初始化与数据准备
- 在 Jupyter-Lab 会话中,使用左侧的导航菜单。导航至 input_data 双击文件夹 input_data.
- 将所有将用作分析输入的数据集复制到 input_data 目录中 拖拽&滴将文件从当前所在文件夹拖动到 Jupyter-lab 会话中 input_data 文件夹下方的区域。
注意:所有数据集必须位于以下任一位置 .csv 或 .h5ad (对于单细胞数据而言)格式。所有 .csv 文件必须包含匹配的 样本编号 列(数据集之间必须使用相同的 ID)。所有其他列将用作特征。在 h5ad- 文件中,细胞注释必须包含两个标识符以指定 样本编号 和 cluster_id这些数据将用于聚合和匹配。其他格式的组学数据集需要转换为指定格式 .csv 使用前进行格式化(图3)。给定的单细胞RNA测序(scRNA-seq)数据集 .h5seurat 格式可能会被转换 .h5ad 执行 Jupyter 笔记本: 00_数据转换.ipynb. - 导航至 构型 点击文件夹 文件夹 符号,然后双击文件夹 mofa_workflow,脚本, 和 构型在文件夹中,打开该文件 Data_configs.csv 双击即可。
- 在 值 列,添加文件夹路径到 input_data (data_path)和 结果 (result_path)文件夹。添加一个名称,该名称将作为文件扩展名添加到所有保存的文件中 值 用于的柱 配置名称 (本方案采用 MI_v1 [心肌梗死 第1版]图4).
- 单击以保存更改 文件 > 保存 CSV 文件 在顶部菜单中。
- 使用左侧的导航菜单,通过点击进入脚本文件夹 脚本. 双击以打开初始化笔记本 00_配置更新.ipynb。通过点击执行该脚本 重启内核并运行所有单元格 顶部的按钮,然后单击 重启 在弹出窗口中(图5).

图 3:数据输入与设置。 为执行该工作流程,所有数据必须存储在指定的 input_data 文件夹中。每个输入数据集应提供单独的文件。单细胞数据应以 .h5ad 格式提供,其中包含基于 cluster_id 的细胞注释(例如,来自先前的细胞类型注释步骤的结果)以及一列 sample_id(唯一标识每个待分析的独立样本)。所有其他输入数据集应以 '.csv' 格式提供,包含一列表示 sample_id(需与单细胞数据中的对应列匹配),其余各列则为将在 MOFA 分析中使用的特征。请点击此处查看该图的放大版本。
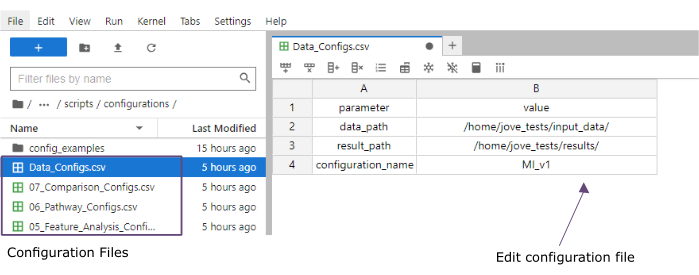
图 4:Jupyter-lab 配置文件。 在工作流程执行过程中,参数的更改(例如调整过滤选项等)通过“.csv”配置文件进行指定。在克隆的代码仓库中,已包含每个步骤的默认配置文件。这些文件可在 Jupyter-lab 控制台中直接编辑,方式类似于电子表格。 请点击此处查看此图的放大版本。
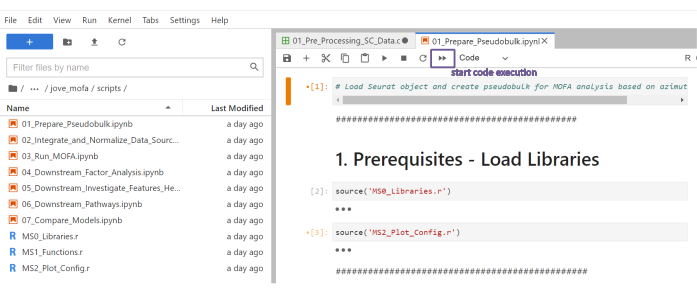
图 5:Jupyter Notebook 脚本。 完整的工作流程由一系列 Jupyter Notebook 组成,需在修改相应的配置文件后依次执行。通过双击左侧的 Jupyter Notebook,可在右侧打开对应的文件。可点击顶部高亮显示的按钮开始完整执行该文件。请点击此处查看该图的放大版本。
3. 数据预处理与标准化
- 预处理——将单细胞数据转换为伪批量数据。
注意:仅当分析中使用单细胞数据时,才需要执行此步骤。- 使用左侧的导航菜单,通过双击configuration进入配置文件夹。通过双击打开文件01_Preprocessing_SC_Data.csv。检查文件中自动填充的值,如有必要,调整data_name 列中的值,使其与input_data 文件夹中将用于分析的单细胞数据集的文件名相对应。
注意:默认情况下,初始化脚本会将输入数据文件夹中所有.h5ad文件的名称添加到配置文件中。如果某些数据集不应用于分析,可在此处将其移除。 - 在顶部菜单中点击文件 > 保存 CSV 文件,以保存所做的更改。
- 使用左侧的导航菜单,点击scripts进入scripts 文件夹。通过双击打开笔记本01_Prepare_Pseudobulk.ipynb 。点击顶部的重启内核并运行所有单元格 按钮,并在弹出窗口中点击重启,以执行该脚本。
- 使用左侧的导航菜单,先双击figures ,再双击01_figures,进入图表文件夹。通过双击打开新生成的图表FIG01_Amount_of_Cells_overview。
注意:笔记本的执行可能需要数分钟。当笔记本成功执行后,将弹出提示窗口,且文件FIG01_Amount_of_Cells_Overview 将被笔记本更新或重新生成。最后修改时间列可指示文件的生成时间,以判断其为新文件或旧文件。 - 检查图表,识别每个样本中细胞数量极少的细胞类型簇。记录下需在后续步骤中排除的簇 ID 名称(图 6)。
- 使用左侧的导航菜单,点击 …,然后双击configurations,返回配置文件夹。通过双击打开文件02_Preprocessing_Configs_SC.csv。
- 检查configuration_name 和data_name 列中的值,并根据需要进行调整。
注意:在初始化脚本中,这些值会预先填充为输入数据文件夹中所有.h5ad文件的名称,以及先前在Data_Configs.csv文件中设置的configuration_name 值。如果需要从分析中排除某些文件,或使用其他文件名扩展名,可在此处进行调整。 - 在cell_type_exclusion 列中调整值,添加上一步中确定需排除的所有 cluster_id,各 ID 之间用“,”分隔。
- 在顶部的导航栏中点击文件 > 保存 CSV 文件,以保存更改。
- 使用左侧的导航菜单,通过双击configuration进入配置文件夹。通过双击打开文件01_Preprocessing_SC_Data.csv。检查文件中自动填充的值,如有必要,调整data_name 列中的值,使其与input_data 文件夹中将用于分析的单细胞数据集的文件名相对应。
- 预处理——整合与标准化其他组学数据源。
- 通过双击打开文件02_Preprocessing_Configs.csv,并为将要包含且存储在data_input 文件夹中的每个数据集调整预处理配置(每行对应一个数据集)。
- 检查configuration_name 和data_name 列中的值,并根据需要进行调整。
- 根据需要应用的预处理步骤,相应地调整各列中的其他参数。
注意:对于输入数据集文件夹中找到的每个数据集,系统会添加默认值,但这些值并不针对特定数据类型。因此,必须进行调整。参数的详细说明见Documentation_Config_Parameter.doc文件。 - 点击文件 > 保存 CSV 文件以保存更改。
- 使用左侧的导航菜单,点击scripts进入scripts 文件夹。通过双击打开笔记本02_Integrate_and_Normalized_Data_Sources.ipynb。点击顶部的重启内核并运行所有单元格 按钮,并在弹出窗口中点击重启,以执行该脚本。
- 使用左侧的导航菜单,点击folder 图标,然后依次双击results 和02_results,进入生成的02_results 文件夹。检查其中是否包含文件02_Combined_data_'configuration_name'_Integrated.csv,该文件为整合后的预处理数据输入文件。
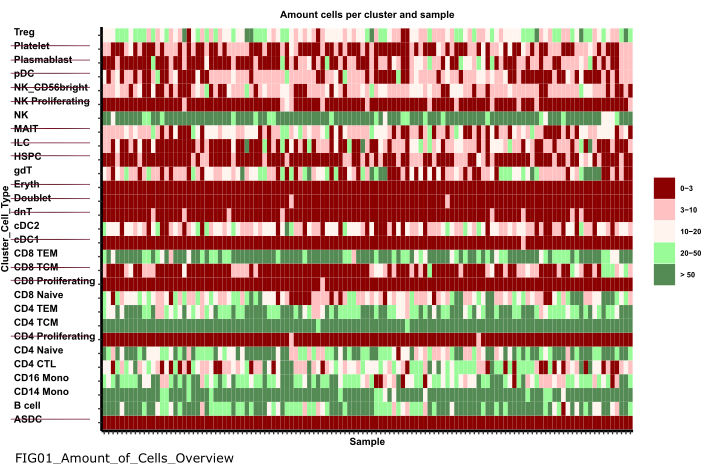
图6:数据预处理与整合。 “01_Prepare_Pseudobulk”步骤的输出之一是图表“Fig01_Amount_of_Cells_Overview”。在此图中,每个cluster_id(y轴表示先前细胞类型注释步骤所得的细胞类型)对应各样本('sample_id')中的细胞数量。在所展示的结果中,每样本细胞数量较少的细胞类型已被排除在后续分析之外(以删除线标示)。请点击此处查看该图的放大版本。
4. 运行 MOFA
- 在 Jupyter-Lab 中,使用左侧的导航菜单,通过点击进入 configurations 文件夹 文件夹 符号,然后双击 mofa_workflow,然后双击 脚本 和 构型. 打开文件 03_MOFA_配置.csv 双击即可。
- 检查以下条目的输入内容 配置名称 和 mofa_result_name 列并根据需要调整条目,若应使用替代名称。
注意: mofa_result_name 将作为 MOFA 生成的所有结果文件的文件扩展名。该扩展名可以不同于 配置名称 值,因为相同的输入数据可能会用于不同的 MOFA 设置(本方案使用 MI_v1_MOFA). - 输入应在 MOFA 模型中估计的因子数量(因素数量 柱) 并定义是否应应用加权和缩放(视图加权 和 比例视图 列)通过调整文件中的数值。
- 单击以保存更改 文件 > 保存 CSV 文件.
- 使用左侧的导航菜单进行浏览 脚本 点击“文件夹”即可脚本. 打开笔记本 03_运行_MOFA.ipynb 双击文件即可打开。通过单击来执行该脚本 重启内核并运行所有单元格 顶部的按钮并点击 重启 在弹出窗口中。
- 导航至 03_图示 双击文件夹 图 然后 03_图示. 打开生成的图表 图03_概述_方差分解_'mofa_result_name 并分析模型结果(图7A).
- 使用左侧的导航菜单跳转至生成内容 03_结果 点击文件夹 文件夹 符号,然后双击 结果 和 03_结果检查是否包含样本因子值文件 03_Factor_Data_'mofa_result_name'.csv 以及特征因子权重文件 03_体重数据_'mofa_result_name'.csv.
5. 下游分析
- 因子解释
- 使用左侧的导航菜单进行导航 输入数据 点击文件夹 文件夹 符号,然后双击 输入数据.
- 制备一种 .csv 文件(已制备样本元数据.csv) 包含将与生成因子进行关联分析的样本的所有元数据(协变量)。将该文件复制到 input_data 使用文件夹 拖动&滴 将文件放入文件夹概览中 input_data 文件夹
注意:必须包含 样本编号 用于匹配先前使用数据的列,以及用于分析每个特征的其他列。 - 在 Jupyter-Lab 中,使用左侧的导航菜单,通过点击返回到配置文件夹 文件夹 符号,然后双击 mofa_workflow,随后 脚本 和 构型. 打开文件 04_因子分析.csv 双击即可。
- 检查条目是否正确 配置名称 和 mofa_result_name 包含将在脚本中分析的配置和 MOFA 结果的名称,并在必要时进行调整。
- 在 数值协变量 柱,添加所有数值型列的名称 制备样品元数据.csv 将用逗号分隔的、拟与MOFA因子相关联分析的文件(本方案使用 C反应蛋白,肌酸激酶).
- 在 分类协变量列,添加所有分类列的名称 已制备样本元数据.csv 将用逗号分隔的、拟针对MOFA因子进行分析的文件(本方案使用 测量).
- 单击以保存更改 文件 > 保存 CSV 文件.
- 使用左侧的导航菜单,通过点击进入“scripts”文件夹 脚本打开笔记本 04_下游因子分析.ipynb 双击该脚本,然后单击以执行。 重启内核并运行所有单元格 单击顶部的按钮,在弹出窗口中点击重启。
- 使用左侧的导航菜单进行浏览 04_图表 双击文件夹 图 然后 04_图表. 双击生成的图表以打开,并分析各因素之间的有趣模式和关联: 图4 因子与数值型特征的关联
mofa_result_name.pdf图7B图4 因子关联性
带分类特征的_mofa_结果名称.pdf图7C). 图4_按因子划分的特征重要性概览_'mofa_result_name.pdf图8A).
- 特征分析
- 使用左侧的导航菜单,通过点击返回配置文件夹 … 然后双击 构型. 打开文件 05_Feature_Analysis_Configs.csv 双击即可。
- 检查条目是否正确 配置名称 和 mofa_result_name 列对应于将用于下游分析的配置名称和生成的 MOFA 结果,必要时可对其进行调整。
- 在 因子 柱,添加下一个脚本中将用于绘制顶部特征的因子。
- 在柱中 分面变量,添加一个分类列的列名 预处理样本元数据.csv 文件,将用于在图中对样本进行分组(本方案使用 测量)
- 单击以保存更改 文件 > 保存 CSV 文件.
- 使用左侧的导航菜单进行导航 脚本 点击文件夹 脚本. 打开笔记本 05_下游分析_探究特征_热图.ipynb 双击该文件,然后单击以执行脚本 重启内核并运行所有单元格 顶部的按钮,然后单击 重启 在弹出窗口中。
- 使用左侧的导航菜单进行导航 05_图表 双击文件夹即可打开 图 然后在 05_图示. 打开并分析生成的图表 图05_热图_特征概述_ mofa_result_namepdf 通过双击文件(图8B).
注意:根据图中将显示的特征数量,可能需要调整参数 绘图宽度 和 绘图高度 在……之内 05_特征分析配置.csv 重新运行脚本,以确保所有内容均适配图表。
- 通路分析
- 使用左侧的导航菜单进行导航 input_data 通过点击文件夹 文件夹 符号,然后双击 input_data.
- 制备 .csv 文件(制备通路数据.csv) 包含将用于富集分析的通路列表。将该文件复制到 input_data 使用文件夹 拖动&滴 将文件拖放到文件夹概览中 input_data 文件夹
注意:必须包含三列: ID (该通路的唯一标识符), 基因 (按基因名称(SYMBOL)列出的通路相关基因,每行一个基因) 通路名称 (通路的名称/文字描述) - 在 Jupyter-Lab 会话中,使用左侧的导航菜单,点击 …,然后双击 configurations 文件夹以进入该目录 构型. 打开文件 06_通路配置.csv 双击即可。
- 检查条目中的 mofa_result_name 柱,并确保其名称与将用于通路富集分析的 MOFA 结果文件名称相对应。
- 检查条目中的内容 类型 柱并移除其中的条目 类型 不包含匹配特征的列 基因 柱中的 已准备通路数据.csv 文件。
注意:默认情况下,在工作流程执行过程中,MOFA 模型中使用的所有不同视图都会被添加到此文件中。如果某些视图不包含至少匹配一个通路的特征,则需要将其移除;否则,执行将失败。例如,通路文件仅包含基因的通路注释,但存在一个包含蛋白质名称的视图。 - 单击以保存更改 文件 > 保存 CSV 文件.
- 使用导航菜单进行导航 脚本 通过点击文件夹 脚本打开笔记本电脑 06_下游通路.ipynb 双击该脚本,然后单击以执行。 重启内核并运行所有单元格 顶部的按钮,并单击 重启 在弹出窗口中。
- 使用左侧的导航菜单进行导航 06_图示 文件夹,首先双击 图 然后 06_图表. 打开生成的图表 图06_通路与基因 mofa_result_name 通过双击它来查看可视化通路(图8C).
注意:可视化通路的选择方式可通过配置文件进行设置。更多详情,请参阅参数的相关文档。 - 使用左侧的导航菜单跳转至生成内容 06_结果 通过点击文件夹来 文件夹 符号,然后双击 结果 和 06_结果检查是否包含含有富集通路的文件 06_通路富集_'mofa_result_name'.
6. 比较不同配置和版本(补充图1、补充图2、补充图3、补充图4)
- 为了比较在工作流程中使用不同参数/配置的效果,请重新运行第 3-5 节,修改配置文件中的参数,并使用不同的 configuration_name 和 mofa_result_name 标识符。
注意:新结果将使用这些名称进行存储,以便比较不同运行结果。 - 在 Jupyter-Lab 中,使用左侧的导航菜单进入 configurations 文件夹。通过双击打开文件 07_Comparison_Configs.csv。
- 在 mofa_result_name 列中,添加所有将被比较的先前 MOFA 运行的名称(每个名称/配置占一行,例如 MI_v1_MOFA, MI_v2_MOFA)。
- 在 compare_factors 列中,添加将在模型之间进行比较的因素。默认值为 Factor1,Factor2,Factor3。(补充图 2A)。
注意:在本脚本中,将通过相关性分析来比较不同模型的特征和因子值。此方法仅适用于基于相同样本(由 sample_id 指示)和相同特征集的模型。如果被比较版本之间的样本或特征不匹配,则这些样本或特征将被排除在比较之外。 - 通过点击 文件 > 保存 CSV 文件 来保存更改。
- 使用左侧菜单,点击 scripts 进入 scripts 文件夹。通过双击打开笔记本 07_Compare_Models.ipynb。点击 重启内核并运行所有单元格 按钮,并在弹出窗口中点击 重启,以执行脚本。
- 使用左侧菜单,先双击 figures ,再双击 06_figures,进入 06_figures 文件夹。通过双击文件打开生成的图表,以分析不同版本之间的相似性:
FIG07_Variance_Model_Comparison.pdf(补充图 2B)
FIG07_Factor_Correlations.pdf
(补充图 2C)
FIG07_Feature_Correlations.pdf
(补充图 3C)
7. 拓展工作流程:添加其他参数和配置
注意:除了当前可在配置文件中设置的参数外,代码中可能还包含其他调整或参数。例如,MOFA 模型本身提供了多个其他训练参数17,这些参数既可以直接在代码中修改,也可以通过配置文件使其可调。本方案的下一节将举例说明如何为额外的 MOFA 模型训练参数实现这一设置。完成此部分需要具备 R 编程知识。
- 在 Jupyter-Lab 中,使用左侧的导航菜单进入 scripts 文件夹。通过双击打开笔记本 03_Run_MOFA.ipynb。
- 点击左侧的 目录 选项卡,然后点击其中的子章节 4.3 设置 MOFA 训练选项并运行模型训练。向下滚动以查看笔记本中打印出的 MOFA 模型可配置参数的输出内容。
- 在标题下方代码中的 R for 循环内,所有 MOFA 的数据、模型和训练选项均已被设置。在代码行 model_opts$num_factors = mofa_configs$amount_of_factors[i] 下方,添加以下新行:
model_opts$likelihoods['data_type'] = 'poisson'。
注意:这将更改模型在所有 MOFA 运行中对由名称 data_type 指定的视图所采用的输入分布。当为某一数据类型指定泊松分布(poisson)时,该模型仅在该数据类型的特征为整数(例如来自 RNA-seq 的读段计数)时才能运行。如需了解更多关于 MOFA 数据、训练和模型选项的信息,可参考 MOFA 教程和文档17。 - 通过点击顶部的 保存 按钮,保存笔记本中的更改。
- 若要通过 .csv 配置文件传递新参数,请使用左侧导航栏,通过双击 configurations 进入配置文件夹,并通过双击打开文件 03_MOFA_Configs.csv。
- 添加一个新列以指定参数名称,例如 number_iterations,并输入一个值,例如 1000。通过点击 文件 > 保存 CSV 文件 保存更改。
- 使用导航菜单点击 scripts 进入脚本文件夹。通过双击打开笔记本 03_Run_Mofa.ipynb。点击左侧的 目录 选项卡,然后点击子章节 4.3 设置 MOFA 训练选项并运行模型训练。
- 将代码行 train_opts$maxiter = 50000 替换为 train_opts$maxiter = mofa_configs$column_name[i](如果新增列的名称为 number_of_iterations,则应写为 train_opts$maxiter = mofa_configs$number_of_iterations[i])。
注意:该笔记本在开头部分(子章节:前置配置与参数)会读取配置文件 03_MOFA_Configs.csv,并将其作为 mofa_configs 数据框 加载到当前会话中,因此在该代码行中引用了该对象及其对应的新生成列。由于可同时运行多个配置,i 用于标识数据框中的行,因为模型估计是在一个 for 循环中遍历 .csv 文件中的每一行进行的。在笔记本开头的“前置配置与参数”部分读取配置文件的这一原则适用于所有笔记本,其他修改也可依此方式进行。 - 通过点击 保存 按钮保存笔记本中的更改。
访问受限。请登录或开始试用以查看此内容。
结果
成功执行工作流程后,将生成多个表格和图示,如图2所示。图示文件将存放于/figures文件夹中(图6、图7、图8、补充图1、补充图2、补充图3、补充图4),表格文件将存放于指定的/results文件夹中。
如果工作流执行未成功,可能主要由以下原因导致:技术性错误,例如内存不足(尤其是在第一步加载大型单细胞数据集时)、数据格式不正确(例如,不同数据集之间的 sample_id 列不匹配)或配置文件中的参数设置错误(例如,排除了过多的特征)。在这种情况下,通常会在 Jupyter Notebook 脚本执行期间出现错误提示,且不会生成任何图表或数据。...
访问受限。请登录或开始试用以查看此内容。
讨论
通过本方案,介绍了一种基于 Jupyter Notebook 的模块化且可扩展的工作流程,可用于快速探索复杂的多组学数据集。该工作流程的主要部分包括数据预处理与数据整合(提供多种标准步骤用于数据的过滤与标准化)、MOFA9 模型的估计以及一些示例性的下游分析。其中最关键的步骤之一是对不同的组学数据集进行预处理、整合与标准化。本文介绍了一种针对包含单细胞 RNA 测序(scRNA-seq)数据、prime-seq 大量 RNA 测序、细胞因子检测、血浆蛋白质组学及临床指标的数据集的处理策略, 最终获得了一个整合且标准化的数据集,可用于识别心肌梗死(MI)11 中相关的重要生物学过程。若其他组学数据需要额外的预处理方法,则应在 MOFA 分析之前完成这些步骤。预处理后的数据可作为当前工作流程的输入。该模型的输出结果可用于评估不同数据集整合的质量以及预处理对识别潜在技术偏差的影响。例如,可首先仅应用最少的预处理和标准化步骤,随后评估进一步标准化的效果。在本应用中观察到,加入“按特征进行的分位数标准化”可使蛋白质组学 与其他检测方...
访问受限。请登录或开始试用以查看此内容。
披露
作者声明无利益冲突。
致谢
C.L. 由亥姆霍兹协会在联合研究生院"Munich School for Data Science - MUDS"项目下提供资助。
访问受限。请登录或开始试用以查看此内容。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| Apptainer | NA | NA | https://apptainer.org/docs/admin/main/installation.html |
| 计算服务器、工作站或云平台 (Linux、Mac 或 Windows 环境)。 根据不同输入数据集的大小,建议在合适的设备上运行该工作流程(在我们的设置中使用:16 核 CPU,64GB 内存) | 任意厂商 | 16 CPU, 64GB Memory | 大内存仅在处理原始单细胞数据时需要。预处理完成后,后续分析步骤也可在普通台式机或笔记本电脑上进行 |
| git | NA | NA | https://git-scm.com/book/en/v2/Getting-Started-Installing-Git |
| GitHub | GitHub | NA | https://github.com/heiniglab/mofa_workflow |
参考文献
- Lähnemann, D., et al. Eleven grand challenges in single-cell data science. Genome Biol. 21 (1), 31(2020).
- Colomé-Tatché, M., Theis, F. J. Statistical single cell multi-omics integration. Curr Opin Syst Biol. 7, 54-59 (2018).
- Hawe, J., Theis, F., Heinig, M. Inferring interaction networks from multi-omics data. Front Genet. 10, 535(2019).
- Hawe, J. S., et al. Network reconstruction for trans acting genetic loci using multi-omics data and prior information. Genome Med. 14 (1), 125(2022).
- Koh, H. W. L., Fermin, D., Vogel, C., Choi, K. P., Ewing, R. M., Choi, H. iOmicsPASS: network-based integration of multiomics data for predictive subnetwork discovery. NPJ Syst Biol Appl. 5, 22(2019).
- Ogris, C., Hu, Y., Arloth, J., Müller, N. S. Versatile knowledge guided network inference method for prioritizing key regulatory factors in multi-omics data. Sci Rep. 11, 6806(2021).
- Lee, C., vander Schaar, M. A variational information bottleneck approach to multi-omics data integration. Proceedings of The 24th International Conference on Artificial Intelligence and Statistics. 130, 1513-1521 (2021).
- Singh, A., et al. DIABLO: an integrative approach for identifying key molecular drivers from multi-omics assays. Bioinformatics. 35 (17), 3055-3062 (2019).
- Argelaguet, R., et al. Multi-omics factor analysis-a framework for unsupervised integration of multi-omics data sets. Mol Syst Biol. 14 (6), e8124(2018).
- Cantini, L., et al. Benchmarking joint multi-omics dimensionality reduction approaches for the study of cancer. Nature Commun. 12 (1), 124(2021).
- Pekayvaz, K., et al. Multiomic analyses uncover immunological signatures in acute and chronic coronary syndromes. Nature Medicine. 30 (6), 1696-1710 (2024).
- Swirski, F. K., Nahrendorf, M. Cardioimmunology: the immune system in cardiac homeostasis and disease. Nat Rev Immunol. 18 (12), 733-744 (2018).
- Janjic, A., et al. Prime-seq, efficient and powerful bulk RNA sequencing. Genome Biol. 23 (1), 88(2022).
- Wolf, F. A., Angerer, P., Theis, F. J. SCANPY: large-scale single-cell gene expression data analysis. Genome Biol. 19 (1), 15(2018).
- Cao, Y., et al. Integrated analysis of multimodal single-cell data with structural similarity. Nucleic Acids Res. 50 (21), e121(2022).
- Get Started - JupyterLab 4.1.0a4 documentation. , Available from: https://jupyterlab.readthedocs.io/en/latest/getting_started/overview.html (2024).
- MOFA2: training a model in R. , Available from: https://raw.githack.com/bioFAM/MOFA2_tutorials/master/R_tutorials/getting_started_R.html (2020).
- De Silva, D., et al. Robust T cell activation requires an eIF3-driven burst in T cell receptor translation. eLife. 10, e74272(2021).
- Li, G., Liang, X., Lotze, M. HMGB1: The central cytokine for all lymphoid cells. Front Immunol. 4, 68(2013).
- Jassal, B., et al. The reactome pathway knowledgebase. Nucleic Acids Res. 48 (D1), D498-D503 (2020).
- Argelaguet, R., et al. MOFA+: a statistical framework for comprehensive integration of multimodal single-cell data. Genome Biol. 21 (1), 111(2020).
- Velten, B., et al. Identifying temporal and spatial patterns of variation from multimodal data using MEFISTO. Nat Methods. 19 (2), 179-186 (2022).
- Qoku, A., Buettner, F. Encoding domain knowledge in multi-view latent variable models: A Bayesian approach with structured sparsity. Proceedings of The 26th International Conference on Artificial Intelligence and Statistics. 206, 11545-11562 (2022).
- Multi-Omics Factor Analysis. MOFA. , Available from: https://biofam.github.io/MOFA2/ (2024).
- Mitchel, J., et al. Tensor decomposition reveals coordinated multicellular patterns of transcriptional variation that distinguish and stratify disease individuals. bioRxiv. , (2023).
访问受限。请登录或开始试用以查看此内容。
重印与许可
