阅读通用领域与特定领域技能评估多媒体量表是一种可靠且有效的多媒体评估工具,旨在评估认知能力和基础阅读技能。该量表能够生成全面的认知与阅读表现特征,对于阅读障碍儿童尤其具有重要价值。
本文内容
摘要
摘要
阅读技能的获得是一个复杂的过程,需要培养多种领域通用和领域特定的能力。因此,许多儿童难以保持与年级水平相当的熟练程度也就不足为奇了,特别是当他们在两个领域的多种能力上均面临挑战时——这在存在阅读困难的个体中尤为明显。值得注意的是,尽管阅读困难是影响学龄儿童最常见的神经发育障碍之一,但目前大多数可用的诊断工具缺乏一个全面的框架来评估与阅读障碍相关的全部认知技能,且计算机化的选项极为有限。尤其突出的是,目前几乎没有具备这些特征的工具可供西班牙语儿童使用。本研究旨在阐明使用Sicole-R多媒体测验电池诊断西班牙语儿童阅读困难的实施方案。该工具面向小学阶段,专注于评估科学文献所规定的与阅读障碍相关的认知技能。具体而言,它着重评估一系列已被研究证实与阅读障碍相关的认知能力。这一重点基于如下观察:阅读障碍个体通常在该数字化工具所评估的多个认知领域表现出缺陷。该测验电池已显示出良好的内部一致性和多维内部结构。这一多媒体测验电池已被证明是诊断小学阶段阅读困难儿童的适宜工具,能够提供全面的认知特征分析,不仅对诊断具有重要价值,而且有助于制定个性化的教学方案。
引言
阅读障碍是一种神经发育障碍,其特征是单词识别不准确和/或不流畅,以及拼写和解码能力差,并表现为在常规教学、智力正常及社会文化机会充足的条件下,仍出现意料之外且持续性的高效阅读技能获取困难1。这种神经生物学障碍通常表现为阅读、拼写和写作方面的困难,主要源于语音处理缺陷2,3。“早期 识别阅读障碍的重要性再怎么强调也不为过 ,因为它有助于及时进行干预和支持4,5。当学生在接受干预反应模型中未能超越第三级(Tier-3)时 ,就 有必要对与阅读障碍相关的 更 广泛的领域通用和领域特异性能力进行 全面评估,这一点已由科学 文献所强调。本文所介绍技术的开发正是基于开展全面评估的必要性 ,以 确保为个体提供 恰当的干预措施和支持 。 此外,先前的研究 强调了基于技术的 筛查工具(如网络应用程序和 计算机游戏)在促进有效 筛查过程中的实用性6,7。这些研究共同揭示了阅读障碍的多维特性,强调需要采用综合性的评估和干预策略,以应对阅读障碍个体之间不同的认知特征。尽管阅读障碍在学龄儿童中十分普遍,但目前大多数可用的诊断工具缺乏一个能够全面评估领域通用和领域特异性技能的框架。此外,针对西班牙语人群的计算机化评估工具尤为匮乏。本多媒体测验电池通过利用技术手段,实现了对与阅读障碍相关认知技能的详细评估,从而弥补了上述不足。
阅读障碍的理论视角与认知缺陷
多种理论模型,包括语音理论、快速听觉加工理论、视觉理论、大细胞理论和小脑理论,旨在解释阅读障碍的成因并指导干预措施(详见综述)8。语音理论将阅读障碍归因于语言声音加工方面的困难9,而快速听觉加工理论则认为阅读障碍与感知快速变化声音的能力缺陷有关10。视觉理论强调阅读困难中的视觉因素,大细胞理论则指出视觉和听觉加工通路的损伤是其根源11。小脑理论认为,阅读障碍源于小脑功能损伤,进而影响运动控制和认知功能12。Nicolson 和 Fawcett 提出的神经承诺延迟(Delayed Neural Commitment, DNC)框架认为,技能习得速度较慢以及神经网络发育延迟是阅读障碍的核心特征。近期模型如多重缺陷模型提出,阅读障碍是一种受遗传、认知和环境因素共同影响的复杂障碍13,14,15。例如,Ring 和 Black14支持多重缺陷模型,表明语音和认知加工缺陷共同导致了阅读障碍的异质性。Soriano-Ferrer 等人15对西班牙语发育性阅读障碍(DD)儿童开展的研究发现,其命名速度、言语工作记忆和语音意识(PA)均存在显著损伤。类似地,Zygouris 等人16和 Rauschenberger 等人6强调了认知筛查工具在识别这些缺陷中的重要性,阅读障碍个体在相关测试中的得分始终低于正常发展同龄人。
阅读障碍筛查中的技术方法:来自研究的见解
关于阅读障碍筛查的研究已发展出三种主要方法:早期检测策略、结合多种评估手段的综合筛查方法,以及通过技术整合提高效率17。Politi-Georgousi18 近期的 系统性综述指出,当前趋势更倾向于开发用于干预 阅读障碍症状 的应用,而非专注于筛查过程本身, 这一趋势与技术整合相一致,旨在提升阅读障碍学生的 阅读能力。现有多种工具,例如Fawcett和Nicolson开发的阅读障碍早期筛查测试(Dyslexia Early Screening Test, DEST),可评估速度、语音技能、运动技能、小脑功能及知识水平19。“基于计算机的工具已取得 进展,包括一种用于评估希腊儿童 阅读与认知能力的网络应用程序20,以及Hautala等人21和Rauschenberg等人6 开发的利用游戏化和机器学习进行 阅读障碍早期识别的工具。Ahmad等人将游戏化与神经网络相结合,在检测中实现了95%的准确率22。针对不同文字系统的研究表明,语音意识和快速自动命名在阅读障碍识别中具有重要意义23,24。
西班牙语儿童阅读障碍研究进展
通过使用Sicole-R技术,西班牙语儿童阅读障碍的研究取得了显著进展。Jiménez等人证明了该技术在不同年龄组中评估阅读障碍的有效性,特别是在小学早期阶段,能够基于语音和句法加工能力区分阅读障碍儿童与正常阅读发展儿童25。Guzmán等人研究了存在语音困难的阅读障碍儿童的命名速度缺陷,强调了阅读障碍与通过字母-RAN和数字-RAN等任务测量的命名速度之间的相互作用26。Jiménez等人进一步研究了不同音节结构下的语音意识缺陷27,而Ortiz等人则探讨了西班牙语阅读障碍儿童的言语感知缺陷,发现无论音位对比或语言单位如何,其言语感知发展均存在障碍28,29。Jiménez等人还检验了阅读障碍的双重缺陷假说30,并进一步分析了认知加工过程以及阅读障碍患病率中的性别差异31,32。Rodrigo等人探讨了西班牙语阅读障碍儿童的词汇通达问题33,Jiménez等人则深入分析了句法加工缺陷34。最后,Jiménez等人研究了阅读障碍亚型中的语音和正字法加工过程,揭示了不同亚型在正字法通路效率上的差异35。这些研究共同加深了我们对西班牙语人群中阅读障碍所涉及的认知与语言挑战的理解。
这些研究在参与儿童的年龄和背景方面具有一些共同特征。参与研究的儿童年龄范围为7至14岁。大多数研究集中于7至12岁的学龄儿童,少数研究则纳入了年龄高达14岁的儿童,从而涵盖了从小学早期到青春期前的发育阶段31,32。参与儿童主要来自西班牙的加那利群岛。此外,部分研究还纳入了来自西班牙其他地区和危地马拉的样本31,32。研究对象来自公立和私立学校,其背景涵盖城市和郊区地区。这些研究中所代表的社会经济水平从低中层到工薪阶层和中产阶级不等。
这些研究共同极大地推进了我们对阅读障碍复杂性的理解,为阅读障碍研究领域做出了重要贡献。本研究中,该工具已适用于多个伊比利亚美洲国家(包括西班牙、危地马拉、智利和墨西哥),有助于在多样化的西班牙语人群中评估诊断的准确性和精确性。
本研究旨在制定一项使用专门多媒体测验工具诊断西班牙语儿童阅读困难的方案。主要目标是提供一种综合评估工具,用于评估与阅读障碍相关的领域通用和领域特定技能。
实验装置概述
的 SICOLE-R 采用 Java 2 平台标准版(J2SE)编程,数据库使用 HSQL 引擎。该软件包含 6 个主要评估模块:1)感知处理,包括发音、发音部位和发音方式任务;2)音位处理,包括音素识别、音素删除、音素切分和音素融合任务;3)命名速度,包括数字、字母、颜色和图片的命名速度任务;4)正字法处理,包括词素和词缀的形态理解以及同音词理解任务;5)句法处理,包括性别、数量、功能词和语法结构任务;6)语义处理,通过说明性文本和叙事性文本影响阅读理解任务。每个任务开始前,由教学代理提供操作说明,并附带一至两次练习试次(视任务而定)及示范演示。本文展示了各任务的应用流程。
在向研究样本施测多媒体测验电池之前,针对每个国家(即墨西哥、危地马拉、厄瓜多尔和智利)的西班牙语形式进行了适应性调整,包括词汇、图像及其他相关内容的修改。所有拉丁美洲国家的施测条件保持一致。施测环境必须位于学校内安静的区域,避免噪音、干扰和中断。多媒体测验电池的施测时长根据学生的年龄和能力而定,通常分为3至4次进行,每次30分钟。由于该测验数据库与大多数电子表格及统计数据分析系统兼容,评估者可对每名儿童及每项任务的结果进行分析。在数据采集过程中,采用了两种不同类型的任务:1)由主试记录学生口头表现的任务,通过外接鼠标点击记录正确与错误反应;2)要求学生通过点击选项独立完成选择的任务。
方案
本方案的实施遵循了拉 Laguna 大学(ULL)研究伦理与动物福利委员会(Comité de Ética de la Investigación y Bienestar Animal,CEIBA)提供的指导方针。数据根据各国课程安排在不同时间收集 ,仅纳入其教育管理部门、学校及家长已提供知情同意的学生信息。 本研究使用的能力测试量表已注册为知识产权,可通过与 ULL 签订转让协议获取。 有意获取该测试量表的人员可联系 ULL 知识转移办公室(OTRI)以获取更多信息。
1. SICOLE-R 的安装与准备
- 应用本工具时,请采用以下纳入标准:小学二年级至六年级的学生。请采用以下排除标准:不包括有特殊教育需求的学生,即因感觉障碍或获得性神经问题等原因需要支持和针对性教育关注的学生。
注意:评估需在安静的环境中单独对每位学生进行,环境应配备计算机并具有良好的照明条件。需使用带适配麦克风的耳机,以方便学生接收任务指令,并提高其表现水平。 - 在计算机上安装软件时,以管理员身份运行安装文件,然后点击图标以打开工具。启动应用程序后,将显示一个初始界面,提供多种操作选项。
- 在开始评估之前,填写即将执行任务的学生信息。输入学生数据后,将其记录在学生列表中,后续可对信息进行修改。
- 每次新增一名学生时,在任务开始前将出现一个测试界面。在此界面上,请让学生点击屏幕上出现的靴子。
注意:该小游戏的目的是建立评估学生运动控制能力的基线。通过记录学生按压键盘按键的反应,可监测其运动速度的个体差异。此小游戏仅出现一次。 - 在开始评估前,请主试者向学生提供以下指导语:现在,你将进入一个拥有不同入口的虚拟马戏团环境。每个入口通向有趣的活动,你将参与其中。一位小丑将引导你穿过这些入口,并说明每项活动的要求。请坐在主试者旁边,仔细聆听指令。请在每一项任务中尽力而为。享受探索并完成这些活动的乐趣!
- 选择待评估的学生,点击开始部分以启动任务。主菜单包含5个彩色门,每个门对应一个待评估的模块。
- 每个任务开始时均会显示一段引导性说明,请提醒学生注意听讲。系统将通过教学代理向学生说明游戏性质及操作方法,包括为每项任务提供口头指导、通过示范展示操作流程,并呈现可供学生模仿的示例。
- 在完成示例后,确保教学代理提供相应的反馈,若学生操作错误,允许其重新执行示例,随后正式开始评估。
注意:教学代理是一个虚拟角色,旨在引导学生完成各项任务。该角色需具备清晰易懂的语言表达能力,能够提供教学指导、任务示范以及基于学生反应的反馈。教学代理必须被编程为能够根据学生在任务中的输入做出一致且准确的响应。
2. SICOLE-R 任务
- 黄色门:使用语音感知任务的感知处理模块
- 在计算机上打开程序。在程序界面中导航至黄色门。点击 One of the Available Subtasks 以启动任务:(1) 清浊音判断,(2) 发音方式,以及 (3) 发音部位。
- 允许教学代理为学生提供指导说明和任务示范。代理应说:“现在我们将听到成对的音节。如果音节相同,请按蓝色按钮;如果不同,请按红色按钮。看我是如何操作的。现在轮到你来尝试以下示例。”
- 向学生展示两个示例项目:/ba/-/pa/;/ja/-/ka/。再次指导学生:若音节对相同,则选择蓝色圆圈;若不同,则按红色按钮。
- 任务完成后,确保教学代理根据学生在示例中的回答提供反馈。示例完成后,允许代理指导学生开始正式任务。
- 在整个任务过程中,选择圆圈(蓝色或红色)的操作流程保持一致,并记录正确与错误反应。若学生需要再次聆听音节对,请点击 Speaker Icon 重新播放一次。请注意,每个项目仅允许额外重播一次。
- 粉色门:音位意识模块
- 音位切分任务
- 在计算机上打开程序。在程序界面中导航至粉色门。选择 Phoneme Segmentation 以选定该任务。
- 允许教学代理为学生提供指导说明。代理应说:“现在我们将专注于音位切分。先看我示范一遍,然后你会看到两个示例项目。”
- 向学生展示两个示例项目。要求学生大声说出每个单词的答案。
- 使用外接鼠标点击蓝色按钮表示正确反应,点击红色按钮表示错误反应。确保教学代理根据学生对示例的反应提供反馈。
- 示例结束后,确保教学代理指导学生开始正式任务。
- 音位合成任务
- 在计算机上进入程序。在程序界面中导航至粉色门。选择 Phoneme Blending 以选定该任务。
- 允许教学代理为学生提供指导说明。代理应说:“现在我们将专注于音位合成。先看我示范一遍,然后你会看到两个示例项目。”
- 向学生展示两个示例项目。要求学生大声说出每个单词的答案。
- 使用外接鼠标点击蓝色按钮表示准确反应,点击红色按钮表示不准确反应。确保教学代理根据学生对示例的反应提供反馈。
- 示例结束后,允许教学代理指导学生开始正式任务。任务执行过程中流程保持一致,记录准确与不准确的反应。
- 若学生需要再次聆听某个单词,请点击 Parrot Icon 进行重播。请注意,每个项目仅允许重播一次。
- 音位隔离任务
- 在计算机上打开程序。在程序界面中导航至粉色门。点击 Phoneme Isolation 以选定该任务。
- 允许教学代理为学生提供指导说明和任务示范。代理应说:“现在我们将专注于音位的隔离。先看我示范一遍,然后你会看到两个示例项目。你的任务是点击名称开头音与目标词相同的图片。”
- 向学生展示两个示例项目。观察学生是否点击了与目标词开头音相同的图片。
- 确保教学代理根据学生对示例的反应提供反馈。示例结束后,确保代理指导学生开始正式任务。
- 任务执行过程中流程保持一致,记录正确与错误反应。若学生需要再次聆听某个单词,请点击 speaker Icon 进行重播。请注意,每个项目仅允许重播一次。
- 音位删除任务
- 在计算机上打开程序。在程序界面中导航至粉色门。选择 Phoneme Deletion 以选定该任务。
- 允许教学代理为学生提供指导说明并示范任务。代理应说:“现在我们将专注于音位删除。先看我示范一遍,然后你会看到两个示例项目。”
- 向学生展示两个示例项目。要求学生大声说出每个单词的答案。
- 使用外接鼠标点击蓝色按钮表示正确答案,点击红色按钮表示错误答案。确保教学代理根据学生对示例的反应提供反馈。
- 示例结束后,确保教学代理指导学生开始正式任务。任务执行过程中流程保持一致,记录正确与错误反应。
- 若学生需要再次聆听某个单词,请点击 speaker Icon 进行重播。请注意,每个项目仅允许重播一次。
- 音位切分任务
- 橙色门:命名速度与正字法模块
- 快速自动命名(RAN)任务
- 在计算机上访问程序。进入程序界面中的橙色门。选择 Naming Speed 以选定该任务。
- 允许教学代理提供指导说明并示范任务。展示命名速度模块中字母RAN子任务的一个示例。
- 要求学生大声说出答案。若示例中的回答正确,则在屏幕上选择蓝色按钮;若错误,则点击红色按钮。
- 确保教学代理根据学生的反应提供反馈。示例结束后,确保教学代理启动正式任务。
- 通过点击鼠标左键开始计时以启动任务。任务进行时,屏幕上将根据子任务显示一个元素矩阵。
- 要求学生按顺序大声命名矩阵中的各个元素,同时记录学生出现的任何错误。
- 对于每个错误,使用外接鼠标的右键记录错误次数。当学生完成所有元素的命名后,再次按下左键以结束计时并完成该子任务。完成第一个子任务(字母RAN)后,下一个子任务(数字RAN)将自动出现,并遵循相同流程。此过程依次进行剩余子任务(颜色RAN和物体RAN)。
- 词干与词缀任务
- 在计算机上访问程序。在平台界面中导航至橙色门,点击 Lexemes and Suffixes 以选定该任务。
- 启用教学代理为学生提供指导说明和任务示范,包括一个示例项目,学生需使用外接鼠标选择与目标词对应的图片。
- 确保教学代理根据学生对示例的反应提供反馈,然后指导学生开始正式任务。
- 在整个任务执行过程中保持流程一致性,提示学生为每个呈现的项目选择与目标词对应的图片,并记录正确反应与遗漏反应。
- 同音词理解任务
- 在计算机上访问程序。在平台界面中导航至橙色门。点击 Homophone Comprehension 以选定 任务。
- 启用教学代理为学生提供指导说明和任务示范。展示一个示例项目,提示学生使用外接鼠标选择与目标词对应的图片。
- 确保教学代理根据学生对示例的反应提供反馈,并在示例展示后指导学生开始正式任务。
- 在整个任务执行过程中保持步骤的一致性。提示学生为每个呈现的项目选择与目标词对应的图片。
- 在任务执行过程中记录正确反应与遗漏反应。
- 快速自动命名(RAN)任务
- 绿色门:句法处理模块
- 性范畴任务
- 在计算机上打开程序。在程序界面中导航至绿色门。点击 Gender 以选定该任务。
- 允许教学代理为学生提供指导说明和任务示范。提供两个示例让学生完成,要求他们使用外接鼠标点击句子中符合性别一致关系的对应词语。
- 确保教学代理根据学生对示例的反应提供反馈。示例展示后,确保教学代理指导学生开始正式任务。
- 在整个任务执行过程中保持流程一致性。提示学生根据性别一致关系点击句子中的对应词语。
- 在任务执行过程中收集正确与错误反应。
注:与西班牙语不同,英语语法中不区分性别。
- 数范畴任务
- 在计算机上打开程序。在程序界面中导航至绿色门。点击 Number 以选定该任务。
- 允许教学代理为学生提供指导说明和任务示范。提供两个示例让学生完成,要求他们使用外接鼠标点击句子中符合数一致关系的对应词语。
- 确保教学代理根据学生对示例的反应提供反馈。示例展示后,确保教学代理指导学生开始正式任务。
- 在整个任务执行过程中保持流程一致性。提示学生根据数一致关系点击句子中的对应词语。
- 在任务执行过程中收集正确与错误反应。
注:与西班牙语不同,英语语法中不区分单复数范畴。
- 功能词任务
- 在计算机上打开程序。在程序界面中导航至绿色门。点击 Functional Words 以选定该任务。
- 允许教学代理为学生提供指导说明和任务示范。提供两个示例让学生完成,要求他们使用外接鼠标根据句子语境点击对应的功能词。
- 确保教学代理根据学生对示例的反应提供反馈。示例展示后,确保教学代理指导学生开始正式任务。
- 在整个任务执行过程中保持流程一致性。提示学生根据句子语境点击对应的功能词。
- 在任务执行过程中收集正确与错误反应。
- 句法结构任务
- 在计算机上打开程序。在程序界面中导航至绿色门。选择 Grammatical Structure 以选定该任务。
- 允许教学代理为学生提供指导说明和任务示范。提供两个示例让学生完成,要求他们使用外接鼠标为每张图片选择合适的句子。
- 确保教学代理根据学生对示例的反应提供反馈。示例展示后,确保教学代理指导学生开始正式任务。
- 在整个任务执行过程中保持流程一致性。提示学生使用外接鼠标为每张图片选择合适的句子。
- 在任务执行过程中记录正确与错误反应。
- 性范畴任务
- 蓝色门:使用阅读理解任务的语义处理模块
- 在计算机上打开程序。进入程序界面中的蓝色门。选择 The Fruits 以阅读说明性文本,或选择 Tino's Getaway 以阅读叙事性文本。
- 允许教学代理为学生提供任务说明。选定文本类型后,在屏幕上显示相应文本。
- 学生必须阅读文本并记忆其中最重要的信息。阅读完成后,要求学生使用外接鼠标点击屏幕上的箭头,表示阅读结束并进入下一环节。
- 允许教学代理指导学生阅读问题,并使用外接鼠标选择正确答案。学生阅读问题后,相应地选择正确选项。
3. 数据分析
- 为评估多媒体测验工具在西班牙语人群中的结构效度和诊断准确性,采用验证性因子分析(CFA)和受试者工作特征(ROC)曲线分析。
- 进行验证性因子分析(CFA),以验证多媒体测验工具的潜在因子结构。该分析可用于检验数据是否符合基于理论假设预设的结构模型。
- 使用多个拟合指数评估模型拟合度,包括比较拟合指数(CFI)、Tucker-Lewis 指数(TLI)、近似误差均方根(RMSEA)以及标准化残差均方根(SRMR)。模型拟合良好的标准为:CFI 和 TLI 值大于 0.90,RMSEA 和 SRMR 值小于 0.08。
- 为确定多媒体测验工具的诊断准确性,进行 ROC 曲线分析。该方法可用于评估测验正确区分存在与不存在阅读困难个体的能力。ROC 曲线下面积(AUC)反映了测验的整体准确性。AUC 为 0.5 表示无诊断能力,AUC 为 1.0 表示具有完美诊断能力。
- 通过分析不同阈值水平下的敏感性和特异性,确定测验工具的最佳截断点。
- 通过同时采用 CFA 和 ROC 曲线分析,对多媒体测验工具进行全面评估,以确认其在西班牙语人群中的结构效度和诊断准确性。
结果
样本研究
样本包括来自西班牙(N = 325)、墨西哥(N = 169)、危地马拉(N = 227)和智利(N = 160)的881名参与者,均为以西班牙语为母语的个体。样本被分为两组:451人属于阅读障碍(RD)组,430人属于正常阅读能力(NAR)组。有特殊教育需求的儿童——即因感官障碍、神经问题或其他状况而需要支持和特殊教育关注的儿童——被排除在外,因为这些因素通常被用作学习障碍或严重行为障碍的排除标准,无论是在暂时阶段还是整个受教育期间。RD组的参与者选择标准包括:智商等于或高于80,单词阅读时间测量百分位在第75百分位以上,伪词阅读时间测量百分位在第75百分位以上,或伪词阅读准确率测量百分位在第25百分位以下。同样,NAR组的选择标准与上述类似,但额外要求PROLEC36理解任务的百分位在第25百分位以上。所有百分位均根据参与者的年级水平确定。参与者的分组分类依赖于单词阅读和伪词阅读任务,每项任务包含独立的测试模块。在两个模块中,参与者均被要求尽可能快速地大声朗读所呈现的语言刺激材料。单词阅读模块包含32个刺激材料,而伪词阅读模块包含48个刺激材料。单词的熟悉度通过Guzman和Jiménez37提出的标准进行控制。记录了正确反应、错误和反应潜伏期时间的测量数据,其中潜伏期时间从每个项目出现开始计算,直至学生发出语音反应为止。单词阅读模块表现出较高的内部一致性(α = .89),而伪词阅读模块的内部一致性更高(α = .91)。不同年级中RD与NAR学生的分布情况如下:二年级有30名NAR学生和27名RD学生;三年级有100名NAR学生和88名RD学生;四年级有100名NAR学生和116名RD学生;五年级有100名NAR学生和116名RD学生;六年级有100名NAR学生和104名RD学生。为评估总样本及各年级内部的年龄差异,进行了单因素方差分析(one-way ANOVA)。结果显示无显著差异,所有p值均大于0.05。同样,使用卡方检验对性别变量的分布进行了分析,所有p值也均大于0.05。
描述性统计
表1列出了年龄及各项评估指标的描述性统计结果(均值和标准差)。数据按性别分类,区分了来自不同国家的正常阅读者与阅读障碍者。结果显示,大量评估指标之间存在正向且具有统计学意义的相关性(见表2)。该表展示了各项指标之间的相关系数,范围从弱到强。相关系数小于0.3被视为弱相关,大于0.5则归类为强相关。表中同时提供了具体的相关系数值及其对应的相关强度分类。例如,弱相关(r < 0.3)包括音素融合-分割(r = 0.354)以及删除-同音词理解(r = 0.270);中等相关(0.3 ≤ r < 0.5)出现在语法结构-数词(r = 0.463)与功能词-语法结构(r = 0.512)之间;强相关(r ≥ 0.5)则体现在数词-性别(r = 0.642)以及图片命名速度-颜色命名速度(picture RAN-Color RAN,r = 0.442)之间。
表1:各项测量指标的描述性统计。 本表提供了数字工具中包含的各项测量指标的均值、标准差及其他描述性统计量。AGE:年龄;NAR:正常阅读能力者;RD:阅读障碍;SEG:音素分割;BLN:音素合成;ISO:音位隔离;DEL:音位删除;HOM:同音词理解;R&S:词根与词缀;GEN:性别;NUM:数;FW:功能词;GRS:语法结构;EXT:说明性文本;NAT:叙事性文本;VOC:发音浊化;MOA:发音方式;POA:发音部位;DIG:数字命名速度;LET:字母命名速度;COL:颜色命名速度;PIC:图片命名速度 请点击此处下载该表格。
表2:各项测量指标的相关系数。 本表展示了数字工具各项测量指标之间的相关系数,反映了这些指标之间关系的强度与方向。SEG:音素切分;BLN:音素混合;ISO:音素隔离;DEL:音素删除;HOM:同音词理解;R&S:词根与词缀;GEN:语法性别;NUM:语法数;GRS:语法结构;FW:功能词;EXT:说明性文本;NAT:叙事性文本;VOC:发音浊化;MOA:发音方式;POA:发音部位;DIG:数字命名速度;LET:字母命名速度;COL:颜色命名速度;PIC:图片命名速度。请点击此处下载该表格。
验证性因子分析
采用验证性因子分析(CFA)评估多媒体测验电池所提出的因子结构。该模型包含一个二阶因子和六个潜在变量,每个潜在变量代表多媒体测验电池的不同模块。这些构念包括:语音意识(包含音素分割、音素识别、音素合成和音素删除任务)、形态-正字法模块(包含词根与后缀以及同音词理解任务)、句法(包含性别、数量、语法结构和功能词任务)、言语感知(包含清浊音、发音方式和发音部位任务)、阅读理解(包含说明性文本和叙事性文本理解任务),以及快速自动命名(包含RAN任务中的字母、颜色、数字和图片命名任务)。为确保多媒体测验电池中所有任务评分尺度的一致性(范围为0至1),我们采用了最大比例缩放法(proportion of maximum scaling, POMS)进行估计。基于时间的任务(词根与后缀)的POMS分数已进行计算38。
统计分析和图形展示使用 R 4.3.1 版本39完成,并采用了 lavaan40、semTools41 和 ggplot242 软件包。模型拟合度通过多种拟合优度指标进行评估。尽管卡方拟合优度检验显著,χ2(df) = 632.01,p < .001,提示假设模型与观测数据之间存在差异,但需注意的是,卡方检验对样本量较为敏感43。因此,还参考了其他补充的拟合指标。
比较拟合指数(CFI)值为0.961,超过通常可接受的0.95阈值,表明模型与数据拟合良好。近似误差均方根(RMSEA)为0.038,表明模型与数据具有较紧密的拟合。标准化残差均方根(SRMR)为0.034,低于推荐值0.05,提示拟合效果理想。各条目因子载荷介于0.36至0.81之间,表明在相应因子上的载荷显著。总体平均提取方差(AVE)超过0.50,说明具有足够的收敛效度;总体组合信度(CR)高于0.80,表明具有良好的内部一致性信度。
综上所述,验证性因子分析(CFA)的结果支持所提出的因子结构,表明模型拟合良好,具有良好的收敛效度和信度。请参见图1中该模型的图示。
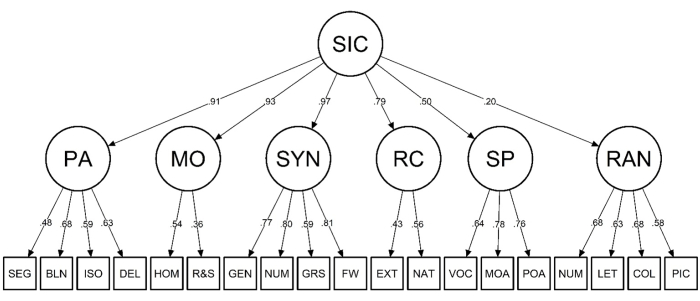
图 1:验证性因子分析。 本图展示了在数字工具上进行的验证性因子分析结果,重点呈现了因子载荷以及不同认知加工测量指标之间的关系。缩写:SIC = Sicole-R;PA = 音位意识;SEG = 切分;BLN = 合音;ISO = 音素分离;DEL = 删除;MO = 形态加工;HOM = 同音词理解;R&S = 词根与后缀;SYN = 句法加工;GEN = 性;NUM = 数;GRS = 句法结构;FW = 功能词;RC = 阅读理解;EXT = 说明性文本;NAT = 叙述性文本;SP = 言语感知;VOC = 发音浊化;MOA = 发音方式;POA = 发音部位;RAN = 快速自动化命名;NUM = 数字 RAN;LET = 字母 RAN;COL = 颜色 RAN;PIC = 图片 RAN。请点击此处查看该图的放大版本。
测量不变性分析用于检验多媒体测验的因子结构在不同性别间是否稳定。测量不变性的检验包括一系列模型比较,这些比较设定了日益严格的等值约束条件。44我们进行了统计分析,并遵循了之前CFA相同的拟合模型标准。我们依次约束了代表构型、度量(载荷)、标量(截距)和严格(残差)结构的参数45任何模型拟合不佳均表明所约束的方面在不同组别中未保持一致。当联合考虑时,χ的不变性程度被确定2D 是 >0.05 且 ΔCFI 为 <0.01. 模型指数结果的汇总及其差异如图所示 表3.
表3:不变性模型拟合指数。 本表展示了用于检验模型性别不变性的拟合指数,评估该数字化工具在男性与女性群体之间结构和测量属性的一致性程度。这些指数通过验证该工具在不同性别群体中对认知过程进行一致测量的能力,确保了其可靠性和有效性。请点击此处下载此表格。
构型模型仅对模型中变量的相对构型在两组间保持一致进行了约束,该模型对数据的拟合程度良好:χ2(292) = 745.970,p<.001,CFI = .964,SRMR = 0.034,RMSEA = .036,90% CI (.033, .038)。度量不变性模型进一步约束了变量构型及所有因子载荷在各组间保持恒定,其拟合指数与构型模型相当:χ2(310) = 768.56,p<.001,CFI = .963,SRMR = .037,RMSEA = .036,90% CI (.033, .038)。因子载荷的不变性得到了差异检验结果的支持,差异检验未达到显著水平,表明模型相似:χ2D (18) = 26.30,p = .09;ΔCFI = .001。在标量不变性模型中,变量构型、因子载荷以及指标均值/截距均被约束为各组相同,其拟合指数略低于理想水平:χ2(322) = 787.50,p<.001,CFI = .963,SRMS = .038,RMSEA = .035(90% CI = .032, .038)。用于评估模型相似性的差异检验结果表明存在因子不变性:χ2D(12) = 13.00,p = .369;ΔCFI = .001。最后,在严格不变性模型中,变量构型、因子载荷、指标均值/截距以及残差均被约束为各组相同,其拟合指数亦略低于理想水平:χ2(341) = 798.20,p<.001,CFI = .961,SRMS = .039,RMSEA = .0035(90% CI = .032, .038)。严格不变性得到了非显著性差异检验的支持:χ2D(11) = 25.81,p<.001;ΔCFI = .002。
诊断准确性
为评估多媒体测验工具的准确性和区分能力,进行了受试者工作特征(ROC)分析。ROC分析有助于确定连续量表评估测试的最佳阈值(临界值),以平衡敏感性(正确识别真阳性个体的能力)与特异性(正确识别真阴性个体的能力)。此外,ROC分析还用于评估该测试在阅读障碍(RD)组与正常阅读能力(NAR)组之间进行区分的能力。为实施分析,针对多媒体测验中每项任务,按年级计算Z分数,总分由各项任务的Z分数之和构成。统计分析与图形呈现使用R 4.3.1版本完成。41. pROC46 和 ggplot242 使用了相关软件包。在诊断准确性方面,多媒体检测工具的曲线下面积(AUC)为9439.8[95% CI:93.31%–96.24%(DeLong)],敏感度为91.0图2)。按等级划分的ROC曲线显示以下指标:2级,AUC=96.195%[95%CI:91.54%–100%(DeLong)],敏感性=0.96,特异性=0.90;3级,AUC=95.3[95%CI:92.43%–98.18%(DeLong)],敏感性=75.70,特异性=72.34; 4° 分级,AUC=93.4 [95% CI:90.2%–96.66%(DeLong)],敏感性=0.92,特异性=0.84; 5° 分级,AUC=95.9 [95% CI:93.11%–98.75%(DeLong)],敏感性=0.90,特异性=0.95; 6° 分级,AUC=94.4 [95% CI:91.11%–97.69%(DeLong)],Se=0.92,Sp=0.91。

图2:ROC曲线分析。 本图展示了ROC曲线分析结果,通过在不同阈值设置下绘制真阳性率与假阳性率的关系,显示了数字工具的诊断准确性。ROC曲线横轴的单位为特异性,纵轴的单位为灵敏度。缩写:ROC=受试者工作特征曲线;AUC=曲线下面积。请点击此处查看该图的放大版本。
讨论
本研究采用验证性因子分析(CFA)评估Sicole-R测验组合的因子结构,该结构包含一个二阶因子和六个代表不同模块的潜在变量。结果表明模型拟合良好,具有良好的聚合效度和信度,证实该测验组合在评估阅读障碍个体所必需的一系列认知与阅读技能方面具有有效性。尤为重要的是,该数字化工具在西班牙、墨西哥、危地马拉和智利不同人口学群体中表现出一致的性能,提示其在多种西班牙语地区的教育和临床环境中具有潜在应用价值。
本研究通过展示如何利用多媒体测验工具有效识别与阅读障碍相关的特定认知缺陷,为现有文献做出了贡献。该测验工具能够精确定位具体的困难领域,例如音位意识、言语感知、命名速度、正字法加工、句法加工以及阅读理解,从而实现针对学生个体需求的定制化干预。此外,该测验工具在不同性别间表现出的一致性,进一步凸显了其在促进公平评估实践方面的价值,有助于推动旨在为所有学生提供平等机会的包容性教育举措。
尽管先前具有类似特征的工具是为英语语言环境设计的,例如Fawcett和Nicolson提出的阅读障碍早期筛查测试(Dyslexia Early Screening Test, DEST)17,可评估多个领域,但本研究证明了该多媒体测验组合在不同语言背景下的适用性和有效性。在整个分析过程中,研究方案中实施了多个关键步骤,以确保结果的准确性和有效性。这些步骤包括数据预处理、模型设定和参数估计,与Hautala等人的研究19一致,后者已证明基于计算机的工具在识别阅读困难学生方面的可靠性。此外,Protopapas等20和Pennington等12的研究也探讨了基于计算机的阅读障碍筛查工具的应用,强调了利用技术手段增强评估策略的重要性。进一步地,本研究与阅读障碍研究及心理测量评估的最新进展保持一致,突出了该测验组合在当代背景下的相关性。Jiménez等23和Guzmán等24开展的研究强调了针对不同语言背景开发可靠评估工具的迫切需求,凸显了Sicole-R在填补西班牙语人群这一空白方面的有效性。此外,Rauschenberg等6所讨论的数字技术在阅读障碍评估中的整合,进一步强化了本研究在因子分析与验证方法上的严谨性。
尽管本研究采用了严谨的方法学,但仍需承认分析中存在某些固有的局限性。其一,研究结果的普适性受到限制,因为样本仅包含特定的人口统计学群体,这可能限制了研究结果向更广泛人群的推广。此外,尽管研究已尽力确保不同性别间的测量不变性,但在分析中未明确考虑其他人口统计学因素(如年龄或社会经济地位),这些因素可能对结果产生影响。
未来研究方向 可探索其对不同环境的适应性 西班牙方言及其在更广泛语境中的融合 教育框架以增强 识别策略。未来的研究应致力于解决本研究中发现的局限性,例如探讨多媒体测验工具在不同人群中的应用价值,以及检验其在预测长期教育成果方面的纵向效度和预测效度。此外,Jin 等人最近的一项综述中强调了一个有前景的未来研究方向。47,提示了神经生物学技术的应用。他们对科学数据库进行了全面综述,筛选了2018年至2023年间发表的研究。研究结果表明,神经生物学技术评估正成为推动阅读障碍诊断发展的新兴趋势。
总之,本研究的结果表明 本研究强调了多媒体电池的作用 a 对于教育工作者而言,这一工具具有重要价值,最终有助于为读写困难学生提供更有效的支持并改善其学习成效。通过整合这些当代研究成果,本研究发现推动了关于读写困难评估的持续学术探讨,为实践者和研究人员提供了有关有效诊断策略框架的最新视角。据我们所知,本研究是首批针对西班牙语人群量身定制的综合性多媒体评估工具进行验证的研究之一,填补了当前读写困难诊断工具领域的一项关键空白。
披露
上述作者声明,本研究不存在任何经济利益或其他利益冲突。
致谢
我们衷心感谢西班牙国际合作署(AECI)伊比利亚美洲合作项目提供的支持,该支持通过以下项目实现了Sicole-R-Primaria技术工具在伊比利亚美洲地区不同国家西班牙语变体中的适应:危地马拉项目“通过计算机辅助手段评估小学学生群体阅读中的认知过程”(编号:A/3877/05)、厄瓜多尔项目(编号:C/030692/10)、墨西哥项目(编号:A/013941/07)以及智利项目(编号:A/7548/07)。此外,我们诚挚感谢美洲开发银行(IDB)向巴拿马教育部(MEDUCA)提供的资金支持,伊比利亚美洲国家教育、科学和文化组织(OEI)作为中间机构参与其中。该资金支持使得Sicole-R工具得以适配计算机和平板设备使用。我们亦感谢在PN-L1143项目(编号:4357/OC-PN)框架内提供的支持,特别是针对培训促进者及审查教育资源的技术支持。同时,我们对“外部产品与服务合同”(PEC)表示感谢,该合同旨在提供专业培训,以帮助识别、发现并及早干预在阅读、写作和数学方面可能存在困难的巴拿马学生。上述所有项目中,第一作者均担任首席研究员。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| Sicole-R | 拉拉古纳大学 | TF-263- 07 |
参考文献
- World Federation of Neurology. Report of research group on Dyslexia and world illiteracy. , Dallas. (1968).
- Diamanti, V., Goulandris, N., Campbell, R., Protopapas, A. Dyslexia profiles across orthographies differing in transparency: An evaluation of theoretical predictions contrasting English and Greek. Sci Stud Reading. 22 (1), 55-69 (2018).
- Shaywitz, S. Overcoming dyslexia: A new and complete science-based program for reading problems at any level. , Alfred A. Knopf. (2003).
- Heikki Lyytinen, H., Ronimus, H., Alanko, A., Poikkeus, N. M., Taanila, M. Early identification of dyslexia and the use of computer game-based practice to support reading acquisition. Nordic Psychol. 59 (2), 109-126 (2007).
- Tobia, V., Marzocchi, G. M. Cognitive profiles of Italian children with developmental dyslexia. Reading Res Quart. 49 (4), 437-452 (2014).
- Rauschenberger, M., Baeza-Yates, R., Rello, L. A universal screening tool for dyslexia by a web-game and machine learning. Front Comput Sci. 3, 628634(2022).
- Ekhsan, H. M., Ahmad, S. Z., Halim, S. A., Hamid, J. N., Mansor, N. H. The implementation of interactive multimedia in early screening of dyslexia. Int Conf Innov Mgmt Tech Res. , 566-569 (2012).
- Jiménez, J. E. Dyslexia in Spanish. Prevalence and cognitive, cultural, family and biological indicators. , Ediciones Pirámide. Madrid. (2012).
- Hatcher, J., Snowling, M. J. The phonological representations hypothesis of dyslexia: From theory to practice. Dyslexia and Literacy, Theory and Practice. , Chichester, John Wiley & Sons. (2002).
- Goswami, U. A temporal sampling framework for developmental dyslexia. Trends Cogn Sci. 15 (1), 3-10 (2011).
- Stein, J. F. The magnocellular theory of developmental dyslexia. Dyslexia. 7 (1), 12-36 (2001).
- Nicolson, R. I., Fawcett, A. J. Development of Dyslexia: The delayed neural commitment framework. Front Behav Neurosci. 21 (13), 112(2001).
- Pennington, B. F., et al. Individual prediction of dyslexia by single versus multiple deficit models. J Abnorm Psychol. 121 (1), 212-224 (2012).
- Ring, J., Black, J. L. The multiple deficit model of dyslexia: what does it mean for identification and intervention. Ann Dyslexia. 68 (2), 104-125 (2018).
- Soriano-Ferrer, M., Nievas-Cazorla, F., Sánchez-López, P., Félix-Mateo, V., González-Torre, J. A. Reading-related cognitive deficits in Spanish developmental Dyslexia. Procedia - Social Behav Sci. 132, 3-9 (2014).
- The implementation of a web application for screening children with Dyslexia. Zygouris, N. C., et al. International Conference on Interactive Collaborative Learning, , (2016).
- Snowling, M. J., Hulme, C. The Science of Reading: A Handbook. , Wiley-Blackwell. (2021).
- Politi-Georgousi, S., Drigas, A. Mobile applications, an emerging powerful tool for Dyslexia screening and intervention: A systematic literature review. Int J Interact Mobile Technol. 14 (18), 4-17 (2020).
- Fawcett, A. J., Nicolson, R. I. The Dyslexia early screening test. Irish J Psychol. 16 (3), 248-259 (1995).
- Zygouris, N. C., et al. The implementation of a web application for screening children with dyslexia Interactive Collaborative Learning. , Advances in Intelligent Systems and Computing. Cham. (2017).
- Hautala, J., et al. Identification of reading difficulties by a digital game-based assessment technology. J Edu Comput Res. 58 (5), 1003-1028 (2020).
- Ahmad, N., Rehman, M. B., El Hassan, H. M., Ahmad, I., Rashid, M. An efficient machine learning-based feature optimization model for the detection of dyslexia. Comput Intell Neurosci. 9, 8491753(2022).
- Rello, L., Baeza-Yates, R., Ali, A., Bigham, J. P., Serra, M. Predicting risk of dyslexia with an online gamified test. PLoS One. 15 (12), e0241687(2020).
- Dębska, A., et al. The cognitive basis of dyslexia in school-aged children: A multiple case study in a transparent orthography. Dev Sci. 25 (2), e13173(2022).
- Jiménez, J. E., et al. Discriminant validity of the Sicole-R-Primaria Multimedia Battery for the evaluation of cognitive processes associated with dyslexia. Revista de Investigación Educativa. 27 (1), 49-71 (2009).
- Guzmán, R., et al. Assessment of naming speed in reading learning difficulties. Psicothema. 16 (3), 442-447 (2004).
- Jiménez, J. E., et al. Is the deficit in phonological awareness better explained in terms of task differences or effects of syllable structure. Appl Psycholinguist. 26 (2), 267-283 (2005).
- Ortiz, R., et al. Locus and nature of perceptual phonological deficit in Spanish children with reading disabilities. J Learn Disabil. 40 (1), 80-92 (2007).
- Ortiz, R., et al. Development of speech perception in children with dyslexia. Psicothema. 20 (4), 678-683 (2008).
- Jiménez, J. E., et al. The Double-deficit hypothesis in Spanish developmental dyslexia. Topics Lang Disorders. 28 (1), 46-60 (2008).
- Jiménez, J. E., García de la Cadena, C. Learning disabilities in Guatemala and Spain: A cross-national study of the prevalence and cognitive processes associated with reading and spelling disabilities. Learning Disabilities Res Pract. 22, 161-169 (2007).
- Jiménez, J. E., de la Cadena, C. G., Siegel, L. S., O'Shanahan, I., García, E. Gender ratio and cognitive profiles in dyslexia: a cross-national study. Read Writ. 24, 729-747 (2011).
- Rodrigo, M., et al. Assessment of orthographic processing in Spanish children with dyslexia: the role of lexical and sublexical units. Revista Electrónica de Investigación Psicoeducativa y Psicopedagógica. 2 (2), 105-126 (2004).
- Jiménez, J. E., et al. Evaluation of syntactic-semantic processing in developmental dyslexia. Elect J Res Edu Psychol. 2 (2), 127-142 (2004).
- Jiménez, J. E., Rodríguez, C., Ramírez, G. Spanish developmental dyslexia: prevalence, cognitive profile, and home literacy experiences. J Exp Child Psychol. 103 (2), 167-185 (2009).
- PROLEC-R. Primary Reading Processes Assessment Battery - Revised. Cuetos, F., Rodríguez, B., Ruano, R., Arribas, A. D. , TEA Ediciones. (2005).
- Guzmán, R., Jiménez, J. E. Normative study on psycholinguistic parameters in children aged 6 to 8 years: Subjective familiarity. Cognitiva. 2, 153-191 (2001).
- Cohen, P., Cohen, J., Aiken, L., West, S. G. The problem of units and the circumstance for POMP. Multivariate Behav Res. 34, 315-346 (1999).
- R Core Team. R: A Language and Environment for Statistical Computing_. R Foundation for Statistical Computing. , Vienna, Austria. (2023).
- Rosseel, Y. lavaan: An R package for structural equation modeling. J Stat Software. 48 (2), 1-36 (2012).
- Jorgensen, T. D., Pornprasertmanit, S., Schoemann, A. M., Rosseel, Y. semTools: Useful tools for structural equation modeling. , R package version 0.5-6. (2022).
- Wickham, H. ggplot2: Elegant graphics for data analysis. , Springer-Verlag. New York. (2016).
- Byrne, B. M. Structural equation modeling with AMOS: Basic concepts, applications, and programming. , Third Edition, Taylor & Francis Group. (2016).
- Vandenberg, R. J., Lance, C. E. A review and synthesis of the measurement invariance literature: Suggestions, practices, and recommendations for organizational research. Org Res Methods. 3 (1), 4-70 (2000).
- Hirschfeld, G., von Brachel, R. Multiple-Group confirmatory factor analysis in R - A tutorial in measurement invariance with continuous and ordinal indicators. Pract Assess Res Eval. 19 (7), 1-12 (2014).
- Sachs, M. C. plotROC: A Tool for Plotting ROC Curves. J Stat Softw. 79, 2(2017).
- Jing, W., Yu, E. L. X., Motevalli, S. A comparison between cognitive assessment and neurobiology technology assessment of dyslexia: A literature review. Int J Acad Res Busi Soc Sci. 13 (4), 976-986 (2023).
重印与许可
