本双语实验方案提供了一种计算药物发现工作流程,用于评估来源于数据库的天然分子与Polo样激酶1至3(PLK1–3)之间的蛋白-配体相互作用,及其吸收、分布、代谢、排泄、毒性和稳定性(ADMET-S)性质。
本文内容
摘要
摘要
Polo样激酶1(PLK1)在细胞周期的S期、G2期和M期中发挥关键作用,其过表达在多种癌症(包括乳腺癌)中频繁出现,导致基因组不稳定性和凋亡调控失常。与靶向激酶结构域的传统ATP竞争性抑制剂不同,选择性抑制PLK1的Polo-box结构域(PBD)提供了一种有前景的策略,可破坏对有丝分裂进程至关重要的蛋白-配体相互作用,从而在癌细胞中触发凋亡。然而,PLK1与其同源蛋白(PLK2和PLK3)结构高度相似,而后者分别在神经功能和应激反应中起重要作用,因此必须具备极高的选择性,以避免脱靶效应。为应对这一挑战,本方案采用双语(美国手语和英语)计算流程,整合了虚拟筛选、结构聚类、蛋白-配体对接、结合亲和力预测、ADMET-S谱分析以及量子力学(QM)稳定性分析。从SuperNatural 3.0天然产物数据库出发,根据与乳腺癌的相关性及类药性标准筛选化合物,通过聚类确保化学多样性,并评估其与PLK1、PLK2和PLK3的PBD结构的相互作用。尽管虚拟对接和in silico ADMET-S评估无法最终确认选择性或作用机制,但本研究生成了可验证的假设,并优先筛选出一组来源于天然产物的候选分子,供后续进行分子动力学模拟、生化验证或实验性筛选。
引言
Polo样激酶(PLKs)是一类蛋白激酶,其结构由一个N端结构域和一个包含一个或两个Polo-box结构域(PBD)的C末端组成1,2。 这些Polo-box结构域的数量和功能多样性在不同的PLK家族成员之间存在差异。PLK1参与细胞分裂的S期、G2期和M期。在细胞周期中,PLK1在S期作为DNA损伤检查点发挥作用,在G2期则调控染色体凝集和中心体成熟。PLK1还促进细胞进入M期,随后推动纺锤体组装、后期启动以及胞质分裂3,4。PLK1的过表达会导致因中心体异常形成而引发的遗传不稳定性,从而破坏细胞周期调控,使细胞无法正常调节凋亡过程。 这种过表达现象已在肺癌、头颈部癌、食管癌、胃癌、结直肠癌和乳腺癌中被观察到4。因此,通过靶向PBD的抑制剂抑制PLK1可能触发细胞凋亡5,6。该实验流程旨在实现高选择性,以避免抑制对神经系统功能和基因毒性应激管理至关重要的PLK2和PLK33。
在某些情况下,PLK2 作为肿瘤抑制因子发挥作用,调控 G1/S 期转换,并促进细胞周期蛋白 E 的降解,从而防止细胞不受控增殖。PLK3 在细胞周期调控和对基因毒性应激的响应中具有复杂作用,通过参与 DNA 损伤检查点激活和诱导凋亡,有助于维持基因组完整性7。重要的是,尽管抑制 PLK1 已成为癌症治疗中一种有前景的治疗策略,但 PLK2 和 PLK3 在神经系统功能和应激反应中的关键作用要求开发高度选择性的抑制剂,以尽量减少对这些重要激酶的脱靶效应3。这一生物学背景以及超过 38% 的序列同源性3凸显了发现特异性靶向 PLK1 泊洛盒结构域(PBD)化合物的重要性,同时避免干扰 PLK2 和 PLK3 在正常细胞生理中的保护功能。
已知的Polo样激酶(PLK)抑制剂,尤其是靶向PLK1的抑制剂,因其在癌症治疗中的潜在治疗应用而被广泛研究。已有多种化合物被开发并进入临床试验阶段,包括BI 2536、伏拉塞替布(volasertib,BI 6727)、昂凡塞替布(onvansertib,NMS-1286937)和GSK461364,这些化合物通常作为ATP竞争性抑制剂8,9,10。其他类型的抑制剂则靶向PBD结构域,包括百里醌(Thymoquinone,TQ)11,12、Poloxin13,14和Allopole-A15。尽管据报道具有前景,但由于存在诸如ADMET-S性质欠佳和脱靶效应等挑战,目前尚无获批的特异性PBD抑制剂或处于后期阶段的临床试验6。例如,据报道多种PLK1-PBD抑制剂为非特异性蛋白质烷基化剂16,限制了其临床应用。因此,提高潜在PLK1-PBD抑制剂的选择性和ADMET-S特性仍是药物发现中的关键目标。
本研究旨在利用虚拟筛选、结构相似性过滤、分子对接、结合能计算及 ADMET-S 评估,探索具有 ADMET-S 特性的潜在 PLK1-PBD 抑制剂。对 PLK2 和 PLK3 采用相同的流程,以评估其潜在选择性。尽管目前已存在多种用于激酶抑制剂发现的计算流程,但极少有方法能同时整合针对 PLK1–3 PBD 的选择性筛选、全面的 ADMET-S 分析以及量子力学稳定性分析,尤其是应用于天然产物库的研究更为罕见。该工作流程基于已建立的虚拟筛选范式,但经过优化,更便于教学使用,适用于早期假设的生成。本方案仅需一台标准笔记本电脑(8 GB 内存)、免费的学术软件,且无需编程基础,因此适用于高中、本科及研究生阶段的教学环境,包括基于课程的本科科研实践(CUREs)。
本研究的计算流程始于蛋白质准备,其中PLK1-PBD、PLK2-PBD和PLK3-PBD的结构从蛋白质数据库(PDB)中获取,或通过建模和处理以解决结构上的不一致。接下来进行天然产物数据库筛选,根据化合物作为抗乳腺癌药物的潜力及其是否符合里宾斯基五规则(Lipinski’s Rule of Five)进行过滤。随后,基于分子指纹和相似性将化合物聚类为50个代表性结构。这些代表性化合物随后进行蛋白-配体对接和结合亲和力计算,生成针对三种PLK蛋白的相互作用数据。接着,利用三个不同的网络服务器评估ADMET-S性质,以预测药代动力学、类药性、毒性及代谢稳定性。通过量子力学(QM)计算,采用最高占据分子轨道(HOMO)和最低未占据分子轨道(LUMO)分析HOMO–LUMO能隙,评估分子稳定性。最后,分析ADMET-S数据,根据理化性质、吸收、分布、代谢、排泄、毒性和稳定性等标准,对化合物进行筛选和排序,以确定潜在且选择性的PLK1-PBD抑制剂。
方案
所有所用软件工具的研究资源标识符(RRIDs)和版本号均在材料表中提供。
1. 目标蛋白的制备
- 为本项目创建一个工作目录,用于存储结构文件和计算结果。
- 访问蛋白质数据库(Protein Data Bank),获取目标蛋白PLK1-PBD的编号(4HCO11),并使用哈佛分子力学化学平台的图形用户界面(CHARMM-GUI17,18)解决可能存在的结构差异问题。
- 访问CHARMM-GUI网站并注册学术账户。注册完成后,点击输入生成器(input generator),选择PDB Reader,输入PDB编号4HCO,然后点击下一步。
- 在下一页中,确保仅选中PROA——蛋白链A,并在接下来的两页中均点击下一步。
- 将step1_pdbreader.pdb下载至指定目录,将文件重命名为4hco或自定义名称,并使用文本编辑器或代码将文件中所有组氨酸残基(HSD)的名称更改为(HIS)。
- 对PLK2-PBD(PDB编号:4XB019)重复上述操作。
注意:对于无PDB编号的结构(如PLK3-PBD),应使用同源建模结构或Alphafold20预测结构,并通过Uniprot21确保序列准确性。
2. 天然产物数据库筛选
- 访问天然产物 SuperNatural 3.0 数据库,选择疾病子页面22。
- 选择乳腺癌,置信区间可为任意值或无限制,因为所有结果都需要通过程序进行过滤,然后点击 查找。点击 下载完整结果 文件,将结果以 .csv 格式保存至指定目录。随后,使用代码筛选出置信区间为 0.900–1.000 的条目(共 1,193 个,总数为 73,406)。
注:也可在通路子页面23中输入乳腺癌的京都基因与基因组百科全书(KEGG)标识符进行查询。 - 前往 常见问题 子页面,在页面底部可找到可供下载的完整数据集(.csv 文件)。下载该文件后,使用脚本将数据集中的简化分子线性输入规范(SMILES)字符串与上述 1,193 个分子的 SuperNatural 标识符进行匹配,并生成其 SMILES 字符串列表(smiles.csv)。
- 选择乳腺癌,置信区间可为任意值或无限制,因为所有结果都需要通过程序进行过滤,然后点击 查找。点击 下载完整结果 文件,将结果以 .csv 格式保存至指定目录。随后,使用代码筛选出置信区间为 0.900–1.000 的条目(共 1,193 个,总数为 73,406)。
3. 整群抽样
- 下载包含几乎所有开源软件包的 Anaconda 发行版(https://www.anaconda.com/download),或单独下载集成开发环境(IDE),例如 RStudio(RStudio Desktop - Posit)或 Jupyter(Jupyter Notebook)。使用 Conda 安装开源的化学信息学与机器学习软件包 RDKit24。
注意:有关安装 Conda 及创建 Conda 环境的说明,请参阅 conda 25.9.2.dev31 文档。有关在环境中安装 RDKit 及配置模块的信息,请参阅《RDKit 2025.03.6 安装文档》。 - 将 补充文件 1 中的“Lipinski.py”脚本与“smiles.csv”文件置于同一文件夹中并运行该脚本。该脚本将激活 Conda 环境,加载模块,读取 SMILES 字符串文件,根据利平斯基五规则(Rule of 5)对生物利用度和吸收性进行筛选(从 1,193 个化合物中筛选出 n = 999),并将筛选后的 SMILES 字符串列表保存为“all.csv”。
注意:请确认已成功生成“all.csv”文件,并包含约 999 个化合物(即筛选后的子集)。打开文件以验证每个条目是否均为有效的 SMILES 字符串。在 RStudio 控制台中执行以下命令后,可运行 Python:library(reticulate); reticulate::use_condaenv(nameofcondaenv)。 - 将 补充文件 1 中的“Clustering.py”脚本与“all.csv”文件置于同一文件夹中,并在首选的 IDE 中运行。该脚本将加载聚类模块,读取 SMILES 字符串文件,并基于分子指纹和 Tanimoto 相似性将化合物分为 50 个聚类。
注意:50 个代表性结构(rep_struct.csv,位于 补充文件 1 中)将以 SMILES 字符串列表的形式保存在目录中。Tanimoto 相似性(在化学信息学中也称为 Jaccard 指数)25 是一种基于分子指纹量化两个分子之间结构相似性的指标,Tanimoto 系数范围为 0(无相似性)至 1(指纹完全相同)。请确保“rep_struct.csv”文件中恰好包含 50 个唯一的 SMILES 条目,每个条目代表一个聚类。
4. 蛋白质-配体对接与结合亲和力计算
- 访问基于 AutoDock Vina 的腔穴检测引导盲对接网络服务器(CB-Dock2)26。
- 进入对接选项卡并上传 4HCO 蛋白。
- 为上传配体,点击绘制配体,然后从 SMILES 字符串列表中粘贴一个配体(rep_struct.csv,补充文件 1)。在下一个字段中输入电子邮件地址以便更方便地收集压缩数据,然后点击自动盲对接。对剩余的 49 个小分子聚类代表物重复此操作,并将其标记为 lig1、lig2、…、lig50。
- 前往收到的电子邮件结果,将压缩文件夹下载到名为 4HCO 的子目录中,并按顺序命名(4hco_lig1、4hco_lig2、…、4hco_lig50)。
- 解压文件夹,并删除除以“.complex.pdb”结尾的蛋白-配体复合物文件外的所有文件。
注意:请确认每个配体目录(4hco_lig1 至 4hco_lig50)均包含相应的“.complex.pdb”文件。 - 使用文本编辑器打开一个示例 .complex.pdb 文件,仔细记录蛋白链 ID:P 和配体 ID:A:UNL,然后使用文件压缩工具重新压缩文件夹。
- 访问用于评估选择性和蛋白-配体结合亲和力的 PROtein binDing enerGY 预测(PRODIGY)网络服务器27。
- 点击PRODIGY-lig(蛋白-小分子)选项卡,以一次上传包含多个蛋白-配体复合物的压缩文件夹(例如 4hco_lig1)。输入蛋白链和配体 ID,完成验证码验证,然后点击提交 Prodigy-Ligand。
- 数据处理完成后,点击所有输出的归档文件 (.zip) 下载结果。对所有子目录(直至 4hco_lig50)重复前述步骤及结果收集。
- 对蛋白 4XB0 和 PLK3 重复所有步骤,需特别注意文件命名规范(如 4xb0_lig1 或 plk2_lig1)。
注意:确认所有蛋白-配体复合物的输出 CSV 文件均已下载,并包含 ΔG 和界面残基数据两列。
- 解压文件夹,并删除除以“.complex.pdb”结尾的蛋白-配体复合物文件外的所有文件。
5. ADMET-S 评估
- 访问 ADMETlab3 3.0 平台28.
- 点击 开始使用 在……下方 "ADMET 筛选" 并输入一组SMILES。
- 打开 rep_struct.csv 将SMILES字符串列表的全部内容复制到文本字段中并提交。
- 使用平台的彩色编码评分系统评估药代动力学和类药性质,并将评估结果下载为 .csv 文件以供进一步分析。
- 进入 SwissADME 工具29.
- 点击 开始使用 在……下方 "ADMET 筛选" 并输入一组SMILES。
- 将全部50个分子的SMILES字符串列表粘贴到输入框中。
- 点击 运行 用于计算生物利用度和渗透性等性质,包括血脑屏障穿透能力。
- 将输出结果下载为 .csv 文件,以便与其他 ADMET 结果进行整合。
- 下载并安装 ToxTree30 (通过决策树方法进行毒性危害评估)与用户操作系统兼容。
- 打开软件 通过 使用命令:sh Toxtree.sh 运行终端
- 将SMILES字符串单独输入Tox游戏副本,依据Cramer规则对毒性进行分类。
- 将结果导出为 .csv 文件,以便与其他 ADMET 数据整合。
注意:检查 ADMETLab3 和 SwissADME 输出的 CSV 文件中配体数量是否一致(n = 50),并确认 Toxtree 的结果已根据 Cramer 分类规则(I–III)对每个化合物进行了分类。
- 安装 ORCA 后31,创建一个名为 stability 的文件夹,并在工作目录中为每个分子创建子文件夹(例如 plk1_lig1、plk1_lig2、...、plk1_lig50)。
- 使用 Avogadro(Avogadro)从每个分子的 SMILES 字符串构建分子结构:进入 Extensions 选项卡,点击 Optimize Geometry 以优化分子几何构型。生成 ORCA 输入文件 通过 扩展应用 > ORCA > 生成 ORCA 输入并应用以下设置:
! B3LYP OPT FREQ def2-TZVP
%maxcore 4000
%pal
nprocs 1
结束 - 修改每个配体的下载文件 .sh 作业文件,以包含唯一的作业名称和电子邮件地址。然后,使用以下命令将“stability”目录传输到高性能计算(HPC)系统:
ssh xsedeu0000@darwin.hpc.udel.edu
mkdir ~/4hco
scp -r /local/path/to/stability xsedeu0000@darwin.hpc.udel.edu:~/4hco - 通过简单 Linux 资源管理实用程序(SLURM 高性能计算集群工作负载管理器)使用循环脚本执行作业:
for i in {1..50}; do
cd ~/4hco/stability/plk1_lig${i}
chmod +x job_lig${i}.sh
sbatch job_lig${i}.sh
完成 - 收到任务完成邮件后,进入配体文件夹并打开输出文件以查看数据,记录HOMO和LUMO值:
cd ~/4hco/stability/plk1_lig1
nano lig1.out
- 使用 Avogadro(Avogadro)从每个分子的 SMILES 字符串构建分子结构:进入 Extensions 选项卡,点击 Optimize Geometry 以优化分子几何构型。生成 ORCA 输入文件 通过 扩展应用 > ORCA > 生成 ORCA 输入并应用以下设置:
6. ADMET-S 数据分析
- 将来自 SwissADME 生物利用度和渗透性雷达图的理化性质数据合并到一个 .csv 文件中。
- 保存来自 SwissADME 的 .csv 文件,并将其命名为“Physiochemical.csv”。
- 将“Physiochemical.py”脚本(补充文件 1)与“Physiochemical.csv”置于同一文件夹中并运行该脚本。
- 应用以下标准:nHD:0–7,nHA:0–12,nStereo:<2,LogP:0–3,LogD:1–3,LogS:–4 至 0.5,Fsp3:>0.41,nHet:1–15。
- 从 SwissADME 获取吸收和分布数据。
- 截取并保存 SwissADME 中的 BOILED-Egg32 图表。
- 应用以下标准:分子必须位于“蛋”区域内,并作为 P-糖蛋白抑制剂,优先选择红色点。
- 从 ADMETlab3.0 获取细胞色素(CYP)底物和抑制剂的代谢数据。
- 保存来自 ADMETlab3.0 的 .csv 文件,并将其命名为“Metabolism.csv”。
- 编辑该 .csv 文件,仅保留 CYP-inh 和 CYP-sub 两列。
- 将“Metabolism.R”脚本(补充文件 1)与“Metabolism.csv”置于同一文件夹中并运行该脚本。
- 应用以下标准:优先选择 CYP p450 抑制剂且非底物(类别为 0)的分子。
- 从 ADMETlab3.0 获取血浆清除率和半衰期的排泄数据。
- 保存来自 ADMETlab3.0 的 .csv 文件,并将其命名为“Excretion.csv”。
- 编辑该 .csv 文件,仅保留 cl-plasma 和 t0.5 两列。
- 将“Excretion.py”脚本(补充文件 1)与“Excretion.csv”置于同一文件夹中并运行该脚本。
- 应用以下标准:血浆清除率:0.01–5 ml/min/kg。
- 从 Toxtree 获取毒性类别数据,从 ADMETlab3.0 获取毒发色团数量的毒性数据。
- 保存来自 ADMETlab3.0 的 .csv 文件,并将其命名为“Toxicity.csv”。
- 编辑该 .csv 文件,仅保留 Toxicophore 列,并新增一列记录每个配体来自 Toxtree 的毒性类别。
- 将“Toxicity.py”脚本(补充文件 1)与“Toxicity.csv”置于同一文件夹中并运行该脚本。
- 应用以下标准:毒发色团数量为 0–2。
- 从 ORCA 输出文件中获取稳定性数据(“ORBITAL ENERGIES”,特别是 HUMO 和 LUMO 能量值)。
- 创建一个 Excel 表格,将每个配体的 HUMO 和 LUMO 能量分别记录为独立列。
- 新增一列用于计算带隙(HUMO–LUMO = 带隙)。
- 将该 Excel 表格另存为“Stability.csv”。
- 将“Stability.py”脚本(补充文件 1)与“Stability.csv”置于同一文件夹中并运行该脚本。
- 应用以下标准:带隙差值在 3.6–5 eV 之间。
结果
目标蛋白结构文件方案可确保目标蛋白文件经过优化,适用于分析和基于结构的分子对接。所得的PDB格式结构文件不含缺失的残基和氢原子、缺失的原子类型,以及水分子和共结晶配体等不必要的组分。图1A、B展示了准备前后结构的可视化差异(通过Mol* Viewer33可视化)。如果仍存在任何残留的格式问题(如无法识别的原子名称或不完整的残基),CB-Dock2在上传时通常会报错。此时,可在重新尝试对接步骤前进行轻微的手动修正,例如将HSD重命名为HIS,或移除非标准残基。
图2展示了基于分子指纹和Tanimoto相似性进行主成分分析(PCA)的聚类结果。图中,每个聚类由一个灰色阴影椭圆圈出,椭圆内颜色相近的点代表该聚类中的分子。坐标轴上的主成分1和主成分2提供了Tanimoto矩阵中高维元素降维后的二维线性表示。本研究在聚类采样步骤中使用Tanimoto相似性,以减少冗余并增强999种符合Lipinski规则的天然产物之间的化学多样性。通过利用分子指纹计算两两之间的Tanimoto相似性,将数据集划分为50个结构相关的化合物聚类。随后从每个聚类中选择一个代表性分子,确保最终的50个配体集合能够覆盖广泛的化学空间,同时最小化后续分子对接和ADMET-S分析中的计算冗余。该策略提高了虚拟筛选的效率和代表性,尤其适用于SuperNatural 3.0等大型天然产物数据库。(见图2)。
针对PLK1蛋白在CB-Dock2中的五个CurPocket构象,对每种蛋白-配体复合物进行最优构象模拟,并结合范德华力和氢键作用,以Vina评分形式预测其结合亲和力。如图3中配体1的模拟示例所示,其与第二个CurPocket构象(C2)的结合最佳,Vina评分为–7.5 kcal/mol,低于其余四个最优构象。CB-Dock2通过基于经验参数的打分函数和随机全局优化算法实现分子对接。CB-Dock2已得到严格验证,相较于其他先进的盲对接工具表现出更优异的性能,是对接研究的理想选择26,34。该服务器在结合构象预测方面的成功率约为85%(RMSD <2 Å),优于包括初代CB-Dock、SwissDock、COACH-D和MTiAutoDock在内的多种常用工具34。这一高精度归因于CB-Dock2创新性地整合了两种互补的对接策略:基于结构的方法和基于模板的方法。
图4 展示了使用PRODIGY网络服务器预测的每种蛋白-配体组合的平均预测亲和力热图。较高的亲和力表现为较低的摩尔能量(kcal/mol)和更绿的热图色调,代表有利的结合亲和力;相反,较低的亲和力表现为较高的摩尔能量和更红的热图色调,代表结合能力较差。从选择性的角度来看,理想的化合物应对目标蛋白(PLK1)具有优于同源蛋白(PLK2–3)的有利亲和力。例如,配体27相对于配体45具有更高的PLK1-PBD选择性,后者在三种蛋白中表现出相似的亲和力。尽管化合物3、5、6、7、27、28、34、35和49对PLK1-PBD的亲和力高于PLK2/3,但它们在二维指纹空间中化学结构多样(平均ECFP4 Tanimoto系数≈0.135,任意两两之间均未达到≥0.50),这表明其广泛的特异性可能源于保守的PBD结合口袋几何结构以及共享的三维药效团/相互作用模式,而非骨架结构的相同性。建议通过相互作用指纹比较和药效团映射来确定PLK1-PBD识别的结构决定因素。
理化性质评估结果以雷达图形式展示(图5)。所评估的性质包括原子间相互作用、溶解度和生物利用度。部分化合物在可接受范围内表现出更理想的理化性质:nHD = 0–7,nHA = 0–12,nStereo < 2,LogP = 0–3,LogD = 1–3,LogS = –4 至 0.5,Fsp3 > 0.41,以及 nHet = 1–15。该雷达图对计算筛选流程中确定的50个代表性配体的理化性质进行了全面的多维可视化展示。其设计目的是通过将各化合物的性质与既定的上下限进行对比,评估其符合预设“类药性”标准的程度。图表围绕极轴展示了十个关键的分子描述符,包括酸性pKa和碱性pKa。绿色多边形(下限)与蓝色多边形(上限)之间的阴影区域表示根据实验方案中提供的阈值确定的每项性质的理想或可接受范围。酸性pKa(2–12)和碱性pKa(3–10)的上下限基于文献综述确定35,36,37,因为在药物发现中不存在单一的pKa上下限。每条彩色线代表50个配体中的一个。连接单个配体各数据点所形成的形状,同时展示了其在选定的十项性质上的整体特征。绝大多数50个配体均落在绿色与蓝色多边形所定义的可接受区域内或非常接近该区域。这表明初始筛选步骤,特别是Lipinski五规则的应用以及基于Tanimoto相似性的聚类,在富集具有理想类药性质的分子方面非常有效。建议展示所有参数记录值的完整范围。
图6A–C 展示了来自 ADMETlab3.0 和 SwissADME 的 ADME 数据组成部分。从吸收和分布开始,采用 BOILED-Egg 模型38 在 图6A 来自 SwissADME 的结果代表了药物的吸收与分布 通过 脂溶性和通透性,如图中黄色和白色椭圆所示。该区域包含P-糖蛋白(P-gp)底物和抑制剂,分别以蓝色和红色点表示,其中抑制P-gp对提高吸收率至关重要。在 图6B代谢热图可视化了约7种CYP细胞色素P450酶的抑制作用和底物特性。理想情况下,配体应不抑制CYP酶且不作为其底物(绿色),优选结果表明药物具有安全的药理学特性,无或低药物-药物相互作用。 图6C 代表药物清除率和半衰期的排泄数据。排泄可通过最佳血浆清除率加以区分<5 mL/min/kg)。所有抗癌药物的药物半衰期取决于其作用机制、毒性和靶点。理想的半衰期能够在维持药物浓度处于治疗窗内的同时,最大限度地减少毒性,并允许采用方便的给药方案。39,40.
展示了两种毒性评估方法的结合。在图7A中,显示了ADMETlab3.0为每种配体识别出的毒理官能团(toxicophores)数量。目前尚无明确的阈值或关于可接受毒理官能团数量范围的信息。在图7B中,Toxtree的应用提供了与毒性等级(I-III级)相关的信息,以及Cramer规则的违反与符合情况。配体1的示例结果在顶部栏显示其毒性结果及其SMILES编码,结构式位于左下窗口。右上窗口中的毒性等级识别结果表明,根据Cramer规则,配体1属于高毒性(III类),而非其他可能类别,如II类(中等毒性)或I类(低毒性)。右下窗口展示了基于Cramer规则决策树得出该分类的书面推理过程。
对优化结构进行振动频率的ORCA量子化学计算,可得到用于确定带隙的轨道能级值。图8展示了由HOMO与LUMO能级差计算得到的每种配体的带隙(eV)。阴影区域表示3.6 eV至5.0 eV之间的阈值范围,该区域内每个数据点均满足与更高理想稳定性和反应性相关的能级要求。图9总结了整个计算工作流程,展示了从靶标蛋白准备和天然产物数据库筛选到ADMET-S评估的各个连续阶段,旨在识别具有选择性的PLK1-PBD抑制剂,同时确保其具备类药性质和化学稳定性。该可视化路线图突出了本方案的模块化、易用性以及适用于教学实施的特点。
表1 将协议从线性指令序列转化为适用于课堂教学与独立科研的稳健且具备错误识别能力的流程。该方案通过在关键转换节点嵌入验证标准,明确应对计算药物发现中公认的可重复性挑战。例如,在 CHARMM-GUI 处理后确认组氨酸残基统一标记为“HIS”,可防止下游分子对接中出现隐性失败;在聚类前验证 SMILES 结构的完整性,可避免 ADMET 预测中的连锁错误。该表格还突出了教学设计,每个故障排查提示均只需最低限度的计算背景即可操作(例如,“用文本编辑器打开 .complex.pdb 文件以检查链 ID”),契合论文面向聋人、本科/研究生及高中生学习者的可及性目标。此外,通过标注对结果影响显著的关键步骤(如选择性评估),进一步提升流程的可靠性与教育价值 通过 通过比较性PRODIGY评分,该表格有助于用户优先分配关注和资源。
该整合工作流程的一个关键优势在于,它能够揭示互补性计算预测之间的差异,暴露出凸显单一方法局限性的边界情况。例如,PLK1-PBD 的配体 5 在 CB-Dock2 中表现出较强的 Vina 评分(−7.9 kcal/mol),且 PRODIGY 预测的亲和力良好(ΔG = −9 kcal/mol,图 4),但却未能通过多项 ADMET 筛查。该配体不符合 BOILED-Egg 吸收-分布模型,血浆清除率数值较差(9.3 mL/min/kg,图 6),提示其会被快速清除,同时被 Toxtree 判定为 Cramer III 类(高毒性),含有五个毒性基团(图 7A)。相反,配体 33 的 PRODIGY 预测 PLK1 亲和力中等(−5.4 kcal/mol),但满足全部 ADMET 标准,表现出低毒性(I 类)、理想的 LogP 值(0.7),以及良好的吸收-分布特性和血浆清除率。尽管其亲和力较弱,配体 33 仍是一个更具药物特性的候选分子。这一对比说明了早期药物发现中的一项基本原则:仅具有高结合亲和力是不够的,还需具备良好的药代动力学特性和安全性。与此同时,像配体 5 这类尽管 ADMET 表现不佳的化合物,仍可能为后续优化提供有价值的骨架结构,用于在不牺牲活性的前提下改善其安全性或代谢稳定性。
尽管该工作流程中的早期筛选步骤旨在进行分类和优先级排序,而非永久性排除,但通过对 ADMET 工具和文献中可获得的理想性质限制条件进行进一步分析,可将50个候选化合物进一步精简。在针对114项与 ADMET 及电子特性相关的描述符进行评估的50个配体中,有13个满足至少95项理想性质标准。其中,六个化合物(10、13、14、32、43 和 47)对 PLK1-PBD 的 ADMET-S 剖面更优,且结合亲和力高于 PLK2/3,因此被确定为最优候选抑制剂(图10)。结构-功能比较与定量相似性分析表明,这些命中化合物与已知的 PLK1-PBD 抑制剂具有关键的药效团特征,提示其结合行为可能存在共性。所有命中化合物均含有芳香或杂芳香骨架,模拟了 TQ、Poloxin 和 Allopole-A 中的疏水环系统,可在 PBD 结合口袋内实现 π–π 和疏水相互作用。通过保守的氢键作用基序(羧基、酰胺基和羰基)可观察到功能重叠,这些基序类似于参考抑制剂中介导关键极性相互作用的结构。多个命中化合物中存在的柔性脂肪族和环状连接链,类似于 Poloxin 类似物的构象适应性,有助于朝向关键结合残基的定向排列。在定量上,Tanimoto 相似性评分(0.36–0.54)证实了这些命中化合物与已知抑制剂之间存在中等程度的结构相似性,其中命中物 10、13 和 14 与 Poloxin 最为相似,命中物 32 与 TQ 相似,而命中物 43 和 47 则与 Allopole-A 相似。综合来看,这些结果突显了明显的结构与功能重叠,表明这些命中化合物可能模拟了已验证的 PLK1-PBD 抑制剂的结合拓扑结构和相互作用模式,同时仍保留足够的新颖性以供进一步优化(图10)。
为评估计算工作流程的稳健性,将已知的PLK1-PBD抑制剂(Poloxinpan14 和 Allopole-A15)作为阳性对照,同时以两种结构无关且未见报道具有PLK1-PBD活性的抗糖尿病药物——二甲双胍(Metformin)和伊美格列明(Imeglimin)作为阴性对照,在ADMET-S、分子对接和结合亲和力分析中进行比较。阳性对照的结合亲和力分别为–5.8 和 –5.6 kcal/mol,而阴性对照的亲和力较弱,分别为–5.1 kcal/mol(Metformin)和–4.8 kcal/mol(Imeglimin),与其缺乏PBD结合活性的特性一致。值得注意的是,ADMET-S评估显示,阴性对照满足的有利描述符(114项性质中的88项)多于阳性对照(114项中的80项),从而验证了该工作流程能够区分药代动力学优势与靶点特异性结合潜力。这些结果强调了保持平衡视角的重要性:若化合物表现出较强的靶点亲和力,即使其ADMET预测结果不理想,也不应过早排除,因为此类骨架仍可能为后续优化提供有价值的起点。相反,药代动力学性质优良但结合能力较弱的分子,则可作为低风险模板用于类似物开发。尚需进一步的生化与细胞实验验证这些计算结果,并优化筛选优先级标准。
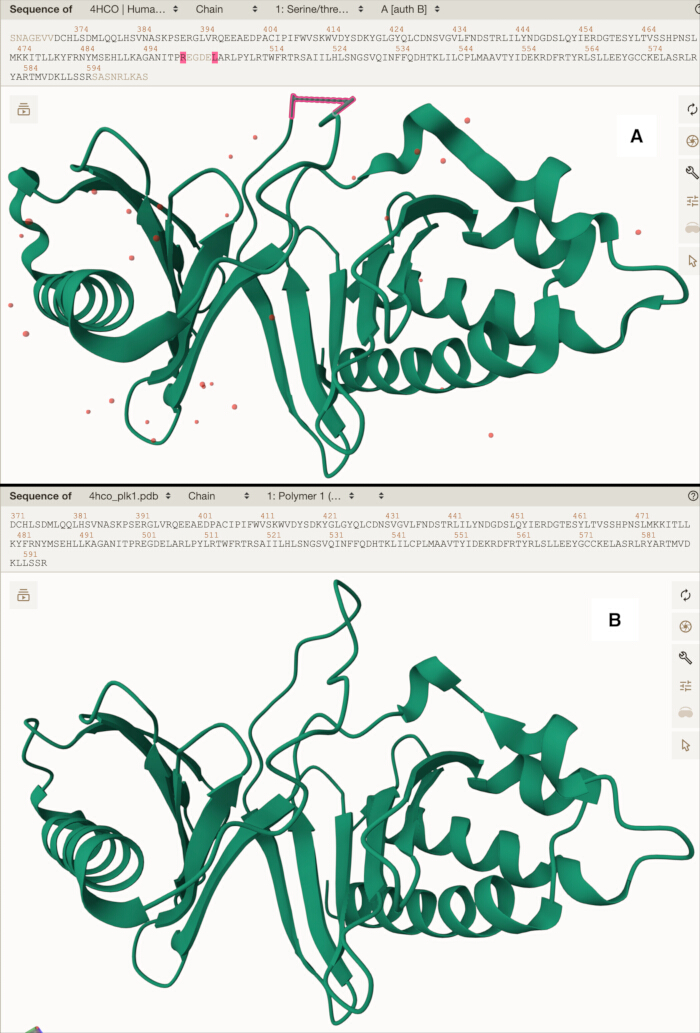
图1:未处理结构与经CHARMM-GUI处理后的4HCO结构的比较。(A)直接从PDB上传的4HCO结构,突出显示缺失的残基。(B)经过CHARMM-GUI预处理流程后的4HCO结构。选择4HCO(PLK1-PBD结合TQ)是因为它是少数几种结合了有机配体的PLK1-PBD晶体结构之一,因此可直接应用于基于结构的小分子抑制剂发现。请点击此处查看该图的放大版本。
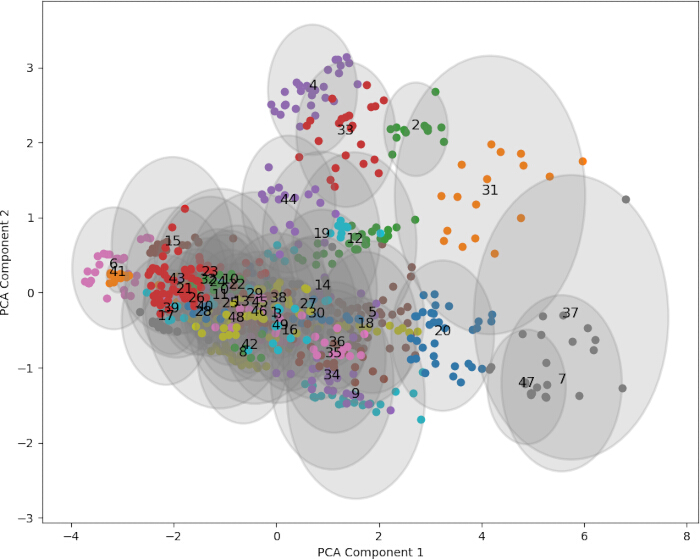
图2:基于分子指纹和Tanimoto相似性进行K-均值聚类的999种符合Lipinski规则的天然产物的主成分分析(PCA)。每个点代表一种化合物,按其所属的聚类(1–50)着色,聚类以灰色椭圆圈出,以突出其化学相似性。聚类内部的紧密分布以及聚类之间的明显分离表明,基于Tanimoto的聚类方法成功减少了结构冗余,同时保留了数据集中的化学多样性。这种多样性确保了为后续分子对接所选出的50个代表性配体能够覆盖广泛的化学空间,从而增强虚拟筛选结果的稳健性和普适性。 请点击此处查看该图的放大版本。
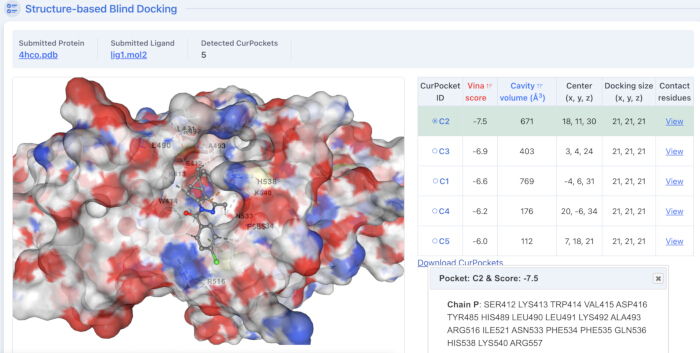
图 3:CB-Dock2 盲对接鉴定了配体 1 在 PLK1 极体结构域(PBD)内的高亲和力结合构象。所示的 CurPocket C2 构象(Vina 评分 = −7.5 kcal/mol)是在预测的五个结合位点中得分最优的构象,其特征是与 PBD 关键残基(Trp414、His538 和 Lys540)形成有利的范德华接触和氢键相互作用。该结果验证了在缺乏共结晶配体的情况下,使用基于结构的盲对接方法识别生物学相关结合口袋的可行性,并展示了本工作流程如何优先选择预测结合能最强的构象,用于后续的选择性分析。请点击此处查看该图的高清版本。
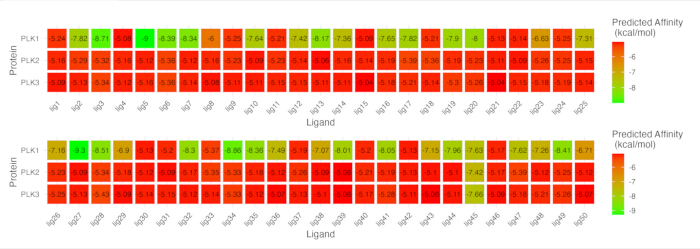
图 4:基于蛋白质-配体组合的 PRODIGY 网络服务器预测亲和力热图。该热图直观展示了配体在与 PLK1、PLK2 和 PLK3 结合时的重叠情况。尽管某些配体(包括配体 45)在三种 PLK 亚型中表现出相似的结合亲和力,提示选择性较差,但其他配体(特别是配体 3、5、6、7、27、28、34、35 和 49)则显示出对 PLK1 的强烈偏好(与 PLK2/PLK3 相比,ΔΔG ≥ 3.0 kcal/mol),这与实现 PBD 选择性抑制的目标一致。从定量角度看,50 种配体中有 20 种基于 PRODIGY 预测的 ΔG 值,对 PLK1 相较于 PLK2 和 PLK3 均表现出近两倍的选择性。这种差异性结合归因于 PBD 结合口袋中存在的细微结构差异,而盲式对接方案能够捕捉到这些差异。请点击此处查看该图的放大版本。
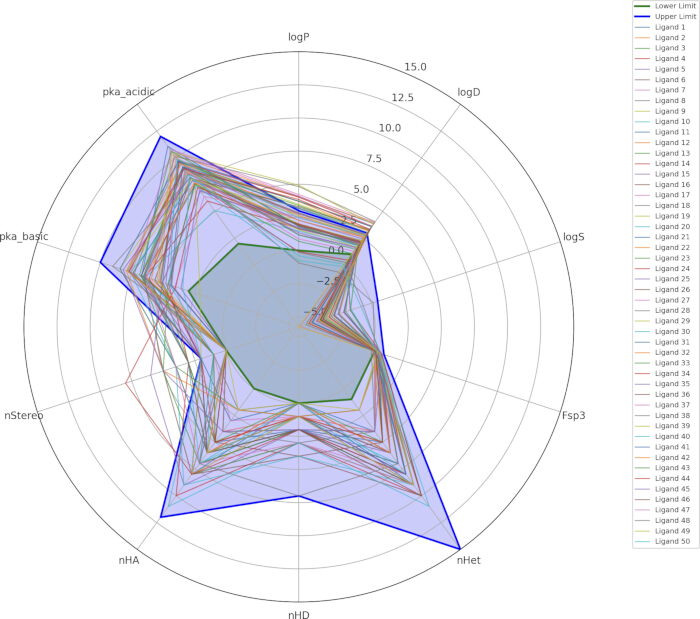
图5:结合ADMETlab3.0与SwissADME的理化性质表征。参数包括nHD = 氢键供体数量,nHA = 氢键受体数量,碱性pKa,酸性pKa,nStereo = 立体中心数量,LogP = 正辛醇/水分配系数,LogD = pH=7.4时的正辛醇/水分配系数,LogS = 水溶性值,Fsp3 = sp3杂化碳原子数/总碳原子数,以及nHet = 杂原子数。请点击此处查看该图的放大版本。
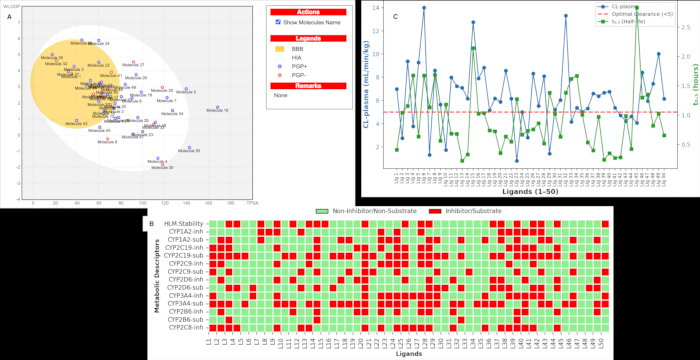
图6:ADMETlab3.0 与 SwissADME 的 ADME 结果组合. (A) 基于Wildman-Crippin LogP(WLOGP)的BOILED-Egg图 与. 由SwissADME提供的拓扑极性表面积(TPSA),用于表示吸收与分布特性:血脑屏障(BBB)通透性位于黄色(蛋黄)区域,胃肠道吸收(HIA)位于白色椭圆内,P-糖蛋白底物和非底物分别以蓝色和红色点表示。位于“蛋”形区域之外的分子被认为具有较差的吸收和分布特性。B) 涉及人肝代谢(HLM)稳定性的不同细胞色素P450(CYPs)标识物的代谢热图,其中红色表示抑制剂/底物,绿色表示非抑制剂/非底物,以绿色为理想结果。C排泄涉及血浆清除率和半衰期等参数。红色虚线表示理想的血浆清除率<5 mL/min/kg),而5-15 mL/min/kg和 >15 mL/min/kg 分别表示中等和高清除率。 请点击此处查看此图的放大版本。
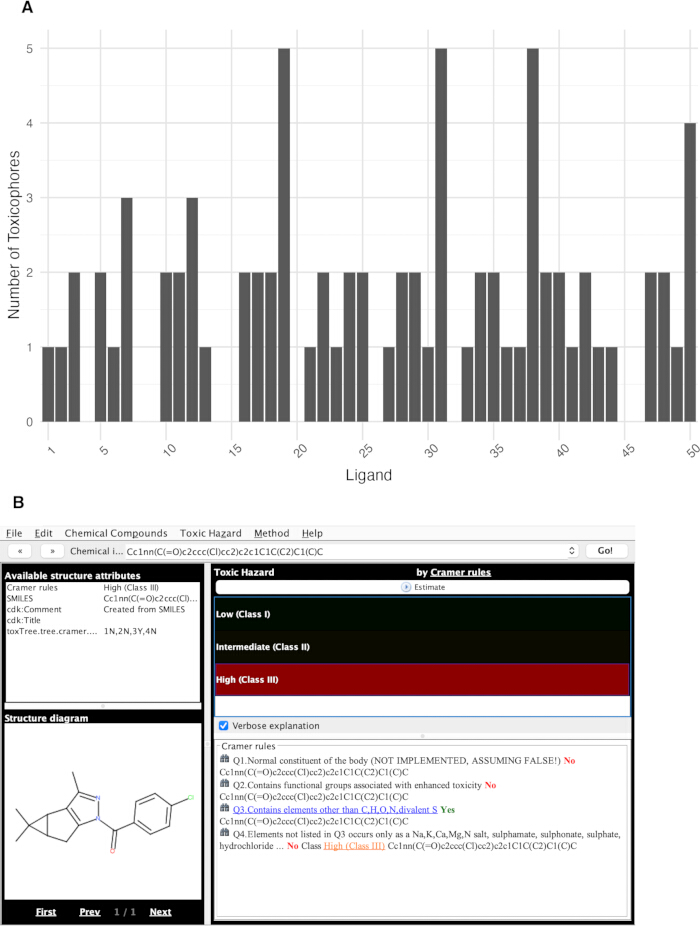
图7:整合毒性分析揭示筛选配体中的关键安全性隐患。(A)基于 ADMETlab3.0 预测结果,50 种代表性天然产物中毒性警示结构数量的分布情况。(B)配体 1 的毒性分析示例,显示被标记为红色的 III 类毒性,并在下方文本框中列出相关的 Cramer 规则详细说明。该双重评估方法(毒性警示结构 + Cramer 分类)可实现对高风险化合物的早期筛选。请点击此处查看本图的高清版本。
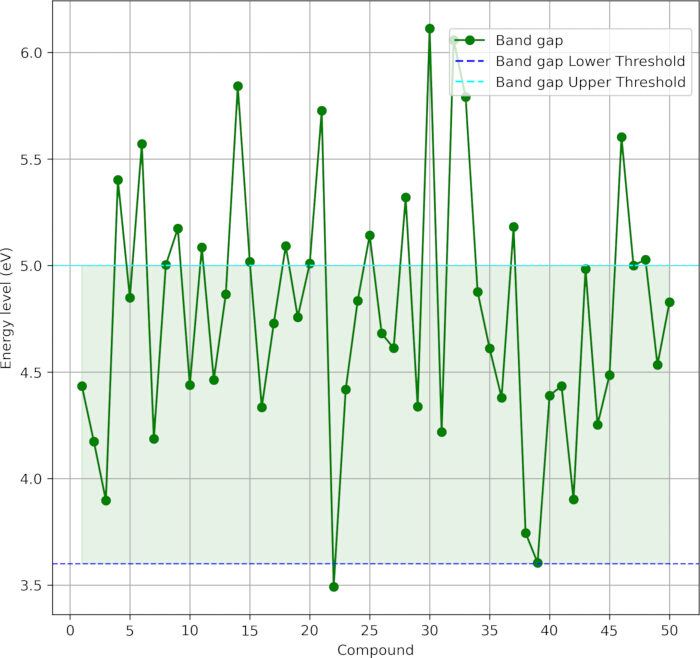
图 8:使用 ORCA 在 B3LYP/def2-TZVP 理论水平下计算的 50 种代表性天然产物衍生配体的 HOMO–LUMO 能带隙能量(单位为 eV)。阴影区域(3.6 至 5.0 eV)表示最佳稳定性窗口:能带隙低于 3.6 eV 可能表明化学反应性较高或存在光降解风险,而高于 5.0 eV 的值可能表明电子极化能力较差且结合适应性降低。落在该范围内的配体在动力学稳定性与分子响应性之间表现出良好的平衡,支持将其优先作为潜在的 PLK1-PBD 抑制剂候选物。请点击此处查看该图的放大版本。
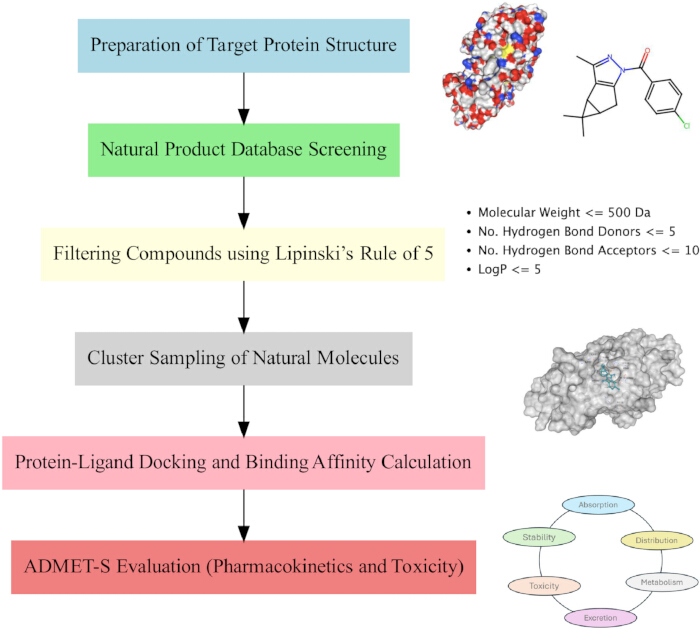
图9双语计算药物发现工作流程图流程始于PLK1-PLK3 PBD结构的制备,随后针对SuperNatural 3.0数据库进行以疾病为导向的筛选及过滤 通过 Lipinski五规则(分子量 ≤ 500 Da,氢键供体 ≤ 5,氢键受体 ≤ 10,LogP ≤ 5)。在聚类分析后选择代表性化合物,并通过蛋白-配体对接、结合亲和力预测以及全面的ADMET-S谱型分析进行评估,包括吸收、分布、代谢、排泄、毒性及量子力学(QM)稳定性评估。 请点击此处以查看此图的放大版本。
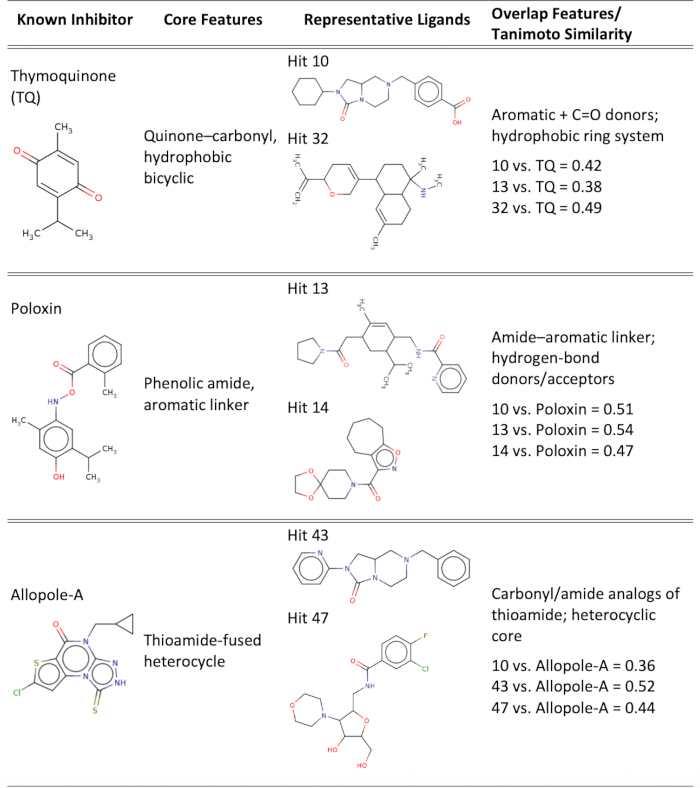
图10:最佳候选配体与已知PLK1-PBD抑制剂之间的结构-功能比较重叠。该图展示了通过整合虚拟筛选、聚类分析、结合亲和力及ADMET-S谱型分析所鉴定出的六个最佳候选化合物(10、13、14、32、43和47)。这些配体满足至少114项理想理化与药代动力学描述符中的95项,并且相对于PLK2/3,对PLK1-PBD表现出更高的结合亲和力。为评估潜在的结构与功能趋同性,基于共享的核心药效团特征及成对Tanimoto相似性系数(ECFP4指纹图谱),将每种配体与已知的PLK1-PBD抑制剂TQ、Poloxin和Allopole-A进行了比较。中等程度的相似性评分(0.36–0.54)以及常见的功能基团,如芳香环或杂芳环、氢键供体/受体对和疏水性连接链,表明其在结合特征上存在部分重叠。请点击此处查看该图的放大版本。
| 工作流程阶段 | 中间检查点(如何确认成功) | 关键步骤(为何该步骤决定成败) | 常见问题 & 故障排除指南 |
| 1. 目标蛋白制备 | • PDB 文件在 Mol* View 中加载无错误。 • 结合口袋中无缺失残基(目视检查)。 • 组氨酸残基标记为“HIS”(而非HSD/HSE) | 错误的蛋白质结构 → 错误的结合口袋 → 误导性的分子对接构象。CHARMM-GUI 可确保正确的质子化状态、氢原子定位,以及水分子/配体的去除。 | 期号:CB-Dock2 拒绝该 PDB 文件。 固定:使用文本编辑器去除非常规残基,确保仅保留蛋白质链,并标准化原子/残基名称。 |
| 2. 天然产物筛选(Lipinski 五规则) | • “all.csv” 仅包含有效的 SMILES(非空、化学上可解析)。 • 计数符合预期(例如,999/1,193)。 | 无效的SMILES字符串会导致RDKit、分子对接服务器和ADMET工具崩溃。过滤过程必须保持化学结构的有效性。 | 期号:聚类过程中脚本失败。 固定:在 Python 中使用 Chem.MolFromSmiles(smiles, sanitize=True) 添加 SMILES 验证;记录并移除无效条目后再继续。 |
| 3. 整群抽样 | • “rep_struct.txt” 中的 50 个独特 SMILES 结构。 • PCA 图(图 2)显示明显的聚类分离。 | 聚类效果差 → 代表序列冗余或缺乏多样性 → 筛选效率低下 | 问题:所有分子聚集为一个组。 修正:验证指纹类型(例如 Morgan/ECFP4)、Tanimoto 阈值和 SMILES 标准化方法。若多样性较低,可考虑增加聚类数量。 |
| 4. 蛋白质-配体对接(CB-Dock2) | • 每种配体返回 ≥1 个“.complex.pdb”文件。 • Vina 评分均为负值(例如,≤ −5 kcal/mol)。 • 配体位于 CurPocket 内(非表面)。 | 对接决定了结合构象和亲和力。错误的构象会导致 PRODIGY 预测结果不准确。 | 期号:任务失败,或配体未对接。 固定:使用 SMILES 在 CB-Dock2 中重新绘制配体;确保文件名中不含特殊字符;核对电子邮件以获取任务状态。若问题持续,可尝试使用 SwissDock 作为备选方案。 |
| 5. 结合亲和力(PRODIGY) | • PRODIGY 返回所有复合物的 ΔG 值。 • 亲和力与 CB-Dock(Vina)评分呈相关性(趋势一致)。 | 选择性评估依赖于PLK1与PLK2/PLK3之间准确的ΔG值。链或配体ID的错误分配将导致预测结果错误。 | 期号“未找到链”错误。 固定:在文本编辑器中打开 .complex.pdb 文件;确认蛋白质链 ID(例如“P”)和配体残基名称(例如“UNL”);在 PRODIGY 中正确输入。 |
| 6. ADMET-S 评估 | • 所有50个SMILES均在SwissADME、ADMETlab3.0和ToxTree中返回结果。 • 输出的 CSV 文件中不含“N/A”或“Error”行。 | ADMET 数据不一致 → 候选化合物排序错误。现有平台可能在罕见天然产物骨架上表现不佳。 | 期号ADMETlab3.0 不接受 SMILES 格式。 固定:使用 RDKit 进行 SMILES 标准化(MolToSmiles(MolFromSmiles(...)))。对于 ToxTree,每次输入一个分子,并验证结构渲染。 |
| 7. 量子稳定性(ORCA) | • 每个ORCA任务均顺利完成,未出现“SCF未收敛”或“几何结构错误”。 • 输出(.out)文件中包含HOMO/LUMO值。 | 带隙决定化学稳定性/反应性。失败的计算任务 = 关键筛选条件缺失数据。 | 期号ORCA 作业崩溃。解决方法:在 Avogadro 中重新优化几何结构;确保无重复原子;增大 %maxcore 参数,或对大分子改用 def2-SVP 基组。 |
| 8. 整合的ADMET-S筛选 | • 最终的配体列表满足所有标准(例如,LogP 为 0–3,带隙为 3.6–5 eV,Cramer 分类为 I/II 类)。 • ≥1 种配体显示出对 PLK1 的选择性(与 PLK2/3 相比,ΔΔG ≥ 2 kcal/mol)。 | 过于严格或不一致的阈值会排除可行的候选化合物;而过于宽松的阈值则会使有毒或不稳定的化合物进入后续阶段。 | 期号:无配体通过所有筛选条件。 修正:依次放宽单一标准(例如,允许 LogP ≤ 4 或含 3 个毒理警示结构),并记录相应的权衡。与已知药物进行比较,以实现基准对照。 |
表1:针对识别选择性PLK1-PBD抑制剂的八阶段双语计算工作流程中的关键质量控制节点、高影响力决策点及故障排除策略。每一行对应从蛋白质准备到整合ADMET-S筛选的一个主要实验阶段,并具体说明:(i) 如何验证该步骤成功完成(中间检查点),(ii) 该步骤对整体成功或失败的关键作用(关键步骤依据),以及 (iii) 常见技术故障的实用解决方案(故障排除指导)。本表既可作为验证路线图,也可作为在学术环境或资源有限条件下实施该方案的学生和研究人员的教学辅助工具。
补充文件 1: Python 脚本。包含用于 Lipinski 规则应用的 Python 脚本;用于聚类分析的 Python 脚本;用于理化性质计算的 Python 脚本;用于代谢分析的 R 脚本;用于排泄分析的 Python 脚本;用于毒性预测的 Python 脚本;用于稳定性评估的 Python 脚本;以及 50 种分析化合物的 SMILES 字符串。请点击此处下载该文件。
讨论
本研究聚焦于一种探索性计算工作流程,通过虚拟筛选、分子对接和ADMET-S分析来鉴定和评估潜在的PLK1-PBD抑制剂。该流程能够根据预测的结合趋势和药代动力学特性有效优先排序化合物。在本方案中,鉴定出一组可能的PLK1抑制剂,并评估其对PLK1–3蛋白的ADMET性质和结合亲和力。该方案采用以疾病为导向的方法,从包含约73,400个化合物的数据库中筛选出50个分子(图9)。随后对这50个分子进行ADMET-S评估,计算其药代动力学和药效动力学特性、类药性以及稳定性。此外,还计算了这些分子对PLK1–3蛋白的结合亲和力,以评估其对PLK1的抑制效力及选择性。根据结果,若干分子表现出更理想的性质。后续药物发现研究可选择淘汰部分分子并重点研究其中少数候选物,或暂不进行早期淘汰,而在药物设计过程中后期利用这些结果优化ADMET性质。
聚焦于PLK1、PLK2和PLK3而排除PLK4与PLK5的生物学依据源于结构与功能两方面的考量。由于PLK4和PLK5在结构和功能上与PLK1存在显著差异,且其在癌症治疗中的相关性有限,因此未被纳入本研究。PLK1具有激酶结构域和Polo-box结构域(PBD),在调控有丝分裂事件中发挥关键作用,是癌症治疗的重要靶点41。相比之下,PLK4和PLK5在结构上具有明显差异:PLK4含有隐匿型Polo-box(CPB)而非经典的PBD,主要参与中心粒复制;而PLK5缺乏功能性激酶结构域,几乎仅在脑组织中表达3。鉴于它们与PLK1-PBD的结构相似性极低,且在癌症相关的有丝分裂失调中作用有限,纳入PLK4和PLK5将无法为PLK1-PBD抑制剂的选择性评估提供有意义的信息。因此,该筛选策略为评估选择性提供了具有生物学相关性和计算可行性的框架。值得注意的是,六个最优候选配体(10、13、14、32、43和47)表现出比已知抑制剂TQ和Allopole-A更优异的结合能及ADMET-S特性,提示其作为潜在PLK1-PBD调节剂的价值。
为支持稳健实施,特别是帮助初次接触计算药物发现工具的学生或研究人员,本文提供了关键检查点(亦见“实验方案”部分)、关键步骤及工作流程故障排除指南的总结,详见表1。该表格增强了流程的适应性;例如,若用户无法访问高性能计算(HPC)资源,可暂缓进行ORCA稳定性分析;若某网络服务器不可用,则建议使用SwissDock等替代方案。这种灵活性确保了该工作流程在不同机构环境中仍具可行性,同时保持科学严谨性,并凸显本研究作为一项包容性、双语化、面向教育的早期药物发现贡献的新颖性。尽管整个工作流程被设计为一个集成化流程,但若干关键步骤从根本上决定了其成败(见表1)。此外,配套视频配有同步英文字幕及美国手语(ASL)手语翻译员,旨在提供无障碍且不分散注意力的学习体验。手语翻译员的指令与屏幕操作在时间上精确同步,例如,先打出“下一步”手势,随后暂停,等待光标点击“Next”按钮。在4HCO准备步骤中,手语翻译员使用手指标注(“A”和“B”)引导链的选择,屏幕录制内容亦精确对应此操作。在SuperNatural 3.0筛选片段中,手语翻译员的窗口会调整大小并移至右上方,同时引导观众注意“pathway”图标,并在光标执行操作时暂停。这些设计选择确保聋人及听力障碍观众能够获得与听力正常的使用者相同的集成化、实时指导,有效复现了面对面、由教师指导的实验教学体验。
除了上述优势外,还有多种方法可以改进工作流程。首先,初始筛选步骤可以进行优化;除了以疾病为导向和聚类抽样的方法外,还可以从对天然产物数据库中所有分子进行对接模拟开始,以确定哪些化合物最适合与靶标蛋白结合。此外,为了准确预测结合亲和力,还需要更精确的估算方法。 PRODIGY 用于计算蛋白-配体亲和力的“无静电”方法,是将相互作用中各类原子接触数(如碳-碳、氮-氮、氧-氧及其他原子)代入一个经过训练的多重线性回归模型中,并采用四重交叉验证进行拟合,该方法在多次研究中均与实验测得的亲和力数据表现出显著相关性42,43。 其他可选方法包括 FoldX44、fastDRH45、深度学习模型46以及结合高级采样技术的分子动力学模拟(MD),这些方法在预测结果上可能表现出不同程度的一致性,具体取决于各方法本身的准确性47。
另一个方面是,ADMET-S 评估中使用的各种软件工具会产生大量指标,而理解用于评估药物候选资格的每个指标至关重要。确保准确性的方法之一是将多种上市药物应用于该方案,以确定它们如何达到各项阈值。 在此背景下,毒性仍需进一步研究,因为分子不会仅基于如 Cramer 规则等复杂决策树得出的毒性谱型而被直接淘汰,许多现有可用的药物具有类似的分类。 即使结合毒性谱型分析,毒理警示结构(toxicophores)的数量也并不能完全反映毒性。 在此情况下,该工作流程的一个延伸方向是将小分子样品与现有药物进行对比分析,以辅助结果解读。 例如,研究人员在解释由量子力学(QM)计算得出的 HOMO–LUMO 能隙值所反映的稳定性时,参考了以往文献中关于 DFT 计算在当前乳腺癌药物(如 Tamoxifen48、Letrozole49 和 Cisplatin50)中的应用与观察结果。此前,类似的工作流程已被用于识别针对多种疾病/障碍靶点的潜在抑制剂51。最近,Stafford 等人6综述了针对 PLK1-PBD 的抑制剂设计策略及其在癌症治疗中的应用前景。最新的研究通过基于结构的药效团建模、虚拟筛选、分子对接、分子动力学(MD)模拟及生物学评价,识别出可同时靶向 PLK1-PBD 和 PLK4-PB3 的双靶点抑制剂52。Zhou 等人还利用 3D QSAR 药效团模型、ADMET 分析、骨架跃迁、分子对接和分子动力学(MD)方法,从海洋天然产物库中筛选出 PLK1-PBD 抑制剂53。
总体而言,本研究的新颖性体现在以下四个方面。第一,本研究采用双语计算方案,以美国手语和英语同时呈现,从而提升STEM领域(尤其是聋人和听力障碍学生与研究人员)的可及性与包容性。这种双语呈现方式在计算药物发现领域极为罕见,且符合加劳德特大学推动公平科学教育的使命。第二,尽管PLK1仍是一个极具吸引力的抗癌靶点,但目前尚缺乏利用整合的结构、能量及ADMET-S标准对PLK1、PLK2和PLK3进行选择性评估的严谨计算研究。以往大多数研究仅聚焦于激酶结构域的抑制作用,或缺乏比较性选择性分析。本研究通过提供一种针对三种PLK-PBD的初步探索性并行筛选方案,填补了这一空白,该方案采用筛选机制,优先选择对PLK1具有高亲和力且脱靶结合最小的化合物。第三,该工作流程在设计时充分考虑了效率与易用性,尤其适用于教学环境及资源有限的场景。整个流程从数据库筛选到ADMET-S评估均可在标准学术硬件(配备8 GB内存的笔记本电脑)上于两周内完成,所用软件均为免费的网络工具(CB-Dock2、PRODIGY、SwissADME、ADMETlab)。分子对接与结合亲和力计算耗时较短(每个配体约30秒)。最耗时的步骤是使用ORCA进行的量子力学(QM)稳定性分析,但该步骤可延后至后续阶段执行,或在高性能计算资源上运行,如文中所示。相关脚本具有模块化特点,仅需进行基本的命令行或Jupyter Notebook编辑,便于无缝整合至现有课程体系。运行时间适中:数据库筛选与Lipinski规则符合性检查仅需数分钟;在普通台式机上对约1,000个分子进行聚类耗时不到30分钟。所有软件工具均可免费用于学术用途,支持跨平台(Windows、macOS、Linux),且无需商业许可,显著降低了使用门槛。第四,所鉴定出的配体表现出与纳摩尔级相互作用一致的优良结合亲和力,同时具备理想的类药性、代谢稳定性及低毒性特征。多个候选化合物展现出对PLK1-PBD强效且特异的结合能力,并具有优良的ADMET-S性质,值得进一步验证。 通过 分子动力学模拟或 体外 检测方法
因此,除了其方法学上的实用性之外,本研究还展示了如何利用易于获取、开源且高效的计算工具作为起点,来应对高价值的生物医学挑战,同时促进包容性的科学培训。随着PLK1-PBD抑制剂在肿瘤学领域不断获得关注,该工作流程为早期药物发现提供了一个可重复且适合教学的蓝图。其灵活性使其适用于高中、本科及研究生阶段的教学环境,并为课程整合科研项目(CUREs)提供了良好基础,使学生能够获得真实且动手参与的研究机会。与仅依赖激酶结构域对接或单一蛋白筛选的流程不同,该方法能够同时评估PBD在PLK1–3之间的选择性,这一点至关重要,因为这三种蛋白具有超过>38%的结构同源性,却发挥着不同的生物学功能。此外,通过在开放获取框架中整合聚类分析、ADMET-S预测和量子力学(QM)稳定性评估,相较于暴力虚拟筛选,该方法降低了冗余性并减少了候选化合物的淘汰风险。
披露
作者声明无竞争利益。
致谢
本研究获得了美国国立普通医学科学研究所、美国国立卫生研究院(1R15GM148942-01)、国家医学图书馆(R25LM014208)以及匹兹堡大学动量奖(Momentum Grant)的资助。本研究工作使用了特拉华大学的 DARWIN 平台(darwin.hpc.udel.edu),计算资源由先进网络基础设施协调生态系统:服务项目分配编号 [MED230016] 提供 & 支持(ACCESS)项目,由美国国家科学基金会资助,项目编号为 #2138259、#2138286、#2138307、#2137603 和 #2138296。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| ADMETLab3 | Simulations Plus. Inc | V3.0 | ADMET性质 |
| Alphafold | Google DeepMind & Isomorphic Labs (Alphabet子公司) | V3.0.1 | 三维蛋白质建模 |
| Anaconda/Conda | Anaconda, Inc. | V24.9.2 | 开源包管理系统 |
| CB-Dock2 | Yang Cao实验室 | V2.0 | 蛋白质-配体盲对接 |
| CHARMM-GUI | 理海大学 | V3.8 | 生物分子操作与模拟 |
| DARWIN on ACCESS | 特拉华大学 | N/A | 高性能计算 |
| ORCA | FAccTs GmbH | V6.1.0 | 量子化学计算软件包 |
| Protein Data Bank | 全球蛋白质数据库 | RRID:SCR_006555 | 蛋白质数据库 |
| RDKit | 开源 | RRID:SCR_014274 | 化学信息学编程 |
| SuperNatural 3.0 | 柏林生理学与科学信息技术研究所 | V3.0 | 天然分子库 |
| SwissADME | 瑞士生物信息学研究所 | RRID:SCR_017865 | ADME性质 |
| Toxtree | Ideaconsult有限公司 | V3.1.0 | 毒性分类 |
参考文献
- Eckerdt, F., Yuan, J., Strebhardt, K. Polo-like kinases and oncogenesis. Oncogene. 24 (2), 267-276 (2005).
- Dube, D. Polo-like kinases: An antimitotic drug target for cancer therapy. Protein Kinase Inhib. 2022, 457-477 (2022).
- de Cárcer, G., Manning, G., Malumbres, M. From PLK1 to PLK5: Functional evolution of polo-like kinases. Cell Cycle. 10 (14), 2255-2262 (2011).
- Lee, S. Y., Jang, C., Lee, K. A. Polo-like kinases (Plks), a key regulator of cell cycle and new potential target for cancer therapy. Dev Reprod. 18 (1), 65-71 (2014).
- Park, J. E., Hymel, D., Burke, T. R. Jr, Lee, K. S. Current progress and future perspectives in the development of anti-polo-like kinase 1 therapeutic agents. F1000Res. 6, 1024(2017).
- Stafford, J. M., Wyatt, M. D., McInnes, C. Inhibitors of the PLK1 polo-box domain: Drug design strategies and therapeutic opportunities in cancer. Expert Opin Drug Discov. 18 (1), 65-81 (2023).
- Feng, Y. B., et al. Overexpression of PLK1 is associated with poor survival by inhibiting apoptosis via enhancement of survivin level in esophageal squamous cell carcinoma. Int J Cancer. 124 (3), 578-588 (2009).
- Gutteridge, R. E. A., Ndiaye, M. A., Liu, X., Ahmad, N. PLK1 inhibitors in cancer therapy: From laboratory to clinics. Mol Cancer Ther. 15 (7), 1427-1435 (2016).
- Steegmaier, M., et al. BI 2536, a potent and selective inhibitor of polo-like kinase 1, inhibits tumor growth in vivo. Curr Biol. 17 (4), 316-322 (2007).
- Vanden Bossche, J., et al. Spotlight on volasertib: preclinical and clinical evaluation of a promising PLK1 inhibitor. Med Res Rev. 36 (4), 749-786 (2016).
- Yin, Z., Song, Y., Rehse, P. H. Thymoquinone blocks pSer/pThr recognition by PLK1 polo-box domain as a phosphate mimic. ACS Chem Biol. 8 (2), 303-308 (2013).
- Reindl, W., Yuan, J., Krämer, A., Strebhardt, K., Berg, T. Inhibition of polo-like kinase 1 by blocking polo-box domain-dependent protein-protein interactions. Chem Biol. 15 (5), 459-466 (2008).
- Scharow, A., et al. Optimized PLK1 PBD inhibitors based on poloxin induce mitotic arrest and apoptosis in tumor cells. ACS Chem Biol. 10 (11), 2570-2579 (2015).
- Reindl, W., Yuan, J., Krämer, A., Strebhardt, K., Berg, T. A pan-specific inhibitor of the polo-box domains of polo-like kinases arrests cancer cells in mitosis. ChemBioChem. 10 (7), 1145-1148 (2009).
- Park, J. E., et al. Specific inhibition of an anticancer target, polo-like kinase 1, by allosterically dismantling its mechanism of substrate recognition. Proc Natl Acad Sci U S A. 120 (35), e2305037120(2023).
- Archambault, V., Normandin, K. Several inhibitors of the PLK1 polo-box domain turn out to be non-specific protein alkylators. Cell Cycle. 16 (12), 1220-1224 (2017).
- Jo, S., Kim, T., Iyer, V. G., Im, W. CHARMM-GUI: A web-based graphical user interface for CHARMM. J Comput Chem. 29 (11), 1859-1865 (2008).
- Park, S. J., Kern, N., Brown, T., Lee, J., Im, W. CHARMM-GUI PDB manipulator: Various PDB structural modifications for biomolecular modeling and simulation. J Mol Biol. 435 (14), 167995(2023).
- Kim, J. H., Ku, B., Lee, K. S., Kim, S. J. Structural analysis of the polo-box domain of human polo-like kinase 2. Proteins. 83 (7), 1201-1208 (2015).
- Jumper, J., et al. Highly accurate protein structure prediction with AlphaFold. Nature. 596 (7873), 583-589 (2021).
- UniProt Consortium. UniProt: The universal protein knowledgebase in 2023. Nucleic Acids Res. 51 (D1), D523-D531 (2023).
- Gallo, K., et al. SuperNatural 3.0—A database of natural products and natural product-based derivatives. Nucleic Acids Res. 51 (D1), D654-D659 (2023).
- Du, J., et al. KEGG-PATH: Kyoto encyclopedia of genes and genomes-based pathway analysis using a path analysis model. Mol Biosyst. 10 (9), 2441-2447 (2014).
- Bento, A. P., et al. An open source chemical structure curation pipeline using RDKit. J Cheminform. 12 (1), 51(2020).
- Chung, N. C., Miasojedow, B., Startek, M., Gambin, A. Jaccard/Tanimoto similarity test and estimation methods for biological presence-absence data. BMC Bioinformatics. 20 (Suppl 15), 644(2019).
- Liu, Y., et al. CB-Dock2: Improved protein–ligand blind docking by integrating cavity detection, docking and homologous template fitting. Nucleic Acids Res. 50 (W1), W159-W164 (2022).
- Vangone, A., et al. Large-scale prediction of binding affinity in protein–small ligand complexes: the PRODIGY-LIG web server. Bioinformatics. 35 (9), 1585-1587 (2019).
- Fu, L., et al. ADMETlab 3.0: An updated comprehensive online ADMET prediction platform enhanced with broader coverage, improved performance, API functionality and decision support. Nucleic Acids Res. 52 (W1), W422-W431 (2024).
- Daina, A., Michielin, O., Zoete, V. SwissADME: A free web tool to evaluate pharmacokinetics, drug-likeness and medicinal chemistry friendliness of small molecules. Sci Rep. 7 (1), 1-13 (2017).
- Patlewicz, G., Jeliazkova, N., Safford, R., Worth, A., Aleksiev, B. An evaluation of the implementation of the Cramer classification scheme in the Toxtree software. SAR QSAR Environ Res. 19 (5-6), 495-524 (2008).
- Neese, F. Software update: The ORCA program system—version 5.0. Wiley Interdiscip Rev Comput Mol Sci. 12 (5), e1606(2022).
- Daina, A., Zoete, V. A BOILED-Egg to predict gastrointestinal absorption and brain penetration of small molecules. ChemMedChem. 11 (11), 1117-1121 (2016).
- Sehnal, D., et al. Mol* Viewer: Modern web app for 3D visualization and analysis of large biomolecular structures. Nucleic Acids Res. 49 (W1), W431-W437 (2021).
- Liu, Y., Cao, Y. Protein–ligand blind docking using CB-Dock2. Comput Drug Discov Des. 2023, 113-125 (2023).
- Manallack, D. T. The pKa distribution of drugs: application to drug discovery. Perspect Med Chem. 1, 25-38 (2007).
- Manallack, D. T., Prankerd, R. J., Yuriev, E., Oprea, T. I., Chalmers, D. K. The significance of acid/base properties in drug discovery. Chem Soc Rev. 42 (2), 485-496 (2013).
- Charifson, P. S., Walters, W. P. Acidic and basic drugs in medicinal chemistry: A perspective. J Med Chem. 57 (23), 9701-9717 (2014).
- Wildman, S. A., Crippen, G. M. Prediction of physicochemical parameters by atomic contributions. J Chem Inf Comput Sci. 39 (5), 868-873 (1999).
- Pasha, T., et al. Therapeutic importance of biological half-life of antineoplastic agents – A review. Adv Pharmacol Pharm. 10, 265-272 (2022).
- Smith, D. A., Beaumont, K., Maurer, T. S., Di, L. Relevance of half-life in drug design. J Med Chem. 61 (10), 4273-4282 (2018).
- Sharma, P., et al. A cryptic hydrophobic pocket in the polo-box domain of the polo-like kinase PLK1 regulates substrate recognition and mitotic chromosome segregation. Sci Rep. 9 (1), 1-15 (2019).
- Kurkcuoglu, Z., et al. Performance of HADDOCK and a simple contact-based protein–ligand binding affinity predictor in the D3R Grand Challenge 2. J Comput Aided Mol Des. 32 (1), 175-185 (2018).
- Gaieb, Z., et al. D3R Grand Challenge 2: Blind prediction of protein–ligand poses, affinity rankings, and relative binding free energies. J Comput Aided Mol Des. 32 (1), 1-20 (2018).
- Delgado, J., Radusky, L. G., Cianferoni, D., Serrano, L. FoldX 5.0: Working with RNA, small molecules and a new graphical interface. Bioinformatics. 35 (20), 4168-4169 (2019).
- Wang, Z., et al. fastDRH: A webserver to predict and analyze protein–ligand complexes based on molecular docking and MM/PB (GB) SA computation. Brief Bioinform. 23 (5), bbac201(2022).
- Wang, H., Liu, H., Ning, S., Zeng, C., Zhao, Y. DLSSAffinity: Protein–ligand binding affinity prediction via a deep learning model. Phys Chem Chem Phys. 24 (17), 10124-10133 (2022).
- Schöning-Stierand, K., et al. Proteins Plus: A comprehensive collection of web-based molecular modeling tools. Nucleic Acids Res. 50 (W1), W611-W615 (2022).
- Flores-Holguín, N., Glossman-Mitnik, D. CDFT-based chemical reactivity properties analysis of the fluorine substitution in the selective estrogen receptor modulator (SERM) tamoxifen. Theor Chem Acc. 142 (8), 79(2023).
- Akçay, H. T., Bayrak, R. Computational studies on the anastrozole and letrozole, effective chemotherapy drugs against breast cancer. Spectrochim Acta A Mol Biomol Spectrosc. 122, 142-152 (2014).
- Georgieva, I., Trendafilova, N., Dodoff, N., Kovacheva, D. DFT study of the molecular and crystal structure and vibrational analysis of cisplatin. Spectrochim Acta A Mol Biomol Spectrosc. 176, 58-66 (2017).
- Lawal, M. M., Kucukkal, T. G. Evaluation of small molecule binding to the polo-box domain of PLK1 at the molecular level. J Comput Biophys Chem. 25 (5), 751-768 (2026).
- Zhao, C., et al. Discovery of novel dual-targeting inhibitors against PLK1-PBD and PLK4-PB3: structure-guided pharmacophore modelling, virtual screening, molecular docking, molecular dynamics simulation, and biological evaluation. J Enzyme Inhib Med Chem. 40 (1), 2522810(2025).
- Zhou, N., Zheng, C., Tan, H., Luo, L. Identification of PLK1-PBD inhibitors from the library of marine natural products: 3D QSAR pharmacophore, ADMET, scaffold hopping, molecular docking, and molecular dynamics study. Mar Drugs. 22 (2), 83(2024).
重印与许可
