本研究探讨了来自多种药用植物基因组中参与或预测参与三维结构域交换的蛋白质。通过采用机器学习模型,准确预测三维结构域交换蛋白,并预测其功能及其在次生代谢物生成中的相关性。
需要JoVE订阅才能观看此内容。 请登录或开始免费试用
本文内容
摘要
摘要
3D 结构域互换是一种蛋白质结构现象,其中两个或多个蛋白质亚基交换相同的结构亚基并形成寡聚体。表现出 3D 结构域互换的蛋白质在多种生物学功能中发挥关键作用,例如药用植物中的次生代谢物生物合成,以及应对多种生物和非生物胁迫。本研究探讨了利用随机森林和 K-最近邻分类器模型预测药用植物基因组中 3D 结构域互换模式的能力,其准确率分别为 91.6% 和 88.7%。总共 420 条(31%)序列被预测为可能参与 3D 结构域互换。此外,还对来自多种药用植物的预测 3D 结构域互换蛋白序列进行了富集分析,基于基因本体(GO)术语、京都基因与基因组百科全书(KEGG)通路分析以及其在次生代谢物生物合成通路中的结构域分布进行功能注释。对预测序列的功能注释推断表明,3D 结构域互换序列参与多种分子功能,如光系统 II 中的光合电子传递和电子载体,在光合作用环式电子传递途径中转移电子,氧化磷酸化,以及通过合成次生代谢物(萜类、生物碱和多胺)调控环境胁迫(生物和非生物)相关基因的表达。这些发现强调了机器学习在预测蛋白质参与 3D 结构域互换现象及其相应功能方面的能力,并凸显了其在促进药物发现和生物工程研究中的潜力。
引言
计算方法通过实现对蛋白质结构、功能和相互作用的详细分析与预测,彻底改变了蛋白质研究。精确识别和注释蛋白质功能对于揭示生命分子机制至关重要,并在医学进步和药物开发中具有深远意义。然而,实验方法固有的复杂性和高昂成本限制了其在大规模序列数据中的可扩展性。因此,开发用于蛋白质功能预测的计算方法已成为计算生物学和分子生物学中的一个关键领域,通过创新的大规模方法弥补了这一空白1。
3D 结构域互换2 是蛋白质中的一种结构现象,指共享结构的片段在单个肽链之间发生交换。1994年,关于3D结构域互换机制的首次报道来源于白喉毒素二聚体的研究3。然而,3D结构域互换的基本原理可追溯至四十年前。已观察到牛胰核糖核酸酶A(RNase A)在乙酸中冻干时,通过复杂的化学修饰实验可形成二聚体4。在蛋白质寡聚化过程中,两条或更多蛋白质链通过柔性铰链区交换相同的结构元件。在单体亚基之间交换的蛋白质部分被称为互换结构域,其可能包含一个完整的球状结构域、一个环区,或某些蛋白质中的二级结构元件。相反,在单体中原位置保持不变的区域则称为非互换结构域5。非互换结构域之间的相互作用被称为非互换结构域界面(NSDI),如图1所示。在3D结构域互换中,一个蛋白质亚基的非互换结构域与另一亚基已互换的结构域之间的关系被称为互换结构域界面(SDI)。该现象的另一个重要特征是铰链区,即连接非互换结构域与互换结构域的一段柔性连接片段。铰链区在促进3D结构域互换的运动中发挥关键作用,并作为构象开关,使结构重排成为可能,从而实现结构域的互换。3D结构域互换已被证实参与多种生物学过程,包括蛋白质组装与功能调控5。此外,该现象还与某些蛋白质错误折叠疾病相关,异常的结构域互换可能导致聚集体或淀粉样纤维的形成。
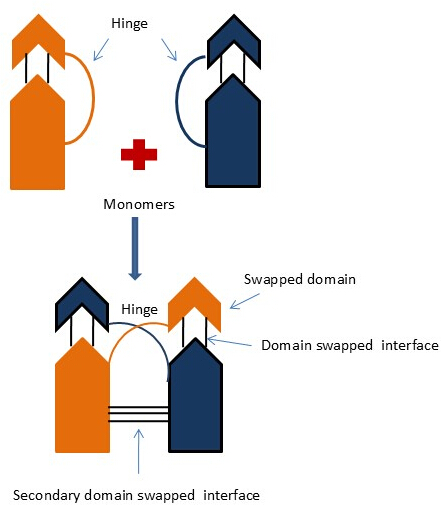
图1:三维结构域交换的结构示意图。 该示意图展示了两个蛋白质单体之间通过一个柔性铰链区交换相同的结构元件,从而形成结构域交换的二聚体或寡聚体组装结构 请点击此处查看此图的放大版本。
根据交换结构域的性质及所形成的寡聚体结构,已鉴定出多种类型的三维结构域交换6。2002年,Eisenberg 及其同事将三维结构域交换分为三种类型:真实结构域交换(BDS)、准结构域交换(QDS)和三维结构域交换候选(CDS)7。其中最常见的蛋白类别为真实结构域交换,其特征是二聚体和单体分子均以稳定形式存在,其中二聚体呈现结构域交换构象,而单体则呈现闭合构象。在准结构域交换中,蛋白以寡聚体形式存在,但其同源蛋白已知以单体形式存在。在三维结构域交换候选类别中,仅确认蛋白属于结构域交换分类,但缺乏相关单体或其单体同源物的结构信息8。在此类情况中,不存在单体或其单体同源物,而是存在异源蛋白分子。表1列出了这三类别的示例9。
表1:3D结构域交换的类型及示例。 请点击此处下载该表格。
后续研究揭示了大量发生结构域交换的蛋白质结构,为理解三维结构域交换(3D domain swapping)的概念奠定了基础。最早支持这一现象的结构证据来自λ噬菌体Cro阻遏蛋白分子,该蛋白通过其C末端链段的交换形成二聚体结构。1996年,研究人员发现单体形式的Cro蛋白可参与三维结构域交换10。其他一些结构11,如βB2-晶状体蛋白12、人源CksHs2蛋白13、牛肝过氧化氢酶14以及重组人白细胞介素-515,也被报道可能具有三维结构域交换结构。根据蛋白质分子中发生交换的结构域位置,三维结构域交换可分为三类:C末端结构域交换、N末端结构域交换以及相对少见的中央结构域交换。有研究者利用完整的人类基因组预测结构域交换案例,采用随机森林(Random Forest)和支持向量机(Support Vector Machine)作为二分类器,其预测准确率分别为81.7%和73.9%。在人类基因组中,近44%的蛋白质序列被预测为可能具有三维结构域交换特征6。对预测结果进行了富集分析,内容包括结构域分布、疾病相关性分布以及基于基因本体(Gene Ontology, GO)的功能注释。另一种方法则采用随机森林算法对全基因组范围内的Ocimum tenuiflorum进行分析,发现该植物中约25%的蛋白质序列被预测参与三维结构域交换。研究人员还通过GO术语关联及其蛋白质结构域家族关联进行功能注释,发现仅有1158条序列与非生物胁迫相关16。
植物表现出多种独特的蛋白质家族,其中某些特定蛋白质被证实能够发生结构重排,包括三维结构域交换。三维结构域交换可能通过产生次生代谢物或其他具有多种药理学应用的生物学相关通路,影响生物和非生物胁迫条件;因此,这些蛋白质成为本研究的重要关注点。Wal1 的晶体结构显示了一种结构域交换的二聚体构型,其不对称单元中含有两个二聚体,并呈现出与半胱氨酸蛋白酶抑制剂 C 相似的结构重排。植物半胱氨酸蛋白酶抑制剂在非生物胁迫中发挥重要作用,同时还能提高作物抗性。根据现有文献及多个相关数据库的资料,已鉴定出共计 20,121 种预测存在三维结构域交换的蛋白质,其中 17,552 种来源于植物,2,569 种来源于非植物生物17,18。
文献中已报道了多种利用机器学习方法预测不同植物中三维结构域互换(3D domain swapping)的实例。例如 拟南芥 显示33.7%(12,033条已审阅序列中的4,058条), Medicago truncatula 20.9%(186条审阅序列中的39条) Solanum tuberosum 36.5%(400条被审阅序列中的146条) Solanum lycopersicum 25.5%(423 条被审阅序列中的 108 条),以及 Ocimum tenuiflorum 15.5%(36841 条审阅序列中的 5706 条)6计算方法在探索三维结构域交换蛋白的结构与功能特征方面已变得不可或缺。这些方法通过基于最优特征的序列预测、注释及富集分析,有助于揭示其基本的分子机制。针对多种蛋白质序列中三维结构域交换的预测,采用基于支持向量机(SVM)的分类器实现。该方法通过整合序列与结构特征而建立,在训练数据集上的预测准确率达到76.33%,在测试数据集上达到73.81%,表明其在识别蛋白质结构域交换倾向方面具有潜在应用价值20选择KNN而非SVM的主要原因是KNN的训练过程要简单得多。KNN只需设置一个主要参数K(即在进行预测时所考虑的最近邻样本数量),而SVM则需要仔细调整多个参数,如核函数类型、C和gamma。此外,KNN能更简便地处理多分类问题,而SVM通常需要采用更复杂的策略,例如一对一策略。
用于蛋白质结构预测的机器学习
蛋白质结构的预测涉及从其 FASTA 序列推断出蛋白质的三维构象。该领域的最新进展在很大程度上得益于将多种机器学习技术应用于进化数据21,22。早期从共进化数据中提取信息的方法依赖于机器学习技术。然而,最近的策略,特别是利用深度残差网络的方法,在预测潜在目标方面表现出更优越的性能23。Alphafold 是一种基于深度学习的数据库,而 Rosetta 是一种基于物理能量函数的工具。这些工具可用于预测可逼近实验结构的完整三维原子结构。它们仅提供原子分辨率的结构坐标,但无法识别三维结构域交换事件。相比之下,本文提出的方法并非完整的三维结构预测工具,而是仅预测某种蛋白质是否可能发生三维结构域交换24,25。
药用植物作为预防和治疗多种疾病的天然资源,已有数个世纪的使用历史,这归因于其含有的生物活性化合物。它们在传统医学中具有重要作用,并促进了现代药物的研发。然而,在药用植物蛋白质三维结构域交换用于药物发现的研究领域,目前尚无显著工作开展。包括机器学习及其集成模型在内的算法,能够识别序列数据中的模式与关系,从而预测蛋白质的三维结构域交换。本研究选择药用植物的原因在于,可通过分析植物中参与三维结构域交换的蛋白质,揭示其功能多样性,进而理解植物在应激反应、病原体防御以及代谢物生物合成中的分子机制。由于利用核磁共振(NMR)或晶体学技术在大量且复杂的高级寡聚构象中确定蛋白质三维结构域交换存在技术挑战,因此亟需发展先进的计算方法。
本研究工作的总体目标是采用一种计算方法,利用随机森林(Random Forest, RF)26 和 K-最近邻(K-nearest neighbor, KNN)27 算法,开展蛋白质序列结构预测任务,并对多种药用植物序列中的三维结构域交换事件进行全面的全基因组分析。随机森林(RF)是一种二分类器,它是一种强大且通用的机器学习算法,广泛应用于蛋白质序列分析中。该算法通过构建多个决策树(DT)的集成模型进行运算,在训练集和测试集上均能实现较高的预测准确率。在蛋白质序列分析任务中,RF 可分析多种特征,包括理化性质、序列组成、二级结构以及从序列比对或谱图中提取的进化信息。RF 擅长处理大规模且含噪声的数据集,并可提供特征重要性评估指标28。K-最近邻(K-Nearest Neighbors, KNN)分类器是一种简单而有效的机器学习算法,在蛋白质序列分析中被广泛应用。其原理是根据输入序列在特征空间中 k 个最近邻样本的多数类别来判定其分类。在蛋白质序列分析中,KNN 可用于预测功能类别、结构特性以及亚细胞定位。KNN 分类常用的特征包括氨基酸组成、序列模体、进化谱图或理化属性。由于其结构简单、易于解释且效果良好,KNN 成为蛋白质序列分析中一种有价值的工具29。这两种算法相互补充,共同构建了一个全面的计算框架,用于研究多种药用植物序列中的三维结构域交换现象。需要指出的是,这两个模型仅能预测可能发生结构域交换的潜在案例,而无法预测完整的三维结构坐标,也无法确定在交换过程中具体参与的区域或残基。这有待于进一步研究,以识别参与交换的特定区域或残基,从而阐明三维结构域交换事件的机制及其功能意义。三维结构域交换包含多种结构上不同的现象,例如闭环构型、开放末端交换,以及其他差异,如不同的铰链区和结构域架构。鉴于此,本研究所提出的方法将所有类型的三维结构域交换事件归为统一的分类体系。这一选择最初是由于可用于明确标注特定三维结构域交换类别的数据十分有限。这是首次针对多种基于药用植物的数据集所开展的此类尝试,我们认为,若能区分不同的交换机制,将有望提升模型的预测准确性。
对药用植物进行富集分析有助于鉴定参与生物活性化合物合成和应激反应的关键基因、蛋白质及通路,从而揭示其分子机制。这类分析可研究与生物活性物质合成、抗逆性及抗病性相关的重要基因、蛋白质和生物学过程。对选定蛋白质进行功能注释,例如基因本体(GO)和KEGG通路分析,能够揭示次生代谢物生成及环境胁迫响应背后的分子机制。该方法显著促进药物发现,提高作物抗逆能力,并阐明植物代谢通路,推动可持续农业与药用植物研究的发展。
本研究的新颖贡献
本研究强调了机器学习在推动构建更精确、更高效的模型以预测生物数据集中蛋白质结构模式方面的能力。
本研究将新特征整合到机器学习算法中,提高了其更清晰地预测蛋白质功能的能力。这些特征有助于更深入理解蛋白质的结构-功能关系,从而在蛋白质工程中实现更精确的蛋白质设计与优化。
对预测蛋白质进行富集分析有助于发现关键的生物通路、细胞过程和分子功能,为生物标志物发现、药物设计及疾病机制研究提供有价值的靶点。该分析可提高基于通路的干预措施及治疗靶点识别的精确性。
访问受限。请登录或开始试用以查看此内容。
方案
注:本节概述了建议方法学的完整流程,共包括六个主要步骤:(a)数据收集,(b)特征选择,(c)数据预处理,(d)数据后处理,(e)模型构建,(f)所提出模型的结果评估,以及(g)对正向预测序列在不同层次上进行富集分析。本研究工作采用了第10代 Core i5-10500 处理器。该处理器拥有六个核心和12个线程,基础频率为 3.10 GHz,最大睿频可达 4.50 GHz。其配备 12 MB 的 Intel Smart Cache,支持 DDR4-2666 内存,并集成 UHD Graphics 630 以提供图形处理能力。该处理器专为高效多任务处理与生产力设计,兼容 LGA 1200 插槽,热设计功耗(TDP)为 65W。
1. 数据采集
- 使用3d3dswap-pred(https://caps.ncbs.res.in/3dswap-pred/3dswap-pred.html)和3DSwap+(https://caps.ncbs.res.in/3Dswapplus/index.html)30 补充表1、补充表2、补充文件1、补充文件2。共使用573个经人工审校的3D结构域互换分子的PDB条目,主要来源于药用植物。
- 采用最佳代表性谱图(Best Representative Profile, BRP)方法构建负数据集,为每个Pfam31蛋白家族(http://pfam.xfam.org/)分配一个最佳代表性序列(Best Representative Sequence, BRS)。使用HMMER32(https://www.ebi.ac.uk/Tools/hmmer/)以0.001的E值阈值,将总共10,112条结构序列与所有Pfam BRP进行比对。利用DIAL对所得序列进行处理,以识别结构域(https://bioinformaticshome.com/db/tool/DIAL)。将575个PDB条目作为负数据集(训练集)纳入分析。
- 纳入通过BRP方法获得的314条蛋白序列,以及通过3DSwap+鉴定出的261条经人工审校的非3D结构域互换序列,作为负数据集。
- 从UniProt33(https://www.uniprot.org/)获取共计1,355条经审核的来自多种药用植物的蛋白序列条目。本研究共纳入13种药用植物(测试/预测数据集): Citrus sinensis (RS-102), Vitis vinifera (RS-226), Mentha (RS-28), Cannabis sativa (RS-21), Acorus clamus (RS-511), Coffea arabica (RS-104), Papaver somniferum (RS-58), Hibiscus (RS-88), Jasmine (RS-89), Thyme (RS-30), Thymus (RS-14), Illicium oligandrum (RS-72), 和 Citrus limon (RS-12)。系统发育树见补充图1。
2. 使用该功能进行模型创建
- 利用包含453个特征的综合特征集来预测药用植物中的蛋白质序列。该特征集包括439个已建立的特征和16个新特征,这些特征是基于全面的文献综述精心筛选得出的。
- 使用AAindex数据库34(https://www.genome.jp/aaindex/)确定氨基酸的理化性质。应用WEKA35机器学习平台(https://www.waikato.ac.nz/int/research/institutes-centres-entities/institutes/artificial-intelligence-institute/research/software/)进行特征选择。有关新引入的特征,请参见 表2。
表2:新增特征及其描述列表。 该表格总结了在特征提取阶段构建的新颖特征,旨在提升模型在预测三维结构域交换方面的性能。每个特征均捕捉了蛋白质特定的基于序列、理化或结构特性,这些特性被认为可能影响其发生结构域交换的倾向性。文中提供了详细描述,以阐明各特征的生物学意义及其计算推导方法。请点击此处下载该表格。
3. 数据预处理与后处理
注意:数据预处理。数据预处理是机器学习中一个关键的步骤,涉及为分析准备原始数据。这包括对数据进行清洗(例如,去除重复项、处理缺失值等)。
- 使用补充编码文件1将分类变量编码为数值形式,该文件包含四个主要步骤:(1)定义评分字典,(2)通过seq I0. parse处理fasta序列,(3)创建数据框,(4)对三维结构域交换特征进行数值分析。
- 通过数据后处理优化并解释模型输出。重新校准预测结果,汇总分析结果,并应用分类阈值。根据先前研究支持36,37,38,使用阈值β = 0.5(范围0-1)对双峰三维结构域交换数据集进行分类。
- 以70:30的训练-测试划分比例分割数据集,其中70%用于模型训练,30%用于独立评估。
- 采用标准缩放器(Standard Scaler)方法对训练数据进行标准化处理,使各特征值均值为0、标准差为1,以提高与机器学习估计器的兼容性。进行特征选择以识别最具影响的变量。
注意:数据标准化是许多机器学习算法广泛采用的预处理步骤,以确保最佳性能。偏离正态分布的数据可能对机器学习模型的性能产生负面影响39。 - 进行验证。为确保模型评估的稳健性和无偏性,还实施了K折交叉验证,详见补充表3。
- 将数据集划分为K个子集。在K=5个子集上迭代训练和评估模型,同时使用剩余子集进行独立测试。
4. 模型的建立与实施
- 实施并精细调整随机森林(Random Forest, RF)和 K-最近邻(K-Nearest Neighbors, KNN)算法,以优化预测性能。使用 573 和 575 条蛋白质序列进行模型训练、验证,使用 1,355 条蛋白质序列进行测试。
- 使用 Python 脚本 (Supplementary Coding File 1) 基于选定的蛋白质序列提取数值特征值。将这两个数据集的数值保存为 CSV 文件,并提交至 RF 和 KNN 分类器以生成二分类模型。
- 利用这些模型区分发生三维结构域交换与未发生三维结构域交换的蛋白质。参见 图 2 和 图 3 中用于预测三维结构域交换的通用框架。
- 为 RF 模型设置超参数:n_estimators=20,max_depth=4,random_state=42。
- 为 KNN 分类器模型设置超参数:neighbors=5。
注意:这些参数设置经过精细调优,旨在提升模型在人工整理的药用植物数据集上的性能。
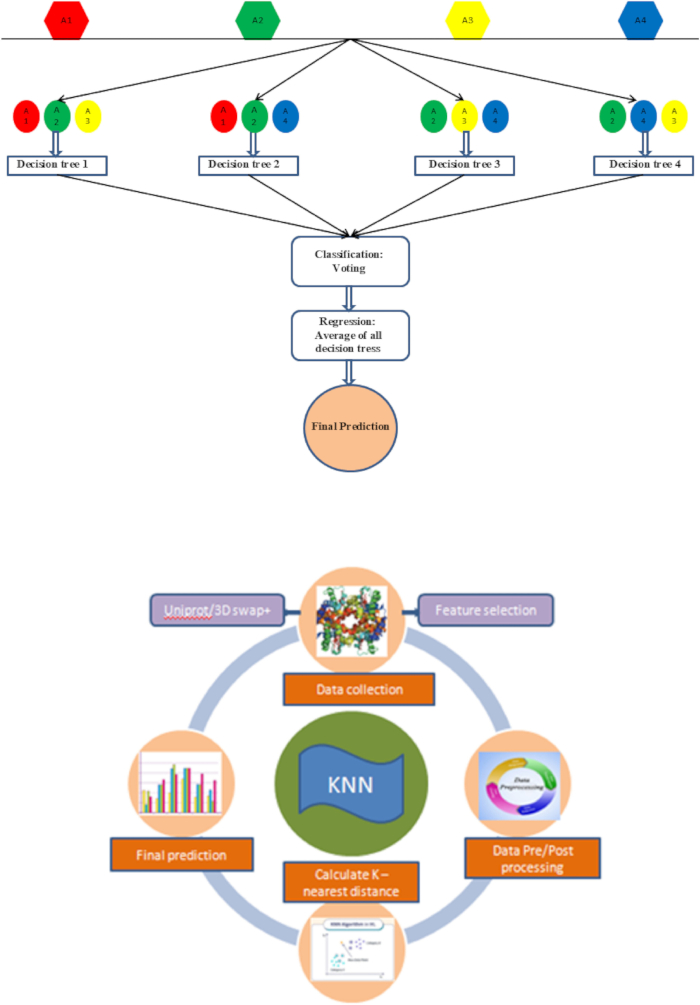
图2:图示性示意图。 图示显示 随机森林与K近邻(KNN)机器学习模型,展示其在二分类任务背景下的算法结构与功能工作流程 请点击此处以查看此图的放大版本。
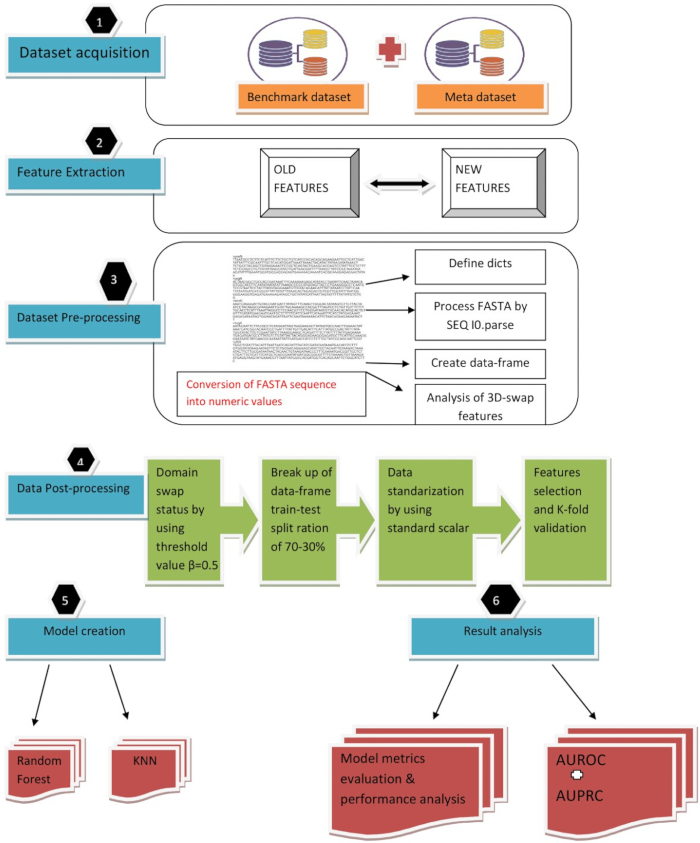
图3:基于机器学习的工作流程。该示意图展示了一种基于机器学习的流程,用于预测药用植物蛋白中的三维结构域交换。该流程首先通过整合基准数据集和元数据集获取数据集。特征提取阶段从蛋白质序列中提取已有特征和新特征。在数据集预处理阶段,通过序列解析和字典映射将FASTA序列转换为数值,以构建结构化数据框,其中包括特定的三维结构域交换特征。后处理阶段包括使用阈值(β = 0.5)分配结构域交换状态、将数据按70-30比例划分为训练集和测试集、对特征进行标准化,以及通过k折交叉验证进行特征选择。训练了两种机器学习模型——随机森林(RF)和K近邻(KNN),并利用模型评估指标以及AUROC和AUPRC来评估其预测准确性与稳健性请点击此处查看该图的放大版本。
5. 机器学习分类器的静态评估与模型评价
- 实施并优化随机森林(RF)和K近邻(KNN)算法以提升预测性能。使用573和575条蛋白质序列进行模型训练、验证,使用1,355条蛋白质序列进行测试。
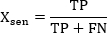 (1)
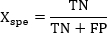 (2)
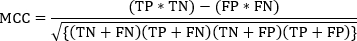 (3)
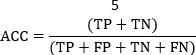 (4)
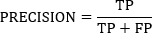 (5)
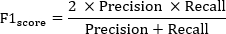 (6)
注:将真阳性(TP)定义为模型正确预测为发生结构域交换的序列所占的百分比;将真阴性(TN)定义为模型正确预测为未发生结构域交换的序列所占的百分比;将假阳性(FP)定义为未发生结构域交换的蛋白质被错误预测为发生结构域交换的情况;将假阴性(FN)定义为发生结构域交换的蛋白质被错误预测为未发生结构域交换的情况。 - 计算 X老年 准确识别出的真阳性比例,以及 Xspe 作为模型正确识别的真阴性比例。
注意:使用马修斯相关系数(MCC)通过分析混淆矩阵中的真阳性、真阴性、假阳性和假阴性来评估二分类的质量。 - 计算准确率(ACC),以衡量总预测中正确预测所占的比例。
注:精确率(Precision)衡量的是在所有预测为阳性的结果中正确识别出的阳性所占的比例,而F1分数(F1-score)是精确率与灵敏度(Sensitivity)的调和平均值,用于平衡假阳性与假阴性。 - 使用 AUC 评估二分类任务中分类模型的性能。使用 Scikit-learn Python 库计算 AUC(曲线下面积)40基于被分类为阳性与阴性的蛋白质。
- 使用测试数据评估这些参数。
6. 多种药用植物物种三维结构域交换预测模型的实施
- 在13种不同药用植物(包括 Citrus sinensis, Mentha, Vitis vinifera, Thyme, Thymus vulgaris, Jasmine, Hibiscus, Papaver somniferum, Illicium oligandrum, Citrus limon, Acorus calamus, Cannabis sativa, 和 Coffea arabica)的共计1,355条经过审阅的序列(预测数据集)上应用随机森林(RF)和K近邻(KNN)算法。
注意:这些蛋白质与多种功能相关,例如 Citrus sinensis、Mentha 和 thyme 有助于缓解消化不良;Vitis vinifera、Jasmine、Hibiscus 是抗氧化剂的丰富来源,同时可改善皮肤健康;Illicium oligandrum 因其抗真菌和抗菌特性而著称等。
7. 药用植物中正向预测的三维结构域交换蛋白的富集分析
- 利用 UniProt 的数据,将这些蛋白质序列的登录号映射到次级代谢产物类别。
- 从预测的序列中提取基因 ID。
- 打开 KEGG 在线服务器41(https://www.genome.jp/kegg/),通过粘贴单个基因 ID 或蛋白质名称来检查其相应的通路,进行 KEGG 通路富集分析。
- 通过将预测的三维结构域交换蛋白与预测数据集进行对比,开展比较分析,以检测特定基因本体(GO)术语和生物通路在统计学上的显著过表达。将预测序列的基因 ID 粘贴至 ShinyGO v0.742(https://bioinformatics.sdstate.edu/go74/),并选择所需的功能或通路类别(生物学功能、细胞组分、分子功能、KEGG 等)。
注意:使用一个支持用户编写和执行 Python 代码的在线云平台43对这些注释进行可视化。
访问受限。请登录或开始试用以查看此内容。
结果
表现出三维结构域交换的蛋白质常与多种生物学功能相关。然而,针对参与三维结构域交换的蛋白质序列进行系统性、全基因组范围的分析仍基本未被探索。本研究首次尝试从13种药用植物中预测潜在的三维结构域交换蛋白,并重点分析其与次生代谢物结构域、KEGG通路及基因本体(GO)术语的关联性。通过对可获取文献的综合分析以及所应用机器学习模型的性能评估表明,相较于K-近邻算法(KNN),随机森林(RF)模型在预测三维结构域交换类别方面表现出更优的性能。 图 4A,较高的AUC值表明AUROC分析性能优异;RF模型(AUC=-0.914)表现出较强区分3D-DS与3D-NDS类别的能力。而KNN模型的AUC值(AUC=-0.883)略低于RF模型,但仍显示出良好的3D结构域交换分类能力& 三维非结构域交换。在 图 4B,精确率-召回率曲线(AUPRC)显示,RF 模型具有较高的精确率和召回率,表明其在减少假阳性(FP)病例方面效果显著。尽管 KNN 模型表现出完美的精确率,意味着其不产生任何假阳性,但其较低的召回率表明它遗漏...
访问受限。请登录或开始试用以查看此内容。
讨论
全面了解蛋白质在其完整基因组范围内的三维结构域交换现象在多个领域具有重要意义。机器学习方法,特别是随机森林和K近邻算法26,27,已被用于直接从基因组水平的蛋白质序列数据中预测三维结构域交换。这两种机器学习模型包含多个步骤,如数据集收集、特征选择、数据预处理与后处理、自定义模型脚本的实现以及模型评估。随机森林和K近邻模型的预测准确率分别为91.6%和88.7%。随后,这些预测模型被应用于13种药用植物的不同完整基因组。
据我们所知,这是首次利用机器学习技术在基因组尺度上对药用植物中的三维结构域交换现象进行全面研究。本研究选择KNN而非SVM,因为KNN更为简单,且在处理复杂非线性数据方面优于SVM。预测结果显示,在分析的序列中,有30.99%可能与三维结构域交换相关,凸显了这一结构现象在多种植物物种中的广泛存在。当前方法主要侧重于结构预测及其分子和功能多样性。RF和KNN仅能预测可能发生结构域交换的潜在案例,而无法预测完整的三维结构坐标,或确定具体参与该过程的残基区...
访问受限。请登录或开始试用以查看此内容。
披露
作者声明,他们不存在任何已知的可能影响本文所报告工作的竞争性经济利益或个人关系。
致谢
本研究未获得任何资助。
访问受限。请登录或开始试用以查看此内容。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| 3DSwap+ | https://caps.ncbs.res.in/3Dswapplus/index.html | ||
| Pfam | EMBL-EBI | http://pfam.xfam.org/: | |
| HMMER | EMBL-EBI | https://www.ebi.ac.uk/Tools/hmmer/: | |
| Aaindex | https://www.genome.jp/aaindex/: | ||
| DIAL | Bioinformaticshome.com | https://bioinformaticshome.com/db/tool/DIAL: | |
| WEKA | 怀卡托大学 | https://www.waikato.ac.nz/int/research/institutes-centres-entities/institutes/artificial-intelligence-institute/research/software/ | |
| KEGG | https://www.genome.jp/kegg/ : | ||
| ShinyGO | https://bioinformatics.sdstate.edu/go/ : | ||
| uniprot | Uniprot | https://www.uniprot.org/ : |
参考文献
- Radivojac, P., et al. A large-scale evaluation of computational protein function prediction. Nat Methods. 10 (3), 221-227 (2013).
- Bennett, M. J., et al. 3D domain swapping: a mechanism for oligomer assembly. Protein Sci. 4, 2455-2468 (1995).
- Bennett, M. J., et al. Domain swapping: entangling alliances between proteins. Proc Natl Acad Sci U S A. 91, 3127-3131 (1994).
- Liu, Y., et al. The crystal structure of a 3D domain-swapped dimer of RNase A at a 2.1-Å resolution. Proc Natl Acad Sci U S A. 95 (7), 3437-3442 (1998).
- Straub, J. E., et al. Principles governing oligomer formation in amyloidogenic peptides. Curr Opin Struct Biol. 20, 187-195 (2010).
- Upadhyay, A. K., et al. Genome-wide prediction and analysis of 3D domain-swapped proteins in the human genome from sequence information. PLoS One. 11 (7), e0159627(2016).
- Liu, Y., et al. 3D domain swapping: as domains continue to swap. Protein Sci. 11, 1285-1299 (2002).
- Schlunegger, M. P., et al. Oligomer formation by 3D domain swapping: a model for protein assembly and misassembly. Adv Protein Chem. 50, 61-122 (1997).
- Rousseau, F., et al. Implications of 3D domain swapping for protein folding, misfolding and function. Adv Exp Med Biol. 747, 137-152 (2012).
- Anderson, W. F., et al. Structure of the Cro repressor from bacteriophage λ and its interaction with DNA. Nature. 290 (5809), 754-758 (1981).
- Albright, R. A., et al. High-resolution structure of an engineered Cro monomer shows changes in conformation relative to the native dimer. Biochemistry. 35, 735-742 (1996).
- Bax, B., et al. X-ray analysis of beta B2-crystallin and evolution of oligomeric lens proteins. Nature. 347, 776-780 (1990).
- Parge, H. E., et al. Human CksHs2 atomic structure: A role for its hexameric assembly in cell cycle control. Science. 262, 387-395 (1993).
- Fita, I., et al. The NADPH binding site on beef liver catalase. Proc Natl Acad Sci U S A. 82 (6), 1604-1608 (1985).
- Milburn, M. V., et al. A novel dimer configuration revealed by the crystal structure at 2.4 Å resolution of human interleukin-5. J Biol Chem. 268, 2117-2120 (1993).
- Upadhyay, A. K., et al. Genome-wide analysis of domain-swap predicted products in the genome of anti-stress medicinal plant: Ocimum tenuiflorum. Bioinformat Biol Insights. 13, 1177932218821362(2019).
- Simpson, G. A., et al. Crystal structure and interconversion of monomers and domain-swapped dimers of the walnut tree phytocystatin. Biochim Biophys Acta Prot Proteom. 1872 (2), 140975(2024).
- Tran, L. H., et al. 3D domain swapping dimerization of the receiver domain of cytokinin receptor CRE1 from Arabidopsis thaliana and Medicago truncatula. Front Plant Sci. 24 (12), 756341(2021).
- Shameer, K., et al. Insights into protein sequence and structure-derived features mediating 3D domain swapping mechanism using support vector machine-based approach. J Bioinform Comput Biol. 4, 33-42 (2010).
- Shameer, K., et al. 3dswap-pred: prediction of 3D domain swapping from protein sequence using Random Forest approach. Protein Pept Lett. 19, 1010-1020 (2012).
- Tasnim, F. Protein sequence classification through deep learning and encoding strategies. Proc Comp Sci. 238, 876-881 (2024).
- Xu, Y., et al. Deep dive into machine learning models for protein engineering. J Chem Info Modeling. 60 (6), 2773-2790 (2020).
- Lilhore, U. K., et al. Optimizing protein sequence classification: integrating deep learning models with Bayesian optimization for enhanced biological analysis. BMC Med Inform Decis Mak. 24, 236(2024).
- Jumper, J., et al. Highly accurate protein structure prediction with AlphaFold. Nature. 596 (7873), 583-589 (2021).
- Du, Z., et al. The trRosetta server for fast and accurate protein structure prediction. Nat Protoc. 16 (12), 5634-5651 (2021).
- Genuer, R., et al. Random forests: Some methodological insights. arXiv. , (2008).
- Guo, G., et al. KNN model-based approach in classification. Lect Notes Comput Sci. 2888, 986-996 (2003).
- Kathuria, C., et al. Predicting the protein structure using random forest approach. Procedia Comput Sci. 132, 1654-1662 (2018).
- Gui, Y., et al. Application of K-nearest neighbors in protein-protein interaction prediction. Highlights Sci Eng Technol. 2, 125-131 (2022).
- Joseph, A. P., Shingate, P., Upadhyay, A. K., Sowdhamini, R. 3PFDB+: improved search protocol and update for the identification of representatives of protein sequence domain families. Database. 2014, bau026(2014).
- Finn, R. D., et al. The Pfam protein families database. Nucl Acids Res. 41, D211-D222 (2013).
- Mistry, J., et al. Challenges in homology search: HMMER3 and convergent evolution of coiled-coil regions. Nucl Acid Res. 41, e121(2013).
- Apweiler, A. UniProt: The universal protein knowledgebase. Nucl Acids Res. 46 (5), 2699-2699 (2018).
- Kawashima, S., et al. AAindex: amino acid index database, progress report 2008. Nucl Acids Res. 36, D202-D205 (2008).
- Frank, E., et al. Data mining in bioinformatics using WEKA. Bioinformatics. 20, 2479-2481 (2004).
- Pedregosa, F., et al. Scikit-learn: Machine Learning in Python. J Mach Learn Res. 12, 2825-2830 (2011).
- Wu, C., et al. Prediction of DNA methylation site status based on fusion deep learning algorithm. IEEE AEMCSE Proc. 5, 180-183 (2022).
- Wilhelm, T., et al. Phenotype prediction based on genome-wide DNA methylation data. BMC Bioinform. 15, 1-15 (2014).
- Uddin, S., et al. Dataset meta-level and statistical features affect machine learning performance. Sci Rep. 14 (1), 1F670(2024).
- Pedregosa, F., et al. Scikit-learn: Machine Learning in Python. J Mach Learn Res. 12, 2825-2830 (2011).
- Kanehisa, M., et al. Kyoto encyclopedia of genes and genomes. Nucl Acid Res. 28 (1), 27-30 (2000).
- Ge, S. X., et al. ShinyGO: a graphical gene-set enrichment tool for animals and plants. Bioinformatics. 36 (8), 2628-2629 (2020).
- Bisong, E. Google Colaboratory. Building Machine Learning and Deep Learning Models on Google Cloud Platform. , Apress. Berkeley, CA. (2019).
- Kirby, G. W. Biosynthesis of the morphine alkaloids. Science. 155 (3759), 170-173 (1967).
- Toffolatti, S. L., et al. Role of terpenes in plant defence to biotic stress. Biocont Agents Sec Metabol. , 401-417 (2021).
- Boncan, D. A. T., et al. Terpenes and terpenoids in plants: interactions with environment and insects. Int J Mol Sci. 21 (19), 7382(2020).
- Mansouri, H., et al. The response of terpenoids to exogenous gibberellic acid in Cannabis sativa L. at vegetative stage. Acta Physiol. Plant.33, 1085-1091 (2011).
- Pál, M., et al. Speculation: Polyamines are important in abiotic stress signalling. Plant Sci. 237, 16-23 (2015).
- Mattoo, A. K., et al. Higher polyamines restore and enhance metabolic memory in ripening fruit. Plant Sci. 174 (4), 386-393 (2008).
访问受限。请登录或开始试用以查看此内容。
重印与许可
本文已发表
视频即将推出