基于质谱的蛋白质组学数据可从开放数据库中获取,并可通过免费工具进行访问。鉴于数据库搜索和描述的复杂性,许多生物学家缺乏利用这些数据集的知识。本文提供了一份使用免费工具进行基本蛋白质组学数据搜索的指南。
需要JoVE订阅才能观看此内容。 请登录或开始免费试用
本文内容
摘要
摘要
基于质谱(MS)的蛋白质组学数据,包括依赖数据采集(DDA)和非依赖数据采集(DIA),在生物研究中被广泛应用。然而,由于缺乏关于如何有效搜索和分析蛋白质组学数据的清晰示范,这些数据集在验证研究中的应用仍然有限。为填补这一空白,我们从PRoteomics IDEntifications数据库(PRIDE)数据存储库中选取了一个DDA和一个DIA数据集,以更清晰地展示蛋白质组学数据分析流程以及蛋白质搜索结果的下游后处理过程。为演示目的,我们使用了两款免费的计算工具:FragPipe(v22.0)用于DDA数据集,DIA-NN(2.1.0)用于DIA数据集。使用R代码演示了后续处理步骤,例如生成火山图和差异表达蛋白质列表。本研究提供了搜索和分析蛋白质组学数据的基本操作流程,可作为有效处理蛋白质组数据集的入门必备指南。通过本工作,我们旨在为研究人员提供必要的知识,使其能够在生物学研究中充分利用蛋白质组学数据。
引言
蛋白质组学领域因开放获取数据存储库和免费软件工具的广泛应用而发生了革命性变化1,这些资源在提升研究能力以及推动数据共享文化方面发挥了关键作用。诸如PRIDE2等集中式资源的建立,以及人类蛋白质组组织(HUPO)蛋白质组学标准倡议(PSI)制定的标准化数据格式3,为数据的重用与整合创造了前所未有的机遇。然而,蛋白质组学数据的分析与解读仍存在显著的技术障碍,尤其对于希望对其自身实验结果进行正交验证的生物学家和临床科研人员而言尤为如此4。本文通过提出一种不依赖仪器厂商的计算工作流程,直接应对这一挑战,为研究人员提供一个可及的框架,使其能够独立查询、分析并整合公共蛋白质组学数据与自身研究成果,从而在无需额外湿实验的情况下实现可靠的正交验证。本方法特别适用于希望对其自身实验中鉴定出的特定蛋白质差异表达进行正交验证,并通过探索其关注蛋白质在大量已发表研究中的表达模式来提出新假说的研究人员。通过提供逐步操作指南,我们旨在使更广泛的研究人员能够充分挖掘公共蛋白质组学数据的潜力,最终增强其研究的稳健性与影响力。
在基于质谱(MS)的蛋白质组学中,MS1和MS2扫描是数据采集的基础。MS1扫描(又称全扫描)用于检测和测量样品中所有离子的质荷比(m/z),从而提供离子群体的全面概览5。MS2扫描(也称为碎裂扫描)则选择MS1扫描中特定的前体离子进行分离和碎裂,生成碎片离子谱图,用于肽段鉴定6。
数据依赖性采集(DDA)从 MS1 扫描中选择丰度最高的离子进行 MS2 碎裂,产生更简单的谱图,从而简化分析过程。然而,DDA 可能导致在复杂样品中出现随机采样和缺失值,限制了结果的可重复性7。相比之下,数据非依赖性采集(DIA)系统性地对预设 m/z 窗口内的所有离子进行碎裂,确保全面覆盖并最大限度减少缺失值。这提高了定量的准确性和可重复性8,但 DIA 需要先进的计算工具来解析其高度复杂的 MS2 谱图9。
PRIDE(https://www.ebi.ac.uk/pride)2是 ProteomeXchange联盟 (https://www.proteomexchange.org)10内的主要数据库,该联盟是一个用于共享蛋白质组学数据的全球性平台。用户可通过关键词搜索高效地浏览这一庞大资源,以查找感兴趣的数据集。
DIA-NN11 是一款利用深度神经网络的软件套件,是分析数据非依赖性采集(DIA)蛋白质组学数据的金标准工具。其在肽段鉴定与定量准确性方面表现卓越,特别适用于处理复杂的 DIA 数据集12。对于数据依赖性采集(DDA)工作流程,集成于 FragPipe 分析流程中的 MSFragger13 可实现超快速肽段鉴定。该工具创新的碎片离子索引方法可实现快速谱图匹配,在速度上比传统工具快出逾 100 倍。
凭借这些全面的数据库和先进工具,研究人员能够轻松地重用蛋白质组学数据,以进行跨研究验证和发现新的生物学信息。这种可及性推动了在多种疾病中识别出大量蛋白质生物标志物14,15,改善了预后预测16,并实现了基于蛋白质组谱的分子亚型分类17。
访问受限。请登录或开始试用以查看此内容。
方案
注意:工作流程概览见图1,所用软件的详细说明见材料表。
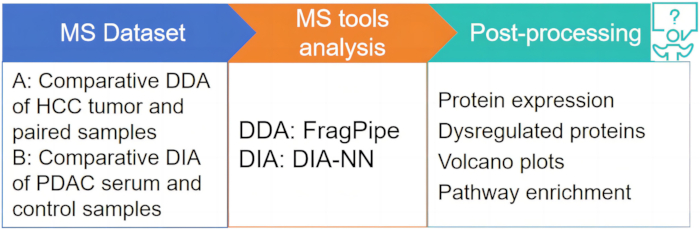
图1:研究设计概览。 请点击此处查看此图的放大版本。
1. 示例文件和软件设置
注意:所有应用程序均可免费用于个人研究用途,并可在个人计算机上运行(支持 Windows 和 Linux 系统)。
- 为项目创建一个新目录。
- 从 PRIDE 下载 JMU_LM2_8526_55.raw、JMU_LM2_8568_51.raw、JMU_LM2_8696_37.raw、JMU_LM2_2112_87.raw、JMU_LM2_2195_91.raw、JMU_LM2_2377_73.raw、20150127_liver_XH03_T_01.raw、20150127_liver_XH03_T_02.raw、20150127_liver_XH03_T_03.raw、20150127_liver_XH03_P_01.raw、20150127_liver_XH03_P_02.raw、20150127_liver_XH03_P_03.raw。
注意:这两组文件可分别从 https://www.ebi.ac.uk/pride/archive/projects/PXD039273 和 https://www.ebi.ac.uk/pride/archive/projects/PXD006512 下载(图 2)。 - 下载并安装所需的软件工具。
- 下载最新版本的 DIA-NN .msi 文件。DIA-NN 可在 https://github.com/vdemichev/DiaNN/releases/tag/2.0 免费获取,Windows 系统使用 .msi 文件,Linux 系统使用 .zip 文件。
- 下载最新版本的 MSFileReader .exe 文件。MSFileReader 可在 https://github.com/thermofisherlsms/MSFileReader/blob/main/MSFileReader_x64.exe 免费获取 .exe 文件,用于处理赛默飞世尔科技(Thermo Fisher)DIA 格式的 raw 数据。
- 下载最新版本的 .NET SDK .exe 文件。.NET SDK 可在 https://dotnet.microsoft.com/en-us/download 免费获取 .exe 文件,在 Windows 系统中运行 MSFileReader 所必需。
- 下载最新版本的 FragPipe .zip 文件。FragPipe 可在 https://github.com/Nesvilab/FragPipe/releases 免费获取 .zip 文件。建议下载包含 jre 的版本,因其内含适用于 Windows 的 Java 运行环境,用于运行 FragPipe。MSFragger 已嵌入 FragPipe 中。
- 从 补充文件 1 和补充文件 2 下载最新版本的 R、RStudio 及 R 脚本文件。R 和 RStudio 可分别从 https://cran.rstudio.com/bin/windows/base/R-4.5.0-win.exe 和 https://posit.co/download/rstudio-desktop/ 免费下载。
- 解压压缩文件,并点击 .exe 或 .msi 文件 安装应用程序。
使用 DIA-NN 进行 DIA 数据分析
- 从 UniProt 下载参考蛋白质组 fasta 文件。要下载 Homo sapiens 参考蛋白质组(不包含异构体信息),请访问 https://www.uniprot.org/proteomes/UP000005640(图 3A)。
- 点击 Add FASTA 按钮,将参考蛋白质组文件加载到 DIA-NN 中。
- 在前体离子生成部分,选择两个选项:FASTA digest for library-free search /library generation 和 Deep learning-based spectra, RTs and lMs prediction。点击 Run 按钮以生成预测的谱图库(图 3B)。
- 一旦预测的谱图库文件生成,可在相同实验采集条件下用于其他实验,方法是点击 Spectral 按钮添加该预测谱图库。
- 取消选中 Precursor ion generation 部分的两个选项,并在输入部分点击与文件格式相对应的 Type 按钮,以加载 DIA 数据。
- 在算法设置中,将质量精度和 MS1 精度均设为 0.0 ppm。
- 根据实验设置,在前体离子生成部分调整前体离子和碎片离子的质量范围。
- 保留其他默认设置。
- DIA-NN 的前体离子生成使用 Trypsin/P(在 K/R 后切割,若其后为脯氨酸则不切割),允许 1 次漏切以模拟不完全消化;对于非经典肽段(如免疫肽组学),禁用 N-term M excision,或为更长的肽段将漏切次数增加至 2。
- 对于翻译后修饰(PTM)研究,显式启用默认禁用的可变修饰(例如 Ox (M) 表示甲硫氨酸氧化,K-GG 表示泛素化),并根据实验设置扩展肽段筛选条件(长度:7–30 个氨基酸;电荷:1–4+;前体 m/z:300–1800),例如对于大分子量 PTM 或非胰蛋白酶消化,可调整为长度 5–50 个氨基酸,电荷 1–6。
- 算法设置利用自动校准(质量精度 = 0.0 ppm)实现精确的质量对齐;对于低分辨率仪器,可改用手动容差(例如 10 ppm);“运行间匹配”(Match Between Runs, MBR)可在不同运行间传递鉴定结果(对于异质样品应禁用)。
- 神经网络评分可提高鉴定置信度(除非数据质量较差,否则应保留);Quant Unlabeled Mass Spectrometry(UMS)支持高精度的无标记定量;对于同重标签(如 TMT),应切换至 MS2 定量。仅在使用高分辨率 DIA 数据时采用无谱图库搜索,以避免对谱图库的依赖。
- 点击 Run 按钮,等待结果直至操作界面显示“Finished”,表示运行完成(图 3C)。
3. 使用 FragPipe 进行 DDA 数据分析
- 安装完成后,点击 ~\FragPipe\fragpipe\bin 文件夹中的 Fragpipe 图标。所有相关依赖设置可在“Config”选项卡中查看。检查您的计算机上是否已存在三个模块(MSFragger、IonQuant、diaTracer、DIA-NN 和 Python)。若不存在,请点击 Download/Update 或 Download 进行下载(图 4A)。
- 切换到下一个选项卡 Workflow。选择工作流程为 Default,然后点击 Load workflow。点击 Add files 添加文件路径。在“Assign files”下指定实验名称和生物重复编号,或保持默认不填(图 4B)。
- 现在点击 Database 切换至该选项卡。加载一个 fasta 文件,或根据样本物种下载相应的 fasta 文件。下载时,为简化运行,请选择 Reviewed sequences only、Add decoys 和 Add common contaminants 选项(图 4C)。
- 然后点击 MSFragger 切换选项卡。选择 Closed Search default config,然后点击 Load。
注:封闭式搜索主要用于搜索您已设定的修饰类型,而开放式搜索则会从数据中探索所有可能的修饰,后者更耗时且占用更多内存。 - 在峰匹配(Peak matching)设置中,除建议将校准(Calibration)和优化(Optimization)设为 None 以节省时间外,其余保持默认设置。
- 针对蛋白质消化参数,应根据实验条件进行调整。以下为推荐的默认设置(图 5A)。
注:前体离子和碎片离子质量容差(±20 ppm)定义了实验谱图与理论肽段匹配时允许的最大质量误差,对于高分辨率仪器建议使用更严格的数值。酶切规则(严格胰蛋白酶)指定切割特异性(K/R 后切割,除非其后为 P),允许最多 2 次漏切,以包含部分消化的肽段。肽段长度(5–50 个残基)和质量(500–5000 Da)过滤器用于排除不合理候选肽段。可变修饰(如甲硫氨酸氧化 +15.9949 Da,丝氨酸/苏氨酸/酪氨酸磷酸化 +79.96633 Da)用于检测化学修饰,而“最大组合数”(5)限制每条肽段上同时发生的修饰数量,以控制搜索空间。“每个位点最大可变修饰数”(如 M 上最多 3 个)用于控制修饰频率。对大型蛋白质组建议启用“分割数据库”以提高效率,同位素误差(0/1/2)用于校正同位素峰误分配。这些参数共同在肽段鉴定的灵敏度、特异性和计算负载之间实现平衡。 - 切换至“Validation”选项卡。取消选中 Predict RT 和 Predict spectra,这些选项适用于 DIA 数据(图 5B)。
- 点击 Quant (MS1) 选项卡。勾选 Run MS1 quant,然后点击 Load Quant defaults。选择 IonQuant 并保持默认设置(图 6A)。若保留时间不稳定,可禁用 MBR;若存在全局强度偏倚,可禁用 Intensity normalization;对于大规模数据集,建议启用 Keep index 以减少内存占用。
注:Quant (MS1) 的默认设置旨在优化基于 MaxLPQ(MaxLFQ 延伸的蛋白质定量算法,适用于蛋白质组)的非标记定量,要求每个蛋白质至少有 ≥1 个唯一离子(提高至 ≥2 可增强严格性,但会降低覆盖度)。“跨运行匹配”(Match Between Runs, MBR)利用保留时间容差(默认 0.4 分钟;色谱稳定时可收紧至 0.2 分钟,梯度波动大时可放宽)和离子淌度容差(默认 0.05 1/k0 [归一化迁移率倒数];根据离子淌度精度调整),并以 ≤1% 的错误发现率(FDR)进行过滤(默认 MBR 离子 FDR=0.01;严格分析可降至 0.005)。蛋白质推断采用 uniquer+rascor 方法(通过“剃刀肽段”策略进行蛋白质分组)。特征检测使用 10 ppm 质量容差(低分辨率质谱可增至 20 ppm,高分辨率可减至 5 ppm)。 - 现在点击 Run 选项卡。选择 Output directory,然后点击 RUN 开始分析数据(图 6B)。
注:对于不关注翻译后修饰或不使用标记定量的非标记蛋白质组学数据,PTMs、Glyco 和 Quant (Isobaric) 选项卡无需使用。
4. DIA-NN/FragPipe 下游分析
注意:本研究中使用的详细代码包含在补充文件1和补充文件2中。本研究中使用的软件包版本信息可在补充文件3中找到。
- 打开 RStudio,并读取由 DIA-NN 或 FragPipe 生成的蛋白质表达数据。通常使用 DIA-NN 输出的以 .pg_matrix.tsv 结尾的蛋白群组矩阵数据,以及 FragPipe 输出的以 .tsv 结尾的合并蛋白数据进行分析。
- 在不填充 NA 的情况下移除缺失值,并过滤掉由少于两个唯一肽段鉴定和定量的蛋白群组。
注意:本研究中的 DIA 图表基于经过过滤的蛋白群组生成,而 DDA 图表则来自未过滤的蛋白群组。 - 使用中位数缩放法或分位数归一化法对蛋白质强度在样本间进行归一化。本研究中,DIA 数据采用中位数归一化,DDA 数据采用分位数归一化,以更好地展示这两种方法。
注意:中位数归一化对异常值具有较强的鲁棒性,适用于大多数蛋白质在各样本间表达不变的情况,此时中位蛋白质丰度可作为稳定的参考点。然而,当存在大量差异表达蛋白时,该方法可能失效18。分位数归一化可确保各样本间蛋白质丰度分布一致,在比较分布差异较大的样本时尤为有用。但研究表明,该方法可能降低统计功效,并存在过度归一化的风险,从而掩盖真实的生物学差异18。在蛋白质组学中,中位数归一化广泛用于无标记研究,以消除与质谱仪性能相关的系统性偏差;而分位数归一化则更适用于大规模数据集、差异表达分析和聚类分析19,20。 - 计算 log2 倍数变化(例如,PDAC 血清 vs 正常),以及 t 检验 p 值。使用 Benjamini-Hochberg 方法计算校正后的 p 值。设定显著性阈值(例如,|log2FC| > 1,p_adj(FDR)< 0.05)。
注意:本研究图表中使用的 p 值截断值为原始值,因为使用校正 p 值(p_adj)会因这些数据集规模有限而导致所有可检测到的蛋白质均被排除。 - 检查缺失值/NA 值的存在情况并予以排除。生成火山图以可视化显著差异的蛋白。
- 筛选显著失调的蛋白质。对蛋白质表达值进行 Z 分数标准化。绘制带有样本分组注释的聚类热图。
- 使用 org.Hs.eg.db 将蛋白质映射至 Entrez ID。进行基因本体富集分析(生物过程)和 KEGG 通路分析。
注意:在基因本体(GO)分析中,通常选择生物过程(BP)类别,因为其描述了由多个分子活动共同完成的较大生物学过程或程序20。这些术语聚焦于在癌症等疾病中发生紊乱的细胞功能,包括细胞周期调控、代谢过程等关键过程。除 BP 外,GO 分析还包括分子功能(MF)和细胞组分(CC)类别。MF 术语描述基因产物的生化活性,如离子转运或 DNA 结合能力;CC 术语定义基因产物发挥功能的细胞定位,如细胞核、线粒体膜或细胞骨架。 - 在 STRINGdb 中查询蛋白质相互作用(置信度评分 ≥ 400)。使用 visNetwork 生成交互式网络图。
访问受限。请登录或开始试用以查看此内容。
结果
为了更好地说明蛋白质组学数据集的检索过程,我们为本次分析选取了两种类型的数据集。为展示临床背景下差异表达的蛋白质,我们使用“clinic”等关键词在PRIDE数据库中进行检索。具体而言,我们从临床蛋白质组肿瘤分析联盟(Clinical Proteomic Tumor Analysis Consortium, CPTAC)21中选择了一个适用于DIA分析的数据集,以及从中国人类蛋白质组计划(Chinese Human Proteome Project, CNHPP)22中选择了一个适用于DDA分析的数据集。这些数据集的选取有助于全面评估和展示该软件在分析健康与疾病相关蛋白质组数据方面的功能。
图中所示的火山图对正常个体与胰腺导管腺癌(PDAC)患者血清蛋白的差异表达,以及肝细胞癌(HCC)肿瘤样本与其配对组织之间的差异表达进行了全面分析(
访问受限。请登录或开始试用以查看此内容。
讨论
本方案通过整合DIA-NN和FragPipe等免费工具,展示了蛋白质组学数据分析的方法。成功的关键在于若干重要步骤,例如在DIA-NN中生成谱图库时,需精确选择前体离子并设置质量精度(步骤2.3)27,这些参数依赖于仪器类型,对实现完整的肽段鉴定至关重要。同样,在FragPipe中细致地设置数据库(步骤3.4),包括诱饵库的生成和污染物过滤,对于控制错误发现率(FDR)也极为关键。
修改和故障排除通常涉及验证软件依赖项(例如,MSFileReader 所需的 .NET,FragPipe 所需的 Java)以及管理计算资源,尤其是对于大型数据集,可能需要为 MSFragger 增加内存,或对 DIA-NN 使用高性能计算(HPC)。社区论坛(例如 GitHub)可提供有价值的、持续更新的故障排除支持。
主要局限性包括该方案仅适用于无标记的DIA和DDA工作流程,无法进行全面的翻译后修饰(PTM)分析28或基于标记的定量分析,尽管MSF...
访问受限。请登录或开始试用以查看此内容。
披露
F.Z. 是 Molemuse Biotech Studio 的创始人。
致谢
本项目由Molemuse Biotech Studio提供支持。
访问受限。请登录或开始试用以查看此内容。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| .NET SDK v. 9.0.203 | 微软 | https://dotnet.microsoft.com/zh-cn/download | |
| DIA-NN v. 2.1.0 | https://github.com/vdemichev/DiaNN/releases/tag/2.0 | ||
| FragPipe v. 22.0 | https://github.com/Nesvilab/FragPipe/releases | ||
| MSFileReader 版本 3.1 | 赛默飞世尔科技 | https://github.com/thermofisherlsms/MSFileReader/blob/main/MSFileReader_x64.exe | |
| R 4.5.0 | https://cran.rstudio.com/bin/windows/base/R-4.5.0-win.exe | ||
| Rstudio v. 2024.12.1+563 | https://posit.co/download/rstudio-desktop/ |
参考文献
- Pedrioli, P. G. A., et al. A common open representation of mass spectrometry data and its application to proteomics research. Nat Biotechnol. 22 (11), 1459-1466 (2004).
- Perez-Riverol, Y., et al. The PRIDE database at 20 years: 2025 update. Nucl Acids Res. 53 (D1), D543-D553 (2025).
- Deutsch, E. W., et al. Proteomics Standards Initiative at Twenty Years: Current Activities and Future Work. J Proteome Res. 22 (2), 287-301 (2023).
- Schubert, O. T., Röst, H. L., Collins, B. C., Rosenberger, G., Aebersold, R. Quantitative proteomics: challenges and opportunities in basic and applied research. Nat Protoc. 12 (7), 1289-1294 (2017).
- Wang, X., Shen, S., Rasam, S. S., Qu, J. MS1 ion current-based quantitative proteomics: A promising solution for reliable analysis of large biological cohorts. Mass Spectro Rev. 38 (6), 461-482 (2019).
- Vaudel, M. MS2-Based Quantitation. Proteome Inform. , 155-177 (2016).
- Meyer, J. G. Qualitative and Quantitative Shotgun Proteomics Data Analysis from Data-Dependent Acquisition Mass Spectrometry. Shotgun Proteomics. 2259, 297-308 (2021).
- Fröhlich, K., et al. Data-Independent Acquisition: A Milestone and Prospect in Clinical Mass Spectrometry-Based Proteomics. Mol Cell Proteomics. 23 (8), 100800(2024).
- Zhang, F., Ge, W., Ruan, G., Cai, X., Guo, T. Data-Independent Acquisition Mass Spectrometry-Based Proteomics and Software Tools: A Glimpse in 2020. Proteomics. 20 (17-18), 1900276(2020).
- Deutsch, E. W., et al. The ProteomeXchange consortium at 10 years: 2023 update. Nucl Acids Res. 51 (D1), D1539-D1548 (2023).
- Demichev, V., Messner, C. B., Vernardis, S. I., Lilley, K. S., Ralser, M. DIA-NN:neural networks and interference correction enable deep proteome coverage in high throughput. Nat Meth. 17 (1), 41-44 (2020).
- Zhang, F., et al. A Comparative Analysis of Data Analysis Tools for Data-Independent Acquisition Mass Spectrometry. Mol Cell Proteomics. 22 (9), 100623(2023).
- Kong, A. T., Leprevost, F. V., Avtonomov, D. M., Mellacheruvu, D., Nesvizhskii, A. I. MSFragger: ultrafast and comprehensive peptide identification in mass spectrometry-based proteomics. Nat Meth. 14 (5), 513-520 (2017).
- Anderson, N. L., Anderson, N. G. The Human Plasma Proteome. Mol Cell Proteomics. 1 (11), 845-867 (2002).
- Kowal, J., et al. Proteomic comparison defines novel markers to characterize heterogeneous populations of extracellular vesicle subtypes. Proc Natl Acad Sci. 113 (8), E968-E977 (2016).
- Cao, L., et al. Proteogenomic characterization of pancreatic ductal adenocarcinoma. Cell. 184 (19), 5031-5052.e26 (2021).
- Dong, L., et al. Proteogenomic characterization identifies clinically relevant subgroups of intrahepatic cholangiocarcinoma. Cancer Cell. 40 (1), 70-87.e15 (2022).
- Dubois, E., Galindo, A. N., Dayon, L., Cominetti, O. Comparison of normalization methods in clinical research applications of mass spectrometry-based proteomics. 2020 IEEE Conf Computat Intelligence Bioinfo Computat Biol. , 1-10 (2020).
- Dressler, F. F., Brägelmann, J., Reischl, M., Perner, S. Normics: Proteomic Normalization by Variance and Data-Inherent Correlation Structure. Mol Cell Proteomics. 21 (9), 100269(2022).
- Dimmer, E. C., et al. The Gene Ontology - Providing a Functional Role in Proteomic Studies. Proteomics. 8 (23-24), pmic.200800002(2008).
- Lih, T. M., et al. Detection of Pancreatic Ductal Adenocarcinoma-Associated Proteins in Serum. Mol Cell Proteomics. 23 (1), 100687(2024).
- Chinese Human Proteome Project (CNHPP) Consortium. Proteomics identifies new therapeutic targets of early-stage hepatocellular carcinoma. Nature. 567 (7747), 257-261 (2019).
- Kanehisa, M., Furumichi, M., Sato, Y., Matsuura, Y., Ishiguro-Watanabe, M. KEGG: biological systems database as a model of the real world. Nucl Acids Res. 53 (D1), D672-D677 (2025).
- Campello, E., Ilich, A., Simioni, P., Key, N. S. The relationship between pancreatic cancer and hypercoagulability: a comprehensive review on epidemiological and biological issues. Br J Cancer. 121 (5), 359-371 (2019).
- Fang, L., Xu, Q., Qian, J., Zhou, J. Y. Aberrant Factors of Fibrinolysis and Coagulation in Pancreatic Cancer. OncoTargets Ther. 14, 53-65 (2021).
- Vlodavsky, I., Elkin, M., Ilan, N. Impact of heparanase and the tumor microenvironment on cancer metastasis and angiogenesis: basic aspects and clinical applications . Rambam Maimonides Med J. 2 (1), (2011).
- Fröhlich, K., et al. Benchmarking of analysis strategies for data-independent acquisition proteomics using a large-scale dataset comprising inter-patient heterogeneity. Nat Comm. 13 (1), 2622(2022).
- Polasky, D. A., et al. MSFragger-Labile: A Flexible Method to Improve Labile PTM Analysis in Proteomics. Mol Cell Proteomics. 22 (5), 100538(2023).
- Gerault, M. A., Camoin, L., Granjeaud, S. DIAgui: a Shiny application to process the output from DIA-NN. Bioinfo Adv. 4 (1), (2024).
- Hsiao, Y., et al. Analysis and Visualization of Quantitative Proteomics Data Using FragPipe-Analyst. J Proteome Res. 23 (10), 4303-4315 (2024).
- Yu, F., Deng, Y., Nesvizhskii, A. I. MSFragger-DDA+ enhances peptide identification sensitivity with full isolation window search. Nat Comm. 16 (1), 3329(2025).
- Li, K., Teo, G. C., Yang, K. L., Yu, F., Nesvizhskii, A. I. diaTracer enables spectrum-centric analysis of diaPASEF proteomics data. Nat Comm. 16 (1), 95(2025).
- Qiao, R., Li, H., Bian, H., Xin, L., Shan, B. De Novo sequencing-assisted homology search for DIA data analysis enables low abundance peptide variants discovery. Biorvix. 10, (2025).
- Meissner, F., Geddes-McAlister, J., Mann, M., Bantscheff, M. The emerging role of mass spectrometry-based proteomics in drug discovery. Nat Rev Drug Disc. 21 (9), 637-654 (2022).
- Zheng, Y., et al. Multi-omics data integration using ratio-based quantitative profiling with Quartet reference materials. Nat Biotechnol. 42 (7), 1133-1149 (2024).
- Bubis, J. A., et al. Challenging the Astral mass analyzer to quantify up to 5,300 proteins per single cell at unseen accuracy to uncover cellular heterogeneity. Nat Meth. 22 (3), 510-519 (2025).
- Leutert, M., Entwisle, S. W., Villén, J. Decoding Post-Translational Modification Crosstalk With Proteomics. Mol Cell Proteomics. 20, 100129(2021).
- Schneider, M., et al. A Scalable, Web-Based Platform for Proteomics Data Processing, Result Storage and Analysis. Proteome Res. 24 (3), 1241-1249 (2025).
- Jalili, V., et al. The Galaxy platform for accessible, reproducible and collaborative biomedical analyses: 2020 update. Nucl Acids Res. 48 (W1), W395-W402 (2020).
访问受限。请登录或开始试用以查看此内容。
重印与许可
