我们提出一种基于强化学习的大型语言模型微调方法,该方法使用实体幻觉指数(Enti Hallucination Index, EHI)作为奖励信号,以减少文本摘要中的实体级别幻觉。在会议记录上的实验表明,该方法可提高实体的忠实性和准确性。
需要JoVE订阅才能观看此内容。 请登录或开始免费试用
本文内容
摘要
摘要
大型语言模型(LLM)的最新进展显著提升了抽象式摘要生成的质量。然而,幻觉问题——尤其是实体级幻觉,即引入不存在或错误的实体——仍然是一个关键挑战。在本研究中,我们提出一种以实体幻觉指数(EHI)为指导指标的奖励驱动型摘要模型微调框架。该方法首先在结构化转录数据集 XSUM 上,利用预训练模型(如 Flan-T5、DistilBART 和 Mistral 或其他主流 LLM)生成初始摘要。通过从生成的摘要和标准参考摘要中提取命名实体,计算精确率并对虚构实体进行惩罚,从而得出 EHI。微调过程采用强化学习进行引导,其中 EHI 作为奖励信号。我们采用类 REINFORCE 的更新机制,优化摘要模型以最大化实体保真度。实验表明,使用 EHI 进行微调的模型在不牺牲信息量的前提下,显著降低了幻觉率。此外,我们发现 EHI 指导下的模型在跨领域摘要任务中表现出更强的泛化能力,显示出更高的鲁棒性。该方法为提升摘要事实性提供了切实可行的方向,突出了准确实体表征的关键作用。
引言
基于大语言模型(LLMs)的抽象式摘要模型已在多个领域取得了显著成果。然而,一个长期存在的挑战是幻觉问题,即生成的摘要包含与源输入内容不符的错误或虚构信息1,2。在会议摘要、医疗报告或金融文档等高风险应用场景中,涉及命名实体的幻觉问题可能严重削弱摘要的可信度与实用性3。
Researchers 进行了一项大规模的人类评估,发现摘要生成模型经常产生幻觉——即生成内容在源文档中缺乏依据——并且这些幻觉与重复性和不连贯性相关1。另一项研究表明,抽象性越强的模型,其忠实度越低;该研究指出,抽象程度更高的输出具有更低的事实准确性,并包含更多不忠实的句子2。FRANK 基准测试报告称,大约 30% 的摘要存在事实不一致问题,另一项广受关注的研究也指出了类似的错误率,并认为高水平的幻觉使摘要几乎毫无用处1,2。幻觉可分为内在型(与源内容矛盾)和外在型(无法从源内容中验证)。一篇关于抽象式摘要中幻觉问题的教程解释说,内在幻觉是指生成内容与输入相矛盾(例如,将已获批的疫苗误报为被拒绝),而外在幻觉则添加了无法验证的事实,例如声称某疫苗正在进行临床试验,但原文并未提及4。该研究还报告称,在使用 ROUGE、BLEU 和 METEOR 进行评估时,最先进的摘要模型约有 25% 的输出包含幻觉内容,并警示在医疗、法律或网络安全等领域,幻觉可能带来严重危害。
传统的n-gram指标(ROUGE5、BLEU、METEOR)与人类对事实性的判断相关性较差,促使了基于参考文本和无需参考文本的指标的发展6。基于问答的指标(如FEQA和QuestEval)通过判断从摘要中提取的问题-答案对是否能由源文本回答来评估摘要质量。FEQA与人类判断的相关性更强,并表明更具抽象性的摘要往往保真度更低;而QuestEval在一致性、连贯性、流畅性和相关性方面显著提升了与人类判断的相关性。QAFactEval进一步优化了该方法,通过先选择名词短语作为答案并生成问题,再进行回答;该策略在SummaC基准测试中提高了与人类评估的相关性。信息抽取(IE)指标将知识表示为“主语-关系-宾语”三元组,但容易受到抽取过程错误的影响。自然语言推理(NLI)指标(如FactCC和SummaC)将摘要句子分类为被源文本蕴含或矛盾4。FactCC使用弱监督数据训练分类器以检测事实一致性,并标出不一致的文本片段2。SummaC在适当的粒度上应用NLI模型,从而提供较强的事实性估计,但FRANK基准指出,这些指标仍将事实性视为二元判断,且缺乏统一的评估框架1,7,8。研究人员提出的由人类评估的维度——流畅性、连贯性、相关性和一致性——已被广泛采用9。另一项评估研究强调,一致性是最具客观性的维度,因为它仅检查摘要是否被源文本所蕴含;该研究指出,高达92%的XSum摘要包含保真性错误9,10。然而,人工评估耗时且成本高昂,因此自动指标对于可扩展的评估至关重要8。当前的指标通常将内在和外在的幻觉错误聚合为单一分数,阻碍了错误诊断4。
由于最大似然训练无法直接优化摘要质量,研究者已采用强化学习(RL)来提升摘要的相关性和事实性。Pasunuru 和 Bansal 提出了一种多奖励 RL 框架,该框架结合了显著性(ROUGE)和蕴含奖励,并实现了最先进的性能11采用REINFORCE算法将强化学习(RL)应用于抽取式摘要生成;该模型通过最大化ROUGE得分,生成的摘要比基于分类器的方法更具信息量,人类问答评估结果证实了这一点12多任务模型进一步结合了问题生成和蕴含生成,以确保覆盖性和连贯性122024年一项关于抽象式摘要生成的综合调查显示,事实一致性是一项根本性挑战,并提倡采用强化学习(RL)以促进生成真实可靠的摘要。该调查建议对事实一致的摘要给予奖励,并引入外部知识源和属性控制以提高准确性13. 基于人类反馈的强化学习(RLHF)通过在人类偏好数据上训练奖励模型,并对摘要生成器进行微调以最大化该学习到的奖励,从而扩展了这一思想9基于人类反馈的强化学习(RLHF)已逐渐被用于使模型输出与期望特性(如事实性和有用性)保持一致4,14.尽管多-奖励的强化学习(RL)和基于人类反馈的强化学习(RLHF)虽能将模型与人类对保真度的认知对齐,但它们依赖于ROUGE或二元事实性等粗糙的评估指标。相比之下,本文提出的方法采用细粒度的实体级别幻觉指数作为奖励信号,该方法具有实证基础,计算成本较低,且无需人类反馈。
尽管已有多种评估指标,但仍存在若干局限性。N-gram 指标忽略了语义正确性,基于问答(QA)和基于信息抽取(IE)的指标会从问题生成和信息抽取模型中传播错误,而自然语言推断(NLI)指标则将事实性简化为二元的蕴含判断1,4,6。相关研究强调,现有的基于模型的评估指标难以在细粒度层面识别幻觉现象,因为它们通常在句子或文档级别上运行,无法分离出导致错误的具体实体4。人工评估仍是金标准,但成本高昂且具有主观性15。此外,现有指标未能区分内在幻觉与外在幻觉,也无法捕捉关系的过度关注或关注不足1。大语言模型可能产生幻觉,是因为其文本生成依赖于统计可能性而非事实验证。由于训练数据的局限性、概率性生成机制以及缺乏事实核查,模型可能生成看似自信但实际错误的输出;而过度自信和偏见可能导致模型以极高的确定性陈述虚假信息;相关指南建议采用检索增强生成和长期记忆机制,使模型建立在外部数据基础之上15。然而,这些技术主要聚焦于基于检索的任务;摘要生成仍需要能够识别并惩罚幻觉实体的评估指标。 先前的研究已认识到实体级别评估在事实性判断中的重要性。FEQA 和 QuestEval 等指标尝试利用问答技术来评估事实一致性16,17。然而,这些方法通常依赖参考摘要或外部问答系统,限制了其可扩展性。本研究在此基础上进一步推进,采用实体幻觉指数(Entity Hallucination Index, EHI)这一轻量级实证指标,专注于命名实体的忠实性,通过将实体划分为五类幻觉因素,如图1所示。
研究表明,幻觉现象普遍存在,现有评估指标尚不完善,而强化学习技术缺乏细粒度的奖励机制。人类实验显示,摘要模型在相当一部分情况下会出现幻觉,常常混淆实体或捏造细节9。当前的评估指标要么侧重于n-gram重叠,要么将事实性视为二元判断,而现有的强化学习方法则优化ROUGE分数或粗糙的事实性信号。在实体层面,尚缺乏能够衡量以下情形的评估指标:摘要提及了原文中不存在的实体(负向幻觉)、遗漏关键实体(焦点丢失幻觉)以及其他相关场景。本文提出的基于实体幻觉指数(Entity Hallucination Index, EHI)的微调方法填补了这一空白,通过在实体层面对幻觉进行量化,并为强化学习提供结构化奖励。通过将EHI整合到基于人类反馈的强化学习(RLHF)中,我们旨在微调大语言模型,以最小化实体层面的幻觉,生成既流畅又事实准确的摘要。
在本研究中,我们提出了一种新颖的微调方法,该方法利用实体幻觉指数(Entity Hallucination Index, EHI)作为奖励信号,以减少实体层面的幻觉现象。EHI 通过将模型输出中提取的实体与输入文档中实际存在的实体进行比较,量化实体的正确性和可追溯性,从而降低对参考文本的依赖18。本文所述方法引导模型生成在实体上更具忠实性的摘要,且无需依赖人工标注的事实性标签。
综上所述,具备事实感知能力的奖励模型已被用于微调19,20。与以往依赖粗粒度事实性奖励或人工标注数据集的方法不同,我们提出使用EHI作为直接且自动的奖励信号进行微调,从而在无需额外监督的情况下促进基于实体的摘要生成。本研究的创新贡献如下:(i)本研究引入了一种由EHI引导的微调框架,可提升抽象式摘要中的实体保真度;(ii)本研究提出了一种可扩展的强化学习流程,无需依赖人工标注的事实性数据集;(iii)本研究在会议转录数据集、XSUM新闻数据集上验证了EHI评分的实证提升效果,并通过定性分析突出展示了幻觉现象的减少;(iv)本研究共享了一个基于Colab的可复现实现 ,以推动面向幻觉感知摘要生成的进一步研究21。
本研究验证了以下假设:通过使用EHI等细粒度、以实体为中心的奖励机制来优化语言模型,可在计算资源消耗极小的情况下,有效提升摘要任务中的忠实性和可靠性。该方法通过以下三个方面,推动了摘要忠实性领域中参数高效微调技术的发展:(i)在编码器-解码器架构(DistilBART、FlanT5)和仅解码器架构(Mistral)上均展现出有效性;(ii)提供了一个可适配于不同模型类型、领域和规模的通用框架;(iii)相较于完全重新训练,具有更高的计算效率。
访问受限。请登录或开始试用以查看此内容。
方案
本研究的目的是微调一个语言模型(LM),以生成实体幻觉更少的摘要。当模型“自信地生成不正确或不相关的输出”时,就会发生幻觉现象,这是因为模型根据统计可能性生成文本,而非基于事实验证。为此,我们设计了一种基于实体幻觉指数(EHI)的奖励函数,并应用强化学习来最大化该函数。
问题构建
给定输入文档 Xi,目标是生成一个摘要 Yi,使得 Yi 中提到的实体均能在 Xi 中找到依据。传统的最大似然训练并未显式优化事实一致性,这类训练方法不会对引入虚构实体的行为进行惩罚。因此,引入一种基于奖励的微调策略,其中奖励与实体保真度成正比,通过 EHI 进行度量。
数据集与方法
使用了两个语料库:首先是包含多轮会议转录文本及其摘要式人工参考摘要的对话转录数据集;其次是XSUM新闻摘要基准数据集22,23。每个数据集均经过清洗、展平处理,并按80%训练集、10%验证集和10%测试集进行划分。对话文本包含大量非正式语言和代词,而XSUM则包含简洁的新闻文章;该组合使我们能够评估模型在领域内和跨领域的泛化能力。
对源文档和摘要均进行实体提取,以计算实体幻觉指数(EHI)。在微调过程中,本研究仅使用训练集部分,同时监控验证集上的EHI得分以选择最佳检查点。最终评估结果基于保留的测试集报告,该测试集在模型微调前后始终处于零样本状态。
总之,首先将转录本整理为扁平化格式并划分数据。预训练模型生成基线摘要。其次,利用基于 Transformer 的命名实体识别(NER)和五个幻觉因子计算 EHI。在微调过程中,通过 LoRa 适配器利用 EHI 奖励更新模型。最后,使用微调后的模型生成摘要,并通过 EHI、实体 F1 值及其他指标进行评估(图 2)。所有实验均可通过提供的代码和配置文件复现。图 3 展示了数据集准备、基线摘要生成、EHI 计算、微调及评估的逐步流程。
基线摘要
选择三种预训练的大语言模型,并获取其基线摘要结果:Flan-T5、Mistral(Nous-Hermes-2-Mistral-7B-DPO)和 DistilBART24,25,26。每个模型均以零样本模式运行,为每篇输入文档(xi)生成初始摘要(Yi)。采用束搜索(束宽为4,长度惩罚系数为1.0),以生成流畅且简洁的摘要。这些基线摘要用于评估幻觉现象的普遍程度,并为后续微调提供起点。
实体抽取与 EHI 计算
准确计算实体幻觉指数(Entity Hallucination Index, EHI)需要强大的命名实体识别(NER)支持。最初,使用 Spacy 进行 NER 操作。尽管已知基于 Transformer 的 NER 模型更为准确,但选择 Spacy 作为初始方案基于以下原因:(1)基于 Transformer 的 NER 模型本身已被证明比 Spacy 更容易产生幻觉;(2)Spacy 作为统计模型,在实现成本和执行时间方面具有计算效率优势;(3)这也有助于证明即使使用较弱的 NER 模型,EHI 仍能在降低幻觉方面保持稳健性。然而,考虑到实验所用数据集为已建立的基准数据集,且 spaCy 的 en_core_web_sm 模型在口语化转录文本上表现脆弱13,因此改用基于 Transformer 的 NER 模型(dslim/bert-base-NER),该模型是在 CoNLL-2003 数据集上微调的 BERT 模型。基于 BERT 的 NER 系统在特定领域任务中已被证明优于 spaCy 模型——例如,在识别 17 类实体时,航空领域专用的 Aviation-BERT-NER 模型达到了 94.78% 的 F1 分数,而 spaCy NER 仅识别出 7 类实体,F1 分数为 93.73%27。该 BERT NER 模型通过 Hugging Face Transformers28 配置,并执行不区分大小写的匹配。为捕捉代词及表层形式的变体,该方法额外应用了简单规则,将“Mr. Smith”和“Smith”映射至同一规范形式;但完整的共指消解仍留待后续研究。在 XSUM 数据集的 200 条记录样本上,不同 NER 模型的对比分析结果可参见表 1。
实体幻觉指数(EHI)的计算公式为:
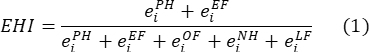
其中 PH、EF、OF、NH、LF 分别表示文章 i 的正向幻觉(Positive Hallucination, PH)、提取因子(Extractiveness Factor, EF)、负向幻觉(Negative Hallucination, NH)、过度关注实体(Overfocused Entities, OF)和丢失关注(Lost Focus, LF)的对应得分。
幻觉因素的详细信息:
正性幻觉(PH):用于衡量新引入的实体,这些实体在事实上是正确的且具有益处。
提取度因子(EF):用于衡量从输入文档中准确提取到摘要中的实体数量。
负性幻觉(NH):捕捉那些不正确或未基于输入内容的幻觉生成实体。
过度关注(OF):惩罚那些过度集中于少数实体而忽略多样性的摘要。
丢失重点(LF):对摘要中遗漏输入内容中重要实体的情况进行惩罚。
上述各项因子的计算方法详见图4,并附有示例计算以作说明。以输入文档实体(I)为例:“John”、“AI”、“conference”;参考摘要实体(R):“John”、“AI”;生成摘要实体(G):“John”、“AI”、“technology”。EHI 值越高,表示实体忠实度越好,既奖励具有提取性的摘要,也奖励正向幻觉(引入有用但忠实的实体),同时惩罚无依据、过度或遗漏的实体20。这些因子通过检测到的实体总数进行归一化处理,从而生成介于 0 到 1 之间的 EHI 分数。在训练过程中通过监控 EHI 验证结果来选择最优检查点。PH 和 EF 用于奖励有益的新实体和正确提取,而 OF、NH 和 LF 则用于惩罚重复、虚构和遗漏。得分为 1.0 表示摘要中的所有实体均有据可依或为有益幻觉,得分为 0 则表示摘要中未出现任何源文本中的命名实体。
基于强化学习的微调流程
微调的详细超参数配置将单独提供 表2,表3, 和 表 4,分别展示了 Mistral-7B、DistilBart 和 Flan-T5 的优化器类型、学习率、批量大小、硬件配置及其他配置细节。此处的目标是微调模型参数 θ 通过最大化生成摘要的预期实体幻觉指数(EHI)奖励。形式上,对于输入文档 Xi,生成的摘要 Yi和模型参数 θ 预期奖励目标定义为:
 (2)
其中 EHI (y, x) 表示在生成的摘要 Yi 与输入 Xi 之间计算的实体幻觉指数。
根据 REINFORCE 算法25,该目标函数的梯度估计为:
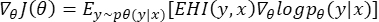 (3)
在实际操作中,从模型中采样生成摘要,计算其对应的EHI分数,并应用策略梯度更新以鼓励产生更高奖励的输出。为实现参数高效的微调,本研究采用了低秩适应(Low-Rank Adaptation, LoRA)方法,仅更新LoRA适配器,而保持基础模型权重冻结。微调在A100 GPU上进行,使用较小的学习率(例如 5 × 10⁻⁶)、批量大小为4,并通过Adam优化器在8个步骤上累积梯度29。每500次更新后重新生成摘要,以刷新奖励估计值,训练持续至验证集EHI收敛。REINFORCE基线设定为近期奖励的滑动平均值,以降低方差。除EHI外,还记录了实体F12、ROUGE-1/2/L分数以监控生成摘要的整体质量。摘要会定期重新生成,以反映微调过程中模型的改进情况。
评估指标
使用诸如 Rouge-1、Rouge-25 等信息性指标对输出结果进行评估。使用如 Rouge LCS5 等流利度指标。实体重叠指标采用 Entity F1,幻觉指标则包括 EHI、FactCC 和 QAGS2,6,18,30。FactCC 使用在合成矛盾数据上训练的分类器,将句子标记为与源文本蕴含或矛盾。FactCC 提供两个分数;本文记录的是标签为 VALID 时的分数。另一方面,QAGS 采用基于大语言模型(LLM)的问答方法。使用轻量级模型 T5 small 生成文本相关问题31,使用 Roberta_base_Squad2 在输出文本上生成答案32。选择这些模型是因为其执行时具有较低的计算成本。
访问受限。请登录或开始试用以查看此内容。
结果
本实验重点在于提供定量证据,以证明基于实体幻觉指数(EHI)引导的微调在多种模型架构和数据集上对降低实体级幻觉的影响。结果表明,幻觉相关指标持续改善,同时保持了事实一致性并保留了问答能力。
数据集性能
对话数据集性能:
表5展示了在多轮对话数据集上降低幻觉的实验结果。采用EHI引导的微调方法在Mistral和DistilBART模型上均取得了显著提升:
Mistral 的 EHI 分数实现了 57.8% 的相对提升,从 0.346 上升至 0.546;而 DistilBART 展现了 61.5% 的相对提升,从 0.317 增加到 0.512。两个模型在事实一致性方面均表现出稳定提升,FactCC 分数分别提高了 36.6% 和 64.4%。在问答性能方面,QAGS 结果呈现出混合模式:Mistral 出现了小幅下降,降幅为 5.7%;DistilBART 保持稳定,略有提升,增幅为 3.3%;Flan-T5 ...
访问受限。请登录或开始试用以查看此内容。
讨论
基于问答的指标(例如 FEQA/QuestEval/QAFactEval)和基于自然语言推理的指标(例如 FactCC/SummaC)需要辅助的问答或蕴含判断组件,且通常提供句子级别的评估结果。相比之下,EHI 是一种轻量级、无需参考文本、面向实体层级的评分方法,它(i)直接针对我们观察到的主要错误模式——实体幻觉;(ii)与模型无关且计算速度快;(iii)可作为强化学习微调的密集奖励信号。实验表明,EHI 通过精确定位导致事实性错误的实体,补充了问答类和推理类指标的不足,能够在不引入复杂的问答或蕴含判断流程的前提下实现有针对性的改进。
强化学习框架通过使用实体幻觉指数(Entity Hallucination Index, EHI)作为密集奖励信号,直接优化实体忠实性18。该指标量化了生成摘要中命名实体的存在性、正确性和可追溯性,并按类型和严重程度对幻觉进行分类。在微调过程中,使用EHI对基线摘要进行评分,并通过强化学习促使模型最大化该指标,从而将生成过程调整为输出实体忠实的结果,而无需依赖人工标注。与句子级别的问答或蕴含评分相比,...
访问受限。请登录或开始试用以查看此内容。
披露
作者无任何利益冲突需要披露。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| Colab NVIDIA A100 GPU | NVIDIA | N/A | Google Colaboratory Pro |
| DistilBART(编码器)–解码器 | Hugging Face | https://huggingface.co/sshleifer/distilbart-cnn-12-6 | |
| dslim/bert-base-NER | Hugging Face (dslim) | https://huggingface.co/dslim/bert-base-NER | 微调 BERT base 以用于英文命名实体识别 |
| 评估模型 基于问答的 QAGS | Salesforce 研究 | N/A | 事实性分类器 |
| 评估模型(事实性)FactCC | 谷歌研究 | N/A | 事实性分类器 |
| Flan-T5(编码器–解码器 | https://huggingface.co/docs/transformers/main/zh/model_doc/flan-t5 | 开源、文本到文本、大语言模型 | |
| Hugging Face Transformers | Hugging Face, Inc. | https://huggingface.co/docs/transformers/index | 模型加载 &和微调 |
| Nous-Hermes-2-Mistral-7B-DPO | Mistral | https://huggingface.co/NousResearch/Nous-Hermes-2-Mistral-7B-DPO | 70亿参数语言模型 |
| 编程语言 Python 3.10(Colab 运行时) | Python 软件基金会 | 3.10 版本 | 核心实现 |
| Streamlit | 开源 | https://streamlit.io/ | 事实性分类器 |
| XLSUM 数据集 | BUET | https://github.com/csebuetnlp/xl-sum | |
| XSUM 数据集 | 爱丁堡大学 | https://github.com/EdinburghNLP/XSum |
参考文献
- Maynez, J., Narayan, S., Bohnet, B., McDonald, R. On faithfulness and factuality in abstractive summarization. Proc Annu Meet Assoc Comput Linguist. 2020, 173-173 (2020).
- FEQA: A question answering evaluation framework for faithfulness assessment in abstractive summarization. Durmus, E., He, H., Diab, M. Proc Conf Empir Methods Nat Lang Process, , 454-454 (2020).
- A short summary of automatic summarization. NLG Blog. , Andong. https://andongluis.github.io/nlg-blog/Summarization-post/ (2018).
- Understanding factuality in abstractive summarization. Pagnoni, A., Padmakumar, V., May, J. Proc Conf North Am Chapter Assoc Comput Linguist Hum Lang Technol, 2021, 4812-4829 (2021).
- Lin, C. Y. ROUGE: A package for automatic evaluation of summaries. Workshop Text Summarization Branches Out. 2004, 74-81 (2004).
- Evaluating the factual consistency of abstractive text summarization. Kryściński, W., McCann, B., Xiong, C., Socher, R. Proc Conf Empir Methods Nat Lang Process, 2020, 750-750 (2020).
- Goyal, T., Durmus, E., Cardie, C. Fact checking summarization with self supervised and few shot learning. Proc Annu Meet Assoc Comput Linguist. 2022, 564-579 (2022).
- QuestEval: Summarization asks for fact-based evaluation. Scialom, T., Dray, P. A., Lamprier, S., Piwowarski, B., Staiano, J., Wang, A., Gallinari, P. Proc Conf Empir Methods Nat Lang Process, 2021, 6594-6604 (2021).
- Mukesh, K. Hallucinations in abstractive summarization. Medium. , https://medium.com/@mukesh.kr/hallucinations-in-abstractive-summarization-b5904bc1c5c5 (2023).
- Factual error correction for abstractive summarization models. Cao, M., Dong, Y., Wu, J., Cheung, J. C. K. Proc Conf Empir Methods Nat Lang Process, 2020, 6251-6258 (2020).
- Yan, E. Evaluation & hallucination detection for abstractive summaries. , https://eugeneyan.com/writing/abstractive-summarization-evaluation/ (2021).
- Uekawa, A. Evaluation metrics for summarization. , https://dev.to/akuer/evaluation-metrics-for-summarization-1d7f (2023).
- Honnibal, M., Montani, I. spaCy 2: Natural language understanding with Bloom embeddings convolutional neural networks and incremental parsing. Zenodo. , (2017).
- Reinforcement learning from human feedback: Aligning large language models. , At https://neptune.ai/blog/reinforcement-learning-from-human-feedback (2023).
- Shakil, H., Farooq, A., Kalita, J. Abstractive text summarization: State of the art, challenges, and improvements. Neurocomputing. 603, 128255-128255 (2024).
- AI, Z. Reducing LLM hallucinations: A developer's guide. GetZep. , https://www.getzep.com/ai-agents/reducing-llm-hallucinations/ (2025).
- Ouyang, L., et al. Training language models to follow instructions with human feedback. Adv Neural Inf Process Syst. 2022, 27730-27744 (2022).
- Entity hallucination index in abstractive summarization-A metric. Praveenkumar, K., Balbantaray, R. C., Vittala, K. P. Proc Int Conf Commun Circuits Syst, 2023, 1-5 (2023).
- Multi-reward reinforced summarization with saliency and entailment. Pasunuru, R., Bansal, M. Proc Conf North Am Chapter Assoc Comput Linguist Hum Lang Technol, 2018, 646-653 (2018).
- Williams, R. J. Simple statistical gradient-following algorithms for connectionist reinforcement learning. Mach Learn. 8 (3-4), 229-256 (1992).
- Katwe NLP. EHI_XLSUM_XSUM_Finetuning. , GitHub. https://github.com/katweNLP/EHI_XLSUM_XSUM_Finetuning (2025).
- ELITR minuting corpus: A novel dataset for automatic minuting from multi-party meetings in English and Czech. Nedoluzhko, A., Singh, M., Hledíková, M., Ghosal, T., Bojar, O. Proc Int Conf Lang Resour Eval (LREC), 2022, 2623-2632 (2022).
- Don't give me the details, just the summary! Topic aware convolutional neural networks for extreme summarization. Narayan, S., Cohen, S. B., Lapata, M. Proc Conf Empir Methods Nat Lang Process, 2018, 1797-1807 (2018).
- Lewis, M., et al. Denoising sequence to sequence pre training for natural language generation, translation, and comprehension. Proc Annu Meet Assoc Comput Linguist. 2020, 7871-7880 (2020).
- Chung, H. W., et al. Scaling instruction fine-tuned language models. J Mach Learn Res. 25 (1), 1-53 (2024).
- Jiang, A. Q., et al. Mistral 7B. arXiv. , (2023).
- Chandra, C., Ojima, Y., Bendarkar, M. V., Mavris, D. N. Aviation BERT NER: Named entity recognition for aviation safety reports. Aerospace. 11 (11), 890-890 (2024).
- Lim, D. S. bert-base-NER. , https://huggingface.co/dslim/bert-base-NER (2021).
- Adam: A method for stochastic optimization. Kingma, D. P., Ba, J. Int Conf Learn Represent, , (2015).
- QAGS: Evaluating question answering and generation for summarization. Wang, A., Cho, K. Proc Conf Empir Methods Nat Lang Process, 2020, 390-402 (2020).
- Patil, S. valhalla/t5-small-qg-hl. , https://huggingface.co/valhalla/t5-small-qg-hl (2020).
- deepset/roberta-base-squad2. , Deepset GmbH. https://huggingface.co/deepset/roberta-base-squad2 (2020).
- Factually consistent summarization via reinforcement learning with textual entailment feedback. Roit, P., et al. Proc Annu Meet Assoc Comput Linguist, 2023, 8027-8044 (2023).
- Hallucination diversity aware active learning for text summarization. Xia, Y., et al. Proc Conf North Am Chapter Assoc Comput Linguist Hum Lang Technol, 2024, 3885-3900 (2024).
- Wei, Z., et al. TruthRL: Incentivizing truthful large language models via reinforcement learning. arXiv. , (2025).
访问受限。请登录或开始试用以查看此内容。
重印与许可
