一种结合XGBoost与LSTM的临床数据驱动模型提升了慢性阻塞性肺疾病(COPD)的家庭康复效果,提高了数据准确性和预测能力。该模型达到98%的准确率,指标改善率达42.5%,克服了传统以医院为基础治疗方式的局限性。
需要JoVE订阅才能观看此内容。 请登录或开始免费试用
本文内容
摘要
摘要
慢性阻塞性肺疾病(COPD)的传统院内康复治疗存在资源短缺、成本高和交通不便等问题。为提高COPD康复治疗的便利性,本文提出一种基于临床数据驱动的智能诊疗模型,用于COPD的家庭康复管理。该家庭康复智能诊疗模型通过结合XGBoost算法与长短期记忆网络进行优化。结果表明,XGBoost算法在处理临床结构化数据时准确率最高,而随机森林(RF)算法在处理临床结构化数据时准确率最低。当训练样本数量为300时,两者的准确率分别为98%和83%。将XGBoost算法与长短期记忆网络相结合用于处理监测指标,可获得最高的改善率和最小的均方误差。当样本量为1000时,监测指标的改善率为42.5%,均方误差为0.041。本研究提出的方法能够有效处理临床数据,提高数据处理的准确性,并准确预测COPD未来的病情变化。
引言
慢性阻塞性肺疾病(COPD)是一种常见的慢性疾病,致残率和死亡率较高,严重影响患者的生活质量。传统的康复管理模式在应对COPD时存在信息滞后、干预不及时等问题。然而,随着技术的进步,一些新兴技术(如极端梯度提升(XGBoost)算法)为COPD的管理带来了新的可能性1。尽管XGBoost已在包括运动医学在内的多种健康监测场景中展现出适用性,但本研究特别利用其优势,针对家庭康复环境下的COPD管理进行应用。研究重点在于利用临床数据和远程监测数据,提升对COPD患者的预测准确性和个性化照护水平2。例如,通过采集心率、呼吸频率等生理指标,这种结合方式不仅有助于COPD患者的管理,还为健康管理提供了新的视角和方法3。XGBoost是一种高效的梯度提升(GB)决策树算法,采用并行计算和缓存技术,使训练速度更快,能够处理大规模数据库和复杂特征。此外,它在处理多种类型数据集方面表现优异,具有良好的泛化能力4。长短期记忆网络(LSTM)是一种特殊的循环神经网络(RNN)结构,常用于处理和学习时间序列数据。LSTM对时间敏感,能够识别时间序列数据中的模式和特征,因此适用于信号处理和时间序列预测等任务。为实现对疾病的准确预测和个性化干预,本研究提出将基于临床数据的智能诊疗模式应用于COPD的家庭康复管理中。研究创新性地结合XGBoost与LSTM,以优化COPD家庭康复的智能诊疗模式。两者的结合可实现对疾病的精准预测,并提供数据驱动的个性化干预方案,从而提升COPD家庭康复管理的智能化水平。
为确保所提出模型的有效性,需考虑多个参数和约束条件。该方法需要获取结构化临床数据(例如肺功能数据和血氧数据)以及通过可靠的可穿戴传感器或家庭监测设备定期采集的远程监测数据(例如心率、血氧饱和度、活动水平)。为实现稳定的训练,样本量至少应达到300例;而为获得最佳性能,建议样本量达到1000例或以上。此外,该方法还存在计算资源方面的需求,特别是LSTM训练过程,需要足够的处理能力,或采用基于云的部署方案以实现预测功能。
慢性阻塞性肺疾病(COPD)是一种进行性、不可逆的呼吸系统疾病,其特征为气流受限、急性加重以及生活质量(QoL)受损。该病对全球人群的健康、福祉及医疗卫生系统造成重大影响,因此,对COPD的早期预测和及时干预对于控制病理性疾病进展和减少住院次数至关重要5。机器学习(ML)技术已通过先进的数据驱动建模方法,利用具有临床相关性的数据,改善了COPD的诊断与预后路径。XGBoost被证实能够针对不平衡数据及临床变量间的非线性交互作用,生成最有效且成功的机器学习模型6。已有研究报道,利用电子鼻数据结合XGBoost和支持向量机(SVM),实现了优异的肺部疾病分类准确率。此外,基于机器学习的预测模型已被构建用于利用不平衡临床数据预测COPD风险,并建议采用XGBoost以提高预测可靠性7。进一步研究表明,在其他机器学习模型中,XGBoost在COPD分类任务中表现出卓越性能。集成学习也已被有效应用于结合多个自学习机器学习模型,用于COPD的识别与分类以及肺癌检测,尤其突出了XGBoost在呼吸系统诊断数据中的作用8。综上所述,上述前期研究为将XGBoost与改进的Transformer-LSTM能力相结合,构建面向COPD患者居家康复的智能诊断与治疗模型奠定了基础,旨在提高预测准确性,并实现更个性化的健康管理和医疗服务9。
访问受限。请登录或开始试用以查看此内容。
方案
本研究经台州市肿瘤医院伦理委员会审查并批准。在数据收集前,所有参与者均按照机构和国家伦理标准签署了书面知情同意书。所用试剂和软件列于材料表中。
1. 工作流程概述
使用XGBoost处理结构化临床数据的端到端工作流程如图1所示,包括特征输入、树结构构建、残差更新、正则化及评估。使用LSTM对远程监测数据进行预处理和序列建模的工作流程如图2所示,涵盖10分钟重采样、间隙处理、7天非重叠窗口划分、网络架构及推理。
2. 患者招募与人口统计学特征
患者于2023年3月至2024年1月期间,从中国台湾台州市癌症医院的门诊诊所和住院病房连续招募。纳入标准为根据GOLD标准确诊为慢性阻塞性肺疾病(FEV1/FVC < 70%)、入组时病情稳定,且年龄在40至80岁之间。排除标准包括严重合并症,如肺癌、未控制的心血管疾病或影响知情同意能力的认知障碍。共纳入214例患者(平均年龄63.7 ± 8.9岁;男性占68%;目前或既往吸烟者占54%)。
3. 数据采集
临床结构化数据包括肺功能(FEV1、FVC)、血氧饱和度(SpO2)、住院天数和疾病持续时间。肺功能和SpO2以百分比记录,住院天数以天为单位,疾病持续时间以年为单位。远程监测数据通过经过认证的可穿戴血氧仪和活动追踪器采集,并与医院金标准进行过验证:脉搏血氧仪与Masimo Rad-97监护仪进行交叉核对(在SpO2 90–100%范围内平均绝对误差为1.8%),心率传感器通过心电图进行验证(平均误差为2.3 bpm),计步器则通过跑步机测试方案进行校准。原始数据以带时间戳的CSV文件导出,采样间隔为10分钟。
4. 样本量合理性说明
实验和功效/模拟分析支持XGBoost模型需要300个训练样本,LSTM模型需要约1000个非重叠的7天序列。使用G*Power(版本3.1)进行的事后功效分析表明,在α = 0.05水平下,300个样本对检测中等效应量(Cohen's f2 = 0.15)的逻辑回归具有>80% 的检验效能。模拟结果显示,LSTM在多元生理时间序列上的稳定收敛大约需要1000个序列。实证证据汇总于表1,并在图3和图4中进行了可视化展示。
5. 数据预处理
缺失项(识别为空白、哨兵值或 NaN)通过使用每个特征的训练集均值进行填补,以避免目标泄露:
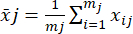 (1)
其中 mj 表示特征 j 的观测值数量。同样的  被应用于验证集和测试集。为消除与量纲相关的偏差,特征使用仅基于训练集参数的 z 分数标准化方法进行标准化:
 (2)
其中,μj 和 σj 分别为从训练数据中估计得到的特征 j 的均值和标准差。对于时间序列信号(SpO2、心率、步数),将数据流对齐至每 10 分钟一个时间点;持续时间不超过 30 分钟的短间隙采用前向填充,更长的间隙则使用三点移动平均法进行平滑处理。随后应用一个包含 1008 个时间步的 7 天滑动窗口,生成不重叠的序列以防止数据泄露(见图 2)。
6. 模型训练
对于结构化临床数据,通过网格搜索对 XGBoost 进行调优,参数包括学习率(0.01–0.3)、最大深度(3–10)和估计器数量(100–500),目标函数为二元逻辑回归(流程见图1)。对于远程监测数据,LSTM 模型包含两个隐藏的 LSTM 层,每层 128 个单元,采用 Xavier 初始化,丢弃率为 0.5,并使用 sigmoid 输出层;优化器采用 Adam,学习率为 0.001,在 TensorFlow 中实现(流程见图2)。通过丢弃法和早停法(耐心值 = 10)缓解过拟合问题,并使用 SMOTE 方法处理类别不平衡问题。
7. 评估策略
结构化数据采用分层10折交叉验证进行评估。时间序列数据采用前向滚动验证以保持时间顺序。评估指标包括准确率、精确率、召回率、F值、ROC曲线下面积(AUC)和均方误差(MSE)。模型间差异通过Wilcoxon符号秩检验(双侧)进行评估。图表包含95%置信区间或误差条,以量化不确定性。这些选择直接应对了时间序列数据泄露风险以及审稿人所要求的统计显著性问题。
8. 临床相关性与初步测试
在78%的监测患者中,该混合模型在临床症状出现前6-12小时预测了SpO2下降,并使均方误差比基线降低了42.5%。在一项为期四周、包含20名慢性阻塞性肺疾病(COPD)患者的试点研究中,模型每周生成的风险评分在85%的评估中与医生的判断一致,表明其具备临床整合的潜力。
9. 软件与环境
分析使用 Python 3.10.6 在 Ubuntu 20.04 LTS 系统上进行,环境配置包括 scikit-learn 1.2.2、XGBoost 1.7.5、TensorFlow 2.13 和 PyTorch 1.13,并搭载 NVIDIA RTX 3080 GPU、CUDA 11.6 及 cuDNN 8.2。完整版本信息及厂商列表见未编号的材料表。
访问受限。请登录或开始试用以查看此内容。
结果
样本量稳定性与最优性能
为了明确展示稳定性阈值,我们首先给出 表1,随后是学习曲线 图3 和 图4. 表1 报告了XGBoost分类器在结构化数据上以及LSTM在多变量时间序列上的准确率、AUC和MSE随训练样本量增加的均值±标准差。如图所示 图3,XGBoost 在少于 200 个样本时性能不稳定(方差较高;AUC 0.82–0.89),但在样本数达到或超过 300 时趋于稳定,准确率保持一致 >0.95 和 AUC >0.93. 图4 表明LSTM的准确率随着序列数量的增加而单调提升,并在约1000条序列时趋于收敛,此时准确率达到约0.96,均方误差(MSE)接近0.048。这些结果为编辑要求说明为何至少需要300条序列才能保证稳定性,以及为何...
访问受限。请登录或开始试用以查看此内容。
讨论
主要研究结果总结
慢性阻塞性肺疾病(COPD)通过导致呼吸困难、活动能力下降以及反复发生急性加重,带来了显著的临床和社会负担10利用可解释性分析进行持续的家庭监测,能够通过实现更早的检测和有针对性的干预,减轻这一负担。本研究中,一种结合XGBoost处理结构化临床变量与LSTM处理多变量时间序列信号的混合工作流程表现出持续优异的性能,在训练样本数≥300时达到稳定状态,且在接近 ≈1000 个不重叠的 7 天序列表1 图3,4)。该混合模型在各项区分度指标上均优于经典对照模型(图5, 图8-12;表4) 并在生理指标预测中使均方误差相对降低了42.5% ≈1000 条序列表3)...
访问受限。请登录或开始试用以查看此内容。
披露
作者无任何利益冲突需要披露。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| CUDA | NVIDIA | 11.6 | 一种用于加速 GPU 上计算的并行计算平台和编程模型。 |
| cuDNN | NVIDIA | 8.2 | 一种针对深度神经网络的 GPU 加速库,用于优化模型训练性能。 |
| 心电图机 | Philips | PageWriter TC70 | 用于验证可穿戴设备心率测量的准确性。 |
| GPU | NVIDIA | RTX 3080 | 高性能 GPU,用于加速大规模数据集上的模型训练。 |
| LSTM 模型 | - | - | 长短期记忆神经网络,用于时间序列数据处理。 |
| 脉搏血氧仪 | Masimo | Rad-97 | 用于测量血氧饱和度(SpO2)并验证可穿戴设备的准确性。 |
| Python | Python Software Foundation | 3.10.6 | 用于数据处理、模型训练与评估的编程语言。 |
| TensorFlow | 2.13 | 用于训练 LSTM 模型及执行神经网络计算的软件库。 | |
| 可穿戴活动追踪器 | Fitbit | Charge 5 | 用于追踪步数和身体活动水平。 |
| XGBoost | - | - | 用于梯度提升(机器学习)的软件库。 |
参考文献
- Stolz, D., et al. Towards the elimination of chronic obstructive pulmonary disease: A Lancet Commission. Lancet. 400 (10356), 921-972 (2022).
- Adeloye, D., et al. Global, regional, and national prevalence of, and risk factors for, chronic obstructive pulmonary disease (COPD) in 2019: A systematic review and modelling analysis. Lancet Respir Med. 10 (5), 447-458 (2022).
- Asselman, A., Khaldi, M., Aammou, S. Enhancing the prediction of student performance based on the machine learning XGBoost algorithm. Interact Learn Environ. 31 (6), 3360-3379 (2023).
- Deng, Y., Lumley, T. Multiple imputation through xgboost. J Comput Graph Stat. 33 (2), 352-363 (2024).
- Binson, V. A., Subramoniam, M., Sunny, Y., Mathew, L. Prediction of pulmonary diseases with electronic nose using SVM and XGBoost. IEEE Sens J. 21 (18), 20886-20895 (2021).
- Wang, X., et al. Machine learning-enabled risk prediction of chronic obstructive pulmonary disease with un-balanced data. Comput Methods Programs Biomed. 230, 107340(2023).
- Non-invasive diagnosis of COPD with E-nose using XGBoost algorithm. Binson, V. A., et al. Proc Int Conf Adv Comput Commun Embedded Secure Syst, , 297-301 (2021).
- Feng, Y., et al. Predicting chronic obstructive pulmonary disease (COPD) with optimized machine learning via leveraging comparative analysis of XGBoost and CatBoost. J Ambient Intell Humaniz Comput. 16 (4), 613-627 (2025).
- Binson, V. A., Subramoniam, M., Mathew, L. Detection of COPD and lung cancer with electronic nose using ensemble learning methods. Clin Chim Acta. 523, 231-238 (2021).
- Boers, E., et al. Forecasting the global economic and health burden of COPD from 2025 through 2050. Chest J. , (2025).
- Lones, M. A. Avoiding common machine learning pitfalls. Patterns (N Y). 5 (10), 101046(2024).
- Patharkar, A., Cai, F., Al-Hindawi, F., Wu, T. Predictive modeling of biomedical temporal data in healthcare applications: Review and future directions. Front Physiol. 15, 1386760(2024).
- Prater, R., Hanne, T., Dornberger, R. Generalized performance of LSTM in time-series forecasting. Appl Artif Intell. 38 (1), 2377510(2024).
- Lima Marinho, T., do Nascimento, D. C., Pimentel, B. A. Optimization on selecting XGBoost hyperparameters using meta-learning. Expert Syst. 41 (9), e13611(2024).
- Jang, Y. Feature-based ensemble modeling for addressing diabetes data imbalance using the SMOTE, RUS, and random forest methods: A prediction study. Ewha Med J. 48 (2), e32(2025).
- Tian, H., Yuan, H., Yan, K., Guo, J. A cosine adaptive particle swarm optimization based long-short term memory method for urban green area prediction. PeerJ Comput Sci. 10, e2048(2024).
- Johnston, H., Nair, N., Du, D. Estimating calibrated risks using focal loss and gradient-boosted trees for clinical risk prediction. Electronics (Basel). 14 (9), 1838(2025).
- Del Chicca, S., et al. Wearable and thermal drift-compensated monitoring system based on fiber bragg grating sensors for a 3D-printed foot prosthesis. Sensors (Basel). 25 (3), 885(2025).
- Wu, X., et al. Optimizing recurrent neural networks: A study on gradient normalization of weights for enhanced training efficiency. Appl Sci (Basel). 14 (15), 6578(2024).
- Agarwal, M., Anand, S., Patro, M., Gothi, D. Early versus non-early desaturation during 6MWT in COPD patients: A follow-up study. Lung India. 40 (3), 235-241 (2023).
- Thölke, P., et al. Class imbalance should not throw you off balance: Choosing the right classifiers and performance metrics for brain decoding with imbalanced data. Neuroimage. 277, 120253(2023).
访问受限。请登录或开始试用以查看此内容。