本研究提出一种结合元蒸馏与元学习的轻量级图神经网络,以提升英文文本分类效果。该方法在低数据量和跨领域场景下增强了泛化能力,同时降低了计算成本并保持高性能。
需要JoVE订阅才能观看此内容。 请登录或开始免费试用
本文内容
摘要
摘要
全球化与信息技术的发展推动了英文文本数据的激增,对高效分类提出了迫切需求。为提升英文文本分类在小样本和跨领域场景下的泛化能力,并实现模型轻量化,本研究结合复杂系统理论与深度学习,构建了一种充分考虑文本样本分布特性的图神经网络模型。该方法采用结合元学习策略的两级元知识蒸馏方法,动态调整教师模型参数,优化整体知识迁移过程。实验结果表明,所提出模型在少样本与跨领域文本分类任务中的分类性能显著优于传统图神经网络及其他主流对比模型。在轻量化方面,通过两阶段元蒸馏机制生成的SM模型在多主题文本分类数据集上保持了极高的性能保留率,同时显著降低了计算时间。此外,该方法在长文本处理场景中仍能保持高效率与稳定的分类性能,在计算效率方面相较传统蒸馏方法及文献报道的其他方法具有明显优势。所提出的方法在显著降低计算成本的同时,有效提升了低样本量与跨领域应用场景下英文文本的分类性能,为资源受限环境中的英文文本分类提供了可行且高效的技术解决方案。
引言
全球化进程的加快以及信息技术的进步,导致社交媒体、学术研究和商业交流等领域中的英语文本数据呈爆炸式增长。高效地对这些文本进行分类,以实现信息检索、情感分析、内容管理等功能,已成为自然语言处理中的一项重要任务1。英语文本分类(ETC)的目标是根据文本的语义内容将其划分到预定义的类别中。然而,自然语言的复杂性,包括其歧义性、上下文依赖性以及表达方式的多样性,给文本分类任务带来了诸多挑战2。目前,深度学习(DL)技术的发展为文本分类带来了新的机遇。以基于Transformer的双向编码器表示(BERT)及其变体为代表的预训练语言模型,能够通过对大规模语料库的预训练学习丰富的上下文语义信息,显著提升文本分类的性能3。然而,现有的ETC方法仍面临两个关键局限:首先,这些方法通常强调单一模型或特征的优化,忽视了语言作为复杂系统所具有的内在特性,例如其动态性和涌现行为,导致在数据稀疏或跨领域场景下的泛化能力不足;其次,尽管预训练模型性能强大,但其高昂的计算成本和庞大的参数量严重阻碍了其在资源受限环境中的实际部署4,5。为解决上述问题,本研究提出一种融合复杂系统理论(CST)与两阶段元蒸馏机制(TSMDM)的轻量级文本分类框架。
在本....
访问受限。请登录或开始试用以查看此内容。
方案
为了提高ETC在小样本和跨领域场景下的泛化能力,并实现轻量化模型,本研究提出了一种融合CST与TSMDM的文本分类框架。该框架的整体流程如图1所示。
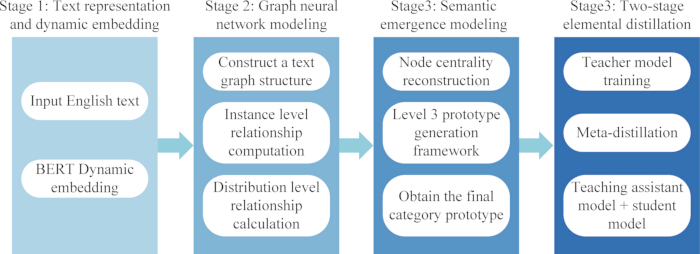
图1:集成CST与TSMDM的四阶段轻量级英文文本分类框架可视化。该工作流程包含四个阶段。第一阶段利用基于BERT的动态嵌入对输入的英文文本进行文本表示。第二阶段通过构建文本图并计算实例级和分布级关系,应用图神经网络建模。第三阶段通过节点中心性重构和多层次原型生成框架建模语义涌现,以获得最终的类别原型。第四阶段进行两阶段元素蒸馏,其中先训练教师模型,再通过元蒸馏实现知识迁移,生成最终的学生模型。
访问受限。请登录或开始试用以查看此内容。
结果
实验设置与数据集:
为全面评估所提出模型在小样本跨域分类任务中的性能及轻量化效率,本研究在四个数据集上进行了实验:FewRel(小样本关系分类)、ARSC(跨域情感分析)、Reuters-21578(多主题新闻分类)和 ArXiv(长篇学术摘要)。FewRel 是一个广泛使用的小样本关系分类数据集,源自 Wikipedia,包含 100 个语义关系类别(例如“商业/公司创始人”和“地点/国家首都”),每个类别包含 700 条高质量句子。ARSC 用于评估模型在真实世界跨域场景下的表现,涵盖 Amazon 平台上 23 个产品类别(如“图书”、“DVD”、“厨房电器”)的用户评论,构成 69 个二分类情感分析任务(正面/负面)。Reuters-21578 是一个经典的多类别新闻文档分类数据集,包含 21,578 篇路透社新闻文章,标注于 90 个存在重叠的主题类别(经济、政治、体育等)之下。此外,本研究还通过 ArXiv 公共 API 收集了计算机科学领域的论文摘要,构建了一个长文本分类数据集,用于测试模型处理长文本序列的计算效率。各数据集的样本示例如 表 1 所.......
访问受限。请登录或开始试用以查看此内容。
讨论
为了在少样本和跨领域场景下增强ETC的泛化能力,同时降低计算成本,本研究提出了一种结合CST与TSMDM的轻量级文本分类框架。将CST与TSMDM框架相结合,通过在模型设计中引入语言系统动力学和涌现语义特性,并实现高效的轻量化压缩知识迁移,从而解决了现有ETC方法的核心局限性(少样本/跨领域泛化能力差以及计算成本高)。这种设计上的协同效应是该模型在资源受限环境下性能优于传统方法的关键。
从理论上讲,将复杂系统理论(CST)引入文本分类超越了传统模型对局部语义或静态分布的依赖,为理解具有动态性和涌现性特征的语言这一复杂系统提供了新的计算建模视角31。在方法论上,所提出的分布感知图神经网络(GNN)与轻量级语义模型蒸馏框架(TSMDM)为少样本学习、跨域适应和模型压缩提供了一个协同优化的框架。实验结果表明,该模型在FewRel和ARSC等数据集上优于传统的GNN、BERT基线模型以及当前最先进的对比方法(表3),验证了其在少样本和跨域场景下的卓越泛化能力和效率。在FewRel的5类5样本任务中达到95.1.......
访问受限。请登录或开始试用以查看此内容。
披露
作者无任何利益冲突需要披露。
致谢
作者无任何致谢事项。
....访问受限。请登录或开始试用以查看此内容。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| 中央处理器(CPU) | 商用硬件供应商(Intel、Dell、Lenovo) | Intel i5-7300HQ | 硬件规格 |
| 图形处理器(GPU) | 商业硬件供应商(NVIDIA,ASUS) | NVIDIA GeForce RTX 3060,12 GB VRAM | 硬件规格 |
| 随机存取存储器(RAM) | 商业硬件供应商 | 16 GB DDR4 | 硬件规格 |
| 固态硬盘(SSD) | 商业硬件供应商 | 1 TB NVMe 固态硬盘 | 硬件规格 |
| 操作系统 | 微软官方网站 | Windows 10(64 位) | 系统软件 |
| Python | Python 官方网站 (python.org) | Python 3.8 | 编程语言 |
| PyTorch | PyTorch 官方网站 (pytorch.org) | PyTorch 1.11.0 | 深度学习框架 &和核心文库 |
| CUDA | NVIDIA 官方网站 | CUDA 11.3 | 深度学习框架 &核心合集 |
| Hugging Face Transformers | Hugging Face Hub (huggingface.co) | 稳定版本(适配 Python 3.8/PyTorch 1.11.0) | 深度学习框架 &和核心文库 |
| NumPy | PyPI (pypi.org) | 稳定版本(适配 Python 3.8) | 数据处理 &和统计库 |
| Pandas | PyPI (pypi.org) | 稳定版本(适配 Python 3.8) | 数据处理 &和统计库 |
| Scikit-learn | PyPI (pypi.org) | 稳定版本(适配 Python 3.8) | 数据处理 &和统计库 |
| SciPy | PyPI (pypi.org) | 稳定版本(适配 Python 3.8) | 数据处理 &和统计库 |
| Matplotlib | PyPI (pypi.org) | 稳定版本(适配 Python 3.8) | 可视化库 |
| AdamW | PyTorch 内置 | 集成于 PyTorch 1.11.0 | 优化器 |
| BERT | Hugging Face Hub (huggingface.co) | BERT-base(bert-base-cased) | 预训练模型 |
| FewRel | FewRel 官方代码库(GitHub)/ 维基百科 | 100 个语义关系类别,每个类别 700 个句子;训练集/验证集/测试集划分(5:2:3) | 数据集 |
| ARSC | 公开的跨领域情感分析数据集(GitHub/ACL 文集) | 23 个亚马逊产品类别,69 项二元情感分析任务;训练集/验证集/测试集划分比例(4:2:3) | 数据集 |
| 路透社-21578 | 加州大学欧文分校机器学习知识库 / 路透社官方档案 | 21,578 篇新闻文章,90 个主题类别;ModApte 划分方法 | 数据集 |
| ArXiv | ArXiv 公共 API (arxiv.org) | 计算机科学论文摘要;训练/验证/测试集划分(7:2:1) | 数据集 |
| 分词器 | Hugging Face Hub (huggingface.co) | BERT-base-cased 分词器 | 其他必需工具 |
| Git | Git 官方网站 (git-scm.com) | 最新稳定版本 | 其他必需工具 |
参考文献
- Wen, J., Liu, P. A classification method for English texts based on hybrid recurrent neural network and graph construction in social recommendation systems. IEEE Syst J. 17 (4), 5272-5279 (2023).
- Choudhuri, S., Adeniye, S., Sen, A.
访问受限。请登录或开始试用以查看此内容。