本研究探讨了关系营销因素是否能够改善中国足球超级联赛球迷的体育推荐系统。将满意度、信任、承诺和互惠性纳入推荐模型,显著提升了Top-N推荐的准确性,尤其是在数据稀疏和长尾分布条件下效果更为明显。结果表明,承诺和互惠性是推动用户持续高参与行为的主要因素,而满意度和信任则主要促进早期参与。
需要JoVE订阅才能观看此内容。 请登录或开始免费试用
本文内容
摘要
摘要
理解并预测球迷的消费行为是职业体育领域的一项核心挑战,然而大多数推荐系统主要依赖历史交互数据,对影响球迷参与度的关系营销因素关注有限。为弥补这一不足,本研究开发了MLP-PA(带金字塔注意力机制的多层感知机),并考察将球迷的关系状态——如满意度、信任感、承诺度和互惠性——纳入推荐模型后,是否能够提升在中国足球超级联赛(CSL)球迷中多个消费场景下的推荐效果。基于涵盖门票购买、商品消费、会员服务和数字内容等多场景数据集的实证结果表明,MLP-PA生成的推荐在Top-N排序准确率上显著优于传统的协同过滤方法,尤其在数据稀疏和长尾情境下提升更为明显。进一步分析发现,不同关系因素与特定的消费模式相关联:承诺度和互惠性更强烈地关联于重复性及高参与度行为,而满意度和信任感主要影响初始性及短期反应。这些发现表明,关系营销因素在球迷消费行为中具有实质性且差异化的影响力,为职业足球领域的个性化参与策略与数字化运营提供了可操作的洞见。
引言
近年来,推荐系统已成为数字平台的核心组成部分,通过数据驱动的个性化方式实现用户、产品与消费情境之间的匹配。尽管推荐技术在电子商务和在线媒体等领域已得到广泛应用,但其在职业体育领域的应用仍相对滞后1。在中国足球超级联赛(CSL)等联赛中,球迷的消费行为具有高度的情境敏感性,并在赛前、比赛日和赛后阶段不断演变,其购买决策与线下观赛、情感依恋以及社会身份密切相关。然而,目前大多数体育推荐系统研究主要借鉴其他领域的协同过滤或基于内容的技术,且聚焦于点击或购买等短期交互信号。这些方法在很大程度上忽略了球迷与俱乐部之间的关系动态——例如信任、承诺或互惠性,而体育营销研究已证实这些因素会影响长期参与和重复消费行为2。因此,现有模型难以解释为何在不同关系状态下,相似的行为历史可能导致截然不同的消费结果。这一不足凸显了构建新型推荐框架的必要性:应超越交互频率的局限,明确纳入关系驱动机制以解释球迷决策过程3。
从关系营销的角度来看,满意度、信任、承诺和互惠共同构成了关系质量,并已被广泛证实为影响球迷关键行为结果的驱动因素,包括现场观赛、商品购买、会员续费以及口碑推广4,5,6。相比之下,目前大多数体育推荐系统仍将球迷与项目之间的互动建模为高度同质化的行为信号,很少关注这些互动背后的关系情境。这种简化限制了系统捕捉不同关系因素在消费阶段和参与强度上的差异化影响的能力,也解释了为何仅基于互动历史的模型往往难以区分短期反应与持续性、高投入的球迷行为。
从工程角度来看,体育推荐系统面临额外的挑战,包括非对称的隐式反馈、严重的长尾稀疏性以及异构的多触点交互场景7。传统的协同过滤方法和单路径深度模型在这些场景下通常表现出有限的跨上下文泛化能力,并且在营销运营中的决策支持方面可解释性较差。
从方法论角度来看,以往的推荐系统研究已提出多种解决方案,以应对数据稀疏性、异质性以及长期优化等问题。基于图结构和注意力机制的模型通过重新加权邻居节点的重要性并捕捉高阶交互关系,提升了表征学习与排序性能8,9。将协同过滤信号与深度学习相结合的混合架构,在大规模推荐任务中表现出性能提升10。基于强化学习的方法则进一步将优化目标从短期准确率扩展至长期收益11。这些进展为在稀疏反馈条件下建模复杂交互关系提供了重要的方法论基础。
然而,大多数这些方法仍然对关系营销构念缺乏关注,并未在推荐过程中明确纳入满意度、信任、承诺或互惠等变量。这一局限性在职业足球情境中尤为突出,因为球迷与俱乐部之间的关系是动态发展的,且已知不同的关系维度会主导不同的行为结果(例如首次购买与重复观赛)12,13,14,15。
为弥补这一不足,我们提出MLP-PA(具有金字塔注意力的多层感知机),这是一种针对中国足球超级联赛(CSL)场景设计的关系感知推荐框架。该模型基于具有多层感知机(MLP)主干的神经协同过滤(NCF)架构,将满意度、信任、承诺和互惠视为一等关系特征,并将其注入基于注意力的先验通道中。随后采用金字塔特征注意力模块进行晚期融合,以在多个尺度上选择性地增强显著的交互模式,同时整合粉丝、项目和上下文表征。通过显式建模关系变量与非线性交互特征,MLP-PA旨在提升体育推荐中的预测准确性和可解释性。
在一个自建的CSL数据集上的实证评估表明,所提出的方法在Top-N排序指标上始终优于经典基线方法,包括UserCF、ItemCF和MF-BPR。对模型变体的进一步分析表明,引入关系感知注意力机制有助于缓解长尾稀疏性和上下文异质性问题。结果还揭示了关系因素的不同作用:承诺和互惠性与重复性及高参与度行为关联更强,而满意度和信任则主要支持首次及短期响应行为。
访问受限。请登录或开始试用以查看此内容。
方案
本研究使用了仅为科研目的收集的去标识化粉丝-物品交互日志和匿名问卷数据。未访问、存储或处理任何个人身份信息。根据机构和国家指南,本研究无需正式的伦理委员会批准或个人知情同意。
数据集准备与实验流程
步骤1. 数据准备与预处理
数据集的准备与实验流程旨在将原始行为日志和问卷反馈转化为统一且可复现的实验数据集,适用于模型训练与评估。该过程重点关注数据清洗、匿名化处理、特征构建、归一化以及交互记录与关系相关变量的对齐。首先对原始交互日志进行筛选,剔除不完整条目和重复事件,以确保数据一致性。随后通过哈希方法对粉丝标识符和项目标识符进行匿名化处理,以保护用户隐私。多种交互形式(包括浏览、点击、购买和出席验证)被映射为隐式反馈信号,每个观测到的交互均被视为正样本实例。满意度、信任度、承诺度和互惠性等关系相关变量则从问卷反馈中收集,并与相应的粉丝标识符关联。针对问卷中缺失的数值,采用同一会员等级内的均值插补法进行处理,以保留群体层面的特征。连续型特征使用最小-最大缩放法归一化至[0, 1]区间,以确保各变量间的可比性。完成预处理后,最终数据集以结构化文件形式存储,包含匿名化的粉丝ID、项目ID、时间戳、上下文标签及归一化后的关系变量,并在所有实验设置中保持一致使用。
预期结果:
通过此流程,输出结果包括一个经过清理的交互表、一个与粉丝标识符对齐的关系变量标准化表格,以及一份统计摘要,详细列出最终数据集中粉丝、物品和交互的数量。
步骤 2. 训练集/验证集/测试集划分与负采样
在用户层面按时间顺序划分数据,以避免信息泄露。对于每位粉丝,将其最近的一次交互保留用于测试,倒数第二次交互用于验证,其余交互用于训练。负样本通过从物品集合中均匀采样未交互过的物品生成。在训练过程中,针对每个正样本交互,固定抽取一定数量的负样本(负采样比例 = 1:5)。所有模型均一致地采用相同的候选集构建方式。
预期输出:
此步骤的结果包括按时间顺序划分的训练集、验证集和测试集,以及根据指定采样比例预先生成的负样本列表。
步骤 3. 软件环境与实现
所有实验均使用 Python 实现。模型训练与评估采用 PyTorch(版本 ≥ 1.12)完成。贝叶斯超参数优化使用 Optuna(版本 ≥ 3.0)执行。训练脚本在配备单块 NVIDIA GPU(显存 ≥ 8 GB)的工作站上运行。配置文件中指定数据集路径、模型参数和优化设置,以确保实验可重复性。
步骤 4. 模型构建与参数设定
MLP-PA 模型由嵌入层、多层感知机主干网络、关系注意力通道以及金字塔注意力融合模块组成。关键参数设置如下:嵌入维度 = 32;MLP 隐藏层 = [64, 32];激活函数 = ReLU;优化器 = Adam,学习率 0.001,权重衰减 1e-5。金字塔注意力模块采用三种池化尺度,卷积核大小为 {1, 2, 4},步长与卷积核大小相等。注意力缩减比设为 4。应用 dropout(丢弃率 0.3)以防止过拟合。若验证集上的 NDCG@10 在连续 10 个训练周期内未提升,则触发早停机制。
步骤 5. 训练与超参数优化
模型使用成对的贝叶斯个性化排序(BPR)损失函数进行训练。在训练过程中,每个训练周期结束时都会监测验证集性能。贝叶斯超参数优化用于搜索学习率、嵌入维度、dropout 率、负采样比例以及与注意力机制相关的参数。优化目标为验证集上的 NDCG@10 指标。每个候选配置均采用早停法进行训练,以降低计算成本。
预期结果:
通过该过程,输出结果包括训练好的模型检查点、验证性能日志,以及通过贝叶斯优化确定的最优超参数配置。
步骤6. 评估与结果生成
训练完成后,基于验证集上的NDCG@10指标选择表现最优的模型,并在测试集上进行评估。为每位粉丝生成Top-N推荐列表,使用HR@K和NDCG@K指标衡量模型性能。此外,采用相同的评估协议开展进一步分析,包括消融实验和基于阶段条件的注意力分布分析,以确保结果之间的可比性。
完成标准
当获得以下输出时,视为本方案已完成:1)一个超参数已优化的完全训练好的 MLP-PA 模型;2)所有基线模型和消融模型在测试集上的 HR@K 和 NDCG@K 结果;3)保存的模型检查点、评估指标以及可复现的配置文件。这些输出共同支持所提出的推荐系统方案的独立重复验证。
承诺-信任关系营销理论
承诺-信任理论将承诺与信任视为关系质量的核心决定因素。通过降低交易不确定性并促进长期导向与合作意愿,这些因素推动了关系的持续性与价值创造16。信任反映了球迷对俱乐部能力、诚信与善意的信念,从而降低感知风险与信息不对称。因此,更高的信任度有助于降低个性化推荐、数据授权及支付流程中的参与障碍,进而支持从点击到购买转化漏斗中早期阶段及低承诺水平的行为。相比之下,承诺体现的是球迷愿意投入时间、财力与情感维系该关系,即使面临竞争性选择或暂时不满亦不轻易终止17。由于承诺与身份认同、沉没成本及专属性投入密切相关,其对高成本、高参与度行为具有更强且更稳定的解释力,例如重复购买、会员续费、现场观赛以及口碑推荐等行为18。
基于这些差异,我们提出以下假设。
H1(信任 → 支持性行为):更高的信任度会降低决策阻力与感知风险,从而增加点击、加入购物车以及首次购买等浅层行为的发生概率。
假设2(承诺的相对优势):在四个关系维度中,承诺对高成本和长期行为(包括重复购买、续订以及线下参与)具有最强的边际解释力,且其对预测效果的贡献超过满意度和信任。
社会交换理论
社会交换理论强调,个体在重复互动中遵循互惠和公平的规范19。感知到的互惠意味着球迷认为俱乐部在价值让渡、情感回应和资源分配方面与其存在双向互动。当互惠被视为真实且可持续时,球迷更有可能通过消费和观赛行为予以回报,从而形成正向反馈循环20。满意度是累积体验相对于期望水平的函数。通过期望—确认机制,满意度可促进短期顺从行为和积极的口碑传播,并为信任与承诺的发展提供有利基础21。
因此,我们得出:
H3(满意度 → 支持性行为):更高的满意度会降低后悔情绪并提高反应的及时性,从而促进短期购买和参与行为。
H4(互惠 → 转化与回购):在重复博弈框架下,互惠信号会增强“我获益 → 我回馈”的交换强度,显著提升转化率和回购率——尤其是在价格敏感或资源稀缺的情境中。
综合这两种理论,四个维度在其影响路径上表现出明显的背景异质性:
在存在不确定性或感知风险较高的情境下——如新产品、动态定价、高风险授权/支付——信任会产生更强的边际效应(支持假设H1)。
在长期/身份持久的情境中——如季票、连续主场赛事、会员续费——承诺起主导作用(支持假设H2)。
在重要匹配节点或激励/稀缺条件下——如有限的优惠、促销活动——互惠原则对转化率和重复购买的提升作用更为显著(支持假设H4)。
满意度作为“基础土壤”,在几乎所有情境下都能积极驱动短期行为(支持假设H3),并通过提升体验质量间接巩固信任与承诺。我们并未通过结构方程模型来检验这些假设,而是将四个维度引入注意力层,使模型能够学习到情境化的权重,并通过消融实验验证了这一机制。
MLP
多层感知机(MLP)在我们的框架中作为骨干表示学习器。
(1)输入映射层。
原始特征向量通过权重矩阵 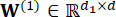 和偏置项 b(1) 进行一次线性扩展,得到
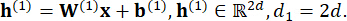 (1)
(2)深度非线性层。
我们堆叠线性层、激活层和归一化层。线性映射采用全连接仿射变换:
z = Wx + b,(2)
其中,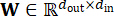 为权重矩阵,
 为偏置向量,x 为前一层的输出,z 为线性输出。为了匹配 ReLU 的激活特性并在训练过程中保持梯度稳定,我们对 W 采用 He 初始化方法:
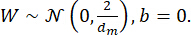 (3)
激活函数为 ReLU,特别适用于深度网络结构22。当 x>0 时,ReLU 的导数为常数,能有效缓解由 sigmoid 激活函数引起的梯度消失问题,从而加快反向传播速度和收敛过程23。ReLU 在计算上也较为简单(无需指数运算),且具有天然的稀疏性(当 x<0 时输出为零),可减少神经元的冗余响应,提升泛化能力。其定义为24
σ(x) = max(0,x), (4)
将该非线性函数逐元素应用于线性输出,得到:
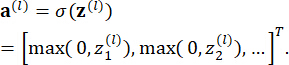 (5)
在每次“线性 → 激活”操作之后,我们引入批量归一化(Batch Normalization, BN)以稳定梯度并加速收敛。BN 在每个小批量数据内动态标准化特征,缓解内部协变量偏移,提高训练稳定性,并降低对学习率的敏感性。BN 还具有类似注入噪声的轻微正则化效果,有助于防止过拟合,同时不损害模型容量。
设当前小批量输出为 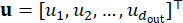 ,第 j 个特征的 BN 变换为
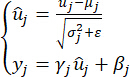 (6)
何处 μj 和 σj2 是第 j 个特征的批次均值和方差,ε 是用于数值稳定的微小常数,γj 和 βj 是可学习的缩放和偏移参数,用于恢复网络的非线性表达能力。
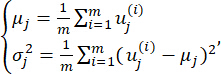 (7)
其中,m 为小批量样本大小,ε 是用于保证数值稳定性的微小常数,γj, βj 是可学习的缩放/偏移参数,用于在归一化后恢复网络的非线性表达能力。
(3)特征压缩层
深度特征提取后,我们在MLP模块末端附加一个特征压缩层,以在抑制冗余的同时保留显著信息,降低后续模块的计算负担,并提供适度的正则化。设输入向量为 。压缩后的输出为
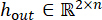 ,其参数为
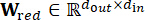 ,
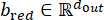 。该操作定义如下:
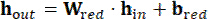 (8)
金字塔注意力(PA)机制
设最后一个MLP层的输出为  。为了能够显式选择高阶非线性相互作用,我们首先按域/通道将
 重排为一个矩阵25:

 (9)
其中,C 为通道数量,L 为每个通道的长度。
(1)多尺度特征构建。
沿特征轴 L,应用多尺度的一维池化以获得26
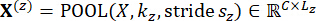 (10)
其中 ks 和 stride 定义第 s 个尺度。
(2)每个尺度的通道注意力。
对于每个尺度,构建一个通道描述符和注意力权重27:
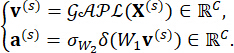 (11)
其中 δ(⋅) 为 ReLU,σ(⋅) 为 Sigmoid,
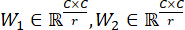 ,r 为缩减比。
按通道应用权重:
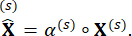 (12)
(3)融合与回写。
使用GAPL将每个尺度投影到统一的一维空间并进行融合:
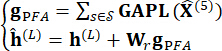 (13)
其中,Ps 为融合权重,Wr 为残差写回中使用的可学习投影。
最终评分:
 (14)
其中 ⊙ 表示哈达玛(逐元素)乘积, 表示向量拼接。
Top-N 任务的形式化与学习目标
(1)问题设定。
设粉丝集合为 F,项目集合为 I(票务、商品、会员权益和内容)。隐式反馈  表示粉丝
 是否与项目
 发生过交互(如点击、购买、出席/验证等)。训练集中的正样本为
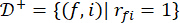 ,
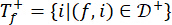 。
我们将四个关系营销变量——满意度(satisfaction)、信任(trust)、承诺(commitment)和互惠性(reciprocity)——作为一个向量: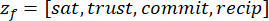 输入至注意力层,以获得上下文感知的关系表征
 ,该表征与粉丝/项目嵌入向量
 融合,生成评分
 。对于每一对正样本
 ,我们从
 中按固定比例抽取若干负样本,构成
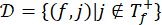 。
(2)成对目标。
为了直接优化相对排序,我们使用 BPR(贝叶斯个性化排序)损失28:
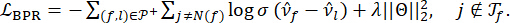 (15)
此处 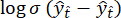 表示“正得分超过负得分”的可能性;
 是用于控制过拟合的 L2 正则项;
 表示所有可学习参数。
(3)推断与排序。
在测试时,候选集为 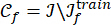 。我们计算得分 ,并返回 Top-N 列表29:
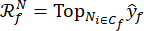 (16)
推荐算法设计
本部分介绍了本研究中使用的完整推荐工作流程,涵盖了从数据预处理到模型训练及在线推理的端到端流程。该工作流程说明了如何通过表示学习和基于注意力机制的建模,将原始的用户-物品交互数据与关系变量转化为个性化的排序得分。具体步骤如下所述。
步骤 1:数据准备与标准化。
将客户服务中心(CSL)风扇与项目的交互日志转换为隐式反馈信号。处理缺失值,并对四个关系变量——满意度、信任度、承诺度和互惠性——进行归一化处理。数据按时间顺序划分为训练集、验证集和测试集,并为每个正向交互生成多个负样本。
步骤 2:关系注意力编码。
这四个关系变量被输入到一个注意力模块中,以学习上下文感知的重要性权重,从而为下游建模生成紧凑的风扇关系表征。
步骤3:相互作用输入构建。
学习粉丝和项目的嵌入表示,并将其与关系表示进行拼接,以形成每个粉丝-项目交互的完整特征向量。
步骤 4:表示学习。
这些交互特征通过一个多层感知机(MLP)分支,以捕捉高阶非线性模式并生成融合的潜在表示。
步骤 5:金字塔特征注意力。
在MLP输出之上构建多尺度特征金字塔。应用通道注意力机制和跨尺度融合,并通过残差连接整合增强后的特征,以放大显著通道并抑制冗余通道。
步骤6:评分与输出。
线性分支与增强的非线性表示进行拼接后输入至输出层,以计算每一对粉丝–项目组合的偏好得分。
步骤 7:训练与优化。
该模型采用成对排序目标进行优化。通过结合自适应优化器、权重衰减、丢弃法和早停法,以提升泛化能力并减轻过拟合。
步骤 8:贝叶斯超参数优化。
验证排序指标被用作自动搜索关键超参数的目标,包括嵌入维度、网络深度和宽度、学习率、负采样比例、dropout 率以及与金字塔结构和注意力机制相关的参数。
步骤9:推断与排序。
在在线推理过程中,针对每个粉丝在候选物品集合上计算偏好得分,以生成 Top-N 推荐结果,并可选择应用重排序策略,以考虑新颖性、多样性及业务约束。
实验验证
数据集与特征模式
我们基于一个自建数据集进行评估,该数据集通过哈希处理的球迷ID,将匿名的俱乐部信息系统中球迷与商品之间的隐式交互日志与同期的关系调查数据进行关联。数据涵盖票务、商品、会员资格和内容四个业务领域,包括浏览、点击、加入购物车/收藏、购买/购票以及场馆内核验等事件,并包含时间戳、触点渠道、上下文标签和促销标识。数据时间跨度不少于一个完整赛季,规模达到足以支持深度建模的球迷、商品和事件数量级。
特征模式与编码:项目-项目ID、项目类型、团队标签、价格区间(ID/类别嵌入);粉丝—粉丝ID、地区、会员等级、会员时长(粉丝ID作为嵌入学习;其他分类/数值字段标准化);关系质量特征—满意度、信任度、承诺度、互惠性,缩放到[0,1]范围后输入注意力通道,再通过PA与MLP表示融合;上下文—阶段标签、渠道、促销标志、小时、星期几(分类变量作为嵌入;时间特征采用正弦/余弦位置编码)。
超参数优化
MLP-PA 的关键超参数通过贝叶斯优化在预设的搜索空间内进行调优,以验证集上的 NDCG@10 作为主要目标(HR@10 作为参考指标),并采用早停法以减轻过拟合。每个候选配置均在多个随机种子下运行并取平均结果。最终部署的参数设置见表 1。
| 超参数 | 描述 | 搜索范围 | 选定值 |
| 嵌入维度 | 用户/项目嵌入大小 | {32, 64, 128} | 64 |
| MLP隐藏层 | MLP层数 | {2, 3, 4} | 3 |
| MLP隐藏单元 | 每隐藏层单元数 | {64, 128, 256} | 128 |
| Dropout率 | Dropout概率 | [0.1, 0.5] | 0.3 |
| 学习率 | 初始学习率 | [1e-4, 1e-2] | 1.00E-03 |
| 负采样比例 | 每个正样本对应的负样本数 | {1, 3, 5, 10} | 5 |
表1: MLP-PA 模型的最终超参数设置
访问受限。请登录或开始试用以查看此内容。
结果
收敛性与稳定性
为了评估所提出模型的收敛行为和训练稳定性,我们将其验证性能与一个标准的基于多层感知机(MLP)的推荐器进行比较,该推荐器不包含金字塔特征注意力机制或关系感知注意力机制,作为对照模型。所有模型均在相同的数据划分、优化设置和停止准则下进行训练,以确保比较的公平性。
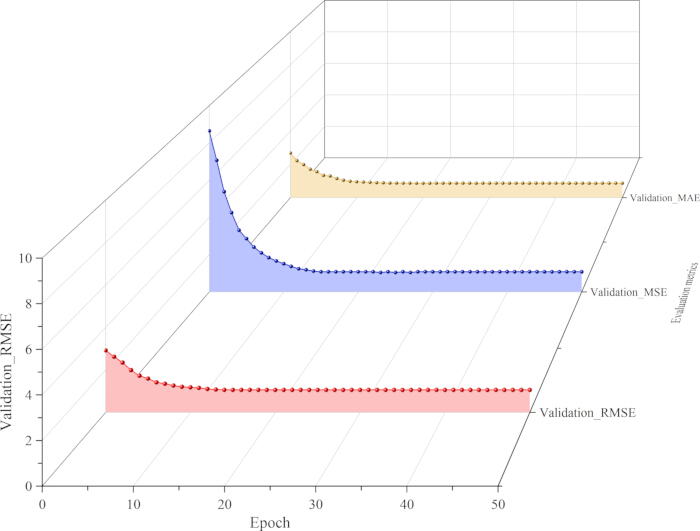
图 1: 模型在训练过程中的收敛性与稳定性。
访问受限。请登录或开始试用以查看此内容。
讨论
概念与方法学贡献
本研究通过重新定义关系维度——满意度、信任、承诺和互惠性——在概念上做出了贡献,将其视为具有情境敏感性的关系信号,而非静态的辅助特征,其影响随参与阶段的不同而变化。所提出的框架通过基于注意力的机制来实现这一理念,该机制在行为表征的基础上动态地重新加权关系线索。通过这种方式,该框架超越了特征增强,引入了一种将关系营销构念嵌入现代推荐架构的系统化方法。
从方法论上讲,将关系感知的优先级与多尺度表示学习骨干网络相结合,展示了可解释性与预测建模如何得以协同解决。该框架并非仅仅将注意力机制视为提升性能的组件,而是将其作为分析透镜,用以考察和解释关系机制。这使得模型不仅是一种预测工具,同时也成为体育分析中用于机制发现的仪器。
超越总体性能的机制层面解读
本研究的核心科学发现在于所学模型行为与既定关系理论之间的一致性。基于阶段的注意力模式表明,在...
访问受限。请登录或开始试用以查看此内容。
披露
作者声明无利益冲突。
致谢
作者感谢匿名审稿人提出的建设性意见和建议,这些意见和建议有助于提高本文的清晰度和质量。同时感谢合作机构为本研究提供了数据访问支持。本文所表达的任何观点、发现和结论均为作者个人观点,不一定反映其所属机构的观点。
访问受限。请登录或开始试用以查看此内容。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| Python | https://www.python.org | 3.9.10 | |
| 深度学习框架 | PyTorch | https://pytorch.org | >= 1.12 |
| 超参数优化库 | Optuna | https://optuna.org | >= 3.0 |
| 硬件 | NVIDIA GPU | https://www.nvidia.com | 单个 GPU,>= 8 GB 显存 |
| 数据集 | 自建 CSL 粉丝数据集 | N/A | 至少一个完整赛季或更长时间;规模足以支持深度建模 |
| 交互数据 | 粉丝–项目隐式交互日志 | N/A | 未单独版本化 |
| 调查数据 | 关系问卷数据 | N/A | 未单独版本化 |
| 数据预处理方法 | 基于哈希的匿名化 | N/A | 应用于粉丝和项目标识符 |
| 数据预处理方法 | 会员等级内均值填补 | N/A | 应用于缺失的问卷回答 |
| 数据预处理方法 | 最小–最大归一化 | N/A | 范围 [0, 1] |
| 数据划分策略 | 按时间顺序的用户级划分 | N/A | 最近的数据为测试集;次近的为验证集;其余为训练集 |
| 负采样 | 均匀负采样 | N/A | 正负样本比例 = 1:5 |
| 模型主干 | MLP(多层感知机) | https://pytorch.org/docs/stable/nn.html | 隐藏层 [128, 64, 32](已优化) |
| 注意力模块 | 关系注意力通道 | N/A | 自定义模块 |
| 融合模块 | 金字塔注意力(PA) | N/A | 池化尺度 {1, 2, 4},步长等于卷积核大小,压缩比 = 4 |
| 优化器 | Adam | https://pytorch.org/docs/stable/generated/torch.optim.Adam.html | 学习率 0.001,权重衰减 1e-5 |
| 正则化 | Dropout | https://pytorch.org/docs/stable/generated/torch.nn.Dropout.html | 丢弃率 0.3 |
参考文献
- Wang, L., et al. Drug combination recommendation model for systemic lupus erythematosus and antiphospholipid syndrome. Pharmaceutics. 18 (8), 1224(2025).
- Hu, X., Yuan, Z., Ma, Z. A robot control knowledge recommendation model PKGAT based on multimodal knowledge graph. Int J Softw Eng Knowl Eng. 35 (8), (2025).
- Ji, S. An intelligent recommendation model for disclosure of electricity market entities based on association rule mining algorithm. Electr Eng. , In press (2025).
- Xie, F., et al. Differential weighting and flexible residual GCN-based contrastive learning for recommendation. Symmetry. 17 (8), 1320(2025).
- Duan, J., et al. A deep recommendation model based on semantic information and correlation between items. J Intell Inf Syst. , In press (2025).
- Malakhatka, E., et al. Optimal time recommendation model for home appliances: HSB Living Lab dishwasher study. Energy Effic. 18 (1), 3(2024).
- Yuan, Q., Cong, G., Ma, Z., Sun, A., Magnenat-Thalmann, N. Time-aware point-of-interest recommendation. Proc Int ACM SIGIR Conf Res Dev Inf Retr, 36, 363-372 (2013).
- Alaoui, E. D., et al. Comparative study of filtering methods for scientific research article recommendations. Big Data Cogn Comput. 8 (12), 190(2024).
- Li, X., Hu, G. Design and implementation of an electronic journal resource recommendation system integrating user profile and knowledge graph. Front Comput Intell Syst. 10 (2), 74-78 (2024).
- Sami, A., et al. A deep learning-based hybrid recommendation model for internet users. Sci Rep. 14 (1), 29390(2024).
- Zhonghua, W. Intelligent recommendation model of tourist places based on collaborative filtering and user preferences. Appl Artif Intell. 37 (1), (2023).
- Wang, Q., Esquivel, A. J. Personalized movie recommendation system based on DDPG: Application and analysis of reinforcement learning in user preferences. Front Soc Sci Technol. 5 (18), (2023).
- Miao, L., et al. Study on two-tier EV charging station recommendation strategy under multi-factor influence. J Artif Intell. 5, 181-193 (2023).
- Yunni, X., et al. A quasi-Newton matrix factorization-based model for recommendation. Int J Web Serv Res. 20 (1), 1-15 (2023).
- Mourad, J., et al. Personalized PV system recommendation for enhanced solar energy harvesting using deep learning and collaborative filtering. Sustain Energy Technol Assess. 60, 103456(2023).
- Pfajfar, G., et al. Value of corporate social responsibility for multiple stakeholders and social impact: A relationship marketing perspective. J Bus Res. 143, 46-61 (2022).
- Khan, R. U., et al. The impact of customer relationship management and company reputation on customer loyalty: The mediating role of customer satisfaction. J Relatsh Mark. 21 (1), 1-26 (2022).
- Sheth, J. New areas of research in marketing strategy, consumer behavior, and marketing analytics: The future is bright. J Mark Theory Pract. 29 (1), 3-12 (2021).
- Mishra, M., Mund, P. Fifty-two years of consumer research based on social exchange theory: A review and research agenda using topic modeling. Int J Consum Stud. 48 (4), e13074(2024).
- Cook, K. S., Hahn, M. Social exchange theory: Current status and future directions. Theor Sociol. 50, 179-205 (2021).
- Naseer, A., Jalal, A. Multimodal objects categorization by fusing GMM and multilayer perceptron. Proc 5th Int Conf Adv Comput Sci (ICACS), , 1-7 (2024).
- Hussain, K., et al. Analyzing LULC transformations using remote sensing data: Insights from a multilayer perceptron neural network approach. Ann GIS. 30, 1-28 (2024).
- Mfetoum, I. M., et al. A multilayer perceptron neural network approach for optimizing solar irradiance forecasting in Central Africa with meteorological insights. Sci Rep. 14 (1), 3572(2024).
- Yu, Y., et al. Multi-scale spatial pyramid attention mechanism for image recognition: An effective approach. Eng Appl Artif Intell. 133, 108261(2024).
- Liu, H., et al. A deep convolutional neural network for the automatic segmentation of glioblastoma brain tumor: Joint spatial pyramid module and attention mechanism network. Artif Intell Med. 148, 102776(2024).
- Liu, M., et al. Vehicle object counting network based on feature pyramid split attention mechanism. Vis Comput. 40 (2), 663-680 (2024).
- Alvarado, O., et al. A systematic review of interaction design strategies for group recommendation systems. Proc ACM Hum-Comput Interact, 6 (CSCW2), 1-51 (2022).
- Zhao, Y. Design of garment style recommendation system based on interactive genetic algorithm. Comput Intell Neurosci. 2022, 9132165(2022).
- Nazer, L. H., et al. Bias in artificial intelligence algorithms and recommendations for mitigation. PLOS Digit Health. 2 (6), e0000278(2023).
访问受限。请登录或开始试用以查看此内容。