我们展示了一种可重复的协议,用于实施FedRisk,即一种可解释的联邦学习框架。该流程包括语义数据协调、隐私保护的实体对齐、差分隐私校准、本地GBDT训练、全局Transformer融合以及梯度压缩的异步更新,从而实现跨多个机构的安全、可扩展且符合监管要求的金融风险预测。
需要JoVE订阅才能观看此内容。 请登录或开始免费试用
本文内容
摘要
摘要
金融数据在不同机构间的分散性以及严格的隐私法规严重阻碍了协作式风险管理,导致欺诈检测准确率低于60%,中小企业贷款违约误判率超过25%。现有的联邦学习解决方案在处理非独立同分布(Non-IID)数据、模型可解释性及合规性方面面临挑战,导致实际应用率低于20%。为解决这些不足,我们提出FedRisk——一种可解释的联邦学习框架,集成了四项关键创新。第一,跨机构数据网格结合本体语义协调机制,实现超过85%的特征利用率。第二,混合人工智能模型将具有单调性约束的局部可解释GBDT与基于全局注意力的Transformer相结合,在Non-IID场景下相比FedAvg降低7.6%的性能损失。第三,三方隐私保护机制采用总预算为ε=5的自适应差分隐私、加法秘密共享以及公平性感知正则化,将群体预测偏差控制在0.05以下,RAROC损失低于2.1%。第四,通信高效优化将每轮通信带宽降至8.5 MB,训练时间缩短至85分钟。在超过500万条多机构记录上的评估结果显示,FedRisk的AUC-ROC达到0.912,仅比集中式GBDT低1.8%,同时对成员推断攻击的抵抗能力达到AUC为0.58。该框架将跨机构数据传输量减少了99%,在AUC-ROC指标上优于经典联邦学习基线模型7.3%。通过在无需共享原始数据的前提下实现安全、透明且符合监管要求的风险预测,FedRisk为跨机构金融协作提供了一种可扩展的解决方案。
引言
数字金融的深入发展正在重塑服务模式,从个人信贷风险控制到中小企业供应链融资,数据已成为核心生产要素。根据中国人民银行《2023年中国金融科技发展报告》,截至2023年底,中国数字信贷规模超过65万亿元,占总余额的38%,日均交易数据量超过500TB1。然而,“数据孤岛”仍是重大障碍。由于竞争和安全顾虑,各机构普遍采用封闭式数据模式。例如,在信用卡欺诈检测中,银行仅依赖内部数据,无法获取关键的跨机构记录,导致对新型欺诈的识别率低于60%。同样,在中小企业信贷中,缺乏外部保险和税务数据,使得违约预测误差超过25%。这种数据割裂带来了双重挑战:一方面限制了2亿普惠金融客户的服务可及性,另一方面使风险交叉传染概率上升18%(中国银保监会2023年报告)。因此,数据孤岛已成为制约数字金融高质量发展的核心瓶颈。
近年来,全球数据隐私法律的激增显著限制了集中式数据共享。金融机构现在必须遵守三项核心原则:“最小必要性”、“知情同意”和“可追溯性”。尽管各地区框架有所不同,但均对跨机构数据使用设定了严格的门槛,详见Table 1。
| 监管框架 |
访问受限。请登录或开始试用以查看此内容。
方案
系统架构
跨机构数据网格与语义层
为解决跨机构数据异构性问题,该研究通过领域驱动的节点划分构建了数据网格(Data Mesh)架构。各金融机构作为独立的数据域节点运行,同时保留其数据所有权与控制权,语义层则实现数据的统一理解与交互。基于本体的语义层建立了统一的金融风控数据模型,定义了核心实体、fmap 属性及实体间关系。具体的语义映射规则详见表5。针对机构特有的字段,通过语义映射函数实现标准化转换:
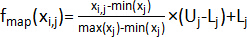 (18)
| 核心实体 |
访问受限。请登录或开始试用以查看此内容。
结果
预测性能:在非独立同分布场景下接近集中式模型的水平
在具有高度非独立同分布(Non-IID)数据的真实场景中(机构违约率差异为0.2%–3.5%),FedRisk 展现出卓越的风险区分能力,如表12所示。其 AUC-ROC 达到 0.912,PR-AUC 为 0.823,Brier 得分为 0.042,假阳性率(FPR)为 1.02%。这些指标不仅满足金融风控的核心要求——低误拒率和高精度(FPR<1.5%,AUC-ROC>0.9)——而且相比经典联邦模型 FedAvg(AUC-ROC 0.839)提升了 7.3%,相比隐私增强模型 FedAvg+DP(AUC-ROC 0.812)提升了 10%。这一性能优势源于两项关键设计:第一,对 GBDT 局部子模型施加单调性约束,对“"客户收入"”和“"信用评分"”等关键特征引入单调性约束,在保留 GBDT 对结构化数据强大拟合能力的同时,防止决策逻辑异常;第二,采用全局注意力 Transformer 融合机制,对数据质量高的.......
访问受限。请登录或开始试用以查看此内容。
讨论
动态超参数调优策略,特别是余弦退火学习率调度器,在平衡收敛速度与模型稳定性方面至关重要。通过在100个训练周期内将学习率从0.05衰减至0.00025,该方法加快了初期收敛速度,同时最小化了后期波动,使训练时间减少了37%,验证集AUC-ROC提升了2.3%,优于固定学习率调度方案。同样关键的是差分隐私中的自适应噪声校准,其中基于方差感知的拉普拉斯噪声(scale=Δf/ε,Δf=1.2,ε=0.5)会根据各机构数据波动动态调整。当特征方差超过0.15时,噪声强度增加100%,在分布偏移期间防止隐私泄露,同时将AUC-ROC性能下降限制在< 0.8%以内。这些措施确保了符合GDPR标准的隐私保护(ε=5),且未牺牲模型实用性,成员推断攻击的AUC为0.58,证实了其有效性。
FedRisk 当前的实现局限于纵向联邦学习(VFL)场景,限制了其在数据水平划分架构中的适用性。通信开销随参与方数量增长呈线性增加,每增加一个机构,每轮通信带宽约增加 2.1 MB,这对大规模部署构成了挑战>20 个节点)。此外,混合 GBDT-Transformer 模型引入了计算瓶颈:注意.......
访问受限。请登录或开始试用以查看此内容。
披露
作者无任何利益冲突需要披露。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| 笔记本电脑 | Dell Technologies | N/A | 用于数据处理和文档记录 |
| 统计分析软件(SPSS) | IBM Corp. | 版本 26.0 | 用于统计分析 |
| Microsoft Excel | Microsoft | Office 365 | 数据录入和基本数据处理 |
参考文献
- 2023 risk monitoring report. , China banking and insurance regulatory commission. https://www.cbirc.gov.cn (2023).
- Zhang, X., Mavromatis, A., Vafeas, A., Nejabati, R., Simeonidou, D. Federated feature selection for horizontal federated learning in IoT networks. IEEE Internet Things J. 10 (11), 10095-10112 (2023).
- Liu, Y., et al.
访问受限。请登录或开始试用以查看此内容。