为了提升足球比赛中战术决策的分类效果,本研究提出了一种基于 Transformer 的多模态融合模型,该模型整合了视觉、位置、声学和上下文数据。该模型在包含 500 个序列的多模态数据集上实现了接近实时的性能,在准确率以及压力导致的误分类方面均优于 CNN-LSTM、BiLSTM-Attention 和 GNN 基线模型。
需要JoVE订阅才能观看此内容。 请登录或开始免费试用
本文内容
摘要
摘要
现代足球运动要求快速且准确的战术决策能力。然而,传统的战术决策评估方法生态效度较差,且难以大规模应用。为应对这些挑战,本文介绍了一种基于 Transformer 的多模态融合模型,该模型结合球员位置信息、视频、音频以及上下文元数据,用于对实时战术决策进行分类。研究对40名男性球员开展了实验,并构建了一个包含500段多模态比赛片段的数据集。其中,40名球员的数据集来源于受控的实验室风格决策实验,用于初步验证和可靠性评估;随后,从扩展的比赛模拟和真实比赛录像中提取了500段多模态序列,构成用于训练和测试多模态 Transformer 模型的较大规模数据集。
该方法通过五个阶段处理输入:数据采集、预处理、特征提取、基于Transformer的融合以及决策分类。与CNN-LSTM、BiLSTM-Attention和GNN等基线模型相比,所提出的方法将决策预测准确率提高了28%,由压力引起的误分类减少了41%,且推理延迟低至52.6 ms,适用于近实时应用。然而,由于样本群体局限于单一地区年轻男性运动员,样本量相对较小且同质性较高,研究结果在更广泛战术情境和更广泛运动员人群中的可推广性仍受限。这些结果强调了基于Transformer的多模态融合在自动化战术决策分析中的贡献,同时也指出了其在更多样化和大规模比赛场景中进一步验证的必要性。
引言
足球等团队运动要求运动员在动态且不确定的环境中迅速做出战术决策。运动员必须持续观察来自球体、队友和对手的视觉信息,并在极短时间内做出反应,以确保竞争优势。足球中的战术决策高度依赖于对球员移动、球的轨迹以及情境线索的快速感知。尽管反应时间与选择性注意等一般性感知认知能力确实会影响运动表现,但近期研究更强调基于数据、具备情境感知能力的模型,以逼近真实比赛中的战术认知过程1,2,3,4,5。反应时间以及认知能力等感知能力在运动表现中同样发挥着关键作用6,7,8。近年来关于运动认知的研究表明,战术决策不仅依赖于感知技能,还依赖于运动员实时整合动态空间信息、对手施压情况以及比赛情境线索的能力。关于感知-认知专长的研究提示,战术素养更高的运动员能够更快识别线索,更高效地获取信息,并在压力下表现出更稳定的决策模式。这些发现支持了构建能够捕捉体育决策过程复杂性与多层次特性的计算模型的必要性。
评估战术决策的传统方法通常采用受控的实验室任务和主观专家判断,这些方法在生态效度和可扩展性方面存在显著限制。近年来深度学习的发展为自动化分析提供了可能,可通过多模态数据源(如视频、位置追踪数据以及比赛情境元数据),结合能够捕捉时序和跨模态依赖关系的架构实现。尽管取得了这些进展,目前大多数模型仍基于卷积神经网络-长短期记忆网络或双向长短期记忆网络(CNN-LSTM 或 BiLSTM)模型,其在建模不同模态之间长距离依赖关系方面能力有限。这一局限性推动了基于 Transformer 的多模态融合模型的发展,此类模型在足球场景中能够更全面、更稳定地建模战术决策过程。以对抗性团队运动足球为例,运动员必须快速评估关于球的位置、队友、对手以及自身在场上的位置等信息,并结合自身能力、教练指令和比赛具体情境,决定最佳行动方案9,10。由于组织良好的数据集和明确的战术构成要素易于获取,本研究聚焦于足球;然而,所涉及的战术决策原则同样适用于多种团队运动。
事实上,先前的研究表明,CNN-LSTM 和 BiLSTM 由于采用固定的感受野或受顺序门控机制的限制,无法捕捉极长距离的时间依赖性11,12,13。类似地,在动作识别和多模态时间建模领域的基础基准研究发现,基于 LSTM 的模型在序列长度增加或上下文线索相隔多个帧时,其性能会下降,这可能限制其在动态体育场景中的生态效度。此外,基于图神经网络(GNN)的模型虽是建模空间交互的有力工具,但在需要细粒度时间推理,或上下文压力线索随时间快速变化的场景中,其表现始终欠佳14,15。与这些方法相比,近期基于 Transformer 的框架通过单次前向传播即可联合整合长距离时间线索、空间关系和上下文信号,借助全局自注意力机制,在体育数据分析、人类活动识别和视频-语言任务中展现出更优的性能。此类基准研究结果为本研究中所提出模型采用基于 Transformer 的架构作为主干网络提供了合理依据。
提升战术认知并理解战术原则已被证明对于解决比赛中的制约因素和问题至关重要16,17。足球运动员通过技战术训练学习多种比赛要素,包括渗透、进攻保护、跑位、时机、限制、防守保护、平衡和注意力集中等18。随着运动员足球经验的积累,他们对技术和战术基本原理的理解也应随之加深。因此,运动员能够更轻松地识别相关比赛信号,从而在特定情境下针对每项比赛规则做出恰当的决策19。正因如此,运动员能够将自身的运动效率与决策能力相结合,使移动模式与专项技能相辅相成。
作者采用多属性决策方法分析了锻炼和习惯带来的适应性益处,阐明了合格训练能力在大学生体育教育中的有效性。有效的身体活动、健康体能习惯的养成,以及倡导教育机构中体育呈现方式的改革,均被赋予了重要权重。研究使用直觉模糊加权赫罗尼均值(IFWHM)方法,并借助模糊数实现有效决策。结果支持了大学生的认知成效,并更准确地评估了他们的身体健康问题。为检测数据中潜在的关联,研究者20采用了增强型Apriori方法。该研究结论与高等教育中学生体质健康评估密切相关。首个结果是通过评估不同取向疲劳的发生频率来确定的。
以往基于人工智能的体育分析研究主要集中在计算机视觉任务上,包括运动员检测、追踪以及群体活动识别。近期的弱监督和无需检测器的架构揭示了多模态和上下文感知建模在理解战术行为中的重要性。这些进展要求将多模态深度学习技术整合,以对足球运动中的战术决策进行分类。本文利用通过矩阵分解从效用矩阵中生成的潜在特征向量,计算用户与用户之间或项目与项目之间的余弦相似度。
近期体育分析领域的研究已转向多模态且具有情境感知能力的深度学习框架,该框架结合视频、位置数据和上下文线索以解读战术行为。多种基于Transformer的方法在建模体育环境中长时程时间结构和跨模态关系方面表现出强大能力,包括:用于多模态动作识别的MM-ViT、用于体育情境推理的统一对比融合Transformer,以及基于交叉注意力的事件检测器21,22。这些方法表明,相较于单一模态的CNN-LSTM模型,采用能够捕捉球员之间、空间、运动线索及上下文信息相互作用的架构,更能有效表征战术决策。基于这一研究方向,本研究也将采用基于Transformer的多模态融合框架,联合处理视觉、位置和上下文信号,以实现对足球战术决策的近实时建模。
以往的足球分析模型通常基于 CNN-LSTM 或 BiLSTM 架构,这类模型能够捕捉局部时间模式,但在处理跨模态的长距离依赖关系时存在困难。Transformer 通过引入全局自注意力机制弥补了这一不足,使模型能够在较长时间窗口内关联球员运动、球的轨迹以及情境线索,这对于稳健的战术决策分析至关重要。为了解决推荐系统中评分数据稀疏性的问题,作者23,24提出了一种基于评论的矩阵分解技术,该技术结合了基于评论的协同过滤与评分填补方法。
然而,这些方法的有效性、可扩展性和适用性因其依赖边界框进行推理以及对大量数据标注的需求而受到严重限制。解决这一问题的一种方法是利用边界框标签同时训练球员检测和群体行为识别25,26,27,28。尽管训练数据仍需基于个体的边界框标注,但所提出的方法在推理过程中自动计算球员的边界框。弱监督群体行为识别(Weakly Supervised Group Activity Recognition, WSGAR)方法无需在训练或推理阶段提供个体级别的标注,旨在减轻标注负担。该方法首先利用在外部数据集上预训练的检测器生成边界框候选,随后学习过滤掉无关的检测结果。最近29,研究人员提出了一种无需检测器的WSGAR解决方案,该方法通过令牌嵌入生成局部上下文以聚合球员信息。
在体育分析领域,多模态和基于变换器的架构最近变得尤为重要,因为它们能够捕捉长时间范围的时序模式,并整合异构的数据流30,31。变换器的各种变体已被应用于预测运动员的移动轨迹、进行多视角战术分析以及识别动作意图,在时间推理能力方面表现出优于CNN-LSTM模型的性能。多模态融合策略结合了视频、位置和上下文线索,在实时战术建模中取得了令人鼓舞的初步成果,并凸显了交叉注意力机制和序列到序列学习在理解比赛过程中决策动态方面的重要性。
基于Transformer的多模态框架最近在需要整合多种数据流的各个领域中展现出卓越的性能。例如,基于ViT的多模态融合模型已用于联合解析视频、姿态和音频信息,通过交叉注意力机制实现情境感知的事件预测、运动员追踪和动作识别32,33。此外,MM-Former和基于Perceiver的架构在融合时空线索以及长时序推理方面,已超越循环神经网络和卷积模型,在体育数据分析与人类活动分析中表现更优34。这些结果支持本研究采用基于Transformer的多模态融合架构,表明Transformer能够通过全局注意力捕捉模态间的细粒度交互35。Transformer特别适用于战术分析,因为其全局注意力机制使模型能够在更长的时间窗口内关联视觉线索、位置数据和上下文信号,而这是CNN-LSTM和BiLSTM模型所不具备的能力。
尽管人们对评估团队运动中的战术决策越来越感兴趣,但以往的研究主要依赖人工设计和验证的评估方法来衡量预先设定活动(如驾驶和传球)中的表现速度和决策准确性36,37,38。尽管这些框架能够提供有关运动员行为和决策水平的深入数据,但在可扩展性、客观性以及适用于动态、真实世界情境方面存在局限性39。当前的方法尚未整合能够记录并理解战术决策多模态特性的计算机化数据驱动方法,而战术决策涉及运动员动作、视觉信号、听觉线索与比赛环境之间复杂的关联40,41,42。此外,这些方法通常忽略了能够在背景信息与时间关系之间切换的多层面人工智能结构。目前明显缺乏一种基于Transformer的多模态融合框架,该框架能够利用视频影像和位置追踪等丰富的实时数据源,并将团队运动中的决策过程纳入其中。填补这一空白可显著提升高性能运动环境中决策的战术洞察力、可扩展性与独立性。与当前的CNN-LSTM和BiLSTM方法相比,这种基于Transformer的融合方法有意识地建模了视觉、空间和上下文信息之间的跨模态注意力。此类创新促进了更密集的战术表征,并在高压情境下将误分类率降低超过40%。
本研究的主要目标是开发一种基于Transformer的多模态融合框架,用于评估足球运动中的战术决策能力。尽管所提出的框架可推广至其他团队运动项目,但本研究聚焦于足球,因其具有较高的战术复杂性且存在结构化的数据集。该系统能够基于专家评估,对受控且独立的足球任务中的战术准确性与反应时机进行结构化评估。本研究通过整合多模态数据源(包括位置追踪数据、视频片段、音频信号以及比赛情境信息),克服了人工评估和静态测试环境的局限性。
利用基于变换器的注意力机制,该框架能够持续学习多模态关联,从而对玩家的实时决策方法进行统一且具有上下文感知能力的解读。
本研究的主要目标是通过数据驱动的洞察,帮助教练员和分析师更深入地理解运动员的思维过程和团队动态,从而推动体育领域智能化表现评估的发展。
该框架将通过利用变换器的注意力机制持续学习多模态间的关系,从而能够在实时游戏中实时获得对玩家决策策略的统一理解。
因此,该系统能够提供有关战术行为的可操作见解,而这些见解若使用标准评估方法则难以表征。
目标是增强可解释性,为教练和分析师提供更有用的信息。
本研究的主要贡献如下:
本研究采用基于Transformer的多模态融合设计,提出一种用于团队运动中战术决策分析的新型深度学习模型。
通过整合从真实比赛视频中提取的视觉、位置和上下文数据流,该方法显著拓展了基础研究中引入的简单评估方法的范围,后者仅关注单独的传球和运球动作。
多模态编码器通过使用注意力机制整合球员追踪数据、视觉帧以及上下文比赛事件,来捕捉复杂的时空关系。
在基准足球数据集上的实验表明,该模型的性能优于传统的基线方法,例如基于卷积神经网络(CNN)的融合方法和长短期记忆网络(LSTM)。
与CNN-LSTM、BiLSTM-Attention和GNN基线模型相比,所提出的基于Transformer的多模态融合架构表现出显著性能提升。
访问受限。请登录或开始试用以查看此内容。
方案
研究纳入了40名年龄在18至24岁之间的男性足球运动员(平均年龄 = 20.1 ± 1.2岁),这些运动员来自一个地区联赛中的四支业余和半职业俱乐部。所有参与者均具有至少三年的竞技经验,并且目前处于结构化训练环境中。数据采集在两个受控环境下进行:首先,在标准化的训练场训练中模拟战术性传球/带球决策场景;其次,在长时间的比赛模拟会话中提取多模态序列。所有实验程序均经北部湾大学机构伦理委员会批准(批准编号:BG-PE-2023-117),并在数据采集前获得所有参与者的书面知情同意。本研究严格遵守国际及机构伦理标准。北部湾大学机构伦理委员会审查并批准了所有涉及人类受试者的研究程序(批准编号:BG-PE-2023-117)。在数据采集前,每位参与者均签署书面知情同意书,所有收集的数据在分析前均进行了匿名化处理。
本研究旨在通过基于 Transformer 的多模态融合架构,实现对团队运动中战术决策过程的自动化与增强化分析。该方法整合多种数据源,包括视频、音频、空间位置信息以及运动员元数据,以构建一个稳健的实时预测模型。图1展示了所提出方法的架构。本研究共包含五个阶段,各阶段描述如下:
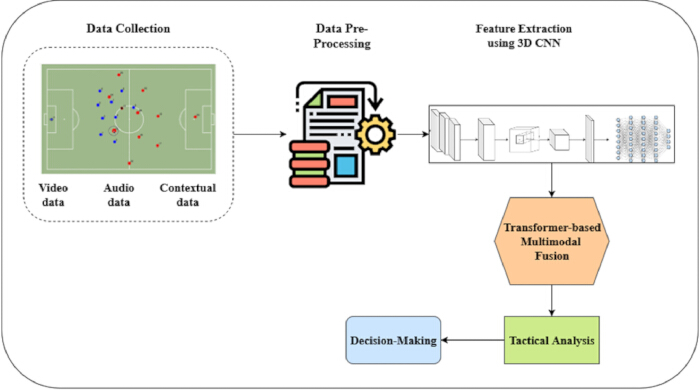
图1.所提出方法的架构。 该模型结合多模态输入与分类组件用于战术决策的示意图。 请点击此处查看此图的放大版本。
数据采集与预处理
通过采集比赛录像中的多种模态数据,例如视频流、音频解说、GPS/定位信息以及运动员表现指标,获得原始资料。每种模态数据均需进行预处理,处理方法包括视频的帧提取、音频的噪声滤波以及传感器读数的归一化,以确保各模态在时间步长上保持同步。
以 25 fps 的帧率提取视频帧,并下采样至 224 × 224 分辨率。音频信号采用 300 至 3,400 Hz 的带通滤波器进行处理,以消除大部分环境噪声。来自 GPS 传感器的位置跟踪数据以 10 Hz 的频率记录,并通过基于时间戳的线性插值法进行插值,确保与 25 Hz 的视频时间线对齐。所有输入均通过共享时间戳进行时间对齐,并使用 z 分数标准化对其量纲进行归一化处理。
特征提取
为了获取视频数据的时空信息,使用了3D卷积神经网络(3D CNN)。3D CNN能够处理视频帧之间的空间和时间信息,使模型具备检测运动模式、理解群体行为以及提取基于运动特征的能力。该操作为每个动作序列生成密集的特征表示,作为模型的视觉输入。每个视频输入片段包含以步幅2采样的16个连续帧。在训练过程中应用了随机裁剪、水平翻转和亮度归一化。3D CNN采用Adam优化器(学习率lr = 0.0001)、批量大小为16,并使用交叉熵损失函数进行优化。
多模态输入的嵌入与对齐
随后,将来自不同模态的嵌入与3D CNN的输出进行整合。采用一种多模态Transformer模型架构,其中不同的编码器分支分别处理各模态数据。通过引入交叉注意力层实现模态间的融合与对齐,使模型能够捕捉不同模态之间的相互依赖关系(例如球员位置与球的运动之间的关系,以及解说文本提供的上下文信息)。这种融合方式有助于增强对当前战术决策的上下文理解。所有嵌入均在PyTorch中实现。视频特征通过线性投影从1,024维降至512维,音频和位置特征分别投影至256维和128维,并在时间对齐前统一为512维。
基于 Transformer 的多模态融合
采用多模态Transformer来融合从所有来源提取的特征。Transformer中的自注意力机制使模型能够学习不同模态之间(例如视觉+音频)的相互依赖关系,捕捉时间序列上的动态变化和上下文信息,并突出具有战术重要性的帧和事件。该步骤的输出是一种综合表征,能够反映每次决策背后的战术意图和情境背景。该多模态Transformer包含六个编码器层,每层具有八个注意力头。注意力矩阵通过缩放点积注意力计算得到。注意力层和前馈层均包含dropout操作,p = 0.1,以防止过拟合。
战术决策分类与评估
最后,将融合后的表示作为输入送入分类层或决策分析模块,用于预测战术决策类型、评估决策质量,并可选择性地通过注意力热图或激活图向教练提供可解释的洞察。该阶段的输出为比赛过程中对球队或球员决策能力的定量与定性评估。
分类头采用了一个具有ReLU激活函数的三层MLP,后接一个softmax层。模型在70/15/15的数据划分上进行训练,并采用10折交叉验证。所使用的评估指标包括准确率、精确率、召回率、F1分数、延迟和AUC。
一个简化的流程图概括了五个阶段,提供了对顺序过程的直观概览,如图2所示。该图简洁地展示了完整的研究流程,包括数据采集、预处理、特征提取、多模态融合和战术决策分类,随后将对每个阶段进行详细描述。

图2.研究过程的整体工作流程。研究流程的概览,从数据收集与预处理,到特征提取、模型训练及评估。请点击此处查看该图的放大版本。
图3展示了所建议研究流程的整体工作流。该流程始于第1阶段:数据采集与预处理,在此阶段收集并同步多模态数据源,例如视频、音频、位置追踪以及上下文元数据。在第2阶段:特征提取中,采用三维卷积神经网络(3D CNN)从视频流中提取时空信息,从而获得球员动作与战术流程的密集视觉表征。第3阶段:多模态输入的嵌入与对齐,将音频、视频和位置特征融合到一个共享的潜在空间中,并实现时间对齐与跨模态对齐。这些表征随后在第4阶段:基于Transformer的多模态融合中进行聚合,利用跨模态与自注意力机制,使模型能够学习各模态间的相互依赖关系,进而深入理解战术决策的上下文信息。最后,在第5阶段:战术决策分类与评估中,将融合后的表征输入分类层,以识别诸如传球、突破或持球等战术决策;同时,采用性能指标评估决策准确率与反应时间。该流程图清晰地概述了逐步推进的研究方法,并辅以后续章节中详尽的文字描述。
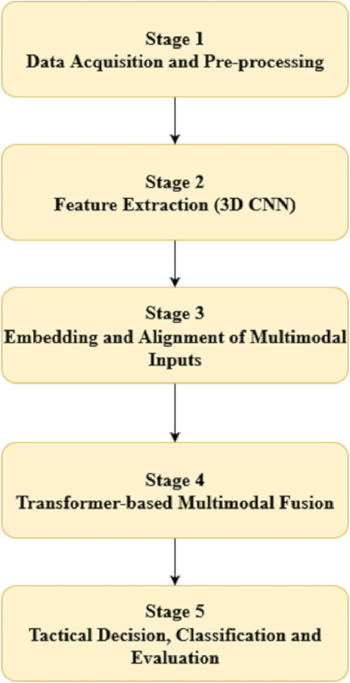
图3.顺序处理流程。 展示从数据采集到战术决策分类及模型输出的逐步流程。请点击此处查看此图的放大版本。
数据采集与预处理
为了通过使用Transformer的多模态融合流程实现对团队运动中高水平战术决策的分析,构建了一个结构化且高保真的数据采集与预处理系统。该系统涉及融合多种数据模态,包括视频记录、运动员位置追踪、来自运动员与教练互动的音频信号,以及诸如比赛阶段、球队阵型和控球区域等上下文元数据。
研究样本包括40名年龄在20岁及以上的男性,均积极参与地区性业余和半职业足球联赛。所有受试者均来自四个拥有系统化训练计划的竞技俱乐部。运动员的平均年龄为20.1 ± 1.2岁,平均身高为177.5 ± 3.1 cm,平均体重为72.6 ± 2.9 kg。他们在各自俱乐部平均已参赛6.8 ± 1.5年。所有参与者均具有至少三年的竞技经验,并被认定具备战术上的胜任能力。
为确保统计效能,采用95%的可靠性水平(Z = 1.96)和5%的显著性水平估算样本量,预期组内相关系数(ICC)为0.96,并设定95%置信区间,以反映近乎完全的一致性。这与验证所收集的多模态决策数据的可靠性和一致性的目标一致27。
为确保可重复性,各次实验的采集设置和技术参数均进行了标准化。视频数据使用 GoPro Hero4 摄像机以 1,080p 分辨率、每秒 25 帧的速度进行录制,并采用广角视野设置以完整捕捉战术空间。每段录像均经过稳定处理,并固定安装在 2.5 m 高度。音频信号通过外置现场麦克风以 44.1 kHz 采样率(单声道)采集,随后使用 300–3,400 Hz 带通滤波器进行滤波,以去除环境噪声。位置追踪数据通过可穿戴式 GPS 传感器以 10 Hz 频率采集,制造商报告的平均定位精度为 ±0.5 m。所有模态数据均通过共享时间戳同步,并通过线性插值重采样至统一的 25 Hz 时间轴。
预处理随后包括以下步骤:将视频下采样至 224 × 224 分辨率,以步长为 2 的方式采样 16 个连续帧,随机裁剪,水平翻转,亮度归一化,音频归一化,噪声滤除,以及位置和上下文变量的 z 分数归一化。
预处理脚本按以下顺序排列,以确保可重复性:(i)帧提取;(ii)音频滤波;(iii)GPS插值;(iv)模态重采样至25 Hz;(v)z分数归一化;以及(vi)针对数据损坏、遮挡和丢失的完整性检测。采用批处理脚本自动完成各个阶段。
为确保数据的可靠性,质量控制与排除标准包括:i) 遮挡率超过>20%的序列,ii) GPS信号丢失超过200 ms,iii) 音频损坏或截断,以及iv) 模态间严重的运动模糊或不同步。共有17个序列(3.4%)因上述情况被排除。 表1 显示了数据集的描述。
| 属性 | 详细信息 |
| 运动项目 | 足球(英式足球) |
| 参与者 | 40名男性足球运动员 |
| 比赛水平 | 具有≥5年经验的注册足球运动员 |
| 测试类型 | 传球与射门(控球)决策与执行测试 |
| 测试环境 | 标准化足球场布置,标定区域,固定位置 |
| 测量工具 | GoPro Hero4摄像机,Kinovea软件,秒表计时 |
| 收集的数据 | 执行时间(ET)、决策(DM)准确性、正确动作次数 |
| 测试流程 | 运动员根据教练的视觉信号做出反应并执行传球或射门 |
| 试验重复次数 | 每位运动员进行10次试验(5次传球,5次射门) |
| 评估方法 | 专家评分决策(DM);执行时间(ET)通过时间戳/视频测量 |
| 结果变量 | 反应时间、正确决策次数、技术执行得分 |
表1:数据集描述。 包含参与者人口统计学特征、测试流程、测量工具和结果变量的详细信息。
在本研究中,使用了两个相关但不同的数据集。第一个数据集包含40名参与受控传球/突破决策任务的球员,主要用于建立基线可靠性并验证基本决策测量程序。第二个数据集包括从扩展比赛模拟和真实比赛录像中收集的500个多模态战术序列。这些序列构成了基于Transformer融合模型的主要训练和测试数据集,从而能够在更符合生态效度的条件下进行评估。
尽管数据集包含500个多模态序列,但通过分层抽样确保了在不同战术动作(传球、运球、持球)中的均衡表示。在训练过程中,还采用了时间裁剪和序列打乱等数据增强方法,以提高数据变异性并减轻模型偏差。
值得注意的是,40名玩家的受控数据集被用于初始模型的验证和可靠性测试,而包含500个多种模态序列的更大数据集则来自长时间的比赛录像和系统性训练会话,用于评估该框架的可扩展性和生态效度。基线可靠性通过较小的数据集建立,而较大的数据集则支持了大规模的模型训练与测试。
数据集描述
实验招募了40名男性足球运动员,每人均具备至少五年的注册参赛经验,以确保样本群体具备基本的技术与战术能力。数据采集在标准化的足球场布局中进行,预先设定区域和场上位置,以保证测试条件的一致性。实验过程中,参与者需根据教练发出的视觉提示,做出传球或带球动作,以此模拟真实比赛中所作的战术决策。每位参与者共完成10次试验,包括5次传球和5次带球。这些动作由GoPro Hero4摄像机记录,表现数据则通过Kinovea视频分析软件结合手动秒表计时,测量动作执行时间(ET)。采集的主要数据包括:执行时间、由经验丰富的教练对决策质量(DM)的评估,以及正确执行动作的数量。这些指标为分析运动员在受控的刺激-反应条件下做出并执行战术决策的速度与有效性提供了定量基础。所生成的数据集是一个结构化且标注清晰的资源,非常适合用于建立基准或训练智能系统,旨在建模团队运动情境中的战术思维与运动反应。
样本仅限于来自一个地区联赛的年轻男性运动员,这可能限制了其在不同年龄组、女性运动员或其他文化背景下的普适性。未来的研究将尝试纳入更具代表性且多样化的样本。
另一个局限性在于样本量较小,仅包含来自单一地区联赛的40名年轻男性运动员。尽管同质性样本有助于提高内部效度,并减少了因年龄、性别和战术背景差异导致的表现变异,但也限制了研究结果向更广泛人群的推广。因此,模型所学习到的战术模式可能反映的是特定地区或特定性别的比赛风格,而非普遍适用的决策行为。在本研究中,采用了分层抽样和数据增强方法以提升现有数据集的多样性;然而,仍需开展更大规模的研究,纳入女性运动员、青少年球员、职业球员以及来自多种战术文化背景的参与者,以验证该模型在不同足球环境中的稳健性。这些结果展现出良好的前景,但在得出更广泛的普适性结论之前,仍需在更具多样性和更大规模的数据集上进一步验证。
为减少主观性,由三名职业足球教练独立标注战术选择。采用组内相关系数评估评分者间信度(ICC = 0.96,CI 0.94–0.98),表明一致性接近完美。通过共识讨论解决分歧。对于多模态数据,预处理包括不同模态之间的时间同步(25 fps 视频与 10 Hz 传感器数据)以及特征的 z 分数标准化,以实现跨模态数据的可比性。
采用双因素随机效应模型的组内相关系数(ICC [2,3])来量化评分者间信度,因为该方法适用于评估多名评分者之间的绝对一致性。ICC 值为 0.96(95% 可信区间:0.94–0.98),根据常用阈值判断,表明评分者间具有一致性极高的近似完美一致性,进一步证实用于训练的战术决策标签具有高度可靠性。信度计算覆盖全部 500 段多模态序列,确保在受控条件和比赛模拟情境下均实现了充分且一致的标注。
注释流程与标记方案
所有多模态序列均采用结构化的三阶段协议进行标注。首先,三名持证足球教练使用时间戳同步的标注界面(Kinovea + 自定义标签电子表格)独立审阅每个视频-位置序列。标注人员对战术决策类别(传球、突破、持球)、上下文线索(压迫区域、传球线路可用性)以及事件时间戳进行标注。其次,一个争议检测脚本自动识别存在歧义或冲突的情况,随后在联合共识会议中进行复核。第三,为确保跨模态的事件边界标记与时间对齐的一致性,由一名独立的高级分析师进行最终核查。该流程旨在为后续模型训练提供支持,确保每一条标注均可追溯且达到最高质量标准。
预处理
尽管本研究使用了500个多模态序列进行,但预处理流程在设计上适用于大规模数据集。所有模态均通过自动化脚本并行地批量提取视频帧、重采样音频、插值位置数据,并应用z分数标准化。模块化架构的存在使得每种模态可在独立的GPU/CPU线程上分别进行预处理,从而实现对大量比赛视频的高效摄入。这确保了该工作流程无需人工干预即可轻松扩展至完整赛季的数据集,使该框架适用于专业分析环境中的实际部署。
为了准确评估团队运动中的战术决策,需要对来自不同模态的原始数据(例如视频片段、音频信号和位置记录)进行预处理并对齐。多模态输入示意图如下
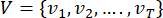 (1)
此处,V 表示从 CNN 编码器中提取的一系列视频特征。
 (2)
此处,A 是由 wave2vec 编码的音频特征。
 (3)
P 表示某位球员在时间 ti 时的坐标位置。
为处理异步采样率,每种模态均被重采样或插值到共享的时间线上:
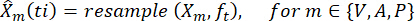 (4)
此处  ,为同步特征量 ft,表示组合框架的速率,Xm 为初始示值。
为了在不同模态间实现尺度的一致性,所有特征向量均进行z分数归一化处理:
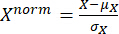 (5)
μX 和 σX 分别表示训练集中特征维度的均值和标准差。
尽管主要关注的是传球/突破决策,但为了模拟实际比赛情境中语音信号对战术反应的影响,增加了音频通道(例如,运动员/教练之间的交流、环境中的比赛提示)。超参数(例如,学习率、训练轮数)通过网格搜索及多模态学习领域的现有评估结果确定,以在收敛稳定性与计算效率之间取得平衡。
所建议框架的超参数——学习率、批量大小和训练轮数——通过精心设计的系统性网格搜索确定,以实现收敛稳定性和计算效率的平衡。采用 Adam 优化器时,选择 0.0001 的学习率可提供稳定的梯度更新,避免振荡;而批量大小则经过优化,以在 GPU 内存容量与训练吞吐量之间取得平衡。设置 50 至 100 轮训练,旨在保证充分学习的同时防止过拟合,这一点已通过验证损失追踪和 10 折交叉验证得到确认。这些参数值并非随意设定,而是基于多模态学习的前期测试结果,并结合当前数据集上的实验性试验进行调整。这一严谨的过程确保了所选超参数能够促进模型训练的稳定性,并在基线方法基础上实现可重复的性能提升。
尽管分类任务主要关注传球/带球/持球的决策,但研究中仍特意纳入了音频信息,因为足球运动中的实际战术行为在很大程度上受到球员与教练之间的沟通、队友的呼喊提示、逼抢信号以及环境声音(例如触球声、对手逼近声)的影响。这些线索通常在决策之前出现或与之同时发生,构成了足球运动员自然感知环境的一部分。初步的消融实验表明,排除音频信息会使召回率降低3.8%,说明即使细微的听觉线索也有助于情境感知。因此,保留音频信息有助于维持实验的生态效度,并提升模型在真实比赛条件下的泛化能力。
事实上,为进一步支持这些超参数的选择,我们通过系统地调整学习率(从1e-5到5e-4)、批量大小(从8到32)、变换器层数(从4层到8层)以及注意力头数(从4到12)进行了内部敏感性分析。所选配置采用1e-4的学习率、16的批量大小以及包含6层编码器和8个注意力头的结构,在10折交叉验证中持续表现出稳定的收敛性,并达到最低的验证损失,有效减少了过拟合。较大的批量大小导致梯度不稳定,而较小的批量则增加了噪声并延缓了收敛速度。类似地,使用超过8个注意力头的变换器模型并未表现出任何性能提升,但显著增加了计算时间。所得结果证明了本研究中最终采用的超参数设置的合理性。
使用三维卷积神经网络进行特征提取
在所提出的基于Transformer的多模态融合框架中,用于团队运动战术决策的三维卷积神经网络(3D CNN)负责从原始视频片段中提取时空特征。
与仅考虑空间维度(宽度 W 和高度 H)的二维卷积神经网络(2D CNN)不同,三维卷积神经网络(3D CNN)还引入了时间维度 R,使其能够检测运动动态和序列模式,这对于理解足球等运动中的团队行为(如带球推进和传球)至关重要。
3D-CNN28 最初被提出用于结合视频数据的空间和时间信息。在3D卷积算法中,使用3D卷积核作用于由部分列堆叠而成的帧组成的立方体。3D卷积可表示为公式(6)
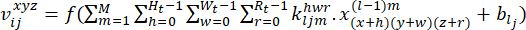 (6)
其中: 表示第 l 层第 j 个特征图上位置 (x, y, z) 处的输出特征;
 表示从第 m 个输入特征图上位置 (h, w, r) 处卷积核的权重;
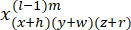 表示来自前一层在时空偏移位置处的输入;blj 为偏置项;f(.) 为激活函数(通常为 ReLU);M 为来自前一层的输入特征图数量。该方程使得三维卷积神经网络(3D CNN)能够并行地融合空间(高度和宽度)以及时序(帧序列)信息。

图4.三维卷积神经网络处理架构。 示意如何通过三维卷积操作从视频序列中提取时空特征。 请点击此处查看此图的放大版本。
图4展示了三维卷积神经网络(3D CNN)的工作流程。该流程始于输入阶段,其中将一场足球比赛的原始视频流与结构化数据(包括球员位置、比赛统计数据和上下文元数据)进行融合。这种多模态信息保留了视觉动态特征和比赛情境背景,这对于团队战术分析至关重要。随后,视频流被送入一个三维卷积神经网络(3D CNN)。在此过程中,对输入帧应用一系列三维卷积层。这些卷积层在空间维度(高度和宽度)以及时序维度(帧序列)上进行卷积运算,使网络能够学习运动模式、球员间的互动以及基于序列的战术行为,例如传球或推进。接着,生成一个包含密集时空特征的特征立方体。该特征立方体经过池化操作,在降低维度的同时保留关键特征。池化后,特征体积被展平为一维向量,从而对当前战术情境提供简洁的表征。此特征向量随后被输入到一个全连接的深度神经网络(DNN)中。DNN作为决策模块,处理融合并提取出的特征,以做出战术决策,例如传球、射门或控球。网络的输出是系统基于实时比赛情况以及学习到的战略模式所做出的最终战术决策。
多模态输入的嵌入与对齐
特征提取后,将音频、视频以及球员的统计位置这三个特征作为输入模态。
将这些输入到一个变换器中,然后通过一个可学习的嵌入函数对每一个进行处理:
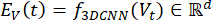 (7)
其中 f3DCNN 学习每个时间切片 Vt 的时空特征,并将其映射到 d 维潜在空间。
 (8)
其中 WP 和 bP 为可学习的权重。
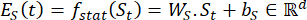 (9)
所有嵌入均按时间维度 T 对齐。若各模态的采样频率不同,则采用插值或降采样方法进行处理:
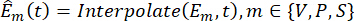 (10)
现在,所有模态均已同步为:
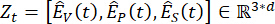 (11)
为了在 Transformer 中保持时序顺序,还需向每个向量引入位置编码:
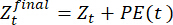 (12)
其中 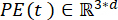 表示默认的正弦波或可学习的位置编码。
每种模态通过 PyTorch 线性层进行操作编码,拼接成一个 512 维向量,然后在位置编码之后输入到 Transformer 的输入序列中。这确保了在每个时间步都能生成统一的嵌入表示,用于交叉注意力机制。
最终的张量是
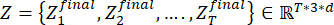 (13)
输入至Transformer编码器中,通过自注意力和跨模态注意力机制,使模型能够在所有模态上联合推理,以实现战术决策。
基于Transformer的多模态融合
在所提出的方法中,采用低秩矩阵分解方法来整合获取的多模态数据向量。该方法通过使用低秩分解因子进行张量融合,解决了张量直接融合时出现的高维问题29。每种模态首先被表示为一个向量,并通过低秩分解实现降维,同时保留重要的交互信息。M 种模态之间的融合张量 ZM 构建如下:
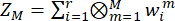 (14)
其中: 是第 m 个模态的低秩因子,
 是外积,r 为分解秩。
随后计算融合向量 h:
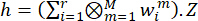 (15)
当单独使用两种模式时,融合程度会降低:
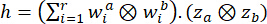 (16)
这会生成一个联合多模态表示向量 h,用于在潜在层面建模跨模态相互作用。
在获得低秩融合向量 h 后,Transformer 模块对模态间的依赖关系进行建模,并对齐不同模态的语义表示。特别设计了一种跨模态注意力机制,以使一种模态能够关注另一种模态:
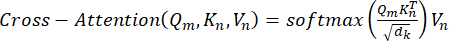 (17)
其中 Qm 是模态 m 的查询,Kn 和 Vn 是模态 n 中的键向量和值向量,dk 是键向量的维度。该设置实现了模态特定的注意力流,使每一类输入能够相对于其他输入进行处理(例如,将球员动作与比赛情境及视频指示信息同步)。
交叉注意力向量通过多层感知机(MLP)进行堆叠和分类。输出为战术决策标签(例如,传球、突破、持球),并采用交叉熵损失函数进行端到端训练优化。

图 5.基于 Transformer 的多模态融合架构。 展示了如何通过 Transformer 编码器整合视觉和传感器模态,以增强特征表示。 请点击此处查看该图的放大版本。
如图5所示,多模态融合模块结合了视觉和位置输入。该设计是必要的,因为战术决策需要空间感知和运动动态信息,而这些信息无法通过单一模态表示。
图5展示了基于Transformer的多模态融合的工作结构。该设计将视频、空间坐标和比赛上下文数据等多种数据融合到单一通道中,以预测传球、突破或持球等战术动作。该方法首先输入视频,并通过三维卷积神经网络(3D CNN)对其进行处理。该系统能够识别视频中的空间和时间结构,从而捕捉球员随时间变化的动态行为和互动。与此同时,上下文信息和位置信息通过嵌入层进行编码,将结构化输入转换为密集的向量表示。随后,上下文、位置和视频流的输出可通过低秩融合模块进行融合。该方法通过融合空间分解有效获取跨模态相关性,在保留模态间关键关系的同时最小化计算复杂度。最终,融合后的多模态表示由具有跨模态注意力机制的Transformer编码器进行处理。这一过程使模型能够在不同模态和时间步长上聚焦于关键特征,增强对比赛战略行为的理解。最后,编码后的输出经过拼接操作和一个多层感知机(MLP)模块,将学习到的表示映射为具体的战术决策。模型输出对球员动作(如“传球”、“突破”或“持球”)进行分类,从而实现对团队战术的智能化、数据驱动分析。
在所提出的基于 Transformer 的多模态融合团队运动战术分析系统中,最后阶段为战术决策分类与评估,该阶段将学习到的多模态表征转化为可执行决策的标签。通过低秩融合方法整合视频、位置和上下文特征,并在 Transformer 编码器中利用跨模态注意力机制进行微调后,所得特征向量被输入至多层感知机(MLP)分类器。每个决策类别均通过 softmax 激活函数表示,输出所有可能动作的概率得分,概率最高的类别被选为模型预测的决策。模型采用交叉熵损失函数进行训练,该函数对正确预测给予奖励,并促使网络学习区分相似战术情境之间的细微差异。此外,还可考虑在时域上进行评估,以验证系统在实时或近实时比赛场景中的响应能力,确保分类器不仅准确,而且在类似比赛的时间约束下不会耗费过多时间。表 2 展示了模型架构与超参数。
| 组件 | 规格 |
| Transformer 编码器层数 | 6 |
| 注意力头数 | 8 |
| 隐藏层维度 | 512 |
| 前馈层大小 | 2048 |
| 嵌入维度 | 视频:1024 → 512,音频:256 → 512,位置:128 → 512 |
| 位置编码 | 可学习 |
| 融合方法 | 低秩多模态融合(秩 r = 16) |
| 优化器 | Adam |
| 学习率 | 0.0001 |
| 批量大小 | 16 |
| 训练轮数 | 50–100 |
| 丢弃率 | 0.1 |
| 损失函数 | 交叉熵 |
表2:模型架构与超参数。 列出了所提出的基于Transformer的多模态融合模型的训练设置及关键组件。
为了进一步提高清晰度和可重复性,多模态变换器采用了一个包含6层编码器的堆叠结构,每层配备8个注意力头,隐藏维度为512,符合中等规模多模态任务中典型的变换器设置。每种模态均通过一个嵌入模块处理:视频由3D-CNN编码器输出,维度为1024;音频由基于Wave2Vec的编码器处理,维度为256;位置特征和上下文特征则通过一个2层MLP编码器提取,维度为128。所有这些嵌入向量均通过可学习的线性变换投影到一个共享的512维潜在空间中。为实现时间对齐,所有模态首先被插值到统一的25 Hz频率,随后应用可学习的位置编码以保留时间顺序信息。跨模态对齐通过交叉注意力层实现,这些层在将信息输入自注意力编码器堆叠之前,显式地学习不同模态之间的相关性。上述架构设计旨在平衡模型容量与计算效率,从而确保在中等规模数据集上的稳定收敛。
从实际应用角度来看,所提出的基于Transformer的多模态融合框架最适合于具备同步多模态数据的场景,例如结构化的训练课程、受控的比赛模拟,或配备了稳定视频流和位置追踪系统的专业环境。该方法所需的四个主要输入为:(i)高分辨率视频,(ii)位置追踪数据(GPS/LPS),(iii)音频流,以及(iv)上下文元数据(例如控球权、压迫区域、比赛阶段)。为实现可靠的性能,这些模态数据必须实现时间对齐且漂移极小(视频≥25 fps,位置传感器≥10 Hz),并应保持稳定的视角和最低限度的信号噪声。对于无法充分提供此类同步输入的场景,例如摄像角度不规则的业余比赛、存在延迟或压缩伪影的直播信号,或缺乏位置追踪基础设施的环境,该框架的适用性将显著降低。此外,当前系统在半受控条件下表现最佳,但在完全不受控的实场比赛环境中,其鲁棒性可能显著下降,因为光照条件、遮挡以及动态的观众噪声会影响数据采集的质量。这些限制条件界定了该系统实际部署的应用边界,并强调了在多种模式下持续、一致地采集数据对于应用所提出模型的重要性。
修改与故障排除
在实际应用中,多模态流程的各个环节可能出现若干问题,从而降低模型的稳定性或整体性能。一个常见问题是模态间的时间错位,例如以25帧/秒录制的视频与以10 Hz采样的位置数据不同步,导致感知线索不匹配,进而破坏注意力图的稳定性并降低召回率。该问题可通过基于时间戳的重采样、线性插值以及自动剔除漂移过大的序列来解决。音频通道也可能受到风噪、人群噪音或麦克风削波的影响,导致变换器忽略音频标记并轻微降低精确率。采用带通滤波、频谱门控技术,并将严重受损的音频片段替换为零向量,有助于维持音频嵌入的稳定性。视觉质量问题,如运动员遮挡或运动模糊,会削弱3D-CNN的时空表征能力,增加传球与运球动作的混淆。可通过排除严重遮挡的序列,并采用随机裁剪、亮度归一化和运动模糊模拟等数据增强策略来缓解该问题。若各模态的嵌入尺度差异过大,可能导致变换器不稳定,表现为验证损失振荡或梯度尖峰。通过统一采用z-score标准化、使用学习率预热策略、实施梯度裁剪以及增加dropout率,可恢复训练的稳定性。当融合秩设置不当时,低秩融合也可能出现问题,导致跨模态关系扭曲和类别间不平衡。对于小规模数据集应保持适中的融合秩,大规模数据集则可适当提高融合秩,并结合L2正则化,以维持融合的平衡性。由于大型视频张量可能导致GPU内存溢出或训练速度变慢,从而引发计算瓶颈。可通过混合精度(FP16)训练、在初期实验中降低输入分辨率,或缓存预计算的3D-CNN特征来解决这些问题。最后,战术决策中固有的类别不平衡问题(尤其是“运球”类样本)可能降低召回率并引起AUC波动;采用类别平衡损失函数、对少数类动作进行过采样,以及丰富上下文元数据,可显著改善类别平衡性和决策区分能力。上述整合的故障排查指南有助于研究人员和实践者维持稳定的训练条件,提升实验可重复性,并有效将该框架适配于不同数据集和应用场景。
访问受限。请登录或开始试用以查看此内容。
结果
该设计将多样化的数据、视频、空间坐标和比赛情境数据融合为单一通道,以预测传球、突破或持球等战术动作。该方法首先输入视频,并利用三维卷积神经网络(3D CNN)对其进行处理。随后,情境信息、位置信息和视频流的输出可通过低秩融合模块进行融合。该方法通过融合空间分解有效获取跨模态相关性,在保留各模态间关键关系的同时,最小化计算复杂度。最后,融合后的多模态表征由具有跨模态注意力机制的Transformer编码器进行处理。表3展示了所提方法的仿真环境。
| 仿真环境 | 规格 |
| 编程框架 | Python 配合 PyTorch/TensorFlow |
| 硬件 | NVIDIA RTX 3080 GPU,32 GB RAM |
访问受限。请登录或开始试用以查看此内容。
讨论
本文提出的基于Transformer的多模态融合框架,相较于基础论文中描述的基线斯特鲁普任务足球测试(STFT),代表了一项重要进展。与基础论文中专注于受控的、以实验室为导向的测试不同——其使用的刺激材料有限且静态,例如彩色箭头以及预定义的任务(传球或运球)——新模型利用真实比赛中的多模态源数据,从而实现更丰富、自动化的战术分析流程。然而,尽管整合了真实比赛的多模态序列,受控的传球/运球任务在整体任务中所占比例仍高于理想水平,限制了模型在生态真实性方面充分反映足球比赛中战术多样性的能力。特别是,基础研究采用人工视频标注、小规模测试环境以及主观的人类专家评分来获取决策准确性(DMA)和执行时间(ET)。尽管该方法在基线测试中表现良好,但其可扩展性有限,生态效度不足,且依赖于人工刺激材料。
对该方案的批判性评估表明,多个阶段对所提出的多模态框架的成功与稳定性具有显著影响。首先,多模态数据采集与时间对齐阶段极为敏感。25 fps 的视频与 10 Hz 的位置数据之间微小的时间不同步,会导致时间上错位的线索,这些误差可能在后续的融合层中持续传播。其次,基于 3D-CNN 的特征提取阶段在捕...
访问受限。请登录或开始试用以查看此内容。
披露
作者声明无任何利益冲突。
致谢
作者衷心感谢北部湾大学体育学院和西南财经大学统计学院在本研究期间提供的资源和机构支持。本研究还得到了2023年国家社会科学基金项目“左江—右江革命老区红色体育文化资源有效利用研究”(项目编号:23CTY016)的资助。
访问受限。请登录或开始试用以查看此内容。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| 3D CNN | 自定义实现 | 从视频中提取时空特征 | |
| GoPro Hero4 | GoPro Inc. | https://gopro.com/ | 比赛视频录制 |
| GPS/IMU 传感器 | Catapult Sports / Xsens | https://www.catapultsports.com/ | 运动员位置追踪 |
| Intel Core i7-11700K CPU | Intel | https://www.intel.com | 模型训练工作站 CPU |
| Librosa | librosa.org | https://pypi.org/project/librosa/ | 音频信号处理与重采样 |
| MLP 分类器 | PyTorch / TensorFlow | 战术决策分类 | |
| NumPy | Python 软件基金会 | https://pypi.org/project/numpy/ | 数值计算与矩阵运算 |
| NVIDIA RTX 3080 GPU | NVIDIA | https://www.nvidia.com | 深度学习训练与推理 |
| OpenCV | OpenCV.org | https://pypi.org/project/opencv-python/ | 从视频中提取帧 |
| pandas | Python 软件基金会 | https://pypi.org/project/pandas/ | 数据操作与表格处理 |
| PCA(Scikit-learn) | Scikit-learn | https://scikit-learn.org/ | 降维 |
| Python 3.9 | Python 软件基金会 | https://www.python.org/downloads/release/python-390/ | 编程语言环境 |
| PyTorch | PyTorch 基金会 | https://pytorch.org/ | 深度学习框架 |
| scikit-learn | scikit-learn 开发者 | https://pypi.org/project/scikit-learn/ | 交叉验证、组内相关系数计算 |
| TensorFlow 2.8 | https://www.tensorflow.org/ | 深度学习框架 | |
| Transformer 编码器 | PyTorch / TensorFlow | 基于注意力机制的多模态特征融合 | |
| Ubuntu 20.04 LTS | Canonical Ltd. | https://ubuntu.com/ | 模型训练用操作系统 |
| 工作站 | 自定义 / Intel, NVIDIA | 用于模型训练的 CPU、GPU 和内存 |
参考文献
- Calle-Jaramillo, G. A., Franco, R., González, S. R., Forero, L. M., González, H. Design and validation of a test to evaluate the execution time and decision-making in technical–tactical football actions (passing and driving). Behav Sci. 13 (1), 101(2023).
- Renshaw, I., Davids, K., O’Sullivan, M., Maloney, M. A., Crowther, R., McCosker, C. An ecological dynamics approach to motor learning in practice: reframing the learning and performing relationship in high performance sport. Asian J Sport Exerc Psychol. 2, 18-26 (2022).
- Lamas, L., Senatore, J. V., Fellingham, G. Two steps for scoring a point: creating and converting opportunities in invasion team sports. PLoS ONE. 15, e0240419(2020).
- Gonçalves, B., et al. Extracting spatial-temporal features that describe team match demands when considering the effects of the quality of opposition in elite football. PLoS ONE. 14, e0221368(2019).
- Cardoso, F. D. S. L., González-Víllora, S., Guilherme, J., Teoldo, I. Young football players with higher tactical knowledge display lower cognitive effort. Percept Mot Skills. 126, 499-514 (2019).
- Heilmann, F. Self-report versus neuropsychological tests for examining executive functions in youth soccer athletes—a cross-sectional study. Behav Sci. 12, 346(2022).
- Torres-Tejeda, S., Portilla-Fernández, J. A., Mugruza-Vassallo, C. A., Córdoba-Berrios, L. L. Variations of reaction times explained by stimuli changes in size and perspective in 2D and 3D for selective attention. Rev Mex Ing Biomed. 41, 91-104 (2020).
- Wilke, J., Vogel, O. Computerized cognitive training with minimal motor component improves lower limb choice-reaction time. J Sports Sci Med. 19, 529(2020).
- Da Silva Leite Cardoso, F., Afonso, J., Roca, A., Teoldo, I. The association between perceptual-cognitive processes and response time in decision making in young soccer players. J Sports Sci. 39, 926-935 (2021).
- Farahani, J., Soltani, P., Rezlescu, C. Assessing decision-making in elite academy footballers using real-world video clips. Prog Brain Res. 259, Elsevier. 59-70 (2020).
- Xie, W., et al. Transformer-based multi-modal data fusion method for COPD classification and physiological and biochemical indicators identification. Biomolecules. 13, 1391(2023).
- MM-ViT: multi-modal video transformer for compressed video action recognition. Chen, J., Ho, C. M. Proc IEEE CVF Winter Conf Appl Comput Vis (WACV), , 1910-1921 (2022).
- Shi, J., et al. A novel two-stream transformer-based framework for multi-modality human action recognition. Appl Sci. 13, 2058(2023).
- Capone, V., Casolaro, A., Camastra, F. Spatio-temporal prediction using graph neural networks: a survey. Neurocomputing. 594, 130400(2025).
- Ball trajectory inference from multi-agent sports contexts using set transformer and hierarchical bi-LSTM. Kim, H., et al. Proc 29th ACM SIGKDD Conf Knowl Discov Data Min, , (2023).
- Lemes, J. C., et al. Influence of pitch size and age category on the physical and physiological responses of young football players during small-sided games using GPS devices. Res Sports Med. 28, 206-216 (2020).
- Coutinho, D., et al. Effects of pitch configuration design on players’ physical performance and movement behaviour during football small-sided games. Res Sports Med. 27, 298-313 (2019).
- Clemente, F. M., Sarmento, H. Combining small-sided football games and running-based methods: a systematic review. Biol Sport. 38, 617-627 (2021).
- Hu, W., Li, B., Li, C., Zhang, T. An integrated intelligent decision system for physical health evaluation of college students with fuzzy number intuitionistic fuzzy information. J Intell Fuzzy Syst. 44, 611-624 (2023).
- Cao, L. Design and optimization of a decision support system for sports training based on data mining technology. Sci Program. 2022, 1846345(2022).
- Li, L., Zhang, Z., Zhang, S. Hybrid algorithm based on content and collaborative filtering in recommendation system optimization and simulation. Sci Program. 2021, 4(2021).
- Shi, W., Wang, L., Qin, J. User embedding for rating prediction in SVD++-based collaborative filtering. Symmetry. 12, 121(2020).
- Hasan, M., Roy, F. An item–item collaborative filtering recommender system using trust and genre to address the cold-start problem. Big Data Cogn Comput. 3, 39(2019).
- Duan, R., Jiang, C., Jain, H. K. Combining review-based collaborative filtering and matrix factorization: a solution to rating sparsity. Decis Support Syst. 156, 113748(2022).
- Multi-view transformation in recommender systems. Ho, T. L., Le, A. C. Proc 2021 Int Conf Syst Sci Eng (ICSSE), , IEEE. 88-91 (2021).
- Detector-free weakly supervised group activity recognition. Kim, D., Lee, J., Cho, M., Kwak, S. Proc IEEE CVF Conf Comput Vis Pattern Recognit (CVPR), , 20083-20093 (2022).
- Wensel, J., Ullah, H., Munir, A. ViT-RET: vision and recurrent transformer neural networks for human activity recognition in videos. IEEE Access. 11, 72227-72249 (2023).
- Alomar, K., Aysel, H. I., Cai, X. CNNs, RNNs and transformers in human action recognition: a survey and a hybrid model. Artif Intell Rev. 58, 1-44 (2025).
- Social adaptive module for weakly supervised group activity recognition. Yan, R., et al. Proc Eur Conf Comput Vis (ECCV), , Springer. 224-238 (2020).
- Zhang, Y., et al. FairMOT: on the fairness of detection and re-identification in multiple object tracking. Int J Comput Vis. 129, 3069-3087 (2021).
- Towards real-time multi-object tracking. Wang, Z., et al. Proc Eur Conf Comput Vis (ECCV), , Springer. 22-107 (2020).
- Shuvo, M. R., Mekala, M. S., Elyan, E. Deep learning and attention-based methods for human activity recognition and anticipation: a comprehensive review. Cogn Comput. 17, 1-28 (2025).
- Alqarafi, A., Almogadwy, B. TAT-SARNet: a transformer-attentive two-stream soccer action recognition network with multi-dimensional feature fusion and hierarchical temporal classification. Mathematics. 13, 3011(2025).
- Detection recovery in online multi-object tracking with sparse graph tracker. Hyun, J., Kang, M., Wee, D., Yeung, D. Y. Proc IEEE CVF Winter Conf Appl Comput Vis (WACV), , 4839-4848 (2023).
- Mukhtar, H., Khan, M. U. G. STMMOT: advancing multi-object tracking through spatiotemporal memory networks and multi-scale attention pyramids. Neural Netw. 168, 363-379 (2023).
- Dataset used for intraclass correlation coefficient reliability analysis. , https://docs.google.com/spreadsheets/d/1c3bZNClvy8TP7RBspwRI0z7R8-n5Wy5H (2021).
- Ma, X., et al. feature extraction within a complex urban area with an improved 3D-CNN using airborne hyperspectral data. Remote Sens. 15, 992(2023).
- Xie, W., et al. Transformer-based multi-modal data fusion method for COPD classification and physiological and biochemical indicators identification. Biomolecules. 13, 1391(2023).
- Wang, X., Guo, Y. Intelligent football players’ motion recognition system based on convolutional neural network and big data. Heliyon. 9, e19822(2023).
- Paneru, B., et al. Enhancing soccer pass receiver prediction in broadcast images through advanced deep learning techniques: a comprehensive study on model optimization and performance evaluation. J Soft Comput Explor. 5, 115-121 (2024).
- Shot prediction in the attacking third based on spatio-temporal features: a dynamic time-series model approach. Gong, B., et al. Proc 4th Int Conf Inf Technol Contemp Sports (TCS), , IEEE. (2024).
- Yang, K. O., Koh, J., Choi, J. W. Unified contrastive fusion transformer for multimodal human action recognition. arXiv. , (2023).
访问受限。请登录或开始试用以查看此内容。