本文介绍了一种高通量的抗体胶体稳定性检测方法的大规模应用,用于生成大型数据集,并支持可直接用于人工智能/机器学习的可开发性预测。
本文内容
摘要
摘要
抗体工程中的一个关键挑战是开发用于评估胶体稳定性的分析性筛选方法,以确保生物制剂适用于高浓度配方及给药。电荷稳定型自相互作用纳米粒子光谱法(CS-SINS)是传统亲和捕获自相互作用纳米粒子光谱法(AC-SINS)的改进版本,已被调整为一种可靠的胶体稳定性评估 方法,用于预测高浓度溶液中的行为。该方法能够在投入大量资源之前识别出胶体稳定性问题,从而支持关键的早期可开发性决策,显著降低后期候选分子的淘汰率,并加快候选分子筛选的时间进程。本研究证明,该检测方法可无缝整合到现有的发现工作流程中,且由于其样品需求极低,可与典型的早期阶段检测并行开展,在不影响其他表征工作的前提下提供预测高浓度行为的宝贵数据。已有研究表明,除了等离子体共振波长的偏移外,常规的动态光散射(DLS)测量还可提高本文所述高通量方法的可靠性。综上所述,预期通过DLS测量与自动化分析程序的交叉验证,将有助于可靠地筛选出各类模式的候选抗体治疗药物。
引言
在治疗性抗体的开发与制剂过程中,乳光现象和黏度是开发以患者为中心的商业化产品时需要重点考虑的因素1,2,3,4,5,6,7,8。传统上,需使用大量蛋白质才能在高浓度下直接观察这些性质,这在抗体发现早期阶段实际上阻碍了最优候选分子的识别,因为在该阶段蛋白质的可获得性有限。可靠地识别这些现象对于可开发性评估至关重要,以减轻后续高浓度溶液行为不良的问题1,2,3,4,5,6,7,8。因此,人们高度关注那些能够在低蛋白浓度下实现高通量、并可预测高浓度溶液不良行为的方法9,10,11,12,13,14,15,16。其中一种方法——扩散相互作用参数-动态光散射法(kD-DLS)已被证明可用于可靠预测高浓度性质,但其在蛋白质消耗量和通量方面尚不能满足早期研发流程的低用量、高通量要求12,13。
最近,一种基于金纳米粒子的超低消耗检测方法(CS-SINS)被证明与kD-DLS实验结果具有高度相关性,并能有效预测高浓度条件下的不良溶液性质。16这些特性使 CS-SINS 成为开发高通量筛选工具的理想候选技术。CS-SINS 检测利用固定在金纳米颗粒表面的捕获抗体来锚定候选抗体 通过 其Fc区域,使Fab臂能够与溶液中的分子相互作用。这种构型意味着测得的自聚集信号主要由Fab-Fab相互作用主导,这一特点具有优势,因为研究表明Fab结构域主要决定了单克隆抗体的自聚集特性,这很可能与互补决定区(CDR)的表面特性有关。17,18,19,20,21,22,23这一作用机制使得 CS-SINS 非常适用于预测与高浓度制剂相关的胶体稳定性风险。其他高通量(HTP)方法,包括直立单层吸附色谱法(SMAC)——一种基于尺寸排阻色谱(SEC)柱、利用通用固定相对自缔合作用进行模拟的方法,以及交叉相互作用色谱法(CIC)——均涉及色谱柱制备和大量样品需求。17,24,25,26,27.
本文所述方法详细介绍了CS-SINS检测的经微孔板验证的实验体系,通过实验室自动化和数据分析实现高通量筛选,在结合现有方法优势的同时,提高了结果的可靠性。本研究还展示了由于该检测方法对分子自身相互作用具有富集特性,多种类型的样本均可获得高质量结果,从而证明该方法对蛋白质来源具有普适性。此外,我们探讨了将胶体性质的相关信息更早地传达给项目团队,如何进一步支持多特异性抗体药物的策略性设计28,29,30,31,32,33,34。
高浓度溶液性质的研究通常在多特异性候选分子筛选流程的后期阶段进行,即在先导分子筛选及工程化改造完成之后(图1A)。随着诸如CS-SINS等方法的发展,仅需数微克样品即可实现对这些性质的早期预测,从而通过超低稀释浓度下的测量来预测胶体稳定性风险16。在候选分子数量较多的早期阶段引入可开发性高通量筛选(图1A),并针对单特异性和多特异性分子形式开展并行数据生成,将更有助于指导药物发现过程31,32。高通量CS-SINS可与现有的结合力和功能测定并行整合到分子筛选体系中,因此可在不干扰或延迟现有工作流程的前提下,丰富候选分子的信息数据包。在先导候选分子筛选中强调优良的胶体性质,将影响后续的筛选进程,如图1B所示。
在提出的早期可开发性筛选工作流程中,先导化合物的识别需全面考虑有利的药物特性,包括生产制造和患者用药可及性,从而简化后续开发流程34。生物制剂的高浓度特性可决定其给药途径:需前往医院进行的静脉注射,或患者可在家中自行给药的皮下注射,后者通常需要高浓度制剂35,36。具有低自聚集特性的可开发单克隆抗体(mAbs)通常被配制在 >100 mg/mL 的浓度5,35。在临床前候选药物开发阶段,通过使用辅料(如降低黏度的试剂)进行处方优化,可克服因溶液性质不佳带来的胶体稳定性风险34,35。然而,这会为生物制药生产带来下游挑战,并延长成功获得药物批准所需的时间36。已知可降低黏度的辅料(如盐类和氨基酸)也可能影响蛋白质稳定性,改变先前表征的可开发性特征,使开发过程更加复杂36,37。此外,过量使用辅料可能因免疫原性问题、多种安全性顾虑,或对治疗依从性的影响而限制适用患者人群,并在生产过程中引入新的挑战38,39,40。Starr 等人首次发表了 CS-SINS 方法,描述了 PLL 与 IgG 的最佳质量分数为 0.03,并通过 ζ 电位测量证实了在组氨酸处方中 PLL 对单克隆抗体自聚集的纳米颗粒稳定作用16。值得注意的是,添加过多 PLL 会导致检测体系过度稳定,从而阻碍对单克隆抗体自相互作用的观察(PLL 提高金纳米颗粒稳定性的效果见补充图 1)。使用不含盐的组氨酸处方可最小化静电屏蔽效应(增加德拜长度),从而延长分子间相互作用范围,放大弱自聚集信号,并模拟高浓度条件下抗体分子更接近时的行为。通常情况下,对于未观察到自聚集现象的高浓度制剂,优先选择低离子强度的处方。
大分子PLL聚合物会阻碍更多的捕获型单克隆抗体在金纳米颗粒表面的结合,从而缩小等离子体共振位移窗口,进而需要更复杂的曲线拟合程序和分析方法来进行后续数据处理。本研究利用了一个与内部数据库同步的网络门户工具。这种前期投入的主要优势在于,能够从大规模序列库中构建数据,以最大化下游候选分子的多样性,并缓解在成本较高的开发阶段可能出现的瓶颈问题。34,35,36. 本文所述的CS-SINS检测法是一种与高通量筛选兼容的方法,已被证明与后期胶体稳定性检测结果具有良好的相关性16人工智能辅助分析正在推进未来项目的多特异性分子的合理设计,并有助于理解复杂结构中各结构域的独立作用41,42,43,44这些努力将共同影响对抗体治疗药物胶体稳定性特性的荟萃分析和更精确的评估,从而最终在早期研发阶段节省时间&D 阶段。
方案
图2展示了纳米颗粒偶联制备过程,图3展示了完整的工作流程,图4绘制了实验室自动化流程,图5包含了数据分析流程的示意图。所用试剂和设备列于材料表中。
1. 缓冲液的配制
注意:第 1 周(样品制备)
- 配制组氨酸溶液(10 mM,pH 6.0)(样品缓冲液和检测缓冲液)。
注意:这些步骤在第1天进行。- 将5 mM L-组氨酸单盐酸盐一水合物和5 mM L-组氨酸溶解于超纯水中。边搅拌边逐滴加入盐酸,同时使用校准过的pH计监测,直至pH达到6.0。
- 在真空条件下,通过孔径为0.22 µm的滤膜过滤溶液,并将滤液收集至无菌瓶中。
- 为质量控制目的测定溶液电导率,确保读数约为500 µS/cm。
- 配制醋酸钾溶液(20 mM,pH 4.3)(捕获单克隆抗体偶联缓冲液)。
- 将醋酸钾溶解于超纯水中,并用冰醋酸调节pH至4.3。
- 按照步骤1.1.2所述方法,通过0.22 µm孔径滤膜真空过滤对该溶液进行除菌。
- 配制聚-L-赖氨酸溶液。
- 用超纯水配制5 mg/mL的储存液,保存于−20 °C,待用。
2. 所有样品(候选单克隆抗体)的透析
注意:在第 2–5 天执行这些步骤。
- 将100 µL或300 µL透析器在10 mM组氨酸、pH 6.0溶液中预浸泡5分钟。
- 将所有样品(50–100 µL)转移至透析夹心盒中。将夹心盒浸入10 mM组氨酸缓冲液(pH 6.0,每盒700 mL),在储液槽中加入搅拌子,将储液槽置于磁力搅拌板上,在4 °C孵育2小时15分钟。
- 每隔2小时15分钟更换一次10 mM组氨酸缓冲液(pH 6.0),共更换七次;或进行四次过夜缓冲液更换,以确保充分去除样品中的盐分。
- 回收样品,转移至洁净的样品基质小瓶中,并在4 °C保存,直至进行CS-SINS检测。
- 透析后测定样品浓度并记录多分散性信息。通过将280 nm处的原始吸光度值除以1 mg/mL溶液在280 nm处的吸光度值,计算校正后的浓度。
- 根据孔位地址和浓度(µg/mL)准备液体处理仪输入文件,包括对照样品。
3. 捕获型单克隆抗体的缓冲液置换(图2,步骤1)
注意:在第2周第1天(检测当天)执行这些步骤。
- 在室温下以 1,000 × g 离心 2 分钟,从 2 mL 脱盐柱中去除保存缓冲液。每 700 µL 所需的捕获单克隆抗体需准备两根脱盐柱。每次离心后弃去穿流液。
- 用 1 mL 的 20 mM 乙酸钾缓冲液(pH 4.3)洗涤脱盐柱三次,每次洗涤均以 1,000 × g 离心 2 分钟。
- 向每根脱盐柱中加入 700 µL 捕获单克隆抗体(山羊抗人 Fcγ 特异性抗体),并在 1,000 × g 条件下离心 2 分钟,将洗脱液收集至新的 15 mL 管中。
- 收集脱盐后的洗脱液,将其转移至第二个已平衡的脱盐柱中,并再次以 1,000 × g 离心 2 分钟。
- 合并所有洗脱的样品。
- 脱盐后,按照第 2–5 天步骤 2.5 所述方法测定捕获单克隆抗体溶液的浓度。
- 用 20 mM 乙酸钾缓冲液(pH 4.3)将捕获单克隆抗体储备液稀释至 0.8 mg/mL,并置于一旁备用。
4. 聚-L-赖氨酸工作液的制备
- 用超纯水将聚-L-赖氨酸储备液的小份样品稀释至 2.66 mg/mL。
5. 金纳米颗粒的浓缩(图2,步骤2)
- 使用含有20 nm金纳米颗粒的聚丙烯微量离心管,将储备悬浮液分装为1.2 mL等份至1 mL离心管中,或分装为4.8 mL等份至5 mL离心管中。在21,130 × g 条件下离心6分钟。
- 小心移除上清液(约1.1–1.15 mL),避免扰动沉淀,然后将上清液转移至另一个锥形管中。
- 将浓缩后的沉淀物及残留液体合并至一个洁净的微量离心管中。通过移液确定纳米颗粒体积,并利用保留的上清液将总体积调整为(1 mL离心管数量 × 50 µL)或(5 mL离心管数量 × 200 µL)。例如,在对10份1.2 mL样品(分装于1 mL离心管)进行离心后,应将浓缩纳米颗粒的最终体积调至500 µL。
6. 纳米颗粒组装
- 将1.5 µL聚-L-赖氨酸工作溶液与48.5 µL缓冲液置换后的捕获单抗溶液充分混合(图2,步骤3)。
- 将第5步得到的浓缩纳米颗粒溶液与第6.1步得到的聚-L-赖氨酸/捕获单抗溶液按1:1比例混合(图2,步骤4)。
- 将混合物在室温(23 °C)下孵育过夜(图2,步骤5)。
7. 液体处理仪检测板设置
注意:在第 2 天执行这些步骤。
- 准备检测所需的材料,包括透析后的抗体、含有透析后浓度信息的液体处理仪输入文件、偶联金纳米颗粒、机器人操作吸头、板和储液槽(图3,实验室自动化,步骤1)。根据 图3 所示布局将吸头、样品、板和储液槽预装至仪器平台(实验室自动化,步骤1)。
- 将对照品加入样品板的 A12–D12 孔中(两个阳性对照和两个阴性对照)。H12 孔留空,用于液体处理仪制备的缓冲液样品。
- 打开液体处理仪的 CS-SINS 方法并启动程序(图3,实验室自动化,步骤2–3)。当提示时加载液体处理仪输入文件,并输入样品数量(图4A)。检查随后出现的两个计算核对窗口(图4B、C),确认数值无误后继续运行。
- 将样品(包括对照)用 10 mM 组氨酸缓冲液(pH 6.0)稀释至终浓度为 55.5 µg/mL,总体积为 100 µL,通过将样品从基质样品管转移至聚合酶链式反应板完成(图4D,步骤1)。监控运行进度,已完成的板区域显示为灰色,正在进行的步骤以绿色高亮显示(图4E)。
- 将每个样品用 10 mM 组氨酸缓冲液(pH 6.0)进一步稀释为较大体积的 11.1 µg/mL 溶液,通过将样品从聚合酶链式反应板转移至深孔板,终体积为 200 µL(图4D,步骤2)。
- 在步骤2完成后让系统暂停。当提示时,通过反复倒置管子并上下吹打约10次,混匀步骤6.3中制备的浓缩金纳米颗粒。
- 将纳米颗粒均匀分装至两个聚丙烯微量离心管中,并将管子打开盖子后放置在平台指定的管架位置(图4D 中高亮标注“AuNP”处)。恢复运行,使液体处理仪每次向第二个深孔板的两个孔中各分配 20 µL 纳米颗粒(图4D,步骤3)。
- 让液体处理仪将 192 µL 样品从含有 11.1 µg/mL 样品的深孔板(图4D,步骤2)转移至第二个深孔板,并充分混匀。为每个样品制备 4× CS-SINS 主混合液,在向终体积 240 µL 中加入 48 µL 金纳米颗粒后,样品终浓度为 10 µg/mL(图4D,步骤3)。此时启动 4 小时孵育计时器。
- 让液体处理仪先向源孔中分配 30 µL,然后向 384 孔板每个象限的四个孔中的三个孔各分配 60 µL,为每个样品生成技术重复三份(图4D,步骤4)。将剩余的 30 µL 返回至源板。
- 在运行过程中监控液体处理仪平台的布局。观察已使用的吸头和已加样孔的颜色由浅灰色实时变为深灰色,正在进行的操作以绿色标识(图4E)。
- 运行完成后取出板,使用低粘性透明封板膜密封,并在室温下孵育共 4 小时。在 3.5 小时时,启动动态光散射程序,使用 补充图2 所示设置将腔室平衡至 20 °C。
- 在 4 小时时点,以 1 nm 为步长测量每孔在 510 至 570 nm 范围内的吸收光谱(峰值两侧各 30 nm)。
- 在 4.5 小时时点立即使用动态光散射板式读数仪测量该板,测量参数见 补充图2。
注意:由于动态范围有限,应使用高性能板式读数仪进行光谱测量。请勿使用快速读数功能。
8. 数据分析(图5,数据处理流程)
- 从分光光度计平台导出原始文件,并保存至可访问的驱动器文件夹中。
- 访问与内部服务器相连的脚本网页门户。输入所需的 CS-SINS 输入参数,包括:(1)起始波长;(2)原始结果文件的目录位置;(3)板组和候选标识符;(4)用于归一化的阳性和阴性对照孔地址;(5)方法设置指定"手动" 或 "液体处理仪");(6)用于光谱扫描和动态光散射测量的仪器;(7)电子实验记录本(ELN)编号;(8)数据采集日期。
- 提交参数至网络门户,并确认在原始结果目录的子文件夹中生成了三个 Excel 文件。
- 使用网络门户执行的曲线拟合脚本计算 λmax 值。
- 查看包含平行样本数值、归一化结果以及光谱扫描和动态光散射测量的代表性图表的两个输出文件。
- 使用包含检测元数据和标准化结果的第三个输出文件,在数据库用户界面中创建批量实验室结果。根据各组特定要求定义报告属性,并将结果上传至数据库,以实现公司范围内的访问。
结果
图6展示了结果,补充图3A显示了代表性粗提样品和纯化样品的CS-SINS评分示例,补充图3B描述了不同日期间各孔之间信号的变异性,补充图4包含了平板验证过程的结果,而补充图5则说明了两种CS-SINS检测读数的归一化计算方法。
重要的是,为确保检测的可行性,样品经透析后收集,透析缓冲液为 10 mM 组氨酸(pH 6.0),报告浓度至少为 55 µg/mL,因为这是最低储备浓度(每份样品至少 6 µg),并由此生成了新的子代标识符。总共包含 70 份纯化样品和 20 份粗提表达样品,分别代表在不同可开发性检测节点的样品类型(纯化样品来自先导优化阶段,粗提样品来自先导化合物发现阶段,经一步或两步纯化获得,如图 1A所示)。粗提样品由全自动哺乳动物表达系统——蛋白质表达与纯化平台(PEPP;GNF,美国加利福尼亚州圣地亚哥)生成。对照品来源于商业材料,此前已验证其具有最高或最低的黏度、kD-DLS 和 CS-SINS 值。新鲜分装样品储存于 -80°C,每次检测均使用新的分装样品。
图6A,B 按样本类型绘制的平均光谱和DLS得分,柱状图显示了对应颜色编码的误差棒(标准差)。归一化由脚本计算得出,即将样本与阴性对照之间的差值(通过光谱位移计算的λ最大值,或Z-平均值、流体动力学直径,单位为nm)除以各对照之间的差值补充图5). 图6C 将光谱得分与DLS得分进行对比作图,展示了两种分析方法之间的明显相关性。 表1 列出了用于参考的标识符、孔位地址、样本类型、光谱评分以及DLS评分及其标准偏差。对于单特异性IgG而言,胶体稳定性风险的阈值(无论光谱或DLS读数)为归一化值高于0.35(图中以绿色虚线表示) 图6A,B6/70(不含重复对照)纯化样品被评为高风险,而64/70的纯化样品被评为低风险。值得注意的是,对于多特异性分子形式,预期其临界值会更高。在粗提表达样品中,2/20样品被评为高风险,18/20被评为低风险。本研究中测试的纯化样品,其部分亲本批次的粗提表达物也进行了检测,结果相似(如图所示) 补充图 3A),表明该检测方法在从独立批次中放大(纯化)候选蛋白质时具有代表性。尽管样本量有限,但需注意的是,粗提PEPP样品的标准误差可能高于纯化样品。在后期阶段进行CS-SINS的优势在于,可与需要较多蛋白进行分析的检测方法(如黏度和kD-DLS测量)联用,实现正交评估;而在早期可开发性筛选阶段进行CS-SINS的优势则在于可提前识别胶体稳定性风险,从而可能影响最终的候选分子筛选结果。图 1B)。具有高误差的临界样本可通过后续检测进一步确认为高风险或低风险。
由于检测到的等离激元位移变化非常微小,因此描述了一种替代的读数方法,以增强对检测结果的信心,该方法可拓宽动态范围,在缺乏高端酶标仪来检测微小变化的情况下可能尤为有用。DLS读数能够区分纳米颗粒的聚集状态,而不依赖于纳米颗粒的光谱特性;然而,这两种方法的标椎误差范围相似,且相对于其测量值而言均较小。似乎更容易出现离群值读数的样本会具有更高的误差(或表现为“多峰分布”而无法由DLS报告结果),但CS-SINS值在检测工作范围内的样本具有较低的误差分布。在比较DLS值与光谱评分值时,来自粗提样本的DLS结果比光谱评分具有更集中的误差分布;然而,这种差异仅影响到一个候选样本,该样本的DLS评分低于阈值,但光谱评分未低于阈值。如果实验室配备有不同的仪器,这种方法可能具有实用价值。
为了具体评估数据处理方法本身及其可靠性,对上述数据集中阳性和阴性对照的两种检测方式均进行了从头到尾的扫描时间调整,同时增设多个中、低浓度对照,作为384孔板起始和结束位置的中间参考点。补充图4展示了最终板验证的结果,显示置于孔板起始与结束位置的样本数值差异大多无统计学意义(补充图4A,B),且两种检测读数之间具有高度相关性(补充图4C)。最后,基于光谱扫描和DLS数据集中的对照样本,计算了图6中的Z因子和%CV值。根据此处提供的对照数据,光谱扫描检测的Z因子为0.648,阳性对照的变异系数(CV)为0.019%,阴性对照为0.012%;而DLS检测的Z因子为0.998,阳性对照的CV为0.025%,阴性对照为0.021%。总体而言,本检测中样本数值之间的Spearman相关系数(图6C)计算为0.829,呈强正相关。这些数值表明两种测量方式均具有良好的精密度和可重复性。不出所料,新型且更具优势的DLS检测策略优化了Z因子,但光谱扫描仍提供了足够的信号分离带,可用于记录可靠结果(Z > 0.5)。需要强调的是,DLS信号是在CS-SINS工作流程中同步获取的正交读数,无需额外的样本制备步骤。原始DLS得分的数值差异更大,从而实现了更高的Z因子,但“得分”经标准化处理后具有相同的解释方式。此外,DLS读数可捕捉纳米颗粒聚集体的三维尺寸信息,而等离子体位移和光谱信息仅提供邻近关系的间接指示,这可能有助于加深对CS-SINS检测动态过程的理解。考虑到高通量(HTP)检测基于微孔板且具有时间敏感性,我们旨在通过这些方法提高检测的可靠性。
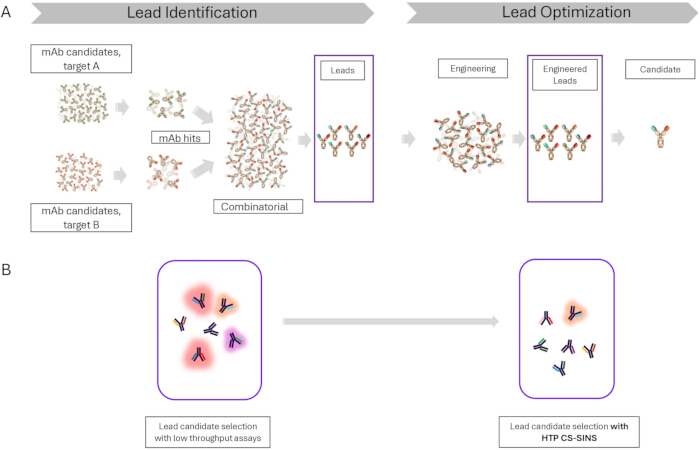
图 1:可开发性研究范式及 CS-SINS 数据采集。(A)本图展示了多特异性抗体从发现阶段到候选分子筛选的典型工作流程。发现过程首先产生用于筛选的单特异性候选分子,随后通过多种数据包进行评估,以缩小感兴趣的单特异性分子范围,再将其组合成多特异性形式。通过重复或扩展数据包分析,进一步缩小先导候选分子范围,直至选出最优候选分子进入开发阶段。当筛选出少量分子时,当前工作流程中会进行低通量检测(紫色框)。HTP CS-SINS 可在该路径的每个阶段实施,提供有价值的数据,从而优化筛选过程。(B)展示了两种不同路径下前6个候选分子胶体性质的假设结果:一种是基于低通量检测进行先导候选分子筛选,另一种是结合 HTP CS-SINS 进行筛选。具有不良溶液行为的候选分子以发光效果表示。在第一种情形中,基于发现阶段筛选出的最佳结合特性所选定的先导候选分子,有一半表现出较差的高浓度行为。而在第二种情形中,由于在早期发现筛选中同时考虑了 CS-SINS 数据与结合数据,仅包含一个胶体稳定性中等偏差的候选分子。在第二种情形下,潜在可行候选分子的多样性高于第一种情形。请点击此处查看该图的放大版本。
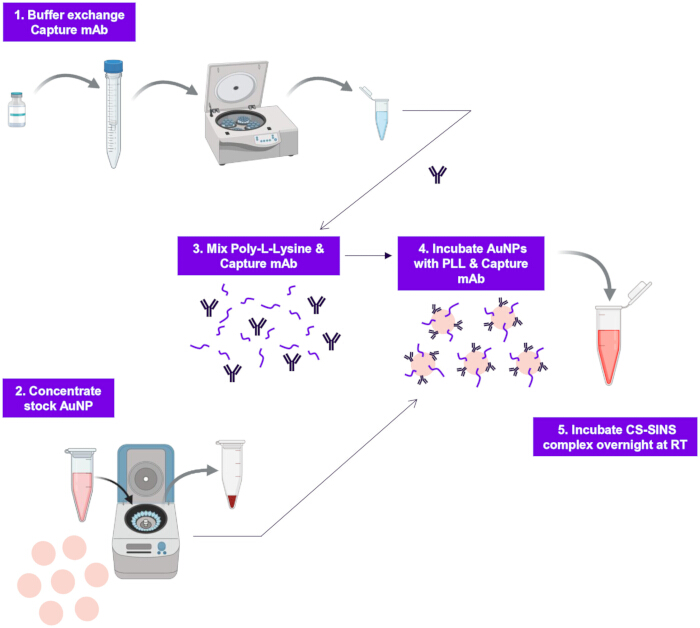
图2:SINS检测流程图。金纳米颗粒的制备与偶联步骤:(1)将捕获用单克隆抗体(mAb)置换至20 mM乙酸钾缓冲液(pH 4.3)中,并稀释至0.8 mg/mL。(2)从原液中浓缩金纳米颗粒。(3)将聚-L-赖氨酸与缓冲液置换后的捕获mAb混合。(4)将金纳米颗粒与聚-L-赖氨酸及捕获mAb共同孵育,并充分混匀。(5)将CS-SINS复合物在室温下孵育过夜。请点击此处查看该图的高清版本。
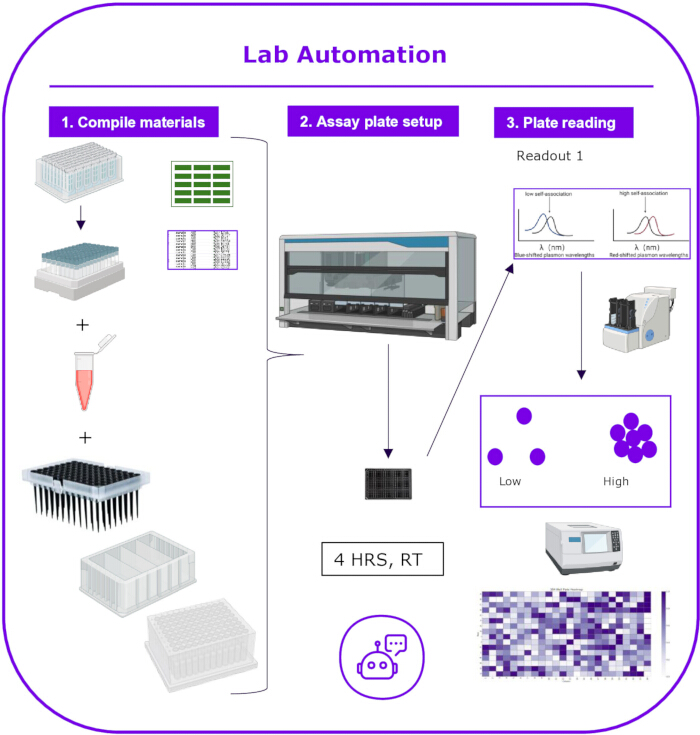
图 3:实验室自动化工作流程。实验室自动化工作流程:(1)为液体处理仪方法准备材料和样品。将缓冲液置换为 10 mM 组氨酸(pH 6)的样品收集于矩阵管或 96 孔板中。将样品浓度信息整理成液体处理仪可读的输入文件。收集 CS-SINS 复合物金纳米颗粒(偶联捕获单克隆抗体)、自动化液体处理吸头及塑料耗材,以备液体处理仪检测体系的建立。(2)在液体处理仪上制备检测板,并于室温孵育 4 小时。(3)在 4 小时时间点,对样品孔进行光谱扫描(读数 1),持续 25 分钟;在 4.5 小时时间点后,通过动态光散射(读数 2)获取各孔中更为均一的颗粒群体的粒径信息。请点击此处查看该图的放大版本。
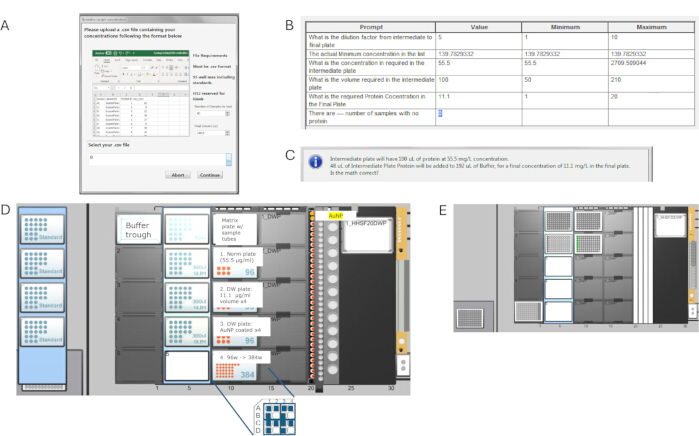
图4液体处理程序与板设置. (A程序启动且系统初始化后,将弹出一个独立窗口/提示框,用于选择包含指定孔位地址和样品浓度的输入文件。每次均需指定样品数量,但200 µL体积(384孔板 Stamp 加样前混合试剂的最终体积)保持不变。B点击后 继续 从前一个窗口中(A),此第二个窗口将显示左侧输入文件的解析结果及右侧的对应数值,以供确认。C) 在确认了来自(B),此时会出现第三个窗口,弹出对话框,再次核对用于归一化的样品浓度计算(100 µL 体积)与最终深孔板(200 µL 体积)之间的数学关系。D此布局来自液体处理软件模块的方法编辑器视图。左侧装载了300 µL标准吸头;在平台中央,装载了1盒50 µL和3盒300 µL细吸头,这些吸头与液体处理机器人兼容。前方放置了一个缓冲液槽,内含10 mM组氨酸缓冲液(pH 6),该缓冲液为样品透析所用。金纳米颗粒被均分至2个微量离心管中,敞口放置于右侧试管架的后部。带有样品管的基质板装载于载体后部第10列。紧随样品之后,依次为归一化板(1)、含11.1 µg/mL样品的深孔板(2)、合并样品与纳米颗粒的200 µL深孔板(3),以及384孔板格式的板(4)。E液体处理工作站的甲板布局可实时显示吸头的取用和样品的分配过程,并在每一步操作进行时标记相应的孔位。此处,所有样品(位于载体后部的96孔板图像)rd 柱)以及后续的归一化板均显示为灰色,表明样本已从源矩阵板添加至归一化板。图中绿色部分显示八通道吸头从槽中吸取缓冲液后,将其加入归一化板的第一列并进行混匀操作。 请点击此处以查看此图的放大版本。
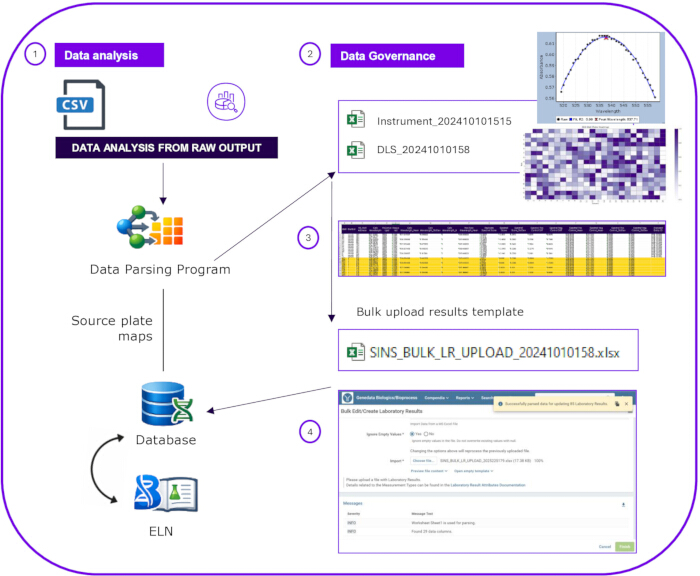
图5数据处理方案数据处理流程:(1)原始数据文件被提交至内部服务器。(2)通过定制脚本读取并处理数据文件,以优化光谱扫描的曲线拟合,计算CS-SINS重复样本的λmax,并利用动态光散射(DLS)筛选多峰分布的颗粒群体。(3)数据按重复组进行归类,随后对各组取平均值并相对于指定对照进行归一化处理;数据库门户中的对应孔板图谱被调用以关联结果。(4)所有数据被整理成可直接上传至数据库的模板格式,同时自动生成图表用于电子实验记录本(ELN)报告。 请点击此处以查看此图的放大版本。
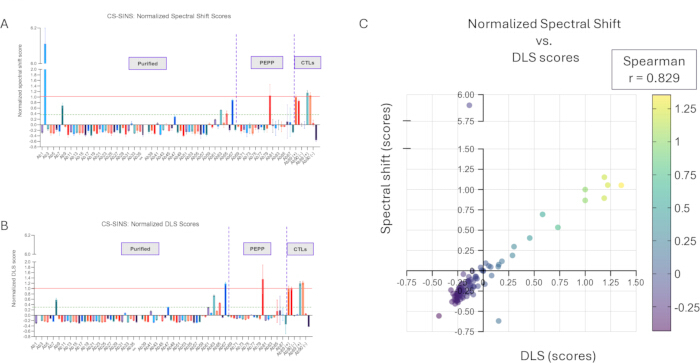
图6:读数1和读数2的代表性数据. (A将归一化光谱位移评分按PPB编号绘制为柱状图,分别展示纯化样品、粗提表达样品及对照样品(如图所示,并以垂直虚线分隔),以确定不同样品类型间的误差棒分布。实心红线表示检测的上限值,对应阳性对照;绿色虚线表示CS-SINS低风险分子谱型的截断值。B归一化的DLS评分按PPB ID以柱状图形式绘制,分别对应纯化样品、粗提表达样品以及对照样品(如图所示,不同类型样品之间以虚线分隔),以确定各样品类型间的误差棒分布情况。部分数值缺失(例如2)nd 浅蓝色表示高于平均水平的分数(A)由于DLS输出的多模态扫描结果被脚本软件网页门户判定为无效。实心红线表示检测的上限值,对应于阳性对照;而绿色虚线表示CS-SINS低风险分子谱型的截断值。C归一化后的光谱位移得分与DLS值得分的平均值通过相关性散点图进行比较(如图所示,光谱位移得分对应Y轴,DLS得分对应X轴)。颜色编码仅与DLS得分相对应。 请点击此处以查看该图的放大版本。
表1. 通过CS-SINS测定的抗体样品胶体稳定性评分。 该表格总结了样品编号、孔位地址、样品分类、归一化光谱评分以及来自CS-SINS检测的动态光散射(DLS)评分。请点击此处下载该表格。
补充图1:PLL 提高了 AuNP 在 10 mM His 缓冲液(pH 6)中用于 CS-SINS 的稳定性。该图显示,在 PLL 包被的 CS-SINS 复合物上结合阴性对照 mAb 以及仅含缓冲液的对照组中,光谱峰高度重叠;相比之下,未包被的金纳米颗粒与阴性对照 mAb 或单独缓冲液的光谱峰则位于完全不同的范围。蓝色曲线表示在 4 小时时间点以 1 nm 为步长采集的、与 AuNP 偶联后在 10 mM His 缓冲液中孵育的光谱扫描结果,叠加了未预先孵育聚-L-赖氨酸(poly-l-lysine)时与阴性对照(PPB-117487)偶联微珠的扫描结果。红色曲线表示在 4 小时时间点以 1 nm 为步长采集的、与 AuNP 偶联后在 10 mM His 缓冲液中孵育的光谱扫描结果,叠加了预先孵育聚-L-赖氨酸后与阴性对照(PPB-117487)偶联微珠的扫描结果。在存在 PLL 的情况下,两种阴性对照的计算 λmax 值非常接近。请点击此处下载该文件。
补充图2: 动态光散射实验及DLS板式读取仪所用孔板的设置参数。请点击此处下载该文件。
补充图3: PEPP中表达的抗体与下游纯化后抗体的CS-SINS评分对比。(A)以孔位和板编号为单位绘制了PEPP样品(例如,A1PL1 = 第1板A1孔)表达Ab64的归一化光谱偏移评分,并通过垂直虚线与下游纯化Ab64的归一化光谱偏移或DLS评分分隔,在柱状图中展示以确定不同类型样品间的误差棒分布(标准差)。绿色虚线标记了CS-SINS低风险分子谱型的截断值。(B)此处绘制了(A)中实验运行的所有样品在整块板上的总AUC及其分布情况(不同对应实验以颜色编码)。请点击此处下载该文件。
补充图4: 384孔板对照的端到端验证。(A)将384孔板前几列样品的平均归一化光谱评分绘制成图,以红色表示;而在384孔板末尾扫描的重复值则以浅绿色显示。重复值并列排列,从阳性对照(在PPB编号旁用加号标注)到阴性对照(在PPB编号旁用减号标注)。由液体处理程序制备的缓冲液对照(独立于样品输入提示)的值以格子图案表示。(B)将384孔板前几列样品的平均归一化DLS评分绘制成图,以红色表示;而在384孔板末尾扫描的重复值则以浅绿色显示。重复值并列排列,从阳性对照(在PPB编号旁用加号标注)到阴性对照(在PPB编号旁用减号标注)。由于存在多模态读数,DLS检测中无缓冲液对照值。(C)将从384孔板前几列至末尾样品的平均归一化光谱评分与DLS评分绘制为相关性散点图。数据点的颜色编码直接对应于平均归一化的光谱扫描评分。由于DLS检测无缓冲液对照值(因多模态读数所致),本图中仅比较两种检测方法各自的6个对照重复值。请点击此处下载该文件。
补充图5:光谱评分或DLS评分归一化的计算方法,以实现用户之间及不同日期之间的通用报告与参照。阳性对照值设定为1,阴性对照值设定为0,高分值表示胶体行为较差。请点击此处下载该文件。
讨论
本方案在原始 CS-SINS 方法的基础上进行了多项关键性改进16。重要的是,优化后的 PLL:IgG 比例和组氨酸缓冲体系均沿用了原始研究中的条件16。最显著的改进是将该检测方法适配至液体处理机器人平台,从而实现高通量处理(每天最多可处理 352 个样本,而原先约为 20 个),通过自动化液体操作减少了人工干预时间,并提高了实验的可重复性。该机器人系统兼容基于微孔板的多种格式,包括可转印至新的格式(如 384 孔板)以及多种类型的实验耗材。各程序可独立运行,端到端的工作流程在样本受限的情况下仍能提供高通量的检测结果,并显著提升可重复性。此外,还引入了动态光散射(DLS)作为光谱位移的正交检测手段,其 Z 因子优于光谱位移分析结果(0.998 对比 0.648),这对于光谱评分处于临界值或标准偏差较高的样本尤为有价值,并有助于解释等离子体位移现象,从而扩展仅从酶标仪输出结果中获得的动态范围。建议不具备高端多功能酶标仪的实验室可采用 DLS 可靠地执行 CS-SINS 检测。为解决 384 孔板中可能存在的随时间变化的变异性问题,进行了广泛的板间验证(补充图 4),通过在孔板起始和结束位置均设置对照,确认了扫描时间对结果的影响极小。此外,研究还证明粗提的 PEPP 样本可获得与纯化材料相当的结果(图 6,补充 图 3A),从而将该方法的应用范围扩展至早期发现阶段,即在无法获得纯化蛋白的情况下仍可使用,此点此前未见报道。 补充图 3 中的数据显示不同来源样本之间具有良好的可靠性,同时也表明该检测方法在不同日期之间的变异极小,因为数据来自不同的数据集并进行了归一化处理。更具体而言,补充图 3B 展示了来自各实验孔板所有孔的曲线下总面积(颜色编码以对应 补充图 3A 中同一实验的相应孔板),用以说明同一实验内以及不同日期、不同磁珠制备批次下所预期但极小的变异性。在早期发现阶段,诸如 kD-DLS 和基于层析柱的方法(SMAC、CIC)由于样本消耗量较高且无法处理粗提物,因而不可行12,13,24,25,26,27;而 CS-SINS 在此阶段具有独特优势,仅需每样本 6 µg 蛋白即可进行胶体稳定性筛选,且蛋白可仅经一步纯化。最后,曲线拟合脚本已更新,以支持对微小的 lambda max 位移进行精细调整,并实现更优的文件管理及向内部数据库自动导出数据报告。
常见的故障排查情况包括:(1)光谱或动态光散射(DLS)检测结果的标准差较高,通常表明纳米颗粒混合不充分(步骤 7.6)或样品发生聚集;此时建议使用 DLS 对透析后的样品进行质量控制检查,以确认透析后样品的完整性,并优先采用光谱评分作为标准读数;(2)DLS 分布呈多峰或 DLS 检测失败,通常由样品预先存在的聚集或灰尘污染引起;在透析前通过 0.22 µm 滤膜过滤可缓解此问题;(3)光谱评分与 DLS 评分之间存在差异,通常归因于 DLS 测量值偏差(可能由于多分散性较高,此时光谱评分通常处于正常至较高范围);(4)阳性对照值不一致,通常由纳米颗粒储存不当或捕获型单克隆抗体降解所致;每次实验应使用新鲜分装并储存在 -80 °C 的试剂(避免在 4 °C 储存超过数天)。
该检测方法的一些局限性包括:需要时间对样本进行充分透析,并在检测前一天半手动地制备偶联纳米颗粒;然而,透析所需时间与样本数量无关。关于吸头堵塞风险,液体处理吸头会在吸取过程中监测压力变化,相关错误会在操作中显现。在方法开发阶段,我们检查了日志文件(并在后续维护后持续检查),以确保脚本正确计算预期体积。浓缩珠制剂的分装功能已经过测试,预计不会出现问题。我们认识到该检测具有时间敏感性,评估主要由Fab段主导,并且作为一种替代性检测方法,无法直接测量胶体行为(如黏度和乳光现象)。然而,这种改进使得在药物发现早期能够高效表征更大规模的数据集,成为此前尚不存在的强大筛选工具。
本方案中有多个关键步骤需特别注意,以确保结果的可重复性。首先,在缓冲液配制过程中精确调节pH值(步骤1.1.1和1.2.1)至关重要,pH偏差超过±0.1单位可能影响纳米颗粒的稳定性及抗体捕获效率。用于捕获抗体配制的低pH缓冲液可确保最佳偶联效果,所规定的缓冲条件已针对电荷稳定性和广泛的抗体兼容性进行了优化(通常在制剂背景下)。10 mM组氨酸缓冲液(pH 6.0)可在维持蛋白质稳定性的同时提供最佳的静电相互作用。其次,彻底透析并完全去除盐分(步骤2.3)极为关键,透析不完全会干扰纳米颗粒组装过程中的静电相互作用。第三,金纳米颗粒的浓缩步骤(方案步骤5.1–5.3)必须谨慎操作,避免扰动沉淀物,因为纳米颗粒浓度不一致将直接影响检测的灵敏度。第四,聚-L-赖氨酸(PLL)与捕获单克隆抗体(mAb)的比例0.03(步骤4.1)已优化至可在保持足够等离子体位移窗口的同时实现最大表面覆盖率,此比例此前已有确立16。在液体处理动力学方面,在引入金纳米颗粒之前,使用液体感应吸头执行归一化和板内混合操作;而金纳米颗粒在溶液中无法被可靠检测,因此设定分配体积为标准值。上游液体感应可帮助操作人员识别板错位或样本缺失等问题,而384孔 stamping 步骤则可识别Z轴对齐问题。最后,严格遵守4小时孵育时间(方案步骤7.10–7.12),并始终从头到尾完整读取整块板(即使板未完全加样)至关重要,因为等离子体位移和纳米颗粒聚集是时间依赖性现象;延迟或提前读数可能导致CS-SINS评分不准确,而完整读取整板可确保高通量(HTP)格式下跨天评分的一致性。
随着对多特异性抗体胶体稳定性的研究日益深入,CS-SINS等高通量生物物理检测所提供的大型数据集有望用于训练人工智能/机器学习(AI/ML)模型,以更深入地理解分子稳定性上的组合效应。研究表明,随着序列多样性增加,为提高AI/ML结果的准确性,所需的数据集规模也随之增大41,42,43。当单特异性分子被重构为双特异性或三特异性分子时,其原有的性质和分子描述符可能发生改变,这需要从整体分子电荷分布与平衡的角度进行考量,而非仅基于序列或特定基序来评估化学降解风险等属性17,18,19,20,21,22。值得注意的是,诸如预测的静电斑块、疏水性以及溶剂可及表面积等结构特征,能够在不依赖序列特异性特征的前提下提升对聚集性和稳定性的预测能力,从而使多个较小规模的数据集也适用于预测模型的构建17,18,19,20,21,22。CS-SINS评分作为分子生物物理特性综合表现的代表性指标,其简洁性使其非常适合用于AI/ML模型的训练。
披露
作者声明不存在利益冲突或竞争性经济利益。
致谢
我们谨向以下团队和个人致以诚挚感谢,感谢他们提供的宝贵意见和富有见地的讨论:Jonathan Kingsbury(开发可行性与制剂前科学CMC部门负责人),感谢他提供的专业见解;密歇根大学药学与化学工程教授Peter Tessier,感谢他在CS-SINS方法开发过程中的合作;在本项目发展过程中来自LMR各部门或与之相关的其他成员(特别感谢Samantha Schultz、Xiaohua Liu、Megan Salemi、Tina Matin、Julie Jaworski、Sanjana Mandala、Kalie Mix、Maciej Majewski、Jinrong Ma、May Cindhuchao、David Reczek、Tristan Magnay、Drew Lynch、Ailin Wang、Dietmar Hoffmann、Eva Bric-Furlong、Karen Wong、Leighton Marcovici、Christian Lange、Christa Pescher、Ben Mittelstaedt和Melanie Fischer);以及赛默飞世尔科技公司负责缓冲液制备的团队(特别感谢Archer Killingsworth和Elisa Ferrara)。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| CLEARSEAL 封膜 100片装 | Fisher Scientific | 500214 | |
| CO-RE II (50 μL 导电探针,300 μL 导电探针,300 µL型细导电尖端 | Hamilton公司 | 235966, 235902, 235806 | |
| Eppendorf管 带卡扣盖(5.0 mL,微量管) | Eppendorf | 30119401 | |
| Falcon 锥形离心管(15 mL) | 赛默飞世尔科技 | Falcon 352196 | |
| 山羊抗人 Fcγ-特异性抗体 | 杰克逊免疫研究实验室 | 109-005-008 | |
| 金纳米颗粒(20 nm) | Ted Pella 公司 | 157051 | |
| Greiner Bio-One 384孔板 μ透明底聚苯乙烯微孔板 – (SS & DLS 检测板 | Fisher Scientific | 07-000-057 | |
| Greiner Bio-One MASTERBLOCK 96 孔深孔锥底 2 mL 储存板 – (主混合液和试剂混合板) | Fisher Scientific | 07-000-122 | |
| 硬壳PCR板标准化(96孔,低矮型,薄壁,带裙边,白色/透明 HSP9601) | 伯乐(Bio-Rad) | HSP9601 | URL: https://www.bio-rad.com/zh-cn/sku/HSP9601-hard-shell-96-well-pcr-plates-low-profile-thin-wall-skirted-white-clear?ID=HSP9601 |
| 组氨酸盐酸盐缓冲液样品(10 mM,pH = 6.0,样品与检测缓冲液) | Sigma | H8125;H6034 | 将每种试剂用超纯水配制为终浓度5 mM,调节pH至6.0,用超纯水定容,经0.22 μm滤膜过滤 μm 滤膜 |
| Matrix ScrewTop 管样品(500 μL) | 赛默飞世尔科技 | 3744 | |
| MD100 或 MD300 Xpress Mini 透析仪(Xpress Micro Dialyzer,Scienova,6–8 kDa,96 孔深孔板装(12 个盒),密封膜)及透析槽/盒(低体积透析夹心盒) | Vivaproducts, Inc. | 40789, 40076 | |
| 1.5 mL 纯聚丙烯微量离心管 | USA Scientific | 1615-5500 | |
| Nalgene 一次性聚丙烯机器人储液槽 – (缓冲液槽) | 赛默飞世尔科技 | 1200-2300 | |
| Nalgene 快速流速无菌一次性滤器(PES 膜) | 赛默飞世尔科技 | 567-0020 | |
| 聚-L-赖氨酸 >70,000 MW | MP Biomedicals | 219454405 | 在超纯水中配制 5 mg/mL 的储备液 |
| 阳性对照与阴性对照(1 mg/mL,透析至10 mM 组氨酸缓冲液,pH 6) | 内源性商业抗体 | N/A | 阳性对照出现约 2 nm 的光谱偏移,DLS 粒径为 250–300 nm;阴性对照光谱偏移可忽略,DLS 粒径与仅含缓冲液的对照组相当 |
| 乙酸钾缓冲液捕获(20 mM,pH = 4.3,单克隆抗体偶联缓冲液) | Fisher Scientific | P171-500 | 将试剂用超纯水配制成10 mM的终浓度,用乙酸调节pH至4.3,再用超纯水定容,经0.22 μm滤膜过滤 μm 滤膜 |
| Zeba 脱盐柱(2 mL、5 mL 或 10 mL) | 赛默飞世尔科技 | PI-89889; 89891; 89893 |
重印与许可
本文已发表
视频即将推出