RNA二级结构主要通过结构探针技术在成熟RNA中进行观察。共转录结构追踪测序技术(CoSTseq)将已用于研究聚合酶在新生RNA上位置的核内延伸技术与结构探针技术相结合,从而实现了对处于活跃转录过程中的RNA的二级结构的观测。
需要JoVE订阅才能观看此内容。 请登录或开始免费试用
方法文章
新生转录本与成熟转录本的RNA结构比较分析 酿酒酵母(Saccharomyces cerevisiae)
* These authors contributed equally
本文内容
摘要
摘要
转录过程中,新生RNA在离开RNA聚合酶(Pols)时即开始碱基配对。这种碱基配对促使RNA结构的形成,从而在RNA加工、翻译和稳定性水平上显著影响基因表达。目前研究RNA二级结构的既定方法仅限于成熟转录本,而对于折叠状态的研究仍知之甚少。此外,由于相对丰度较低(< 1%)以及新生RNA的瞬时性为其分离与表征带来困难。共转录结构追踪技术(CoSTseq)结合转录延伸反应中掺入生物素标记的核苷三磷酸(biotin-NTP)和二甲基硫酸酯(DMS)探针,可同时获取RNA聚合酶的位置信息及新生转录本的碱基配对状态。在 酿酒酵母(Saccharomyces cerevisiae) CoSTseq 可获取由三种 RNA 聚合酶(RNA Pols)转录的新生 RNA 3'-端附近的序列与结构信息。在转录延伸过程中,生物素标记的核苷三磷酸(biotin-NTP)在聚合酶活性位点处掺入,有效阻滞 RNA 聚合酶的进一步延伸。随后,使用二甲基硫酸酯(DMS)处理样本,使未配对的腺嘌呤(A)、胞嘧啶(C)和尿嘧啶(U)发生甲基化修饰。接着通过生物素富集及使用模板转换逆转录酶进行 cDNA 合成,实现双端测序,并计算 DMS 反应活性随聚合酶位置的变化情况。CoSTseq 可与 DMS 探针技术(DMS-MaPseq)平行开展,从而同时捕获折叠后的成熟转录本结构信息。本文提供了 CoSTseq 与 DMS-MaPseq 平行实验的详细操作流程,包括转录延伸反应、文库构建及数据分析方法。 关键词:CoSTseq,DMS-MaPseq,新生 RNA,RNA 聚合酶,转录延伸,DMS 甲基化,结构探针,高通量测序,cDNA 合成,模板转换逆转录酶.
引言
RNA 可通过分子内的碱基配对折叠成二级和三级结构,这些结构还可受到充当分子伴侣的蛋白质影响,从而引导 RNA 的正确折叠1。RNA 结构具有高度动态性,细胞内的 RNA 可根据其热力学景观采取多种构象,形成一组可能的 RNA 三维结构集合2。这种动态的构象变化可能影响基因调控和表达3,4。相反,RNA 也可形成高度稳定的结构,这些结构与其功能密切相关,例如 tRNA、小核 RNA(snRNA)和 rRNA。尽管这些例子强调了成熟 RNA 在调控中的重要作用,但真核生物的 RNA 加工过程通常与转录同时发生,包括前体 mRNA 剪接、3'端切割以及 RNA 修饰。同样,RNA 的折叠也可能在转录本成熟之前即已开始,如其他文献所述5。
尽管RNA序列可以编码其二级结构,但准确确定其结构通常需要在体外或体内进行实验验证in vitro或in vivo。随着诸如DMS-MaPseq(二甲基硫酸盐突变谱分析结合测序)等结构特异性化学修饰技术的发展,现已能够从活细胞中解析细胞内RNA的二级结构6。将DMS引入细胞后,它会特异性地甲基化腺苷、胞苷以及一定程度上的尿苷的沃森-克里克碱基配对面,而这些位点只有在未配对状态下才可被修饰。经DMS修饰后,可使用高保真且高度持续性的逆转录酶(如耐热II型内含子逆转录酶,TGIRT)7,将修饰过的碱基在最终构建的cDNA文库中转化为突变位点。这些突变可用于推断RNA在核苷酸水平上的可及性。尽管该技术功能强大,DMS-MaPseq及相关方法迄今主要被用于研究已完全折叠的成熟RNA6。
已开发出多种方法用于研究新生RNA的调控与加工过程。为克服RNA-seq技术的局限性,研究者开发了全局延伸测序(GROseq)技术。RNA-seq仅能检测细胞中RNA水平的稳态,因此所提供的信息是转录、RNA加工及降解等影响RNA水平过程的平均结果。GROseq利用溴代尿苷进行核内延伸实验,使RNA聚合酶(Pol)能够在新生RNA上以数十个碱基的分辨率添加核苷酸8。在此基础上发展出的精确延伸测序(PROseq)技术,则通过使用生物素标记的核苷三磷酸(biotin-NTPs)实现了在单碱基分辨率上对新生RNA上RNA聚合酶位置的定位。该方法中,当RNA聚合酶在新合成RNA的3'末端最后一次被检测到时,即加入一个生物素标记的核苷酸9。
最近,Schärfen 等人开发并使用了共转录结构追踪技术(Co-transcriptional Structure Tracking, CoSTseq),该技术利用并改进了生物素延伸标记(biotin run-on)和DMS探针法,实现了对酿酒酵母(S. cerevisiae)新生转录本RNA结构的测定10。CoSTseq 能够在活跃转录过程中测定RNA二级结构;本实验方案详细描述了在CoSTseq实验中如何将核内延伸标记(nuclear run-on)与DMS探针法相结合。由于CoSTseq在样品制备过程中需要精细操作,并且在数据分析阶段需严格把控数据质量,因此本方案详述了在Illumina测序平台上构建适用于双端测序文库的最佳实践。CoSTseq实验可同时获得新生RNA和成熟RNA,后者可作为DMS-MaPseq数据集进行分析,从而实现新生RNA与成熟RNA之间的严格比较(图1)。实验方面,需要获取用于维持酵母培养、开展核内延伸标记及DMS探针实验的相关试剂,具体要求如下文所述。新生RNA的产量对CoSTseq文库构建和数据分析的成功至关重要,因此合适的培养条件(包括适宜的培养箱和培养基)是确保获得足够起始材料的关键。最后,为开展CoSTseq数据的计算分析,建议使用高性能计算(High-Performance Computing, HPC)集群。
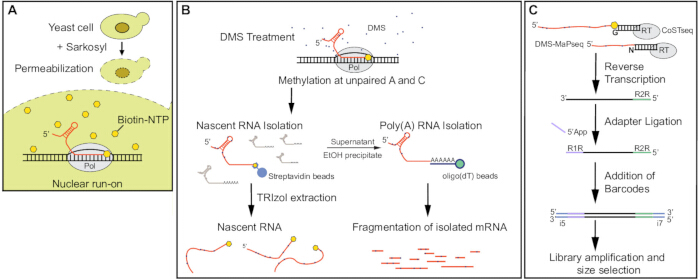
图 1:同一生物样本中联合进行CoSTseq与DMS-MaPseq文库构建的流程概览。(A) 使用月桂酰肌氨酸钠(sarkosyl)对酵母细胞壁和细胞核膜进行通透化处理,可在核内转录延伸反应中使生物素标记的核苷三磷酸(biotin-NTP)掺入新生RNA的3'末端。(B) DMS对通透化细胞中的新生RNA和成熟RNA上未配对的A和C残基(有时也包括U)进行甲基化修饰,随后通过苯酚/氯仿抽提获得总RNA。接着,利用链霉亲和素偶联的磁珠从总RNA中纯化出新生RNA;再通过TRIzol抽提将新生RNA从磁珠上洗脱下来。与此同时,含有聚腺苷酸化mRNA的磁珠上清液可经乙醇沉淀;由此材料可通过寡核苷酸(dT)磁珠下拉法分离mRNA。在文库构建前,Poly A+ mRNA需进行片段化处理。(C) 分别使用模板转换逆转录酶从新生RNA或成熟RNA生成cDNA,随后连接5'和3'接头,以引入N7 UMI和条形码(CoSTseq的详细步骤见图 2)。需注意的是,DMS-MaPseq与CoSTseq的逆转录步骤将使用不同的异源双链接头,其突出端分别与CoSTseq中使用的biotin-NTP和DMS-MaPseq中使用的N突出端互补。为减少文库偏差,扩增时采用最少的PCR循环数,并进行片段大小筛选以去除接头二聚体。请点击此处查看该图的放大版本。
访问受限。请登录或开始试用以查看此内容。
方案
注意:实验开始前,请确保已准备好表 1中列出的所有缓冲液。所有试剂均应使用无核酸酶的水配制。若使用非分子生物学级别的化学品/试剂配制缓冲液,建议对缓冲液进行过滤除菌。在进行第1至第4部分前,需预先准备好以下物品:
1. 材料与试剂的准备
- 提前至少1天配制10%的月桂酰肌氨酸钠(sarkosyl,v/v)溶液,以确保有足够时间完全溶解。使用0.22 µm滤器对均一溶液进行过滤除菌。在实验当天,用10%月桂酰肌氨酸钠溶液配制0.5%的月桂酰肌氨酸钠溶液,并置于冰上保存直至使用。
- 将超速离心机预冷至4 °C。在通风橱内,将恒温混匀仪设置为30 °C,并预热一份2.5×结构探针缓冲液(2.5x Structure probing buffer)。该恒温混匀仪后续将用于DMS处理。
- 在通风橱内,将金属浴或加热块设置为65 °C,并为每个反应预热650 µL酸性酚:氯仿(acid phenol: chloroform)溶液,用于RNA提取。
- 将DTT加入2.5×转录缓冲液中,使其终浓度为2 mM。新鲜配制并预冷淬灭液和洗涤液,以便DMS处理后立即使用(见表1)。
- 在RNA提取前,将40 µL的20% SDS分装至用于酵母裂解的离心管中。配制100 mM氯化锌(ZnCl2)溶液,并在使用前过滤除菌。
- 构建可能需要的缺失、敲降或敲入型酵母菌株,以针对新生RNA碱基配对问题与酿酒酵母野生型菌株进行比较研究。每次实验前均需通过划线法在适当的酵母琼脂平板(YPD、缺陷型培养基或含抗生素平板)上重新活化菌株。在实验开始前一天,从单克隆出发接种液体培养物。有关酵母菌株培养与操作的更多说明,请参阅Schärfen等,2025。
CoSTseq 酵母细胞的制备
- 预备培养:将酿酒酵母(S. cerevisiae)菌株 BY4741 接种于 50 mL YPAD 培养基中,在 30 °C、200 rpm 振荡条件下培养至对数中期(600 nm 处的光密度(OD)= 0.6)。如有必要,将培养物稀释至 OD 0.2–0.3,并继续培养至 OD 达到 0.6。
- 酵母收集:在预冷的离心机(4 °C)中,以 2,500 ×g 离心 3 分钟,收集并沉淀约 1.8 OD(约 3 mL)的酵母培养物。将上清液弃入废液容器中。用 10 mL 冷的磷酸盐缓冲盐水(PBS)重悬沉淀,洗涤一次。再次于 4 °C 以 2,500 × g 离心 3 分钟。弃去上清液,将酵母沉淀置于冰上保存。
- 酵母细胞通透化:将酵母沉淀小心地重悬于 10 mL 冷的 0.5% 烷基硫酸钠(sarkosyl)溶液中。使用 P1000 移液器重悬细胞,避免产生气泡。冰上孵育 20 分钟以促进细胞通透化。于 4 °C 以 400 × g 离心 5 分钟,收集通透化后的酵母细胞。将通透化后的酵母细胞重悬于 100 µL 无核酸酶水中。
注意:尽管DMS标记不需要细胞壁通透化,但核内转录延伸反应需要通透化处理,以使生物素标记的核苷酸能够到达转录位点。这一通透化通过使用Sarkosyl处理实现,Sarkosyl可同时通透酵母细胞壁和核膜。此外,Sarkosyl处理还能通过阻止新的转录起始事件,并将负延伸因子从Pol II和染色质上解离,从而促进转录延伸实验的进行11,12。操作过程中应轻柔处理样品,并保持较低的离心速度(400 × g),以防止细胞破裂,确保生物素有效掺入正在延伸的新生转录本中13。
3. 核内转录延伸与DMS探针分析
注意:使用生物素标记的核苷三磷酸(biotin-NTP)进行核内转录延伸实验时,会产生空间位阻,使RNA聚合酶在活性位点处停止延伸,从而为新生RNA的特异性富集提供生物素标记。根据所需分辨率的不同,核内转录延伸实验可使用一种、两种或全部四种生物素标记的核糖核苷酸9。出于成本效益考虑,本文所述实验流程仅使用一种生物素标记的核苷酸(即生物素-CTP)。
- 建立核内转录延伸反应
- 配制含有新鲜添加的 5 mM DTT 的 2.5x 转录缓冲液工作液,并将 2.5x 结构探针缓冲液预热至 30 °C(见表 1)。
- 在一个洁净的 2 mL 离心管中,加入 120 µL 的 2.5x 转录缓冲液、3.75 µL 的 10 mM ATP、3.75 µL 的 10 mM GTP、3.75 µL 的 10 mM UTP、7.5 µL 的 1 mM Bio-CTP、15 µL 的 10% 十二烷基肌氨酸钠(sarkosyl),然后用 46.25 µL 无核酸酶水补足至总体积 200 µL。
- 向管中加入 100 µL 细胞悬液,并在设定为 30 °C、转速为 500 rpm 的恒温混匀仪中孵育 2 分钟,同时震荡混合。
注意:此步骤对时间极为敏感。应尽量减少样本数量以获得可靠数据。为保证一致性,建议在不同样本之间错开操作时间。
- DMS 处理:孵育完成后,立即同时向管中加入 200 µL 预热的 2.5x 结构探针缓冲液和 25 µL DMS 试剂。轻轻涡旋混合两次,随后继续在 30 °C、500 rpm 震荡条件下于恒温混匀仪中孵育 4 分钟。各样本之间应间隔 30 秒,以保持操作一致性。
注意:DMS 探针反应是一种瞬时反应,可实现对 RNA 碱基配对状态的高时间分辨率检测14。为防止 DMS 持续修饰,必须立即使用强还原剂 β-巯基乙醇淬灭 DMS 标记反应。此外,残留的 DMS 将干扰后续 RNA 提取时的回收效率。在离心前加入水饱和的异戊醇可去除细胞沉淀中残余的不溶性 DMS15。此步骤对时间极为敏感,为获得可靠数据,必须严格控制样本数量。
警告:DMS 是一种剧毒、无色液体,具有轻微洋葱样气味。操作时需采取极端防护措施。直接接触和/或吸入其蒸气可能导致眼睛、口腔及呼吸道坏死,并对器官造成严重损伤。操作时应佩戴护目镜、实验服和合适的手套。尽可能佩戴双层手套,并在接触或使用 DMS 后立即更换手套。所有涉及 DMS 的操作均应在通风橱中进行。应使用专用废液容器收集 DMS 废物。 - 淬灭与洗涤
- 按照表 1所述提前配制停止缓冲液和洗涤缓冲液,并置于冰上保存直至使用。通过加入 1 mL 停止缓冲液终止 DMS 甲基化反应。
- 将 DMS 标记的样品在预冷的离心机中以 3,500 x g 离心 5 分钟。将上清液弃入适当的废液容器中。
- 向沉淀中加入 1 mL 洗涤缓冲液并重悬。重复步骤 3.3.2。立即进行 RNA 提取,切勿冷冻酵母沉淀。
- 苯酚-氯仿提取
- 将 DMS 标记的酵母重悬于 600 µL RNA 裂解缓冲液中,然后转移至含有 40 µL 20% SDS 的离心管中。在 65 °C、950 rpm 震荡条件下孵育 30 秒。
- 向酵母裂解液中加入 650 µL 预热的酸性苯酚:氯仿混合液,继续在 65 °C、950 rpm 震荡条件下于恒温混匀仪中加热 2 分钟。随后将样品置于冰上静置 5 分钟。
注意:在此期间,将加热块或恒温混匀仪温度调至室温(RT)。 - 在室温下以 20,000 x g 离心 3 分钟。
- 将上层水相转移至新的离心管中,加入 650 µL 氯仿,短暂涡旋混合。再次离心后,将上层水相转移至另一含有 700 µL 异丙醇的新离心管中。
- 上下颠倒混匀,于 -20 °C 冰箱中孵育 30 分钟,使 RNA 沉淀。随后在 4 °C 下以 20,000 x g 离心 45 分钟。弃去上清液,用 750 µL 75% 乙醇(EtOH)洗涤沉淀。
注意:本步骤为实验流程中的暂停点。样品可在 -80 °C 条件下保存于 75% 乙醇中过夜。 - 以 20,000 x g 离心 3 分钟,弃去上清液。将 RNA 沉淀在空气中干燥,然后溶于 81 µL 无核酸酶水中。使用波长设为 260 nm 的分光光度计测定 RNA 产量。取 1 µL 上述重悬液进行测量。如需要,可对 RNA 样品进行稀释。下一步操作前,应至少获得 80 µg 总 RNA。
注意:如有必要,DMS 标记的 RNA 可在 -80 °C 下保存最多 2 周。
新生RNA(CoSTseq)
注意:从苯酚:氯仿抽提获得的总 RNA 包含 DMS 标记的成熟 RNA 以及来自三种聚合酶的 DMS 标记生物素化新生 RNA。为了从总 RNA 中纯化新生 RNA,后续步骤将使用链霉亲和素磁珠富集生物素化的新生 RNA。由于生物素与链霉亲和素之间具有极强的亲和力(Kd = 10-14 - 10-15 M),需进行两次连续的 RNA 试剂(见材料表)抽提,以将 RNA 从链霉亲和素磁珠上洗脱下来。需要注意的是,酵母中新生 RNA 的比例不到总 RNA 的 1%,具体比例取决于生长条件16。
- 生物素下拉实验
- 链霉亲和素磁珠的制备
- 根据表1所示成分配制预洗缓冲液A和预洗缓冲液B。通过涡旋振荡使链霉亲和素磁珠均匀悬浮。每80 µg总RNA样品取44 µL均匀悬浮的磁珠。
注意:根据样品数量乘以相应体积进行放大。 - 将磁珠置于磁力架上,去除保存液。用1 mL预洗缓冲液A重悬磁珠。
- 室温孵育2分钟,磁力分离后弃去上清液。重复洗涤一次。用1 mL预洗缓冲液B洗涤一次。磁力分离后弃去上清液,并立即进入结合与洗涤步骤。
- 根据表1所示成分配制预洗缓冲液A和预洗缓冲液B。通过涡旋振荡使链霉亲和素磁珠均匀悬浮。每80 µg总RNA样品取44 µL均匀悬浮的磁珠。
- 结合与洗涤
- 根据表1所示配制2×结合缓冲液、1×结合缓冲液、高盐洗涤缓冲液和低盐洗涤缓冲液。
- 加入两倍原始体积(88 µL)的2×结合缓冲液重悬预洗后的磁珠。将80 µL磁珠转移至含有80 µL生物素标记RNA样品的无菌1.5 mL离心管中。
- 将磁珠-样品混合物在旋转仪上室温旋转孵育20分钟。通过磁力架收集含有成熟RNA的流穿液(进入沉淀步骤)。
- 用500 µL高盐缓冲液清洗磁珠-新生RNA复合物两次。随后用500 µL 1×结合缓冲液清洗一次,再用500 µL低盐缓冲液清洗一次。
- 链霉亲和素磁珠的制备
- 通过RNA提取试剂进行洗脱
- 将恒温混匀仪预热至60 °C。将可达到20,000 x g转速的离心机预冷至4 °C。
- 向磁珠-新生RNA复合物中加入300 µL RNA提取试剂(见材料表),并重悬。在设定为60 °C的恒温混匀仪中孵育5分钟。
- 加入60 µL氯仿,涡旋振荡,室温孵育3分钟。在预冷的离心机中以14,000 x g离心5分钟。
- 将上层水相转移至新的收集管中(约180 µL)。弃去有机相,保留磁珠及剩余水相。
- 重复提取步骤,使收集管中水相最终体积达到360 µL。
- 向收集管中加入360 µL氯仿,短暂涡旋。在预冷的离心机中以14,000 x g离心5分钟。
- 将上层液体(约350 µL)转移至新管中。加入900 µL无水乙醇和1 µL共沉淀剂,沉淀RNA。
- 短暂涡旋,于-20 °C静置沉淀20分钟,或于-80 °C过夜。
- 在预冷的离心机中以20,000 x g离心20分钟。小心弃去上清液。
- 用750 µL 75%乙醇洗涤沉淀,随后在20,000 x g下再次进行低温离心5分钟。
- 干燥沉淀以去除残留乙醇,时间约10分钟。将RNA沉淀溶解于3.75 µL H2O中。
注意:使用洗脱的RNA进行点杂交,再用链霉亲和素-HRP偶联物探针检测,是评估生物素下拉效率的最有效方法。然而,该方法消耗大量样品,导致后续文库构建材料不足。
- 上清液的沉淀
- 向含有成熟RNA的上清液中加入2.5–3倍体积的乙醇进行沉淀。于-20 °C静置1小时。
- 在预冷的离心机中以20,000 x g离心45分钟。小心吸除上清液。
- 用0.5 mL 75%乙醇洗涤RNA沉淀,干燥后将沉淀溶解于50 µL无核酸酶水中。将离心管置于65 °C金属浴中以促进RNA沉淀的溶解。
- 使用分光光度计测定RNA浓度,用于后续实验步骤。
5. 成熟RNA(DMS-MaPseq)
- poly A 选择
注意:使用寡核苷酸(dT)磁珠进行亲和捕获,以纯化具有多聚腺苷酸尾的成熟RNA。本方案经过优化,采用Dynabeads mRNA DIRECT纯化试剂盒(参见材料表)。作为初始准备,将1 mL无核酸酶水预热至80 °C用于洗脱,并将金属浴或加热块设定为70 °C。- poly A下拉用RNA的制备:取50 µg沉淀的RNA,用无核酸酶水补足至终体积300 µL。在70 °C加热2分钟以破坏二级结构,立即置于冰上。加入300 µL裂解/结合缓冲液,短暂涡旋混匀。
- 磁珠的制备:通过涡旋至少30秒使磁珠充分悬浮。每份样品取100 µL悬浮磁珠转移至无菌1.5 mL离心管中。置于磁力架上磁分离,弃去保存液。用等体积的裂解/结合缓冲液清洗磁珠,再次磁分离后弃去上清液。
- 结合与洗涤
- 将100 µL预洗后的磁珠加入600 µL已准备好的样品RNA中,室温下在旋转仪上持续旋转5分钟。
- 将样品置于磁力架上收集磁珠,弃去穿流液。用600 µL洗涤缓冲液A洗涤磁珠,用移液器吹打混匀。
- 再次磁分离以弃去洗涤液。用300 µL洗涤缓冲液B洗涤磁珠,用移液器吹打混匀。
- 再次磁分离以弃去洗涤液。将磁珠与90 µL预热(80 °C)的无核酸酶水混合,再加入90 µL裂解/结合缓冲液以促进结合。重复步骤5.1.3.1–5.1.3.3。
- 洗脱:将磁珠重悬于30 µL预热(80 °C)的无核酸酶水中,在75–80 °C孵育2分钟。迅速置于磁力架上,将洗脱液收集至无RNase的离心管中。重复洗脱一次,合并收集洗脱的RNA。
- 片段化
注意:mRNA的片段化可通过酶法或化学方法实现。此处使用氯化锌和高温进行片段化。与需要特定序列或结构元件的酶不同,锌离子作为路易斯酸激活2'氧原子(亲核试剂),从而切割磷酸二酯骨架。该过程在产物RNA链上生成5'羟基和2',3'-环状磷酸酯17。- 将PCR仪的模块温度预设为94 °C,盖子温度设为105 °C。取54 µL已洗脱的mRNA加入PCR管中。
- 加入6 µL 100 mM氯化锌溶液(终浓度为10 mM),涡旋2秒后立即放入预热的PCR仪中,在94 °C孵育55秒。
- 孵育结束后,加入6.6 µL 0.5 M EDTA(终浓度为50 mM)终止反应,上下吹打混匀,迅速将PCR管置于冰上。将反应液转移至无菌1.5 mL离心管中。
- 加入150 µL异丙醇、15 µL 3 M乙酸钠(pH 5.2)和1 µL共沉淀剂,使片段化的mRNA沉淀。
- 在-20 °C放置30分钟。于预冷的离心机中以20,000 × g离心45分钟。用75%乙醇洗涤沉淀,最后溶于15 µL无核酸酶水中。
- PNK处理
注意:使用ZnCl2进行化学片段化会产生不适合连接的5'和3'末端17。因此,在化学片段化后,RNA需经多核苷酸激酶(PNK)处理,该处理可将5'羟基磷酸化,并去除3'磷酸基团,从而使RNA末端可与接头进行连接18。- 加入1 µL核糖核酸酶抑制剂、2 µL 10× PNK缓冲液和2 µL T4 PNK。在37 °C孵育60分钟。加入30 µL无核酸酶水、50 µL RNA结合缓冲液和50 µL乙醇以终止反应。
- 采用基于离心柱的RNA纯化方法去除杂质并浓缩RNA。可使用市售试剂盒(RNA Clean and Concentrator试剂盒,参见材料表)。简要步骤如下:将两体积RNA结合缓冲液与一体积样品混合,再将等体积的该混合液与100%乙醇混合,加载至离心柱(置于新的收集管中)。离心后弃去穿流液。先后用700 µL和400 µL RNA洗涤缓冲液各洗涤一次离心柱,每次均弃去穿流液。空柱再离心1分钟,确保彻底去除残留洗涤液。
- 用10 µL预热的无核酸酶水洗脱RNA。
注意:所有离心步骤均在室温下以10,000–16,000 × g离心30秒。
6. 模板转换逆转录反应
注意:生物素下拉获得的新生RNA(步骤4.2)以及经PNK处理后的片段化mRNA(步骤5.3)将进行以下步骤以构建文库(参见图1和图2)。简言之,将制备一种可发生模板转换的合成RNA模板/ DNA引物起始双链体(R2 RNA/DNA杂合接头)。该杂合双链提供一段短的互补序列,使逆转录酶(RT)能够从RNA链切换至DNA引物链,即实现模板转换,从而使得cDNA能够无缝地从RNA连续合成至接头序列。本实验使用Induro逆转录酶,该酶已针对本方案经过测试和优化。如果需要,也可使用其他具有模板转换能力的逆转录酶进行CoSTseq文库构建,但需由使用者自行优化条件。
- DNA/RNA 杂合双链接头序列
注意:用于 DMS-MaPseq 样本逆转录的 DNA/RNA 杂合双链接头与 Xu 等人7 中列出的接头相同,并被 Schärfen 等人10 引用。- 对于将用于 CoSTseq 样本逆转录的 DNA/RNA 杂合双链接头,应使用在突出端区域含有“G”的接头。这将使 G 能够捕获 RNA 3'-端的生物素化-C。如果使用其他生物素化的 NTP,则应修改杂合双链 DNA 引物,使其突出端具有相应的配对核苷酸(见表 2)。
- 对于 DMS-MaPseq 接头,应确保其具有单个 N 突出端,因为 RNA 在片段化后 3'-端为随机序列。有关后续文库构建步骤的概述,请参见图 2。
- 模板转换用 DNA/RNA 杂交体的制备:在含有 10 mM Tris-HCl(pH 7.5)和 1 mM EDTA 的缓冲液中,配制浓度为 1 µM 的 R2 RNA 和 R2R DNA 引物。将引物混合物于 82 °C 孵育 2 分钟,然后以 0.1 °C/s 的速率冷却至 25 °C。分装该混合物并冷冻保存以备后续使用。
- 模板转换逆转录
- 加入以下试剂,并在室温下孵育 30 分钟:2 µL 5× 反应缓冲液、1 µL 1 µM DNA/RNA 杂合双链(CoSTseq 样本使用含单个 G 突出端的杂合双链;DMS-MaPseq 样本使用含随机 N 突出端的杂合双链)、0.5 µL 酶、0.5 µL RNase 抑制剂、3.75 µL RNA 样本(或加水至总体积为 7.75 µL)。
- 在不添加 dNTP 的情况下,将该混合物于室温孵育 30 分钟。然后向反应体系中加入 1.25 µL 10 mM dNTPs,并在热循环仪中执行以下循环程序:25 °C 孵育 10 分钟,42 °C 孵育 10 分钟,50 °C 孵育 10 分钟,55 °C 孵育 10 分钟,60 °C 孵育 30 分钟,65 °C 孵育 20 分钟,75 °C 孵育 15 分钟。
- 加入 1 µL RNase H,在 37 °C 孵育 20 分钟。使用基于离心柱的 DNA 纯化方法纯化 PCR 反应产物,以去除残留的引物、核苷酸和酶。最终洗脱体积为 20 µL。
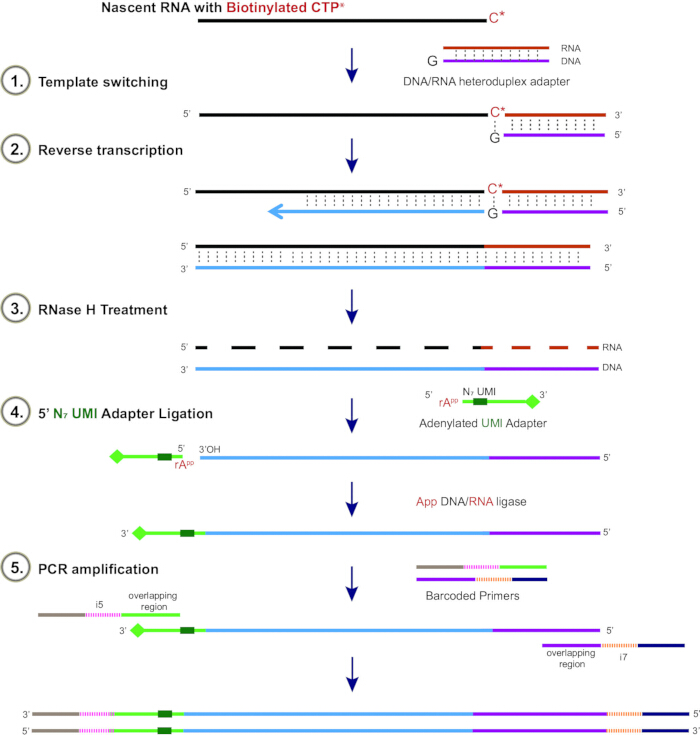
图2:CoSTseq文库构建的详细示意图。 带有生物素标记3'末端的新合成RNA与含有G突出端的模板转换接头共同孵育,该G突出端与生物素标记的CTP互补。对于片段化的成熟RNA(DMS-MaPseq),则使用带有N突出端的接头(见图1)。使用具有高度持续性的逆转录酶(如耐热II型内含子逆转录酶,TGIRT)进行cDNA合成,随后用RNase H处理以降解RNA链。接着,5' App DNA/RNA连接酶将N7 UMI接头的核糖腺苷酸化5'端(rApp)连接至单链cDNA的3'羟基端。N7 UMI接头包含一个被封闭的3′末端,以防止接头之间的自连。最后,使用包含重叠区域以及带有针对每个样本分配的独特Illumina i5和i7条形码的5′突出端的引物进行PCR扩增。请点击此处查看该图的放大版本。
7. 用于配对末端标签测序的最终cDNA文库制备的5'接头连接
- 5'端接头的制备
- 使用基于RNA连接酶的反应(例如Mth RNA连接酶,见材料表)对5'端接头进行腺苷酸化修饰,反应体系如下:8 µL 10x 5'-DNA腺苷酸化反应缓冲液,8 µL 1 mM ATP,100 µM R1R DNA(即含有唯一分子标识符或UMI的TruSeq引物),8 µL Mth RNA连接酶,52 µL无核酸酶水。
注:有关N7 UMI接头设计的详细信息,请参见表2和图2。 - 将反应在65 °C孵育1小时,随后在85 °C孵育5分钟。按照制造商说明书,通过乙醇沉淀或基于硅胶膜离心柱的DNA纯化方法纯化产物,以分离cDNA。
- 对于乙醇沉淀,可在-20 °C(至少20分钟)使用终浓度为0.3 M的乙酸钠(pH 5.2)和2–2.5倍体积的95%–100%冷乙醇沉淀DNA。将乙醇沉淀的反应物在预冷(4 °C)的离心机中以最大速度离心15分钟,用70%乙醇洗涤沉淀,再次离心后将沉淀空气干燥。将沉淀重悬(或如使用离心柱则洗脱)于40 µL无核酸酶水中。长期储存请置于-20 °C。
- 使用基于RNA连接酶的反应(例如Mth RNA连接酶,见材料表)对5'端接头进行腺苷酸化修饰,反应体系如下:8 µL 10x 5'-DNA腺苷酸化反应缓冲液,8 µL 1 mM ATP,100 µM R1R DNA(即含有唯一分子标识符或UMI的TruSeq引物),8 µL Mth RNA连接酶,52 µL无核酸酶水。
- 5'端接头连接
- 对于单个20 µL反应体系,向10 µL cDNA中加入以下组分:2 µL 10x NE Buffer 1,2 µL 50 mM MnCl2,2 µL 5' AppDNA/RNA连接酶,4 µL 10 µM(100 ng/µL)的步骤7.1中腺苷酸化后的接头。
- 将反应在65 °C孵育1小时,随后在90 °C孵育3分钟。使用minElute PCR纯化试剂盒纯化反应产物,并以20 µL无核酸酶水洗脱。
- 通过预实验进行cDNA文库的最低循环PCR扩增
- 在开始前,配制含唯一条形码的10 µM索引引物储备液。每个独特的CoSTseq或DMS-MaPseq样本应具有唯一的条形码,以便于后续分析顺利进行。引物序列见表2。含条形码的正向和反向引物可按1:1比例混合,储存为条形码预混液。
- 取步骤7.2的PCR产物2 µL,加入2.5 µL高保真PCR缓冲液(例如商用HiFi缓冲液),0.375 µL dNTP(10 mM),0.75 µL条形码预混液(或0.375 µL单独的i5和i7唯一条形码引物),0.25 µL高保真热启动DNA聚合酶(例如商用HiFi热启动酶),6.625 µL无核酸酶水。
- 将反应在95 °C预变性,然后重复[15秒98 °C,30秒62 °C,30秒72 °C]共23个循环,最后在72 °C孵育1分钟。在1%琼脂糖凝胶上电泳,以确定最佳循环数。
注:为测试较低循环条件,可在较低循环数结束时(例如第15或16循环结束)取样,在琼脂糖凝胶上电泳,比较不同循环数下cDNA文库条带的强度。
- 文库扩增的最终PCR
- 取步骤7.2的PCR产物18 µL,加入KAPA HiFi PCR试剂盒中的以下组分:22.5 µL高保真PCR缓冲液,3.375 µL dNTP(10 mM),6.75 µL条形码预混液(或3.375 µL单独的i5和i7唯一条形码引物),2.25 µL高保真热启动DNA聚合酶,以及59.625 µL无核酸酶水。
- 将反应在95 °C预变性,然后按照步骤7.3确定的循环数重复[15秒98 °C,30秒62 °C,30秒72 °C],最后在72 °C孵育1分钟。
- 片段大小选择
- 使用基于磁性微珠的纯化方法(例如AMPure XP或等效产品)对PCR产物进行片段大小选择。使用1.3倍体积的微珠(例如,对于50 µL的PCR反应,使用65 µL微珠悬液),充分混匀至均匀。室温下孵育10分钟,使微珠结合样本。
注:该1:1.3倍的样本与微珠比例可有效去除引物接头二聚体,并确保保留的DNA片段长度不小于150 bp且不大于800 bp。 - 小心移除上清液,避免扰动微珠,然后根据制造商方案使用80%乙醇洗涤微珠。
- 用11 µL洗脱缓冲液洗脱最终产物。取1 µL进行琼脂糖凝胶电泳以验证文库。将最终产物送交测序。
- 使用基于磁性微珠的纯化方法(例如AMPure XP或等效产品)对PCR产物进行片段大小选择。使用1.3倍体积的微珠(例如,对于50 µL的PCR反应,使用65 µL微珠悬液),充分混匀至均匀。室温下孵育10分钟,使微珠结合样本。
8. 数据分析
注意:完整的 CoSTseq 软件包和分析代码可在 GitHub 上获取(https://github.com/NeugebauerLab/CoSTseq),分析流程如图3所示。该流程旨在处理 CoSTseq 和 DMS-MaPseq 测序数据。CoSTseq 采用 Snakemake,这是一种生物信息学工作流工具,可通过优化可用 CPU 核心数量实现分析过程的并行化19。工作流由一个 Snakefile 定义,其中包含一组规则,用于确定将要执行的分析任务。安装 GitHub 软件包后,无需修改所提供的 Snakefile。
- 根据原始数据存储的实际路径,调整配置文件(.yaml 文件)中的文件路径设置。配置中应包含适配子序列的路径及其对应的样本名称。修改配置文件以运行 Snakefile 中定义的特定分析。
- 开始分析时,下载以 fastq.gz 格式存储的原始双端测序数据。使用 fastp20 对测序读段进行处理,去除接头序列,并对 Phred 质量值不低于 20 的读段进行质量过滤。随后使用 STAR21 将过滤后的读段比对至参考基因组,生成 BAM 文件。
- 为进一步验证结果,可在综合基因组浏览器(IGV)中可视化 CoSTseq 分析流程生成的 BAM 文件。通过 IGV 可清晰观察目标基因各区域的读段分布情况,若读段覆盖整个基因区域(包括内含子),则表明其来源于新生 RNA。如预期所示,成熟 RNA 的读段在内含子区域的覆盖度应极低,因为这些读段应主要来自已成熟且可能被高效剪接的转录本。
- 通过 fastp 输出的 .html 文件(可在网页浏览器中打开)获取读段重复率的估计值。需注意,CoSTseq 数据中的读段重复率可能非常高,这凸显了下一步去重处理的关键性。
- 使用 UMICollapse22 对读段进行去重,将具有相同 UMI 和比对位置的读段合并,仅保留唯一读段,从而减少 PCR 扩增偏差。处理后的文件应为无重复读段的 BAM 格式,其中比对至 rRNA 的读段已与非 rRNA 基因相关的读段分离。
- 在模块化 CoSTseq 分析流程的最终主要步骤中,使用自定义的 Python 程序计算每个核苷酸位点的突变计数和读段覆盖度。该程序的具体函数可在 GitHub 上的源代码中找到,Snakefile 中则详细定义了生成以 .pkl 格式存储数据所需的输入、输出、参数及函数调用。
注意:CoSTseq 分析流程还可支持多种其他分析,但可能需要根据个性化需求优化参数。一种适用于 CoSTseq 的有效方法是 HDProbe,这是一个 R 软件包,可用于全基因组范围内的突变率比较分析10。简而言之,HDProbe 需要所有重复样本的数据,能够系统性地识别与对照组相比具有显著差异的突变率区域。其他可能希望开展的分析还包括基于实验获得的 DMS 反应活性进行RNA二级结构预测,该分析可通过 RNAstructure 软件包实现23。
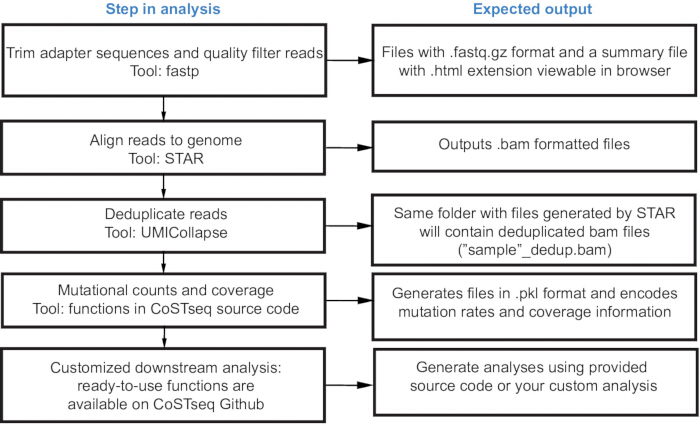
图3:模块化CoSTseq分析流程的分析步骤及预期输出结果。 分析步骤展示了除推荐使用的现有工具外,还可使用即用型CoSTseq分析流程,并列出了各步骤预期生成的输出文件及其内容。请点击此处查看该图的高清版本。
访问受限。请登录或开始试用以查看此内容。
结果
本节展示了按照本方案所述实施 CoSTseq 工作流程及分析后所产生的实际结果。首先,本节描述了测序前后对成功文库制备进行质量评估后所预期的结果。在测序之前,研究人员可通过测试性 PCR 和 TapeStation 分析来确认经生物素富集后是否存在 RNA,这表明在 CoSTseq 文库制备过程中新生 RNA 已被成功分离。测序后的数据质量评估(例如通过读段覆盖情况的可视化检查,以及后续基于自定义 Python 程序的分析)可确保获得足够且丰富的数据用于下游分析。此阶段评估的一些关键指标包括:内含子区域的覆盖度、重复读段百分比、每个核苷酸的测序深度以及平均读段长度。这些指标界定了数据集的分析范围,降低了结果被过度解读的风险。其次,本节介绍了一些潜在的分析方法。例如,鉴于 DMS-MaPseq 可与 CoSTseq 联用,因此可在特定目标基因的某一区域内比较新生 RNA 与成熟 RNA 的 DMS 反应活性谱。RNA 聚合酶延伸过程中的动态 RNA 二级结构可在单核苷酸分辨率下实现可视化。此类分析对于丰度较高的细胞 RNA 分子尤为有效,因其可达到更高的测序深度,例如核糖体 RNA。
访问受限。请登录或开始试用以查看此内容。
讨论
RNA由于碱基配对的动力学速度快于其合成速率,因此在转录过程中即开始折叠24,25,26,27目前,我们对新生RNA折叠的认识主要来自对原核生物RNA的单分子研究, 体外 探针,或 计算机模拟 方法。在本方案中,介绍了CoSTseq的详细工作流程;该技术能够 体内 相对于RNA聚合酶位置的新生转录本共转录折叠的检测 S. cerevisiae10. 本方案概述了数据分析流程,重点介绍质量控制步骤。
在应用CoSTseq及相关方法时,应遵循常规实验室安全规范,包括但不限于佩戴1至2副手套(尤其是在接触二甲基硫酸酯(DMS)等有害化学品时),以及穿着实验服以保护操作人员并降低RNA污染或降解的风险。处理RNA时必须...
访问受限。请登录或开始试用以查看此内容。
披露
作者无任何利益冲突需要披露。
致谢
作者谨此感谢 Dr. SK Boopathy Jegathambal 提供的编程支持,以及 Neugebauer 实验室的成员,特别是 P. Bech,他们在研究过程中提供的有益讨论。本研究得到了美国国立卫生研究院(NIH)(项目编号:R01GM112766,授予 KMN)以及美国心脏协会(AHA)博士前奖学金(项目编号:908949,授予 LS)的资助。LPS 获得了美国国立卫生研究院培训基金 5T32GM14943803 的支持。LRAB 获得了美国心脏协会博士后奖学金(项目编号:26POST1569544)的支持。在耶鲁基因组分析中心进行的数据采集工作得到了美国国立卫生研究院下属国家普通医学科学研究所的支持,资助编号为 1S10OD03036301A1。本研究的全部责任由作者承担,研究内容不一定代表 NIH 的官方观点。
访问受限。请登录或开始试用以查看此内容。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| 10 mM ATP | Invitrogen | 18330019 | |
| 10 mM 生物素-11-CTP | Jena biosciences | NU-831-BIOX | |
| 10 mM GTP | Invitrogen | 18332015 | |
| 10 mM UTP | Invitrogen | 18333013 | |
| 10X NEBuffer 1 | New England Biolabs | B7001S | 用于第7.2.1步 |
| 10X 磷酸盐缓冲液(PBS) | Gibco | 70011-044 | |
| 20% SDS | RPI | L23100-500 | |
| 酸性酚:氯仿 | Ambion | AM9722 | |
| 用于片段大小筛选的AMPure XP磁珠 | Beckman Coulter | A63880 | 用于第7.5.1步的片段大小筛选 |
| 蛋白胨 | Gibco | 211677 | |
| 酵母提取物 | Gibco | 212750 | |
| Bicine | Sigma Aldrich | B3876-100G | |
| 氯仿 | Sigma Aldrich | 319988 | |
| D-(+)-葡萄糖 | Sigma Aldrich | G5767-500G | |
| DIFCO 琼脂 | BD DIFCO | 214010 | |
| 二甲基硫酸酯 | Sigma Aldrich | D186309-5ML | |
| Dynabeads™ MyOne Streptavidin C1 磁珠 | Invitrogen | 65001 | 用于第4.1节的生物素下拉实验 |
| Dynabeads™ mRNA DIRECT™ 纯化试剂盒 | Invitrogen | 61011 | 用于第5.1节的Poly A筛选 |
| EDTA,pH 8,0.5 M | Sigma Aldrich | 03690-100ML | |
| 乙醇 | Sigma Aldrich | E7023-500ML | |
| GlycoBlue | Invitrogen | AM9516 | 共沉淀剂,用于第4.2.7步和第5.2.4步 |
| Induro® 逆转录酶 | New England Biolabs | M0681S | 第6.3.1步使用的逆转录酶 |
| 异戊醇 | Sigma Aldrich | W205710-1KG-K | |
| 异丙醇 | JT-BAKER | 9084-05-01 | |
| KAPA HiFi HotStart PCR 试剂盒 | Roche | 07958889001 | 高保真DNA聚合酶,用于第7.3.2步和第7.4.1步的PCR反应 |
| 氯化镁 | Sigma Aldrich | SLCM2154 | |
| MinElute PCR 纯化试剂盒 | Qiagen | 28004 | 用于第6.3.3步和第7.2.2步的DNA纯化 |
| Mth RNA 连接酶 | New England Biolabs | M2611A | |
| 寡核苷酸纯化与浓缩试剂盒(Oligo Clean & Concentrator) | Zymo Research | D4060 | 建议用于第7.1.2步的DNA寡核苷酸纯化 |
| 乙酸钾 | Sigma Aldrich | 236497-500G | |
| 氯化钾 | JT Baker | 3040-01 | |
| 氢氧化钾 | Avantor | 6984-04-01 | |
| RNA 纯化与浓缩试剂盒-5(RNA Clean & Concentrator-5) | Zymo Research | R1014 | 第5.3.2步中PNK处理后的RNA纯化试剂盒 |
| RNaseOUT™ 重组核糖核酸酶抑制剂 | Thermo Fisher Scientific | 10777019 | 第5.3.1步PNK处理过程中使用的RNase抑制剂 |
| Sarkosyl | IBI Scientific | IB07080 | |
| 乙酸钠 | Quality Biological | 351-035-721 | |
| 氯化钠 | Sigma Aldrich | S5150-1L | |
| 氢氧化钠 | Macron | 7708-10 | |
| SUPERase·In™ RNase 抑制剂(20 U/μL) | Thermo Fisher Scientific | AM2696 | 第6.3.1步中使用的RNase抑制剂 |
| T4 多核苷酸激酶 | New England Biolabs | M0201S | |
| 耐热性5’ App DNA/RNA 连接酶 | New England Biolabs | M0319L | |
| Tris-HCl,pH 7.4,1 M | Thermo Scientific | J60202.K2 | |
| 吐温X-100(Triton X-100) | TEKNOVA | T1105 | |
| TRIzol™ 试剂 | Invitrogen | 15596-026 | 用于第4.2节新生RNA的洗脱;在第4节中也称为"RNA试剂" |
| β-巯基乙醇 | Sigma Aldrich | M6250-1L |
参考文献
- Zhang, J., Fei, Y., Sun, L. Advances and opportunities in RNA structure experimental determination and computational modeling. Nature Methods. 19 (10), 1193-1207 (2022).
- Bonilla, S. L., Jones, A. N., Incarnato, D. Structural and biophysical dissection of RNA conformational ensembles. Current Opinion in Structural Biology. 88, (2024).
- Bose, R., Saleem, I., Mustoe, A. M. Causes, functions, and therapeutic possibilities of RNA secondary structure ensembles and alternative states. Cell Chemical Biology. 31 (1), 17-35 (2024).
- Rapakko, J., Scaravilli, M., Änkö, M. L. Interplay between RNA-protein interactions and RNA structures in gene regulation. FEBS Open Bio. , (2025).
- Rodgers, M., Woodson, S. A. A roadmap for rRNA folding and assembly during transcription. Trends in biochemical sciences. 46 (11), 889-901 (2021).
- Tomezsko, P., Swaminathan, H., Rouskin, S. DMS-MaPseq for Genome-Wide or Targeted RNA Structure Probing In Vitro. Methods in Molecular Biology. 2254, 219-238 (2021).
- Xu, H., Douglas, C. W., Lambowitz, A. M. Improved TGIRT-seq methods for comprehensive transcriptome profiling with decreased adapter dimer formation and bias correction. Scientific Reports. 9 (1), (2019).
- Lopes, R., Agami, R., Korkmaz, G. GROseq, A Tool for Identification of Transcripts Regulating Gene Expression. Methods in molecular biology (Clifton, N.J). 1543, 45-55 (2017).
- Mahat, D. B., et al. Base-Pair Resolution Genome-Wide Mapping Of Active RNA polymerases using Precision Nuclear Run-On (PROseq). Nature protocols. 11 (8), 1455-1476 (2016).
- Schärfen, L., Vock, I. W., Simon, M. D., Neugebauer, K. M. Rapid folding of nascent RNA regulates eukaryotic RNA biogenesis. Molecular Cell. 85 (8), 1561-1574 (2025).
- Hawley, D. K., Roeder, R. G. Functional steps in transcription initiation and reinitiation from the major late promoter in a HeLa nuclear extract. Journal of Biological Chemistry. 262 (8), 3452-3461 (1987).
- Hawley, D. K., Roeder, R. G. Separation and partial characterization of three functional steps in transcription initiation by human RNA polymerase II. Journal of Biological Chemistry. 260 (13), 8163-8172 (1985).
- Zubradt, M., et al. DMS-MaPseq for genome-wide or targeted RNA structure probing in vivo. Nature Methods. 14 (1), 75-82 (2017).
- Tijerina, P., Mohr, S., Russell, R. DMS foot-printing of structured RNAs and RNA-protein complexes. Nature Protocols. 2 (10), 2608-2623 (2007).
- Liebig, A., Waldsich, C. W. Probing RNA structure within living cells. Methods in enzymology. 468, 219-238 (2009).
- Pelechano, V., Chávez, S., Pérez-Ortín, J. E. A Complete Set of Nascent Transcription Rates for Yeast Genes. PLOS ONE. 5 (11), (2010).
- Wery, M., Descrimes, M., Thermes, C., Gautheret, D., Morillon, A. Zinc-mediated RNA fragmentation allows robust transcript reassembly upon whole transcriptome RNA-Seq. Methods. 63 (1), 25-31 (2013).
- Wang, L. K., Lima, C. D., Shuman, S. Structure and mechanism of T4 polynucleotide kinase: an RNA repair enzyme. The EMBO Journal. 21 (14), 3873-3880 (2002).
- Köster, J., Rahmann, S. Snakemake a scalable bioinformatics workflow engine. Bioinformatics. 28 (19), 2520-2522 (2012).
- Chen, S., Zhou, Y., Chen, Y., Gu, J. fastp: an ultrafast all-in-one FASTQ preprocessor. Bioinformatics (Oxford, England). 34 (17), i884-i890 (2018).
- Dobin, A., et al. STAR: ultrafast universal RNA-seq aligner. Bioinformatics (Oxford, England). 29 (1), 15-21 (2013).
- Liu, D. Algorithms for efficiently collapsing reads with Unique Molecular Identifiers. PeerJ. 7, (2019).
- Spasic, A., Assmann, S. M., Bevilacqua, P. C., Mathews, D. H. Modeling RNA secondary structure folding ensembles using SHAPE mapping data. Nucleic Acids Research. 46 (1), 314-323 (2018).
- Saldi, T., Fong, N., Bentley, D. L. Transcription elongation rate affects nascent histone pre-mRNA folding and 3′ end processing. Genes & Development. 32 (3-4), 297-308 (2018).
- Pan, T., Artsimovitch, I., Fang, X., Landick, R., Sosnick, T. R. Folding of a large ribozyme during transcription and the effect of the elongation factor NusA. Proceedings of the National Academy of Sciences. 96 (17), 9545-9550 (1999).
- Heilman-Miller, S. L., Woodson, S. A. Effect of transcription on folding of the Tetrahymena ribozyme. RNA. 9 (6), 722-733 (2003).
- Yu, A. M., et al. Computationally reconstructing co-transcriptional RNA folding from experimental data reveals rearrangement of nonnative folding intermediates. Molecular Cell. 81 (4), 870-883 (2021).
- Yu, G., et al. Genome-wide probing of eukaryotic nascent RNA structure elucidates cotranscriptional folding and its antimutagenic effect. Nature communications. 14 (1), (2023).
访问受限。请登录或开始试用以查看此内容。
重印与许可
