通过计算机系统提供基于两种自然语言处理语义特征的反馈,并结合教师的书面反馈,以提高学生英语写作的流利度和准确性。结果显示,前者取得了积极效果。
需要JoVE订阅才能观看此内容。 请登录或开始免费试用
本文内容
摘要
摘要
近年来,计算机辅助语言学习技术在语言学习领域取得了显著进展,尤其是在人工智能(AI)背景下。多种技术被视为语言学习的支柱,不仅在计算机学科中,也在教育领域中具有重要地位,例如自动写作评估(以下简称 AWE)和自动作文评分(AES)。目前,使用 AWE 技术进行的评估仅能以整体评分的形式完成,尽管这种形式在促进语言学习方面已表现出相当高的有效性,但无法提供详细或深入的反馈。为了针对语言的两个核心要素(即语法和流利度)提供详细的写作反馈,本研究考虑采用一个包含神经网络模型以及两种基于语义的自然语言处理(以下简称 NLP)方法的计算机辅助实现系统。为此,90 名巴基斯坦高校英语作为第二语言的学习者(ESL)被随机分配至对照组、教师反馈组和实验组。计算机辅助评估系统包含了神经网络。AWE 基线模型与教师评分之间的对比测试结果显示,采用这些神经网络的计算机辅助反馈与教师评分之间存在相关性。此类结果对英语作为第二语言的写作教学具有重要意义,特别是在语言准确性和流利度构成挑战的教学情境中。
引言
写作反馈涉及语言的多个方面,如组织结构、语法、流畅性、内容和语言运用,使学习者能够重写或创作新的书面文本1,2,3。目前,随着计算机辅助语言学习(以下简称CALL)以及自动写作评价(AWE或AES)和书面作文评分技术的迅速发展,英语写作教师已成为主要受益者4。此外,计算机辅助英语写作评估能够针对内容、语法、词汇等语言要素提供诊断性反馈,及时、个性化且客观地回应学生的书面文本。AWE系统还能够为学生提供清晰的书面反馈,帮助他们内化通过这些书面回应所获得的知识,从而提升学生的认知能力6。
本研究基于一项研究4,该研究提出了多策略、基于计算机的英语写作学习概念,结合英语写作反馈理论,并借鉴分析性评分过程。该方法包含其他基于自然语言处理(NLP)语义的模型,将深度学习融入书面反馈,以提供详尽的书面反馈评分。该方法解决了以往自动写作评估(AWE)技术的局限性,即仅强调整体评分,而忽视分析性、具体化的评分。因此,该方法更注重针对一系列语言指标的准确且即时的评估,并提供分项得分与总分,以提升学生的英语写作学习效果。在诸多语言学特征(如内容、复杂性、准确性、流利性)中,本研究将仅考察巴基斯坦英语作为第二语言(ESL)学习者的写作流利性及语法方面。为此,本研究提出一种结合神经网络技术与教师评价的NLP技术应用策略。
在巴基斯坦的语言学习环境中,巴基斯坦学生在英语写作学习方面面临诸多困难,尽管学生从一年级到十四年级都将英语作为必修课程进行学习。在此过程中,许多因素产生了影响,例如课程设置不当以及采用陈旧的语法讲解方法7。在大学阶段,教师需要教授的学生人数相当多,而这些学生来自不同的中学和学院,背景各异。这迫使教师花费大量时间纠正学生的写作错误,导致工作负担过重。另一方面,学生往往将教师的书面反馈视为理所当然,并未积极识别并改正自身错误8。
一项研究指出,由于学生害怕出错,这种心理会成为流畅写作的障碍,从而主要影响了写作的流利性;因此,学生往往更倾向于避免犯错,而非积极表达思想。此外,乌尔都语在英语写作中偶尔会产生语言干扰,同时还存在其他语境因素的影响。而且,乌尔都语是巴基斯坦的国语。由于这些语境因素,每当学生进行书面输出或修改文稿时,教师都难以向每位学生提供准确、及时且一致的反馈。基于写作评估理论,本研究将采用自动机器写作反馈策略,与传统的教师评估方式进行比较,并采用分析性评分而非整体性评分,以确保学生能够即时获得关于两个重要语言维度(即语法和流利性)的反馈4。
目前已出现多种工业级的自动写作评估(AWE)和自动作文评分(AES)产品,包括 Pigai.org、Bingo English、My Access、E-rater、I-write、Criterion 等。AWE/AES 在发展初期主要基于贝叶斯定理10、线性回归11等传统机器学习系统。目前,深度学习的进一步发展,特别是神经网络技术,显著推动了写作反馈领域的发展,例如循环神经网络(RNN)12、长短期记忆网络(LSTM)13、卷积神经网络(CNN)14以及 BERT 方法15。AWE 还受益于自然语言处理(NLP)初期采用的预训练策略16。许多研究考虑了多种基于神经网络的解决方案,例如生成对抗样本以辅助学习、通过多任务学习17、自监督学习18以及图算法19进行学习。一些研究提出了不同的技术以应对写作反馈中训练数据不足的问题20。此外,还存在多种评分模型,为众多神经网络模型提供了支持21。
语法错误纠正(下文简称 GEC)是自然语言处理任务中一个独立的方向,具备自动检测并纠正写作中语法错误的能力。GEC 的任务内容与自动写作评估(AWE)的各个方面密切相关。AWE 任务通常需要考虑语法错误的诊断,其中大多数错误需要以正确形式加以标注。然而,AWE 研究对 GEC 的关注较少,仅有少数研究将早期的 GEC 模型整合到 AWE 技术中。最初,GEC 研究大多采用 N-gram22 和语言模型23(包括 BERT24)来识别和纠正语法错误。然而,上述方法无法完全解决语序混乱和成分缺失等问题。编码器-解码器架构25在 GEC 中取得了同样成功,解决了此前其他模型难以处理的问题。值得注意的是,先进的 GEC 架构采用多种模型来应对挑战,其中包括基于 Transformer 的方法26。
多项研究证实,与人工评分相比,自动作文评分系统(AES)在评估写作文章方面具有较高效率27,28。一项研究29探讨了自动评估对学习者英语流利度的影响,结果表明,自动评估对英语写作的流利性具有积极影响。然而,也有部分研究30认为,尽管AES的错误检出率高于人工评分,但其重要性不应被过度强调。近期研究强调了人工智能辅助写作评估工具在语言教育中日益增强的有效性。其中一项研究31在中国大学生的学习背景下,比较了自动评分与教师反馈的效果。
基于人工智能的工具在学术写作中的革命性作用已在近期文献中得到广泛报道。有关将人工智能驱动的写作工具作为传统英语作为外语(EFL)写作教学补充的研究,强调了在技术成功实施过程中,公平机会与教师积极支持的至关重要性32。针对自动写作评价(AWE)的研究,例如对 Pigai 的研究,表明在计算机支持下的反馈与提升英语作为第二语言(ESL)的写作能力、修改能力以及新文本创作之间存在显著相关性33。另一项研究指出,变分自编码器(VAEs)在英语写作训练方面具有积极影响,能够使学习者在深度学习的更高层次上获得关于多种语言特征的反馈34。还有研究提出,基于神经网络的 AWE 系统与基于自然语言处理(NLP)的语法纠错(GEC)结合使用将更为有效,后者利用深度学习提供即时评估35。
多智能体系统的改进是推动写作辅助技术发展的重要一步。以基于深度学习的学术写作润色助手AcademyCraft为例,作为一种多智能体系统,它已展现出撰写文本和提供详细反馈的能力,从而通过复杂的分析机制促进基于人工智能的英语作为外语/第二语言(EFL/ESL)写作支持36。事实上,基于技术的语言学习研究也已识别出多种新兴模式,例如深度学习、自动评估以及结合表现分析的语义反馈,这些模式显示出写作准确性和学习者参与度的逐步且持续提升37。
Transformer-LSTM 模型在英语写作的自动评分与反馈方面已展现出一定的应用潜力。这类混合架构结合了 Transformer 的上下文理解能力与 LSTM 系统的序列处理优势,最终在语法和连贯性评分的准确性方面表现出提升,并能生成更为细致的反馈内容38。针对英语作为外语(EFL)教师对人工智能写作工具的认知研究表明,教师普遍报告其在内容组织和写作质量方面带来了可量化的改进,同时强调教学法支持在激发技术整合效用中的关键作用39。目前关于教师反馈与计算机辅助反馈之间对比的研究仍较少,有待进一步利用深度学习模型探究此类工具对英语作为第二语言(ESL)学习者在写作流利度与语法方面的具体影响。
访问受限。请登录或开始试用以查看此内容。
方案
本研究中使用的所有软件和工具均列在材料表中。
评分标准
本研究采用的评估分类涵盖两个主要维度,即流利度与准确性,这两个维度包含了对作为外语的英语写作进行全面评估的全部要求。这些维度旨在衡量写作质量的关键方面,有助于有效沟通以及语言能力水平的展示。流利度模块通过衡量思想表达的流畅程度以及词汇和句子结构的使用效果,来评估写作的自然性、表现力和连贯性。准确性模块则针对语法的精确性、机械性错误的无瑕程度,以及对标准英语规范的遵守情况,理论上可在多个层面上衡量并统计语言中的错误率。(见Table 1)
任务定义
在英语学习者自动写作评估的条件下,本研究提出了一种新的英语写作计算机辅助评估系统模型。与以往研究受限于自动写作评估系统范围的情况相比,本系统通过引入创新的深度学习技术,对数据进行广泛处理,从而在语言分析水平、修改范围以及系统级反馈分析方面帮助克服这些局限性。该双模型系统基于作文的两个最重要指标——流畅性(指文本在自然性、连贯性和表达性方面的程度)和正确性(指文本在语法、机械性及语言错误方面的正确程度),利用神经网络的不同组成部分执行多项评估任务。此外,系统能够识别多个语言层面上的错误,提出纠正措施,并以列表形式提供反馈,帮助用户以系统化的方式提升学生的语言学习效果。为了描述计算机辅助自动评估系统的计算过程,我们提出以下公式(1)–(4)所示的数学模型(见表2)。
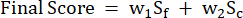 (1)
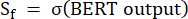 (2)
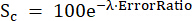 (3)
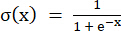 (4)
其中:最终得分 = 写作综合评估得分;w1 = 流畅性得分的权重;w2 = 正确性得分的权重;Sf = 基于 BERT 的流畅性得分(经归一化至 [0, 1]);Sc = 指数衰减正确性得分;λ = 控制错误惩罚的衰减常数;σ(x) = 逻辑 sigmoid 激活函数;ErrorRatio = 文本中错误数量与总词元数的比值。流畅性得分通过逻辑 sigmoid 函数 σ(x) 归一化至 [0, 1],而正确性得分则采用指数衰减函数进行评分,以对错误频率施加适当的惩罚。
系统架构与设计
其系统架构采用具有并行处理结构的双模型系统,通过并行评估路径对输入的作文进行并行分析。流畅性与正确性模块分别生成相应的分数,最终综合得分是这两个子分数的加权平均值。此外,正确性模块除了评分外,还提供错误检测与纠正建议(见图1)。
流利度模块
写作流利度可以定义为在语言使用过程中,关于词汇选择的准确性、句式结构的多样性、句法复杂性、连贯性等方面的特征或模式4。流利度评估模型旨在捕捉表达的思想内容,避免出现犹豫或不自然的情况,使表达尽可能接近母语者的交流模式。传统的流利度测量依赖于评分量表,存在评分者间信度的问题。本研究所提出的系统克服了这一缺陷,通过引入基于 BERT 的神经网络,利用深度情境理解自动增强语义连贯性和语言自然性。该架构选择基于 BERT 的优势而作出,研究表明 BERT 在识别上下文关系和语义模式方面表现优异,而这正是流利度测量所必需的。输入序列被送入系统后,经过 12 层 Transformer 结构,并通过多头自注意力机制识别长距离依赖关系和上下文关联(见图 2)。
注意的机制如下:
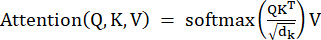 (5)
设 Q、K 和 V 分别为表示查询、键和值的矩阵,d 和 k 为键向量的维度。CLS 标记嵌入是一种摘要性嵌入,用于记录整个输入序列的整体语义一致性。
流利度评分的计算方法如下:
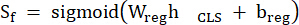 (6)
其中 hCLS 为 BERT [CLS] 标记的嵌入表示,Wreg 和 breg 为回归头的参数,σ 为 sigmoid 激活函数,用于将输出归一化至 [0, 1] 区间。
正确性模块
正确性评估侧重于语法准确性、机械性精确性以及对标准英语规范的遵守。该维度关注写作的技术层面,包括句法、词形、标点符号和拼写准确性。正确性评估不仅评价语言错误的数量,还考察这些错误对文本整体质量的影响。与强调语义连贯性和自然流畅性的流利度评估不同,正确性评估模块要求精确识别错误并进行系统性修正。该模块能够区分不同类型的错误,评估其严重程度,并提供有针对性的修正建议,以支持学习改进。正确性损失采用经过微调用于语法错误检测与修正的 FLAN-T5 模型。这一选择基于 T5 模型的文本到文本转换能力,使系统能够在同一框架内实现错误发现与相应修正。该系统采用编码器-解码器结构,文本以如下形式进行转换输入:(见图3)
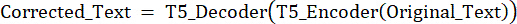 (7)
编码器模块生成上下文相关的表征,不仅捕捉语法倾向,还识别潜在的失败区域:
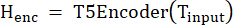 (8)
通过生成适当的语法变体以纠正被错误识别的错误,解码器生成修正后的序列:
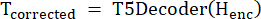 (9)
这种双向处理方式使系统能够识别错误的上下文,并了解如何修正这些上下文,从而使提示在语义上连贯,同时聚焦于语法方面的任何纠正。
误差量化与评分算法
准确性评分通过将原始写作与正确版本进行比较,综合考虑语言错误及其严重程度,错误的严重性依据其在文本中的位置以及对语义理解的干扰程度而定。该方法能够捕捉不同错误类型对文本理解影响程度的差异。评分系统以对数方式强调了错误频率与文本质量低下之间的关系。对原始文本和修改后文本进行词元比对的基本步骤,包含两个基于字符串位对齐技术的比对层级。第二阶段涉及根据已知的语言学分类体系,识别并分类错误类型,这些分类体系将错误区分为语法错误(主谓一致、时态一致性、句法结构可靠性)、机械性错误(大写、标点和拼写)以及用法错误(词语选择、习语表达和语体恰当性)。第三阶段是根据文本总长度计算错误比率。第四步采用指数衰减评分算法,将错误比率转化为可直接解释的正确性得分,以近似模拟错误频率与文本质量之间非相加性和非线性的依赖关系。
误差量化过程的数学处理始于已安装误差比率的计算,该比率提供了归一化的误差安装率,从而允许对不同长度的文本进行公平比较:
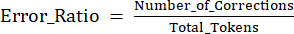 (10)
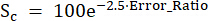 (11)
该校准参数值 2.5 是基于经验并通过人类专家判断进行全面验证后确定的,以确保评分函数能够根据错误频率的增加所导致的文本质量下降,提供与人类理解一致的结果。以这种方式设定该参数值,可保证:错误率较低的文本(Error_Ratio < 0.1)因严格遵循标准英语规则而获得较高的正确性评分;错误率中等的文本(0.1 < Error_Ratio ≤ 0.3)获得中等的正确性评分,表明存在一定的语言问题,但尚不严重;错误率较高的文本(Error_Ratio > 0.3)则因存在严重影响理解可能性的关键语言问题而获得较低的正确性评分。
正确性评分算法在进行正确性评估时,系统性地将基于T5的系统所定位并修正的所有错误作为扣分项,纳入最终错误率的计算中。用于语法错误的扣分机制通过随着错误比例增长而呈指数级下降的方式体现:当错误比例趋近于高值时,扣分趋近于0,表示文本质量极差;而当错误比例等于0时,扣分达到100,表示未检测到任何错误,完全符合英语标准规范。这种数学关系确保了正确性评分能够在整个语言能力谱系中提供显著区分度,并对连续的小幅进步具有敏感响应,从而真实反映语言习得水平。
数据集:训练与评估语料库
训练数据的质量和范围对于双模型系统的性能至关重要。本研究采用了一个设计良好的学生写作文本数据集来开发和评估该模型,该数据集通过不同的写作任务生成。样本包括45名男性和45名女性巴基斯坦大学生,平均年龄为19岁,均将“功能英语”作为必修课程学习。每位学生在八周内完成了八篇作文,包括前测、干预阶段作文和后测任务。每次写作任务允许学生撰写400至450个单词。数据集的统计信息具有以下特征:
70,500 字
平均句子长度:15.7 个词(标准差 = 3.2)
词汇广度(类符-形符比):0.64(标准差 0.08);语法错误密度:每100个词中2.3个(标准差 = 1.1)
所选数据的合理性及数据质量保证
所选数据集基于若干重要考虑因素,以确保其在自动写作评估研究中的丰富性和相关性。首先,选择经济学专业学生群体,是因为其特点与巴基斯坦高等教育中的英语作为外语(EFL)学习者相似,从而能够提供更真实、反映现实情境的写作样本。其次,根据前期研究数据,确定了每篇作文的字数范围为400至450词,该范围在语言复杂性上足以被机器可靠分析,同时在人工评分的一致性方面仍具有可管理的规模。每篇作文均由三位经过培训的英语教师依据标准化的10分制评分量表,从流利度和准确性两个维度进行评估(评分者间信度κ值分别为:流利度维度0.847,准确性维度0.823)。人工评分员的培训过程严格,依据参照雅思(IELTS)和托福(TOEFL)写作评估标准制定的评分细则进行。该数据包含一个由人工标注的数据集,可用于训练和验证基于人工标注数据的模型。
数据预处理与验证的步骤
数据集经过系统化的预处理,包括文本规范化、使用 BERT WordPiece 分词器对文本进行分词,以及进行质量验证检查。为确保数据完整性,未包含提交不完整作业或生成抄袭文本的参与者。最终数据通过分层抽样随机划分为训练集(70%,n = 189)、验证集(15%,n = 41)和测试集(15%,n = 40),以确保在不同语言熟练程度和任务类型之间保持平衡。对一个包含约5000万词的大型参考语料库进行语言学分析,该语料库包括专业编辑的学术文本、报纸文章和已发表的散文。该语料库提供了执行流利度测试所需的语言模式,并通过与标准用法的比较,辅助错误检测流程。在参考语料库中,预处理和索引之前的步骤包括分词、词性标注、句法解析和语义标注,以支持实时评估过程中的高效访问。
流利度模型训练策略
提出了一种顺序优化系统,用于训练数据以实现语言流畅性。训练过程中采用了最先进的技术特性,包括自适应学习率调度、渐进式批量大小以及先进的正则化方法,这些方法可在训练推进过程中防止过拟合,从而保持模型在识别语言流畅性相关语言模式方面的有效性。学习率设定为 5 × 10⁻⁴,并采用线性衰减策略,以确保收敛过程稳定,不会在最优参数值附近发生振荡。该学习率通过在 [1 × 10⁻⁶, 1 × 10⁻⁴] 范围内的网格搜索确定,其中 5 × 10⁻⁵ 在收敛速度与稳定性之间实现了最合适的权衡。实际训练将限制为仅 3 个训练周期,这一配置基于验证损失追踪的实证效益进行优化,旨在防止过拟合的同时,确保参数得到充分更新,从而使学习有效。此外,设置了早停机制,耐心值为 2 个周期,最小变化量(delta)为 0.001,以防止模型性能下降。
优化采用 AdamW 优化器进行,其简化参数设置如下:β₁ = 0.9(动量项,用于控制一阶矩估计值的指数衰减)、β₂ = 0.999(二阶矩估计项,用于控制二阶矩估计值的指数衰减)以及 ε = 1 × 10⁻8(数值稳定性参数)。权重衰减正则化(λ = 0.01)用于防止参数幅值过度增大,该值通过在 [0.001, 0.1] 范围内进行验证性能分析后选定。复杂的监控机制能够在训练过程中持续跟踪多种指标,以确保模型达到最佳性能并避免过拟合。监控框架包含以下内容:
损失追踪:在每个训练周期内跟踪训练损失和验证损失,当验证损失在连续两个周期内不再改善时,将自动触发早停机制。
性能指标:每经过100次训练步骤,使用验证数据计算预测得分与实际得分之间的皮尔逊相关系数。
梯度感知:通过监测梯度范数来检测梯度消失和梯度爆炸,当梯度范数达到1.0时,应用梯度裁剪。
学习率调度:若检测到验证损失在超过1个epoch内出现平台期,则降低学习率(因子 = 0.5)。
正则化相关:通过系统性消融实验确定了丢弃率(BERT 部分为 0.1,回归头部分为 0.3)。在训练过程中采用了多种基于防止过拟合的正则化方法:(1)使用针对网络中每种类型层优化后的丢弃率进行丢弃正则化(dropout regularization);(2)如上所述的权重衰减(weight decay);(3)根据验证集性能确定的早停法(early stopping);(4)基于回译方法对 15% 的训练样本进行改写以实现数据增强。每轮训练后均保存性能最佳模型的检查点,并根据验证集上的相关性得分选择得分最高的模型。流畅度评估部分所使用的损失函数为均方误差(Mean Squared Error, MSE),这是用于预测连续流畅度得分的回归任务的主要目标函数。其数学形式的损失函数表达如下:
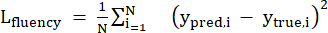 (12)
N 是总训练样本量,y_pred,i 表示第 i 个样本的预测流利度得分,y_true,i 表示由人类专家评估者给出的相应真实得分。该损失函数在以二次方式抑制预测值与实际值误差方面非常有效,使得较大的误差会受到更大的惩罚,同时该函数也是可微的。学习率调度机制高度先进,采用两阶段过程:首先经历一个线性预热阶段,随后进入系统性衰减过程,以实现最佳的收敛特性。在预热阶段中,学习率先从零开始,逐步增加至最大值,之后模型参数将基于训练数据集进行优化。预热阶段的数学表达式为:
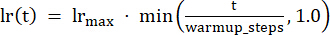 (13)
在预热阶段之后,学习率以系统性的线性方式衰减,以避免参数值过度偏离最优解,从而实现稳定的收敛。从数学上讲,衰减阶段表示为:
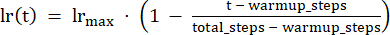 (14)
其中 t 为当前训练步数,lr_max 为预热阶段达到的最大学习率,warmup 为分配给预热阶段的步数,total 为所有训练周期中的总训练步数。上述调度策略可确保模型在训练初期快速学习,并在收敛阶段保持稳定性。
正确性模型训练策略
正确性模型基于迁移学习策略,采用预训练的 FLAN-T5 模型,以充分利用所需的所有可用语法知识。该模型旨在探究通用语言理解能力,以及针对英语作为第二语言学习者所犯错误的具体信息。所采用的迁移学习方法调用了 pszemraj/flan-t5-large-grammar-synthesis 检查点作为基础模型,该模型在正确性方面具有多项显著优势。由于该模型已经过训练,并具备在多种文本领域中训练所得的高水平语言理解能力,因此能够适应多种写作风格和写作主题。特别是,该模型已在涵盖多种语法错误类型的大型纠错数据集上进行了针对语法的精细化训练,这些错误类型常见于第二语言写作中。此外,该检查点包含强大的错误检测系统,已针对不同类型的错误(即形态学错误、句法错误和语义错误)进行了测试,从而为本研究的内在纠错测试参数提供了理想的比较标准。
领域自适应过程反映了系统性的参数调整,这些调整不会改变预训练模型的语言理解通用能力,但会引入写作评估任务求解的特定特征。该自适应过程的数学推导如下:
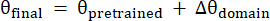 (15)
其中,θpretrained 表示预训练模型的参数,该模型编码了通用的语言理解能力和语法知识;Δθdomain 表示从目标写作评估任务中学习到的特定参数更新。这些针对特定领域的参数更新通过在目标数据集上进行基于梯度的优化计算得到,从而确保模型在不破坏其广泛语言能力的前提下,发展出对英语作为外语(EFL)写作中常见错误类型的任务特异性敏感性。
含对照的实验
为了验证EG的功能性,建议采用皮尔逊相关系数作为衡量的关键指标,该指标用于确定自动化评分与人类专家评分之间的线性关联。相关系数可通过以下公式计算得出:
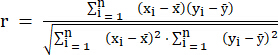 (16)
其中 xi 表示自动化评分,表示人工评分, 和
 分别为各自的均值。相关系数的取值范围为 −1 到 1,接近 1 的值表示自动化评分与人工评估之间存在强正相关关系。
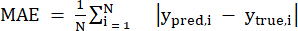 (17)
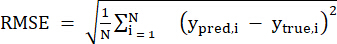 (18)
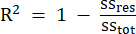 (19)
基线模型比较
为了评估EG的性能并证明其相较于现有方法的优势,本文将其与成熟的AWE方法及传统的单指标方法进行了深入比较。这些基线比较对于验证EG架构的附加价值至关重要,同时表明将流畅性与正确性评估相结合,相较于孤立关注单一维度的方法,能够带来可量化的性能提升。所选基线模型涵盖AWE的四个类别,每一类均体现了对写作评估方式的不同取向。第一类采用基于单个BERT的模型来评估语言流畅性,这些模型利用Transformer架构分析文本的连贯性与流畅性模式。第二类根植于传统语言学方法,专注于基于规则的语法错误检测系统,其关注点局限于正确性,而忽略了写作质量的其他方面,如衔接性与内容。第三类为基于特征的AWE系统,通过语言复杂性指标——如句子长度变化、词汇多样性以及句法复杂性——生成整体质量评分。第四类则考虑混合系统,通过结合多种表层语言特征,通常采用集成方法或加权平均策略。这些模型未能达到EG神经架构所实现的集成化复杂程度。基线模型的性能通过三个主要维度进行评估。第一个维度衡量系统生成分数与经过培训的人类专家(英语教师)使用标准化评分标准所给评分之间的一致性。第二个维度评估泛化能力,判断模型在不同主题和复杂程度的三类文章中是否保持性能稳定。第三个维度依赖于预测可靠性,通过平均绝对误差、均方根误差和置信区间分析等统计工具,评估评分的准确性与稳定性。综合来看,这三个维度构建了一个稳健的比较框架,凸显了EG系统在实现更高精度与稳定性方面相较于传统方法的优越性。
实验组和对照组
本研究包括90名正在两个完整班级中学习功能性英语课程的本科经济学学生。数据在三个时间点采集:前测、干预阶段和后测,以追踪写作准确性和流利性随时间的变化。该涉及人类受试者的研究已获得巴基斯坦COMSATS伊斯兰堡大学拉合尔校区系咨询委员会的批准。参与者被置于两种条件下:传统人工反馈和计算机辅助反馈。对照组由45名学生组成,他们接受来自经过培训的英语教师的传统书面反馈。学生收到的书面反馈包括整体评分、错误识别,以及教师以评语形式提供的改进建议。实验组同样包括45名学生,他们在课堂上的教学方式相同,但学生的写作通过EG系统提供的快速自动化反馈得到补充,该系统在提交作文后约30秒内即提供有关写作流利度和正确性的诊断信息。
本研究持续进行8周,其中在第1周进行前测,以确定受试者在接受干预前的初始写作水平。在接下来的六周内,实验组接受基于计算机的自然语言处理语义标记反馈,对照组则接受教师评价。最终在第8周进行后测,以分析准确性和流利性得分在前测与后测之间的差异。为了获得具有可比性的结果,要求所有受访者在每次评估阶段完成相似的写作任务,从而最大限度地减少任务难度和内容熟悉度等潜在的混杂变量对写作表现的影响。为确保写作提示的难度水平一致并建立内容效度,写作题目以一致的方式进行选择。论文主题的选择基于学生所涉及的多个内容领域,以避免因长时间重复相同任务而导致的练习效应和参与者厌倦情绪。
在前测阶段,要求参与者撰写一篇400–450词的作文,内容围绕学术目标与职业规划。这一描述性任务基于个人经历与未来展望,要求写作者组织好文章结构,提供清晰的实例,并有条理地陈述个人目标与动机。干预阶段的写作任务涉及不同主题,例如日常生活作息、兴趣爱好、旅行经历、大学第一天、人生中难忘的日子以及与最好朋友共度的美好时光。后测题目与“技术对沟通的影响”这一主题相关,要求作文长度为400–450词。
访问受限。请登录或开始试用以查看此内容。
结果
统计方法的有效性与可靠性
该系统在多种互补的统计方法上进行了测试,这些方法均提供了关于实验组(EG)对写作能力发展影响的全面证据。这是一种多层面的分析方法,承认教育干预措施需要进行复杂的统计分析,不能简单地归结为组间比较,而应分析变化模式、效应量大小以及各种测量策略之间的相关性(表1、表3 和表4)。
各组间写作能力提升的比较分析
为了观察对照组与实验组在准确性和流利性得分上的变化差异,采用独立样本t检验来比较两组在后测与前测之间写作提升得分的差异。这一分析方法基于本研究的核心问题,即自动化反馈是否比传统教学策略产生更好的学习效果。t检验方法不仅能够测量统计显著性,还提供置信区间,有助于解释实际重要性及可重复性的可能性。为了解两种不同反馈系统影响的大小,系统计算了效应量d(见表5)。根据既定标准,Cohe...
访问受限。请登录或开始试用以查看此内容。
讨论
实验结果表明,本研究取得了几项重要成果。首先,双模型系统与人类专家评判之间具有高度相关性(r = 0.923),显著优于单模型方法及当前的自动写作评估(AWE)系统。其次,控制干预研究显示,英语作为第二语言(ESL)学生的写作表现得到显著提升,效应量大(d = 1.28),超过近期文献报道的水平。第三,该系统在多项评估指标上均表现出更优性能,包括更低的平均绝对误差(0.149)以及在不同写作任务中更高的评分一致性。
为了将当前的研究发现置于更广泛的研究背景中,本文通过与近期采用相似方法和评估标准的研究进行系统性比较,开展了全面的对比分析。本研究通过引入独立的模块分别评估流利度和正确性,解决了现有自动写作评估(AWE)系统中的关键局限性:采用基于BERT的架构进行流利度评估,并利用基于T5的模型进行语法错误检测与纠正。通过将本研究的双模型系统与另外五项近期AWE研究进行性能对比,结果表明本系统具有更高的相关系数(0.923 vs 0.844–0.891)、更低的预测误差(MAE = 0.149 vs 0.174–0.198),以及更大的实验效应量(d = 1.28),显著高于其他类似...
访问受限。请登录或开始试用以查看此内容。
披露
所有作者均无利益冲突。
致谢
我们感谢伊斯兰堡COMSATS大学拉合尔校区英语系在协助收集学生数据方面提供的支持。
访问受限。请登录或开始试用以查看此内容。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| <研究中使用的>软件/库 | |||
| 深度学习框架 | PyTorch | 1.13.1 | 用于神经网络实现的深度学习框架 |
| 预训练模型 | 变形金刚(拥抱脸) | 4.21.3 | 预训练模型加载、BERT和T5模型实现 |
| 语言模型 | BERT(变换器中的双向编码器表示) | bert-base-uncased | 流畅度评估、语义一致性评估、情境理解 |
| 语言模型 | FLAN-T5(微调语言网络 T5) | pszemraj/flan-t5-大型语法-综合 | 语法错误更正、文本到文本转换、错误检测 |
| 数值计算 | 数字派 | 1.23.5 | 数值计算,数学函数的数组运算 |
| 数据分析 | 熊猫 | 1.5.2 | 数据处理、统计分析与预处理 |
| 机器学习 | Scikit-learn | 1.1.3 | 统计指标计算、相关分析、评估指标 |
| 可视化 | Matplotlib | 3.6.2 | 数据可视化、训练进度图、性能图表 |
| 可视化 | 海本 | 0.12.1 | 统计数据可视化,相关热图 |
| NLP工具包 | NLTK(自然语言工具包) | 3.7 | 文本预处理、分词、语言分析 |
| 自然语言处理 | 太空 | 3.4.4 | 高级自然语言处理预处理、POS标签、语法分析 |
| 分词化 | 标记器 | 0.13.2 | BERT WordPiece 快速分词化和 T5 分词化 |
| 统计与分析软件 | |||
| 统计软件 | SPSS 统计软件 | 版本26.0 | 统计分析、独立样本t检验、方差分析、相关分析 |
| 训练数据集 | Kaggle ASAP 数据集 | 2012年版本 | 训练语料库参考(90%的AWE模型使用该数据集) |
| PYTHON优化与训练库 | |||
| 优化器 | 火炬.最佳。亚当W | PyTorch 1.13.1 | 带权重衰减正则化(λ=0.01)、&beta的模型优化;1=0.9, β2=0.999, ε=1×10⁸ |
| 丧失 / 激活 | torch.nn.functionl | PyTorch 1.13.1 | 乙状结肠激活、丧失函数、降落正则化 |
| 数据加载 | torch.utils.data.DataLoader | PyTorch 1.13.1 | 渐进批量分组(4→16)、数据加载和批处理 |
| 分词化 | 变形金刚。自动分词器 | 变形金刚 4.21.3 | BERT WordPiece 分词,文本预处理 |
| 模型加载 | 变形金刚。自动模型 | 变形金刚 4.21.3 | BERT和T5架构的预训练模型加载 |
| 梯度控制 | torch.nn.utils.clip_grad_norm_ | PyTorch 1.13.1 | 梯度裁剪(阈值:1.0)用于训练稳定性 |
| LR调度 | torch.optim.lr_scheduler | PyTorch 1.13.1 | 利用线性衰减和预热学习率调度 |
| 指标 | sklearn.metrics | Scikit-learn 1.1.3 | 皮尔逊相关、MAE和RMSE计算用于评估 |
| PYTHON NEURAL NETWORK IMPPLEMENTATION | |||
| 基础级 | torch.nn.模块 | PyTorch 1.13.1 | 自定义神经网络架构的基类(Fluency &正确性模块) |
| 线性层 | 火炬.nn.线性 | PyTorch 1.13.1 | 线性回归头实现(768→512及以上;256及以上;128→1个神经元) |
| 正则化 | 火炬.nn.退出 | PyTorch 1.13.1 | 退出正则化(BERT 0.1,回归头 0.3) |
| 激活 | torch.nn.functional.sigmoid | PyTorch 1.13.1 | S形结肠激活用于流畅度评分归一化 [0,1] |
| 激活 | torch.nn.functional.relu | PyTorch 1.13.1 | 回归层中的ReLU激活,用于非线性变换 |
| 变压器 | 变形金刚。BertModel | 变形金刚 4.21.3 | 12层变压器,多头自注意用于流畅度评估 |
| Seq2Seq | 变形金刚。T5For 条件生成 | 变形金刚 4.21.3 | 用于语法纠错的编码器-解码器架构 |
| 损失函数 | 火炬.nn.MSELoss | PyTorch 1.13.1 | 流畅度回归训练中的均方误差损失函数 |
| PYTHON评估与度量库 | |||
| 相关性 | scipy.stats.pearsonr | SciPy 1.9.3 | 模型与人类一致的皮尔逊相关系数 |
| 误差指标 | sklearn.metrics.mean_absolute_error | Scikit-learn 1.1.3 | 预测准确度的绝对误差平均(MAE)计算 |
| 误差指标 | sklearn.metrics.mean_squared_error | Scikit-learn 1.1.3 | 误差大小评估的均方根误差(RMSE) |
| 统计检验 | scipy.stats.ttest_ind | SciPy 1.9.3 | 独立样本t检验用于统计显著性检验 |
| 相关矩阵 | numpy.corrcoef | NumPy 1.23.5 | 评估者间信度的相关矩阵计算 |
| 数据相关性 | 熊猫。DataFrame.corr | 熊猫 1.5.2 | 数据相关分析与统计报告 |
| 可视化 | matplotlib.pyplot | Matplotlib 3.6.2 | 表现可视化、相关图、训练进展图表 |
| 热力图 | seaborn.热力图 | 海生 0.12.1 | 相关矩阵可视化与统计数据展示 |
| PYTHON文本处理与NLP库 | |||
| 文本处理 | re(正则表达式) | Python 3.9+ 内置 | 文本模式匹配、数据清理与预处理 |
| 配置处理 | JSON | Python 3.9+ 内置 | 配置文件处理,模型参数存储 |
| 序列化 | 泡菜 | Python 3.9+ 内置 | 模型序列化与检查点保存/加载 |
| 进展追踪 | TQDM | 4.64.1 | 训练循环和数据处理的进度条 |
| 伐木 | 伐木 | Python 3.9+ 内置 | 训练进度日志、错误跟踪与调试 |
| 可重复性 | 随机 | Python 3.9+ 内置 | 可重复实验的随机种子设置 |
| 文件系统 | 操作系统 | Python 3.9+ 内置 | 文件系统操作,模型路径管理 |
| CLI 解析 | argparse | Python 3.9+ 内置 | 训练配置的命令行参数解析 |
| COMMERCIAL AWE / AES 平台(参考) | |||
| 商业平台 | Pigai.org | 商业AWE平台 | 中文EFL写作评估,自动反馈系统 |
| 商业平台 | 宾果英语 | 商业AWE系统 | 英语学习支持,写作技能发展 |
| 教育平台 | 我的访问权 | 教育写作平台 | 学生写作评估与反馈传递 |
| 计分引擎 | E-ratinger | ETS自动计分引擎 | 标准化考试论文评分,整体评估 |
| 评估工具 | 我写 | 写作评估工具 | 学术写作评估与诊断反馈 |
| 实习服务 | 标准 | ETS写作练习服务 | 写作技能发展与自动反馈 |
| 人工智能语言模型 | ChatGPT | OpenAI 语言模型 | 人工智能辅助写作反馈与评估(文献中引用) |
| <强>深度学习架构(文献引用) | |||
| 建筑 | 循环神经网络(RNN) | 蔡,2019年 | 顺序文本处理 & mdash;编写反馈系统与自动评估 |
| 建筑 | 长短期记忆(LSTM) | Jin 等,2018 | 远程依赖建模 & mdash;自动论文评分与序列分析 |
| 建筑 | 卷积神经网络(CNN) | Dong 等,2017 | 局部模式识别及mdash;文本分类与特征提取用于评分 |
| 建筑 | 变压器-LSTM混合型 | Xuan,2025年 | 结合上下文和顺序处理 & mdash;自动计分与反馈生成 |
| 建筑 | 变分自编码器(VAE) | Kumar 等,2024 | 生成建模与mdash;增强写作技能发展和个性化反馈 |
| 建筑 | 多智能体系统 | Thompson 等,2024 | 协作人工智能处理与mdash;高级写作辅助(AcademiCraft平台) |
| 机制 | 注意力机制 | Dong 等,2017 | 自我关注和多头注意力等;提升AES性能和上下文理解 |
| <强>传统机器学习技术(参考) | |||
| 统计方法 | 贝叶斯定理 | 鲁德纳与梁,2002年 | 传统的机器学习方法和mdash;早期AES/AWE开发与概率评分 |
| 统计方法 | 线性回归 | Phandi 等,2015 | 统计建模及mdash;基于特征的写作评估与评分预测 |
| 学习方法 | 排名偏好学习 | 陈与他,2013年 | 基于排名的方法论 & mdash;比较论文评分与偏好建模 |
| 语言模型 | N-gram模型 | 谢等,2015 | 统计语言建模 & mdash;语法纠错与模式识别 |
| 建筑 | 编码-解码器架构 | Ge 等,2018 | 序列对序列建模 & mdash;语法纠错与文本转换 |
| <强>评估标准与框架 | |||
| 评估标准 | 雅思写作评估 | 评分规准调整 | 流利度和正确性的标准化评估标准 |
| 评估标准 | 托福写作评估 | 学术写作标准 | 熟练度评估与标准化评分 |
| 统计指标 | 科恩的d效应量 | 0.2=小,0.5=中,0.8=大 | 干预效果的实际显著性评估 |
| 可靠性衡量 | 评级间可靠性(κ) | 流利度:0.847 / 正确性:0.823 | 卡帕系数和mdash;人工评估者一致性与一致性验证 |
参考文献
- Bitchener, J. Evidence in support of written corrective feedback. J Second Lang Writ. 17 (2), 102-118 (2008).
- Nusrat, A., Ashraf, F., Narcy-Combes, M. F. Effect of direct and indirect teacher feedback on accuracy of English writing: A quasi-experimental study among Pakistani undergraduate students. 3L Lang Linguist Lit. 25 (4), 84-98 (2019).
- Nusrat, A., Khan, S., Kashif, F., Fawad, R. Effect of teachers’ asynchronous e-feedback and synchronous oral feedback on English language learners’ writing accuracy. Front Educ. 7, 783684 (2022).
- Chen, B., Bao, L., Zhang, R., Zhang, J., Liu, F., Wang, S., et al. A multi-strategy computer-assisted EFL writing learning system with deep learning incorporated and its effects on learning: A writing feedback perspective. J Educ Comput Res. 61 (8), 60-102 (2024).
- Li, J., Link, S., Hegelheimer, V. Rethinking the role of automated writing evaluation (AWE) feedback in ESL writing instruction. J Second Lang Writ. 27, 1-18 (2015).
- Ellis, R. Explicit form-focused instruction and second language acquisition. The handbook of educational linguistics. , 437-455 (2008).
- Shamim, F. Trends, issues and challenges in English language education in Pakistan. Asia Pac J Educ. 28 (3), 235-249 (2008).
- Haider, G. An insight into difficulties faced by Pakistani student writers: Implications for teaching of writing. J Educ Soc Res. 2 (3), 17-27 (2012).
- Nawaz, M., Hussain, S. A., Bughio, F. A. Exploring the preferred corrective feedback and practiced corrective feedback among Pakistani ESL secondary school students and teachers in writing class: Matches and mismatches. Int J Lang Lit Transl. 6 (1), 31-45 (2023).
- Rudner, L. M., Liang, T. Automated essay scoring using Bayes theorem. J Technol Learn Assess. 1 (2), 1-22 (2002).
- Phandi, P., Chai, K. M. A., Ng, H. T. Flexible domain adaptation for automated essay scoring using correlated linear regression. , 431-439 (2015).
- Cai, C. Automatic essay scoring with recurrent neural network. , 1-7 (2019).
- Jin, C., He, B., Hui, K., Sun, L. TDNN: A two-stage deep neural network for prompt-independent automated essay scoring. 1, 1088-1097 (2018).
- Dong, F., Zhang, Y., Yang, J. Attention-based recurrent convolutional neural network for automatic essay scoring. CoNLL. , 153-162 (2017).
- Sharma, A., Kabra, A., Kapoor, R. Feature enhanced capsule networks for robust automatic essay scoring. , 365-380 (2021).
- Mim, F. S., Inoue, N., Reisert, P., Ouchi, H., Inui, K. Corruption is not all bad: Incorporating discourse structure into pre-training via corruption for essay scoring. IEEE ACM Trans Audio Speech Lang Process. 29, 2202-2215 (2021).
- Cummins, R., Rei, M. Neural multi-task learning in automated assessment. arXiv. , 1-9 (2018).
- Cao, Y., Jin, H., Wan, X., Yu, Z. Domain-adaptive neural automated essay scoring. , 1011-1020 (2020).
- Jiang, Z., Liu, M., Yin, Y., Yu, H., Cheng, Z., Gu, Q., et al. Learning from graph propagation via ordinal distillation for one-shot automated essay scoring. , 2347-2356 (2021).
- Li, X., Chen, M., Nie, J. Y. SEDNN: Shared and enhanced deep neural network model for cross-prompt automated essay scoring. Knowl Based Syst. 210, 106491 (2020).
- Beseiso, M., Alzubi, O. A., Rashaideh, H. A novel automated essay scoring approach for reliable higher educational assessments. J Comput High Educ. 33 (3), 727-746 (2021).
- Xie, W., Huang, P., Zhang, X., Hong, K., Huang, Q., Chen, B., et al. Chinese spelling check system based on an n-gram model. , 128-136 (2015).
- Brockett, C., Dolan, W. B., Gamon, M. Correcting ESL errors using phrasal SMT techniques. , 249 (2006).
- Zhang, S., Huang, H., Liu, J., Li, H. Spelling error correction with soft-masked BERT. , 882-890 (2020).
- Ge, T., Wei, F., Zhou, M. Reaching human-level performance in automatic grammatical error correction: An empirical study. arXiv. , 1-15 (2018).
- Zhao, W., Wang, L., Shen, K., Jia, R., Liu, J. Improving grammatical error correction via pre-training a copy-augmented architecture with unlabeled data. 1, 156-165 (2019).
- Shermis, M. D., Koch, C. M., Page, E. B., Keith, T. Z., Harrington, S. Trait ratings for automated essay grading. Educ Psychol Meas. 62 (1), 5-18 (2002).
- Mizumoto, A., Shintani, N., Sasaki, M., Teng, M. F. Testing the viability of ChatGPT as a companion in L2 writing accuracy assessment. Res Methods Appl Linguist. 3 (2), 100116 (2024).
- Ajabshir, Z. F., Ebadi, S. The effects of automatic writing evaluation and teacher-focused feedback on CALF measures and overall quality of L2 writing across different genres. Asian Pac J Second Foreign Lang Educ. 8 (1), 26 (2023).
- Almusharraf, N., Alotaibi, H. An error-analysis study from an EFL writing context: Human and automated essay scoring approaches. Tech Knowl Learn. 28 (3), 1015-1031 (2023).
- Chen, H., Pan, J. Computer or human: A comparative study of automated evaluation scoring and instructors' feedback on Chinese college students' English writing. Asian Pac J Second Foreign Lang Educ. 7 (1), 34 (2022).
- Liu, X., Zhang, Y., Chen, L. The transformative impact of AI-powered tools on academic writing: Perspectives of EFL university students. Lang Learn Technol. 28 (2), 78-95 (2024).
- Zhang, Q., Li, F. From process to product: Writing engagement and performance of EFL learners under computer-generated feedback instruction. System. 115, 102998 (2023).
- Kumar, S., Patel, R., Williams, T. Automated deep learning approaches in variational autoencoders (VAEs) for enhancing English writing skills. J Educ Technol Res. 45 (3), 234-251 (2024).
- Martinez, A., Rodriguez, P., Thompson, K. Neural automated writing evaluation with corrective feedback. Comput Linguist. 50 (1), 123-145 (2024).
- Thompson, J., Anderson, C., Davis, R. AcademiCraft: Transforming writing assistance for English for academic purposes with multi-agent system innovations. Artif Intell Educ. 12 (4), 445-462 (2024).
- Rodriguez, M., Kim, S., Brown, D. Technology-enhanced language learning in English language education: Performance analysis, core publications, and emerging trends. Appl Linguist Rev. 15 (2), 201-225 (2024).
- Xuan, Y. Transformer-LSTM models for automatic scoring and feedback in English writing assessment. IEEE Access. 13, 82084-82096 (2025).
- Anderson, R., Smith, K., Johnson, M. The impact of AI writing tools on the content and organization of students' writing: EFL teachers' perspective. Comput Educ. 195, 104712 (2023).
访问受限。请登录或开始试用以查看此内容。