本研究描述了一种在染色体序列已知或无需关注时,对质粒进行纳米孔测序的工作流程。初始的质粒DNA富集步骤可确保最佳的质粒测序深度,并最大化每张流动池可测序的样本数量。
本文内容
摘要
摘要
本研究描述了一种旨在最大化质粒DNA产量和测序准确性的纳米孔测序工作流程。研究人员涵盖了该流程的每一步操作,包括质粒DNA提取、快速条形码标记与接头连接的文库构建、将文库加载至流动槽进行测序、实时或事后碱基识别,以及使用Autocycler进行序列组装。作者还明确了计算机配置要求,其主要取决于是否进行实时碱基识别。作者利用该工作流程对来自十个临床菌株的纯化质粒进行了测序。为消除宿主细胞菌株差异这一变量的影响,作者 还将这些临床菌株与一种常见的受体菌株进行接合,并对接合子进行了测序。这些实验获得的质粒组装结果与凝胶迁移率推断的质粒大小相符,且在三分之二的案例中,与短读长校正后的组装结果一致,或序列两两比对相似性在0.05%以内。质粒DNA序列的富集还最大限度地提高了质粒测序效率,使得在覆盖度最优的情况下可并行测序多达24个样本。该方案是充分的 适用于大小在4至174 kb之间的质粒,且可耐受高达72%的染色体污染而不影响准确性。该方案特别适用于染色体序列已知或无需关注的情形,例如质粒序列验证、提升通过全基因组测序(WGS)已获得的质粒序列的准确性,或对通过接合捕获的质粒进行测序。本研究以以下生物体为例进行说明: 大肠杆菌,这代表了用于重组基因表达以及通过接合转移进行质粒捕获的常用宿主。
引言
质粒是普遍存在于细菌中的自我复制DNA片段。其大小具有高度变异性,范围从<800 bp到2.5 Mbp不等,通常呈现双峰分布,其中较小的峰对应于高拷贝数的非接合型质粒,较大的峰对应于低拷贝数、通常为接合型的质粒1,2。质粒在微生物生态学中发挥关键作用,携带有助于宿主适应环境挑战或开拓新生态位的基因。质粒还作为加速进化的平台,增强遗传可塑性,并介导菌株、物种、属甚至科之间的水平基因转移3,4。网络分析和比较基因组学研究已证实环境耐药组(resistome)作为临床相关抗生素抗性基因(ARGs)的持久储存库,从而促进这些基因在不同生态环境中的维持与传播5。追踪质粒及其携带的抗生素抗性基因和毒力基因有助于识别传播途径6。因此,质粒的鉴定与表征在公共卫生、临床微生物学及生物技术等多个领域具有重要意义。
新一代测序(NGS)技术的出现使得对未知DNA模板进行高通量测序成为可能,从而为微生物分离株的基因组表征开辟了道路。全基因组测序(WGS)能够追踪新病原体、耐药菌株以及逃避免疫疫苗的变异株的出现、传播和传播途径。该技术也越来越多地被用于帮助识别临床暴发期间的传播路径,从而为未来暴发的预防干预措施提供依据7。最后,WGS还能够对耐药基因(ARGs)进行谱型分析,从而为治疗决策提供参考8,尽管将ARGs与定性及定量的抗生素耐药表型相关联仍处于研究进程中9。
然而,全基因组测序(WGS)大规模产生的短读长(SR)测序数据通常长度在 400–500 bp 范围内。这一长度短于大多数可移动遗传元件(MGEs)的大小,因此无法解析这些元件10。在 WGS 数据中,质粒序列的in silico鉴定还受到覆盖度不完整以及质粒之间、细菌染色体与其他质粒之间存在共享序列的进一步干扰10。因此,组装结果往往高度片段化且不完整,导致无法确定其亚基因组位置(染色体或质粒)10。
长读长(LR)测序技术能够生成高度连续的基因组组装结果,可跨越更多的重复区域,极大地促进了完整质粒组装的获得。目前主要有两种可用的长读长单分子测序技术11,12。其中,纳米孔测序技术由于成本低、周转时间快,且适用于资源有限的环境,在微生物基因组学中正变得越来越受欢迎13,14。
纳米孔测序设备使用含有数千个纳米孔阵列的流动池。DNA被加载到流动池中,由具有解旋酶活性的马达蛋白打开,并在电流差的驱动下通过纳米孔。当单条DNA链中的核苷酸依次通过单个纳米孔时,电流受到干扰,产生特征性信号,该信号由连接至每个纳米孔的电子传感器检测。这些信号通过碱基识别算法进行解码,所得数据随后利用多种生物信息学工具进行进一步的组装与分析。
与短读长测序(SR-sequencing)方法相比,纳米孔测序在电信号数据分析(碱基识别)过程中 tends 产生较低的读段质量(较低的Q值),并在同聚物序列中引入插入/缺失错误15。已有研究指出,天然DNA中邻近的甲基化可能导致系统性的碱基识别错误16。目前普遍采用的解决方案是引入短读长数据用于组装后的错误校正。然而,这一过程(称为“打磨”或“polishing”)会增加成本和操作复杂性17。提高测序深度也可提升准确性,但在技术上并不总是可行。
2024年的研究表明,Oxford Nanopore测序(ONT)R10.4.1流通池与V14化学试剂可为革兰氏阴性菌(G-细菌)生成高质量且连续的基因组组装结果,而在单核苷酸水平的精细分析中,短读长测序(SR-sequencing)数据仍具优势18。然而,长读长(LR)与短读长(SR)测序在准确性方面的差距正逐步缩小。近年来的多项改进包括在提高测序速度的同时实现更精确的数据采样、引入专为原生细菌DNA及甲基化设计的新型碱基识别算法,从而提升碱基识别准确率19,以及更新分析工具,例如用于单倍型分型、变异检测和星型等位基因识别的新算法。还需注意,最新的Dorado算法V.0.9.0(ONT,2025)可用于原始电信号数据(squiggle data)的重新碱基识别。事实上,已有部分全基因组测序(WGS)研究报道,通过纳米孔测序获得的微生物基因组质量已达到无需短读长数据进一步矫正即可获得高可信度一致序列的水平20,21。
质粒通常含有大部分获得性耐药基因,尤其是在肠杆菌科分离株中22。因此,解析质粒序列有助于明确耐药基因的遗传环境,这对于追踪抗菌药物耐药性(AMR)的传播至关重要23,24。纳米孔测序技术已用于研究携带blaKPC基因的质粒的微进化过程25。 MinION设备也已在医院环境中用于临床分离株中质粒的实时台式测序及耐药基因检测26。尽管如此,质粒分析尚未成为常规感染控制实践的一部分。
尽管长读长测序(LR-sequencing)在从基因组序列中恢复质粒方面相较于短读长测序(SR-sequencing)有显著改进27,但仍存在一些问题。Flye28、Canu29 和 Raven30 等长读长组装工具能够生成高质量的染色体组装结果,但在组装质粒序列方面表现不佳。部分原因在于测序覆盖深度不足,因为质粒DNA在全基因组测序(WGS)数据中的丰度较低31。需要注意的是,由于质粒具有模块化结构、富含二级结构且常含有重复序列,其高质量组装所需的测序深度高于染色体DNA(需达到50x的读长深度32)。
富集含有质粒序列的DNA样本是提高测序覆盖深度的有效方法,但在DNA测序前对质粒DNA进行分离或富集对于临床诊断应用而言成本过高或操作繁琐,并且可能因选择性富集特定DNA序列而引入偏差。2017年,研究人员利用质粒富集的DNA尝试对临床样本中的质粒DNA进行完整组装,以检测抗生素抗性基因(ARGs)24。研究对来自六种不同肠杆菌科物种的八个分离株进行测序,以最大化种群和质粒结构的多样性。在尝试了多种基因组组装工具后,结果表明Canu/Canu+Pilon的表现明显优于其他工具;该研究团队还尝试了一种宏组装方法,成功解析出更多质粒结构,最终实现了测序样本中已知质粒总数的78%的完整组装。然而,大重复序列的存在以及(在较小程度上)DNA提取过程中的问题,仍然对所有单重叠群质粒组装的检测构成了重大挑战24。
最近,作为一种富集低丰度质粒序列的补充方法,自适应采样已通过在细菌分离株样本中排除染色体序列得到研究,但该方法需要已知的参考序列33。
本文作者描述了针对质粒DNA富集样本定制的ONT测序方案。通过提高质粒DNA的代表性,并结合最新的文库制备方案、流动池技术及序列组装工具,该工作流程所获得的组装结果在大小上与凝胶迁移率推断的结果一致;在三分之二的案例中,其序列一致性或与短读长测序(SR-sequencing) polished 结果相当,或在成对序列一致性上差异不超过0.05%。质粒DNA序列的富集还最大限度地提高了质粒测序的效率,使得在获得最佳覆盖深度的同时,可并行对多达24个样本进行测序。这些方案并非旨在取代标准的纳米孔全基因组测序(WGS)方法,而是在染色体序列已知或无需关注的情况下,最大限度地提高质粒测序的准确性与效率。
该工作流程包括质粒DNA提取、带条形码的文库构建、接头与马达蛋白的连接、检测流动池、将文库加载到流动池进行测序、对电信号进行数据分析(实时或事后)、使用Autocycler34进行序列组装,以及多种下游分析(图1)。
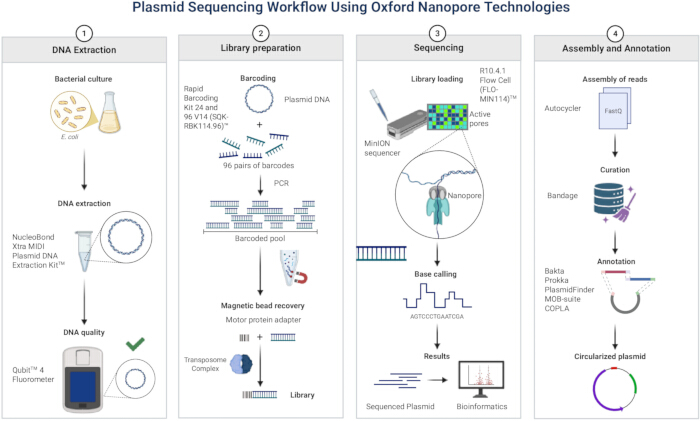
图1:使用Oxford Nanopore Technologies进行质粒测序的工作流程。 步骤1:DNA提取;步骤2:文库制备;步骤3:测序;步骤4:组装与注释。使用BioRender创建。Cortés, G. (2026) https://BioRender.com/u3b15st。 请点击此处查看此图的放大版本。
方案
1. 质粒DNA提取
注意:本实验方案采用商业质粒DNA提取试剂盒,从临床分离的大肠杆菌(Escherichia coli)菌株及其相应的接合子中提取质粒DNA35。有关接合实验的详细方案可参见文献36。该方案适用于高拷贝数和低拷贝数的质粒,质粒大小范围约为3 kb至200 kb。对于大质粒需特别注意,因其通常拷贝数较低(每细胞仅1–2个拷贝),导致DNA得率受限。为弥补此不足,建议增加菌体量以及裂解液和中和液的体积,以确保有足够的质粒DNA与柱结合。使用本方案仍可成功回收大小达200 kb的质粒;然而,对于巨型质粒(>200 kb),其适用性有限。
- 质粒提取
- 第1天:将样品划线接种于添加了适当抗生素的Luria-Bertani(LB)琼脂平板上,以筛选相应质粒携带的抗性标记,于37 °C培养24小时。
注意:通过向每毫升 LB 培养基中加入 1 µL 浓度为 100 mg/mL 的羧苄青霉素(或适当的抗生素)储备液,使其终浓度为 100 µg/mL。 - 第2天:从第1天的单个分离菌落接种3–5 mL含适当抗生素的LB培养基。37 °C振荡培养约8小时,或培养至菌液OD₆₀₀达到1–2。
注意:OD 的测定600使用含有适当抗生素的新鲜LB培养基调零分光光度计,然后取1 mL菌液转移至洁净的比色皿中,测定600 nm处的光密度(OD)。若读数超出线性范围,需稀释样品后重新测定。 - 接种400 µL第2天的LB预培养液至400 mL含适当抗生素的LB培养基中。在37 °C条件下振荡培养8–12小时,或直至OD600 达到1–2(如前所述)。
注意:若 OD 值超过 400 mL,则增加培养液体积600 12 小时内未达到 1–2。为降低质粒丢失或重排的风险,应尽可能减少培养传代次数,并在所有生长步骤中持续使用抗生素筛选。仅在需要更高 DNA 产量时才增加培养体积。 - 第3天:将培养物转移至适合培养液体积的离心管中。在4200 x g 10 分钟,然后根据以下公式,按照制造商推荐的试剂体积重悬沉淀:
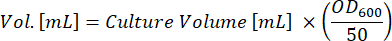
注意:示例:对于400 mL的低拷贝质粒细菌培养物(OD600 = 2)待裂解的样品,其相应的裂解缓冲液 RES、LYS 和 NEU 的适量体积均为 16 mL。
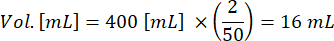
注意:如果重悬、裂解或中和所用试剂的体积未根据总培养生物量进行适当调整(光密度600 × 体积,或 ODV),裂解可能不完全,中和效率低下,且沉淀物形成过多。这可能导致质粒产量降低、纯度下降,并可能堵塞纯化柱。按照生产商提供的公式(步骤1.1.4)按比例调整缓冲液体积,可确保高效裂解、完全中和,并稳定回收高质量的质粒DNA。 - 按照试剂盒说明书进行细胞裂解、使用适当的缓冲液润湿滤膜以及中和。
注意:如果沉淀物体积较大,可叠加使用两个滤膜,并按比例调整缓冲液体积。若上清液仍不透明,需增加离心步骤。中和后,由于沉淀物体积较大,可能需要额外的离心步骤。大多数临床样本均存在此情况。 大肠杆菌,可能是因为它们在培养过程中容易形成生物膜37,涉及分泌一种厚实的基质38裂解液中过多的沉淀物可能堵塞层析柱,延长排液时间,并可能导致蛋白质污染样品。如果上清液澄清,则这些额外步骤可能无需进行。 - 将裂解液在4200 x g 30分钟。将上清液转移至新管,再次离心30分钟。如果经过上述离心后上清液仍不透明(图2),在4200 x g.
注意:在离心过程中将裂解液转移至50 mL培养管中可能有助于上清液的移除,因为沉淀有时无法完全沉降至管底,可能滞留在管口附近。由于处理的液体体积较大,单个层析柱可能达到饱和,无法承载更多样品。为提高过滤速度或最大化DNA得率,可将裂解液分至两个层析柱中进行处理。 - 根据试剂盒说明书进行EQU、WASH和ELU步骤。
- 使用异丙醇沉淀DNA。
注意:如果沉淀物不可见,可在 -20 °C 孵育约 10 分钟。然而,通常最好谨慎地吸除上清液,相信沉淀物仍附着在管壁上,即使肉眼不可见。 - 按照说明用乙醇洗涤DNA。如果蛋白质沉淀仍然存在,进行额外洗涤。
- 室温(约 20 °C)干燥 DNA 15–30 分钟。
- 将DNA重悬于100 µL无核酸酶水中;此较小体积有助于在Nanopore文库制备中最大化浓度。
注意:此处为合适的暂停点。质粒DNA可在–20 °C下保存数月。本方案所用的提取试剂盒通过优化的缓冲液化学成分、温和裂解及裂解液澄清步骤,旨在最大限度减少染色体(基因组)DNA的污染;尽管如此,仍不能完全排除大量染色体DNA污染的可能性,作者在质粒制备样品中已检测到此类污染(见结果)。
- 第1天:将样品划线接种于添加了适当抗生素的Luria-Bertani(LB)琼脂平板上,以筛选相应质粒携带的抗性标记,于37 °C培养24小时。
- DNA 产量与质量控制
使用荧光染料定量DNA并评估其质量,相较于紫外吸收法,荧光染料对低浓度DNA具有更高的特异性和灵敏度。在本方案中,使用荧光计设备对DNA、RNA或蛋白质样品进行准确且便捷的定量。39.- 荧光计工作流程
- 将DNA样本置于室温。准备标准品和样本的试管。
注意:根据样本数量计算工作液中染料和缓冲液的适当体积。每个标准品和样本应通过将染料按1:200的比例稀释于缓冲液中,制备200 µL工作液。该设备内置试剂计算器,也可用于此类计算。 - 根据以下步骤准备测定管 表1.
- 每管涡旋震荡数秒,然后在室温下孵育2分钟。
- 使用标准品校准荧光计。插入样品管并记录读数。详细操作步骤请参阅荧光计使用手册39.
注意:对于典型的质粒中量制备,每100–400 mL培养液的DNA产量通常在~50至150 µg之间,具体产量取决于质粒大小、拷贝数及培养条件。典型的纳米孔测序读长范围为~2 kb至20 kb,标准质粒的中位读长通常在5–10 kb左右。基于连接反应的试剂盒可产生更长的读长>对于较大的质粒,可获得更长的读长(中位数为20 kb),但快速试剂盒虽然制备速度更快,读长略短。
- 将DNA样本置于室温。准备标准品和样本的试管。
- 荧光计工作流程
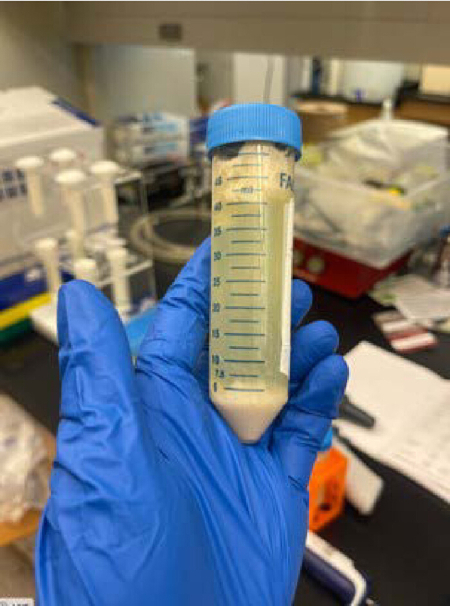
图 2:一次离心步骤后浑浊的裂解液上清。 需要进行连续离心,直至上清液澄清,以避免堵塞过滤柱。请点击此处查看该图的放大版本。
| 标准检测管 | 用户样品检测管 | |
| 工作液(染料与缓冲液,1:200) | 190 µL | 180–199 µL |
| 标准品(来自试剂盒) | 10 µL | – |
| 用户样品 | – | 1–20 µL |
| 每根检测管中的总体积 | 200 µL | 200 µL |
表1:荧光计所用试剂体积和用量。 表中列出的是单个样品的用量;可根据待分析样品的数量配制相应体积的混合液。
2. 方法2:文库制备
注意:考虑因素。根据条形码试剂盒40提供的说明,对提取的质粒进行测序文库构建。本方案使用基于转座酶技术的试剂盒,可同时对DNA进行片段化和加标签,提供快速且简化的操作流程,减少手动操作时间并简化文库构建过程。
- DNA 制备
- 第 1 天:设置热循环仪程序:30 °C 保持 2 分钟,然后 80 °C 保持 2 分钟。
- 在室温下解冻试剂盒组分,离心收集并根据 表 2 进行混合。
注意:若使用离心机,应以不超过 330 x g 的低速离心。 - 在无核酸酶水中制备 DNA:将 200 ng DNA 转移至 0.2 mL PCR 管中,并向每个样品中加入适量的无核酸酶水,使最终体积达到 10 µL。用移液器轻柔吹打 10–15 次以混匀。在微量离心机或离心机中以 330 x g 短暂离心,以便于后续步骤中的移液操作。
- 按照 表 3 所述,在 PCR 管中配制混合液。
- 通过移液混匀,然后短暂离心。
- 使用步骤 1 中的热循环程序孵育 PCR 管。将管子置于冰上冷却。
- 短暂离心。
- 天然条形码连接
- 将带有条形码的样品汇集至一个洁净的 1.5 mL Eppendorf 管中。确保总体积不超过 1000 µL。
- 通过涡旋重悬磁珠。向汇集的条形码样品中加入等体积的磁珠,并通过弹击混匀。
- 在 Hula 混合器上室温孵育 10 分钟。
- 在无核酸酶水中配制 2 mL 80% 乙醇。
- 将样品离心并吸附在磁铁上:将管子紧贴磁铁放置。保持管子在磁铁上,用移液器吸除上清液作为废液。
注意:任何适当强度和尺寸的磁铁(包括钕磁铁)均可有效替代昂贵的磁力架。通常,持有力约为 5–12 磅、直径为 0.3–1 英寸的磁铁适用于标准的 0.2–1.5 mL 管,可在基于磁珠的纯化步骤中实现上清液的干净去除。 - 在磁铁存在下,用 1 mL 80% 乙醇洗涤磁珠,吸除乙醇。重复洗涤一次。
注意:调整管子相对于磁铁的位置可能有助于更方便地去除乙醇。如果磁珠沉淀意外扰动,可进行一次额外的低速离心,以确保磁珠完全沉淀。 - 短暂离心后将管子重新放回磁铁上。用移液器吸除任何残留的乙醇。干燥 30 秒,但不要使沉淀完全干裂。
- 移开磁铁,并将磁珠重悬于洗脱缓冲液中。根据所使用的条形码数量,参见 表 4 确定应使用的 EB 体积。
- 室温孵育 10 分钟。
- 将管子放回磁铁上,直至洗脱液变澄清。
- 使用 1 µL 洗脱样品在荧光计上测定 DNA 浓度,以确认文库制备成功,避免在失败的文库上浪费流动池。
- 接头连接
- 将 11 µL DNA 文库转移至新管中并标记。
注意:如有需要,将多余的 DNA 储存于 -20 °C 以备后续测序使用。 - 根据 表 5 在新管中稀释已解冻的快速接头,并上下吹打混匀。
- 向 11 µL DNA 文库中加入 1 µL 稀释后的 RA。
- 弹击管壁混匀,短暂离心以确保全部液体聚集于管底。
- 在台面上孵育 5 分钟。
- 将 11 µL DNA 文库转移至新管中并标记。
| 试剂 | 室温解冻 | 离心 | 移液混匀 |
| Rapid Barcodes | 未冷冻 | ✓ | ✓ |
| Rapid Adapter | 未冷冻 | ✓ | ✓ |
| AMPure XP beads | ✓ | ✓ | 使用前立即通过移液或涡旋振荡混匀 |
| Elution Buffer | ✓ | ✓ | ✓ |
| Adapter Buffer | ✓ | ✓ | 通过涡旋振荡混匀 |
表2:纳米孔文库制备所需的试剂体积和用量。 每种试剂所需执行的操作已用(✓)标记。
| 试剂 | 每样本体积 |
| 10 µL 模板DNA(来自上一步,200 ng) | 10 µL |
| 1.5 µL 快速条形码,每个样本使用一个 | 1.5 µL |
| 总体积 | 11.5 µL |
表3:快速加接头测序的试剂及体积。 所示体积为每个DNA样本所需量;可先配制混合液,再分别加入DNA样本。
| 1-24 个条形码 | 48 个条形码 | 72 个条形码 | 96 个条形码 | |
| 洗脱缓冲液体积 | 15 µL | 30 µL | 45 µL | 60 µL |
表4:每24个条形码所用的洗脱缓冲液体积。 体积根据条形码数量进行标注。
| 试剂 | 体积 |
| 快速接头 (RA) | 1.5 µL |
| 接头缓冲液 (ADB) | 3.5 µL |
| 总体积 | 5µL |
表5:接头连接试剂及用量。 体积可根据样本数量进行调整。
3. 流通池运行
注意:当对少量质粒进行中等测序深度测序时,应选择标准输出流动池。Nanopore 建议执行流动池检测以确定活性纳米孔数量;根据保修标准,纳米孔设备的流动池应至少具有 800 个活性纳米孔。单个 MinION 流动池提供的测序产出足以用于多个富含质粒 DNA 的 DNA 样本测序(有关多重测序的更多细节,请参见讨论部分),同时相比 GRIDion 或 Promethean 流动池具有更低的成本和更高的灵活性。
- 流动池的预处理与上样
注意:本方案使用 R10.4.1 流动池(2022 年发布)。该流动池具有更长的孔道和双读取头,可提高同聚物测序的准确性20,21。本测序方案及条形码试剂盒不适用于其他类型的流动池。在进行大规模多重测序、追求高覆盖度或处理较大质粒或基因组时,建议选用高输出流动池。请根据样本数量和目标测序深度,权衡成本、通量与测序质量。- 从冷藏环境中取出试剂,包括测序缓冲液(SB)、文库磁珠(LIB)或文库溶液(LIS)、牛血清白蛋白(BSA)、流动池连接液(FCT)和流动池冲洗液(FCF)。室温下冰上融化。试剂完全融化后,涡旋混匀,短暂离心,并置于冰上保存。
- 通过使用 表6 中列出的试剂配制新鲜的 DNA 管,准备流动池预处理液。通过倒置和移液混匀。
- 打开设备盖子,插入流动池。施加轻柔压力以确保正确安装。
- 将盖子轻轻推开,暴露预处理口。
- 检查预处理口内部或附近是否存在气泡。回吸 20–30 µL 液体以去除气泡。
注意:切勿移除超过 20–30 µL 的缓冲液。孔道必须始终浸没在缓冲液中。若孔道暴露于空气中,可能导致其无法使用。确保可见通道内的缓冲液连续无中断。 - 吸取 800 µL 预处理混合液,加入预处理口。避免引入气泡。让设备静置 5 分钟。
- 通过反复吹打重悬文库。
注意:应在使用前立即重悬,因为文库会迅速沉降。 - 在新管中,根据 表7 所示体积,将 DNA 文库与适量的文库磁珠混合。
注意:作者使用的快速条形码试剂盒采用基于转座酶的方法对 DNA 进行片段化并连接条形码,不进行有意的片段大小选择,因此读长主要反映原始输入 DNA 的长度。与基于连接的试剂盒(如原生条形码试剂盒)不同,快速条形码试剂盒不包含单独的短片段或长片段缓冲液。尽管较长的 DNA 仍可产生长读段,但其分布更具变异性,通常比使用长片段缓冲液富集长片段的基于连接的文库更短。缺少缓冲液简化了操作流程并减少了手动操作时间,但对文库片段大小分布的控制能力较弱,可能影响组装质量。基于连接的试剂盒通过选择性富集大片段并去除小片段,通常能获得更高的中位读长和更优的组装连续性,尤其适用于从头组装和复杂基因组。 - 调整样品口盖以暴露端口。将 200 µL 预处理混合液加入流动池的预处理口。
- 上样前轻柔混匀已制备的 DNA 文库。
- 将含磁珠的 DNA 文库以每滴 75 µL 分次加入样品口,每次一滴,待前一滴完全吸收后再加入下一滴。
- 重新盖上样品口盖,并关闭预处理口。
- 安装光屏蔽罩:将光屏蔽罩前缘对准卡扣,然后将其余部分放下以覆盖整个流动池。切勿尝试将光屏蔽罩置于卡扣下方。光屏蔽罩应围绕盖子放置,保护流动池顶部区域免受光照。
注意:文库上样后应立即安装光屏蔽罩,以获得最佳测序输出。在文库从流动池移除前的所有后续步骤中均应保持安装状态。光屏蔽罩未牢固固定于设备上,操作时需小心,避免移位。 - 关闭设备盖子,开始测序运行。
- 启动测序运行——计算资源要求:
最低配置:8 核 CPU,16 GB 内存,1070 NVIDIA GPU,500 GB SSD
推荐配置:16 核 CPU,32 GB 内存,2070 NVIDIA GPU,1 TB SSD
注意:确保软件和计算机系统均为最新版本,并至少预留 500 GB 的可用存储空间以容纳新生成的文件。软件更新或其他程序可能干扰测序运行。请在 Windows 或 Ubuntu 操作系统上运行该软件。- 设置运行时间限制:根据多重测序的质粒数量设定运行时限。默认为 48 小时,最长可运行 72 小时。详细操作请参阅说明书。
注意:运行时间取决于多重测序程度和质粒大小,而非质粒数量。可多重测序的样本或质粒数量取决于所需的测序深度和流动池的输出能力。对于典型的质粒测序,每个标准纳米孔流动池多重测序 20–24 个样本通常可提供足够的覆盖度,以实现准确的组装和变异检测,前提是质粒大小在约 200 kb 以下。较大的质粒或更高的覆盖度需求可能需要减少每个流动池的样本数。高输出流动池每轮运行可支持更多样本(可达 96 个或以上),适用于高通量质粒测序或需要极深覆盖度的项目。用户应权衡条形码数量、质粒大小和目标深度,确保每个质粒获得足够的读段以完成完整组装。 - 若在测序过程中进行去多重化处理,请启用条形码修剪功能。
注意:监控每个条形码的读段数量,当达到足够覆盖度时停止运行,以延长流动池使用寿命。 - 选择超精确碱基识别模式。
注意:请勿选择自适应采样或条形码平衡功能。该选项会显著降低读段输出,并加速孔道损耗。若无 GPU,建议在运行结束后再进行碱基识别。 - 选择相应的快速条形码试剂盒(24 或 96)。
- 确保设备水平放置,并以默认设置(最小 Q 值为 10)启动测序运行。
注意:此处为一个方便的暂停点,设备可整夜运行。 - 事后碱基识别(若计算机不具备实时碱基识别能力,或为提高碱基识别准确性,可使用改进的分析工具重新分析原始数据):在软件中打开已完成的测序运行
注意:以下步骤仅适用于未选择实时碱基识别的情况。 - 选择碱基识别,并选用超精确(SUP)模型。
- 选择原始 FAST5/POD5 数据,并设置输出目录。
- 开始碱基识别。
- 设置运行时间限制:根据多重测序的质粒数量设定运行时限。默认为 48 小时,最长可运行 72 小时。详细操作请参阅说明书。
| 试剂 | 每流式池体积 |
| 流式池冲洗液 (FCF) | 1,170 μL |
| 牛血清白蛋白 (BSA),50 mg/mL | 5 μL |
| 流式池连接液 (FCT) | 30 μL |
| 管中最终总体积 | 1,205 μL |
表6:引物和上样流动池的试剂及体积。试剂体积按每个流动池给出。
| 试剂 | 每流动池体积 |
| 测序缓冲液 (SB) | 37.5 μL |
| 文库磁珠 (LIB) 或文库溶液 (LIS),如使用 | 25.5 μL |
| DNA文库 | 12 μL |
| 总计 | 75 μL |
表7:文库上样所需的试剂及体积。 表中体积针对DNA文库;文库磁珠(bid)应在使用前立即混匀。
4. 方法4:使用自动循环仪进行组装
注意:将测序读段组装成重叠群(contig)有多种可选方法。每种组装软件都有其优势和特定的偏差。本方案推荐使用 Autocycler,该工具整合了多种不同的组装结果,并将其合并为最终的综合组装结果。此方法较为耗时,您也可选择仅使用单一组装软件以节省时间。请确保已在终端中安装 Conda,以便下载相应的软件。补充命令文档中包含一个环境文件的链接,可用于配置系统环境。
- 评估测序运行质量:通过 Minknow 软件或运行报告的 .html 文件检查测序运行质量,记录各项质量指标(产量、Q值、读长、分布情况)。可选地,使用 NanoPlot 分析 FASTQ 文件,以确认各条形码的读长分布、N50 及质量得分谱型。只有当测序产量和读长分布与预期质粒大小一致时,方可继续后续分析。
- 去除条形码:确定测序运行过程中是否启用了条形码切除功能。若未去除条形码,需使用 Porechop(v0.2.4)对 FASTQ 文件进行条形码修剪,并在下游分析前验证条形码接头序列已成功去除。
- 读长修剪:使用 Filtlong(v0.3.1)对长读长数据进行修剪,去除约 5–10% 质量最低的读段,同时保留约 90% 的总产量。生成用于组装的过滤后 FASTQ 文件。若后续组装产生嵌合重叠群(contig),可通过设置最低读长阈值 ≥3,000 bp 来提高过滤严格性,并重新生成过滤后的读段。
- 子抽样并组装读段子集:根据推荐设置,使用 Autocycler 对读段进行子抽样,并利用 Raven(v1.8.3)、Flye(v2.9.6)、Canu(v2.3.0)、miniasm(v0.3.0)、Myloasm(v0.2.0)、NECAT(v0.0.1)、Plassembler(v1.8.1)以及任意其他选定的组装工具对每个读段子集进行组装。记录每次组装所得重叠群的长度及环化状态。优先选择能够报告环化结果的组装工具(Raven、Flye、miniasm、Myloasm 和 Plassembler)用于质粒重建。对于 Canu 和 NECAT 的组装结果,应根据先前组装中环状重叠群的预期质粒大小,识别候选质粒重叠群。
- 检查与整理组装结果:使用 Bandage(v0.9.0)可视化各组装图文件(.gfa),评估重叠群的环化情况、不同组装工具间大小的一致性以及是否存在嵌合连接的证据。去除在多个组装工具中均无支持的线性重叠群,保留大小估计一致的环状重叠群。若多数组装结果存在嵌合连接,返回步骤 4.3,提高最低读长阈值(建议 ≥3,000 bp)。当主要质粒已实现环化但存在较小且无支持的重叠群时,应在生成一致性序列前去除次要重叠群。完成人工整理后,可批量执行一致性序列生成与打磨步骤。
- 生成一致性序列与最终组装:在完成人工整理后,使用 Autocycler 基于整理后的组装结果生成一致性序列。执行 Autocycler 的其余命令,以获得最终的一致性质粒序列。详细的命令行指令和参数设置见补充材料。
- 打磨(Polishing):在获得完整组装序列后,使用经修剪的长读段数据结合 Medaka(v2.1.1)对组装结果进行打磨,以显著提高一致性准确性。
注意:尽管额外的打磨轮次有助于提升一致性准确性,但也可能引入错误。最佳实践是在打磨前使用如 DNAapler 等程序对新重叠群进行旋转;相关命令见补充命令部分。
5. 方法5:注释
注意:目前有许多有效的细菌注释工具。以下程序推荐用于全面的注释。
- Bakta 非常适用于蛋白质组学分析,因为它目前处于积极维护状态,并被视为 Prokka 的精神继承者41,42。
- 对于复制子分型、质粒移动性分型以及接合转移分型,MOB-suite 具有较高的可靠性6。MOB-suite 可利用 mash 距离法推断质粒系统发育关系,并能识别插入序列(IS)元件43。
- COPLA 也是质粒分类学中一个有用的工具。该工具采用独特的策略,将质粒划分为质粒分类单元,在领域内受到推荐44。
注:由于质粒具有模块化结构且重组频率高,导致序列比对困难,因此质粒系统发育研究在历史上一直面临重大挑战。COPLA 通过计算平均核苷酸一致性(ANI)来应对这些挑战。
结果
临床 E. coli 菌株
为了展示牛津纳米孔测序技术(ONT)在临床菌株质粒测序中的应用,作者对10株菌进行了测序,这些菌株由华盛顿大学的Stephen Salipante博士慷慨提供。这些菌株来自一个包含312株肠外致病性 E. coli(ExPEC)的菌种库,这些分离株均来源于华盛顿大学医学中心在常规临床诊疗过程中采集的血液或尿液样本45。
质粒接合及通过凝胶迁移实验进行表征
研究人员还使用大肠杆菌(E. coli)菌株 LMB100 作为受体进行了接合实验。接合是一种将存在于一个细胞(供体)中的质粒转移至另一个细胞(称为受体)的过程46。该转移需要两个细胞之间的直接物理接触,通常通过检测受体细胞中是否存在接合性质粒的标记来确认。这使得作者能够排除宿主菌株差异这一变量,并展示本方案在通过质粒捕获方法(一种用于分析特定生态位中质粒谱型的技术)获得的质粒测序中的应用。所有接合实验均成功产生了接合子,证实了供体菌中存在可接合的质粒。作者所遵循的实验方案详见文献36。该研究团队鉴定了供体和受体菌株中存在的质粒,并通过脉冲场凝胶电泳(PFGE)估算了其迁移能力。十个代表性供体菌株列于表8中,其中第三列列出了这些菌株所含质粒的估计大小。超出PFGE凝胶分辨率范围的质粒未包含在此表中,但研究人员成功组装了多个大小约为4 kb的较小质粒(未显示)。
| 供体菌株 | 质粒 | 估计的PFGE大小 | 组装长度 | 平均深度 | 零深度碱基对数 | 覆盖度% | 发生改变的位点数 | SR前准确性% |
| blood_08 _0081 | pblood_08_ 0081_1 | 170000 | 171829 | 100 | 99.941803 | 54 | 0.0314 | 99.9686 |
| blood_08 _0081 | pBlood_08_ 0081_2 | 82000 | 85576 | 46.9 | 0 | 100 | 2 | 99.9977 |
| blood_d-08 _0094 | pBlood_d-08 _0094 | 179000 | 173334 | 382.6 | 3121 | 98.19943 | 2,347 | 98.646 |
| blood_08 _1447 | pBlood_08 _1447 | 97000 | 99624 | 36.2 | 0 | 100 | 0 | 100 |
| blood_10 _0913 | pBlood_10 _0913_1 | 70000 | 71788 | 49 | 4 | 99.994428 | 188 | 99.7381 |
| blood_10 _0913 | pBlood_10 _0913_2 | 112000 | 118727 | 41.2 | 126 | 99.893874 | 276 | 99.7675 |
| blood_1 1_184 | pBlood_11 _184_1 | 150000 | 146583 | 65.1 | 287 | 99.804206 | 134 | 99.9086 |
| blood_11_184 | pBlood_11 _184_2 | 75000 | 74263 | 82.1 | 0 | 100 | 32 | 99.9569 |
| blood_2011 _0238 | pBlood_ 2011_0238 | 170000 | 167286 | 110.9 | 0 | 100 | 0 | 100 |
| upec_108 | pUPEC_108 | 130500 | 131039 | 103.9 | 0 | 100 | 0 | 100 |
| upec_134 | pUPEC_134 | 160500 | 157829 | 169 | 0 | 100 | 0 | 100 |
| upec_271 | pUPEC_271 | 145500 | 144519 | 86 | 33311 | 76.950436 | 1,557 | 98.9226 |
| upec_90 | pUPEC_90 | 70000 | 74624 | 139.8 | 0 | 100 | 6 | 99.992 |
表8: 10种供体菌株质粒的大小估计值及测序准确性指标。 列出了基于脉冲场凝胶电泳(PFGE)或Oxford Nanopore测序(ONT)组装得到的供体质粒序列的大小估计值。同时展示了仅使用ONT数据与经短读长序列(SR)校正后的质粒组装结果之间的成对比较,以作为准确性的参考指标。相关指标包括:组装长度、平均测序深度、零深度区域、覆盖度百分比、发生改变的位点数以及校正前的准确性百分比。
基于ONT的质粒测序输出指标
测序运行设置为24小时。共对24个样本进行了多重测序。每个样本的技术数据,包括质量分数(Q)、长度和覆盖度,列于表9中。Nanopore测序为所有分析样本提供了足够的读段输出量和质量。在所有文库中,测序平均每个样本产生134,115条读段,平均产出为576.2 Mb。读段平均长度为8,797 bp,平均N50为3,693 bp,足以支持质粒的组装。读段平均质量分数为Q16.0,中位数为Q16.6,单个运行的质量分数范围为Q13.7至Q18.0。
| 测序菌株 | 读段数(kb) | 碱基数(Mb) | 平均长度 | 最大长度 | 最小长度 | N50 | 中位数长度 | 平均Q值 | 中位数Q值 | |
| Blood_08_0081 供体 | 109.8 | 261 | 5713 | 508418 | 78 | 2377 | 1351 | 14.5 | 15 | |
| Blood_08_0094 供体 | 89.3 | 229 | 4177 | 114948 | 81 | 2565 | 1065 | 13.7 | 14 | |
| Blood_08_1447 供体 | 87.5 | 246 | 5041 | 135147 | 75 | 2816 | 1609 | 15.1 | 15.7 | |
| Bblood_10_0913 供体 | 247.7 | 1026 | 9260 | 174231 | 70 | 4143 | 1661 | 15.5 | 16.1 | |
| Blood_11_154 供体 | 51.5 | 110 | 4172 | 91148 | 73 | 2127 | 1387 | 16.1 | 16.5 | |
| Blood_2011_0238 供体 | 16.8 | 42 | 6707 | 104848 | 62 | 2534 | 845 | 15.3 | 15.2 | |
| UPEC_108 供体 | 50.6 | 77 | 1915 | 90234 | 67 | 1525 | 1103 | 15.8 | 16.2 | |
| UPEC_134 供体 | 50 | 143 | 7110 | 158393 | 72 | 2865 | 1133 | 16 | 16.2 | |
| UPEC_217 供体 | 64 | 236 | 7512 | 144275 | 78 | 3678 | 1895 | 17.4 | 17.9 | |
| UPEC_90 供体 | 52.9 | 157 | 5666 | 95944 | 72 | 2969 | 1593 | 16.8 | 17.2 | |
| Blood_08_0081 LMB100 接合子 | 53.5 | 119 | 5162 | 225856 | 1 | 2232 | 1009 | 16 | 16.8 | |
| Blood_08_0094 LMB100 接合子 | 160 | 442 | 7257 | 252176 | 1 | 2761 | 1083 | 17.3 | 18.2 | |
| Blood_08_1447 LMB100 接合子 | 238 | 1029 | 10249 | 209221 | 1 | 4320 | 1857 | 17.7 | 18.7 | |
| Blood_10_0913 LMB100 接合子 | 792.3 | 4341 | 11508 | 474325 | 1 | 5479 | 2731 | 17.7 | 18.8 | |
| Blood_11_184 LMB100 接合子 | 42.5 | 281 | 17931 | 146626 | 87 | 6615 | 2448 | 16 | 16.7 | |
| Blood_2011_0238 LMB100 接合子 | 147.7 | 585 | 9000 | 344203 | 1 | 3962 | 1781 | 18 | 18.9 | |
| UPEC_108 LMB100 接合子 | 173.4 | 778 | 10127 | 168756 | 80 | 4485 | 2079 | 15.3 | 16.1 | |
| UPEC_134 LMB100 接合子 | 105.4 | 667 | 17568 | 349230 | 71 | 6323 | 2232 | 15.5 | 16.3 | |
| UPEC_271 LMB100 接合子 | 74.2 | 336 | 14521 | 342195 | 83 | 4520 | 1306 | 14.6 | 14.8 | |
| UPEC_90 LMB100 接合子 | 75.2 | 418 | 15348 | 225661 | 83 | 5561 | 2016 | 15.7 | 16.4 | |
表9:10个供体菌株面板测序输出指标的NanoQ报告。 列出了测序输出指标,包括来自供体菌株和接合子的读段数、碱基数、长度(平均值、中位数、最大值和最小值)、长度分布、N50以及Q值(平均值和中位数)。
质粒组装与准确性
质粒序列使用 Autocycler34 进行组装。表8 第四列列出了10个样本组装后质粒序列的大小,所有样本均与基于PFGE迁移率的估计值(第三列)一致。通过将Medaka优化的长读长组装结果与Medaka(v2.2.0)结合polypolish(v0.6.1)的组装结果进行比较,评估了准确性。使用MUMmer(v3.2.4)中的dnadiff工具计算序列一致性(表8)。在所有分析的质粒(n = 12)中,组装序列平均长度为120.4 kb,平均测序深度为109x,质粒序列的平均覆盖度为97.9%。在优化前,组装序列相对于短读长序列优化组装结果的平均序列一致性为99.74%。
染色体污染程度的评估
为评估质粒覆盖度和染色体污染情况,将测序读段比对至组装得到的质粒序列以及 E. coli LMB100 染色体序列。使用 minimap2(v2.2.6)对经碱基识别的 Nanopore 读段进行比对。利用 SAMtools(v1.1.7)处理比对结果,生成排序后的 BAM 文件并计算比对统计信息。通过 SAMtools coverage 模块估算质粒的覆盖度和平均深度。不同样本间的质粒测序深度有所差异,但均显著高于准确组装所需的最低覆盖度(50–70 x)。部分读段比对到染色体上,表明质粒提取过程中存在宿主 DNA 的残留(表 10)。
| 质粒 | 总读段数 | 染色体读段数 | 染色体读段百分比 | 平均染色体覆盖度 | 平均质粒覆盖度 | 质粒:染色体比率 |
| pBlood_08_0081_2 | 53491 | 20116 | 37.61% | 5 | 1068 | 236 |
| pBlood_d-08_0094 | 160024 | 74827 | 46.76% | 37 | 1618 | 44 |
| pBlood_08_1447 | 238031 | 127967 | 53.76% | 62 | 7842 | 127 |
| pBlood_10_0913_1 | 792263 | 221610 | 27.97% | 87 | 7801 | 90 |
| pBlood_10_0913_2 | 792263 | 221610 | 27.97% | 87 | 7772 | 89 |
| pBlood_11_184_1 | 42494 | 15919 | 37.46% | 7 | 1637 | 250 |
| pBlood_11_184_2 | 42494 | 15919 | 37.46% | 7 | 2188 | 335 |
| pBlood_2011_0238 | 147680 | 80526 | 54.53% | 56 | 2965 | 53 |
| pUPEC_108 | 173409 | 107884 | 62.21% | 61 | 4008 | 65 |
| pUPEC_134 | 105418 | 68645 | 65.12% | 29 | 3640 | 127 |
| pUPEC_271 | 74232 | 53554 | 72.14% | 34 | 1202 | 35 |
| pUPEC_90 | 75193 | 30052 | 39.97% | 16 | 4488 | 278 |
表10:染色体DNA污染程度的估计值。 从受体菌株中纯化的质粒所含的染色体污染,通过比对到LMB100染色体序列的读段数占质粒读段数的比例进行量化。对于每个质粒,列出了质粒读段数、总读段数、染色体读段数、染色体平均覆盖深度、质粒平均覆盖深度以及质粒与染色体读段比(P:C Ratio)。请注意,pBlood_08_0081_1未包含在内,因其无法在受体菌中回收;这些估算均在受体菌中进行,因其具有均一的染色体背景。
染色体污染被量化为比对到组装的LMB100染色体序列的读段数相对于质粒读段数的比例。染色体污染率在72.1%至28.0%之间,平均为46.9%(表10)。该方法可能高估染色体污染,因为同时比对到质粒和染色体的读段被计为仅属于染色体,但结果仍表明存在显著的染色体残留。尽管存在此类染色体残留,组装流程仍成功重建了完整的质粒序列,且所有样本中这些序列的大小仍与脉冲场凝胶电泳(PFGE)迁移率预测的大小一致(表8,第三和第四列)。
接合性质粒的代表性供体-受体配对
菌株upec271于2011年至2013年间从尿液样本中分离获得,归属于系统发育群B2和序列型ST131。PFGE分析显示存在一条约145 kb质粒对应的条带[图3A,(供体)]。短读长测序分析鉴定出IncF复制子的存在。
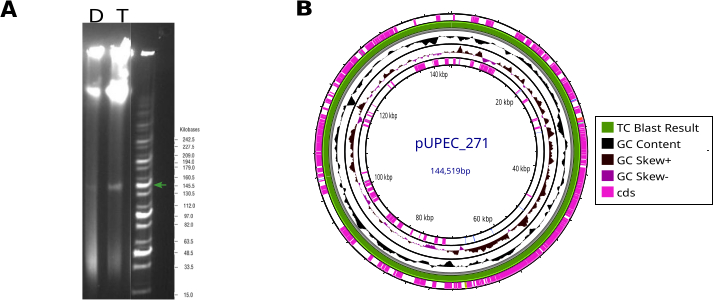
图3:pUPEC271的表征。(A) 供体菌与接合子的脉冲场凝胶电泳(PFGE)。图中显示了供体菌(D)和接合子(T)的PFGE条带;绿色箭头指示对应于pUPEC271质粒的条带。PFGE所用实验方案详见一项研究36。 (B) pUPEC271的图谱。 将接合子与供体菌进行比对,其一致性序列(100%相同)以绿色环状图表示。该图谱由Proksee软件生成48。最外层环表示编码序列(CDS)的位置,两个内环分别显示GC含量和GC偏移,最内层环表示tRNA基因的位置。请点击此处查看该图的放大版本。
通过此前文献中描述的脉冲场凝胶电泳(PFGE)分析方法36,进一步证实了该质粒(作者命名为pUPEC271)的转移 [图3A,T(接合子)]。从供体菌株upec271中纯化的质粒DNA(pUPEC271_donor)采用纳米孔测序技术进行测序。测序结果显示,该质粒大小为144,519 bp,与其在PFGE凝胶上的条带大小一致(图3B)。该质粒含有IncF型复制子,并携带对六类不同抗生素的耐药基因(见补充表1)。作者还从其中一个接合子中纯化了DNA(pUPEC271_TC),获得的序列与供体完全相同。最终组装结果与pUPEC271_donor比对后如图3B所示。上述结果证实,供体菌株中的接合性质粒成功转移至接合子菌株。相关技术数据见表9。
菌株 Blood_10_0913 是携带多个质粒的菌株示例之一。该样本于2008年至2013年间从血液中分离获得,短读长测序结果显示存在两个复制子,分别为IncF型和IncY型复制子。对该菌株进行PFGE分析,鉴定出大小分别约为70 kb和110 kb的两个质粒(图4A)。这一结果通过纳米孔测序得以验证,测序获得了两个组装序列,长度分别为71,182 bp和111,226 bp。作者将这两个质粒分别命名为pBlood_10_0913_1和pBlood_10_0913_2(图4B)。然而,由于两个质粒中携带接合转移装置的区域存在高度序列同源性,初始组装未能实现环化闭合(高度同源区域在图4B中已标出)。使用Bandage47生成的组装失败图谱如图4C所示。只有在严格剔除短读长(< 3000 bp)序列后,才成功完成了这两个质粒的完整组装。
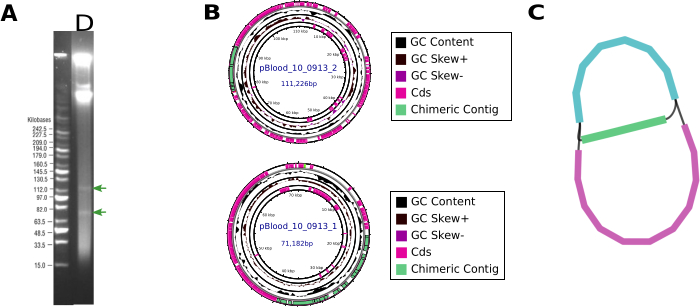
图4:Blood_10_0913菌株质粒的鉴定与组装。(A)脉冲场凝胶电泳(PFGE)。绿色箭头指示质粒条带。 PFGE所用方案见文献36。(B) 序列组装。pBlood_10_0913样品中两个较小质粒pBlood_10_0913_2和pBlood_10_0913_2的组装结果。(C)组装失败。由于两个不同组装之间存在共享序列而导致组装失败的示意图。该图由Bandage软件生成47。 请点击此处查看该图的放大版本。
补充表 1:pUPEC271 携带的耐药基因。 显示了 pUPEC271 质粒的大小、复制子以及相关耐药基因。请点击此处下载该文件。
补充命令。请点击此处下载该文件。
讨论
质粒的鉴定与表征在公共卫生、临床微生物学和微生物生态学领域备受关注,因为质粒能够在不同生态环境中维持并传播适应性基因1,5,并作为加速进化的平台4。下一代测序(NGS)技术的引入使得微生物分离株及微生物群体基因组的高通量测序成为可能,但组装后对完整质粒或质粒来源的重叠群(contig)进行鉴定通常需要长读长测序数据,因为短读长测序数据无法解析长度超过读长的重复区域。牛津纳米孔测序技术(ONT)已成为一种广受欢迎的长读长测序方法,其应用不仅涵盖全基因组测序和宏基因组学,还包括质粒序列验证、表观遗传修饰的检测与表征、RNA测序,以及串联基因阵列内在不稳定性的评估(详见文献12,49的综述)。
在此,研究人员展示了一种用于纳米孔测序(ONT)质粒的实验流程,适用于染色体序列已知或无需关注的情况。原因是质粒提取过程耗时、费力且成本较高(因为需要培养宿主菌群并进行处理),而利用纳米孔技术对整个基因组进行测序通常足以获得完整的质粒组装结果,同时提供其基因组背景信息。该方案在以下情况中尤为有用:验证质粒基因工程中的质粒序列50,51,提高全基因组测序(WGS)已获得的质粒序列的准确性24,或对通过接合转移从临床或环境样本中捕获的质粒进行表征。
从临床和环境样本中提取DNA可能需要进行一些定制化调整。本文作者报告称,他们所使用的一些临床菌株会产生生物膜基质,容易堵塞滤膜,因此需要多次离心收集菌体,有时还需额外使用两片滤膜。此外,与测序高拷贝数质粒相比,为测序接合性质粒,需要更大体积的培养物,因为自然界中存在的中等及大型质粒通常拷贝数较低2。
该方案已成功实现了对大小在4 kb至173 kb之间的质粒进行测序,此范围完全符合制造商的技术规格(2–200 kb)。最近一项研究分析了NCBI数据库中收录的23,000条质粒序列,发现其大小存在显著差异,且与来源密切相关:来源于人类的质粒中位数大小最小(76 kb),而土壤和植物来源的质粒最大(分别为215 kb和427 kb);其他所有来源的质粒中位数大小介于79 kb至147 kb之间。因此,本方案应可覆盖大多数质粒,可能仅对巨型质粒52以及土壤或植物来源的质粒存在例外3。
作者加入质粒DNA富集步骤,以提高质粒DNA组装的准确性。大量染色体DNA的存在会导致测序流动池中的细胞孔被非目标序列读长占据,从而显著降低质粒DNA的测序深度。此前已有研究采用质粒DNA富集步骤,尝试对临床样本中的质粒DNA进行完整组装,以检测抗生素抗性基因(ARGs)24。该方法在仅使用纳米孔测序数据完成质粒组装方面表现出显著提升(相对于基准,完整组装率达到78%)。后续又有多个类似研究相继报道50,53,54。
为了提高读长准确性,其中两项研究采用了纳米孔公司(nanopore)开发的一种名为“伪配对读长的配对碱基识别”(paired basecalling on pseudopaired reads)的技术50,53。该方法通过比对同一条DNA分子的正链和反链所产生的原始电信号,使测序准确性提高约一个数量级。伪配对读长的配对碱基识别技术可与多重测序(multiplexing)兼容,前提是实验策略能够识别出同一分子的正向和反向链。因此,该方法不能用于从含有未知质粒组成或混合质粒样本中纯化的质粒。需注意,基因组中质粒的数量通常在0到7个之间(尤其在临床分离株中)2,55。
研究人员注意到样本中存在较高水平的染色体污染(表10)。根据序列比对结果,所分析的10个样本的污染水平在28%至72%之间。然而,当研究人员将该序列数据根据染色体与质粒(或存在的多个质粒)相对大小进行标准化处理后,发现质粒序列的丰度平均比染色体序列高出144倍。若要将此数值转化为质粒DNA的富集程度,则需要知道每个样本中质粒的拷贝数。
MinION 流动池通常可产生约 30 GB 的测序数据输出,理论上能够实现每个运行批次测序超过 96 个质粒。实际上,由于受到 96 种条形码的限制,每个流动池最多可并行处理 96 个质粒,这是实际操作中的上限。然而,染色体 DNA 污染和天然条形码分布不均会降低每个样本的有效测序深度。为确保每个样本具有足够的测序深度,更保守的做法是每个流动池合并约 24 个质粒样本。推荐的质粒序列准确组装所需测序深度为 50 至 70 倍32,56。在本文展示的示例中,作者在一个流动池中运行了 21 个多重样本,获得了平均 109 倍的测序深度,与每个流动池推荐的最佳样本数量相符。
需要注意的是,当测序深度过高时,通过合格/不合格读段划分来评估整体读段质量的信息价值较低。相比之下,由读段长度分布得出的指标能更清晰地反映数据集的质量。其中一个指标是N50,定义为长度等于或大于该值的读段所包含的碱基数占总碱基数的50%。该数值对质量控制步骤极为敏感。例如,使用Filtlong等工具过滤低质量或短读段,会显著去除分布中较短读段的尾部,从而导致N50值被抬高。这一现象在表9中表现明显。
作者使用了ONT的快速条形码试剂盒,该试剂盒利用转座复合物对质粒DNA进行片段化,因此无需预先了解质粒的限制性酶切图谱。先前的一项研究发现,对于小质粒(<20 kb),必须进行酶切片段化,因为小质粒在大多数DNA提取过程中仍保持环状结构,因而缺乏用于接头连接的游离末端54。该研究未使用条形码,而条形码可通过PCR扩增产生额外的游离末端,因此在此情况下,这一问题可能并不成立。OnRamp是用于常规质粒验证的一种高级方法,它通过利用全长质粒读段进行组装,避免了条形码的使用,从而简化了样品制备流程54。然而,在本研究中,作者出于三个原因更倾向于使用条形码。第一个原因是能够不受质粒长度影响地构建组装序列。第二个原因是能够耐受染色体DNA的污染。第三个原因是如上所述,这为多个样本的多重测序提供了可能。
早期的一项研究指出,通过整合不同基因组拼接工具的拼接结果,可以消除各单一拼接平台固有的偏差,从而改善最终的拼接效果24。这种整合分析(meta-analysis)特性已被纳入作者所使用的拼接程序Autocycler34中。与之前版本Trycycler57相比,Autocycler实现了更高的自动化程度;它利用测序数据的多个子集,并(如前所述)使用多种拼接工具进行多次拼接,以生成更精确的一致性拼接结果。然而,大多数拼接工具,即使是最优秀的工具(如Flye28、Canu29和Raven30),在处理具有高度序列同源性的质粒时仍存在困难,容易错误地将不同质粒序列合并,或产生单个质粒的多个拷贝 ,并且常常会遗漏小型质粒58,59(另见图4C)。当出现此类问题时,剔除低质量读段并去除短读段有助于解决嵌合重叠群(chimeric contigs)的问题。
为了评估测序方案的整体准确性,作者将仅使用牛津纳米孔技术(ONT)的组装结果与结合长读长和短读长数据进行优化后的组装结果进行了比较,后者(在缺乏PacBio数据的情况下)是目前的金标准。作者还获得了凝胶电泳数据,显示了各样本中质粒的数量及其估计大小(表8, 第三列)。研究人员成功组装出10个样本中存在的全部13个质粒,并获得与组装序列一致的大小。这一成果相当显著,因为长读长序列组装工具通常难以组装具有结构复杂序列的质粒。在更精细的层面上,两组序列之间的成对比较显示准确性存在差异(表8)。在13个质粒组装结果中,有5个在ONT组装序列中存在无覆盖区域,推测这是在仅使用ONT数据进行序列组装过程中人为引入的序列片段所致。其余7个质粒中,3个存在单核苷酸多态性(SNPs),成对差异范围在0.0023%至0.05%之间,另外4个则完全一致。准确性的高低似乎与质粒DNA富集程度或测序深度无关,但与单个样本中是否存在多个质粒相关,可能是因为多个质粒的存在会增加序列复杂性水平(表8)。总之,该工作流程旨在优化质粒序列的产出量和准确性。尽管该流程能够成功组装质粒序列,但在核苷酸水平上的准确性存在一定变异。该方案可用于测序多种不同大小范围的质粒,可耐受至少72%的染色体DNA污染,并且(取决于质粒大小和流动槽状态)可在单个流动槽中同时处理至少24个质粒。
披露
作者无任何利益冲突需要披露。
致谢
我们非常感谢华盛顿大学的 Steve Salipante 慷慨分享了其发表的一组临床大肠杆菌(E. coli)菌株45。本研究部分得到了加州大学圣克鲁兹分校(UCSC)向 MC 提供的创新与创业发展主任职位的研究支持资金,以及加州大学 Alianza MX 项目“墨西哥高负担和脆弱人群中结核分枝杆菌分离株的基因组特征分析:对传播和耐药性的深入理解”对 MC 的资助。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| 1.5 mL Eppendorf DNA LoBind 管 | Sigma Aldrich | EP022431081 | 可替换为其他品牌的同类产品 |
| 1.5 mL 离心管架 | 赛默飞世尔科技 | 22-313630 | 可替换为其他品牌的同类产品 |
| 15 mL 一次性离心管 | FALCON | 352096 | 可以替换为其他品牌的 |
| 15 mL 离心管架 | 赛默飞世尔科技 | 8850 | 可替换为其他品牌的同类产品 |
| 2.0 mL 微量离心管 | Fisherbrand | 05-408-138 | 可替换为其他品牌的同类产品 |
| 250 mL 无菌烧瓶 | PYREX | 5320 | 可替换为其他品牌的同类产品 |
| 羧苄青霉素 | GOLD BIOTECHNOLOGY | C-103-50 | 可替换为其他品牌的同类产品 |
| 离心 | Eppendorf | 5424R-PR-R | 可替换为其他品牌的同类产品 |
| 离心 | Eppendorf | 5810R-P-R | 可替换为其他品牌的同类产品 |
| 离心管 | Sigma Aldrich | B1283-4EA | 可替换为其他品牌的同类产品 |
| 一次性接种环:1 µL | Fisherbrand | 22-363-595 | 可替换为其他品牌的同类产品 |
| 电子数字天平 | 丹佛仪器 | APX-2001 | 可替换为其他品牌的同类产品 |
| 乙醇 | Fisher Scientific | 04-355-720 | 可替换为其他品牌的同类产品 |
| 乙醇抗性标记物 | 记号笔 | 37001; 37002; 37003 | 可以替换为其他品牌的 |
| 流通池(R10.4.1) | Oxford Nanopore Technologies | FLO-MIN114 | |
| 流动池清洗试剂盒 | Oxford Nanopore Technologies | EXP-WSH004 | |
| 手套 | X-GEN | 44-100M | 任何品牌的腈类手套均可使用 |
| 冰桶 | 赛默飞世尔科技 | 432128 | 可替换为其他品牌的同类产品 |
| 异丙醇 | Fisher Scientific | BP26184 | 可替换为其他品牌的同类产品 |
| MinION 测序仪 | Oxford Nanopore Technologies | MIN-101B | |
| 原生条形码试剂盒 96 V14 | Oxford Nanopore Technologies | SQK-NBD114.96 | |
| NucleoBond Xtra MIDI 质粒DNA提取试剂盒 | Takara | 740410.5 | |
| PCR管架 | AXYGEN | R96PCRFSP | 可替换为其他品牌的同类产品 |
| PCR管:(0.2 mL) | AXYGEN | PCR-02-C | 可替换为其他品牌的同类产品 |
| 程序自动循环器 v0.5.2 | Ryan Wick / 墨尔本大学 | ||
| 程序 bcftools v1.22 | 惠康桑格研究所(HTSlib / Samtools 团队) | ||
| 程序 bwa v0.7.19 | Heng Li,最初就职于布罗德研究所 | ||
| Canu v2.3 程序 | 加利福尼亚大学戴维斯分校 &和太平洋生物科学公司合作者 | ||
| flye 程序 v2.9.6 | 加利福尼亚大学圣地亚哥分校(Pavel Pevzner 实验室) | ||
| 程序鳉 v2.1.1 | Oxford Nanopore Technologies | ||
| 程序 metamdbg v1.2 | INRIA | ||
| miniasm v0.3 程序 | Heng Li | ||
| 程序 minimap2 v2.28 | Heng Li | ||
| 程序 minipolish v0.2.0 | Ryan Wick / 墨尔本大学 | ||
| 程序 porechop v0.2.4 | Ryan Wick / 墨尔本大学 | ||
| 程序 racon v1.5.0 | 新加坡基因组研究所 | ||
| 程序 samtools v1.22.1 | 惠康桑格研究所(HTSlib / Samtools 项目) | ||
| Qubit™ 4 氟光计 | Invitrogen | Q33226 | |
| Qubit™ 检测管 | Invitrogen | Q32856 | |
| 快速条形码试剂盒 24 和 96 V14 | Oxford Nanopore Technologies | SQK-RBK114.96 | |
| 一套可分配1至1000微升液体的微量移液器 – 10 μL(P10),2 – 20 μL(P20),20 – 200 μL(P200)和200 – 1000 μL(P1000) | RAININ | 17008648; 17008650; 17008652; 17008653 | 微量移液器应进行校准 |
| 分光光度计 | 赛默飞世尔科技 | 335905P | 可替换为其他品牌的同类产品 |
| 10 微升灭菌吸头 μL, 200 μL 和 1000 μL | 日食 | 1011-260-000-9; 1018-260-000; 1019-260-000-9 | |
| Thermal cycler C1000 Touch | 伯乐(Bio-Rad) | 1851196 | 可替换为其他品牌的同类产品 |
| 水浴锅 | 赛默飞世尔科技 | 51221052 | 可替换为其他品牌的同类产品 |
参考文献
- Finks, S. S., Martiny, J. B. H. Plasmid-encoded traits vary across environments. mBio. 14 (1), e0319122(2023).
- Ramiro-Martinez, P., de Quinto, I., Lanza, V. F., Gama, J. A., Rodriguez-Beltran, J. Universal rules govern plasmid copy number. Nat Commun. 16 (1), 6022(2025).
- Redondo-Salvo, S., et al. Pathways for horizontal gene transfer in bacteria revealed by a global map of their plasmids. Nat Commun. 11 (1), 3602(2020).
- Rodriguez-Beltran, J., DelaFuente, J., Leon-Sampedro, R., MacLean, R. C., San Millan, A. Beyond horizontal gene transfer: the role of plasmids in bacterial evolution. Nat Rev Microbiol. 19 (6), 347-359 (2021).
- Castaneda-Barba, S., Top, E. M., Stalder, T. Plasmids, a molecular cornerstone of antimicrobial resistance in the one health era. Nat Rev Microbiol. 22 (1), 18-32 (2024).
- Robertson, J., Bessonov, K., Schonfeld, J., Nash, J. H. E. Universal whole-sequence-based plasmid typing and its utility to prediction of host range and epidemiological surveillance. Microb Genom. 6 (10), (2020).
- Conlan, S., et al. Single-molecule sequencing to track plasmid diversity of hospital-associated carbapenemase-producing Enterobacteriaceae. Sci Transl Med. 6 (254), 254ra126(2014).
- Zankari, E., et al. Identification of acquired antimicrobial resistance genes. J Antimicrob Chemother. 67 (11), 2640-2644 (2012).
- Eyre, D. W., et al. WGS to predict antibiotic MICs for Neisseria gonorrhoeae. J Antimicrob Chemother. 72 (7), 1937-1947 (2017).
- Arredondo-Alonso, S., Willems, R. J., van Schaik, W., Schurch, A. C. On the (im)possibility of reconstructing plasmids from whole-genome short-read sequencing data. Microb Genom. 3 (10), e000128(2017).
- Rhoads, A., Au, K. F. PacBio sequencing and its applications. Genomics Proteomics Bioinformatics. 13 (5), 278-289 (2015).
- Zhang, T., et al. Nanopore sequencing: flourishing in its teenage years. J Genet Genomics. 51 (12), 1361-1374 (2024).
- González, A., Fullaondo, A., Odriozola, A. Why are long-read sequencing methods revolutionizing microbiome analysis? Microorganisms. 13 (8), (2025).
- Wick, R. R., Holt, K. E. Polypolish: Short-read polishing of long-read bacterial genome assemblies. PLoS Comput Biol. 18 (1), e1009802(2022).
- Delahaye, C., Nicolas, J. Sequencing DNA with nanopores: Troubles and biases. PLoS One. 16 (10), e0257521(2021).
- Watson, M., Warr, A. Errors in long-read assemblies can critically affect protein prediction. Nat Biotechnol. 37 (2), 124-126 (2019).
- De Maio, N., et al. Comparison of long-read sequencing technologies in the hybrid assembly of complex bacterial genomes. Microb Genom. 5 (9), (2019).
- Lerminiaux, N., Fakharuddin, K., Mulvey, M. R., Mataseje, L. Do we still need Illumina sequencing data? Evaluating Oxford Nanopore Technologies R10.4.1 flow cells and the Rapid v14 library prep kit for Gram-negative bacteria whole genome assemblies. Can J Microbiol. 70 (5), 178-189 (2024).
- Dabernig-Heinz, J., et al. A multicenter study on accuracy and reproducibility of nanopore sequencing-based genotyping of bacterial pathogens. J Clin Microbiol. 62 (9), e0062824(2024).
- Sereika, M., et al. Oxford Nanopore R10.4 long-read sequencing enables the generation of near-finished bacterial genomes from pure cultures and metagenomes without short-read or reference polishing. Nat Methods. 19 (7), 823-826 (2022).
- Wick, R. R., Judd, L. M., Holt, K. E. Assembling the perfect bacterial genome using Oxford Nanopore and Illumina sequencing. PLoS Comput Biol. 19 (3), e1010905(2023).
- Paterson, D. L. Resistance in gram-negative bacteria: enterobacteriaceae. Am J Med. 119 (1), discussion S62-70 S20-S28 (2006).
- Peter, S., et al. Tracking of antibiotic resistance transfer and rapid plasmid evolution in a hospital setting by nanopore sequencing. mSphere. 5 (4), (2020).
- George, S., et al. Resolving plasmid structures in Enterobacteriaceae using the MinION nanopore sequencer: assessment of MinION and MinION/Illumina hybrid data assembly approaches. Microb Genom. 3 (8), e000118(2017).
- Dong, N., Yang, X., Zhang, R., Chan, E. W., Chen, S. Tracking microevolution events among ST11 carbapenemase-producing hypervirulent Klebsiella pneumoniae outbreak strains. Emerg Microbes Infect. 7 (1), 146(2018).
- Lemon, J. K., Khil, P. P., Frank, K. M., Dekker, J. P. Rapid nanopore sequencing of plasmids and resistance gene detection in clinical isolates. J Clin Microbiol. 55 (12), 3530-3543 (2017).
- Linde, J., et al. Comparison of Illumina and Oxford Nanopore Technology for genome analysis of Francisella tularensis, Bacillus anthracis, and Brucella suis. BMC Genomics. 24 (1), 258(2023).
- Bickhart, D. M., et al. Generating lineage-resolved, complete metagenome-assembled genomes from complex microbial communities. Nat Biotechnol. 40 (5), 711-719 (2022).
- Koren, S., et al. Canu: scalable and accurate long-read assembly via adaptive k-mer weighting and repeat separation. Genome Res. 27 (5), 722-736 (2017).
- Vaser, R., Sikic, M. Time-and memory-efficient genome assembly with Raven. Nat Comput Sci. 1 (5), 332-336 (2021).
- Lynch, M. D., Neufeld, J. D. Ecology and exploration of the rare biosphere. Nat Rev Microbiol. 13 (4), 217-229 (2015).
- Kruasuwan, W., et al. Comparative evaluation of commercial DNA isolation approaches for nanopore-only bacterial genome assembly and plasmid recovery. Sci Rep. 14 (1), 27672(2024).
- Ulrich, J. U., et al. Nanopore adaptive sampling effectively enriches bacterial plasmids. mSystems. 9 (3), e0094523(2024).
- Wick, R. R., Howden, B. P., Stinear, T. P. Autocycler: long-read consensus assembly for bacterial genomes. Bioinformatics. 41 (9), (2025).
- NucleoBond Xtra Plasmid DNA Purification User Manual. , Takara Bio USA. Available from: https://www.takarabio.com/documents/User%20Manual/NucleoBond%20Xtra%20Plasmid%20DNA%20Purification%20User%20Manual_Rev_15.pdf?srsltid=AfmBOorkdYVlr34yclNUgmBCn4imrn-gbvTafmkD2Yrnnch6fH-K_VwZ (2019).
- Mota-Bravo, L., et al. Detection of horizontal gene transfer mediated by natural conjugative plasmids in E. coli. J Vis Exp. (193), (2023).
- Hancock, V., Witso, I. L., Klemm, P. Biofilm formation as a function of adhesin, growth medium, substratum, and strain type. Int J Med Microbiol. 301 (7), 570-576 (2011).
- Hung, C., et al. Escherichia coli biofilms have an organized and complex extracellular matrix structure. mBio. 4 (5), e00645-e00713 (2013).
- Qubit 4 assays quick reference (Pub. No. MAN0017210 C.0). , Thermo Fisher Scientific. (2025).
- Rapid barcoding sequencing kit 96 v14. , Oxford Nanopore Technologies. Available from: https://store.nanoporetech.com/us/rapid-barcoding-sequencing-kit-96-v14.html (2026).
- Schwengers, O., et al. Bakta: rapid and standardized annotation of bacterial genomes via alignment-free sequence identification. Microb Genom. 7 (11), (2021).
- Seemann, T. Prokka: rapid prokaryotic genome annotation. Bioinformatics. 30 (14), 2068-2069 (2014).
- Singh, H., et al. Integrons: the hidden architects of bacterial adaptation, evolution, and the challenges of antimicrobial resistance. Antonie Van Leeuwenhoek. 118 (7), 90(2025).
- Redondo-Salvo, S., et al. COPLA, a taxonomic classifier of plasmids. BMC Bioinformatics. 22 (1), 390(2021).
- Salipante, S. J., et al. Large-scale genomic sequencing of extraintestinal pathogenic Escherichia coli strains. Genome Res. 25 (1), 119-128 (2015).
- Couturier, A., et al. Real-time visualisation of the intracellular dynamics of conjugative plasmid transfer. Nat Commun. 14 (1), 294(2023).
- Wick, R. R., Schultz, M. B., Zobel, J., Holt, K. E. Bandage: interactive visualization of de novo genome assemblies. Bioinformatics. 31 (20), 3350-3352 (2015).
- Grant, J. R., et al. Proksee: in-depth characterization and visualization of bacterial genomes. Nucleic Acids Res. 51 (W1), W484-W492 (2023).
- MacKenzie, M., Argyropoulos, C. An Introduction to nanopore sequencing: past, present, and future considerations. Micromachines (Basel). 14 (2), (2023).
- Emiliani, F. E., Hsu, I., McKenna, A. Multiplexed assembly and annotation of synthetic biology constructs using long-read nanopore sequencing. ACS Synth Biol. 11 (7), 2238-2246 (2022).
- Brown, S. D., Dreolini, L., Wilson, J. F., Balasundaram, M., Holt, R. A. Complete sequence verification of plasmid DNA using the Oxford Nanopore Technologies' MinION device. BMC Bioinformatics. 24 (1), 116(2023).
- Hall, J. P. J., Botelho, J., Cazares, A., Baltrus, D. A. What makes a megaplasmid? Philos Trans R Soc Lond B Biol Sci. 377 (1842), 20200472(2022).
- Brown Kav, A., Benhar, I., Mizrahi, I. A method for purifying high-quality and high-yield plasmid DNA for metagenomic and deep sequencing approaches. J Microbiol Methods. 95 (2), 272-279 (2013).
- Mumm, C., et al. Multiplexed long-read plasmid validation and analysis using OnRamp. Genome Res. 33 (5), 741-749 (2023).
- Balbuena-Alonso, M. G., et al. Genomic analysis of plasmid content in food isolates of E. coli strongly supports its role as a reservoir for the horizontal transfer of virulence and antibiotic resistance genes. Plasmid. 123-124, 102650(2022).
- Zhao, W., et al. Oxford nanopore long-read sequencing enables the generation of complete bacterial and plasmid genomes without short-read sequencing. Front Microbiol. 14, 1179966(2023).
- Wick, R. R., et al. Trycycler: consensus long-read assemblies for bacterial genomes. Genome Biol. 22 (1), 266(2021).
- Johnson, J., Soehnlen, M., Blankenship, H. M. Long read genome assemblers struggle with small plasmids. Microb Genom. 9 (5), (2023).
- Boostrom, I., Portal, E. A. R., Spiller, O. B., Walsh, T. R., Sands, K. Comparing long-read assemblers to explore the potential of a sustainable low-cost, low-infrastructure approach to sequence antimicrobial resistant bacteria with Oxford Nanopore sequencing. Front Microbiol. 13, 796465(2022).
重印与许可
