本方案描述了一种可重复的工作流程,将异常凝血酶原(PIVKA-II)、甲胎蛋白(AFP)和常规临床变量整合到肝细胞癌的逻辑回归诊断模型中,并在早期及AFP阴性肝细胞癌病例中进行了验证。
本文内容
摘要
摘要
甲胎蛋白(AFP)在肝细胞癌(HCC)早期检测中的敏感性尚不完善,尤其对于早期阶段和AFP阴性肿瘤的检出能力有限。本研究评估了异常凝血酶原/维生素K缺乏诱导蛋白-II(PIVKA-II)、AFP以及常规临床变量是否可整合为一种可重复的HCC诊断模型。研究采用包含112例影像学确诊HCC患者和93例非HCC对照者的回顾性训练队列(共205名参与者)进行模型构建,并采用包含58例HCC患者和126例非HCC对照者的独立前瞻性验证队列(共184名参与者)进行模型外部验证,且未对模型重新拟合。使用影像学检查前的血液样本检测AFP和PIVKA-II水平,并在同一诊断时间窗内提取临床变量。最终的多变量逻辑回归模型整合了ln(AFP)、ln(PIVKA-II)、年龄、性别、白蛋白、国际标准化比值(INR)和血小板计数。该联合模型在训练队列中的AUC为0.93,在验证队列中为0.89。在验证队列中,其敏感性为84.5%,特异性为90.5%。在早期HCC亚组中敏感性仍达72.7%,在AFP阴性HCC亚组中为73.1%,均优于单独使用AFP。校准曲线和自助法验证表明模型具有良好的稳定性。研究结果表明,PIVKA-II、AFP及常规临床变量可被整合为一种适用于高危肝病人群的实用诊断分层工具。
引言
肝细胞癌(HCC)是癌症相关死亡的主要原因之一,通常发生在患有慢性肝病的患者中,包括乙型肝炎病毒感染、丙型肝炎病毒感染、酒精相关性肝病以及代谢功能障碍相关性脂肪性肝病1。早期发现具有重要的临床意义,因为当肿瘤尚未发生血管侵犯、肝外扩散或肝功能显著恶化时,根治性治疗的效果最佳。目前的监测策略通常依赖肝脏超声检查,有时联合或不联合血清甲胎蛋白(AFP)检测2。然而在常规临床实践中,监测效果受到操作者依赖性、肿瘤体积较小、肝硬化结节形态异质、肥胖导致的影像学困难以及部分肿瘤不产生或仅产生极少量AFP等因素的影响3,4。
甲胎蛋白(AFP)因价格低廉、易于获取且临床医生对其较为熟悉而被广泛使用。然而,其诊断价值受到敏感性不完全和特异性欠佳的限制。在传统的20 ng/mL阈值下,AFP可能遗漏大量早期或AFP阴性的肝细胞癌(HCC)病例。采用较低的阈值虽可提高敏感性,但会增加活动性肝炎、肝硬化或其他炎症性肝病患者的假阳性结果5,6。这些局限性使得单一生化标志物的检测结果不足以用于高风险肝病人群的诊断分层。
异常凝血酶原,也称为维生素K缺乏诱导的蛋白-II(PIVKA-II)或去γ-羧基凝血酶原,是在恶性肝细胞产生未完全羧化的凝血酶原时释放的。PIVKA-II反映的是与凝血相关的肿瘤生物学特征,而非甲胎蛋白(AFP)的分泌情况,且在AFP水平较低时仍可能具有诊断价值7。既往研究及荟萃分析表明,PIVKA-II可提高肝细胞癌(HCC)的检出率,尤其是与AFP联合使用时,对于早期或AFP阴性的疾病可能更具补充价值8,9。然而,仅依赖标志物的策略未能充分考虑宿主背景、肝脏储备功能、血小板计数、凝血状态或潜在肝脏疾病的影响。
复合诊断模型为结合临床背景共同解读肿瘤标志物结果提供了一种实用方法。GALAD、GAAD 及相关模型已表明,可将人口统计学变量与生物标志物相结合,以提高在不同病因和人群中的肝细胞癌(HCC)检出率10,11。这些模型的性能支持采用多变量风险评估,而非依赖单一生物标志物的固定阈值。与此同时,部分模型包含的检测项目并非所有实验室均可常规开展,且其截断值在不同地区、病因构成、疾病分期及预期临床用途中可能存在差异12。若模型基于广泛可及的生物标志物和常规实验室指标构建,则更易于在常规诊断流程中推广应用。与以往可能依赖特异性生物标志物或人群特异性截断策略的模型不同,本研究评估了一种基于广泛可及的生物标志物和常规临床变量的多变量诊断模型,并在一个独立的前瞻性队列中验证了其诊断效能。
PIVKA-II 适用于该框架,因为它可作为 AFP 的补充,并且能够在临床实验室已使用的自动化免疫分析平台上进行检测。在同一次临床诊疗过程中,可同时获得年龄、性别、白蛋白、胆红素、血小板计数、国际标准化比值以及肝脏疾病背景等常规指标,这些变量可能反映肝脏储备功能或与凝血相关的信息,对肝细胞癌(HCC)风险具有提示意义13。将这些变量与 AFP 和 PIVKA-II 结合,可能提高风险判别的准确性,同时避免依赖单一截断值。
因此采用双队列诊断设计,评估了PIVKA-II、AFP及常规临床变量。在回顾性训练队列中建立多变量逻辑回归模型,并在独立的前瞻性验证队列中进行测试,且未重新拟合模型。将该模型的诊断性能与单独使用AFP、PIVKA-II及临床变量的情况进行比较,重点关注早期肝细胞癌(HCC)、AFP阴性HCC、截断值解释、校准以及自助法内部验证。
方案
本研究经西湖大学医学院附属杭州市第一人民医院伦理委员会审查批准,批准编号为 IIT-20230528-0108-01。在血液采集前,已从前瞻性纳入的参与者处获得书面知情同意。对于在常规诊疗过程中回顾性纳入的临床记录及留存的剩余样本,由于使用的是去标识化数据且未实施任何额外干预,伦理委员会豁免了知情同意要求。
可重复性、偏倚控制与数据完整性
在统计分析之前,已预先规定了纳入标准、血液采样时间点、影像学判定规则、亚组定义、候选预测因子、截断值定义、缺失数据处理规则以及验证流程。血液样本在增强造影影像学确诊之前以及任何抗肿瘤治疗开始之前采集。实验室检测采用匿名的研究编号,训练队列和验证队列的样本以随机顺序进行检测。实验室人员对最终诊断结果、队列分组、巴塞罗那临床肝癌(BCLC)分期以及甲胎蛋白(AFP)阴性状态保持盲法。影像学诊断与分期的确定独立于实验室检测过程。数据录入、单位换算、队列分配、排除编码、缺失值编码及统计分析数据集均由两名研究人员进行核对,确认无误后进行模型拟合。在整个变量筛选、模型拟合、截断值确定及验证过程中,训练队列与验证队列始终保持分离。
研究人群与设计
这项双队列诊断研究开发并验证了一种用于肝细胞癌(HCC)检测的多变量模型,该模型结合了异常凝血酶原/维生素K缺乏或拮抗剂-II诱导的蛋白质(PIVKA-II)、甲胎蛋白(AFP)以及常规临床变量。回顾性构建的训练队列纳入了2021年1月1日至2023年12月31日期间接受评估的受试者,用于变量筛选、模型拟合、截断值确定以及自助法内部验证。前瞻性入组的验证队列纳入了2024年1月1日至2025年12月31日期间接受评估的受试者,仅用于样本外测试。在验证队列中未进行任何变量重新筛选、模型重新拟合、系数更新、截断值再优化或基于亚组的重新校准。受试者流程、队列分配、血液采样、血浆处理、生物标志物检测、影像学判定及统计分析流程见图1。
研究对象来自西湖大学医学院附属杭州市第一人民医院的肝病高危人群监测或诊断路径。高危状态定义为慢性乙型肝炎感染、慢性丙型肝炎感染、任何病因的肝硬化,或根据临床评估、实验室记录或既往影像学检查证实存在纤维化的脂肪性肝病。符合条件的受试者为年龄≥18岁的成年人,且在血液采集后14天内完成影像前血液采样以及增强多期相计算机断层扫描(CT)和/或动态增强磁共振成像(MRI)。排除标准包括:既往接受过肝细胞癌治疗(如手术切除、消融、经动脉治疗或系统性治疗);采样前7天内使用过维生素K;正在接受维生素K拮抗剂治疗或其他可能影响凝血功能解读的抗凝治疗;采样时存在急性胆管炎或胆道梗阻;妊娠;缺乏甲胎蛋白(AFP)、异常凝血酶原(PIVKA-II)或最终影像学诊断结果;以及标本质量不合格且无有效重复样本。
最终研究人群包括389名参与者。训练队列包括205名参与者,其中112例经影像学确诊的肝细胞癌(HCC)病例和93例非HCC对照。验证队列包括184名参与者,其中58例经影像学确诊的HCC病例和126例非HCC对照。在训练队列中,93例非HCC对照包括30例健康对照和63例慢性肝病对照。在验证队列中,126例非HCC对照包括0例健康对照和126例慢性肝病对照。
仅根据乙型肝炎病史或代偿期肝硬化,不判定为有症状状态。只有当影像学检查前的病历记录中明确记载了新出现或加重的右上腹疼痛、无法解释的体重减轻、腹部膨隆、黄疸、尿色加深,或经临床确认且无其他明确病因解释的失代偿表现时,参与者才被归类为有症状。未出现上述表现的参与者则被归类为无症状或监测发现者。
诊断评估与分期
最终的肝细胞癌(HCC)状态通过常规诊疗中进行的对比增强多期CT和/或动态对比增强MRI进行判定。影像检查必须至少包含动脉期和门静脉期;若具备延迟期结果,也应纳入评估。当在高危肝脏中发现病灶呈现动脉期明显强化,并伴有门静脉期和/或延迟期廓清,无论是否存在强化包膜,均将该病灶归类为HCC。对于影像学表现不符合HCC特征且无其他恶性诊断的参与者,则归类为非HCC。
采用预设表格提取影像学信息,记录影像检查方式、获取的时相、动脉期强化、廓清、包膜征、病灶数量、最大病灶直径、大血管侵犯以及肝外播散情况。由两名经过培训的阅片者根据最终的放射学报告独立提取影像特征。若有分歧,则通过协商达成一致意见,并采用相同的预定义标准进行判定。若CT和MRI均可用,则优先选用多期相信息更完整的检查方式;若两种检查方式的多期相信息均完整,则采用作为最终临床决策依据的检查方式。
在肝细胞癌(HCC)状态最终确定后分配BCLC分期。早期HCC定义为BCLC 0–A期。甲胎蛋白(AFP)阴性HCC定义为影像学检查前血液样本中AFP <20 ng/mL。这些亚组标签仅用于亚组性能评估,不用于模型训练或受试者入组资格判定。
样本采集与血浆处理
在外周静脉血采集前,受试者需至少禁食8小时以上,并于清晨在增强CT/MRI确认及抗肿瘤治疗开始前采集血液样本。采集总共10 mL静脉血至含K2-EDTA抗凝剂的采血管中。采血后立即轻轻倒置试管8–10次,并在4 °C条件下运送至实验室。从静脉穿刺到离心的时间间隔控制在2小时以内,并在样本记录日志中注明。
采用冷藏离心机在 4 °C 条件下以 1,600 × g 离心 10 分钟,分离血浆。将血浆上清液转移至 1.5 mL 无核酸酶的微量离心管中,并分装为每份 0.5–1.0 mL。分装后样本于 -80 °C 保存,直至检测。在进行生物标志物检测前,将一份样本在室温(20–25 °C)下解冻 20–30 分钟,仅限一次;通过轻柔颠倒混匀,并在完全解冻后 2 小时内完成检测。根据预先设定的实验室样本接受标准,对可见凝块、中至重度溶血或明显脂血的样本予以剔除。对于前瞻性验证队列,在临床可行的情况下,于影像学确诊前进行重复采血。
AFP 与 PIVKA-II 检测
使用全自动免疫分析仪通过电化学发光免疫分析法检测AFP和PIVKA-II。AFP的结果以ng/mL为单位记录,PIVKA-II的结果以mAU/mL为单位记录。结果直接从实验室信息系统导出。
每个分析批次均包含特定检测的校准品以及至少两个内部质控水平。批次通过的标准是所有质控结果均需落在预设的实验室质控范围内。甲胎蛋白(AFP)和异常凝血酶原(PIVKA-II)的分析精密度目标为:批内变异系数≤10%,批间变异系数≤15%。若质控失败或检测到批次漂移,则拒绝该批次,对分析仪重新校准,并在样本量充足的情况下重新运行该批次。对于单个样本出现不合理或超出检测范围的结果,若条件允许,应从同一解冻后的分装样本中进行两次重复测定,并采用两次有效重复结果的均值。若重复检测失败或样本量不足,则标记该结果为无效,并按照缺失数据规则进行处理。
常规临床变量提取
在与甲胎蛋白(AFP)/蛋白质诱导维生素K缺乏或拮抗剂-II(PIVKA-II)采血相同的临床就诊过程中提取了常规临床变量。候选变量包括年龄、性别、丙氨酸氨基转移酶、天冬氨酸氨基转移酶、白蛋白、总胆红素、国际标准化比值(INR)、凝血酶原时间以及血小板计数。当影像前窗口期内存在多个数值时,选择最接近AFP/PIVKA-II采样时间的数值。分析前对所有单位进行了标准化处理。年龄以年为单位记录;性别编码为女性=0,男性=1;血小板计数以×10⁹/L为单位记录;白蛋白以g/L为单位记录;总胆红素以μmol/L为单位记录;AFP以ng/mL为单位记录;PIVKA-II以mAU/mL为单位记录。
提取后进行了范围检查、单位检查和不合理数值检查。对标记出的数值,需核对原始记录进行确认。仅当原始记录证实存在样本质量问题、单位换算错误或处理偏差时,该数值才予以剔除。经核实的极端值予以保留。变量字典定义了数据集结构、变量名称、单位、编码规则、转换规则以及缺失值代码。
预测因子定义与变量选择
在模型开发前即已确定候选预测因子。核心生物标志物为AFP和PIVKA-II。常规临床候选变量包括年龄、性别、丙氨酸氨基转移酶、天冬氨酸氨基转移酶、白蛋白、总胆红素、国际标准化比值(INR)或凝血酶原时间,以及血小板计数。AFP和PIVKA-II进行了自然对数转换。检测值低于检测下限时,在转换前以检测下限的一半数值替代。
在训练队列中,HCC 与非 HCC 参与者之间的单变量比较采用独立样本 t 检验分析近似正态分布的变量,采用 Mann-Whitney U 检验分析偏态连续变量,采用 χ² 检验或 Fisher 精确检验分析分类变量。单变量筛选中 P < 0.10 的变量被纳入多变量建模。采用方差膨胀因子(VIF)评估多重共线性,VIF >5 被视为存在显著共线性问题。当两个变量存在高度共线性时,保留临床可解释性更明确且对模型性能提升更优的变量。
最终的多变量逻辑回归模型仅在训练队列中建立。ln(AFP) 和 ln(PIVKA-II) 被强制纳入模型。其他预测变量通过基于赤池信息准则(Akaike information criterion)的向后剔除法进行筛选。经过向后选择后,保留的变量包括 ln(AFP)、ln(PIVKA-II)、年龄、性别、白蛋白、国际标准化比值(INR)以及血小板计数。
模型开发与风险评分计算
采用多变量逻辑回归拟合诊断模型,以肝细胞癌(HCC)状态作为二分类结局。HCC 的预测概率通过以下方程由线性预测值 η 计算得出:
p(HCC)=1/[1+exp(-η)]
η = -4.862+0.247×ln(AFP)+0.712×ln(PIVKA-II)+0.018×年龄+0.331×性别-0.062×白蛋白+0.554×INR-0.004×血小板计数
AFP 以 ng/mL 为单位测量,PIVKA-II 以 mAU/mL 为单位测量,年龄以年为单位,性别编码为女性 = 0、男性 = 1,白蛋白以 g/L 为单位测量,INR 为无量纲,血小板计数以 ×10⁹/L 表示。AFP 和 PIVKA-II 采用自然对数转换。列线图基于相同的拟合系数生成。在受试者工作特征(ROC)分析、校准分析、决策曲线分析及验证中,使用的是预测概率而非列线图评分尺度。
截断值定义与阈值处理
根据分析目的对PIVKA-II的阈值进行了标注。PIVKA-II既定的临床截断值为40.0 mAU/mL。训练队列中PIVKA-II的Youden指数截断值为45.0 mAU/mL。固定特异性截断值是通过在训练队列中选择最接近90%特异性的阈值得出的,PIVKA-II的该值为38.0 mAU/mL。仅在验证队列中观察到的37.5 mAU/mL截断值被视为探索性阈值,未用作主要的验证截断值。
对于联合模型,主要的二分类截断值通过Youden指数在训练队列中确定,并直接应用于验证队列而不作更改。AFP采用既定的临床截断值20.0 ng/mL来定义AFP阴性亚组,并用于与常规临床实践进行比较。在ROC分析中优化的AFP截断值则与临床阈值分别标注。因此,截断值根据其分析用途分别报告,而非视为可互换的阈值。
模型性能、校准与验证
采用受试者工作特征曲线及曲线下面积评估区分能力。AUC 以 95% 置信区间表示。AUC 比较采用 DeLong 检验。分类性能在预设的截断值下以灵敏度、特异度、阳性预测值、阴性预测值和准确率表示。
通过校准截距、校准斜率、Brier评分以及Hosmer-Lemeshow拟合优度检验来评估校准情况。校准图比较了不同风险组中预测的与观察到的肝细胞癌(HCC)发生概率。内部验证在训练队列中采用1,000次自助法重采样,以估计经乐观校正的AUC和经乐观校正的校准斜率。验证队列仅用于外部性能评估。在验证队列中未进行任何系数更新、模型重新拟合、阈值再优化或基于亚组的重新校准。
采用决策曲线分析法,在0.05至0.50的阈值概率范围内评估临床实用性。比较了单独使用甲胎蛋白(AFP)、单独使用异常凝血酶原(PIVKA-II)、临床变量模型以及联合模型的净获益。
缺失数据处理与敏感性分析
主要分析对最终模型中所有变量均有记录的参与者采用完整病例建模方法。对每个候选预测因子的缺失值进行了汇总。若任一保留预测因子的缺失比例超过5%,则以结局、所有保留的预测因子及队列指示变量作为插补模型的变量,采用链式方程多重插补法进行敏感性分析。缺失比例超过20%的变量不纳入多变量建模。将插补分析得到的模型系数、AUC、校准斜率及分类指标与完整病例分析结果进行比较。
软件与可重复性报告
所有分析均使用 R 4.3.2 版本和 RStudio 2023.12.1 版本完成。Logistic 回归分析采用基础 stats 包进行。ROC 分析及 DeLong 比较使用 pROC 1.18.5 版本完成。校准分析使用 rms 6.7-1 版本和 ResourceSelection 0.3-6 版本完成。Bootstrap 验证采用 1,000 次重采样,随机种子固定为 70558。决策曲线分析使用 rmda 1.6 版本完成。如需进行多重插补,则使用 mice 3.16.0 版本完成。分析脚本重现了研究对象流程、模型系数、ROC 曲线、校准指标、Bootstrap 验证、决策曲线分析、基于截断值的分析以及统计表格。
结果
基线特征
最终分析共纳入389名参与者。训练队列包括205名参与者,其中112名为影像学确诊的肝细胞癌(HCC)病例,93名为非HCC对照。验证队列包括184名参与者,其中58名为影像学确诊的HCC病例,126名为非HCC对照。基线特征总结于表1中。
在训练队列中,93例非肝细胞癌(HCC)对照包括30例健康对照和63例慢性肝病对照。在验证队列中,126例非HCC对照包括0例健康对照和126例慢性肝病对照。乙型肝炎病毒感染为主要的基础肝病。训练队列中,112例HCC病例中有57例为巴塞罗那临床肝癌分期(BCLC)0–A期;验证队列中,58例HCC病例中有30例为BCLC 0–A期。年龄、性别、肝病史、HCC家族史、肝硬化状态、Child-Pugh分级、丙氨酸氨基转移酶、天冬氨酸氨基转移酶、白蛋白、总胆红素、血小板计数、凝血酶原时间、国际标准化比值、糖尿病和高血压在表1报告的各队列分层中分布均衡。
在训练组中,肝细胞癌(HCC)病例的甲胎蛋白(AFP)中位数为57.3 ng/mL,非HCC对照组为22.4 ng/mL。异常凝血酶原(PIVKA-II)的中位数分别为197.6 mAU/mL和86.3 mAU/mL。在验证队列中,HCC病例的AFP中位数为60.2 ng/mL,非HCC对照组为21.5 ng/mL。PIVKA-II的中位数分别为191.5 mAU/mL和84.1 mAU/mL。
训练队列诊断性能
训练队列的区分度见图2(A),相应的敏感性-特异性比较见图2(B)。操作特征总结于表2。AFP在既定的20.0 ng/mL临床截断值下,AUC为0.78,敏感性为62.50%,特异性为78.49%。PIVKA-II在训练队列Youden截断值45.0 mAU/mL时,AUC为0.85,敏感性为78.57%,特异性为82.80%。临床变量模型在预测概率阈值0.40时,AUC为0.81,敏感性为69.64%,特异性为80.65%。联合模型在训练队列中具有最高的区分能力,在预测概率阈值0.50时,AUC为0.93,敏感性为88.39%,特异性为89.25%。
分期分层性能
不同BCLC分期的生物标志物分布见图3(A),检出率见图3(B),各分期特异性的AUC值见图3(C)。AFP、PIVKA-II及联合模型评分在BCLC 0–A、B和C期疾病中均呈递增趋势。AFP在早期肝细胞癌(HCC)与非HCC对照组之间存在重叠。PIVKA-II在不同分期分层中表现出更强的区分能力。联合模型在各分期分层中提供了最高的判别效能,包括BCLC 0–A期HCC。
甲胎蛋白与异常凝血酶原之间的互补性
标志物评分相关性见 图4(A)-(C),标志物交叉分类见图4(D)。AFP与PIVKA-II存在部分非重叠现象。同时观察到AFP阳性/PIVKA-II阴性以及AFP阴性/PIVKA-II阳性的肝细胞癌病例。联合模型将额外的单标志物阴性肝细胞癌病例分类为高风险,支持采用综合评分而非单独使用任一生物标志物。
外部验证
验证队列的ROC曲线见图5(A),校准曲线见图5(B),亚组敏感性-特异性模式见图5(C)。相应的验证指标汇总于表3。在所有验证的肝细胞癌病例中,AFP的AUC为0.75,在18.5 ng/mL时敏感性为62.1%、特异性为88.9%;PIVKA-II的AUC为0.78,在38.0 mAU/mL时敏感性为72.4%、特异性为91.3%;联合模型的AUC为0.89,在预测概率阈值为0.56时,敏感性为84.5%、特异性为90.5%、阳性预测值为78.8%、阴性预测值为94.1%。
在早期肝细胞癌中,AFP的敏感性为45.5%,特异性为88.9%;PIVKA-II的敏感性为59.1%,特异性为91.3%;联合模型的敏感性为72.7%,特异性为90.5%。在AFP阴性肝细胞癌中,AFP的敏感性为23.1%,PIVKA-II的敏感性为61.5%,联合模型的敏感性为73.1%。在病毒性肝细胞癌中,联合模型的敏感性为85.3%,特异性为91.3%。在非病毒性肝细胞癌中,联合模型的敏感性为83.3%,特异性为89.7%。验证队列的校准截距为-0.08,校准斜率为0.91,Brier评分为0.118,Hosmer–Lemeshow P 值为0.64。
多变量回归与内部验证
多变量回归分析结果见表4。在校正模型中,经对数转换的PIVKA-II仍是最强的独立预测因子,校正后比值比为2.05,95%置信区间(CI):1.48–2.89,P < 0.001。经对数转换的AFP也与肝细胞癌(HCC)独立相关,校正后比值比为1.28,95% CI:1.05–1.62,P = 0.021。国际标准化比值(international normalized ratio)仍具有独立预测价值,校正后比值比为1.74,95% CI:1.12–2.78,P = 0.015。最终的向后逐步回归模型保留了ln(AFP)、ln(PIVKA-II)、年龄、性别、白蛋白、国际标准化比值以及血小板计数。
自举法内部验证指标也在表4中进行了报告。训练集的表观AUC为0.93,平均乐观偏倚为0.018,经乐观偏倚校正后的AUC为0.91。表观校准斜率为1.00,经乐观偏倚校正后的校准斜率为0.94,训练队列的Brier评分为0.104,Hosmer–Lemeshow P 值为0.72。
截断值审核与特定阈值的性能
由于PIVKA-II的阈值因分析目的不同而有所差异,因此基于截断值的结果被分别报告,而非视为可互换。事后Youden指数优化截断值的性能见表5。AFP的Youden指数优化截断值为19.0 ng/mL,敏感性为67.9%,特异性为89.1%,阳性预测值为71.3%,阴性预测值为87.3%,准确率为81.2%,AUC为0.78。PIVKA-II的Youden指数优化截断值为37.5 mAU/mL,敏感性为75.4%,特异性为92.0%,阳性预测值为79.8%,阴性预测值为89.7%,准确率为85.9%,AUC为0.82。联合模型的Youden指数优化预测概率截断值为0.57,敏感性为86.2%,特异性为90.6%,阳性预测值为82.7%,阴性预测值为92.4%,准确率为89.8%,AUC为0.90。
使用既定临床界值的性能表现见表6。在既定的AFP界值20.0 ng/mL时,AFP的敏感性为65.2%,特异性为88.5%,阳性预测值为70.1%,阴性预测值为86.0%,准确率为80.3%,AUC为0.77。在既定的PIVKA-II界值40.0 mAU/mL时,PIVKA-II的敏感性为73.0%,特异性为93.1%,阳性预测值为81.8%,阴性预测值为89.0%,准确率为85.6%,AUC为0.82。在预测概率阈值为0.60时,联合模型的敏感性为83.5%,特异性为92.0%,阳性预测值为84.7%,阴性预测值为91.2%,准确率为88.9%,AUC为0.89。
在接近 90% 特异性的临界值下,性能表现如表 7所示。AFP 采用 19.0 ng/mL 的临界值,敏感性为 67.9%,特异性为 89.1%。PIVKA-II 采用 37.5 mAU/mL 的临界值,敏感性为 75.4%,特异性为 92.0%。联合模型采用预测概率临界值 0.57,敏感性为 86.2%,特异性为 90.6%。这些临界值验证结果解释了 PIVKA-II 不同阈值(37.5、38.0、40.0 和 45.0 mAU/mL)之间数值差异的原因:45.0 mAU/mL 是训练队列中用于主要训练比较的约登(Youden)临界值,38.0 mAU/mL 用于验证阶段固定特异性的报告,40.0 mAU/mL 是已建立的临床临界值,而 37.5 mAU/mL 是在临界值验证表中事后优化的约登最佳临界值。
疾病亚组分布
AFP、PIVKA-II 和联合模型评分在不同疾病亚组中的分布情况如图6(A)-(C)所示。AFP、PIVKA-II 和联合模型评分在慢性肝病对照组中最低,在肝细胞癌(HCC)组中较高。AFP 在慢性肝病对照组与早期 HCC 之间存在重叠。PIVKA-II 和联合模型评分在慢性肝病对照组、早期 HCC 以及所有分期 HCC 之间表现出更清晰的区分。
数据可用性:
支持本研究发现的数据集在 Figshare 上公开获取,网址为 https://doi.org/10.6084/m9.figshare.33048095.v1。
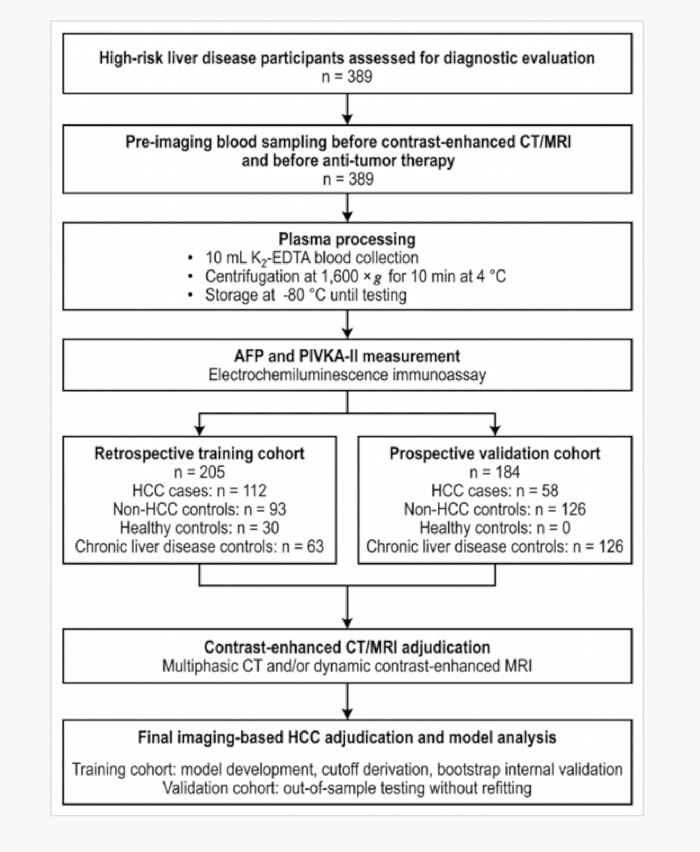
图 1:参与者流程、队列分配、样本处理及诊断判定。 流程图显示了训练队列和验证队列中参与者的筛选、队列分配、影像学检查前的血液采样、血浆处理、AFP/PIVKA-II 测定、增强 CT/MRI 评估以及基于影像学的肝细胞癌(HCC)最终判定过程。请点击此处查看该图的放大版本。
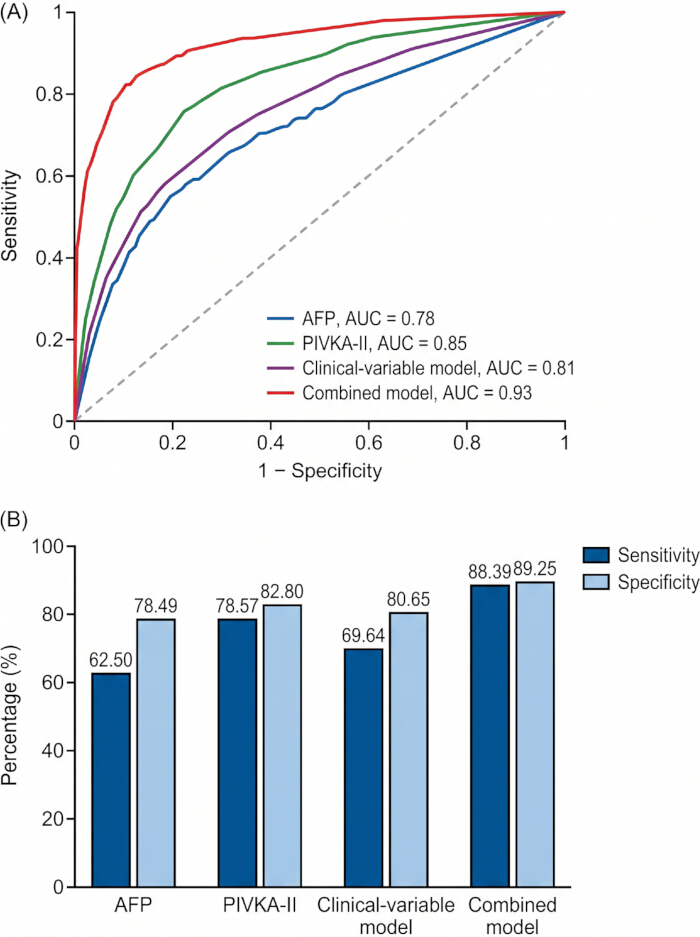
图2:AFP、PIVKA-II、临床变量模型及联合模型在训练队列中的诊断效能。(A)训练队列中AFP、PIVKA-II、临床变量模型与多变量联合模型的受试者工作特征曲线比较。(B)各诊断方法在训练队列报告阈值下的敏感性与特异性。请点击此处查看该图的放大版本。
相应的操作特性总结于 表2中。
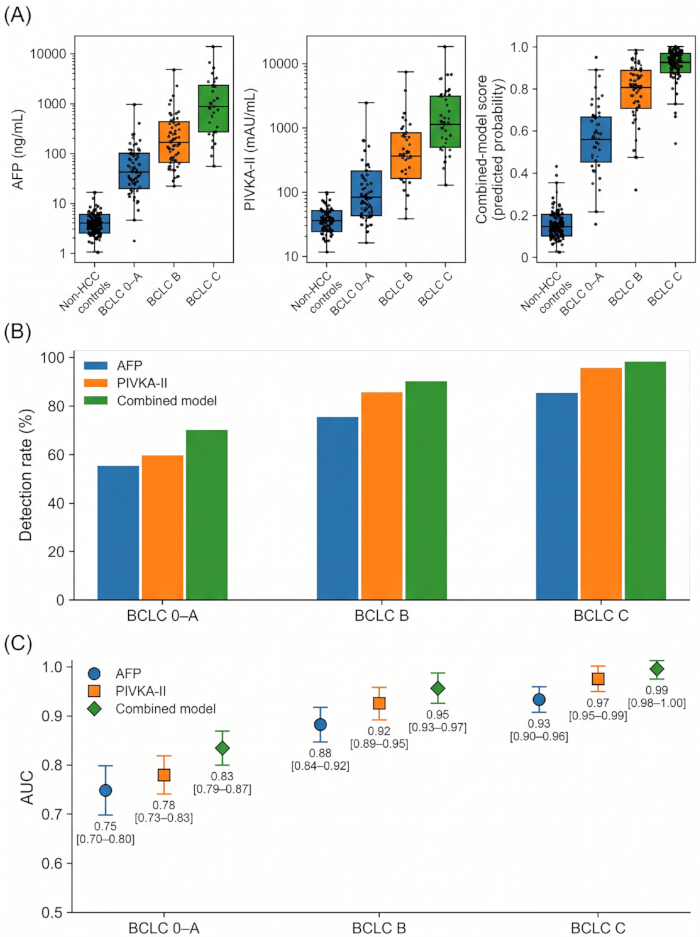
图3:按BCLC分期分层的诊断效能。(A)AFP、PIVKA-II及联合模型评分在非HCC对照组和BCLC分期组中的分布情况。(B)AFP、PIVKA-II及联合模型在各BCLC分期中的检出率。(C)AFP、PIVKA-II及联合模型在各分期中的特异性AUC,包括BCLC 0–A期HCC。请点击此处查看该图的放大版本。
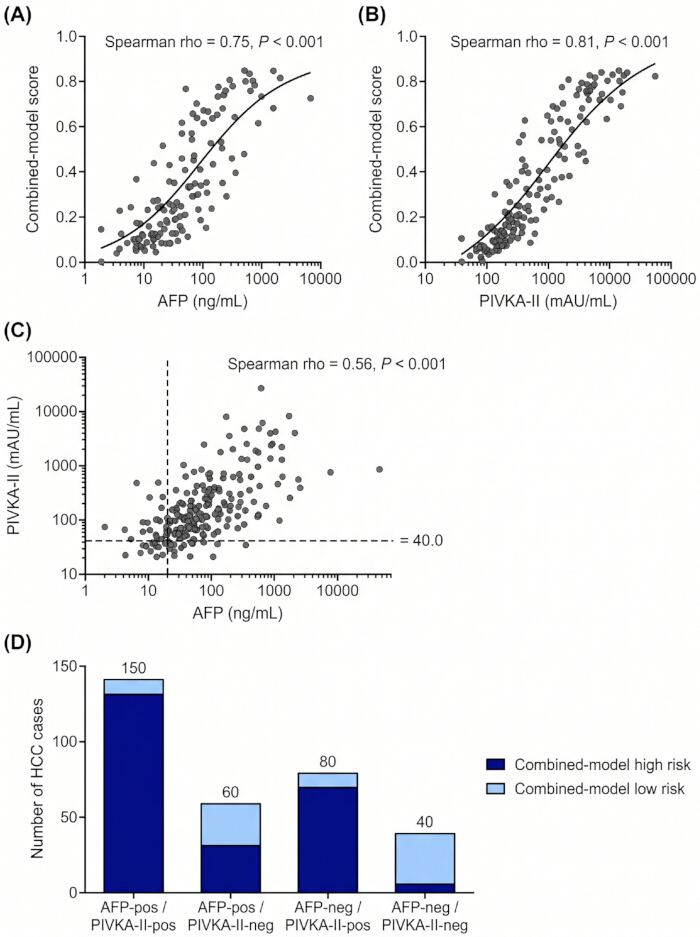
图4:AFP、PIVKA-II与联合模型评分之间的相关性及互补性。(A)AFP与联合模型评分之间的相关性。(B)PIVKA-II与联合模型评分之间的相关性。(C)AFP与PIVKA-II之间的相关性。(D)根据AFP状态、PIVKA-II状态及联合模型风险分类对HCC病例进行交叉分类。请点击此处查看该图的放大版本。
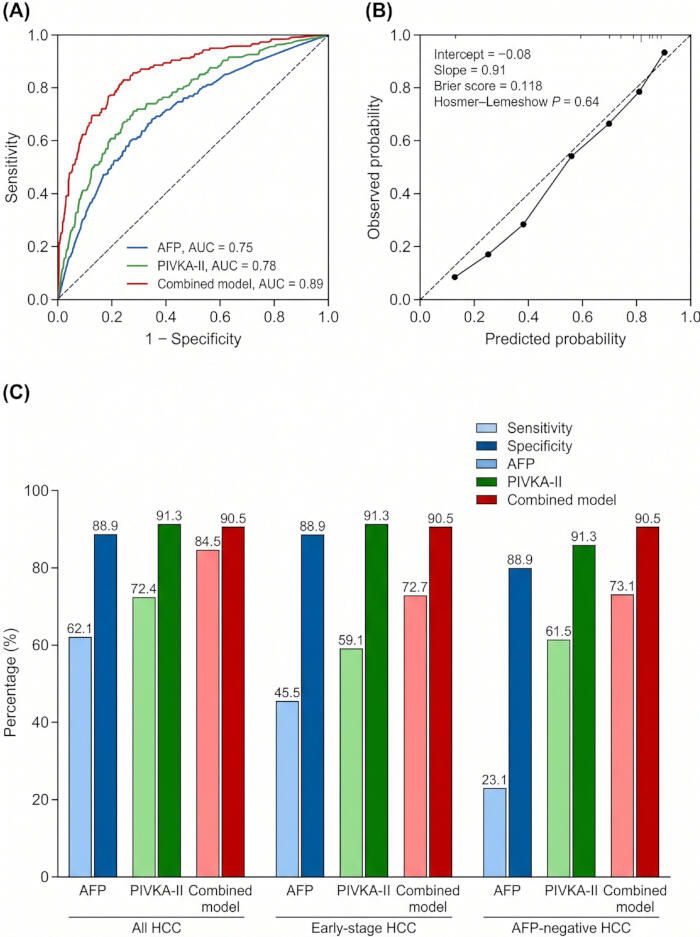
图5:在独立验证队列中对诊断性能进行外部验证。(A)验证队列中AFP、PIVKA-II及联合模型的受试者工作特征曲线。(B)联合模型在验证队列中的校准图。(C)AFP、PIVKA-II及联合模型在所有HCC、早期HCC和AFP阴性HCC中的敏感性和特异性比较。相应的验证指标汇总于表3中。请点击此处查看该图的放大版本。
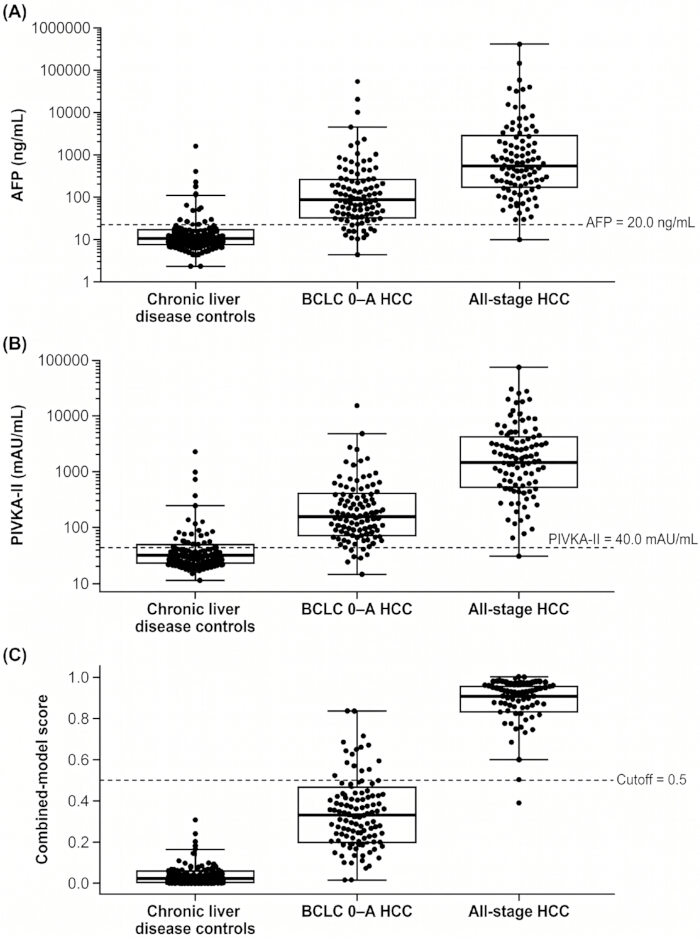
图6:AFP、PIVKA-II及联合模型评分在疾病亚组中的分布。(A)慢性肝病对照组、BCLC 0–A期HCC及全分期HCC中的AFP分布。(B)慢性肝病对照组、BCLC 0–A期HCC及全分期HCC中的PIVKA-II分布。(C)慢性肝病对照组、BCLC 0-A期HCC及全分期HCC中的联合模型评分分布。请点击此处查看该图的高清版本。
| 因素 | 类别 / 汇总 | 训练集 HCC n = 112 | 训练集非 HCC 对照组 n = 93 | 验证集 HCC n = 58 | 验证集非 HCC 对照组 n = 126 | P 值 |
| 性别,n (%) | 男性 | 76 (67.9%) | 59 (63.4%) | 39 (67.2%) | 76 (60.3%) | 0.374 |
| 女性 | 36 (32.1%) | 34 (36.6%) | 19 (32.8%) | 50 (39.7%) | — | |
| 年龄,年 | 均值 ± 标准差 | 58.9 ± 9.3 | 58.1 ± 10.4 | 59.4 ± 8.8 | 57.6 ± 9.7 | 0.281 |
| 肝病史,n (%) | HBV | 84 (75.0%) | 64 (68.8%) | 42 (72.4%) | 83 (65.9%) | 0.332 |
| HCV | 6 (5.4%) | 5 (5.4%) | 3 (5.2%) | 7 (5.6%) | 0.914 | |
| 酒精性肝病 | 13 (11.6%) | 10 (10.8%) | 6 (10.3%) | 12 (9.5%) | 0.825 | |
| HCC 家族史,n (%) | 是 | 9 (8.0%) | 7 (7.5%) | 4 (6.9%) | 8 (6.3%) | 0.887 |
| 肝硬化,n (%) | 是 | 80 (71.4%) | 61 (65.6%) | 42 (72.4%) | 88 (69.8%) | 0.468 |
| HCC 分期(BCLC),n (%) | 0–A | 57 (50.9%) | — | 30 (51.7%) | — | — |
| B | 33 (29.5%) | — | 17 (29.3%) | — | — | |
| C | 22 (19.6%) | — | 11 (19.0%) | — | — | |
| Child–Pugh 分级,n (%) | A | 85 (75.9%) | 77 (82.8%) | 43 (74.1%) | 101 (80.2%) | 0.341 |
| B | 27 (24.1%) | 16 (17.2%) | 15 (25.9%) | 25 (19.8%) | — | |
| ALT,U/L | 均值 ± 标准差 | 48.6 ± 22.1 | 47.1 ± 20.6 | 47.9 ± 22.4 | 45.2 ± 20.1 | 0.517 |
| AST,U/L | 均值 ± 标准差 | 60.3 ± 28.5 | 58.0 ± 27.8 | 58.7 ± 29.4 | 56.2 ± 26.9 | 0.488 |
| 白蛋白,g/L | 均值 ± 标准差 | 39.0 ± 4.7 | 39.5 ± 4.6 | 38.7 ± 5.1 | 39.6 ± 4.5 | 0.554 |
| 总胆红素,μmol/L | 均值 ± 标准差 | 20.1 ± 11.3 | 18.6 ± 10.8 | 20.4 ± 11.6 | 18.1 ± 10.9 | 0.321 |
| 血小板计数,×10⁹/L | 均值 ± 标准差 | 137 ± 61 | 146 ± 59 | 134 ± 60 | 149 ± 57 | 0.437 |
| 凝血酶原时间,s | 均值 ± 标准差 | 13.7 ± 1.4 | 13.5 ± 1.3 | 13.8 ± 1.5 | 13.5 ± 1.2 | 0.411 |
| INR | 均值 ± 标准差 | 1.18 ± 0.12 | 1.16 ± 0.11 | 1.19 ± 0.13 | 1.15 ± 0.10 | 0.334 |
| AFP,ng/mL | 中位数(四分位距) | 57.3 (19.8–135.1) | 22.4 (10.4–46.0) | 60.2 (20.6–131.7) | 21.5 (9.8–48.1) | 0.071 |
| PIVKA-II,mAU/mL | 中位数(四分位距) | 197.6 (83.1–438.2) | 86.3 (38.6–131.2) | 191.5 (81.4–422.5) | 84.1 (37.1–129.4) | 0.064 |
| 凝血酶原时间延长,n (%) | 是 | 30 (26.8%) | 20 (21.5%) | 15 (25.9%) | 24 (19.0%) | 0.372 |
| 糖尿病,n (%) | 是 | 19 (17.0%) | 14 (15.1%) | 10 (17.2%) | 19 (15.1%) | 0.764 |
| 高血压,n (%) | 是 | 33 (29.5%) | 26 (28.0%) | 18 (31.0%) | 36 (28.6%) | 0.824 |
| 非 HCC 对照组中的对照类型,n (%) | 健康对照 | — | 30 (32.3%) | — | 0 (0.0%) | — |
| 慢性肝病对照 | — | 63 (67.7%) | — | 126 (100.0%) | — | |
| 注:HCC,肝细胞癌;BCLC,巴塞罗那临床肝癌;ALT,丙氨酸氨基转移酶;AST,天冬氨酸氨基转移酶;INR,国际标准化比值;AFP,甲胎蛋白;PIVKA-II,维生素K缺乏诱导的蛋白-II;PT,凝血酶原时间;IQR,四分位距。P 值显示了在适用情况下各报告队列/状态分层之间的基线比较结果。HCC 分期仅针对 HCC 病例报告。对照类型仅针对非 HCC 对照组报告。 | ||||||
表1:训练队列和验证队列的基线特征。 按队列和肝细胞癌(HCC)状态列出人口统计学特征、肝病背景、HCC分期、Child-Pugh分级、常规实验室指标、甲胎蛋白(AFP)以及异常凝血酶原(PIVKA-II)。
| 方法 | 敏感性 (95% CI) | 特异性 (95% CI) | AUC (95% CI) | 阈值 |
| AFP | 62.50 (53.41–71.06) | 78.49 (69.07–86.04) | 0.78 (0.72–0.84) | 20.0 ng/mL |
| PIVKA-II | 78.57 (70.29–85.37) | 82.80 (73.95–89.61) | 0.85 (0.80–0.90) | 45.0 mAU/mL |
| 临床变量模型 | 69.64 (60.28–77.87) | 80.65 (71.13–88.04) | 0.81 (0.75–0.87) | 预测概率 = 0.40 |
| 联合模型 | 88.39 (81.35–93.36) | 89.25 (81.26–94.65) | 0.93 (0.89–0.96) | 预测概率 = 0.50 |
| 注:AFP 在既定的临床截断值 20.0 ng/mL 处进行评估。PIVKA-II 的阈值 45.0 mAU/mL 是用于主要训练比较的训练队列 Youden 截断值。临床变量模型和联合模型使用在训练队列中推导出的预测概率阈值进行评估。 | ||||
表2:训练队列的诊断性能。 显示了甲胎蛋白(AFP)、异常凝血酶原(PIVKA-II)、临床变量模型以及多变量联合模型在训练队列中的AUC、敏感性、特异性和报告的阈值。
| 亚组 | 项目 | AFP | PIVKA-II | 联合模型 |
| 所有HCC | AUC | 0.75 | 0.78 | 0.89 |
| 所有HCC | 主要验证阈值 | 18.5 ng/mL | 38.0 mAU/mL | Predicted probability = 0.56 |
| 所有HCC | 敏感性,%(95% CI) | 62.1 (48.7–74.2) | 72.4 (59.1–83.5) | 84.5 (72.6–92.6) |
| 所有HCC | 特异性,%(95% CI) | 88.9 (82.0–93.4) | 91.3 (85.1–95.3) | 90.5 (84.2–94.8) |
| 所有HCC | 阳性预测值,% | 63.8 | 72.7 | 78.8 |
| 所有HCC | 阴性预测值,% | 88.1 | 91 | 94.1 |
| 早期HCC | 探索性亚组阈值 | 15.2 ng/mL | 33.5 mAU/mL | Predicted probability = 0.51 |
| 早期HCC | 敏感性,%(95% CI) | 45.5 (25.1–67.3) | 59.1 (38.5–77.7) | 72.7 (52.0–87.6) |
| 早期HCC | 特异性,% | 88.9 | 91.3 | 90.5 |
| 早期HCC | 阳性预测值,% | 40 | 54.5 | 66.7 |
| 早期HCC | 阴性预测值,% | 90.1 | 87.5 | 92.3 |
| AFP阴性HCC | 探索性亚组阈值 | 7.5 ng/mL | 31.2 mAU/mL | Predicted probability = 0.48 |
| AFP阴性HCC | 敏感性,%(95% CI) | 23.1 (9.7–42.6) | 61.5 (40.6–79.8) | 73.1 (52.2–88.4) |
| AFP阴性HCC | 特异性,% | 88.9 | 91.3 | 90.5 |
| AFP阴性HCC | 阳性预测值,% | 22 | 52 | 64.5 |
| AFP阴性HCC | 阴性预测值,% | 90.2 | 88.3 | 92.7 |
| 病毒性HCC | 探索性亚组阈值 | 19.3 ng/mL | 40.7 mAU/mL | Predicted probability = 0.59 |
| 病毒性HCC | 敏感性,%(95% CI) | 64.7 (46.9–79.9) | 73.5 (56.4–86.4) | 85.3 (69.9–94.7) |
| 病毒性HCC | 特异性,% | 88.1 | 90.5 | 91.3 |
| 病毒性HCC | 阳性预测值,% | 67.3 | 73 | 81.3 |
| 病毒性HCC | 阴性预测值,% | 87.5 | 90.8 | 94.7 |
| 非病毒性HCC | 探索性亚组阈值 | 20.1 ng/mL | 34.5 mAU/mL | Predicted probability = 0.53 |
| 非病毒性HCC | 敏感性,%(95% CI) | 58.3 (36.6–77.9) | 70.8 (48.9–87.4) | 83.3 (62.6–95.3) |
| 非病毒性HCC | 特异性,% | 89.2 | 92.1 | 89.7 |
| 非病毒性HCC | 阳性预测值,% | 59.2 | 69.7 | 75 |
| 非病毒性HCC | 阴性预测值,% | 89 | 92 | 93.8 |
| 联合模型校准 | 截距 | — | — | −0.08 |
| 联合模型校准 | 斜率 | — | — | 0.91 |
| 联合模型校准 | Brier评分 | — | — | 0.118 |
| 联合模型校准 | Hosmer–Lemeshow P值 | — | — | 0.64 |
| 注:所有HCC行报告主要验证分析结果。早期HCC、AFP阴性HCC、病毒性HCC和非病毒性HCC行报告探索性亚组性能。亚组阈值用于描述各亚组内的表观工作点,未用于模型重新拟合或再校准。AFP阴性HCC定义为AFP <20.0 ng/mL。PPV,阳性预测值;NPV,阴性预测值。 | ||||
表3:验证队列诊断性能及亚组分析。 显示了AFP、PIVKA-II及联合模型在所有HCC、早期HCC、AFP阴性HCC、病毒性HCC和非病毒性HCC中的AUC、报告的阈值、敏感性、特异性、阳性预测值和阴性预测值。联合模型的校准指标也一并列出。
| 因素/指标 | 单变量 P 值 | 系数 β | 校正后 OR / 验证指标 | 95% 置信区间 | P 值 |
| 截距 | — | −4.862 | — | — | — |
| 年龄 | 0.112 | 0.018 | 1.02 | 0.99–1.05 | 0.186 |
| 性别,男性 | 0.087 | 0.331 | 1.41 | 0.83–2.37 | 0.204 |
| AFP,自然对数转换 | 0.004 | 0.247 | 1.28 | 1.05–1.62 | 0.021 |
| PIVKA-II,自然对数转换 | <0.001 | 0.712 | 2.05 | 1.48–2.89 | <0.001 |
| 白蛋白,g/L | 0.008 | −0.062 | 0.94 | 0.89–0.99 | 0.032 |
| 国际标准化比值(INR) | 0.012 | 0.554 | 1.74 | 1.12–2.78 | 0.015 |
| 血小板计数,×109/L | 0.052 | −0.004 | 0.99 | 0.98–1.00 | 0.044 |
| 训练集表观 AUC | — | — | 0.93 | 0.89–0.96 | — |
| 平均乐观度 | — | — | 0.018 | — | — |
| 乐观度校正后 AUC | — | — | 0.91 | 0.87–0.95 | — |
| 训练集表观校准斜率 | — | — | 1 | — | — |
| 乐观度校正后校准斜率 | — | — | 0.94 | — | — |
| 训练集 Brier 评分 | — | — | 0.104 | — | — |
| Hosmer–Lemeshow P 值 | — | — | 0.72 | — | — |
| 注:最终的线性预测式为 η = −4.862 + 0.247 × ln(AFP) + 0.712 × ln(PIVKA-II) + 0.018 × 年龄 + 0.331 × 性别 − 0.062 × 白蛋白 + 0.554 × INR − 0.004 × 血小板计数。预测概率计算公式为 p(HCC) = 1 / [1 + exp(−η)]。AFP 以 ng/mL 为单位;PIVKA-II 以 mAU/mL 为单位;年龄以年为单位;性别编码为女性 = 0,男性 = 1;白蛋白以 g/L 为单位;INR 为无量纲数值;血小板计数以 ×10⁹/L 为单位。 | |||||
表4:多变量逻辑回归及自助法内部验证。 显示了训练队列模型中评估变量的单变量P值、校正后的模型系数、校正后的比值比、95%置信区间和多变量P值。报告了自助法乐观性估计、校正后乐观性的AUC、校正后乐观性的校准斜率、Brier评分以及Hosmer–Lemeshow检验结果。
表5:使用约登指数优化截断值的诊断性能。 显示了甲胎蛋白(AFP)、异常凝血酶原(PIVKA-II)及联合模型在采用约登指数截断值时的灵敏度、特异度、阳性预测值、阴性预测值、准确率和曲线下面积(AUC)。
| 方法 | 既定临界值 | 敏感性,% (95% CI) | 特异性,% (95% CI) | 阳性预测值,% (95% CI) | 阴性预测值,% (95% CI) | 准确率,% (95% CI) | AUC (95% CI) |
| AFP | 20.0 ng/mL | 65.2 (57.0–72.7) | 88.5 (83.4–92.3) | 70.1 (61.8–77.4) | 86.0 (80.7–90.3) | 80.3 (75.0–84.8) | 0.77 (0.72–0.82) |
| PIVKA-II | 40.0 mAU/mL | 73.0 (65.2–79.8) | 93.1 (88.8–96.0) | 81.8 (74.2–87.7) | 89.0 (83.9–92.8) | 85.6 (80.9–89.5) | 0.82 (0.78–0.86) |
| 联合模型 | 预测概率 = 0.60 | 83.5 (76.6–89.0) | 92.0 (87.4–95.3) | 84.7 (77.9–90.0) | 91.2 (86.3–94.6) | 88.9 (84.6–92.2) | 0.89 (0.86–0.93) |
| 注:既定的临床临界值为 AFP 20.0 ng/mL 和 PIVKA-II 40.0 mAU/mL。联合模型的结果基于用于此临床临界值比较的相应预设概率阈值报告。 | |||||||
表6:使用既定临床截断值的诊断性能。 显示了使用既定AFP截断值20.0 ng/mL和既定PIVKA-II截断值40.0 mAU/mL时的敏感性、特异性、阳性预测值、阴性预测值、准确率和AUC。联合模型在用于此截断值比较的相应概率阈值下报告。
| 方法 | 最接近 90% 特异性的截断值 | 敏感性, % (95% CI) | 特异性, % (95% CI) | 阳性预测值, % (95% CI) | 阴性预测值, % (95% CI) |
| AFP | 19.0 ng/mL | 67.9 (59.1–75.7) | 89.1 (84.2–92.8) | 71.3 (62.4–79.0) | 87.3 (82.1–91.2) |
| PIVKA-II | 37.5 mAU/mL | 75.4 (67.3–82.2) | 92.0 (87.7–95.1) | 79.8 (71.6–86.3) | 89.7 (84.7–93.3) |
| 联合模型 | 预测概率 = 0.57 | 86.2 (79.3–91.3) | 90.6 (85.8–94.0) | 82.7 (74.8–88.7) | 92.4 (87.9–95.4) |
| 注:这些截断值的选择旨在截断值验证分析中实现最接近 90% 的特异性。对于 PIVKA-II,37.5 mAU/mL 是本验证分析中的 Youden 截断值及接近 90% 特异性的截断值,38.0 mAU/mL 是表 3 中报告的主要验证阈值,40.0 mAU/mL 是已确立的临床截断值,45.0 mAU/mL 是表 2 中使用的训练队列 Youden 截断值。 | |||||
表7:在特异性最接近90%的截断值下的诊断性能。 显示了AFP、PIVKA-II及联合模型在选定阈值下达到最接近90%特异性时的敏感性、特异性、阳性预测值和阴性预测值。
讨论
本研究评估了一种整合PIVKA-II、AFP及常规临床变量的肝细胞癌(HCC)综合诊断策略,重点关注早期阶段及AFP阴性疾病的诊断14。在训练队列和验证队列中,联合模型的表现均优于单一标志物检测。在训练队列中,联合模型的AUC为0.93,而AFP为0.78,PIVKA-II为0.85。在独立验证队列中,该模型仍保持较强的区分能力,AUC达0.89,敏感性为84.5%,特异性为90.5%。这些结果支持一种基于模型的方法,即联合解读互补的生物标志物与临床信号,而非依赖单一血清阈值进行诊断决策。
验证结果阐明了PIVKA-II的附加价值,尤其是在AFP可靠性最低的情况下。在所有验证的肝细胞癌(HCC)病例中,AFP的敏感性为62.1%,而在AFP阴性HCC中则下降至23.1%。PIVKA-II表现出更高的总体敏感性,在AFP阴性HCC中仍保持61.5%的敏感性。联合模型进一步将AFP阴性HCC的敏感性提高至73.1%,早期HCC的敏感性提高至72.7%,同时维持了高特异性。这一模式与既往证据一致,表明PIVKA-II所捕获的诊断信息部分独立于AFP,尤其在AFP水平较低的肿瘤和早期肿瘤负荷中更为显著15,16,17。相关性分析和交叉分类分析也支持这一解释,显示AFP与PIVKA-II并非可互换的标志物,且整合评分能够检出单标志物分类所遗漏的额外病例。
多变量分析结果表明,联合模型的优势不仅源于将AFP与PIVKA-II相加。临床变量提供了与年龄、性别、肝脏储备功能、凝血状态及血小板计数相关的额外信息。该设计与已建立的多变量肝细胞癌(HCC)风险模型一致,包括GALAD、GAAD及相关基于生物标志物的评分系统,这些模型均通过整合人口统计学和实验室变量,以提高在异质性肝病人群中的诊断效能18,19,20。在调整后的模型中,经对数转换的PIVKA-II仍是最强的独立预测因子,经对数转换的AFP保持独立关联性,而国际标准化比值(INR)提供了额外的诊断信号。调整后,转氨酶的信息量较低,提示一旦考虑了肿瘤相关及凝血相关标志物,非特异性肝炎症并非区分能力的主要驱动因素。
截断值分析解决了审稿过程中提出的一个重要问题。不同的PIVKA-II阈值不应被解读为相互矛盾的主要截断值。45.0 mAU/mL的值用于训练队列ROC比较,40.0 mAU/mL代表已确立的临床阈值,而37.5–38.0 mAU/mL范围则反映了基于约登指数优化或固定特异性分析的替代阈值策略。这些阈值回答了不同的临床问题:以敏感性为导向的截断值可能适用于高风险人群的监测,而以特异性为导向的截断值则在优先减少假阳性时更为可取。在这些策略中,联合模型的表现始终比单独使用AFP或PIVKA-II更为稳定,支持其作为风险分层工具的应用,而非取代基于影像学的诊断21。
仍存在若干局限性。训练队列来自单中心,前瞻性验证队列的规模中等。仍需开展多中心验证,尤其是在具有不同病因背景的人群中,包括与非酒精性脂肪性肝病(NAFLD)、酒精相关以及丙型肝炎病毒(HCV)相关的肝细胞癌(HCC)。HCC状态通过增强CT和/或MRI进行判定,这反映了常规诊断实践,但可能低估极早期或不典型病灶。部分亚组分析,特别是早期阶段和甲胎蛋白(AFP)阴性HCC,纳入的病例数少于总体队列。校准和自助法(bootstrap)分析有助于评估模型的稳定性,但无法替代前瞻性实施研究,后者用于检验基于模型的监测是否能够提高转诊效率、早期检出率以及后续临床结局22。
综上所述,与单一生物标志物策略相比,联合PIVKA-II、AFP及常规临床变量可提高肝细胞癌(HCC)的检出率,并在训练队列和独立验证队列中均表现出稳定的性能。该模型在早期HCC和AFP阴性HCC中保持了具有临床实用性的敏感性,同时维持了高特异性,弥补了基于AFP监测策略的两个常见盲区。由于所需输入变量均为常规可获取指标,该方法适用于在高危肝病人群中进一步验证。未来多中心研究应将该模型与超声联合AFP直接比较,评估预设的操作阈值,并探讨其与新兴生物标志物或影像学特征联合应用是否可进一步提升早期HCC的检出能力23,24。
披露
作者声明不存在任何竞争性财务或非财务利益。在研究设计、数据收集、统计分析、结果解释、论文撰写以及决定提交论文发表的过程中,没有任何商业资助方、试剂生产商、软件供应商或诊断平台公司参与其中。
致谢
作者感谢参与本研究的受试者以及支持血液采集、临床协调、影像学审查和数据验证工作的临床工作人员。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| 1.5 mL 无核酸酶离心管 | Eppendorf | 30123328 | 血浆分装与储存 |
| AFP校准品 | Roche Diagnostics | AFP CalSet II, 09227261190 | AFP校准 |
| AFP质控品 | Roche Diagnostics | PreciControl Tumor Marker, 11776452160 | AFP质量控制 |
| AFP质控品 | Roche Diagnostics | PreciControl Universal, 11731416160 | AFP质量控制 |
| AFP试剂盒 | Roche Diagnostics | Elecsys AFP, 09015124190 | AFP检测 |
| 全自动电化学发光免疫分析仪 | Roche Diagnostics | cobas e 801 | AFP与PIVKA-II检测 |
| 校准分析软件包 | R package | rms 6.7–1 | 校准分析 |
| 决策曲线分析软件包 | R package | rmda 1.6 | 决策曲线分析 |
| Hosmer–Lemeshow检验软件包 | R package | ResourceSelection 0.3–6 | Hosmer–Lemeshow检验 |
| K2-EDTA采血管,10 mL | BD | 367525 | 外周静脉采血 |
| 多重插补软件包 | R package | mice 3.16.0 | 多重插补 |
| PIVKA-II试剂盒 | Roche Diagnostics | Elecsys PIVKA-II, 08333629190/08333629500 | PIVKA-II检测 |
| 冷冻离心机 | Eppendorf | Centrifuge 5425 R | 血浆分离 |
| ROC分析软件包 | R package | pROC 1.18.5 | ROC分析与DeLong检验 |
| 统计分析软件 | R Foundation | R 4.3.2 | 统计分析 |
| 统计分析软件界面 | Posit Software | RStudio 2023.12.1 | 统计分析 |
参考文献
- Oh JH, Jun DW. The latest global burden of liver cancer: A past and present threat. Clin Mol Hepatol. 2023;29(2):355-357.
- Heimbach JK et al. AASLD guidelines for the treatment of hepatocellular carcinoma. Hepatology. 2018;67(1):358-380.
- Singal AG et al. Meta-analysis: Surveillance with ultrasound for early-stage hepatocellular carcinoma in patients with cirrhosis. Aliment Pharmacol Ther. 2009;30(1):37-47.
- Tzartzeva K et al. Surveillance imaging and alpha fetoprotein for early detection of hepatocellular carcinoma in patients with cirrhosis: A meta-analysis. Gastroenterology. 2018;154(6):1706-1718.e1.
- Parikh ND et al. Biomarkers for the early detection of hepatocellular carcinoma. Cancer Epidemiol Biomarkers Prev. 2020;29(12):2495-2503.
- Gopal P et al. Factors that affect accuracy of alpha-fetoprotein test in detection of hepatocellular carcinoma in patients with cirrhosis. Clin Gastroenterol Hepatol. 2014;12(5):870-877.
- Hanif H et al. Update on the applications and limitations of alpha-fetoprotein for hepatocellular carcinoma. World J Gastroenterol. 2022;28(2):216-229.
- Norman JS, Mehta N. The role of AFP-L3 and DCP biomarkers in the diagnosis and management of hepatocellular carcinoma. Curr Hepatol Rep. 2025;24(1):16.
- Suttichaimongkol T et al. PIVKA-II or AFP has better diagnostic properties for hepatocellular carcinoma diagnosis in high-risk patients. J Circ Biomark. 2023;12:12-16.
- Piratvisuth T et al. Development and clinical validation of a novel algorithmic score (GAAD) for detecting HCC in prospective cohort studies. Hepatol Commun. 2023;7(11):e0317.
- Jarrah M et al. Performance of GALAD, GAAD, and ASAP for early HCC detection in chronic liver disease: A systematic review and meta-analysis. Liver Cancer. 2026;15(2):285-299.
- Zhou JM, Wang T, Zhang KH. AFP-L3 for the diagnosis of early hepatocellular carcinoma: A meta-analysis. Medicine (Baltimore). 2021;100(43):e27673.
- Singal AG et al. AASLD practice guidance on prevention, diagnosis, and treatment of hepatocellular carcinoma. Hepatology. 2023;78(6):1922-1965.
- Best J et al. The GALAD scoring algorithm based on AFP, AFP-L3, and DCP significantly improves detection of BCLC early-stage hepatocellular carcinoma. Z Gastroenterol. 2016;54(12):1296-1305.
- Poté N et al. Performance of PIVKA-II for early hepatocellular carcinoma diagnosis and prediction of microvascular invasion. J Hepatol. 2015;62(4):848-854.
- Xu F et al. The diagnostic value of serum PIVKA-II alone or in combination with AFP in Chinese hepatocellular carcinoma patients. Dis Markers. 2021;2021:8868370.
- Liu M et al. Validation of the GALAD model and establishment of GAAP model for diagnosis of hepatocellular carcinoma in Chinese patients. J Hepatocell Carcinoma. 2020;7:219-232.
- Aralica M et al. GALAD, or des-gamma-carboxy prothrombin compared with alpha-foetoprotein for the diagnosis of hepatocellular carcinoma in people with chronic liver disease. Cochrane Database Syst Rev. 2024;12(12):CD015826.
- Zhang S et al. Evaluating the combined diagnostic power of alpha-fetoprotein and protein induced by vitamin K absence or antagonist-II for hepatocellular carcinoma. J Gastrointest Oncol. 2025;16(3):1157-1175.
- Pham TTT, Ho DT, Nguyen TB, Phan HT. Clinical performance of GAAD score, alpha-fetoprotein, and PIVKA-II in diagnosing hepatocellular carcinoma in the Vietnamese cohort. Discov Oncol. 2025;16:1813.
- Youden WJ. Index for rating diagnostic tests. Cancer. 1950;3(1):32-35.
- Tarao K et al. Real impact of tumor marker AFP and PIVKA-II in detecting very small hepatocellular carcinoma (≤2 cm, Barcelona stage 0): Assessment with a large number of cases. World J Hepatol. 2020;12(11):1046-1054.
- Kim DY et al. Utility of combining PIVKA-II and AFP in the surveillance and monitoring of hepatocellular carcinoma in the Asia-Pacific region. Clin Mol Hepatol. 2023;29(2):277-292.
- Kao SYZ et al. Cost-effectiveness of a precision hepatocellular carcinoma surveillance strategy in patients with cirrhosis. EClinicalMedicine. 2024;75:102755.