实验性脑型疟疾(ECM)可导致神经炎症和血脑屏障功能障碍。本研究利用GSE162535数据集,建立了一套可重复的基于R语言的RNA-seq分析流程,比较对照组(CB)、ECM组(MB)和青蒿琥酯治疗组(AB)脑组织样本,进行质量控制(QC)、主成分分析(PCA)和DESeq2分析。该流程可识别由ECM驱动的转录变化,并评估青蒿琥酯对炎症及神经血管通路的调节作用。
需要JoVE订阅才能观看此内容。 请登录或开始免费试用
方法文章
利用DESeq2量化实验性脑型疟疾脑组织中与青蒿琥酯相关的转录组变化的计算流程
* These authors contributed equally
本文内容
摘要
摘要
RNA测序(RNA-seq)被广泛用于定义与疾病相关的转录程序,但为了确保在不同实验组之间进行可重复的比较,并获得具有生物学可解释性的结果,需要建立一致且端到端的工作流程。本文介绍了一套完整的RNA-seq分析方案,用于评估实验性脑型疟疾(ECM)及经青蒿琥酯治疗后的小鼠脑组织转录组变化,所用数据来自公共数据集GSE162535。该工作流程分析三个组别:对照组脑组织(CB)、ECM脑组织(MB)和青蒿琥酯治疗后的ECM脑组织(AB),起始数据为HTSeq-count矩阵。在导入并格式化原始计数数据后,本方案以CB作为参考基准构建DESeq2数据集,过滤低计数基因,并通过文库大小可视化、主成分分析和样本距离聚类进行质量控制。随后计算三个主要对比组间的差异表达(MB vs CB、AB vs MB、AB vs CB),并对log2倍数变化进行收缩处理,以实现稳定的效应量估计。方案导出完整的及具有显著性的差异表达基因表格,生成火山图和MA图,并绘制各对比组中变异最大基因及排名靠前的差异表达基因的热图。为支持机制层面的解读,该流程还包括特异性免疫标志物的提取(如细胞因子、趋化因子、小胶质细胞活化标志物、血脑屏障/内皮细胞相关基因),并对显著上调和下调的基因集进行基因本体(Gene Ontology)和KEGG通路富集分析。本方案为刻画ECM相关的神经炎症转录程序以及量化青蒿琥酯对这些特征的调控作用提供了可重复的分析模板。
引言
脑型疟疾(CM)是Plasmodium falciparum感染引起的一种危及生命的神经系统并发症,尽管病例管理已取得进展,但它仍是导致疟疾死亡的主要原因。CM的特征包括急性脑病、微血管功能障碍、内皮细胞活化以及血脑屏障(BBB)破坏,并继发神经炎症,可导致昏迷,且在幸存者中常遗留持续性神经认知后遗症1。CM的发病机制是多因素的,涉及宿主炎症反应与寄生虫源性和宿主源性因子在神经血管界面的相互作用,因此仅从临床终点推断其因果机制十分困难1。
实验性脑型疟疾(ECM)模型,特别是 疟原虫伯氏株 在受控条件下,C57BL/6小鼠感染ANKA为研究脑部特异性免疫病理、血脑屏障损伤及神经炎症信号通路提供了一个可操作的平台2,3这些模型已被用于绘制疾病不同阶段的细胞和分子反应图谱,并用于测试辅助干预措施。 体内2,3然而,细胞外基质的病理生物学过程复杂且高度动态,靶向检测可能遗漏在多个免疫和神经血管程序中发生的协调性通路水平变化。
青蒿琥酯是治疗重症疟疾推荐的一线肠外给药疗法,在多个关键证据基础上已显示出相比奎宁显著的生存获益4。尽管快速清除寄生虫是青蒿琥酯疗效的核心,但神经功能结局可能同时反映了寄生虫负荷的降低以及对炎症和神经血管通路的继发性调节1,4。因此,了解青蒿素类药物治疗在实验性脑型疟(ECM)期间如何重塑大脑转录程序,可为临床疗效数据提供机制层面的补充见解,并可能识别出具有潜力的通路,用于辅助性神经保护策略的开发。
RNA测序(RNA-seq)能够无偏倚地对疾病和治疗状态下的全基因组转录响应进行分析,支持差异表达分析及后续的功能解释。公共数据库(如美国国家生物技术信息中心基因表达综合数据库NCBI Gene Expression Omnibus,GEO)提供了经过整理的数据集,适用于可重复的再分析,其中包括编号为GSE162535的数据集,该数据集包含来自对照组脑组织(CB)、脑型疟疾脑组织(MB)以及青蒿琥酯治疗后脑型疟疾脑组织(AB)的脑RNA-seq数据5。为了支持从此类数据集中实现可重复的科学发现,需要采用稳健的统计框架进行基于计数的差异表达分析,同时需要富集分析工具,以从生物通路和生物过程的角度解释基因水平的变化。
本研究提供了一种可重复的、端到端的RNA测序分析流程,适用于对照组(CB)、实验性脑疟(MB)和青蒿琥酯治疗组(AB)的脑组织样本。本文的创新之处在于采用标准化的基于DESeq2的分析流程,整合了预定义的生物学相关对比(MB vs CB、AB vs MB 和 AB vs CB)、严格的质控输出(文库大小评估、主成分分析和样本距离热图),并通过clusterProfiler6,7进行基因本体(GO)和KEGG通路富集分析,实现整合的下游功能解读。此外,该流程引入基于结构化免疫基因面板的解读方法,可系统性地表征神经炎症、免疫及神经血管相关的转录响应。通过结合统计严谨性、流程透明性以及适合发表的图表输出,本方案为分析脑疟相关转录组失调及评估临床前疟疾研究中治疗干预引起的转录变化提供了稳健且可复用的分析框架。
访问受限。请登录或开始试用以查看此内容。
方案
本研究使用了公开可用的RNA-seq数据,未涉及任何新的人类或动物实验。因此,无需伦理审批和知情同意(材料表)。
1. 准备计算环境和文件夹结构
- 设置硬件和操作系统
- 使用至少配备 8 GB 内存(建议 16 GB)且拥有 ≥10 GB 可用磁盘空间的工作站或笔记本电脑,用于下载文件和存储输出结果。
- 使用 Windows、macOS 或 Linux 系统,并确保具有安装 R 软件包和向工作目录写入文件的权限。
- 安装所需软件
- 安装 R(版本 4.2 或更高版本)。建议安装 RStudio Desktop,以便交互式运行工作流程并管理项目目录。
- 创建项目目录和输出文件夹
- 为分析创建一个新文件夹(例如 GSE162535_RNAseq_DESeq2)。将该文件夹设置为 R 的工作目录。
- 按以下方式准确创建输出文件夹:
- 创建 results/ 文件夹。在其中创建 results/fig/ 和 results/tables/ 子文件夹。
- 安装所需的 R 软件包
- 安装 CRAN 软件包:tidyverse、pheatmap 和 RColorBrewer。安装 Bioconductor 软件包:DESeq2、apeglm(可选)、clusterProfiler 和 org.Mm.eg.db。
- 在脚本开头加载所需软件包:DESeq2、tidyverse、pheatmap、RColorBrewer、clusterProfiler、org.Mm.eg.db 和 ggplot2。通过运行 set.seed(123) 设置随机种子以确保结果可重复。
- 实施数据完整性与隐私保护措施
- 仅在项目目录中存储下载的文件。如果环境中包含敏感数据或受 embargo 限制的数据,应限制对项目目录的访问权限。在工作流程结束时,通过将 sessionInfo() 导出至 results/sessionInfo.txt 文件来记录所使用的软件版本。
注意:本方案对公共 RNA-seq 计数数据进行计算机模拟分析,不涉及生物样本的处理。
- 仅在项目目录中存储下载的文件。如果环境中包含敏感数据或受 embargo 限制的数据,应限制对项目目录的访问权限。在工作流程结束时,通过将 sessionInfo() 导出至 results/sessionInfo.txt 文件来记录所使用的软件版本。
2. 获取RNA-seq计数矩阵并定义实验组
- 下载 GSE162535 的 GEO 数据集文件
- 从 GEO 下载 GSE162535 的 HTSeq 计数文件,并将其保存在项目目录中,命名为 GSE162535_All.HTSeq.counts.txt.gz。使用 gzfile() 和 read.delim() 确认文件能够无错误打开,以验证文件完整性。
- 将 HTSeq 计数数据加载到 R 中
- 使用 read.delim(gzfile(...), header = TRUE, check.names = FALSE, quote = "", comment.char = "") 导入压缩的计数表。使用 str()、head() 和 colnames() 检查导入的对象,以确认:
- 第一列包含基因标识符(例如 AccID),其余列包含样本水平的计数数据。
- 使用 read.delim(gzfile(...), header = TRUE, check.names = FALSE, quote = "", comment.char = "") 导入压缩的计数表。使用 str()、head() 和 colnames() 检查导入的对象,以确认:
- 标准化数据类型并处理重复的基因标识符
- 将样本列定义为除基因标识符列(AccID)外的所有列。将所有样本列强制转换为整数计数。对具有相同 AccID 的行进行合并,通过求和处理重复的基因标识符。
- 将合并后的表格转换为标准的数据框。将行名设置为基因标识符,并从计数矩阵中移除该标识符列。
- 验证计数矩阵结构
- 确认计数矩阵包含 12 个样本列。确认样本列名的格式为 AB_1..AB_4、CB_1..CB_4 和 MB_1..MB_4。
- 如果计数矩阵的列数不等于 12,则停止执行。
- 创建并验证样本元数据
- 创建一个样本元数据表(colData),包含以下列:
- sample:与计数矩阵列名相对应的唯一样本标识符。group:为每个样本分配的生物学条件。
- 从基因表达综合数据库(GEO)获取数据集 GSE162535 对应的样本注释信息。
- 利用 GEO 登录号信息和描述实验条件的样本注释字段,验证每个样本的身份。将计数矩阵中的每个样本标识符与其经验证的 GEO 注释进行匹配。
- 将每个经验证的样本分配至以下组别之一:对照脑组织(CB)、实验性脑型疟疾脑组织(MB)或青蒿琥酯治疗的实验性脑型疟疾脑组织(AB)。
- 调整元数据表的顺序,使其样本顺序与计数矩阵的列顺序一致。
- 将元数据表中的样本标识符与计数矩阵中的标识符进行比对,确认一一对应关系。将 group 变量编码为因子,其水平顺序为 CB、MB 和 AB。
- 将 CB 设为参考水平,以定义对照脑组织组作为下游差异表达分析的基线。
- 将元数据表的行名设置为样本标识符。
注意:组标签并非仅根据计数矩阵中样本的排列顺序进行分配。在与表达矩阵对齐之前,已使用 GEO 元数据和登录号信息独立验证了样本身份,以提高可重复性并降低样本误分类的风险。
- 创建一个样本元数据表(colData),包含以下列:
3. 构建 DESeq2 数据集并进行基本的质量控制
- 对计数矩阵进行清理
- 将计数矩阵中的缺失值替换为零。使用列方向的 is.na() 汇总结果确认缺失值的缺失。
- 创建 DESeq2 数据集
- 使用 DESeqDataSetFromMatrix() 创建 DESeqDataSet,参数设置如下:countData = counts;colData = sample_info;design = ~ group。
- 过滤低计数基因
- 移除在所有样本中总计数 <10 的基因,使用命令 dds <- dds[rowSums(counts(dds)) >= 10, ]。通过打印对象摘要记录保留的基因数量。
- 评估文库大小
- 将过滤后的计数矩阵的列总和计算为文库大小。生成文库大小的柱状图,并将其保存为 results/fig/library_sizes.pdf。
- 检查文库大小图,确认没有任何样本的测序深度极端,与研究设计不一致。
4. 运行 DESeq2 并生成用于可视化的转换对象
- 拟合 DESeq2 模型
- 使用 dds <- DESeq(dds) 运行差异表达建模。保留拟合后的 DDS 对象,用于后续所有结果的提取。
- 创建转换后的表达矩阵
- 使用 rld <- rlog(dds, blind = FALSE) 计算标准化对数转换。使用 vsd <- vst(dds, blind = FALSE) 计算方差稳定转换。将 rld 和 vsd 用于主成分分析(PCA)、聚类分析和热图绘制。
注意:使用 blind = FALSE 以保留依赖于分组的方差结构。
- 使用 rld <- rlog(dds, blind = FALSE) 计算标准化对数转换。使用 vsd <- vst(dds, blind = FALSE) 计算方差稳定转换。将 rld 和 vsd 用于主成分分析(PCA)、聚类分析和热图绘制。
5. 使用主成分分析(PCA)和样本间距离聚类进行全局质量控制
- 生成主成分分析(PCA)
- 使用 plotPCA(rld, intgroup = "group", returnData = TRUE) 计算 PCA。提取 PC1 和 PC2 解释的方差百分比。使用 ggplot2 绘制 PC1 与 PC2 的散点图,以样本名称标注各点,并按分组着色。
- 将 PCA 图保存为 results/fig/PCA_samples.pdf。确认生物学重复样本按分组聚集,且无样本作为离群值分离。
- 生成样本距离热图
- 使用 dist(t(assay(vsd))) 计算样本间的成对距离。将距离对象转换为矩阵以进行可视化。创建一个列注释表,包含每个样本的分组因子。
- 使用 pheatmap() 绘制距离矩阵,并保存为 results/fig/sample_distance_heatmap.pdf。确认样本主要按分组聚类。
6. 计算三个主要对比的差异表达
- 定义对比组
- 将疾病效应定义为 ECM 与对照组:MB 与 CB;将 ECM 内的治疗效应定义为青蒿琥酯处理组与 ECM 组:AB 与 MB;将治疗组与基线对照定义为青蒿琥酯处理组与对照组:AB 与 CB。
- 提取 DESeq2 结果并进行 log2 倍数变化收缩
- 使用 results(dds, contrast = c("group", groupA, groupB)) 提取每个对比组的原始结果。使用 lfcShrink(dds, contrast = c("group", groupA, groupB), res = res, type = "normal") 对 log2 倍数变化进行收缩。
- 将结果转换为数据框,并将基因标识符作为名为 gene_id 的列存储。按名义 p 值对结果排序,以确保报告的稳定性。
- 将每个完整的结果表保存至 results/tables/,文件名为:
- DESeq2_MB_vs_CB_all_genes.csv、DESeq2_AB_vs_MB_all_genes.csv、DESeq2_AB_vs_CB_all_genes.csv
注意:如果由于软件包配置导致收缩失败,请改用本地安装支持的其他收缩类型重新运行。
- DESeq2_MB_vs_CB_all_genes.csv、DESeq2_AB_vs_MB_all_genes.csv、DESeq2_AB_vs_CB_all_genes.csv
- 定义显著性阈值并导出显著基因集
- 使用以下标准定义差异表达基因(DEGs):校正后 p 值(FDR)< 0.05,且绝对 log2 倍数变化 ≥ 1。对每个对比组进行筛选,排除校正后 p 值缺失的基因。
- 将显著差异表达基因表导出至:results/tables/DESeq2_MB_vs_CB_sig.csv、results/tables/DESeq2_AB_vs_MB_sig.csv、results/tables/DESeq2_AB_vs_CB_sig.csv
- 汇总每个对比组的差异表达基因数量
- 计算每个对比组中显著基因的数量。将汇总表保存为 results/tables/DE_summary_counts.csv。
7. 为每个对比组生成火山图。
- 创建火山图函数。
- 对每个基因计算 -log10(校正后 p 值)。使用以下阈值将每个基因分类为上调、下调或无显著性:FDR < 0.05 且 |log2FC| ≥ 1。
- 使用 ggplot2 绘制 log2FC(x 轴)与 -log10(FDR)(y 轴)的关系图。在 log2FC = ±1 和 -log10(0.05) 处添加虚线阈值线。
- 导出火山图
- 将每个图以 PDF 格式保存至 results/fig/ 目录下:volcano_MB_vs_CB.pdf、volcano_AB_vs_MB.pdf、volcano_AB_vs_CB.pdf。
注意:在不同比较组之间使用一致的坐标轴范围,以便于图形间的视觉比较。
- 将每个图以 PDF 格式保存至 results/fig/ 目录下:volcano_MB_vs_CB.pdf、volcano_AB_vs_MB.pdf、volcano_AB_vs_CB.pdf。
8. 为每个对比生成 MA 图
- 将MA图导出为单个PDF文件。
- 打开一个名为 results/fig/MA_plots.pdf 的PDF设备。使用 plotMA() 函数为每个原始 DESeq2 结果对象绘制MA图,并使用对比名称标记每个图。关闭PDF设备。
9. 生成用于展示全局变异性和特定对比差异表达基因的表达热图。
- 绘制所有样本中变异最大的基因。
- 基于 vsd 检测矩阵计算每个基因在各样本间的行方差,筛选变异最大的前 100 个基因,并对每个基因在所有样本中进行均值中心化。
- 使用 pheatmap() 函数生成热图,并添加样本分组注释。将图像保存为 results/fig/heatmap_top100_variable_genes.pdf。
- 绘制每个对比组中差异表达最显著的基因。
- 对每个对比组,根据校正后的 p 值筛选前 50 个差异表达最显著的基因,提取其 VSD 表达矩阵,并对每个基因进行均值中心化。为每个对比组生成热图,并保存为:
- results/fig/heatmap_top50_MB_vs_CB.pdf, results/fig/heatmap_top50_AB_vs_MB.pdf, results/fig/heatmap_top50_AB_vs_CB.pdf
注意:若启用行标签,请增加 PDF 的宽度和高度。
10. 进行靶向免疫标志物分析。
- 汇总各比较组中选定的免疫相关基因。
- 定义一组免疫标志物基因:Il6, Il1b, Il10, Tnf, Ifng, Il21, 和 Icam1。从每个比较组的结果表格中提取这些基因的 log2FC、p 值和校正后的 p 值。
- 按基因标识符合并三个比较组的汇总结果。将合并后的表格保存为 results/tables/immune_genes_summary.csv。
- 生成免疫标志物热图(rlog)。
- 在转换后的检测矩阵中识别存在的免疫基因。提取这些存在免疫基因的 rlog 表达矩阵。
- 按基因进行均值中心化处理。生成热图并保存至 results/fig/heatmap_immune_genes.pdf。
11. 按功能类别进行扩展免疫组分析
- 定义免疫面板。
- 按类别定义免疫标志物面板,包括:促炎性细胞因子和干扰素应答基因、抗炎和调节性基因、趋化因子、小胶质细胞活化标志物、星形胶质细胞标志物、血脑屏障和内皮细胞活化标志物、T细胞标志物和耗竭标志物、单核细胞/巨噬细胞标志物、补体通路基因,以及氧化应激和细胞死亡相关基因。
- 提取每个比较组的免疫面板差异表达结果。
- 建立从基因符号到免疫类别的映射表。对每个比较组的结果表筛选出免疫面板基因,并将类别映射信息合并至各筛选后的结果表中。
- 将三个特定比较组的免疫表格合并为一个总表。将合并后的表格保存为 results/tables/immune_panels_DE_all_contrasts.csv。生成分类的免疫面板表达热图。
- 确定 rld 检测矩阵中存在的免疫面板基因。在行名中附加类别标签,以在图中保留面板分类信息。绘制带有样本分组注释的 rlog 热图。
- 保存输出结果。
- 保存为:results/fig/heatmap_immune_panels_all.pdf, results/fig/heatmap_immune_panels_all.png
12. 生成免疫叠加火山图
- 创建免疫叠加火山图。
- 通过将免疫基因面板注释与每个对比结果表进行关联,标记基因为免疫相关或非免疫相关。将所有非免疫相关基因以灰色背景点形式绘制,免疫相关基因则按免疫功能类别着色并置于前景。在 log2FC = ±1 和 -log10(0.05) 处添加阈值线。
- 导出免疫叠加火山图。
- 将 MB 与 CB 的免疫叠加火山图保存为:
- results/fig/volcano_MB_vs_CB_immune_overlay.pdf
- results/fig/volcano_MB_vs_CB_immune_overlay.png
- 将 AB 与 MB 的免疫叠加火山图保存为:
- results/fig/volcano_AB_vs_MB_immune_overlay.pdf
- results/fig/volcano_AB_vs_MB_immune_overlay.png
注意: 经过人工整理的免疫基因面板已预先定义并按功能类别分组;包含完整基因符号及其注释的列表见补充表 S1。该表格确保分析的透明性和可重复性,便于在不同研究中直接复用和验证基于面板的分析结果。
- 将 MB 与 CB 的免疫叠加火山图保存为:
13. 进行功能富集分析(GO 和 KEGG)
- 定义用于富集分析的基因集
- 针对每个比较组(MB 与 CB,以及 AB 与 MB),使用校正后 p 值阈值 < 0.05 和绝对 log₂ 倍数变化阈值 ≥ 1,提取显著差异表达基因(DEGs)。
- 将差异表达基因分为上调基因(log₂FC > 0)和下调基因(log₂FC < 0)。
- 定义背景(全集)基因集
- 使用 DESeq2 数据集中经过计数过滤后保留的所有基因作为背景全集。从过滤后的 DESeq2 对象中提取基因符号,并使用 bitr() 函数结合 org.Mm.eg.db 将背景基因符号转换为 Entrez 标识符。
注意: 使用一致的背景基因集可确保富集结果无偏。
- 使用 DESeq2 数据集中经过计数过滤后保留的所有基因作为背景全集。从过滤后的 DESeq2 对象中提取基因符号,并使用 bitr() 函数结合 org.Mm.eg.db 将背景基因符号转换为 Entrez 标识符。
- 映射富集分析所用的基因标识符
- 使用 bitr() 将每个差异表达基因集的基因符号转换为 Entrez 标识符。仅保留成功映射的基因用于 KEGG 富集分析。若某基因集无任何基因成功映射,则跳过该基因集的富集分析。
注意: 基因本体(GO)富集分析使用基因符号,而 KEGG 富集分析需要 Entrez 标识符。
- 使用 bitr() 将每个差异表达基因集的基因符号转换为 Entrez 标识符。仅保留成功映射的基因用于 KEGG 富集分析。若某基因集无任何基因成功映射,则跳过该基因集的富集分析。
- 进行基因本体(GO)富集分析(生物过程)
- 使用 enrichGO() 函数进行 GO 富集分析,设置 OrgDb = org.Mm.eg.db,keyType = "SYMBOL",ontology(ont)= "BP"。将 DESeq2 数据集中所有经过过滤的基因符号指定为全集。
- 使用 pAdjustMethod = "BH" 进行多重检验校正。设定显著性阈值为 pvalueCutoff = 0.05 和 qvalueCutoff = 0.05。通过 minGSSize = 10 和 maxGSSize = 500 限制基因集大小。
- 将 GO 富集分析结果导出至 results/tables/ 目录。生成前若干个显著富集的 GO 条目的条形图,并保存至 results/fig/。
- 进行 KEGG 通路富集分析
- 使用 enrichKEGG() 函数进行 KEGG 富集分析,设置 organism = "mmu"。输入差异表达基因集的 Entrez 标识符,并使用已映射的 Entrez 背景基因集作为全集。
- 应用 pAdjustMethod = "BH" 进行多重检验校正。设定显著性阈值为 pvalueCutoff = 0.05 和 qvalueCutoff = 0.05。通过 minGSSize = 10 和 maxGSSize = 500 限制基因集大小。
- 将 KEGG 富集分析结果表格导出至 results/tables/ 目录。生成富集通路的条形图并保存至 results/fig/。
注意: 若基因映射不足,KEGG 富集分析可能无法返回结果;此类情况将在不中断工作流程的前提下被妥善处理。
14. 进行免疫特异性富集分析(可选模块)
- 构建免疫特异性基因集
- 根据经过审编的功能分类定义免疫面板基因。将差异表达基因(DEG)列表与免疫面板基因取交集。针对每个比较组,将免疫特异性差异表达基因分为上调和下调基因集。
- 对免疫特异性基因集进行富集分析。
- 采用第13节中描述的相同GO和KEGG富集分析流程。使用相同的背景基因集和参数设置。保存结果时,文件名中应包含“immune”标签,以便与全局富集结果区分开。
15. 生成富集点图(可选模块)
- 加载富集分析结果。
- 从 results/tables/ 目录导入 GO 或 KEGG 富集分析表格。
- 转换富集分析指标。
- 将 GeneRatio 值从分数形式(x/y)转换为数值型比率;计算 −log₁₀(校正后 p 值) 以用于可视化。
- 生成点图。
- 以基因比率为横轴,富集术语描述为纵轴作图;点的大小根据基因数量缩放,颜色根据 −log₁₀(校正后 p 值) 着色。
- 根据校正后 p 值的排序选择最显著的富集术语;将点图保存为 PDF 和 PNG 格式文件,存储至 results/fig/ 目录。
16. 保存会话信息并完成运行
- 导出会话信息。
- 将 sessionInfo() 的输出保存到 results/sessionInfo.txt,以记录 R 版本和软件包版本。
- 确认流程成功完成
- 确认工作流程已生成以下内容:results/fig/ 目录中的图表,results/tables/ 目录中的表格。
- 确认三个主要差异分析结果文件已存在且非空:DESeq2_MB_vs_CB_all_genes.csv、DESeq2_AB_vs_MB_all_genes.csv、DESeq2_AB_vs_CB_all_genes.csv。
访问受限。请登录或开始试用以查看此内容。
结果
数据质量评估与全局转录组结构
来自12个脑组织样本(CB、MB、AB;每组n = 4)的RNA-seq数据通过标准化流程进行处理。在过滤低计数基因(总计数≥10)后,保留数据集用于后续分析。对rlog转换后的计数数据进行主成分分析(PCA),结果显示样本按实验分组分离,且各组内的重复样本一致聚类(图1A–B)。
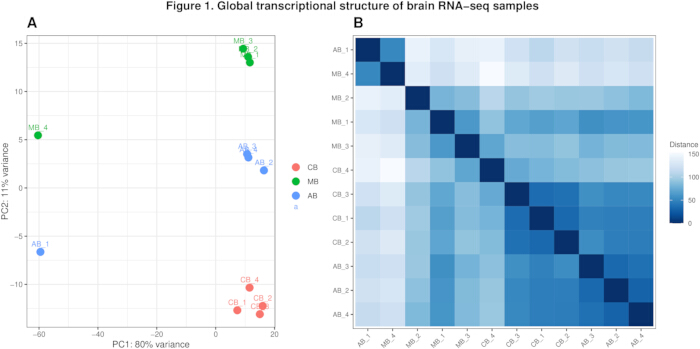
图1:脑组织RN...
访问受限。请登录或开始试用以查看此内容。
讨论
本研究提出了一种可重复的、基于 DESeq2 的批量 RNA-seq 数据分析流程,适用于预定义的生物学比较。该方案整合了标准化的预处理、经验证的元数据分配、标准化、差异表达检验以及结构化的下游输出,能够一致且透明地生成转录组学结果。通过明确定义分析步骤和参数,该流程旨在提高不同研究之间的可重复性和可比性6,7,11。
确保工作流程稳健运行的关键步骤有多个。首先,将样本元数据与基因表达综合数据库(Gene Expression Omnibus, GEO)注释进行核对,可避免仅根据计数矩阵的排列顺序推断分组信息,从而降低样本误分类的风险。其次,在标准化之前对低计数基因进行过滤,有助于减少噪声并稳定离散度估计,这对于批量RNA测序数据集中的差异表达分析至关重要8。第三,使用DESeq2的“比率中位数”方法进行标准化,能够校正文库大小差异和组成偏差,且无需...
访问受限。请登录或开始试用以查看此内容。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| clusterProfiler (R 包) | Bioconductor | RRID:SCR_016884 | 功能富集分析(GO 和 KEGG 通路) |
| DESeq2 (R 包) | Bioconductor | RRID:SCR_015687 | 基于计数的 RNA-seq 数据差异表达分析 |
| ggplot2 (R 包) | CRAN | RRID:SCR_014601 | PCA 图、火山图和汇总图表的可视化 |
| GitHub(可选) | GitHub Inc. | RRID:SCR_002630 | 可重复脚本的版本控制与共享 |
| HTSeq-count RNA-seq 数据集 (GSE162535) | NCBI 基因表达综合数据库 (GEO) | RRID:SCR_005012 | 用于分析输入的批量 RNA-seq 计数矩阵 |
| matrixStats (R 包) | CRAN | RRID:SCR_016361 | 高效计算行/列统计量(例如方差) |
| openxlsx (R 包) | CRAN | RRID:SCR_019215 | 将结果表格导出为 Excel 格式 |
| 操作系统 | Microsoft / Apple / Linux | N/A | 支持 Windows 10+、macOS 或 Linux |
| org.Mm.eg.db (R 包) | Bioconductor | RRID:SCR_002815 | 用于小鼠基因 ID 映射的基因注释数据库 |
| PDF 查看器 | 任意 | N/A | 查看输出图形(PCA 图、热图、火山图) |
| 个人计算机或工作站 | 任意 | N/A | 建议至少 16 GB 内存以进行 RNA-seq 分析 |
| pheatmap (R 包) | CRAN | RRID:SCR_016418 | 基因表达与聚类热图可视化 |
| R 统计软件(版本 ≥ 4.2) | 统计计算基金会 R Foundation for Statistical Computing | RRID:SCR_001905 | 所有 RNA-seq 分析的核心计算环境 |
| RColorBrewer (R 包) | CRAN | RRID:SCR_015742 | 热图和图表的配色方案 |
| RStudio Desktop | Posit Software | RRID:SCR_000432 | 用于脚本编写和可重复性研究的集成开发环境(IDE) |
| 样本元数据文件(CSV 格式) | 生成文件 / GEO 注释 | N/A | 经过整理的样本注释,将样本关联至 CB、MB 和 AB 组 |
| stringr (R 包) | CRAN | RRID:SCR_019195 | 用于富集结果可视化和格式化的字符串处理 |
| tibble (R 包) | CRAN | RRID:SCR_019186 | 数据框处理与整洁数据结构 |
| tidyverse (R 包套件) | CRAN | RRID:SCR_019186 | 数据操作、转换与可视化 |
参考文献
- Storm J, Craig AG. Pathogenesis of cerebral malaria—inflammation and cytoadherence. Front Cell Infect Microbiol. 2014;4:100.
- Hinduja S, Kunieda M. Modelling of ECM and EDM processes. CIRP Annals. 2013 Jan 1;62(2):775–97.
- Soares SMA, Gualberto ACM, da Costa AC, Gonçalves DA, Gameiro J. A high-fat diet protects C57BL/6 mice from Plasmodium berghei ANKA infection in an experimental malaria study. Front Trop Dis. 2023;4:1188902.
- Manzoni G, Try R, Guintran JO, Christiansen-Jucht C, Jacoby E, Sovannaroth S, Zhang Z, Banouvong V, Shortus MS, Reyburn R, Chanthavisouk C. Progress towards malaria elimination in the Greater Mekong Subregion: perspectives from the World Health Organization. Malaria Journal. 2024 Mar 1;23(1):64.
- Wang Q, Tang Y, Pan Z, Yuan Y, Zou Y, Zhang H, et al. RNA-seq-based transcriptome analysis of the anti-inflammatory effect of artesunate in early treatment of a mouse cerebral malaria model. Mol Omics. 2022;18(8):716–30.
- Love MI, Huber W, Anders S. Moderated estimation of fold change and dispersion for RNA-seq data with DESeq2. Genome Biol. 2014;15(12):550.
- Anders S, Huber W. Differential expression analysis for sequence count data. Genome Biol. 2010;11(10):R106.
- Robinson MD, McCarthy DJ, Smyth GK. edgeR: a Bioconductor package for differential expression analysis of digital gene expression data. bioinformatics. 2010 Jan 1;26(1):139-40.
- McCarthy DJ, Chen Y, Smyth GK. Differential expression analysis of multifactor RNA-Seq experiments with respect to biological variation. Nucleic Acids Res. 2012;40(10):4288–97.
- Conesa A, Madrigal P, Tarazona S, Gomez-Cabrero D, Cervera A, McPherson A, et al. A survey of best practices for RNA-seq data analysis. Genome Biol. 2016;17:13.
- Yu G, Wang LG, Han Y, He QY. clusterProfiler: an R package for comparing biological themes among gene clusters. OMICS. 2012;16(5):284–7.
- Hänzelmann S, Castelo R, Guinney J. GSVA: gene set variation analysis for microarray and RNA-seq data. BMC Bioinformatics. 2013 Jan 16;14(1):7.
- Shen-Orr SS, Gaujoux R. Computational deconvolution: extracting cell type–specific information from heterogeneous samples. Curr Opin Immunol. 2013;25(5):571–8.
- Subramanian A, Tamayo P, Mootha VK, Mukherjee S, Ebert BL, Gillette MA, et al. Gene set enrichment analysis: a knowledge-based approach for interpreting genome-wide expression profiles. Proc Natl Acad Sci U S A. 2005;102(43):15545–50.
- Stark R, Grzelak M, Hadfield J. RNA sequencing: the teenage years. Nat Rev Genet. 2019;20(11):631–56.
访问受限。请登录或开始试用以查看此内容。
重印与许可
本文已发表
视频即将推出