本文提出了一种结合 You Only Look Once 第11版(YOLOv11)与卷积神经网络的生产线安全监控方法。该方法在图形处理器上实现了在交并比阈值为0.5时的平均精度均值(mAP@0.5)达到0.91,mAP@0.5:0.95为0.82,每秒处理120帧,性能优于所评估的基线模型。
需要JoVE订阅才能观看此内容。 请登录或开始免费试用
本文内容
摘要
摘要
随着工业4.0的深入推进,生产线的自动化与智能化水平显著提升,对监控系统的实时性、准确性与安全性提出了更高要求。传统的监控系统依赖人工巡检或基于简单阈值的判断,普遍存在响应速度慢、误报率高、智能化程度有限等问题。为此,本文提出一种融合You Only Look Once第11版(YOLOv11)与卷积神经网络(CNN)的生产线安全监控系统。首先对采集的图像进行预处理;随后利用YOLOv11实现对工人、设备及潜在危险源的实时识别;接着引入具有多尺度特征融合与注意力机制的改进型CNN网络,以增强对小目标及遮挡目标的特征提取能力;最后将检测结果与CNN增强的特征进行融合,以评估安全状态。实验采用自建的生产线安全数据集,使用带动量项(0.9)的随机梯度下降(SGD)优化器,初始学习率为0.01,权重衰减为0.0005,学习率采用余弦退火策略调整,批量大小为32,训练200个周期。以mAP@0.5和每秒帧数(FPS)作为评价指标,与基准算法进行对比。结果表明,所提出的系统在mAP@0.5上达到0.91,检测速度达120 FPS。在遮挡、光照变化等复杂条件下仍表现出良好的鲁棒性,验证了其在生产线安全监控中的有效性与实际应用潜力。
引言
在现代工业生产中,安全是确保生产效率和人员福祉的基石。生产线环境通常涉及高速机械设备、复杂的工艺流程以及多任务协同作业。任何微小的潜在安全隐患都可能导致严重的生产事故,造成重大经济损失甚至人员伤亡。因此,建立一个高效、智能且实时的安全监控系统对于提升工业生产安全至关重要1,2。
传统的安全监控方法主要依赖人工视频监控和多种传感器(如红外、烟雾和振动传感器)3。人工监控不仅效率低下,而且由于监控人员容易疲劳,易出现漏检情况,无法实现持续、全面的覆盖。尽管传感器可在一定程度上提供预警功能,但其检测范围有限,且易受环境干扰,导致误报问题突出4。智能监控系统正逐渐成为研究热点。利用深度学习算法对视频流进行实时分析,可自动识别异常事件、不安全行为和潜在风险,从而显著提升监控系统的智能化水平4,5。
目标检测是智能监控中的一项核心技术。作为单阶段目标检测器的代表,YOLO(You Only Look Once)系列算法展现出显著优势。从 YOLOv1 到 YOLOv8,该系列算法持续发展,在网络结构、损失函数、训练方法等方面不断优化6,7。特别是 YOLOv11,在保持高帧率的同时实现了更高的检测精度,尤其在面对复杂背景和密集目标时表现突出8。
然而,尽管 YOLOv11 在通用目标检测任务中表现出色,但在特定的生产线安全监控场景中仍面临挑战9。例如,当工人被设备部分遮挡,或安全标识过小且颜色与背景相近时,YOLOv11 的检测精度可能会下降。这要求模型具备更强的特征提取和语义理解能力10。
卷积神经网络(CNN)在图像特征提取方面具有强大的能力11。通过设计更深、更复杂的网络结构,CNN能够学习到更丰富、更抽象的图像特征。将CNN与YOLOv11相结合,可利用YOLOv11的快速检测能力以及CNN的深度特征提取能力,从而构建一个更强大且更智能的安全监控系统。
基于此,本文提出了一种结合 YOLOv11 与 CNN 的生产线安全监控系统。本研究的创新之处包括:(1)提出一种 YOLOv11 与改进型 CNN 的深度融合架构;(2)引入多尺度特征融合与复合注意力机制,以增强对关键安全特征的识别能力;(3)在自建的复杂场景数据集上验证了该模型的性能优势。
YOLO 系列算法的发展
自 Redmon 等人于 2015 年首次提出以来12,You Only Look Once(YOLO)算法引起了广泛关注。与依赖区域建议的两阶段检测器不同,YOLO 将目标检测视为一个回归任务。通过直接预测图像中目标的类别和位置,YOLO 显著提升了检测速度,使其适用于实时应用13。
作为该系列中的开创性工作,YOLOv1 首次实现了端到端的目标检测14。YOLOv1 将输入图像划分为网格结构,每个网格单元通常以 S × S 的形式排列,负责检测位于其边界内的物体。
具体而言,YOLOv1 的输出是一个张量。在 S × S × (B × 5 + C) 中,每个边界框的预测包含 5 个元素:中心点坐标 (x,y)、宽度 w、高度 h 和置信度 c。该计算过程如公式 (1) 所示:
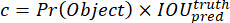 (1)
其中,Pr(对象) 表示网格中存在目标的概率, IOU 表示预测边界框与真实边界框之间交集与并集的比值。每个网格还预测一组类别概率, Pr 表示目标属于该类别的概率 i- 在存在目标的情况下进行分类。YOLOv1 的损失函数由三个主要部分组成:坐标预测损失、置信度估计损失和类别预测损失15.
YOLOv2 引入了批归一化、高分辨率分类器以及多尺度训练策略,这些方法提高了模型的稳定性和准确性16。YOLOv3 采用 Darknet-53 作为其骨干网络,并借鉴特征金字塔网络(FPN)的思想,以增强目标检测能力17。
YOLOv4 在 YOLOv3 的基础上进行了大量优化,引入了跨阶段部分网络(Cross Stage Partial Network, CSPNet)18、路径聚合网络(Path Aggregation Network, PANet)19 以及 Mosaic 数据增强等技术,进一步提升了模型性能。YOLOv5 在工程实现方面做出了重要贡献,提供了更易于使用且更高效的实现方式20。
近年来,YOLO 系列持续发展,相继推出了 YOLOv6、YOLOv7 和 YOLOv8 等版本。通过引入扩展高效层聚合网络(Extended Efficient Layer Aggregation Network, E-ELAN)结构和模型重参数化技术,YOLOv7 在速度和精度方面均实现了新的突破。这些改进不仅提升了特征学习的效率,还优化了网络的推理性能,使 YOLOv7 在多种实时目标检测任务中超越了此前的版本及许多主流检测器。YOLOv8 进一步优化了网络结构,采用无锚框(anchor-free)设计,简化了模型,并增强了其泛化能力21。
在先前版本优势的基础上,本研究采用的 YOLOv11 针对复杂工业场景进行了优化。其核心改进包括特征提取网络、更高效的特征融合模块以及更稳健的损失函数设计。这些改进使 YOLOv11 在应对生产环境中的遮挡、小目标和复杂背景时表现出更优的性能。YOLOv11 是由 Ultralytics 发布的 YOLO 系列的一个版本。相较于 YOLOv8,它改进了 C3K2 模块和特征融合路径,并引入了自适应锚框策略,从而在工业场景中提供更强的检测鲁棒性。
卷积神经网络(CNN)的基础与进展
卷积神经网络(CNN)是一种关键模型,对深度学习在计算机视觉领域的成功产生了深远影响。该模型通过卷积操作提取图像的局部特征,再通过池化操作降低特征维度,从而实现图像的层次化抽象22。
典型的卷积神经网络(CNN)由多个卷积层、池化层和全连接层组成。卷积层使用卷积核扫描输入图像,在局部区域上计算点积,并生成特征图。计算过程如公式(2)所示:
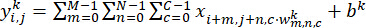 (2)
其中,x 为输入图像,wk 和 bk 分别为卷积核的权重和偏置, 表示输出特征图在位置 (i,j) 处的值。池化层通常采用最大池化(Max Pooling)或平均池化(Average Pooling)。全连接层负责提取特征并预测分类概率。
基于此,本文为 YOLOv11 设计了一种 CNN 特征增强模块,该模块由两个并行分支组成:一个多尺度卷积分支,采用 3 × 3 和 5 × 5 卷积核提取多尺度特征;以及一个注意力分支,依次连接通道注意力(Squeeze-and-Excitation)和空间注意力模块,以增强关键目标的判别性特征。两个分支的输出通过逐元素相加进行融合,对应的特征增强损失函数如公式 (3) 所示:
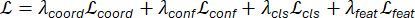 (3)
Lcoord 是边界框坐标回归损失;Lconf 是目标置信度损失;Lcls 是类别分类损失;Lfeat 是特征增强损失,用于约束CNN增强模块提取的小目标和遮挡目标的判别性特征;λcoord、λconf、λcls、λfeat 是对应损失项的权重系数。本任务中设置 λfeat = 0.05,其余权重根据检测任务需求进行平衡。
VGGNet23 和 ResNet24 等经典卷积神经网络(CNN)结构在图像分类任务中取得了巨大成功。在这些架构中,ResNet 有效缓解了深度网络训练中的梯度消失问题,从而促进了更深、更复杂网络结构的构建。
在目标检测任务中,卷积神经网络(CNN)通常被用作特征提取器(主干网络)。例如,YOLO 系列算法中的 Darknet、跨阶段部分 Darknet(CSPDarknet)等均基于 CNN25 构建。为了增强特征提取能力,研究人员提出了多种改进的 CNN 结构。例如,Inception 模块通过多尺度卷积核并行提取特征;DenseNet 通过密集连接增强特征重用;Squeeze-and-Excitation 网络则通过注意力机制自适应地调整特征通道的重要性26。
本研究中,我们设计了一种改进的卷积神经网络(CNN)模块,以增强 YOLOv11 的特征提取能力。该模块结合了多尺度特征融合与注意力机制,能够更有效地捕捉生产线场景中的关键安全信息。
深度学习在工业安全监控中的应用现状
深度学习在工业安全监控领域已得到广泛应用。基于卷积神经网络(CNN)的算法被用于判断工人是否正确佩戴安全帽、检测未经授权进入危险区域的行为,以及监测故障设备的状态27。
在行为识别方面,采用三维卷积神经网络(3D CNN)和循环神经网络来分析工人的操作行为,识别潜在的不安全动作。例如,通过分析工人的姿态序列,可判断其是否违反安全操作规程28。
YOLO 和 Faster R-CNN 广泛用于实时监控视频中人员与设备的检测。例如,已有文献提出了一种基于 YOLOv5 的实时安全帽检测系统,有效提升了建筑工地安全管理的智能化水平29。
尽管现有研究已取得一定进展,但仍存在若干挑战。首先,工业场景通常具有复杂的光照、遮挡和背景干扰,这对算法的鲁棒性提出了严格要求。其次,实时性是一项关键需求,算法必须在保持精度的同时实现高速推理。最后,现有研究主要集中在单任务检测,缺乏对多源信息融合与综合分析的探索30。
本研究提出的YOLOv11与CNN融合模型旨在通过增强特征提取与融合能力,解决上述挑战,实现对生产线安全风险的全面、实时监测。
访问受限。请登录或开始试用以查看此内容。
方案
YOLOv11 和 CNN 算法
系统整体架构
本文提出的生产线安全监控系统采用了一种结合 YOLOv11 与改进型 CNN 的混合架构,以实现高精度、高速的实时安全监测。如图1所示,该系统主要由输入预处理模块、YOLOv11 目标检测模块、CNN 特征增强模块以及融合决策模块组成。输入图像首先由预处理模块进行归一化和数据增强,以提升模型的泛化能力。随后,通过 CSPDarknet 主干网络提取特征,并利用空间金字塔池化-快速(SPPF)模块扩展感受野。在上采样后对多尺度特征进行融合,并依次对融合后的特征施加通道注意力和空间注意力机制,以进一步增强关键目标的判别性表征。CNN 特征增强模块插入于 YOLOv11 主干网络的 C3、C4 和 C5 层输出之后,分别接收尺寸为 80 × 80 × 256、40 × 40 × 512 和 20 × 20 × 1,024 的多尺度特征图。该模块可进一步增强对小目标和遮挡目标的特征提取能力。最后,融合决策模块将 YOLOv11 的检测结果与 CNN 增强后的特征相结合,并通过设计的损失函数进行联合优化,输出目标的精确位置、类别及置信度得分。
YOLOv11 检测框架
YOLOv11 引入了多项关键改进,充分发挥了 YOLO 系列单阶段检测框架的优势。其架构分为三个主要部分:骨干网络、特征融合网络和检测头。骨干网络采用增强型 CSPDarknet 结构。特征融合网络引入了跨阶段局部连接和深度可分离卷积,借鉴了特征金字塔网络和路径聚合网络的设计,以有效融合多尺度特征。
特征增强模块
特征增强模块旨在提高模型对关键安全特征的敏感性。该模块处理YOLOv11主干网络每一层生成的特征图,通过上采样和下采样操作融合不同尺度的信息。具体而言,多尺度分支用于捕捉空间尺度的多样性,而注意力分支则动态增强关键通道和位置响应。这两个分支并非独立运作,而是通过残差连接和特征重校准实现互补与融合。在每个尺度上,经增强模块处理后的特征图通过1×1卷积调整至与原始特征图相同的通道数,再通过逐元素相加的方式与原始YOLOv11特征图融合。融合后的特征图随后输入后续的特征金字塔网络(FPN)进行多尺度融合,从而形成层次化的安全特征表示。为确保模块间的无缝集成,采用端到端联合训练策略,损失函数由YOLOv11检测损失和CNN模块特征增强损失共同组成。
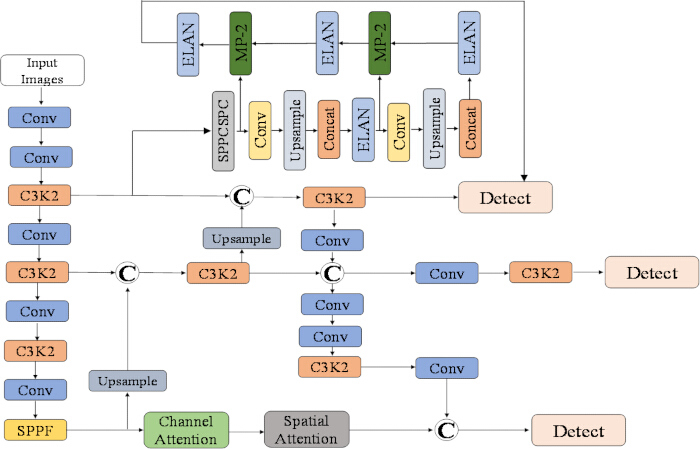
图 1.YOLOv11-CNN 算法。 特征增强模块旨在提高模型对关键安全特征的敏感性。该模块处理来自 YOLOv11 主干网络不同层的特征图,通过上采样和下采样操作融合多尺度特征,并引入通道注意力和空间注意力机制。为确保 YOLOv11 模块与 CNN 模块之间的无缝集成,采用联合训练策略。在训练过程中,对两个模块的参数进行端到端优化。损失函数结合了 YOLOv11 的检测损失与 CNN 模块的特征增强损失。请点击此处查看此图的放大版本。
访问受限。请登录或开始试用以查看此内容。
结果
为验证所提出的 YOLOv11 与 CNN 融合模型在生产线安全监控中的有效性,构建了一个涵盖多种安全隐患场景的数据集。该数据集包含 12,000 张生产线场景图像,按 7:1.5:1.5 的比例划分为训练集、验证集和测试集,并固定随机种子为 42。数据集覆盖多种工况,包括标准光照、低光照、部分遮挡、严重遮挡、运动模糊以及复杂背景。推理时的置信度阈值设为 0.5,非极大值抑制(NMS)阈值设为 0.45。所有实验均重复三次,结果以均值 ± 标准差形式报告。标注类别包括工人、安全帽、机械臂、危险区域、工具和车辆,采用 PASCAL Visual Object Classes(VOC)格式。交并比(IoU)阈值设为 0.5,标注一致性通过双人交叉验证确认。输入图像统一缩放至 640 × 640,并采用 Mosaic 数据增强。训练使用 SGD 优化器,初始学习率为 0.01,动量为 0.9,权重衰减为 0.0005,批量大小为 32。训练共进行 200 个轮次,采用余弦退火策略调整学习率。
为全面评估模型的有效性,采用了多种评价指标:平均精度均值(mAP)、每秒帧数(FPS)用于衡量图...
访问受限。请登录或开始试用以查看此内容。
讨论
实验结果表明,所提出的 YOLOv11–CNN 融合模型在生产线安全监控中提高了检测精度和实时性能。该系统利用 YOLOv11 高效的单阶段检测能力以及 CNN 模块的特征增强能力,在复杂光照和遮挡条件下成功识别了工人、设备和危险区域。通过多尺度特征融合和注意力机制,增强了对关键安全要素的关注能力,为预警提供了可解释的视觉依据。
该系统在汽车制造和电子装配等生产线上具有实际应用价值,其实时监测功能可减少对人工检查的依赖,并缩短对潜在安全隐患的响应时间。对于螺丝、工具等小型目标,以及被机械臂或其他设备部分遮挡的作业人员目标,多尺度特征融合与注意力机制能够提升模型提取和突出安全相关特征的能力。这些改进对于目标尺寸和可见性各异的生产环境具有重要意义。
然而,本研究仍存在明显的局限性。在严重遮挡或光照极低的情况下,由于目标特征信息变得不完整,现有卷积特征可能不足,导致模型性能下降。新增的卷积神经网络特征增强模块引入了150万额外参数,可能增加低成本边缘设备的计算负担,限制其在资源受限环境中的部署。本研究使用可见光图像数据,未融合多模态...
访问受限。请登录或开始试用以查看此内容。
披露
作者声明无利益冲突。
致谢
本工作部分由台州学院高层次人才科研启动基金“智能制造中精密检测关键技术研究”(TZXY2020QDJJ006)资助。
访问受限。请登录或开始试用以查看此内容。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| COCO API | N/A | 用于目标检测准确率评估与统计分析的评估工具。 | |
| CUDA 11.4 | NVIDIA | N/A | 与 PyTorch 1.12 框架配合使用的并行计算平台。 |
| Edge TPU | N/A | 用于延迟和功耗测试的部署平台;报告的延迟为 18 ms,功耗为 15 W。 | |
| Jetson Xavier 边缘计算设备 | NVIDIA | 用于吞吐量测试的边缘计算设备;报告的处理速度为 70 FPS,第99百分位延迟在 50 ms 以内。 | |
| NVIDIA Tesla V100 GPU | NVIDIA | 用于训练/评估服务器的 GPU。 | |
| PyTorch 1.12 | N/A | 用于模型训练与评估的深度学习框架。 | |
| scikit-learn | N/A | 用于模型评估的评估/统计分析工具。 | |
| 自建生产线安全数据集 | N/A | N/A | 包含 12,000 张生产线场景图像的数据集,采用 VOC 格式,涵盖标准光照、低光照、部分遮挡、严重遮挡、运动模糊及复杂背景;共六个标注类别:工人、安全帽、机械臂、危险区域、工具和车辆。 |
| 训练服务器 | 配备 NVIDIA Tesla V100 GPU 和 Ubuntu 20.04 操作系统的服务器。 | ||
| Ubuntu 20.04 操作系统 | N/A | 训练/评估服务器所使用的操作系统。 | |
| VOC 标注格式 | N/A | N/A | 用于自建生产线安全数据集的标注格式。 |
| YOLOv11 目标检测模型 | Ultralytics | N/A | 用于实时检测工人、设备及潜在危险的目标检测模型。 |
参考文献
- Ramadan MNA, Ali MAH, Jaber H, Alkhedher M. Blockchain-secured IoT-federated learning for industrial air pollution monitoring: a mechanistic approach to exposure prediction and environmental safety. Ecotoxicol Environ Saf. 2025;300:118442.
- Ahn J, et al. SafeFac: video-based smart safety monitoring for preventing industrial work accidents. Expert Syst Appl. 2023;215:119397.
- Natha S, et al. A scalable and generalized deep ensemble model for road anomaly detection in surveillance videos. Comput Mater Contin. 2024;81(3):3707-3729.
- Diallo AR, Homri L, Dantan JY. Reducing false alarms in fault detection: a comparative analysis between conformal prediction and classical methods applied to PCA and autoencoders. J Process Control. 2025;152:103495.
- Cheng X, Han Y, Zhang W. Development of intelligent monitoring system for soil erosion in pipeline engineering based on deep learning. Comput Electr Eng. 2025;126:110432.
- Yan H, et al. A global feature fusion and adaptive optimization method to enhance detection accuracy and computational efficiency based on YOLOv8. Alexandria Eng J. 2025;129:538-552.
- Samma H, Al-Azani S, El-Ferik S. UAV-based real-time face detection using YOLOv7. Transp Res Procedia. 2025;84:331-338.
- Gong X, Yu J, Zhang H, Dong X. AED-YOLO11: a small object detection model based on YOLO11. Digit Signal Process. 2025;166:105411.
- Li R, Xiao K, Lin S, Wu Z. Enhancing aquatic ecosystem monitoring through fish jumping behavior analysis and YOLOv5: applications in freshwater fish identification. J Environ Manage. 2025;391:126413.
- Zhang D, Gao Q, Chen Z, Lin Z. Semantic feature refinement of YOLO for human mask detection in dense crowded. J Vis Commun Image Represent. 2025;107:104399.
- Choi MJ, Ku DG, Lee SJ. Integrated YOLO and CNN algorithms for evaluating degree of walkway breakage. KSCE J Civ Eng. 2022;26(8):3570-3577.
- Li Y, et al. Underwater acoustic intelligent spectrum sensing with multimodal data fusion: an Mul-YOLO approach. Future Gener Comput Syst. 2025;173:107880.
- Jiang D, et al. Real-time tracker of chicken for poultry based on attention mechanism-enhanced YOLO-Chicken algorithm. Comput Electron Agric. 2025;237:110640.
- Yang X, et al. Automated concrete bridge damage detection using an efficient Vision Transformer-enhanced anchor-free YOLO. Engineering. 2025;51:311-326.
- Fuertes D, et al. People detection with omnidirectional cameras using a spatial grid of deep learning foveatic classifiers. Digit Signal Process. 2022;126:103473.
- Deepak GD, Bhat SK. Maximizing YOLOv2 efficiency: a study on multiclass detection of indoor objects. Results Eng. 2025;26:105405.
- Zhang C, et al. Personnel target detection in infrared environment based on YOLOv3-tinier network and its FPGA implementation. Infrared Phys Technol. 2025;150:106015.
- Zhou Y. A YOLO-NL object detector for real-time detection. Expert Syst Appl. 2024;238:122256.
- Asadollahpour E, Rahmannejad R, Asghari A, Abdollahipour A. Back analysis of closure parameters of Panet equation and Burger's model of Babolak water tunnel conveyance. Int J Rock Mech Min Sci. 2014;68:159-166.
- Anguchamy KK, Palanisamy V. Real-time object detection using improvised YOLOv4 and feature mapping technique for autonomous driving. Expert Syst Appl. 2025;280:127452.
- Khan AT, Jensen SM, Khan AR. Advancing precision agriculture: a comparative analysis of YOLOv8 for multi-class weed detection in cotton cultivation. Artif Intell Agric. 2025;15(2):182-191.
- Raushan R, Singhal V, Jha RK. Damage detection in concrete structures with multi-feature backgrounds using the YOLO network family. Autom Constr. 2025;170:105887.
- Zarboubi M, Bellout A, Chabaa S, Dliou A. CustomBottleneck-VGGNet: advanced tomato leaf disease identification for sustainable agriculture. Comput Electron Agric. 2025;232:110066.
- Xie F, et al. Wine variety traceability by data fusion of near-infrared spectroscopy and mid-infrared spectroscopy combined with GAF and ResNet. Chemom Intell Lab Syst. 2025;264:105468.
- Huang J, et al. Estimation of the orientation of potatoes and detection bud eye position using potato orientation detection you only look once with fast and accurate features for the movement strategy of intelligent cutting robots. Eng Appl Artif Intell. 2025;142:109923.
- Huang Y, et al. Human intrusion detection with distributed fiber optic data based on Squeeze-Excitation and hierarchical connection enhancement network. Opt Fiber Technol. 2025;94:104297.
- Qi R, et al. Mechanical fault diagnosis of on-load tap changers using time-frequency vibration analysis and a lightweight YOLO model. Measurement. 2025;256:118441.
- Yan J, Wang Z. YOLO V3+VGG16-based automatic operations monitoring and analysis in a manufacturing workshop under Industry 4.0. J Manuf Syst. 2022;63:134-142.
- Nazli NANM, et al. A real-time system for detecting personal protective equipment compliance using deep learning model YOLOv5. Procedia Comput Sci. 2024;245:647-656.
- Xiao Y, et al. The prediction of kiwi quality attributes based on multi-source data fusion comprehensive analysis model using HSI and FHSI. J Food Compos Anal. 2025;144:107645.
访问受限。请登录或开始试用以查看此内容。