本方案描述了一种基于指南的检索增强生成聊天机器人的开发与评估方法,该机器人可从基于网络的癌症临床实践指南中检索并总结内容,以生成有参考依据的用户查询回复。
需要JoVE订阅才能观看此内容。 请登录或开始免费试用
本文内容
摘要
摘要
互联网上医疗信息的广泛可及性改善了患者获取健康相关知识的途径;然而,这也增加了患者接触不准确医疗信息的风险。癌症治疗涉及复杂的信息,使得患者难以识别准确且基于证据的信息来源。大型语言模型虽能实现自然语言交互,但常产生“幻觉”内容,限制了其在医疗信息传递中的应用。检索增强生成(RAG)技术通过将回答建立在外部参考源的基础上,有望降低此类风险。本研究描述了一种基于指南的RAG聊天机器人的开发与评估过程,该系统利用公开可获取的基于网络的癌症临床实践指南。系统从指南的目录页面提取URL,使用基于词频-逆文档频率的形态学分析和余弦相似度对页面文本进行处理,并从高度相关页面构建参考信息。大型语言模型利用这些参考信息生成受限于指南内容的回答。本研究以《肺癌患者及家属指南手册》(JLCS Guidebook for Lung Cancer Patients and Families)作为参考指南。问题集包括指南涵盖范围内的癌症类型和范围外的癌症类型,以评估系统对回答的控制能力。研究成功从目录页面提取了医疗信息,提取的URL中有98%包含可引用的医学内容。对于范围内的问题,聊天机器人通过总结指南内容生成回答,在定义的测试条件下人工审查未发现任何幻觉内容。对于范围外的问题,聊天机器人始终拒绝回答,并提示现有信息不足以提供答案。该指南的网页结构便于在URL层级高效抓取和组织参考内容。本方案为利用基于网络的临床实践指南构建人工智能医疗信息服务系统提供了实用指导。
引言
互联网和社交媒体的广泛使用使患者更容易获取医学信息1,2。癌症治疗相关的信息通常复杂且繁多,患者尤其难以识别准确、相关且基于科学证据的信息来源3。尽管在线资源有助于提升患者对疾病的认知,但其中也包含大量错误的医学信息3,可能对患者在治疗决策方面产生负面影响4。由于与癌症相关的虚假信息可能影响患者的治疗结局5,因此迫切需要人工智能(AI)系统来帮助个体用户搜索、总结和解读医学信息6。
大语言模型(LLMs)使用户能够通过自然语言对话获取信息7;然而,生成错误信息(即“幻觉”)的问题在医学领域仍然是一个严重关切8,9,10,11。错误信息的一个关键来源是用于开发聊天机器人的训练数据的质量和准确性。此外,模型训练的静态特性意味着知识可能随时间推移而过时,从而限制了LLMs提供最新且符合情境的信息的能力12,13。这些局限性凸显了有效知识管理策略的重要性,以确保聊天机器人的回答保持准确、相关且及时更新。特别是在医疗环境中,临床实践指南等基于证据的资源不断更新,推荐意见和护理标准持续演变,因此更需要能够便捷访问并引用当前权威资源的系统。为应对这一挑战,检索增强生成(retrieval-augmented generation, RAG)技术日益受到关注,该技术通过整合来自外部知识源的信息来生成响应10,13,14,15,16,17。
尽管检索增强生成(RAG)在医学聊天机器人中的应用日益广泛,但关于如何将临床实践指南系统性地整合为参考信息来源,目前关注仍有限18。许多临床实践指南在互联网上公开可获取;然而,其现有的网页结构是否可直接作为RAG系统的检索框架,尚不明确18。此外,如何在无需人工构建知识库的前提下建立参考信息的实用方法,尚未得到充分建立。
本研究旨在通过开发和评估一种基于公开可用的网络癌症临床实践指南的指南型RAG聊天机器人,建立医疗领域中参考指南的人工智能系统的设计原则,从而实现对基于指南信息的简便且及时的获取。作为概念验证,我们评估了利用现有公开临床实践指南的网络结构进行指南检索、回答生成和回答限制的技术可行性,旨在提出一种可重复的指南参考RAG系统的开发流程。
访问受限。请登录或开始试用以查看此内容。
方案
本研究不涉及需要防范研究风险的人类受试者,因此根据日本涉及人类受试者的医学研究伦理指南,无需经过机构审查委员会的审查19。本研究的报告遵循个体预后或诊断多变量模型透明报告(Transparent Reporting of a Multivariable Model for Individual Prognosis or Diagnosis, TRIPOD)-LLM指南20。
有关基于指南的 RAG 聊天机器人协议的示意图,请参见图 1。
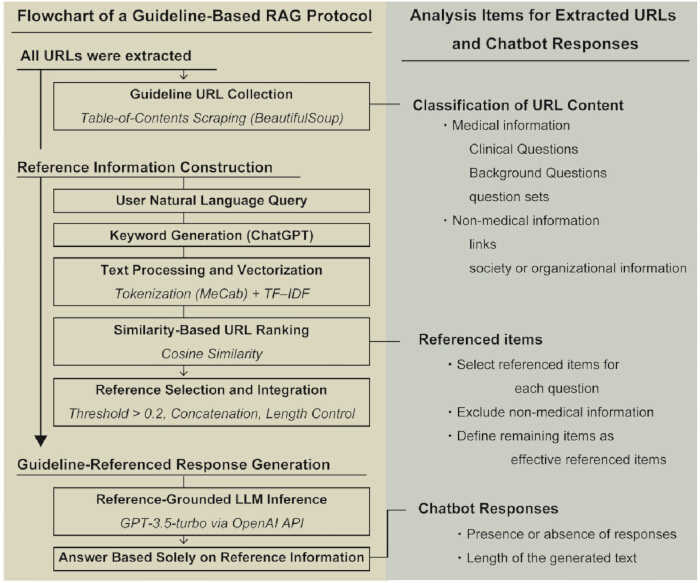
图1.基于指南的检索增强生成(RAG)聊天机器人协议工作流程。 基于指南的RAG聊天机器人工作流程的示意图。从基于网络的临床实践指南目录页面提取URL,并用于构建参考信息。用户查询被转换为关键词,网页内容通过分词、词频-逆文档频率向量化和余弦相似性分析进行处理,以识别相关的指南页面。选定的参考信息被整合后提供给大语言模型,使其仅基于引用的指南内容生成响应。右侧面板总结了用于评估提取的URL、参考信息和聊天机器人响应的评价项目。 请点击此处查看该图的放大版本。
1. 基于网络指南的参考信息准备
- 使用 Python(版本 3.12)编程语言实现的 BeautifulSoup 4(HTML 解析库)从目标网络版临床实践指南的目录页面中提取所有 URL。
注意:使用包含以下包的编程语言实现 URL 提取脚本:HTML 解析库(版本 4.12.3)和 requests(网页获取库;版本 2.32.3)。使用 pip 安装这些包。URL 提取的完整源代码见补充文件 1。软件详细信息请参见材料表。 - 手动审查所有提取出的 URL,以确认其可成功访问且与目标临床实践指南相关。
- 将每个 URL 分类为包含医学信息或非医学信息。由一位作者(S.N.)完成 URL 分类。
注意:医学信息定义为可引用的指南内容,包括临床问题(CQs)、背景问题以及问题集。非医学信息包括链接、学会或组织页面以及其他不适合引用的辅助性内容。 - 将已验证的 URL 汇总到一个 Microsoft Excel 工作簿(.xlsx 格式)中,每行记录一个 URL。将生成的 URL 列表作为后续文本检索、预处理和相似性分析的输入数据集保存。
2. 从用户查询生成关键词
- 将自然语言查询输入至 ChatGPT(生成式预训练变换模型,版本 4o;关键词生成模型)。
- 提示模型从用户查询中提取两个关键词。
- 使用以下用日语撰写的提示语进行关键词生成:
"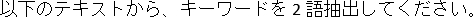 "
(英文翻译:“从以下文本中提取两个关键词。”) - 将用户的自然语言查询附加至该指令之后,并提交给关键词生成模型以生成关键词。
- 不得手动修改任何模型参数。使用关键词生成模型的默认设置执行关键词生成。
- 为每条用户查询生成两个关键词。保留所生成的两个关键词,不做进一步修改、筛选或人工选择,并将其用于后续的相似性计算。
- 将生成的关键词存储在 Microsoft Excel 工作簿(.xlsx 格式)中。针对每条记录,保存原始用户查询及其对应的生成关键词,用于后续基于相似性的检索。
3. 文本处理与相似度计算
- 使用网页检索库和HTML解析库,从每个提取的URL中获取全文内容。利用BeautifulSoup的get_text()函数从HTML源码中提取文本内容。
- 对提取的网页文本和生成的关键词进行预处理,移除HTML标签和非日文字符。
- 使用MeCab(版本0.996;日文形态分析器)及其默认词典进行日文形态分析。仅保留名词,并将其连接成以空格分隔的文本字符串。
- 将生成的关键词合并为单个文本字符串,并应用与网页文本相同的预处理和分词流程。
- 使用scikit-learn库(版本1.6.1)中的TfidfVectorizer实现,基于默认参数设置,从处理后的网页文本和关键词文本生成词频-逆文档频率(TF-IDF)向量。
注意:所有TfidfVectorizer参数均保持默认值,未应用任何自定义参数设置。 - 使用余弦相似度函数,计算每个网页向量与关键词向量之间的余弦相似度。
- 根据余弦相似度得分,将URL按降序排列。不应用额外的并列排序规则。
- 选择余弦相似度得分≥0.2的页面作为候选参考信息。
注意:余弦相似度阈值(0.2)是在系统开发过程中通过经验确定的,旨在优先提高检索的召回率,避免遗漏潜在相关的指南内容。 - 保留所有满足相似度阈值的候选页面。
4. 参考信息的构建
- 从排序列表的顶部开始,依次提取所选页面的文本内容。
- 将提取的文本连接起来,形成一个单一的参考文档。
- 在提交给大语言模型(LLM)之前,将参考文本中的换行符和连续的空白字符替换为单个空格。
- 在提供给大语言模型(LLM)之前,将连接后的参考文本截断为前 4,096 个字符。
注意:截断限制基于字符数而非 token 数。选择 4,096 个字符的限制是基于经验,以确保组合后的提示和参考信息保持在 GPT-3.5-turbo-16k 响应生成模型的输入容量范围内。
5. 基于人工智能的响应生成
- 通过应用程序编程接口(API)向响应生成模型提供构建的参考信息和原始用户查询。
- 使用以下日语提示指导人工智能,以确保其响应完全基于提供的参考信息生成:
您是一位为癌症患者提供指导的医疗信息助手。请仅根据以下参考信息生成回答,不要使用您自己的常识或推理。回答应详尽且易于理解,长度约为500个字符。如果参考信息中未包含足够的信息来回答问题,请回答:“文本中信息不足”,不要进行任何推测或使用常识。 - 参考信息:[参考文本] 问题:[用户查询]
- 使用以下设置通过响应生成模型生成回复:temperature = 0.1,最大输出长度 = 1,024 tokens,n = 1,停止条件 = 无。
- 获取人工智能生成的回复,以供后续评估。
注意:请将参考信息和用户查询作为单条用户消息提交。请将回复生成指令单独作为系统消息提供。
6. 参考指南与问题提出
- 选择《肺癌患者及家属 JLCS 指南手册》(Lung Guidebook)21 作为基于指南的 RAG 聊天机器人系统的参考信息,该手册可在线免费获取。
- 根据癌症类型创建两类评估问题:一类为胸腺肿瘤,属于指南涵盖范围;另一类为儿童胶质瘤,不在参考信息的覆盖范围内。
- 针对每种癌症类型,设计四个涵盖诊断与治疗方面的问题:
“XX 肿瘤(例如胸腺肿瘤或儿童胶质瘤)有哪些可用的诊断方法?”
“XX 肿瘤的病理学诊断方法有哪些?”
“XX 肿瘤有哪些可用的治疗选择?”
“XX 肿瘤有哪些可用的外科治疗选择?” - 将与参考网络指南所涵盖癌症类型相关的问题提交给聊天机器人。例如,在使用《肺癌指南手册》作为参考信息时,提交关于胸腺肿瘤诊断的问题。
- 将超出参考指南范围的问题提交给聊天机器人,以评估其避免使用外部或无关信息的能力。例如,在使用《肺癌指南手册》作为参考信息时,提交关于儿童胶质瘤的问题。
- 在独立的聊天会话中对每个问题进行评估,问题之间不得延续对话历史。
- 记录人工智能生成的回答,用于后续评估。
7. 反应评估
- 对所有生成的回答进行人工审核。
- 评估每个回答是否包含幻觉内容。
- 评估每个回答是否由参考指南中的信息所支持。
注:幻觉内容定义为包含不存在的事件、名称或术语的回答,此类内容可能造成医疗危害14。所有生成的回答均由一位在大学医院拥有8年工作经验的作者进行准确性及无幻觉审查,其专业领域包括癌症患者支持与医患沟通。对于回答分类中的任何疑问,均通过与一位在日本国立癌症中心从事癌症信息服务超过20年的医师合著者讨论后达成共识。 - 仅当所有临床相关陈述均可直接从检索到的参考指南中得到确认,且无需额外知识或未经支持的推断时,才视为回答得到支持。
- 使用预定义的结果标签对每个回答进行分类。将仅包含由参考指南支持信息的回答归类为“无幻觉”;将包含未经支持或捏造信息的回答归类为“存在幻觉”。
访问受限。请登录或开始试用以查看此内容。
结果
通过目录页面检索医学内容的可获取性
网络爬虫架构从指南的目录页面收集了网址。从《肺部指南手册》中,共从目录页面提取出106个网址,其中104个(98%)包含医学信息(补充表1)。基于指南内容页面的聊天机器人回复效果总结于表1中。当问题在指南范围内时,聊天机器人能够针对全部四个临床关键词生成回复。对于“胸腺肿瘤诊断”和“病理诊断”这两个关键词,每个关键词均提取出3个相关网址,且所有提取的网址均被判定为有效(100%)。对于“治疗方法”和“手术治疗”这两个关键词,每个关键词均提取出15个网址,其中14个为有效项目(93%)。
| 查询 | 关键词 | ... |
访问受限。请登录或开始试用以查看此内容。
讨论
本研究探讨了一种基于指南的检索增强生成(RAG)聊天机器人,该机器人以网络版临床实践指南——《肺癌患者及家属指南手册》(JLCS Guidebook for Lung Cancer Patients and Families)作为参考信息源。该聊天机器人通过利用指南的网页结构,并根据用户查询与网页内容的相似性进行页面检索,从而生成基于指南内容的回答。该方法表明,基于相似性的检索与参考指南生成回答相结合,可支持可靠且高效的医学信息传递。近期研究已强调了基于大语言模型(LLM)的医疗聊天机器人在幻觉现象和回答可靠性方面的潜力与局限性12,13,14。与以往聚焦于通用聊天机器人框架的研究10,12,13不同,本研究方案展示了一种可复现的、基于指南的RAG方法,该方法在URL...
访问受限。请登录或开始试用以查看此内容。
披露
作者声明无竞争利益。
致谢
作者感谢日本湘南纪念医院乳腺中心的井上健一医学博士、理学博士(Kenichi Inoue, MD, PhD)在基于指南的检索增强生成式聊天机器人开发过程中提供的大量技术支持。作者还感谢日本国立癌症中心癌症控制研究所(日本东京)的山木千佳子博士(Chikako Yamaki, PhD)以及研究团队全体成员就本文所探讨主题提供的宝贵建议。此外,作者感谢 Editage 提供的英文语言编辑服务。本研究得到了日本健康与劳动科学研究基金(R6–Cancer Control–23EA1026)的资助。
访问受限。请登录或开始试用以查看此内容。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| Beautiful Soup 4(版本 4.12.3) | Beautiful Soup Project | N/A | 用于 URL 提取和 HTML 解析的 Python 库 |
| ChatGPT 版本 4o | OpenAI | N/A | 用于关键词生成 |
| GPT-3.5-turbo | OpenAI | N/A | 用于响应生成 |
| 肺癌患者及家属 JLCS 指南 | 日本肺癌学会 | N/A | 基于网络的临床实践指南,用作参考信息 |
| MeCab(版本 0.996) | MeCab Project | N/A | 日语形态分析器 |
| OpenAI API | OpenAI | N/A | 用于基于人工智能的响应生成 |
| Python(版本 3.12) | Python 软件基金会 | N/A | 编程环境 |
| Requests(版本 2.32.3) | Requests Project | N/A | 用于网页获取的 Python 库 |
| scikit-learn(版本 1.6.1) | scikit-learn 开发者 | N/A | 用于 TF–IDF 向量化和余弦相似度计算。 |
| urllib.parse | Python 软件基金会 | N/A | 用于 URL 标准化和拼接的 Python 库 |
参考文献
- Helft PR, Hlubocky F, Daugherty CK. American oncologists' views of internet use by cancer patients: a mail survey of American Society of Clinical Oncology members. J Clin Oncol. 2003;21(5):942-947.
- Chen X, Siu LL. Impact of the media and the internet on oncology: survey of cancer patients and oncologists in Canada. J Clin Oncol. 2001;19(23):4291-4297.
- Goto Y, et al. Differences in the quality of information on the internet about lung cancer between the United States and Japan. J Thorac Oncol. 2009;4(7):829-833.
- Ogasawara R, et al. Reliability of cancer treatment information on the internet: observational study. JMIR Cancer. 2018;4(2):e10031.
- Johnson SB, Park HS, Gross CP, Yu JB. Complementary medicine, refusal of conventional cancer therapy, and survival among patients with curable cancers. JAMA Oncol. 2018;4(10):1375-1381.
- Rajpurkar P, Chen E, Banerjee O, Topol EJ. AI in health and medicine. Nat Med. 2022;28(1):31-38.
- The Lancet Digital Health. ChatGPT: friend or foe? Lancet Digit Health. 2023;5(3):e102.
- Huang L, et al. A survey on hallucination in large language models: principles, taxonomy, challenges, and open questions. arXiv. 2023;2311.05232.
- Ji Z, et al. Survey of hallucination in natural language generation. ACM Comput Surv. 2023;55(12):248.
- Yang R, et al. Retrieval-augmented generation for generative artificial intelligence in health care. npj Health Syst. 2025;2(2).
- Zakka C, et al. Almanac—retrieval-augmented language models for clinical medicine. NEJM AI. 2024;1(2):AIoa2300068.
- Chow JCL, Li K. Developing effective frameworks for large language model-based medical chatbots: insights from radiotherapy education with ChatGPT. JMIR Cancer. 2025;11:e66633.
- Chow JCL, Li K. Large language models in medical chatbots: opportunities, challenges, and the need to address AI risks. Information. 2025;16(7):549.
- Nishisako S, Higashi T, Wakao F. Reducing hallucinations and trade-offs in responses in generative AI chatbots for cancer information: development and evaluation study. JMIR Cancer. 2025;11:e70176.
- Lewis P, et al. Retrieval-augmented generation for knowledge-intensive NLP tasks. Adv Neural Inf Process Syst. 2020;33:9459-9474.
- Gao Y, et al. Retrieval-augmented generation for large language models: a survey. arXiv. 2023;2312.10997.
- Jeong M, Sohn J, Sung M, Kang JJB. Improving medical reasoning through retrieval and self-reflection with retrieval-augmented large language models. Bioinformatics. 2024;40:i119-i129.
- Lewis M, et al. Grounding large language models in clinical evidence: a retrieval-augmented generation system for querying UK NICE clinical guidelines. arXiv. 2025;2510.02967.
- Ministry of Education, Culture, Sports, Science and Technology; Ministry of Health, Labour and Welfare; Ministry of Economy, Trade and Industry. Ethical guidelines for medical and biological research involving human subjects [Article in Japanese]. Ministry of Health, Labour and Welfare.
- Gallifant J, et al. The TRIPOD-LLM reporting guideline for studies using large language models. Nat Med. 2025;31:60-69.
- The Japanese Lung Cancer Society. JLCS Guidebook for Lung Cancer Patients and Families. Available at: https://www.haigan.gr.jp/public/guidebook/2024/. Accessed January 21, 2026.
- Liu M, et al. Evaluating the effectiveness of advanced large language models in medical knowledge: a comparative study using Japanese national medical examination. Int J Med Inform. 2025;193:105673.
- Kudo T, Yamamoto K, Matsumoto Y. Applying conditional random fields to Japanese morphological analysis. In: Proceedings of the 2004 Conference on Empirical Methods in Natural Language Processing. 2004:230-237.
访问受限。请登录或开始试用以查看此内容。