本文介绍了一种用于急性胰腺炎患者多器官功能障碍综合征早期风险分层的队列构建、实验室检测标准化、惩罚模型开发、验证及床旁评分构建的实验方案。
本文内容
摘要
摘要
急性胰腺炎中多器官功能障碍综合征的早期识别仍然困难,因为器官功能恶化可能在常规严重程度评估完成之前就已发生。本文介绍了一种可重复的方案,用于开发、验证并应用基于入院24小时内常规实验室检测结果的生化-凝血综合评分。选择多器官功能障碍综合征作为主要终点,因其反映了多个器官系统的临床显著性功能障碍,并可直接指导早期监测强度、升级治疗计划以及重症监护资源的分配。该方案涵盖多中心队列构建、入组资格筛选、终点裁定、实验室单位标准化、缺失数据处理、预测因子标准化、惩罚回归模型构建、留出验证、评分构建、与现有严重程度评分的比较基准分析以及敏感性分析。在模型构建过程中保留连续型实验室变量以减少信息丢失,仅在将最终模型转化为临床可用的床旁评分时使用具有临床可解释性的分类方式。操作过程中的关键检查点包括队列构建确认、缺失数据阈值评估、锁定的预处理规则、模型选择结果、验证结果以及最终评分的解读。通过此工作流程,可将常规检测的生化与凝血标志物整合为一种结构化的入院风险分层工具,用于急性胰腺炎相关多器官功能障碍综合征的预测。该评分旨在支持更密切的观察、重复实验室检测以及器官支持通路的准备工作,但应作为临床判断和现有严重程度评估框架的补充,而非替代。
引言
急性胰腺炎是一种常见的消化系统急症,其临床病程从轻度、自限性炎症到快速进展并伴有器官功能障碍的重症疾病不等。目前的严重程度评估通常依据修订版亚特兰大分类标准,该标准根据局部并发症、全身并发症以及器官衰竭的存在与否和持续时间来定义疾病严重程度1。在住院早期,床旁评分系统也被用于支持风险评估和治疗升级决策。急性胰腺炎严重程度床旁指数利用发病最初24小时内可获得的五个变量,用于估计住院期间死亡风险2。近期的临床指南继续强调对重症疾病的早期识别、反复再评估、适当的液体复苏、器官支持计划以及及时升级治疗3。
在常规临床实践中,早期风险评估仍然较为困难。急性胰腺炎的炎症反应变化迅速,一些传统的评分系统需要多次测量、入院后才逐渐显现的生理学参数,或在初次临床就诊时可能无法获得的影像学结果4。因此,风险分层可能因采样时间、当地工作流程和治疗路径的不同而发生变化。这些不确定性可能导致对低风险患者进行不必要的强化监测或干预,而病情迅速恶化的患者则可能延误升级治疗。近期一项关于急性胰腺炎严重程度预测的综述指出,临床评分和单个生物标志物的性能在不同患者人群、疾病严重程度分布以及评估时间窗之间存在差异5。
最近的大多数预测研究尝试使用入院后24小时内收集的变量,通常以持续性器官衰竭或重症急性胰腺炎作为目标结局。这种方法在临床上具有实用性,但许多已发表的模型仍受限于单中心设计、验证不充分,以及对数据预处理和缺失数据处理方法报告不足6。对于预测模型而言,透明报告尤为重要,因为纳入标准、预测因子定义、样本量、缺失数据处理、模型构建决策以及验证流程会直接影响结果的可重复性和临床解释7。一种基于入院数据的方法若要在不同医疗机构间通用,应依赖常规可获取的检测指标,明确定义单位转换流程,说明实验室数值如何标准化,并在模型拟合前明确说明不完整的预测因子值如何处理。
生化指标和凝血异常均与急性胰腺炎早期病情恶化相关。炎症激活、内皮损伤、血液浓缩、肾灌注不足以及微循环障碍可能在早期即出现,并导致器官功能障碍。凝血系统的激活与炎症反应密切相关,急性胰腺炎相关性凝血病已被描述为持续性器官衰竭和不良预后发展过程的一部分8。D-二聚体也被报道为入院时与器官衰竭、局部并发症、入住重症监护病房及死亡率相关的标志物9。然而,凝血指标常被单独解读,而未在结构化的入院诊疗流程中与常规生化指标联合应用。
在本方案中,选择多器官功能障碍综合征作为主要终点,因为它代表了多个器官系统出现具有临床意义的功能障碍。尽管持续性器官衰竭仍是急性胰腺炎严重程度分类的核心依据,但多器官功能障碍综合征更贴近临床实际的收治判断问题:即患者是否可能需要更密切的监测、反复的实验室评估、器官支持准备或重症监护资源。该终点还允许将生化和凝血指标的改变与更广泛的全身性恶化模式相关联,而非局限于单一器官的结局进行评估。
本文介绍了一种可重复的入院生化-凝血评分方案,用于急性胰腺炎患者多器官功能障碍综合征的早期风险分层。该方案采用入院24小时内获得的常规实验室指标,对单位进行标准化统一,并规范缺失数据的处理方法,通过惩罚模型构建方法开发模型,最终将模型转化为临床可解读的综合评分。该方案的目的并非取代临床判断或现有的严重程度评估体系,而是提供一种透明、可复制的工作流程,帮助医疗机构将入院时的实验室数据整理为具有临床指导意义的风险信息。
方案
本研究方案经嘉兴学院附属嘉善县第一人民医院人类生物医学研究伦理委员会批准(批准号:2026 研究批准号 005;受理号:LW2026004;批准日期:2026 年 1 月 13 日)。由于本项回顾性研究使用的是去标识化的临床数据,因此豁免了个人知情同意的要求。在分析前,已删除姓名、医院识别编号、电话号码、住址和身份证号码等直接标识信息。数据处理遵循机构的数据保护要求以及《赫尔辛基宣言》10。
研究设计与多中心队列构建
本项回顾性多中心队列研究利用入院时的生化和凝血指标数据,建立了一种可重复的评分流程,用于急性胰腺炎(AP)患者早期多器官功能障碍综合征(MODS)的风险分层。AP的诊断依据以下三项标准中的至少两项:典型的腹痛、血清淀粉酶或脂肪酶水平达到正常上限的三倍以上,或符合AP的影像学表现。基线时间窗定义为入院后的最初24小时。对于每一项实验室预测指标,均采用该时间窗内最早符合条件的数值。在首次记录到MODS发作之后获得的数值,不用于预测模型的构建。
采用统一的筛选日志、入组标准核对清单、数据字典和终点裁定表格,对2023年1月1日至2025年12月20日期间来自参与中心的连续急性胰腺炎(AP)住院患者进行筛选。筛选日志记录了总共筛查的入院人数、重复入院、因AP诊断未确诊而排除的病例、年龄小于18岁、慢性胰腺炎、与胰腺恶性肿瘤相关的胰腺炎、入院时间不可靠、24小时实验室数据不可获取、终点记录不完整,以及最终纳入分析的队列。锁定后的筛选日志用于生成图1。在分析前,已将图1 中的患者数量与最终分析数据集进行核对。
分析队列锁定后,患者按7:3的比例被分配至训练队列和独立验证队列。队列划分使用R 4.3.2版本中的caret包(版本6.0-94)完成,随机种子固定为20260420。分层抽样依据MODS状态和研究中心进行。若各队列间研究中心分布差异超过5个百分点,则采用研究中心与MODS状态联合分层。队列分配结果在模型拟合前保存,之后不再修改。预处理规则、缺失值填补设置、模型调参、系数估计、评分构建及截断值选择均仅基于训练队列得出。独立验证队列仅用于锁定模型的评估。
纳入标准与入组流程
符合条件的患者为年龄≥18岁的成人,确诊为急性胰腺炎(AP),有可追溯的住院时间,在入院后24小时内至少进行过一次生化或凝血功能实验室检查,并具备完整的院内病历资料以供终点事件判定。若无法确诊AP、存在慢性胰腺炎或胰腺恶性肿瘤相关性胰腺炎,或首次住院时间无法可靠重建,则排除该患者。对于转院患者,若跨机构间无法追溯首次住院时间、首次实验室采样时间或早期器官功能障碍状态,亦予以排除。在研究期间同一患者多次入院的情况下,仅保留首次符合纳入标准的住院记录。每例被排除的病例均记录一个主要排除原因。
结局与终点事件裁定
主要结局为住院期间的多器官功能障碍综合征(MODS),定义为住院期间两个或以上器官系统出现功能障碍。器官功能障碍的评估依据电子病历中的呼吸、心血管、肾脏、肝脏、凝血及神经系统记录。在模型建立之前,各研究中心均采用相同的预先指定的器官系统标准,用于终点事件裁定的操作标准详见补充表1。
两名经过培训的评审员独立评估了每份去标识化的病历,所依据的资料包括入院记录、病程记录、重症监护室记录、操作记录、实验室报告、生命体征记录以及出院小结。裁决表记录了患者研究编号、受累器官系统、来源记录、发病日期和时间、支持性的实验室或生理学数值、评审员判断以及最终裁决状态。评审员之间达成一致的结果即被接受为最终结论;存在分歧时,由第三位高级评审员进行裁决。次要结局包括入住重症监护室、有创或无创机械通气、肾脏替代治疗、住院期间死亡、感染性坏死或引流操作,以及住院时间。住院时间的计算方式为出院日期减去入院日期再加1天。
入院时的候选预测因子
候选预测因子仅限于入院后24小时内可获得的常规检测指标。在24小时时间窗内重复检测的结果,保留最早符合条件的数值。生化指标包括白细胞计数、C反应蛋白、有检测结果时的降钙素原、乳酸、葡萄糖、总钙、血尿素氮、肌酐、丙氨酸氨基转移酶、总胆红素、白蛋白和乳酸脱氢酶。凝血相关指标包括血小板计数、凝血酶原时间、凝血酶原时间-国际标准化比值(INR)、活化部分凝血活酶时间、纤维蛋白原和D-二聚体。
收集了用于病例组合描述和基准评分计算的基线临床变量。这些变量包括年龄、性别、体重指数、症状出现至入院时间、急性胰腺炎病因、吸烟状况、既往胰腺炎病史、合并症、入院时心率、平均动脉压、全身炎症反应综合征状态、急性胰腺炎严重程度床旁指数评分、急性生理与慢性健康状况评估II评分以及序贯器官衰竭评估评分。当凝血酶原时间和凝血酶原时间国际标准化比值均可用时,建模使用凝血酶原时间国际标准化比值,而凝血酶原时间保留用于描述性报告。提取文件中每条记录对应一次住院,包含中心代码、患者研究代码、入院时间、采样时间、原始值、原始单位、标准化值、标准化单位、来源表及缺失标志。
各中心间的实验室检测标准化
所有实验室检测变量在分析前均转换为预设的目标单位:白细胞计数和血小板计数,109/L;C反应蛋白,mg/L;降钙素原,ng/mL;乳酸、葡萄糖、总钙和血尿素氮,mmol/L;肌酐和总胆红素,µmol/L;丙氨酸氨基转移酶和乳酸脱氢酶,U/L;白蛋白和纤维蛋白原,g/L;凝血酶原时间和活化部分凝血活酶时间,秒;凝血酶原时间-国际标准化比值,无量纲比值;D-二聚体,mg/L 纤维蛋白原当量单位。以 µg/mL 纤维蛋白原当量单位报告的 D-二聚体数值通过 1:1 的数值换算转换为 mg/L 纤维蛋白原当量单位。以 D-二聚体单位(D-dimer units)报告的数值仅在本地实验室提供经验证的换算系数时进行转换;未提供经验证换算系数的数值在建模时视为缺失值。
在合并数据前,对每个中心的报告单位、参考范围、检测记录和分析仪备注进行了审核。标准化文件保留了原始单位、目标单位、转换规则以及负责核查转换的审核人员信息。在主要分析中,实验室数值未根据各中心特定的参考范围进行标准化,因为评分旨在使用绝对的临床数值。在填补和敏感性分析过程中保留了中心代码。对于非负性检测出现的负值、单位不兼容、时间戳超出24小时窗口期以及源记录不支持的数值,均予以标记。仅当源记录确认存在转录错误或单位转换错误时,才对数值进行修正;否则,将其设为缺失值。
数据预处理与缺失数据处理
在模型拟合前,按变量、研究中心和MODS状态对缺失情况进行汇总。若候选预测因子的整体缺失率超过30%,或在任一单一研究中心的缺失率超过50%,则在模型构建中予以排除。若患者的候选预测因子中缺失比例超过40%,或主要结局无法判定,则该患者被排除在建模数据集之外。
连续型预测变量在开发队列中基于第1和第99百分位数进行缩尾处理。相同的阈值被应用于独立验证队列。验证数据中不再重新估算这些阈值。经过缩尾处理后偏度仍大于2的变量采用自然对数转换;对于可能包含零值的变量,使用log(x + 0.01)进行转换。连续型预测变量使用开发队列的均值和标准差进行标准化,相同的参数也应用于验证数据。
采用 R 语言中的 mice 软件包(版本 3.16.0)通过链式方程进行多重插补。每个数据集生成 20 个插补数据集,每数据集迭代 20 次。连续变量使用预测均值匹配法,二分类变量使用逻辑回归,名义分类变量使用多项逻辑回归。插补模型中包含候选预测因子、中心代码、队列指示符以及 MODS 状态,用于模型构建。验证结果未用于修改预处理规则、变量入选标准或阈值。当报告回归估计值时,采用 Rubin 法则进行合并。预测指标在每个插补数据集中分别计算,并以合并估计值或中位数估计值及相应范围进行汇总。预先设定两项敏感性分析:完整病例分析,使用无最终模型预测因子缺失的患者数据;基线值分析,采用 24 小时内最差的合格实验室检测值而非最早值。
统计分析与模型构建
在模型构建队列和独立验证队列中分别总结基线特征。连续变量以均值 ± 标准差或中位数(四分位间距)表示,分类变量以例数(百分比)表示。比较发生与未发生多器官功能障碍综合征(MODS)患者入院时的生化及凝血指标。连续变量采用 Student t 检验或 Wilcoxon 秩和检验,分类变量采用卡方检验或 Fisher 精确检验。这些 P 值仅用于描述性分析,不单独用于预测因子的筛选。
模型开发仅限于开发队列。由于事件数量有限且实验室预测变量之间存在相关性,为减少过拟合,主要采用惩罚性逻辑回归模型。该模型使用 R 4.3.2 版本中的 glmnet 4.1-8 版本包进行拟合,分布族设定为二项分布,预测变量经过标准化处理,并采用最小绝对收缩与选择算子(LASSO)惩罚方法(alpha = 1)。通过重复10次的10折交叉验证进行惩罚参数调优,随机种子固定为20260420。惩罚参数的选择依据“一标准误规则”。保存了系数路径、交叉验证误差值、选定的惩罚参数以及保留的预测变量。分析流程见图2。本方案中使用的软件、统计包、数据库系统和实验室平台列于材料表中。
在经过惩罚性筛选后,未将未惩罚的逻辑回归作为主要推断模型。若报告比值比以用于临床解释,则将其标注为筛选后描述性估计值。使用受试者工作特征曲线下面积评估区分度,并采用 pROC 软件包 1.18.5 版本中的 DeLong 方法计算 95% 置信区间。校准度通过校准截距、校准斜率、Brier 得分及校准图进行评估。在开发队列中,采用含 1,000 次重复的自助法重采样来估计经乐观校正后的模型性能。决策曲线分析未保留在修订后的分析集中;因此, manuscript 中删除了关于临床净收益的结论。
评分的推导与解读
基于入院时生化与凝血指标的积分式综合评分,是根据锁定的惩罚模型系数推导得出。模型拟合过程中使用的是连续性变量。仅在模型最终确定后,为便于床旁计算,才引入分类阈值。这些阈值依据既定的临床参考范围、实验室常用的异常阈值,或在验证前于开发队列中根据系数确定的切点来选定。阈值未在验证队列中进行优化。
根据锁定系数的方向和相对大小分配整数分值。分值越高,提示实验室指标异常越严重。总分通过将保留的各组分分值相加计算得出。预设的风险等级仅用于风险分层,不用于定义多器官功能障碍综合征(MODS)。该评分旨在识别可能需要更密切观察、重复实验室检查或启动器官支持通路准备的患者。该评分并非作为独立的诊断标准、抗凝治疗的触发条件,也不能替代临床医生的重新评估。
保留验证与基准评估
将锁定的预处理规则、填补结构、缩尾处理阈值、标准化参数、模型系数、评分规则和预设的截断值应用于保留验证队列。未进行进一步的预测变量筛选、模型重新拟合、系数再校准或阈值优化。验证性能通过区分度、校准度、Brier得分、灵敏度、特异度、阳性预测值和阴性预测值进行总结。
在数据可获取的情况下,采用相同的入院时间窗计算已建立的严重程度评估工具,包括急性胰腺炎床旁严重程度指数、急性生理与慢性健康状况评分Ⅱ、序贯器官衰竭评估评分、Ranson评分、无害性急性胰腺炎评分以及全身炎症反应综合征标准。比较分析使用了相同的终点指标、分析人群和验证框架。配对的曲线下面积比较采用DeLong检验进行。
所有验证图和按评分分层的图均基于锁定的分析数据集生成。在制图前,已根据最终分析队列、开发队列、独立验证队列或预先规定的评分分层核对每张图中各图示部分的样本量。针对高维组学、生态计数数据或差异丰度分析设计的可视化方法未用于常规临床检验数据。
结果
队列特征与基线可比性
共纳入300例急性胰腺炎患者进入最终分析队列。根据预先设定的7:3分层保留拆分方法,将210例患者分配至开发队列,90例患者分配至保留验证队列。所有纳入患者均在入院后24小时内具有合格的生化和凝血指标检测结果。
基线特征见表1。开发队列与保留验证队列在年龄(54.0年 ± 16.4年 vs 55.3年 ± 15.2年,P = 0.486)、性别分布(男性:61.9% vs 61.1%,P = 0.898)、体重指数(25.0 [22.6–27.9] kg/m2 vs 24.7 [22.2–27.5] kg/m2,P = 0.293)、症状出现至入院时间(13.2 [7.1–22.6] h vs 12.8 [6.8–21.7] h,P = 0.612)以及急性胰腺炎病因(P = 0.931)方面相似。合并症、入院时生命体征、全身炎症反应综合征状态、急性胰腺炎严重程度床旁指数评分、序贯器官衰竭评估评分,以及所列的入院时生化和凝血指标在两组间也基本平衡。上述比较证实,保留验证集的划分未引入具有临床意义的基线不平衡。
按 MODS 状态划分的入院时生化与凝血指标
在 300 例患者中,50 例在住院期间发生多器官功能障碍综合征(MODS),250 例未发生。按 MODS 状态划分的入院时生化与凝血指标总结于表 2。与未发生 MODS 的患者相比,发生 MODS 的患者白细胞计数更高(14.4 × 10⁹/L ± 5.2 × 10⁹/L vs 12.3 × 10⁹/L ± 4.6 ×10⁹/L,P = 0.008)、中性粒细胞-淋巴细胞比值更高(13.4 [9.1–21.3] vs 9.0 [5.9–14.2],P < 0.001)、C 反应蛋白水平更高(138.6 [86.9–226.7] mg/L vs 61.4 [29.2–123.8] mg/L,P < 0.001)、降钙素原水平更高(1.25 [0.56–3.28] ng/mL vs 0.43 [0.18–1.02] ng/mL,P < 0.001)、乳酸水平更高(2.7 [2.0–4.0] mmol/L vs 1.7 [1.2–2.4] mmol/L,P = 0.004)以及血糖水平更高(11.2 [8.9–15.1] mmol/L vs 8.9 [7.3–11.4] mmol/L,P = 0.010)。
MODS 组的钙水平也较低(1.96 mmol/L ± 0.21 mmol/L vs 2.06 mmol/L ± 0.17 mmol/L, P = 0.013)和白蛋白(32.5 g/L ± 5.6 g/L vs 35.9 g/L ± 4.8 g/L, P < 0.001),以及更高的血尿素氮水平(9.4 [7.4–13.2] mmol/L vs 6.6 [5.1–8.9] mmol/L, P < 0.001),肌酐(108.9 [84.7–163.4] µmol/L vs 77.1 [62.4–97.6] µmol/L, P < 0.001)、总胆红素(22.1 [14.2–38.9] µmol/L 对比 18.6 [12.3–31.7] µmol/L, P = 0.038),以及乳酸脱氢酶(372.4 [289.8–512.3] U/L vs 254.6 [203.2–329.1] U/L, P < 0.001)。MODS组的凝血酶原时间、凝血酶原时间-国际标准化比值、活化部分凝血活酶时间及D-二聚体水平也更高。血小板计数(P = 0.096)和纤维蛋白原(P 组间差异无统计学意义(= 0.268)。这些比较仅为描述性分析,未单独用于预测因子的筛选。
早期结局模式及与评分相关的变化趋势
根据多器官功能障碍综合征状态划分的粗略临床结局见图3。发生多器官功能障碍综合征的患者相较于未发生者住院时间更长(图3A)。此外,这些患者进入重症监护病房的比例更高(图3B)、接受机械通气(图3C)、接受肾脏替代治疗(图3D)、发生感染性坏死或接受引流手术(图3E)以及院内死亡率(图3F)也更高。所有图表数据均来自最终确定的300例患者分析队列。
预先设定的基于评分的复合评分分层中观察到的临床结局见图4。多器官功能障碍综合征的发生率在低危、中危、高危和极高危组之间呈逐步升高趋势(图4A)。重症监护病房收治率(图4B)、住院死亡率(图4C)以及感染性坏死或引流操作的发生率(图4D)也呈现类似的递增趋势。住院时间在四个评分分层中亦依次延长(图4E)。其中,多器官功能障碍综合征发生率和重症监护病房收治率的梯度变化最为显著。所有图表均基于锁定的分析数据集,采用预先设定的评分类别生成。
基于评分点的综合评分在修订版亚特兰大严重程度分类中的分布情况如图5所示。轻度、中度重度和重度急性胰腺炎患者的中位综合评分依次逐步升高,表明入院时的生化-凝血评分与既定的临床严重程度分类具有一致性。图5基于同一组已锁定的300例患者分析队列生成。未使用排序分析、差异丰度分析、火山图、q值、Bray–Curtis距离或主坐标分析等可视化方法。
惩罚模型的构建及保留的预测因子
惩罚模型的构建仅在开发队列中进行。图6A展示了候选入院预测因子的系数变化轨迹,用于选择惩罚参数的重复10折交叉验证曲线见图6B。采用“一个标准误规则”选定惩罚参数后,最小绝对收缩与选择算子(least absolute shrinkage and selection operator)惩罚方法保留了九项入院预测因子:白蛋白(albumin)、血尿素氮(blood urea nitrogen)、肌酐(creatinine)、钙(calcium)、乳酸脱氢酶(lactate dehydrogenase)、凝血酶原时间-国际标准化比值(prothrombin time–international normalized ratio)、D-二聚体(D-dimer)、血小板计数(platelet count)和葡萄糖(glucose)。
保留的预测因子及选择后描述性估计值见表3。这些估计值旨在辅助临床解释,并未在经过惩罚性选择后被视为确证性推断。关联方向具有临床一致性:白蛋白降低、血尿素氮升高、肌酐升高、钙降低、乳酸脱氢酶升高、凝血酶原时间-国际标准化比值升高、D-二聚体升高、血小板计数降低以及血糖升高均与更高的多器官功能障碍综合征(MODS)风险相关。选择后描述性估计值如下:白蛋白每降低5 g/L,比值比为1.29(95%置信区间1.13–1.47);血尿素氮每升高1 mmol/L,比值比为1.12(1.06–1.18);肌酐每升高10 µmol/L,比值比为1.05(1.02–1.09);钙每降低0.1 mmol/L,比值比为1.18(1.07–1.30);乳酸脱氢酶每升高100 U/L,比值比为1.21(1.07–1.37);凝血酶原时间-国际标准化比值每升高0.1,比值比为1.14(1.05–1.25);D-二聚体每升高1.0 mg/L纤维蛋白原当量单位,比值比为1.09(1.02–1.17);血小板计数每降低50 × 109/L,比值比为1.16(1.01–1.34);血糖每升高1 mmol/L,比值比为1.05(1.00–1.10)。
基于评分的综合评分构建
用于构建基于评分的入院生化-凝血综合评分的规则见表4。该评分源自锁定的惩罚模型系数,并被转化为临床可解释的类别,以便在床旁进行计算。白蛋白、血尿素氮、肌酐、钙、乳酸脱氢酶、凝血酶原时间、国际标准化比值、D-二聚体和血小板计数共八个变量被纳入作为评分的核心组成部分。葡萄糖因其对模型的贡献小于核心生化和凝血变量而被保留为可选的修正因子,尽管其与多器官功能障碍综合征的关联方向仍与锁定模型保持一致。
一个包含锁定惩罚模型所保留的全部九个预测因子的列线图如图所示 图7列线图为基于入院时的白蛋白、尿素氮、肌酐、钙、乳酸脱氢酶、凝血酶原时间-国际标准化比值、D-二聚体、血小板计数和血糖值,提供了个体化预测多器官功能障碍综合征概率的评估工具。该列线图被用作解释性辅助手段,而基于评分的复合评分仍作为主要的临床床旁实用工具,因其可直接通过常规入院实验室检测指标进行计算。
模型性能与内部验证
开发队列和保留验证队列中的模型性能见表5。在开发队列中,带有惩罚项的惩罚逻辑回归模型的受试者工作特征曲线下面积为0.873(95%置信区间0.820–0.926),在保留验证队列中为0.836(0.751–0.921)。开发队列中的Brier评分为0.117,保留验证队列中为0.139。开发队列的校准截距和斜率分别为0.04(−0.08–0.16)和0.97(0.79–1.18),保留验证队列中分别为0.08(−0.14–0.30)和0.91(0.68–1.15)。
在预先设定的预测风险阈值0.18处,该模型在开发队列中的敏感性和特异性分别为0.82和0.77,在保留验证队列中分别为0.75和0.74。在开发队列中,阳性预测值和阴性预测值分别为0.39和0.96,在保留验证队列中分别为0.39和0.93。基于评分的复合评分相较于锁定的惩罚模型显示出较低的区分能力,但仍保持了有用的筛查性能,在开发队列和保留验证队列中,受试者工作特征曲线下面积(AUC)分别为0.823和0.783。在预先设定的≥8分的评分阈值下,该评分在开发队列和保留验证队列中的阴性预测值分别为0.93和0.91。
与已建立的严重程度评分进行基准比较
与已建立的严重程度评估工具的基准比较结果见表6。在两个队列中,锁定入院生化-凝血模型的区分能力均高于Ranson评分、无害性急性胰腺炎评分以及全身性炎症反应综合征标准。在开发队列中,该模型与Sequential Organ Failure Assessment评分(通过DeLong检验,P = 0.12)相比无显著差异,但其区分能力高于Acute Physiology and Chronic Health Evaluation II评分(P = 0.03)、急性胰腺炎严重程度床旁指数评分(P = 0.01)、Ranson评分(P < 0.001)、无害性急性胰腺炎评分(P < 0.001)以及全身性炎症反应综合征标准(P < 0.001)。在独立验证队列中,该模型与Sequential Organ Failure Assessment评分(P = 0.34)、Acute Physiology and Chronic Health Evaluation II评分(P = 0.08)以及急性胰腺炎严重程度床旁指数评分(P = 0.05)相比差异无统计学意义,但与Ranson评分(P = 0.02)、无害性急性胰腺炎评分(P = 0.01)以及全身性炎症反应综合征标准(P = 0.02)相比仍具有统计学显著性差异。
基于点数评分的风险分层
风险分层结果如表7所示。患者被分为低风险(0–4分)、中风险(5–8分)、高风险(9–12分)和极高风险(≥13分)四组。多器官功能障碍综合征(MODS)的发生率从低风险组的3.5%(4/115)依次上升至中风险组的8.9%(9/101)、高风险组的33.3%(20/60)和极高风险组的70.8%(17/24)。重症监护病房(ICU)入住率在四组中分别为8.7%、23.8%、60.0%和83.3%。院内死亡率从低风险组的0.9%上升至中风险组的2.0%、高风险组的10.0%和极高风险组的25.0%;感染性坏死或引流发生率则从2.6%上升至8.9%、23.3%和33.3%。住院时间中位数从低风险组的7.6(5.2–10.4)天,依次增加至较高风险组的11.4(8.0–16.5)天、18.6(13.0–26.8)天和24.9(17.5–37.2)天。
敏感性分析
敏感性分析的结果总结于补充表2中。这些分析用于评估主要研究结果是否依赖于缺失数据的处理方式或基线值的赋值方法。在完整病例分析中,保留的预测因子及其关联方向与主要的插补分析结果一致。判别能力仅有轻微变化,在开发队列和独立验证队列中,受试者工作特征曲线下面积分别为0.861和0.821。在基线值敏感性分析中,采用入院后24小时内最差的合格实验室数值替代最早数值时,模型在开发队列和独立验证队列中的受试者工作特征曲线下面积分别为0.879和0.829。在两种敏感性分析中,按评分分层的多器官功能障碍综合征(MODS)发病率在低危、中危、高危和极高危组之间仍保持有序递增。这些结果表明,预先设定的不同数据预处理方案并未对入院生化-凝血检测流程的总体结论产生实质性影响。
数据可用性:
用于重现主要分析的去标识化数据集,以及数据字典、单位转换表和分析脚本,已存入Figshare,唯一数据标识符为 https://doi.org/10.6084/m9.figshare.32565768.v1。在数据提交前,已移除直接的患者标识信息,中心标识符也已根据机构数据保护要求进行编码。该存储库包含重现本论文中报告的队列描述、预测变量预处理、模型开发、评分构建、保留验证、基准分析、敏感性分析及图表级结果所需的所有文件。
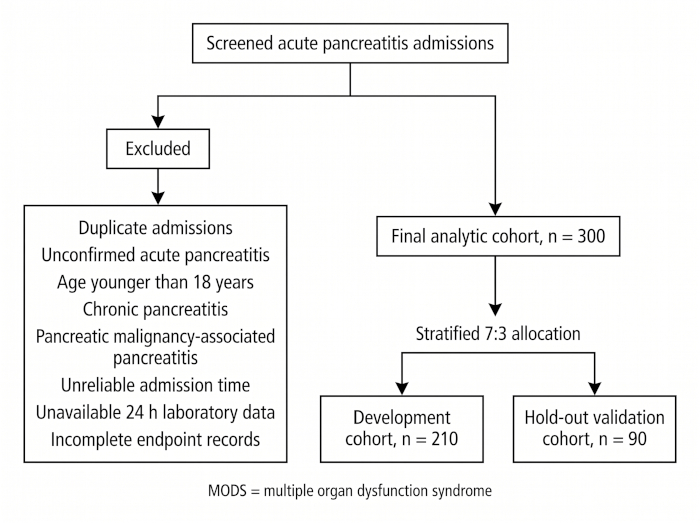
图1:患者筛选与队列分配。该流程图展示了参与中心连续收治的急性胰腺炎患者筛选情况、排除原因、最终分析队列,以及按7:3比例分层分配至开发队列和保留验证队列的情况。开发队列包含210例患者,保留验证队列包含90例患者。MODS表示多器官功能障碍综合征。请点击此处查看该图的放大版本。
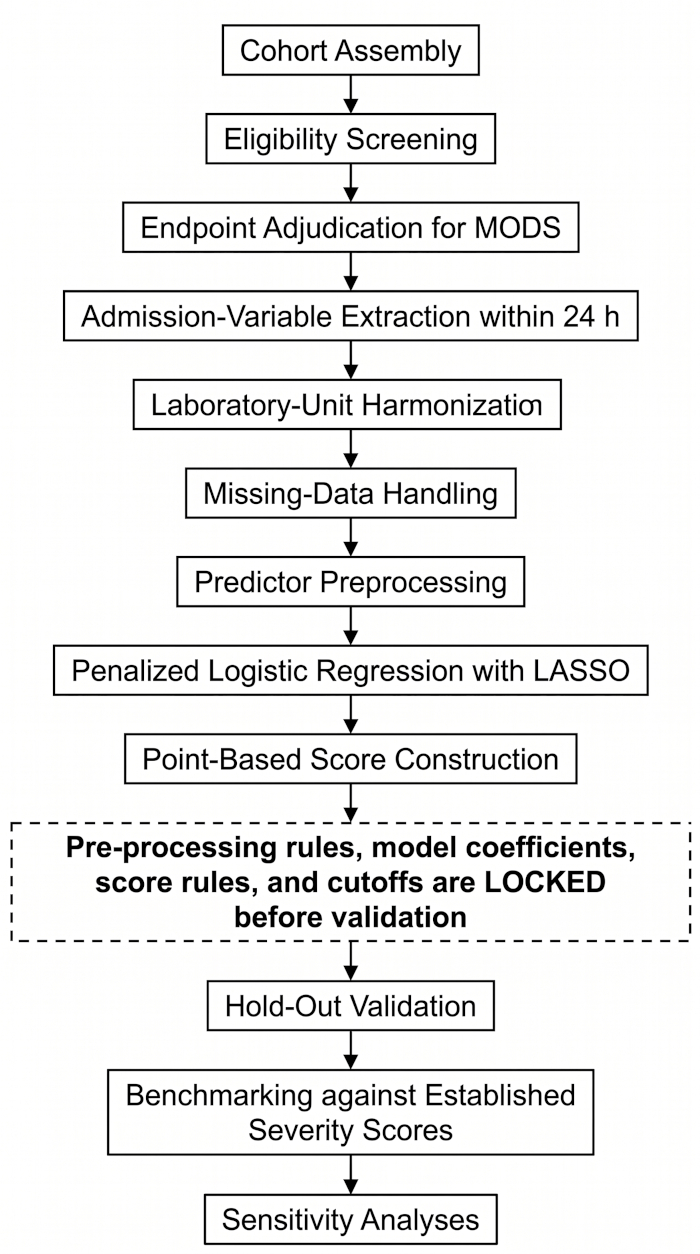
图2:入院生化-凝血评分开发的可重复分析工作流程。该示意图总结了队列构建、资格筛选、终点判定、入院变量提取、实验室单位标准化、缺失数据处理、预测因子预处理、惩罚模型开发、基于积分的评分构建以及锁定的独立验证。所有预处理规则、模型系数、评分构建步骤和截断值定义均在开发队列中确定,随后在独立验证队列中进行评估。请点击此处查看该图的放大版本。
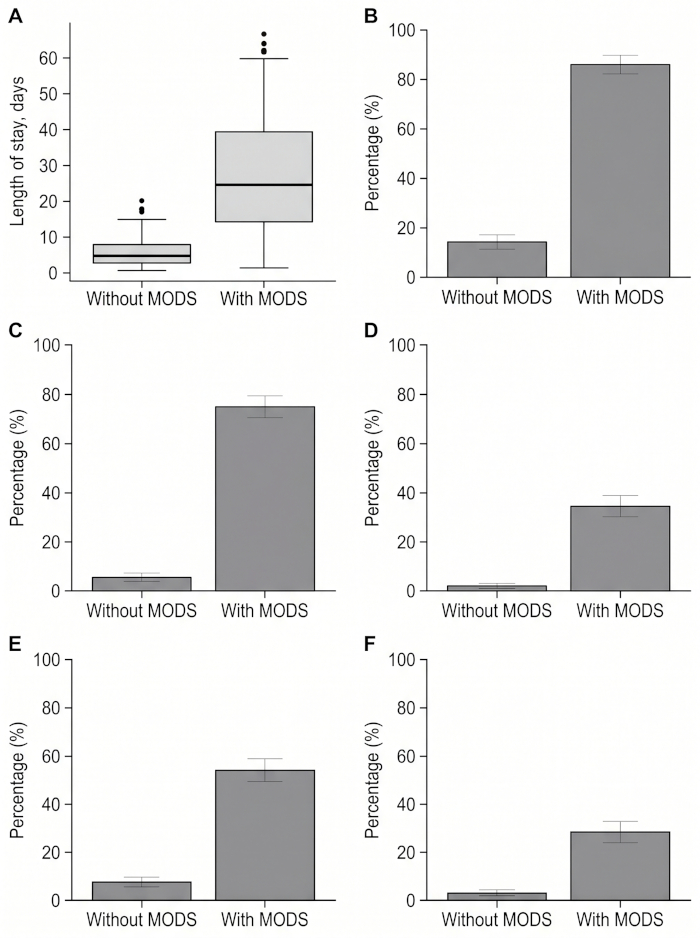
图 3:根据多器官功能障碍综合征状态划分的粗临床结局。(A)未合并与合并多器官功能障碍综合征患者的住院时长。(B)根据多器官功能障碍综合征状态划分的重症监护病房收治率。(C)根据多器官功能障碍综合征状态划分的机械通气使用率。(D)根据多器官功能障碍综合征状态划分的肾脏替代治疗使用率。(E)根据多器官功能障碍综合征状态划分的感染性坏死或引流手术发生率。(F)根据多器官功能障碍综合征状态划分的院内死亡率。所有图表均基于锁定的300例患者分析队列生成。MODS 表示多器官功能障碍综合征;ICU 表示重症监护病房。请点击此处查看该图的高清版本。
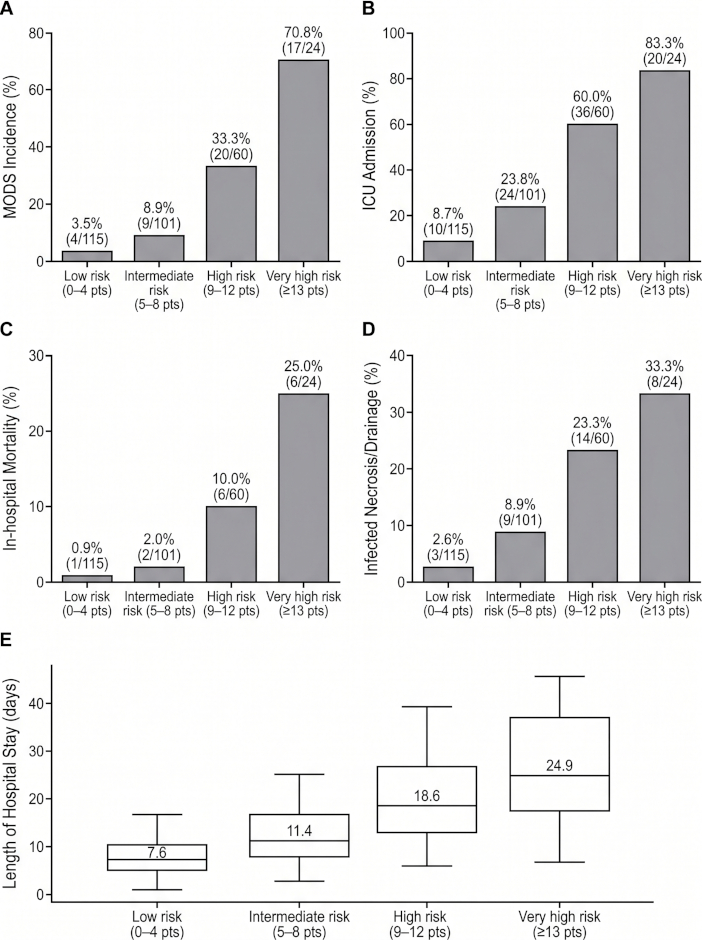
图4:基于评分分层的复合评分所观察到的结局发生率。(A)低、中、高和极高风险组中多器官功能障碍综合征的发生率。(B)四个评分分层中重症监护病房(ICU)入住率。(C)四个评分分层中院内死亡率。(D)四个评分分层中感染性坏死或引流操作的发生率。(E)四个评分分层中住院时间。所有图表均基于锁定的分析数据集生成,采用预先设定的评分分类:低风险(0–4分)、中风险(5–8分)、高风险(9–12分)和极高风险(≥13分)。MODS表示多器官功能障碍综合征;ICU表示重症监护病房。请点击此处查看本图的放大版本。
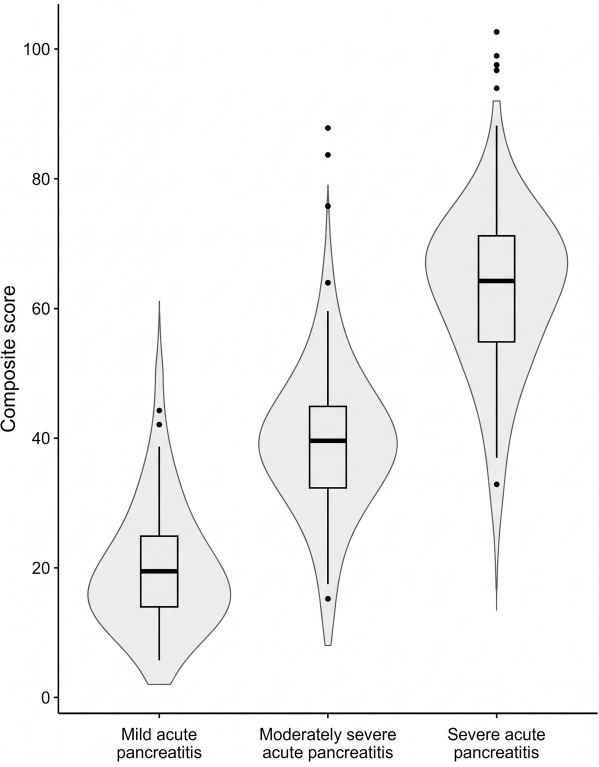
图 5:基于评分的综合评分在修订版亚特兰大严重程度分类中的分布情况。本图展示了轻度、中度重度及重度急性胰腺炎患者的综合评分分布。综合评分在三类严重程度中呈逐步升高趋势,表明入院时的生化–凝血评分与修订版亚特兰大严重程度分类具有一致性。该图基于锁定的300例患者分析队列生成。AP表示急性胰腺炎。请点击此处查看该图的放大版本。
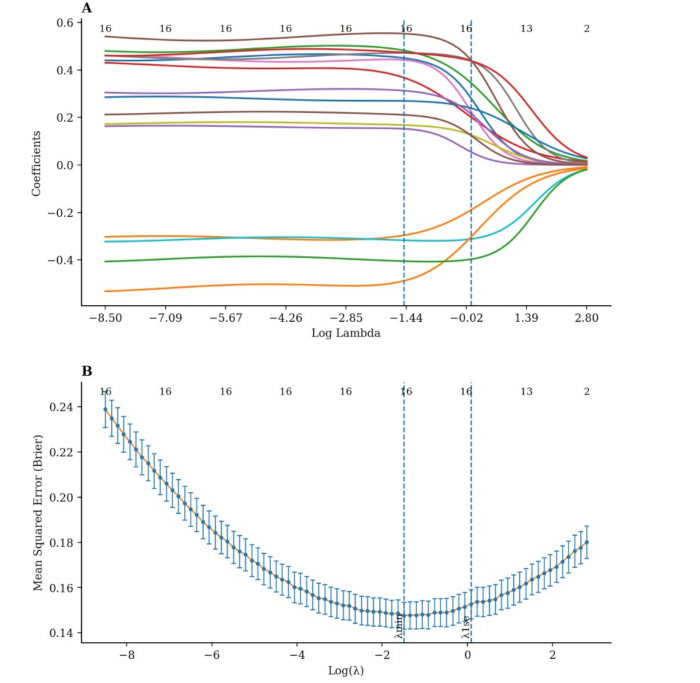
图6:开发队列中的惩罚模型构建。(A)候选入院生化与凝血预测因子的最小绝对收缩与选择算子(LASSO)系数变化轨迹。(B)采用重复10折交叉验证结果选择惩罚参数,并应用“一标准误规则”获得一个简洁的锁定模型,用于评分构建及独立验证。LASSO 表示最小绝对收缩与选择算子;PT-INR 表示凝血酶原时间国际标准化比值。请点击此处查看该图的放大版本。
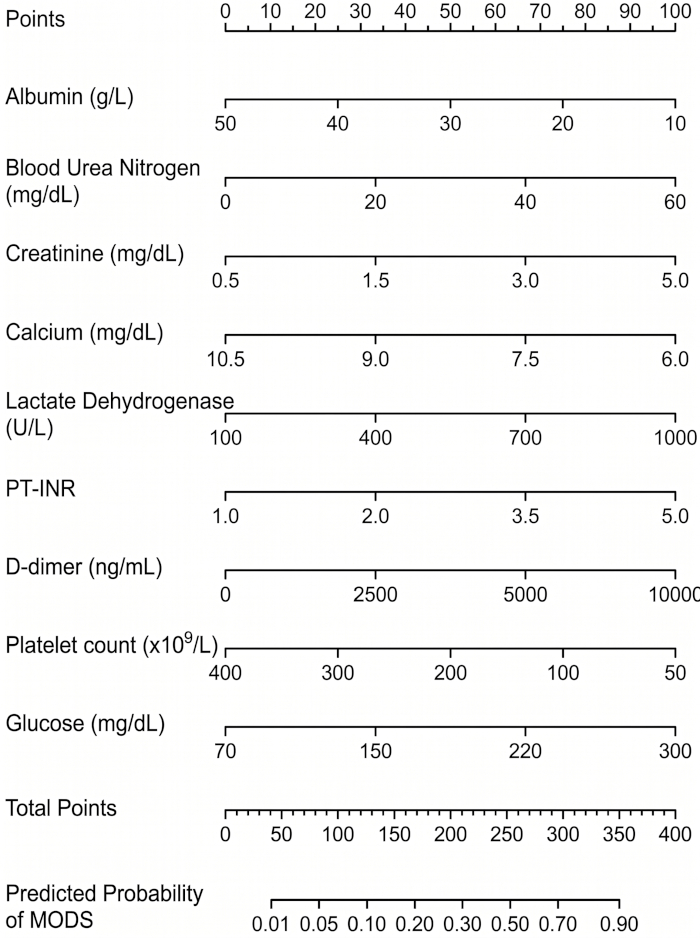
图7:基于锁定预测模型的个体化风险评估列线图。该列线图纳入了经锁定的惩罚模型保留的九项入院预测因子:白蛋白、血尿素氮、肌酐、钙、乳酸脱氢酶、凝血酶原时间-国际标准化比值(PT-INR)、D-二聚体、血小板计数和葡萄糖。每个预测因子贡献一定分数,总分对应于多器官功能障碍综合征(MODS)的估计概率。列线图作为解释性辅助工具提供,而基于评分的综合评分仍是主要的临床床旁实用工具。MODS 表示多器官功能障碍综合征;PT-INR,凝血酶原时间-国际标准化比值;FEU,纤维蛋白原当量单位。请点击此处查看该图的放大版本。
| 变量 | 开发队列 n=210 | 独立验证队列 n=90 | P 值 |
| 年龄,年 | 54.0 ± 16.4 | 55.3 ± 15.2 | 0.486 |
| 男性,n (%) | 130 (61.9) | 55 (61.1) | 0.898 |
| 体重指数,kg/m² | 25.0 (22.6–27.9) | 24.7 (22.2–27.5) | 0.293 |
| 症状出现至入院时间,h | 13.2 (7.1–22.6) | 12.8 (6.8–21.7) | 0.612 |
| 病因,n (%) | 0.931 | ||
| 胆源性 | 89 (42.4) | 38 (42.2) | |
| 高甘油三酯血症 | 65 (31.0) | 29 (32.2) | |
| 酒精相关性 | 19 (9.0) | 8 (8.9) | |
| 特发性 | 25 (11.9) | 11 (12.2) | |
| 其他 | 12 (5.7) | 4 (4.4) | |
| 既往胰腺炎病史,n (%) | 31 (14.8) | 12 (13.3) | 0.742 |
| 吸烟史,n (%) | 58 (27.6) | 24 (26.7) | 0.868 |
| 糖尿病,n (%) | 37 (17.6) | 17 (18.9) | 0.795 |
| 高血压,n (%) | 62 (29.5) | 28 (31.1) | 0.784 |
| 慢性肾病,n (%) | 8 (3.8) | 4 (4.4) | 0.797 |
| 入院心率,次/分钟 | 92.4 ± 15.8 | 93.1 ± 16.2 | 0.726 |
| 平均动脉压,mmHg | 88.6 ± 12.4 | 87.9 ± 11.8 | 0.65 |
| 全身炎症反应综合征,n (%) | 72 (34.3) | 30 (33.3) | 0.871 |
| 急性胰腺炎严重程度床旁指数评分 | 1.0 (0.0–2.0) | 1.0 (0.0–2.0) | 0.842 |
| 序贯器官衰竭评估评分 | 1.0 (0.0–2.0) | 1.0 (0.0–2.0) | 0.796 |
| 急性生理与慢性健康状况评分 II | 7.0 (5.0–10.0) | 7.0 (5.0–10.0) | 0.884 |
| 多器官功能障碍综合征,n (%) | 35 (16.7) | 15 (16.7) | 1 |
| 白细胞计数,×10⁹/L | 12.8 ± 4.7 | 12.9 ± 4.9 | 0.865 |
| C-反应蛋白,mg/L | 70.6 (32.8–141.5) | 72.4 (35.1–145.9) | 0.778 |
| 葡萄糖,mmol/L | 9.1 (7.4–11.8) | 9.0 (7.2–11.6) | 0.691 |
| 总钙,mmol/L | 2.05 ± 0.18 | 2.04 ± 0.19 | 0.672 |
| 血尿素氮,mmol/L | 6.9 (5.2–9.4) | 7.1 (5.3–9.6) | 0.584 |
| 肌酐,μmol/L | 80.2 (64.5–104.8) | 81.1 (65.1–106.2) | 0.731 |
| 白蛋白,g/L | 35.2 ± 5.1 | 35.0 ± 5.0 | 0.754 |
| 乳酸脱氢酶,U/L | 270.8 (212.5–356.7) | 275.6 (216.2–361.4) | 0.637 |
| 凝血酶原时间-国际标准化比值 | 1.09 (1.02–1.18) | 1.10 (1.03–1.19) | 0.694 |
| D-二聚体,mg/L 纤维蛋白原当量单位 | 1.84 (0.92–3.82) | 1.91 (0.95–3.96) | 0.744 |
| 血小板计数,×10⁹/L | 203.6 ± 68.4 | 201.8 ± 66.9 | 0.836 |
表1:开发队列与保留验证队列患者的基本特征。 比较了开发队列与保留验证队列之间的基线人口统计学、临床、严重程度评分、生化及凝血相关变量。连续变量以均值±标准差或中位数(四分位间距)表示,分类变量以n(%)表示。P 值用于队列间的描述性比较。
| 变量 | 非MODS组 n = 250 | MODS组 n = 50 | P值 |
| 白细胞计数,×10⁹/L | 12.3 ± 4.6 | 14.4 ± 5.2 | 0.008 |
| 中性粒细胞与淋巴细胞比值 | 9.0 (5.9–14.2) | 13.4 (9.1–21.3) | <0.001 |
| C反应蛋白,mg/L | 61.4 (29.2–123.8) | 138.6 (86.9–226.7) | <0.001 |
| 降钙素原,ng/mL | 0.43 (0.18–1.02) | 1.25 (0.56–3.28) | <0.001 |
| 乳酸,mmol/L | 1.7 (1.2–2.4) | 2.7 (2.0–4.0) | 0.004 |
| 葡萄糖,mmol/L | 8.9 (7.3–11.4) | 11.2 (8.9–15.1) | 0.01 |
| 总钙,mmol/L | 2.06 ± 0.17 | 1.96 ± 0.21 | 0.013 |
| 血尿素氮,mmol/L | 6.6 (5.1–8.9) | 9.4 (7.4–13.2) | <0.001 |
| 肌酐,μmol/L | 77.1 (62.4–97.6) | 108.9 (84.7–163.4) | <0.001 |
| 丙氨酸氨基转移酶,U/L | 46.2 (25.6–93.8) | 58.7 (31.5–119.4) | 0.084 |
| 总胆红素,μmol/L | 18.6 (12.3–31.7) | 22.1 (14.2–38.9) | 0.038 |
| 白蛋白,g/L | 35.9 ± 4.8 | 32.5 ± 5.6 | <0.001 |
| 乳酸脱氢酶,U/L | 254.6 (203.2–329.1) | 372.4 (289.8–512.3) | <0.001 |
| 血小板计数,×10⁹/L | 207.4 ± 67.2 | 190.3 ± 72.5 | 0.096 |
| 凝血酶原时间,s | 12.7 (11.8–13.9) | 14.1 (12.9–15.7) | 0.002 |
| 凝血酶原时间国际标准化比值 | 1.08 (1.02–1.16) | 1.22 (1.10–1.38) | 0.002 |
| 活化部分凝血活酶时间,s | 31.8 (28.4–36.5) | 36.9 (31.7–42.8) | 0.006 |
| 纤维蛋白原,g/L | 4.12 ± 1.18 | 4.31 ± 1.29 | 0.268 |
| D-二聚体,mg/L 纤维蛋白原当量单位 | 1.48 (0.78–3.16) | 4.62 (2.10–8.95) | <0.001 |
表2:根据多器官功能障碍综合征状态划分的入院时生化及凝血指标。 实验室指标代表入院后24小时内获得的最早合格检测值。连续变量以均值±标准差或中位数(四分位间距)表示。P 值用于描述发生多器官功能障碍综合征患者与未发生者之间的比较。这些比较用于表征入院时的差异,但不单独用于预测因子的筛选。
| 锁定模型中保留的预测因子 | 与较高 MODS 风险相关的方向 | 用于解释的标准化单位 | 描述性比值比 | 95% 置信区间 | 建模作用 |
| Albumin | 较低值 | 每降低 5 g/L | 1.29 | 1.13–1.47 | 核心评分组成部分 |
| Blood urea nitrogen | 较高值 | 每升高 1 mmol/L | 1.12 | 1.06–1.18 | 核心评分组成部分 |
| Creatinine | 较高值 | 每升高 10 μmol/L | 1.05 | 1.02–1.09 | 核心评分组成部分 |
| Total calcium | 较低值 | 每降低 0.1 mmol/L | 1.18 | 1.07–1.30 | 核心评分组成部分 |
| Lactate dehydrogenase | 较高值 | 每升高 100 U/L | 1.21 | 1.07–1.37 | 核心评分组成部分 |
| Prothrombin time-international normalized ratio | 较高值 | 每升高 0.1 | 1.14 | 1.05–1.25 | 核心评分组成部分 |
| D-dimer | 较高值 | 每升高 1.0 mg/L 纤维蛋白原当量单位 | 1.09 | 1.02–1.17 | 核心评分组成部分 |
| Platelet count | 较低值 | 每降低 50 × 10⁹/L | 1.16 | 1.01–1.34 | 核心评分组成部分 |
| Glucose | 较高值 | 每升高 1 mmol/L | 1.05 | 1.00–1.10 | 可选修饰因子 |
表3:锁定的惩罚模型保留的预测因子及选择后描述性估计值。 该表格展示了通过锁定的最小绝对收缩与选择算子惩罚逻辑回归模型所保留的预测因子,以及用于临床解释的选择后描述性估计值。比值比是针对所示的缩放单位给出的。这些估计值在经过惩罚选择后不被视为确证性推断。
| 评分项目 | 类别 | 赋分 |
| 白蛋白,g/L | ≥38 | 0 |
| 34–37.9 | 1 | |
| 30–33.9 | 2 | |
| <30 | 3 | |
| 血尿素氮,mmol/L | <6.5 | 0 |
| 6.5–8.9 | 1 | |
| 9.0–12.9 | 2 | |
| ≥13.0 | 3 | |
| 肌酐,μmol/L | <80 | 0 |
| 80–109 | 1 | |
| 110–169 | 2 | |
| ≥170 | 3 | |
| 总钙,mmol/L | ≥2.10 | 0 |
| 2.00–2.09 | 1 | |
| 1.90–1.99 | 2 | |
| <1.90 | 3 | |
| 乳酸脱氢酶,U/L | <250 | 0 |
| 250–349 | 1 | |
| 350–499 | 2 | |
| ≥500 | 3 | |
| 凝血酶原时间-国际标准化比值 | <1.10 | 0 |
| 1.10–1.19 | 1 | |
| 1.20–1.39 | 2 | |
| ≥1.40 | 3 | |
| D-二聚体,mg/L 纤维蛋白原当量单位 | <1.0 | 0 |
| 1.0–2.9 | 1 | |
| 3.0–5.9 | 2 | |
| ≥6.0 | 3 | |
| 血小板计数,×10⁹/L | ≥200 | 0 |
| 150–199 | 1 | |
| 100–149 | 2 | |
| <100 | 3 | |
| 葡萄糖,mmol/L | <10.0 | 0 |
| ≥10.0 | 1 |
表4:入院生化-凝血综合评分的构建。
基于锁定惩罚模型得出的点阵式综合评分,并将其转换为临床可解读的床旁分类。根据保留预测因子的方向及其相对贡献度分配相应点数。总点数通过累加所有保留的评分组分获得。由于葡萄糖与核心生化–凝血组分的关联较弱,但其风险方向仍保持一致,因此作为可选的调整因子予以保留。
| 工具 | 队列 | AUC | Brier 评分 | 校准截距 | 校准斜率 | 截断值 | 敏感性 | 特异性 | 阳性预测值 | 阴性预测值 |
| (95% CI) | (95% CI) | (95% CI) | ||||||||
| 锁定的惩罚模型 | 开发队列 | 0.873 (0.820–0.926) | 0.117 | 0.04 (−0.08 至 0.16) | 0.97 (0.79–1.18) | 预测风险 ≥0.18 | 0.82 | 0.77 | 0.39 | 0.96 |
| 锁定的惩罚模型 | 独立验证队列 | 0.836 (0.751–0.921) | 0.139 | 0.08 (−0.14 至 0.30) | 0.91 (0.68–1.15) | 预测风险 ≥0.18 | 0.75 | 0.74 | 0.39 | 0.93 |
| 基于评分的复合评分 | 开发队列 | 0.823 (0.758–0.888) | 0.132 | 不适用 | 不适用 | ≥8 分 | 0.76 | 0.72 | 0.35 | 0.93 |
| 基于评分的复合评分 | 独立验证队列 | 0.783 (0.684–0.882) | 0.151 | 不适用 | 不适用 | ≥8 分 | 0.7 | 0.69 | 0.31 | 0.91 |
表5:锁定惩罚模型与基于评分的复合评分的性能。 开发队列和独立验证队列中的区分能力、校准能力及基于阈值的性能如表所示。区分能力以受试者工作特征曲线下面积(95% 置信区间)表示。校准能力通过Brier评分、校准截距和校准斜率进行总结。阈值相关指标在预设的截断值下报告:锁定惩罚模型的预测风险 ≥0.18,基于评分的复合评分为 ≥8 分。
| 预测工具 | 开发集 AUC | DeLong P 值 vs 锁定模型 | 独立验证集 AUC | DeLong P 值 vs 锁定模型 |
| (95% CI) | (开发集) | (95% CI) | (验证集) | |
| 锁定的生化-凝血模型 | 0.873 (0.820–0.926) | 参照 | 0.836 (0.751–0.921) | 参照 |
| 序贯器官衰竭评估评分 | 0.842 (0.780–0.904) | 0.12 | 0.810 (0.712–0.908) | 0.34 |
| 急性生理与慢性健康评估 II 评分 | 0.812 (0.744–0.880) | 0.03 | 0.790 (0.682–0.898) | 0.08 |
| 急性胰腺炎严重程度床旁指数评分 | 0.795 (0.724–0.866) | 0.01 | 0.765 (0.648–0.882) | 0.05 |
| Ranson 评分 | 0.742 (0.661–0.823) | <0.001 | 0.701 (0.577–0.825) | 0.02 |
| 无害性急性胰腺炎评分 | 0.701 (0.618–0.784) | <0.001 | 0.688 (0.560–0.816) | 0.01 |
| 全身炎症反应综合征标准 | 0.684 (0.598–0.770) | <0.001 | 0.672 (0.541–0.803) | 0.02 |
表6:与现有严重程度评估工具的基准比较。 锁定的入院生化-凝血模型与基于相同入院时间窗计算的现有急性胰腺炎严重程度或器官功能障碍评估工具进行了比较(在数据可用的情况下)。展示了开发队列和独立验证队列中受试者工作特征曲线下面积及其95%置信区间。在每个队列中,采用配对DeLong检验将每种基准工具与锁定的生化-凝血模型进行比较。
| 风险等级 | 评分范围 | 患者数,n | 多器官功能障碍综合征发生率,n (%) | 重症监护病房入住,n | 机械通气,n (%) | 肾脏替代治疗,n (%) | 院内死亡率,n (%) | 感染性坏死或引流,n (%) | 住院时间,天 |
| (%) | |||||||||
| 低风险 | 0–4 | 115 | 4 (3.5) | 10 (8.7) | 3 (2.6) | 1 (0.9) | 1 (0.9) | 3 (2.6) | 7.6 (5.2–10.4) |
| 中等风险 | 5–8 | 101 | 9 (8.9) | 24 (23.8) | 9 (8.9) | 4 (4.0) | 2 (2.0) | 9 (8.9) | 11.4 (8.0–16.5) |
| 高风险 | 9–12 | 60 | 20 (33.3) | 36 (60.0) | 18 (30.0) | 10 (16.7) | 6 (10.0) | 14 (23.3) | 18.6 (13.0–26.8) |
| 极高风险 | ≥13 | 24 | 17 (70.8) | 20 (83.3) | 13 (54.2) | 7 (29.2) | 6 (25.0) | 8 (33.3) | 24.9 (17.5–37.2) |
表7:基于点数综合评分的风险分层。 根据总评分点数,将患者分为低风险、中等风险、高风险和极高风险组。报告了各评分分层中观察到的多器官功能障碍综合征发生率及关键临床结局。分类变量结果以n(%)表示,住院时间以中位数(四分位间距)表示。
补充表 1:多器官功能障碍综合征终点判定的操作标准。 该表格定义了预先规定的用于判定呼吸、心血管、肾脏、肝脏、凝血及神经系统功能障碍的器官系统标准。当住院期间出现两个或以上器官系统功能障碍时,即确定最终终点事件。两名经过培训的评审员独立评估每个病例,分歧由第三名高级评审员裁决。请点击此处下载该文件。
补充表 2:缺失数据处理和基线值赋值的敏感性分析。 该表格总结了主要的填补分析以及预先指定的敏感性分析,包括完整病例分析、发病后 24 小时内最差值基线赋值以及中心校正的性能检验。这些分析用于评估模型区分能力、Brier 评分、保留的预测因子模式以及按评分分层的风险梯度是否因不同的预处理方法而发生实质性改变。请点击此处下载该文件。
讨论
急性胰腺炎相关多器官功能障碍综合征(MODS)可能在入院后短时间内发生,尤其是在伴有早期全身性炎症、内皮损伤、组织灌注受损和代谢不稳定的患者中。本方案的设计围绕这一入院窗口期展开,因为最初的24小时通常决定了患者是继续接受普通病房观察,还是需要更密切的再评估、加强监测或启动器官支持通路的准备。研究结果表明,将常规可获得的生化和凝血指标通过一个固定且可重复的建模流程进行处理后,可整合为一个可用于急性胰腺炎早期MODS风险分层的可解释评分系统11。该方法与临床现实一致,即单一生物标志物或延迟的严重程度分类可能无法充分捕捉高危急性胰腺炎患者早期出现的全身性恶化模式12。
将生化指标与凝血指标联合应用的生物学依据在临床上具有合理性。重症急性胰腺炎并非由单一孤立通路驱动;在疾病早期恶化过程中,全身性炎症、内皮细胞活化、毛细血管渗漏、肾灌注不足、凝血系统激活以及微循环障碍可能相互促进。所保留的生化预测因子反映了这一多轴心过程。白蛋白降低可能提示与炎症相关的血管渗漏及生理储备下降,而血尿素氮和肌酐升高则与低血容量、肾灌注不足或早期肾损伤一致。血钙降低、乳酸脱氢酶升高以及血糖升高可能反映代谢应激、组织损伤以及更严重的全身性炎症紊乱13。凝血预测因子提供了互补信息:凝血酶原时间国际标准化比值(PT-INR)延长、D-二聚体升高以及血小板计数降低,可能在明显器官功能障碍尚未完全显现之前,提示凝血系统激活、纤维蛋白转化、血小板消耗以及微循环功能障碍14。因此,随着评分分层的升高,多器官功能障碍综合征(MODS)发生率及次要结局的逐步增加表明,该评分捕捉到的是一种临床意义上连贯的早期全身恶化模式,而非孤立的实验室异常。
本研究在方法学上的一个重要贡献是强调可重复性。修订后的方案固定了入组时间窗,采用24小时内最早的合格实验室检测值,应用明确的单位统一规则,定义了数据缺失的阈值,标准化了预处理流程,并将模型调参限制在开发队列中进行。这些步骤直接影响该评分在不同医疗机构间的可重复性。例如,D-二聚体的报告在不同实验室之间存在差异,当本地报告使用D-二聚体单位但缺乏经过验证的换算系数时,不能默认其等同于纤维蛋白原当量单位。同样,实验室检测值的缺失可能反映的是本地的检测路径,而非数据的随机缺失15。因此,方案中的多个步骤至关重要:24小时基线规则必须一致应用,不得使用MODS发生后的实验室值构建预测变量,终点事件的判定应遵循预先规定的器官系统标准,实验室检测值在合并前必须转换为统一的目标单位,且保留的验证队列不得用于特征筛选、系数重新校准或截断值优化16。
该工作流程可根据不同机构的实际情况进行调整,但此类调整应事先明确规定。如果某个候选变量因入院时未常规检测而导致缺失数据过多,则应将其排除在模型构建之外,而非在超出合理阈值的情况下进行填补。如果D-二聚体的单位无法统一为纤维蛋白原当量单位,则应将其视为无法统一的变量,而不应基于缺乏依据的假设进行转换。如果本地实验室使用不同的检测平台,主要分析可保留绝对临床值,而敏感性分析则可将研究中心代码或检测平台作为校正因素纳入。如果MODS事件数量少于预期,建模策略应倾向于更强的收缩性、保留更少的预测因子或采用更简单的评分结构,而非扩大模型以拟合不稳定的信号17。实际的故障排查还应包括检查凝血功能检测是否在入院时常规开具,预测因子的分布是否在不同中心之间出现意外差异,验证阈值是否被无意中重新调整,以及每个图表面板是否与锁定的分析数据集一致18。
研究结果的解释存在若干局限性。保留验证队列来自相同的回顾性多中心数据集,因此属于内部保留验证,而非独立的外部验证。事件数量有限,即使采用惩罚性建模,仍增加了预测因子保留不稳定的風險。选择后描述性比值比仅用于支持临床解释,不应视为确证性推断。部分终点指标依赖于电子病历中记录的质量,而不同医疗中心在临床实践方面未测量的差异可能影响器官支持决策。决策曲线分析未保留在修订后的分析集中,因此本文未声称该评分在不同阈值概率下具有临床净获益19。该评分也不应取代已建立的严重程度评估、重复临床检查、必要时的影像学检查或临床医生判断。低分结果可支持常规观察和标准再评估,但不能排除后续病情恶化;高分结果应被理解为提示需加强监测、重复实验室检查以及更早准备器官支持通路,而非作为固定的治疗指令20。
总体而言,本研究提出了一种可重复的急性胰腺炎患者入院生化-凝血评分流程,用于早期对多器官功能障碍综合征(MODS)进行风险分层。在开发队列和保留验证队列中,锁定的惩罚模型和基于积分的评分均表现出一致的区分能力及有序的风险梯度;敏感性分析表明,预先设定的缺失数据处理方法或基线值替代方案并未对主要结果产生实质性影响。该方法的主要价值在于将常规可获取的入院实验室数据整合为具有可解释性的早期风险信号,有助于患者分诊、调整监测强度,并为器官支持通路的启动做好准备21。未来的研究应优先开展多中心前瞻性外部验证,涵盖使用不同检验平台的医院,评估其实时校准性能,比较基于相同锁定模型开发的电子风险计算器,并进一步评价依据评分指导的监测路径是否能在不增加不必要的重症监护使用的情况下,减少治疗升级的延迟22。
披露
作者声明他们与本研究相关的利益冲突不存在。
致谢
作者谨向参与急性胰腺炎患者诊断、治疗和数据收集工作的所有临床医生及实验室工作人员表示感谢。我们同样感谢提供临床数据的患者,他们的贡献深表谢意。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| 名称 | 公司名称 | 目录编号 / 网址 | 备注 |
| R 统计软件 | R Foundation for Statistical Computing | 版本 4.3.2 https://www.r-project.org/ | 用于数据预处理、模型开发、验证及图表生成的统计计算环境。 |
| caret R 软件包 | CRAN / Max Kuhn | 版本 6.0-94 https://cran.r-project.org/package=caret | 使用 createDataPartition 进行分层的 7:3 模型开发与留出验证集划分。 |
| glmnet R 软件包 | CRAN / glmnet 作者 | 版本 4.1-8 https://cran.r-project.org/package=glmnet | 用于具有二项分布族和 alpha = 1 的 LASSO 惩罚逻辑回归。 |
| mice R 软件包 | CRAN / amices 项目 | 版本 3.16.0 https://cran.r-project.org/package=mice | 使用链式方程进行多重插补,生成 20 个插补数据集,迭代 20 次。 |
| pROC R 软件包 | CRAN / pROC 作者 | 版本 1.18.5 https://cran.r-project.org/package=pROC | 用于 ROC 分析、AUC 估计、置信区间计算以及 DeLong 比较。 |
| cobas 8000 模块化分析仪系列 | Roche Diagnostics | 05641446001 / SYS_128 https://diagnostics.roche.com/global/en/products/systems/cobas-8000-analyzer-series-sys-128.html | 用于生化和免疫化学检测。提交前请根据参与实验室记录核对分析仪型号和目录信息。 |
| XN-1000 自动血液分析仪 | Sysmex Corporation | 型号 XN-1000 https://www.sysmex.com/en-us/lab-solutions/hematology/xn-series/xn-1000 | 用于获取全血细胞计数变量,包括白细胞和血小板计数。提交前请根据参与实验室记录核对。 |
| CS-5100 自动血液凝固分析仪 | Sysmex Corporation | 型号 CS-5100 https://www.sysmex.com/en-us/lab-solutions/hemostasis/sysmex-cs-5100 | 用于凝血变量检测,包括 PT、APTT、纤维蛋白原和 D-二聚体。提交前请根据参与实验室记录核对。 |
| ABL90 FLEX PLUS 血气分析仪 | Radiometer Medical ApS | 型号 ABL90 FLEX PLUS https://www.radiometer.com/en/products/blood-gas-testing/abl90-flex-plus-blood-gas-analyzer | 若使用该平台,则用于乳酸测定。提交前请根据参与实验室记录核对。 |
| 电子病历系统 | 参与医院 | 机构特有;不适用 | 用于提取入院记录、病程记录、ICU 记录、操作记录、生命体征及出院记录。如有具体供应商和系统名称,应予以替换。 |
| 实验室信息系统 | 参与医院 | 机构特有;不适用 | 用于提取实验室时间戳、原始数值、单位及标准化数据。如有具体供应商和系统名称,应予以替换。 |
| 终点事件裁定表单 | 研究团队 | 定制研究文件;不适用 | 由两名评审员及一名高级评审员使用,用于标准化裁定多器官功能障碍综合征(MODS)状态及发病时间。 |
| 数据字典与单位转换表 | 研究团队 | 定制研究文件;不适用 | 定义变量名称、目标单位、转换规则、缺失值标记、中心代码及可用于分析的数据格式。 |
参考文献
- Banks PA, et al. Classification of acute pancreatitis-2012: revision of the Atlanta classification and definitions by international consensus. Gut. 2013;62(1):102-111.
- Wu BU, et al. The early prediction of mortality in acute pancreatitis: a large population-based study. Gut. 2008;57(12):1698-1703.
- Tenner S, et al. American College of Gastroenterology Guidelines: Management of Acute Pancreatitis. Am J Gastroenterol. 2024;119(3):419-437.
- Lee DW, Cho CM. Predicting severity of acute pancreatitis. Medicina (Kaunas). 2022;58(6):787.
- Metri A, Bush N, Singh VK. Predicting the severity of acute pancreatitis: current approaches and future directions. Surg Open Sci. 2024;19:109-117.
- Efthimiou O, et al. Developing clinical prediction models: a step-by-step guide. BMJ. 2024;386.
- Collins GS, Reitsma JB, Altman DG, Moons KGM. Transparent reporting of a multivariable prediction model for individual prognosis or diagnosis: the TRIPOD statement. Ann Intern Med. 2015;162(1):55-63.
- Li L, et al. Coagulopathy and acute pancreatitis: pathophysiology and clinical treatment. Front Immunol. 2024;15:1477160.
- Wan J, et al. Serum D-dimer levels at admission for prediction of outcomes in acute pancreatitis. BMC Gastroenterol. 2019;19:67.
- World Medical Association. World Medical Association Declaration of Helsinki: ethical principles for medical research involving human subjects. JAMA. 2013;310(20):2191-2194.
- Garg PK, Singh VP. Organ failure due to systemic injury in acute pancreatitis. Gastroenterology. 2019;156(7):2008-2023.
- Wu BU. Prognosis in acute pancreatitis. CMAJ. 2011;183(6):673-677.
- Wang H, et al. Early predictive value of different indicators for persistent organ failure in acute pancreatitis: a systematic review and network meta-analysis. J Clin Gastroenterol. 2024;58(3):307-314.
- Dumnicka P, et al. The interplay between inflammation, coagulation and endothelial injury in the early phase of acute pancreatitis: clinical implications. Int J Mol Sci. 2017;18(2):354.
- Favaloro EJ, Dean E. Variability in D-dimer reporting revisited. Pathology. 2021;53(4):538-540.
- Wolff RF, et al. PROBAST: A tool to assess the risk of bias and applicability of prediction model studies. Ann Intern Med. 2019;170(1):51-58.
- Riley RD, et al. Calculating the sample size required for developing a clinical prediction model. BMJ. 2020;368.
- Collins GS, et al. Evaluation of clinical prediction models (part 1): from development to external validation. BMJ. 2024;384.
- Vickers AJ, Elkin EB. Decision curve analysis: a novel method for evaluating prediction models. Med Decis Making. 2006;26(6):565-574.
- Riley RD, van der Windt D, Croft P, Moons KGM, editors. Prognosis Research in Healthcare: Concepts, Methods, and Impact. Oxford University Press; Oxford; 2019.
- Wu H, Li J, Zhao J, Li S. A new scoring system can be applied to predict the organ failure related events in acute pancreatitis accurately and rapidly. Pancreatology. 2020;20(4):622-628.
- Riley RD, et al. Evaluation of clinical prediction models (part 2): how to undertake an external validation study. BMJ. 2024;384.