本方案描述了一种基于深度学习的工作流程,用于非物质文化遗产图案的语义分割、重建及艺术风格合成,通过基于变换器的特征提取、对抗性重建和空间自适应图像生成,支持文化遗产的数字化保护与创造性应用。
需要JoVE订阅才能观看此内容。 请登录或开始免费试用
本文内容
摘要
摘要
随着基于深度学习的图像合成技术的发展,非物质文化遗产(ICH)图案的数字化保存与重构日益受到关注。现有的基于SegCycle-SPADE的方法在传统工艺图案的结构分割与艺术化重构方面已展现出潜力;然而仍存在若干局限,包括数据集多样性不足、文化语义信息融合不充分,以及在重构过程中对图案结构特征的保留不够完整。为应对这些挑战,本研究提出一种改进的SegCycle-SPADE框架,用于非物质文化遗产图案类型的语义分割与艺术化重构。该框架采用基于Transformer的分割模型SegFormer,以精确识别图案中的纹样边界与区域。此外,引入跨注意力文化特征融合模块,以增强具有文化意义的关键纹样并提升特征表达能力。图案的转换与重构通过CycleGAN实现,同时采用空间自适应去归一化(SPADE)进行艺术风格合成,以保持分割图与生成图像之间的语义一致性。为提升模型的泛化能力与艺术多样性,框架在苗族蜡染文化纹样数据集与WikiArt数据集上共同训练。实验结果表明,所提出的注意力引导的SegCycle-SPADE框架在分割准确率与遗产图案重构性能方面均优于现有的基于生成对抗网络(GAN)的重构方法。该框架为人工智能辅助下的文化遗产记录、重构及传统图案设计的艺术化复兴提供了可扩展的解决方案。
引言
文化遗产包括无形元素(如习俗、语言和信仰)以及有形元素(如艺术品、建筑和文字记录),是人类历史、创造力和身份认同的基本体现1。遗产保护旨在帮助社区重新连接其文化根源,并使后代能够受益于集体文化记忆。它还促进跨文化理解,增进对不同传统与习俗的欣赏,并推动对多元历史叙事的认可。这些文化资产有助于我们理解前人的价值观、观点和经历,并对当代社会身份的形成和文化延续起到重要作用。文化遗产保护的基本原则如图1所示。
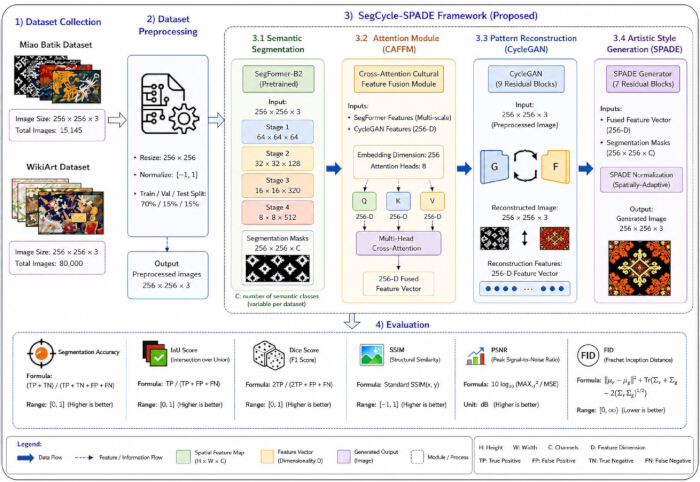
图1。基于 SegCycle-SPADE 框架的文化遗产图案重建概念示意图。 本研究提出的方法用于非物质文化遗产图案的重建与增强。该工作流程包括从苗族蜡染和 WikiArt 数据集中采集数据、图像预处理、使用 SegForm....
访问受限。请登录或开始试用以查看此内容。
方案
所提出的 SegCycle-SPADE 框架旨在通过语义分割、基于注意力的特征增强、生成式重建以及艺术风格合成,实现对传统文化遗产图案的重建与优化。本研究采用了公开可用的文化遗产与艺术图像数据集,包括苗族蜡染数据集(Miao Batik dataset)和 WikiArt 数据集。研究未涉及人类受试者、患者数据、个人信息、动物实验或临床记录,因此无需机构伦理委员会批准及知情同意。首先,本研究使用苗族蜡染文化纹样数据集与 WikiArt 数据集进行评估。苗族蜡染数据集由 Quan 等人(2024)32 描述,包含 15,148 张标注的传统苗族蜡染纹样图像。本研究直接使用数据集提供者已有的标注,未额外生成任何人工标注。随后,对图像进行预处理,包括调整尺寸、归一化、去噪以及生成分割掩码。具体的预处理参数详见“数据预处理”小节。所提出的框架采用一种基于 Transformer 的模型 SegFormer-B2,用于数据的语义分割。该方法旨在检测文化纹样的关键区域并学习其结构。分割所得特征随后通过注意力机制进行增强,突出与文化纹样相关的重要信息,并抑制无关内容。注意力机制的具体配置详见“CAFFM”小节。增强后的特征被输入 CycleGAN,通过循环学习重建受损结构。在训练过程中,通过在原始苗族蜡染图像上施加随机掩码和部分遮挡操作,人工构建不完整纹样样本。这些退化操作模拟了文化遗产文物中常见的纹样缺失区域与结构损伤。生成的不完整图像作为 CycleGAN 重建模块的输入,对应的原始图像则作为重建目标。重建后的文化遗产图案进一步通过 SPA....
访问受限。请登录或开始试用以查看此内容。
结果
所提出的 SegCycle-SPADE 框架通过两个数据集进行了评估:苗族蜡染文化图案数据集和 WikiArt 数据集。苗族蜡染数据集包含传统文化遗产图像,主要用于语义分割和结构重建任务;而 WikiArt 数据集包含多样的艺术风格,用于艺术风格学习与生成。来自这两个数据集的图像均经过完整的 SegCycle-SPADE 流程处理,包括语义分割、CAFFM、图案重建以及基于 SPADE 的艺术风格生成。文化图案信息与艺术风格表征的融合使该框架能够生成具有文化意义且视觉连贯的输出结果。
所有实验均在配备 Intel Core i7 处理器和 NVIDIA GPU 的支持 GPU 的工作站上进行。具体而言,实验所用工作站配置为 Intel Core i7(第 11 代)CPU、配备 24 GB VRAM 的 NVIDIA RTX 3090 GPU 以及 32 GB 系统内存。模型使用 Python 3.8 和 PyTorch 1.10 并结合 CUDA 加速实现。训练过程采用单 GPU 设置,未使用分布式训练。所有实验均全程使用标准 FP32 精度,未采用混合精度训练。优化器选用 Ad.......
访问受限。请登录或开始试用以查看此内容。
讨论
近年来,由于传统工艺逐渐消失,非物质文化遗产(ICH)图案的保存与数字化重建受到越来越多的关注。先前的研究尝试通过基于深度学习(DL)的图像处理技术来应对文化遗产的流失问题。例如,Quan 等人32提出了一种基于知识图谱和深度学习的框架,用于贵州苗族蜡染文化的保护。尽管该研究聚焦于文化图案的数字化重建,但其方法主要依赖于知识图谱的表示。类似地,Fu 和 Razmjooy16提出了一种基于特征金字塔网络(FPN)的框架,用于文化遗产图像的增强与修复。尽管该方法在图像增强方面实现了有效的特征提取,但并未引入图像分割引导机制或针对不完整文化图案的生成式重建机制。相比之下,本文提出的 SegCycle-SPADE 框架结合了多种深度学习组件,以克服上述挑战。首先,采用 SegFormer 模型进行语义分割,以准确识别文化遗产图案中的纹样区域;随后,基于 CAFFM 的特征增强模块提升了细粒度纹样结构的特征表示;接着,利用 CycleGAN 重建模块通过对抗学习重建文化图案中缺失或不完整的区域;最后,SPADE 模块在保持与分割图结构对齐的同时实现风格.......
访问受限。请登录或开始试用以查看此内容。
披露
利益冲突:
作者声明无竞争利益。
致谢
作者感谢广东工程职业技术学院和华南师范大学在本研究完成过程中提供的学术与机构支持。本研究受2023年度国家社会科学基金一般项目(No. 23BH161)资助,项目名称为 数字再生博物馆:中国经典书画文物的活化与传播研究
....访问受限。请登录或开始试用以查看此内容。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| Adam 优化器 | PyTorch 优化器库 | Adam | 模型训练过程中使用的优化算法。 |
| CUDA 工具包 | NVIDIA 公司 | CUDA 11.3 | 用于深度学习计算的 GPU 加速。 |
| cuDNN | NVIDIA 公司 | cuDNN 8.2 | 用于加速训练和推理的深度神经网络加速库。 |
| CycleGAN | 加州大学伯克利分校 / 开源 | 官方 PyTorch 实现(https://github.com/junyanz/pytorch-CycleGAN-and-pix2pix) | 用于文化纹样重建的生成对抗网络。 |
| ImageNet 预训练权重 | ImageNet / 开源 | mit_b2.pth(ImageNet-1K 预训练检查点) | 在苗族蜡染数据集上进行微调前,用于初始化 SegFormer-B2 主干网络。 |
| Intel 处理器 | Intel 公司 | Intel Core i7(第 11 代) | 用于图像预处理、模型训练支持和推理的 CPU。 |
| Matplotlib | Matplotlib 开发团队 | Matplotlib 3.5.1 | 用于训练曲线和评估结果的可视化。 |
| 苗族蜡染数据集 | Zenodo 仓库 | DOI: 10.5281/zenodo.20807658 | 包含 15,148 张图像的文化纹样数据集,用于语义分割和图案重建。 |
| NumPy | NumPy 开发者 | NumPy 1.21.5 | 用于数值计算和数据集处理。 |
| NVIDIA GPU | NVIDIA 公司 | NVIDIA RTX 3090(24 GB 显存) | 用于模型训练和推理的硬件平台。 |
| OpenCV | OpenCV 基金会 | OpenCV 4.5.5 | 用于图像预处理、缩放、插值和高斯去噪。 |
| 操作系统 | Canonical 公司 | Ubuntu 20.04 LTS | 实验执行环境。 |
| Pillow(PIL) | Python 图像库 | Pillow 8.4.0 | 用于图像加载和操作。 |
| Python | Python 软件基金会 | Python 3.8.10 | 用于实现和实验的编程语言。 |
| PyTorch | Meta AI | PyTorch 1.10.0 | 用于模型训练和推理的深度学习框架。 |
| 随机种子 | 实验设置 | 42 | 用于数据集划分、模型初始化和实验可重复性的固定种子。 |
| Scikit-learn | Scikit-learn 开发者 | Scikit-learn 1.0.2 | 用于数据集划分、统计分析和评估指标。 |
| Seaborn | 开源社区 | Seaborn 0.11.2 | 用于统计数据分析可视化。 |
| SegFormer-B2 | NVIDIA 研究院 / 开源 | SegFormer-B2(MIT-B2 主干网络) | 基于 Transformer 的语义分割模型,用于文化纹样分割。 |
| 分割掩码 / 标注 | 苗族蜡染数据集 | 随数据集提供 | 用于纹样分类和训练的像素级语义分割标签。 |
| SPADE | NVIDIA 研究院 / 开源 | 官方 PyTorch 实现(https://github.com/NVlabs/SPADE) | 基于分割引导的图像合成模型,用于艺术图案生成。 |
| TorchVision | Meta AI | TorchVision 0.11.1 | 与 PyTorch 配合使用的图像处理工具和数据集变换。 |
| WikiArt 数据集 | WikiArt | https://www.wikiart.org/ | 包含超过 80,000 件艺术品、涵盖 27 种艺术风格的艺术风格数据集,用于风格学习与合成。 |
参考文献
- Huang B, Mo L. SegCycle-SPADE: An end-to-end framework for semantic segmentation-based automated extraction and artistic reconstruction of traditional craft patterns using conditional GAN. PLoS ONE. 2025;20:e0329100.
- Yan Z, et al. Digital sustainability of heritage: Exploring indicators affecting the effectiveness of digital dissemination of intangible cultural heritage through qualitative interviews. Sustainability. 2025;17:1593.
- Yan Z, et al. Construction of digital dissemination effects evaluation indicator system of traditional techniques of intangible cultural heritage. npj Heritage Science. 2025;13:224.
- Imon SS. Intangible cultural heritage as a ....
访问受限。请登录或开始试用以查看此内容。