本研究探讨了英语专业学生在翻译聚焦中国的叙事文本时的决策与修改行为,通过整合击键记录和弹幕语料库,揭示文本显著性如何影响翻译过程中的认知负荷与翻译质量。
本文内容
摘要
摘要
随着聚焦中国的叙事文本日益进入国际传播领域,中译英已演变为一种意义协商的过程,而非简单的语言转换。对学生译者而言,主要挑战不仅在于词汇选择,更在于如何将富含文化内涵的指涉、评价性立场以及叙事定位,恰当地呈现给源语语境之外的读者。本研究考察了72名英语专业学生在翻译聚焦中国的叙事文本时的实时决策与修改行为。研究采用“过程-结果”设计,整合了通过Translog-II采集的击键记录数据、译文质量评估结果,以及辅助性的弹幕(danmu,即时间同步评论)语料库——后者被视为一种受众显著性层面的反映,而非对语段语言难度的直接衡量。翻译过程从停顿时长、修改频率、修改位置及阶段分布等方面进行分析,译文质量则通过专家评分及针对文化相关语段的目标编码进行评估。研究还利用来自24个Bilibili视频的18,642条弹幕评论语料,识别出公众关注度较高的叙事主题和文化敏感性表达。结果显示,文化负载高且评价性强的语段引发了更长的停顿、更频繁的递归式修改以及更密集的中程重构。高质量译文与在语篇层面和文化适应层面进行的选择性、策略性修改相关,而非与总修改次数的增加相关。弹幕中显著的叙事触发点与高加工努力的翻译语段之间的重合,被解读为受众显著性与译者处理压力趋同的证据,而非因果关系的证明。本研究通过将修改行为与嵌入文化的叙事翻译相联系,推进了翻译过程研究,并为跨文化传播中的译者培养提供了启示。
引言
近年来,中国相关话语的翻译已从一个相对专门化的议题转变为国际传播中的核心问题1。此类翻译所涉及的,远不止命题内容的传递,更是承载政治立场、文化框架与受众定位的公共叙事的重构。关于中国政治话语翻译的研究日益清晰地表明:当文本被译介给中国以外的读者时,措辞、情态与文本重点的选择,同时也成为关于中国如何在海外被叙述与解读的选择2。一旦问题被如此界定,仅关注最终译作的“产品导向”方法便显得不足。一份完成的译文可以展示最终的选择,却无法揭示不确定性何时出现、改写从何处开始,或相互竞争的解决方案如何被尝试与舍弃3。
这些局限性有助于解释为何实证性的翻译过程研究已成为翻译学中的一个重要分支,该研究利用过程追踪工具来直接捕捉翻译过程中的停顿、删除、插入以及决策的时间特征,而非仅从最终译文中间接推断这些信息4。这种方法并非取代对译作、社会学、文化或基于语料库的研究路径,而是为翻译决策在每一时刻的形成过程提供了新的证据。近期的研究已从单纯描述孤立的停顿现象,转向将翻译建模为一种具有时间结构的活动。例如,犹豫—定向—流畅(hesitation-orientation-flow)分类法将翻译行为视为在不确定性、搜索和流畅产出之间有规律地交替的过程,从而解释了为何在特定任务阶段会出现不稳定性并引发文本的重新表述5。这一转变在学生翻译研究中尤为相关,因为学习者的语言能力、主题知识以及策略控制能力在此阶段仍处于同步发展阶段6。
眼动追踪与键盘记录相结合的证据表明,新手译者在翻译过程中无法均匀分配注意力,且在汉译英过程中,目标文本的生成往往成为认知负荷的主要来源7。因此,最终译文中看似局部的措辞问题,实际上可能反映了实时翻译过程中注意力与努力程度的广泛性重组8。最近的研究进一步表明,学生译者可能产出在表层质量上相似的译文,但在所需付出的努力、不确定性和自我监控程度上却存在显著差异。即使最终译文令人满意,其背后仍可能依赖于脆弱或低效的决策路径,而这类问题只能通过关注翻译过程的敏感性测量手段才能捕捉到9。此外,比较性研究指出,翻译专长涉及对何时暂停、检索信息、继续起草或返回修改等环节所进行的稳定元认知调控10。
修改是这一隐性认知过程最为明显的体现。正是在修改过程中,译者会回溯先前的措辞,尝试不同的表达方式,并判断问题究竟出在词汇、句法、语篇还是文化层面。因此,修改不应被视为后期润色的步骤,而应被看作衡量译者能力发展的重要指标。更好的翻译结果与翻译过程中对替代方案的整合方式密切相关,这表明有效的修改具有选择性、策略性和时机性,能够响应整体文本的更高要求,而非简单地累积修改痕迹11,12,13。
当源文本聚焦于中国叙事,而非中立的信息性段落时,翻译过程中的决策与修订复杂性会更加凸显。此类文本往往依赖于富含文化内涵的预设、具有历史语境的表达方式以及评价性线索,其意义依赖于共享的背景知识,而非明确的阐述14,15,16。文本难度会改变加工处理的精细程度;承载文化或评价密度的叙述性文本迫使译者以更小的语言单位进行操作,实施非线性的翻译策略,并反复进行局部结构调整8。对于学生译者而言,核心问题在于:如何在不削弱文化特异性的前提下,为原话语社群之外的读者揭示或重构多大程度的隐含背景信息。
本研究由三个具体的研究空白所驱动。首先,翻译过程中的各项指标,如停顿时长、长时停顿频率、光标中断和词典查阅,往往与修订类型学分开考察,这使得决策压力如何在后续的重述中显现变得难以观察。其次,相较于通用学术或说明类文本,具有文化特异性的叙事类别在过程层面受到的关注较少,尽管以中国为主题的叙事通常要求译者同时处理文化负载、评价密集性以及隐含的背景信息压缩等问题。14,15,16在本研究中,文化负载指文化特定参照和共有预设的密度;评价密度指明确或隐含的立场表达、情感强度以及价值倾向性框架;叙事压缩则指背景信息、因果关系或社会定位在较短文本片段中被浓缩的程度。第三,翻译任务通常仅基于文本内部分析来设计,很少考虑被识别为困难的文本片段是否与数字传播中公众关注的焦点相吻合。弹幕(时间同步的视频评论)可作为副文本和参与性话语,凸显受众所关注、质疑和重新诠释的内容。17,18;然而,弹幕显著性必须被视为观众参与度的语义层面指标,而非语段层面语言难度的直接替代物。
针对这些不足,本研究探讨了英语专业学生在将聚焦中国的叙事文本从中文翻译成英文时如何进行决策与修改。通过将翻译过程数据与网络受众话语纳入同一分析框架,本研究旨在解释学生译者不仅在哪些方面遇到困难,而且这些困难为何集中在特定类型的叙事意义上。
本研究具体探讨以下四个研究问题:(1)英语专业学生在翻译以中国为主题的叙述性文本时,其汉译英决策模式具有哪些特征?(2)在文化负载程度和叙事密度不同的文本片段中,修订行为有何差异?(3)哪些维度的修订行为与更高的翻译质量相关?(4)弹幕讨论中识别出的文化显著点是否与翻译过程中产生最大认知负荷的文本片段相重合?
相应地,该研究在一个分析序列中检验了四个相互关联的假设:H1 提出,文化负载较高的文本片段相较于文化负载较低的片段,会引发更长的停顿、更大的决策不确定性以及更频繁的修改;H2 区分了两条路径,预测评价性密度将增加延迟性修改,而叙事压缩将增加篇章层面的重构;H3 预测,相较于仅以总修改次数衡量,翻译质量将更显著地由修改的选择性和时机所解释;H4 预测,弹幕显著片段将与高负荷翻译片段重叠,体现观众显著性与译者加工压力之间的关联性趋同。
方案
所有涉及人类受试者的方法均按照机构指南进行,并经韩山师范学院机构审查委员会(IRB)或人类研究伦理委员会批准。在实验开始前,已从所有参与者处获得知情同意。
概念框架与研究设计
本研究采用过程-成果研究设计,并辅以话语层面分析,探讨观众生成的弹幕评论如何影响字幕翻译。分析框架整合了文本特征、翻译过程指标以及翻译质量结果。具体而言,研究考察了弹幕密度所反映的观众注意力是否引导译者将认知资源集中于特定文本特征,以及这种注意力分配是否继而影响翻译质量。
为了实施该框架,本研究首先基于四个维度建立了字幕片段层面的文本特征:文化负载、评价密度、叙事压缩和弹幕显著性。文化负载指文本中包含需要改编或解释的文化特异性内容。评价密度用于衡量字幕片段中带有情感或态度色彩语言的集中程度。叙事压缩反映了在字幕时长限制下语义内容被压缩的程度。弹幕显著性则表示观众对每个字幕片段的关注程度,通过同步弹幕评论的数量进行量化。与传统的翻译难度衡量标准不同,弹幕显著性反映的是社会性分布的注意力,而非文本内在的复杂性。某个字幕片段若引发大量观众互动,未必意味着其翻译难度更高;相反,它代表了观看体验中具有更高交际重要性的节点。
分析框架包含三个相互关联的数据集。参与者层面的数据集包括个体的人口统计学特征和翻译专业水平。过程-结果数据集将每个字幕片段与从键盘记录中提取的行为指标以及专家对翻译质量的评分相关联。弹幕数据集包含与字幕时间同步的观众评论,从中计算出弹幕显著性值。这些数据集通过参与者和片段标识符进行链接,从而能够针对每个翻译的字幕片段,同时分析其与译者特征、认知加工行为、观众注意力及翻译结果之间的关系。最终整合的数据库包含216次完整的翻译会话和3,168个参与者-文本-片段观测值,为后续的过程-结果分析提供了实证基础。
参与者筛选与背景特征分析
样本包括从中国南方一所公立大学招募的72名英语专业学生,均匀分布在本科二年级、三年级和四年级(每年级24名参与者)。所有参与者均为以中文为母语者,正在接受英语写作与翻译的正规教育。为确保受训译者群体内部的可比性,排除了曾在英语国家居住超过6个月或已获得专业翻译资格认证的个体。参与者未根据翻译经验、文化熟悉度或第二语言熟练程度划分为不同的实验组。相反,年级水平、近期英语水平测试成绩、先前的翻译课程学习经历、自评对中国相关文化话题的熟悉程度以及每周双语练习的平均参与时间被记录下来,并作为个体层面的协变量纳入统计模型中。此项说明也解决了同行评审过程中提出的参与者数量不一致问题:原稿和复现数据集均包含72名参与者、216次任务会话以及3,168个片段级别的观测数据。
源文本选择与任务构建
翻译材料包含三篇以当代中国为背景的叙事性文本,专为本研究设计,旨在反映真实的公共话语,同时避免使用受版权保护的材料。每篇文本包含205至225个汉字,但在内部特征上系统性地有所不同。文本A讲述春节返乡的故事,文化负载适中,句法相对简单明了。文本B叙述端午节的记忆,包含更高密度的文化特有表达和隐含背景知识。文本C描述农村直播带货的叙事,以密集的评价性语言和压缩的叙事视角为特征。
采用从句边界和意义单元边界对文本进行系统分段,得到三个翻译任务中的44个可分析单元(表1)。在正式编码前,编码手册使用1–5级顺序量表定义了文化负载、评价密度和叙事压缩。一项涉及12名未参与主实验学生的预研究,验证了预期难度校准、任务说明的清晰性以及用于按键记录对齐的分段边界的稳定性。
辅助语料库构建与显著性映射
为了识别公开显著的叙事线索,从2023年1月至2025年12月期间上传的24个Bilibili视频中汇编了一个辅助弹幕语料库。仅当视频符合源文本所代表的三个语义领域之一、累计观看次数超过50,000次、包含密集的弹幕互动,并允许导出和进行时间同步评论的主题映射时,才被纳入。在去除重复项并过滤表情符号、拟声填充词和无关片段后,最终语料库包含18,642条评论。
采用与源文本相关的关键词锚点对内容词进行标准化和聚类。随后,基于归一化后的关键词簇频率、对应主题簇内评论的集中程度以及平均评价强度的加权组合,为每个源文本片段分配连续的弹幕显著性评分。该方法能够在语义簇层面实现对译者加工 effort 与受众显著性的比较,而非依赖直接的词汇匹配。由于弹幕反映的是观众对在线视频的反应,而非实验性翻译任务本身,因此弹幕显著性被解读为受众参与度的外部指标,而非源文本片段语言难度的直接证据。
实验步骤与数据采集
翻译任务在受控的计算机实验室中单独进行,硬件、软件和互联网访问条件均保持标准化(图2)。在开始前,先进行五分钟的指导说明,强调为国际读者生成可读的英文文本;随后,参与者完成三分钟的英文打字热身练习,以尽量减少键盘适应对结果的影响。三项翻译任务通过 Translog-II 依次进行,任务顺序采用拉丁方设计进行平衡,以使潜在的疲劳效应和顺序效应在各参与者之间均匀分布。每篇文本的最长完成时间为20分钟,两次任务之间安排有五分钟的休息间隔。
尽管允许使用内置的双语词典,但禁止使用机器翻译系统和外部搜索引擎。所有按键、停顿和光标移动均被自动记录,并辅以同步屏幕录像,以验证非线性修改过程。每项任务完成后,参与者需完成一份自评难度问卷,该问卷仅用于辅助解释边界模糊的编码情况。
过程测量与变量编码
击键记录与预定义的片段结构对齐。对齐片段从对应于某一片段的第一个目标语言击键开始,到参与者明确进入下一个片段时结束。重叠的修改通过带时间戳的光标追踪记录重新分配。
决策行为通过五个指标进行量化:首次停顿持续时间(在初始片段翻译前)、段落内平均停顿持续时间、超过两秒的停顿频率、词典查阅次数,以及反映偏离线性写作的光标中断次数(表2)。修订行为从两个维度进行分类:时间和功能。时间维度区分了在当前片段写作过程中立即进行的局部修订与在写作推进到后续内容后才进行的延迟修订。功能编码将修订分为四类:表层修订(不改变语义的形式层面修正)、意义修订(词汇或句法层面的修改)、语篇层面修订(对子句关系或连贯性的调整)以及文化适应性修订(面向目标读者的改写)。两名经过培训的编码员独立分析每一次修订事件,在协商一致后为每个事件分配一个主要的功能类别。所有编码指标的评分者间信度良好。Cohen’s ĸ 显示修订功能分类编码具有高度一致性(ĸ = 0.84,p < 0.001)。对于有序文本层面变量,组内相关系数(ICC,双向混合效应模型,绝对一致性)显示文化负载(ICC = 0.86)、评价密度(ICC = 0.78)和叙事压缩(ICC = 0.82)均具有较高的信度。所有初始编码分歧均通过共同协商解决。
翻译质量评估
由两名具有博士学位并拥有丰富翻译教学经验的评估者,在不参考过程数据的情况下独立评估翻译质量。评估者对参与者身份和过程指标设盲,采用总分为100分的评分标准,该标准均匀分布于五个维度:语义准确性、语言流利性、叙述连贯性、文化表达恰当性以及语域适切性(表3)。若评分差异超过8分,则启动联合评审并达成共识后重新评分,最终翻译质量得分采用仲裁后的平均分。保留仲裁前的评分记录,以便在重复实验材料中透明报告评估者间信度。
统计建模
分析分为三个连续阶段进行。首先,计算描述性统计量,以总结各年级组和文本类型中所有变量的情况。其次,采用混合效应回归模型分析片段层面的加工努力程度,以考虑文本内片段的嵌套结构以及来自同一参与者的重复观测值。因变量包括首次停顿时长和修订频率,将其建模为文化负载、评价密度、叙事压缩和弹幕显著性等因素的函数,同时控制参与者的语言熟练度。为提高统计透明度,还报告了预测变量间的相关性、方差膨胀诊断结果、95% 置信区间、效应量估计值以及模型拟合指标。
最后,通过建模评估了修订时间与修订功能相对于总体修订频率对翻译质量的预测作用。采用每个分布的前五分位数、标准化的综合努力指数以及偶然重叠分析,评估了弹幕显著片段与高努力翻译片段之间的重叠情况。未进行探索性因子分析或结构方程建模。因此,相关图表仅作为概念性、描述性或基于回归的总结呈现。
结果
翻译会话的总体概况
所有72名参与者在标准化实验条件下完成了三项翻译任务,共产生216次完整的翻译会话。经过句段对齐后,最终分析数据集包含3,168个参与者-文本-句段观测值。样本中每篇文本的平均任务完成时间为998.4秒,在不同年级组和源文本之间存在明显差异(表4;图3)。因此,论文正文及配套数据均一致支持样本量为n = 72名参与者;任何对子集进行汇总的图表均应明确标示这些子集。
四年级学生完成翻译任务的速度快于二年级学生,且中断次数更少。这种差异不仅体现在处理速度上。与二年级学生相比,四年级学生首次停顿的平均持续时间更短,长停顿次数更少,总修订次数也更低,同时取得了最高的翻译质量评分。相比之下,二年级学生产生的修订最多,其中大部分为表层修改和即时局部更正。高年级学生表现出更高比例的延迟修订和文化适应性修订,表明优异的翻译表现与选择性修订策略相关,而非修订数量的多少。
三种源文本之间的差异同样显著。文本A产生的完成时间最短、长暂停次数最少,且修订密度最低。文本B和文本C均带来了更高的认知加工负荷,但其机制不同。文本B引发了最多与文化相关的修订事件,而文本C则产生了最高频次的语篇层面修订,以及最长的段内平均暂停时长。因此,不同文本的加工困难来源各不相同。在文本B中,困难主要集中于文化限定性指称和隐含的背景假设;而在文本C中,困难主要与叙述压缩和评价性立场表达相关。
单因素方差分析证实,不同年级组在总体翻译质量上存在显著差异, F (2, 69) = 31.84, p < 0.001,效应量较大(η2 ≈ 0.48,基于参与者层面的平均得分)。事后比较显示,四年级学生的得分显著高于三年级学生,而三年级学生又优于二年级学生。在首次停顿时长、长停顿频率以及延迟修订比率上也观察到相同的趋势。总体而言,这些基线结果为后续分析确立了两个重要结论:第一,三篇源文本的差异体现在加工难度上,而不仅仅在于主题内容的不同;第二,翻译质量的提升与翻译加工过程的重组相关,而非单纯降低加工负荷。
文本显著性对决策和修订行为的影响
为了确定片段级别的文本属性是否能够预测加工努力,我们针对首次停顿时长、长停顿频率、总修订密度和延迟修订密度分别拟合了混合效应模型。将文化负载、评价密度、叙事压缩程度以及弹幕显著性作为固定效应,参与者和文本片段作为随机截距纳入模型(表5;图4)。预测变量筛选结果证实不存在严重的多重共线性问题,所有方差膨胀因子(Variance Inflation Factor, VIF)均远低于保守阈值2.5(最大VIF = 1.45)。为评估模型拟合优度及解释的方差比例,计算了所有混合效应模型的边际和条件R2值(边际R2范围为0.08至0.19;条件R2范围为0.46至0.64)。随机效应(参与者和片段截距)的完整方差成分及其对应的模型拟合指标详见表5。系数估计值的解释结合其95%置信区间进行,而非仅依赖p值。
文化负荷在各个模型中均表现出最强且最一致的影响。在首次停顿模型中,文化负荷评分每增加一个单位,首次停顿时间延长0.91秒(b = 0.91,SE = 0.12,95% CI [0.67, 1.15],p < 0.001)。文化负荷还显著增加了长停顿频率(b = 0.19,SE = 0.04,95% CI [0.11, 0.27],p < .001)和总修订密度(b = 0.27,SE = 0.06,95% CI [0.15, 0.39],p < .001)。因此,具有文化负荷的语段不仅延迟了初始加工过程,还提高了后续重新表述的可能性。
叙事压缩表现出同样显著但不同的效应模式。它对语篇层面的修改具有较强的预测作用(b = 0.31,SE = 0.07,95% CI [0.17, 0.45],p < .001),并显著增加了段落内停顿的平均持续时间(b = 0.58,SE = 0.14,95% CI [0.31, 0.85],p < .001)。从实际意义上看,那些将大量背景信息压缩在较短文本范围内的段落,较少引发即时的词汇替换,而更可能需要进行更广泛的结构重构。
评价性密度也产生了显著影响,尽管其主要作用体现在延迟修订上,而非初始决策延迟。在延迟修订模型中,评价性密度呈现出正向系数(b = 0.23,SE = 0.05,95% CI [0.13, 0.33],p < .001)。其对首次停顿时长的影响相对较小(b = 0.34,SE = 0.13,95% CI [0.09, 0.59],p = 0.010)。这些结果表明,在初始翻译过程中,评价性线索并不总是被识别为加工中的瓶颈;相反,它们通常在初稿完成之后才频繁显现为问题,促使译者重新审视立场、语气或叙述的恰当性。
在控制文本内部变量后,弹幕显著性仍是一个显著的预测因子。它显著预测了首次停顿时长(b = 0.36,SE = 0.14,95% CI [0.09, 0.63],p = 0.011)和总修订密度(b = 0.17,SE = 0.06,95% CI [0.05, 0.29],p = 0.006)。尽管其效应量小于文化负载和叙事压缩,但其稳定的贡献表明,在弹幕语料中吸引公众更多关注的文本片段,在翻译过程中也往往需要更高的加工努力。该发现被解释为语义显著性的趋同证据,而非弹幕频率直接导致翻译困难的证据。
修订行为与翻译质量
后续分析探讨了翻译质量是否更受修订总量的影响,还是更受其时间特征和功能特征的影响。质量模型(表5)得出了明确的结果模式。修订总次数对翻译质量的预测作用不显著(b = 0.04,95% CI [-0.06, 0.14],p = 0.412),而修订的时间特征和功能特征均为显著预测因子。具体而言,延迟修订比例(b = 1.12,95% CI [0.39, 1.85],p = 0.003)、语篇层面的修订(b = 1.76,95% CI [0.96, 2.56],p < 0.001)以及文化适应性修订(b = 2.04,95% CI [1.14, 2.94],p < 0.001)均与翻译质量呈正相关。相比之下,表层修订表现出虽小但具有统计学意义的负相关(b = -0.63,95% CI [-1.18, -0.08],p = 0.028)。
这些发现表明,仅凭修改数量无法区分有效的重构与不稳定的草稿过程(图5)。对翻译稿的定性分析支持了这一解释。在得分较低的译文中,修改往往集中在局部词汇替换和语法修正上,未能解决中文叙事线索与英文修辞框架之间更深层次的不匹配问题。而在得分较高的译文中,延迟进行的修改通常涉及信息结构的重组、选择性显化策略的引入,或调整评价性语言,以提升国际读者的理解性。具有代表性的弹幕评论译文——包括“这个表达非常中式”、“背景需要解释”以及“外国观众可能不理解这一指涉”——说明了与相应片段聚类相关的文化显著性受众关切类型。这些示例仅用于辅助解释,不应被解读为参与者意图的证据。
弹幕显著性与翻译瓶颈之间的重叠
最终分析考察了弹幕语料库中公众显著关注的片段是否与翻译过程中产生最大加工努力的片段重叠。通过标准化并加总首次停顿时长、长停顿频率和修订密度,为每个片段计算出一个综合努力指数。随后将基于该综合努力指数排名前20%的片段与基于弹幕显著性排名前20%的片段进行比较。
重叠程度显著:九个最高努力度片段中有六个也出现在九个弹幕显著性最高的片段中,对应66.7%的重叠率。由于前五分之一的比较仅涉及九个片段,威尔逊置信区间相对较宽(95% CI 约为35.4%–87.9%)。然而,精确的随机重叠分析表明,在随机分配的情况下,出现六个或更多重叠片段的可能性较低(p ≈ .001)。在片段层面,弹幕显著性与综合努力指数呈正相关(Spearman's ρ = 0.41, p = 0.006)。大多数重叠片段出现在文本B和C中,集中于文化嵌入性指涉、数字创业以及评价性立场表达。这些发现表明,公共话语可作为叙事意义尤为凸显之处的外部指标,但该关联仅为相关性,而非因果关系。
综上所述,这些发现表明,在翻译以中国为主题的叙事内容时,加工努力程度具有片段特异性,主要受文化负载、叙事压缩和评价密度的影响。翻译质量并不取决于总体修改量,而是取决于延迟性、语篇敏感性以及文化导向的修改策略。最后,高加工努力的翻译片段与弹幕显著的叙事节点之间的观察一致性,支持了受众显著性与译者加工努力之间存在关联性,但并不意味着弹幕显著性本身会导致翻译困难。
数据可用性:
所有原始数据、按键记录文件、处理后的片段级观测数据、会话级观测数据、弹幕视频元数据以及前5,000条显示的弹幕评论均提供在复现数据集工作簿中。完整的弹幕评论文件包含18,642条评论,已随数据集包一并存档。该数据集可通过Zenodo知识库获取,网址为 https://doi.org/10.5281/zenodo.19289665。
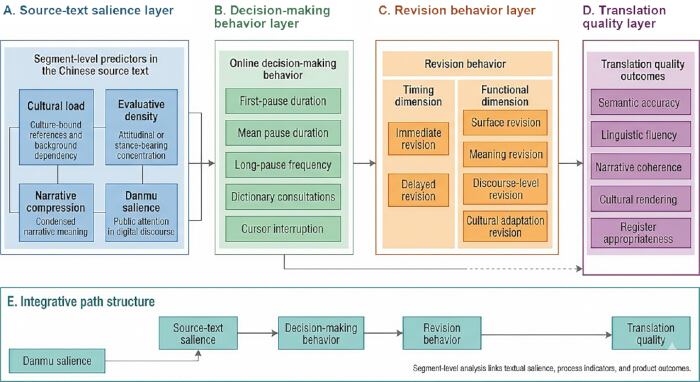
图 1: 本研究的概念框架。 (A)文本片段层面的预测因子,包括文化负载、评价密度、叙事压缩和弹幕显著性。(B)用于量化在线决策行为的过程指标,包括首次停顿时长、平均停顿时长、长停顿频率、词典查阅次数和光标中断次数。(C)根据修订时机与修订功能对修订行为进行的二维分类。(D)用于评估翻译质量的五个维度:语义准确性、语言流利性、叙事连贯性、文化表达恰当性以及语域适切性。(E)整体分析框架,展示源文本显著性、决策行为、修订行为与翻译质量之间的关系,其中弹幕显著性作为语义受众关注度的外部指标。本研究未进行或呈现探索性因子分析(EFA)或结构方程模型(SEM)。请点击此处查看此图的放大版本。
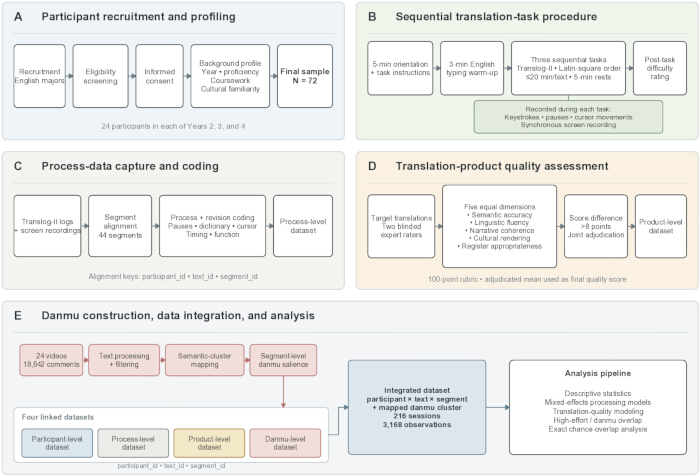
图 2: 数据采集与数据对齐的工作流程。 (A)参与者招募、资格筛选、知情同意及背景信息收集。(B)在标准化实验条件下,使用 Translog-II 实施三项翻译任务。(C)过程数据采集,包括击键、停顿、光标移动、修改片段及同步屏幕录制。(D)由专家盲评翻译成果,并对评分差异进行仲裁。(E)构建辅助弹幕语料库,并将其与参与者、文本、语段、过程及成果层面的数据集进行对齐,以生成最终用于推断性分析的整合数据集。请点击此处查看该图的放大版本。
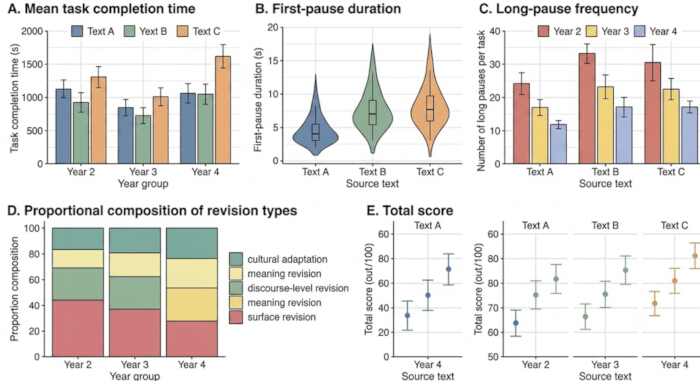
图3: 不同年级组和源文本在过程与结果指标上的分布情况。(A)按源文本和年级组划分的平均任务完成时间。(B)首次暂停时长在三种源文本中的分布情况。(C)按源文本和年级组划分的长暂停频率。(D)各年级组中修订类别的比例分布,包括表层修订、意义修订、语篇层面修订以及文化适应性修订。(E)各年级组对每种源文本的总体翻译质量评分。综合来看,各子图显示年级越高,处理中断越少,修订策略更具选择性,翻译质量也更高;而文本B和C相比文本A带来了更大的认知加工负荷。 请点击此处查看该图的高清版本。
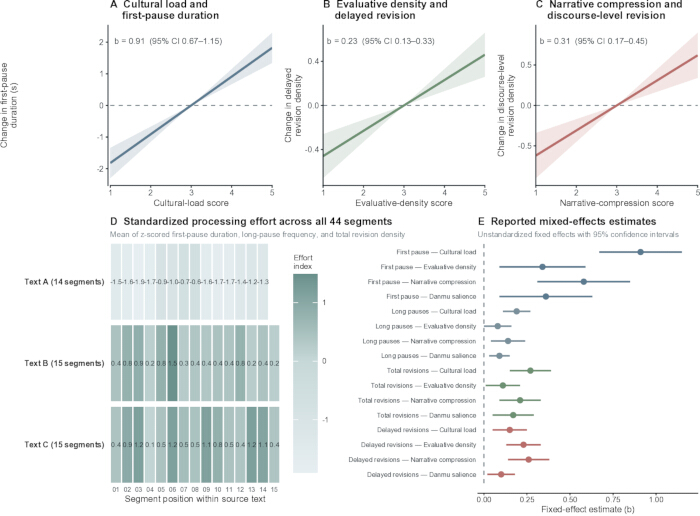
图 4: 文本显著性在片段层面对翻译过程行为的影响。 (A)文化负载对首次停顿时长的拟合边际效应。(B)评价密度对延迟修订密度的拟合边际效应。(C)叙事压缩对语篇层面修订密度的拟合边际效应。(D)按源文本分组的所有源文本片段中标准化加工努力指数的热图。(E)由混合效应回归模型估计的标准化固定效应系数。该图表明,不同的文本特征会激活不同的加工路径,文化负载、评价密度和叙事压缩通过部分不同的机制影响翻译中的犹豫与修订行为。请点击此处查看该图的放大版本。
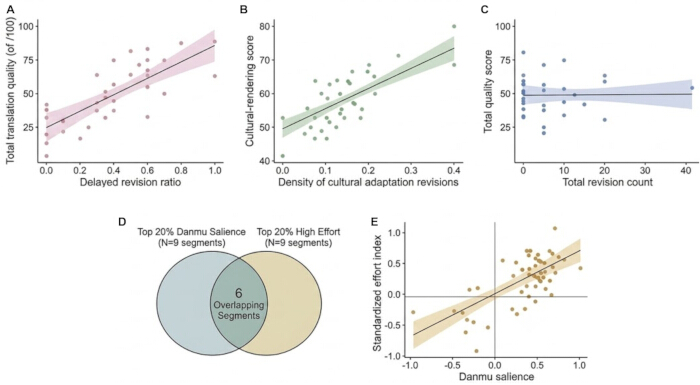
图5:翻译过程、翻译质量与弹幕显著性之间的关系。(A)延迟修订比例与总体翻译质量得分之间的关联。(B)针对文化适应的修订次数与文化表达得分之间的关系。(C)总修订次数与整体翻译质量之间的关联,表明仅凭修订数量对质量的预测价值有限。(D)弹幕显著性最高的前20%片段与翻译努力度最高的前20%片段之间的重叠情况。(E)弹幕显著性与标准化加工努力指数在片段层面的关联。综合来看,这些子图表明,成功的翻译表现与具有策略性时机和功能性目标的修订相关,而并非仅取决于修订量;同时,公众关注度高的叙事片段往往也与翻译过程中的瓶颈区域相重合。请点击此处查看该图的放大版本。
| 文本编号 | 叙事主题 | 汉字数量 | 分段数 | 文化负载评分(1–5) | 评价密度评分(1–5) | 叙事压缩评分(1–5) | 预测难度 | 验证说明 |
| Text A | 春节返乡叙事 | 212 | 14 | 3 | 2 | 3 | 中等 | 已由12名非参与者学生进行预测试 |
| Text B | 端午节记忆叙事 | 219 | 15 | 5 | 3 | 4 | 高 | 已由12名非参与者学生进行预测试 |
| Text C | 农村直播与家乡发展叙事 | 223 | 15 | 4 | 5 | 4 | 高 | 已由12名非参与者学生进行预测试 |
表1:源文本特征与片段结构。
| 变量 | 层级 | 操作定义 | 测量单位 |
| 首次停顿时长 | 片段 | 从片段开始到首次输入相关目标语言字符的时间 | 秒 |
| 片段内平均停顿时长 | 片段 | 片段内所有停顿时长的平均值 | 秒 |
| 长停顿频率 | 片段 | 持续时间超过2秒的停顿次数 | 计数 |
| 词典查阅次数 | 片段 | 片段处理过程中词典窗口激活的次数 | 计数 |
| 光标中断次数 | 片段 | 在文本未稳定完成前,基于光标操作偏离线性撰写过程的次数 | 计数 |
| 即时修改 | 片段 | 在撰写尚未超出当前局部文本区域时进行的修改 | 计数 / 密度 |
| 延迟修改 | 片段 | 在撰写已推进至后续文本区域后进行的修改 | 计数 / 密度 |
| 表层修改 | 修改功能 | 不引起语义变化的表层形式修正 | 计数 / 密度 |
| 意义修改 | 修改功能 | 影响意义表达的词汇或句法调整 | 计数 / 密度 |
| 语篇层面修改 | 修改功能 | 对从句关系、连贯性或信息顺序的调整 | 计数 / 密度 |
| 文化适应性修改 | 修改功能 | 面向目标受众对文化相关意义进行重构或显化 | 计数 / 密度 |
| 综合努力指数 | 片段 | 基于首次停顿时长、长停顿频率和修改密度的标准化综合指标 | z分数 |
| 弹幕显著性 | 片段 / 语义簇 | 基于标准化关键词簇频率、评论集中度和评价强度加权的语义簇代理指标 | 连续分数 |
表2:过程变量的操作性定义。
| 语义准确性 | 评分范围 | 评分重点 |
| 语义准确性 | 1-20 | 忠实于原文含义、传递内容的精确性以及无重大扭曲 |
| 语言流畅性 | 1-20 | 语法正确性、自然度、惯用表达及句子层面的可读性 |
| 叙述连贯性 | 1-20 | 信息流、从句衔接、逻辑推进及文本稳定性 |
| 文化适切性 | 1-20 | 对文化专有项的处理、显化程度、语境构建及解释性可及性 |
| 语域恰当性 | 1-20 | 与目标读者的匹配度、风格适宜性及语调把控 |
表3:翻译质量评分标准。
| 部分 | 变量 | 第2年 (n = 24),均值 ± 标准差 | 第3年 (n = 24),均值 ± 标准差 | 第4年 (n = 24),均值 ± 标准差 |
| 参与者会话层面特征 | 任务完成时间 (sec) | 1070.84 ± 18.22 | 996.59 ± 20.08 | 927.76 ± 19.91 |
| 参与者会话层面特征 | 首次停顿平均持续时间 (sec) | 7.09 ± 0.50 | 6.65 ± 0.40 | 6.38 ± 0.41 |
| 参与者会话层面特征 | 每项任务的长停顿频率 | 21.04 ± 0.32 | 18.47 ± 0.30 | 16.31 ± 0.19 |
| 参与者会话层面特征 | 每项任务的总修订次数 | 28.65 ± 2.87 | 26.24 ± 2.63 | 24.59 ± 2.42 |
| 修订配置 | 延迟修订比例 | 0.45 ± 0.01 | 0.54 ± 0.01 | 0.63 ± 0.01 |
| 修订配置 | 语篇层面修订比例 | 0.37 ± 0.01 | 0.40 ± 0.01 | 0.45 ± 0.01 |
| 修订配置 | 文化适应性修订比例 | 0.38 ± 0.01 | 0.42 ± 0.00 | 0.48 ± 0.01 |
| 修订配置 | 表层修订比例 | 0.04 ± 0.00 | 0.02 ± 0.00 | 0.00 ± 0.00 |
| 产出质量 | 总质量评分 | 77.82 ± 4.65 | 84.03 ± 4.44 | 88.27 ± 4.56 |
| 产出质量 | 文化表达评分 | 77.73 ± 4.49 | 83.95 ± 4.85 | 88.18 ± 4.86 |
表4:过程与产品变量的描述性统计。
| 结果变量 | 预测因子 | b | 标准误 | 95% 置信区间 | t/z | p |
| 首次停顿时长 | 文化负载 | 0.91 | 0.12 | [0.67, 1.15] | 7.58 | < 0.001 |
| 首次停顿时长 | 评价密度 | 0.34 | 0.13 | [0.09, 0.59] | 2.62 | 0.01 |
| 首次停顿时长 | 叙事压缩 | 0.58 | 0.14 | [0.31, 0.85] | 4.14 | < 0.001 |
| 首次停顿时长 | 弹幕显著性 | 0.36 | 0.14 | [0.09, 0.63] | 2.55 | 0.011 |
| 长停顿频率 | 文化负载 | 0.19 | 0.04 | [0.11, 0.27] | 4.75 | < 0.001 |
| 长停顿频率 | 评价密度 | 0.08 | 0.04 | [0.00, 0.16] | 2 | 0.046 |
| 长停顿频率 | 叙事压缩 | 0.14 | 0.05 | [0.04, 0.24] | 2.8 | 0.005 |
| 长停顿频率 | 弹幕显著性 | 0.09 | 0.03 | [0.03, 0.15] | 3 | 0.003 |
| 总修订密度 | 文化负载 | 0.27 | 0.06 | [0.15, 0.39] | 4.5 | < 0.001 |
| 总修订密度 | 评价密度 | 0.11 | 0.05 | [0.01, 0.21] | 2.2 | 0.028 |
| 总修订密度 | 叙事压缩 | 0.21 | 0.06 | [0.09, 0.33] | 3.5 | < 0.001 |
| 总修订密度 | 弹幕显著性 | 0.17 | 0.06 | [0.05, 0.29] | 2.75 | 0.006 |
| 延迟修订密度 | 文化负载 | 0.15 | 0.05 | [0.05, 0.25] | 3 | 0.003 |
| 延迟修订密度 | 评价密度 | 0.23 | 0.05 | [0.13, 0.33] | 4.6 | < 0.001 |
| 延迟修订密度 | 叙事压缩 | 0.26 | 0.06 | [0.14, 0.38] | 4.33 | < 0.001 |
| 延迟修订密度 | 弹幕显著性 | 0.1 | 0.04 | [0.02, 0.18] | 2.5 | 0.013 |
| 总质量评分 | 总修订次数 | 0.04 | 0.05 | [-0.06, 0.14] | 0.82 | 0.412 |
| 总质量评分 | 延迟修订比例 | 1.12 | 0.37 | [0.39, 1.85] | 3.03 | 0.003 |
| 总质量评分 | 语篇层面修订 | 1.76 | 0.41 | [0.96, 2.56] | 4.29 | < 0.001 |
| 总质量评分 | 文化适应性修订 | 2.04 | 0.46 | [1.14, 2.94] | 4.43 | < 0.001 |
| 总质量评分 | 表层修订 | -0.63 | 0.28 | [-1.18, -0.08] | -2.25 | 0.028 |
| 总质量评分 | 年级组 | 3.48 | 0.69 | [2.13, 4.83] | 5.04 | < 0.001 |
表5:预测片段水平过程行为与翻译质量的混合效应模型。
讨论
本研究结果表明,以中国为主题的叙述文本在从中文到英文的翻译过程中,其难度并非均匀分布于全文,而是集中在文化指涉、评价立场以及叙事意义高度压缩的文本片段中。这一发现支持了基于翻译过程的难度观,而非词汇缺失的难度观。实证翻译过程研究强调,翻译是一种时间上有组织的活动,其中停顿、定向和产出在时间上分布不均19。本研究观察到的努力集中现象反映了特定文本片段施加了更大的解释压力,从而比其他部分更深刻地干扰了线性写作进程。假设检验可总结如下:H1 得到支持,因为文化负载增加了早期犹豫和修订密度;H2 得到修正,因为评价密度和叙事压缩通过不同的修订路径发挥作用;H3 得到支持,因为修订的时间和功能比总修订次数更能预测翻译质量;H4 得到支持,表现为弹幕显著性与高努力片段之间存在关联性重叠,而非因果关系。
关于修改行为,数据显示,总修改次数并不能预测翻译质量;相反,延迟性修改、语篇层面修改以及文化适应性修改才是提升表现的主要驱动因素。这一区别表明,只有当修改作为有结构的重新评估时才具有成效,而非仅仅进行重复的局部修补。这与眼动追踪和键盘记录研究的结果一致,即当任务难度增加时,新手译者会以不同方式分配精力,而本研究中表现更优的学生并非只是更积极地进行修改7。他们会选择性地中断初步方案,在后续阶段重新评估,并将修改重点放在叙事连贯性或文化适切性上。因此,仅凭最终译文得分不足以解释译者的表现,因为相似的最终评分往往源于截然不同的认知过程轨迹9。
这一现象最好通过努力转化的视角来理解。在得分较低的译文中,认知努力停留在局部层面——学生会暂停、替换词汇项或调整冠词,却未能解决源文本含义与目标文本框架之间的深层不匹配问题。相反,得分较高的译文显示出努力被转化为结构性决策,从而优化了文本以适应目标读者。这些结果与学生译后编辑表现的相关研究相呼应,证实了加工过程中的努力并不自动产生益处;其价值取决于能否将这种努力转化为可被理解的文本改进。20.
此外,不同的文本特征会激活不同的加工机制。文化负载显著增加了早期犹豫和局部修改的密度,而叙事压缩则强烈预测了篇章层面的修改行为。这一区别阐明了为何翻译过程中困难片段的表现形式各不相同:某些文本因素在初始表述阶段即干扰了认知通达,而另一些因素则仅在维持较大语篇范围内的连贯性过程中才显现为问题。与已有研究一致,这些研究显示困难文本会导致更小的加工单位和更密集的中断;本研究结果进一步强调,浓缩的文化内涵与评价性意义迫使译者在局部表达与整体叙事框架之间不断切换。8.
本研究在方法论上的一个重要贡献是将弹幕显著性作为受众话语层面进行整合。高努力翻译片段与弹幕显著性片段之间存在显著重叠,表明学生遇到的瓶颈往往与在数字传播中引起受众高度关注的节点相吻合。这将翻译难度与参与式话语联系起来,但并未将二者混为一谈。弹幕评论揭示了受众在视频媒介传播过程中所关注或争议的内容,而键盘敲击记录和修改记录则揭示了学生译者如何处理源语文本中语义相关的片段。因此,最合理的解释是一种共同线索假说:文化负载的指涉、压缩的背景假设以及评价性立场可能同时吸引受众注意并增加译者的加工压力21。
从教学法角度来看,这种重叠表明,以中国为主题的叙事在意义被公开且快速协商的语境中传播,其传播过程受制于即时性、可理解性与受众契合度等相互竞争的优先考量22。因此,翻译培训必须从将修改视为一种通用的校对环节,转向强调具有功能性和时间策略性的干预措施。观察到的翻译瓶颈很少仅由术语问题造成;它们往往出现在叙事意义依赖于文化背景预设、关系性框架以及受众选择性接触的情境中。与中华各民族叙事文学的传播类似,这些叙事的跨语际传递需要超越词汇层面的忠实,转而思考如何重构本土文化意义,以适应更广泛的全球传播23。该方法可在翻译教学中加以应用,通过使用击键日志、屏幕录制以及受众话语实例,帮助学生识别何时需要对文本片段进行显化、语序调整、文化框架重构或语域调整,而非简单的词汇替换。
这些研究结果的解释存在若干局限性。首先,弹幕显著性是观众参与度的语义聚类代理指标,而非语言难度的直接测量,且当前的相关性设计无法确立公众显著性与翻译努力之间的因果关系。未来的研究可通过对文化负载、评价密度和叙事压缩进行实验性操控,以检验其因果路径。其次,样本仅限于来自一所大学的翻译受训者,参与者的经验、文化熟悉度和第二语言熟练程度是通过统计方法控制的,而非通过完全分层抽样的方式。若能以职业译者、来自多个机构的学生以及更广泛语言熟练度水平的群体进行重复验证,将增强结果的可推广性。第三,源文本由研究人员构建并经过预实验测试以校准任务难度,但未来研究应增加使用真实公众文本的验证,并引入独立的材料开发小组。第四,文化负载、评价密度、叙事压缩以及修订功能的编码依赖于透明的操作定义、独立编码员的记录以及可验证的评分者间信度,并结合经仲裁的编码文件进行。未来的研究还可结合击键记录、眼动追踪、回溯性访谈、出声思维法或译后编辑任务,以三角验证支撑修订决策的认知机制。
本研究最终阐明了学生在涉及中国主题的汉译英过程中的表现机制。通过整合键盘记录数据、译文成果评估以及数字受众话语分析,研究结果表明,翻译瓶颈出现在具有公共情感色彩的叙事意义节点上。跨文化翻译的决定性因素并非修改次数的多寡,而是译者能否识别出需要进行阐释性重构的文本片段,并有策略地延迟定稿,直至形成稳定且符合受众期待的解决方案。
披露
作者们已经 无利益冲突声明。
作者贡献
Weijia Chen:研究构想、方法学、正式分析、调查、撰写初稿。
Chunming Wu: 研究设计、正式分析与数据处理流程的指导,以及对审稿意见修改稿的审阅与反馈。
致谢
本研究得到了韩山师范学院两项资助项目的支持。具体而言,本研究是2023年线下一流本科课程“汉英翻译理论与实践II”(批准号:YHS〔2023〕172)的阶段性研究成果。此外,本研究还获得了2025年教学质量与教学改革工程“课程思政”示范课程“汉英翻译”项目(批准号:YHSJ〔2025〕126)的资助。作者衷心感谢机构为本研究完成所提供的支持。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| 哔哩哔哩弹幕语料库 | Bilibili | 24 个视频;18,642 条评论;https://www.bilibili.com | 辅助弹幕语料库的构建及片段级弹幕显著性计算 |
| Microsoft Excel | Microsoft Corporation | Excel 2021;https://www.microsoft.com/microsoft-365/excel | 数据清洗、编码整理及初步数据管理 |
| R | R Foundation for Statistical Computing | R 4.3.1;https://www.r-project.org | 混合效应模型分析、相关性分析及图表生成 |
| 屏幕录制软件 | 实验室工作站 | 本地工作站工具;无目录号 | 非线性修改片段的验证及过程数据备份 |
| SPSS | IBM Corporation | SPSS Statistics 27.0;https://www.ibm.com/products/spss-statistics | 描述性统计、方差分析及基础统计分析 |
| Translog-II | Copenhagen Business School / CRITT | Translog-II;https://sites.google.com/site/centretranslationinnovation/translog-ii | 翻译任务中的击键记录,以及对停顿、光标移动和修改过程的记录 |
参考文献
- Valdeón RA, Li S. Political discourse translation in contemporary Chinese and Western contexts. Translator. 2024;30(4):1-14.
- Du L, Afzaal M. Analyzing modality-mediated ideology in translated Chinese political discourses: An ideological square model approach. Humanit Soc Sci Commun. 2024;11:956.
- Carl M. Empirical translation process research: Past and possible future perspectives. Transl Cogn Behav. 2024;6(2):252-274.
- Qassem M, Al Thowaini BM. Cognitive processes and translation quality: Evidence from keystroke-logging software. J Psycholinguist Res. 2023;52(5):1589-1604.
- Carl M, et al. Hesitation, orientation, and flow: A taxonomy for deep temporal translation architectures. Ampersand. 2024;12:100164.
- Swar O, Mohsen M. Students' cognitive processes in L1 and L2 translation: Evidence from a keystroke logging program. Interact Learn Environ. 2023;31(10):6247-6263.
- Wang Y, Li S, Rasmussen YZ. Translators' allocation of cognitive resources in two translation directions: A study using eye-tracking and keystroke logging. Appl Sci. 2025;15(8):4401.
- Wang F, Xu Q. Processing of translation units by student and semi-professional translators in translating texts with different levels of translation difficulty. PLoS One. 2025;20(4):e0320809.
- Chen X, Yan JX. Examining student translators' writing and translation products: Quality, errors, and self-perceived mental workload. Interpret Transl Train. 2024;18(3):465-485.
- Dong D, Chen ML. Metacognitive strategies in translation: A comparative study of student and professional translators. Humanit Soc Sci Commun. 2025;12:890.
- Chen X, Yan JX. Investigating the processing effort in translation students' L2 writing and L2 translating: Evidence from keylogging. Humanit Soc Sci Commun. 2025;12:1810.
- Cao L, Doherty S, Lee JF. The process and product of translation revision: Empirical data from student translators using eye tracking and screen recording. Interpret Transl Train. 2023;17(4):548-565.
- Van Egdom GW, Schrijver I, Verplaetse H, Segers W. The impact of collaborative processes on target text quality in translator training. Interpret Transl Train. 2024;18(3):486-506.
- Riondel A. How to teach revision: Tips from an interview study. Interpret Transl Train. 2024;18(3):507-522.
- Lu S, Chen X. An experimental study on viewing perception and gratification of danmu subtitled online video streaming. J Spec Transl. 2024;42:217-238.
- Lei Y, Peng M, Han Y. Mistaken presuppositions and the translation of cultural texts: A study of two English translations of The Classic of Tea. Perspectives. 2025. doi:10.1080/0907676X.2025.2599854.
- Kim HR. Danmu as paratext: An exploratory study of paratextual functions in Chinese fan-subtitled videos. J Transl Stud. 2025;26(3):197-231.
- Wu X, Fitzgerald R. The danmu discourse of user engagement with cross-posted broadcast interviews in Chinese social media. Journalism. 2025;26(3):733-751.
- Yamada M, Carl M, Schaeffer MJ. Introduction to the special Ampersand issue on empirical translation process research. Ampersand. 2024;12:100179.
- Peng X, Wang X, Li X. When student translators meet with machine translation: The impacts of machine translation quality and perceived self-efficacy on post-editing performance. SAGE Open. 2024;14(4):21582440241291624.
- Yang Y. Making sense of the raw meat: A social semiotic interpretation of user translation on the danmu interface. Discourse Context Media. 2021;44:100550.
- Zeng D. Danmu subtitling as a self-regulative practice: A descriptive discourse analysis of Bilibili danmu subtitles from ethical perspectives. Front Psychol. 2025;16:1577260.
- Li Y, Cai X. The translation of ethnic literature: An analysis of the Chinese and English translations of the Yi folk narrative poem Ashima and their dissemination. Perspectives. 2025. doi:10.1080/0907676X.2025.2502935.