本方法提出了一种基于可解释人工智能(XAI)的综合框架,旨在通过在受控云环境中使用合成医疗数据集,实现安全的医疗云数据迁移。该方案最终构建出一个原型系统,结合了零信任安全机制、基于时间的访问控制以及可解释的异常检测,以支持数据迁移过程的透明性与安全性。
需要JoVE订阅才能观看此内容。 请登录或开始免费试用
本文内容
摘要
摘要
在医疗保健系统中,越来越多的数据正在向云端迁移,但这也使得数据传输过程可能成为安全方面风险最大的环节。本文描述了一种基于可解释人工智能(XAI)的可复现安全云数据迁移协议,使用合成医疗数据集和受控的云环境进行实现。所开发的框架融合了零信任架构、时间最小权限、加密通信、集中监控以及可解释的异常检测机制,以实现更安全、透明且可审计的数据迁移。测试采用一个10 GB的合成电子健康记录数据集,包含约2000万条记录,分布在28个关系型数据表中。迁移过程在亚马逊网络服务(AWS)上进行,使用PostgreSQL数据库和私有虚拟网络。异常检测采用孤立森林(Isolation Forest)算法,而安全事件的解释则通过SHAP(Shapley加性解释)方法实现。该框架在十次独立的迁移尝试中进行了评估,评估指标包括凭证暴露时长、事件检测时间、异常检测准确率、迁移延迟和数据完整性。在测试配置下,凭证暴露时间从24小时减少至1小时(降低了95.8%),异常检测准确率达到97.4%,事件检测时间缩短至约15分钟,并通过校验和验证确保了100%的数据完整性。然而,更强的安全措施导致平均迁移延迟增加了11%。这些结果表明,将可解释人工智能与安全云迁移工作流程相结合,在管理医疗数据方面具有广阔的应用前景。
引言
云计算现已成为全球医疗系统的重要组成部分,可提供可扩展的存储空间、计算资源,并通过云实现健康记录的交换、支持决策系统以及开展健康数据分析1,2,3。随着许多医疗机构升级其信息系统,将数据从传统的本地系统迁移至云端已成为关键步骤4。恰当的数据迁移有助于更便捷地检索数据、更高效地运行操作,并支持智能化程度更高的数据分析;但与此同时,也必须正视在数据传输过程中所伴随的严重安全与隐私风险5。
在数据生命周期中,迁移阶段是一个众所周知的脆弱环节,因为医疗保健数据在迁移过程中会主动在系统和网络之间传输6。此外,组织在数据迁移阶段可能面临诸如凭证被黑客攻击、未授权访问、数据截获、操纵行为甚至数据丢失等安全威胁6,7。由于患者信息高度敏感,医疗环境对这类风险的抵御能力较弱,因此必须严格遵守监管要求和安全措施,达到最高合规标准8,9。若无法确保迁移流程的安全性并实现流程的可观测性,则无法有效保障数据的机密性、完整性和可追溯性10,11。
为了提升云安全,人们已开发出多种安全框架和标准。例如,美国国家标准与技术研究院(National Institute of Standards and Technology, NIST)提出的零信任架构(Zero Trust Architecture)强调持续验证用户、设备和服务的安全性12,而云采用框架则为治理、身份管理、加密和监控等方面提供指导13。事实上,当前的云安全方法主要聚焦于自动化、基础设施即代码(infrastructure-as-code)以及持续监控14,15。尽管这些方法基于重要的安全原则,但它们在很大程度上关注的是通用的云部署和运行环境,而非迁移过程本身16。实际上,目前尚缺乏针对医疗健康领域云数据安全迁移的分步、详细且可复现的操作流程,以整合身份管理、安全数据传输、验证、监控以及迁移后的安全加固等关键环节17。
机器学习异常检测已被公认为在云环境安全监控中具有重要作用的技术。它能够检测异常的系统活动以及潜在的安全事件18。然而,许多异常检测方法是封闭系统,无法对安全事件被标记的决策依据提供解释19。系统无法解释其决策会降低管理员的信任度,使审计工作变得困难,并削弱在高度监管的医疗环境中自动化安全决策的价值20。可解释的人工智能(XAI)方法,如SHapley Additive exPlanations(SHAP)和局部可解释模型无关解释(Local Interpretable Model-agnostic Explanations, LIME),不仅能为机器学习预测提供清晰的解释,还能增强对安全监控系统的理解、问责性和可信度21,22。
尽管云安全和可解释的人工智能已取得显著进展,但在实现集成方面,仍缺乏将安全迁移控制与可解释的安全监控相结合的可重复实验方案23。现有研究大多仅针对单一组件,例如加密、访问控制、异常检测或云治理,且均未提供可系统实施、评估和复现的集成化方法论24。此外,几乎没有任何研究尝试将零信任安全原则、时间最小权限、集中可观测性以及可解释的异常检测整合到单一的医疗云迁移工作流程中25,26。
本文提出了一种基于可解释人工智能(Explainable AI)的框架,旨在填补医疗系统中安全云数据迁移的空白。该架构在有序的数据迁移流程中,采用零信任模型、限时访问、安全通信、集中日志记录与监控,以及基于SHAP的可解释异常检测方法27,28。该协议为在实验条件下实施、监控和评估安全的医疗数据迁移提供了分步指导。通过将安全控制措施与人工智能可解释的监控机制相结合,所提出的框架旨在提升整个数据迁移生命周期中的透明度、可审计性和安全性29,30。
访问受限。请登录或开始试用以查看此内容。
方案
本研究使用了一个完全合成的医疗保健数据集,该数据集是为安全云数据迁移的实验评估而生成的。未使用任何真实患者数据、受保护的健康信息(PHI)或可识别的医疗记录。因此,无需机构审查委员会批准和知情同意。本研究中使用的所有材料均包含在材料表中。
1. 概述
- 配置一个安全的云迁移环境,该环境由源层、迁移中心层、目标层、网络层、身份与访问管理层、可观测性层以及可解释人工智能层组成。
- 在隔离的云环境中部署所有组件,以支持医疗健康数据的安全迁移。在所有系统组件之间建立加密通信通道。
- 通过数据集准备、环境配置、架构部署、安全迁移、异常监控和迁移后验证等步骤执行协议。所提出的可解释人工智能驱动的安全云数据迁移框架的整体架构如图1所示。
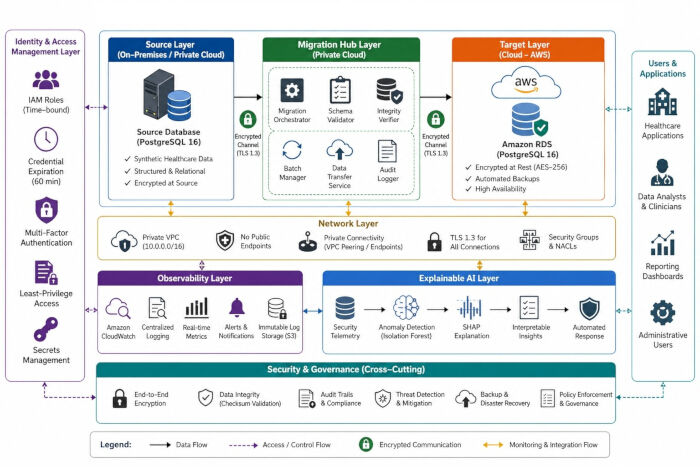
图 1: 面向医疗系统的可解释人工智能(XAI)驱动的安全云数据迁移框架的整体架构。 该框架包括身份与访问管理层、源数据库层、迁移中心层、目标云数据库层、网络安全层、可观测性层、可解释 AI 监测层,以及贯穿各层的安全与治理服务。该架构集成了基于时间的最小权限访问控制、TLS 1.3 加密通信、基于校验和的完整性验证、持续安全监控以及基于 SHAP 的可解释性机制,以实现安全、透明且可重复的医疗数据库迁移。本图由作者使用 Microsoft PowerPoint(Microsoft 365)创建。 请点击此处查看此图的放大版本。
2. 计算环境配置
- 配置计算环境
- 准备用于安全云端数据迁移和基于可解释人工智能的监测所需的计算资源。
- 安装并配置 材料表 中列出的全部硬件、软件、云服务、数据库、安全工具和机器学习库。在启动迁移实验前,验证所有必需组件均正常运行。
- 配置云环境
- 建立一个适用于医疗数据迁移的安全云环境。设置私有虚拟私有云(VPC),以实现源系统、迁移中心与目标系统之间的无缝通信。不仅在数据静态存储时,也在数据传输过程中采用强加密措施。
- 根据 材料表 中所述的详细信息,准备目标数据库和迁移服务。
- 配置身份与访问管理,配置监控和日志服务。
3. 数据集准备与描述
- 使用材料表中列出的 Faker Python 库生成合成医疗保健数据集。通过预定义的概率分布配置人口统计学属性,包括患者年龄、性别、种族和地理位置。
- 生成临床信息,包括诊断、实验室结果、药物、过敏史、医疗操作和住院记录,同时保持真实的临床关联关系。
- 通过根据预定义的就诊频率分布为个体患者分配多次就诊记录,生成纵向患者就诊数据。
- 使用按时间顺序排列的事件顺序,为入院、实验室检查、药物给药、出院摘要和审计日志生成时间戳。
- 根据预定义的数据质量分布,引入具有临床合理性的缺失值、重复记录和异常值观测。
- 使用 Faker 库生成的合成值替换所有个人身份信息。在导出数据集之前验证引用完整性与逻辑一致性。将以 PostgreSQL 兼容的 SQL 格式导出经过验证的数据集。配置数据集以支持真实的医疗数据迁移场景。生成数据集的特征汇总于 表 1 中。
- 定义数据库关系。将 Patient_ID 设为患者表的主键。在患者、就诊、实验室、药物和审计日志表之间建立外键关系。在启动迁移前验证所有表之间的引用完整性。
- 模拟真实的医疗数据特征。使用正态分布生成患者年龄。使用泊松分布生成就诊频率。以 5% 的比例引入缺失值,以模拟真实世界电子健康记录(EHR)的不完整性。在迁移前将所有患者标识符替换为哈希值。验证所有生成的记录均符合预定义的模式约束。
- 在迁移前通过检查模式一致性、引用完整性、缺失值、重复记录和预定义的质量约束来验证生成的数据集。
| 参数 | 数值 |
| 数据集类型 | Synthetic Healthcare EHR Dataset |
| 数据集大小 | 10 GB |
| 总记录数 | 20 Million |
| 表数量 | 5 Core Tables- 28 relational tables |
| 患者记录 | 5,000,000 |
| 就诊记录 | 10,000,000 |
| 实验室检测结果 | 4,000,000 |
| 用药记录 | 3,000,000 |
| 审计日志 | 5,000,000 |
| 主键 | Patient_ID |
| 缺失值率 | 5% |
| 年龄分布 | 正态分布 |
| 就诊频率 | 泊松分布 |
| 完整性阈值 | <0.1% Violations |
表1:用于协议验证的合成医疗数据集的特征。 该表格概述了数据集的基本信息,包括数据库规模、关系表数量、总记录数、患者属性、临床变量以及用于重现安全迁移实验的验证特征。
4. 系统架构部署
- 部署由源层、迁移中心层、目标层、网络安全层、可观测性层和可解释人工智能层组成的安全云迁移架构。本研究中所使用的已部署系统架构如图2所示。
- 该框架由六个工作层组成,在迁移过程中各层依次执行其功能。第一层为源层,用于存储合成的医疗保健数据库。
- 迁移中心负责模式提取、加密数据传输、完整性验证以及迁移编排。目标层用于存储迁移至 Amazon RDS PostgreSQL 的数据库。
- 网络安全层通过私有 VPC 端点、TLS 1.3 加密、安全组和网络访问控制列表来保障所有通信的安全。
- 可观测性层持续借助 Amazon CloudWatch 收集身份验证日志、迁移日志、数据库活动日志和安全事件。
- 可解释人工智能层接收已收集的安全遥测数据,通过隔离森林(Isolation Forest)算法进行处理,并对发现的异常生成基于 SHAP 的解释。所有架构层之间通过经过身份验证的私有网络通道进行通信,贯穿整个迁移工作流程。
- 部署并验证源数据库环境,以确保在迁移前实现安全访问和数据可用性。
- 使用合成的医疗保健数据集建立 PostgreSQL 16 数据库。在源数据库中保存患者信息、就诊记录、实验室结果、药品记录和审计日志。
- 仅允许授权的迁移服务和管理用户访问数据库。在启动迁移操作前,验证数据库的可用性和连接性。
- 配置迁移中心,以协调模式提取、加密数据传输和迁移编排。
- 在私有虚拟私有云(VPC)内部署专用的迁移服务器。配置迁移编排服务,以协调模式提取、数据传输和验证操作。
- 启用模式验证服务,以验证源环境与目标环境之间的兼容性。启用完整性验证服务,以在数据传输过程中及完成后验证迁移数据的完整性。在执行迁移任务前,验证迁移中心与数据库系统之间的通信。
- 部署目标层。将 Amazon RDS PostgreSQL 16 作为目标数据库环境进行部署。启用自动备份和恢复服务。为目标数据库中存储的数据启用 AES-256 加密。
- 配置网络安全。禁用与迁移资源相关联的所有公共 IP 地址。仅允许通过 VPC 内的私有端点进行通信。配置网络访问控制列表(NACLs)和安全组。对系统组件之间的所有通信启用 TLS 1.3 加密。验证是否不存在仍处于活动状态的可公开访问的端点。
- 配置集中监控,以持续收集安全事件、迁移日志和系统性能指标。
- 启用 Amazon CloudWatch 日志记录和监控服务。收集身份验证日志、迁移日志、数据库活动日志和安全事件日志。配置日志保留期为 365 天。启用不可变日志存储,以满足审计和合规性要求。验证实时指标采集和告警生成功能。
- 配置可解释人工智能环境,以执行实时异常检测并生成可解释的安全分析结果。
- 在监控环境中部署异常检测服务。配置可解释人工智能框架,以处理迁移过程中生成的安全遥测数据。连接来自源系统、迁移中心、目标数据库和监控服务的安全遥测数据流。
- 启用实时异常检测和基于 SHAP 的解释生成功能。在启动迁移实验前,验证遥测数据的成功摄入。
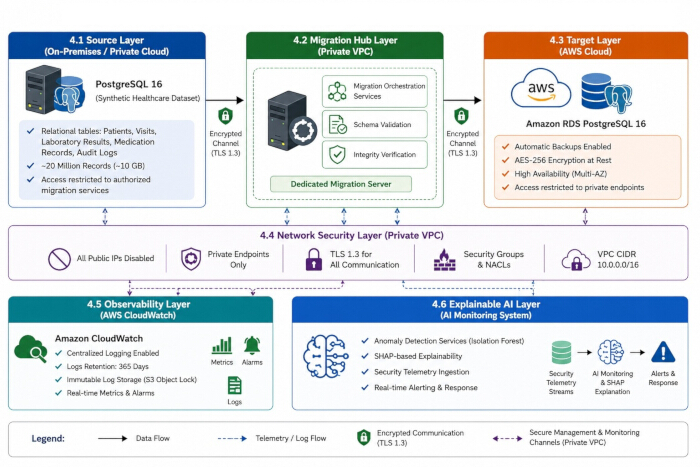
图 2: 安全医疗云迁移框架的部署架构。 部署环境展示了包含合成医疗数据集的源 PostgreSQL 数据库、位于私有虚拟私有云(VPC)内的专用迁移中心、Amazon RDS PostgreSQL 目标数据库、网络安全部分、通过 Amazon CloudWatch 实现的集中可观测性,以及可解释人工智能(AI)监控层。所有通信均通过受 TLS 1.3 加密保护的私有端点进行。本图由作者使用 Microsoft PowerPoint(Microsoft 365)创建。 请点击此处查看此图的放大版本。
5. 安全迁移工作流程
注意:通过执行威胁建模、模式迁移、安全数据迁移、迁移验证以及迁移后加固来完成安全迁移工作流程。
- 在启动迁移流程之前,识别潜在的安全威胁,并制定相应的缓解控制措施。
- 识别迁移资产、潜在的攻击途径以及可能发生的网络攻击场景。
- 评估因认证令牌泄露导致的凭证窃取、内部人员通过未授权的管理员访问发起的攻击、针对先前截获的认证请求实施的重放攻击、试图拦截加密通信通道的中间人(MITM)攻击、在迁移过程中篡改数据库结构的模式篡改攻击,以及旨在获取未授权管理员权限的权限提升攻击。
- 检查采用临时最小权限凭证管理机制是否足以防止凭证窃取和权限提升攻击。验证使用 TLS 1.3 加密的通信能否有效防御重放攻击和中间人攻击。
- 验证身份与访问管理(IAM)策略是否能够阻止未授权的管理员访问。确认持续的审计日志记录了所有与安全相关的迁移活动。确保通过 SHA-256 校验和检查能够检测到对数据库模式或数据的未授权更改。
- 验证可解释的异常检测框架能够定位异常的迁移行为,并提供可解读的安全解释。为每个已识别的威胁制定对应的安全控制映射表。在开始数据库迁移前,确认所有已识别的威胁均已得到充分缓解。作者在表 2中总结了威胁模型与安全控制措施。
- 迁移数据库模式。从源 PostgreSQL 数据库中提取模式定义。验证模式与目标数据库环境的兼容性。检查表结构、主键、外键、索引及约束条件。将验证后的模式定义部署至目标数据库。在数据迁移前确认模式已成功部署。
- 通过加密通信通道安全迁移医疗数据,同时对迁移活动进行持续监控。
- 将迁移批次大小配置为每事务 10,000 条记录。使用 TLS 1.3 建立加密通信通道。通过虚拟私有云(VPC)内的私有网络端点传输数据。
- 启用自动重试机制,对失败事务最多重试三次。
保持数据传输吞吐量在 100 MB/s 至 150 MB/s 之间。在整个传输过程中持续监控迁移活动。将所有迁移事件记录到集中式审计日志中。
- 通过比对校验和、记录数量及数据库结构,验证迁移的完整性与完成度。
- 在迁移前生成所有源表的 SHA-256 哈希值,在迁移后生成所有目标表的 SHA-256 哈希值。比对源端与目标端的校验和值。交叉核对源数据库与目标数据库的行数。检查模式、表间关系及数据库约束的一致性。仅当校验和值、记录数量和模式结构完全一致时,方可视为迁移成功。
- 在数据迁移成功完成后,移除临时权限并完成安全控制的最终配置。
- 在迁移完成后立即撤销所有临时迁移凭证。从服务账户中移除提升的迁移权限。归档审计日志与安全监控记录。
- 验证备份流程已成功完成。停用临时迁移服务器及相关资源。对已迁移的环境执行最终安全审查。记录迁移结果与验证结果。本研究中使用的完整安全迁移工作流程如图 3所示。
| 威胁场景 | 安全控制 | 检测方法 | 缓解措施 |
| 凭证窃取 | 临时最小权限(TLP) | 身份与访问管理日志(IAM logs) | 自动撤销凭证 |
| 内部人员攻击 | 基于角色的访问控制(RBAC) | 审计日志 + SHAP | 终止会话 |
| 重放攻击 | TLS 1.3 + 随机数验证(Nonce validation) | 网络监控 | 拒绝重复请求 |
| 中间人攻击(MITM) | TLS 1.3 加密 | 证书验证 | 加密通信 |
| 模式篡改 | SHA-256 校验和 + 模式验证(schema validation) | 完整性验证 | 恢复已验证的模式 |
| 权限提升 | 身份与访问管理策略强制执行(IAM policy enforcement) | 安全日志 | 撤销权限 |
表2:所提出的迁移框架中威胁模型及相应的安全措施。 该表格概述了主要的代表性安全威胁及其对应的缓解机制,这些机制基于零信任安全原则、加密、身份管理、完整性验证、监控以及可解释的异常检测。
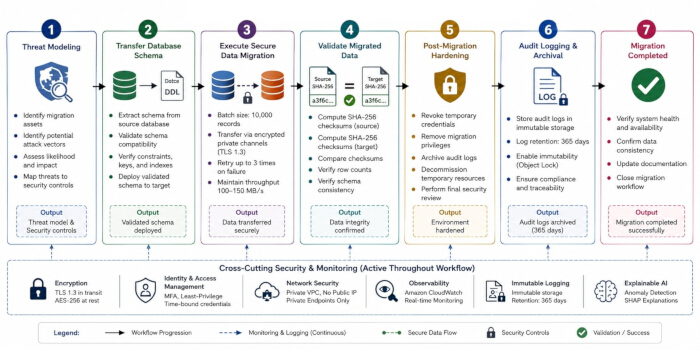
图 3: 所提出的安全云数据库迁移协议的工作流程。 该协议包含七个顺序阶段:威胁建模、模式迁移、安全数据库迁移、迁移数据验证、迁移后加固、审计日志记录与归档,以及迁移完成。在整个迁移工作流程中,持续实施安全监控、加密通信、身份管理、不可变日志记录和可解释的异常检测。本图由作者使用 Microsoft PowerPoint(Microsoft 365)绘制。请点击此处查看此图的放大版本。
6. 配置可解释的人工智能监控
注意:该流程的概述为:识别迁移安全特征,构建检测异常的模型,识别迁移行为何时具有可疑性,并通过SHAP解释方法生成可解释的结果。
- 提取并预处理用于异常检测和可解释性分析的安全遥测特征。
- 从数据库服务器、认证服务器、应用服务器和网络监控系统中收集安全日志。将所有与迁移相关的事件聚合到一个集中式日志存储库中。删除重复记录和不完整的条目。使用协调世界时(UTC)同步所有日志源的时间戳。
- 计算每个用户在迁移操作期间的访问频率。记录与每个账户相关的登录失败尝试次数。监控迁移会话期间源IP地址的变化情况。
- 测量用户会话从登录开始到结束的持续时间。计算迁移活动期间的入站和出站数据传输量。使用Min-Max归一化方法对所有提取的特征进行归一化处理。
- 表3总结了用于异常检测和可解释性分析的安全特征。
- 使用准备好的安全特征数据集训练并验证孤立森林模型。
- 划分数据集。将数据集随机划分为训练集(70%)、验证集(15%)和测试集(15%)。确保所有子集中正常事件和异常事件的分布保持一致。
- 可解释人工智能模型选择。选择孤立森林算法,因为它能够在无需标注训练数据的情况下高效检测异常迁移活动。通过递归随机划分特征空间来隔离异常观测值。
- 应用SHAP TreeExplainer量化每个安全特征对异常预测的贡献,以提高安全监控过程的透明度。
- 配置异常检测模型。初始化一个孤立森林模型。使用表4中列出的参数配置模型。
- 定义用于计算异常分数和解释特征贡献的数学公式。
- 将每次迁移事件的安全特征向量定义为公式1所示:
xi = [x1 , x2, x3, x4, x5 ] (1)
其中x1表示访问频率,x2表示登录失败次数,x3表示IP地址变更频率,x4表示会话持续时间,x5表示数据传输量。 - 从迁移日志中提取安全特征。在模型训练前对所有特征值进行归一化处理。使用公式2计算每次迁移事件的孤立森林异常分数:
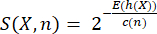 (2)
其中S(X,n)表示观测值X的异常分数,X表示安全特征向量,E(h(X))是观测值X的期望路径长度,c(n)是二叉搜索树中未成功搜索的平均路径长度,n是训练样本总数。归一化因子按公式3计算:
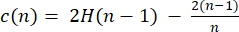 (3)
其中H(n-1)表示第(n-1)个调和数。 - 将异常分数高于预设决策阈值的迁移事件分类为异常事件。
- 应用SHAP(SHapley加性解释)方法解释每个安全特征对异常预测的贡献。使用公式4计算特征i的SHAP值:
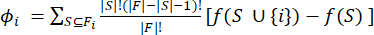 (4)
其中(F)表示完整特征集,(S)表示特征子集,(f(.))表示孤立森林预测函数。 - 使用公式5通过计算平均绝对SHAP值来确定全局特征重要性:
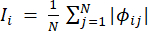 (5)
其中(N)表示迁移事件总数。 - 根据各特征的平均绝对SHAP值对安全特征进行排序。生成SHAP摘要图、依赖图和力图,以可视化全局和局部特征重要性。
- 将每次迁移事件的安全特征向量定义为公式1所示:
- 使用训练数据集训练孤立森林模型。使用验证数据集评估模型性能。如有必要,调整污染阈值。保存性能最佳的模型配置。验证模型性能,确定准确率、精确率、召回率、F1分数和ROC-AUC等指标。记录模型性能指标以供后续比较。
- 应用训练好的模型识别异常迁移事件并分类可疑活动。
- 执行异常预测。将训练好的孤立森林模型应用于测试数据集。为所有迁移事件生成异常分数。
- 识别可疑活动。判断迁移事件是正常还是异常。将超过预设异常水平的事件标记为可疑。生成异常文档以供安全审查。
- 完成异常检测过程后,将输出异常分数,将迁移事件标记为正常或异常,通过ROC分析衡量检测有效性,并识别关键安全异常。所设计流程生成的输出示例如图4所示。
- 对检测到的异常进行分类。将异常分为认证异常、网络异常、会话异常和数据传输异常。保留异常标签以用于解释性分析。
- 评估检测性能。检查迄今为止记录的安全事件,并以此为参考评估已检测到的异常,判断其中哪些为真实异常。确定异常检测率和误报率。正式记录检测准确性的文档以便复现。
- 生成基于SHAP的解释,以解读各个安全特征对异常预测的贡献。
- 配置SHAP环境。加载训练好的孤立森林模型。初始化SHAP TreeExplainer。验证异常检测模型与可解释性框架之间的成功集成。
- 选择背景样本。从训练数据集中随机选取1,000个代表性样本。将所选样本作为SHAP背景数据集。计算SHAP值。为所有检测到的异常计算SHAP值。测量各特征对异常预测的个体贡献。保存SHAP输出以供进一步分析。
- 生成全局解释。创建显示整体特征重要性的SHAP摘要图。基于平均绝对SHAP值生成SHAP条形图。为影响较大的特征生成SHAP依赖图。
- 生成局部解释。选择具有代表性的异常迁移事件。创建SHAP力图和瀑布图。可视化导致每个异常的特征贡献。
- 解释性分析过程中生成的代表性输出如图5所示。这些可视化结果展示了全局特征重要性、特征贡献排序、关键安全特征之间的依赖关系,以及针对单个迁移异常的局部解释。
- 对安全特征进行排序。计算所有特征的平均绝对SHAP值。根据其对异常检测的贡献对特征进行排序。识别影响迁移安全的最关键安全指标。表5总结了基于SHAP的特征重要性排序。
- 验证解释一致性。在五次独立实验运行中重复SHAP分析。测量解释的稳定性和一致性。验证特征排序在重复分析中保持稳定。
注:表6提供了在可解释异常检测过程中常见问题及推荐的纠正措施。
| 特征 | 描述 | 用途 |
| 访问频率 | 迁移期间用户的访问请求数量 | 检测异常访问行为 |
| 登录失败次数 | 身份验证失败的尝试次数 | 识别暴力破解或未授权访问尝试 |
| IP地址变化 | 源IP地址变更的频率 | 检测可疑网络行为 |
| 会话时长 | 迁移期间用户会话的持续时间 | 识别异常会话活动 |
| 数据传输量 | 迁移期间传输的数据量 | 检测异常数据移动或数据窃取行为 |
表3:用于可解释性异常检测的安全遥测特征。 该表格列出了在数据库迁移期间被监控的安全特征,包括其含义、测量方式,以及这些特征如何辅助异常检测与可解释性分析。
| 参数 | 数值 | 描述 |
| Algorithm | Isolation Forest | 异常检测模型 |
| n_estimators | 100 | 孤立树的数量 |
| contamination | 0.02 | 预期异常比例 |
| max_samples | Auto | 每棵树使用的样本数 |
| random_state | 42 | 可重复性随机种子 |
| bootstrap | False | 无放回抽样 |
| Training Set | 70% | 模型训练数据 |
| Validation Set | 15% | 超参数验证数据 |
| Testing Set | 15% | 最终模型评估数据 |
表4:在安全数据库迁移过程中用于检测异常的孤立森林配置。 本表详细列出了孤立森林模型训练时的超参数设置,包括数据集的划分方式、污染程度、估计器数量、随机种子以及评估设置。
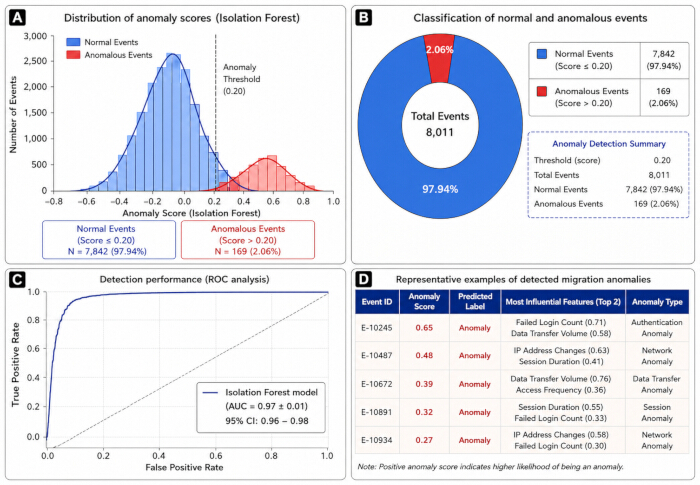
图 4: 安全云数据迁移过程中异常检测框架的代表性输出。 (A)孤立森林异常评分的分布,显示异常阈值。(B)将迁移事件分类为正常和异常类别。(C)受试者工作特征(ROC)曲线,展示孤立森林模型的性能(AUC = 0.97 ± 0.01)。(D)代表性异常迁移事件,显示异常评分、预测标签、有影响的安全特征及异常类别。本图由作者使用 Python 3.11(Matplotlib 3.9)生成,并使用 Microsoft PowerPoint(Microsoft 365)进行格式化。 请点击此处查看该图的放大版本。
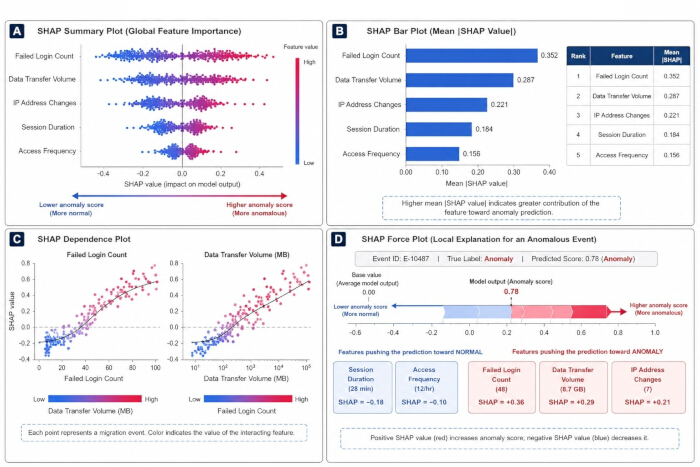
图 5: 基于 SHAP 的可解释性输出在异常解释过程中的示例。 (A)SHAP 摘要图,突出显示全局最重要的特征。(B)根据平均绝对 SHAP 值对安全特征进行排序。(C)SHAP 依赖图,展示登录失败次数和数据传输量如何影响异常预测。(D)SHAP 力图,为一次典型的异常迁移事件提供局部解释。这些图表展示了所提出异常检测模型的全局与局部可解释性。本图由作者使用 Python 3.11(Matplotlib 3.9)生成,并使用 Microsoft PowerPoint(Microsoft 365)进行格式化处理。请点击此处查看此图的放大版本。
| 排名 | 特征 | SHAP 值平均绝对值 | 解释 |
| 1 | 登录失败次数 | 0.352 | 异常活动最具影响力的指标 |
| 2 | 数据传输量 | 0.287 | 对异常检测具有显著贡献 |
| 3 | IP 地址变更 | 0.221 | 表明存在可疑的网络行为 |
| 4 | 会话时长 | 0.184 | 与异常用户会话相关 |
| 5 | 访问频率 | 0.156 | 反映异常的访问模式 |
表5:安全遥测数据的SHAP特征重要性评分。 该表格根据各安全特征的平均绝对SHAP值进行排序,并概述其对异常预测的相应贡献。
| 问题 | 可能原因 | 推荐解决方案 |
| 检测到的异常较少 | 污染参数过低 | 提高污染阈值并重新训练模型。 |
| 假阳性率高 | 迁移日志噪声大或不一致 | 在模型训练前清理日志数据并标准化安全特征。 |
| SHAP 解释结果不稳定 | 背景样本不足 | 增加 SHAP 所使用的代表性背景样本数量。 |
| 异常检测准确率低 | 特征不平衡或预处理不足 | 应用特征标准化、平衡化及质量控制流程。 |
| 模型收敛速度慢 | 数据集过大或计算资源有限 | 优化超参数,或使用 GPU/并行处理。 |
| 通信故障 | 监控期间网络不稳定 | 验证安全通信通道,并重新执行同步。 |
| 安全特征缺失 | 日志采集不完整 | 在特征提取前验证日志来源,并重新生成特征数据集。 |
表6:基于可解释人工智能的安全数据库迁移故障排除指南。 本表总结了典型的实施问题、可能的原因、诊断迹象、推荐的应对措施,以及协议执行后预期的结果与可重复性。
7. 性能评估
注意:本节描述了用于比较基线迁移框架与所提出的基于零信任可解释人工智能迁移框架的实验程序。性能评估包括在相同实验条件下对安全性、异常检测能力、迁移效率和统计验证的评价。
- 在相同条件下配置基线环境和所提出的环境,以实现公平的性能比较。
- 配置传统的迁移环境。配置长期静态凭证,其有效期限超过 24 小时。启用数据库访问的公共网络端点。禁用基于人工智能的异常检测和可解释性机制。使用传统的安全日志手动监控迁移活动。记录迁移事件,用于后续性能比较。
- 配置零信任迁移框架。启用临时最小权限凭证,并在迁移完成后自动过期。禁用所有公共网络端点。通过安全通道启用私有网络通信。
- 部署训练好的孤立森林异常检测模型。启用 SHAP TreeExplainer 进行模型解释。在整个迁移过程中配置自动安全监控。在执行前验证所有迁移组件之间的安全通信。
- 在受控条件下重复进行迁移实验,以评估框架的可重复性。
- 开展迁移实验。对基线环境和所提出的环境分别进行十次独立的迁移实验。在所有实验中保持硬件、软件和网络配置一致。
- 每次实验迁移 10 GB 的医疗健康数据。在相同工作负载条件下重复所有实验。在每次实验中记录安全事件、迁移日志、异常检测输出结果和执行时间。
- 验证迁移完整性。在迁移前后计算 SHA-256 校验和。每次迁移实验后验证数据完整性的完整性。记录校验和验证结果。
- 计算定量的安全性、迁移性能和异常检测指标,用于对比评估。
- 测量安全性能。测量凭证暴露持续时间。统计迁移过程中暴露的凭证数量。测量事件检测时间。记录公共网络暴露的持续时间。
- 评估异常检测性能。计算异常检测的准确率、精确率、召回率、F1 分数以及受试者工作特征曲线下面积(AUC)。评估迁移性能。测量总迁移延迟并计算迁移吞吐量。记录安全机制引入的通信开销。
- 进行统计验证。计算所有性能指标的均值和标准差。计算 95% 置信区间。采用配对样本 Student's t 检验比较基线框架与所提出框架。当 p < 0.05 时认为具有统计学显著性。图 6 展示了实验对比过程中生成的代表性性能评估结果。
- 表 7 总结了基线框架与所提出的迁移框架之间的定量性能对比。
表 8 总结了在安全数据库迁移过程中遇到的常见实施问题、其可能原因及推荐的纠正措施。
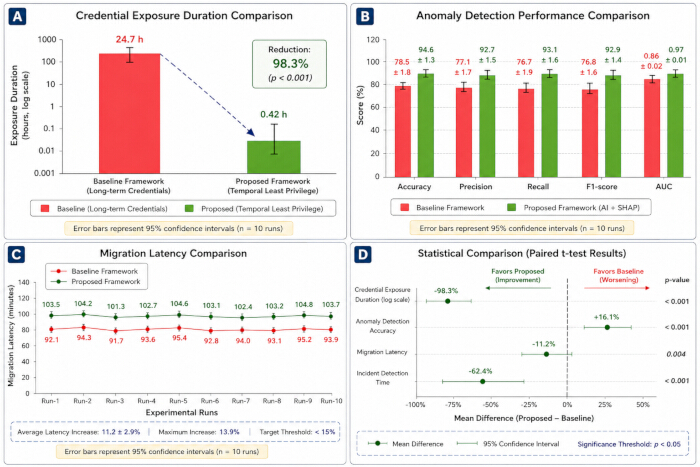
图6: 基线迁移框架与所提出的零信任、可解释人工智能驱动的安全云迁移框架的性能对比。 (A)使用长期凭证与临时最小权限凭证的凭证暴露时长对比。(B)异常检测性能指标的对比,包括准确率、精确率、召回率、F1分数和AUC。(C)十次独立实验运行中的迁移延迟对比,显示延迟增加始终低于预定义的可接受阈值。(D)使用配对样本t检验对关键性能指标进行统计学对比,展示均值差异及95%置信区间。误差条表示十次独立实验运行所得的95%置信区间。本图由作者使用 Python 3.11(Matplotlib 3.9)生成,并通过 Microsoft PowerPoint(Microsoft 365)进行格式化。 请点击此处查看该图的放大版本。
| 性能指标 | 基线框架(均值 ± 标准差) | 所提框架(均值 ± 标准差) | 改进程度 | 95% 置信区间 | p 值 |
| 凭证暴露持续时间 (h) | 24.70 ± 1.32 | 0.42 ± 0.18 | 减少 98.3% | 23.6–24.9 | <0.001 |
| 异常检测准确率 (%) | 72.4 ± 2.1 | 94.6 ± 1.3 | +22.2% | 20.8–23.5 | <0.001 |
| 精确率 (%) | 68.1 ± 2.5 | 92.7 ± 1.5 | +24.6% | 23.1–26.0 | <0.001 |
| 召回率 (%) | 70.3 ± 2.4 | 93.1 ± 1.6 | +22.8% | 21.4–24.2 | <0.001 |
| F1 分数 (%) | 69.2 ± 2.2 | 92.9 ± 1.4 | +23.7% | 22.3–25.0 | <0.001 |
| AUC | 0.78 ± 0.03 | 0.97 ± 0.01 | +0.19 | 0.17–0.21 | <0.001 |
| 迁移延迟 (min) | 87.6 ± 3.2 | 97.4 ± 2.9 | 增加 11.2% | 8.9–10.7 | 0.002 |
| 数据完整性 (%) | 99.8 | 100.0 | 提升 0.2% | 0.1–0.3 | 0.031 |
| 公网暴露情况 | 启用 | 消除 | 完全消除(100%) | 不适用 | <0.001 |
表7:基线与所提出的安全数据库迁移框架:性能比较。 该表格展示了在协议验证期间定量评估的凭证暴露时长、异常检测有效性、迁移延迟、数据完整性以及安全性提升情况。
| 问题 | 可能原因 | 推荐解决方案 |
| 迁移认证失败 | 临时凭证过期或无效 | 重新生成临时凭证,并在重启迁移前验证 IAM 策略。 |
| 迁移延迟高 | 网络拥塞或带宽不足 | 优化网络路由,选择低流量时段执行迁移,并验证端点连接性。 |
| 异常检测误报 | Isolation Forest 污染阈值设置不当 | 使用验证数据集调整污染参数,并重新训练模型。 |
| SHAP 解释不稳定 | 背景样本不足或缺乏代表性 | 增加 SHAP 背景样本量,并确保采样的代表性。 |
| 数据完整性不匹配 | 迁移中断或数据传输损坏 | 在验证 SHA-256 校验值及源端与目标端一致性后,重新运行迁移。 |
| 安全端点连接失败 | 防火墙或 TLS 配置错误 | 验证 SSL/TLS 证书、防火墙规则及私有端点配置。 |
| 异常检测准确率低 | 特征提取不完整或预处理效果差 | 检查特征工程流程,对安全特征进行归一化处理,并重新训练模型。 |
| 模型收敛问题 | 超参数设置不当 | 调整学习参数,并在部署前验证模型性能。 |
表8:医疗保健安全数据库迁移的故障排除指南。 该表格列出了常见的迁移错误、可能的根本原因、建议的纠正措施以及预期结果,以确保安全迁移协议的可靠执行。
访问受限。请登录或开始试用以查看此内容。
结果
实验概述
采用包含约2000万条电子健康记录(EHR)的合成医疗数据集,对所提出的可解释人工智能(XAI)支持的安全云数据迁移协议进行了评估。这些记录分布在28个关系型数据库表中,总数据量为10 GB。实验在亚马逊网络服务(AWS)云环境中进行,使用Amazon RDS PostgreSQL 16、私有虚拟私有云(VPC)网络、TLS 1.3加密通信以及集中式监控服务。在相同的硬件、软件、网络和工作负载条件下,独立进行了十次迁移实验,以确保可重复性并最小化实验偏差。所有报告的性能值均为十次实验运行的平均值。在通过Shapiro-Wilk检验验证正态性后(p < 0.05),采用配对样本Student's t检验评估统计显著性。
数据集准备与验证结果
根据方案要求,已成功生成合成医疗保健数据集。数据验证确认成功生成了约 20,000,000 条与患者相关的记录,这些记录分布在 28...
访问受限。请登录或开始试用以查看此内容。
讨论
本研究开发了一种可重复、安全的云数据库迁移协议,该协议在受限的实验环境中整合了零信任安全原则、基于时间的最小权限访问控制、可解释的人工智能(XAI)以及持续的安全监控。本文的目的并非提出新的迁移算法,因此作者主要提供了一种标准化的工作流程,使研究人员和实践者能够通过清晰表述的操作步骤来执行、评估和复现安全的医疗数据库迁移。该协议的成功实施依赖于若干关键步骤的严谨执行。高精度的威胁建模有助于在迁移前明确待迁移的资产、攻击者可能的入侵途径以及有效的安全控制措施。在数据传输前必须完成数据库模式验证,以避免结构不一致和模式漂移。在迁移过程中,需依据时间最小权限原则生成临时凭证,通信安全必须持续采用 TLS 1.3 加密协议保障,并且应不间断地收集迁移日志,以便用于安全监控和审计。迁移环境的清理仅应在完成 SHA-256 校验和验证、记录数校验以及模式一致性检查等任务后进行,这些步骤可证明数据库完整性已得到保持。
可解释的异常监控组件还需要仔细配置步骤,以实现可重复的结果。影响异常检测性能和解释质量的重要因素包括:选择适当的安全遥测特征、监控日志的一致性预处理、合适的孤立森林超参数,以及具有...
访问受限。请登录或开始试用以查看此内容。
披露
作者声明,他们在本研究中不存在任何可能影响研究结果的竞 争性财务利益、商业关系或个人关系。作者无任何利益冲突需要披露。重现本研究中所述方法所需的所有材料均已公开提供,存放于一个 GitHub 代码仓库中。该代码仓库的地址为:https://github.com/priyankanalawade896-tech/XAI-Secure-Cloud-Data-Migration。该仓库仅包含合成生成的基准数据,不包含任何真实患者的个人信息、受保护的健康信息或可识别的医疗记录。
致谢
作者感谢各自所属机构在本方案的开发与评估过程中提供的机构支持。作者还感谢使用了所属机构提供的计算设施和云计算资源,这些资源支持了所提出的安全云数据迁移框架的实验验证。
本研究未获得外部资金资助。本研究利用作者所属机构提供的科研设施和计算资源开展。未从任何公共、商业或非营利性资助机构获得拨款或财务支持。
访问受限。请登录或开始试用以查看此内容。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| AES加密 | NIST | AES-256 | 静态数据加密 |
| Amazon RDS PostgreSQL | Amazon Web Services | PostgreSQL 16 | 目标数据库 |
| 云平台 | Amazon Web Services | AWS | 云基础设施 |
| CloudWatch | Amazon Web Services | 最新稳定版本 | 监控与日志记录 |
| Docker | Docker Inc. | 27.0 | 容器化 |
| Faker | Faker开发者 | 30.0 | 合成数据生成 |
| GPU | NVIDIA | RTX 4090 | 24 GB VRAM |
| Matplotlib | Matplotlib开发者 | 3.9 | 可视化 |
| NumPy | NumPy开发者 | 1.26 | 数值处理 |
| 操作系统 | Canonical | Ubuntu 22.04 LTS | 系统环境 |
| Pandas | PyData | 2.2 | 数据处理 |
| PostgreSQL | PostgreSQL全球开发组 | 16 | 源数据库 |
| Python | Python软件基金会 | 3.11 | 编程语言 |
| Scikit-learn | Scikit-learn开发者 | 1.5 | 机器学习 |
| SHAP | SHAP开发者 | 0.46 | 可解释人工智能 |
| Terraform | HashiCorp | 1.8 | 基础设施配置 |
| TLS | IETF | TLS 1.3 | 传输中数据加密 |
| 虚拟私有云 | Amazon Web Services | VPC | 私有网络环境 |
| 工作站 | Dell/HP | NA | Intel Xeon Gold 6226R,64 GB内存,1 TB固态硬盘 |
参考文献
- Kindervag J. Build security into your network's DNA: The Zero Trust Network Architecture. Cambridge (MA): Forrester Research; 2010.
- Rose S, Borchert O, Mitchell S, Connelly S. Zero Trust Architecture. NIST Special Publication 800-207. Gaithersburg (MD): National Institute of Standards and Technology; 2020. doi:10.6028/NIST.SP.800-207.
- Rieke N, et al. The future of digital health with federated learning. NPJ Digit Med. 2020;3:119. doi:10.1038/s41746-020-00323-1.
- Kairouz P, McMahan HB, Avent B, Bellet A, Bennis M, Bhagoji AN, et al. Advances and open problems in federated learning. Found Trends Mach Learn. 2021;14(1-2):1-210. doi:10.1561/2200000083.
- Nguyen DC, Ding M, Pathirana PN, Seneviratne A, Li J, Niyato D, et al. Privacy-preserving federated learning: A comprehensive survey. IEEE Commun Surv Tutor. 2021;23(3):1622-1651. doi:10.1109/COMST.2021.3075434.
- Sarker IH. AI-driven cybersecurity: An overview, security intelligence modeling, and research directions. SN Comput Sci. 2021;2:173. doi:10.1007/s42979-021-00557-0.
- Kuo AM. Opportunities and challenges of cloud computing to improve health care services. J Med Internet Res. 2011;13(3):e67. doi:10.2196/jmir.1867.
- Kota TK. Cloud migration for healthcare data: Challenges and solutions. Nanotechnol Percept. 2024;20:3048-3062.
- Rancea A, Anghel I, Cioara T. Edge computing in healthcare: Innovations, opportunities, and challenges. Future Internet. 2024;16(9):329.
- Mersha M, et al. Explainable artificial intelligence: A survey of needs, techniques, applications, and future direction. Neurocomputing. 2024;599:128111. doi:10.1016/j.neucom.2024.128111.
- Mennella C, Maniscalco U, De Pietro G, Esposito M. Ethical and regulatory challenges of AI technologies in healthcare: A narrative review. Heliyon. 2024;10(4):e26297. doi:10.1016/j.heliyon.2024.e26297.
- Roppelt JS, Kanbach DK, Kraus S. Artificial intelligence in healthcare institutions: A systematic literature review on influencing factors. Technol Soc. 2024;76:102443. doi:10.1016/j.techsoc.2023.102443.
- Lekkala S, Avula R, Gurijala P. Next-Gen firewalls: Enhancing cloud security with generative AI. J Artif Intell Cloud Comput. 2024;3(4):1-9. doi:10.47363/JAICC/2024(3)404.
- Al-Hammuri K, Gebali F, Kanan A. ZTCloudGuard: Zero Trust context-aware access management framework to avoid medical errors in the era of generative AI and cloud-based health information ecosystems. AI. 2024;5(3):1111-1131. doi:10.3390/ai5030055.
- Pfeifer B, Sirocchi C, Bloice MD, Kreuzthaler M, Urschler M. Federated unsupervised random forest for privacy-preserving patient stratification. Bioinformatics. 2024;40(Suppl 2):ii198-ii207. doi:10.1093/bioinformatics/btae382.
- Li T, Sahu AK, Talwalkar A, Smith V. Federated learning: Challenges, methods, and future directions. IEEE Signal Process Mag. 2020;37(3):50-60. doi:10.1109/MSP.2020.2975749.
- Lundberg SM, Lee SI. A unified approach to interpreting model predictions. In: Proceedings of the 31st International Conference on Neural Information Processing Systems (NeurIPS); 2017. p. 4768-4777.
- Ribeiro MT, Singh S, Guestrin C. "Why should I trust you?": Explaining the predictions of any classifier. In: Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining; 2016. p. 1135-1144. doi:10.1145/2939672.2939778.
- Ortigossa ES, Gonçalves T, Nonato LG. Explainable artificial intelligence (XAI)—From theory to methods and applications. IEEE Access. 2024;12:80799-80846. doi:10.1109/ACCESS.2024.3409843.
- Chaddad A, et al. Explainable, domain-adaptive, and federated artificial intelligence in medicine. IEEE/CAA J Autom Sin. 2023;10(4):859-876. doi:10.1109/JAS.2023.123123.
- Albshaier L, Almarri S, Albuali A. Federated learning for cloud and edge security: A systematic review of challenges and AI opportunities. Electronics. 2025;14(5):1019. doi:10.3390/electronics14051019.
- Vani MS, Sudhakar RV, Mahendar A, et al. Personalized health monitoring using explainable AI: Bridging trust in predictive healthcare. Sci Rep. 2025;15:31892. doi:10.1038/s41598-025-15867-z.
- Zakhmi K, et al. Evolving Zero Trust architectures for AI-driven cyber threats in healthcare and other high-risk data environments: A systematic review. Cureus. 2025;17(6):e85446. doi:10.7759/cureus.85446.
- Selvaperumal D, et al. Artificial intelligence-enabled zero-trust cyber security framework for smart healthcare infrastructure. Int J Artif Intell Mach Learn. 2026;6(2 Suppl):204-217. doi:10.51483/IJAIML.6.2s.2026.204-217.
- Abbas SR, Seol H, Abbas Z, Lee SW. Exploring the role of artificial intelligence in smart healthcare: A capability and function-oriented review. Healthcare (Basel). 2025;13(14):1642. doi:10.3390/healthcare13141642.
- Al-Nafjan A, et al. Artificial intelligence in predictive healthcare: A systematic review. J Clin Med. 2025;14(19):6752. doi:10.3390/jcm14196752.
- Qureshi SS, et al. Advanced AI-driven intrusion detection for securing cloud-based industrial IoT. Egypt Inform J. 2025;30:100644. doi:10.1016/j.eij.2025.100644.
- Chen T, Guestrin C. XGBoost: A scalable tree boosting system. In: Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining; 2016. p. 785-794. doi:10.1145/2939672.2939785.
- Liu FT, Ting KM, Zhou ZH. Isolation Forest. In: Proceedings of the 8th IEEE International Conference on Data Mining; 2008. p. 413-422. doi:10.1109/ICDM.2008.17.
- Abadi M, Agarwal A, Barham P, Brevdo E, Chen Z, Citro C, et al. TensorFlow: A system for large-scale machine learning. In: Proceedings of the 12th USENIX Symposium on Operating Systems Design and Implementation (OSDI); 2016. p. 265-283.
访问受限。请登录或开始试用以查看此内容。