本研究整合了网络药理学、分子对接、分子动力学模拟和MM-PBSA方法,以筛选谷胱甘肽响应性无碱基位点捕获前药在非小细胞肺癌(NSCLC)中潜在的蛋白质相互作用。化合物5被优先选为MMP9和SRC的后续研究候选分子;然而,这些结果仍为计算预测结果。该发现具有提出假说的意义,尚需通过生物化学实验和细胞水平验证。
本文内容
摘要
摘要
非小细胞肺癌(NSCLC)仍是癌症相关死亡的主要原因,其治疗效果常受限于获得性耐药和系统性毒性。谷胱甘肽响应型无碱基位点捕获前药在既往实验研究中已显示出选择性抗肿瘤活性,但其释放的代谢产物是否也与癌症相关蛋白存在有意义的相互作用仍有待明确。本文采用整合的in silico工作流程,结合网络药理学、分子对接、分子动力学(MD)以及分子力学泊松-玻尔兹曼表面积(MM-PBSA)分析,对两种谷胱甘肽响应型前药(化合物1和化合物2)、其含氨基氧的产物(化合物4和化合物5)以及一组匹配的非捕获对照化合物(化合物3和化合物6)进行可验证的蛋白互作假说排序。共鉴定出21个重叠的化合物和疾病相关靶点,并通过蛋白质-蛋白质相互作用拓扑结构优先筛选出AKT丝氨酸/苏氨酸激酶1(AKT1)、表皮生长因子受体(EGFR)、肿瘤坏死因子(TNF)、基质金属蛋白酶9(MMP9)以及SRC原癌基因非受体酪氨酸激酶(SRC)。化合物5与MMP9的单次AutoDock Vina评分最有利(-8.418 kcal·mol⁻1),且在MMP9和SRC的MD轨迹中表现出相对稳定的对接构象。然而,排名最高的MMP9构象并未直接协调催化Zn2⁺离子,也未直接与His401、Glu402、His405或His411发生作用,因此不能将其归类为典型的MMP9抑制性结合模式。MD和MM-PBSA分析仅描述了这些复合物的轨迹行为及其相对能量排序,未证明其在细胞内的靶点结合、酶活性抑制或信号通路调控。因此,已确立的无碱基位点捕获活性与新预测的蛋白相互作用被视为相互独立、可能并行的假说,而非已证实的作用机制链条。总体而言,本研究结果为后续实验优先筛选了特定的化合物-靶点组合,但并未确立多靶点抗NSCLC的作用机制。
引言
非小细胞肺癌(NSCLC)是肺癌中最常见的组织学亚型,至今仍是全球癌症相关死亡的主要原因之一1。尽管靶向治疗和精准肿瘤学已取得显著进展,但长期治疗效果仍常受到获得性耐药、应答持续时间有限以及治疗相关毒性的限制2。表皮生长因子受体(EGFR)靶向药物已改善了分子筛选患者群体的治疗结局,但在治疗过程中几乎不可避免地会出现耐药,因此迫切需要通过其他或互补机制发挥作用的治疗策略3,4。以铂类为基础的传统化疗仍是治疗方案的重要组成部分,但其临床获益受到长期使用所致的累积毒性和耐药性的限制5,6。上述局限性共同凸显了寻找具有独特作用机制且能在肿瘤微环境中选择性激活的抗肿瘤药物的必要性。
在内源性DNA损伤中,脱碱基或无嘧啶位点(abasic或apyrimidinic位点)数量极为丰富且具有重要的生物学后果,每个细胞每天可产生数千个此类损伤7。若这些损伤未能被有效修复,可转化为DNA链断裂,进而导致基因组不稳定性和细胞死亡8,9。脱嘌呤/脱嘧啶内切酶1(Apurinic/apyrimidinic endonuclease 1)是碱基切除修复通路中的关键酶,因其可切割脱碱基位点并启动下游修复过程10,11。这种对修复通路的依赖性使得与脱碱基位点相关的损伤成为抗癌药物开发的潜在靶点12。基于这一原理,研究人员此前开发了谷胱甘肽响应性的脱碱基位点捕获前药,以利用肿瘤细胞中升高的谷胱甘肽环境。其经谷胱甘肽触发后生成的产物含有氨基氧基团,能够捕获醛基形式的脱碱基位点;此前的实验研究表明,该类化合物在H1299细胞中表现出选择性细胞毒性、细胞周期阻滞和诱导凋亡效应13。这些数据支持化合物设计中DNA损伤位点捕获这一作用机制。然而,这些研究并未证明MMP9、SRC、EGFR、AKT1或TNF是在脱碱基位点捕获的下游被调控的。因此,本计算分析中识别出的任何蛋白靶点相互作用,除非在同一生物系统中同时验证了这两种过程,否则必须被视为独立的假设。
本研究基于这一区别进行设计。生物学原理的第一层面是先前已建立的谷胱甘肽响应性释放与无碱基位点捕获化学反应14。本研究所探讨的第二层面是一个探索性问题:前体药物本身或其释放产物在计算上是否与选定的癌症相关蛋白具有兼容性。采用网络药理学方法优先筛选候选蛋白,随后通过分子对接、分子动力学(MD)以及MM-PBSA分析来研究选定的蛋白-配体复合物15,16。这些计算并非旨在证明预测的蛋白介导了已知的DNA损伤表型,也不是为了建立无碱基位点捕获与致癌信号传导之间的因果关系。相反,该工作流程用于生成一组按优先级排序的、可进行实验验证的假设,后续可通过直接结合实验、酶活性检测、信号通路分析、DNA损伤检测以及表型分析加以评估。
方案
由于本研究完全基于计算,不涉及人类受试者、脊椎动物、患者来源的生物样本或可识别的个人数据,因此无需获得机构审查委员会的批准。知情同意亦不适用。本方案中使用的所有数据库、软件包、力场及计算资源均列于材料表中。
研究化合物与分析工作流程
先前报道的谷胱甘肽响应性无碱基位点捕获化合物被用作研究分子17。选择化合物1和化合物2作为前药母体结构,因为谷胱甘肽触发的裂解反应分别生成含氨基氧的产物化合物4和化合物5。选择化合物4和化合物5进行结构分析,因为它们代表了释放后的物种,仍保留了可与无碱基位点发生反应的氨基氧基团。化合物3被纳入作为结构匹配的谷胱甘肽响应性对照;其裂解产物化合物6缺乏共价捕获无碱基位点醛基所必需的氨基氧官能团。因此,在反向靶点预测中纳入了化合物1–3以比较母体骨架,将化合物4和化合物5用于与优先靶蛋白的对接分析,而将化合物6作为阴性对照配体用于SRC分子动力学(MD)比较。纳入SRC–化合物6的轨迹是为了为含氨基氧的化合物5体系提供结构匹配的对照,并非证明氨基氧基本身决定SRC结合。化合物1–6的化学结构及其活化关系如图1所示。该设计有意将已建立的DNA损伤位点捕获化学与当前用于假设生成的潜在蛋白相互作用分析分离开来。
化合物相关靶点的预测
化合物1、化合物2和化合物3的二维结构以MDL MOL格式保存,并使用Open Babel 3.1.1版本将其转换为规范的简化分子输入线性表示(SMILES)字符串,输出格式为规范SMILES18。每个导出的字符串被重新导入,再生结构在提交至SwissTargetPrediction前,与相应的二维结构进行目视比对,物种限定为Homo sapiens19。保留预测靶标中概率值非零的结果。将三种化合物获得的靶标列表合并,去除重复条目,并将剩余靶标标准化为官方人类基因符号,再进行后续分析。将标准化的化合物-靶标配对作为网络表格导入网络可视化与分析软件中,其中化合物和预测靶标作为节点,化合物与靶标之间的关系作为边,以可视化预测靶标之间的关系20。
疾病相关靶点的获取及交集靶点的鉴定
通过在 GeneCards 数据库中使用搜索词“lung cancer H1299”检索与疾病相关的靶点21。设定相关性评分阈值大于 0.27,以保留与该查询关联性更强的基因。对基因符号进行标准化处理,并手动去除重复条目。利用在线维恩图/交集分析工具22确定化合物预测靶点与疾病相关靶点之间的交集。仅保留交集中的靶点,用于后续的蛋白质-蛋白质相互作用(PPI)、富集分析及靶点优先级排序分析。
蛋白质-蛋白质相互作用分析及核心靶点筛选
将相交的靶点提交至相互作用基因/蛋白质检索搜索工具(STRING)11.5 版本,限定物种为 Homo sapiens,并设置最低相互作用评分阈值为 0.40023。所得的蛋白质-蛋白质相互作用(PPI)数据被导入 Cytoscape 3.10.0 版本,用于可视化和拓扑结构分析。在一项网络拓扑分析 插件中,计算了原始 21 个节点 PPI 网络中每个节点的度值、介数中心性及接近中心性;所得数值用于下文所述的基于中位数的逐级筛选过程24。中心性指标在原始的 21 节点 PPI 网络上计算,并用于后续逐级过滤。原始网络的度值中位数为 12,保留度值 ≥ 12 的节点,得到 13 个候选靶点。在这 13 个候选靶点中,介数中心性中位数为 0.031293,接近中心性中位数为 0.769231。第二轮筛选保留介数中心性 ≥ 0.031293 且接近中心性 > 0.769231 的节点,最终获得五个核心候选基因:AKT1、EGFR、TNF、MMP9 和 SRC。所报告的中心性数值沿用自原始的 21 节点网络,而非在子集筛选后重新计算。最终确定的五个核心候选基因用于后续的结构分析。原始拓扑参数对应一个包含 21 个节点和 116 条边的无向 PPI 网络。
基因本体与京都基因与基因组百科全书富集分析
使用基因注释、可视化与集成发现数据库(DAVID)对交集靶点进行基因本体(GO)和京都基因与基因组百科全书(KEGG)通路富集分析,物种限定为Homo sapiens25。GO富集分析涵盖生物过程(BP)、细胞组分(CC)和分子功能(MF),同时分析KEGG信号通路。在本次探索性分析中,以名义p < 0.10作为筛选阈值,用于保留富集条目;错误发现率经Benjamini校正后的p值、Bonferroni校正值、错误发现率及Fisher精确检验值均在补充表格中列出,但不用于确定保留的条目集合。保留的条目按名义p值进行排序。为便于后续可视化与结果解读,保留前20条KEGG通路以及每个GO分类中排名前10的条目。条形图与气泡图通过在线生物信息学可视化工具生成。
分子对接中受体与配体的准备
优先蛋白的晶体结构从 RCSB 蛋白质数据库(PDB)获取:AKT1,PDB ID 3O96;EGFR,PDB ID 5UWD;TNF,PDB ID 2AZ5;MMP9,PDB ID 1GKC;以及 SRC,PDB ID 2H8H。用于分子对接的蛋白结构通过分子可视化软件进行预处理,移除共结晶配体和水分子,随后使用对接准备软件进一步处理。对于 MMP9,保留一份未经修改的 PDB 1GKC 原始结构,作为催化 Zn2⁺ 环境及 N2-[(2R)-2-{[甲酰基(羟基)氨基]甲基}-4-甲基戊酰基]-N,3-二甲基-L-缬氨酰胺(NFH)结合模式的晶体学参考。在 1GKC 的 A 链中,催化 Zn2⁺ 由 His401、His405 和 His411 配位,距离分别为 2.21、2.23 和 2.22 Å,而两个 NFH 氧原子与 Zn2⁺ 的配位距离分别为 2.07 和 2.38 Å;Glu402 为催化酸/碱残基。这些晶体学相互作用被用作评估化合物 5 对接相互作用图谱的正向结构参考。对于 SRC,使用 PDB 2H8H 进行 SRC 的分子动力学(MD)计算。这些结构比较仅用于解释分析,不作为酶抑制或细胞内靶点结合的证据。
化合物4和化合物5的三维结构从PubChem获得,并在分子建模软件中通过能量最小化进行优化26。配体在生理条件下进行质子化处理,并使用Merck分子力场94(MMFF94)进行能量最小化,直至能量梯度低于0.01 kcal·mol⁻1·Å⁻1。在对接预处理软件中添加氢原子,分配Gasteiger电荷,并定义可旋转键。化合物6是非捕获型对照化合物3的谷胱甘肽裂解产物,采用相同的工作流程制备,并仅用于对接至SRC蛋白以生成匹配对照分子动力学轨迹的初始构象。因此,化合物6既未作为额外的预测治疗性配体引入,也未用于支持多靶点作用机制。
分子对接流程
采用分子对接软件,在半柔性对接协议下进行分子对接,受体保持刚性,配体允许保持柔性27,28。对于每个受体,对接框的中心位于共结晶配体的位置,以使搜索区域对应于实验确定的结合口袋。对接框的尺寸设置为:AKT1、EGFR 和 SRC 为 24 Å × 24 Å × 24 Å,MMP9 为 26 Å × 26 Å × 26 Å,TNF 为 28 Å × 28 Å × 28 Å。搜索 Exhaustiveness 参数设为 32,输出构象数设为 20,能量范围设为 4 kcal·mol⁻1。每次对接运行中排名最高的构象被保留用于相互作用分析。
为评估对接体系的内部可靠性,使用相同参数将每个共结晶配体重新对接至其相应的受体结合口袋中,并以重原子均方根偏差(RMSD)低于2.0 Å作为可接受标准。最终的对接构象通过分子可视化软件进行检查。对于MMP9–化合物5复合物,特别分析了保留的相互作用图谱中配体与催化性Zn2⁺离子的直接配位作用,以及与His401、Glu402、His405和His411的接触情况,并将配体位置与PDB 1GKC中晶体结构NFH的构象进行比较。仅当在保留的构象中明确观察到配体与Zn2⁺的直接配位时,才报告定量的金属配位距离;否则记为“不适用”,而不作推断。因此,若MMP9的对接构象缺乏这些典型的催化位点特征,则被归类为非典型构象,不视为MMP9酶活性抑制的证据。总体而言,AutoDock Vina评分和对接构象仅用于相对优先排序和假设生成,而非作为结合亲和力或细胞内靶点结合的证明。
分子动力学实验方案
用于分子动力学(MD)分析的蛋白质-配体复合物基于对接获得的结合构象构建。MD计算使用GROMACS29进行。蛋白质采用CHARMM36力场进行参数化,配体的原子类型和参数则使用第二代通用Amber力场(GAFF2)30,31进行分配。通过小分子参数化和配体拓扑生成工具,采用Austin Model 1-键电荷校正(AM1-BCC)方法生成部分电荷;随后由配体拓扑生成软件创建与GROMACS兼容的配体拓扑文件32,33,34。每个复合物被置于TIP3P水盒子中,在周期性边界条件下,溶质到盒子边界的最小距离为1.0 nm。添加钠离子和氯离子以中和每个体系的净电荷,并额外添加NaCl使最终离子强度达到0.15 M。
采用最陡下降法进行能量最小化,直至最大作用力降至1000 kJ·mol⁻1·nm⁻1以下。随后,在粒子数、压力和温度恒定(NPT)的条件下,对能量最小化后的体系在310 K和1 bar下进行平衡,并对蛋白质主链施加位置限制。温度通过V-rescale控温器控制,压力通过Parrinello-Rahman控压器控制。长程静电相互作用采用粒子网格Ewald(PME)方法计算。短程静电截断距离和范德华截断距离均设为1.0 nm,所有涉及氢原子的键均使用线性约束求解器(LINCS)算法进行约束。生产模拟轨迹的运行时长为150 ns,积分时间步长为2 fs,每10 ps保存一次坐标,用于后续分析。
轨迹分析
对生产轨迹的平衡部分进行了轨迹分析。蛋白质主链RMSD和配体RMSD在通过最小二乘法拟合至初始参考构象后计算得出。使用Cα原子以每个残基为基础计算均方根涨落(RMSF)值。配体与其受体之间的氢键分析采用3.5 Å的供体-受体距离截断值和30°的供体-氢-受体角度截断值。氢键占据率定义为在分析的轨迹帧中特定氢键存在的比例。这些指标用于表征三个分子动力学轨迹中结构的稳定性、残基水平的柔性以及分子间相互作用的持续性。
分子力学泊松-玻尔兹曼表面积法(MM-PBSA)结合自由能计算
使用MM-PBSA分析软件,基于分子动力学轨迹的平衡阶段片段,采用MM-PBSA方法计算结合自由能35。对于每个蛋白质-配体复合物,采用150 ns生产相轨迹的最后50 ns进行自由能分析。从100.0 ns至149.9 ns期间,每隔100 ps均匀采样,共采集500个时间帧;150.0 ns的终点未包含在采样集合中。总结合自由能计算为范德华能、静电能、极性溶剂化能和非极性溶剂化能各项之和:
ΔG_bind = ΔE_vdW + ΔE_ele + ΔG_polar + ΔG_nonpolar (1)
未进行熵校正。所有采样帧的平均结合自由能及标准偏差均已计算。
可重复性与计算验证对照
在靶点预测、疾病-靶点检索和交集分析步骤中使用的所有基因名称均在下游分析前标准化为官方人类基因符号。所有受体-配体对均保持相同的对接参数。通过使用相同的搜索设置以及预设的重原子RMSD接受阈值(<2.0 Å),将相应的共结晶配体重新对接至各受体结合口袋,以技术验证对接设置的准确性。晶体结构MMP9–NFH复合物被保留作为催化Zn2⁺环境的阳性结构参照,而SRC–Compound 6则作为SRC轨迹分析中匹配的非捕获型对照物。分子动力学(MD)轨迹在纳入后续分析前,已检查其温度与压力稳定性,并确认无异常的模拟盒体积漂移。所有输入文件、受体结构、配体拓扑文件、对接配置文件、MD参数文件以及MM-PBSA帧选择记录均已归档,以支持计算结果的可重复性。
结果
化合物相关靶点的预测及交集靶点的鉴定
对化合物1–3进行反向靶点预测,获得了212个潜在的人类靶点。同时,使用关键词“lung cancer H1299”并在GeneCards中设置相关性评分阈值大于0.27,检索到188个与非小细胞肺癌(NSCLC)相关的靶点。对化合物预测靶点与疾病相关靶点集合进行交集分析,得到21个重叠靶点,这些靶点被保留用于后续所有分析。两个靶点集合之间的重叠情况如图2所示。结果表明,研究中的化合物作用靶点集中于有限的、与疾病相关的靶点子集,而非广泛且无特异性的靶点空间。
蛋白质-蛋白质相互作用分析及核心靶点筛选
将21个相交靶点导入STRING以构建蛋白质-蛋白质相互作用(PPI)网络。所得网络包含21个节点和116条边。补充表1中的节点度值总和为232,与116条无向边一致。针对该原始网络计算了中心性值。节点度的中位数为12;采用度≥12的筛选条件保留了13个候选靶点。在这13个候选靶点中,中介中心性的中位数为0.031293,接近中心性的中位数为0.769231。结合中介中心性≥0.031293且接近中心性>0.769231的条件,优先筛选出五个枢纽候选靶点:AKT1、EGFR、TNF、MMP9和SRC。所显示的保留子集的数值均为在筛选过程中沿用的原始21节点网络的中心性指标,并未针对13节点或5节点子网络重新计算。这些靶点的网络中心性仅用于对后续基于结构的评估候选靶点进行排序,不应被解释为这些靶点是化合物生物学作用靶点的直接证据。补充表1、补充表2和补充表3分别列出了初始21节点网络、首轮筛选后保留的13个候选靶点以及最终五个枢纽候选靶点的中心性指标。顺序的PPI网络筛选过程及最终五个枢纽候选靶点分别展示于图3A、图3B、图3C、和 图3D中。
基因本体论与京都基因与基因组百科全书富集分析
对21个交集靶点进行功能富集分析,共鉴定出121条满足名义 p < 0.10 纳入标准的KEGG通路。前20条排名最高的通路如图4A所示。其中,内分泌耐药、癌症通路、癌症中的蛋白聚糖、EGFR酪氨酸激酶抑制剂耐药以及ErbB信号通路尤为显著。这些通路与非小细胞肺癌(NSCLC)中的肿瘤增殖、存活、侵袭及治疗耐药密切相关。所有满足名义 p < 0.10 标准的121条保留KEGG通路的完整富集统计结果见补充表4。
GO 富集分析进一步筛选出 177 个 BP 术语、29 个 CC 术语和 61 个 MF 术语,均满足相同的名义标准 p < 0.10 纳入标准。每个类别中排名前十的术语如下所示 图4B, 图4C, 和 图 4D主要的生物学过程包括血管相关平滑肌细胞增殖的正向调控、有丝分裂细胞周期的G2/M期转换、胰岛素样生长因子受体信号传导、蛋白质磷酸化、细胞凋亡的负调控以及信号转导。主要的细胞组分术语包括细胞核、膜筏、黏着斑、质膜以及染色体的端粒区域。相比之下,分子功能方面排名靠前的术语如 图4D 包括蛋白激酶活性、蛋白丝氨酸激酶活性、ATP结合、蛋白丝氨酸/苏氨酸激酶活性、蛋白酪氨酸激酶活性、RNA聚合酶II CTD七肽重复序列激酶活性、激酶活性、组蛋白H2AX Y142激酶活性、组蛋白H3 Y41激酶活性以及相同蛋白结合。BP、CC和MF的完整富集统计结果如下所示 补充表5, 补充表6,以及 补充表 7综合这些富集结果表明,交集靶基因集合主要集中于与非小细胞肺癌进展相关的信号传导、生存调控及致癌反应过程。
基于分子对接的代谢物-靶点复合物优先级排序
化合物4与化合物5分别与通过网络拓扑学优先筛选出的五种蛋白质进行了分子对接。所报告的数值如下 表1 AutoDock Vina 对接得分并非实验测得的结合自由能。化合物 5 与 MMP9 的对接得分最为有利(-8.418 kcal)·mol⁻1),随后是化合物4与MMP9(-7.840 kcal·mol⁻1)。化合物5在AKT1和EGFR上的评分也优于化合物4,而化合物4在SRC上的评分略高(-6.549 对比 -6.204 kcal·mol⁻1)和 TNF(-5.436 对比 -5.299 kcal·mol⁻1因此,化合物5在五种蛋白质中并未表现出一致的评分优势。对接结果仅用于优先选择代表性复合物以进行进一步的结构分析。
典型的对接构象如图5所示。在排名最高的MMP9–化合物5相互作用图谱中,显示的接触位点位于Ala417和Pro421附近,距离分别约为3.0 Å和2.4 Å。在保留的最高评分构象相互作用图谱中,未标注化合物5与ZN2⁺的直接配位,且未显示与His401、Glu402、His405或His411的直接接触。这与1GKC晶体结构参考数据形成对比,在后者中,His401、His405和His411分别在2.21、2.23和2.22 Å距离上配位催化性ZN2⁺,而反向羟肟酸类抑制剂NFH通过两个氧原子在2.07和2.38 Å距离上配位同一ZN2⁺。由于在保留的相互作用图谱中未标注化合物5与ZN2⁺的直接配位,因此未赋予任何化合物5-ZN2⁺配位距离;这应被解释为在该保留图谱中缺乏直接配位的实验证据,而非测得的金属间距数值。与MMP9–NFH晶体结构参考数据的三维比较见补充图1。因此,该结合几何构型不同于典型的锌依赖性抑制性结合模式,当前的对接结果不支持将化合物5归类为MMP9抑制剂。保留MMP9仅用于分子动力学(MD)分析,以确定该特定的非典型对接几何构型在轨迹过程中是否持续存在。对于其他复合物,化合物5显示出与AKT1和SRC的预测接触,而化合物4也与MMP9和SRC形成了明确的对接相互作用。与图5F一致,这些观察结果描述的是预测的相互作用和相对对接评分,而非经实验验证的结合亲和力。
选择三个复合物进行分子动力学(MD)分析,目的是进行比较而非验证。选择MMP9–化合物5是因为其具有最有利的单一对接评分,但其MMP9构象为非经典构象,需要谨慎进行结构后续分析。SRC–化合物5被选为第二个候选复合物,而SRC–化合物6则作为匹配的非捕获对照轨迹纳入分析。相应的初始构象如图6A、图6B、和 图6C所示。该设计使得能够比较所选对接几何构型的持续性,而不会将MD稳定性视为靶点结合或功能调控的证据。
分子动力学分析
为了比较在动态水相条件下选定的对接衍生构型的稳定性,分别生成了 MMP9–化合物5 和 SRC(PDB 2H8H)–化合物5 复合物的 150 ns 分子动力学(MD)轨迹,并将 SRC(PDB 2H8H)–化合物6 的轨迹作为匹配的阴性对照。初始构象如图6A、 图6B、和 图6C所示。在这些轨迹中,化合物5 在 MMP9 和 SRC 体系中的配体 RMSD(图6D)低于化合物6 在 SRC 体系中的 RMSD。MMP9–化合物5 轨迹进入了一个相对低波动的状态,SRC–化合物5 轨迹在初始调整期后趋于稳定,而 SRC–化合物6 轨迹则表现出更大的波动。这些差异表明,在分子动力学模拟过程中,选定的化合物5 对接构象具有更高的持久性。然而,这些结果并不能证明化合物5 在细胞内与 MMP9 或 SRC 结合,且 MMP9 的轨迹未能克服起始构象中缺乏经典催化 ZN2⁺ 相互作用的问题。
蛋白质主链的RMSD显示出相似的比较模式。MMP9–化合物5的轨迹在大约30 ns后进入相对稳定的主链状态,而SRC–化合物5的轨迹达到平稳相的时间较晚,SRC–化合物6的轨迹则表现出更大的波动。这些观察结果仅描述了轨迹行为。稳定的蛋白质主链或配体轨迹并不能证明细胞内靶点占据、酶活性抑制或信号通路调节。三种系统的蛋白质主链RMSD曲线见补充图2。
轨迹分析
采用氢键占有率和残基波动性分析来描述分子动力学轨迹中的接触持久性(图7A)。化合物5在MMP9轨迹中与Arg95形成高占有率的氢键(>85%),并在SRC轨迹中与Leu325频繁相互作用(>70%),而SRC–化合物6对照组中的代表性接触占有率较低。这些残基并不作为功能靶点调控的证据;占有率数值仅表示在分析的轨迹中特定接触发生的频率。
结合口袋残基的RMSF分析显示了不同体系在局部柔性上的特异性差异(图7B)。SRC–化合物6轨迹中多个局部区域的波动幅度大于SRC–化合物5轨迹,而MMP9–化合物5轨迹在其结合口袋残基范围内的波动程度则相对受限。由于MMP9和SRC是不同的蛋白质,其残基水平的RMSF值不能直接进行逐残基比较。结合氢键占据率分析,这些结果共同表征了分子间相互作用的持续性与局部柔性,有助于优先筛选出适合进行实验验证的复合物。但这些结果并未确立MMP9或SRC作为化合物的细胞内作用靶点,也未证明任一蛋白介导了这些化合物的抗癌表型。
分子力学泊松-玻尔兹曼表面积结合自由能计算
从平衡后的轨迹片段计算得到的MM-PBSA估计值如图8所示。MMP9–化合物5复合物的ΔG_bind估计值为-19.65 ± 6.43 kcal·mol⁻1,SRC–化合物5复合物为-17.72 ± 6.84 kcal·mol⁻1,而SRC–化合物6对照组为-10.37 ± 5.61 kcal·mol⁻1。在此计算方案中,结合能的相对排序依次为MMP9–化合物5、SRC–化合物5和SRC–化合物6。这些数值是依赖于方法的估计值,来源于有限的轨迹片段,且未进行熵校正。因此,这些值仅用于本研究内部的比较,不应被解释为实验测得的结合亲和力,也不应作为功能性蛋白调控的证据。
通过分子对接、分子动力学(MD)、接触占有率、残基波动性以及MM-PBSA分析,化合物5在MMP9和SRC复合物中被计算优先选择用于后续研究。这些计算结果的一致性增强了选择这两对蛋白进行后续实验的合理性,但并不能证实MMP9或SRC是其直接的细胞内靶点。特别是,MMP9的非经典结合构象以及缺乏已证实的催化性Zn2⁺配位,使得无法从当前的结构数据推断出经典的MMP9抑制机制。
由结果得出的结论
计算工作流程优先筛选出21个重叠的疾病相关靶点,并确定AKT1、EGFR、TNF、MMP9和SRC为拓扑学核心候选靶点。基于结构的分析进一步优先选择化合物5用于MMP9和SRC复合物的实验验证。这些发现并未证明直接的靶点结合、MMP9或SRC抑制、通路调控,或蛋白质相互作用与先前确立的无碱基位点捕获效应之间的因果机制联系。因此,该研究支持一组可验证的计算假说,而非已通过实验确立的多靶点抗非小细胞肺癌机制。
数据可用性:
支持本研究发现的数据集公开获取地址为王X、彭Z、邢Y、薛L。非小细胞肺癌中谷胱甘肽响应性无碱基位点捕获前药潜在蛋白质相互作用的计算机优先排序[数据集]。Figshare;2026。doi:10.6084/m9.figshare.33313620.v1。
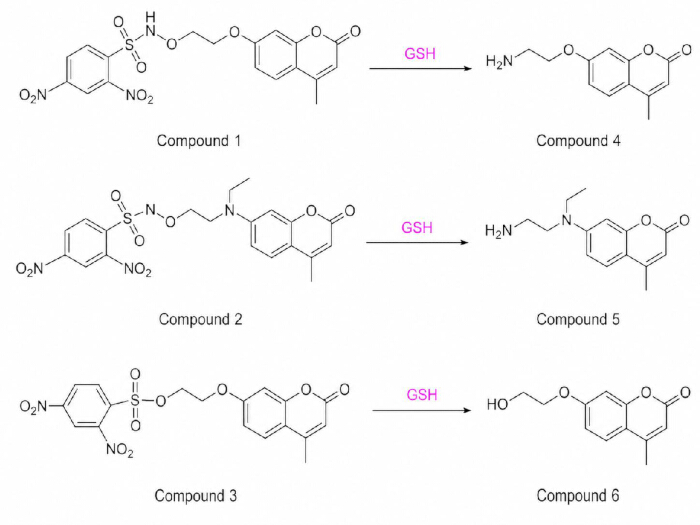
图1:研究化合物的化学结构及谷胱甘肽触发的转化关系。 化合物1和化合物2是响应谷胱甘肽的前药,分别释放含氨基氧的代谢产物化合物4和化合物5。化合物3是相应的谷胱甘肽响应结构对照物,生成的化合物6缺乏氨基氧介导的脱碱基位点捕获功能。化合物1–3用于反向靶点预测,化合物4和化合物5用于核心靶点对接,化合物6则作为SRC分子动力学比较中的阴性对照配体。缩写:SRC,SRC原癌基因,非受体酪氨酸激酶。 请点击此处查看该图的放大版本。
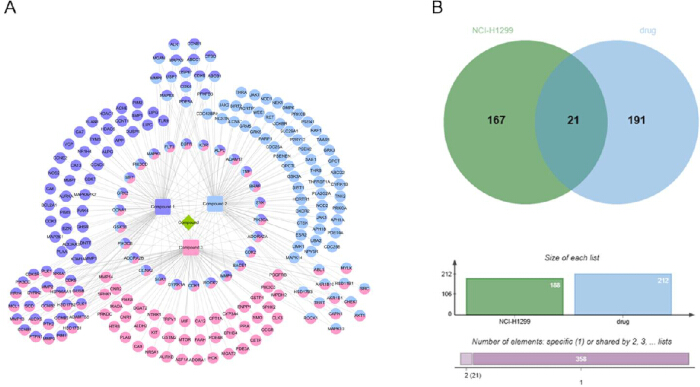
图2:化合物预测靶点与非小细胞肺癌相关靶点的交集。(A)基于化合物1–3的反向靶点预测结果生成的化合物-靶点网络。(B)维恩图显示化合物预测靶点与使用H1299肺癌查询获取的疾病相关靶点之间的重叠区域。共获得21个交集靶点,用于后续的蛋白质-蛋白质相互作用分析、富集分析以及基于结构的优先排序。请点击此处查看该图的放大版本。
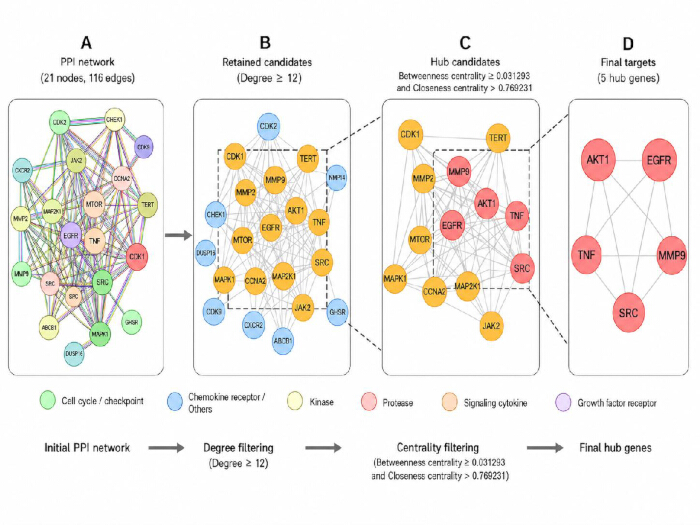
图3:蛋白质-蛋白质相互作用网络及核心靶点筛选。(A)21个交集靶点的蛋白质-蛋白质相互作用网络(共116条边)。(B)使用度值 ≥ 12 进行第一轮筛选,保留13个候选靶点。(C)对保留的13个候选靶点进一步采用介数中心性 ≥ 0.031293 且接近中心性 > 0.769231 进行第二轮筛选,获得5个核心候选靶点。(D)最终的5个核心候选靶点:AKT1、EGFR、TNF、MMP9 和 SRC。用于逐级筛选的中心性数值均基于原始的21节点、116条边的网络计算得出,并在后续筛选中直接沿用,而非在每次子集形成后重新计算。缩写:AKT1,AKT丝氨酸/苏氨酸激酶1;EGFR,表皮生长因子受体;TNF,肿瘤坏死因子;MMP9,基质金属蛋白酶9;SRC,SRC原癌基因,非受体酪氨酸激酶。请点击此处查看该图的放大版本。
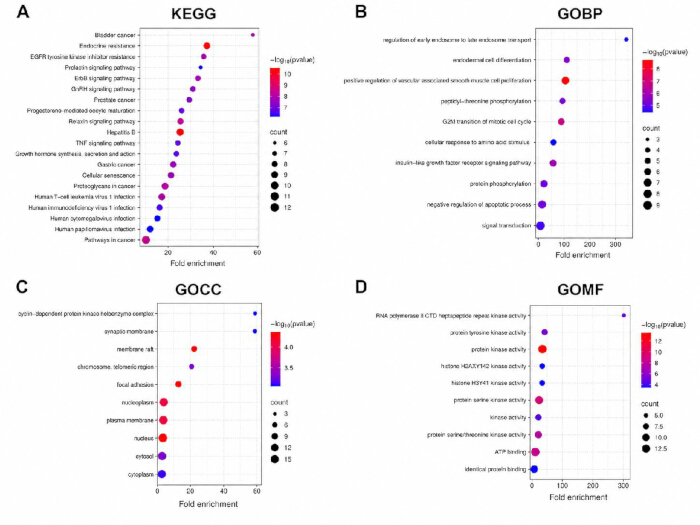
图4:交集靶点的功能富集分析。(A)前20个富集的京都基因与基因组百科全书(KEGG)通路的气泡图。(B)前10个富集的基因本体(Gene Ontology)生物过程术语的条形图。(C)前10个富集的基因本体(Gene Ontology)细胞组分术语的条形图。(D)前10个富集的基因本体(Gene Ontology)分子功能术语的条形图。最终可视化图中横轴显示折叠富集度;A图中的气泡大小反映基因数量。所有包含在补充表4–7中的KEGG和GO条目均满足名义上的p < 0.10纳入标准;所绘制的通路/术语按名义p值排名最高者选取。多重检验校正后的值已在补充表中列出,但未用于纳入分析。请点击此处查看该图的放大版本。
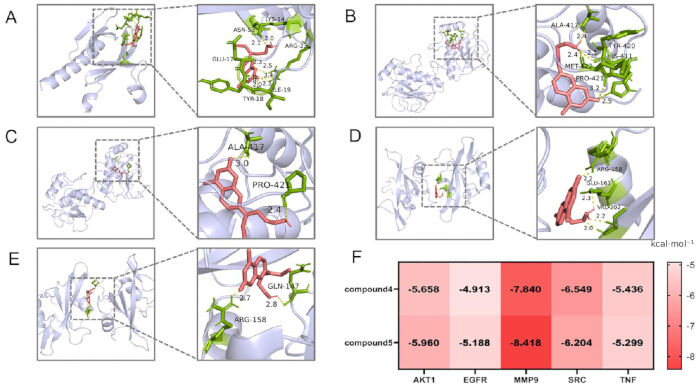
图5:化合物4和化合物5与优先靶向蛋白的分子对接构象及AutoDock Vina评分。(A)化合物5与AKT1的预测对接构象。(B)化合物4与MMP9的预测对接构象。(C)化合物5与MMP9的最高排名预测构象;显示的相互作用接近Ala417和Pro421,但未标注与His401、Glu402、His405或His411的直接催化性Zn2⁺配位或直接接触。因此,该构象未呈现典型的MMP9抑制性结合模式。在补充图3中提供了与NFH结合的MMP9晶体结构(PDB 1GKC)的参考相互作用图谱对比,包括晶体学Zn2⁺配位距离。(D)化合物4与SRC的预测对接构象。(E)化合物5与SRC的预测对接构象。(F)化合物4和化合物5对五种优先靶向蛋白的AutoDock Vina对接评分(kcal·mol⁻1)热图。在此对接方案中,更负的数值表示更有利的Vina评分;这些数值并非实验测得的结合亲和力。缩写:AKT1,AKT丝氨酸/苏氨酸激酶1;MMP9,基质金属蛋白酶9;NFH,N2-[(2R)-2-{[甲酰基(羟基)氨基]甲基}-4-甲基戊酰基]-N,3-二甲基-L-缬氨酰胺;SRC,SRC原癌基因,非受体型酪氨酸激酶;PDB,蛋白质数据库;Ala,丙氨酸;Pro,脯氨酸;His,组氨酸;Glu,谷氨酸。请点击此处查看该图的放大版本。
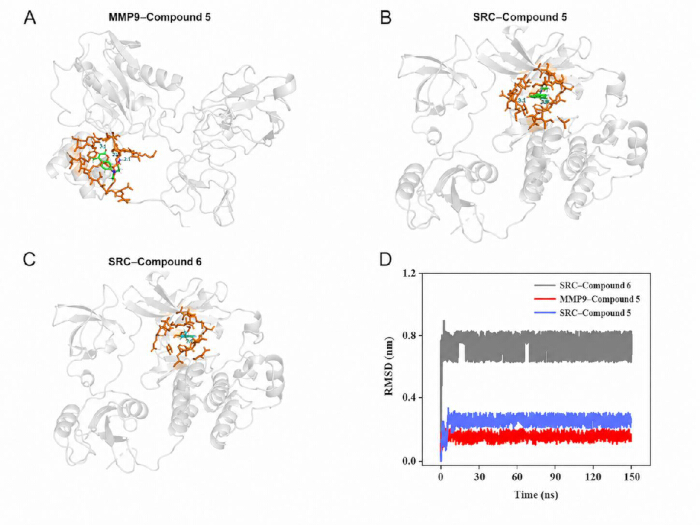
图6:MD复合物的结构概述及配体稳定性分析。(A)化合物5与MMP9的初始对接构象,用作分子动力学(MD)模拟的起始结构。(B)化合物5与SRC(PDB 2H8H)的初始对接构象。(C)化合物6与SRC(PDB 2H8H)的初始对接构象;化合物6是对照化合物3经谷胱甘肽裂解后的产物,缺乏氨基氧基脱碱基位点捕获功能。(D)在150 ns的模拟轨迹中,MMP9–化合物5、SRC–化合物5和SRC–化合物6复合物中配体相对于初始对接构象的均方根偏差(RMSD)。该图展示了分子动力学模拟过程中构象的稳定性,但并不证明在细胞内与靶标的结合。缩写:MD,分子动力学;MMP9,基质金属蛋白酶9;SRC,SRC原癌基因,非受体酪氨酸激酶;PDB,蛋白质数据库;RMSD,均方根偏差。请点击此处查看该图的放大版本。
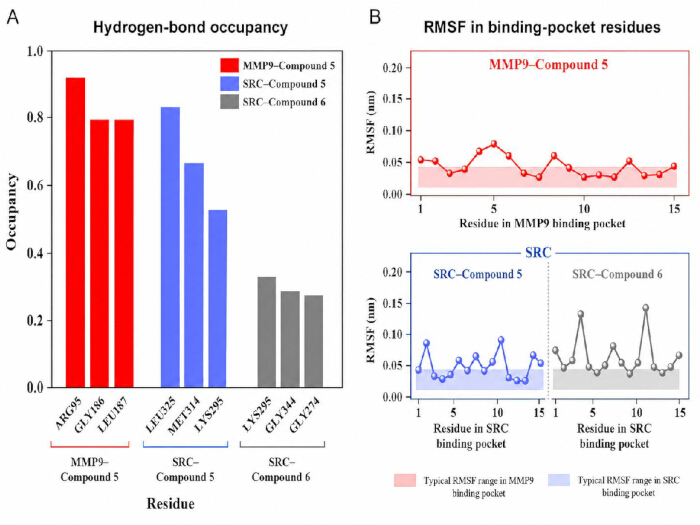
图7:分子动力学分析过程中的动态相互作用特征。(A)MMP9–化合物5、SRC–化合物5和SRC–化合物6在150 ns轨迹模拟期间代表性配体-蛋白氢键的占据情况。(B)结合口袋残基的均方根波动。MMP9的曲线基于MMP9体系进行解读,而SRC–化合物5和SRC–化合物6的曲线则在SRC体系内进行直接对照比较。这些分析描述了分子动力学模拟过程中的接触持续性和局部柔性,但并未证明MMP9或SRC在细胞内的靶点结合或功能调控。缩写:MD,分子动力学;MMP9,基质金属蛋白酶9;SRC,SRC原癌基因,非受体型酪氨酸激酶;RMSF,均方根波动。请点击此处查看该图的放大版本。
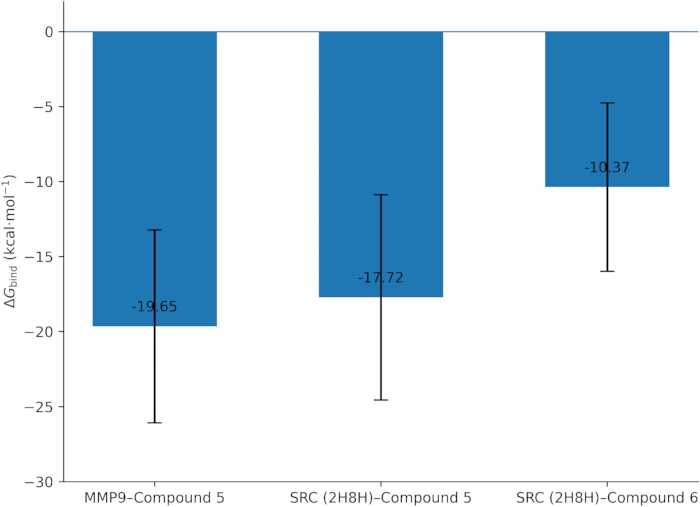
图8:分析所得复合物的分子力学泊松-玻尔兹曼表面积能量估算。 通过分子力学泊松-玻尔兹曼表面积法(MM-PBSA)对MMP9–化合物5、SRC(PDB 2H8H)–化合物5以及SRC(PDB 2H8H)–化合物6复合物的平衡轨迹片段进行分析,获得估算的ΔG_bind值。数据以均值±标准差表示,仅用于本研究内部的相对比较,而非实验测定的结合亲和力。图8中y轴标签为ΔG_bind (kcal·mol⁻1),与“方法与结果”部分所用公式及术语保持一致。缩写:MMP9,基质金属蛋白酶9;SRC,SRC原癌基因,非受体酪氨酸激酶;PDB,蛋白质数据库;ΔG_bind,结合自由能;MM-PBSA,分子力学泊松-玻尔兹曼表面积法。请点击此处查看此图的放大版本。
| 化合物 | AKT1 (kcal·mol⁻¹) | EGFR (kcal·mol⁻¹) | MMP9 (kcal·mol⁻¹) | SRC (kcal·mol⁻¹) | TNF (kcal·mol⁻¹) |
| 化合物 4 | -5.658 | -4.913 | -7.840 | -6.549 | -5.436 |
| 化合物 5 | -5.960 | -5.188 | -8.418 | -6.204 | -5.299 |
表1:化合物4和化合物5与五种优先靶标蛋白的AutoDock Vina分子对接得分。 化合物4和化合物5与AKT1、EGFR、MMP9、SRC及TNF的AutoDock Vina对接得分(kcal·mol⁻1)。更负的数值表示在指定的对接方案中具有更有利的对接结果。这些数值为计算所得的打分结果,不应被描述为实验测得的结合自由能或亲和力。缩写:AKT1,AKT丝氨酸/苏氨酸激酶1;EGFR,表皮生长因子受体;MMP9,基质金属蛋白酶9;SRC,SRC原癌基因,非受体型酪氨酸激酶;TNF,肿瘤坏死因子。
补充图1:MMP9–NFH晶体学参考结构与排名最高的MMP9–化合物5对接构象的结构比较。(A)MMP9–NFH参考复合物(PDB 1GKC)的催化Zn2+环境,显示His401、His405、His411、Glu402以及所示的NFH配位距离。(B)排名最高的化合物5对接构象,显示Ala417和Pro421的相互作用。(C)同一化合物5对接构象的另一种三维视图。该比较仅作为结构参考,不证明对MMP9具有抑制作用。缩写:MMP9,基质金属蛋白酶9;NFH,N2-[(2R)-2-{[甲酰(羟基)氨基]甲基}-4-甲基戊酰基]-N,3-二甲基-L-缬氨酰胺;PDB,蛋白质数据库;Ala,丙氨酸;Pro,脯氨酸;His,组氨酸;Glu,谷氨酸。请点击此处下载该文件。
补充图 2:分子动力学分析过程中蛋白质骨架的均方根偏差。 MMP9–Compound 5、SRC(PDB 2H8H)–Compound 5 和 SRC(PDB 2H8H)–Compound 6 体系在整个分子动力学轨迹中的蛋白质骨架均方根偏差曲线。最终图像使用标准化标签 MMP9–Compound 5、SRC–Compound 5 和 SRC–Compound 6,坐标轴分别表示为 RMSD(nm)和时间(ns)。这些曲线描述了分子动力学模拟过程中随时间变化的构象行为,不应被解释为细胞结合或蛋白质调控的证据。缩写:MMP9,基质金属蛋白酶 9;SRC,SRC 原癌基因,非受体酪氨酸激酶;PDB,蛋白质数据库;RMSD,均方根偏差;MD,分子动力学。请点击此处下载该文件。
补充图3:1GKC-NFH参考复合物与排名最高的化合物5对接构象中MMP9催化锌离子(Zn2+)环境的比较。 在晶体结构MMP9–NFH参考复合物(PDB 1GKC)中,His401、His405和His411分别在2.21、2.23和2.22 Å的距离上配位催化Zn2+,两个NFH氧原子在2.07和2.38 Å处与Zn2+配位;Glu402为催化酸/碱残基。相比之下,保留的排名最高的化合物5相互作用图显示其与Ala417(3.0 Å)和Pro421(2.4 Å)存在接触,但未标注与Zn2+的直接配位,也未与His401、Glu402、His405或His411形成直接接触。因此,未赋予任何化合物5与Zn2+之间的配位距离。该比较支持将化合物5的构象归类为非经典预测结合模式,而非经典的锌依赖性抑制性结合模式。缩写:MMP9,基质金属蛋白酶9;PDB,蛋白质数据库;Ala,丙氨酸;Pro,脯氨酸;His,组氨酸;Glu,谷氨酸。请点击此处下载该文件。
补充表1:初始21节点、116条边的蛋白质-蛋白质相互作用网络的拓扑学指标。 在基于中心性筛选前,所有21个交集靶点节点的拓扑参数,包括平均最短路径长度、介数中心性、接近中心性、聚类系数、度、偏心率、邻域连接性、径向性、应力以及拓扑系数。节点度的总和为232,对应于116条无向边。请点击此处下载该文件。
补充表 2:经基于度的筛选后保留的 13 个候选节点的原始网络拓扑参数。 在对初始包含 21 个节点和 116 条边的网络应用度标准后,保留的 13 个节点的拓扑参数。这些数值是从原始的 21 节点、116 边网络中沿用至后续介数中心性和接近性中心性筛选步骤的指标;它们并非在 13 节点子网络上重新计算所得。请点击此处下载该文件。
补充表3:经连续筛选后保留的最终五个枢纽候选基因的原始网络拓扑参数。 经连续筛选后保留的最终五个枢纽候选基因AKT1、EGFR、TNF、MMP9和SRC在原始21节点、116条边网络中的拓扑参数。这些保留的数值仅用于支持基于网络的优先排序,并不代表在五节点子网络上重新计算的度量指标,也不表明这些蛋白质已被实验验证为药物靶点。缩写:AKT1,AKT丝氨酸/苏氨酸激酶1;EGFR,表皮生长因子受体;TNF,肿瘤坏死因子;MMP9,基质金属蛋白酶9;SRC,SRC原癌基因,非受体型酪氨酸激酶。请点击此处下载该文件。
补充表4:满足名义p < 0.10纳入标准的121条通路的完整京都基因与基因组百科全书(KEGG)富集结果。 在21个交集靶点中保留的全部121条通路的京都基因与基因组百科全书(KEGG)富集统计结果(名义p < 0.10),包括基因比值、基因计数、列表总数、背景命中数、背景总数、p值、Benjamini校正值、富集倍数、Bonferroni校正值、错误发现率及Fisher精确检验值。排名前20的通路已在图4A中可视化展示。纳入标准由名义p值界定;为保证透明性,同时提供了Benjamini校正、Bonferroni校正和错误发现率数值,但这些指标未用于定义保留的通路集合。请点击此处下载该文件。
补充表5:完整的基因本体生物学过程富集结果(177个满足名义p < 0.10的条目)。 针所有保留的177个基因本体生物学过程条目(名义p < 0.10),提供完整的富集统计信息,包括基因比例、基因数量、列表总数、背景命中数、背景总数、p值、Benjamini校正值、富集倍数、Bonferroni校正值、错误发现率以及Fisher精确检验值。排名前10的条目已在图4B中可视化展示。条目的纳入以名义p值为判定标准;为保证透明性,报告了经校正的数值,但未用于定义保留的条目集合。请点击此处下载该文件。
补充表6:基因本体细胞组分富集分析完整结果(共29个满足名义p < 0.10的条目)。 所有29个保留的基因本体细胞组分条目的完整富集统计结果(名义p < 0.10),包括基因比例、基因数量、列表总数、背景命中数、背景总数、p值、Benjamini校正值、富集倍数、Bonferroni校正值、错误发现率及Fisher精确检验值。排名前10的条目已在图4C中可视化展示。条目纳入标准依据名义p值设定;为保证透明性,报告了经多重检验校正后的数值,但未用于定义保留的条目集合。请点击此处下载该文件。
补充表7:完整的基因本体分子功能富集结果(61个满足名义p < 0.10的条目)。 所有61个保留的基因本体分子功能条目(名义p < 0.10)的完整富集统计结果,包括基因比例、基因数量、列表总数、背景命中数、背景总数、p值、Benjamini校正值、富集倍数、Bonferroni校正值、错误发现率以及Fisher精确检验值。排名前10的条目已在图4D中可视化展示。条目的纳入以名义p值为标准;为保证透明性,报告了经校正的数值,但未用于定义保留的条目集合。请点击此处下载该文件。
讨论
本研究应在两个层面的机制框架内进行解读。第一个层面基于先前的实验工作:谷胱甘肽响应性激活会释放出含氨基氧的物种,该物种可捕获醛基型无碱基位点,且该化合物类别在H1299细胞中表现出选择性细胞毒性、细胞周期效应及诱导凋亡作用。第二个层面为探索性研究,也是本工作的重点:计算靶点预测和基于结构的分析表明,同一类化合物可能还与某些癌症相关蛋白相容。本研究中尚无实验能够证明所预测的蛋白质相互作用在细胞内实际发生,或证明这些相互作用是无碱基位点捕获的下游效应。因此,这两个层面被有意保持分离,而非合并为一个已被证实的多靶点作用机制。
在网络层面,21个交集靶点富集于癌症和耐药相关通路中,且AKT1、EGFR、TNF、MMP9和SRC在蛋白质-蛋白质相互作用网络中处于核心位置。这些结果有助于候选靶点的优先排序,但网络中心性分析和通路富集分析无法证明化合物是否直接与蛋白质结合或改变通路活性。因此,枢纽蛋白应被视为靶向验证的候选分子。要确立其功能作用,需在用于测定细胞表型的同一非小细胞肺癌(NSCLC)细胞系中进行直接干扰或靶点结合实验。
MMP9 说明了这一区别的重要性。化合物 5 与 MMP9 的单次对接评分最理想,但保留的最优构象相互作用图谱并未标注其与催化性 Zn2+ 离子的直接配位,或与 His401、Glu402、His405 或 His411 的直接相互作用。在 1GKC 晶体结构参考中,His401、His405 和 His411 分别在 2.21、2.23 和 2.22 Å 距离上与 Zn2+ 配位,而 NFH 的两个氧原子则在 2.07 和 2.38 Å 距离上与 Zn2+ 配位;Glu402 是催化酸/碱残基。相比之下,化合物 5 的相互作用图谱仅显示了与 Ala417 和 Pro421 附近的接触。补充图 3 展示了参考相互作用图谱的对比。由于未标注化合物 5 与 Zn2+ 的直接配位,因此未分配任何化合物 5–Zn2+ 配位距离。因此,当前的结构结果最好被描述为与 MMP9 的一种非经典预测性结合,而非催化位点抑制的证据。后续的分子动力学轨迹仅用于检验该特定对接构象是否在时间进程中保持稳定;它无法将非经典对接几何结构转化为酶抑制的证明36,37。因此,MMP9 应仍被视为生化测试的候选靶点,而非主要或已验证的靶点。MMP9 已被广泛讨论于癌症侵袭、肿瘤微环境重塑以及针对 MMP9 的治疗策略中38,39。
相同的证据标准也适用于SRC。SRC–化合物5的轨迹比SRC–化合物6对照表现出更持久的相互作用,但分子动力学稳定性并不等同于细胞内靶点占据40,41。使用化合物6可提供与非捕获型裂解产物的匹配对照,增强了内部结构比较的可靠性,但并不能证明氨基氧功能基团负责SRC结合,或SRC信号在细胞内发生改变。要支持此类结论,需要对总SRC、p-SRC/SRC、下游信号标志物以及正交的靶点结合检测进行直接评估。
MM-PBSA 同样为采样的轨迹提供了相对的能量估算,而非实验测得的亲和力数据。MMP9–化合物5和SRC–化合物5的估算结果优于SRC–化合物6,这与比较轨迹观察结果一致;但该计算对采样构象和方法学近似较为敏感,且当前分析未包含熵校正。因此,对接、分子动力学和MM-PBSA结果之间的一致性仅提高了内部计算的自洽性,并不能证实对MMP9或SRC的功能调控作用。
脱碱基位点捕获与预测的蛋白质相互作用之间的关系仍未明确。一种可能是,谷胱甘肽释放的氨基氧骨架在保持其既有的DNA损伤位点捕获活性的同时,还独立地与特定蛋白质发生平行相互作用。另一种可能是,某些预测的蛋白质相互作用在生物学相关浓度下并不发生,或对表型无贡献。目前的数据尚无法区分这些可能性。要证明其机制上的关联,需要在化合物处理后同时检测DNA损伤应答和蛋白质通路的变化,并通过扰动实验验证:改变候选靶点会改变其抗癌表型。
未来的实验验证应在H1299细胞中进行,该细胞模型与此前对该化合物系列进行实验表征时所用模型一致。分阶段策略将首先通过浓度-反应活性、凋亡、细胞周期、迁移/侵袭等实验,比较化合物5与溶剂对照以及结构匹配的非捕获型化合物6。 γ通过H2AX检测确定表型与DNA损伤背景42MMP9 应通过明胶酶谱法和蛋白质表达分析进行检测,而 SRC 信号则应通过总 SRC 和酪氨酸416磷酸化 SRC 进行评估,同时 p-SRC/SRC 比值作为主要的信号读出指标。应使用正交的靶点结合方法(如表面等离子共振)独立评估化合物与蛋白质的直接结合。43只有当直接结合证据与相应的细胞功能读数一致时,候选相互作用才可被视为获得实验支持。对MMP9或SRC进行遗传学或药物学扰动,可进一步验证这些候选分子是否对H1299表型具有因果性贡献。该分阶段框架保留了此前已确立的脱碱基位点捕获活性与通过计算优先排序得出的MMP9/SRC相互作用假说之间的区别,同时为后续实验验证定义了直接路径。
披露
作者声明,他们不存在与本工作相关的任何竞争性财务利益或其他利益冲突。资助方在研究设计、数据收集、分析或解释、论文撰写,以及决定发表结果等方面均未发挥任何作用。
致谢
本工作得到了辽宁省教育厅青年项目(JYTQN2023441)、辽宁省科技厅省联合基金博士科研启动项目(2023-BSBA-151)以及锦州医科大学青年科技人才支持项目(JYQT202305)的资助。在稿件修改过程中,使用了 ChatGPT(OpenAI)进行语言润色、结构整理和修改辅助。作者们审阅并核实了文中的科学内容、数据解读及最终文字表述,对稿件承担全部责任。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| ACPYPE | ACPYPE 开发者 / Bio2Byte | 版本 2023.11.14 | 小分子配体拓扑文件的生成及其转换为GROMACS兼容格式 |
| AmberTools(Antechamber) | AMBER 开发团队 | AmberTools 23.3 | AM1-BCC 部分电荷分配与 GAFF2 配体参数生成 |
| AutoDock Vina | Forli 实验室,斯克里普斯研究所 | 版本 1.2.5 | 分子对接及排序的蛋白质-配体构象生成。 |
| AutoDockTools(MGLTools) | 斯克里普斯研究所计算结构生物学中心 | 版本 1.5.7 | 受体与配体准备、Gasteiger电荷分配、可旋转键定义及PDBQT格式转换。 |
| BIOVIA Discovery Studio Visualizer | 达索系统èmes BIOVIA | 版本 2025 | 对接构象可视化与蛋白质-配体相互作用分析 |
| CHARMM36 力场 | MacKerell 实验室 / CHARMM 力场开发者 | CHARMM36 | 分子动力学计算中的蛋白质参数化;本研究始终采用 CHARMM36(非 CHARMM36m)。 |
| Chem3D Ultra (ChemOffice 专业版) | Revvity Signals 软件 | 版本 22.2 | 使用MMFF94力场进行配体能量最小化。 |
| 化合物 1–6 | 如 Li 等人在《ACS Chemical Biology》(2022)中所述,先前已合成 | N/A | 计算工作流程中使用的谷胱甘肽响应型前体前药、释放产物及匹配的非捕获对照对。 |
| cytoHubba | cytoHubba 开发者 / Cytoscape 应用商店 | 版本 0.1 | 基于度、介数中心性和接近中心性分析的枢纽靶点优先排序 |
| Cytoscape | Cytoscape 联盟 | 版本 3.10.0 | 化合物-靶点与蛋白质相互作用网络的可视化及拓扑学分析 |
| DAVID 生物信息学资源 | 人类逆转录病毒学与免疫信息学实验室,美国国家癌症研究所弗雷德里克实验室 | 网络资源 | 基因本体与KEGG富集分析;名义p值 &以 p < 0.10 作为探索性纳入标准;报告的是校正后的 p 值,但未用于确定最终保留的变量集合。 |
| GAFF2 | AMBER 开发团队 | GAFF2 | 配体力场参数化 |
| GeneCards 人类基因数据库 | GeneCards 产品系列 / LifeMap Sciences 公司 / 以色列魏茨曼科学研究所 | 网络资源 | 使用查询“lung cancer H1299”检索疾病相关靶点。 |
| gmx_MMPBSA | gmx_MMPBSA 开发团队 | 版本 1.6.3 | 基于GROMACS分子动力学轨迹的MM-PBSA结合自由能计算;从100.0中采样了500帧–149.9 纳秒,以 100 皮秒为间隔,不包含 150.0 纳秒的终点;未进行熵校正。 |
| GROMACS | GROMACS 开发团队 | 版本 2024.4 | 分子动力学轨迹生成与轨迹分析 |
| Microbioinfo 在线可视化平台 | 上海纽百特生物科技有限公司 / 微生物信息 | 网络资源 | 富集条形图和气泡图的生成 |
| Open Babel | Open Babel 开发团队 | 版本 3.1.1 | 将结构文件转换为规范的SMILES格式以用于SwissTargetPrediction输入。 |
| PubChem | 美国国立卫生研究院,美国国家医学图书馆,国家生物技术信息中心 | 网络资源 | 三维配体结构的获取 |
| PyMOL 分子图形系统 | 施ödinger, LLC | 版本 2.5.4 | 蛋白质制备、结构可视化及分子对接构象检查 |
| RCSB 蛋白质数据库 | 结构生物信息学研究协作实验室(RCSB) | PDB ID:3O96;5UWD;2AZ5;1GKC;2H8H | AKT1、EGFR、TNF、MMP9 和 SRC 的蛋白质结构检索。 |
| STRING | STRING 联盟 | 版本 11.5 | 蛋白质-蛋白质相互作用网络构建;智人;最低相互作用得分要求为0.400;原始拓扑参数对应于包含21个节点和116条边的无向PPI网络。 |
| SwissTargetPrediction | 洛桑大学分子建模组 / 瑞士生物信息学研究所 | 网络资源 | 化合物1的反向靶点预测–3;仅限于智人(Homo sapiens)的物种。 |
| TIP3P 水模型 | 在 GROMACS 中实现 | TIP3P | 用于溶剂化蛋白质-配体复合物的三站点显式溶剂水模型 |
| Venny | BioinfoGP,国家生物技术中心í(西班牙国家研究委员会生物分子与细胞生物学中心) | 版本 2.1 | 化合物预测靶点与疾病相关靶点列表的交集 |
参考文献
- Sung H, et al. Global cancer statistics 2020: GLOBOCAN estimates of incidence and mortality worldwide for 36 cancers in 185 countries. CA Cancer J Clin. 2021;71:209-49.
- Herbst RS, Morgensztern D, Boshoff C. The biology and management of non-small cell lung cancer. Nature. 2018;553:446-54.
- Kim J, et al. Updates on the treatment of epidermal growth factor receptor-mutant non-small cell lung cancer. Cancer. 2025;131:e35778.
- Lin Y, Wang X, Jin H. EGFR-TKI resistance in NSCLC patients: mechanisms and strategies. Am J Cancer Res. 2014;4:411-35.
- Dasari S, et al. Pharmacological effects of cisplatin combination with natural products in cancer chemotherapy. Int J Mol Sci. 2022;23:1532.
- Ellie S, et al. Chemotherapy drugs cyclophosphamide, cisplatin and doxorubicin induce germ cell loss in an in vitro model of the prepubertal testis. Sci Rep. 2018;8:1773.
- De Bont R, van Larebeke N. Endogenous DNA damage in humans: a review of quantitative data. Mutagenesis. 2004;19:169-85.
- Ciccia A, Elledge SJ. The DNA damage response: making it safe to play with knives. Mol Cell. 2010;40:179-204.
- David SS, Williams SD. Chemistry of glycosylases and endonucleases involved in base-excision repair. Chem Rev. 1998;98:1221-62.
- Robson CN, Hickson ID. Isolation of cDNA clones encoding a human apurinic/apyrimidinic endonuclease that corrects DNA repair and mutagenesis defects in E. coli xth (exonuclease III) mutants. Nucleic Acids Res. 1991;19:5519-23.
- Sczepanski JT, et al. Rapid DNA-protein cross-linking and strand scission by an abasic site in a nucleosome core particle. Proc Natl Acad Sci U S A. 2010;107:22475-80.
- Krokan HE, Bjørås M. Base excision repair. Cold Spring Harb Perspect Biol. 2013;5:a012583.
- Li X, et al. Selective antitumor activity and photocytotoxicity of glutathione-activated abasic site trapping agents. ACS Chem Biol. 2022;17:797-803.
- Hopkins AL. Network pharmacology: the next paradigm in drug discovery. Nat Chem Biol. 2008;4:682-90.
- Meng XY, et al. Molecular docking: a powerful approach for structure-based drug discovery. Curr Comput Aided Drug Des. 2011;7:146-57.
- Hollingsworth SA, Dror RO. Molecular dynamics simulation for all. Neuron. 2018;99:1129-43.
- Genheden S, Ryde U. The MM/PBSA and MM/GBSA methods to estimate ligand-binding affinities. Expert Opin Drug Discov. 2015;10:449-61.
- O'Boyle NM, et al. Open Babel: an open chemical toolbox. J Cheminform. 2011;3:33.
- Daina A, Michielin O, Zoete V. SwissTargetPrediction: updated data and new features for efficient prediction of protein targets of small molecules. Nucleic Acids Res. 2019;47:W357-64.
- Shannon P, et al. Cytoscape: a software environment for integrated models of biomolecular interaction networks. Genome Res. 2003;13:2498-504.
- Stelzer G, et al. The GeneCards Suite: from gene data mining to disease genome sequence analyses. Curr Protoc Bioinformatics. 2016;54:1.30.1-1.30.33.
- Oliveros JC. Venny: an interactive tool for comparing lists with Venn's diagrams [Internet]. BioinfoGP, CNB-CSIC; 2007-2015.
- Szklarczyk D, et al. The STRING database in 2021: customizable protein-protein networks and functional characterization of user-uploaded gene/measurement sets. Nucleic Acids Res. 2021;49:D605-12.
- Chin CH, et al. cytoHubba: identifying hub objects and subnetworks from complex interactome. BMC Syst Biol. 2014;8:S11.
- Sherman BT, et al. DAVID: a web server for functional enrichment analysis and functional annotation of gene lists (2021 update). Nucleic Acids Res. 2022;50:W216-21.
- Kim S, et al. PubChem 2023 update. Nucleic Acids Res. 2023;51:D1373-80.
- Eberhardt J, et al. AutoDock Vina 1.2.0: new docking methods, expanded force field, and Python bindings. J Chem Inf Model. 2021;61:3891-8.
- Gerek ZN, Ozkan SB. A flexible docking scheme to explore the binding selectivity of PDZ domains. Protein Sci. 2010;19:914-28.
- Abraham MJ, et al. GROMACS: high-performance molecular simulations through multi-level parallelism from laptops to supercomputers. SoftwareX. 2015;1-2:19-25.
- Best RB, et al. Optimization of the additive CHARMM all-atom protein force field targeting improved sampling of backbone and side-chain dihedral angles. J Chem Theory Comput. 2012;8:3257-73.
- Vassetti D, Pagliai M, Procacci P. Assessment of GAFF2 and OPLS-AA general force fields in combination with the water models TIP3P, SPCE, and OPC3 for the solvation free energy of druglike organic molecules. J Chem Theory Comput. 2019;15:1983-95.
- Jakalian A, Jack DB, Bayly CI. Fast, efficient generation of high-quality atomic charges. AM1-BCC model: II. Parameterization and validation. J Comput Chem. 2002;23:1623-41.
- Sousa da Silva AW, Vranken WF. ACPYPE—AnteChamber PYthon Parser interfacE. BMC Res Notes. 2012;5:367.
- Case DA, et al. AmberTools. J Chem Inf Model. 2023;63:6183-91.
- Valdés-Tresanco MS, et al. gmx_MMPBSA: a new tool to perform end-state free-energy calculations with GROMACS. J Chem Theory Comput. 2021;17:6281-91.
- Islam MT, Jang NH, Lee HJ. Natural products as regulators against matrix metalloproteinases for the treatment of cancer. Biomedicines. 2024;12:794.
- Mondal S, et al. Matrix metalloproteinase-9 (MMP-9) and its inhibitors in cancer: a minireview. Eur J Med Chem. 2020;194:112260.
- Rashid ZA, Bardaweel SK. Novel matrix metalloproteinase-9 (MMP-9) inhibitors in cancer treatment. Int J Mol Sci. 2023;24:12133.
- Kessenbrock K, Plaks V, Werb Z. Matrix metalloproteinases: regulators of the tumor microenvironment. Cell. 2010;141:52-67.
- Vandooren J, Van den Steen PE, Opdenakker G. Biochemistry and molecular biology of gelatinase B or matrix metalloproteinase-9 (MMP-9): the next decade. Crit Rev Biochem Mol Biol. 2013;48:222-72.
- Merchant N, et al. Matrix metalloproteinases: their functional role in lung cancer. Carcinogenesis. 2017;38:766-80.
- Chabanon RM, et al. Targeting the DNA damage response in immuno-oncology: developments and opportunities. Nat Rev Cancer. 2021;21:701-17.
- Das S, et al. Surface plasmon resonance as a fascinating approach in target-based drug discovery and development. TrAC Trends Anal Chem. 2024;171:117501.