本方案介绍了一种可重复的深度学习工作流程,利用多通道循环数据和工程特征来预测锂离子电池的健康状态、剩余使用寿命及储能性能。
本文内容
摘要
摘要
本方案介绍了一种可重复的深度学习工作流程,用于利用多通道循环数据预测锂离子电池性能。为解决现有数据驱动模型在多源信息融合与特征表示方面的局限性,该方法采用了五个公开可用的电池数据集。输入包括原始运行信号,如电压、电流、容量、温度、内阻以及库仑效率和能量效率,同时结合了增量容量、微分电压和能量 throughput 等工程特征。本方案详细描述了在多个观测窗口内构建电池级时序张量的标准预处理流程。为提高可重复性,该工作流程采用固定随机种子、重复评估运行及环境追踪,对多种候选神经网络架构进行了评估,包括深度神经网络、卷积神经网络(CNN)、长短期记忆网络(LSTM)、CNN–LSTM 混合模型以及基于 Transformer 的模型。代表性结果表明,在所评估的模型中,集成多通道数据与工程特征的 CNN–LSTM 架构表现出优异的预测性能。该选定配置在健康状态估计中实现了 0.024 的平均绝对误差和 0.955 的 R2 值,同时在剩余使用寿命和可放电能量估计方面保持了较高的预测精度。消融实验与鲁棒性分析进一步验证了多通道特征融合的贡献,以及该注重可重复性的工作流程在多次评估中表现出的稳定性。该标准化方法为在不同运行条件下开展电池全生命周期管理与预测建模提供了可重复的框架。
引言
锂离子电池因其高能量密度、长循环寿命以及在从便携式电子设备到电网级储能系统等广泛应用中较低的自放电率,已成为全球向可再生能源转型的核心。然而,长期运行不可避免地导致容量逐渐衰减和内阻增加1。这种性能衰退不仅降低了经济可行性,还带来了严重的安全隐患,包括热失控。随着大规模储能系统的部署持续加速,电池生命周期管理变得日益复杂2。传统的基于阈值的监测和人工检查方案难以应对动态运行环境3。此外,在充放电速率波动、环境温度变化以及放电电压差异的条件下,依赖单一参数无法准确预测电池的健康状态(SOH)或剩余使用寿命(RUL)4。尽管当前工作流主要通过实验室控制下的循环数据集进行验证,其多通道架构和时序建模框架未来可能适用于电动汽车应用及多变环境条件下所面临的动态运行工况。
电池退化是一种高度复杂且非线性的电化学过程,主要由固态电解质界面(SEI)膜的生长、活性锂的损失以及电极材料的结构劣化所驱动。传统上,状态估计依赖于等效电路模型或电化学-物理偏微分方程(PDE)5。尽管这些物理模型能够提供有价值的作用机制洞察,但在处理多通道耦合信号时,面临显著的计算开销以及参数识别难题。因此,在嵌入式电池管理系统(BMS)中,其在高倍率放电条件下受复杂的扩散动力学和环境变化影响,实时实现受到严重限制6。相比之下,本文提出的深度学习(DL)工作流程将大部分计算负担集中在离线训练阶段,而训练完成的模型在部署期间可实现相对较快的推理。因此,该框架有望支持未来在资源受限的BMS及边缘计算环境中的应用。
近年来,由于数据驱动的深度学习(DL)方法具有卓越的非线性拟合能力,已成为强大的工具。然而,现有的深度学习方法存在两个主要局限性。首先,许多方法主要依赖单一容量衰减曲线或特定的放电电压阈值,而忽略了多通道循环响应(如电压、电流和温度)之间固有的时空相关性。这一局限性导致模型在多条件运行场景下的鲁棒性降低7。先前的研究表明,在复杂操作过程中忽略热状态会加速预测误差的累积8,9。其次,应用机器学习(ML)领域长期存在可重复性难题。实验条件的差异、预处理流程描述不充分以及神经网络超参数的随意选择,常常导致原本稳健的模型在跨数据集验证中失败10。为降低预处理和早期循环预测过程中信息泄露的风险,所提出的流程在外部验证和跨数据集评估之前,仅从训练数据集中提取归一化缩放因子和构建特征基线。
为解决这些关键性空白,本实验方案的总体目标是提供一种自动化、高可重复性的深度学习工作流程,用于基于多通道循环数据预测锂离子电池的能量存储性能。该方法的核心理念在于,通过在高维神经网络架构中整合跨模态时间序列数据,显式捕捉与电池退化相关的复杂长期依赖关系。与现有的基于物理模型和深度学习的方法相比,本方案的一个关键优势在于其整体标准化设计,构建了一个涵盖原始信号预处理、特征工程、模型训练及不确定性评估的完整流程。尽管混合神经网络架构此前已有研究,但本工作流程强调在以可重复性为导向的训练框架内,通过将电化学循环变量与工程化退化特征对齐,实现标准化的多通道数据融合。与以往报道的许多工作流程不同,本方案引入了标准化的参数配置、固定的随机种子、重复的评估运行以及全面的环境追踪,以提升在异构电池数据集和不同实验室条件下的可重复性。此外,该工作流程系统性地比较了多种神经网络架构,以评估在不同输入配置下的预测稳定性与性能表现。在所评估的数据集和实验条件下,卷积神经网络–长短期记忆网络(CNN–LSTM)架构通过结合局部特征提取与长程时间序列建模,在保持适中计算复杂度的同时,相较于单独使用的CNN模型和基于Transformer的模型展现出更优的预测性能。本方案适用于致力于开发可重复且适应环境变化的电池生命周期管理预测模型的研究人员与工程师。
方案
本研究无需机构伦理审批,因为研究仅使用公开的锂离子电池循环数据集,未涉及人类受试者、动物实验或生物样本。
1. 数据采集与整理
- 获取多通道循环数据集
- 从公开可用的电池数据库中下载包含充放电循环记录的锂离子电池循环数据集。直接从各机构的开放获取数据库或数字对象标识符链接获取 CALCE、SANYO、PANASONIC、KOKAM 和 GOTION 数据集,以确保数据集版本的一致性。
- 选择包含完整循环次数、容量测量值以及至少一条连续充放电曲线的电池样本。通过确认单个循环内无超过两小时的中断,并且恒流和恒压阶段均被完整记录,来验证数据的连续性。
- 过滤原始循环记录
- 对原始循环记录进行筛选,保留包含温度、内阻、库仑效率和能量效率测量值的样本。将缺少这些必需状态通道的电池单元从分析流程中排除,因为后续的多通道特征融合需要完整的物理输入变量集合。
- 剔除包含不完整记录、时间戳不一致、测试程序未定义或充放电终止条件不明确的循环。将异常循环定义为相邻循环间容量骤降超过5%、电压测量值超出化学体系特定工作范围,或时间戳间隔非单调的循环。
- 构建时序电池数据库
- 按时间顺序整理保留的循环记录,构建电池级别的时序数据库。
- 使用层次数据格式第5版(HDF5)存储处理后的数据集。按照数据集来源、化学体系和单个电池单元标识符建立标准化的目录结构。
- 在数据集划分前为每个电池单元分配唯一标识符。在训练集-测试集划分过程中,基于电池单元标识符进行分组,确保来自同一物理电池的所有连续循环仅归属于一个数据子集。
注:在预处理、归一化、重采样或特征工程之前,应单独保存原始的未处理数据集。
- 定义观测窗口
- 使用前50次循环、前100次循环以及电池总生命周期的前20%构建多通道观测窗口。通过将寿命终止前的总循环次数乘以0.2,计算20%生命周期的阈值。
- 在张量构建之前,对每个观测窗口内的电压、电流、容量、温度、内阻和效率测量值进行对齐。
- 将最终输入结构格式化为三维张量,其维度分别为观测窗口长度、128个标准化的单循环内采样点,以及有序排列的多通道特征集合。
2. 数据预处理与特征工程
- 预处理原始循环数据
- 对原始循环数据集执行统一的预处理,以标准化所有电池来源的数据质量。使用 Python 3.10 配合 Pandas 库进行时间序列操作,以及 SciPy 进行数值插值,完成所有预处理、同步和标准化流程。
- 在下游分析之前,去除异常值、检测缺失值、校准时间戳、识别充放电阶段,并标准化采样频率。采用改进的 Z 分数阈值法进行异常检测,拒绝标准设定为大于 3.0。
- 通过在所有数值数组中识别 NaN 标志自动检测缺失值。根据电流极性区分充电和放电阶段,将正电流值分配给充电循环,负电流值分配给放电循环。
- 使用分段三次埃尔米特插值多项式重建缺失的信号段,以在相位过渡对齐过程中保留电化学时间动态特性。
- 重采样循环曲线
- 当检测到不同数据集之间的采样密度变化或信号漂移时,对循环曲线进行重采样。当连续测量之间的间隔相对于相应循环阶段的中位采样频率偏差超过 10% 时,触发自动重采样。
- 标准化每个循环内的采样点数量,以减少平台特定的记录差异。使用一维线性插值将所有时间序列映射到固定的时空网格上。
- 在张量构建之前,将每个充放电曲线压缩或扩展为恰好 128 个等距采样点。
- 归一化连续变量
- 在模型训练前对所有连续变量进行归一化,以稳定网络收敛并减少量纲相关偏差。应用最小-最大缩放法,将所有连续变量转换为 0 到 1 之间的数值范围。
- 所有归一化参数仅从训练数据集中计算得出。将固定的缩放参数应用于验证集和测试集,以降低在早期循环预测过程中发生时间前向数据泄露的风险。
- 构建多通道输入张量
- 将每块电池的连续循环记录划分为固定长度的时间段。根据预定义的观察窗口(对应前 50 个循环、前 100 个循环或电池生命周期的前 20%)组织这些时间段。
- 在张量构建之前,对每个时间段内的电压、电流、容量、温度、内阻和效率测量值进行对齐。
- 将对齐后的特征矩阵拼接成一个三维张量,格式为 (N × 128 × C),其中 N 表示观察窗口长度,128 表示标准化的单循环内采样点数,C 表示物理和工程特征通道的总数。
- 提取工程特征
- 从原始循环信号中提取工程电化学特征,以提高对退化模式的识别能力。在标准化采样网格上计算 dQ/dV 和 dV/dQ,获得增量容量和微分电压特征。
- 应用 Savitzky–Golay 滤波器生成平滑的增量容量和微分电压曲线。
- 从滤波后的电化学特征中提取退化指标,包括峰值电压偏移、相变电压差异以及循环间能量累积变化。
3. 深度学习模型构建与训练
- 构建候选预测模型
- 为 图1A 所示的所有预测模型构建标准化的训练与评估框架。使用 PyTorch 2.0 或更高版本实现深度学习工作流程。
- 使用模块化的 Python 脚本执行训练流程,包括数据加载、模型初始化、优化和评估。
- 准备传统机器学习基线模型,包括线性回归、随机森林和梯度提升决策树模型。将随机森林模型配置为包含 100 棵树,最大深度为 10。
- 通过 Scikit-learn 库配置梯度提升决策树框架,学习率为 0.1,最大树深度为 5。
- 准备深度学习候选架构,包括多层感知机、一维卷积神经网络(CNN)、长短期记忆网络(LSTM)、CNN–LSTM 和基于 Transformer 的模型。
- 在所有深度学习架构中统一核心超参数,采用 AdamW 优化器、高斯误差线性单元激活函数、隐藏维度为 128 以及 0.2 的 Dropout 率。
- 配置 CNN–LSTM 架构
- 配置 CNN–LSTM 架构以融合输入张量中的多通道循环信息(图1B)。通过将卷积特征提取器级联至两个堆叠的循环层(每层包含 128 个隐藏单元)来构建混合架构。
- 使用三个并行的全连接回归头结束该架构,以同时预测健康状态(SOH)、剩余使用寿命(RUL)和可放电能量。
- 将多通道输入张量通过三个连续的一维卷积层处理,卷积核大小分别为 3、5 和 7,以提取多尺度局部特征。
- 在每个卷积层后应用批归一化,以提高优化过程中的梯度稳定性。
- 在进行序列建模前,将卷积特征图重塑为连续的时间序列。
- 将编码后的时间序列输入堆叠的循环层,以捕获预定义观测窗口内的长程退化依赖关系。
- 划分数据集用于模型训练
- 将处理后的电池单元数据集按 70:15:15 的比例划分为训练、验证和测试子集。使用固定的随机种子值 42 执行数据集划分。
- 基于电池化学体系进行分层抽样,以在所有数据子集中保持平衡的退化分布。
- 严格在电池单元级别进行数据集划分,而非对单个循环进行随机化,以保留连续的退化轨迹。
- 在划分过程中将每个电池单元视为不可分割的单元,以防止数据集之间的信息泄露。
- 通过计算训练、验证和测试子集中电池单元标识符的交集并确认无重叠,程序化地验证数据集的隔离性。
- 使用完整的 GOTION 磷酸铁锂(LFP)数据集构建外部测试数据集,用于分布外评估和跨数据集泛化能力评估。
- 通过专用的 GitHub 仓库公开源代码、环境配置文件和处理后的数据集划分,以支持方法透明性和可重复性。
- 初始化模型训练
- 训练前将回归损失函数设为均方误差。通过等权重聚合各预测目标的损失值来计算全局训练目标。
- 将初始学习率设为 1 × 10⁻³,并根据数据集大小选择 32 或 64 的批量大小。
- 对于包含超过 5,000 个循环的数据集,使用 64 的批量大小以提高硬件利用率;对于较小的数据集,使用 32 的批量大小以提高优化稳定性。
注:通过初步的网格搜索评估选择这些超参数,以在不同观测窗口下平衡收敛速度和梯度稳定性。
- 应用训练控制
- 基于验证损失变化应用动态学习率调度器。若验证损失在连续 5 个训练周期内未改善,则将学习率降低为原来的 0.5 倍。
- 在优化过程中保持最低学习率阈值为 1 × 10⁻⁵。
- 在最多 100 个训练周期后停止模型训练,以减少过拟合。
- 若验证损失在连续 15 个训练周期内未下降,则触发早停机制,并恢复至表现最佳的验证迭代对应的模型权重。
- 维护可重复性记录
- 在模型初始化和训练前设置固定的随机种子值为 42。
- 在 Python random 模块、NumPy 和 PyTorch 后端中一致地应用该固定随机种子,并禁用非确定性 CUDA 操作。
- 记录每次实验运行的软件环境、依赖版本、参数设置、数据划分和训练输出。
- 在配备 NVIDIA RTX 3090 图形处理器或同等硬件的工作站上,使用 Ubuntu 22.04 系统并借助 CUDA 11.8 加速执行所有深度学习工作流程。
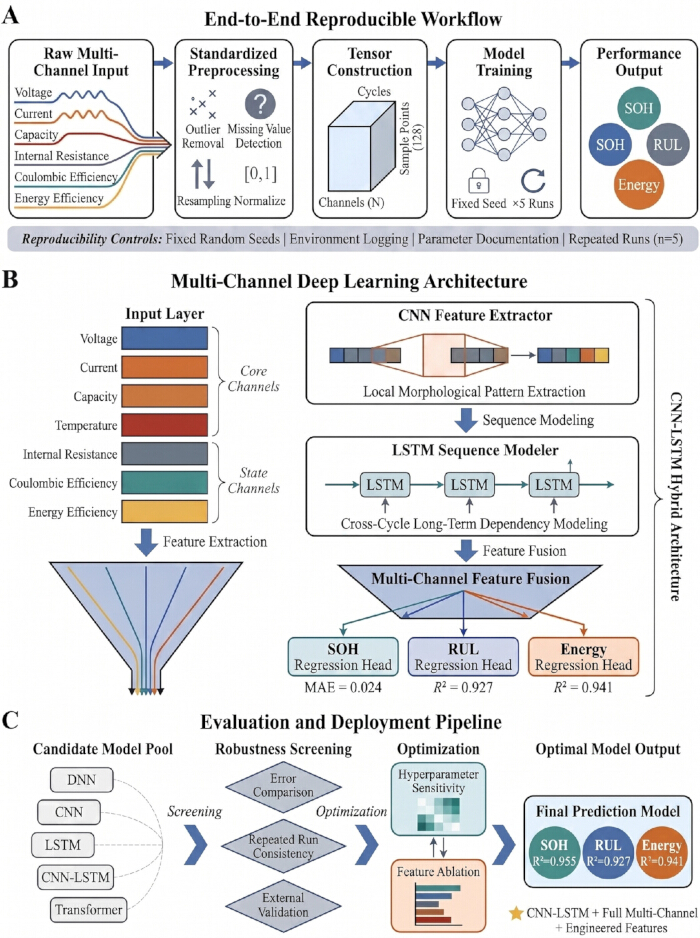
图1.用于多通道锂离子电池性能预测的可重复深度学习(DL)工作流程。(A)端到端可重复工作流程,展示多通道数据采集、标准化预处理、张量构建、模型训练及电池性能指标预测。可重复性控制措施包括固定随机种子、重复训练运行、参数跟踪和环境日志记录。(B)用于多通道特征提取、时间序列建模、特征融合以及健康状态(SOH)、剩余使用寿命(RUL)和可放电能量预测的CNN-LSTM混合架构。(C)评估与部署流程,展示候选模型筛选、鲁棒性评估、超参数优化及最终模型选择。请点击此处查看该图的放大版本。
4. 模型评估与靶点预测
- 生成模型预测
- 将目标测试电池数据集输入各个训练好的模型。在推理前,将预处理后的测试数据集加载为序列化的 PyTorch 张量。
- 使用禁用梯度的上下文管理器执行前向推理过程,以防止在评估期间发生意外的参数更新。
- 利用训练好的回归头并行生成各性能指标的预测结果。
- 从为 SOH、RUL 和可放电能量预测配置的三个并行回归头中提取同步输出。
- 计算预测目标值
- 通过将当前可用容量与电池初始容量进行比较来计算 SOH。
- 将电池初始容量定义为前三个稳定循环期间记录的最大放电容量。
- 将 SOH 计算为当前循环容量与确定的初始容量基准之间的比值。
- 通过识别电池容量不再保持稳定的运行阈值来估算 RUL。
- 将寿命终止定义为电池容量不可逆地降至额定标称容量的 80% 以下时所对应的循环次数。
- 将 RUL 计算为从当前观测点到定义的寿命终止阈值之间剩余的循环次数。
- 根据记录的放电条件预测可放电能量。
- 使用梯形积分法对放电区间内的放电电压与放电电流乘积进行数值积分,以计算真实放电能量。
- 评估预测性能
- 针对每个预测目标,计算平均绝对误差(MAE)、均方根误差(RMSE)、平均绝对百分比误差(MAPE)和决定系数(R2)。
- 使用 Scikit-learn 的评估模块,依据标准化的统计公式计算所有评估指标。
- 在所有模型、数据集和输入配置上应用相同的指标计算方法,以保持评估的一致性。
- 在独立测试数据集中汇总所有电池样本的性能指标,以评估模型的整体泛化能力。
- 报告分层性能
- 计算各评估指标在多次重复实验运行中的均值和标准差。
- 报告的统计量基于五次独立的模型初始化结果得出。
- 报告均值性能指标的同时提供 95% 置信区间,以量化预测的不确定性。
- 比较不同观测窗口长度和输入通道配置下的模型性能。
- 使用对应于 50 次、100 次和 200 次循环的观测窗口对比较分析进行分层。
- 在从仅容量输入到完整多通道张量融合的多种输入配置下评估预测性能。评估、鲁棒性筛选和部署选择的工作流程参见 Figure 1C。
5. 可重复性、稳健性与敏感性分析
- 验证可重复性与鲁棒性
- 在 图2A 所示的所有可重复性评估中,保持相同的数据划分、预处理流程和实验步骤。
- 计算主要评估指标在多次重复试验中的变异系数,以评估可重复性的一致性。
- 使用相同的标准化训练与测试流程重复所有评估程序。
- 每次重复评估均采用随机初始化的网络权重,同时保持相同的数据加载与打乱顺序的确定性流程。
- 执行重复训练实验
- 在相同的实验条件下,使用预定义的固定随机种子值重复训练预测模型,以确保权重初始化的可重复性。
- 使用相同的数据集划分进行五次独立的训练运行,以减少由数据驱动的变异性。
- 通过取五次重复训练运行所得评估指标的平均值,计算最终的性能指标。
- 使用平均后的评估得分汇总最终的鲁棒性指标,而非直接合并原始预测张量。
- 评估超参数敏感性
- 在敏感性分析过程中,分别调整学习率、批量大小、隐藏层维度和dropout比例。
- 评估的学习率范围为 1 × 10⁻⁴ 至 1 × 10⁻²,批量大小范围为 32 至 128,隐藏层维度范围为 32 至 256,dropout比例范围为 0.1 至 0.5。
- 记录每次超参数调整后预测准确率的相应变化。
- 使用均方根误差(RMSE)和决定系数(R2)量化预测性能的变化。
- 执行特征消融分析
- 从多通道输入流中移除选定的输入通道,包括温度、内阻和工程特征向量。
- 采用留一法策略进行特征消融,每次移除一个特征组,同时保留其余多通道输入结构。
- 比较每次特征移除实验后的预测性能,以评估各特征组对模型稳定性与准确性的贡献。
- 通过计算相对于完整多通道基线模型的平均绝对误差百分比增幅,量化每个特征组的相对贡献。参见 图2B 中的鲁棒性评估与敏感性分析流程。
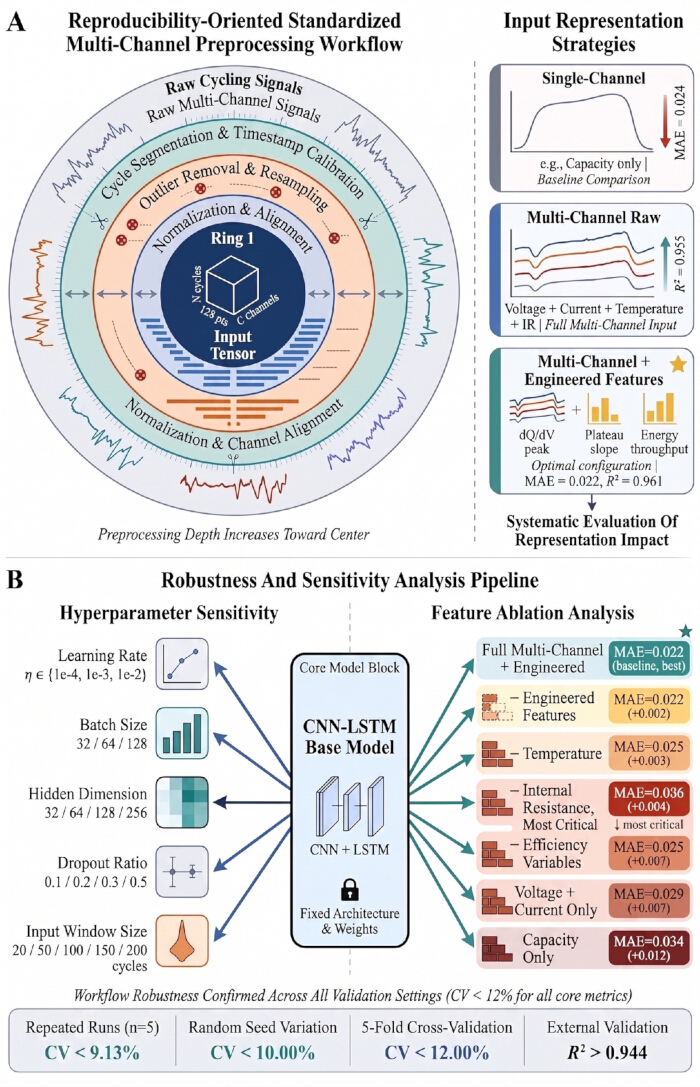
图2。标准化预处理、鲁棒性评估与敏感性分析工作流程。(A)标准化多通道预处理工作流程,展示原始循环信号处理、时间戳校准、异常值去除、重采样、归一化、通道对齐和张量构建过程。输入表示策略比较了单通道输入、多通道原始输入以及结合工程特征的多通道输入。(B)鲁棒性与敏感性分析流程,展示系统性的超参数扰动、重复运行评估、特征消融分析、交叉验证以及对CNN-LSTM工作流程的外部验证。请点击此处查看该图的放大版本。
结果
多通道循环信号与数据分配
通过分析具有代表性的多通道循环信号和性能分布,对锂离子电池的循环响应行为进行了表征。本研究采用了五个代表多种化学体系的锂离子电池数据集,包括钴酸锂(LCO)、镍钴铝氧化物(NCA)、镍锰钴氧化物(NMC)和磷酸铁锂(LFP)(表1)。将电压、电流、容量、温度、内阻以及库仑效率或能量效率等核心循环变量,与增量容量和微分电压特性等工程特征相结合,构建了多通道表征框架。CALCE数据集的容量-电压曲线及健康状态(SOH)分布(图3A)、SANYO数据集的平均电压曲线及SOH分布(图3B)、PANASONIC数据集的老化轨迹(图3C)、KOKAM数据集的电压演化热图(图3D)以及GOTION数据集的电压分布曲线(图3E)表明,不同电池化学体系表现出显著差异的退化行为。例如,GOTION IFP20100140A数据集呈现出典型的阶梯状电压特征,这通常与LFP体系相关;而PANASONIC NCR18650BD数据集则在长期循环过程中表现出持续的容量衰减,并伴随电压曲线的偏移。
| 数据集编号 | 电池类型 / 型号 | 化学体系 | 封装形式 | 电池数量 | 分析的总循环次数 | 使用的早期循环窗口 | 每循环采样点数 | 核心循环参数通道 | 附加状态参数通道 | 衍生特征 | 预测目标 |
| 数据集 #1 | CALCE LCO battery | LCO | 软包 | 38 | 4,216 | 前50次、前100次、前20%寿命 | 128 | 电压、电流、时间、容量 | 温度、内阻 | dQ/dV、dV/dQ、充电时长、放电能量 | SOH、RUL、可放电能量 |
| 数据集 #2 | SANYO UR18650E | NCA | 圆柱形 18650 | 24 | 2,487 | 前50次、前100次、前20%寿命 | 128 | 电压、电流、时间、容量 | 温度、库仑效率 | dQ/dV、电压平台斜率、能量效率 | SOH、RUL、可放电能量 |
| 数据集 #3 | PANASONIC NCR18650BD | NCA | 圆柱形 18650 | 42 | 5,134 | 前50次、前100次、前20%寿命 | 128 | 电压、电流、时间、容量 | 温度、内阻、库仑效率 | dQ/dV、dV/dQ、充电时长、能量累积量 | SOH、RUL、可放电能量 |
| 数据集 #4 | KOKAM SLPB533459H4 | NMC | 软包 | 19 | 1,968 | 前50次、前100次、前20%寿命 | 128 | 电压、电流、时间、容量 | 温度、内阻 | dQ/dV、放电时长、电压斜率 | SOH、RUL、可放电能量 |
| 数据集 #5 | GOTION IFP20100140A | LFP | 方形 | 57 | 6,482 | 前50次、前100次、前20%寿命 | 128 | 电压、电流、时间、容量 | 温度、内阻、能量效率 | dQ/dV、平台持续时间、充/放电能量 | SOH、RUL、可放电能量 |
表1:可重复深度学习工作流程中使用的锂离子电池数据集、多通道循环变量、工程特征和预测目标的特性。 该表格总结了本研究中包含的锂离子电池数据集,包括电池化学体系、电池封装形式、电池数量、总分析循环次数、观测窗口、采样密度、多通道循环变量、工程化的电化学特征,以及用于模型开发与评估的预测目标。缩写:SOH = 健康状态;RUL = 剩余使用寿命;LCO = 钴酸锂;NCA = 镍钴铝氧化物;NMC = 镍锰钴氧化物;LFP = 磷酸铁锂。
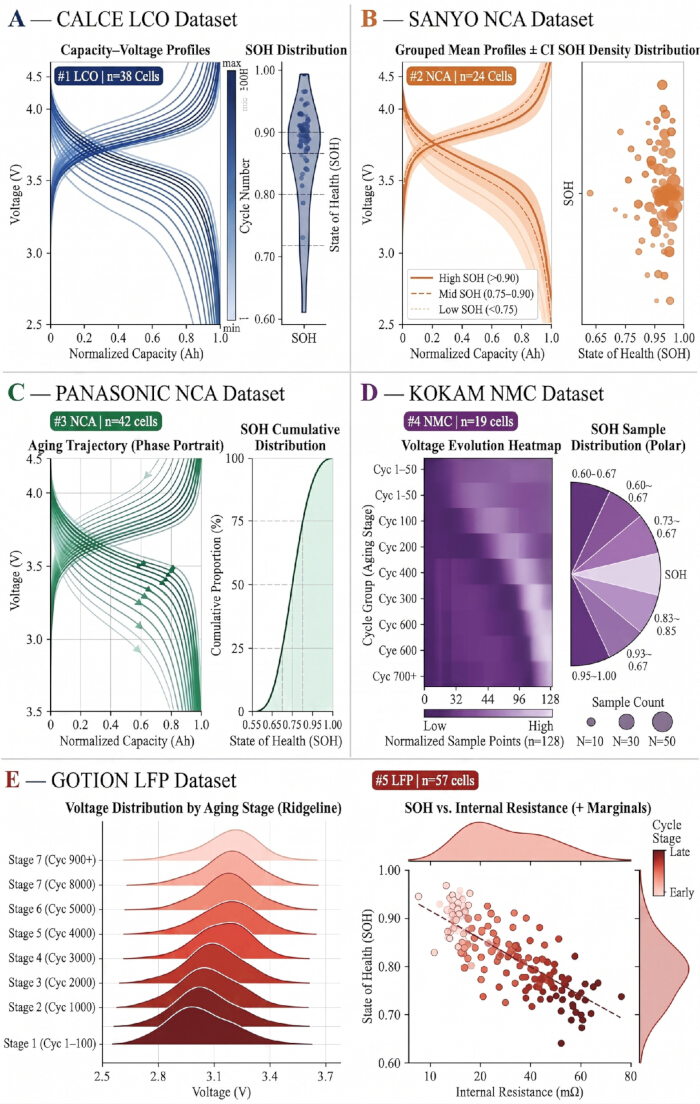
图3。锂离子电池数据集中具有代表性的多通道循环曲线及电池健康状态分布。(A)CALCE锂钴氧化物数据集的容量-电压曲线及健康状态(SOH)分布。(B)SANYO镍钴铝氧化物数据集的平均电压曲线及健康状态(SOH)分布。(C)PANASONIC镍钴铝氧化物数据集的老化轨迹及累积健康状态(SOH)分布。(D)KOKAM镍锰钴氧化物数据集的电压演变热图及健康状态(SOH)样本分布。(E)GOTION磷酸铁锂数据集的电压分布曲线及健康状态(SOH)与内阻关系。 请点击此处查看该图的放大版本。
储能整体预测性能
所提出的多通道工作流程在所有评估任务中均表现出较低的预测误差和一致的预测性能(表2)。在电池健康状态(SOH)估计方面,模型在验证数据集上的平均绝对误差(MAE)为0.021,在测试数据集上为0.024,对应的R2值分别为0.962和0.955。这些结果表明,在所评估条件下,该模型在连续电池健康状态估计中具有稳定的预测性能。该工作流程在剩余使用寿命(RUL)和可放电能量估计方面也表现出可靠的预测能力,其测试数据集上的R2值分别达到0.927和0.941。为进一步评估预测稳定性,所有性能指标均基于五个独立的模型初始化过程进行计算,且每次使用的数据集划分完全相同。重复评估结果显示,各项指标的标准差和变异系数均保持在较低水平,表明模型对随机初始化的敏感性较低,在重复训练条件下表现出稳定的预测行为。此外,95%置信区间在多次运行中表现出较小的波动,进一步验证了所提出多通道工作流程的稳健性与可重复性。
| 预测任务 | 数据集划分 | MAE | RMSE | MAPE (%) | R² |
| SOH 估计 | 验证集 | 0.021 | 0.029 | 2.47 | 0.962 |
| SOH 估计 | 测试集 | 0.024 | 0.033 | 2.83 | 0.955 |
| RUL 预测 | 验证集 | 18.6 | 25.9 | 8.74 | 0.938 |
| RUL 预测 | 测试集 | 21.4 | 29.7 | 9.63 | 0.927 |
| 可放电能量预测 | 验证集 | 0.087 | 0.121 | 3.18 | 0.948 |
| 可放电能量预测 | 测试集 | 0.094 | 0.129 | 3.56 | 0.941 |
表2:可重复的深度学习工作流程在锂离子电池性能估计中对验证集和测试集的预测性能。 该表格总结了所提出的工作流程在健康状态(SOH)估计、剩余使用寿命(RUL)预测和可放电能量预测方面,使用验证集和测试集所获得的预测性能。性能评估指标包括平均绝对误差(MAE)、均方根误差(RMSE)、平均绝对百分比误差(MAPE)和决定系数(R2)。缩写:SOH = 健康状态;RUL = 剩余使用寿命;MAE = 平均绝对误差;RMSE = 均方根误差;MAPE = 平均绝对百分比误差。
不同深度学习架构的性能比较
在不同网络架构和输入配置下的评估表明,预测性能存在显著差异(表3)。基于可重复性进行架构选择前后,RMSE 的分布情况如图4A所示。深度神经网络架构的 MAE 和 RMSE 值相对高于基于序列和混合架构。不同多通道输入配置之间的比较总结于图4B。在所评估条件下,结合局部特征提取与跨周期时序建模的模型表现出更优的预测准确性。预测变异性较低的模型通常聚集在较高平均性能得分区域,且标准差较小(图4C)。各种输入配置下平均性能与标准差的关系如图4D所示。在所有测试配置中,CNN–LSTM 架构在所评估的数据集和实验条件下取得了最低的 MAE(0.024)和最高的 R2 值(0.955)。此外,将工程化特征与完整的多通道输入相结合,可进一步将 MAE 降低至 0.022,R2 值提升至 0.961,而仅使用容量输入的模型则表现出较差的预测性能。
| 类别 | 模型 / 输入配置 | MAE | RMSE | MAPE (%) | R² |
| 深度学习架构 | DNN | 0.031 | 0.042 | 3.58 | 0.928 |
| CNN | 0.027 | 0.037 | 3.14 | 0.941 | |
| LSTM | 0.026 | 0.036 | 3.05 | 0.944 | |
| CNN–LSTM | 0.024 | 0.033 | 2.81 | 0.955 | |
| Transformer | 0.025 | 0.034 | 2.89 | 0.951 | |
| 输入配置 | 仅容量 | 0.034 | 0.046 | 3.92 | 0.916 |
| 电压 + 电流 | 0.029 | 0.039 | 3.29 | 0.936 | |
| 全多通道输入 | 0.024 | 0.033 | 2.83 | 0.955 | |
| 多通道 + 工程特征 | 0.022 | 0.031 | 2.61 | 0.961 |
表3:不同深度学习架构与输入配置的预测性能比较。 该表格比较了可重复的多通道工作流程中所采用的不同深度学习架构与输入配置的预测性能。性能评估指标包括平均绝对误差(MAE)、均方根误差(RMSE)、平均绝对百分比误差(MAPE)和决定系数(R2)。缩写:DNN = 深度神经网络;CNN = 卷积神经网络;LSTM = 长短期记忆网络;MAE = 平均绝对误差;RMSE = 均方根误差;MAPE = 平均绝对百分比误差。
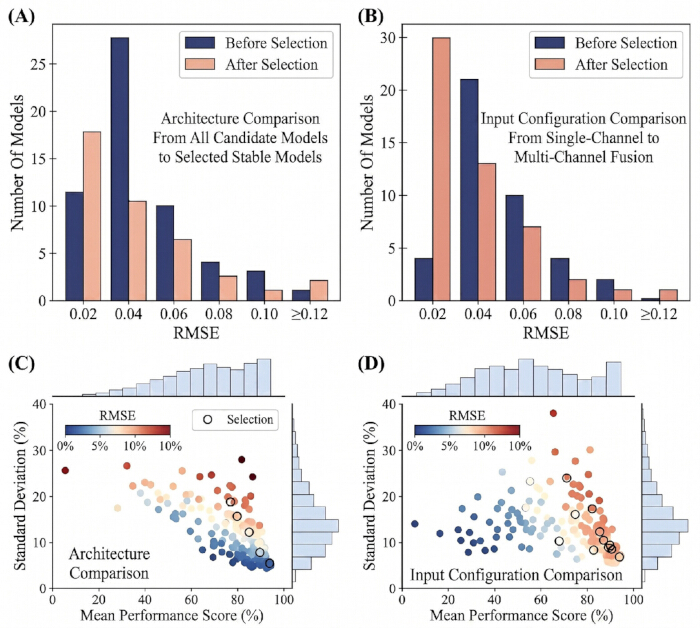
图 4.基于可重复性的模型架构与输入配置比较。(A)基于可重复性进行架构选择前后,均方根误差的分布情况。(B)在稳定模型选择前后,不同输入配置下的均方根误差分布。(C)候选模型架构的平均性能与标准差比较,颜色表示均方根误差,空心圆圈表示所选的稳定模型。(D)输入配置的平均性能与标准差比较,颜色表示均方根误差,空心圆圈表示所选的最优配置。请点击此处查看该图的放大版本。
误差分布与一致性评估
通过分析绝对误差分布,评估了传统机器学习基线模型与深度学习架构在预测稳定性方面的表现。传统机器学习基线模型表现出更宽的误差分布和更长的高误差尾部,表明其在复杂退化模式预测任务中稳定性较差。在所评估的深度学习模型中,CNN–LSTM 架构展现出相对较窄的误差分布和较短的高误差尾部,说明其在局部特征提取与时间序列建模的融合方面有所改进(图5)。在所评估的数据集中,引入温度、内阻以及与效率相关的变量,与预测误差离散度的逐步降低相关。
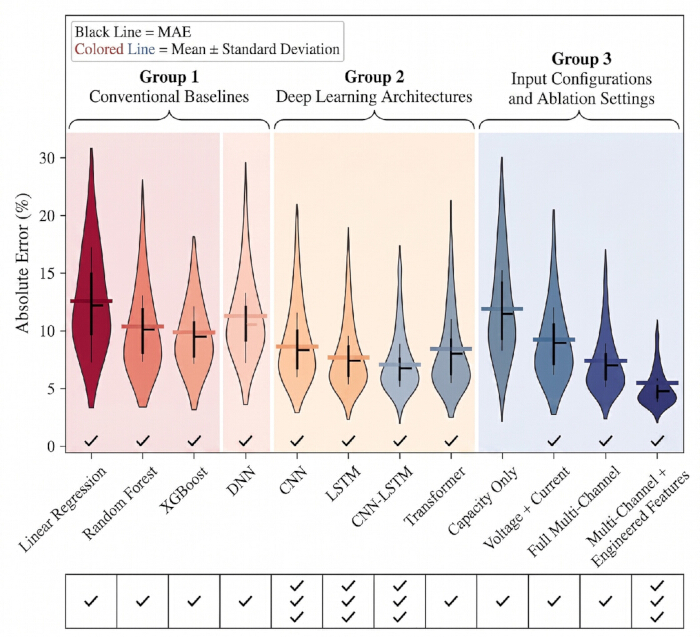
图 5.传统机器学习(ML)基线方法与多通道深度学习(DL)模型的绝对误差分布。小提琴图比较了传统机器学习基线、深度学习架构以及多通道输入配置下绝对预测误差的分布情况。黑色线条表示平均绝对误差,彩色线条表示均值±标准差。请点击此处查看该图的放大版本。
不同验证场景下的可重复性与稳健性
该工作流程在多次训练运行和多种验证策略下均保持了稳定的预测性能(表4)。使用固定数据划分和固定随机种子初始化进行的重复实验产生了稳定的性能指标,R2值始终高于0.95,且平均绝对误差(MAE)的标准差较低。通过五折交叉验证和外部验证数据集的额外评估表明,在不同重复实验条件下性能波动有限。外部验证阶段仅使用GOTION数据集,该数据集完全未参与模型训练和超参数优化过程。由于该数据集代表了一种不同的磷酸铁锂(LFP)化学体系和棱柱形电池构型,因此该外部评估在异质电化学和结构条件下对跨数据集泛化能力进行了严格检验。此外,变异系数分析和重复运行评估表明,在独立实验中预测结果的离散程度较低,进一步支持了所提出的多通道工作流程的稳健性和可重复性。
| 验证设置 | 性能指标 | 均值 | 标准差 | 最小值 | 最大值 | 变异系数 (%) |
| 固定数据划分的重复运行(n = 5) | MAE | 0.023 | 0.0021 | 0.021 | 0.026 | 9.13 |
| RMSE | 0.032 | 0.0028 | 0.029 | 0.036 | 8.75 | |
| MAPE (%) | 2.76 | 0.24 | 2.48 | 3.11 | 8.7 | |
| R² | 0.957 | 0.006 | 0.949 | 0.964 | 0.63 | |
| 不同随机种子的重复运行(n = 5) | MAE | 0.024 | 0.0024 | 0.021 | 0.027 | 10 |
| RMSE | 0.033 | 0.0031 | 0.029 | 0.037 | 9.39 | |
| MAPE (%) | 2.84 | 0.27 | 2.52 | 3.19 | 9.51 | |
| R² | 0.954 | 0.007 | 0.946 | 0.962 | 0.73 | |
| 五折交叉验证 | MAE | 0.025 | 0.003 | 0.022 | 0.029 | 12 |
| RMSE | 0.034 | 0.0034 | 0.03 | 0.039 | 10 | |
| MAPE (%) | 2.95 | 0.31 | 2.57 | 3.41 | 10.51 | |
| R² | 0.951 | 0.009 | 0.94 | 0.961 | 0.95 | |
| 外部验证 | MAE | 0.027 | 0.0032 | 0.023 | 0.031 | 11.85 |
| RMSE | 0.037 | 0.0038 | 0.032 | 0.042 | 10.27 | |
| MAPE (%) | 3.18 | 0.35 | 2.76 | 3.67 | 11.01 | |
| R² | 0.944 | 0.011 | 0.931 | 0.956 | 1.17 |
表4:所提出的多通道深度学习工作流程在多次训练运行和不同验证策略下的可重复性与稳健性分析。 该表格总结了所提出的工作流程在固定数据划分的重复运行、不同随机种子的重复运行、五折交叉验证以及外部验证条件下的可重复性和稳健性表现。性能指标包括平均绝对误差(MAE)、均方根误差(RMSE)、平均绝对百分比误差(MAPE)、决定系数(R2)、标准差(SD)和变异系数。缩写:MAE = 平均绝对误差;RMSE = 均方根误差;MAPE = 平均绝对百分比误差;SD = 标准差。
超参数敏感性与特征消融
超参数敏感性分析表明,预测性能随观测窗口大小、激活函数、隐层维度大小和序列模型深度的变化而变化。图6A展示了观测窗口大小对预测误差分布的影响。在所评估的条件下,观测窗口在100至200个循环之间时,预测误差较低;而更长的观测窗口在预测准确率上的提升逐渐减弱。图6B总结了激活函数对预测变异性的依赖关系。在评估条件下,修正线性单元(ReLU)和高斯误差线性单元(GELU)激活函数相比其他激活函数表现出更低的预测误差。图6C展示了预测性能对隐层维度大小和序列模型深度的敏感性。隐层维度为128、序列建模层数为两到三层时,预测性能更优;而较浅的网络结构和较小的隐层维度则与更高的预测误差相关。特征消融分析进一步表明,移除人工设计特征或与效率相关的变量后,平均绝对误差(MAE)相较于完整的多通道配置有所增加(表5),提示多通道输入与人工设计的电化学特征共同促进了预测性能的提升。
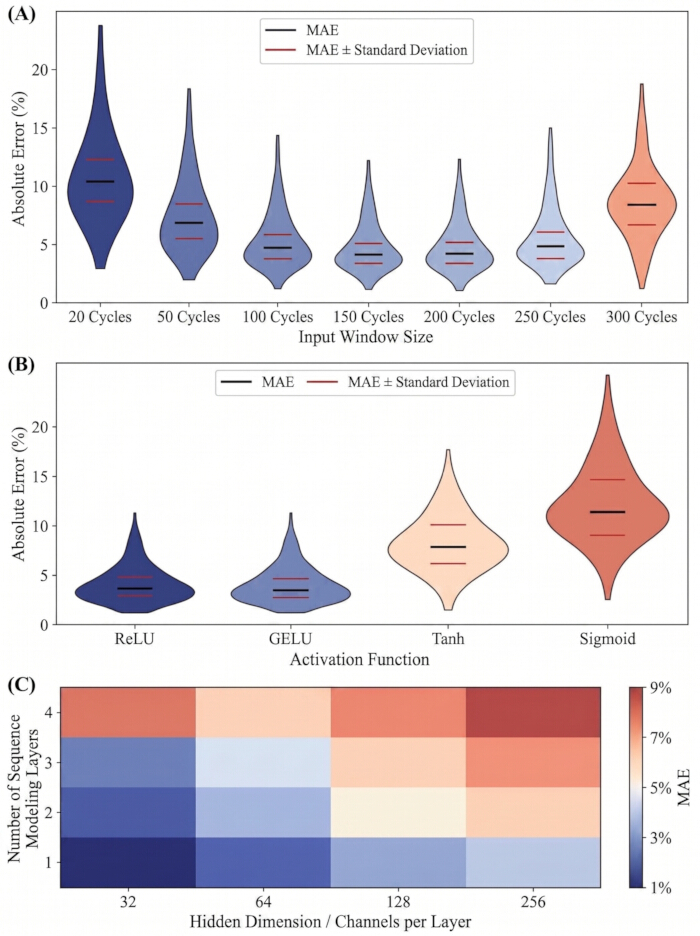
图6.预测性能对超参数变化的敏感性。(A)输入窗口大小对预测误差分布的影响。(B)激活函数选择对预测误差分布的影响。(C)热图显示预测结果对隐藏层维度大小和序列模型层数的敏感性。黑色线条表示平均绝对误差,彩色线条表示均值±标准差(适用时)。请点击此处查看该图的放大版本。
| 类别 | 设置 | 平均绝对误差 (MAE) | 均方根误差 (RMSE) | 平均绝对百分比误差 (MAPE, %) | 决定系数 (R²) |
| 输入窗口大小 | 20 个循环 | 0.031 | 0.043 | 3.74 | 0.927 |
| 50 个循环 | 0.026 | 0.036 | 3.08 | 0.944 | |
| 100 个循环 | 0.023 | 0.032 | 2.71 | 0.957 | |
| 150 个循环 | 0.022 | 0.031 | 2.63 | 0.96 | |
| 200 个循环 | 0.022 | 0.031 | 2.59 | 0.961 | |
| 250 个循环 | 0.023 | 0.032 | 2.67 | 0.958 | |
| 300 个循环 | 0.024 | 0.033 | 2.79 | 0.955 | |
| 激活函数 | ReLU | 0.023 | 0.032 | 2.74 | 0.957 |
| GELU | 0.022 | 0.031 | 2.61 | 0.961 | |
| Tanh | 0.026 | 0.036 | 3.05 | 0.946 | |
| Sigmoid | 0.034 | 0.047 | 3.96 | 0.918 | |
| 每层隐藏维度 / 通道数 | 32 | 0.028 | 0.039 | 3.22 | 0.939 |
| 64 | 0.024 | 0.033 | 2.81 | 0.954 | |
| 128 | 0.022 | 0.031 | 2.58 | 0.961 | |
| 256 | 0.023 | 0.032 | 2.69 | 0.958 | |
| 序列建模层数 | 1 | 0.027 | 0.038 | 3.14 | 0.942 |
| 2 | 0.023 | 0.032 | 2.73 | 0.956 | |
| 3 | 0.022 | 0.031 | 2.6 | 0.961 | |
| 4 | 0.024 | 0.034 | 2.86 | 0.952 | |
| 特征消融 | 完整多通道 + 工程化特征 | 0.022 | 0.031 | 2.61 | 0.961 |
| 无工程化特征 | 0.024 | 0.033 | 2.84 | 0.955 | |
| 无温度 | 0.025 | 0.034 | 2.93 | 0.951 | |
| 无内阻 | 0.026 | 0.035 | 3.01 | 0.949 | |
| 无效率相关变量 | 0.025 | 0.034 | 2.95 | 0.95 | |
| 仅电压 + 电流 | 0.029 | 0.039 | 3.29 | 0.936 | |
| 仅容量 | 0.034 | 0.046 | 3.92 | 0.916 |
表5:不同超参数设置和特征消融配置下模型性能的敏感性分析。 该表格总结了输入窗口大小、激活函数、隐藏层维度大小、序列模型深度以及特征消融策略在所提出的多通道深度学习工作流程中对预测性能的影响。性能评估指标包括平均绝对误差(MAE)、均方根误差(RMSE)、平均绝对百分比误差(MAPE)和决定系数(R2)。缩写:MAE = 平均绝对误差;RMSE = 均方根误差;MAPE = 平均绝对百分比误差;ReLU = 修正线性单元;GELU = 高斯误差线性单元。
讨论
本方案中描述的可重复的深度学习工作流程利用多通道循环数据,实现了对锂离子电池性能的准确预测。在所评估的实验条件下,该工作流程在健康状态(SOH)估计中的测试平均绝对误差(MAE)达到0.024,R2值为0.955,表明其在电池生命周期管理和储能监控应用中具有潜在实用价值11,12,13。
该方案的一个主要优势在于,相较于传统的电化学-物理偏微分方程(PDE)模型,其计算复杂度显著降低5。尽管基于物理机制的方法能够为电池退化提供机理层面的深入理解,但在高倍率放电条件和多通道运行环境下,常面临参数识别的挑战。相比之下,本研究提出的数据驱动工作流程直接从循环数据中建模非线性退化行为,无需对电池化学体系进行显式的基于物理的参数化14。在所评估的数据集和实验条件下,CNN–LSTM 架构相较于单独使用的 CNN、LSTM 以及基于 Transformer 的模型表现出更优的预测性能。近期研究已证明,Transformer 架构在具备不确定性估计能力的退化预测中具有有效性15,同时 CNN 在利用异构充电数据实现隐私保护型电池故障预测方面也展现出潜力16。然而,在本工作流程中优先选用 CNN–LSTM 架构,因其在所评估的实验室条件下,能够在预测精度、计算效率和训练稳定性之间实现良好平衡。卷积层从循环曲线中提取局部形态特征,而 LSTM 层则对重复循环模式中的长时程时间依赖关系进行建模17,18。尽管该混合架构相较于单一网络结构增加了模型复杂度,但在所评估的实验条件下,其计算需求仍与实际电池管理系统部署场景相兼容。由于大部分计算开销发生在离线模型训练阶段,推理阶段的计算负担相对较轻,因而支持在无需持续依赖云端计算的情况下,实现车载实时预测和边缘级电池状态监测。
本方案的性能在很大程度上取决于若干关键的预处理和输入配置步骤。首先,严格的序列比对和重采样程序(步骤 2.2)对于保持多通道循环信号之间的时间关系至关重要。在初步评估中发现,多通道序列的错位会导致预测稳定性下降以及模型误差增加。其次,将构建的电化学特征(如差分电压特性)与原始循环信号相结合,有助于提升预测性能。特征消融分析表明,当保留构建特征的同时结合温度和内阻变量时,平均绝对误差值更低19。此外,将构建的电化学描述符与多通道时间特征相结合,增强了模型在不同运行条件下捕捉复杂退化模式的能力20,21,22。本研究实施的一项关键方法学保障措施是对归一化缩放因子和特征工程基线进行严格隔离。所有统计归一化参数和构建特征的计算均仅基于训练数据集得出,然后才应用于验证和测试数据集。该流程降低了在早期循环预测和跨数据集评估过程中发生信息泄露的风险,从而提高了预测工作流程的可靠性和可重复性。
在执行或修改本方案时,CNN-LSTM 优化过程中可能出现训练不稳定或与梯度相关的问题。损失函数无法收敛或产生 NaN 值,可能表明循环序列建模层中存在梯度爆炸。在此类情况下,采用梯度裁剪、将初始学习率从 1 × 10⁻³ 降低至 1 × 10⁻⁴,或适度增加批次大小,可通过平滑梯度更新来提高训练稳定性。此外,在深层时间序列建模过程中,相较于 Sigmoid 或双曲正切激活函数,ReLU 和 GELU 激活函数有助于改善梯度传播。因此,本研究中提供的超参数敏感性分析可帮助研究人员在不同训练条件下优化工作流程的稳定性与预测性能23。
尽管在评估条件下取得了良好的预测性能,但本方案仍存在若干局限性。当前的工作流程主要基于实验室控制下的恒流/恒压循环数据集进行验证。在实际的电动汽车应用中,电池会经历随机的充放电行为、多变的用户操作模式以及波动的环境条件,这些因素可能改变电池的退化特性。在如此动态的运行条件下,数据驱动的电池模型可能会遇到分布外场景,即此前未观测到的退化轨迹或环境条件可能导致预测可靠性下降。为了提高在实际部署环境中的鲁棒性,未来对该工作流程的改进可引入不确定性量化策略,例如证据深度学习(evidential DL)或分位数回归框架,以在电池状态预测的同时提供经过校准的置信区间。此外,领域自适应和迁移学习方法有助于弥合实验室生成的退化轨迹与真实世界循环行为之间的分布差异24。联邦学习或动态加权迁移学习策略可进一步支持利用大规模实验室数据集进行模型预训练,并结合有限的真实运行数据进行微调,同时保护用户数据隐私25。尽管当前框架在受控的实验室条件下表现出稳定的预测性能,但电动汽车中的实际电池管理系统(BMS)必须在高度动态的负载工况和波动的环境温度下运行。因此,未来对该工作流程的改进可受益于引入真实驾驶循环数据以及在线模型更新策略,以提升在实际应用中的预测可靠性。
通过标准化数据划分、预处理、特征提取以及随机种子初始化流程,本方案提高了应用于电池机器学习工作流中的可重复性26。本文提出的多通道特征融合策略及以可重复性为核心的训练框架,可为可再生能源储能、电动汽车监测以及电池长期生命周期评估的预测性电池管理系统(BMS)的未来发展提供支持。
披露
作者声明不存在竞争性财务利益或利益冲突。
致谢
作者感谢南方科技大学物理系和剑桥大学霍默顿学院提供的机构支持,这些支持为本研究提供了必要的学术环境和计算资源。作者还感谢那些公开提供开放获取锂离子电池数据集(包括CALCE、SANYO、PANASONIC、KOKAM和GOTION)的研究机构和贡献者,使得本次全面的多通道分析得以实现。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| CALCE 电池数据集 | 马里兰大学先进生命周期工程中心(CALCE) | https://calce.umd.edu/battery-data | 用于模型训练与验证的多通道锂离子电池循环数据来源 |
| CUDA Toolkit | NVIDIA | 版本 11.8 | 深度学习模型训练的 GPU 加速 |
| GOTION IFP20100140A 数据集 | Mendeley Data | https://doi.org/10.17632/vpw4t7ytbx.2 | 外部验证及多通道电池退化分析 |
| KOKAM SLPB533459H4 数据集 | Mendeley Data | https://doi.org/10.17632/7w4y4fzzbb.1 | 多通道电池退化建模与验证 |
| Matplotlib | Matplotlib 开发团队 | 版本 3.7.1 | 模型性能、敏感性分析及可重复性结果的可视化 |
| NumPy | NumPy 开发者 | 版本 1.24.3 | 数值计算与张量构建 |
| PANASONIC NCR18650BD 数据集 | Mendeley Data | https://doi.org/10.17632/wykht8y7tg.1 | 多通道循环数据来源及工程特征提取 |
| Pandas | Pandas 开发者 | 版本 2.0.3 | 数据组织、预处理及表格数据管理 |
| PyTorch | PyTorch 基金会 | 版本 2.0.1 | 深度学习架构的构建与训练,包括 CNN–LSTM 模型 |
| Python | Python 软件基金会 | 版本 3.10.12 | 数据预处理、特征工程、模型训练与评估 |
| SANYO UR18650E 数据集 | NASA 预测数据仓库 | https://ti.arc.nasa.gov/tech/dash/groups/pcoe/prognostic-data-repository/ | 用于可重复性评估与模型验证的多通道循环数据来源 |
| Scikit-learn | Scikit-learn 开发者 | 版本 1.2.2 | 基线模型实现、数据集划分及性能指标计算 |
参考文献
- Lu J, Xiong R, Tian J. Deep learning to estimate lithium-ion battery state of health without additional degradation experiments. Nat Commun. 2023;14:2760.
- Zhang H, Li Y, Zheng S. Battery lifetime prediction across diverse ageing conditions with inter-cell deep learning. Nat Mach Intell. 2025;7:270–7.
- Zhang Y, et al. State-of-health estimation for lithium-ion batteries via incremental energy analysis and hybrid deep learning model. Batteries. 2025;11(6):217.
- Liu C, et al. Deep learning for state of health estimation of lithium-ion batteries in electric vehicles: A systematic review. Energies. 2025;18(6):1463.
- Chen C, Wei J, Li Z. Remaining useful life prediction for lithium-ion batteries based on a hybrid deep learning model. Processes. 2023;11(8):2333.
- Chen B, et al. Lithium-ion battery state of health estimation based on feature reconstruction and Transformer-GRU parallel architecture. Energies. 2025;18(5):1236.
- Zhao W, Ding W, Zhang S, Zhang Z. Enhancing lithium-ion battery lifespan early prediction using a multi-branch vision transformer model. Energy. 2024;302:131816.
- Hu J, et al. Early prediction of lithium-ion battery degradation with a generative pre-trained transformer. Nat Commun. 2026;17:126.
- Li Y, et al. Accurate and adaptive state of health estimation for lithium-ion battery based on patch learning framework. Measurement. 2025;250:117083.
- Geng M, et al. Interpretable deep learning with uncertainty quantification for lithium-ion battery SOH estimation. Energy. 2025;335:138027.
- Li Y, et al. State-of-health prediction of lithium-ion batteries using feature fusion and a hybrid neural network model. Energy. 2025;319:135163.
- Zhou J, et al. Deep learning estimation of state of health for lithium-ion batteries using multi-level fusion features of discharge curves. J Power Sources. 2025;653:237781.
- Wang Y, et al. A comprehensive review of machine learning-based state of health estimation for lithium-ion batteries: Data, features, algorithms, and future challenges. Renew Sustain Energy Rev. 2025;224:116125.
- Severson KA, et al. Data-driven prediction of battery cycle life before capacity degradation. Nat Energy. 2019;4(5):383–91.
- Wu R, et al. Confidence-aware quantile Transformer for reliable degradation prediction of battery energy storage systems. Reliab Eng Syst Saf. 2025;260:111019.
- Yang H, et al. Privacy-preserving collaborative battery fault warning for massive electric vehicles by heterogeneous data from charging stations. Nat Commun. 2026;17:974.
- Liu Y, et al. A hybrid deep learning approach for remaining useful life prediction of lithium-ion batteries based on discharging fragments. Appl Energy. 2024;358:122555.
- Bockrath S, Lorentz V, Pruckner M. State of health estimation of lithium-ion batteries with a temporal convolutional neural network using partial load profiles. Appl Energy. 2023;329:120307.
- Zhang Z, et al. Multi-cycle charging information guided state of health estimation for lithium-ion batteries based on pre-trained large language model. Energy. 2024;313:133993.
- Li Z, Zhang X, Gao W. State of health estimation of lithium-ion battery during fast charging process based on BiLSTM-Transformer. Energy. 2024;311:133418.
- Bao X, et al. Hybrid deep neural network with dimension attention for state-of-health estimation of lithium-ion batteries. Energy. 2023;278:127734.
- He N, et al. Early prediction of battery lifetime based on graphical features and convolutional neural networks. Appl Energy. 2024;353:122048.
- Rieger LH, et al. Uncertainty-aware and explainable machine learning for early prediction of battery degradation trajectory. Digit Discov. 2023;2(1):112–22.
- Li H, et al. A cross-material lithium-ion battery state of health estimation method based on three-stage domain adaptation. Energy. 2025;139376.
- Han T, et al. Source-free dynamic weighted federated transfer learning for state-of-health estimation of lithium-ion batteries with data privacy. IEEE Trans Power Electron. 2024;39(11):15085–100.
- Rhyu J, et al. Systematic feature design for cycle life prediction of lithium-ion batteries during formation. Joule. 2025;9(5):101884.