所提出的MSCNN-LSTM框架将多尺度空间特征提取与时间序列建模相结合,用于体育视频动作识别,在基准体育动作数据集上能够捕捉精细的空间特征和时间运动模式,并实现具有竞争力的分类性能。
本文内容
摘要
摘要
在体育视频中进行动作识别仍然具有挑战性,原因包括复杂的运动动态、遮挡以及类内高度变异性。尽管现有的深度学习方法(包括CNN-BiLSTM和基于迁移学习的模型)在人类活动识别方面已表现出有效性,但在具有快速且多样化动作的体育场景中,其性能可能受限。许多现有方法依赖于单尺度卷积滤波器,可能无法同时有效捕捉细粒度和粗粒度的运动特征。为解决这一局限性,本研究提出一种多尺度卷积神经网络(MSCNN)与长短期记忆网络(LSTM)相结合的体育视频动作识别方法。MSCNN通过并行卷积核在多个感受野上提取空间表征,从而能够学习详细动作特征和上下文运动特征。这些特征随后由LSTM处理,以捕捉连续帧之间的时序依赖性和运动连续性。实验在UCF11、UCF Sports和JHMDB基准数据集上进行评估。所提出的MSCNN-LSTM模型分别达到了98.3%、95.4%和81.7%的分类准确率,优于本研究中对比的其他方法。消融实验进一步验证了多尺度特征提取以及时序建模对整体性能的贡献。这些结果表明,所提出的框架在融合空间与时序信息用于体育视频动作识别方面具有潜力。
引言
人体活动识别在多个现实领域中具有广泛应用,包括智能监控、异常检测、基于动作的音视频检索以及医疗患者监护1,2。动作识别,特别是在来自监控系统和社交媒体平台的视频流中,对于异常检测和事件理解具有重要意义3。在视频分析中,人体动作通过对手部和腿部等不同身体部位的观察来识别。与静态图像不同,单帧图像通常不足以表征一个动作4。例如,踢足球和跳绳动作在单帧图像中的初始姿态可能看起来相似。当这些动作在连续帧序列中被观察时,其差异才会变得明显,这些帧序列捕捉了人体运动模式及其与周围环境的交互5,6,7。本文中使用的缩写词汇总于表1,以提高可读性并确保术语的一致性。
| 缩写 | 全称 |
| AI | 人工智能 |
| AUC | 曲线下面积 |
| BiLSTM | 双向长短期记忆网络 |
| CNN | 卷积神经网络 |
| CUDA | 统一计算设备架构 |
| F1-score | 精确率与召回率的调和平均数 |
| GPU | 图形处理器 |
| HAR | 人体动作识别 |
| JHMDB | 联合人体运动数据库 |
| LSTM | 长短期记忆网络 |
| mAP-T | 时序平均精度均值 |
| MCC | 马修斯相关系数 |
| MSCNN | 多尺度卷积神经网络 |
| ROC | 受试者工作特征 |
| TSI | 时序稳定性指数 |
| UCF | 中佛罗里达大学 |
| VRAM | 视频随机存取存储器 |
表1:文中使用的缩写列表。 本研究中通篇使用的常见缩写和首字母缩略词及其对应的全称。
快速而准确的体育视频分类对于多种应用具有重要意义8,9,10,包括体育数据分析、事件检测、基于内容的检索以及推荐系统11,12,13。随着体育相关视频内容的快速增长,早期分析框架的局限性日益凸显14。因此,人们越来越需要能够应对体育活动复杂性和动态性的鲁棒方法。传统的体育视频分类方法主要依赖于手工设计的描述符,例如光流和方向梯度直方图(HOG),以刻画体育视频中的运动模式和活动特征15。
卷积神经网络(ConvNets)在静态图像分类中已取得显著成功,并已被应用于视频分析。然而,动作识别仍然更具挑战性,因为视频包含动态的时空信息。当前基于深度学习的方法通常可分为三类:双流网络16、3D卷积网络以及计算高效的架构。为了从光流中学习时间信息,双流网络采用额外的卷积神经网络(ConvNet)17,18,但这种方法计算成本较高。虽然C3D、I3D和R3D等3D卷积架构能够直接建模时间信息,但它们显著增加了参数数量,使得优化更加困难。计算高效的方法则通过探索分解的3D操作来降低模型复杂度。
此外,由于卷积神经网络(CNN)能够提取局部空间特征,而长短期记忆网络(LSTM)能够捕捉时间上下文信息,因此混合模型可以有效地从传感器输入中学习时空运动模式。近期结合卷积神经网络与循环神经网络结构的研究已取得令人鼓舞的成果18,19,20。然而,由于LSTM在序列处理过程中会压缩信息,特征提取过程中引入的噪声可能影响识别性能。为解决这一问题,多项研究引入了注意力机制21,22。注意力机制使模型能够聚焦于对识别任务最为相关的特征,从而提升分类性能。
尽管结合了基于卷积神经网络(CNN)特征提取的深度双向长短期记忆网络(LSTM)模型在人体动作识别中已取得令人瞩目的成果,但在将其扩展至体育视频动作识别时仍面临若干挑战。首先,现有的CNN-LSTM架构通常采用单尺度卷积特征提取,这可能限制其捕捉多空间和时间分辨率下动作的能力,例如体育场景中球员与物体的同步运动。多尺度卷积网络(包括3D CNN23和双流CNN)已证明在不同尺度下捕获空间与运动线索的重要性,但这一理念在基于LSTM的混合系统中仍较少被探索。其次,大多数先前的CNN-BiLSTM模型24主要关注短期时间依赖性,而团队运动中常见的长距离运动连续性与对象间交互可能无法被充分表征。许多基于迁移学习的方法(如MobileNetV2和ResNet)依赖静态帧特征,未能充分挖掘时间注意力机制或自适应多尺度特征融合25的潜力。此外,大多数现有模型主要在UCF11和JHMDB等基准数据集上进行评估,而更新的、针对体育场景设计的数据集(如SoccerNet和FineGym),因其包含复杂的摄像机运动和活动模式,仍缺乏充分研究。这些局限性凸显了构建一种将多尺度卷积特征提取框架与LSTM或BiLSTM等时间记忆模块相结合的必要性,以更有效地捕捉体育视频动作识别中的细粒度空间表征与长距离时间依赖关系。
此外,卷积神经网络(CNN)能够提取局部空间特征,而长短期记忆网络(LSTM)能够建模时间上下文。因此,混合型CNN-RNN架构在人体活动识别中表现出良好的性能26,27近年来,研究通过引入互补的学习策略扩展了传统的CNN-LSTM框架,以提升人体活动识别的性能。例如,已有研究引入了注意力机制,以突出与任务相关的特征并抑制信息量较少的表示,从而提高识别准确率28其他方法采用了多任务学习,以联合优化动作识别与时间分割任务,从而提升学习效率和特征表示能力29尽管取得了这些进展,现有方法在区分视觉上相似的动作时仍可能存在局限性,因为细微的空间和时间特征并不总能被有效捕捉。 表 2 总结了现有方法的优势与局限性30.
| 参考文献 / 年份 | 使用方法 | 数据集 | 性能指标 | 主要优势 | 局限性 |
| Hassan et al. (2024)1 | KFDI (关键帧动态图像) | UCF11 | 准确率:85.3% | 高效的关键帧选择和改进的动态图像表示。 | 对帧选择错误敏感;时间建模能力有限。 |
| Zhou et al. (2023)24 | 扩张卷积神经网络 + 双向长短期记忆网络 + 残差模块 | UCF11, UCF Sports | 准确率:UCF11:89%;UCF Sports:92.2% | 整合了空间与时间学习;能够捕捉多尺度信息。 | 计算量大;在小数据集上存在过拟合风险。 |
| Ullah et al. (2025)34 | 局部-全局特征 + 量子支持向量机(QSVM) | UCF11 | 准确率:82.6% | 结合手工设计特征与深度特征,实现鲁棒识别。 | 需要手动调参;可扩展性有限。 |
| Shin et al. (2025)25 | ViT-ReT(视觉Transformer + 循环Transformer) | UCF11, UCF50, UCF101, 和 JHMDB | 准确率:UCF11:97.73%;UCF50:98.81%;UCF101:98.46%;JHMDB:83.38% | 能够捕捉长距离的空间和时间依赖关系。 | 计算成本高且数据需求量大。 |
| Su et al. (2024)23 | 3D-CNN | UCF11 | 准确率:85.1% | 端到端的时空特征学习。 | 内存和GPU资源需求高。 |
| Karuppannan et al. (2024)35 | 深度自编码器 + 卷积神经网络(CNN) | UCF11 | 准确率:96.2% | 学习紧凑的特征表示。 | 长期时间建模能力有限。 |
| Sahoo et al. (2020)36 | HAR-Depth | KTH, UCF Sports, JHMDB, UCF101, 和 HMDB51 | 准确率:KTH:97.67%;UCF Sports:95.00%;JHMDB:73.13%;UCF101:92.97%;HMDB51:69.74% | 基于深度信息的有效时间学习。 | 需要精确的深度估计和大量预处理。 |
表2:现有用于体育视频动作识别的深度学习方法比较。 代表性深度学习方法的综述,包括数据集、方法学特征、优势与局限性,突出本研究所提出的MSCNN-LSTM框架所解决的研究空白。
提出了一种由音频同步驱动的面部动画生成框架,该框架结合了面部去噪模型(FDM)与局部到全局潜在扩散模型(LG-LDM),以生成具有情感表达的面部动画。采用以情感为中心的向量量化变分自编码器(EVQ-VAE)来重建精细的三维面部几何结构及细微的表情变化31。此外,开发了一种基于双目立体视觉的遮挡感知机器人抓取框架,可在遮挡条件下实现目标分割、定位、遮挡推断以及多目标抓取姿态估计32。同时,提出了一种从点云中提取地面的两阶段框架,该方法利用网格投影和自适应分箱划分,通过基于网格的特征分析完成粗略提取后,使用高程和曲率概率进一步优化地面与障碍物之间的边界33。
尽管基于深度学习的动作识别已取得显著进展,但现有方法在处理体育视频的高度可变性和复杂性方面仍面临困难,其中包括快速运动、相机移动以及多名运动员之间的互动。许多传统的基于卷积神经网络(CNN)或长短期记忆网络(LSTM)的模型仅在单一空间尺度上运行,因此可能难以有效捕捉局部和全局的运动模式。此外,在长时间序列或重叠动作中保持时间连贯性仍然具有挑战性。尽管迁移学习方法已改善了特征提取,但其在体育特定数据集上的适应性仍相对缺乏探索。
本研究旨在开发并评估一种多尺度卷积神经网络-长短期记忆网络(MSCNN-LSTM)框架,用于体育视频动作识别,通过结合多尺度空间特征提取与基于LSTM的时间建模,以同时捕捉细粒度的空间特征和长期时间依赖性。该框架采用互补的卷积核和多层次特征融合策略,提升在复杂条件下对复杂体育动作的表征能力。其性能在UCF11、UCF Sports和JHMDB基准数据集上进行了评估,评估指标包括准确率、精确率、召回率、F1分数、时间平均精度均值(mAP-T)、时间稳定性指数(TSI)、Cohen's kappa系数(κ)、马修斯相关系数(MCC)以及ROC曲线下面积(AUC)。实验结果表明,该方法相较于本研究中对比的其他方法具有竞争力,凸显了其在体育数据分析、运动员表现监测、自动事件检测及体育视频理解中的应用潜力。
方案
本研究采用了一种两阶段深度学习框架,用于体育视频动作识别,该框架将多尺度卷积神经网络(MSCNN)与长短期记忆网络(LSTM)相结合。模型开发与评估使用了公开的基准数据集,即 UCF11、UCF Sports 和 JHMDB。研究未从人类受试者收集新数据,也未访问或处理任何可识别个人身份的信息。由于本研究涉及对公开、匿名化数据集的二次分析,且不涉及直接的人类参与,因此无需机构伦理审批和知情同意。
该工作流程包括帧采样和时间归一化,随后使用 MSCNN 模块进行特征提取。提取的特征接着通过 LSTM 网络进行时间建模处理,然后传递至多分类分类层。最后,利用选定的基准数据集对模型进行训练和评估。图 1 展示了所提出框架的整体架构。
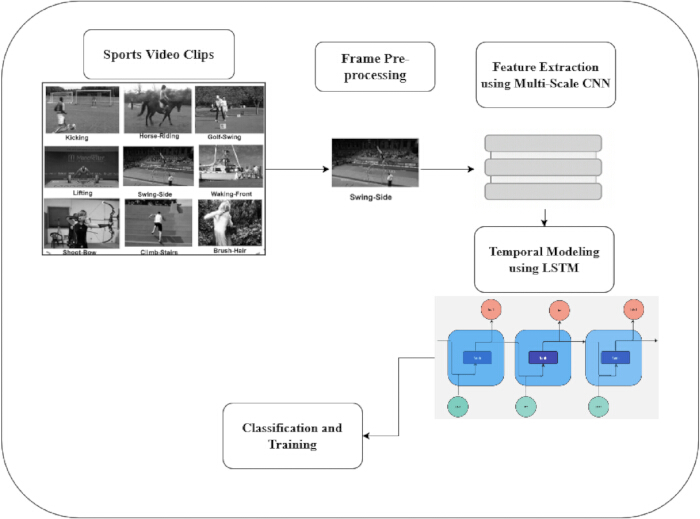
图1:用于体育视频动作识别的MSCNN-LSTM框架示意图。整体工作流程展示了视频预处理、多尺度空间特征提取、时间序列学习以及动作分类。 请点击此处查看该图的放大版本。
图1展示了基于混合MSCNN-LSTM架构的体育视频动作识别框架的工作流程。该过程始于包含多种运动动作(如踢球、骑马和挥杆击高尔夫球)的体育视频片段。在预处理阶段,原始视频被分解为单个帧,这些帧经过裁剪、标准化并准备输入模型。预处理后的帧随后被送入MSCNN模块进行特征提取。多尺度卷积架构在不同的感受野上捕获空间特征,从而能够从体育视频帧中提取局部和上下文信息。提取的特征向量随后由LSTM网络处理,以建模时间依赖性以及连续帧间运动的演变过程。最后,分类与训练模块利用学习到的时空表征对每个视频片段的动作类别进行预测。所提出的框架包含四个顺序步骤,首先使用UCF11(YouTube Actions)、UCF Sports和JHMDB基准数据集进行数据收集和预处理。每个体育视频被转换为一系列帧,这些帧经过调整大小、归一化,并通过旋转、翻转和裁剪进行数据增强,以提高对环境变化的鲁棒性。预处理后的帧随后由所提出的多尺度卷积神经网络(MSCNN)处理,其中具有3×3、5×5和7×7卷积核的并行卷积分支提取互补的局部和上下文空间特征。这些多尺度特征通过批归一化和最大池化进行拼接和优化,生成紧凑的特征表示。所得的帧级特征随后输入至长短期记忆网络(LSTM),以建模连续帧之间的时间依赖关系。最终的LSTM输出被展平,并通过带有ReLU激活函数的全连接层,再经Softmax分类器预测动作类别。该网络采用Adam优化器进行训练,损失函数为交叉熵,并结合Dropout正则化以减少过拟合。模型性能最终在UCF11、UCF Sports和JHMDB基准数据集上通过准确率、精确率、召回率和F1分数进行评估。
1. 数据收集与预处理
本研究使用了三个公开可用的体育与人类动作基准数据集。这些数据集包含真实世界的体育视频片段,涵盖了不同的摄像机运动、视角以及复杂的背景环境。具体而言,本研究采用了UCF11(YouTube动作数据集)(https://www.crcv.ucf.edu/data/UCF_YouTube_Action.php),该数据集包含从1,168个YouTube视频中收集的11类动作,视频来自约25名个体,每类动作包含多个样本。联合标注的人体运动数据库(JHMDB)34,35 包含21类动作和928个带标注的视频。UCF Sports数据集包含10类动作,共150个视频序列,视频来源于电视转播,分辨率为720 × 480像素(https://www.crcv.ucf.edu/data/UCF_Sports_Action.php)。
这些数据集共同涵盖了个人运动和团体运动,在时间持续长度和视觉尺度上提供了多样性,可用于评估所提出的MSCNN-LSTM动作识别框架。作为数据质量筛选过程的一部分,对UCF11、UCF Sports和JHMDB数据集进行了检查,以识别损坏的视频、重复文件以及标注不完整的片段。未发现符合这些排除标准的样本,因此保留了所有可用视频用于后续分析。随后,采用一致的随机划分策略将数据集划分为训练集(70%)、验证集(15%)和测试集(15%)。图2展示了用于训练和评估的代表性图像。
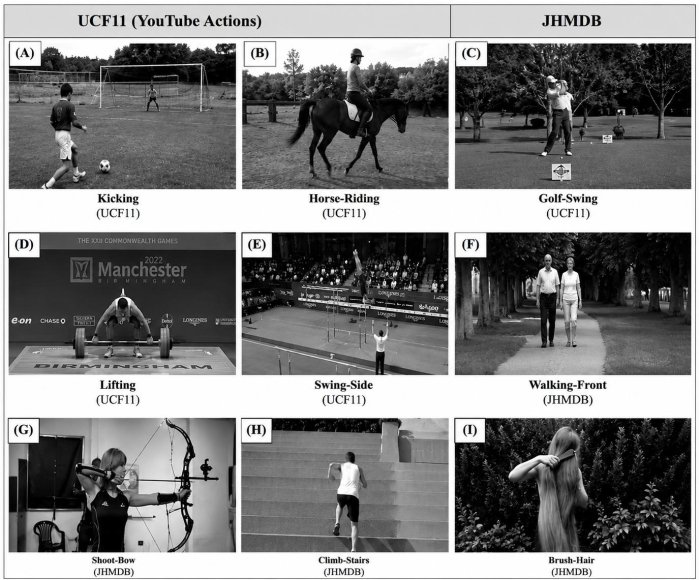
图 2:基准体育动作识别数据集中的代表性帧。 图中(A–D)为UCF11(YouTube动作)数据集的示例,(E–H)为UCF Sports数据集的示例,(I–L)为JHMDB数据集的示例。这些帧展示了动作类别、视角、背景、光照条件以及运动复杂性方面的变化。请点击此处查看此图的放大版本。
所提出的动作识别模型在UCF11、UCF Sports和JHMDB基准数据集上进行了评估,总结见表3。这些数据集代表了多样化的运动模式和具有挑战性的环境条件。UCF11(YouTube动作)数据集包含来自11个类别的体育动作,采集条件涵盖不同的光照、视角和背景变化。UCF Sports数据集由150个职业赛事转播中的场地体育视频组成,包含真实的运动序列。JHMDB数据集为21种细粒度动作类别提供了详细的人体运动标注,是时空动作识别的基准数据集。综合来看,这些数据集被用于评估模型在体育运动和人体动作场景下的性能。网络使用Adam优化器训练100个周期,批量大小为32,初始学习率为0.001,并采用交叉熵损失函数。选择验证损失最低的模型进行最终评估。所有实验均使用固定的随机种子42。为提高收敛性,采用了早停法和在平台期降低学习率的策略,并在LSTM训练期间使用阈值为5.0的梯度裁剪以防止梯度爆炸。所提出的MSCNN-LSTM模型包含约1500万个可训练参数。实现所用的硬件和软件配置总结于表4。由于类别分布已足够均衡,未额外应用类别加权或重采样方法。对比模型采用其原始研究中报告的超参数实现,并在可行的情况下统一训练设置。性能值报告为五次独立运行(不同随机初始化)的平均值±标准差。采用配对t检验在显著性阈值p < 0.05下评估所提出模型与对比模型之间的差异。
| 数据集 | 类别数量 | 视频数量 | 分辨率(像素) | 来源 | 描述 |
| UCF11 (YouTube Actions) | 11 | 1168 | 可变(≈ 320×240) | University of Central Florida | 包含11种人类动作,来自体育活动(例如篮球投篮、跳水、高尔夫挥杆、足球颠球)。视频采集自YouTube,光照、视角和背景变化较大。 |
| UCF Sports | 10 | 150 | 720×480 | UCF Sports Action Dataset | 包含跳水、骑马、高尔夫挥杆、跑步和举重等体育活动,视频来源于真实电视转播片段(BBC、ESPN)。 |
| JHMDB | 21 | 928 | 320×240 | Max Planck Institute for Intelligent Systems | 包含日常活动和体育动作,如接物、跳跃、梳头、射击和跑步,并提供关节标注,用于运动和姿态分析。 |
表3:用于训练和评估的基准数据集特征。 UCF11、UCF Sports 和 JHMDB 数据集的概述,包括动作类别数量、视频样本数量、数据集特征,以及它们在模型训练、验证和测试中的作用。
| 使用的参数 | 描述 |
| 编程语言 | Python 3.8.18 [4] |
| 深度学习框架 | TensorFlow 2.15.0 [1] |
| GPU 加速器 | NVIDIA GeForce RTX 3090 (24 GB VRAM) [1] |
| CPU | Intel Core i9 @ 3.5 GHz × 16 核 |
| 操作系统 | Windows 11 |
| 内存 (RAM) | 64 GB DDR4 |
| 优化器 | Adam (学习率 = 0.001) |
| 批量大小 | 32 |
| 训练轮数 | 100 |
| 激活函数 | ReLU (CNN 层), Softmax (输出层) |
| Dropout 率 | 0.5 |
表4:所提出的MSCNN-LSTM模型的仿真环境与超参数配置。 模型训练与评估过程中所使用的硬件规格、软件环境、优化器设置、学习率、批量大小、训练轮数、输入维度及其他超参数。
2. 预处理
训练前,每段原始视频被转换为按时间顺序排列的帧序列,随后进行归一化、时间采样和数据增强。每段输入视频 V 首先被转换为一系列帧,并表示为一个4D张量 V ∈ RT×H×W×C,其中 T 是帧的数量, H × W i 表示帧索引,且 C 表示颜色通道的数量(RGB 为 3)。预处理流程包括帧提取、空间尺寸调整,随后进行中心裁剪或随机裁剪以达到固定分辨率(H′, W′),逐像素强度归一化,以及可选的数据增强,包括随机翻转、缩放和颜色抖动,然后进行特征提取。具体而言,强度归一化采用标准分数归一化,如公式(1)所示。
 (1)
在……的地方 μ, σ 通道的均值和标准差是在训练集上计算得到的,还是采用式(2)中的最小-最大缩放法?
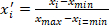 (2)
归一化后,每一帧表示为 F̃t ∈ RH′×W′×C′,所得视频张量表示为 V′ ∈ RT×H′×W′×C。在多尺度卷积前端中,通过应用多个不同卷积核尺寸的二维卷积(对于早期时空卷积为三维卷积),获得多个感受野的空间特征图;随后为每一帧或短视频片段生成时间特征表示,并送入 LSTM 模块。原始论文采用 MobileNetV2 进行特征提取,再使用深度双向 LSTM(Deep BiLSTM)进行时间建模;上述完全相同的预处理流程与多尺度卷积加 LSTM 的替代方案完全兼容。
3. 取样与时间归一化
由于视频长度 T 在不同数据集之间以及同一数据集内部存在差异,我们通过对帧进行均匀采样或时间重采样,使多尺度卷积+LSTM网络的输入帧数或短片段数固定为 N。均匀的帧索引可按公式(3)计算,
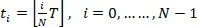 (3)
因此,采样的帧序列是 Vs = {F̃t0, …, F̃tN−1}. 当需要更高的时间精度时,我们进行线性时间插值:对于任意重采样的分数时间 τ ∈ [0, T−1] 按公式 (4) 计算得到。
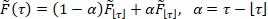 (4)
使得重采样后的序列 Vs 恰好包含 N 个帧,并保持运动的平滑性。或者,通过短的连续片段进行采样(时间窗口长度为 w,步长为 s)可得到一组片段张量,其中每个片段 Cj ∈ RT×H′×W′×C,且 j = 0, …, ⌊(T − w)/s⌋。为实现网络内部的时间归一化,采用多尺度的简单时间池化是有效的:给定由多尺度卷积生成的时间特征序列 X = {x1, …, xN},按公式 (5) 应用池化后的特征。
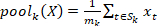 (5)
其中 Sk 表示尺度 k 的时间支持(例如,Sk 可以为非重叠块或扩张索引),且 mk = |Sk|。
在特征提取之前,所有视频均被缩放至 224 × 224 像素,并以每秒 25 帧的速率进行采样。每次实验均采用固定的 32 帧序列长度。数据增强技术包括随机裁剪(缩放比例 = 0.8–1.0)、随机旋转(±15°)、随机水平翻转(概率 = 0.5)以及亮度调整(±20%)。像素值使用 ImageNet 的均值 [0.485, 0.456, 0.406] 和标准差 [0.229, 0.224, 0.225] 进行标准化。对于每个视频序列,采用均匀帧选择进行时间维度上的采样。较长的视频通过均匀裁剪或采样以保持序列长度一致,而少于 32 帧的视频则进行零填充。这些设置在训练和评估过程中始终保持不变。
4. 使用 MSCNN 进行特征提取
采用多尺度卷积神经网络(MSCNN)以增强体育视频中动作的空间表征能力。传统的卷积神经网络依赖单一的卷积核尺寸,可能在捕获多尺度空间特征方面能力有限。由于某些体育动作具有相似的视觉特征,单尺度卷积结构可能难以同时捕捉局部和全局特征。为解决这一局限性,所提出的框架利用不同尺寸的卷积核进行多尺度特征提取与特征融合。
在所提出的网络架构中,使用 1 × 1 卷积核来整合通道间的信息,并降低输入特征图的维度。此外,这些层通过引入额外的特征变换和非线性表示,增强了网络的表达能力。不同尺寸的卷积核能够实现多尺度的空间信息提取。在加权多尺度特征融合之后进行序列归一化,以提高训练的稳定性。为了缓解深度网络训练过程中的梯度消失和梯度爆炸问题,该架构采用了残差连接和基于 LSTM 的时序建模。
多尺度设计增强了网络在不同空间分辨率下捕获特征的能力,并提升了特征表示能力。此外,传统的 N × N 卷积核被分解为 N × 1 和 1 × N 卷积操作。MSCNN 模块中采用的 N × 1 和 1 × N 卷积旨在从单个视频帧中捕获互补的方向性和多尺度空间特征。这些卷积操作通过在不同感受野尺度上提取模式,增强了空间特征表示。随后,LSTM 模块对连续帧之间的时间关系进行建模,处理由 MSCNN 提取的特征序列,以学习动作识别所需的长期时间依赖性。
每个体育视频 V = {F1, F2, …, FT} 被分解为 T 个帧。为了编码空间变化(例如,运动员姿态、运动模糊、球的轨迹),在三个不同尺度上设置卷积分支,s ∈ {1, 2, 3},分别对应 3 × 3、5 × 5 和 7 × 7 的卷积核大小。每个分支按公式 (6) 提取特征图:
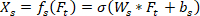 (6)
其中 Ws 和 bs 分别为尺度 s 上的卷积权重和偏置,σ 为 ReLU 激活函数。多尺度融合层按公式 (7) 聚合特征:
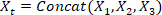 (7)
该融合特征张量同时嵌入了细粒度的运动线索和大范围的上下文信息(例如群体活动)。图3仅展示了MSCNN特征提取模块。用于时间建模与分类的LSTM层(256个隐含单元)、全连接层(128个神经元)和dropout层(0.5)在图4中单独呈现。
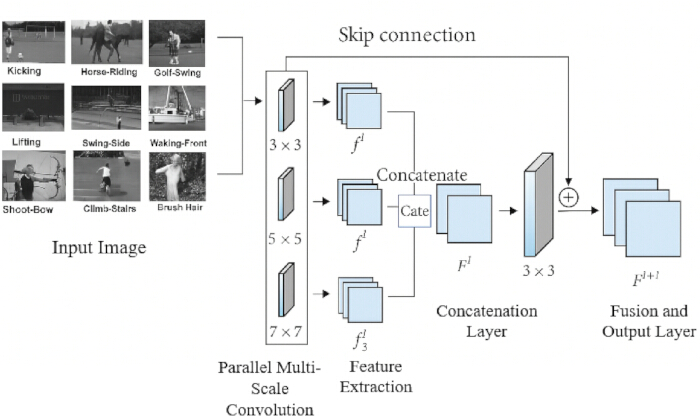
图3:提出的多尺度卷积神经网络(MSCNN)特征提取模块。 三个并行的卷积分支(卷积核大小分别为 3 × 3、5 × 5 和 7 × 7)提取互补的多尺度空间特征,这些特征在由 LSTM 网络进行时间建模之前进行融合。请点击此处查看该图的放大版本。
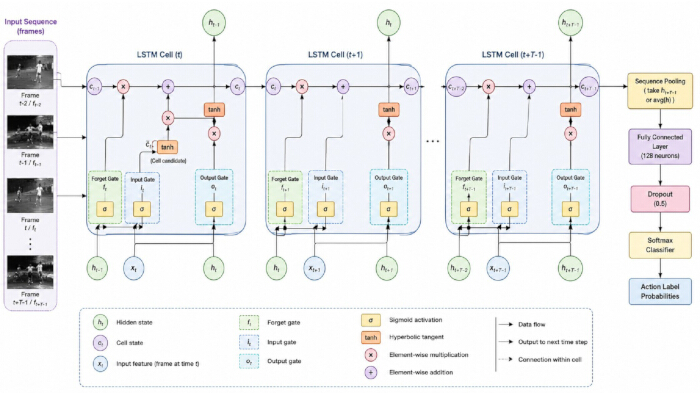
图 4:用于体育视频动作识别的LSTM架构示意图。LSTM模块通过连续视频帧中的输入门、遗忘门和输出门操作来建模时间依赖性。请点击此处查看该图的放大版本。
图3 展示了用于体育视频动作识别的多尺度卷积神经网络(MSCNN)特征提取模块。输入视频帧通过三个卷积分支并行处理,卷积核尺寸分别为3 × 3、5 × 5和7 × 7,每个分支包含64个滤波器,用于捕获互补的细粒度和粗粒度空间特征。输出结果通过批归一化、ReLU激活函数和2 × 2最大池化进行优化,随后通过一个包含128个滤波器的1 × 1卷积进行拼接与融合。残差跳跃连接保留了低层空间信息,并改善了梯度流动。融合后的特征图被展平并传入一个包含256个隐藏单元的LSTM层,用于时序建模,之后经过一个包含128个神经元的全连接层,使用ReLU激活函数和0.5的丢弃率,最终通过Softmax层进行分类。多尺度特征图(f1l、f2l 和 f3l)被拼接形成融合表示(Fl),再通过一个3 × 3卷积进一步优化,生成下一层的输出特征图。该分层结构能够在多个感受野上学习互补的空间特征,从而提升体育动作识别的性能。
5. 使用 LSTM 进行时间建模
为了对视频边缘的时间演化过程进行建模,将聚合后的特征序列输入LSTM系统,以捕捉运动的动态依赖关系和连续性。对于每个输入视频,我们首先提取每帧的多尺度CNN特征。设视频帧为 I1, …, IT。对于每一帧 t 和每个尺度 s,多尺度卷积编码器生成一个特征向量 ft(s) ∈ Rd。然后通过投影+拼接或加权求和的方式将不同尺度融合为单一的帧描述符,如公式(8)所示:
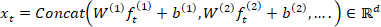 (8)
然后将序列 {xt}tT=1 输入 LSTM 以建模时间动态。在标准 LSTM 表示中,时刻 t 的门和状态如公式 (9) 至 (13) 所示:
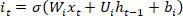 (9)
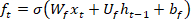 (10)
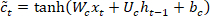 (11)
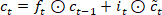 (12)
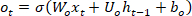 (13)
其中,σ 是 sigmoid 激活函数,⊙ 表示逐元素相乘。尽管可以使用双向 LSTM 结构来捕捉过去和未来的时序上下文,但本研究提出的框架采用标准 LSTM 来建模连续视频帧之间的时序依赖关系。该设计选择与本研究中提出的 MSCNN-LSTM 架构保持一致。在处理视频片段后,获得了一个片段表示(例如,最后一个隐藏状态或时序池化):z = Poolt(vt)。
图4展示了所提出的用于体育动作识别的LSTM架构的工作流程。该网络接收一段视频帧序列或由CNN提取的特征,并在连续的时间步(t−2、t−1 和 t)上进行处理。每个LSTM单元包含一个输入门、一个遗忘门和一个输出门,用于调控信息在网络中的流动。输入门将新信息纳入细胞状态,遗忘门丢弃无关的时间信息,输出门生成传递至下一时间步的隐藏状态。细胞状态用于保留长期的时间依赖关系,而隐藏状态则捕获短期的时间信息。经过序列化处理后,对LSTM的输出进行池化以生成时间特征表示,随后送入全连接层和Softmax分类器,以预测对应的体育动作。该网络使用Adam优化器进行训练,共训练100个epoch,批量大小为32,初始学习率为0.001,并采用交叉熵损失函数。选择验证损失最低的模型进行最终评估。为确保可重复性,所有实验均采用固定的随机种子42进行。训练过程中采用早停法(early stopping)和在平台期降低学习率的策略以改善收敛性,并在LSTM训练期间应用梯度裁剪(阈值为5.0),以防止梯度爆炸。所提出的MSCNN-LSTM模型包含约1500万个可训练参数。
最终的类别得分和概率采用线性层加 softmax 函数,如公式 (14) 所示:
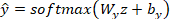 (14)
通过最小化标记片段上的交叉熵损失来训练,如公式 (15) 所示:
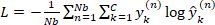 (15)
其中 Nb 是批次的大小, C 类别数量,以及 y(n) 是独热编码的真实标签。正则化(dropout 在 xt对LSTM输出和权重衰减应用梯度裁剪,以提高长序列运动数据训练的稳定性。
结果
所提出的 MSCNN-LSTM 模型在 UCF11(YouTube 动作)、UCF Sports 和 JHMDB 数据集上进行了训练和评估,这些数据集包含了多样化的体育动作、视角和运动模式。由于类别分布已足够均衡,因此未采用额外的类别加权或重采样方法。对比模型采用其原始研究中报告的超参数实现,并在可行的情况下统一了训练设置。结果以五次独立运行(不同随机初始化)的均值 ± 标准差表示。使用配对 t-检验在显著性阈值 p < 0.05 下评估所提出模型与对比模型之间的差异。
图5比较了三种数据集上的分类准确率。MSCNN-LSTM模型取得了最高的准确率,在UCF11上达到98.3%,在UCF Sports上达到95.4%,在JHMDB上达到81.7%。这些数值均超过了Dilated CNN–BiLSTM、Two-Stream LSTM和ViT-ReT模型所获得的结果。JHMDB上较低的准确率反映了在低分辨率视频中识别细粒度动作的更大难度。
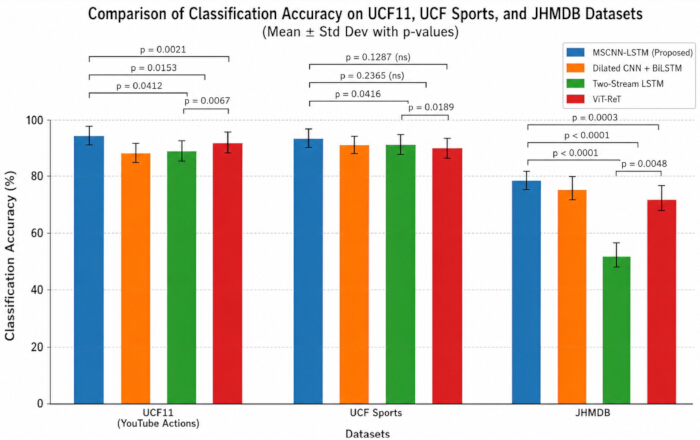
图 5:不同深度学习模型在体育视频数据集上的分类准确率(%)比较。 MSCNN-LSTM、ViT-ReT、双流LSTM(Two-Stream LSTM)和扩张CNN+双向LSTM(Dilated CNN + BiLSTM)在UCF11、UCF Sports和JHMDB数据集上的分类准确率。结果以五次独立实验的均值±标准差(mean ± SD)表示(n = 5)。误差线代表一个标准差。采用双尾配对t检验评估统计学显著性(p < 0.05)。请点击此处查看该图的放大版本。
该模型在所有数据集上也达到了最高的精确率,在 UCF11 上约为 96%,在 UCF Sports 上为 93%,在 JHMDB 上为 78%图6)。召回率分别为约 95%、94% 和 77%(图7),而相应的F1分数分别为约95.5%、93.5%和77.5%(图8这些结果表明,该模型在准确识别动作类别与限制假阳性预测之间保持了良好的平衡。
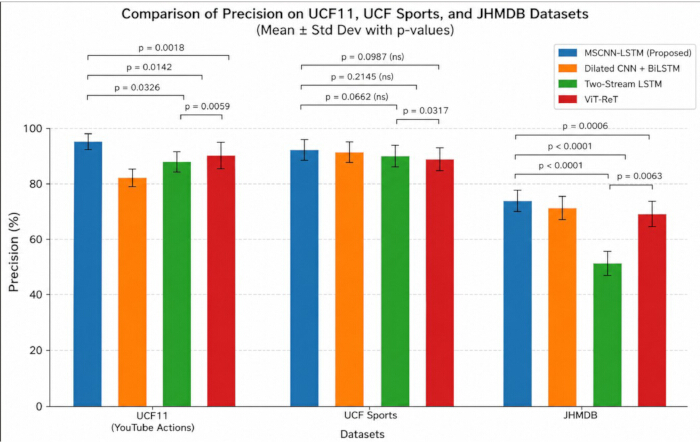
图6:不同深度学习模型在体育视频数据集上的精确率(%)比较。 精确率值以五次独立运行的均值±标准差(n = 5)表示。误差条代表一个标准差。采用双尾配对t检验评估统计学显著性(p < 0.05)。请点击此处查看该图的放大版本。
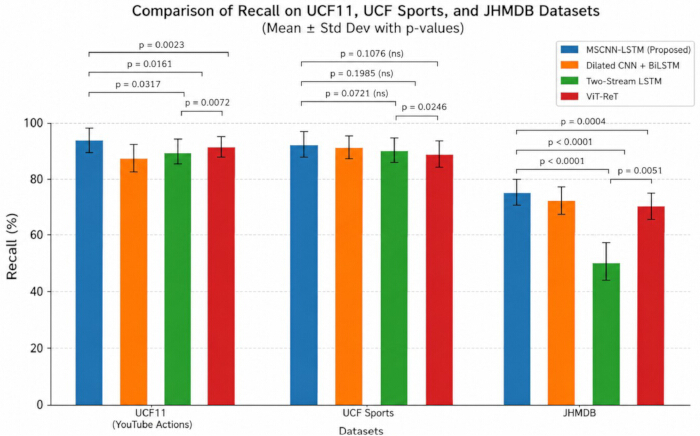
图7:不同深度学习模型在体育视频数据集上的召回率(%)比较。召回率值以五次独立实验的均值±标准差(n = 5)表示。误差条代表一个标准差。采用双尾配对t检验评估统计学显著性(p < 0.05)。请点击此处查看该图的放大版本。
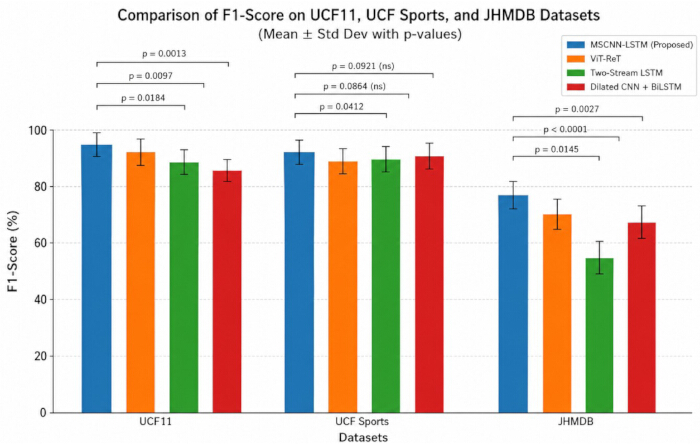
图8:不同深度学习模型在体育视频数据集上的F1分数(%)比较。F1分数以五次独立运行的均值±标准差(n = 5)表示。误差条代表一个标准差。采用双尾配对t检验评估统计学显著性(p < 0.05)。请点击此处查看该图的放大版本。
表5列出了Cohen’s kappa和Matthews相关系数的结果。在UCF11数据集上,所提出的模型达到了κ = 0.96和MCC = 0.96,而ViT-ReT的κ/MCC值为0.92/0.92,Two-Stream LSTM为0.90/0.90,Dilated CNN–BiLSTM为0.87/0.87。在UCF Sports数据集上,MSCNN-LSTM取得了κ = 0.95和MCC = 0.94,超过了ViT-ReT(0.90/0.90)、Two-Stream LSTM(0.88/0.89)和Dilated CNN–BiLSTM(0.84/0.85)的相应值。在JHMDB数据集上,所提出的模型达到了κ = 0.83和MCC = 0.84,而ViT-ReT为0.74/0.75,Two-Stream LSTM为0.70/0.71,Dilated CNN–BiLSTM为0.71/0.72。这些结果表明,所提出模型的预测标签与真实标签之间具有更强的一致性。
| 模型 | 数据集 | Cohen’s Kappa (κ) | Matthews 相关系数 (MCC) |
| Dilated CNN + BiLSTM [4] | UCF11 (YouTube 动作) | 0.87 ± 0.01 | 0.88 ± 0.01 |
| UCF Sports | 0.84 ± 0.02 | 0.85 ± 0.02 | |
| JHMDB | 0.71 ± 0.03 | 0.72 ± 0.03 | |
| Two-Stream LSTM [38] | UCF11 (YouTube 动作) | 0.90 ± 0.01 | 0.91 ± 0.01 |
| UCF Sports | 0.88 ± 0.02 | 0.89 ± 0.02 | |
| JHMDB | 0.70 ± 0.03 | 0.71 ± 0.03 | |
| ViT-ReT (Vision Transformer + Recurrent Transformer) [6] | UCF11 (YouTube 动作) | 0.92 ± 0.01 | 0.92 ± 0.01 |
| UCF Sports | 0.90 ± 0.01 | 0.90 ± 0.01 | |
| JHMDB | 0.74 ± 0.02 | 0.75 ± 0.02 | |
| 本文提出的 MSCNN–LSTM | UCF11 (YouTube 动作) | 0.96 ± 0.01 | 0.96 ± 0.01 |
| UCF Sports | 0.95 ± 0.01 | 0.94 ± 0.01 | |
| JHMDB | 0.83 ± 0.02 | 0.84 ± 0.02 |
表5:不同深度学习模型上Cohen's kappa(κ)与Matthews相关系数(MCC)的比较。 MSCNN-LSTM、ViT-ReT、双流LSTM和扩张CNN+BiLSTM在UCF11、UCF Sports和JHMDB数据集上的性能比较。数值越高,表明预测标签与真实标签之间的一致性越强,分类可靠性越高。数值以五次独立实验的均值±标准差(n = 5)表示。
图9展示了受试者工作特征曲线。所提出的MSCNN-LSTM在UCF11上取得了0.975的AUC值,在UCF Sports上为0.961,在JHMDB上为0.937。这些持续较高的AUC值表明,该方法在不同复杂程度的数据集上均能有效区分动作类别。
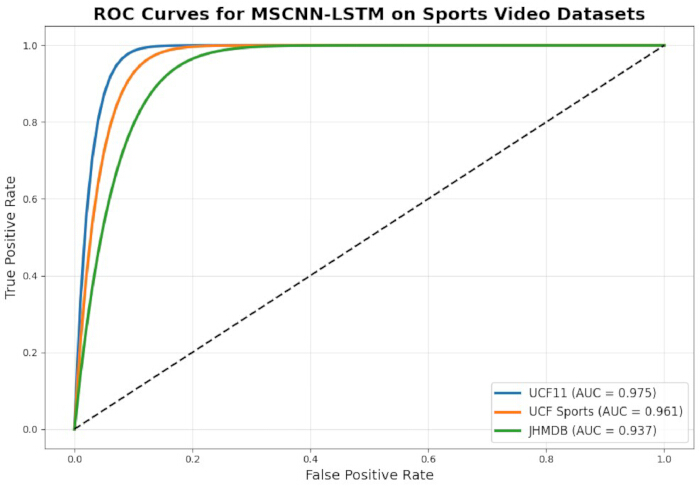
图9:所提出的 MSCNN-LSTM 模型的受试者工作特征(ROC)曲线。 UCF11、UCF Sports 和 JHMDB 数据集的 ROC 曲线,展示了真阳性率与假阳性率之间的权衡关系。曲线下面积(AUC)总结了模型在不同分类阈值下的判别性能。请点击此处查看该图的放大版本。
时间性能结果总结见表6。在UCF11数据集上,所提出的模型达到了98.3%的mAP-T、96.5%的帧级别准确率以及0.95的TSI。在UCF Sports数据集上,相应数值分别为95.4%、94.0%和0.93。在JHMDB数据集上,模型的mAP-T为81.7%,帧级别准确率为78.9%,TSI为0.88(表7)。这些数值均高于对比模型的结果,表明该模型在短时和长时动作序列上均具有更优的时间连贯性和预测稳定性。
| 方法 | 数据集 | mAP-T (%) | 帧级别准确率 (%) | 时间稳定性指数 (TSI) |
| 空洞卷积神经网络 + 双向长短期记忆网络4 | UCF11 (YouTube 动作数据集) | 93.6 ± 0.8 | 91.8 ± 0.9 | 0.87 ± 0.01 |
| UCF Sports | 90.2 ± 1.0 | 89.1 ± 1.1 | 0.83 ± 0.02 | |
| JHMDB | 72.4 ± 1.5 | 70.3 ± 1.7 | 0.78 ± 0.03 | |
| 双流长短期记忆网络38 | UCF11 (YouTube 动作数据集) | 94.8 ± 0.7 | 92.6 ± 0.8 | 0.89 ± 0.01 |
| UCF Sports | 91.3 ± 0.9 | 90.0 ± 1.0 | 0.85 ± 0.02 | |
| JHMDB | 73.8 ± 1.4 | 71.5 ± 1.6 | 0.79 ± 0.03 | |
| ViT-ReT (视觉Transformer + 循环Transformer)6 | UCF11 (YouTube 动作数据集) | 95.5 ± 0.6 | 93.4 ± 0.7 | 0.90 ± 0.01 |
| UCF Sports | 92.4 ± 0.8 | 91.2 ± 0.9 | 0.87 ± 0.01 | |
| JHMDB | 74.6 ± 1.3 | 72.8 ± 1.4 | 0.81 ± 0.02 | |
| . | UCF11 (YouTube 动作数据集) | 98.3 ± 0.5 | 96.5 ± 0.6 | 0.95 ± 0.01 |
| UCF Sports | 95.4 ± 0.7 | 94.0 ± 0.8 | 0.93 ± 0.01 | |
| JHMDB | 81.7 ± 1.1 | 78.9 ± 1.3 | 0.88 ± 0.02 |
表6:体育视频动作识别的时间性能指标比较。 不同深度学习模型在基准数据集上的时间片段平均精度均值(mAP-T)、帧级别准确率和时间稳定性指数(TSI)的实验结果。数值以五次独立运行的均值±标准差表示(n = 5)。
| 配置 | 多尺度卷积神经网络(MSCNN) | LSTM | 准确率 (%) | F1分数 (%) | mAP-T (%) |
| 仅CNN基线 | ✗ | ✗ | 90.4 ± 1.2 | 89.8 ± 1.3 | 88.9 ± 1.4 |
| CNN + LSTM | ✗ | ✓ | 93.1 ± 0.9 | 92.4 ± 1.0 | 91.7 ± 1.1 |
| 仅MSCNN | ✓ | ✗ | 94.2 ± 0.8 | 93.6 ± 0.9 | 92.8 ± 1.0 |
| 提出的MSCNN-LSTM | ✓ | ✓ | 98.3 ± 0.5 | 97.8 ± 0.6 | 97.1 ± 0.6 |
表7:所提出的MSCNN-LSTM框架的消融研究。 在相同训练和评估设置下,MSCNN和LSTM组件的性能贡献。数值以五次独立运行的均值±标准差表示(n = 5)。
图10、图11、图12 分别展示了 UCF11、UCF Sports 和 JHMDB 的行归一化混淆矩阵。三个矩阵均表现出明显的对角线优势,表明大多数动作类别被正确识别。少量非对角线上的错误主要出现在具有相似视觉或运动特征的动作之间。JHMDB 矩阵表现出相对更高的类别混淆,与此数据集更具挑战性所导致的较低定量性能结果一致。
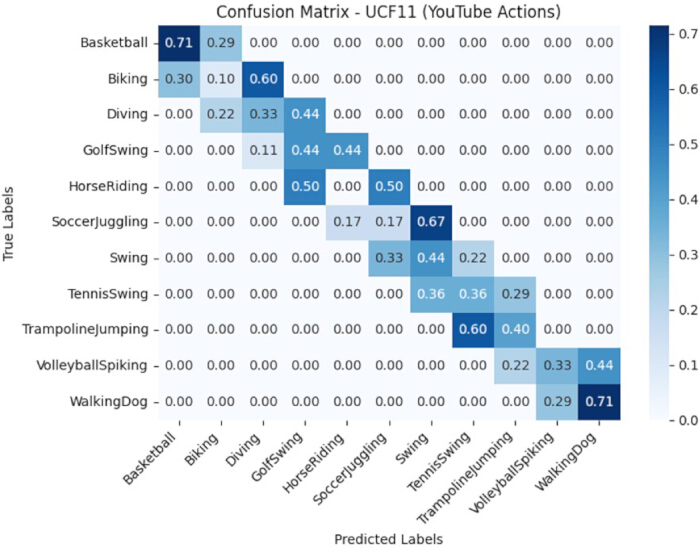
图10:所提出的 MSCNN-LSTM 模型在 UCF11 数据集上的行归一化混淆矩阵。每一行被归一化为1,对角线元素表示各类别的召回率,而非整体分类准确率,后者已单独报告。请点击此处查看该图的放大版本。
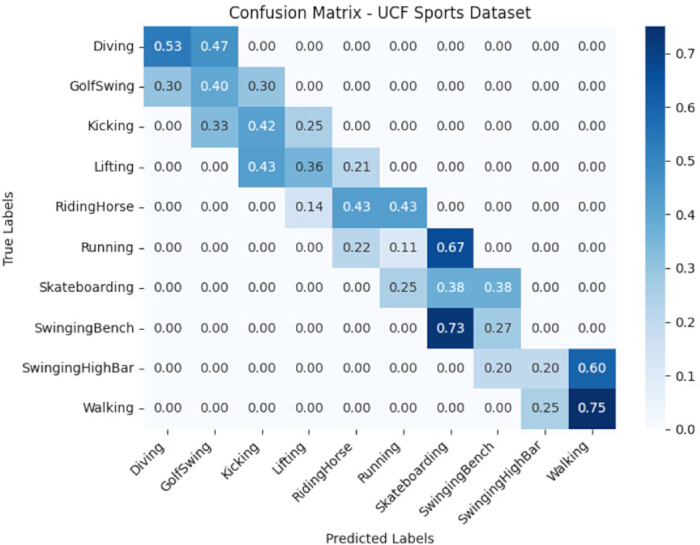
图11:所提出的MSCNN-LSTM模型在UCF Sports数据集上的行归一化混淆矩阵。每一行被归一化为1,对角线元素表示各类别的召回率,而非整体分类准确率(后者单独报告)。请点击此处查看该图的放大版本。
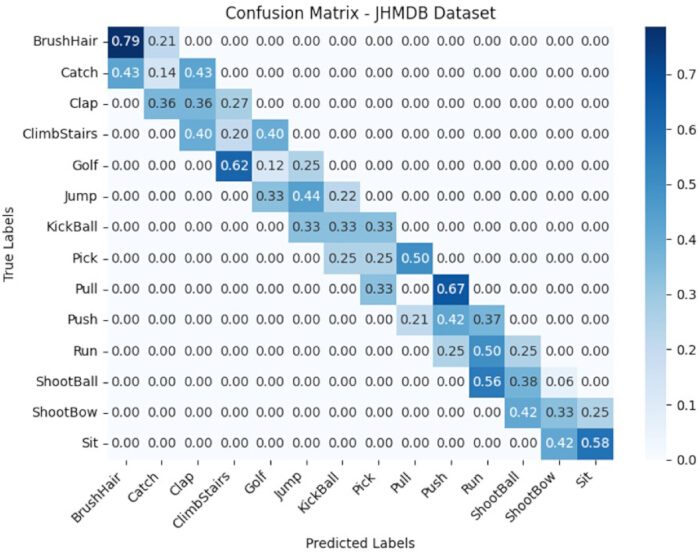
图12:所提出的MSCNN-LSTM模型在JHMDB数据集上的行归一化混淆矩阵。每一行被归一化为1,对角线元素表示各类别的召回率,而非整体分类准确率,后者已单独报告。请点击此处查看该图的放大版本。
总体而言,所提出的 MSCNN-LSTM 框架在分类、一致性、判别能力以及时间稳定性指标上均持续优于所评估的对比模型。研究结果支持了以下假设:将多尺度空间特征提取与基于 LSTM 的时间建模相结合,能够提升在具有不同运动复杂度、图像质量及视角条件的数据集上的体育动作识别性能。
数据可用性:
本研究中分析的数据集可从以下来源公开获取:UCF11(YouTube行为)数据集(https://www.crcv.ucf.edu/data/UCF_YouTube_Action.php)和UCF Sports数据集(https://www.crcv.ucf.edu/data/UCF_Sports_Action.php)。为支持本研究的可重复性,实验中使用的预处理流程、数据集划分(训练/验证/测试集分割生成)、实现文件、配置文件及辅助文档均已存入Zenodo知识库,并在https://doi.org/10.5281/zenodo.21020947公开提供。
讨论
所提出的 MSCNN-LSTM 框架在 UCF11、UCF Sports 和 JHMDB 基准数据集上始终优于被评估的各类方法。基于空洞卷积神经网络–双向长短期记忆网络(Dilated CNN–BiLSTM)、视觉 Transformer 架构以及 3D 卷积神经网络(3D CNN)的先前方法虽已展现出有效的时空特征学习能力,但可能受限于较高的计算复杂度、较大的训练需求,或对细粒度运动模式表征不足23,24,25。相比之下,所提出的框架将多尺度空间特征提取与基于 LSTM 的时间建模相结合,能够同时捕捉局部运动细节和长程时间依赖关系。该融合策略提升了对复杂体育动作的识别能力,减少了类别间的混淆,并增强了时间一致性,尤其在更具挑战性的 JHMDB 数据集上表现更为显著。这些结果表明,与被评估的基于卷积神经网络、循环神经网络及 Transformer 的方法相比,所提出的框架在空间与时间信息表征之间实现了更优的平衡。
从理论角度来看,MSCNN-LSTM 框架为多尺度特征融合与序列时序学习提供了一种统一的方法36,37。通过使用分层感受野,能够在不同尺度上提取空间信息,而 LSTM 则对连续视频帧之间的依赖关系进行建模。该设计通过在时序建模之前保留局部和上下文空间信息,扩展了传统的 CNN-LSTM 流程。在包含不同动作类别、运动模式和摄像机视角的数据集上均表现出稳定性能,进一步验证了所提出架构的鲁棒性。
从实际应用的角度来看,该框架在自动化体育数据分析、运动员表现评估、事件检测以及体育视频理解方面展现出潜力。然而,在部署之前,还需在真实世界运行条件下进行进一步验证。尽管该架构实现了较强的识别性能,但其在资源受限设备或基于云的分析平台上的适用性,仍需通过计算成本、推理时间、内存需求和能耗等方面的进一步评估来确认。
消融实验表明,MSCNN 和 LSTM 组件具有互补作用。MSCNN 通过在多个感受野尺度上学习表征,提升了空间特征提取能力;而 LSTM 通过捕捉连续帧之间的运动依赖关系,增强了时间建模能力。完整的 MSCNN-LSTM 结构取得了最佳性能,表明多尺度空间特征提取与时间序列建模共同促进了动作识别性能的提升。
总体而言,所提出的MSCNN-LSTM框架有效结合了空间和时间特征表示学习,用于体育视频动作识别。在UCF11、UCF Sports和JHMDB数据集上的评估结果表明,与现有的深度学习方法相比,该框架性能更优。这些结果支持了以下假设:将多尺度卷积特征与基于LSTM的时间建模相结合,能够提升对复杂体育动作的识别能力。然而,仍需在更大规模、更多样化且跨领域的数据集上进行验证,以确立其泛化能力及实际应用价值。
应考虑若干局限性。首先,评估仅限于公开可用的基准数据集,可能无法充分代表现实体育环境的多样性和复杂性。其次,尽管使用了固定的训练、验证和测试划分,仍无法完全排除数据集偏差或意外的数据泄露。第三,报告的性能可能因数据集构成、模型初始化、预处理流程和训练设置的不同而有所变化。此外,多尺度卷积和时序建模组件增加了计算需求,可能影响在资源受限设备上的部署。该框架也未通过外部数据集或实时生产场景进行评估。
基于Transformer的视频模型在大规模动作识别数据集上表现出色,但通常需要大量的计算资源和充足的训练数据。所提出的MSCNN-LSTM框架通过结合多尺度空间特征提取与循环时序建模,提供了一种替代方案。未来的研究应探索跨数据集验证、实时推理、计算优化、不确定性估计,以及将基于Transformer的注意力机制与所提出的多尺度CNN-LSTM框架相结合的混合架构38。
披露
作者声明无利益冲突。
致谢
本研究在马来西亚国民大学信息科学与技术学院人工智能技术中心(CAIT)进行。作者衷心感谢机构提供的支持和研究设施。本工作未获得任何公共、商业或非营利性资助机构的专项资助。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| GeForce RTX 3090 GPU | NVIDIA Corporation | RTX 3090, 24 GB VRAM | 用于深度学习模型的训练与推理 |
| Intel Core i9 处理器 | Intel Corporation | 16 核,3.5 GHz | 用于数据预处理与计算 |
| 系统内存 | Generic | 64 GB DDR4 RAM | 支持大规模视频处理 |
| Python 编程语言 | Python Software Foundation | 版本 3.8.18 | 实现所用的主要编程语言 |
| TensorFlow | 版本 2.15 | 用于模型开发的深度学习框架 | |
| 操作系统 | Microsoft Corporation | Windows 11 | 模型开发与实验 |
| CUDA Toolkit | NVIDIA Corporation | CUDA 11.8 | 模型训练的 GPU 加速 |
| cuDNN | NVIDIA Corporation | cuDNN 8.9.7 | 深度神经网络加速库 |
| OpenCV | Open Source | 版本 4.8.1 | 视频帧提取与预处理 |
| NumPy | Open Source | 版本 1.24.4 | 数值计算与数组处理 |
| Scikit-learn | Open Source | 版本 1.3.2 | 性能评估与统计分析 |
| Matplotlib | Open Source | 版本 3.7.5 | 实验结果可视化 |
| UCF11 数据集 | University of Central Florida | 公开数据集 | 体育动作识别基准数据集 |
| UCF Sports 数据集 | University of Central Florida | 公开数据集 | 体育动作识别基准数据集 |
| JHMDB 数据集 | Max Planck Institute for Informatics | 公开数据集 | 人体运动与动作识别基准数据集 |
参考文献
- Hassan N, Miah ASM, Shin J. A deep bidirectional LSTM model enhanced by transfer-learning-based feature extraction for dynamic human activity recognition. Appl Sci. 2024;14:603. https://doi.org/10.3390/app14020603
- Egawa R, et al. Dynamic fall detection using graph-based spatial temporal convolution and attention network. Electronics. 2023;12:3234. https://doi.org/10.3390/electronics12153234
- Riahi M, Eslami M, Safavi SH, Torkamani Azar F. Human activity recognition using improved dynamic image. IET Image Process. 2020;14:3223–3231. https://doi.org/10.1049/iet-ipr.2020.0372
- Muhammad K, et al. Human action recognition using attention-based LSTM network with dilated CNN features. Future Gener Comput Syst. 2021;125:820–830. https://doi.org/10.1016/j.future.2021.06.017
- Al-Obaidi S, Al-Khafaji H, Abhayaratne C. Making sense of neuromorphic event data for human action recognition. IEEE Access. 2021;9:82686–82700. https://doi.org/10.1109/ACCESS.2021.3085769
- Wensel J, Ullah H, Munir A. ViT-ReT: Vision and recurrent transformer neural networks for human activity recognition in videos. IEEE Access. 2023;11:72227–72249. https://doi.org/10.1109/ACCESS.2023.3293445
- Vrskova R, Hudec R, Kamencay P, Sykora P. Human activity classification using the 3DCNN architecture. Appl Sci. 2022;12:931. https://doi.org/10.3390/app12020931
- Ullah A, et al. Action recognition using optimized deep autoencoder and CNN for surveillance data streams of non-stationary environments. Future Gener Comput Syst. 2019;96:386–397. https://doi.org/10.1016/j.future.2019.01.041
- Jaouedi N, Boujnah N, Bouhlel MS. A new hybrid deep learning model for human action recognition. J King Saud Univ Comput Inf Sci. 2020;32:447–453. https://doi.org/10.1016/j.jksuci.2018.08.001
- Zebhi S, Al-Modarresi SMT, Abootalebi V. Converting video classification problem to image classification with global descriptors and pre-trained network. IET Comput Vis. 2020;14:614–624. https://doi.org/10.1049/iet-cvi.2020.0023
- Cust E, Sweeting AJ, Ball K, Robertson S. Machine and deep learning for sport-specific movement recognition: A systematic review. J Sports Sci. 2019;37:568–600. https://doi.org/10.1080/02640414.2018.1504613
- Cao S, Wang B, Zhang W, Ma L. Visual consensus modeling for video-text retrieval. In Proc AAAI Conf Artif Intell. 2022:167–175. https://doi.org/10.1609/aaai.v36i1.19890
- Yu H, et al. Fine-grained video captioning for sports narrative. In Proc IEEE Conf Comput Vis Pattern Recognit (CVPR). 2018:6006–6015. https://doi.org/10.1109/CVPR.2018.00628
- Browne P, Sweeting AJ, Woods CT, Robertson S. Methodological considerations for furthering the understanding of constraints in applied sports. Sports Med Open. 2021;7:22. https://doi.org/10.1186/s40798-021-00307-9
- Gao T, et al. Sports video classification method based on improved deep learning. Appl Sci. 2024;14:948. https://doi.org/10.3390/app14020948
- Dong Z, Xie M, Li X. Multi-scale receptive fields convolutional network for action recognition. Appl Sci. 2023;13:3403. https://doi.org/10.3390/app13063403
- Liu S, et al. Human memory update strategy: A multi-layer template update mechanism for remote visual monitoring. IEEE Trans Multimed. 2021;23:2188–2198. https://doi.org/10.1109/TMM.2020.3009234
- Liu S, Liu D, Muhammad K, Ding W. Effective template update mechanism in visual tracking with background clutter. Neurocomputing. 2021;458:615–625. https://doi.org/10.1016/j.neucom.2021.05.032
- Haque MN, et al. GRU-based attention mechanism for human activity recognition. In Proc ICASERT. 2019:1–6. https://doi.org/10.1109/ICASERT.2019.8934521
- Al-qaness MA, Dahou A, AbdElaziz M, Helmi A. Multi-ResAtt: Multilevel residual network with attention for human activity recognition using wearable sensors. IEEE Trans Ind Inform. 2022;19:144–152. https://doi.org/10.1109/TII.2022.3147850
- Duan F, et al. A multi-task deep learning approach for sensor-based human activity recognition and segmentation. IEEE Trans Instrum Meas. 2023;72:2514012. https://doi.org/10.1109/TIM.2023.3264512
- Gomes E, et al. Machine learning algorithms for activity-intensity recognition using accelerometer data. Sensors. 2021;21:1214. https://doi.org/10.3390/s21041214
- Su C, et al. A novel model for fall detection and action recognition combining lightweight 3D-CNN and ConvLSTM networks. Pattern Anal Appl. 2024;27:3. https://doi.org/10.1007/s10044-023-01234-5
- Zhou T, et al. Behavior recognition based on improved density clustering and context-guided Bi-LSTM model. Multimed Tools Appl. 2023;82:45471–45488. https://doi.org/10.1007/s11042-023-14678-9
- Shin J, et al. Video-based human activity recognition using hybrid deep learning model. Comput Model Eng Sci. 2025;143:3615. https://doi.org/10.32604/cmes.2025.058341
- Vrskova R, Hudec R, Kamencay P, Sykora P. A new approach for abnormal human activities recognition based on ConvLSTM architecture. Sensors. 2022;22:2946. https://doi.org/10.3390/s22082946
- Vijeikis R, Raudonis V, Dervinis G. Efficient violence detection in surveillance. Sensors. 2022;22:2216. https://doi.org/10.3390/s22062216
- Rendón-Segador F, et al. ViolenceNet: Dense multi-head self-attention with bidirectional ConvLSTM for detecting violence. Electronics. 2021;10:1601. https://doi.org/10.3390/electronics10131601
- Kalfaoglu E, Kalkan S, Alatan A. Late temporal modeling in 3D CNN architectures with BERT for action recognition. In Proc ECCV Workshops. 2020. https://doi.org/10.1007/978-3-030-66823-5_43
- Moaaz M, Mohamed E. Violence detection in surveillance videos using deep learning. Inf Bull Fac Comput Artif Intell. 2020;2:6.
- Song W, et al. Expressive 3D facial animation generation based on local-to-global latent diffusion. IEEE Trans Vis Comput Graph. 2024;30:7397–7407. https://doi.org/10.1109/TVCG.2024.3456213
- Li L, Cherouat A, Snoussi H, Wang T. Grasping with occlusion-aware ally method in complex scenes. IEEE Trans Autom Sci Eng. 2025;22:5944–5954. https://doi.org/10.1109/TASE.2024.3434610
- Li R, et al. UE-Extractor: A grid-to-point ground extraction framework for unstructured environments. IEEE Robot Autom Lett. 2025;10:5991–5998. https://doi.org/10.1109/LRA.2025.3563127
- Jhuang, H., Gall, J., Zuffi, S., Schmid, C., Black, M. J. Towards understanding action recognition. Proceedings of the IEEE International Conference on Computer Vision. 3192–3199, doi:10.1109/ICCV.2013.396 (2013).
- OpenMMLab. MMAction2: JHMDB dataset preparation. GitHub. https://github.com/open-mmlab/mmaction2/tree/main/tools/data/jhmdb (2026).
- Ullah W, Khalid YN, Khan SH. A novel deep hybrid framework with ensemble-based feature optimization for HAR. arXiv preprint arXiv:2508.18695. 2025. https://arxiv.org/abs/2508.18695
- Karuppannan K, Darmanayagam SE, Cyril SR. Human action recognition using fusion-based discriminative features and LSTM classification. Concurr Comput Pract Exp. 2022;34:e7250. https://doi.org/10.1002/cpe.7250
- Sahoo SP, et al. HAR-depth: A novel framework for human action recognition using sequential learning and depth estimated history images. IEEE Trans Emerg Top Comput Intell. 2020;5:813–825. https://doi.org/10.1109/TETCI.2020.3006543