本研究提出了一种算法,该算法将移窗分层变换器编码器捕获的分层视觉特征与通过线段检测生成的曼哈顿式三维边界框的先验深度紧密耦合,从而实现对复杂室内场景的高精度语义重建。
需要JoVE订阅才能观看此内容。 请登录或开始免费试用
本文内容
摘要
摘要
为解决复杂室内场景中因家具遮挡导致的语义预测不连续性和物理边界形变问题,本文提出一种利用建筑结构先验的语义解析方法。该方案采用移窗式分层 Transformer 编码器提取多尺度视觉特征,并结合梯度方向一致性线段检测算法构建曼哈顿三维边界框。该边界框在编码离散几何轮廓为连续物理势场之前,被转换为有符号距离场(SDF)先验。一种结构引导的交叉注意力机制强制视觉信号与真实的三维正交几何边界对齐,从而恢复遮挡区域内的特征连续性。由超像素节点构建的空间邻接图驱动图卷积网络(GCN)进行特征聚合,确保物理承重平面内的宏观语义一致性。像素级交叉熵损失与自定义的结构一致性损失相结合,增强了约束条件,对越界预测施加惩罚。多次独立实验结果表明,平均交并比(mIoU)达到 68.7%,标准差为 0.2%;结构边界 F1 分数达到 76.4%,标准差为 0.3%,验证了所提出模块的鲁棒性能。在单个图像节点尺寸为 256 的情况下,平均推理时间保持在 61 ms。
引言
室内场景图像的语义分析在三维空间认知与智能空间推理任务中占据核心地位1,2。在真实物理环境中,复杂的空间布局常常严重阻碍视觉特征的提取3。解决由大尺度家具遮挡引起的建筑基础结构的语义不连续性和物理边界畸变问题,对空间认知研究具有重要意义4,5。准确消除杂乱物体的干扰,恢复同一墙面和地面的物理连续性,将直接决定三维场景重建与全局空间逻辑分析的准确性6。由大尺度家具遮挡引起的语义不连续性以及所提出的建筑先验引导的结构修复效果如图1所示,其中在相同室内场景条件下,对表1A中的被遮挡红绿蓝(RGB)输入、图1B中的基线掩码畸变以及图1C中的结构先验修复结果进行了对比。
为了满足空间逻辑推理的精度要求,当前主流的像素驱动视觉网络在处理复杂室内环境时面临多重障碍7,8。室内空间通常布满密集的家具和杂乱的陈设,导致图像中低层视觉边界信号显著丢失9。传统的特征提取机制过度依赖局部二维颜色和纹理响应,缺乏对三维人造结构刚性正交规律的宏观理解10。局部感受野的这一局限性使得特征传播容易中断,难以跨越遮挡区域扩展全局拓扑结构11。目前迫切需要解决由遮挡和干扰引起的语义预测不连续以及物理边界严重畸变这一核心问题12。
为解决由遮挡和干扰引起的建筑地基结构缺陷问题,学术界已开发出多种针对性的干预措施13。跨模态特征聚合网络通过引入深度图或文本先验信息辅助红绿蓝(RGB)图像,有效弥补单一视觉模态在空间感知上的固有缺陷14,15。边界感知与自适应上下文选择框架将物理轮廓增强策略注入特征解码阶段,显著提升了复杂场景下预测结果的边缘贴合度16,17。基于图卷积网络(GCN)和特征交互机制的推理模型通过构建节点级连接,显著提高了同质区域内的特征平滑性和宏观语义一致性18,19。将显式的曼哈顿结构先验整合到视觉特征提取流程中,可强加几何一致性约束,从而应对大面积前景物体遮挡所导致的特征不连续性挑战20。
为解决与建筑基础设施相关的语义预测错误及物理边界严重失真这一核心难题,本文提出一种基于闭环耦合机制并融合建筑先验的语义解析框架。该框架通过在连续几何势场与离散视觉特征流形之间建立双向映射对齐关系,突破了传统工程化流程的局限,形成一种非平凡的协同机制,利用结构规律校正遮挡误差。该方案依赖多尺度视觉骨干网络和基于消失点估计的线段检测算法,以并行方式获取局部外观特征和代表曼哈顿式三维边界框的正交边缘先验,并将其转换为符号距离场(SDF)。算法采用结构引导的交叉注意力机制,将视觉特征作为查询向量,将SDF特征作为键和值进行点积计算,从而迫使视觉信号在特征空间中与真实的三维几何边界对齐。由超像素节点及空间共面性边特征构建的空间邻接图被输入图卷积网络(GCN),以实现跨节点的特征聚合与消息传递。端到端的参数优化过程联合采用像素级交叉熵损失和一种自定义的结构一致性损失函数,严格约束并惩罚跨越建筑先验边界的预测像素。完整的语义解析流程在图2中进行了总结,该图展示了RGB图像输入、几何先验提取、交叉注意力对齐、超像素图推理与语义掩码解码在统一架构内的关联关系。
早期的场景解析网络依赖卷积操作来捕捉局部外观纹理,但由于局部感受野的限制,其在大规模目标上的语义一致性表现不足21,22。先前的研究已将视觉Transformer架构中的自注意力模块应用于提取全局上下文信息,并构建像素间的长距离关联特征23,24。跨模态多视角特征聚合策略通过融合深度图点云和文本指令输入,提取场景的三维几何空间特征25,26。面向特定领域的特征融合混合注意力机制逐渐成熟,通过构建特征交互桥梁,显著降低了视觉信号在多尺度传输过程中的能量损耗与特征稀疏性,提升了复杂结构解析的鲁棒性。前沿的编码器设计联合整合并推理高频域空间细节与全局及局部特征,增强了网络对高相似性细粒度语义类别的区分能力,提高了室内场景解析的准确性27,28。近年来语义分割架构的进展为优化计算效率和空间感知能力提供了有价值的参考。针对密集预测和多尺度上下文聚合设计的模型能够从复杂背景中提取细粒度几何特征。特征解耦与协同融合策略有效缓解了边界区域的语义模糊问题。轻量化注意力机制与门控聚合模块优化了参数分布,在保留局部结构细节的同时加快了推理速度。实施这些高效架构设计为降低室内场景解析中非欧几里得拓扑推理操作的计算开销提供了理论指导。
构建结构先验和三维布局估计被用于校正局部视觉解析错误29。以往研究提取室内建筑的正交和平行几何特征作为推理约束,以减少因杂乱的室内背景导致的网络预测偏差30,31。现有方案采用线段检测算法和图像消融点分析技术生成曼哈顿三维边界框,以映射房间的物理边界,并辅助底层视觉特征的定位32。边界感知模块与多尺度上下文的联合架构将先验结构信息隐式嵌入高维特征解码过程,迫使网络输出与真实物理轮廓高度吻合的语义掩码,有效改善物体边缘的锯齿状和模糊问题33。具有边界增强特性的半监督或弱监督损失函数设计已被广泛研究。通过依赖严格的数学公式惩罚违反空间拓扑规则的独立像素分类行为,从梯度优化源头保障最终分割结果的几何平滑性和结构完整性34。
一些研究采用图神经网络在高维空间中对视觉特征进行跨域聚合,并推理拓扑关系35。超像素分割算法将具有相似颜色响应和纹理特征的相邻像素块预先聚合为独立的连通节点。该超像素分割算法在图像层面压缩了图结构的计算冗余,同时保留了图像的基本几何拓扑结构36。基于高维节点特征向量构建的图卷积网络(GCN),利用表示空间邻近性的邻接矩阵,驱动多尺度视觉信息在空间域中沿物理连接图进行高效的方向性传输与交互融合37,38。时间信息增强模块与混合多尺度跳跃连接机制的应用,抑制了在多层深度消息传递过程中产生的节点特征过度平滑与均质化现象39。多尺度图小波变换技术及伪标签元素学习优化策略,优化了节点特征更新公式中的抗背景噪声机制,使具有相同语义属性的特征在复杂网络拓扑中保持协同响应模式40。基于图的推理机制将规则像素网格映射到非欧几里得拓扑空间,以实现对不规则建筑结构及内部构件的特征聚合计算41。
访问受限。请登录或开始试用以查看此内容。
方案
在网络训练开始前,已准备好室内RGB场景数据集及其语义标注。大规模室内3D数据集和RGB-D室内场景数据集(参见材料表)均从其官方存储库获取。为匹配目标解析场景,保留了包含家具遮挡、光照变化、墙体边界中断及复杂空间布局的室内采集场景。语义标签被转换为索引化的单通道PNG标注掩码,所有RGB图像和语义掩码均调整至512 × 512像素尺寸。训练期间应用了在线数据增强,包括概率为0.5的随机水平翻转、0.8至1.2之间的随机亮度缩放以及-10°至+10°之间的随机旋转,以拓宽结构布局分布。RGB通道使用均值0.485、0.456、0.406和标准差0.229、0.224、0.225进行归一化处理。大规模室内3D基准遵循本研究采用的官方发布划分,使用1201个训练场景和312个验证场景进行模型开发与验证。RGB-D室内场景基准遵循官方评估协议,包含795张训练图像和654张测试图像。未对这两个公开基准进行额外的百分比划分。
采用一个移位窗口分层 Transformer 视觉骨干网络(参见材料表)作为移动窗口 Transformer 编码器骨干进行初始化。补丁嵌入尺寸配置为 4 x 4 像素。四个分层阶段的嵌入维度分别设置为 128、256、512 和 1024,四个阶段中的 Transformer 块数量设置为 2、2、18 和 2。局部注意力窗口大小设置为 7 x 7,四个分层阶段的注意力头数量分别设置为 4、8、16 和 32。所有多层感知器层内部均使用非线性连续激活函数。在每个分层阶段之后,通过步长为 2 的补丁合并操作进行空间下采样。核心网络架构和卷积推理模块的超参数总结于表 1中。
随后对输入特征图执行移位窗口自注意力特征提取。每个特征图被划分为空间尺寸为 7 × 7 的非重叠局部窗口。规则窗口注意力与移位窗口注意力在相邻的移位窗口变换器块之间交替进行。循环移位距离设置为 3 像素,并在每个局部注意力窗口内应用相对位置偏置编码。通过多头自注意力聚合局部视觉特征,以生成层次化的多尺度特征表示。
曼哈顿结构先验信息从室内 RGB 图像中提取。结构边缘线段采用梯度方向一致性线段检测算法进行检测。主导结构方向通过基于消失点估计的随机抽样一致(RANSAC)算法(参见材料表)进行聚类。重建三个相互正交的曼哈顿方向,以生成曼哈顿三维边界框表示。通过计算每个像素到最近边界线段的最小欧几里得距离,将重建的结构边界转换为符号距离函数(SDF)图。
在获得视觉特征与符号距离函数先验后,生成了结构引导的交叉注意力特征。视觉特征流形通过线性变换矩阵 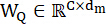 映射为查询张量 Q。连续距离场先验通过变换矩阵
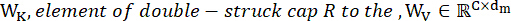 映射为键张量 K 与值张量 V,模型维度设置为 512。多头调制将投影空间划分为 8 个独立的子空间,每个头的维度为 64。空间布局先验将离散像素坐标投影至连续势场,并生成结构亲和矩阵 S 作为显式加性空间偏置,用于调制点积相似度矩阵。选择视觉特征张量作为查询源,是因为语义解析要求每个视觉位置主动从几何先验空间中检索结构一致的证据。符号距离函数先验被用作键和值源,因为它存储了源自曼哈顿布局的连续边界距离与内外结构线索。点积项度量了语义外观与几何先验之间的兼容性,而加性结构项 λS 则将注意力权重向同一物理平面或邻近同一建筑轮廓的像素偏移。系数 λ 表示对提取的结构先验的置信度,并控制刚性正交约束被纳入注意力分布的程度。此公式减少了由家具遮挡引起的跨边界特征扩散,并在非曼哈顿布局中保留了自适应松弛。结构引导的注意力分布根据公式 1 计算。
公式 1: 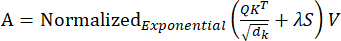
其中 A 表示结构引导的注意力聚合矩阵,Q 表示由视觉特征生成的查询张量,K 表示由 SDF 先验特征生成的键张量,V 表示由结构先验表示生成的值张量,dk 表示键张量的特征维度,λ 表示用于识别局部区域几何置信度并在非曼哈顿空间布局中放宽刚性正交约束的自适应结构加权系数,S 表示 SDF 亲和矩阵。除以 dk 的操作稳定了注意力逻辑值的尺度,防止了因特征维度较大而产生过度集中的注意力权重。归一化指数函数(参见材料表)将调制后的相似性分数转换为归一化的空间分布,使得每个像素能够基于语义和几何一致性聚合结构先验信息。这一设计解释了为何视觉外观和建筑边界先验是在注意力层面融合,而非通过直接的特征拼接。
超像素拓扑图由结构对齐的特征图构建而成。特征图使用空间区域生成算法进行分割。超像素数量设置为256,紧凑度系数设置为10,高斯平滑系数设置为1.0,迭代次数设置为10。在聚类过程中,通过将距离度量权重设置为特征颜色空间距离的恒定比例1.0来强制执行空间邻近约束,从而在密集杂波边界上保持均匀的节点生成。具有同质语义响应的像素被聚合成超像素节点。图边根据空间邻接关系、SDF亲和力强度以及共面几何一致性约束构建。结构亲和矩阵和拓扑连通性的构建过程如图3所示,展示了SDF引导如何转化为图级别的空间关系。
图结构表述的引入,旨在将密集的像素级推理转化为在均匀结构区域上进行节点级空间推理。每个超像素节点代表一个具有相似语义响应和空间连续性的局部区域,而每条边则代表一条受邻接性、距离场亲和性和共面一致性约束的特征传输可靠路径。该设计减少了孤立噪声像素的影响,并使被遮挡的墙壁、地板和天花板区域能够接收来自物理相邻节点的信息。因此,边的构建充当了连续符号距离场引导与离散非欧几里得图推理之间的数学桥梁。
配置了一个具有512、256和128隐藏特征维度的三层图卷积推理网络。图卷积层基于节点的空间关系在图结构上执行特征平滑。自循环邻接在消息传递过程中保留了每个节点的原始状态,防止小结构区域的特征被周围大区域抹除。对称归一化通过节点度数的逆平方根乘积来缩放邻接矩阵元素,使得在传播过程中,高度数节点和低度数节点在可比的数值量级下做出贡献。前向传播执行局部空间聚合,其中每个节点状态在应用逐元素非线性整流函数之前,从相邻的共面聚类吸收高维特征。这种表述使得图卷积层近似于沿着具有物理意义的室内平面进行语义扩散,而非跨无关物体边界进行无限制的平滑。图节点特征根据公式2进行评估。
公式 2: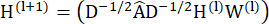
从密集像素特征到超像素节点的投影、图卷积消息传递以及坐标反投影过程如图4所示,阐明了从规则图像网格到非欧几里得拓扑结构,再返回到密集语义表示的特征聚合路径。图4A中的密集像素特征到图4B中超像素节点的投影、图4C中的图卷积消息传递以及图4D中的坐标反投影,共同阐明了从规则图像网格到非欧几里得拓扑结构,再返回到密集语义表示的特征聚合路径。
其中 H(l) 表示第 l 个图卷积层的节点特征张量, 表示带自环连接的邻接矩阵,D 表示对应于邻接矩阵的度矩阵,W(l) 表示第 l 个图卷积层的可学习权重矩阵,σ 表示修正线性单元激活函数。项 ÂH(l) 聚合了来自相邻超像素节点的特征,而 D−1/2 和 D−1/2 则平衡了具有不同连接密度的节点的贡献。可学习矩阵 W(l) 将聚合后的节点特征投影到一个新的语义空间,使得图卷积层能够区分结构一致性与普通的空间邻近性。非线性激活保留了特征聚合后共面区域与非共面区域在响应上的差异。
语义分割特征在图推理后进行解码。解码器采用三个双线性插值上采样阶段和跨层跳跃连接融合操作构建。浅层空间编码器特征通过通道级融合与高层语义解码器特征拼接。特征分辨率恢复至原始图像尺寸,最终通过 1 × 1 卷积层生成语义概率预测图。
完整的语义解析网络使用解耦权重衰减优化器进行训练(参见材料表)。初始学习率设置为0.0001,权重衰减系数为0.01,两个公共基准测试的批次大小均为8。一阶矩衰减率设置为0.9,二阶矩衰减率设置为0.999,数值稳定性epsilon系数设置为1 × 10⁻8。在每个训练周期结束时监控验证损失,并在验证集上的mIoU提高时保存检查点。网络使用多项式学习率衰减策略训练了300个周期,衰减幂为0.9。使用不同的随机种子初始化进行了五次独立训练运行,以建立统计上严谨的评估基线。网络使用像素级交叉熵损失和结构一致性损失联合优化。所有实验均在配备高内存并行计算硬件的计算平台上进行,详细的硬件信息记录在材料表中。
通过计算类别概率张量的空间梯度幅度,联合优化强制了几何边界对齐。结构一致性损失被用作正则化项,将空间预测梯度的范数与连续符号距离函数值相乘。其数学原理是,语义类别变化应集中在接近真实建筑轮廓处,即符号距离函数趋近于零的位置,而平坦的墙壁、地板和天花板内部则应保持平滑的语义响应。当大的预测梯度出现在远离结构边界处时,距离场项会增加惩罚,以抑制同质物理平面内部错误的语义转换。当预测梯度出现在接近零距离轮廓处时,惩罚保持有限,从而保留沿建筑边界的合法类别转换。语义转换区域被约束为与符号距离函数的零距离轮廓对齐,如公式3所示。
公式 3: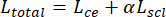
其中 Ltotal 表示最终优化目标函数,Lce 表示像素级交叉熵损失,Lscl 表示结构一致性惩罚损失,α 表示结构损失权重系数。交叉熵项通过标注掩码提供像素级语义监督,而结构一致性项则利用建筑先验施加几何正则化。权重系数 α 平衡了类别识别与边界对齐,防止优化过程过度拟合局部标签准确性或僵化的结构轮廓。这一联合目标将视觉语义、物理边界一致性与可训练网络参数统一在一个优化目标内。
访问受限。请登录或开始试用以查看此内容。
结果
实验设置
本研究采用两个标准的室内场景解析数据集、一个大规模室内三维数据集和一个RGB-D室内场景数据集,用于评估模型性能并进行调优。大规模室内三维数据集包含经过真实扫描获得的复杂物理空间场景以及高分辨率的RGB视图,提供了高精度的逐像素三维点云语义标签和二维空间投影分割掩码。其内在的真实物理空间网格重建数据和正交平面特性为提取分支中曼哈顿三维边界框的精确构建建立了几何真值比较标准。RGB-D室内场景数据集包含被家具和杂乱物体遮挡的室内深度图像,用于测试网络在全局逻辑推理方面的准确性和对遮挡的鲁棒性。
该算法采用 mIoU 来衡量预测语义分布与真实语义分布之间的空间重叠程度,同时引入结构边界 F1 分数,以严格评估预测掩码与通过符号距离函数(SDF)校准的零距离物理结构边缘之间的拟合精度。在计算过程中设定了固定的欧几里得空间像素距离误差阈值,用于判断网络生成的边缘像素是否与建筑物的真实物理边界轮廓相交。这一双重评估体系在约束大面积语义块分类误差的同时,强化了对刚性线条拓扑重建效果的微观定量评估...
访问受限。请登录或开始试用以查看此内容。
讨论
本文的算法将移窗式分层变换器编码器捕获的分层视觉特征与通过线段检测生成的曼哈顿式三维边界框的先验深度紧密耦合,从而实现了对复杂室内场景的高精度语义重建。一种结构引导的交叉注意力机制迫使视觉信号与由符号距离场(SDF)校准的真实几何边界对齐,从而恢复局部遮挡区域中低层特征的连续性42。通过迭代局部聚类算法生成的超像素节点构建拓扑图,驱动图卷积网络(GCN)在物理共面约束下进行特征聚合,确保宏观语义分布的一致性43。实验结果表明,该方法在256个超像素节点配置下的平均交并比达到68.7%,标准差为0.2%;结构边界F1分数为76.4%,标准差为0.3%;平均推理时间为61 ms,反映出在边界重建精度与最终推理效率之间进行了有意识的权衡44。鲁棒性测试进一步表明,该模型在大规模视觉信号丢失的极端条件下仍表现出强大的拓扑修复能力。通过引入结构一致性损失,提升了预测掩码与SDF校准的零距离物理边界之间的对齐精度,实现了计算复杂度与解析质量的协同优化45。该方...
访问受限。请登录或开始试用以查看此内容。
披露
作者声明不存在经济利益冲突。
致谢
基金项目:陕西省重点研发计划(项目编号:2024CY2-GJHX-76)。
访问受限。请登录或开始试用以查看此内容。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| AdamW 优化器 | PyTorch Contributors | https://pytorch.org/ | |
| CCANet | Zihao Z. 等 | https://doi.org/10.1109/TCDS.2024.3455356 | |
| CMPFFNet | Zhou W. 等 | https://doi.org/10.1109/TASE.2023.3332021 | |
| ConvNeXt | Meta AI Research | https://github.com/facebookresearch/ConvNeXt | |
| InternImage | OpenGVLab | https://github.com/OpenGVLab/InternImage | |
| Mask2Former | Meta AI Research | https://github.com/facebookresearch/Mask2Former | |
| MaskDINO | IDEA-Research | https://github.com/IDEA-Research/MaskDINO | |
| NYUv2 | http://cs.nyu.edu/~silberman/datasets/nyu_depth_v2.html | ||
| OneFormer | SHI Labs | https://github.com/SHI-Labs/OneFormer | |
| RANSAC 算法 | scikit-learn 开发者 | https://scikit-learn.org/ | |
| ScanNet V2 | http://www.scan-net.org/ | ||
| SegFormer | NVIDIA | https://github.com/NVlabs/SegFormer | |
| SGCA_GCN | 本研究作者 | 提出的方法(无) | |
| Softmax 函数 | PyTorch Contributors | https://pytorch.org/ | |
| Swin Transformer | Microsoft Research | https://github.com/microsoft/Swin-Transformer |
参考文献
- Zhang Z et al. CCANet: cross-modality comprehensive feature aggregation network for indoor scene semantic segmentation. IEEE Trans Cogn Dev Syst. 2024;17:366–378.
- Cui Y et al. Improving the segmentation of confusable indoor structures using point convolution and sparse vector attention. Geospat Inf Sci. 2025:1–22.
- Yang L, Cai H. Cost-efficient image semantic segmentation for indoor scene understanding using weakly supervised learning and BIM. J Comput Civ Eng. 2023;37:04022062–04022082.
- Uckan T, Aslan C, Hark C. A comprehensive hybrid approach for indoor scene recognition combining CNNs and text-based features. Sensors. 2025;25(17):5350. doi:10.3390/s25175350.
- Sun R et al. Training indoor and scene-specific semantic segmentation models to assist blind and low-vision users in activities of daily living. IEEE Open J Eng Med Biol. 2025;6:533–539.
- Ye S, Hu Y, Lin M. Indoor scene reconstruction with fine-grained details using hybrid representation and normal prior enhancement. IEEE Trans Vis Comput Graph. 2024;31:5275–5287.
- Naseer A et al. Multimodal scene recognition using semantic segmentation and deep learning integration. PeerJ Comput Sci. 2025;11. doi:10.7717/peerj-cs.2858.
- Bae JH, Yu GH, Lee JH. Superpixel image classification with graph convolutional neural networks based on learnable positional embedding. Appl Sci. 2022;12:9176–9190.
- Zhang H, Zou J, Zhang L. EMS-GCN: an end-to-end mixhop superpixel-based graph convolutional network for hyperspectral image classification. IEEE Trans Geosci Remote Sens. 2022;60:1–16.
- Mu Y, Ou L, Chen W. Superpixel-based graph convolutional network for UAV forest fire image segmentation. Drones. 2024;8:142–158.
- Khatun Z, Jonsson H Jr, Tsirilaki M. Beyond pixel: superpixel-based MRI segmentation through traditional machine learning and graph convolutional network. Comput Methods Programs Biomed. 2024;256:108398–108412.
- Yongyin L, Caixia Y. Cross-attention swin transformer for detailed segmentation of ancient architectural color patterns. Front Neurorobot. 2024;18:1513488–1513508.
- Zhou X, Zhou L, Gong S. Swin transformer embedding dual stream for semantic segmentation of remote sensing imagery. IEEE J Sel Top Appl Earth Obs Remote Sens. 2023;17:175–189.
- Ning X, Jiang L, Li W. Swin-MGNet: swin transformer-based multiview grouping network for 3D object recognition. IEEE Trans Artif Intell. 2024;6:747–758.
- Ke A, Luo J, Cai B. UNet-like network fused swin transformer and CNN for semantic image synthesis. Sci Rep. 2024;14:16761–16779.
- Li Y et al. IED-GCN: an internal and external decoupled graph convolutional network for landslide susceptibility assessment. IEEE Trans Geosci Remote Sens. 2025;63:1–17.
- He T, Chen J. DC-GCN: a lightweight graph convolutional network integrating local and global context for semantic segmentation. IEEE J Sel Top Appl Earth Obs Remote Sens. 2025;18:28283–28299. doi:10.1109/JSTARS.2025.3626006.
- Imani M. Superpixel-based graph convolutional neural network for polarimetric synthetic aperture radar image classification. Sci Rep. 2026;16:4736. doi:10.1038/s41598-025-34965-6.
- Wang S, Feng S, Wang Z. Structural prior-guided and feature-enhanced transformer with masked image modeling pretraining for retinal layers and fluid segmentation in macular edema OCT images. Biomed Opt Express. 2025;16:5096–5117.
- Yuan Z et al. Structure-aware progressive multimodal fusion network for RGB-T crack segmentation. J Imaging. 2025;11(11):384. doi:10.3390/jimaging11110384.
- Xu S, Shen R, Liu E. A structure-prior-guided adaptive context selection network for remote sensing semantic segmentation. Electron Lett. 2025;61. doi:10.1049/ell2.70161.
- Minaee S, Boykov Y, Porikli F. Image segmentation using deep learning: a survey. IEEE Trans Pattern Anal Mach Intell. 2021;44:3523–3542.
- Zhou E, Murray AT, Baik J. Mapping 3D classroom seats based on partial object point cloud completion. Cartogr Geogr Inf Sci. 2024;51:404–420.
- Nishi T, Kawasaki S, Iewaki K. M3R-CNN: on effective multimodal fusion of RGB and depth cues for instance segmentation in bin picking. Adv Robot. 2023;37:1143–1157.
- Zhou W, Xiao Y, Yan W. CMPFFNet: cross-modal and progressive feature fusion network for RGB-D indoor scene semantic segmentation. IEEE Trans Autom Sci Eng. 2023;21:5523–5533.
- Zhou W, Xiao Y, Liu Y. FIMKD: feature implicit mapping knowledge distillation for RGB-D indoor scene semantic segmentation. IEEE Trans Artif Intell. 2024;5:6488–6499.
- Liu J, Jiang Z, Xu X. Multi-robot collaborative complex indoor scene segmentation via multiplex interactive learning. CAAI Trans Intell Technol. 2025;10:1646–1660.
- Zhang S, Xie M. MIPANet: optimizing RGB-D semantic segmentation through multimodal interaction and pooling attention. Front Phys. 2024;12:1411559–1411572.
- Li JW et al. Construction of a multiscale feature fusion model for indoor scene recognition and semantic segmentation. Sci Rep. 2025;15:14701. doi:10.1038/s41598-025-95465-1.
- Liang X et al. Indoor building structure segmentation in unorganized point clouds based on corner feature. Eng Constr Archit Manag. 2025. doi:10.1108/ECAM-10-2024-1433.
- Wu LF, Wei D, Xu CA. CFANet: the cross-modal fusion attention network for indoor RGB-D semantic segmentation. J Imaging. 2025;11(6):177. doi:10.3390/jimaging11060177.
- Fan L, Zhou Y, Liu H. Combining swin transformer with UNet for remote sensing image semantic segmentation. IEEE Trans Geosci Remote Sens. 2023;61:1–11.
- Wang Z, Liao Z, Zhou B. SwinURNet: hybrid transformer-CNN architecture for real-time unstructured road segmentation. IEEE Trans Instrum Meas. 2024;73:1–16.
- Zhang H et al. Frequency-domain-guided swin transformer and global-local feature integration for remote sensing images semantic segmentation. IEEE Trans Geosci Remote Sens. 2025;63:5612611. doi:10.1109/TGRS.2025.3535724.
- Li GY, Chen J, Jang SI. SwinCross: cross-modal swin transformer for head and neck tumor segmentation in PET-CT images. Med Phys. 2024;51:2096–2107.
- Tang Y, Hu X, Ke T. Semantic segmentation of high-resolution remote sensing imagery via an end-to-end graph attention network with superpixel embedding. IEEE J Sel Top Appl Earth Obs Remote Sens. 2025;18:7236–7252.
- Wang R, Nie Y, Geng J. Multiscale superpixel-guided weighted graph convolutional network for polarimetric SAR image classification. IEEE J Sel Top Appl Earth Obs Remote Sens. 2024;17:3727–3741.
- Li S, Wu K, Liu H. Hyperspectral image classification based on multiscale feature search graph convolutional network with meta pseudo-labels. IEEE J Sel Top Appl Earth Obs Remote Sens. 2025;18:23485–23504.
- Yang B, Cheng X, Guo J. Temporal information-enhanced graph convolutional network with superpixel-pixel gated knowledge dynamic selection for change detection in satellite time series. IEEE J Sel Top Appl Earth Obs Remote Sens. 2024;17:18399–18412.
- Zhang H, Ku J, Zhao J. Multi-scale graph wavelet convolutional network for hyperspectral image classification. Front Remote Sens. 2025;6:1637820. doi:10.3389/frsen.2025.1637820.
- Zhou Q, Wang L, Gao G. Boundary-guided lightweight semantic segmentation with multiscale semantic context. IEEE Trans Multimedia. 2024;26:7887–7900.
- Xu X, Yen GG, Zhao C. Boundary-based active domain adaptation for semantic segmentation under adverse conditions. IEEE Trans Neural Netw Learn Syst. 2025;36:14721–14734.
- Tang Y, Feng S, Zhao C. A semantic change detection network based on boundary detection and task interaction for high-resolution remote sensing images. IEEE Trans Neural Netw Learn Syst. 2025;36:17184–17198.
- Guan L, Yuan X. Dynamic weighting and boundary-aware active domain adaptation for semantic segmentation in autonomous driving environment. IEEE Trans Intell Transp Syst. 2024;25:18461–18471.
- Fenglei W, Xin G, Zongze Z. A boundary-enhanced semantic segmentation model for buildings. IEEE J Sel Top Appl Earth Obs Remote Sens. 2025;18:5733–5748.
- Shan K, Tan L, Li Y, Jia T. Multi-scale boundary-aware network for remote sensing image semantic segmentation. Sci Rep. 2026;16:3797. doi:10.1038/s41598-025-33943-2.
- Wu D, Guo Z, Li A. Conditional boundary loss for semantic segmentation. IEEE Trans Image Process. 2023;32:3717–3731.
- Li Y, Zhang C, Wang H. Boundaries matter: a novel multibranch semisupervised semantic segmentation method. IEEE Intell Syst. 2024;40:35–44.
- Wang JQ, Chen T, Zheng L. A multiscale remote sensing semantic segmentation model with boundary enhancement based on UNetFormer. Sci Rep. 2025;15:14737. doi:10.1038/s41598-025-99663-9.
- Jung H, Choi HS, Kang M. Boundary enhancement semantic segmentation for building extraction from remote sensed image. IEEE Trans Geosci Remote Sens. 2021;60:1–12.
访问受限。请登录或开始试用以查看此内容。