本方案描述了一个可互操作的网络平台的实施方法,该平台将基于FHIR的临床数据与检索增强生成(Retrieval-Augmented Generation)及多智能体大语言模型相结合,用于临床决策支持。该工作流程支持人工智能(AI)辅助医学数据分析的可重复部署、标准化数据整合与评估。
需要JoVE订阅才能观看此内容。 请登录或开始免费试用
本文内容
摘要
摘要
临床决策常常受到碎片化的电子健康记录以及异构医疗信息系统之间互操作性有限的阻碍。本文介绍了一种分步实施协议,用于构建一个可互操作的网络平台,该平台通过快速医疗互操作性资源(Fast Healthcare Interoperability Resources, FHIR)标准整合临床数据,并结合检索增强生成(Retrieval-Augmented Generation, RAG)、大语言模型(Large Language Models, LLMs)以及多智能体临床推理框架,以支持医学数据分析和临床决策支持。该协议详细描述了完整的操作流程,包括计算环境配置、临床数据集预处理、基于FHIR的数据整合、向量数据库构建、检索配置、提示工程、多智能体协调以及系统评估。代表性结果表明,该平台能够生成具有临床相关性和上下文一致性的响应,同时提升异构数据源之间的语义互操作性。系统性能通过互补的定量与语义指标进行评估,包括BLEU、ROUGE、BERTScore和余弦相似度。采用公开可用的完全匿名化基准医疗数据集进行了定性评估,以检验所提出方法学流程的可重复性。所提出的架构将标准化的医疗互操作性与检索增强型语言模型相结合,以提升上下文推理能力、减少幻觉现象,并支持可重复的人工智能辅助临床工作流。本协议为研究人员和开发者提供了一个可扩展且可重复的框架,适用于构建可互操作、注重隐私保护且智能化的医疗系统,用于临床决策支持、医学数据分析以及未来的转化研究。
引言
医院、诊断中心、实验室和门诊诊所 routinely 生成健康信息,这些信息通常分散在异构的信息系统中。这种碎片化限制了互操作性,阻碍了对全面患者记录的及时访问,为临床诊疗、数据整合和医疗管理带来了持续的挑战1,2,3,4。
这种碎片化在依赖及时获取患者信息的临床工作流程中尤为明显。当医疗专业人员无法调取完整且整合的病历记录时,临床评估将变得更加困难,从而增加决策不完整的风险,并降低医疗服务的效率,尤其是在急诊环境中5,6。
人工智能(AI)尤其是大语言模型(LLMs)的最新进展,拓展了可用于医疗健康领域的计算方法范围。这些模型已在诊断辅助、临床分诊和决策支持等任务中得到研究。例如,Jahan 等人5评估了大语言模型在生物医学任务中的应用,而 Taylor 等人7则研究了针对数字心理健康筛查进行微调的模型,在特定临床环境中报告了令人鼓舞的结果。
大型语言模型的应用还扩展到了更专业的临床领域。Song 等人49探讨了其在尘肺病诊断中的应用,而 Chien 等人8则将这些模型用于分析非正式照护者的工作负荷模式。在眼科领域,Xue 等人9提出了一种用于青光眼诊断的问答系统,而 Tan 等人3 和 Wu 等人10则报道了大型语言模型在混合诊断系统和中医咨询中的应用。
大型语言模型(LLM)的应用不仅限于直接的临床应用。Zhang 等人11研究了其在心理健康场景中用于情绪识别的应用,而 Sarzaeim 等人12则探索了可能有助于公共卫生相关分析的智能警务系统。这些研究展示了基于大型语言模型的方法在不同医疗健康相关领域的广泛应用前景。
尽管大语言模型(LLMs)拓展了医疗保健应用的可能性,但其在临床环境中的整合仍面临重要的技术、组织和监管挑战。实际部署需要适当的计算基础设施、有效的数据治理,以及符合《通用数据保护条例》(GDPR)和《巴西通用数据保护法》(LGPD)等监管框架的要求。这些框架对敏感健康信息的安全和伦理处理提出了要求,同时应对人工智能辅助医疗系统中的隐私、可靠性及算法偏见等问题13,14。
在包括电子健康记录(EHR)、医学影像系统和物联网(IoT)设备在内的异构医疗数据源之间实现互操作性,仍然是人工智能辅助医疗解决方案部署中面临的一项重大技术挑战。在此背景下,HL7 FHIR 等标准化互操作性框架为在不同系统之间交换临床信息提供了结构化机制,同时保持语义一致性并支持可扩展的集成。
本研究展示了一个可互操作的网络平台,该平台将大语言模型与医疗健康互操作性标准相结合,以支持异构临床环境中的医学数据分析。所提出的架构结合了基于HL7 FHIR的数据集成、检索增强生成(RAG)技术以及多智能体处理框架,在提供上下文感知的人工智能辅助分析的同时,确保符合相关的数据保护要求,包括巴西通用数据保护法(LGPD)。
本方案描述了一种基于既定医疗健康互操作性标准的互操作架构,用于整合异构的临床数据。同时详细介绍了基于大语言模型和小语言模型(LLMs 和 SLMs)构建的多智能体处理流程,以及一个结合定量指标与定性分析的评估框架,用于评估所提出平台的行为表现。
访问受限。请登录或开始试用以查看此内容。
方案
本研究未涉及人类受试者的招募、可识别患者记录的访问,或涉及动物的实验。该方案的开发与评估完全基于公开且完全匿名的数据集,用于方法学验证。未访问或处理任何个人健康信息。因此,无需获得机构审查委员会(IRB)或研究伦理委员会的批准。该方案的制定遵循了适用的数据保护原则,包括巴西通用数据保护法(LGPD),以支持未来涉及临床数据的应用。
数据集选择与预处理
本研究采用公开可获取且完全匿名的临床数据集对所提出的方案进行评估,这些数据集包括结构化电子健康记录(EHR)、临床问答数据以及用于方法学验证的医学影像数据集。在集成到平台之前,数据集经过标准化的预处理流程,包括数据归一化、剔除不一致或不完整的记录、映射至HL7 FHIR资源、文本清洗、分割为用于检索的文本块,以及生成用于向量索引的嵌入表示。这些预处理步骤确保了异构数据源之间的语义一致性,促进了数据的互操作性,支持所提出工作流程的可重复性,同时符合适用的数据隐私原则。
数据集来自人工智能和数字健康研究中常用的公开基准数据库。这些数据集被选用来代表异构的临床信息,包括结构化的电子健康记录(EHRs)、非结构化的临床叙述文本、临床问答任务以及医学影像元数据。该方案并不针对特定临床队列进行评估,而是侧重于展示一种可重复的实施工作流程,该流程可适配于不同的医疗数据集。这些基准数据集的多样性使得能够在多种临床数据模态下验证互操作性流程、检索增强生成(RAG)以及多智能体推理框架的有效性。
实验环境配置
实验环境被设置为在受控且可重复的条件下评估互操作平台。该架构包含数据输入模块、互操作层、大语言模型(LLMs)以及评估组件,这些组件被组织成一个用于医学数据分析的单一处理流程。图1展示了从临床数据输入到诊断结果生成的完整工作流程。
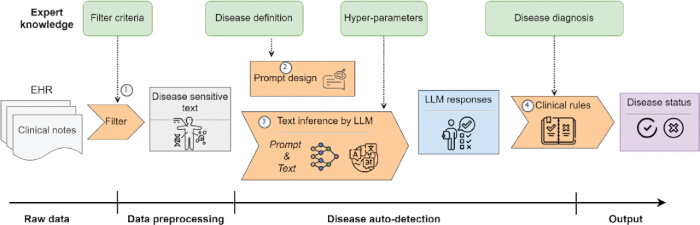
图 1:整体系统工作流程,展示从原始临床数据到疾病状态输出的处理流程。 该流程始于电子健康记录(EHR)数据的导入,随后进行数据过滤与预处理,以提取对疾病敏感的信息。结构化提示设计阶段整合了专家知识、疾病定义和超参数,从而实现与大语言模型(LLM)的有效交互。LLM 执行文本推断,生成上下文感知的响应,随后通过临床规则对这些响应进行评估,以确定最终的疾病状态。该工作流程突出了数据预处理、基于知识的提示设计以及人工智能驱动的推断之间的整合,以支持临床决策。 请点击此处查看此图的放大版本。
医疗保健互操作性架构
后端基础设施采用基于 RESTful API 的模块化架构,以支持平台各组件之间的通信(图2这种架构可容纳异质性临床信息,包括结构化的电子健康记录(EHRs)、医生笔记以及源自医学影像系统的元数据。由于这些数据来自多种来源并具有不同格式,因此通过标准化数据模型(特别是快速医疗互操作性资源(FHIR)框架)实现互操作性。15,16,17..采用FHIR支持结构化信息交换,同时在分布式医疗环境中保持可扩展性和灵活性。还整合了基于HL7的通信机制,以促进与传统临床系统的集成,后者在医疗机构中仍被广泛使用。16,17.
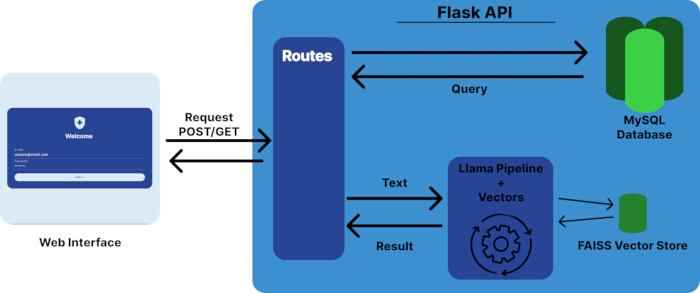
图 2:所提出的互操作平台的系统架构。Web 界面通过使用 HTTP POST/GET 请求的 Flask API 与后端通信。该 API 负责路由管理、查询处理以及与结构化和非结构化数据源的交互。MySQL 数据库用于存储结构化临床数据,而基于 FAISS 的向量存储支持检索操作中的相似性搜索。基于 LLaMA 的处理流程利用向量表示对文本输入进行处理并生成响应,从而实现检索增强生成(Retrieval-Augmented Generation, RAG)。该架构突出了 Web 服务、数据库管理、向量检索和大语言模型推理在一个统一系统中的集成。请点击此处查看此图的放大版本。
多智能体工作流配置
多智能体架构被划分为多个专门的功能性智能体,分别负责工作流程中的不同阶段。预处理智能体执行数据归一化和FHIR映射,随后由检索智能体负责在向量数据库中进行语义搜索。推理智能体将检索到的上下文与大语言模型(LLM)相结合以生成响应,而验证智能体则在最终响应返回前验证输出的一致性和格式。智能体之间的协调遵循顺序编排策略,即每个智能体的输出作为下一阶段的输入,确保实现可重复且模块化的流程。
临床数据整合
数据整合层从多个临床来源汇集信息,并将其准备用于下游处理。预处理包括数据标准化、分词和实体对齐,以提高异构数据集之间的语义一致性。由于临床信息在结构和质量上存在差异,这些操作有助于降低噪声,并促进与人工智能模型的交互。此外,还应用了结构化映射策略,以协调不同的数据格式并保持与处理流程的兼容性,如图315,16,17所示。
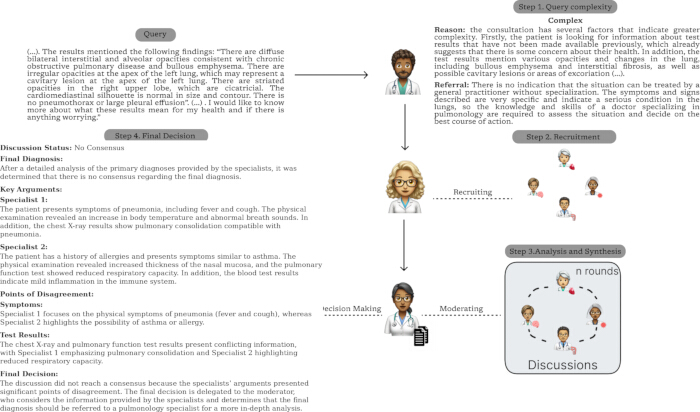
图3:多智能体临床推理过程的详细示例。该图展示了临床查询如何通过多个阶段进行分析,包括复杂性评估、专科专家招募、协作讨论以及最终决策。此过程展示了该系统能够根据查询的复杂性动态调整推理策略,从而在临床决策支持场景中提高效率和诊断准确性。请点击此处查看此图的放大版本。
配置检索增强生成管道
检索增强生成(Retrieval-Augmented Generation, RAG)通过将信息检索与大语言模型的生成能力相结合,实现上下文感知的分析。用户查询首先通过嵌入模型转换为向量表示,并利用语义相似性搜索在向量数据库中匹配,以检索最相关的上下文段落。检索到的文档随后与原始查询合并,再交由大语言模型(LLM)进行推理。该策略有助于在生成响应时提供上下文信息,在包括医疗健康在内的知识密集型应用中,已被证明可提高事实一致性并减少幻觉现象18,19。 图1 和 图3 分别展示了整体检索工作流程及相应的推理过程。
对于每个用户请求,最终提示通过将原始查询与从向量数据库中检索到的最相关上下文段落相结合,动态构建而成。在推理之前,检索到的信息被作为上下文证据纳入,从而使语言模型能够基于检索到的医疗健康知识生成回答,同时保持语义一致性并减少无依据的生成内容。
提示词工程与多智能体推理
该方案采用结构化提示策略,以在生成回答时提升对上下文的解读能力。这些提示技术结合先进的推理机制,有助于在复杂的临床情境中引导推理过程,并与文献报道的最新进展一致20。
该架构包含一个多智能体框架,由执行处理流程中不同功能的专用模块组成,这些功能包括数据验证、上下文过滤、临床推理支持以及输出验证。(图4)模块化结构使得任务可以按顺序或并行执行,从而针对不同的处理需求提供灵活性。将这些任务分布于多个智能体中,降低了对单一语言模型的依赖,支持构建更加稳健的处理流程。这种架构设计策略与分布式人工智能及智能系统设计的最新进展相一致21,22。
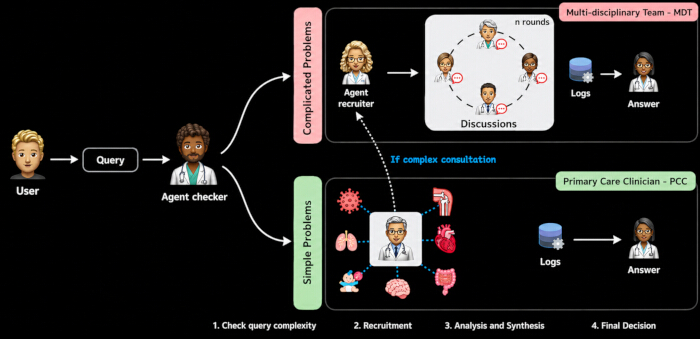
图 4:用于临床推理的多智能体决策框架。该流程始于用户查询,由一个智能体检查器对查询的复杂性进行评估。对于复杂病例,系统会动态召集一个由多个专业智能体组成的多学科团队(MDT),通过多轮迭代讨论来分析问题并综合知识,最终形成决策。而对于较简单的病例,则由初级保健临床医生(PCC)智能体处理,从而实现更快的响应生成。这种自适应架构在效率与分析深度之间实现了平衡,提升了医疗应用中决策的质量与系统的可扩展性。 请点击此处查看该图的高清版本。
性能评估
通过互补的指标评估系统性能,这些指标同时捕捉生成输出的语言质量和语义一致性。采用BLEU分数基于n元组重叠来衡量句法相似性23,而ROUGE用于评估召回率和内容覆盖率,特别是在文本摘要和信息抽取任务中24。语义相似性通过BERTScore进行评估,该指标利用基于Transformer模型获得的上下文嵌入向量来比较生成文本与参考文本25。附加分析包括困惑度(perplexity)和余弦相似度,分别用于考察模型置信度和语义连贯性26,27。
所选的评估指标通过结合词汇和语义分析,从互补的角度评估系统性能。这种结合在医疗应用中尤为重要,因为上下文解释与词汇相似性同样关键。该平台在受控的计算环境中进行了评估,支持基于云和本地部署。本地运行大语言模型(LLM)被作为可选方案,以满足数据隐私要求,并在处理敏感临床信息时减少对外部服务的依赖。该部署策略符合数据保护框架,可适应不同的运行环境4.
访问受限。请登录或开始试用以查看此内容。
结果
采用互补的定量指标和定性分析方法评估系统性能,以检验生成输出的语言准确性和语义一致性。该评估策略结合了词汇和语义层面的度量,以更全面地表征模型在医疗相关语言生成任务中的行为表现。
表1展示了使用BLEU、ROUGE和BERTScore获得的定量结果。选择这些指标是因为它们能够评估生成文本在词汇相似性、信息覆盖率和语义一致性等方面的互补特性,且这些指标在自然语言处理研究中被广泛使用。
...| 评估模型 | 提示类型 | 皮尔逊相关系数 | 均方根误差 | 平均绝对误差 | 命中率 |
| Mixtral | 短提示 | 0.098 |
访问受限。请登录或开始试用以查看此内容。
讨论
本研究中所呈现的评估是利用公开且完全匿名的基准医疗数据集进行的方法学验证。由于本工作的目标是展示一种可重复的实施方案,而非临床有效性,因此未开展涉及医疗专业人员或患者招募的前瞻性临床验证。
本研究的结果表明,将医疗保健互操作性标准与大语言模型相结合,为整合异构临床信息提供了一个实用的框架。所提出的架构将结构化数据交换机制(包括FHIR和HL7)与基于人工智能的语言处理技术集成到统一的工作流程中,符合当前数字健康系统的发展趋势15,16,17。
所提出工作流程的一个重要方面是在多智能体架构中集成检索增强生成(Retrieval-Augmented Generation, RAG)。在此配置下,检索到的文档在响应生成过程中提供额外的上下文信息,以支持知识密集型的临床任务。该架构设计与近期研究一致,这些研究将基于检索的机制描述为提升大语言模型应用中...
访问受限。请登录或开始试用以查看此内容。
披露
作者声明不存在可能影响本稿件所报告工作的竞争性财务利益或个人关系。生成式人工智能(AI)工具仅用于协助语言编辑、语法校正以及提升稿件的可读性。所有科学内容、研究设计、方法、数据分析、结果解释以及编辑决策均由作者制定、核实并批准,作者对本稿件内容承担全部责任。
致谢
作者感谢塞阿拉联邦大学(UFC)嵌入式与分布式系统实验室(LESC)提供的研究环境和技术讨论,这些支持了本研究的开展。作者同时感谢本研究中所使用的开源软件、互操作性标准以及公开数据集的开发者和维护者。
访问受限。请登录或开始试用以查看此内容。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| FAISS | Meta Platforms Inc. | Version 1.8.0 | 在检索增强生成(RAG)流程中用于相似性搜索的向量数据库。 |
| FHIR 标准 | HL7 International | Release 4 (R4) | 用于结构化临床数据交换的医疗互操作性标准。 |
| Flask | Pallets Projects | Version 3.0.3 | 用于实现 RESTful 后端 API 的 Python Web 框架。 |
| HL7 标准 | HL7 International | Version 2.x | 用于与医院信息系统实现互操作的遗留消息协议。 |
| HTTP REST API | 自定义实现 | N/A | 前端、后端、数据库与 AI 服务之间的 RESTful 通信层。 |
| LangChain | LangChain Inc. | Version 0.3.x | 用于集成大语言模型、提示工程与检索增强生成工作流的框架。 |
| LangGraph | LangChain Inc. | Version 0.2.x | 用于编排多智能体临床推理工作流的框架。 |
| LLaMA 3.1 8B Instruct | Meta Platforms Inc. | Version 3.1 | 用于临床推理与自然语言生成的大语言模型。 |
| MySQL Community Server | Oracle Corporation | Version 8.0 | 用于存储结构化临床数据的关系型数据库。 |
| Ollama | Ollama Inc. | Version 0.9.x | 用于执行大语言模型推理并保护患者隐私的本地推理引擎。 |
| Python | Python Software Foundation | Version 3.11 | 用于实现完整平台的编程语言。 |
| PyTorch | Linux Foundation | Version 2.4 | 用于大语言模型推理的深度学习框架。 |
| 检索增强生成(RAG)流程 | 自定义实现 | N/A | 结合语义检索与大语言模型推理以生成上下文感知响应的人工智能框架。 |
| Sentence Transformers | Hugging Face Inc. | all-MiniLM-L6-v2 | 用于生成密集向量表示以实现语义文档检索的嵌入模型。 |
| Ubuntu Linux | Canonical Ltd. | Version 24.04 LTS | 用于开发与实验评估的操作系统。 |
| Visual Studio Code | Microsoft Corporation | Version 1.100 | 用于软件实现与调试的集成开发环境。 |
参考文献
- Chukwu E, Garg L. A systematic review of blockchain in healthcare: frameworks, prototypes, and implementations. IEEE Access. 2020;8:21196-21214. doi:10.1109/ACCESS.2020.2969881.
- Al-Nbhany WANA, Zahary AT, Al-Shargabi AA. Blockchain-IoT healthcare applications and trends: a review. IEEE Access. 2024;12:4178-4212. doi:10.1109/ACCESS.2023.3349187.
- Tan Y, et al. MedChatZH: a Chinese medical large language model. Comput Biol Med. 2024;172:108290.
- OLLAMA TEAM. Ollama: Run Large Language Models locally. Version 0.x. San Francisco: Ollama, 2024.
- Jahan I, Laskar MTR, Peng C, Huang JX. A comprehensive evaluation of large language models on benchmark biomedical text processing tasks. Comput Biol Med. 2024;171:108189. doi:10.1016/j.compbiomed.2024.108189.
- Liu X, Zhou Y, Wang Z, et al. Disease topic modeling of users' inquiry texts: a text mining-based PQDR-LDA model for analyzing the online medical records. IEEE Trans Eng Manag. 2023.
- Taylor N, Kormilitzin A, Lorge I, Nevado-Holgado A, Cipriani A, Joyce DW. Model development for bespoke large language models for digital triage assistance in mental health care. Artif Intell Med. 2024;157:102988.
- Song M, et al. PneumoLLM: a large language vision model for pneumonia diagnosis. Med Image Anal. 2024;97:103248.
- Chien SC, Yen CM, Chang YH, Chen YE, Liu CC, Hsiao YP, et al. Using large language model (LLM) to identify high-burden informal caregivers in long-term care. Comput Methods Programs Biomed. 2024;255:108329. doi:10.1016/j.cmpb.2024.108329.
- Xue X, Zhang D, Sun C, et al. Xiaoqing: a Q&A model for glaucoma based on LLMs. Comput Biol Med. 2024;174:108399.
- Wu D, Nie L, Mumtaz RA, Agarwal K. A LLM-based hybrid-transformer diagnosis system in healthcare. IEEE J Biomed Health Inform. 2024.
- Zhang Y, et al. LLM-enhanced multi-teacher knowledge distillation for modality-incomplete emotion recognition in daily healthcare. IEEE J Biomed Health Inform. 2024.
- Sarzaeim P, Mahmoud QH, Azim A. A framework for LLM-assisted smart policing system. IEEE Access. 2024;12:74915-74929. doi:10.1109/ACCESS.2024.3404862.
- Leme RS, Blank M. Lei Geral de Proteção de Dados e segurança da informação na área da saúde. Cad Ibero-Am Direito Sanit. 2020;9(3):210-224. doi:10.17566/ciads.v9i3.690.
- Zaganelli MV, Binda Filho DL. O sigilo médico e os dados sensíveis na telemedicina à luz da Lei Geral de Proteção de Dados. RECIIS. 2023;17(3):729-740. doi:10.29397/reciis.v17i3.3689.
- Tabari P, Costagliola G, De Rosa M, Boeker M. State-of-the-art Fast Healthcare Interoperability Resources (FHIR)-based data model and structure implementations: systematic scoping review. JMIR Med Inform. 2024.
- Martinez T, et al. HL7 systems and interoperability ecosystems in modern healthcare. IEEE Rev Biomed Eng. 2024.
- Chen L, et al. HL7 integration and semantic interoperability in distributed healthcare networks. IEEE J Biomed Health Inform. 2024.
- Liu W, Li W, Huang W, Gao Y. Security framework for medical data sharing. Telemed E-Health. 2024.
- Basile LJ, Carbonara N, Panniello U, Pellegrino R. How can technological resources improve the quality of healthcare service? IEEE Trans Eng Manag. 2024;71:5771-5781. doi:10.1109/TEM.2022.3192405.
- Singh A, et al. Prompt engineering in large language models: a survey using SWOT analysis [preprint]. arXiv. 2024
- Chen L, Chen Y, Liang W, Li X, Li KC, Wang J, Xiong N. MASS: a multiattribute sketch secure data sharing scheme for IoT wearable medical devices based on blockchain. IEEE Internet Things J. 2025;12(2):1990-2001. doi:10.1109/JIOT.2024.3468733.
- Autoridade Nacional de Proteção de Dados (BR). Diretrizes para agentes de tratamento de pequeno porte. Brasília (DF): ANPD; 2021.
- Patel R, Kim H. Interoperability in EHR. IEEE Transactions on Biomedical Engineering, v. 70, n. 8, p. 2341-2354, ago. 2023. DOI: 10.1109/TBME.2023.3241567.
- Zhang T, Kishore V, Wu F, Weinberger KQ, Artzi Y. BERTScore: evaluating text generation with BERT. In: International Conference on Learning Representations (ICLR); 2020.
- Chen X, Lu X, Li Q, Li D, Zhu F. Integration of LLM and Human-AI Coordination for Power Dispatching With Connected Electric Vehicles Under SAGVNs. IEEE Trans Veh Technol. 2025;74(2):1992-2002. doi:10.1109/TVT.2024.3434969
- Zhou S, Chen C, Gu HH. Testing and evaluating SNOMED CT web browsers' textual search feature. In: Proceedings of the IEEE International Conference on Bioinformatics and Biomedicine (BIBM); 2019.
- McPeak G, Sautmann A, George O, Hallal A, Simal EA, Schwartz AL, Abaluck J, Ravi N, Pless R. An LLM's medical testing recommendations in a Nigerian clinic: potential and limits of prompt engineering for clinical decision support. In: Proceedings of the 2024 IEEE 12th International Conference on Healthcare Informatics (ICHI); 2024.
- LLAMA TEAM, AI @ META. The Llama 3 Herd of Models. arXiv preprint arXiv:2407.21783, 2024. Disponível em: https://arxiv.org/abs/2407.21783.
- Conselho Nacional de Saúde (BR). Resolução nº 466, de 12 de dezembro de 2012. Aprova as diretrizes e normas regulamentadoras de pesquisas envolvendo seres humanos. Brasília (DF): Ministério da Saúde; 2012.
- Singhal K, Azizi S, Tu T, et al. Large language models encode clinical knowledge. Nature. 2023;620:172-180. doi:10.1038/s41586-023-06291-2.
- Sahoo P, et al. A systematic survey of prompt engineering in large language models [preprint]. arXiv. 2024. Available from: https://arxiv.org/abs/2402.07927
- Yan Y, Hou Y, Xiao Y, Zhang R, Wang Q. KNOWNET: guided health information seeking from LLMs via knowledge graph integration. IEEE Trans Vis Comput Graph. 2024.
访问受限。请登录或开始试用以查看此内容。