本行为科学与心理评估方案通过标准化在线问卷的施测、评分、数据质量筛查及可重复分析,用于评估大学生的网络成瘾及情绪调节困难情况。
本文内容
摘要
摘要
互联网使用已深度融入大学生活,但仅凭使用时间无法充分评估互联网使用问题。现有证据表明,适应不良或强迫性互联网使用模式与情绪调节困难相关,然而问卷顺序、纳入标准、筛查阈值、计分方法及分析报告方式的不一致,持续限制了不同研究之间的可比性。本文提出了一种标准化的问卷研究方案,适用于针对大学生群体中互联网成瘾与情绪调节困难的行为科学及心理评估研究。该方案包括固定的问卷顺序、预设的纳入标准、强制回答设置、基于预实验确定的完成时间阈值、逐级数据质量筛查、互联网成瘾测验(Internet Addiction Test)与16项情绪调节困难量表(Difficulties in Emotion Regulation Scale)的标准化计分,以及可重复的描述性分析、相关性分析和多变量回归分析。该方案还规定了原始回收数据、筛查日志、README/代码本文件以及最终可供分析的数据集的归档要求。本文报告了一项代表性实施案例,以展示该方案的执行过程,而非验证测量工具或确立患病率。在该实施中,共邀请了520名学生,回收问卷480份。经过依次排除重复提交、作答过快、注意力检查失败、模式化作答、逻辑矛盾以及核心数据缺失的问卷后,保留了452份有效问卷。预设的分析示例考察了互联网成瘾测验总分与情绪调节困难量表总分之间的关联。保留样本的互联网成瘾测验总分平均为51.94,情绪调节困难量表总分平均为35.95。随着互联网成瘾严重程度的升高,情绪调节困难程度也随之增加,且在调整人口学与行为学协变量后,该关联仍显著存在。本方案提供了一个透明的研究流程,可用于未来在大学生群体中开展的横断面、重复测量或纵向研究,并支持重复实施、审计与适当调整。
引言
互联网使用已成为大学生活中普通的一部分,包括学术工作、社交沟通、娱乐、信息获取以及情绪应对。因此,不应简单地将学生的互联网行为理解为屏幕暴露时间或在线时长。早期证据表明,在当前移动平台环境高度普及之前,青年群体和大学生中已出现明显的网络使用问题1。近期更多基于大学的研究进一步表明,网络使用问题的发生率已达到需要进行系统性评估而非仅作非正式描述的程度2。
大学生是进行标准化评估的一个特别重要的群体,因为学业压力、社会角色转变、独立生活以及自主性的增强通常都集中在同一发展阶段出现。这些需求往往通过相同的数字设备和平台来应对,而这些设备和平台本身也可能变得难以自我管控。一项元分析综述表明,学生中存在问题的互联网使用行为与多种心理健康结果相关,支持将其视为一种更广泛的行為和心理问题,而不仅仅是技术使用层面的狭隘问题3。此外,感知到的压力也与大学生中的网络成瘾模式相关,提示在设计该领域基于问卷的研究时,应考虑情绪和情境压力因素4。
本方案在特指由“网络成瘾测试”(Internet Addiction Test)所测量的构念及其既定评分类别时,使用“网络成瘾”这一术语。在讨论关于适应不良、过度使用或对功能造成损害的网络相关行为的更广泛文献时,使用更宽泛的术语“问题性网络使用”。只有在所引用的文献强调失控、冲动或不顾负面后果仍反复使用时,才使用“强迫性网络使用”这一表述。因此,这些术语相互关联,但并不视为完全可互换。当本方案采用“网络成瘾测试”实施时,保留“网络成瘾”作为该测量工具特定的术语;当使用其他替代性或修订版测量工具时,术语应与所选测量工具的构念标签和诊断假设保持一致。
情绪调节为理解为何部分学生会从频繁使用互联网转变为适应不良的互联网使用提供了一个合理的心理学切入点。一项为期一年的前瞻性研究显示,情绪调节困难与中国大学生日后出现或缓解网络成瘾现象均相关5。这一发现对方案设计具有重要意义,因为情绪调节不仅仅是一个附加的相关因素;它可能影响学生如何利用互联网来回避、减轻或管理心理困扰。与此同时,社会功能仍然具有相关性。大学学生中的问题性互联网使用已与其社交技能相关联,表明在评估数字使用变量时,应同时评估人际和情绪因素6。在新冠疫情期间,中国大学生的问题性互联网使用还伴随着更广泛的心理困难,进一步支持了在高校环境中开展结构化评估的必要性7。
另一个挑战在于数字行为具有异质性。学生可能将数字平台用于学习、社交联系、娱乐、健康信息获取或暂时的情绪缓解,而并非所有高频使用都是有害的。一项关于大学生与心理健康相关的数字使用行为的系统综述表明,数字参与可满足多种心理需求8。因此,该领域需要能够区分普通高频使用与问题性或失调性使用的评估方法。近期关于大学生问题性智能手机使用的研究证据同样表明,风险取决于行为模式、功能和使用情境,而不仅仅是使用时长9。基于此,本研究方案结合了互联网使用时长、夜间使用情况、主要在线活动类型以及标准化症状评分,而非依赖单一暴露指标。
测量是另一个主要的不一致来源。网络成瘾测试仍是评估网络成瘾症状最常用的工具之一,但其维度结构和解释在不同应用场景中存在差异。系统的心理测量学证据表明,该工具虽被广泛使用,但其因子结构和评分解释仍持续引发质疑10。在大学生样本中也报告了类似问题,该量表的广泛应用并未完全消除对所测量构念的不确定性11。在西班牙和秘鲁大学生群体中的验证研究同样显示,该工具可能具有可接受的表现,但其心理测量学特性应在具体应用的目标人群中加以考量12,13。
因此,该方案的设计旨在保持工作流程的稳定性,同时在仪器选择上具有适应性。此处使用网络成瘾测试是因其具有历史应用基础、存在可用的阈值,并且可与先前针对大学生的研究进行比较。然而,该方案并不要求网络成瘾测试必须永久作为首选工具。如果诊断框架发生演变,或更新的测量工具对特定人群更为适用,则可在保留相同工作流程的前提下,替换与量表相关的模块、分数范围、严重程度阈值、代码本条目以及README文档。此类替换应在正式数据收集开始前完成,并应作为方案修改进行报告,而非临时的分析性调整。
本文所解决的方法学问题,不仅仅是关于网络成瘾与情绪调节的研究得出了不同的结论。更确切地说,许多研究在问卷顺序、纳入标准、调查平台设置、重复作答处理、注意力检查程序、完成时间阈值、缺失数据规则、计分验证以及分析就绪文件的报告等方面均存在差异。这些差异使得研究结果难以相互比较、重复验证,也难以纳入后续的证据整合。本方案通过固定施测顺序、筛选逻辑、计分结构和分析路径,以可重复、可审核且透明修改的方式回应了这一空白。因此,本方案的贡献是面向研究流程的:它为高校人群中的观察性行为科学与心理评估研究提供了一套可重复的工作流程,而非提出新的心理学构念或将患病率研究作为主要结果。
方案
本研究题为“大学生网络成瘾与情绪调节评估的标准化问卷方案”,在开始招募参与者之前,已获得郑州经贸大学伦理与学术委员会的审查和批准,批准编号为2026011300414。该研究采用横断面、匿名在线问卷设计,研究对象为18至24岁的全日制大学生,并按照机构伦理要求及《赫尔辛基宣言》的规定实施。在参与者访问问卷前,已获得电子知情同意。参与者收到一份电子信息说明,内容包括研究目的、流程、参与的自愿性质以及数据保护措施,且可在任何时间自由退出,不会受到任何处罚。主调查文件中未收集任何可直接识别的个人信息,包括姓名、学号、确切地址、电话号码、个人电子邮件地址或社交媒体账号。平台生成的标识符仅用于筛查重复作答,并在数据集分析前予以删除。所有数据均安全存储,并以去标识化形式进行分析。该问卷流程未在招募参与者前进行前瞻性注册。然而,所有核心方案组成部分,包括锁定版本的问卷、README/代码本、筛查日志、计分规则、分析语法及可供分析的工作流程文件,均已归档,并作为补充工作流程材料提供,以支持研究的可重复性与可审计性。
平台生成的响应标识符以及设备或账户受限的技术标识符仅用于重复响应筛选,并已从最终的匿名分析数据集中删除。核心变量和评分规则总结于表1中,完整的变量字典见补充表1。问卷文件、代码本、筛选日志、输出计划以及可用于分析的工作流程材料见补充文件1。
| 领域 | 变量 | 编码/计分方式 | 在方案中的作用 |
| 入组资格 | 年龄 | 岁;可接受范围为 18–24 岁 | 入组资格变量及协变量 |
| 人口统计学 | 性别 | 1 = 男性;2 = 女性;3 = 不愿透露 | 描述性变量及回归协变量 |
| 人口统计学 | 年级 | 1 = 大一;2 = 大二;3 = 大三;4 = 大四及以上;5 = 研究生 | 描述性变量 |
| 人口统计学 | 学科类别 | 1 = 人文与社会科学;2 = 理工科;3 = 商科与管理;4 = 艺术与设计;5 = 其他 | 描述性变量 |
| 人口统计学 | 居住类型 | 1 = 校内宿舍;2 = 校外租房;3 = 家庭住所;4 = 其他 | 描述性变量 |
| 人口统计学 | 月生活支出 | 1 = <1,000 元;2 = 1,000–1,999 元;3 = 2,000–2,999 元;4 = ≥3,000 元 | 描述性变量 |
| 网络使用行为 | 工作日网络使用时长 | 1 = <2 小时;2 = 2–3.9 小时;3 = 4–5.9 小时;4 = ≥6 小时 | 行为协变量 |
| 网络使用行为 | 周末网络使用时长 | 1 = <2 小时;2 = 2–3.9 小时;3 = 4–5.9 小时;4 = ≥6 小时 | 行为协变量 |
| 网络使用行为 | 主要在线活动 | 1 = 学习;2 = 社交媒体;3 = 游戏;4 = 娱乐/视频;5 = 购物;6 = 混合使用;7 = 其他 | 描述性变量 |
| 网络使用行为 | 主要访问设备 | 1 = 智能手机;2 = 平板电脑;3 = 笔记本/台式机;4 = 多设备混合使用 | 描述性变量 |
| 网络使用行为 | 23:00 后夜间使用 | 1 = 从不;2 = 每周少于一次;3 = 每周 1–2 次;4 = 每周 3–5 次;5 = 几乎每晚 | 行为协变量及逻辑一致性筛查变量 |
| 核心量表 | IAT 总分 | 20 个条目之和;每个条目计分 1–5 分;总分范围 20–100 | 主要自变量 |
| 核心量表 | IAT 严重程度分组 | 20–39 = 正常使用;40–69 = 问题性使用;70–100 = 严重问题性使用 | 分组变量 |
| 核心量表 | DERS-16 总分 | 16 个条目在完成必要的反向计分后求和;总分范围 16–80 | 主要因变量 |
| 核心量表 | DERS-16 各子量表 | 根据固定的 DERS-16 计分标准计算 | 描述性情绪调节结果指标 |
| 协变量 | 睡眠时长 | 1 = <6 小时;2 = 6–6.9 小时;3 = 7–7.9 小时;4 = ≥8 小时 | 调整变量 |
| 协变量 | 每周体育锻炼频率 | 0 = 无;1 = 1–2 次;2 = 3–4 次;3 = ≥5 次 | 调整变量 |
| 协变量 | 学业压力 | 1 = 低;2 = 中等;3 = 高 | 调整变量 |
| 质量控制 | 注意力检查 | 1 = 通过;0 = 未通过 | 排除标准 |
| 质量控制 | 完成时间 | 以秒为单位的完成时长 | 基于时间的筛查变量 |
| 质量控制 | 连续相同回答次数 | 在 36 个计分量表条目中,相同回答的最大连续出现长度 | 模式化回答筛查变量 |
| 质量控制 | 个体内部标准差 | 在 36 个计分量表条目上的个体内部标准差 | 不变应答筛查变量 |
| 质量控制 | 逻辑一致性标志 | 0 = 无矛盾;1 = 检测到矛盾 | 逻辑一致性筛查变量 |
表1:标准化问卷方案中使用的核心变量、编码结构和评分规则。 本表总结了主要工作流程中使用的核心入组标准、人口统计学、互联网使用、量表、协变量及质量控制变量。内容包括用于问卷施测、筛选、评分和分析的主要变量的编码值、评分范围、评分规则及其作用。缩写:IAT = 互联网成瘾测试;DERS-16 = 16项情绪调节困难量表。请点击此处下载该表格。
1. 设置研究人群、问卷结构和调查流程
- 确定目标人群和有效样本
- 招募年龄在18–24岁之间、能够独立在手机或电脑上完成问卷的全日制本科生和研究生。记录问卷的语言版本,并使用已针对目标学生群体验证或适当调整的量表版本。
- 当纳入国际学生、残疾学生或多语言学生群体时,在数据收集前记录任何可访问性或语言方面的修改。
- 限制每位参与者仅提交一次完整应答。在可行的情况下,使用调查平台的设备限制、账户限制、Cookie限制或认证链接功能。
注意:当同一参与者账户从多个设备生成应答时,在重复数据筛查过程中,使用账户限定标识符、时间戳、问卷状态和应答模式相似性识别并合并这些记录。 - 将最终有效样本的最低数量设定为450份问卷,并持续招募,直至经过筛选后清理的数据集仍高于此阈值。
注意:当严重的问题性互联网使用或其他小亚组是主要分析目标时,应在数据收集开始前设定更高的招募目标。 - 记录邀请人数、回收数量、在每个预设筛选步骤中被排除的数量以及最终保留的数量,以便后续在图1中总结参与者流程。
- 以固定顺序构建问卷
- 按以下顺序排列问卷内容:知情同意、人口统计学信息、互联网使用行为、互联网成瘾测验、情绪调节困难量表短版、睡眠时长、每周体力活动和感知到的学业压力。对所有参与者保持此顺序不变,核心量表的顺序不得随机化。
- 使用封闭式应答类别记录年龄、性别、年级、学科类别、居住类型和每月生活开销。将所有人口统计学项目标记为必填项。
注意:对于性别,应包括“男性”、“女性”和“不愿透露”。在描述性分析中保留“不愿透露”选项。在回归分析中,以男性为参照类别,使用指示变量对性别进行编码,分别为女性和“不愿透露”设置独立的指示变量。不得仅因参与者选择“不愿透露”而将其删除。 - 记录工作日互联网使用时长、周末互联网使用时长、主要在线活动、主要访问设备以及23:00后夜间上网情况。将夜间使用编码为:1 = 从不,2 = 每周少于一次,3 = 每周1–2晚,4 = 每周3–5晚,5 = 几乎每晚。
- 记录问卷施测时所处的学术阶段。在代表性实施方案中,调查在常规教学学期期间进行,避开期末考试周,具体时间为学期第6–7周。
- 实施并评分核心测量工具
- 将20项互联网成瘾测验作为必答量表实施,每项评分从1到5。将全部20项得分相加,得到总分(范围为20–100),然后将20–39分归类为正常使用,40–69分为问题性使用,70–100分为严重的问题性使用15。
- 报告基于IAT的得分和严重程度分组时使用“互联网成瘾”;仅在引用更广泛的文献或非IAT构念时使用“问题性互联网使用”。
- 在互联网成瘾测验之后立即施测16项情绪调节困难量表短版,每项评分从1到5。在求和前对第1、6、8项进行反向计分,然后计算总分(范围为16–80),得分越高表示情绪调节困难程度越大16。
- 在确认反向计分无误后,生成非接纳、目标、冲动、策略和清晰度五个子量表得分。
- 在计算总分和子量表得分前,重新核对所有反向计分项目的编码方向。对所有参与者使用相同的DERS-16计分标准,并在README/代码本中记录该计分标准。
- 当使用修订版或替代性的互联网成瘾测量工具时,应在数据收集开始前替换相应的量表模块,并更新项目名称、得分范围、严重程度阈值、计分语法、README/代码本、问卷截图以及材料表。
- 添加协变量和一项注意力检查项目
- 将睡眠时长记录为:<6 h、6–6.9 h、7–7.9 h 和 ≥8 h;将每周体力活动频率记录为:0次、1–2次、3–4次 和 ≥5次;将感知到的学业压力记录为低、中、高。将一次体力活动定义为≥20分钟的中等或剧烈强度活动。
- 在行为部分插入一项定向应答的注意力检查项目,要求参与者选择一个指定的应答选项。在代表性实施方案中使用的注意力检查项目为:“为确认您正在仔细阅读,请为此项选择‘3 = 有时’”。在数据清理阶段,将未能通过该项目的问卷标记为排除对象17。
关键步骤:正式数据收集开始后,不得更改项目措辞、应答锚点、量表顺序、排除阈值、调查平台设置、编码规则或统计分析规则。
注意:在表1中汇总核心变量、编码值、得分范围和计分规则。在补充表1及README/代码本中提供完整的变量字典、文件状态字段、筛选标志、技术标识字段、数据集追踪变量、文件名和软件版本。
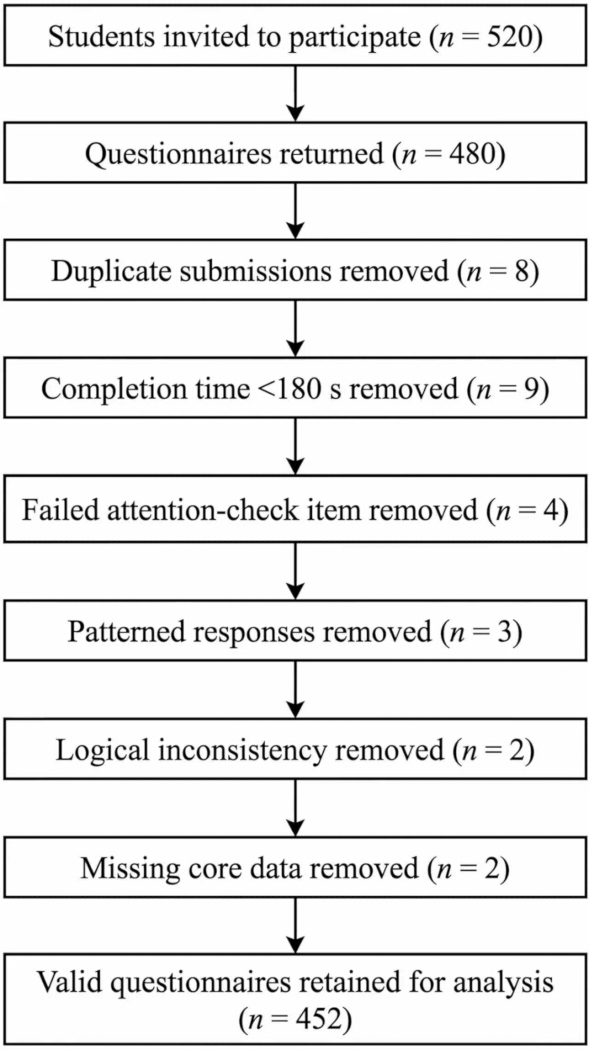
图1:招募、筛选、排除及最终分析样本保留的问卷流程图。 该流程图展示了从邀请的学生到回收问卷,经过逐级数据质量筛选并根据预先设定的标准排除无效问卷,最终保留有效问卷用于分析的全过程。图中列出了受邀学生人数、回收问卷数量、每一步筛选过程中被排除的记录数,以及最终用于分析的样本量。请点击此处查看此图的放大版本。
2. 对问卷进行预试验并确定最终的现场版本
- 对完整问卷进行预试验
- 向20–30名符合正式纳入标准但不保留在最终数据集中的学生施测完整问卷。
- 记录完成时间,以及关于问题清晰度、回答负担、技术访问、题目顺序、注意力检查题目的理解情况,以及人口学或行为应答选项中任何模糊之处的书面反馈。
- 记录预试验样本量、中位完成时间、四分位距、最短与最长完成时间,以及预试验后所作的所有文字修改。
- 在本研究的代表性实施中,预试验共纳入25名学生,中位完成时间为540秒,预计完成时间设定为6–8分钟。
- 根据预试验中发现的模糊表述、语义重复、应答选项不明确或软件显示问题进行修订,随后在正式发布前锁定最终问卷版本。
注:若研究包含多语言学生、老年人、青少年或残障学生,应在正式发布前额外开展认知访谈或亚组预试验。
- 确定操作设置与导出规则
- 在选定的在线问卷平台中创建新的调查项目。将知情同意页设为第一页,并将同意选项设为必答的分支控制项。
- 设置问卷逻辑,使未提供同意的参与者自动退出,无法查看问卷主体内容。
- 使用已锁定的措辞和应答锚点,录入所有人口学、互联网使用、IAT、DERS-16、协变量及注意力检查题目,并将所有核心题目设为必答。
- 启用自动记录开始时间、结束时间、完成时长、应答状态及平台生成的应答标识符。
- 在平台支持的情况下,启用“每位参与者仅提交一次”的控制机制,包括认证链接、设备限制、基于Cookie的重复防止、基于账户的重复防止或重复应答审查设置,并在README/代码本中记录所启用的控制措施。
- 禁用不必要的直接标识信息收集。若平台默认记录IP地址,应根据机构政策禁用IP存储,或将其替换为非标识性的重复筛查字段。
注:当因重复筛查需临时保留IP地址或设备元数据时,仅可在加密的原始文件中存储,限制访问权限至研究分析人员,并在生成最终分析数据集前将其删除。 - 明确是否允许暂停后继续作答。在本方案中,不启用跨会话的正式保存与返回功能。参与者仅可在同一浏览器会话内暂停,记录的完成时间包含全部经过时间。
- 在问卷结束时,以电子表格和逗号分隔值(CSV)格式导出原始返回文件18。同时导出一份问卷-文档文件或PDF/A副本,包含最终问卷措辞、题目顺序、分支设置、必答项设置及编码结构。以版本控制命名方式保存这些文件。
- 计算预试验的中位完成时间,并将有效完成的最低时间阈值设为该值的约三分之一。最终将下限阈值固定为180秒,并在正式筛选中统一应用。
- 由于该截断值基于预试验样本得出,当本方案在显著不同的人群、平台、语言版本或机构环境中实施时,应重新确定该阈值。
注:将最终问卷截图、最终问卷导出文件、README/代码本、预试验日志、注意力检查题文字、筛选日志模板、导出设置及统计语法一并归档为补充材料或审计文件。
3. 发布问卷并保存原始数据集
- 通过固定渠道招募参与者
- 在固定的14天数据收集窗口期内,通过学生交流群组、班级渠道或机构邮件列表分发一份标准化的邀请函。
- 在邀请函和知情同意页面中均需说明研究目的、预计完成时间为6–8分钟、数据将匿名处理、参与完全自愿,以及不参与不会受到任何学术处罚或获得奖励。
- 在任何问卷题目出现之前显示知情同意页面,并要求参与者主动确认同意后方可进入。若未获得明确的同意回应,则不允许访问问卷主体内容。
- 在知情同意页面中声明,参与者可在最终提交前随时退出,且未完成的答卷将不会被纳入最终分析。
- 在所有招募渠道中使用相同的锁定版本问卷。若使用多个招募渠道,仅当渠道本身被预先指定为研究变量时,才记录其来源信息。
- 保留原始返回文件
- 在原始导出文件中保留所有返回的记录,包括未完成或后续被排除的提交内容。调查结束后立即导出完整数据集,并将其保存为 raw_returns_YYYYMMDD.csv 和 raw_returns_YYYYMMDD.xlsx。
- 在原始文件中保留原始提交时间、完成时长、响应状态、平台生成的响应标识符以及设备限制或账户限制的技术标识符。在后续数据清理过程中不得覆盖这些字段。
- 在开始筛选前保存一份只读的原始数据副本。将原始文件、筛选日志和最终分析数据集分别存储在不同的文件夹中。仅允许授权的研究人员访问包含技术标识符的原始文件。
警告:不得在主调查文件中直接收集可识别个人身份的信息,例如全名、学生学号、确切宿舍地址、个人电话号码、个人电子邮件地址或社交媒体账号。
说明:在原始数据导出后暂停工作流程,保存一份原始数据集的只读副本,并仅从此保留副本开始后续清理操作。
4. 筛查回收的问卷并生成最终分析数据集
- 以固定顺序应用筛选序列
- 按设备限定标识符、可用时的账户限定标识符、时间戳、问卷状态及回答相似性对所有返回记录进行排序。首先识别重复提交的记录。当同一收集周期内同一参与者提交了两份或以上记录时,保留其中最早完成的记录。
- 若检测到同一认证账户但从不同设备提交了多份申请,应将其视为同一参与者重复提交。保留最早完成的记录,并排除后续完成的记录。若最早记录不完整而后续记录完整,则保留最早的一份完整记录。
- 移除具有完成时间的记录 <180 秒,完成 180–240 秒的审查记录,并在第四步移除未通过定向反应注意力检查项目的记录。在 screening_log_v1.xlsx 中记录每一步移除的数量19.
- 对于在180–240秒内完成的记录,应结合注意力检查结果、长串作答标记、个体内部标准差及逻辑一致性标记进行人工复核。
- 仅在不存在其他数据质量标记时,保留边缘速度记录。在筛选日志中记录每一次边缘速度判定。
- 删除模式化、不一致或不完整的记录
- 移除所有显示长串作答的问卷,其定义为在36个计分量表条目中出现18个或以上连续相同的回答,或这些条目上的个体内标准差≤0.25。
- 删除显示不可能行为组合的任何问卷。将“在几乎所有网络成瘾测试项目中选择最高反应类别”定义为在20项IAT条目中至少有18项的得分达到5分。
注意:当受访者报告工作日和周末的互联网使用时长均处于最低时长类别时,将触发逻辑不一致规则<每天2小时)、将“几乎每晚”使用互联网编码为晚期互联网使用,且在20项IAT量表中至少有18项得分达到5分。仅在完成重复数据、填写时间、注意力检查及模式化反应的筛选后,应用此标准。 - 剔除所有在任一IAT条目、任一DERS-16条目或任一预先指定的协变量中存在缺失值的问卷。
注意:采用此完整病例规则,是因为在线调查使用了强制性的核心条目,且代表性回归模型需要固定的协变量集。当缺失的协变量数据超过5%时,应使用预先指定的替代缺失数据处理方法,例如多重插补法。 - 为每条保留的记录分配一个匿名研究编号,并将剩余文件保存为 analytic_dataset_v1.csv 和 analytic_dataset_v1.xlsx。
- 从最终分析数据集中删除平台生成的响应标识符、设备限定标识符、账户限定标识符、筛查期间保留的IP地址、时间戳以及自由文本形式的评审记录,仅保留匿名研究编号和分析变量。
关键步骤:对每条记录均需按相同顺序应用筛选流程,且在后续阶段不得重新纳入先前已排除的案例。以首个触发的排除标准作为主要排除原因,次要排除标记仅记录于筛选日志备注中。
注:按排除原因总结最终的排除例数 表2,并将这些计数与后续报告的参与者流程保持一致 图1.
| 筛选顺序 | 筛选项目 | 操作规则 | 筛选操作 | 文档记录规则 |
| 步骤 1 | 原始导出数据保存 | 调查关闭后立即导出所有返回记录,并将其保存为 raw_returns_YYYYMMDD.csv 和 raw_returns_YYYYMMDD.xlsx | 在开始任何数据清洗前,保留一份只读副本 | 归档至 raw-data 文件夹 |
| 步骤 2 | 知情同意与访问权限检查 | 在访问问卷前,识别未提供有效电子知情同意的记录 | 从分析流程中排除无知情同意的记录 | 若平台导出中保留此类记录,则在 screening_log_v1.xlsx 中记录被排除或无法访问的记录 |
| 步骤 3 | 重复记录筛选 | 识别在同一数据采集周期内,具有相同设备限制标识符或账户限制标识符,且在性别、年龄、学年以及至少80%问卷回答相同的记录 | 保留最早完成的记录,排除所有后续重复记录 | 在 screening_log_v1.xlsx 中记录被排除的数量及受影响的 raw_record_id 值;指定主要排除原因 primary exclusion_reason = 1 |
| 步骤 4 | 多设备重复记录合并 | 识别同一经认证参与者账户在不同设备上提交的多个完整记录 | 将这些记录视为重复提交;保留最早完成的记录 | 在 screening_log_v1.xlsx 中记录账户限制标识符和保留的 raw_record_id;为后续记录指定主要排除原因 primary exclusion_reason = 1 |
| 步骤 5 | 完成时间筛选 | 识别所有完成时间 <180 s 的问卷 | 自动排除所有此类记录 | 在 screening_log_v1.xlsx 中记录被排除数量;指定主要排除原因 primary exclusion_reason = 2 |
| 步骤 6 | 临界速度审查 | 识别所有完成时间在 180–240 s 之间的问卷 | 使用注意力检查、长字符串、个体内标准差(within-person SD)和逻辑标志手动审查每条记录;仅在无额外标志时保留 | 在 screening_log_v1.xlsx 中将每条记录标记为 retained_after_manual_review = 1 或 excluded_after_manual_review = 1 |
| 步骤 7 | 注意力检查筛选 | 识别所有未能通过定向应答注意力检查题项的记录 | 排除所有此前未被排除的失败记录 | 在 screening_log_v1.xlsx 中记录被排除数量;指定主要排除原因 primary exclusion_reason = 3 |
| 步骤 8 | 模式化应答筛选 | 识别在36个评分量表题项中连续18个或以上相同应答的记录,或这些题项上个体内标准差 ≤0.25 的记录 | 排除所有此前未被排除的此类记录 | 在 screening_log_v1.xlsx 中记录被排除数量;指定主要排除原因 primary exclusion_reason = 4 |
| 步骤 9 | 逻辑一致性筛选 | 识别表现出预设不可能行为组合的记录:weekday_internet_use 和 weekend_internet_use 均编码为 <2 h,late_night_use 编码为几乎每晚,且在20个IAT题项中至少有18个得分5 | 排除所有此前未被排除的此类记录 | 在 screening_log_v1.xlsx 中记录被排除数量及审查备注;指定主要排除原因 primary exclusion_reason = 5 |
| 步骤 10 | 核心缺失值筛选 | 识别在 IAT_1–IAT_20、DERS_1–DERS_16、age、sex、weekday_internet_use、weekend_internet_use、sleep_duration、physical_activity 或 academic_stress 中存在任何缺失值的记录;“不愿透露”性别视为有效应答,不视为缺失 | 排除所有此前未被排除的此类记录 | 在 screening_log_v1.xlsx 中记录被排除数量;指定主要排除原因 primary exclusion_reason = 6 |
| 步骤 11 | 主要排除原因指定 | 识别满足多个排除标准的记录 | 将预设筛选顺序中首个触发的标准指定为主要排除原因 | 仅在审查备注中记录次要标志;不指定多个主要排除原因 |
| 步骤 12 | 技术标识符移除 | 识别清洗后文件中平台生成的应答标识符、设备限制标识符、账户限制标识符、时间戳及任何临时保留的技术元数据 | 在筛选完成后,从最终分析数据集中移除这些字段 | 在 screening_log_v1.xlsx 中记录移除操作 |
| 步骤 13 | 最终保留 | 保留通过所有先前筛选步骤的记录 | 为每条保留记录分配一个匿名研究ID | 保存为 analytic_dataset_v1.csv 和 analytic_dataset_v1.xlsx |
| 步骤 14 | 筛选汇总 | 统计每一步被移除的数量及最终保留的总数 | 汇总最终数量用于稿件报告 | 确保表2中的数量与图1一致 |
| 步骤 15 | 审计追踪保存 | 将原始文件、筛选日志和最终分析数据集作为独立文件保存 | 不得覆盖、合并或手动编辑已归档的源文件 | 分别存储于 raw-data、screening 和 analytic 文件夹中 |
表2:问卷清理的预设筛选顺序、排除阈值、筛选操作及记录规则。 本表总结了用于清理回收问卷的固定筛选顺序,包括知情同意与访问权限检查、重复问卷筛查、多设备记录协调、完成时间筛查、临界速度审查、注意力检查未通过、模式化作答、逻辑不一致、核心条目缺失、技术标识符删除、最终保留决定以及审计轨迹保存。缩写:IAT = 互联网成瘾测试;DERS-16 = 16项情绪调节困难量表。请点击此处下载该表格。
5. 评分变量、验证信度并准备可用于分析的文件
- 生成总分、子量表分和衍生的分类变量
- 将20个IAT条目得分相加,生成互联网成瘾总分,然后在可供分析的数据文件中同时保存连续型得分和三水平严重程度分类。
- 对DERS-16第1、6、8条进行反向计分,计算总分及五个子量表分,并将所有衍生变量追加至同一参与者水平的数据集。
- 在计算得分前进行范围检查。确认所有IAT和DERS-16条目值均在1–5范围内,所有反向计分后的值也在1–5范围内,IAT总分在20–100范围内,DERS-16总分在16–80范围内。将范围检查结果记录在评分日志中。
- 将协变量重新编码为固定的分析类别
- 将工作日和周末的互联网使用时长重新编码为:<2 h、2–3.9 h、4–5.9 h 和 ≥6 h;将深夜互联网使用频率重新编码为:从不、<1晚/周、1–2晚/周、3–5晚/周 和 几乎每晚。
- 根据第1.4节中预先规定的分类规则,对睡眠时长、体力活动频率和感知学业压力进行重新编码,并将重新编码后的值以固定的变量名存储在同一数据集中。
- 为回归分析对性别进行重新编码,使用两个指示变量:女性 vs. 男性,以及“不愿说明” vs. 男性。在表格脚注和README/代码本中报告编码方式。
- 验证评分完整性与内部一致性
- 在进行推断性分析前,计算IAT总分和DERS-16总分的Cronbach’s α系数。若任一α值<0.7020,则重新检查条目编码、反向计分及是否存在不可能的条目取值范围。在“代表性结果”部分报告Cronbach’s α值。
- 若任一量表显示出意外低的内部一致性,计算条目-总分相关或删除条目后的α值。除非预先规定了条目删除,或研究明确设计为心理测量学验证研究,否则不得从主要分析中移除量表条目。
- 保存最终的可供分析的数据集,并附上一个README文件,列出变量名、编码规则、排除阈值、文件名、软件版本、问卷版本、评分语法、回归模型设定,以及重新生成该数据集所需的全部操作流程。
6. 分析数据并保存可重复的输出结果
- 生成描述性统计量和组间比较
- 连续变量以均值 ± 标准差表示,分类变量以频数和百分比表示。使用预定义的输出结构汇总人口统计学特征、互联网使用行为和量表得分。
- 报告每次分析所使用的样本量。除非表格中明确说明,否则均以保留的分析样本作为分母。
- 比较 DERS-16 总分及各子量表得分在三个 IAT 严重程度组之间的差异,在主要分析中采用双侧检验,α = 0.05。在适当情况下报告标准化效应量。
注意:对于组间比较,方差分析应报告 η2 或偏 η2,若使用非参数检验,则报告相应的非参数效应量。当亚组样本量较小时,对严重问题性使用亚组的比较结果应谨慎解释。 - 当两个变量均呈现可接受的分布特征时,计算 IAT 总分与 DERS-16 总分之间的皮尔逊相关系数;否则,使用斯皮尔曼相关作为敏感性分析。报告样本量 n、相关系数 r 或 ρ、统计软件生成的 95% 置信区间、p 值以及相关强度的解释。
- 拟合调整后的回归模型并归档输出结果
- 以 DERS-16 总分为因变量,IAT 总分为主要自变量。将年龄、性别、工作日互联网使用时间、周末互联网使用时间、睡眠时长、体力活动和感知学业压力作为协变量纳入模型。该模型为标准化工作流程中预定义的分析示范。
- 在解释调整后的回归模型前,需评估回归假设和模型稳定性。检查残差-拟合值图以评估线性与同方差性,通过 Q-Q 图或正态性检验评估残差分布,并计算方差膨胀因子(VIF)以评估多重共线性。
- 在代表性结果部分或补充分析输出中报告这些诊断结果。
- 若检测到残差异方差性,应以异方差稳健标准误作为敏感性分析结果进行报告。
- 若存在强影响观测值,应报告在进行影响诊断后,IAT 总分的主要回归系数是否发生实质性变化。除非满足预先设定的数据质量规则,否则不得剔除强影响观测值。
- 报告调整后模型的非标准化系数、标准误、标准化系数、p 值、模型 R2、调整后 R2、模型 F 统计量及 VIF 范围。在表格标题或脚注中注明样本量。
- 若检验了交互作用、亚组效应或中介路径,应在数据收集前明确说明这些分析,或将其标注为探索性分析。核心方案不要求进行交互作用检验,除非亚组差异是预设的研究目标。
- 将所有统计代码、输出表格、残差图、VIF 输出、信度输出及生成的图表以版本控制的文件名保存。所有可报告的输出结果应直接从 analytic_dataset_v1 重新生成,而非来自手动编辑的文件。
注意:保持方案文本聚焦于工作流程的可重复性。详细的代表性统计结果、亚组图表、回归诊断、多重共线性评估及模型输出应在代表性结果部分呈现。
结果
研究流程与最终分析保留
结果展示了标准化问卷工作流程的实施过程,而非对网络成瘾测试或DERS-16的独立验证。在为期14天的调查期间,共邀请了520名大学生参与,回收有效问卷480份。筛查按照预先设定的顺序进行:首先剔除8份重复提交的问卷,随后剔除9份完成时间少于180秒的问卷、4份未能通过定向回答注意力检查题项的问卷、3份存在规律性作答模式的问卷、2份存在逻辑矛盾的问卷以及2份核心数据缺失的问卷。完成全部筛查流程后,最终分析数据集中保留了452份有效问卷。最终有效保留率为回收问卷的94.2%,占受邀学生的86.9%。从邀请到最终分析数据保留的问卷流程详见图1。
受试者特征
最终分析样本包括452名学生,平均年龄为20.41 ± 1.58岁。女性受访者占样本的较大比例,其中包括279名女生、167名男生和6名选择“不愿透露”的学生。参与者来自各个年级和多个学科,其中大二和大三年级的学生占比最高。大多数受访者居住在校园宿舍,每月生活支出主要集中在1,000–1,999元和2,000–2,999元区间。保留的样本还显示出较高的日常互联网使用率。在工作日,使用时间主要集中在2–3.9小时和4–5.9小时区间;而在周末使用时间有所增加,452名学生中有322人报告每天使用至少4小时。智能手机是最主要的上网方式。最常见的主要网络活动为社交媒体、娱乐/视频以及与学习相关的使用。在23:00之后的夜间使用现象较为普遍,452名学生中有228人报告每周至少有3个晚上进行夜间使用。睡眠时长主要集中在6至7.9小时之间,体育锻炼频率最常见为每周1–2次,而学业压力以中等程度为多数。保留样本的人口学与行为特征详见表3。
| 特征 | 类别 | n | % |
| 性别 | 雄性 | 167 | 36.9 |
| 女性 | 279 | 61.7 | |
| 不愿透露 | 6 | 1.3 | |
| 学年 | 第一年 | 88 | 19.5 |
| 第二年 | 124 | 27.4 | |
| 第三年 | 131 | 29 | |
| 四年级及以上 | 79 | 17.5 | |
| 研究生 | 30 | 6.6 | |
| 学科类别 | 人文与社会科学 | 118 | 26.1 |
| 科学与工程 | 96 | 21.2 | |
| 商业与管理 | 104 | 23 | |
| 艺术与设计 | 82 | 18.1 | |
| 其他 | 52 | 11.5 | |
| 居住类型 | 校内宿舍 | 301 | 66.6 |
| 校外租赁 | 79 | 17.5 | |
| 家庭住宅 | 58 | 12.8 | |
| 其他 | 14 | 3.1 | |
| 每月生活费用,CNY | <1,000 | 61 | 13.5 |
| 1,000–1,999 | 176 | 38.9 | |
| 2,000–2,999 | 149 | 33 | |
| ≥3,000 | 66 | 14.6 | |
| 工作日互联网使用 | <2 h | 52 | 11.5 |
| 2–3.9 小时 | 157 | 34.7 | |
| 4–5.9 小时 | 166 | 36.7 | |
| ≥6 小时 | 77 | 17 | |
| <2 h | 29 | 6.4 | |
| 2–3.9 小时 | 101 | 22.3 | |
| 4–5.9 小时 | 178 | 39.4 | |
| ≥6 小时 | 144 | 31.9 | |
| 主要在线活动 | 研究 | 74 | 16.4 |
| 社交媒体 | 126 | 27.9 | |
| 游戏 | 61 | 13.5 | |
| 娱乐/视频 | 102 | 22.6 | |
| 购物 | 28 | 6.2 | |
| 混合使用 | 47 | 10.4 | |
| 其他 | 14 | 3.1 | |
| 初级通路装置 | 智能手机 | 323 | 71.5 |
| 片剂 | 18 | 4 | |
| 笔记本电脑/台式机 | 67 | 14.8 | |
| 混合设备 | 44 | 9.7 | |
| 23:00后夜间使用 | 从不 | 48 | 10.6 |
| 每周少于一次 | 57 | 12.6 | |
| 每周1至2晚 | 119 | 26.3 | |
| 每周3至5晚 | 141 | 31.2 | |
| 几乎每个夜晚 | 87 | 19.2 | |
| 睡眠持续时间 | <6 h | 83 | 18.4 |
| 6–6.9 小时 | 146 | 32.3 | |
| 7–7.9 小时 | 157 | 34.7 | |
| ≥8 小时 | 66 | 14.6 | |
| 每周体育活动 | 无 | 91 | 20.1 |
| 1–2 次会话 | 176 | 38.9 | |
| 3–4 次会话 | 128 | 28.3 | |
| ≥5 次会话 | 57 | 12.6 | |
| 学业压力 | 低 | 73 | 16.2 |
| 中等 | 241 | 53.3 | |
| 高 | 138 | 30.5 | |
| 年龄,年 | 平均值 ± SD | 20.41 ± 1.58 | — |
表3:保留样本的基本人口统计学和行为特征。 本表展示了经过预设筛选后最终保留样本的人口统计学特征和互联网使用特征。变量包括性别、年级、学科类别、居住类型、月生活支出、工作日和周末互联网使用时长、主要在线活动、主要上网设备、23:00后夜间使用情况、睡眠时长、每周体育活动、学业压力以及年龄。缩写:CNY = 人民币元;SD = 标准差。请点击此处下载该表格。
网络成瘾严重程度、情绪调节结果及信度
在完整的保留样本中(n = 452),互联网成瘾测验总分为 51.94 ± 16.58。根据预先设定的严重程度阈值,200 名受访者被归类为正常使用者,239 名为问题使用者,13 名为严重问题使用者,使得问题使用组成为最大的亚组。保留样本中 DERS-16 总平均分为 35.95 ± 8.89。互联网成瘾测验显示出可接受的内部一致性,Cronbach’s alpha 为 0.91;DERS-16 同样显示出可接受的内部一致性,Cronbach’s alpha 为 0.88。当考察三个 IAT 严重程度组别中的 DERS-16 总分时,正常使用组的平均值最低,问题使用组的平均值较高,而严重问题使用组的平均值最高。在保留样本中(n = 452;F = 72.80, p < 0.001;η2 = 0.245),DERS-16 总分的组间比较具有统计学意义。DERS-16 各子量表的汇总结果也呈现出相同的趋势。由于严重问题使用亚组样本量较小(n = 13),其数值仅作为整体分布模式的一部分呈现,而不作为对严重亚组进行精细推断的基础。互联网成瘾严重程度与情绪调节结果汇总于表 4中。
| 测量指标 | 正常使用 | 问题性使用 | 严重问题性使用 | 总计 |
| n = 200 | n = 239 | n = 13 | n = 452 | |
| IAT 总分 | 34.20 ± 3.90 | 65.33 ± 6.90 | 78.70 ± 6.20 | 51.94 ± 16.58 |
| DERS-16 总分 | 31.20 ± 7.10 | 39.24 ± 8.30 | 48.50 ± 9.60 | 35.95 ± 8.89 |
| DERS-16 情绪不接纳 | 5.90 ± 1.90 | 7.29 ± 2.10 | 8.90 ± 2.40 | 6.72 ± 2.16 |
| DERS-16 目标干扰 | 6.20 ± 1.80 | 7.82 ± 2.00 | 9.10 ± 2.30 | 7.14 ± 2.09 |
| DERS-16 冲动控制困难 | 5.80 ± 1.70 | 7.72 ± 2.10 | 9.40 ± 2.50 | 6.92 ± 2.19 |
| DERS-16 情绪调节策略 | 9.60 ± 2.90 | 12.29 ± 3.30 | 15.10 ± 3.80 | 11.18 ± 3.44 |
| DERS-16 情绪清晰度 | 3.70 ± 1.30 | 4.18 ± 1.40 | 5.00 ± 1.60 | 3.99 ± 1.41 |
| IAT Cronbach’s alpha | — | — | — | 0.91 |
| DERS-16 Cronbach’s alpha | — | — | — | 0.88 |
| DERS-16 总分组间比较 | — | — | — | F = 72.80; p < 0.001; η² = 0.245 |
| IAT 总分与 DERS-16 总分的 Pearson 相关性 | — | — | — | n = 452; r = 0.524; 95% CI: 0.45–0.59; p < 0.001 |
表4:最终分析样本中的网络成瘾严重程度分组、情绪调节结果、信度及相关性。 本表报告了正常使用组、问题使用组和严重问题使用组在IAT总分、DERS-16总分以及DERS-16各子量表得分上的结果。同时报告了整个样本的均值、IAT和DERS-16的Cronbach’s α系数、DERS-16总分的组间比较结果,以及IAT总分与DERS-16总分之间的Pearson相关系数。缩写:IAT = 网络成瘾测试;DERS-16 = 16项情绪调节困难量表;CI = 置信区间;SD = 标准差。请点击此处下载该表格。
网络成瘾与情绪调节之间的关联
在保留的分析样本(n = 452)中,评估了IAT总分与DERS-16总分之间的预定义连续评分关联。IAT总分与DERS-16总分之间的皮尔逊相关系数为正值,且相关性强度中等(r = 0.524,95% CI:0.45–0.59, p < 0.001)。因此,IAT总分较高的学生倾向于报告在情绪调节方面存在更大的总体困难。该结果与严重程度分组分布一致,并不完全依赖于IAT的分类界定,如表4所示。
多变量回归分析
校正后的回归模型纳入了保留的分析样本(n = 452)。以DERS-16总分为因变量,IAT总分为主要自变量。年龄、性别、工作日互联网使用时间、周末互联网使用时间、睡眠时长、每周体力活动水平和学业压力在同一模型中作为协变量纳入。性别采用预先设定的指示变量编码,以男性为参照类别,并分别为女性和“不愿透露”设置独立指示变量。校正后,IAT总分仍与DERS-16总分呈正相关(B = 0.21,SE = 0.02,β = 0.39,p < 0.001)。在协变量中,学业压力与DERS-16总分呈正相关(B = 2.36,β = 0.23,p < 0.001),而睡眠时长(B = -1.12,β = -0.13,p < 0.001)和每周体力活动水平(B = -0.84,β = -0.10,p = 0.003)与DERS-16总分呈负相关。工作日互联网使用时间在校正后仍保留较小的正向系数(B = 0.71,β = 0.09,p = 0.015),而周末互联网使用时间在校正模型中未达到统计学显著性(B = 0.49,β = 0.07,p = 0.071)。在相同设定下,年龄及两个性别指示变量均未显示出显著的独立预测作用。该模型解释了DERS-16总分39.8%的变异量,调整后的R2为0.386,整体模型具有统计学显著性,F(9, 442) = 32.47,p < 0.001。多重共线性不明显,方差膨胀因子介于1.03至1.42之间。残差诊断未发现线性假设或同方差性在残差-拟合值图中存在重大违背。残差Q-Q图显示近似正态性无明显偏离。Breusch-Pagan检验无统计学显著性,p = 0.214。最大Cook距离为0.18,无任何观测值的Cook距离超过0.50。校正后的回归模型详见表5。
| 预测因子 | B | 标准误 | β | t | p | VIF |
| 常数项 | 18.42 | 2.11 | — | 8.73 | <0.001 | — |
| IAT 总分 | 0.21 | 0.02 | 0.39 | 9.84 | <0.001 | 1.42 |
| 年龄 | 0.18 | 0.11 | 0.03 | 1.64 | 0.102 | 1.08 |
| 性别,女性 vs. 男性 | 0.62 | 0.54 | 0.04 | 1.15 | 0.252 | 1.05 |
| 性别,拒绝说明 vs. 男性 | 0.28 | 1.89 | 0.01 | 0.15 | 0.882 | 1.03 |
| 工作日互联网使用 | 0.71 | 0.29 | 0.09 | 2.45 | 0.015 | 1.36 |
| 周末互联网使用 | 0.49 | 0.27 | 0.07 | 1.81 | 0.071 | 1.31 |
| 睡眠时长 | -1.12 | 0.31 | -0.13 | -3.61 | <0.001 | 1.18 |
| 每周体育活动 | -0.84 | 0.28 | -0.1 | -3 | 0.003 | 1.12 |
| 学业压力 | 2.36 | 0.39 | 0.23 | 6.05 | <0.001 | 1.27 |
表5:最终分析样本中DERS-16总分对IAT总分及协变量的多变量线性回归。 本表展示了以DERS-16总分为因变量、IAT总分为主要自变量的校正回归模型。模型中纳入年龄、性别、工作日互联网使用时间、周末互联网使用时间、睡眠时长、每周体力活动水平和学业压力作为协变量。表中还报告了标准化回归系数、方差膨胀因子(VIF)以及模型诊断结果。缩写:IAT = 互联网成瘾测试;DERS-16 = 16项情绪调节困难量表;VIF = 方差膨胀因子。请点击此处下载该表格。
补充表1:标准化问卷工作流程中使用的完整变量字典、文件存在性、编码结构及数据管理字段。 本补充表提供了该方案的完整变量字典,包括伦理与知情同意变量、调查设置变量、人口统计学变量、互联网使用变量、质量控制标记、量表条目、衍生分数、协变量、技术标识符字段、数据集追踪变量、文件状态信息以及编码规则。缩写:IAT = 互联网成瘾测试;DERS-16 = 16项情绪调节困难量表。请点击此处下载该文件。
补充文件 1:补充问卷工作流程材料。 本补充文件包含用于重现标准化问卷施测、筛选、评分和分析工作流程的问卷文件、编码手册、筛选日志、输出计划以及可供分析的工作流程材料。请点击此处下载该文件。
讨论
本文的主要贡献在于标准化的问卷工作流程,而非互联网成瘾与情绪调节困难之间观察到的代表性关联。实施结果表明,在大学生样本中,可以执行一系列固定顺序的步骤,包括电子知情同意、人口统计学问卷、互联网使用行为评估、IAT评分、DERS-16评分、协变量收集、顺序性数据质量筛选以及可重复的回归分析。这种程序性强调具有重要意义,因为在现有文献中,问题性互联网使用常与情绪调节障碍相关联,但不一致的施测和数据清理流程可能导致不同研究之间的结果难以比较21。因此,本工作流程通过在解释结果之前明确测量顺序、排除标准、评分步骤和分析输出,支持了研究结果之间的可比性。
有若干操作步骤对于可重复性尤为关键。首先,在访问问卷之前必须完成电子知情同意,且用于重复项筛查的技术标识符必须与最终的匿名分析数据集相分离。其次,重复项筛查应在完成时间筛查、注意力检查审查、模式化应答筛查、逻辑一致性审查以及缺失值检查之前进行,因为改变这一顺序可能影响最终保留的样本。第三,内隐联想测试(IAT)和情绪调节困难量表-16(DERS-16)的计分流程必须在数据收集前锁定,包括反向计分和严重程度分类。这些步骤有助于减少在线调查研究中可避免的变异,也与更广泛的研究关切一致:互联网成瘾的研究结果可能受到压力、自我控制能力和焦虑等因素的影响,同时也可能受测量方法差异的影响22。
在实施过程中,该方案还需要进行多项故障排查检查。如果调查平台无法限制重复提交,则应通过账户限制标识符、设备限制标识符、时间戳、问卷状态以及应答模式相似性等多种方式组合进行重复记录筛查。若大量记录处于临界速度范围内,则不应仅依赖完成时间,而应结合注意力检查结果、长字符串应答数量、个体内部标准差以及逻辑一致性标记进行综合评估。若Cronbach’s alpha值意外偏低,应在做出任何条目层面的决策前,首先检查条目的编码、反向编码及得分范围。这些步骤尤为重要,因为在线行为和智能手机相关行为与睡眠及情绪调节过程密切相关,若筛查疏忽或编码错误,可能导致推论偏差23。
在代表性实施中所使用的排除阈值应在本工作流程内视为标准化,但并不适用于所有未来人群而固定不变。180秒的最低完成时间阈值源自预实验测试,当该方案应用于老年人、青少年、多语言受访者、适配无障碍需求的问卷或具有不同显示格式的平台时,应重新校准。当量表长度、题目顺序或作答锚点不同时,逻辑不一致规则和模式化作答判定标准也可能需要调整。同样,代表性实施中发现的小型但严重的问题性使用亚组表明,旨在进行亚组比较的研究应在数据收集前提高招募目标或采用分层抽样方法。这种灵活性至关重要,因为包括体力活动在内的行为与生活方式变量,可能以不同方式与注意力、反刍思维和自我调节相互作用,且这些作用在不同学生群体间可能存在差异24。
在应用本方案时,应考虑若干局限性。该工作流程采用自报告式量表,因此回忆误差、社会期望偏差以及共同方法变异可能影响暴露和结局的测量结果。通过使用中性措辞、固定问卷顺序、注意力检查、预设协变量以及对缺失和排除情况的透明报告,可在一定程度上降低这些风险,但无法完全消除。未来的研究还可纳入客观的数字行为测量指标,例如智能手机屏幕使用时间日志、应用程序使用记录或平台提供的使用汇总数据,以增强构念效度。然而,这些补充措施需要单独的知情同意条款、隐私保护措施、数据最小化程序以及数据关联规则。因此,应将其作为预设的方案扩展内容加入,而非对问卷工作流程的非正式补充25。
该方案具有可适应性,但不应机械地应用于所有场景。在非大学人群的研究中,可能需要修订入组标准、招募渠道、学业压力条目以及互联网使用类别。在国际多中心研究中,应在合并数据前记录翻译、文化调适、平台等效性、时区处理、数据保护规则以及各研究点的监测情况。如果使用更新的或针对特定人群的测量工具替代网络成瘾量表(IAT),仍可保留原有工作流程,但在数据收集前需更新评分范围、严重程度阈值、编码手册、分析语法、材料表以及补充变量字典。区分互联网使用时长与失控行为性使用非常重要,因为仅凭在线时间可能无法准确反映问题性或强迫性使用的相同构念26。
最后,本研究的代表性实施为横断面设计,不应将其解读为具有时间方向性的证据。IAT总分与DERS-16总分之间观察到的关联仅说明了分析路径的运行方式,而不能确定情绪调节困难是否导致问题性互联网使用,或问题性互联网使用是否会随时间推移加剧情绪调节困难。其他高校环境中也报告了类似的横断面模式,但需通过纵向研究或重复测量设计来检验方向性与变化趋势27。本方案的价值在于为未来此类研究提供了稳定的基线工作流程。通过标准化知情同意、问卷施测、筛选、评分、信度检查、模型诊断、文件归档及补充文档记录,该方案不仅可支持更具可重复性的横断面研究,也可在时间性问题成为主要研究目标时,拓展应用于纵向研究或干预设计28。方案中包含代码本、筛选日志、输出计划以及可供分析的工作流程材料,也符合面向FAIR原则的研究软件与工作流程文档规范29,并契合更广泛的开放科学倡议中关于透明化与可重复报告的建议30。
披露
作者无任何利益冲突需要披露。
致谢
本研究得到2025年河南省软科学项目“学龄人口变化对河南民办高等教育高质量发展的影响及优化路径研究”(项目编号:252400410490)以及2025年郑州工商学院博士科研基金项目“大学生网络集群行为的形成机制与舆情引导机制研究”的资助。作者感谢郑州工商学院提供的机构支持。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| 分析就绪数据集 | 研究专用内部文档 | analytic_dataset_v1.csv 和 analytic_dataset_v1.xlsx | 用于所有可报告的描述性统计、信度、相关性和回归分析的最终匿名化数据集 |
| 分析语法脚本 | 研究专用内部文档 | analysis_syntax_v1.R 或等效脚本文件 | 用于复现评分验证、信度检查、描述性统计、相关性分析、回归建模、VIF 计算及诊断输出 |
| 注意力检查题项措辞 | 研究专用内部文档 | attention_check_v1.txt | 问卷施测期间所用定向应答式注意力检查题项的锁定措辞 |
| DERS-16 问卷 | 原始量表来源或授权/改编版问卷 | 16-item Difficulties in Emotion Regulation Scale short form | 用于评估情绪调节困难程度;评分依据代码本中记录的锁定版 DERS-16 评分标准 |
| 电子版信息告知书与知情同意页面 | 研究专用内部文档 | consent_form_v1.pdf 或平台同意页面 | 在访问问卷前用于提供研究信息并获取电子知情同意 |
| 文件命名规范表 | 研究专用内部文档 | file_naming_convention_v1.xlsx | 用于标准化原始数据、清洗后数据、分析数据、筛选日志、代码本及输出文件的命名 |
| 最终问卷截图 | 研究专用内部文档 | questionnaire_screenshots_v1.pdf | 用于记录锁定的调查界面显示、题项顺序、应答锚点及必答题设置 |
| 集成开发环境 | Posit | RStudio Desktop | 用于管理脚本、日志及可重复的分析工作流程 |
| 网络成瘾测试问卷 | 原始量表来源或授权/改编版问卷 | 20-item Internet Addiction Test | 用于评估网络成瘾症状,并将使用情况分类为正常使用、问题性使用和严重问题性使用 |
| 在线调查平台 | Qualtrics | XM Platform;机构或授权账户 | 用于构建问卷、强制设置必答题、管理基于知情同意的访问权限、在启用时限制重复提交,并导出应答数据 |
| 可选菜单式统计软件包 | IBM | SPSS Statistics | 当需要基于图形用户界面(GUI)进行描述性统计、信度检查或回归分析时使用 |
| README/代码本文件 | 研究专用内部文档 | README_v1.txt 或 codebook_v1.xlsx | 用于记录变量名称、编码规则、分数范围、反向计分规则、排除阈值、文件名及软件版本 |
| 只读归档副本 | 便携式文档格式 | PDF/A 或机构批准的归档 PDF | 用于保存锁定的调查工具、知情同意页及支持性研究方案文件 |
| 筛选日志工作簿 | 研究专用内部文档 | screening_log_v1.xlsx | 用于记录重复筛选、完成时间筛选、注意力检查未通过、模式化作答、逻辑不一致、缺失情况、人工审核决策及最终保留的样本数量 |
| 电子表格软件 | Microsoft | Microsoft Excel 工作簿格式 (.xlsx) | 用于筛选日志、变量字典、人工审核记录及补充工作簿的准备 |
| 统计计算环境 | R Foundation / CRAN | R 4.5.3 | 用于评分验证、描述性统计、信度检查、相关性分析、回归分析、VIF 计算及诊断输出 |
| 补充文件 1 | 研究专用补充文件 | Supplementary File 1.xlsx | 包含问卷工作流程材料、代码本、筛选日志、输出计划及分析就绪工作流程材料 |
| 补充表 S1 | 研究专用补充表格 | Supplementary Table S1 | 提供完整的变量字典、文件存在性、编码结构、技术标识字段、筛选变量及数据集追踪字段 |
| 调查导出文档 | Qualtrics | Survey-to-Word 导出或 PDF 导出 | 用于归档最终问卷措辞、题项顺序、跳转设置、必答题设置及应答编码 |
| 调查导出格式 | Qualtrics | CSV 导出 | 用于原始数据保留及分析就绪数据的导出 |
参考文献
- Moreno MA, et al. Problematic internet use among US youth: a systematic review. Arch Pediatr Adolesc Med. 2011;165:797-805.
- Ramón-Arbués E, et al. Prevalence and factors associated with problematic internet use in a population of Spanish university students. Int J Environ Res Public Health. 2021;18:7620.
- Cai Z, et al. Associations between problematic internet use and mental health outcomes of students: a meta-analytic review. Adolesc Res Rev. 2023;8:45-62.
- Gong Z, Wang L, Wang H. Perceived stress and internet addiction among Chinese college students: mediating effect of procrastination and moderating effect of flow. Front Psychol. 2021;12:632461.
- Tsai JK, et al. Relationship between difficulty in emotion regulation and internet addiction in college students: a one-year prospective study. Int J Environ Res Public Health. 2020;17:4766.
- Romero-López M, Pichardo C, De Hoces I, García-Berbén T. Problematic internet use among university students and its relationship with social skills. Brain Sci. 2021;11:1301.
- Xie X, et al. Problematic internet use was associated with psychological problems among university students during COVID-19 outbreak in China. Front Public Health. 2021;9:675380.
- Montagni I, et al. Mental health-related digital use by university students: a systematic review. Telemed J E Health. 2020;26:131-146.
- Candussi CJ, Kabir R, Sivasubramanian M. Problematic smartphone usage, prevalence and patterns among university students: a systematic review. J Affect Disord Rep. 2023;14:100643.
- Moon SJ, Hwang JS, Kim JY, Shin AL, Bae SM, Kim JW. Psychometric properties of the Internet Addiction Test: a systematic review and meta-analysis. Cyberpsychol Behav Soc Netw. 2018;21:473-484.
- Jelenchick LA, Becker T, Moreno MA. Assessing the psychometric properties of the Internet addiction test in US college students. Psychiatry Res. 2012;196:296-301.
- Tafur-Mendoza AA, Acosta-Prado JC, Zárate-Torres RA, Ramírez-Ospina DE. Assessing the psychometric properties of the Internet addiction test in Peruvian university students. Int J Environ Res Public Health. 2020;17:5782.
- Fernández-Villa T, Molina AJ, García-Martín M, Llorca J, Delgado-Rodríguez M, Martín V. Validation and psychometric analysis of the Internet addiction test in Spanish among college students. BMC Public Health. 2015;15:953.
- World Medical Association. World Medical Association Declaration of Helsinki: ethical principles for medical research involving human subjects. JAMA. 2013;310:2191-2194.
- Wei Z, Hassan NC, Hassan SA, Ismail N, Gu X, Dong J. Psychometric validation of Young’s Internet addiction test among Chinese undergraduate students. PLoS One. 2025;20:e0320641.
- Bjureberg J, et al. Development and validation of a brief version of the Difficulties in emotion regulation scale : the DERS-16. J Psychopathol Behav Assess. 2016;38:284-296.
- Muszyński M. Attention checks and how to use them: review and practical recommendations. ASK: Research and Methods. 2023;32:3-38.
- Broman KW, Woo KH. Data organization in spreadsheets. Am Stat. 2018;72:2-10.
- Leiner DJ. Too fast, too straight, too weird: non-reactive indicators for meaningless data in internet surveys. Surv Res Methods. 2019;13:229-248.
- Taber KS. The use of Cronbach’s alpha when developing and reporting research instruments in science education. Res Sci Educ. 2018;48:1273-1296.
- Gioia F, Rega V, Boursier V. Problematic Internet use and emotional dysregulation among young people: a literature review. Clin Neuropsychiatry. 2021;18:41-54.
- Chen M, Zhang X. Factors influencing internet addiction among university students: the mediating roles of self-control and anxiety. Acta Psychol (Amst). 2024;250:104535.
- Akbari M, Seydavi M, Sheikhi S, Spada MM. Problematic smartphone use and sleep disturbance: the roles of metacognitions, desire thinking, and emotion regulation. Front Psychiatry. 2023;14:1137533.
- Wang S, Cheng Y, Yang Y, Lu B. The impact of physical activity on internet addiction among college students: the chain mediation role of rumination and mindfulness. BMC Public Health. 2025;25:3643.
- Struminskaya B, Sakshaug JW. Ethical considerations for augmenting surveys with auxiliary data sources. Public Opin Q. 2023;87:619-633.
- Yin J, et al. Associations between both smartphone addiction and objectively measured smartphone use and sleep quality and duration among university students: a cross-sectional study. JMIR Ment Health. 2025;12:e77796.
- Hainagiu SM, Neagu SN. Caught in the Web—emotional regulation difficulties and internet addiction among Romanian medical and technical university students: a pilot cross-sectional study. Healthcare (Basel). 2025;13:2528.
- Guo C, Chen M, Ji X, Li J, Ma Y, Zang S. Association between internet addiction and sleep quality in medical students: a longitudinal study. Front Psychol. 2025;16:1517590.
- Barker M, Chue Hong NP, Katz DS, Lamprecht AL, Martinez-Ortiz C, Psomopoulos F, et al. Introducing the FAIR Principles for research software. Sci Data. 2022;9:622.
- Nosek BA, Alter G, Banks GC, Borsboom D, Bowman SD, Breckler SJ, et al. Promoting an open research culture. Science. 2015;348:1422-1425.