本单中心回顾性研究建立并进行了动脉瘤性蛛网膜下腔出血后迟发性脑缺血的逻辑回归模型的内部验证。在680例患者中,六个早期临床、实验室和影像学变量显示出初步的预测价值。在用于临床实践之前,尚需进一步的外部验证。
本文内容
摘要
摘要
迟发性脑缺血(DCI)是动脉瘤性蛛网膜下腔出血(aSAH)后继发性神经功能损伤的重要原因。本研究为一项回顾性单中心研究,利用2022年7月至2024年12月期间收治的680例aSAH成年患者的数据,建立并评估了DCI的预测模型。根据结局分层,采用8:2的比例将患者分为训练队列(544例)和独立内部验证队列(136例)。训练队列中有175例发生DCI,内部验证队列中有42例发生DCI。在训练队列中,采用10折交叉验证的最小绝对收缩与选择算子回归进行预测变量筛选,最终保留6个变量:年龄、脑水肿、低白蛋白血症、改良Fisher分级、Hunt-Hess分级和世界神经外科医师联合会分级。比较了逻辑回归、极端梯度提升、轻量梯度提升机、支持向量机和K近邻模型的性能。在内部验证队列中,逻辑回归模型的受试者工作特征曲线下面积为0.832(95%置信区间,0.758–0.906);其校准斜率、校准截距和Brier评分为分别为0.98、0.02和0.168,但这些校准指标的置信区间不可获得。研究结果反映了在单一独立内部验证队列中的初步性能表现。由于缺乏完整的可重复性记录、模型截距缺失、未进行基于重抽样的乐观性校正,以及缺乏外部验证,目前尚无法实现个体患者层面的概率计算和临床应用。
引言
已提出多种用于预测aSAH后DCI的模型,但许多模型受限于样本量较小、校准评估不完整、模型开发过程报告不足,以及缺乏外部验证。多数研究主要关注区分度,而校准性、可重复性及临床影响评估的报告则相对不充分。因此,当验证仅限于单一中心时,应采用透明的方法评估模型性能,并谨慎解读结果。
本研究旨在利用常规可获取的早期临床、实验室和影像学变量,开发并进行内部评价脑血管痉挛(DCI)的预测模型。采用五种建模方法,基于相同的一组选定预测因子进行比较。预期的预测时间点为初次入院、实验室检查和影像学评估完成后,但在主要DCI高风险期之前。这些模型用于基于研究的风险评估,而非用于诊断DCI、替代临床判断或独立决定治疗方案。在临床应用前,尚需进行外部验证、重新校准以及临床影响测试。
迟发性脑缺血(DCI)是继发性脑损伤中一种在临床上最为显著且潜在可预防的状况,常见于动脉瘤性蛛网膜下腔出血(aSAH)之后。DCI 通常在发病数天后出现,多发生于 3–14 天内,与新的局灶性神经功能缺损、意识水平下降和/或后续神经影像学上出现脑梗死相关。尽管不同医疗机构在诊断实践上存在一些差异,但 DCI 始终与重症监护病房住院时间延长、医疗资源消耗高以及神经功能预后不良相关。报道的 DCI 发生率通常为 30–40%,凸显了其高发性及重要的预后意义1,2,3,4,5,6值得注意的是,迟发性脑缺血(DCI)并非单一通路的过程。尽管研究重点一直集中在大血管脑血管痉挛上,但越来越多的证据表明,早期脑损伤、皮质扩散性去极化、神经炎症、微血栓形成、内皮功能障碍、自动调节受损以及微循环衰竭均参与了缺血风险的形成。这种多因素的病理生理机制有助于解释 为何以血管痉挛为靶点的治疗可能无法完全预防与DCI相关的梗死,以及为何在常规临床环境中难以识别高危患者。
对动脉瘤性蛛网膜下腔出血(aSAH)后迟发性脑缺血(DCI)进行风险分层至关重要,因为通过及时识别高危患者,可能实现更密切的监测,并及时加强预防或抢救措施7。临床实践中的监测方案可包括更频繁的神经系统检查、经颅多普勒超声、先进的影像学技术(如CT灌注成像)、血流动力学和血管内容量优化、严格遵循尼莫地平治疗方案,以及早期识别神经系统恶化情况,例如脑积水、再出血、癫痫发作、感染或代谢失衡。然而,目前临床决策更多依赖于整体严重程度评分和临床医生的经验,而非基于个体化数据驱动的DCI发生概率评估8,9,10。其中一个原因是文献表明,DCI的危险因素具有异质性,患者自身因素、出血负荷、生理紊乱与神经功能评分量表之间的相互作用可能是非线性的且极为复杂。既往研究已探讨了DCI的潜在预测因子,包括年龄、高血压、基线神经功能状态、动脉瘤特征、实验室指标(如血清钠和白蛋白水平)、提示出血负荷的影像学特征,以及围手术期或治疗相关因素。传统的回归分析方法虽有一定帮助,但在预测因子之间存在相关性、预测因子与风险之间的关系呈非线性,或变量间存在交互作用时可能受到限制11。与此同时,已有多种工具(最常见的是列线图)被提出用于评估DCI风险。尽管列线图具有可行性且视觉直观,但大多数基于小样本构建,纳入变量较少,可能存在过拟合或验证不足的问题。此外,由于不同医疗机构在患者构成、影像解读、治疗策略及DCI诊断阈值方面存在差异,某一中心开发并验证的模型可能难以直接推广至其他医疗单位。
机器学习方法可作为传统临床预测模型的补充,因其能够探索临床数据的更多维度,观察更为复杂的变化趋势,而无需做出严格的线性假设。近年来,基于机器学习的预测模型在脑血管疾病领域中的应用日益广泛,包括用于预后与并发症的预测,以及临床决策支持。12,13,14常用的机器学习算法包括集成树方法,如极端梯度提升(XGBoost)和轻量梯度提升机(LightGBM)、基于核的分类器如支持向量机(SVM),以及基于距离的分类器如k近邻算法(KNN)。这些模型原则上能够对非线性关系进行建模 比传统方法更能揭示相互作用15然而,机器学习模型也存在一些实际问题,例如过拟合风险、可解释性降低,以及需要处理数据预处理、参数调优、校准、评估和验证等环节。值得注意的是,在广泛的临床应用场景中,当预测变量数量较少且信噪比适中时,结构良好的逻辑回归模型的表现可与更复杂的算法相当,甚至更为有效。因此,有必要采用相似的预测变量和评估指标对多种算法进行比较分析,以确定与模型性能和临床适用性相关的方法16,17,18.
既往已提出多种迟发性脑缺血的预测模型,但许多模型存在重要局限性,包括样本量小、校准评估有限、缺乏算法间的直接比较以及验证不足。此外,以往研究常侧重于区分能力,而对校准性能和临床实用性指标的报告不足,而这些指标对于实际应用至关重要。本研究通过在相对较大的队列中构建预测模型,采用最小绝对收缩与选择算子(LASSO)回归进行系统性的预测因子筛选,在统一的建模框架内比较多种机器学习算法,并全面评估模型的区分能力、校准性能及决策分析表现,从而弥补了上述不足。
已有多种关于aSAH后DCI的预测模型被提出,但许多模型存在重要局限性,包括队列规模较小、校准评估不足、模型开发过程报告不完整,以及缺乏外部或时间验证。此外,许多研究仅报告了区分度,而校准和决策曲线分析的报告则不够一致。本研究并未解决外部验证的问题,而是基于常规可获取的临床、实验室和影像学变量,开展了一项单中心模型开发与内部验证研究。该模型的目标应用场景是在患者入院并完成动脉瘤初期治疗后、主要DCI风险期开始之前,进行早期风险分层。该模型可帮助临床医生识别出需要更密切神经功能监测、血管影像学随访、纠正生理异常以及由神经重症团队早期评估的患者。但该模型并非用于替代临床判断、诊断DCI,或在未经外部验证和临床影响测试前指导治疗。既往研究已提出多个预测aSAH后DCI的模型,但这些研究多受限于样本量小、校准报告不完整、不同建模方法间比较有限,或缺乏外部验证。本研究并不声称提供一种经过临床验证的决策工具,而是旨在利用单中心队列中常规可获取的早期临床、实验室和影像学变量,开发并进行内部验证。其预期用途是在患者入院并完成动脉瘤初始治疗后、主要DCI风险期之前,实现早期风险分层。在此背景下,较高的预测风险可支持更密切的神经系统评估、血管监测、生理异常纠正以及神经重症团队的早期介入。该模型并不用于诊断DCI或取代临床医生的判断。
方案
本研究经中国陕西省榆林市第一医院机构伦理委员会批准。由于这是一项对常规收集的医院数据进行的回顾性分析,且所有数据在分析前均已匿名化处理,因此豁免了书面知情同意的要求。本研究遵循机构数据保护要求及《赫尔辛基宣言》的原则进行。
数据与方法
研究人群与设计
这是一项在中国陕西省榆林市第一医院开展的单中心回顾性队列研究。研究筛选了2022年7月至2024年12月期间因动脉瘤性蛛网膜下腔出血(aSAH)入院的患者病历。符合纳入标准的患者为年龄≥18岁的成年人,其aSAH诊断经颅脑及颅内血管影像学检查确认。患者需在症状出现后72小时内入院,并在本次住院期间接受动脉瘤治疗。
若患者存在创伤性蛛网膜下腔出血、非动脉瘤性蛛网膜下腔出血、严重的既往血液系统疾病、其他影响结局评估的主要颅内病变、DCI评估记录不完整或在充分DCI评估期前发生院内死亡,则予以排除。排除早期院内死亡病例可能引入生存偏倚,因为最严重的病例可能被排除在分析之外。因此,研究结果应主要适用于存活时间足以进行DCI评估的患者。
数据收集
临床、实验室、影像学及治疗相关变量均通过预定义的数据提取表从电子病历中提取。提取的变量包括人口统计学因素、病史、动脉瘤特征、早期神经功能分级、早期影像学发现、实验室结果、治疗方案及院内并发症。预定的预测时间点设定在完成初次入院及围手术期评估之后,但在主要迟发性脑缺血风险窗口期之前。
年龄、性别、体重指数、吸烟状况、饮酒情况、高血压、糖尿病、动脉瘤大小、动脉瘤位置、改良 Fisher 分级、Hunt-Hess 分级、世界神经外科医师联合会分级、脑室内出血以及再出血信息均取自入院记录和初始影像资料。实验室变量,包括血红蛋白、血清白蛋白和血清钠,取自预测时间点前最早可获得的血液检测结果。脑水肿评估采用迟发性脑缺血诊断前可获得的基线或治疗后即刻影像。为减少信息泄露,仅在迟发性脑缺血发生后记录的变量不用于模型开发。
贫血定义为血红蛋白 <女性患者为110克/升, <120 g/L(男性患者)。低白蛋白血症定义为血清白蛋白 <35 g/L。低钠血症定义为血清钠 <130 mmol/L。
患者管理遵循机构性动脉瘤性蛛网膜下腔出血护理路径。标准管理包括早期动脉瘤处理、神经学观察、血压控制、液体与电解质管理,以及对并发症的监测,包括脑积水、再出血、癫痫、感染、血管痉挛和迟发性脑缺血。除非存在禁忌症,否则均使用尼莫地平。临床指征明确时,通过神经学检查、血管成像和经颅多普勒超声进行血管痉挛监测。需要时,通过脑脊液分流术处理脑积水。血流动力学优化和挽救性治疗由治疗团队根据具体情况实施。’评估。由于回顾性数据集未能完整记录治疗强度和挽救疗法的具体细节,这些因素无法在模型中完全校正,这被视为一项局限性。
减压病的诊断
迟发性脑缺血被定义为在预期的迟发性脑缺血风险窗口期内发生的、且无法用其他原因解释的新的局灶性神经功能缺损、意识水平下降,或随访计算机断层扫描或磁共振成像显示的新发脑梗死。迟发性脑缺血风险窗口期定义为第3天–出血发作后14天内。在将事件归类为迟发性脑缺血前,需排除其他可能的解释,包括再出血、脑积水、癫痫发作、感染、代谢紊乱、镇静剂效应以及手术相关梗死。
结局判定由两名具有动脉瘤性蛛网膜下腔出血管理经验的临床医生执行,包括一名神经外科医生和一名神经内科/神经重症监护医生。判定人员审阅了临床记录、神经系统检查、影像学报告及随访影像。在结局评估过程中,他们对最终模型输出结果不知情。分歧通过共识讨论并回顾相关影像和临床时间线得以解决。未测量正式的评估者间一致性,增加此限制是因为迟发性脑缺血分类可能涉及临床判断。
样本量计算
样本量估算采用“每变量10个事件”(EPV)的经验法则。11在拥有20个候选预测变量且预期DCI发生率约为35%的情况下,最小样本量为20。 × 10 / 0.35 ≈ 所需样本量为572例。我们最终纳入的680例患者队列超过了这一要求。虽然事件数-变量数(EPV)规则被用作一般性指导原则,但现代预测建模,特别是机器学习算法,可能需要更灵活的样本量考量。最终队列规模被认为足以确保模型稳定性、最小化过拟合风险,并能够可靠地估计模型性能指标。
模型开发与验证
患者被分配至一个包含544名患者的训练队列和一个包含136名患者的保留内部验证队列,分配方式采用基于结局分层的8:2比例划分。采用结局分层是为了确保两个队列中迟发性脑缺血事件的比例相近。在训练队列的544名患者中,有175人发生了迟发性脑缺血;在内部验证队列的136名患者中,有42人发生了迟发性脑缺血。保留8:2的保留设计是因为这是预先设定的模型开发策略,并且它提供了一个独立的队列用于初步的内部性能评估。
预测因子的筛选仅在训练队列中进行,采用最小绝对收缩与选择算子回归,并辅以10折交叉验证。所选的惩罚参数为 λ = 0.031。保留了六个预测因子:年龄、脑水肿、低白蛋白血症、改良 Fisher 分级、Hunt-Hess 分级和世界神经外科医师联合会分级。
逻辑回归、极限梯度提升、轻量梯度提升机、支持向量机以及k-近邻模型均使用同一组选定的预测因子进行构建。所有数据预处理、预测因子筛选及模型开发步骤均仅限于训练队列中进行。内部验证队列在预测因子筛选或模型调优阶段均未被使用,仅在模型开发完成后才用于评估。
原始队列分配所使用的数值随机种子未在存档分析记录中保留,因此无法进行追溯验证。自助法乐观度校正与重复k折内部验证亦不可用。因此,本分析被描述为单次保留集内部验证,而非经过乐观度校正或重复交叉验证的性能评估。
机器学习可重复性
LASSO预测因子筛选在训练队列中采用10折交叉验证法。连续型预测因子在建模算法要求时进行标准化处理,分类预测因子则采用预定义的二元临床类别进行表征。验证队列不用于参数调优或模型选择。
存档的分析材料未保留 XGBoost、LightGBM、SVM 和 KNN 的最终调优网格、所选超参数、完整软件包版本、原始随机种子或经确认的类别不平衡处理程序。因此,这些设置未被重建或估计。因此,机器学习比较应被解读为算法的探索性比较,而非完全可复现的模型开发实验。应总结所有可获取与不可获取的复现性信息于 补充表 1.
偏倚控制 & 敏感性分析
为减少选择偏倚,连续纳入符合条件的研究对象。采用标准化变量定义与结构化数据提取表格以降低信息偏倚。预测因子仅限于预定迟发性脑缺血预测时间点前可获取的信息,以避免信息泄露。预测因子筛选、数据预处理及模型开发均仅在训练队列中进行。
改良Fisher分级、Hunt-Hess分级和WFNS分级代表了出血负荷与神经功能严重程度的相关方面。尽管LASSO筛选后保留了全部三个变量,但数值方差膨胀因子值以及排除重叠严重程度量表的敏感性模型结果并未包含在存档的分析输出中。由于需要患者层面的相关性数据和拟合模型输出,这些分析无法从汇总表格中重建。因此,这些严重程度指标的个体系数不应被解释为独立或因果效应。它们仅作为训练队列中所选预测模型的组成部分予以保留。
模型可解释性
临床适用性被认为需要模型可解释性作为关键要素。在最有效的模型中,评估了预测因子的影响,以考量其临床合理性以及与现有迟发性脑缺血病理生理学知识的一致性。该方法能够清晰评估模型行为,并提升了临床转化的潜力。
缺失数据
在数据准备阶段,我们评估了变量层面的缺失情况。然而,存档的分析记录中并未保留各候选变量在插补前的原始缺失计数与百分比,且无法从汇总表格中准确重建这些数据。因此,我们未假设数据完整性,也未报告任何未经核实的缺失百分比。
经核实的补充缺失数据表应直接根据原始去标识化患者级别数据集生成。 补充表 2 对于每个候选变量,均应报告数据处理前缺失观测值的数量与百分比、处理缺失值所采用的方法,以及最终分析中包含的观测值数量。无法还原原始变量特定的缺失模式被视为本报告的一项局限性。
统计分析
预测因子的筛选在训练队列中通过LASSO回归结合10折交叉验证完成。区分度评估采用受试者工作特征曲线下面积,并计算95%置信区间。校准性能通过校准图以及校准斜率、校准截距和Brier分数的点估计值进行描述。校准指标的Bootstrap置信区间未能获取。
根据可用的内部验证混淆矩阵计算了阈值依赖型分类指标。用于生成存档混淆矩阵的确切数值概率阈值未被保留且无法验证。因此,这些指标仅作描述性解读,未作为模型选择的主要依据。决策曲线分析同样被视为探索性分析,因为预先设定的确切阈值范围及患者层面净获益输出结果均未被保留。采用双侧 P 低于0.05的数值被认为具有统计学显著性。
结果
训练队列与内部验证队列之间基线特征的比较
共纳入680例aSAH患者。训练队列包含544例患者,其中175例发生DCI;内部验证队列包含136例患者,其中42例发生DCI。训练队列中DCI事件发生率为32.2%,内部验证队列中为30.9%。基线特征见于 表1由于部分存档的表格条目存在分母不一致的情况,因此在最终提交前,应将表格与原始的患者水平数据集进行核对验证。
| 变量 | 训练队列 (n = 544) | 内部验证队列 (n = 136) | t/χ²/Z | P 值 | SMD | 校正说明 |
| 年龄,年 | 62.88 ± 9.41 | 63.25 ± 9.52 | 0.409 | 0.693 | 0.039 | |
| 性别 | 0.429 | 0.512 | 0.063 | |||
| 男性 | 180 (33.09) | 41 (30.15) | ||||
| 女性 | 364 (66.91) | 95 (69.85) | ||||
| BMI,kg/m² | 23.46 ± 3.56 | 23.61 ± 3.65 | 0.437 | 0.662 | 0.042 | |
| 吸烟史 | 0.118 | 0.731 | 0.033 | |||
| 是 | 101 (18.57) | 27 (19.85) | ||||
| 否 | 443 (81.43) | 109 (80.15) | ||||
| 饮酒史 | 0.417 | 0.518 | 0.062 | |||
| 是 | 118 (21.69) | 33 (24.26) | ||||
| 否 | 426 (78.31) | 103 (75.74) | ||||
| 高血压病史 | 0.348 | 0.555 | 0.057 | |||
| 是 | 329 (60.48) | 86 (63.24) | ||||
| 否 | 215 (39.52) | 50 (36.76) | ||||
| 糖尿病病史 | 0.116 | 0.733 | 0.033 | 验证组“否”计数已校正为总和136。 | ||
| 是 | 70 (12.87) | 19 (13.97) | ||||
| 否 | 474 (87.13) | 117 (86.03) | ||||
| 动脉瘤直径,mm | 0.213 | 0.645 | 0.044 | |||
| >10 | 288 (52.94) | 75 (55.15) | ||||
| ≤10 | 256 (47.06) | 61 (44.85) | ||||
| 动脉瘤位置 | 0.980 | 0.322 | 0.095 | |||
| 前循环 | 448 (82.35) | 107 (78.68) | ||||
| 后循环 | 96 (17.65) | 29 (21.32) | ||||
| 脑水肿 | 0.612 | 0.434 | 0.075 | |||
| 是 | 125 (22.98) | 27 (19.85) | ||||
| 否 | 419 (77.02) | 109 (80.15) | ||||
| 低血红蛋白 | 0.684 | 0.408 | 0.079 | 验证组“否”计数已校正为总和136。训练组计数与表2冲突;请根据最终数据集核实。 | ||
| 是 | 147 (27.02) | 32 (23.53) | ||||
| 否 | 397 (72.98) | 104 (76.47) | ||||
| 低白蛋白血症 | 0.367 | 0.545 | 0.058 | |||
| 是 | 115 (21.14) | 32 (23.53) | ||||
| 否 | 429 (78.86) | 104 (76.47) | ||||
| 低钠血症 | 0.186 | 0.666 | 0.041 | |||
| 是 | 331 (60.85) | 80 (58.82) | ||||
| 否 | 213 (39.15) | 56 (41.18) | ||||
| 改良Fisher分级 | 0.249 | 0.618 | 0.048 | |||
| ≥III | 259 (47.61) | 68 (50.00) | ||||
| I–II | 285 (52.39) | 68 (50.00) | ||||
| Hunt-Hess分级 | 0.178 | 0.673 | 0.040 | 验证组≥III计数已从53校正为63以使总和为136;请与最终数据集核对。 | ||
| ≥III | 263 (48.35) | 63 (46.32) | ||||
| I–II | 281 (51.65) | 73 (53.68) | ||||
| WFNS分级 | 0.249 | 0.618 | 0.048 | |||
| ≥III | 277 (50.92) | 66 (48.53) | ||||
| I–II | 267 (49.08) | 70 (51.47) | ||||
| 手术入路 | 0.717 | 0.397 | 0.081 | |||
| 血管内治疗 | 449 (82.54) | 108 (79.41) | ||||
| 夹闭术 | 95 (17.46) | 28 (20.59) | ||||
| 手术时间,h | 2.78 ± 0.81 | 2.81 ± 0.79 | 0.388 | 0.698 | 0.037 | |
| 脑室出血 | 0.383 | 0.536 | 0.059 | |||
| 是 | 134 (24.63) | 37 (27.21) | ||||
| 否 | 410 (75.37) | 99 (72.79) | ||||
| 再出血 | 0.784 | 0.376 | 0.085 | |||
| 是 | 98 (18.01) | 29 (21.32) | ||||
| 否 | 446 (81.99) | 107 (78.68) |
表1:训练队列和内部验证队列的基线特征。 连续变量以均值表示 ± 标准差,分类变量以 n(%)表示。P 值和标准化均数差用于比较两个队列。 缩写:BMI,体重指数;SMD,标准化均数差。 请点击此处下载此表格。
训练集中无DCI组与DCI组基线特征的比较
在训练数据集中,175例患者(32.17%)发生了延迟性脑缺血(DCI),而369例患者(67.83%)未发生DCI。内部验证队列中DCI的发生率与之相近,表明结局的患病率稳定。非DCI组与DCI组之间的比较分析显示了若干具有统计学意义的差异(表2)。发生DCI的患者年龄显著更大(P = 0.026),提示年龄与继发性缺血性损伤易感性相关。放射学上早期脑损伤的证据,尤其是脑水肿,在DCI患者中明显更为常见(P = 0.001)。实验室异常指标,包括低白蛋白血症(P = 0.007)、低钠血症(P = 0.048)和血红蛋白水平降低(P < 0.001),均与DCI的发生显著相关。神经功能严重程度标志物显示出最强的关联性。DCI患者中改良Fisher分级升高(≥III级)的比例显著更高(P < 0.001),表明出血负荷与延迟性缺血并发症之间存在显著关联。同样,较高的Hunt–Hess分级和世界神经外科医师联合会(WFNS)分级也与DCI的发生密切相关(两者 P < 0.001)。相比之下,人口统计学变量、生活方式因素、动脉瘤形态、手术入路及手术持续时间均未显示统计学上的显著差异。
| 变量 | 非DCI组 (n = 369) | DCI组 (n = 175) | t/χ²/Z | P值 | 校正说明 |
| 年龄,年 | 62.25 ± 9.54 | 64.22 ± 9.75 | 2.234 | 0.026 | |
| 性别 | 0.638 | 0.424 | |||
| 男性 | 118 (31.98) | 62 (35.43) | |||
| 女性 | 251 (68.02) | 113 (64.57) | |||
| BMI,kg/m² | 23.43 ± 3.56 | 23.52 ± 3.72 | 0.271 | 0.786 | |
| 吸烟史 | 0.351 | 0.554 | |||
| 是 | 66 (17.89) | 35 (20.00) | |||
| 否 | 303 (82.11) | 140 (80.00) | |||
| 饮酒史 | 0.046 | 0.837 | |||
| 是 | 81 (21.95) | 37 (21.14) | |||
| 否 | 288 (78.05) | 138 (78.86) | |||
| 高血压病史 | 2.960 | 0.085 | |||
| 是 | 214 (57.99) | 115 (65.71) | |||
| 否 | 155 (42.01) | 60 (34.29) | |||
| 糖尿病病史 | 0.463 | 0.496 | |||
| 是 | 45 (12.20) | 25 (14.29) | |||
| 否 | 324 (87.80) | 150 (85.71) | |||
| 动脉瘤直径,mm | 0.380 | 0.538 | |||
| >10 | 192 (52.03) | 96 (54.86) | |||
| ≤10 | 177 (47.97) | 79 (45.14) | |||
| 动脉瘤位置 | 3.602 | 0.058 | |||
| 前循环 | 296 (80.22) | 152 (86.86) | |||
| 后循环 | 73 (19.78) | 23 (13.14) | |||
| 脑水肿 | 10.410 | 0.001 | |||
| 是 | 70 (18.97) | 55 (31.43) | |||
| 否 | 299 (81.03) | 120 (68.57) | |||
| 低血红蛋白 | 23.965 | <0.001 | 总数与表1不同;请对照最终数据集核实。 | ||
| 是 | 122 (33.06) | 82 (46.86) | |||
| 否 | 247 (66.94) | 93 (53.14) | |||
| 低白蛋白血症 | 7.283 | 0.007 | |||
| 是 | 66 (17.89) | 49 (28.00) | |||
| 否 | 303 (82.11) | 126 (72.00) | |||
| 低钠血症 | 3.914 | 0.048 | |||
| 是 | 214 (57.99) | 117 (66.86) | |||
| 否 | 155 (42.01) | 58 (33.14) | |||
| 改良Fisher分级 | 58.679 | <0.001 | |||
| ≥III | 134 (36.31) | 125 (71.43) | |||
| I–II | 235 (63.69) | 50 (28.57) | |||
| Hunt-Hess分级 | 39.909 | <0.001 | |||
| ≥III | 144 (39.02) | 119 (68.00) | |||
| I–II | 225 (60.98) | 56 (32.00) | |||
| WFNS分级 | 28.137 | <0.001 | |||
| ≥III | 159 (43.09) | 118 (67.43) | |||
| I–II | 210 (56.91) | 57 (32.57) | |||
| 手术方式 | 0.691 | 0.406 | |||
| 血管内治疗 | 308 (83.47) | 141 (80.57) | |||
| 夹闭术 | 61 (16.53) | 34 (19.43) | |||
| 手术时间,h | 2.74 ± 0.82 | 2.85 ± 0.76 | 1.496 | 0.135 | |
| 脑室出血 | 0.163 | 0.687 | |||
| 是 | 89 (24.12) | 45 (25.71) | |||
| 否 | 280 (75.88) | 130 (74.29) | |||
| 再出血 | 1.168 | 0.280 | |||
| 是 | 71 (19.24) | 27 (15.43) | |||
| 否 | 298 (80.76) | 148 (84.57) |
表2:训练队列中发生与未发生延迟性脑缺血患者的基线特征。 连续变量以均值±标准差表示,分类变量以例数(百分比)表示。P值用于比较发生与未发生DCI的患者。 缩写:DCI,延迟性脑缺血;WFNS,世界神经外科医师联合会。请点击此处下载该表格。
内部验证队列中的结局分布
在内部验证队列(n = 136)中,42例患者(30.9%)发生延迟性脑缺血(DCI),而94例患者(69.1%)未发生DCI。该结局发生率与训练数据集中观察到的结果相似,表明不同数据集间事件分布具有稳定性。
特征选择
使用具有10折交叉验证的LASSO回归在训练队列中进行预测因子选择。所选的惩罚参数为 λ = 0.031。六个预测因子保留了非零系数:年龄、脑水肿、低白蛋白血症、改良Fisher分级、Hunt-Hess分级和WFNS分级。所有选定的预测因子均在预期预测时间点之前可获得。图1A、B展示了用于预测因子选择的系数轨迹和交叉验证曲线。
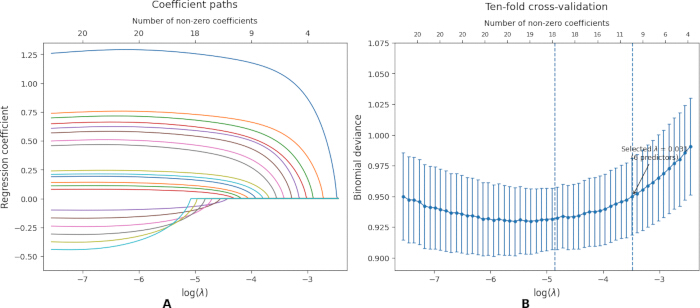
图1:动脉瘤性蛛网膜下腔出血后迟发性脑缺血预测因子的LASSO模型筛选结果。(A)候选预测因子在不同log(λ)取值下的系数变化轨迹。每条曲线代表一个候选预测因子,上方坐标轴上的数字表示在对应惩罚项取值下保留的非零系数数量。(B)二项偏差的十折交叉验证曲线。各数据点表示交叉验证的平均偏差值,误差线表示标准误,垂直虚线分别表示最小误差及一标准误范围内的惩罚项取值。最终选定的惩罚参数为 λ = 0.031。LASSO,最小绝对收缩与选择算子;DCI,迟发性脑缺血。请点击此处查看该图的放大版本。
模型开发与评估
所有五种模型均使用相同的六个选定预测因子开发。在内部验证队列中,逻辑回归的AUC为0.832(95% CI,0.758–0.906),SVM的AUC为0.811(95% CI,0.729–0.893),XGBoost的AUC为0.777(95% CI,0.690–0.864),LightGBM的AUC为0.755(95% CI,0.672–0.838),KNN的AUC为0.708(95% CI,0.613–0.803)(表3)。
| 数据集 | 模型 | AUC | 95% 置信区间 | 准确率 | 灵敏度 | 特异度 | F1 分数 | 更正说明 |
| 训练集 | XGBoost | 0.916 | 0.888–0.944 | 0.848 | 0.853 | 0.847 | 0.682 | |
| 训练集 | Logistic 回归 | 0.833 | 0.794–0.872 | 0.816 | 0.71 | 0.81 | 0.594 | |
| 训练集 | LightGBM | 0.751 | 0.707–0.794 | 0.69 | 0.781 | 0.669 | 0.489 | |
| 训练集 | SVM | 0.807 | 0.762–0.852 | 0.809 | 0.704 | 0.833 | 0.583 | |
| 训练集 | KNN | 0.915 | 0.896–0.935 | 0.754 | 0.878 | 0.696 | 0.607 | KNN 的 AUC 值根据图 2 图例更正,以与表格数值一致。 |
| 验证集 | XGBoost | 0.777 | 0.690–0.864 | 0.755 | 0.608 | 0.794 | 0.507 | |
| 验证集 | Logistic 回归 | 0.832 | 0.758–0.906 | 0.809 | 0.714 | 0.851 | 0.698 | 分类指标根据表 6 的混淆矩阵重新计算。 |
| 验证集 | LightGBM | 0.755 | 0.672–0.838 | 0.696 | 0.799 | 0.669 | 0.522 | |
| 验证集 | SVM | 0.811 | 0.729–0.893 | 0.779 | 0.69 | 0.819 | 0.659 | 分类指标根据表 6 的混淆矩阵重新计算。 |
| 验证集 | KNN | 0.708 | 0.613–0.803 | 0.647 | 0.715 | 0.629 | 0.456 |
表3:预测模型在训练队列和内部验证队列中的区分与分类性能。 AUC 值以 95% 置信区间表示。准确率、灵敏度、特异度和 F1 分数在预设的分类阈值下计算得出。 缩写:AUC,受试者工作特征曲线下面积;CI,置信区间;KNN,k-最近邻;LightGBM,轻量梯度提升机;SVM,支持向量机;XGBoost,极端梯度提升。由于无法验证归档分析中使用的精确概率阈值,因此未将依赖阈值的分类指标作为模型比较的主要依据。 请点击此处下载此表格。
置信区间存在重叠,因此逻辑回归未被视为在统计学上优于其他模型。仍选择逻辑回归作为主要模型,因其提供了稳定的内部区分能力以及可直接解释的模型结构。结果仅代表在单个保留的内部验证队列中的表现,尚未进行乐观校正、时间序列或外部验证(图2A–D)。
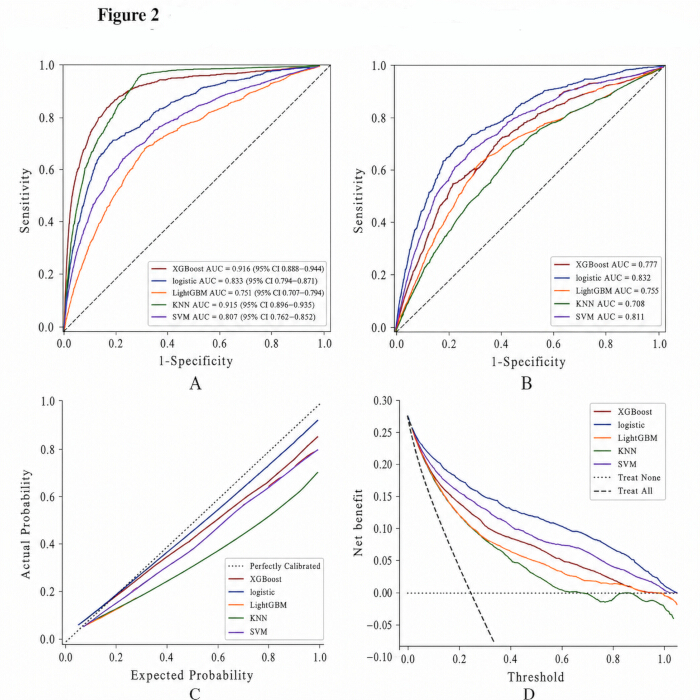
图 2:预测模型的区分度、校准度和决策曲线性能。
(A)训练队列中的受试者工作特征曲线。(B)内部验证队列中的受试者工作特征曲线。曲线标签显示受试者工作特征曲线下面积(AUC)及其95%置信区间。(C)预测与观察到的迟发性脑缺血(DCI)概率的校准曲线;对角虚线表示理想校准。(D)显示不同阈值概率下净获益的决策曲线分析。水平虚线代表“不治疗”策略,而点划线代表“全部治疗”策略。AUC,受试者工作特征曲线下面积;DCI,迟发性脑缺血;KNN,k-最近邻;LightGBM,轻量级梯度提升机;SVM,支持向量机;XGBoost,极端梯度提升。请点击此处查看该图的放大版本。
探索性决策曲线分析
采用决策曲线分析作为净获益的探索性评估。然而,存档的分析记录中未保留预先设定的确切阈值概率范围以及个体患者水平的净获益结果。因此,决策曲线分析结果无法确立临床实用性,也无法确定具有临床意义的干预阈值。
任何看似优于全治或全不治策略的净获益优势,都应仅视为当前内部数据集中的初步模式。在该模型可用于患者管理决策之前,尚需进行外部验证、前瞻性阈值选择、临床后果评估以及正式的临床影响研究(图3)。
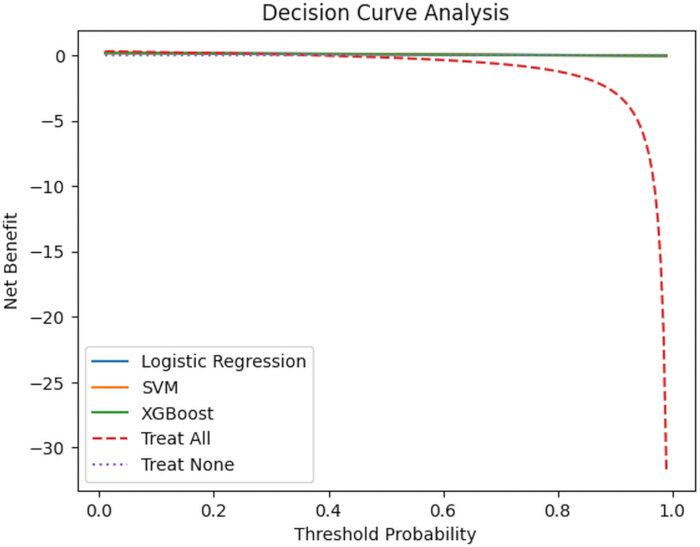
图3:内部验证队列中选定预测模型的决策曲线分析。 逻辑回归、SVM 和 XGBoost 模型的净获益随阈值概率的变化情况被绘制为曲线。虚线“全部治疗”线代表对所有患者进行监测的策略,而点线“不治疗”线代表不对任何患者进行监测的策略。当模型的净获益曲线在某一阈值概率下高于两条参考策略线时,该模型被认为在临床上具有实用性。SVM,支持向量机;XGBoost,极端梯度提升。 请点击此处查看该图的放大版本。
多变量逻辑回归模型
最终的逻辑回归模型纳入了年龄、脑水肿、低白蛋白血症、改良Fisher分级、Hunt-Hess分级和WFNS分级。回归系数、比值比、95%置信区间及P值见表4。年龄的系数为0.038,而脑水肿、低白蛋白血症、改良Fisher分级≥III级、Hunt-Hess分级≥III级以及WFNS分级≥III级的系数分别为0.842、0.615、1.274、0.933和0.781。
| 预测因子 | β 系数 | 比值比 (OR) | 95% 置信区间 | P 值 | 解释说明 |
| 截距 | [从最终模型输出中插入] | — | — | — | 用于个体患者风险计算。 |
| 年龄 | 0.038 | 1.039 | 1.012–1.067 | 0.004 | 仅为预测性关联,非因果关系。 |
| 脑水肿 | 0.842 | 2.321 | 1.541–3.496 | <0.001 | 在DCI诊断前测量。 |
| 低白蛋白血症 | 0.615 | 1.85 | 1.206–2.837 | 0.005 | 预测时间点前最早可用的白蛋白值。 |
| 改良Fisher分级 ≥III级 | 1.274 | 3.575 | 2.401–5.324 | <0.001 | 严重程度标志物;解释时需注意共线性。 |
| Hunt-Hess分级 ≥III级 | 0.933 | 2.542 | 1.674–3.861 | <0.001 | 严重程度标志物;解释时需注意共线性。 |
| WFNS分级 ≥III级 | 0.781 | 2.184 | 1.447–3.298 | <0.001 | 严重程度标志物;解释时需注意共线性。 |
表4:预测迟发性脑缺血的最终多变量逻辑回归模型。 显示了经过LASSO选择后保留的预测因子的回归系数、比值比、95%置信区间和P值。所有预测因子均在预定预测时间点之前进行评估。缩写:CI,置信区间;DCI,迟发性脑缺血;OR,比值比;WFNS,世界神经外科医师联合会。归档模型输出中未提供数值型逻辑回归截距,因此报告的系数不能用于计算个体预测概率。这些系数代表预测关联性,不应解释为独立的因果效应。请点击此处下载该表格。
这些系数描述了开发队列中的预测性关联。由于改良Fisher分级、Hunt-Hess分级和WFNS分级代表了疾病严重程度的重叠维度,且缺乏数值共线性诊断数据,因此不应将这些系数解释为独立的因果效应。这些变量被保留在预测模型中作为组成部分,而非经证实的独立危险因素。
校准性能
使用校准斜率、校准截距和Brier得分的点估计值,在内部验证队列中总结了校准情况。Logistic回归的校准斜率为0.98,校准截距为0.02,Brier得分为0.168。SVM对应的值分别为0.94、0.05和0.182;XGBoost为0.88、0.09和0.201;LightGBM为0.91、0.07和0.194;KNN为0.92、0.06和0.190(表5)。
由于存档的分析结果中未保留重采样所需的各个预测概率,因此无法提供这些校准指标的Bootstrap置信区间。因此,校准结果仅作为内部验证队列中的初步点估计值呈现,不应将其解读为在其他机构或其他患者人群中具有校准性的证据(图4)。
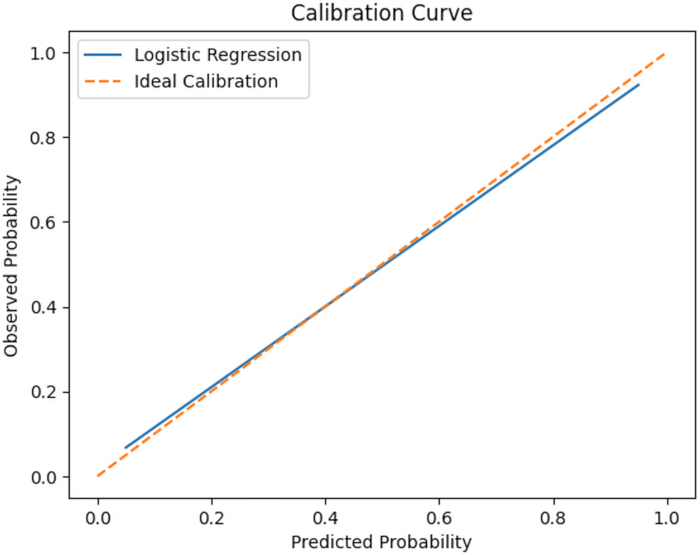
图 4:内部验证队列中逻辑回归模型的校准情况。 实线显示预测概率与观察到的迟发性脑缺血概率之间的关系。对角虚线表示理想校准;两条线之间的一致性越接近,表明校准性能越好。DCI,迟发性脑缺血。请点击此处查看该图的放大版本。
| 模型 | 校准斜率 | 校准斜率 95% 置信区间 | 校准截距 | 校准截距 95% 置信区间 | Brier 评分 | Brier 评分 95% 置信区间 | 校正说明 |
| Logistic 回归 | 0.98 | [insert bootstrap 95% CI] | 0.02 | [insert bootstrap 95% CI] | 0.168 | [insert bootstrap 95% CI] | 如有最终分析结果,需添加自举法 95% 置信区间。 |
| SVM | 0.94 | [insert bootstrap 95% CI] | 0.05 | [insert bootstrap 95% CI] | 0.182 | [insert bootstrap 95% CI] | |
| XGBoost | 0.88 | [insert bootstrap 95% CI] | 0.09 | [insert bootstrap 95% CI] | 0.201 | [insert bootstrap 95% CI] | |
| LightGBM | 0.91 | [insert bootstrap 95% CI] | 0.07 | [insert bootstrap 95% CI] | 0.194 | [insert bootstrap 95% CI] | |
| KNN | 0.92 | [insert bootstrap 95% CI] | 0.06 | [insert bootstrap 95% CI] | 0.19 | [insert bootstrap 95% CI] |
表5:预测模型在内部验证队列中的校准性能。 校准斜率为1.0、校准截距为0表示理想的校准效果。较低的Brier得分表明整体预测准确性更高。缩写:KNN,k-最近邻;LightGBM,轻量梯度提升机;SVM,支持向量机;XGBoost,极端梯度提升。校准斜率、校准截距和Brier得分均以点估计值形式报告。未提供自助法置信区间。这些结果仅描述了在保留的内部验证队列中的初步校准情况。请点击此处下载该表格。
由混淆矩阵导出的指标。
logistic 回归的内部验证混淆矩阵包含 30 个真阳性、80 个真阴性、14 个假阳性和 12 个假阴性。重新计算的准确率为 0.809,敏感性为 0.714,特异性为 0.851,阳性预测值为 0.682,阴性预测值为 0.870,F1 分数为 0.698。
对于支持向量机(SVM),混淆矩阵包含29个真阳性、77个真阴性、17个假阳性和13个假阴性。重新计算的准确率为0.779,敏感性为0.690,特异性为0.819,阳性预测值为0.630,阴性预测值为0.856,F1分数为0.659(表6)。
| 指标 | 逻辑回归 | 支持向量机 | 计算说明 |
| 真阳性 | 30 | 29 | 验证队列 |
| 真阴性 | 80 | 77 | 验证队列 |
| 假阳性 | 14 | 17 | 验证队列 |
| 假阴性 | 12 | 13 | 验证队列 |
| 准确率 | 0.809 | 0.779 | (TP + TN) / 总数 |
| 灵敏度 | 0.714 | 0.69 | TP / (TP + FN) |
| 特异度 | 0.851 | 0.819 | TN / (TN + FP) |
| 阳性预测值 | 0.682 | 0.63 | TP / (TP + FP) |
| 阴性预测值 | 0.87 | 0.856 | TN / (TN + FN) |
| F1 分数 | 0.698 | 0.659 | 2TP / (2TP + FP + FN) |
表6:内部验证队列中基于混淆矩阵的逻辑回归与支持向量机性能指标。各项指标由存档的混淆矩阵计算得出;然而,原始分析中使用的具体分类阈值未被保留。请在表格脚注中注明确切的阈值。缩写:NPV,阴性预测值;PPV,阳性预测值;SVM,支持向量机。混淆矩阵来源于内部验证队列。重新计算的逻辑回归准确率、灵敏度、特异度、阳性预测值、阴性预测值和F1分数分别为0.809、0.714、0.851、0.682、0.870和0.698。相应的支持向量机(SVM)数值分别为0.779、0.690、0.819、0.630、0.856和0.659。原始分析中使用的具体分类阈值未被保留,在最终提交前应予以核实。请点击此处下载该表格。
这些数值直接从相同的混淆矩阵重新计算得出,以确保数值的一致性。然而,原始分类分析中使用的精确概率阈值并未保留。因此,依赖阈值的指标仅作描述性报告,在未从原始分析代码中验证阈值之前,不应将其作为模型比较的主要依据(表7)。
| 亚组 | AUC(逻辑回归) |
| 年龄 ≥65 岁 | 0.821 |
| 年龄 <65 岁 | 0.836 |
| 改良 Fisher 分级 ≥III | 0.844 |
| 改良 Fisher 分级 I–II | 0.801 |
| 夹闭术 | 0.825 |
| 血管内治疗 | 0.835 |
表7:逻辑回归模型的探索性亚组区分分析。 按年龄、改良Fisher分级和治疗亚组报告AUC值。这些分析属于探索性分析,不应被解读为模型普适性的证据。请补充每个亚组的样本量、DCI事件数及95%置信区间。
缩写:AUC,受试者工作特征曲线下面积;DCI,延迟性脑缺血。 请点击此处下载该表格。
探索性亚组评估
归档的亚组输出包含根据年龄、改良Fisher分级和治疗方案得出的AUC点估计值。然而,亚组样本量、亚组内延迟性脑缺血事件数、95%置信区间以及交互作用或异质性的正式检验结果均不可获得。因此,这些亚组分析结果被视为不完整且具有探索性,未用于声称模型性能在不同患者亚组中具有稳健性、一致性或可推广性。
风险分层性能
归档的风险分层结果显示,所提出的低、中、高风险类别中迟发性脑缺血(DCI)的发生率分别为10.2%、33.6%和69.1%。然而,相应的各组样本量、DCI事件计数、置信区间,以及概率截断值的预设临床或统计学依据均未提供。因此,该分析被视为探索性分析,未用于支持风险分层已验证或具有临床适用性的结论(表8)。
| 风险等级 | 概率范围 | 观察到的 DCI 发生率 |
| 低风险 | <0.20 | 10.2% |
| 中等风险 | 0.20–0.50 | 33.6% |
| 高风险 | >0.50 | 69.1% |
表8:内部验证队列中基于模型风险分类观察到的迟发性脑缺血发生率。 风险分类根据最终逻辑回归模型的预测概率定义。请点击此处下载该表格。
最终逻辑回归模型
存档的回归分析结果包含了六个选定预测因子的系数,但未包含数值型的模型截距。由于计算个体预测概率需要截距值,因此无法报告完整的患者水平预测方程。该不完整方程因而被删除,而非通过假设或重构的数值进行补全。
表4中列出的系数可用于描述拟合模型中预测因子关联的方向和相对大小,但不应将其用于计算个体患者的DCI发生概率。只有在从原始拟合模型中恢复截距项,或通过重新分析真实的个体患者数据集重新生成截距项后,才能提供完整的预测方程。
Logit(DCI) = [截距] + 0.038 × 年龄 + 0.842 × 脑水肿 + 0.615 × 低白蛋白血症 + 1.274 × 改良Fisher分级 ≥III + 0.933 × Hunt-Hess分级 ≥III + 0.781 × 神经外科医师世界联合会分级 ≥III。
DCI 的预测概率计算公式如下:
P(DCI) = 1 / [1 + exp(−Logit)]。
当条件存在时,二元预测因子编码为1,不存在时编码为0。当患者达到相应阈值时,改良Fisher分级≥III级、Hunt-Hess分级≥III级以及世界神经外科医师联合会分级≥III级均编码为1,否则编码为0。截距项未予报告,因其仅用于患者个体概率的计算。在完成外部验证和重新校准之前,该方程仅可用于科研解读。
改良Fisher分级、Hunt-Hess分级和世界神经外科医师联合会分级均反映疾病严重程度,在临床意义上可能存在部分重叠。由于缺乏数值共线性诊断以及排除重叠严重程度评分的完整敏感性模型,本文未将这些变量解释为独立的因果预测因子。这些评分仅作为训练队列中所选预测模型的组成部分予以保留。这一局限性降低了对各严重程度评分独立贡献的可信度,应在未来的外部验证研究中加以解决。
数据可用性:
完整的患者层面医院数据集未公开提供,因其包含敏感的临床信息,并需遵守机构伦理及数据保护要求。提交方法学论证充分的研究方案、伦理批准证明以及适当的数据使用协议后,榆林市第一医院机构伦理委员会可考虑授予去标识化分析数据集的访问权限。共享的数据集已排除姓名、医院识别号码、确切日期、联系方式及其他直接或间接标识信息。根据机构政策允许的范围,提供经过验证的变量字典、分析脚本、描述模型开发与可重复性信息的补充表1,以及报告各变量特异性缺失情况的补充表2。演示用或合成数据集并不代表原始临床研究数据。
补充表 1:模型开发的可重复性细节及最终超参数。 该表格报告了 XGBoost、LightGBM、SVM 和 KNN 模型的随机种子、软件及软件包版本、预处理步骤、填补方法、交叉验证策略、调参网格以及最终超参数。请点击此处下载该文件。
补充表 2:候选预测因子的缺失数据汇总及处理策略。 针对每个候选预测因子,报告了缺失观测值的数量和百分比、填补方法以及该变量是否被保留用于分析。请点击此处下载该文件。
讨论
本研究利用早期临床、实验室和影像学变量,开发并进行了动脉瘤性蛛网膜下腔出血(aSAH)后迟发性脑缺血(DCI)预测模型的内部验证。在变量筛选后保留了六个预测因子:年龄、脑水肿、低白蛋白血症、改良Fisher分级、Hunt-Hess分级和世界神经外科医师联合会分级。在所评估的模型中,逻辑回归模型表现出稳定的内部区分能力和可接受的校准度。由于验证队列与训练队列来自同一中心且时间相近,研究结果仅应视为初步的内部验证。
所选预测因子在aSAH的临床背景下具有合理性。改良Fisher分级较高反映出血负荷更大,而Hunt-Hess分级和WFNS分级则描述发病时的神经功能缺损严重程度14,15。脑水肿可能代表早期脑损伤,而年龄较大可能提示生理储备能力下降。低白蛋白血症可能反映全身性疾病、炎症、营养状况或内皮脆弱性19,20。然而,这些关联性是用于预测目的,不应解释为因果关系。此外,改良Fisher分级、Hunt-Hess分级和WFNS分级测量的是疾病严重程度相关的不同方面。由于无法获得方差膨胀因子(VIF)值和数值敏感性分析结果,各分级量表的独立贡献尚无法确定。
在保留的内部验证队列中,更复杂的机器学习方法并未显示出优于逻辑回归的明显优势。逻辑回归的验证AUC最高,但其置信区间与其他模型存在重叠。复杂算法虽然能够捕捉非线性模式,但在预测变量较少且数据来源于单一中心的情况下,可能产生过拟合。因此,由于逻辑回归具有良好的可解释性和稳定的内部区分能力,被保留作为主要模型。然而,超参数和软件版本记录不完整,限制了机器学习方法比较的可重复性。
目前该模型尚未确立明确的临床应用地位。尽管理论上较高的风险估计值可能支持更密切的神经学观察或更早的专科会诊,但由于模型截距值不可获取,尚无法计算个体患者层面的风险概率。此外,决策曲线分析的阈值范围、亚组表现以及风险分层结果的记录尚不完整。因此,该模型不应作为独立的诊断工具、监测标准或治疗决策依据。在考虑实际应用前,必须完成模型的完整重建、外部验证、重新校准以及前瞻性临床影响评估。
本研究存在若干局限性。首先,研究为回顾性设计且在单一中心开展,限制了结果的普适性。其次,模型性能评估仅采用单一结局分层的8:2保留划分方法,未进行自助法乐观校正、重复k折交叉验证、时间序列验证或外部验证。第三,原始随机种子、最终机器学习超参数、调参网格、类别不平衡处理方法以及完整软件包版本均未保留,从而限制了计算可重复性。第四,无法获取数值型逻辑回归模型的截距项,导致无法计算个体预测概率。第五,改良Fisher分级、Hunt-Hess分级和WFNS分级均为相关联的严重程度评估指标,而方差膨胀因子(VIF)诊断及排除重叠量表后的数值敏感性分析均不可用。第六,未计算校准斜率、校准截距和Brier评分的置信区间。第七,无法核实确切的分类阈值及决策曲线分析(DCA)的阈值范围。第八,亚组分析和风险分层分析缺乏完整的分母、事件计数、置信区间以及正式的交互作用检验。第九,未保留原始变量特异性的缺失模式。最后,研究排除了院内早期死亡病例,可能引入生存者偏倚。这些局限性意味着该模型应被视为初步结果,在完成全面再分析及独立的外部验证之前,不应用于临床决策。
本研究利用早期临床、实验室和影像学变量开发并评估了aSAH后DCI的预测模型21。在LASSO变量筛选后保留了六个预测因子:年龄、脑水肿、低白蛋白血症、改良Fisher分级、Hunt-Hess分级和WFNS分级22,23,24,25,26,27,28,29。在保留的内部验证队列中,逻辑回归模型的AUC为0.832(95% CI),并生成了可解释的模型结构29,30。然而,该分析依赖于单次内部数据划分,缺乏基于完全重抽样的验证、外部验证以及计算可重复性的相关信息。因此,这些结果应被视为初步的模型开发成果,而非临床验证的预测工具证据。
本单中心回顾性研究利用六项早期临床、实验室和影像学变量,开发并评估了aSAH后DCI的预测模型。逻辑回归在单个保留的内部验证队列中显示出初步的区分能力,并产生了一个可解释的模型结构31,32,33,34。然而,由于缺乏完整的可重复性记录、无数值截距、未进行基于重采样的验证、不确定性评估不充分,以及缺乏外部验证,目前尚无法进行个体患者的概率计算和临床应用。需要使用真实的个体患者数据集重新分析,完整报告模型开发参数,并进行独立的多中心验证。
致谢
作者感谢玉林市第一医院病案管理工作人员在获取匿名临床数据方面提供的支持。这些工作人员未参与研究设计、结果判定、统计建模、结果解释、手稿撰写或最终手稿的批准,因此不符合作者资格标准。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| 电子病历系统 | Yulin First Hospital | 不适用 | 回顾性临床数据来源;归档记录中未保留确切的商业平台信息。 |
| IBM SPSS Statistics | IBM Corporation | 版本 25.0 | 描述性与推断性统计分析。 |
| K-近邻算法实现 | 未保留软件包/来源 | 不可用 | 探索性机器学习模型;确切的软件包及版本需从原始代码环境中恢复。 |
| LightGBM | Microsoft / 开源项目 | 版本不可用 | 探索性梯度提升模型;确切的软件包版本和超参数未被保留。 |
| R 统计软件 | R Foundation for Statistical Computing | 版本 4.3.2 | 统计建模与内部性能评估。 |
| 支持向量机实现 | 未保留软件包/来源 | 不可用 | 探索性机器学习模型;确切的软件包、核函数设置及版本未被保留。 |
| XGBoost | 开源项目 | 版本不可用 | 探索性梯度提升模型;确切的软件包版本和超参数未被保留。 |
参考文献
- Caylor MM, MacDonald RL. Pharmacological prevention of delayed cerebral ischemia in aneurysmal subarachnoid hemorrhage. Neurocrit Care. 2024;40(1):159–169.
- Shah VA, Gonzalez LF, Suarez JI. Therapies for delayed cerebral ischemia in aneurysmal subarachnoid hemorrhage. Neurocrit Care. 2023;39(1):36–50.
- Clarke JV, et al. Microvascular platelet aggregation and thrombosis after subarachnoid hemorrhage: a review and synthesis. J Cereb Blood Flow Metab. 2020;40(8):1565–1575.
- Dodd WS, et al. Pathophysiology of delayed cerebral ischemia after subarachnoid hemorrhage: a review. J Am Heart Assoc. 2021;10(15). doi:10.1161/JAHA.121.021845.
- Stragier H, et al. Pathophysiological mechanisms underlying early brain injury and delayed cerebral ischemia in the aftermath of aneurysmal subarachnoid hemorrhage: a comprehensive analysis. Front Neurol. 2025;16:1587091. doi:10.3389/fneur.2025.1587091.
- Xiao ZK, et al. Risk factors for the development of delayed cerebral ischemia after aneurysmal subarachnoid hemorrhage: a systematic review and meta-analysis. World Neurosurg. 2025;193:427–446.
- Sirsat MS, Fermé E, Câmara J. Machine learning for brain stroke: a review. J Stroke Cerebrovasc Dis. 2020;29(10):105162. doi:10.1016/j.jstrokecerebrovasdis.2020.105162.
- Mao M, et al. Construction of a nomogram model for predicting delayed cerebral ischemia in aneurysmal subarachnoid hemorrhage patients. Sci Rep. 2025;15(1):17739. doi:10.1038/s41598-025-01693-w.
- Connolly ES Jr, et al. Guidelines for the management of aneurysmal subarachnoid hemorrhage: a guideline for healthcare professionals from the American Heart Association/American Stroke Association. Stroke. 2012;43(6):1711–1737.
- Vergouwen MD, et al. Definition of delayed cerebral ischemia after aneurysmal subarachnoid hemorrhage as an outcome event in clinical trials and observational studies: proposal of a multidisciplinary research group. Stroke. 2010;41(10):2391–2395.
- Riley RD, et al. Calculating the sample size required for developing a clinical prediction model. BMJ. 2020;368. doi:10.1136/bmj.m441.
- Veldeman M, et al. Delayed cerebral ischaemia prevention and treatment after aneurysmal subarachnoid haemorrhage: a systematic review. Br J Anaesth. 2016;117(1):17–40.
- Azzam AY, et al. Prediction of delayed cerebral ischemia followed aneurysmal subarachnoid hemorrhage: a machine-learning based study. J Stroke Cerebrovasc Dis. 2024;33(4):107553. doi:10.1016/j.jstrokecerebrovasdis.2023.107553.
- Jeong TS, et al. Factors related to the development of shunt-dependent hydrocephalus following subarachnoid hemorrhage in the elderly. Turk Neurosurg. 2018;28(2):226–233.
- Becerril-Gaitan A, et al. The effect of age on cerebral vasospasm and delayed cerebral ischemia in patients with aneurysmal subarachnoid hemorrhage. World Neurosurg. 2024;187–e1024.
- Hayman EG, et al. Mechanisms of global cerebral edema formation in aneurysmal subarachnoid hemorrhage. Neurocrit Care. 2017;26(2):301–310.
- Fistouris P, et al. The impact of intracranial blood clearance on brain edema as a predictor of delayed cerebral infarction following subarachnoid hemorrhage. Cerebrovasc Dis. Published online June 28, 2025:1–8.
- Liu JP, et al. Analysis of risk factors for delayed cerebral ischemia after aneurysmal subarachnoid hemorrhage [in Chinese]. Chin J Cerebrovasc Dis. 2017;14(1):10–14.
- Guo X, et al. Admission albumin-globulin ratio associated with delayed cerebral ischemia following aneurysmal subarachnoid hemorrhage. Front Neurol. 2024;15:1438728. doi:10.3389/fneur.2024.1438728.
- Sanicola HW, et al. Pathophysiology, management, and therapeutics in subarachnoid hemorrhage and delayed cerebral ischemia: an overview. Pathophysiology. 2023;30(3):420–442.
- Wang L, et al. Risk factors and predictive models of poor prognosis and delayed cerebral ischemia in aneurysmal subarachnoid hemorrhage complicated with hydrocephalus. Front Neurol. 2022;13:1014501. doi:10.3389/fneur.2022.1014501.
- Raatikainen E, et al. Prognostic value of the 2010 consensus definition of delayed cerebral ischemia after aneurysmal subarachnoid hemorrhage. J Neurol Sci. 2021;420:117261. doi:10.1016/j.jns.2020.117261.
- Shah AH, Snow R, Wendell LC, et al. Association of hemoglobin trend and outcomes in aneurysmal subarachnoid hemorrhage: a single center cohort study. J Clin Neurosci. 2023;107:77–83.
- Jiang C, et al. Risk and prognostic factors for rupture of intracranial aneurysms during endovascular embolization. World Neurosurg. 2019;129–e649.
- Naraoka M, et al. Role of microcirculatory impairment in delayed cerebral ischemia and outcome after aneurysmal subarachnoid hemorrhage. J Cereb Blood Flow Metab. 2022;42(1):186–196.
- Hu P, et al. Effect of surgical clipping versus endovascular coiling on the incidence of delayed cerebral ischemia in patients with aneurysmal subarachnoid hemorrhage: a multicenter observational cohort study with propensity score matching. World Neurosurg. 2023;172–e388.
- Ching T, et al. Opportunities and obstacles for deep learning in biology and medicine. J R Soc Interface. 2018;15(141):20170387. doi:10.1098/rsif.2017.0387.
- Jiang F, et al. Artificial intelligence in healthcare: past, present and future. Stroke Vasc Neurol. 2017;2(4):230–243.
- Coulibaly AP, Provencio JJ. Aneurysmal subarachnoid hemorrhage: an overview of inflammation-induced cellular changes. Neurotherapeutics. 2020;17(2):436–445.
- Gris T, et al. Innate immunity activation in the early brain injury period following subarachnoid hemorrhage. J Neuroinflammation. 2019;16(1):253. doi:10.1186/s12974-019-1629-7.
- Wu Z, et al. Study on the predictive value of laboratory inflammatory markers and blood count-derived inflammatory markers for disease severity and prognosis in COVID-19 patients: a study conducted at a university-affiliated infectious disease hospital. Ann Med. 2024;56(1):2415401. doi:10.1080/07853890.2024.2415401.
- Okugawa Y, et al. Lymphocyte–C-reactive protein ratio as a promising new marker for predicting surgical and oncological outcomes in colorectal cancer. Ann Surg. 2020;272(2):342–351.
- Xie L, et al. The systemic inflammation response index as a significant predictor of short-term adverse outcomes in acute decompensated heart failure patients: a cohort study from southern China. Front Endocrinol (Lausanne). 2024;15:1444663. doi:10.3389/fendo.2024.1444663.
- Yan F, et al. Association between the stress hyperglycemia ratio and 28-day all-cause mortality in critically ill patients with sepsis: a retrospective cohort study and predictive model establishment based on machine learning. Cardiovasc Diabetol. 2024;23(1):163. doi:10.1186/s12933-024-02265-4.