本方案将多维度转录组学数据与机器学习相结合,用于在扩张型心肌病中识别与衰老和线粒体相关的基因,以发现生物标志物并进行分子亚型分类。
本文内容
摘要
摘要
扩张型心肌病(DCM)的特征是左心室扩张和收缩功能障碍,常伴随线粒体功能障碍以及免疫-炎症激活。然而,DCM中与衰老相关的分子特征及线粒体调控通路尚未完全阐明。本研究分析了来自基因表达综合数据库(Gene Expression Omnibus)的六个批量转录组数据集和一个单细胞RNA测序数据集。在完成数据归一化、批次校正和细胞类型注释后,通过差异表达分析、加权基因共表达网络分析以及蛋白质-蛋白质相互作用网络构建,筛选出与衰老和线粒体相关的候选基因。进一步采用最小绝对收缩与选择算子回归、随机森林以及支持向量机-递归特征消除方法筛选核心基因。通过免疫细胞浸润、细胞间通讯和分子分型分析,对DCM中心脏免疫微环境的特征进行了刻画。共鉴定出66个与衰老相关的基因和16个与线粒体相关的基因,这些基因主要富集于缺氧诱导因子-1信号通路、氧化磷酸化以及一氧化氮合酶相关通路。机器学习与单细胞RNA测序分析确定SERPINE1、TGFB2、CYBB和TLR2为核心基因。其中,CYBB和TLR2在单核细胞和巨噬细胞中高表达,而SERPINE1和TGFB2主要在基质细胞中表达。免疫景观分析显示,DCM样本中促炎性巨噬细胞活化增强,细胞间通讯发生改变。根据核心基因的表达模式,DCM样本被划分为两种分子亚型,分别与血管内皮生长因子信号通路和初级胆汁酸生物合成通路相关。本研究提供了一个整合性分析框架,可用于识别DCM中的候选生物标志物和分子亚型。
引言
扩张型心肌病(DCM)是一种以左心室扩张和收缩功能受损为特征的心肌疾病。它是心力衰竭的第三大常见病因,也是全球心脏移植的主要指征1。基于人群的研究估计,其患病率约为每250名成人中有1例,男性患病率更高,且相当比例的病例可归因于单基因变异2。这些发现表明,遗传易感性和环境因素均参与了DCM的发生和发展。
扩张型心肌病(DCM)的发病机制涉及多个相互关联的过程,包括炎症激活、氧化应激、心肌细胞凋亡以及纤维化信号通路的失调。某些炎症相关基因多态性,如肿瘤坏死因子-α启动子变异,已被证实与病毒性DCM的易感性相关3。在人类DCM亚型中,氧化应激水平升高也与心肌细胞死亡及左心室功能障碍相关4。此外,Wnt/β-catenin和钙调磷酸酶/活化T细胞核因子信号通路的异常激活可促进心肌肥厚和间质纤维化,从而推动疾病进展5,6。线粒体功能障碍是DCM的另一重要环节,因为心肌细胞具有较高的能量需求。线粒体生物合成、钙稳态、线粒体自噬以及线粒体DNA完整性的破坏,均可损害氧化磷酸化过程,并导致进行性心脏功能障碍7,8,9,10。
尽管已有这些机制性发现,但仍存在重要的知识空白。特别是,在扩张型心肌病(DCM)的发生和进展过程中,线粒体结构重塑与生物能量功能障碍之间的时间关系和因果关系尚未完全明确11。已有多种治疗策略被研究。干细胞疗法通过旁分泌、细胞保护和免疫调节作用显示出再生潜力,但仍需优化细胞来源、递送途径以及移植后的细胞存活率12。基因治疗策略,包括基于腺相关病毒的递送和基于成簇规律间隔短回文重复序列的基因组编辑,也提供了潜在的精准治疗方案。然而,与心脏趋向性、载体免疫原性以及长期安全性相关的局限性仍未解决13。
来自基因表达综合数据库(Gene Expression Omnibus, GEO)等存储库的公共转录组数据集被广泛用于扩张型心肌病(DCM)的生物标志物发现。这些资源提供了多中心临床队列的访问权限,支持具有成本效益且可重复的研究,并可通过跨数据集整合提高统计效能14。转录组分析还能够实现全基因组范围的候选基因筛选、分子亚型分类以及通路水平的分析15。然而,公共数据集存在固有的局限性,包括技术批次效应、临床和病因学异质性、因果推断能力有限,以及纵向随访或预后信息不完整16。因此,基于公共转录组数据集得出的研究结果最适用于假设生成和候选生物标志物的优先排序,但仍需在独立队列和实验模型中进行验证。
许多关于扩张型心肌病(DCM)的生物信息学研究主要依赖差异表达分析,这种方法可能产生假阳性结果,且无法充分表征心脏组织中的基因共表达网络及细胞异质性。为克服这些局限性,本研究采用了一种整合分析策略,结合多种互补方法。批量转录组分析可提供适用于病例-对照比较的组织水平表达谱。加权基因共表达网络分析(WGCNA)可识别与表型特征相关的基因模块,从而优先筛选功能相关的基因集,而非单个差异表达基因。蛋白质-蛋白质相互作用(PPI)网络分析则基于网络拓扑结构识别高度连接的基因。本研究采用三种机器学习算法——最小绝对收缩与选择算子回归(LASSO回归)、随机森林和支持向量机-递归特征消除——在整合数据集中识别候选生物标志物¹⁷。随后,通过单细胞RNA测序(scRNA-seq)进一步分析细胞类型特异性的表达模式及细胞间通讯网络18。
尽管线粒体功能障碍和与衰老相关的分子改变在扩张型心肌病(DCM)中均已得到研究,但它们与疾病相关转录变化的联合关联仍缺乏深入探讨。本研究整合了多个批量转录组和单细胞RNA测序(scRNA-seq)数据集,以鉴定DCM中与衰老和线粒体相关的枢纽基因,表征心脏免疫微环境,并基于所鉴定的基因分析分子亚型。该整合方法用于优先筛选候选生物标志物,并为后续的机制研究和验证研究提供基础。
方案
所有动物实验均经河南中医药大学第二附属医院实验动物伦理委员会审查和批准(批准号:HNSZYYYJS2023011150)。所有操作均遵循《实验动物福利伦理审查指南》(GB/T 35892-2018)以及替代、减少和优化的3R原则。本研究中使用的试剂、数据库、软件和设备列于材料表中。
1. 数据资源与实验材料
采用具有自发性扩张型心肌病(DCM)表型、体重为25 ± 2 g的雄性SPF级CTNTR141W转基因小鼠作为模型组。以年龄匹配、体重为25 ± 2 g的雄性SPF级C57BL/6J小鼠作为对照组。每组包含12只小鼠。所有动物均来自持有有效实验动物生产许可证的机构,并饲养于SPF级屏障环境中,环境温度为22 ± 2 °C,相对湿度为40%–60%,光照周期为12小时光照/12小时黑暗,可自由摄取灭菌饲料和饮水。所有小鼠在实验开始前均经过1周的适应性饲养,随后在相同条件下继续饲养4周,再进行心脏功能评估和样本采集。实验开始时所有小鼠均为6–8周龄。小鼠经深度麻醉后通过颈椎脱臼法处死。
从基因表达综合数据库(Gene Expression Omnibus, GEO)19中获取了七套扩张型心肌病(DCM)患者左心室心肌组织的公开转录组数据集。这些数据集包括六个批量转录组数据集和一个单细胞RNA测序(scRNA-seq)数据集GSE145154。分析中同时包含了CD45阳性与CD45阴性细胞组分。在聚类前,将CD45阳性与CD45阴性细胞组分合并处理。样本标识被用作Harmony整合的主要批次变量。纳入了GSE145154中的正常左心室样本与DCM左心室样本,具体为GSM4307515、GSM4307516、GSM4307520和GSM4307521。本研究使用的数据集包括GSE145154、GSE5406、GSE42955、GSE57338、GSE79962、GSE116250和GSE141910。排除了所有非DCM样本,仅保留对照样本(对照组)和DCM样本(DCM组)。经过质量控制后未剔除任何样本。所纳入GEO数据集的样本信息汇总如下:GSE5406包含102个样本(16个对照和86个DCM样本);GSE42955包含17个样本(5个对照和12个DCM样本);GSE57338包含231个样本(136个对照和95个DCM样本);GSE79962包含20个样本(11个对照和9个DCM样本);GSE116250包含51个样本(14个对照和37个DCM样本);GSE141910包含322个样本(161个对照和161个DCM样本)。
2. 大样本转录组数据预处理
使用 GEOquery 软件包20下载了六个大样本数据集的原始表达矩阵和临床注释文件。对于 Affymetrix 芯片数据集,获取了原始 CEL 文件;对于 RNA-seq 数据集,获取了原始计数矩阵。芯片数据的背景校正、分位数归一化及表达值计算采用 affy 软件包中实现的稳健多芯片平均算法(robust multi-array average algorithm)进行21。
使用 edgeR 软件包中的修剪均值法(trimmed mean of M-values method)对 RNA-seq 计数数据进行标准化22 并转换为对数值₂每百万转录本计数(counts per million)经转换后用于分析。使用平台特异性的注释文件将探针标识符转换为官方基因符号。当多个探针对应同一基因时,计算其平均表达值。
使用 sva 软件包中的 ComBat 算法消除了不同数据集之间的技术批次效应23。将数据集来源和检测平台指定为批次因子。在批次校正前后均进行了主成分分析,以评估批次效应去除的效果。
3. 单细胞转录组数据预处理与细胞注释
从 GSE145154 获取的基因表达矩阵被导入 Seurat,并使用 Seurat 版本 524 构建 Seurat 对象。采用以下阈值排除低质量细胞:每个细胞检测到的基因为 200–6,000 个,总唯一分子标识符(UMI)计数大于 500,线粒体基因百分比低于 25%。超出这些质控阈值的细胞被视为低质量或破裂细胞而被剔除。我们仅依据上述质控阈值排除低质量细胞。
使用 NormalizeData 函数对数据进行对数归一化处理,归一化因子为 10,000。采用 vst 方法通过 FindVariableFeatures 函数筛选出前 3,000 个高变基因。随后使用 ScaleData 对数据进行标准化,接着进行主成分分析以实现线性降维。
使用 Harmony 算法25 通过 RunHarmony 函数校正批次效应,其中将样本身份指定为分组变量。利用前 15 个主成分,通过 FindNeighbors 和 FindClusters 函数对细胞进行聚类。采用 Leiden 算法在分辨率为 0.15 的条件下进行聚类。使用统一流形近似与投影(uniform manifold approximation and projection)进行非线性降维和可视化。
使用经典标记基因以及基于SingleR软件包的自动注释方法对细胞类型进行注释26。标记基因如下:B细胞,IGKC、MS4A1和CD79A;心肌细胞,TNNI3、MYL2和ACTC1;内皮细胞,VWF、PECAM1和EGFL7;巨噬细胞,C1QC、C1QB和C1QA;单核细胞,S100A8、S100A9和G0S2;自然杀伤细胞,NKG7、GNLY和CCL5;平滑肌细胞,MYL9、TAGLN和ACTA2;基质细胞,FBLN1、LUM和DCN;T细胞,CD3E、CD3G和CD3D。
4. 差异表达分析与基因集富集评分
使用 limma 软件包27构建线性模型,以比较扩张型心肌病(DCM)组与健康对照组之间的基因表达水平。将 P 值 < 0.05 且绝对倍数变化大于 1.5(对应绝对 log₂ 倍数变化大于 0.58)的基因定义为显著差异表达基因。
采用单样本基因集富集分析,计算每个样本中与衰老相关及线粒体相关基因集的富集评分28。使用Wilcoxon秩和检验评估扩张型心肌病(DCM)组与健康对照组之间富集评分的差异,以P值<0.05为具有统计学意义。
在单细胞水平上,使用 Seurat 中的 AddModuleScore 函数计算与衰老相关和线粒体模块的评分。采用 Wilcoxon 秩和检验评估组间模块评分的差异。
衰老相关基因特征从 CellAge 数据库(https://genomics.senescence.info/cells/)获取,线粒体相关基因集从 GeneCards 获取(https://www.genecards.org/)。用于评分的完整基因列表见补充文件 1。
5. 加权基因共表达网络构建
在批量转录组数据中,保留表达方差最高的前5000个蛋白编码基因用于网络构建。应用 pickSoftThreshold 函数计算多个软阈值幂下的无标度拓扑拟合指数。最优阈值确定为能够产生 R2 值高于 0.9 的无标度网络的最小幂值。据此,后续网络分析采用软阈值幂 β = 5。
使用 blockwiseModules 函数构建了一个加权共表达网络,模块最小大小设为 30。计算每个模块特征基因与衰老相关或线粒体富集评分之间的皮尔逊相关系数。将绝对相关系数大于 0.4 且 P < 0.001 的模块视为显著相关模块。
将显著相关模块中的基因与差异表达基因取交集,以鉴定与扩张型心肌病相关的衰老候选基因及与扩张型心肌病相关的线粒体候选基因。
6. 功能富集分析
使用 clusterProfiler 软件包对候选基因进行功能富集分析,包括基因本体(Gene Ontology, GO)和京都基因与基因组百科全书(Kyoto Encyclopedia of Genes and Genomes, KEGG)通路分析29。GO 富集分析涵盖三个标准类别:生物过程、细胞组分和分子功能。
所有分析均采用人类物种注释,以错误发现率(FDR)对 P 值进行校正,q 值阈值设为 0.05。基因集限定大小范围为 10–500 个基因,且 FDR 小于 0.05 的术语被保留。 < 0.05 被定义为具有统计学显著性。最后,对 GO 富集结果进行可视化展示 通过 分组柱状图用于展示数据,而KEGG富集结果则采用气泡图进行展示。
7. 蛋白质-蛋白质相互作用网络构建与枢纽基因筛选
将候选基因提交至 STRING 11.5 版数据库30,设定物种为 Homo sapiens,相互作用置信度阈值为综合评分大于 0.7。隐藏无连接的节点,并以制表符分隔值格式导出相互作用数据。
相互作用数据被导入 Cytoscape 3.9.1 版本进行可视化31。使用 CytoHubba 插件32通过三种算法计算节点拓扑得分:Degree、最大邻域组分和最大团中心性。
使用MCODE插件33并设置以下默认参数鉴定网络中的核心功能模块:度值截断值为2;k-核值为2;节点得分截断值为0.2;最大深度为100。将三种拓扑算法排名均位于前10的基因与MCODE核心子网络中的基因取交集,以确定最终的蛋白质-蛋白质相互作用枢纽基因。
8. 基于机器学习的核心基因筛选与诊断模型构建
为确保可重复性与均衡的样本代表性,采用固定随机种子(seed = 123456)将整合的批量转录组数据集按7:3的比例随机划分为训练集和验证集。该划分过程根据疾病分组(DCM vs. 对照组)进行分层,以保证两个数据集中各类别的比例一致。在数据划分前,使用sva包校正来自不同数据源的批次效应,并在随机分配过程中将整合后的样本视为一个统一的队列进行处理。
应用了三种机器学习算法来筛选候选基因。首先,进行了LASSO逻辑回归分析 通过 glmnet 包中的 cv.glmnet 函数34采用5折交叉验证构建二分类模型,并以AUC作为评估指标。保留在lambda.min处具有非零系数的基因为候选基因。
其次,使用 randomForest 软件包构建了一个包含 500 棵决策树的随机森林分类模型35。每次分裂时选取的变量数目设置为特征总数的平方根。基因重要性基于基尼系数进行量化,并保留重要性评分最高的前 10 个基因。
第三,使用 caret 软件包中的 rfe 函数36进行 SVM-RFE 分析。设定特征数量范围为 1–10,并采用 5 折交叉验证进行模型训练。最终选择具有最优交叉验证准确率的基因子集。
通过三种算法均鉴定出的基因为最终确定的 DCM 中核心衰老及线粒体相关基因。随后使用 10 种分类算法构建诊断模型:决策树、梯度提升机、提升型广义线性模型、k-最近邻、逻辑回归、神经网络、偏最小二乘、随机森林、支持向量机和极端梯度提升。
使用 pROC 软件包生成受试者工作特征曲线37。计算曲线下面积、准确性、敏感性和特异性,以评估训练集和验证集中的诊断性能。
SHapley 可加性解释分析用于计算每个核心基因对模型预测的贡献38. 汇总图和每样本瀑布图已生成。在验证集中曲线下面积大于0.8的最终诊断模型被认为具有良好的诊断性能。
9. 细胞间通讯推断
使用 CellChat 软件包推断心脏微环境中的细胞间通讯网络39。利用 CellChatDB.human 数据库构建 CellChat 对象。通过 identifyOverExpressedGenes 鉴定差异表达的配体和受体,并通过 identifyOverExpressedInteractions 筛选具有显著性的相互作用配对。
使用 computeCommunProb 计算细胞类型间的通信概率。利用 aggregateNet 汇总全局细胞类型水平的通信网络。通过热图和柱状图对每对细胞类型之间的相互作用数量和通信强度进行量化和可视化。
10. 免疫细胞浸润定量分析
使用单样本基因集富集分析28及免疫细胞特征基因集40,计算每个批量样本中28种免疫细胞类型的富集评分。采用Wilcoxon秩和检验比较扩张型心肌病(DCM)组与健康对照组之间的免疫细胞富集评分差异。以 P < 0.05 为差异具有统计学意义。
采用皮尔逊相关性分析评估核心基因表达水平与免疫细胞富集评分之间的关联。所有相关性分析中,P 值小于 0.05 者视为具有统计学意义。 < 0.05 被视为具有统计学意义。
11. 用于分子分型的共识聚类
使用核心基因表达谱对中国台湾扩张型心肌病样本进行无监督共识聚类 通过 ConsensusClusterPlus 软件包41聚类参数设置为最大聚类数6,重采样迭代次数1000次,重采样比例0.8。采用欧氏距离进行围绕中心点的划分聚类(Partitioning around medoids),并使用固定的随机种子以确保结果可重复。
根据面积差值图和共识聚类稳定性评分确定最优亚型数量,最终确定 K = 2。进一步进行主成分分析以验证两种分子亚型的显著分离。
采用基因集变异分析42计算样本特异性的 KEGG 通路富集分数。使用 limma 软件包27检测不同亚型间通路激活的差异,以 P 值小于 0.05 定义为具有统计学意义。
12. 心脏功能的超声心动图评估
小鼠被麻醉 通过 腹腔注射1%戊巴比妥钠(30 mg/kg)后,将动物仰卧位固定于恒温手术台上。去除胸部毛发后,将超声耦合凝胶均匀涂抹于心前区。
采用小动物超声系统,在左心室乳头肌水平进行二维引导的M型超声心动图检查。采集三个连续且稳定的心动周期,用于测量左心室舒张末期内径、收缩末期内径、射血分数及缩短分数。所有超声心动图评估均由一名专业超声技师盲法完成。
每组随机选取三只小鼠进行超声心动图检查,随后处死这共计6只动物以采集心肌组织并进行ELISA检测。其余实验动物接受了额外的平行实验室检测,但其数据未纳入本研究。
13. 心肌组织采集、蛋白质提取及酶联免疫吸附测定
经超声心动图评估后,在深度麻醉下处死小鼠,迅速采集心脏组织 通过 正中开胸术,并在冰上解剖左心室心肌。分离的组织用冰冷的磷酸盐缓冲液充分冲洗,以去除残留的心内血液。用无菌滤纸吸去多余液体后,样本立即在液氮中速冻,并储存于−80 °C 后续进行蛋白质提取时,须严格避免反复冻融循环。
将冷冻的心肌组织称重后置于冰上,切成约1 mm3的碎片。按照每10 mg组织加入100 µL裂解缓冲液的标准比例,使用含蛋白酶和磷酸酶抑制剂的预冷RIPA裂解缓冲液对组织进行裂解。样品在冰上通过机械方式充分匀浆,并于冰上孵育30分钟,以实现完全的细胞裂解。
裂解物在 4 °C 条件下以 12,000 × g 离心 15 分钟。收集上清液至无酶管中,使用二辛可宁酸蛋白检测试剂盒按照生产商的说明书定量总蛋白浓度。所有样品均用裂解缓冲液调整至相同的蛋白浓度。
采用相应的酶联免疫吸附测定(ELISA)试剂盒检测心肌裂解液中四个枢纽基因的蛋白质表达水平。将系列稀释的标准品和归一化的组织裂解液以每孔100 µL的体积重复加入预包被的微孔板中。微孔板于室温孵育2小时,随后使用试剂盒提供的洗涤缓冲液充分洗涤。
每孔加入酶标抗体,室温孵育1小时,随后彻底洗涤。然后加入底物显色液,酶标板在避光条件下室温孵育20分钟。加入终止液终止显色反应,使用全波长酶标仪在450 nm波长(参考波长:570 nm)测定吸光度值。
14. 统计分析
所有统计分析和数据可视化均使用 R 4.2.3 版本完成。对于每个目标基因(TGFB2、SERPINE1、CYBB、TLR2)的 ELISA 浓度测量值,首先分别对对照组和 DCM 组应用 Shapiro-Wilk 检验以评估数据的正态性。随后使用 F 检验评估两组间方差的齐性。组间比较方法根据方差齐性检验结果确定:若方差齐性(P ≥ 0.05),采用非配对 Student t 检验比较组间均值;若方差不齐(P < 0.05),则采用校正的 Welch t 检验进行分析。所有检验均为双尾检验,统计学显著性阈值设定为 P < 0.05。数据以箱线图表示,并叠加抖动显示的单个数据点。所有检验的 P 值及所用 t 检验类型均在图中详细标注。
结果
数据预处理与差异表达分析
所有六个批量转录组数据集在进行下游分析之前均经过标准化预处理和批次效应校正。微阵列数据采用稳健多阵列平均算法进行归一化,而RNA-seq计数数据则采用M值的修剪均值法(TMM)进行归一化。使用ComBat算法去除与数据集来源和检测平台相关的技术性批次效应。主成分分析显示,校正前样本按数据集来源聚类,而校正后样本分布更为均匀,且无明显的批次分离现象。
使用 limma 软件包对扩张型心肌病(DCM)组与健康对照(HC)组之间进行了差异表达分析。20 个差异最显著的基因的热图显示两组之间的表达谱存在分离(图 1A)。采用 P 值 < 0.05 且 |log₂ 倍数变化| > 0.58 作为阈值,共鉴定出 1,473 个差异表达基因。其中,在 DCM 心肌样本中,819 个基因上调,654 个基因下调(图 1B)。
随后采用单样本基因集富集分析,计算每个样本中与衰老相关和线粒体相关的基因集的富集评分。DCM组与HC组之间的这两项评分均存在显著差异(图1C)。
加权基因共表达网络分析
采用加权基因共表达网络分析方法,以鉴定与衰老相关及线粒体富集评分相关的基因模块。基于批量数据集中表达方差最高的 5,000 个蛋白编码基因构建网络。在软阈值幂参数 β = 5 时,无标度拓扑拟合指数超过 R2 = 0.9,符合无标度网络标准(图 1D)。
层次聚类与模块合并鉴定了三个基因模块。所有三个模块均与衰老相关评分显著相关。其中,青色模块与衰老相关评分的相关性最强(r = 0.69,P < 0.001)。对于线粒体评分,蓝色模块和灰色模块均表现出显著相关性,其中蓝色模块的相关性最强(r = 0.56,P < 0.001;图1E)。因此,选择青色模块用于衰老相关基因筛选,蓝色模块用于线粒体相关基因筛选。
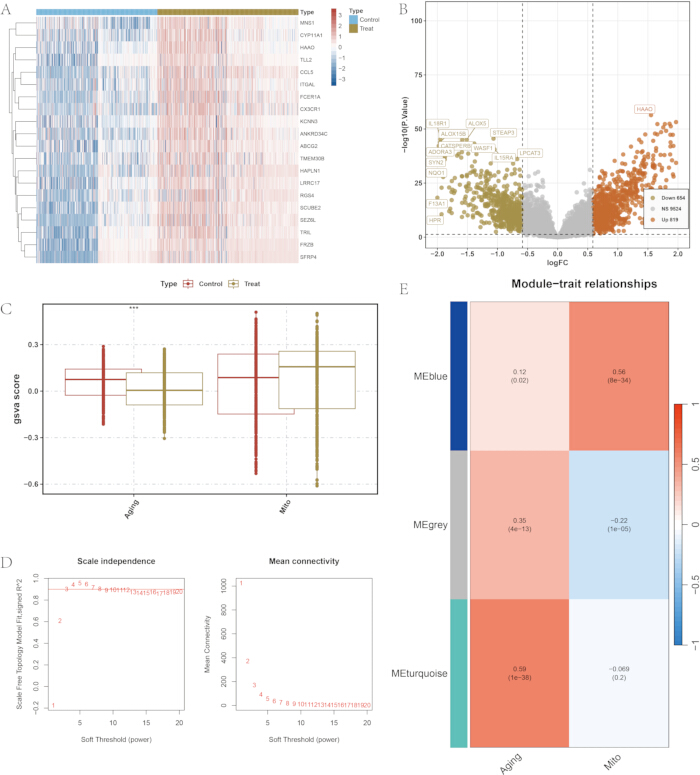
图1:差异表达分析与加权基因共表达网络构建。(A)扩张型心肌病(DCM)组与健康对照(HC)组之间差异表达最显著的20个基因的热图。(B)所有差异表达基因的火山图。红色表示上调基因,绿色表示下调基因,灰色表示无显著性基因。筛选阈值为P值 < 0.05且|log₂倍数变化| > 0.58。(C)单样本基因集富集分析(ssGSEA)得分在衰老相关和线粒体相关基因集中的箱线图。(D)加权基因共表达网络分析的软阈值选择,显示不同软阈值幂次下的无标度拓扑拟合指数和平均连接度。(E)模块特征基因与衰老相关及线粒体相关评分之间相关性的热图。请点击此处查看该图的放大版本。
衰老和线粒体相关候选基因的鉴定
通过将差异表达基因、选定的加权基因共表达网络分析模块中的基因以及相应的参考基因集取交集,鉴定出候选基因。该分析共鉴定出 66 个与扩张型心肌病(DCM)相关的衰老候选基因(图 2A)和 16 个与 DCM 相关的线粒体候选基因(图 2B)。
基因本体富集分析显示,与衰老相关的候选基因在包括一氧化氮合酶生物合成和含胶原的细胞外基质组织等生物学过程中显著富集(图2C)。线粒体相关的候选基因则在与线粒体能量代谢相关的术语中富集,包括线粒体内膜和呼吸链复合物(图2D)。
京都基因与基因组百科全书分析显示,与衰老相关的候选基因在缺氧诱导因子-1、磷脂酰肌醇3-激酶-蛋白激酶B以及晚期糖基化终产物-晚期糖基化终产物受体信号通路中显著富集(图2E)。与线粒体相关的候选基因则在氧化磷酸化等通路中显著富集(图2F)。
DCM组与HC组之间66个衰老相关候选基因的差异表达模式通过表达热图进行可视化展示(图2G)。16个线粒体相关候选基因的表达模式通过箱线图进行可视化展示(图2H)。
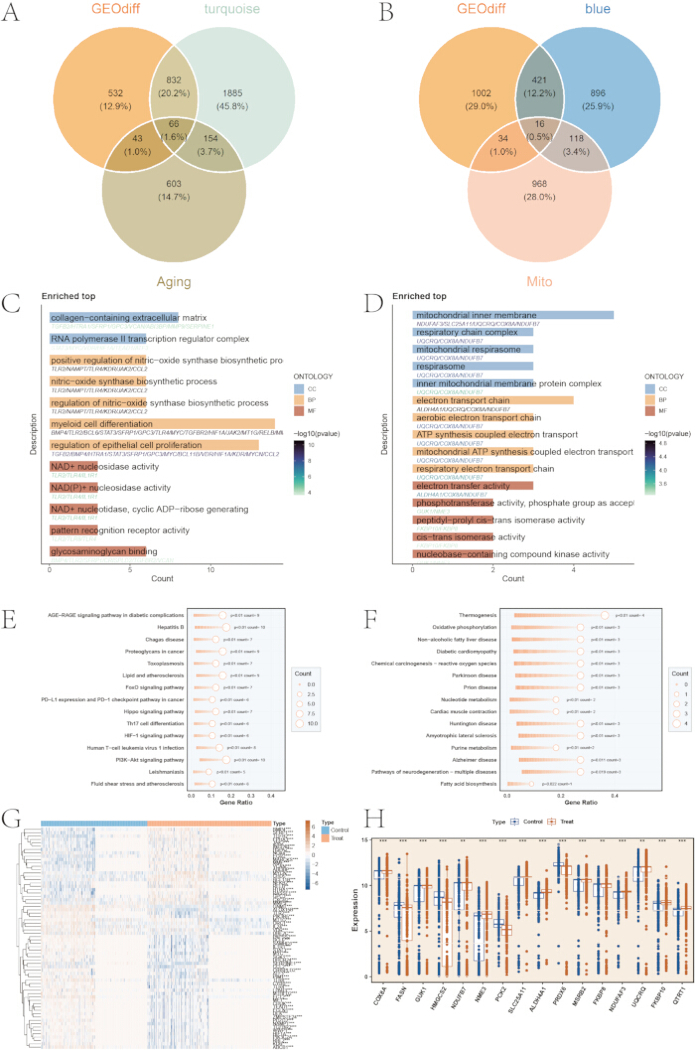
图 2:候选基因的筛选与功能富集分析。(A)维恩图显示差异表达基因、加权基因共表达网络分析模块基因与衰老相关参考基因集之间的交集。(B)维恩图显示差异表达基因、加权基因共表达网络分析模块基因与线粒体相关参考基因集之间的交集。(C)衰老相关候选基因的基因本体(Gene Ontology)富集分析。(D)线粒体相关候选基因的基因本体(Gene Ontology)富集分析。(E)衰老相关候选基因的京都基因与基因组百科全书(Kyoto Encyclopedia of Genes and Genomes)通路富集分析。(F)线粒体相关候选基因的京都基因与基因组百科全书(Kyoto Encyclopedia of Genes and Genomes)通路富集分析。(G)66个衰老相关候选基因在DCM组和HC组中的表达热图。(H)16个线粒体相关候选基因在DCM组和HC组中的表达箱线图。请点击此处查看该图的放大版本。
单细胞RNA测序数据集的细胞类型注释
采用GSE145154单细胞RNA测序数据集进行单细胞分辨率验证。经过质控过滤、对数归一化及Harmony批次校正后,来自不同样本的细胞在均匀流形近似与投影空间中分布均匀,未见明显的样本特异性分离。基于前15个主成分及0.15的聚类分辨率,将细胞划分为9个簇(图3A)。
通过SingleR进行经典标记基因分析和自动注释,鉴定出9种主要细胞类型:巨噬细胞、自然杀伤细胞、T细胞、B细胞、内皮细胞、平滑肌细胞、单核细胞、基质细胞和心肌细胞(图3B)。细胞类型特异性标记基因的表达模式支持了这些注释结果(图3C)。
使用 AddModuleScore 函数计算了每个细胞的线粒体模块评分,扩张型心肌病组与健康对照组之间的评分差异具有显著性(P < 2.22 × 10⁻16;图 3D)。两组之间的衰老相关模块评分也存在显著差异(P < 2.22 × 10⁻16;图 3E)。将线粒体评分投影到均匀流形近似与投影空间中显示,高评分主要出现在心肌细胞中(图 3F)。相比之下,高衰老相关评分则主要出现在巨噬细胞中(图 3G)。
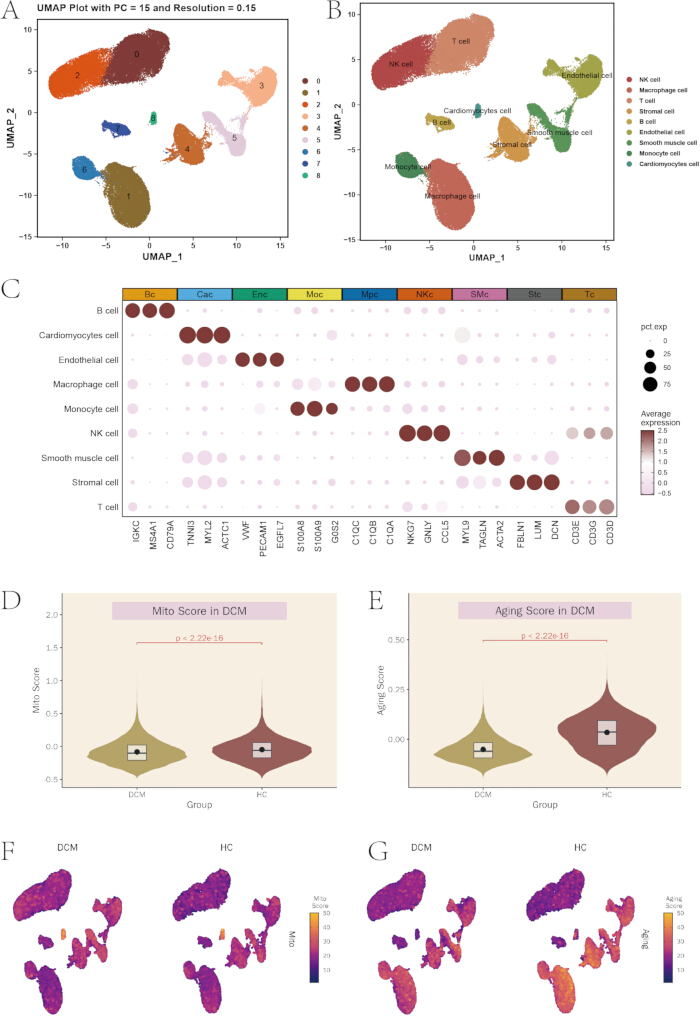
图 3:单细胞转录组注释与模块评分分析。(A)基于前 15 个主成分及聚类分辨率为 0.15 生成的细胞簇的 Uniform Manifold Approximation and Projection(UMAP)图。(B)已注释细胞类型的 Uniform Manifold Approximation and Projection(UMAP)图。(C)显示不同细胞类型中经典标志基因表达的气泡图。(D)DCM 组与 HC 组中线粒体模块评分的小提琴图。(E)DCM 组与 HC 组中衰老相关模块评分的小提琴图。(F)显示线粒体模块评分在各细胞中分布情况的 Uniform Manifold Approximation and Projection(UMAP)图。(G)显示衰老相关模块评分在各细胞中分布情况的 Uniform Manifold Approximation and Projection(UMAP)图。请点击此处查看该图的放大版本。
蛋白质-蛋白质相互作用网络构建
将整合的66个衰老相关基因和16个线粒体相关候选基因提交至STRING 11.5数据库,以构建蛋白质-蛋白质相互作用网络,置信度阈值设定为综合评分 > 0.7。该网络被导入Cytoscape中进行可视化与拓扑分析(图4A)。
采用度、最大团中心性、最大邻域组分以及MCODE分析方法来识别高度连接的节点和核心子网络。这些方法所鉴定出的子网络如图4B–E所示。
根据度、最大团中心性及最大邻域组分排名的前10个基因与MCODE核心子网络中的基因取交集。该分析鉴定了10个候选基因:TGFB2、TLR2、SERPINE1、CYBB、KDR、TLR4、HIF1A、CCL2、MMP9 和 CXCR2。
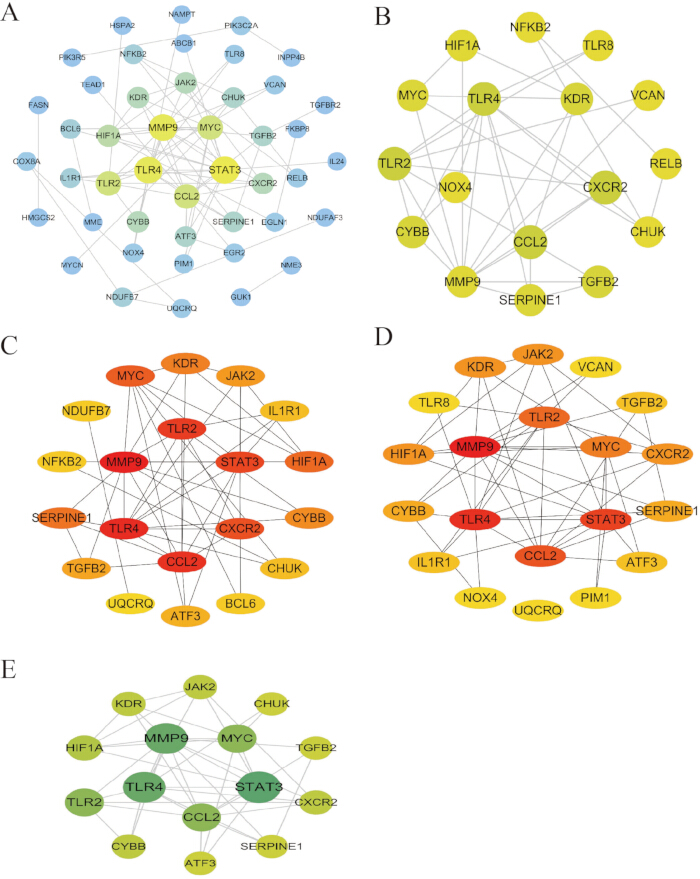
图 4:蛋白质-蛋白质相互作用网络构建与枢纽基因筛选。
(A) 候选基因的整体蛋白质-蛋白质相互作用网络。(B) 使用 MCODE 鉴定的核心子网络。(C) 使用最大团中心性(maximal clique centrality)鉴定的核心子网络。(D) 使用最大邻域组分(maximum neighborhood component)鉴定的核心子网络。(E) 使用度值(Degree)鉴定的核心子网络。请点击此处查看该图的高清版本。
基于机器学习的枢纽基因筛选
采用三种机器学习算法——最小绝对收缩与选择算子逻辑回归(LASSO)、随机森林和支持向量机-递归特征消除——从10个蛋白质-蛋白质相互作用候选基因中筛选枢纽基因。所有分析均使用固定的随机种子(set.seed(12345))和5折交叉验证进行。在LASSO模型中,在最优lambda值(lambda.min)下具有非零系数的基因被保留为候选基因 (图5A)。
在支持向量机-递归特征消除模型中,当包含10个特征时,交叉验证准确率达到最高的0.859(图5B),对应的最小错误率为0.141(图5C)。由500棵决策树组成的随机森林模型显示出袋外错误率的稳定收敛趋势(图5D)。基于Gini系数的基因重要性排序结果显示,TGFB2、TLR2、SERPINE1和CYBB位于最高排名的基因之列(图5E)。三种算法所选基因的交集最终确定了四个核心基因:CYBB、SERPINE1、TGFB2和TLR2(图5F)。
采用SHapley可加性解释(SHapley Additive exPlanations)分析评估每个枢纽基因对模型预测的贡献。其中,TGFB2的平均绝对SHapley可加性解释值最高,为0.249,其次是SERPINE1(0.103)、CYBB(0.083)和TLR2(0.078)(图6A)。汇总图展示了各基因在不同样本中贡献值的分布及方向(图6B)。依赖性图揭示了单个基因表达值与模型贡献之间的关系(图6C),而逐样本的瀑布图则显示了每个基因对个体预测结果的贡献(图6D)。
随后使用10种分类算法基于四个枢纽基因构建诊断分类模型。在训练集中,大多数算法的曲线下面积值均超过0.85(图6E)。在内部验证集中,大多数算法的曲线下面积值均超过0.78(图6F)。
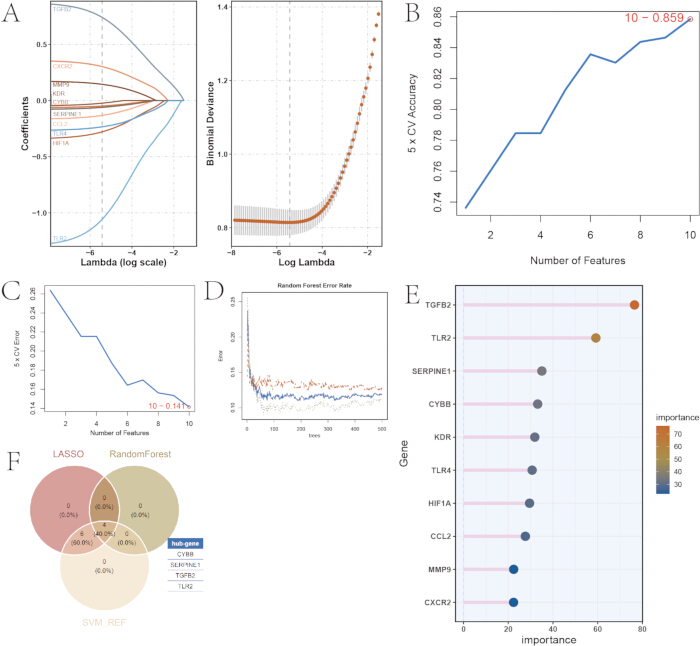
图 5:基于机器学习的枢纽基因筛选。(A)最小绝对收缩与选择算子回归系数轨迹及最优 lambda 选择。(B)支持向量机-递归特征消除模型的交叉验证准确率曲线。(C)支持向量机-递归特征消除模型的交叉验证错误率曲线。(D)随机森林模型的袋外错误率曲线。(E)基于随机森林模型中 Gini 系数的基因重要性排序。(F)Venn 图显示三种机器学习算法识别出的枢纽基因。 请点击此处查看该图的高清版本。
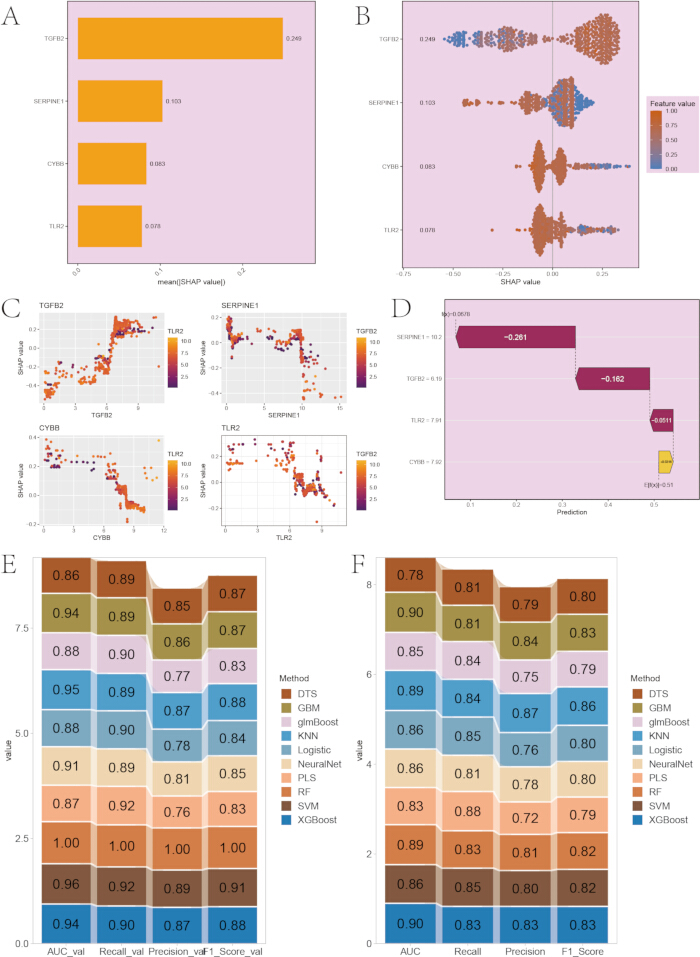
图 6:诊断模型评估与SHapley可加性解释(SHapley Additive exPlanations, SHAP)分析。 (A)四个枢纽基因的平均绝对SHapley可加性解释值。 (B)SHapley可加性解释汇总图,显示基因贡献的分布与方向。 (C)各枢纽基因的SHapley可加性解释依赖图。 (D)代表性样本的SHapley可加性解释瀑布图。 (E)训练集中10种分类算法的诊断性能热图。 (F)验证集中10种分类算法的诊断性能热图。 请点击此处查看该图的高清版本。
单细胞验证与细胞间通讯分析
在单细胞水平上评估了四个核心基因的表达模式。细胞类型分布分析显示,CYBB 和 TLR2 在单核细胞和巨噬细胞中高表达,而 SERPINE1 和 TGFB2 主要在基质细胞中表达(图 7A)。
小提琴图显示,扩张型心肌病组与健康对照组之间的 CYBB 表达水平存在显著差异(图7B)。SERPINE1(图7C),TGFB2(图7D)和 TLR2(图7E)在各组之间也存在显著差异。与健康对照组相比,扩张型心肌病组中所有四个基因均显著上调,P < 每次比较的显著性水平为 0.0001。
使用CellChat和配体-受体数据库推断了心脏微环境中细胞间的通信网络。扩张型心肌病组与对照组之间,细胞间相互作用的数量和总体强度存在差异(图7F)。不同细胞类型之间的通信强度差异也得以观察到(图7G)。单核细胞、巨噬细胞、心肌细胞和基质细胞是该通信网络中的主要参与者。
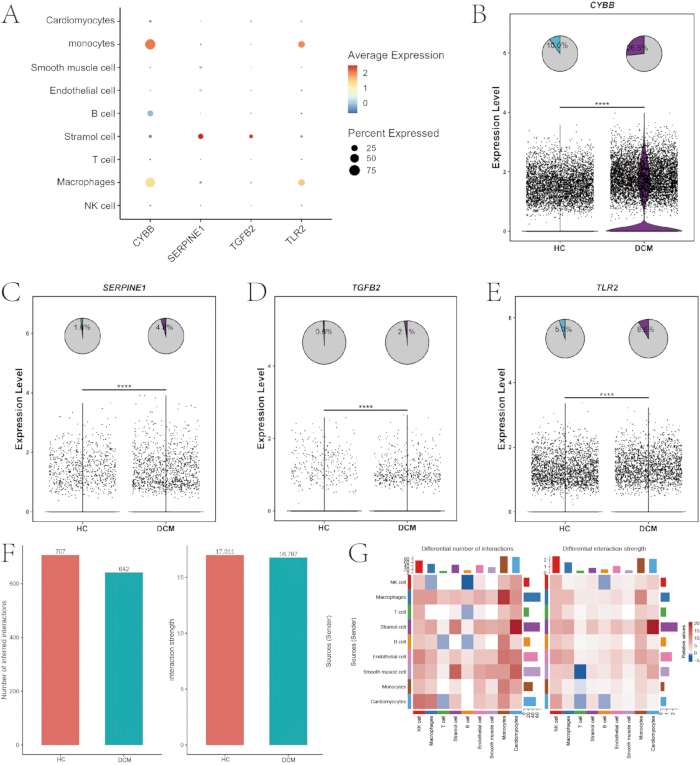
图 7:枢纽基因的单细胞验证及细胞间通讯分析。 (A)气泡图显示四个枢纽基因在不同细胞类型中的表达情况。(B)DCM组与HC组中CYBB基因表达的小提琴图。(C)DCM组与HC组中SERPINE1基因表达的小提琴图。(D)DCM组与HC组中TGFB2基因表达的小提琴图。(E)DCM组与HC组中TLR2基因表达的小提琴图。(F)柱状图显示细胞间相互作用的数量及总体强度。(G)热图显示不同组间细胞间通讯强度的差异。请点击此处查看该图的高清版本。
免疫细胞浸润分析
采用单样本基因集富集分析方法,计算每个整体样本中28种免疫细胞亚群的富集评分。扩张型心肌病组与健康对照组之间,大多数免疫细胞类型的丰度存在显著差异(图8A)。
随后进行皮尔逊相关性分析,以评估枢纽基因表达与免疫细胞富集评分之间的关系。CYBB 表达水平与多种免疫细胞类型的丰度显著相关(图 8B)。SERPINE1(图 8C)、TGFB2(图 8D)和 TLR2(图 8E)也表现出类似的相关性。CYBB、SERPINE1 和 TLR2 与多种天然免疫细胞群体(包括单核细胞和巨噬细胞)呈正相关。
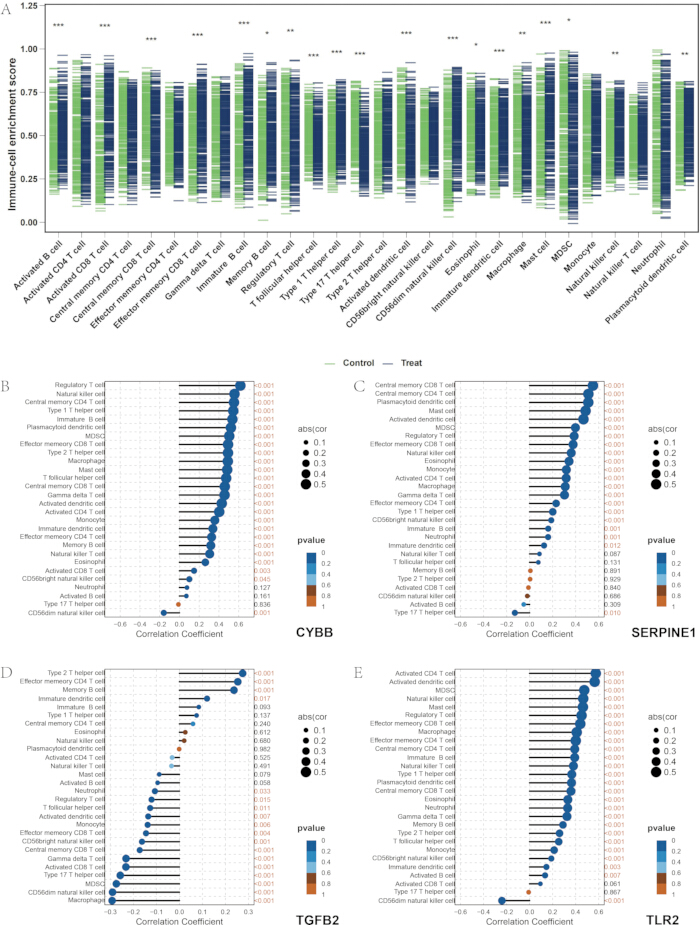
图 8:免疫细胞浸润与相关性分析。 (A)DCM 组与健康对照组(HC 组)中 28 种免疫细胞类型的富集评分箱线图。 (B)CYBB 表达水平与免疫细胞丰度之间的相关性棒棒糖图。 (C)SERPINE1 表达水平与免疫细胞丰度之间的相关性棒棒糖图。 (D)TGFB2 表达水平与免疫细胞丰度之间的相关性棒棒糖图。 (E)TLR2 表达水平与免疫细胞丰度之间的相关性棒棒糖图。 请点击此处查看该图的高清版本。
扩张型心肌病的分子亚型分类
基于四个枢纽基因的表达谱,对扩张型心肌病样本进行了无监督共识聚类分析。共识聚类矩阵支持在 K = 2 时进行分组(图 9A)。Delta area 图进一步支持 K = 2 为最优聚类数目,将样本划分为两种分子亚型,即 C1 和 C2(图 9B)。
CYBB、SERPINE1 和 TLR2 的表达水平在两种亚型之间存在显著差异(图 9C)。多种免疫细胞亚群的丰度在两种亚型之间也有所不同(图 9D)。基因集变异分析显示,C1 亚型中血管内皮生长因子信号通路相对激活,而 C2 亚型中初级胆汁酸生物合成和糖鞘脂生物合成通路富集(图 9E)。主成分分析显示,归属于两种亚型的样本之间存在明显分离(图 9F)。
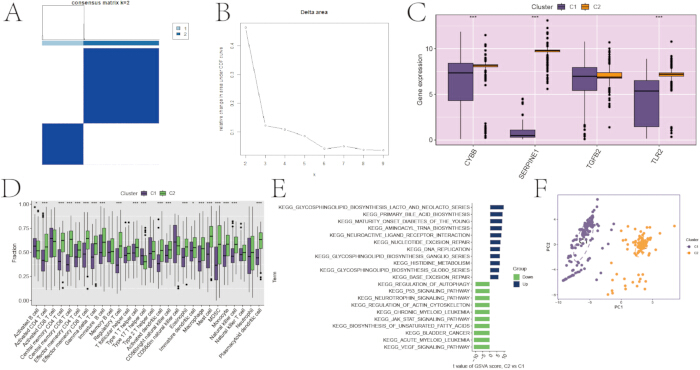
图9:扩张型心肌病分子分型的共识聚类分析。(A)K = 2时的共识聚类矩阵。(B)用于确定最优聚类数目的Delta面积图。(C)两种分子亚型中枢纽基因表达的箱线图。(D)两种分子亚型中免疫细胞丰度的箱线图。(E)两种分子亚型间京都基因与基因组百科全书(Kyoto Encyclopedia of Genes and Genomes)通路差异富集的热图。(F)主成分分析图,显示两种分子亚型之间的分离情况。请点击此处查看该图的高清版本。
体内验证在扩张型心肌病小鼠模型中的应用
采用具有自发性扩张型心肌病表型的CTNTR141W转基因小鼠进行体内验证。与同龄野生型C57BL/6J对照小鼠相比,转基因小鼠表现出显著增大的左心室舒张末期内径和降低的左心室射血分数,符合心室扩张和收缩功能障碍的特征(图10A)。
从左心室心肌组织中提取总蛋白,并在通过二喹啉甲酸法对总蛋白进行标准化后,采用酶联免疫吸附测定法(ELISA)检测四个核心基因编码蛋白的浓度。所有检测均设置重复孔。标准曲线的相关系数(R2)≥ 0.99,重复孔间的变异系数低于10%。Control组与DCM组之间的统计学差异根据F检验评估的方差齐性情况,采用Student's t检验或Welch's t检验进行分析(正态性由Shapiro-Wilk检验确认)。与对照组相比,扩张型心肌病(DCM)小鼠中对应全部四个核心基因的心肌蛋白水平均显著升高(图10B)。ELISA验证实验中每组包含3个生物学重复(单个小鼠)。ELISA验证每组包括三个独立的生物学重复。上述结果应视为初步发现,需在更大样本队列中进一步验证。
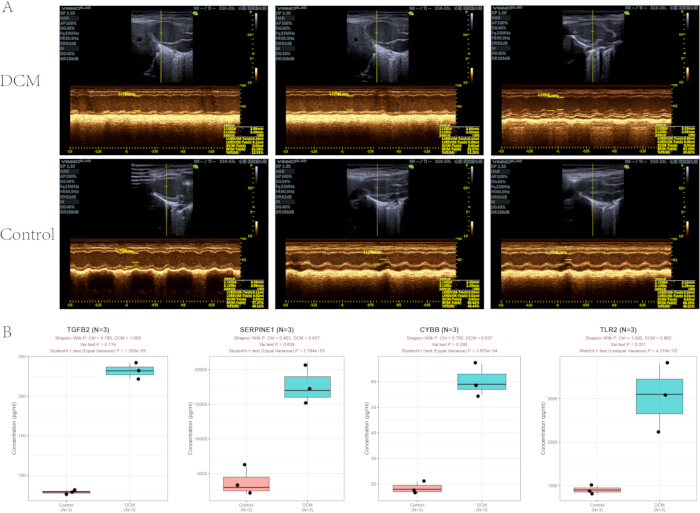
图10:CTNTR141W 转基因扩张型心肌病小鼠模型中的体内验证。(A)CTNTR141W 转基因扩张型心肌病小鼠与野生型对照小鼠的代表性 M 型超声心动图图像。(B)小鼠左心室心肌组织中四个枢纽基因编码蛋白的 ELISA 定量结果。箱须图显示对照组与扩张型心肌病组的蛋白浓度(每组 n = 3 个生物学重复)。每个箱须图中:箱体内实线表示中位数;箱体上下边界分别为第75和第25百分位数(四分位距,IQR);上下须线延伸至1.5 × IQR 范围内的最大和最小非离群数据点;单个黑色实心圆点代表来自单只动物的独立生物学重复。纵轴表示蛋白绝对浓度:TGFB2 和 CYBB 为 pg/mL,TLR2 和 SERPINE1 为 ng/mL。两组间的统计学比较采用 Student t 检验(方差齐性)或 Welch t 检验(方差不齐),数据正态性由 Shapiro-Wilk 检验确认,方差齐性通过 F 检验评估。局限性说明:基于 n = 3 个重复获得的 ELISA 结果为初步探索性发现,未来需扩大样本量进一步验证。请点击此处查看此图的放大版本。
数据可用性:
本研究中分析的六个批量转录组数据集和一个单细胞RNA测序数据集已公开提供于基因表达综合数据库(Gene Expression Omnibus),登录编号分别为GSE5406、GSE42955、GSE57338、GSE79962、GSE116250、GSE141910和GSE145154。单细胞分析包含了来自GSE145154的样本GSM4307515、GSM4307516、GSM4307520和GSM4307521。本研究期间生成或分析的所有其他数据以及计算代码均包含在本发表文章及其补充信息文件中。具体而言,补充文件1包含了完整的衰老和线粒体相关基因列表、28种细胞免疫特征、自定义分析脚本、标准化转录组数据矩阵、ELISA实验的源数据以及所有论文图表的原始源数据。
补充文件 1:与衰老和线粒体相关的基因集、免疫特征、分析脚本、标准化转录组数据以及图表源数据。请点击此处下载该文件。
讨论
整合的多层工作流程结合了大规模转录组学荟萃分析、加权基因共表达网络构建、集成机器学习、单细胞转录组验证以及体内动物模型验证。研究鉴定出四个与衰老和线粒体相关的中心基因CYBB、SERPINE1、TGFB2和TLR2,作为扩张型心肌病(DCM)潜在的诊断生物标志物。整合来自基因表达综合数据库(Gene Expression Omnibus)的六个独立左心室转录组数据集,包括微阵列和RNA测序平台,减少了单个数据集带来的偏差,并增强了分析的统计学基础43,44,45。加权基因共表达网络分析结合预定义的衰老相关和线粒体基因集合,能够识别与表型相关的功能模块,而非仅依赖差异表达分析46。集成机器学习降低了单一特征选择方法所固有的算法偏差47,48,而SHapley加性解释(SHapley Additive exPlanations)分析则量化了每个中心基因对模型预测的贡献度49。通过大规模心肌转录组、单细胞转录组以及转基因小鼠模型的验证,进一步表征了所选基因在细胞分布及心肌蛋白水平上的表达特征50。
批次校正是整合分析中的关键步骤,因为残余的特定数据集变异可能影响差异表达分析和模块-性状关联。因此,在ComBat模型中将数据集来源和检测平台作为批次因子纳入。主成分分析图中若存在残余的数据集依赖性聚类,则提示校正不充分及潜在的系统性偏差44。软阈值化幂次对于加权基因共表达网络的构建也至关重要。选择能够产生大于0.9的无尺度拓扑拟合指数(R2 > 0.9)的最小值,确定β = 5。若该值过低,可能导致模块碎片化或功能信息不足;而过高则可能削弱基因间的连接性,并降低模块-性状相关性分析的统计效能46。单细胞质控阈值根据心脏组织特性进行了调整,因为心肌细胞具有较高的代谢活性。采用严格的过滤策略,设定线粒体基因百分比低于25%、检测到的基因数范围为200–6,000,以去除破裂和低质量细胞,同时保留心肌细胞50。为减少重复机器学习分析之间的变异,数据集划分、模型训练和交叉验证均使用固定的随机种子set.seed(12345)47。
基因型确认、标准化饲养以及一致的超声心动图测量对于维持动物实验中表型的稳定性至关重要。CTNTR141W 转基因小鼠在经过规定的适应期和喂养期后,会出现左心室扩张和收缩功能障碍51。分组前必须进行基因型验证,以排除非转基因动物,防止表型误分类。超声心动图测量应在左心室乳头肌水平一致地获取,并对连续三个稳定的心动周期测量值取平均。成像位置或麻醉深度的变化可能会增加左心室射血分数测量的变异性51。酶联免疫吸附试验(ELISA)的质量通过标准曲线相关系数进行评估,要求 R2 ≥ 0.99,且复孔之间的变异系数 < 10%。标准曲线线性不佳或复孔测量结果不一致可能在蛋白浓度估算中引入系统误差。
在实施工作流程期间,可能会出现若干分析问题。ComBat 校正后仍持续存在的批次分离现象,可能反映了批次变量与临床因素之间的共线性、低表达基因过滤不足,或未建模的技术变异。当有可用数据时,可将年龄和性别等临床协变量作为保护变量纳入分析,同时可移除在超过 70% 样本中表达量为零的基因以降低噪声44。若仍存在残余的批次分离,可考虑使用 removeBatchEffect 进行补充校正。差异表达基因数量异常偏高或偏低时,需评估样本异质性、标准化方法、离群值及阈值选择27。模块与性状相关性较低时,可通过重新评估方差阈值、软阈值化参数以及极端性状值来改善。将最可变基因从 5,000 个扩展至 7,500 个,或将单样本基因集富集分析替换为基因集变异分析,可能有助于提高模块检测效果46。蛋白质-蛋白质相互作用网络中孤立节点过多时,可能需要调整 STRING 置信度阈值或扩大候选基因集合30。机器学习性能不佳可能源于训练集与验证集之间的分布差异、特征冗余或类别不平衡。采用分层抽样、减少冗余特征或对少数类别进行过采样,可能减轻这些影响47。单细胞聚类结果不明确时,需重新评估 Harmony 校正、主成分选择及标记基因注释50。
应考虑若干局限性。转录组数据集系从公共数据库中回顾性获取,无法控制原始研究设计和临床混杂因素。各数据集的临床注释不完整,大多数数据集缺乏关于病因、用药史、患者年龄及长期预后的详细信息。这些局限性阻碍了对所选基因与预后、治疗反应或时间性衰老之间关联的评估52。尽管已进行批次效应校正,仍可能存在残余的技术变异。分析主要基于信使RNA表达,未整合表观基因组、蛋白质组或代谢组数据。因此,无法确定蛋白质活性、翻译后调控以及上游作用机制。分析中仅纳入一个单细胞数据集,限制了对不同扩张型心肌病(DCM)病因间细胞异质性的评估50。CTNTR141W转基因模型主要代表与肌钙蛋白T突变相关的遗传性DCM,可能无法模拟特发性、病毒性或缺血性疾病的病理形式51。小鼠与人类之间的物种差异也限制了直接的临床转化。蛋白质水平的验证仅限于小鼠心肌组织,未开展大规模临床队列研究,也未与已确立的生物标志物进行比较。四个核心基因并非DCM特异性,也可能在其他心血管或炎症性疾病中发生改变。此外,候选基因的筛选基于预先定义的衰老相关和线粒体基因集。这种假设驱动的策略可能排除所选参考基因集之外的基因,而三种机器学习算法的交集分析可能遗漏仅被单一方法识别的基因48。
该分析框架可为扩张型心肌病(DCM)的未来分子亚型分类、生物标志物验证及多组学研究提供支持。在评估四基因 panel 作为诊断或亚型分类工具之前,可先在独立的外周血或心肌队列中对其进行验证。C1 和 C2 亚型表现出不同的免疫和代谢通路特征,为后续验证亚型特异性的生物学特征提供了依据15。所选基因也可用于分子对接、细胞及功能研究。TLR2 和 CYBB 与炎症信号传导及活性氧的产生相关,而 TGFB2 和 SERPINE1 则与纤维化及心脏重构相关53。整合蛋白质组学、代谢组学、表观基因组学、全基因组关联研究以及孟德尔随机化数据,可能有助于评估调控关系及潜在的因果关联54。通过替换疾病特异性的数据集和参考基因集,该工作流程也可适用于肥厚型心肌病、缺血性心肌病及心力衰竭的转录组学研究45。未来若引入单细胞转座酶可及染色质测序(scATAC-seq)和空间转录组学检测,可能进一步提供有关细胞调控和空间表达的信息。在巨噬细胞中观察到的衰老相关特征富集,以及在心肌细胞中观察到的线粒体特征富集,与既往关于心脏疾病中炎症和线粒体过程的研究报道一致55,56,57。
本研究存在若干局限性,需予以说明。值得注意的是,用于蛋白质定量的商用ELISA试剂盒已由厂家正式验证适用于血清样本中目标蛋白的检测。在本研究中,检测基质采用的是心肌组织裂解液而非血清。尽管在整个检测过程中严格实施了统一的样本预处理和实验操作流程,以确保实验数据的可靠性和可比性,但这些ELISA试剂盒在心肌组织裂解液样本中缺乏厂家官方验证,可能导致蛋白质定量结果出现潜在的细微偏差。因此,将仅针对血清设计的ELISA试剂盒应用于心肌组织裂解液,构成本研究的方法学局限性。
披露
作者声明无竞争利益。
致谢
感谢Gene Expression Omnibus数据库提供的公开可用数据。同时感谢审稿人和编辑对稿件提出的建设性意见。本研究由省级部门级科研项目(项目编号:2021JDZX2026)“益气活血方减轻动脉粥样硬化性血管重构的机制”资助。 通过 KLF2-Nrf2介导的炎症调控
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| 超声耦合剂 Aquasonic Clear | Parker Laboratories, Inc. | Mar-34 | 用于小动物超声心动图成像。 |
| BCA 蛋白检测试剂盒 | Thermo Fisher Scientific | 23227 | 在 562 nm 处检测;检测范围为 20–2,000 µg/mL;用于小鼠心脏组织裂解液的总蛋白定量。 |
| CellAge 数据库 | Human Ageing Genomic Resources | https://genomics.senescence.info/cells/ | 衰老相关基因特征的来源。 |
| CytoHubba(Cytoscape 插件) | Cytoscape App Store | 版本 0.1 | 用于蛋白质-蛋白质相互作用网络中的节点拓扑评分。 |
| Cytoscape | Cytoscape Consortium | 版本 3.9.1 | 用于蛋白质-蛋白质相互作用网络的可视化。 |
| 全波长酶标仪 | Thermo Fisher Scientific | Multiskan FC | 用于 ELISA 实验中的吸光度测定。 |
| 基因表达综合数据库(Gene Expression Omnibus) | 美国国家生物技术信息中心(National Center for Biotechnology Information) | https://www.ncbi.nlm.nih.gov/geo/ | 公共数据库,用于获取转录组数据集。 |
| GeneCards | 魏茨曼科学研究所(Weizmann Institute of Science) | https://www.genecards.org/ | 线粒体相关基因集的来源。 |
| Halt 蛋白酶与磷酸酶抑制剂混合液(100×,无 EDTA) | Thermo Fisher Scientific | 78441 | 4 °C 保存;使用前立即以 10 µL/mL 的比例加入 RIPA 缓冲液中。 |
| 液氮 | 本地实验室气体供应商 | 不适用 | 用于心肌组织的速冻处理。 |
| 雄性 SPF 级 C57BL/6J 小鼠,6–8 周龄,25 ± 2 g | 北京维通利华实验动物技术有限公司 | 不适用 | 动物生产许可证号:SCXK(京)2021-0006;作为正常对照组使用。 |
| 雄性 SPF 级 CTNTR141W 转基因扩张型心肌病(DCM)小鼠,6–8 周龄,25 ± 2 g | 中国医学科学院实验动物研究所 | 不适用 | 动物生产许可证号:SCXK(京)2021-0065;作为自发性 DCM 模型使用。 |
| MCODE(Cytoscape 插件) | Cytoscape App Store | 版本 2.0.2 | 用于识别蛋白质-蛋白质相互作用网络中的核心功能子网络。 |
| 小鼠 CYBB ELISA 试剂盒 | Biogradetech | A-QEK09250-96wells | 本研究中用于测定小鼠心肌组织裂解液中的 CYBB 水平。 |
| 小鼠 PAI-1 ELISA 试剂盒 | EK-BIO | ML30970 | 本研究中用于测定小鼠心肌组织裂解液中由 SERPINE1 编码的蛋白 PAI-1 的水平。 |
| 小鼠 TGF-β2 ELISA 试剂盒 | ElaBoX | SEKM-0036 | 本研究中用于测定小鼠心肌组织裂解液中的 TGF-β2 水平。 |
| 小鼠 TLR-2 ELISA 试剂盒 | Solarbio | SEKM-0163 | 本研究中用于测定小鼠心肌组织裂解液中的 TLR-2 水平。 |
| 磷酸盐缓冲液(PBS),pH 7.4,无钙无镁 | Biological Industries | 02-024-1ACS | 无菌 1× 溶液;4 °C 保存;用于组织洗涤和稀释。 |
| R 软件包:caret | CRAN | 版本 6.0-94 | 用于支持向量机-递归特征消除分析。 |
| R 软件包:CellChat | CellChat 开发团队 | 版本 1.6.1 | 用于基于单细胞 RNA 测序数据推断细胞间通讯。 |
| R 软件包:clusterProfiler | Bioconductor | 版本 4.8.3 | 用于功能富集分析。 |
| R 软件包:ConsensusClusterPlus | Bioconductor | 版本 1.64.0 | 用于无监督一致性聚类分析。 |
| R 软件包:edgeR | Bioconductor | 版本 3.42.4 | 用于采用 M 值截尾均值法对 RNA 测序数据进行标准化。 |
| R 软件包:GEOquery | Bioconductor | 版本 2.68.0 | 用于从基因表达综合数据库(Gene Expression Omnibus)下载数据。 |
| R 软件包:glmnet | CRAN | 版本 4.1-8 | 用于最小绝对收缩与选择算子(LASSO)逻辑回归分析。 |
| R 软件包:limma | Bioconductor | 版本 3.56.2 | 用于差异表达分析与统计建模。 |
| R 软件包:pROC | CRAN | 版本 1.18.5 | 用于受试者工作特征(ROC)曲线分析。 |
| R 软件包:randomForest | CRAN | 版本 4.7-1.2 | 用于随机森林机器学习分析。 |
| R 软件包:Seurat | CRAN | 版本 5.0.1 | 用于单细胞 RNA 测序数据分析。 |
| R 软件包:SingleR | Bioconductor | 版本 2.2.0 | 用于自动细胞类型注释。 |
| R 软件包:sva | Bioconductor | 版本 3.48.0 | 用于 ComBat 批次效应校正。 |
| 冷冻离心机 | Sigma-Aldrich | SIGMA 3-K | 用于心肌组织裂解液的离心处理。 |
| RIPA 裂解与提取缓冲液 | Thermo Fisher Scientific | 89900 | 即用型 1× 溶液;4 °C 保存;使用前需添加蛋白酶和磷酸酶抑制剂。 |
| 小动物超声成像系统 | VINNO 科技有限公司 | VINN06LAB | 用于心脏功能的超声心动图评估。 |
| 戊巴比妥钠 | 国药集团化学试剂有限公司 | 20040428 | 配制成 1% 溶液(10 mg/mL)于无菌生理盐水中;以 30 mg/kg 剂量用于腹腔麻醉。 |
| STRING 数据库 | STRING 联盟 | 版本 11.5 | 用于构建蛋白质-蛋白质相互作用网络。 |
| TGrinder H24 组织匀浆器 | 天根生化科技有限公司 | OSE-TH-01 | 用于在 RIPA 缓冲液中以 6.0 m/s 的速度对小鼠心肌组织进行匀浆处理,持续 30–60 秒,重复 2–3 个循环。 |
| 恒温动物平台/小动物加热手术台 | 上海玉研科学仪器有限公司 | T-30350 | 用于在超声心动图检查期间维持小鼠体温在 37 °C;工作温度范围为室温至 50 °C。 |
参考文献
- Pinto YM et al. Proposal for a revised definition of dilated cardiomyopathy, hypokinetic non-dilated cardiomyopathy, and its implications for clinical practice: a position statement of the ESC working group on myocardial and pericardial diseases. Eur Heart J. 2016;37(23):1850-1858. https://doi.org/10.1093/eurheartj/ehv727
- Newman NA, Burke MA. Dilated Cardiomyopathy: A Genetic Journey from Past to Future. Int J Mol Sci. 2024;25(21):11460. https://doi.org/10.3390/ijms252111460
- Mishra B et al. Tumour necrosis factor-alpha promoter polymorphism and its association with viral dilated cardiomyopathy in Indian population: a pilot study. Indian J Med Microbiol. 2015;33(1):16–20. https://doi.org/10.4103/0255-0857.148368
- Frustaci A et al. Oxidative myocardial damage in human cocaine-related cardiomyopathy. Eur J Heart Fail. 2015;17(3):283-290. https://doi.org/10.1002/ejhf.219
- Ni B et al. The role of β-catenin in cardiac diseases. Front Pharmacol. 2023;14:1157043. https://doi.org/10.3389/fphar.2023.1157043
- Kuwahara K et al. TRPC6 fulfills a calcineurin signaling circuit during pathologic cardiac remodeling. J Clin Invest. 2006;116(12):3114-3126. https://doi.org/10.1172/JCI27702
- He SL et al. Mitochondrial-related gene expression profiles suggest an important role of PGC-1alpha in the compensatory mechanism of endemic dilated cardiomyopathy. Exp Cell Res. 2013;319(17):2604–2616. https://doi.org/10.1016/j.yexcr.2013.07.017
- Luczak ED et al. Mitochondrial CaMKII causes adverse metabolic reprogramming and dilated cardiomyopathy. Nat Commun. 2020;11(1):4416. https://doi.org/10.1038/s41467-020-18165-6
- Li E et al. BMAL1 regulates mitochondrial fission and mitophagy through mitochondrial protein BNIP3 and is critical in the development of dilated cardiomyopathy. Protein Cell. 2020;11(9):661–679. https://doi.org/10.1007/s13238-020-00713-1
- Alila-Fersi O et al. First description of a novel mitochondrial mutation in the MT-TI gene associated with multiple mitochondrial DNA deletion and depletion in family with severe dilated mitochondrial cardiomyopathy. Biochem Biophys Res Commun. 2018;497(4):1049-1054. https://doi.org/10.1016/j.bbrc.2018.02.162
- Ramaccini D et al. Mitochondrial Function and Dysfunction in Dilated Cardiomyopathy. Front Cell Dev Biol. 2020;8:624216. https://doi.org/10.3389/fcell.2020.624216
- Yang J et al. Stem cells in the treatment of myocardial injury-induced cardiomyopathy: mechanisms and efficient utilization strategies. Front Pharmacol. 2025;16:1600604. https://doi.org/10.3389/fphar.2025.1600604
- Van Linthout S et al. State of the art and perspectives of gene therapy in heart failure. A scientific statement of the Heart Failure Association of the ESC, the ESC Council on Cardiovascular Genomics and the ESC Working Group on Myocardial & Pericardial Diseases. Eur J Heart Fail. 2025;27(1):5–25. https://doi.org/10.1002/ejhf.3516
- Alimadadi A, Munroe PB, Joe B, Cheng X. Meta-Analysis of Dilated Cardiomyopathy Using Cardiac RNA-Seq Transcriptomic Datasets. Genes (Basel). 2020;11(1):60. https://doi.org/10.3390/genes11010060
- Verdonschot J et al. Clustering of Cardiac Transcriptome Profiles Reveals Unique Subgroups of Dilated Cardiomyopathy Patients. JACC Basic Transl Sci. 2023;8(4):406–418. https://doi.org/10.1016/j.jacbts.2022.10.007
- Zhu T et al. Identification and Verification of Feature Biomarkers Associated With Immune Cells in Dilated Cardiomyopathy by Bioinformatics Analysis. Front Genet. 2022;13:874544. https://doi.org/10.3389/fgene.2022.874544
- Li H et al. Identification of Centrosome Duplication-Related Biomarkers in Hypertrophic Cardiomyopathy Through Integrative Multi-Omics, Single-Cell Transcriptomics, and Experimental Validation. J Am Heart Assoc. 2026;15(12):e047416. https://doi.org/10.1161/JAHA.125.047416
- Ni L et al. Dissecting and validation the biomarker of heart failure progression in patients with atherosclerosis by single-cell sequencing, bioinformatics, and machine learning. Front Genet. 2025;16:1587274. https://doi.org/10.3389/fgene.2025.1587274
- Barrett T et al. NCBI GEO: archive for functional genomics data sets--update. Nucleic Acids Res. 2013;41(Database issue):D991–D995. https://doi.org/10.1093/nar/gks1193
- Davis S, Meltzer PS. GEOquery: a bridge between the Gene Expression Omnibus (GEO) and BioConductor. Bioinformatics. 2007;23(14):1846-1847. https://doi.org/10.1093/bioinformatics/btm254
- Irizarry RA et al. Exploration, normalization, and summaries of high density oligonucleotide array probe level data. Biostatistics. 2003;4(2):249-264. https://doi.org/10.1093/biostatistics/4.2.249
- Robinson MD, McCarthy DJ, Smyth GK. edgeR: a Bioconductor package for differential expression analysis of digital gene expression data. Bioinformatics. 2010;26(1):139–140. https://doi.org/10.1093/bioinformatics/btp616
- Leek JT et al. The sva package for removing batch effects and other unwanted variation in high-throughput experiments. Bioinformatics. 2012;28(6):882–883. https://doi.org/10.1093/bioinformatics/bts034
- Butler A et al. Integrating single-cell transcriptomic data across different conditions, technologies, and species. Nat Biotechnol. 2018;36(5):411-420. https://doi.org/10.1038/nbt.4096
- Korsunsky I et al. Fast, sensitive and accurate integration of single-cell data with Harmony. Nat Methods. 2019;16(12):1289-1296. https://doi.org/10.1038/s51592-019-0619-0
- Aran D et al. Reference-based analysis of lung single-cell sequencing reveals a transitional profibrotic macrophage. Nat Immunol. 2019;20(2):163-172. https://doi.org/10.1038/s41590-018-0276-y
- Ritchie ME et al. limma powers differential expression analyses for RNA-sequencing and microarray studies. Nucleic Acids Res. 2015;43(7):e47. https://doi.org/10.1093/nar/gkv007
- Barbie DA et al. Systematic RNA interference reveals that oncogenic KRAS-driven cancers require TBK1. Nature. 2009;462(7269):108-112. https://doi.org/10.1038/nature08460
- Yu G et al. clusterProfiler: an R package for comparing biological themes among gene clusters. OMICS. 2012;16(5):284-287. https://doi.org/10.1089/omi.2011.0118
- Szklarczyk D et al. STRING v11: protein-protein association networks with increased coverage, supporting functional discovery in genome-wide experimental datasets. Nucleic Acids Res. 2019;47(D1):D607–D613. https://doi.org/10.1093/nar/gky1131
- Shannon P et al. Cytoscape: a software environment for integrated models of biomolecular interaction networks. Genome Res. 2003;13(11):2498-2504. https://doi.org/10.1101/gr.1239303
- Chin CH et al. cytoHubba: identifying hub objects and sub-networks from complex interactome. BMC Syst Biol. 2014;8(Suppl 4):S11. https://doi.org/10.1186/1752-0509-8-S4-S11
- Bader GD, Hogue CW. An automated method for finding molecular complexes in large protein interaction networks. BMC Bioinformatics. 2003;4:2. https://doi.org/10.1186/1471-2105-4-2
- Friedman J, Hastie T, Tibshirani R. Regularization Paths for Generalized Linear Models via Coordinate Descent. J Stat Softw. 2010;33(1):1-22. https://doi.org/10.18637/jss.v033.i01
- Touw WG et al. Data mining in the Life Sciences with Random Forest: a walk in the park or lost in the jungle. Brief Bioinform. 2013;14(3):315-326. https://doi.org/10.1093/bib/bbs034
- Chicco D. Ten quick tips for machine learning in computational biology. BioData Min. 2017;10:35. https://doi.org/10.1186/s13040-017-0155-3
- Robin X et al. pROC: an open-source package for R and S+ to analyze and compare ROC curves. BMC Bioinformatics. 2011;12:77. https://doi.org/10.1186/1471-2105-12-77
- Lundberg SM et al. From Local Explanations to Global Understanding with Explainable AI for Trees. Nat Mach Intell. 2020;2(1):56-67. https://doi.org/10.1038/s42256-019-0138-9
- Jin S et al. Inference and analysis of cell-cell communication using CellChat. Nat Commun. 2021;12(1):1088. https://doi.org/10.1038/s41467-021-21246-9
- Charoentong P et al. Pan-cancer Immunogenomic Analyses Reveal Genotype-Immunophenotype Relationships and Predictors of Response to Checkpoint Blockade. Cell Rep. 2017;18(1):248–262. https://doi.org/10.1016/j.celrep.2016.12.019
- Wilkerson MD, Hayes DN. ConsensusClusterPlus: a class discovery tool with confidence assessments and item tracking. Bioinformatics. 2010;26(12):1572–1573. https://doi.org/10.1093/bioinformatics/btq170
- Hänzelmann S, Castelo R, Guinney J. GSVA: gene set variation analysis for microarray and RNA-seq data. BMC Bioinformatics. 2013;14:7. https://doi.org/10.1186/1471-2105-14-7
- Zheng Y et al. Exploring Key Genes to Construct a Diagnosis Model of Dilated Cardiomyopathy. Front Cardiovasc Med. 2022;9:865096. https://doi.org/10.3389/fcvm.2022.865096
- Johnson WE, Li C, Rabinovic A. Adjusting batch effects in microarray expression data using empirical Bayes methods. Biostatistics. 2007;8(1):118-127. https://doi.org/10.1093/biostatistics/kxj037
- Koslow M, Mondaca-Ruff D, Xu X. Transcriptome studies of inherited dilated cardiomyopathies. Mamm Genome. 2023;34(2):312-322. https://doi.org/10.1007/s00335-023-09978-z
- Zhang B, Horvath S. A general framework for weighted gene co-expression network analysis. Stat Appl Genet Mol Biol. 2005;4:Article17. https://doi.org/10.2202/1544-6115.1128
- Lin M et al. Machine learning and multi-omics integration: advancing cardiovascular translational research and clinical practice. J Transl Med. 2025;23(1):388. https://doi.org/10.1186/s12967-025-06425-2
- Climente-González H et al. Interpretable machine learning leverages proteomics to improve cardiovascular disease risk prediction and biomarker identification. Commun Med (Lond). 2025;5(1):170. https://doi.org/10.1038/s43856-025-00872-0
- Shah P et al. Predicting cardiovascular risk with hybrid ensemble learning and explainable AI. Sci Rep. 2025;15(1):17927. https://doi.org/10.1038/s41598-025-01650-7
- Chaffin M et al. Single-nucleus profiling of human dilated and hypertrophic cardiomyopathy. Nature. 2022;608(7921):174-180. https://doi.org/10.1038/s41586-022-04817-8
- Juan F et al. The changes of the cardiac structure and function in cTnTR141W transgenic mice. Int J Cardiol. 2008;128(1):83-90. https://doi.org/10.1016/j.ijcard.2008.03.006
- Russell-Hallinan A et al. Single-Cell RNA Sequencing Reveals Cardiac Fibroblast-Specific Transcriptomic Changes in Dilated Cardiomyopathy. Cells. 2024;13(9):752. https://doi.org/10.3390/cells13090752
- Knowlton KU. Dilated Cardiomyopathy. Circulation. 2019;139(20):2339-2341. https://doi.org/10.1161/CIRCULATIONAHA.119.040037
- Smith GD, Ebrahim S. Mendelian randomization: prospects, potentials, and limitations. Int J Epidemiol. 2004;33(1):30-42. https://doi.org/10.1093/ije/dyh132
- Chen R et al. Macrophages in cardiovascular diseases: molecular mechanisms and therapeutic targets. Signal Transduct Target Ther. 2024;9(1):130. https://doi.org/10.1038/s41392-024-01840-1
- Liu R et al. Tead1 is essential for mitochondrial function in cardiomyocytes. Am J Physiol Heart Circ Physiol. 2020;319(1):H89-H99. https://doi.org/10.1152/ajpheart.00732.2019
- Sharma S et al. SOD2 deficiency in cardiomyocytes defines defective mitochondrial bioenergetics as a cause of lethal dilated cardiomyopathy. Redox Biol. 2020;37:101740. https://doi.org/10.1016/j.redox.2020.101740