本研究提出了RareCode,一种无监督深度学习框架,通过分析码本激活稀有性(CAR)来检测结直肠癌组织病理学图像中的异常,有望在无需标注训练数据的情况下辅助预筛。
本文内容
摘要
摘要
基于重建的方法通过测量重建误差,在组织病理学图像的无监督异常检测中已得到广泛研究,但由于组织纹理固有的异质性,这些方法往往难以捕捉细微的语义层面病理变化。为克服这一局限,本研究提出 RareCode,一种基于向量量化的框架,将检测范式从像素级重建扩展至语义级码本激活分析。其核心创新在于码本激活稀有性(Codebook Activation Rarity, CAR)评分:在仅使用正常样本进行训练时,统计每个码本条目的激活频率,并在推理阶段将低频激活标记为异常指示,从而在重建误差之外引入语义层面的判别能力。在此单尺度 CAR 机制基础上,进一步引入多尺度分层码本(Multi-scale Hierarchical Codebook, MHC)模块,采用不同尺寸的码本并结合可学习的融合权重,以捕捉从粗粒度组织级结构到细粒度细胞级细节的跨尺度病理模式。依托该多尺度设计,系统在每个码本粒度上生成分层异常热图,为病理医生提供可解释的、多维度的视觉定位线索,明确指示异常发生的位置及其所在的结构层级。在深圳人民医院获取的临床标注结直肠癌组织病理图像数据集上进行的五折交叉验证表明,RareCode 的曲线下面积(AUC)达到 96.82%,优于基线方法。按类别分析显示,癌症检测性能更优(AUC = 99.44%,特异性 = 94.21%),优于炎症检测(AUC = 94.30%,特异性 = 60.44%)。这些结果表明,CAR 分析可能为组织病理学异常检测提供一种有前景的无监督方法,有望辅助结直肠癌诊断中的临床预筛。
引言
结直肠癌的可靠组织病理学筛查仍受限于专家标注和人工复核,尤其是在炎性病变与恶性肿瘤形态重叠的情况下1,2。这些限制促使人们发展无需大量异常标注、能够从正常组织中自主学习的无监督计算方法3,4。
自动组织病理学筛查的临床紧迫性日益凸显,这源于诊断需求与现有病理学专业人员之间的差距不断加大;在过去十年中,每位美国病理学家的诊断工作量增加了超过40%,而病理学家队伍却持续萎缩5。在结直肠癌(CRC)领域,有组织的筛查项目已与29-68%的死亡率下降相关6,但人工病理学复核的能力仍受限于专业人员的可及性。一种能够可靠识别可疑病例以供优先复核的自动化预筛查系统,有望减轻这一负担并改善诊断周转时间。然而,此类系统的部署既需要高灵敏度以避免漏诊真阳性病例,也需要足够的特异性以防止产生过多的假阳性警报7。
无监督异常检测(UAD)在医学图像分析中日益重要8,因为它能够在无需异常训练标签的情况下对正常组织分布进行建模3,9,10。基于重建的模型,包括自编码器、变分自编码器、生成对抗网络以及记忆增强型变体,通过重建误差来识别异常,但高容量的解码器仍可能以高保真度重建异常区域11,12,13,14,15,16,17。基于特征的方法(如 PatchCore 和 PaDiM)使用预训练表示,但从自然图像中学习到的特征可能无法充分捕捉组织病理学中的微观非典型性18,19,20,21。病理学特异性基础模型和基于扩散的异常检测器提供了强大的替代方案,但其数据需求或计算成本可能限制其在高通量筛查中的直接应用22,23。近期的自动化与进化方法,如 EvoAAE24 和 MoARNN-AM25,进一步体现了自适应模型优化在异常检测中的价值,尽管其应用背景不同于组织病理图像分析。相比之下,基于向量量化(VQ)的方法施加了离散码本约束,可减少恒等映射;然而,现有的基于 VQ 的方法仍主要依赖空间重建误差,未能充分利用码本激活模式中蕴含的语义信息26,27。
尽管上述方法在通用领域中表现出良好的性能,但将其应用于复杂的组织病理学场景时仍面临特定挑战。组织病理学图像在多个结构层面上表现出复杂的组织异质性28。在实际应用中,图像分析通常基于从组织切片中提取的局部图像区域进行,而病理诊断本质上具有跨尺度特性:病理医师在低倍镜下评估腺体和组织形态,同时在高倍镜下观察核多形性和有丝分裂象29。我们总结了当前方法的三个关键局限性:第一,病理异常区域与正常组织在染色模式和局部纹理等低级视觉特征上具有高度相似性,导致基于重建的方法难以检测细微异常,因为正常样本与异常样本在语义层面可能产生相似的重建质量;第二,大多数现有方法采用单尺度特征提取,难以同时捕捉组织层面和细胞层面的异常特征30,31;第三,尽管主流方法能够生成像素级热图,但往往无法直观反映异常的层次结构属性,限制了此类模型作为临床诊断辅助工具的实用性。
为应对上述挑战,我们提出 RareCode 框架,一种无监督异常检测(UAD)方法,通过探索码本激活模式及多层次抽象级别的分层特征表示来实现异常识别。该框架包含三个主要组成部分:(1)码本激活稀有性(CAR)评分机制,该机制基于仅在正常样本上训练得到的码本条目激活频率计算稀有性得分,能够在语义层面区分正常与异常样本,并为传统的空间重建误差提供互补的判别信号。(2)多尺度分层码本(MHC)融合架构,通过采用具有不同容量的码本,捕捉从粗粒度结构模式到细粒度细胞细节等多粒度级别的病理特征,并通过可学习权重实现自适应融合。(3)分层可解释定位模块,利用多尺度架构生成不同粒度级别的异常热图,为病理医师提供多尺度、语义上可解释的诊断参考。
本研究的主要假设是:仅基于正常结直肠组织病理学图像训练所得的码本,其激活频率谱能够编码超出像素级重建误差的异常相关语义信息,并且通过多尺度整合这些互补信号,相较于代表性无监督异常检测(UAD)方法,可更有效地区分包含癌变或炎性组织的图像与正常图像,主要通过AUC指标进行评估。为验证该假设,我们在一个临床标注的结直肠癌(CRC)数据集上采用5折交叉验证评估了RareCode方法,并进行了消融实验与定位分析,以探究其核心组件的贡献及其可解释性。
方案
本研究经深圳市人民医院临床研究伦理委员会批准。'医院(批准号:LL-KY-2025300-01)。由于此项回顾性研究使用的是既有的组织病理学图像和临床材料,未与患者直接接触或进行干预,伦理委员会豁免了知情同意要求。所有临床数据和组织病理学图像在分析前均已进行去标识化处理,本研究未使用任何个人身份信息。本研究中使用的所有数据均按照机构和国家研究委员会的伦理标准进行处理。
框架概述
所提出的异常检测框架 RareCode 的整体架构如图所示 图 1该框架采用并行双分支架构。对于每幅512 x 512输入图像,分别提取非重叠的32 x 32和64 x 64图像块作为细尺度和粗尺度输入。64 x 64图像块在送入网络前被调整为32 x 32,从而使两个分支共享相同的编码器-解码器输入尺寸,同时保留不同的感受野。每个分支中的编码器将提取的特征映射到潜在空间,在此MHC模块施加离散化约束。随后,解码器从量化后的特征重建图像,以计算空间域重建误差。接着,CAR机制通过分析码书激活频率来度量语义级异常程度。最后,模型通过加权融合重建分数与CAR分数,得到图像级异常分数。RareCode框架仅使用正常样本进行端到端训练,无需异常标注。双分支设计旨在同时捕获局部细胞特征和更广泛的腺体结构。MHC模块则用于通过不同容量的码书对这些特征进行建模。
编码器-解码器架构
RareCode 为精细尺度分支与粗尺度分支构建了结构独立的编码器和解码器。每个分支采用相同的编码器-解码器设计,但不共享参数。编码器由四个卷积块组成,每个块包含一个 3 x 3 卷积、批量归一化、ReLU 激活函数和丢弃层。通道宽度从 64 增至 128,再增至 256,最终的特征图被展平并投影至一个 64 维的潜在嵌入空间。解码器与编码器结构对称,包含一个全连接投影层和四个转置卷积层,将每个图像块重建至网络的原始输入尺寸。重建误差通过计算输入图像块与重建图像块之间的均方误差得出。通过将此编码器-解码器结构与离散码本约束相结合,RareCode 学习正常组织的紧凑表示,并在推理过程中度量其偏离程度。
多尺度分层码本
为在多个抽象层次上捕捉病理学特征—从广泛的组织模式到局部的细胞变异—MHC模块采用K个离散码本  具有不同容量 n1, n2, ..., nK在最终的四尺度配置中,每个分支分别包含四个码本,其条目数依次为64、128、256和512,每个码本条目具有一个64维嵌入。对于每个编码后的图像块特征,根据欧氏距离选择最近的码本条目。随后,使用跨码本归一化的可学习权重对不同码本的量化输出进行融合。由于压缩约束更强,较小的码本预期编码粗粒度的原型模式,这些模式抽象掉了局部变化;而较大的码本则保留更细粒度的特征,以捕捉更具体的结构特性。对于每个码本
 ,其中 ek(i)
 Rd 表示第k个码本中的第i个嵌入向量,连续特征通过最近邻查找映射至离散码本空间(公式1和2):
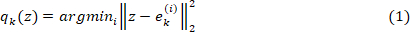

为实现多尺度特征的自适应融合,我们引入了可学习的权重。经 softmax 归一化后,对各码本的量化输出进行加权求和(公式 3):
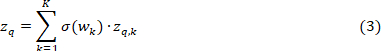
其中 σ(·) 表示 softmax 函数,确保权重满足 Σk σ(wk) = 1。该设计使模型能够根据输入特征的语义内容,自动调整不同粒度码本的贡献比例。
为优化码本学习,我们采用标准向量量化损失函数(公式4):
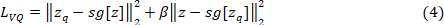
其中 sg·] 表示停止梯度操作, β = 0.25 为承诺损失权重系数。第一项鼓励码本向量向编码器输出移动,而第二项则鼓励编码器输出与其对应的码本向量保持一致。多尺度 VQ 的完整机制如下图所示: 图 2.
代码本激活稀有性评分
CAR通过基于正常训练样本估计的码本激活统计量来检测语义层面的异常。模型训练完成后,所有正常训练图像在不进行数据增强的情况下通过编码器和MHC模块进行处理。对于每个分支和每个码本,记录每个图像块特征的分配索引,并统计每个码本条目被分配的次数。随后对这些计数进行归一化处理,以获得该码本的激活频率分布(公式5):

在推理阶段,每张测试图像均经过相同的图块提取、编码及最近邻码本分配流程处理。对于每个被分配的码本条目,其稀有性评分通过计算其在正常训练集中激活频率的负对数得出(公式6):

何处 ε ε是一个用于维持数值稳定性的小常数。因此,低频码本条目会获得较高的稀有性评分,这表明对应的图像块特征与学习到的正常组织分布一致性较低。将每个图像内部以及细尺度与粗尺度分支间的图像块级稀有性评分进行平均,即可得到图像级的稀有性响应。
为补充激活频率的稀有性,我们还计算了基于百分位数的量化距离分数(公式7):
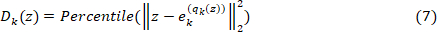
该分数源自每个编码特征向量与其最近码本条目之间的欧几里得距离。距离分布通过正常训练样本进行估算,测试样本距离则转换为百分位数分数。百分位数分数越大,表明该编码特征越难以使用已习得的正常码本原型进行表征。
最终的CAR分数通过可学习的码本权重,结合了所有码本中的激活稀有性与量化距离(公式8):
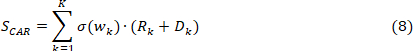
用于多尺度特征融合的同一归一化码本权重被应用于分数级融合,以保持表征学习与异常评分之间的一致性。由此得到的CAR分数在图像级别计算,随后与重建分数结合,以获取最终的异常分数。整体的CAR评分机制如图所示 图 3.
最终异常值计算
我们将空间域重建误差与语义级CAR分数相融合。在融合前,两种分数均采用基于百分位数的最大-最小归一化法分别进行归一化处理,以降低极端异常值的影响。最终图像级异常分数定义为(公式9):
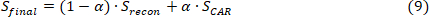
何处 S重构 表示归一化均方重建误差,反映了像素空间中的样本重建质量; SCAR 是上文所述的CAR分数,用于捕捉语义层面异常的程度。超参数 α [0,1] 控制着两个组成部分之间的相对权重,其最优值在验证集上确定。
培训目标
RareCode框架仅使用正常样本进行端到端训练。其总训练损失由以下部分组成(公式10):

每个术语的定义如下:重建损失: 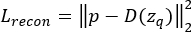 ,测量输入图像块之间的均方误差 p 以及重建的斑块 D(zq) 量化后。该损失函数分别应用于32 × 32 补丁分支
 ) 和 64 × 64 个斑片分支
 ) 以确保在两个空间尺度上有效学习特征。
数据集描述
为评估RareCode,我们在一个经临床标注的结直肠癌组织病理学图像数据集上进行了实验。该数据集包含经苏木精-伊红(H&E)染色的结直肠组织切片图像。&E),购自深圳市人民医院's医院。本数据集中的所有图像均源自真实临床病例。图像以40倍放大倍率数字化采集,原始分辨率为1024。 × 1024像素。为确保标注的可靠性与质量,所有样本类别标签均遵循双盲原则,由两位或以上资深专业病理学家共同审核并确认。
根据组织病理学特征,该数据集被分为三类:正常组织(1,226张图像)、癌症(1,215张图像)和炎症(1,214张图像)。在二元异常检测设置中,癌症和炎症样本被视为异常,而正常样本则作为参考分布。这种设定反映了预期的分诊任务,即将需要进一步病理学检查的病例与形态学正常的病例区分开来。
所有 H&E 染色图像被调整为 512 × 512 像素,然后用作网络输入。采用分层 5 折交叉验证进行评估。在每一折中,首先将正常样本划分为训练集、验证集和保留测试集。RareCode 仅使用训练集中的正常样本进行训练。同样仅包含正常样本的验证集用于模型选择、超参数调优以及融合权重的选择。 α. 仅用于最终性能评估的留出测试集包含未见过的正常样本以及癌症和炎症等异常样本,该测试集未用于模型训练、超参数选择或 α 筛选。代表性类别、数据集结构及验证方案如下所示 图 4.
实施细节
所提出的 RareCode 框架及对比基线均使用 PyTorch 实现。所有实验均在一台配备单块 NVIDIA GeForce RTX 4060 Ti GPU(16 GB)的工作站上进行。在网络架构配置方面,为捕捉不同空间范围的特征,双分支架构以两种尺度处理非重叠图像块:32 × 32 像素(较小的感受野,捕获局部纹理模式)和 64 × 64像素(感受野更大,能捕捉更广泛的空间上下文信息)。两个分支编码器产生的连续特征嵌入维度统一设置为64。在MHC模块中,我们为每个分支配置了四个不同容量的码本,其离散原型数量分别为64、128、256和512。
在优化过程中,该网络以批次大小为8进行了50轮端到端训练。我们采用AdamW优化器进行权重更新,初始学习率设为5。 × 并采用权重衰减以防止过拟合。此外,为确保训练收敛平稳,使用了余弦退火学习率调度策略,从而在训练后期实现更精细的优化。选择补丁尺寸和码本尺寸以平衡多尺度表征与计算成本。最终的 FourScales 配置得到了消融分析的支持,并且 α 该模型在测试集评估前已在验证集上完成筛选。
在解码器复杂度消融实验中,基于 FourScales 配置实现了一个复杂解码器变体。该变体使用了相同的数据划分、码本大小、训练轮次、优化器、学习率以及基于验证的 α 选择、评估指标均与FourScales模型保持一致。基础解码器被替换为包含多尺度深度可分离卷积块和卷积块注意力模块(CBAM)的EMCAD风格解码器。在前三个转置卷积上采样阶段中的每一阶段之后,均并行添加3 × 3, 5 × 5、7 × 应用了 7 次深度卷积,随后进行 1 次 × 逐点融合、批量归一化、ReLU激活、残差连接以及CBAM注意力机制。CBAM包含基于平均池化和最大池化描述符的通道注意力,以及使用7×7卷积核的空间注意力。 × 7 次卷积。最终阶段使用转置卷积和 sigmoid 激活函数来重建 32 × 32 个斑片。
结果
与基线方法比较
为评估 RareCode 框架,我们选取了多种代表性无监督异常检测方法作为基线,涵盖基于重构的方法(如 CAE32, 变分自编码器12, 严重不良事件33, 平均绝对误差34, PatchSAE35),记忆增强重建(MemAE36),知识蒸馏(STFPM37),合成异常生成(DRAEM38)以及预训练特征提取(PatchCore18基准方法的选择侧重于那些可在可比计算资源和数据假设下(仅能访问未标记的正常训练样本)进行训练或应用的方法,从而确保性能差异反映的是方法学贡献,而非预训练数据规模的差异。为确保公平比较,所有方法均使用相同的五折数据划分、预处理流程、评估指标和计算环境进行评估。模型在相同的无监督异常检测协议下,仅使用正常训练样本进行训练,超参数和阈值在验证集上选定,最终性能仅在预留的测试集上进行评估。 表 1 总结了5折交叉验证结果,并 图 5 提供多维度雷达图对比分析。
如图所示, 表 1 以及 图 5RareCode 在结直肠癌数据集上实现了良好的检测性能与统计稳定性。就 AUC 而言,RareCode 达到了 96.82 ± 0.23%)的表现优于多种基于重建的基线模型,包括记忆增强自编码器(94.97%)。 ± 0.81%)。统计分析证实,RareCode 在所有基于重建的基线方法中表现更优(配对 t 检验, p < 0.05),且其改善效果相较于 MemAE 达到了统计学显著性。 (p < 0.01)。RareCode 表现出较低的性能方差(标准差为 0.23%),表明其具有稳定的交叉折叠一致性。基于合成异常的 DRAEM 方法效果有限,这可能反映了简单的纹理叠加策略无法充分模拟复杂的病理异型性。
关于特异性,RareCode 达到了 58.24 ± 5.99%,在降低假阳性率方面优于所有对比方法。这相较于仅重建的基线方法(NoCAR,33.76%)实现了约25个百分点的提升,充分证明了CAR机制的有效性。'其有助于降低假阳性率。STFPM 与 PatchCore 的特异性较低,这可能部分反映了自然图像与组织病理学图像之间的领域差异,因为这两种方法都依赖于自然图像预训练特征。值得注意的是,STFPM 与 DRAEM 表现出较高的特异性方差(±33.53% 与 ±7.09%),其每折特异性范围从接近零到中等水平不等,这引发了对其部署可靠性的担忧。
按类别检测性能
按类别分析通过分别比较癌症样本和炎症样本与正常样本进行。表 2)。RareCode 在癌症检测方面实现了更高的性能(AUC = 99.44 ± 0.12%,召回率 = 98.13 ± 0.29%,特异性 = 94.21 ± 2.22%)高于炎症检测(AUC = 94.30 ± 0.44%,召回率 = 96.55% ± 0.78%,特异性 = 60.44 ± 4.34%)。这些结果表明,RareCode 对恶性异常可能显示出比炎性变化更强的鉴别能力,而炎症-正常边界似乎对整体特异性降低有显著贡献。
消融研究
为探究 RareCode 框架中关键组件的贡献,我们进行了消融实验,以评估 CAR 机制和 MHC 模块对检测性能的影响。结果详述如下: 表 3如图所示, 图 6A在仅重建基线模型基础上加入CAR,将AUC从92.81%提升至95.92%,而多尺度码本融合进一步将AUC提高至96.82%。 图 6B 结果表明,代码本激活稀有性(CAR)也提升了特异性,使其从无CAR基线模型的33.76%提高至完整四尺度(FourScales)模型的58.24%。这些结果支持了代码本激活稀有性与多尺度融合的互补价值。
此外,还使用 FourScales 配置进行了解码器复杂度消融实验。如图所示, 表 3采用多尺度深度卷积模块与卷积块注意力模块(CBAM)的复杂解码器变体,其曲线下面积(AUC)低于基础四尺度模型(95.17%)。 ± 0.44% 对比 96.82% ± 0.23%)。这一结果表明,在当前基于VQ-AE的RareCode设置中,增加解码器容量并未提升异常检测性能,反而可能削弱码本约束表示的有效性。
分层空间响应分析
为评估 RareCode 生成的空间响应,将图像块级别的重建误差与码本稀有度图在图像层面进行聚合,并在正常样本与异常样本之间进行比较。能量比、Cohen's d 和 AUC 用于量化图像层面的响应分离度。详细结果如下: 表 4 以及 图 7 以及 图 8.
结果表明,所有尺度的码本稀缺性评分在异常样本上均表现出响应升高(能量比)。 > 1). 容量较小的码本(Codebook 64)实现了更强的定位级判别能力(78.79% AUC),这与预期一致:更高的压缩率会促使模型学习更抽象的原型模式,这些模式对偏离正常组织原型的异常情况更为敏感。仅重建误差本身就提供了强大的异常捕获能力(93.31% AUC),而CAR分数则从语义频率维度提供了补充信号。
定性检查 图 7 研究显示,癌症样本中升高的反应信号与不规则且密集的腺体、细胞核增大、深染、假复层结构以及上皮极性丧失等区域重叠。在炎症样本中,更强的反应信号出现在扭曲的隐窝周围及密集的炎性细胞浸润区域。较低容量的编码本倾向于捕捉更广泛的组织结构异常,而较高容量的编码本则产生更局部的细胞水平反应信号。这些发现提供了定性的形态学解释,但未进行像素水平的验证。
融合参数分析
融合权重 α 平衡空间重建误差与CAR评分对最终异常评分的贡献。最优 α 各折叠的数值通过在验证集上进行网格搜索(步长 0.05)确定,结果展示于 表 5 以及 图 9最佳 α 数值主要集中在0.85-0.95范围内,平均值为0.90。 ± 0.05。在最优配置下,该模型的平均AUC达到96.82 ± 在测试集上为 0.23%。较高的最优权重(约 0.90)表明,CAR 分数对最终检测的贡献大于重构误差,而重构误差则提供辅助性的局部约束。与 α 在敏感性分析中,当设置 = 0 时(AUC = 93.29%),经验证选择的融合设置将 AUC 提升了约 3.53 个百分点。
本研究提出了用于组织病理学图像无监督异常检测的RareCode框架,旨在缓解传统生成模型所遭遇的恒等映射问题。CAR机制降低了对像素级重建误差的过度依赖,而MHC模块则提供了多粒度层次化特征表示,实现了不同抽象层面的互补性异常判别。在CRC数据集上的实验表明,RareCode实现了96.82%的AUC,分类型分析显示其能有效检测癌症(AUC = 99.44%),且对癌症的判别力强于炎症,这表明炎症-正常组织重叠仍是主要挑战。消融研究证实,整合来自VQ的离散语义特征与多尺度组织形态学表征可提升检测性能。'其高召回率(98.40%)与中等特异性(58.24%)表明,该工具具备作为预筛工具、用于优先处理可疑组织病理学图像的潜力;然而,其对病理医生工作量的实际影响,仍需通过前瞻性工作流程评估来验证。
数据可用性:
本研究所使用的 CRC 组织病理学图像数据集来自深圳市人民医院。's医院在机构伦理批准下进行(批准号:LL-KY-2025300-01)。由于患者隐私和机构数据共享政策,该数据集不公开。经合理请求并征得通讯作者同意,在获得机构批准和数据使用协议的前提下,可授予访问权限。RareCode框架的源代码已在https://github.com/XL-alg/RareCode公开提供。
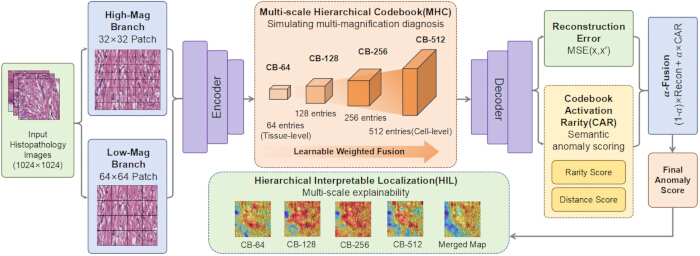
图 1RareCode 框架的整体架构与数据流。 512 × 512 H&E 染色组织病理学图像被分割为不重叠的 32 × 32 与 64 × 64个斑块作为精细与粗尺度输入。两个分支将斑块编码为潜在嵌入,应用多尺度分层码本(MHC)进行离散化,并重建斑块以计算重建误差分数。同时,码本激活稀有性(CAR)机制根据从正常训练样本中学习到的码本激活频率分布来估计语义稀有性。随后,归一化的重建分数与CAR分数融合,生成最终的图像级异常分数,而斑块级响应则被投影回图像平面,用于分层定位。 请点击此处查看此图的放大版本。
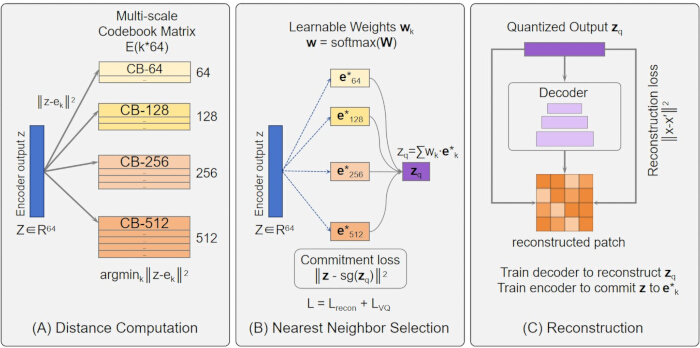
图 2多尺度矢量量化机制。 (A) 编码器输出特征与码本嵌入向量之间的距离计算。B) 在容量为64、128、256和512的码本中进行最近邻选择与加权融合。C) 通过转置卷积解码器从量化特征进行重建。 请点击此处查看此图的放大版本。
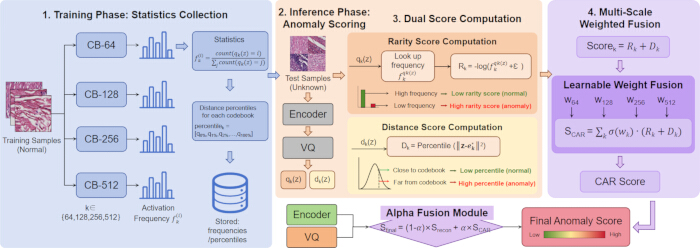
图 3CAR 评分机制。 本图展示了四个阶段:第一阶段:激活频率统计仅基于正常训练样本计算。第二阶段:测试样本通过编码器和向量量化获得激活索引与距离。第三阶段:根据训练集频率分布计算稀有性分数与距离分数。第四阶段:各码本尺度的分数通过可学习权重融合,生成最终的CAR分数。 请点击此处查看此图的放大版本。
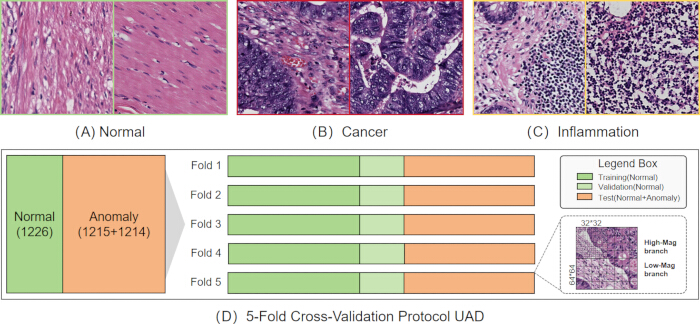
图 4CRC数据集构成与实验方案。 (A–C) 代表性 H&正常结直肠组织、结直肠癌和结直肠炎症的E染色组织病理学图像。D) 针对UAD的五折交叉验证方案,其中正常样本用于训练与验证,而预留的正常样本与异常样本则用于测试。图像以40倍放大倍率进行数字化处理,并分割为32 x 32及64 x 64的图像块。绿色、浅绿色与橙色分别代表训练集、验证集与测试集。 请点击此处查看此图的放大版本。
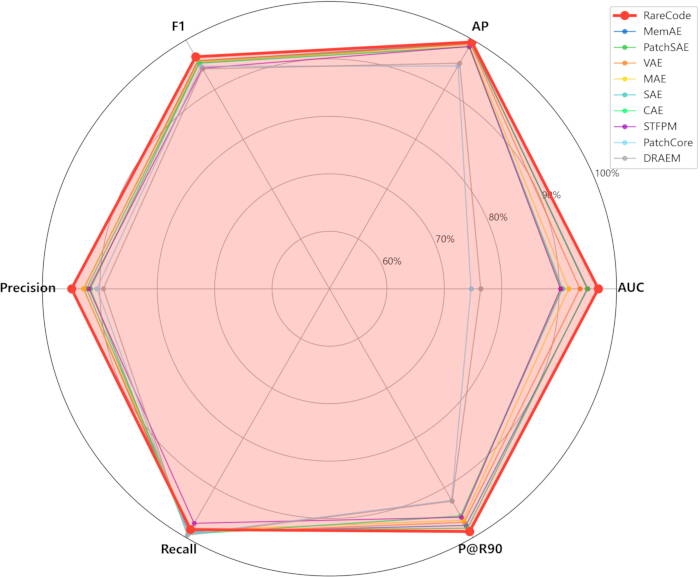
图 5异常检测方法的多指标对比雷达图。 雷达图对比了RareCode与基线方法在AUC、平均精度(AP)、F1分数、精确率、召回率以及90%召回率下的精确率(P@R90)上的表现。所有数值均代表5折交叉验证的平均性能。 请点击此处查看此图的放大版本。
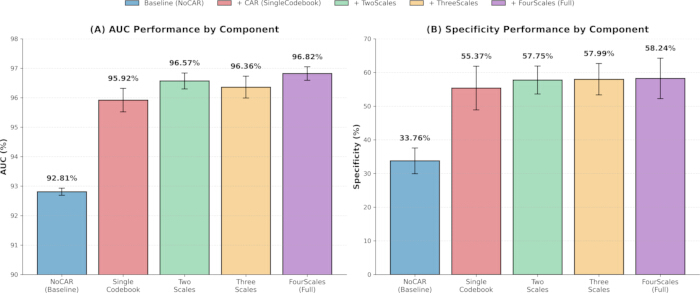
图 6消融研究各组成部分的增量贡献分析。 (A) AUC性能对比显示,从仅重构基线(NoCAR)到单码本再到多尺度配置的渐进式改进。B) 特异性性能比较展示CAR机制'对降低假阳性率的影响。所有误差棒均代表五次交叉验证的标准差(SD)。 请点击此处查看此图的放大版本。
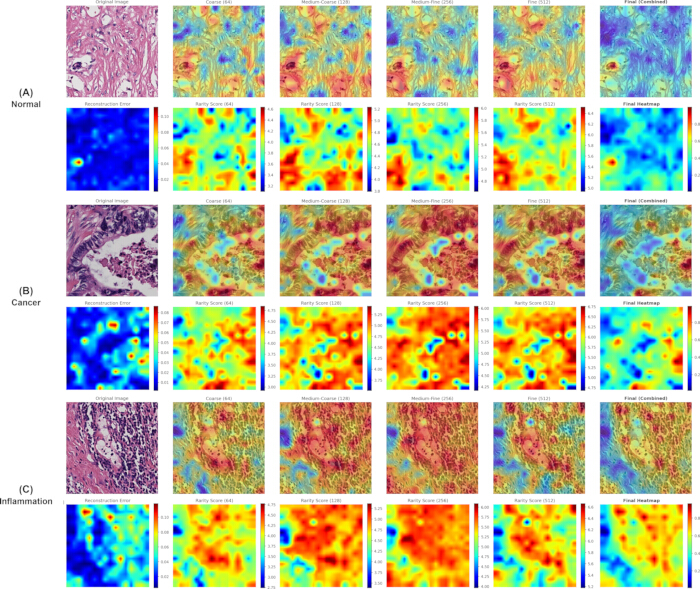
图 7多尺度码本分层定位热图。 代表性示例如下: (A) 正常 (B) 癌症, (C) 炎症样本。每行包含原始图像、叠加图、重建误差图、不同容量(64、128、256和512)码本生成的稀有性评分图,以及最终的融合定位图。较小容量的码本通过更强的压缩抽象突出粗粒度模式,而较大容量的码本则保留更精细的结构细节。高响应区域在性质上与癌症或炎症相关的组织病理学特征相对应,但未经像素级专家标注验证。 请点击此处查看此图的放大版本。
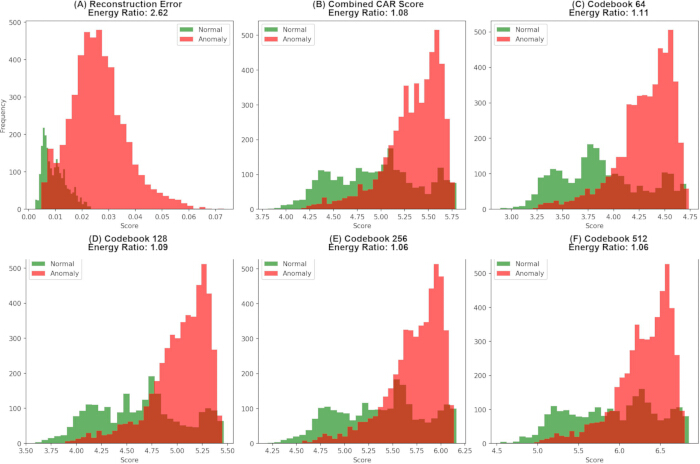
图 8不同评分类型的分布直方图。 直方图比较了正常样本与异常样本之间的评分分布 (A) 重建误差 (B) 联合CAR评分, (C) Codebook 64 (D) 代码本 128, (E) Codebook 256,以及 (F) Codebook 512。绿色与红色直方图分别指示正常样本与异常样本。 请点击此处查看此图的放大版本。
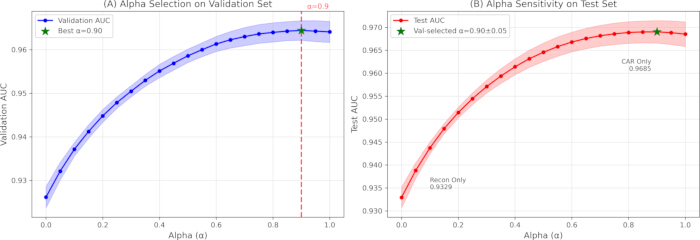
图 9Alpha 参数敏感性分析。 (A) 验证集 AUC 用于 α 筛选。 (B) 不同条件下的测试集AUC α 数值。经验证筛选的 α 数值范围在0.85至0.95之间,平均值为0.90。 ± 0.05,与表5一致。AUC变化始终低于0.5%,当 α 该值在 [0.70, 1.00] 范围内变化,表明其在较宽的参数范围内性能稳定。 请点击此处查看此图的放大版本。
| 方法 | AUC (%) | AP (%) | F1 (%) | 精密度 (%) | 召回率 (%) | 特异性 (%) | P@R90 (%) |
| CAE | 90.37 ± 0.94 | 98.62 ± 0.18 | 95.34 ± 0.15 | 91.64 ± 0.40 | 99.35 ± 0.22 | 28.14 ± 3.88 | 95.66 ± 0.32 |
| SAE | 90.58 ± 0.94 | 98.66 ± 0.18 | 95.34 ± 0.15 | 91.67 ± 0.40 | 99.32 ± 0.24 | 28.46 ± 3.97 | 95.71 ± 0.30 |
| 变分自编码器 | 93.60 ± 0.82 | 99.13 ± 0.12 | 95.86 ± 0.19 | 92.81 ± 0.49 | 99.12 ± 0.29 | 39.07 ± 4.70 | 96.94 ± 0.43 |
| 微量分析工程 | 91.65 ± 2.75 | 98.76 ± 0.50 | 95.61 ± 0.60 | 92.87 ± 1.56 | 98.55 ± 0.55 | 39.74 ± 14.32 | 96.55 ± 0.97 |
| MemAE | 94.97 ± 0.81 | 99.35 ± 0.11 | 95.78 ± 0.33 | 92.82 ± 1.07 | 98.95 ± 0.60 | 39.15 ± 9.99 | 97.57 ± 0.33 |
| PatchSAE | 94.86 ± 0.36 | 99.34 ± 0.05 | 95.39 ± 0.13 | 92.32 ± 0.27 | 98.67 ± 0.12 | 34.91 ± 2.57 | 98.13 ± 0.24 |
| STFPM | 90.23 ± 3.05 | 98.70 ± 0.44 | 94.32 ± 0.21 | 91.90 ± 3.51 | 97.14 ± 3.38 | 29.82 ± 33.53 | 95.93 ± 1.96 |
| DRAEM | 76.34 ± 2.82 | 95.34 ± 0.90 | 94.19 ± 0.07 | 89.39 ± 0.65 | 99.56 ± 0.65 | 6.19 ± 7.09 | 92.69 ± 0.57 |
| PatchCore | 74.64 ± 1.82 | 94.76 ± 0.55 | 94.73 ± 0.05 | 90.52 ± 0.15 | 99.36 ± 0.12 | 17.49 ± 1.54 | 92.54 ± 0.15 |
| RareCode | 96.82 ± 0.23 | 99.59 ± 0.03 | 96.63 ± 0.15 | 94.93 ± 0.67 | 98.40 ± 0.48 | 58.24 ± 5.99 | 98.80 ± 0.10 |
表1:与基线方法的比较结果(5折交叉验证)。 RareCode 与九种基准 UAD 方法在 CRC 数据集上的检测性能。评估指标包括 AUC、平均精度 (AP)、召回率、特异性、F1 分数、90% 召回率下的精确度 (P@R90) 以及精确度。所有数值均为平均值。 ± 五次交叉验证的标准差。**粗体**数值表示各指标的最佳性能。
| 类别 | AUC (%) | AP (%) | F1 (%) | 召回率 (%) | 特异性(%) |
| 癌症 | 99.44 ± 0.12 | 99.86 ± 0.03 | 98.34 ± 0.17 | 98.13 ± 0.29 | 94.21 ± 2.22 |
| 炎症 | 94.30 ± 0.44 | 98.48 ± 0.12 | 93.44 ± 0.29 | 96.55 ± 0.78 | 60.44 ± 4.34 |
表2:各类别异常亚型的检测性能。 RareCode 的独立评估'针对癌症与炎症样本相对于正常样本的检测性能。使用类别特异性最优阈值计算了各项分类指标,包括曲线下面积、平均精度、F1分数、召回率及特异性。
| 变体 | 代码簿配置 | CAR | AUC (%) | AP (%) | F1 (%) | 特异性(%) | P@R90 (%) |
| 无CAR |  | | 92.81 ± 0.12 | 99.05 ± 0.02 | 95.30 ± 0.08 | 33.76 ± 3.82 | 96.72 ± 0.12 |
| 单一码本 | [256] |  | 95.92 ± 0.40 | 99.47 ± 0.05 | 96.25 ± 0.14 | 55.37 ± 6.51 | 98.31 ± 0.43 |
| 双尺度 | [128, 512] | | 96.57 ± 0.27 | 99.56 ± 0.04 | 96.45 ± 0.12 | 57.75 ± 4.14 | 98.75 ± 0.12 |
| 三尺度 | [128, 256, 512] | | 96.36 ± 0.37 | 99.53 ± 0.05 | 96.52 ± 0.17 | 57.99 ± 4.65 | 98.60 ± 0.23 |
| 四尺度 | [64, 128, 256, 512] | | 96.82 ± 0.23 | 99.59 ± 0.03 | 96.63 ± 0.15 | 58.24 ± 5.99 | 98.80 ± 0.10 |
| FourScales + 复合解码器 | [64, 128, 256, 512] | | 95.17 ± 0.44 | 99.39 ± 0.06 | 95.32 ± 0.20 | 53.83 ± 21.45 | 98.40 ± 0.37 |
表3:消融研究结果。 RareCode 配置在逐步添加组件情况下的性能比较:仅重建基线 (NoCAR)、单码本 CAR (SingleCodebook) 以及多尺度配置 (TwoScales, ThreeScales, FourScales)。还包括一项使用 FourScales 配置进行的额外解码器复杂度消融实验。评估指标包括 AUC、平均精度 (AP)、F1 分数、特异性以及召回率为 90% 时的精确度 (P@R90)。
| 评分类型 | 能量比 | 科恩's d | AUC (%) |
| 重建误差 | 2.623 | 2.006 | 93.31 |
| 联合 CAR | 1.078 | 1.002 | 74.85 |
| Codebook 64 | 1.109 | 1.207 | 78.79 |
| Codebook 128 | 1.085 | 1.067 | 76.19 |
| Codebook 256 | 1.065 | 0.916 | 72.80 |
| 代码本 512 | 1.064 | 0.833 | 70.38 |
表4:基于定位衍生响应的图像级分析。 图像平均重建误差与码本稀有度响应在正常与异常样本间的比较,采用能量比与Cohen's d 与 AUC。
| 折叠 | 最佳 α | AUC 值 (%) | 测试 AUC (%) |
| 1 | 0.95 | 96.22 | 96.91 |
| 2 | 0.9 | 96.38 | 96.39 |
| 3 | 0.85 | 96.71 | 96.82 |
| 4 | 0.85 | 96.22 | 96.93 |
| 5 | 0.95 | 96.72 | 97.05 |
| 平均值 | 0.90 ± 0.05 | 96.45 ± 0.23 | 96.82 ± 0.23 |
表5:各交叉验证折次的最优alpha值。 最优融合权重α通过网格搜索(步长0.05)在每次交叉验证折叠的验证集上确定,并附有平均值和标准差统计量。
讨论
结果表明,码本激活模式可能为空间重建误差提供补充信息。从 NoCAR 到完整的 FourScales 模型的性能提升支持了 CAR 评分的潜在贡献,而所选的融合权重表明语义稀有性可能在最终的异常评分中发挥重要作用。一种可能的解释是,结直肠癌相关的异常可跨越不同的形态学尺度,从核异型性到腺体结构破坏,因此可能受益于多尺度的特征表示14。当前模型在同一放大倍数下使用 32 × 32 和 64 × 64 的图像块来捕获不同的空间范围;未来与全切片图像(WSI)处理框架的结合可能进一步支持分层的切片级分析39。
从临床角度来看,RareCode 最好被视为一种预筛查分诊工具,而非自主诊断系统。其较高的召回率(98.40%)表明漏诊异常病例的风险相对较低40,而其适中的特异性(58.24%)可能反映了在无监督环境下区分炎症性改变与正常组织的难度。较高的癌症特异性(94.21%)进一步表明,对于临床最关键的亚型,假阳性警报可能较少。这些性能特征支持将 RareCode 作为预筛查工具,用于优先处理需要专家评估的病例,并优化病理学审查流程5,6。
各类别的结果可能进一步支持RareCode在分诊中的潜在作用。相较于炎症,该方法在癌症检测中表现相对更优,这可能反映了恶性组织中常见的更为显著的结构和细胞学异常,包括极性丧失、核多形性以及间质性纤维化14,39。相比之下,炎症性改变与良性组织变异的重叠程度更高,这在一定程度上可以解释炎症特异性较低的原因。因此,总体特异性应谨慎解读,癌症检测应被视为一项具有重要临床意义的应用场景,而非作为最终的独立自主诊断。
RareCode 的潜在失效模式应结合其单类学习目标来理解。由于该模型学习的是正常组织的模式,而非特定疾病的分类,因此再生性上皮、纤维化、坏死或显著的炎症等非肿瘤性改变也可能获得较高的异常评分。相反,具有接近正常腺体结构的轻微异型增生或高分化癌可能产生较弱的响应。技术因素,包括染色差异、组织褶皱、切片伪影、失焦以及图像压缩,也可能影响重建误差和码本激活频率。这些因素提示,临床转化需要进行图像质量控制、染色标准化、针对扫描仪的校准以及多中心验证39,41。
基线比较的范围。本研究中的实验评估聚焦于在相似数据和计算假设下运行的方法——具体而言,仅使用小规模无标签正常样本、且无需外部预训练语料库即可进行端到端训练的方法。该范围涵盖了无监督异常检测中的主要范式:基于重建的方法(CAE、VAE、SAE、MAE、PatchSAE)、基于记忆增强的方法(MemAE)、知识蒸馏方法(STFPM)、合成增强方法(DRAEM)以及基于预训练特征匹配的方法(PatchCore)。我们注意到有两类方法未被纳入直接基线进行比较。第一类是病理学专用的基础模型(UNI、CONCH、CTransPath),其利用数百万张经过 curated 的病理图像进行预训练,其性能优势主要源于预训练数据的规模与多样性,而非异常检测机制本身;直接比较将混淆预训练数据贡献与检测方法学贡献之间的差异。STFPM 和 PatchCore(二者均使用 ImageNet 预训练主干网络)表现欠佳,实证表明当通用预训练特征应用于组织病理学场景时存在领域差距问题,提示病理学专用的预训练可能有助于弥合这一差距。第二类是基于扩散的异常检测方法,尽管前景良好,但在推理阶段带来显著更高的计算开销(通常需要数百次迭代去噪步骤),限制了其在高通量临床筛查工作流中的适用性,而处理效率在实际应用中是一项必要要求。未来的工作将探讨在 RareCode 架构中引入病理学专用的预训练编码器——替代当前端到端训练的编码器——是否能够在保持 CAR 机制可解释性优势的同时进一步提升检测性能。
应当承认存在若干局限性。首先,验证仅限于单中心的结直肠癌(CRC)数据集,尚需在不同机构、扫描仪和染色方案之间开展多中心评估。其次,尽管针对癌症的特异性结果令人鼓舞,但总体特异性仍受到炎症与正常组织边界的影响。第三,缺乏像素级专家标注,因此无法计算 Dice 和 IoU 指标,定位性能评估仅限于定性可视化以及对空间响应聚合结果的图像级分析。第四,仍需开展正式的阅片者研究,以确定分层热图是否能够提高诊断准确性或阅片效率。最后,RareCode 目前仅支持图像块(patch)级和整张切片图像(WSI)图像级分析,若要在全切片图像(WSI)层面部署,还需与额外的处理框架进行整合39,41,42。
未来的研究应在将RareCode整合到全切片图像(WSI)处理框架后,于公开基准数据集和多中心队列中对其进行评估。前瞻性读者研究可能有助于评估其对诊断准确性、阅片时间以及观察者间一致性的潜在影响42。其他研究方向包括提高计算效率、将模型扩展至多类别异常亚型分类,以及整合多实例学习以实现切片级别的诊断28,39。
披露
作者声明,他们不存在任何已知的可能影响本文报道工作的竞争性财务利益或个人关系。在本研究工作准备过程中,我们使用了 ChatGPT 以改进稿件的语言表达和可读性,并协助生成数据可视化代码。在使用该工具后,我们根据需要对内容进行了审阅和修改,并对发表的文章承担全部责任。
致谢
本研究由雍 Dai 院士工作站(自身免疫性疾病诊断技术)(皖科科技〔2023〕317号)、合肥国家卫生健康科学与技术研究中心联合研究中心研究生创新基金项目职业医学与健康开放基金(编号:OMH-2023-04)、安徽省临床与转化研究项目(编号:202427610020132)资助。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| GeForce RTX 4060 Ti GPU | NVIDIA | N/A | 16 GB VRAM;所有实验均使用单个GPU(RRID:SCR_022858) |
| Matplotlib | Matplotlib Development Team | Version 3.8.4 | 数据可视化与图表生成(RRID:SCR_008624) |
| NumPy | NumPy Developers | Version 1.26.4 | 数值计算与数组操作(RRID:SCR_008633) |
| pandas | pandas Development Team | Version 2.2.3 | 数据组织与表格化结果处理(RRID:SCR_018214) |
| Pillow | Python Imaging Library / Pillow Contributors | Version 10.3.0 | 图像加载与预处理 |
| Python | Python Software Foundation | Version 3.12.3 | 用于模型开发与数据分析的编程语言(RRID:SCR_008394) |
| PyTorch | Meta Platforms, Inc. | Version 2.7.0+cu118 | 用于模型实现与训练的深度学习框架(RRID:SCR_018536) |
| scikit-learn | scikit-learn Developers | Version 1.4.2 | 交叉验证、训练集-测试集划分与评估指标(RRID:SCR_002577) |
| SciPy | SciPy Developers | Version 1.13.1 | 统计分析(RRID:SCR_008058) |
| torchvision | PyTorch Project | Version 0.22.0+cu118 | 图像预处理与数据转换 |
| tqdm | tqdm Developers | Version 4.66.4 | 训练与评估过程的进度监控 |
参考文献
- Fan J, Sun Q, Di Y, et al. DIPathMamba: A domain-incremental weakly supervised state space model for pathology image segmentation. Med Image Anal. 2025;103:103563.
- Nan T, Zheng S, Qiao S, et al. Deep learning quantifies pathologists' visual patterns for whole slide image diagnosis. Nat Commun. 2025;16(1):5493.
- Lagogiannis I, Meissen F, Kaissis G, et al. Unsupervised pathology detection: a deep dive into the state of the art. IEEE Trans Med Imaging. 2024;43(1):241-252.
- Tian Y, Liu F, Pang G, et al. Self-supervised pseudo multiclass pre-training for unsupervised anomaly detection and segmentation in medical images. Med Image Anal. 2023;90:102930.
- Metter DM, Colgan TJ, Leung ST, et al. Trends in the US and Canadian pathologist workforces from 2007 to 2017. JAMA Netw Open. 2019;2(5):e194337.
- Shaukat A, Levin TR. Current and future colorectal cancer screening strategies. Nat Rev Gastroenterol Hepatol. 2022;19(8):521-531.
- Ancker JS, Edwards A, Nosal S, et al. Effects of workload, work complexity, and repeated alerts on alert fatigue in a clinical decision support system. BMC Med Inform Decis Mak. 2017;17(1):36.
- Litjens G, Kooi T, Ehteshami Bejnordi B, et al. A survey on deep learning in medical image analysis. Med Image Anal. 2017;42:60-88.
- Stepec D, Skocaj D. Unsupervised detection of cancerous regions in histology imagery using image-to-image translation. In: Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition Workshops. 2021:3785-3792.
- Li Y, Lao Q, Kang Q, et al. Self-supervised anomaly detection, staging and segmentation for retinal images. Med Image Anal. 2023;87:102805.
- Hinton GE, Salakhutdinov RR. Reducing the dimensionality of data with neural networks. Science. 2006;313(5786):504-507.
- Kingma DP, Welling M. Auto-encoding variational Bayes. In: Proceedings of the 2nd International Conference on Learning Representations (ICLR). 2014.
- Goodfellow IJ, Pouget-Abadie J, Mirza M, et al. Generative adversarial nets. In: Advances in Neural Information Processing Systems. 2014;27:2672-2680.
- Lu S, Zhang W, Zhao H, et al. Anomaly detection for medical images using heterogeneous auto-encoder. IEEE Trans Image Process. 2024;33:2770-2782.
- Yang Z, Zhang T, Soltani Bozchalooi I, et al. Memory-augmented generative adversarial networks for anomaly detection. IEEE Trans Neural Netw Learn Syst. 2022;33(6):2324-2334.
- Huyan N, Quan D, Zhang X, et al. Unsupervised outlier detection using memory and contrastive learning. IEEE Trans Image Process. 2022;31:6440-6454.
- Jézéquel L, Beaudet J, Histace A, et al. Unified anomaly detection via multi-scale contrasted memory. IEEE Trans Image Process. 2026;35:2802-2815.
- Roth K, Pemula L, Zepeda J, et al. Towards total recall in industrial anomaly detection. In: Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition. 2022:14298-14308.
- Defard T, Setkov A, Loesch A, et al. PaDiM: a patch distribution modeling framework for anomaly detection and localization. In: International Conference on Pattern Recognition. Cham: Springer; 2021:475-489.
- Zingman I, Stierstorfer B, Lempp C, et al. Learning image representations for anomaly detection: application to discovery of histological alterations in drug development. Med Image Anal. 2024;92:103067.
- Jiang Y, Cao Y, Shen W. Prototypical learning guided context-aware segmentation network for few-shot anomaly detection. IEEE Trans Neural Netw Learn Syst. 2025;36(7):12016-12026.
- Wang X, Zhao J, Marostica E, et al. A pathology foundation model for cancer diagnosis and prognosis prediction. Nature. 2024;634(8035):970-978.
- Frotscher A, Kapoor J, Wolfers T, et al. Unsupervised anomaly detection in medical imaging using aggregated normative diffusion. Med Image Anal. 2026;109:103895.
- Zeng GQ, Yang YW, Lu KD, et al. Evolutionary adversarial autoencoder for unsupervised anomaly detection of industrial Internet of Things. IEEE Trans Reliab. 2025;74(3):3454-3468.
- Lu KD, Zhang BX, Xu Y, et al. MoARNN-AM: multi-objective automated recurrent neural network with attention mechanism for cyber-attack detection of UAV. IEEE Trans Consum Electron. 2026;72(1):1738-1749.
- van den Oord A, Vinyals O, Kavukcuoglu K. Neural discrete representation learning. In: Advances in Neural Information Processing Systems. 2017;30:6306-6315.
- Ghafourian A, Shui H, Upadhyay D, et al. Targeted collapse regularized autoencoder for anomaly detection: black hole at the center. IEEE Trans Neural Netw Learn Syst. 2025;36(6):10348-10358.
- Gao Z, Mao A, Dong Y, et al. SMMILe enables accurate spatial quantification in digital pathology using multiple-instance learning. Nat Cancer. 2025;6(12):2025-2041.
- Wang X, Liu H, Zhang Y, et al. Joint modeling histology and molecular markers for cancer classification. Med Image Anal. 2025;102:103505.
- Jin H, Shen J, Cui L, et al. Dynamic graph based weakly supervised deep hashing for whole slide image classification and retrieval. Med Image Anal. 2025;101:103468.
- Schmitz R, Madesta F, Nielsen M, et al. Multi-scale fully convolutional neural networks for histopathology image segmentation: from nuclear aberrations to the global tissue architecture. Med Image Anal. 2021;70:101996.
- Masci J, Meier U, Ciresan D, et al. Stacked convolutional auto-encoders for hierarchical feature extraction. In: International Conference on Artificial Neural Networks. Berlin: Springer; 2011:52-59.
- Ng A. Sparse autoencoder. CS294A Lecture Notes. 2011;72:1-19.
- He K, Chen X, Xie S, et al. Masked autoencoders are scalable vision learners. In: Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition. 2022:16000-16009.
- Lim H, Choi J, Choo J, et al. Sparse autoencoders reveal selective remapping of visual concepts during adaptation. In: Proceedings of the 13th International Conference on Learning Representations (ICLR). 2025.
- Gong D, Liu L, Le V, et al. Memorizing normality to detect anomaly: memory-augmented deep autoencoder for unsupervised anomaly detection. In: Proceedings of the IEEE/CVF International Conference on Computer Vision. 2019:1705-1714.
- Wang G, Han S, Ding E, et al. Student-teacher feature pyramid matching for anomaly detection. In: Proceedings of the 32nd British Machine Vision Conference (BMVC). 2021.
- Zavrtanik V, Kristan M, Skocaj D. DRAEM: a discriminatively trained reconstruction embedding for surface anomaly detection. In: Proceedings of the IEEE/CVF International Conference on Computer Vision. 2021:8330-8339.
- Niazi MKK, Parwani AV, Gurcan MN. Digital pathology and artificial intelligence. Lancet Oncol. 2019;20(5):e253-e261.
- Raab SS, Grzybicki DM, Janosky JE, et al. Clinical impact and frequency of anatomic pathology errors in cancer diagnoses. Cancer. 2005;104(10):2205-2213.
- Schömig-Markiefka B, Pryalukhin A, Hulla W, et al. Quality control stress test for deep learning-based diagnostic model in digital pathology. Mod Pathol. 2021;34(12):2098-2108.
- Steiner DF, MacDonald R, Liu Y, et al. Impact of deep learning assistance on the histopathologic review of lymph nodes for metastatic breast cancer. Am J Surg Pathol. 2018;42(12):1636-1646.