本研究提出了一种基于可解释人工智能的工业5.0信息物理协作框架,该框架在MIMII数据集上采用卷积神经网络-Transformer(CNN-transformer)与SHAP方法实现工业声学异常检测。边缘计算的集成支持可解释、以人为中心的预测性维护。
需要JoVE订阅才能观看此内容。 请登录或开始免费试用
本文内容
摘要
摘要
本研究提出了一种基于可解释人工智能(XAI)的赛博-物理协作系统,用于工业5.0背景下工业零部件的可持续制造。现有的赛博-物理人类系统(CPHS)在人工智能集成方面程度有限,且通常缺乏可解释性。因此,亟需提升其可扩展性与灵活性,以符合工业5.0的核心原则:韧性、长期可持续性以及以人为本。为解决这些不足,我们提出一种架构,将深度学习与可解释人工智能(XAI)整合至赛博-物理系统(CPS)生态中,以实现智能化且可解释的决策过程。具体而言,我们采用MIMII(Malfunctioning Industrial Machine Investigation and Inspection)数据集,通过声学信号进行机器故障检测。音频信号经过频谱变换生成频谱图图像,随后由卷积神经网络(CNN)提取空间特征,并由Transformer编码器提取时间特征。为提高系统透明度并促进人机协同,基于Shapley加性解释(SHAP)的方法可帮助操作人员理解系统的决策过程,通过突出显示影响模型预测的关键输入特征实现。此外,该框架应用于基于边缘计算的赛博-物理系统,以实现低延迟、低能耗并提供及时响应,从而有助于保障可持续的生产环境。实验结果表明,所提出的CNN-Transformer架构准确率达到98.5%,性能优于现有的CPHS系统,同时保持了低延迟特性。在该类赛博-物理协作系统中引入可解释人工智能,显著增强了操作人员的信任度,并实现了无缝的人机协作。
引言
从强调技术、机械化和通信的工业4.0向结合技术进步、适应性、可持续发展和以人为本的新工业5.0模式的转变,影响了工业系统的动态演进1,2欧盟委员会将工业5.0定义为一种不仅关注生产率和效率,而且关注以人为本、可持续性和韧性三大支柱的范式。值得注意的是,近期研究指出,人工智能系统、人机协作和可持续制造是推动工业5.0环境的主要驱动力。3,4在不断变化的工业环境中,传统的维护方法已不再足够。为了在复杂且不稳定的环境中实现韧性,维护必须演变为一种更具适应性和系统性的形式5自2011年以来,工业4.0一直是欧洲工业转型的主导模式,推动企业实施数字化转型,以提升运营效率并最大化利用现有资源4因此,必须在不减少生产过程中人工劳动的同时提高效率,并保障工人的健康与安全。为此,企业和学术界已开始界定工业5.0范式的基本原则。5,6,7,部分动机源于日本提出的“超智能社会5.0”理念8,9,10,11尽管近期文献更加重视可持续维护,但大多数现有的系统性评估仍然零散或局限于特定领域,缺乏将韧性、可持续性和人工智能整合在一起的综合框架。例如,有作者探讨了特定系统或策略的可持续维护实践,包括可持续全面生产维护(STPM),而另一些研究人员则讨论将可持续性主题融入维护技术中12,13,14. 作者 对可持续性采纳标准进行了全面评估,并强调了推动制造业产生积极可持续影响的技术因素15然而,在 Industry 5.0 范式中,可持续性、韧性与基于人工智能的决策在这些研究中均未实现充分整合。因此,可持续性通常由独立的维护方法分别处理。在其他可解释人工智能(XAI)技术中,SHAP 因其理论上严谨的特征归因方法而脱颖而出16,17,18.
人工智能能够实现数据驱动的决策,但准确的模型通常需要大量数据。传统的机器学习(ML)方法,如决策树、逻辑回归和线性回归,在高度非线性的情况下常表现不佳,因为它们假设数据分布相对简单19。深度神经网络(DNNs)通过从大规模数据集中学习复杂的特征表示,克服了这些限制20。研究表明,在复杂的决策任务中,更深的网络通常优于浅层结构21,但其不断增加的深度和参数复杂性使得模型的可解释性降低22。
信息物理系统(Cyber-Physical System, CPS)是工业5.0制造的关键使能技术,因为它融合了分布式智能、嵌入式计算机、物理过程和通信。为了实现灵活、智能和实时的工业操作,现代CPS正迅速整合边缘计算、边缘人工智能(AI)和绿色物联网(G-IoT)23,24。近期关于维护4.0和智能维护的研究突出了可持续性与韧性的关键作用。尽管已有研究探讨了维护4.0技术在可持续制造中的重要性,并提出了可持续维护的建模框架,也有文献计量学和系统性研究评估了智能维护技术25,26,27,28。进一步的研究还探讨了将可持续维护融入工业4.0环境以及面向可持续性的生产系统29,30,31,32。操作员4.0(Operator 4.0)概念33、以人为本的工业5.0框架34以及社会经济视角35均在人本化维护领域受到广泛关注。此外,近期研究还强调了数字维护36、预测性与规范性维护37,38以及可持续维护策略39,40的进展。尽管取得了上述进展,相关研究仍较为分散,鲜有研究提供一个整合可解释人工智能(AI)、可持续性、韧性以及以人为中心的信息物理协同的统一范式。尽管CPS部署日益广泛,但尚未实现完全自主,而工业5.0范式本身也不倾向于完全自主。相反,工业5.0更加强调人类的监督、协作与决策。通过将人类思维与协作融入信息物理过程,诸如人在回路中的CPS(HiLCPSs)41、以人为本的CPS(HCPSs)42,43以及信息物理人类系统(CPHSs)44等系统扩展了传统CPS的功能。这种集成通过实现智能系统与人类操作员之间的实时协作,提升了系统的适应性、透明度、安全性与韧性45,46。
工业音频异常检测已因新型架构而得到显著提升,这些架构包括视觉变换器(ViT)、音频频谱图变换器(AST)、Conformer 以及自监督学习;然而,这些技术与面向工业5.0的可解释信息物理系统的集成仍然有限。当前的研究主要关注分类准确率或事后基于XAI的可解释性,尚未将可解释性、边缘部署和人在回路中的决策支持整合到统一框架中。本研究提出一种新型的可解释人工智能驱动的CNN-变换器信息物理协同架构,该架构融合了边缘计算、时序依赖性建模、基于SHAP的可解释性、空间特征学习以及以人为核心的决策支持,旨在实现可持续的工业5.0制造,并克服上述局限性。
因此,该领域仍存在显著的研究缺口。当前基于卷积神经网络(CNN)/Transformer 的声学异常检测技术侧重于分类性能,但缺乏信息物理系统的协同性与可解释性。尽管工业5.0框架提出了以人为本的概念模型,却未能将可解释的深度学习、边缘智能与操作人员参与的决策机制整合到单一系统中;基于可解释人工智能(XAI)的预测性维护技术虽提升了透明度,但其运行仍独立于信息物理人类系统(CPHS)架构之外。因此,目前仍缺乏一种统一的工业5.0信息物理人类系统,能够集成精确的听觉异常检测、基于SHAP的可解释性、支持边缘部署的能力以及人机协同机制。
本文提出了一种新型的可解释人工智能驱动的卷积神经网络-Transformer(CNN-Transformer)信息物理协同范式,以应对工业5.0中的上述限制。所建议的架构将边缘计算部署、基于CNN的空间特征提取、基于Transformer的时间依赖性学习、基于SHAP的可解释性以及人在回路中的决策支持整合到一个统一的信息物理融合系统(CPHS)框架中。与现有方法独立处理各要素不同,该框架提供了一种集成化解决方案,可同时提升异常检测性能、模型透明度、运行效率以及以人类为中心的协作能力,从而推动可持续制造的发展。
本研究的主要目标是通过结合基于SHAP的可解释性、边缘计算和人在回路中的决策支持,以及基于混合CNN-Transformer的声学异常检测方法,构建一个由可解释人工智能(AI)驱动的、面向可持续工业5.0制造的赛博-物理人类系统(CPHS)。具体而言,所提出的框架旨在提高异常检测的准确性,同时提供清晰、可理解的预测结果,促进在边缘端的有效部署,并增强智能系统与人类操作员之间的协同决策。该集成架构通过同时实现高检测性能、可解释性、低延迟运行以及以人类为中心的赛博-物理协同,解决了当前声学异常检测、基于可解释人工智能(XAI)的预测性维护和CPHS框架中存在的不足。
所提出的架构针对工业5.0,提出了一种统一的、基于可解释人工智能的网络-物理-人类系统(CPHS),与当前主要关注分类准确率的声学异常检测技术形成对比。该架构在一个统一框架内集成了基于卷积神经网络(CNN)的空间特征提取、基于Transformer的时间序列建模、基于SHAP的可解释性分析、边缘计算以及人在回路中的决策支持。通过将精确的异常检测与可理解的决策过程及实时边缘部署相结合,该架构解决了透明性、操作员辅助和网络-物理协同等关键问题。本研究的主要科学贡献在于系统层面的集成,这使得所提出的方法不同于以往仅单独关注异常检测、可解释人工智能或工业5.0框架的研究工作。
访问受限。请登录或开始试用以查看此内容。
方案
本研究建议的方法采用基于系统的工业5.0人机协同信息物理系统(CPHS)框架,将可解释的深度学习与由边缘计算支持的协同信息物理架构相结合,以促进可持续制造过程。首先,通过识别当前CPHS解决方案存在的若干局限性来界定问题,这些局限性包括缺乏人工智能驱动的智能性、可解释性以及以人类为中心的协作能力。为应对这些挑战,所提出的解决方案利用MIMII数据集,通过声学信号处理实现对工业机械状态的监测。
该框架首先将生成的频谱图输入卷积神经网络(CNN)模型,通过识别与不同机器状态相关的关键频率模式来提取空间特征。提取到的空间特征将被转换为序列,并输入至Transformer编码器模块,利用自注意力机制捕捉时间依赖性。经变换后的特征表示随后传递至全连接分类器模块,以将机器状态分类为正常或异常。此外,为确保模型透明性并支持以人类为中心的决策过程,采用SHAP可解释性方法,通过选择模型输出中具有显著意义的时频区域来解释预测结果。所设计的模型将在支持边缘计算的网络物理系统(CPS)环境中实现,从而实现低计算延迟和低能耗的实时推理。同时,还将集成人机协同机制,使操作人员能够基于可解释性结果进行验证。模型性能将通过准确率、精确率、召回率和F1分数,以及延迟和能效等系统级指标进行验证。
所提出的框架是一种由可解释人工智能(XAI)驱动的、面向工业5.0背景下的可持续制造的赛博-物理-人类系统(CPHS)机制,其工作流程如图1所示,呈现为从数据采集到智能决策与执行的流水线结构。在数据采集阶段初期,通过MIMII等数据集,从电机、泵和轴承等工业设备中采集声音信号。所获得的数据信号随后被传递至下一阶段,即数据预处理阶段,在此阶段进行滤波、归一化和分段处理。经过分段处理的数据信号最终在特征表示层通过短时傅里叶变换(STFT)转换为频谱图。
然后,AI 模型层利用频谱图图像通过 CNN 模块提取特征,识别空间模式和异常。接着,将提取出的特征进行重塑并输入至 Transformer 编码器,该编码器通过自注意力机制学习时间依赖性和长程关系。最终,分类层将生成的特征向量划分为正常或异常。为确保预测过程的透明性,可解释性层采用 SHAP 方法突出频谱图中具有显著性的时间-频率区域。
此外,该系统还包含人机协同环节,操作人员可对模型的输出结果进行解读并提供反馈。在部署层,模型运行于基于边缘计算的 CPHS 基础设施上,确保快速推理和低功耗运行,同时可根据需要选择与云系统对接,以满足数据存储或高级分析的需求。总体而言,该框架能够实现准确的故障检测、结果可解释性以及高效的实时运行,完全符合工业 5.0 的要求。
问题定义与需求分析
在工业5.0背景下,信息物理人类系统(CPHS)有望实现智能化、可持续性和以人为本的目标。然而,当前构建CPHS的框架受限于缺乏先进的AI赋能能力、可解释性以及对人机协作的充分支持。事实上,传统的CPHS依赖基于规则或不可解释的模型,这阻碍了系统对不断变化的工业环境的适应能力,并降低了操作人员对自动化的信任度。此外,传统CPHS无法有效分析高度复杂的工业数据,例如同时包含空间(即频率)和时间依赖成分的工业声学信号,而这类信号在预测性维护中至关重要。因此,亟需建立一种能够在边缘端高精度检测机器异常、提供可解释结果并支持信息物理系统(CPS)运行的框架。
其中,x(t) 表示声学输入信号,S(f,t) 表示信号的频谱图表示, 为标签, θ 为 CNN-Transformer 架构的参数集合。后续方程中使用的符号将在其首次出现后立即给出,以确保数学上的准确性。
从数学角度来看,该任务可被形式化为一个有监督学习问题。设工业声学信号表示为 x(t)。x(t) 的短时傅里叶变换(STFT)按以下公式计算:
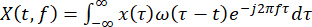 (1)
其中 ω(.) 是窗函数,且 f 是频率。生成的频谱图 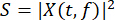 作为深度学习算法的输入。目标是训练该映射函数
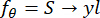 (2)
其中 为类别标签(正常或异常),S 为谱图输入,y 为预测输出标签, θ 为 CNN-Transformer 架构的可学习参数集合。该优化问题被表述为最小化分类损失:
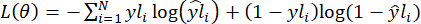 (3)
在最小延迟  、能效
 和可解释性约束条件下,其中解释 ∅(SHAP) 反映了特征在预测过程中的重要性,
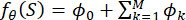 (4)
其中, 表示各个特征的贡献值。根据上述原则,设计需求包括以下几点:(i) 基于混合深度学习的可靠异常检测,(ii) 可解释的输出以支持人工干预,(iii) 在增强型边缘计算信息物理系统(CPS)框架中实现。
数据集获取与预处理
为此,为评估所提出的基于可解释人工智能的 CPHS 框架,选用了 MIMII 数据集13。该数据集是利用声学信号检测工业机械异常的常用基准。该数据库包含多种机器(如滑轨、风扇、泵和阀门)在正常与故障运行状态下的声音 recordings。对于每种机器,录音随不同设置和噪声环境而变化,使其适用于在实时工业条件下进行模型训练与评估。
尽管MIMII数据集在仅依赖正常样本进行训练的无监督异常检测研究中被广泛使用,但它包含了对正常和异常机器状态的明确标注。本研究将问题设定为一个有监督的二分类任务,以检验所提出的基于可解释人工智能的CNN-Transformer架构区分健康与故障机器状态的能力。具体而言,采用MIMII数据集的官方标签,将正常样本标记为类别0,异常样本标记为类别1。
表1展示了数据集描述的详细信息。本研究共考虑了约12,000条声学信号记录,包括正常和故障机械运行状态下的数据。根据要求,本研究中所有记录的采样频率均为16 kHz,每条记录时长为10秒。尽管该数据集包含约12,000条记录,但为了可视化混淆矩阵,仅选择了一个类别平衡的2,000条测试记录子集。所有报告的性能指标均使用完整的测试集(约2,400条记录)计算得出。此外,训练样本与测试样本按80:20的比例进行划分,用于模型训练。由于该数据库包含实时噪声条件,因此非常适用于工业5.0应用场景。本研究中使用的记录分布情况见表2。从该数据集中,选取了覆盖所有机械类型和信噪比(SNR)条件的约12,000条记录,用于监督式二分类实验,并采用80:20的训练/测试划分方式,展示了工业机械类型、对应的机械编号、正常与异常声学记录的总数、SNR条件以及监督式二分类实验所采用的训练/测试划分方案。
实验采用 MIMII(工业机器故障检测与检查)数据集 1.0 版本进行,该数据集包含四种类型的工业机器:风扇、泵、阀门和滑轨。数据采集自不同机器编号(根据机器类型为 ID00–ID06)和不同工况。MIMII 数据库包含在信噪比(SNR)为 −6 dB、0 dB 和 +6 dB 条件下采集的数据。正常数据对应工业机器的健康状态,而异常数据对应异常状态。数据类别根据数据库标注确定,其中正常数据标记为类别 0,异常数据标记为类别 1。
为了确保公平的评估,训练集与测试集的划分必须在原始音频记录层面进行,且早于任何分割、数据增强或频谱图生成步骤。因此,来自同一录音的音频片段不会同时出现在训练集和测试集中。在评估实验中,使用了具有不同信噪比(−6 dB、0 dB 和 +6 dB)的录音,从而能够在多种工业条件下对所提出的框架进行评估。
为防止数据泄露,训练集与测试集的划分以原始音频文件为基础,在进行任何分段或生成频谱图之前完成。来自同一段10秒音频录音的所有片段仅被分配至训练集或测试集中的一方,两个集合之间不存在重叠的片段。随后,针对每个数据集分别生成并增强频谱图。通过这种方式,避免了数据泄露问题,从而防止对模型性能产生过于乐观的评估。
数据集预处理
来自 MIMII 数据集的未经处理的声学信号随后经过处理,以提高信号质量并实现有效的特征提取。输入信号用 x(t) 表示,其中 t 为时间。第一步是噪声滤波,即通过滤波函数滤除背景噪声,其表达式为:
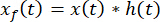 (5)
其中,∗ 表示卷积过程,h(t) 为滤波器的脉冲响应。该过程可增强声学信号的清晰度,并最大限度地减少工业环境中常见的噪声影响。信号归一化用于确保在将所有音频信号输入深度学习模型之前,其幅度具有可比性。归一化后的信号记为 xn(t),其计算公式如下:
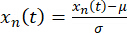 (6)
其中, μ 和 σ 分别为输入信号的均值和标准差。得益于该处理过程,所有输入信号均被保证具有零均值和单位方差。最后,在处理时,将归一化后的输入信号分割为多个微小片段。假设整个信号的长度为 T,则使用滑动窗函数将其分解为 N 个重叠的帧,每帧长度为 L:
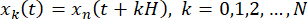 (7)
其中 H 是 hop 大小。该频谱图可由以下公式定义:
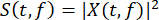 (8)
通过这种方式获得的频谱图被输入基于卷积神经网络-变换器(CNN-transformer)的框架中,以提取空间和时间特征,从而实现有效的异常检测。图2展示了预处理流程。
图2展示了一个可用于工业领域采集的声学数据的垂直预处理流程。首先,从MIMII数据集中提取原始音频信号,并将其输入噪声去除阶段以减少噪声。随后对信号进行归一化处理,以消除幅度不一致性,确保信号的一致性。之后将信号分割为较小的重叠片段。完成分段后,对数据应用短时傅里叶变换(STFT),将时域信号转换为时频域信号。接着计算功率谱,作为生成信号频谱图的一部分。因此,预处理后的频谱图即为该流程的输出结果,并将用于所提出的CNN-Transformer模型中。
频谱图生成
在数据归一化和分段之后,利用短时傅里叶变换(STFT)将声学信号转换为时频表示。生成的频谱图以图像形式展示了分析时段内频率成分的变化情况。在工业环境中,机器故障通常表现为特定的频率模式,因此频谱图在检测机器异常方面具有更高的实用性。
因此,将生成的处理后数据转换为频谱图图像,以区分机器中的正常与异常情况。音频数据将被转换为多个频谱图,使学习模型能够分析机器运行过程中的局部频率成分及时间变化。这些图像作为CNN-Transformer模型的输入数据,其中CNN负责处理空间(频率)模式,而Transformer负责处理时间序列关系。
算法 1:从声学信号生成频谱图
输入:原始音频信号 x(t)
输出:谱图 S(t, f)
步骤 1:加载音频信号 x(t)
步骤 2:应用噪声滤波
步骤 3:对信号 xn(t) 进行归一化
步骤 4:将信号分割为帧:
对于 k = 1 到 N 执行
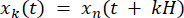
结束循环
步骤 5:对每个片段应用一个窗函数 w(t)
步骤 6:计算短时傅里叶变换(STFT):
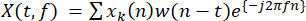 (9)
步骤 7:计算幅值:
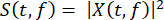 (10)
步骤 8:存储频谱图 S(t, f)
步骤 9:返回语谱图数据集
生成频谱图的过程始于获取原始音频信号,随后进行噪声抑制和信号归一化等预处理步骤,以确保信号的完整性和质量。接着,将归一化后的音频信号分割为多个重叠的时间窗,以捕捉长时和短时的时间特征。为防止频谱泄漏,每个分段在经过短时傅里叶变换之前会先与窗函数相乘。随后,变换后的信号在频域中表示为复数值函数,并对其幅度进行平方。因此,频谱图即表示了给定时间内各频率的能量分布。最后,这些频谱图以类图像数据的形式存储,并输入神经网络用于训练。
使用卷积神经网络进行空间特征提取
在生成频谱图之后,将输出的时频图像作为输入提供给卷积神经网络(CNN)。假设输入的频谱图为  ,其中 H 表示频率域,W 表示时间域。此处使用 CNN 的目的是从输入频谱图中学习具有判别性的空间特征。这些具有判别性的空间特征将有助于区分工业环境中机器的正常与异常行为。
卷积神经网络(CNN)执行的一项基本操作是卷积。使用给定滤波器  的卷积运算定义如下:
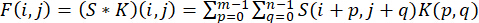 (11)
上述操作使神经网络能够在频谱图中识别局部空间特征,例如边缘、频率和谐波成分。该过程通过多个滤波操作生成不同的特征表示,从而产生多个特征图。卷积之后是如下所示的非线性激活函数:
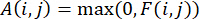 (12)
这种非线性使网络能够捕捉和表示变量之间的复杂关系。卷积神经网络的下一阶段涉及池化操作的应用。常用的池化技术——最大池化在数学上表达如下:
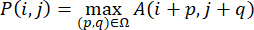 (13)
其中 Ω 表示池化窗口。池化有助于实现平移不变性,并在丢弃冗余信息的同时保留相关信息。从频率等低级变量到复杂的机器行为,可以通过卷积神经网络逐层提取更高级的特征。因此,特征图可用于描述网络的最终输出:
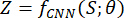 (14)
其中 表示卷积神经网络(CNN)的可学习参数。特征图包含丰富的空间信息,并被转换为序列,作为下一阶段变压器编码器的输入。上述空间特征提取过程对于使模型能够检测工业声学信号中的微小异常至关重要。
图3 演示了如何使用卷积神经网络(CNN)模型从频谱图输入中水平提取空间特征。该过程始于输入的频谱图,它以图像形式编码了音频信号的时频特性。输入频谱图随后通过一个卷积层,其中多种滤波器可提取频率带、边缘和纹理等空间特征,从而生成特征图。接着,提取出的特征图经过一个非线性激活函数——修正线性单元(ReLU),使神经网络能够检测输入数据中的依赖关系。然后,特征图通过一个池化层,在减小特征图尺寸的同时保留其最重要的特征。卷积层、激活层和池化层的这一过程会重复多次,构建出一种特征表示的层次结构,从简单特征开始,逐步演化为与机器运行相关的更复杂特征。
使用变换器编码器进行时间建模
使用卷积神经网络(CNN)提取空间特征后,下一步是生成能够捕捉从频谱图中学习到的基于频率模式的高层特征图。随后将得到的特征图展平并重塑为序列,以捕获声学信号中的时序信息。假设特征图表示为 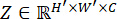 ,其中 H', W' 和 C 分别表示高度、宽度和通道数,则可得到以下序列:
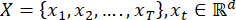 (15)
其中 T 表示序列长度,d 为特征维度。Transformer 随后利用上述序列,通过自注意力机制建模长期依赖关系。与传统的循环模型不同,Transformer 模型并行处理序列中的每个元素,并利用注意力权重确定各部分的相对重要性。注意力机制的工作原理是:根据每个输入 xt 按照以下方式生成查询向量(Query Q)、键向量(Key K)和值向量(Value V):
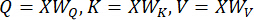 (16)
而 WQ,WK,WV 是可训练的权重。元素之间的相似性通过以下方式确定:
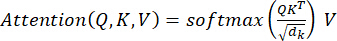 (17)
dk 是向量维度的重要参数。该过程有助于模型从信号中较远的时间步长学习依赖关系,并仅关注相关的时间片段。为了增强网络的学习能力,采用多头注意力机制,即多个注意力头并行地从输入中进行学习:
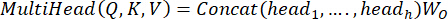 (18)
每个注意力头负责处理时间输入序列中的不同特征。随后是前馈神经网络和残差连接:
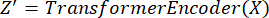 (19)
生成的编码序列同时捕捉了输入的空间和时间特征。该序列被送入分类器层以检测异常。
图4展示了使用Transformer编码器对从CNN提取的特征进行时间建模的整体流程。首先,采用从CNN提取的特征图,这些特征图包含来自频谱图的空间信息。特征图被展平为一个序列,其中每个元素对应一个时间戳。随后,该序列经过线性变换,将数据映射为特定维度的向量。由于Transformer模型本身无法捕捉时间依赖关系,因此还会向嵌入向量中添加位置编码,以保留序列的时间结构。最后,序列通过一个由多个层级堆叠而成的Transformer编码器,在其中采用多头自注意力机制,使模型能够学习序列中不同时间戳之间的关联。前馈神经网络进一步优化这些嵌入表示,而残差连接则确保梯度能够高效传播。该过程在堆叠的Transformer编码器层中重复进行,逐层捕获更为复杂的时间交互关系。最终,通过池化操作(例如平均池化或分类标记(CLS))将序列嵌入整合为一个固定长度的表示,从而得到全局时间特征表示。
分类层
经过变换器编码器进行时间编码后,输出将是一系列编码向量,每个向量均包含与输入信号空间和时间特征相关的特征。从编码输出进行分类的第一步是将所有这些特征聚合为单个向量。这可以通过对特征向量序列应用平均池化,或使用所谓的“分类标记”(classification token)来实现。假设变换器的输出为 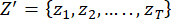 ,其中每个
 。聚合后的特征 h 计算如下:
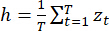 (20)
然后,聚合后的特征向量 h 以紧凑的形式表示输入,并作为分类器的输入。分类部分包含一个或多个全连接层,将学习到的表示转换到输出空间。全连接层实现的变换定义如下:
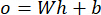 (21)
其中 o 是输出(logits), b 是偏置向量,且 W 是权重矩阵。后者是以未归一化形式表示的类别得分。为了将非线性引入模型,通常使用诸如ReLU之类的激活函数。最后,对logits应用softmax激活函数,以获得每个类别的概率:
 (22)
其中,C 表示类别数量(C = 2;正常与异常)。类别预测将基于最大概率值进行。在训练过程中,通过最小化实际标签与预测标签之间的交叉熵损失,获得模型参数的最优值,从而实现对机器状态的准确分类。综上所述,分类层在将基于 Transformer 架构提取的时间特征转化为实际决策方面发挥着关键作用。通过对健康与故障机器状态进行有效区分,可在工业 5.0 范式下实现异常检测与智能决策。
图5展示了在Transformer编码器之后的分类层工作原理。该过程始于编码序列输出,其中每个向量包含从输入中学习到的时间信息。这些向量被合并为一个单一向量,称为全局特征向量。下一步是将全局特征向量输入多个全连接神经网络层。在每个全连接层中,通过矩阵乘法运算生成输入的线性组合。随后,可应用非线性激活函数(如ReLU),以增强学习决策边界的灵活性。在最后一个全连接层的末端,会输出每个类别的logit得分。这些logit得分可通过Softmax函数计算出每个类别的概率得分。这些概率得分用于判断输入属于类别0(正常)还是类别1(异常)。
使用SHAP进行可解释性分析
在模型对输入信号进行分类后,会根据机器运行是否正常生成相应的预测结果。然而,在工业5.0环境下,仅生成预测是不够的;系统还必须提供透明性和可解释性,以支持人类的决策过程。以下框架采用SHAP方法,这是一种基于博弈论的模型,用于量化各个特征在预测结果中的重要性。通过该方法,SHAP为各个特征分配权重,从而可以评估频谱图输入中不同区域对整体预测的相对重要性。
SHAP 的数学表达基于对模型 f(x) 的分解:
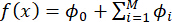 (23)
其中 ∅0 是基线值(模型输出的均值), ∅i 是第 i 个特征的效应,且 M 是输入特征的数量。在本研究中,这些特征来自频谱图的时间-频率单元。若SHAP值为正值,则表示其对异常状态的概率具有促进作用;若为负值,则表示其作用相反。该方法可确保对每个预测结果提供唯一且局部一致的解释。SHAP方法可应用于已训练的CNN-Transformer模型,以基于特征重要性提供解释。其可视化结果将展示频谱图中对决策过程影响最大的时间-频率单元。例如,设备的异常行为可能导致某些高频高能量频带,SHAP框架会识别这些频带为决策过程中的重要贡献者。
此外,SHAP 能够在信息物理环境中促进人与机器之间的协作。这是因为预测结果可以通过直观的可视化方式进行解释,使操作人员和决策系统能够验证预测、分析问题并采取适当措施。这不仅增强了信任,还使基于人工智能的制造过程更加可靠且可追溯。通过将满足当前性能标准的深度学习算法与提供可解释性的 SHAP 相结合,所提出的架构满足了工业 5.0 的要求。
算法 2:基于 SHAP 的模型预测可解释性
输入:训练好的模型 f(x),输入频谱图 S
输出:SHAP 值  和解释图谱
步骤 1:将频谱图 S 输入至训练好的模型
步骤 2:计算预测值:y = f(S)
步骤 3:初始化一个面向深度学习的 SHAP 解释器
步骤 4:计算 SHAP 值:
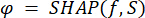
步骤5:针对每个特征 i 在 S 中:
计算贡献 
步骤 6:生成解释图谱:
突出显示高 
步骤 7:可视化特征重要性(热图)
步骤 8:返回 SHAP 值和解释图
基于SHAP的可解释性算法首先获取预处理后的频谱图图像作为输入,并将其输入到训练好的CNN-Transformer架构中进行预测(例如,判断机器状态为正常或异常)。在使用训练好的架构完成预测后,采用SHAP方法对模型进行解释。具体而言,为每个输入特征计算SHAP值(ϕ),以确定输入中哪些时频成分对预测结果的贡献最大。为计算这些值,必须比较模型在包含与不包含某些特征的输入下的输出结果。
在计算每个特征的SHAP值后,可通过SHAP值的符号和大小来评估该特征对预测结果的影响。例如,SHAP值较高的特征更有可能影响预测结果,而正值或负值分别表示该特征将预测结果推向正常/异常类别。根据结果,可生成以热图形式呈现的解释图。
最后,该算法输出 SHAP 值及相应的可视化结果,有助于揭示人类如何分析模型的决策过程。该技术使决策过程更加透明,使人类能够参与其中,从而确保人工智能驱动的工业中算法预测结果及其可靠性的实现。为提高可解释性分析的可靠性,从多种机器类型中准确诊断出的异常实例中选取了具有代表性的测试样本。通过对测试数据集中的 SHAP 值进行聚合,开展全局 SHAP 特征重要性分析,以识别在时频域中持续具有影响力的区域;同时针对这些代表性样本生成局部 SHAP 解释。该整合的局部与全局分析无需专家标注,即可为模型预测提供可靠的解释。
边缘计算使能的 CPS 集成
该方案应用于支持边缘计算的网络物理系统(CPS),旨在实现高效、可持续且实时的工业运行。模型训练完成后,将通过边缘计算方式部署卷积神经网络-Transformer(CNN-transformer)。该边缘计算层位于工业物联网(IIoT)设备附近,包括传感器和机械设备。边缘设备无需将所有采集的数据传输至云端,而是直接对 incoming 声学信号进行推理分析,无需先行上传。因此,系统几乎可立即检测到机械设备的异常情况,并在问题进一步恶化前采取必要措施。这种支持边缘计算的方法另一优势在于提升了延迟性能与运行效率,因为数据在生成位置附近即被分析处理。换言之,与云端方案不同,在云端方案中推理时间 Tinf
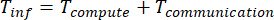 (24)
通常,通过降低Tcommunication,延迟将显著减少。另一项优势是,在持续传输数据时可降低带宽消耗和功耗。因此,该系统可扩展且可持续,适用于拥有大量联网设备的大型工业厂房。此外,信息物理系统(CPS)能够实现与物理层(设备)、人工智能(计算层)以及人类交互层的互动。
人在回路协作
所建议的工业5.0信息物理系统(CPS)的一个关键组成部分是人机协同,即人类操作员与人工智能模型共同参与决策过程。具体而言,根据所设计的框架,该系统不会成为完全自主的黑箱,而是允许操作员与其进行交互,并以SHAP解释的形式观察可解释的预测结果。此处的预测结果指的是检测输出(正常/异常),并附有用于做出预测的频谱图部分的可视化展示。
这种交互有助于操作人员更清楚地理解预测结果的形成过程以及哪些因素对其产生影响。人工参与意味着对系统的输出结果进行验证,并允许操作人员根据专业判断在必要时覆盖系统结果。与人工操作人员的协作使系统更加可信、高效、安全和可靠,有助于防止错误的发生。
访问受限。请登录或开始试用以查看此内容。
结果
所提出的集成可解释人工智能的网络-物理协作系统在 MIMII 数据集的大约 12,000 条音频记录上进行了实验测试,该数据集包含正常和异常的机器状态。训练数据集包含约 9,600 条数据记录,而测试数据集包含约 2,400 条音频样本。根据研究结果,所建议的 CNN-Transformer 模型在测试数据集上的分类准确率达到 98.5%,其值为 0.97–0.98。该结果与表 3中的混淆矩阵及统计稳定性分析相对应。引入 Transformer 编码器增强了架构的时间建模能力,而卷积神经网络(CNN)则从输入的频谱图中提取出具有区分性的空间特征。
除了分类性能外,还评估了其他与系统相关的特性。首先,基于边缘设备的实现推理延迟不超过 20 ms,能够实现实时异常检测。其次,所提出的系统通过减少通信需求,有助于提高能效。最后,所提出的可解释人工智能(Explainable AI)框架提供了 SHAP 可解释性,使领域专家更易于分析模型。MIMII 数据通过短时傅里叶变换(STFT)转换为频谱图,窗长为 1024,步长为 512,快速傅里叶变换(FFT)...
访问受限。请登录或开始试用以查看此内容。
讨论
实验结果表明,所提出的CNN-Transformer架构通过有效整合空间与时间特征学习,在性能上优于单独的算法。根据消融实验,尽管CNN能够从频谱图中提取基于频率的判别性特征,但Transformer编码器通过捕捉声学信号中的长距离时间依赖关系,进一步提升了模型性能。此外,混淆矩阵显示假阴性极少,表明所提出的模型能够有效识别机器异常。该架构实现了更优的分类结果,准确率达到98.5%,召回率达到99.02%。这一结果在工业故障检测系统中至关重要,因为模型必须尽可能避免遗漏任何故障设备。实验结果表明,所提出的具备可解释人工智能(XAI)能力的CNN-Transformer框架,成功实现了高异常检测准确率、可解释性与实时边缘部署的结合。两个模块的协同作用实现了从声学数据中同时提取空间和时间特征,而SHAP解释方法则增强了模型的可解释性与可靠性。这些结果与工业5.0的理念一致,后者强调以人为中心的决策、可持续性以及信息域与物理域之间的协同。然而,仍需通过其他工业数据集进行更全面的评估,并开展实际部署,以评估所提出方法的泛化能力。
采用SHAP实现可解释性不仅提高了系统的效率,还显著增强了对...
访问受限。请登录或开始试用以查看此内容。
披露
仅使用人工智能工具(ChatGPT)协助语言编辑,以改进语法、清晰度和可读性。未使用人工智能工具生成科学数据、开展实验、分析结果、解释研究发现或得出科学结论。所有科学内容、数据分析、解释以及稿件的最终版本均由作者独立审阅、核实和批准,作者对本工作的准确性和完整性负全部责任。作者声明无任何利益冲突。
致谢
资金来源:本工作得到陕西省高等教育教学改革重点项目的资助(项目编号:23BG053);陕西工业职业技术学院高层次人才科研启动基金(项目编号:BSJ-2023-08);以及陕西工业职业技术学院科研项目(项目编号:2024YKYB-006)。作者衷心感谢中国陕西省咸阳市陕西工业职业技术学院和中国西安市西安交通工程学院为本研究提供的设施条件和机构支持。
访问受限。请登录或开始试用以查看此内容。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| 社会支持量表 | 已发表的学术量表;最初由 Park 开发,后经 Kim 修订和补充 | 25项版本;5点式李克特量表应答格式;无商业目录号 | 测量职前幼儿教师在情感支持、信息支持、物质支持和评价支持方面的感知社会支持水平。总体 Cronbach’α = 0.96。 |
| 教师自我效能感量表 | 已发表的学术量表;最初由Enochs和Riggs开发;中文版适应性研究版本 | 25项版本;5点式李克特评分格式;无商业目录号 | 在中国职前幼儿教育背景下,评估教师效能,涵盖一般教师自我效能与个人教师自我效能。总体Cronbach’α = 0.96。 |
| 教师-儿童互动量表 | 已发表的学术量表;由 Lee 开发,并经研究专家组审阅以适用于中国 | 30项版本;5点式李克特量表应答格式;无商业目录号 | 评估教师自我报告的师幼互动能力,而非观察到的课堂互动质量。包含情感互动、言语互动和行为互动;整体Cronbach’α = 0.94。 |
| 人口统计信息表 | 四川文理学院与大邱大学合作研究团队 | 自定义研究问卷部分;无商业货号 | 收集的参与者特征包括性别、教育背景、职业类别、实习地点、实习时长、实习类型和幼儿园类型。 |
| 参与者信息与知情同意书脚本 | 研究团队;经大邱大学研究伦理委员会批准 | 伦理批准编号:XXX;需提供本地批准记录以供核实 | 在问卷发放前使用,用于向学前教育准教师参与者说明研究目的和调查内容,并获取其知情同意。 |
| 试点调查问卷包 | 研究团队与专家组 | 6月使用的试用版本–2024年5月;无商业目录号 | 在50名职前幼儿教育教师中对职业认知量表、社会支持量表、教师自我效能感量表、师幼互动量表及人口统计学问卷条目的清晰性与适用性进行了预试验。 |
| 专家小组评审程序 | 研究团队;由两位学前教育教授、一位幼儿园园长、三位实习督导及研究团队组成的专家组 | 基于共识的内容评审;无商业型号 | 用于在正式调查前对量表条目进行修订,以消除歧义,确保适宜性、语义清晰性、发展适宜性及文化相关性。 |
| 现场打印的问卷表格 | 研究团队;本地机构调查用品 | 纸质调查问卷;无商业目录号 | 用于现场问卷发放。在最终样本中,合并线上问卷前共获得336份有效现场问卷。 |
| 微信 | Tencent | 微信移动应用程序;版本应根据6月份使用的设备/应用程序记录进行核实–2024年7月 | 用作问卷发放的在线分发渠道;通过在线/微信途径共收集到27份完成的电子问卷。 |
| 电话与面对面招募流程 | 研究团队 | 标准化招募流程;无商业目录编号 | 用于联系相关机构/参与者,说明研究目的和调查内容,并在发放问卷前协助获得知情同意。 |
| SPSS Statistics | IBM | 版本 27.0 | 用于描述性统计、皮尔逊相关系数、Cronbach’α信度分析、使用偏度和峰度进行正态性检验,以及哈曼单因素检验’常用方法偏差的单因子检验。 |
| SPSS Amos | IBM | 版本 26.0 | 用于验证性因子分析、结构方程模型构建、多组测量不变性检验、间接效应的Bootstrap检验以及竞争模型比较。 |
| Microsoft Excel | Microsoft | Microsoft 365 Excel 或本地安装的 Excel 版本;提交前请确认确切的本地版本构建信息 | 推荐/用作整理编码后的调查数据、数据字典、补充表格以及 JoVE 材料表的工作簿环境。具体本地版本应由作者核实。 |
| 结构方程模型拟合指数标准 | 已发表的方法学指南;稿件中引用了 Schreiber 等人和 Kline 的参考文献 | 无商业货号;在统计分析计划中应用的标准 | 定义并报告模型拟合指标,包括卡方统计量、卡方值除以自由度、Tucker-Lewis 指数、比较拟合指数、调整后的拟合优度指数、增值拟合指数、近似误差均方根、标准化残差均方根。 |
| Bootstrap中介效应检验程序 | SPSS Amos / 研究团队统计分析计划 | 5,000 次自助抽样;95% 偏差校正置信区间 | 用于通过教师效能检验间接关联。当95%偏差校正置信区间不包含零时,认为间接效应具有显著性。 |
| 测量不变性检验程序 | SPSS Amos / 研究团队统计分析计划 | 多组验证性因子分析 ΔCFI &< .010 和 ΔRMSEA &< .015 标准 | 用于在解释合并的结构方程模型(SEM)估计结果之前,评估性别、项目类型、实习时长和机构之间的构形、度量和标量不变性。 |
参考文献
- Fraga-Lamas P, Barros D, Lopes SI, Fernández-Caramés TM. Mist and edge computing cyber-physical human-centered systems for Industry 5.0: A cost-effective IoT thermal imaging safety system. Sensors (Basel). 2022;22(21):8500.
- Breque M, De Nul L, Petridis A. Industry 5.0: Towards a sustainable, human-centric and resilient European industry. Brussels: European Commission; 2021:https://research-and-innovation.ec.europa.eu/knowledge-publications-tools-and-data/publications/all-publications/industry-50-towards-sustainable-human-centric-and-resilient-european-industry_en.
- Sariişik G, Demir S. Industry 5.0: A human-centric paradigm for sustainable and resilient industrial transformation. Journal of Social Perspective Studies. 2025;2(2):50–66.
- Liu X et al. Evaluating the interactions of multi-dimensional value for sustainable product-service systems with a grey DEMATEL-ANP approach. J Manuf Syst. 2021;60:449–458.
- Di Nardo M et al. The maintenance in Industry 4.0: Assistance and implementation [conference paper]. Presented at: 32nd European Safety and Reliability Conference; Dublin, Ireland; 2022. p. 2286–2292. https://hdl.handle.net/20.500.12607/48222.
- Kagermann H, Lukas WD, Wahlster W. Industrie 4.0: Mit dem Internet der Dinge auf dem Weg zur 4. industriellen Revolution. VDI Nachrichten. 2011;(13):2–3. https://www.dfki.de/fileadmin/user_upload/DFKI/Medien/News_Media/Presse/Presse-Highlights/vdinach2011a13-ind4.0-Internet-Dinge.pdf.
- Council for Science, Technology and Innovation. Report on the Fifth Science and Technology Basic Plan. Tokyo: Cabinet Office, Government of Japan; 2015:https://www8.cao.go.jp/cstp/kihonkeikaku/5basicplan_en.pdf.
- Nahavandi S. Industry 5.0—A human-centric solution. Sustainability (Basel). 2019;11(16):4371.
- Paschek D, Mocan A, Draghici A. Industry 5.0—The expected impact of the next industrial revolution [conference paper]. Presented at: MakeLearn and TIIM International Conference; Piran, Slovenia; 2019. p. 125–132. https://toknowpress.net/ISBN/978-961-6914-25-3/papers/ML19-017.pdf.
- Maddikunta PKR et al. Industry 5.0: A survey on enabling technologies and potential applications. J Ind Inf Integr. 2022;26:100257.
- Longo F, Padovano A, Umbrello S. Value-oriented and ethical technology engineering in Industry 5.0: A human-centric perspective for the design of the factory of the future. Appl Sci (Basel). 2020;10(12):4182.
- Gong Y, Chung YA, Glass J. AST: Audio Spectrogram Transformer [conference paper]. Presented at: Interspeech 2021; Brno, Czech Republic; 2021. p. 571–575. https://www.isca-archive.org/interspeech_2021/gong21b_interspeech.html.
- Purohit H et al. MIMII dataset: Sound dataset for malfunctioning industrial machine investigation and inspection [conference paper]. Presented at: 4th Workshop on Detection and Classification of Acoustic Scenes and Events; New York, NY; 2019. p. 209–213. https://dcase.community/documents/workshop2019/proceedings/DCASE2019Workshop_Purohit_21.pdf.
- Hallioui A et al. A review of sustainable total productive maintenance. Sustainability (Basel). 2023;15(16):12362.
- Vasić S et al. Identification of criteria for enabling the adoption of sustainable maintenance practice: An umbrella review. Sustainability (Basel). 2024;16(2):767.
- Barredo Arrieta A et al. Explainable artificial intelligence: Concepts, taxonomies, opportunities, and challenges toward responsible AI. Inf Fusion. 2020;58:82–115.
- Lundberg SM, Lee SI. A unified approach to interpreting model predictions [conference paper]. Presented at: 31st International Conference on Neural Information Processing Systems; Long Beach, CA; 2017. p. 4765–4774. https://papers.nips.cc/paper/7062-a-unified-approach-to-interpreting-model-predictions.
- Du M, Liu N, Hu X. Techniques for interpretable machine learning. Commun ACM. 2020;63(1):68–77.
- Sarker IH. Machine learning: Algorithms, real-world applications and research directions. SN Comput Sci. 2021;2(3):160.
- Saxe A, Nelli S, Summerfield C. If deep learning is the answer, what is the question? Nat Rev Neurosci. 2021;22(1):55–67.
- Piccialli F et al. A survey on deep learning in medicine: Why, how and when? Inf Fusion. 2021;66:111–137.
- Li Z et al. A survey of convolutional neural networks: Analysis, applications, and prospects. IEEE Trans Neural Netw Learn Syst. 2022;33(12):6999–7019.
- Gil M, Albert M, Fons J, Pelechano V. Engineering human-in-the-loop interactions in cyber-physical systems. Inf Softw Technol. 2020;126:106349.
- Krugh M, Mears L. A complementary cyber-human systems framework for Industry 4.0 cyber-physical systems. Manuf Lett. 2018;15:89–92.
- Jasiulewicz-Kaczmarek M et al. Recent advances in smart and sustainable maintenance [invited-session proposal]. Presented at: 10th IFAC Conference on Manufacturing Modelling, Management and Control; Nantes, France; 2022. https://hub.imt-atlantique.fr/mim2022/wp-content/uploads/2021/12/7a519.pdf.
- Jasiulewicz-Kaczmarek M, Gola A. Maintenance 4.0 technologies for sustainable manufacturing—An overview. IFAC-PapersOnLine. 2019;52(10):91–96.
- Saihi A, Ben-Daya M, As’ad RA. Maintenance and sustainability: A systematic review of modeling-based literature. J Qual Maint Eng. 2023;29(1):155–187.
- Bastas A. Sustainable manufacturing technologies: A systematic review of the latest trends and themes. Sustainability (Basel). 2021;13(8):4271.
- Franciosi C, Iung B, Miranda S, Riemma S. Maintenance for sustainability in the Industry 4.0 context: A scoping literature review. IFAC-PapersOnLine. 2018;51(11):903–908.
- Franciosi C et al. Measuring maintenance impacts on the sustainability of manufacturing industries: From a systematic literature review to a framework proposal. J Clean Prod. 2020;260:121065.
- Vrignat P, Kratz F, Avila M. Sustainable manufacturing, maintenance policies, prognostics and health management: A literature review. Reliab Eng Syst Saf. 2022;218:108140.
- Durán O, Aguilar J, Capaldo A, Arata A. Fleet resilience: Evaluating maintenance strategies in critical equipment. Appl Sci (Basel). 2021;11(1):38.
- Ciccarelli M, Papetti A, Germani M. Exploring how new industrial paradigms affect the workforce: A literature review of Operator 4.0. J Manuf Syst. 2023;70:464–483.
- Madzik P et al. Human-centricity in Industry 5.0—Revealing hidden research topics by unsupervised topic modeling using latent Dirichlet allocation. Eur J Innov Manag. 2025;28(1):113–138.
- Farivar F, Klarin A, Kanani-Moghadam V. Industry 5.0: A socio-technical system perspective on human agency and institutional legitimacy. J Manag Organ. 2026;32(4):1168–1189.
- Karki BR, Porras J. Digitalization for sustainable maintenance services: A systematic literature review. Digit Bus. 2021;1(2):100011.
- Santiago RAdF et al. Data-driven models applied to predictive and prescriptive maintenance of wind turbines: A systematic review of approaches based on failure detection, diagnosis, and prognosis. Energies (Basel). 2024;17(5):1010.
- Carvalho JN, Silva FR, Nascimento EGS. Challenges of the biopharmaceutical industry in the application of prescriptive maintenance in the Industry 4.0 context: A comprehensive literature review. Sensors (Basel). 2024;24(22):7163.
- Santos ACdJ, Cavalcante CAV, Wu S. Maintenance policies and models: A bibliometric and literature review of strategies for reuse and remanufacturing. Reliab Eng Syst Saf. 2023;231:108983.
- Orošnjak M, Brkljač N, Ristić K. Fostering cleaner production through the adoption of sustainable maintenance: An umbrella review with a questionnaire-based survey analysis. Clean Prod Lett. 2025;8:100095.
- Ji Z, Zhou Y, Wang B, Zang J. Human–cyber–physical systems in the context of new-generation intelligent manufacturing. Engineering (Beijing). 2019;5(4):624–636.
- Wang B et al. Toward human-centric smart manufacturing: A human–cyber–physical systems perspective. J Manuf Syst. 2022;63:471–490.
- Jiao J, Zhou F, Gebraeel NZ, Duffy V. Towards augmenting cyber-physical-human collaborative cognition for human–automation interaction in complex manufacturing and operational environments. Int J Prod Res. 2020;58(16):5089–5111.
- Yilma BA, Panetto H, Naudet Y. Systemic formalisation of cyber-physical-social systems: A systematic literature review. Comput Ind. 2021;129:103458.
- Zhou Y, Yu FR, Chen J, Kuo YH. Cyber-physical-social systems: A state-of-the-art survey, challenges and opportunities. IEEE Commun Surv Tutor. 2020;22(1):3
访问受限。请登录或开始试用以查看此内容。