本研究提出了一种用于电网的成本预测混合模型,该模型结合了物理成本定额、动态宏观经济/技术调整以及基于XGBoost的残差补偿。该模型的平均绝对百分比误差(MAPE)达到2.34%,在准确性和可解释性之间实现了平衡,满足了电价制定过程中对监管透明度的需求。
需要JoVE订阅才能观看此内容。 请登录或开始免费试用
本文内容
摘要
摘要
全球能源转型及持续进行的电力市场改革,要求电网企业平衡可靠供电与日益严格的输配电价监管。基于历史数据外推的传统预算方法往往无法反映资产运营的物理基础,而数据驱动的机器学习模型虽能实现较高的预测精度,却缺乏监管成本核查所需的透明度。为解决预测精度与可解释性之间的权衡问题,本研究提出一种基于成本定额的混合成本预测模型。该框架以标准化运行定额作为物理预算的基准,并引入由宏观经济状况和技术进步驱动的定额动态演化机制。采用极端梯度提升(XGBoost)模型捕捉基于定额估算之外的非线性残差,同时利用SHAP(Shapley加性解释)方法解析关键成本驱动因素的贡献。该模型在中国某省级电网16年的匿名化运行数据上进行了验证,平均绝对百分比误差(MAPE)为2.34%,相较于SARIMAX、独立XGBoost和Attention-LSTM模型,预测误差分别降低了61.8%、46.6%和34.1%。所提出的框架将工程成本定额原理与可解释人工智能相结合,既提供了准确的长期成本预测,也为监管允许成本核查提供了一个透明的决策支持工具。
引言
全球能源转型正通过整合分布式可再生能源发电、日益频繁的极端天气事件以及物联网技术的广泛应用,重塑电力系统资产管理与运行实践,这些变化均要求更高的运行灵活性和维护资源,以确保系统可靠性1,2。与此同时,电力监管机构已通过诸如英国的RIIO机制和美国联邦能源监管委员会的收益率审查框架,加强了对输配电价的监管,强调成本论证的透明度3。中国同样采用了“准许成本加合理收益”的监管机制,要求电力企业证明工程活动与财务支出之间的明确关联4。然而,电力企业往往缺乏将实物资产运行与成本预测相连接的透明量化工具,限制了监管机构进行成本核实的有效性5。
现有的预测方法在此环境中存在重要局限性6。传统方法(包括增量预算法和基于ARIMA的模型)假设历史模式相对稳定,在经济波动或极端天气引起的结构性变化下,通常表现不佳7。相比之下,LSTM和Transformer架构等现代机器学习模型在短期预测中具有较高的预测精度,但缺乏监管决策所需的工程可解释性8,9。尽管近期的一些混合预测方法结合了统计学与机器学习技术,但通常忽略了支撑电网会计系统的标准化工程造价定额10。为克服这些局限性,本研究提出一种定额驱动的混合预测框架,将动态定额演化与基于机器学习的残差校正相结合,在保持工程可解释性的同时提升预测精度。
一个重要的研究方向源于自然垄断行业的激励性监管机制,包括英国的RPI-X机制和中国的准许成本核定框架11。这些研究主要采用数据包络分析(DEA)和随机前沿分析(SFA)来评估运营效率12。以往的研究探讨了资本支出(CAPEX)、运营支出(OPEX)与成本效率之间的长期关系,以支持电价监管13,14。尽管这些方法提供了有价值的宏观经济洞察,但其输出结果通常表现为相对效率评分,而非适用于年度预算编制的货币化预测值15,16。此外,前沿模型通常假设实物资产结构和运营条件相对稳定,因而难以捕捉由资产老化、基础设施更新或需求快速增长所引发的突发性成本变化17,18。
第二个研究方向聚焦于基于统计学和人工智能的预测模型。早期研究采用多元线性回归以及带外生变量的自回归积分滑动平均模型(ARIMAX)进行成本预测19。近年来,支持向量回归、随机森林、XGBoost、LSTM 和 Transformer 模型通过挖掘非线性关系和高维特征空间,显著提升了预测性能20,21,22。这些方法通常引入宏观经济指标,如电力需求、生产者价格指数(PPI)和气候变量23。然而,电网运行成本源于工程活动、资产老化、维护计划和管理决策,而不仅仅取决于宏观经济变量24。因此,纯数据驱动模型往往表现为“黑箱”,在监管审查或准许成本核验过程中难以解释预测结果25,26。
工程定额管理为应对这一挑战提供了潜在解决方案27。基于活动的成本核算(ABC)长期以来依赖标准化的作业定额,以估算常规电网运行中的人工、材料、设备及维护需求28。中国主要电力公司已建立涵盖巡检、维护、测试、修理和设备更换等作业的全面定额数据库。然而,这些工程标准主要用于项目结算和审计,而非动态的长期预测29,30。此外,定额标准通常每数年才修订一次,难以及时响应商品价格变动、技术进步和运行实践的变化31。将定额系统应用于数以百万计的分布式资产,也为大规模预测带来了显著的计算挑战32。
尽管在统计预测、机器学习和工程成本管理方面已取得显著进展,但目前尚无现有框架能够有效整合标准化工程造价定额、动态宏观经济调整以及可解释的机器学习,以构建统一的监管成本验证预测模型。本研究假设,将动态变化的造价定额与基于XGBoost的残差学习相结合,可在提高长期预测准确性的同时,保持监管决策所需的工程透明度。为验证该假设,开发了一种混合型定额驱动的预测框架,该框架集成了物理成本建模、宏观经济与技术调整机制、XGBoost残差补偿以及基于SHAP的模型解释方法。所提出的方法旨在为现代电力市场监管下的准许成本验证,提供既准确的长期成本预测结果,又具备可解释性的透明证据支持。
访问受限。请登录或开始试用以查看此内容。
方案
本研究使用了从中国东部某省级电网收集的匿名化运营和财务数据。所有数据在分析前均已汇总并去识别化,未包含任何可识别个人身份或敏感的个体层面信息。因此,本研究无需伦理审批。数据获取与分析遵守了适用于电力行业信息的数据保护法规及机构间协议。
预测框架概述
为了融合基于物理模型与数据驱动的预测方法,开发了一种将工程造价定额与机器学习相结合的混合预测框架。该框架并非简单地组合多种算法,而是遵循以下原则:由物理模型建立基础预测,机器学习则用于补偿残差误差。这种设计确保了预测过程以电网生产与运行活动背后的物理机制为基础,而非仅仅依赖历史成本的外推。
该框架首先建立电力系统资产、标准化运行活动与财务成本科目之间的层级映射关系。生产与运营成本被视为物理资产在常规活动中所消耗资源的货币表现形式,这些物理资产包括变电站、输电线路、配电馈线、计量设备和数字化巡检设备,常规活动则包括巡检、维护、测试、修理和更换等。成本定额作为可度量的工程工作量与相应财务支出之间的连接纽带。
如图1所示,成本定额在整个资产运营和维护过程中作为标准化的核算单位而嵌入,而非抽象的财务分配规则。底层资产工作量被转换为标准化的运营定额,随后映射至成本类别,包括人工、材料、施工设备、外包服务和应急物资。这种分层映射在整个预测过程中保持了工程可解释性和监管可追溯性,并为构建静态基准定额模型提供了物理基础。
方法学工作流程概述
所提出的预测框架包含三个依次进行的阶段:(1)利用资产级别工作负载配额构建物理基线,(2)通过宏观经济和技术调整实现成本配额的动态演化,(3)基于机器学习的残差补偿,以捕捉系统性的非线性效应。如图1所示,该框架建立了从底层资产和标准化运营活动到生产与运营成本预测的分层映射。各阶段的实施细节将在下述小节中进行描述。
基于资产级工作负载的物理基准成本模型
电网的生产与运营成本 Ctotal 包括与多项业务活动相关的支出,如变电站运行、输电线路维护、配电网管理、客户服务以及支持系统的开销。在本研究中,基准运营成本假设由各项标准化运营活动所产生的工作量及其相应的成本定额决定。
静态基线成本的计算公式如下:
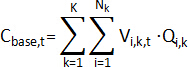 (1)
其中 Vi,k,t 表示与工作量相关的 i- 商业类别中的资产或运营任务 k 在周期期间 t,以及 Qi,k 表示由工程造价定额体系所定义的相应标准化单位成本。业务类别包括变电站检修、输电线路巡检、配电网运行及客户服务等主要运营职能。双重求和用于汇总所有标准化运营活动的成本,以估算维持电网正常运行所需的理论基准支出。
公式(1)通过将标准化的运营活动直接映射到成本账户,建立了工程工作量与财务支出之间的物理关系。与纯统计预测模型不同,该公式提供了一个可解释的工程基准,作为后续动态配额调整和基于机器学习的残差校正的基础。该方程基于中国省级电网企业所采用的运营实践和成本配额体系而建立。表1总结了公式(1)中使用的符号,包括工作量(Vi,k,t)、标准化单位成本(Qi,k)、运营任务数量(Nk)以及业务类别索引(k)。
外部环境扰动下配额的动态演化机制
标准化成本定额(Qi,k)提供了一个具有物理可解释性的基准,但未考虑宏观经济条件变化或技术进步的影响。为了提高其长期适用性,引入了一种动态演化机制,以根据价格通胀和技术驱动的效率提升对基准定额进行调整。
第一个调整项用于反映由宏观经济通货膨胀引起的采购成本变化。电力系统的运行与维护高度依赖于大宗材料,包括铜、铝和硅钢,这些材料的价格与生产者价格指数(PPI)的波动密切相关。由于  是一个基准值为100的指数,需首先将其转换为标准化的通货膨胀率:
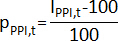 (2)
基于此,价格修正函数  定义为:
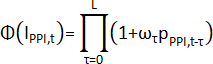 (3)
其中  是一个长度为 L 的滞后权重向量,满足
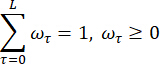
滞后期结构反映了宏观经济通胀对电网供应链采购成本的滞后传导效应。将生产者价格指数(PPI)转换为标准化的通货膨胀率,能够在保留价格变化累积效应的同时,避免直接使用指数值所带来的量纲偏差。公式(2)和(3)借鉴自已建立的宏观经济通胀调整模型,其中滞后期结构针对电力行业的采购周期进行了校准33,34。
通过成本降低因子纳入了技术进步,该因子反映了由于无人机巡检、智能机器人和数字化维修技术等进步所带来的运行效率提升。技术调整因子定义为:
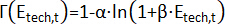 (4)
在本部分中,α 和 β 是通过非线性最小二乘法,基于历史面板数据估计得出的经验弹性系数。为确保技术进步因子始终表示单位定额成本的合理降低,在参数估计过程中对 0 < Γ(Etech,t) ≤ 1 进行约束。需要注意的是,该因子主要反映由成熟技术替代所带来的长期效率提升。公式(4)为本文原创,借鉴了能源技术成本文献35,36 中的学习曲线概念,并将其应用于电网维护作业。在数字化设备部署初期可能产生的额外成本,例如新旧系统并行运行、平台集成、通信测试以及附加维护等,不会被强制从基准定额中扣除;而是由后续的机器学习残差补偿模块进行识别:
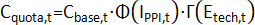 (5)
其中,Cbase,t 表示根据底层资产工作负载和标准化运营成本定额计算得出的静态基准成本; 反映了宏观价格波动对材料、设备及外部服务价格的传导效应;Γ(Etech,t) 则体现了技术成熟后基于效率提升所带来的单位运维成本降低。通过上述动态演化机制,定额基准不再局限于静态核算基础,而是能够随着经济环境和技术条件的变化进行自适应调整。公式(5)为本研究首次提出,标志着将价格与技术修正因素创新性地整合至定额基准框架之中。
配额约束下的系统性非线性残差捕获
尽管存在复杂的进化修正,配额模型在面对不可预测的灾害性天气干扰和突发政策指令时仍不可避免地产生系统性偏差,例如在临时降低资费期间客户投诉处理成本的增加。这种偏差形成了方程两侧的残差项:
Rt = Cactual,t - Cquota,t (6)
由于传统物理规律无法解释这一方面,机器学习可弥补这些局限性。为避免高维特征带来的“维度灾难”,本研究采用基于决策树集成的XGBoost算法对非线性关系 Rt37,38 进行建模。定义了一个强干扰特征矩阵 Xt,其中包括年极端冰冻日数 Dice 等气象特征以及宏观政策强度。
对于由回归树构成的非线性补偿器,预测残差  的生成逻辑可表示为39:
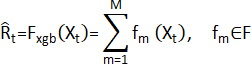 (7)
其中,F 表示所有可能的分类与回归树结构的空间。为了平衡拟合精度与防止过拟合,构建并在第 m 次迭代中最小化一个包含结构复杂度惩罚项的正则化目标函数:
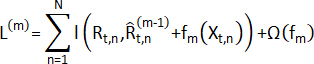 (8)
其中, 是一个凸损失函数,用于衡量真实残差与预测残差之间的差异。本文采用Huber损失以增强模型对异常峰值支出的鲁棒性。正则化项
 用于约束树结构的复杂度,其定义为:
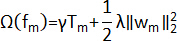 (9)
其中 Tm 表示第 m 棵树中叶节点的数量,wm 表示相应的叶权重向量,γ 和 λ 分别表示叶节点数量惩罚系数和权重正则化系数。
最终的预测方程为:
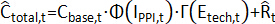 (10)
进一步扩展如下:
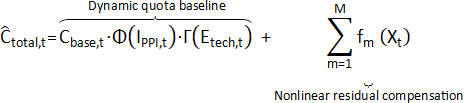 (11)
上述公式从数学上表示了所提出的预测模型的闭环结构。最终的生产与运营成本需求并非由机器学习模型直接生成,而是通过将机器学习模块识别的非线性残差补偿叠加到动态定额基准上而获得。其中,价格和技术因素主要反映定额基准的动态演变,而诸如气候冲击、政策扰动以及维修事件激增等难以通过规则显式刻画的因素,则由机器学习残差补偿模块捕捉。公式(10)和(11)为本研究首次提出,将物理基准与基于机器学习的残差捕捉融合为一个统一的预测框架。
图2 显示,所提出模型的预测结果展现出清晰的分层生成逻辑。一方面,基准定额为成本需求提供了稳定、透明且可审计的物理基础;另一方面,价格调整、技术效应以及外部冲击残差使模型能够适应复杂环境下的动态变化。与直接输出预测值的黑箱模型相比,这种分解结构能够清晰揭示“成本为何上升或下降”,从而增强模型结果在预算审查及输配电价监管中的可解释性。
数据来源与收集方法
理论模型必须通过实证数据进行严格验证,以证明其实际应用价值。由于电力行业核心财务数据涉及国家基础设施运营的敏感信息,本研究从中国东部一个典型省级电网(为方便起见,简称E-Grid)提取了高精度、匿名化的月度财务数据,时间跨度为2010年至2025年连续16个日历年。该省份经历了从传统重工业驱动增长向高端制造业转型的典型经济周期,电网资产规模的年均复合增长率达到7.4%。因此,其成本结构的复杂演变对其他快速发展的电网系统具有潜在参考意义。数据来源于三个主要渠道:(1)内部运行维护日志,记录资产层级的工作负荷、巡检频率和维修事件;(2)财务会计系统,提供涵盖人工、材料、设备和外包服务的月度成本报表;(3)外部环境数据库,包括中国气象局的气象记录和国家统计局的宏观经济指标。
质量控制与缺失数据处理
针对从多源系统整合的130余项初始指标,实施了严格的质量控制流程。缺失数据点占总观测值的比例不足3%,针对具有时间趋势的连续变量采用线性插值法处理,分类指标则采用众数填补法。使用四分位距(IQR)法识别异常值,对于超过第三四分位数3.0倍IQR的数值,采用 Winsorization 方法将其截断至第99百分位数,以保障数据完整性并减轻极端值带来的偏差。
样本量考虑因素
该数据集包含192个月度观测值(2010年1月至2025年12月),其中156个观测值(2010–2022年)用于训练与验证,36个观测值(2023–2025年)保留用于样本外测试。尽管该样本量对于深度学习应用而言相对较小,但适用于XGBoost算法,该算法通过其正则化和树剪枝机制,专为在中小规模表格数据上实现良好性能而设计。为降低潜在的过拟合风险,采取了以下措施:(1)采用严格的正则化惩罚(γ = 0.1,λ = 1.0);(2)设置50轮的早停耐心值(early stopping);(3)保守的树深度限制(max depth = 5)。这些措施共同确保了模型在有限样本量下的稳定性与泛化能力。
数据分割与多源异构整合
为进行严格测试,将2010年1月至2022年12月的数据划为训练-验证区间,共包含156个观测值,用于训练配额演化因子和配额补偿残差网络。2023年1月至2025年12月被保留作为独立的样本外测试集,共包含36个观测值。为何选择这一时期作为最终测试阶段?原因是这三年恰逢新型电力系统建设加速,叠加大规模与厄尔尼诺现象相关的极端高温事件,以及分布式可再生能源发电的快速且不均衡增长,导致电网在物资供应链和维修人力调配方面面临前所未有的压力。
科学筛选并定量定义成本驱动因素,是确保机器学习残差网络能够有效捕捉系统性波动的基础。基于电力系统标准作业成本的管理逻辑,本研究突破了传统财务预测仅依赖历史现金流的单一维度,转而利用原始运行日志和外部系统账目,从物理资产规模、运行维护状况、宏观经济演变以及外部气候环境四个核心边界重构特征工程。在实际建模过程中,针对多源系统整合产生的130余项原始指标,本研究采用皮尔逊相关性检验剔除高度共线性的冗余变量,阈值设定为 |r| > 0.85。结合资深电网专家的先验知识,最终选定42项核心输入特征,构成特征矩阵 Xt。为清晰呈现输入张量的底层数据结构与分布情况,表2从上述四个评估维度中选取12项具有代表性的核心特征,并汇总其在观测期内的描述性统计结果。
为进一步阐明多源特征系统的空间拓扑基础,图3展示了所研究的省级电网的匿名化拓扑示意图。该图叠加了不同电压等级的变电站、输电走廊、分布式可再生能源集群、负荷中心以及典型的环境扰动区域。该拓扑有助于解释为何生产与运营成本共同受到资产规模、网络结构、应急抢修强度以及外部气候冲击的影响。同时,它也为XGBoost补偿模块中所使用的残差驱动变量提供了空间解释依据。
表2显示,不同业务维度的解释变量呈现出明显不同的统计形态。代表企业内生发展动力的实物资产变量,如变电站容量和线路长度,其标准差相对稳定,偏度值集中在0.1至0.8之间。整体数据结构近似正态分布,客观反映了电网基础设施建设周期中稳定发展的属性。与此形成鲜明对比的是表格底部的气象及外部环境扰动变量。例如,过去90天内高温预警日累计数量和线路跳闸影响指数均表现出极强的右偏特征,其偏度值分别为2.15和2.45。这种典型的重尾分布证实了电网实际运维中一个不容忽视的客观痛点:尽管极端天气灾害在年度时间尺度上发生频率相对较低,但一旦触发,往往会导致维修人工投入和备品备件消耗呈指数级增长。从另一个角度看,这些多源特征在分布上表现出的高度非均匀性和极值偏态,揭示了传统线性时间序列模型(如ARIMAX)在拟合复杂电网成本时的理论局限性,此类模型依赖于正态性和同方差性假设。这不仅进一步论证了在物理核算基准之上引入机器学习模块的合理性,也为本文选择XGBoost树模型提供了坚实的统计支持,该模型能够高效处理稀疏特征分布和非线性映射,以逼近成本残差。
超参数优化与评估系统设置
在确定特征输入空间后,模型超参数的设置直接影响残差逼近网络的拟合性能。由于XGBoost补偿网络涉及多个参数,包括树的深度(max depth)、学习率以及正则化惩罚项,且这些参数之间存在非线性相互作用,传统的网格搜索方法不仅计算复杂度高,而且在高维空间中容易陷入局部最优。因此,本研究在参数调优过程中引入了树结构Parzen估计器(Tree-structured Parzen Estimator, TPE),这是一种贝叶斯优化方法。TPE算法能够利用先前评估结果的损失函数反馈,动态引导后续采样方向。通过构建目标变量的后验核密度估计(KDE),自适应地缩小参数搜索范围,使模型能够在较低计算成本下逼近全局最优的超参数配置。TPE优化的目标是在100次迭代中最小化验证集的均方根误差(RMSE),若连续50轮无性能提升则提前终止。
在内部验证集上完成参数优化后,为客观评估各模型在样本外测试集上的最终性能,并满足监管机构对成本验证的定量评估要求,本研究采用平均绝对百分比误差(MAPE)来量化预测序列的相对偏差。同时,为应对实际操作中控制极端成本预测失败的需求,还引入了均方根误差(RMSE),以对较大的误差施加更强的惩罚。最后,决定系数 R2 用于量化回归模型对真实目标方差的整体解释能力。
各指标的数学定义如下:
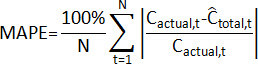 (12)
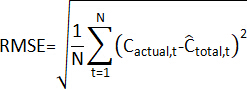 (13)
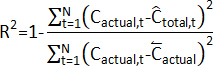 (14)
其中, 表示在时段 t 的实际生产运营成本,
 表示模型预测的成本,
 表示测试样本中的平均实际成本,N 为测试集中的样本数量。
访问受限。请登录或开始试用以查看此内容。
结果
全景式降维预测准确性比较
当所有经过基于树结构帕森估计器(Tree-structured Parzen Estimator, TPE)优化的模型在2023–2025年样本外测试集上进行评估时,该测试集包含了疫情后恢复期的波动以及极端高温事件,从而能够客观比较主流预测算法的性能。为实现严格且全面的评估,研究纳入了四种代表不同方法论的基准模型:代表传统金融预测的指数平滑法(Exponential Smoothing);代表线性季节性时间序列建模的SARIMAX模型;代表无配额约束纯数据驱动方法的独立XGBoost回归模型;以及广泛用于长序列预测的注意力机制增强型长短期记忆网络(Attention-LSTM)。
如表3所示,在2023–2025年样本外预测期间,所提出的定额-机器学习(Quota-ML)模型在预测生产与运营成本方面优于所有基准模型。该模型的平均绝对百分比误差(MAPE)为2.34%,相较于SARIMAX模型(6.12%)降低了61.8%的预测误差,相...
访问受限。请登录或开始试用以查看此内容。
讨论
本研究表明,将工业成本定额与机器学习相结合,可为长期电网成本预测提供一个可解释且准确的框架。结果表明,与气候相关的变量,特别是极端高温天数和线路跳闸影响指数,是成本残差的主要驱动因素,凸显了外部扰动对公用事业支出日益增加的影响。这些发现提示,与天气相关的成本不应再被视为偶然性运营支出,而应纳入专门的应急储备金,并将储备金的启用与预测的气候风险挂钩。线路跳闸影响被确认为关键成本驱动因素,进一步强调了预测性维护和状态监测策略在减少运行中断和成本波动方面的价值。
分析还表明,由于转型期间存在双系统并行运行,数字化转型在实施初期可能会增加运营成本,而非立即带来效率提升。这一发现提示公用事业部门应采用全生命周期成本评估方法,而非仅依据短期财务表现来评估数字化投资,并且在部署智能监控、高级配电管理或数字化变电站时,应预见到暂时性的成本重叠。所提出的残余补偿框架还可进一步扩展,用于估算数字化投资开始产生净成本节约的临界点,从而支持更有效的技术规划与投资决策。
除了在公用事业运营中的应用外,该框架还具有重要的监管意义。通过量化外部驱动因素对成...
访问受限。请登录或开始试用以查看此内容。
披露
所有作者均声明无利益冲突。
作者贡献:
Xiaohui Wang 提出并设计了本研究,建立了研究方法,进行了正式的数据分析,并起草了初稿。Tong Li 参与了数据整理、软件实现和验证工作。Yanchao Lu 参与了方法学的开发、研究实施和数据分析解释。Quanfeng Lv 提供了研究资源,监督了数据采集,并对稿件进行了关键性审阅。Fan Liu 对项目进行了总体监督,参与了研究概念的形成和结果解释,获取了研究经费,并对稿件进行了关键性修改。所有作者均审阅并批准了稿件的最终版本。
致谢
本工作由国家电网有限公司科技项目“生产运行成本分摊分析及异步优化技术研究”(项目编号:520600250029-183-ZN)资助。
访问受限。请登录或开始试用以查看此内容。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| 电网匿名月度核算数据集 | 中国东部某省级电网 | 不适用 | 包含192个观测值的匿名月度生产与运营成本数据集(2010–2025),涵盖实物资产、运维、宏观经济及环境数据。其中156个观测值用于模型构建,36个用于样本外测试。 |
| Matplotlib 绘图库 | Matplotlib 开发团队 | 3.5.2 | 用于生成论文图表及图形输出,包括模型性能图、拓扑结构可视化、残差诊断图、雷达图以及与SHAP相关的可视化摘要。 |
| NumPy 数值计算库 | NumPy 开发者 | 1.22.3 | 用于数值数组操作、矩阵计算及可重复性控制。在适用情况下采用固定的随机种子42。 |
| Pandas 数据处理库 | pandas 开发团队 | 1.4.2 | 用于数据导入、整合、重构、筛选和预处理,包括缺失值填补、时间序列对齐以及模型输入变量的准备。 |
| Python 编程环境 | Python 软件基金会 | 3.9.13 | 用于实现完整的预测工作流程,包括数据预处理、特征工程、模型训练、超参数优化、预测、统计检验及性能评估。 |
| Scikit-learn 机器学习库 | scikit-learn 贡献者 | 1.0.2 | 用于数据预处理、训练-验证集划分、辅助模型评估及统计分析,包括皮尔逊相关性分析和特定性能指标的计算。 |
| SciPy 科学计算库 | SciPy 贡献者 | 1.9.0 | 用于统计计算,包括皮尔逊相关性分析,以及异常值处理和缩尾处理的支持性程序。 |
| 树结构Parzen估计器实现 | Optuna 贡献者 | 3.1.0 | 采用贝叶斯优化方法调优XGBoost超参数,包括最大树深度、学习率和正则化参数。该树结构Parzen估计器通过开源Optuna包实现。 |
| XGBoost 软件库 | DMLC / XGBoost 贡献者 | 1.7.1 | 基于决策树的集成学习库,用于非线性残差补偿。该模型采用带有Huber损失函数和树复杂度惩罚项的正则化目标函数,如公式7–9所述。 |
参考文献
- Rao H, Li J, Sun X. Demand forecasting and allocation optimization of green power grid supply chain based on machine learning algorithm: A study based on the whole-process data of power grid materials. Sustainability. 2025;17(3):1247.
- Huang C, et al. Demand response for industrial micro-grid considering photovoltaic power uncertainty and battery operational cost. IEEE Trans Smart Grid. 2021;12(4):3043-3055.
- Phuangpornpitak N, Prommee W. A study of load demand forecasting models in electric power system operation and planning. GMSARN Int J. 2016;10:19-24.
- Nasir J, et al. A hybrid LMD–ARIMA–machine learning framework for enhanced forecasting of financial time series: Evidence from the NASDAQ Composite Index. Mathematics. 2025;13(15):2389.
- Matos C, et al. Model for integrating the electricity cost consumption and power demand into aggregate production planning. Appl Sci. 2022;12(15):7577.
- Valenzuela J, Mazumdar M, Kapoor A. Influence of temperature and load forecast uncertainty on estimates of power generation production costs. IEEE Trans Power Syst. 2000;15(2):668-674.
- Khan F, et al. A hybrid vector autoregressive model for accurate macroeconomic forecasting: An application to the US economy. Mathematics. 2025;13(11):1706.
- Fatema I, Kong X, Fang G. Electricity demand and price forecasting model for sustainable smart grid using comprehensive long short-term memory. Int J Sustain Eng. 2021;14(6):1714-1732.
- Singh AK, Ibraheem SK, Muazzam M, Chaturvedi DK. An overview of electricity demand forecasting techniques. Netw Complex Syst. 2013;3(3):38-48.
- Iftikhar H, et al. A novel hybrid framework for forecasting stock indices based on nonlinear time series models. Comput Stat. 2025;40(8):4163-4186.
- Jiang P, Li R, Lu H, Zhang X. Modeling of electricity demand forecast for power system. Neural Comput Appl. 2020;32(11):6857-6875.
- Chan SC, et al. Load/price forecasting and managing demand response for smart grids: Methodologies and challenges. IEEE Signal Process Mag. 2012;29(5):68-85.
- Hernandez L, et al. A survey on electric power demand forecasting: Future trends in smart grids, microgrids and smart buildings. IEEE Commun Surv Tutor. 2014;16(3):1460-1495.
- Zareipour H, Canizares CA, Bhattacharya K. Economic impact of electricity market price forecasting errors: A demand-side analysis. IEEE Trans Power Syst. 2009;25(1):254-262.
- Botterud A. Forecasting renewable energy for grid operations. In: Renewable Energy Integration. Academic Press; 2017:133-143.
- Mirowski P, Chen S, Ho TK, Yu CN. Demand forecasting in smart grids. Bell Labs Tech J. 2014;18(4):135-158.
- Sobu A, Wu G. Optimal operation planning method for isolated micro grid considering uncertainties of renewable power generations and load demand. In: IEEE PES Innovative Smart Grid Technologies [conference proceedings]. IEEE; 2012. Available at: https://ieeexplore.ieee.org/
- Han B, et al. Optimal design of an on-grid microgrid considering long-term load demand forecasting: A case study. Distrib Gener Altern Energy J. 2020;35:345-362.
- Tripathy SC. Demand forecasting in a power system. Energy Convers Manag. 1997;38(14):1475-1481.
- Adshead NS, Price DH. Demand forecasting and cost performance in a model of a real manufacturing unit. Int J Prod Res. 1987;25(9):1251-1265.
- Gellert A, et al. A study on forecasting electricity production and consumption in smart cities and factories. Int J Inf Manage. 2019;49:546-556.
- Hernández L, et al. A multi-agent system architecture for smart grid management and forecasting of energy demand in virtual power plants. IEEE Commun Mag. 2013;51(1):106-113.
- Klingler AL, Teichtmann L. Impacts of a forecast-based operation strategy for grid-connected PV storage systems on profitability and the energy system. Sol Energy. 2017;158:861-868.
- Ghalehkhondabi I, Ardjmand E, Weckman GR, Young WA. An overview of energy demand forecasting methods published in 2005–2015. Energy Syst. 2017;8(2):411-447.
- Aderibigbe AO, et al. Enhancing energy efficiency with AI: A review of machine learning models in electricity demand forecasting. Eng Sci Technol J. 2023;4(6):341-356.
- Arumugham V, et al. An artificial-intelligence-based renewable energy prediction program for demand-side management in smart grids. Sustainability. 2023;15(6):5453.
- Dudek G, Piotrowski P, Baczyński D. Intelligent forecasting and optimization in electrical power systems: Advances in models and applications. Energies. 2023;16(7):3024.
- Liu N, et al. A hybrid forecasting model with parameter optimization for short-term load forecasting of micro-grids. Appl Energy. 2014;129:336-345.
- Mohammad AA, et al. Mathematical and statistical modelling of electricity demand forecasting using artificial neural networks and SARIMA: Implications for energy supply chain planning. Alex Eng J. 2026;139:98-108.
- Singh AR, et al. A blockchain-enabled multi-agent deep reinforcement learning framework for real-time demand response in renewable energy grids. Energy Strateg Rev. 2025;62:101905.
- Lu R, et al. Data-driven real-time price-based demand response for industrial facilities energy management. Appl Energy. 2021;283:116291.
- Kondaiah VY, Saravanan B, Sanjeevikumar P, Khan B. A review on short-term load forecasting models for micro-grid application. J Eng. 2022;2022(7):665-689.
- Lee BL, Wilson C, Simshauser P, Majiwa E. Deregulation, efficiency and policy determination: An analysis of Australia's electricity distribution sector. Energy Econ. 2021;98:105210.
- Wang Y, et al. Transmission network expansion planning considering wind power and load uncertainties based on multi-agent DDQN. Energies. 2021;14(19):6073.
- Ding Q, Zhao H. Study on e-commerce logistics cost control methods in the context of COVID-19 prevention and control. Soft Comput. 2021;25(18):11955-11963.
- Duan Y, Xu Z, Chen H, Wang Y. Novel machine learning approach for enhanced smart grid power use and price prediction using advanced Shark Smell-tuned flexible support vector machine. Sci Rep. 2025;15(1):20909.
- Chen T, Guestrin C. XGBoost: A scalable tree boosting system. In: Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining [conference proceedings]. San Francisco, CA, USA; 2016. Available at: https://doi.org/10.1145/2939672.2939785
- Lin KY, et al. Predictive maintenance in industrial systems: An XGBoost-based approach for failure time estimation and resource optimization. J Ind Prod Eng. 2025;42(8):876-899.
- Ajayi OO, Kurien AM, Djouani K, Dieng L. A proactive predictive model for machine failure forecasting. Machines. 2025;13(8):663.
- Lundberg SM, et al. From local explanations to global understanding with explainable AI for trees. Nat Mach Intell. 2020;2(1):56-67.
- Chen H, Gao T, Wang L, Guo P. Explainable machine learning methods for predicting electricity consumption in a long-distance crude oil pipeline. Sci Rep. 2025;15(1):43305.
- Neubauer A, Brandt S, Kriegel M. Explainable multi-step heating load forecasting: Using SHAP values and temporal attention mechanisms for enhanced interpretability. Energy AI. 2025;20:100480.
- Ahmad T, Chen H. Potential of three variant machine-learning models for forecasting district-level medium-term and long-term energy demand in smart grid environment. Energy. 2018;160:1008-1020.
- Masa-Bote D, et al. Improving photovoltaics grid integration through short-time forecasting and self-consumption. Appl Energy. 2014;125:103-113.
访问受限。请登录或开始试用以查看此内容。