本方案描述了一种可重复的量子-经典混合工作流程,用于通过人类语音记录对帕金森病进行分类,包括数据预处理、量子电路实现、模型训练以及用于独立重复验证的交叉验证。
需要JoVE订阅才能观看此内容。 请登录或开始免费试用
本文内容
摘要
摘要
帕金森病是一种进行性神经退行性疾病,目前仍缺乏便捷且低成本的筛查方法。持续元音发声录音包含可测量的声学生物标志物,这些标志物与疾病相关的发声障碍相关,且无需专用设备即可采集。本实验方案描述了一种四量子比特的量子–经典混合卷积神经网络(QI-HCNN),该网络将参数化量子电路与浅层经典分类层相结合,利用降维后的声学语音特征对帕金森病进行分类。该方案还通过与维度匹配的经典神经网络以及梯度提升树分类器进行基准对比,后者分别在降维特征集和完整特征集上进行训练。基于一个公开可用的、去标识化的数据集(包含来自31名个体的195段语音录音),采用三折分层交叉验证时,QI-HCNN的受试者工作特征曲线下面积为0.78,而匹配的经典神经网络为0.87,分别在降维和完整特征集上训练的梯度提升基线模型则分别为0.94–0.95。受控的消融分析表明,电路中的两个纠缠操作之一在设计上无法影响测量输出,而另一个纠缠操作相较于无纠缠变体反而降低了分类性能。基于患者分组的交叉验证进一步显示,性能估计值因分配至测试集的个体不同而存在显著差异,反映出队列规模有限的问题。因此,本方案提供了一个完全明确且可独立复现的量子–经典基线方法,同时结合数据支持对当前电路设计的优势与局限性进行了评估,为未来研究奠定了方法学基础,而非支持其已具备临床诊断就绪的主张。
引言
帕金森病是一种慢性神经退行性疾病,由黑质中多巴胺能神经元进行性丧失引起,全球受影响人数超过1000万,已成为一项重大且日益加重的公共卫生负担1。该疾病既表现为运动症状,如震颤、强直和运动迟缓,也表现为非运动症状,如睡眠障碍和嗅觉丧失。临床诊断主要依赖于使用标准化运动评分量表进行神经系统检查,并在条件允许时辅以多巴胺转运体成像;然而,这两种方法均需要专业人员和基础设施支持,而这些资源并非在所有地区均能均等获得,且早期临床评估仍具有主观性2。由于目前尚无疾病修饰疗法,早期检测的主要价值在于能够实现更早的症状管理和长期随访监测。这一需求推动了低成本、可扩展且非侵入性筛查方法的发展,旨在补充而非取代临床评估。
声音障碍是帕金森病最早可测量的变化之一,且常早于明显的运动症状出现3。持续发出一个元音可提供一种受控的声学信号,从中可提取包括基频微扰、振幅微扰、谐噪比、递归周期密度熵以及去趋势波动分析等多种声学特征。这些特征已被反复证明包含具有诊断价值的信息,并且可以使用消费级录音设备获取4,5。一个基于此类录音数据公开可用的基准数据集已成为该任务的标准测试平台,针对完整特征集应用经典机器学习方法(如支持向量机、随机森林和梯度提升树)的研究报告了受试者工作特征曲线下面积接近0.99的性能6,7,8,表明当使用完整的特征集并结合适当的类别不平衡处理策略时,该分类任务已接近解决。量子机器学习作为一种替代性的计算范式,正在被应用于生物医学分类任务中,其中参数化量子电路利用叠加态和纠缠态以相对较少的可训练参数表示特征间的相互作用,并可通过参数偏移法则而非有限差分近似来解析计算电路梯度9。然而,许多已发表的关于“量子”或“量子启发”的神经网络在生物医学应用中的研究,实际上仅实现了完全经典的架构,这些方法采用了受量子启发的数学形式体系,但并未在模拟器或量子硬件上执行实际的参数化量子电路10。近年来帕金森病检测领域的进展还包括混合卷积神经网络-Transformer架构11、基于注意力机制的深度学习方法用于磁共振成像(MRI)12,以及专为高效计算诊断设计的轻量级卷积神经网络13,这些进展体现了人工智能方法在多种数据模态中的迅速扩展。更广泛而言,非侵入式计算机辅助诊断已成功拓展至其他生物医学应用领域,例如结合机器学习与深度学习的医学影像分析流程14。在同一公开语音数据集上对不同深度学习架构进行的比较评估进一步表明,传统的全特征经典模型亦可实现优异的性能15。
这些进展凸显了一种特定的方法学需求,即建立一种可重复的量子-经典混合卷积神经网络(QI-HCNN)模型 (i)执行一个真实的、完全指定的参数化量子电路;(ii)使用相同的输入特征,与结构匹配的经典神经网络以及一个强基线经典模型进行基准比较;(iii)采用一种评估协议,明确检验小规模生物医学数据集中主要的偏差来源,包括类别不平衡、人口统计学混杂因素,以及交叉验证过程中患者层面的数据泄露。
本实验方案的总体目标是提供一种完全可重复的QI-HCNN工作流程,用于基于人类语音录音的帕金森病分类。该方案描述了一个四量子比特参数化量子电路,采用角度编码、两个基于受控非门的纠缠层,以及通过参数偏移规则优化的可训练变分层,并结合一个浅层经典分类头,应用于一个公开语音录音数据集的四成分主成分表示。该工作流程以足以独立重复的详细程度,明确了所有预处理步骤、完整的电路构建、经典训练配置和评估流程,包括与维度匹配的经典神经网络、维度匹配及全特征梯度提升树基线模型的比较,对电路组件进行受控消融实验,采用患者分组交叉验证以评估对留出受试者的敏感性,以及明确的统计显著性检验。该方案并非仅展示有利结果,而是旨在透明报告当个别电路组件未能显著提升性能的情况,从而提供一个可重复的方法学框架,为未来在小样本生物医学分类任务中开发QI-HCNN架构提供参考。
访问受限。请登录或开始试用以查看此内容。
方案
本方案使用一个公开可用的、去标识化的第三方语音录音数据集。作者未收集新的人类受试者数据,本研究无需额外的机构审查委员会(IRB)批准。数据集获取与参与者层面的数据处理小节中描述的数据集最初由 Little 等人3在机构伦理批准下收集,不包含直接识别参与者的个人信息(仅包含匿名化的录音标识符),且该数据集可公开用于研究用途。请根据您所在机构的政策,确认对此公开数据集的二次分析是否需要伦理审查。在作者所在机构,对此完全去标识化、公开存档的数据集进行回顾性二次分析被认定为免于完整的 IRB 审查。
数据集获取与参与者水平的数据处理
帕金森病分类数据集(UCI 机器学习知识库,数据集编号 174),最初由 Little 等人3描述,已被下载。该数据集包含来自 31 名个体的 195 次持续元音 /a/ 发音录音(其中 23 名被诊断为帕金森病,8 名为健康对照;年龄范围为 46–85 岁)。由于该知识库未提供版本化 DOI,因此在材料表中记录并报告了确切的下载日期。该数据集以逗号分隔值(CSV)文件形式提供(parkinsons.csv)。无需进行解压缩或文件格式转换,可直接使用 Pandas 库中的 read_csv 函数导入该文件(见材料表)。
下载的数据集经核实包含195行和24列,其中包括一个录音标识符列(格式:phon_R01_S  受试者
 _ 录音)、22个连续声学特征列(表1)以及一个二分类标签列(状态:1 = 帕金森病;0 = 健康对照)。在整个实验方案中,表1被用作所有声学特征及特征类别的参考标准。
| 类别 | 代表性特征 | 临床意义 |
| 基频 | MDVP:Fo(Hz), MDVP:Fhi(Hz), MDVP:Flo(Hz) | 发声的平均、最大和最小基频;反映声带振动的稳定性。 |
| 抖动(频率扰动) | MDVP:Jitter(%), MDVP:Jitter(Abs), MDVP:RAP, MDVP:PPQ, Jitter:DDP | 音高周期的逐周期变化,反映喉部运动控制障碍。 |
| 颤动(振幅扰动) | MDVP:Shimmer, MDVP:Shimmer(dB), Shimmer:APQ3, Shimmer:APQ5, MDVP:APQ, Shimmer:DDA | 信号振幅的逐周期变化,反映气息声或不稳定的发声。 |
| 噪声指标 | NHR, HNR | 声音信号中噪声成分与谐波(音调)成分的比值。 |
| 非线性动力学 / 分形标度 | RPDE, D2, DFA, spread1, spread2, PPE | 衡量声音非线性动力学特性、周期性以及与声带振动相关的长程时间相关性的指标。 |
表1: 用于帕金森病分类的声学特征类别。 从帕金森病分类数据集中提取的22个声学语音特征被分为五类:基频、抖动(jitter)、微扰(shimmer)、噪声测量和非线性动力学。每类列出代表性特征及其相应的临床意义。MDVP:多维语音程序;RAP:相对平均微扰;PPQ:音高周期微扰商;APQ:振幅微扰商;DDP:周期差值之差;DDA:振幅绝对差值的平均值;NHR:噪声与谐波比;HNR:谐波与噪声比;RPDE:递归周期密度熵;D2:相关维数;DFA:去趋势波动分析;PPE:音高周期熵。
通过解析录音文件名中最后一个下划线前的子字符串,提取每条录音的参与者标识符。例如,phon_R01_S01_1 和 phon_R01_S01_2 均被分配给参与者 S01。由于来自同一参与者的录音在声学上具有相关性,因此在后续所有分组分析或“留一参与者出”验证流程(详见评估协议小节)中,均使用参与者标识符而非录音标识符。提取后,生成标识符的频数表并进行检查,以确认全部195条录音均被准确分配至31个唯一参与者,无任何录音遗漏未分配,且每位参与者的录音数量与源数据集文档记录一致。
在记录水平(147 条帕金森病记录,占 75.4%;48 条健康对照记录,占 24.6%)和参与者水平(31 名参与者中的 23 名,占 74.2%,被诊断为帕金森病)均对类别分布进行了统计。报告这两种分布是因为记录水平和参与者水平的类别不平衡并不相同,并会影响后续的评估。
由于源数据集中缺乏年龄或性别匹配的帕金森病患者及健康对照组,该局限性已在研究中被记录,并延续至讨论部分,因为此特征反映了原始数据采集情况,无法通过后续预处理进行校正。
预处理流程
所有预处理步骤均在评估方案小节中描述的交叉验证过程的每个训练折内独立进行。Min–Max归一化和主成分分析(PCA)均仅使用每折的训练数据子集进行模型拟合。拟合得到的变换随后直接应用于对应的独立测试数据子集,且不再重新拟合,以防止测试数据的信息泄露到预处理参数中。
每个训练数据子集中的22个原始声学特征使用输出范围为[0, π]的最小-最大缩放器(Min–Max scaler)进行归一化。拟合后的缩放器随后被应用于对应折叠(fold)的训练和测试数据子集(公式1)。公式1遵循标准的最小-最大归一化公式,并为本实验方案定义。最小-最大归一化通过 scikit-learn(版本1.8.0)中的 MinMaxScaler 类实现,参数设置为 feature_range=(0, π)、copy=True 和 clip=False。
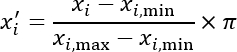 (1)
使用归一化的训练数据拟合了一个主成分分析(PCA)模型,其中主成分数量(n_components)设为4。将拟合得到的PCA变换应用于训练集和测试集。记录每次交叉验证折叠中前四个保留的主成分所解释的总方差比例。在本研究报道的各项分析中,前四个保留的主成分共解释了总方差的81.5%(分别为50.3%、16.3%、9.4%和5.5%)。PCA分析采用PCA类实现,参数设置为n_components=4、svd_solver="full"、whiten=False以及random_state=42。
由于主成分分析(PCA)可能生成负值的成分得分,因此使用PCA变换后的训练集部分拟合了一个输出范围为[0, π]的Min-Max标准化器。随后,将该拟合好的标准化器应用于训练集和测试集部分。由于该标准化器仅基于训练集部分进行拟合,因此任何落在[0, π]区间之外的测试集变换值均被截断至最近的边界。数据集中不存在零方差特征。所有195次记录中每个特征的取值范围均为严格正数,因此未出现除零情况。这一点通过验证缩放后的输出既不包含NaN值也不包含无穷值而得以确认。
在量子电路构建小节所述的角度编码过程中,四个重新归一化的主成分被依次分配为量子比特0、1、2和3的旋转角度。第一个主成分分配给量子比特0,第二个分配给量子比特1,第三个分配给量子比特2,第四个分配给量子比特3。该步骤完成了预处理流程,并将处理后的经典特征传递至量子电路。在第二次Min–Max缩放步骤后,所有输出值均被确认位于区间[0, π]内。由于浮点数舍入导致测试集部分数值略微超出该范围,使用NumPy(版本2.4.4)中的clip函数将其裁剪至最近的边界值。该操作确保了角度编码层的全部四个输入均为区间[0, π]内的有效旋转角度。
量子电路构建
四量子比特电路使用材料表中列出的态矢量模拟器以及下文所述的量子门序列构建。补充代码文件1提供了完整的可执行电路实现,包括用于构建量子门和计算参数偏移梯度的所有辅助函数。图1展示了从语音记录预处理,经过四层电路、经典后处理模块,最终实现分类的完整工作流程。
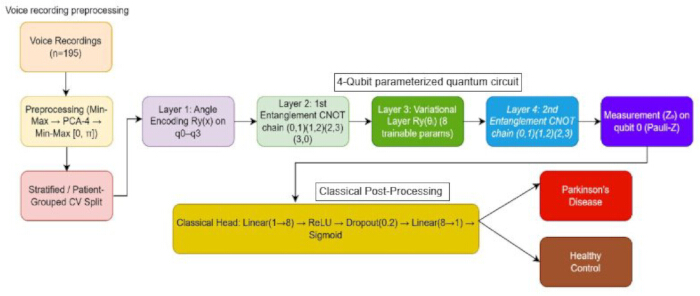
图 1。系统架构与量子电路工作流程。 基于人类语音记录的帕金森病分类工作流程。该示意图展示了语音记录的预处理、分层或按患者分组的交叉验证、四量子比特参数化量子电路的执行、对第 0 号量子比特进行单量子比特泡利-Z 测量、经典后处理,以及最终的二分类结果(帕金森病或健康对照)。CNOT,受控非门;PCA,主成分分析;ReLU,修正线性单元。 请点击此处查看此图的放大版本。
将一个四量子比特寄存器初始化为计算基态 ∣0000。
对于角度编码层,将一个 Ry (xi) 旋转门作用于量子比特 i,其中 i = 0,1,2,3,所用的四个角度由预处理流程生成(公式 2)。公式 2 描述了在参数化量子电路中常用的标准角度编码方法,该方法与 Mitarai 等人9 提出的参数化量子电路学习框架一致,并在本协议定义的特定四量子比特构型中予以应用。
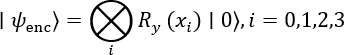 (2)
对于第一层纠缠,应用了一个受控非门的环形链,其控制-目标顺序如下:(0,1)、(1,2)、(2,3) 和 (3,0)。
对于变分层,八个可训练参数 w0 到 w7 通过从均值为 0、标准差为 0.3 的正态分布中独立采样进行初始化。所使用的随机种子记录在材料表中。这八个变分量子参数使用 numpy.random.default_rng(42 + fold_index).normal(0, 0.3, size = 8) 进行初始化,其中 fold_index 为基于零的折叠编号,从而为每一折提供特定但可重复的初始值。对于每个量子比特 i = 0,1,2 和 3,先应用一个 Rz(wi) 门,随后应用一个 Ry(wi+4) 门(方程 3)。方程 3 描述了一个变分(可训练)量子层,该层与 Mitarai 等人9 提出的通用参数化量子电路学习框架一致,并在此通过为本实验方案定义的特定门序列和参数化方式实现。
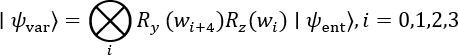 (3)
对于第二层纠缠,应用了一组开放链式的受控非门,其控制-目标顺序如下:(0,1)、(1,2) 和 (2,3)。该链未再闭合回至量子比特 0。
仅对第 0 个量子比特上的泡利-算符的期望值, ,通过态矢量内积计算得到。电路执行使用了一个基于标准数值数组运算实现的自定义态矢量模拟器(补充代码文件 1;qhcnn.py)。全程采用 Complex128 精度(numpy.complex128)。期望值通过态矢量内积解析计算得出,因此未进行基于采样次数(shot-based)的抽样。无需使用任何第三方量子计算框架。如果使用基于采样的模拟器或量子设备替代态矢量模拟器,则需对第 0 个量子比特重复进行计算基测量,并将得到的比特频率转换为期望值(公式 4)。公式 4 是标准的量子力学期望值公式,此处应用于本协议定义的单量子比特泡利-可观测量。由于未进行基于采样的测量,因此无需进行测量误差缓解。模拟器采用大端序(big-endian)量子比特索引方式,其中量子比特 0 对应态矢量索引的最高有效位。在构建泡利-可观测量时,明确考虑了此约定,以确保测量到正确的期望值。
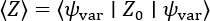 (4)
使用参数偏移法则计算了相对于八个变分参数中每一个参数的梯度。在每次梯度计算过程中,对每个参数需评估电路两次,分别在 θ + π/2 和 θ - π/2 处(公式 5)。公式 5 是 Mitarai 等人9 提出的标准参数偏移法则,此处直接应用,未作修改。
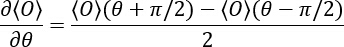 (5)
如上所述,第二层纠缠从未对以量子比特0为目标的受控非门(controlled-NOT gate)进行应用。由于受控非门会保持其控制量子比特的约化态不变,因此无论可训练参数取何值,第二层纠缠都无法改变 。为了使第二层纠缠能够在修改后的协议中影响测量输出,需要将量子比特0作为目标量子比特参与操作,例如通过增加一个连接末尾与起始的(3,0)受控非门来闭合链路,或者测量一个多量子比特可观测量,而非单个量子比特的期望值。本协议中保留了最初指定的第二层纠缠结构,并在其对测量结果的贡献方面,于结果部分明确报告,而非静默修正,因为该电路行为本身属于本研究的发现内容之一。
经典后处理层
经典后处理阶段由一个前馈神经网络组成,该网络使用材料表中列出的标准基于数组的数值运算实现。单个标量电路输出  通过一个全连接层映射到八个隐藏单元,随后应用修正线性单元(ReLU)激活函数。在训练过程中,应用了保留概率为 0.8(丢弃率 = 0.2)的 Dropout 层。然后通过第二个全连接层将这八个隐藏单元映射到单个输出单元,并应用 Sigmoid 激活函数以生成最终的类别概率 ŷ(公式 6)。公式 6 定义了本方案中所采用的具体经典后处理架构,包含标准的线性运算、修正线性单元(ReLU)和 Sigmoid 操作。
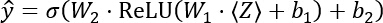 (6)
第一层和第二层的权重矩阵通过从均值为 0、标准差为 0.5 的正态分布中独立采样进行初始化,而所有偏置项均初始化为 0。用于初始化量子变分参数的同一随机数生成器实例及其种子也被用于经典层,以确保运行间结果的可重复性。具体而言,经典权重矩阵使用 numpy.random.default_rng(42 + fold_index).normal(0, 0.5, size=...) 进行初始化,而所有偏置项均初始化为零。在每次交叉验证折次开始时,创建一个以 42 + fold_index 为种子的随机数生成器实例,并在量子参数初始化、经典权重初始化、小批量打乱以及 dropout 掩码生成过程中依次重复使用,而不是为每个过程使用独立的随机种子流。
训练过程中,采用反向丢弃(inverted-dropout)规则,在每次前向传播时生成一个新的随机二值掩码,保留的神经元会被缩放1/0.8倍。在验证和测试阶段,完全禁用丢弃操作,使用完整且未缩放的网络进行推理。
联合QI-HCNN模型包含33个可训练参数:其中8个量子变分参数来自量子电路,25个为经典参数。经典部分由第一全连接层中的8个权重和8个偏置,以及第二全连接层中的8个权重和1个偏置组成。权重和偏置张量的维度分别为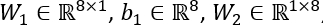 和
 。经典后处理层完全通过标准数值数组运算实现,无需额外的机器学习框架。所有经典计算均采用float64(双精度)算术运算执行。
模型训练
将量子电路构建小节中描述的量子电路与经典后处理层小节中描述的经典后处理层结合,构成一个完整的端到端可训练模型。所有33个可训练参数使用Adam优化器进行联合优化,初始学习率为0.01,并采用权重衰减(仅应用于经典权重矩阵的L2正则化项)。Adam优化器通过标准数值数组运算手动实现,具体参数设置如下:学习率 = 0.01,β1 = 0.9,β2 = 0.999,∈ = 1 × 10⁻⁸,权重衰减 = 1 × 10⁻⁴,仅作用于经典权重矩阵,不作用于偏置项或量子变分参数。
二元交叉熵被用作损失函数。对于文中所述的分裂后类别平衡步骤, 评估方案 在每个训练样本中,其损失贡献根据当前折叠训练分区中该类别的逆频率进行加权。对于不平衡协议,采用均匀的样本权重。二元交叉熵通过标准二元交叉熵公式计算,取每个小批量中所有样本损失的均值。
该模型使用包含 16 个样本的小批量训练了 30 个轮次。在每个轮次开始时,使用 numpy.random.default_rng(42 + fold_index).permutation(n) 对训练样本进行随机打乱,以生成随机的样本顺序。当训练样本数量不能被 16 整除时,保留最后一个较小的小批量,并以其实际大小进行处理,而非丢弃。
训练过程中采用了分段式学习率调整策略。每完成10个训练周期后,学习率乘以0.7,具体在第11和第21个周期开始时进行调整。
使用量子电路构建小节中描述的参数偏移规则,计算了八个量子变分参数的梯度。25个经典参数的梯度则仅通过对经典层进行标准的反向模式微分计算得到。量子电路的输出及其参数偏移梯度,构成了量子电路与经典层之间的接口。全部33个参数均使用同一个Adam优化器实例进行更新。
未采用基于验证集的早停策略。每个模型均按照固定的30个训练周期进行训练,并在最后一个周期结束后报告预留测试集的性能。所有模型参数(量子变分参数、经典权重矩阵及偏置项)在每次交叉验证折次开始时,均使用特定于该折次的随机种子(42 + fold_index)独立重新初始化。参数在不同折次或基线运行之间不共享。
计算环境,包括处理器、内存、软件版本以及每折的近似实际训练时间,记录在材料表中。
评估方案
模型性能通过录音级别和参与者级别的交叉验证程序进行评估,同时结合基线模型比较、类别平衡分析、神经环路消融实验、统计显著性检验以及特征重要性分析。
在初步评估中,195段语音录音采用固定随机种子划分为三个分层折叠,同时在每个折叠内保持录音层面的帕金森病/健康对照比例为75.4%/24.6%。使用其中两个折叠训练前述章节中描述的模型,并在剩余的独立折叠上进行评估,该过程重复进行,直至每个折叠均作为一次测试集使用。针对每个折叠计算准确率、精确率、召回率、F1分数以及受试者工作特征曲线下面积(AUC–ROC),并以三折叠上的均值±标准差形式报告结果。主要的三分层交叉验证通过StratifiedKFold类实现,参数设置为n_splits=3、shuffle=True、random_state=42。
通过将经典后处理层生成的预测类别概率 ŷ 应用固定的概率阈值 0.50,得到二分类预测结果。准确率、精确率、召回率和 F1 分数由这些经过阈值处理的预测结果计算得出,而 AUC–ROC 则直接基于连续的概率值计算,无需进行阈值化处理。精确率、召回率和 F1 分数使用指标函数并设置 zero_division=0 进行计算,对任何未定义的指标赋予 0.0 的值。在所报告的实验中未出现此类未定义情况。
基线模型使用预处理流程生成的相同折叠划分和相同的四组分预处理特征表示进行评估。一个包含一个由八个 ReLU 激活单元构成的隐藏层的经典多层感知机,其结构与混合模型中的经典组件一致,但不含量子电路,使用 Adam 优化器进行训练,L2 正则化系数为 1 × 10⁻⁴。同时,使用相同的四组分特征表示训练了一个梯度提升树分类器,包含 200 棵树、最大树深度为 3、学习率为 0.1,并在每个训练折叠中采用与类别频率成反比的类别权重。此外,还使用初始 Min–Max 归一化后生成的完整 22 维特征表示(未应用 PCA 或量子特征编码)训练了第二个梯度提升树分类器。该模型使用 300 棵树、最大树深度为 4、学习率为 0.05,并采用相同的按训练折叠内类别频率反比加权策略。经典多层感知机基线模型通过 MLPClassifier 实现,参数设置为 hidden_layer_sizes=(8,),activation="relu",solver="adam",alpha=1 × 10⁻4,batch_size="auto",learning_rate_init=0.001,max_iter=500,early_stopping=False,shuffle=True,random_state=42。权重初始化采用实现中默认的 Glorot(Xavier)均匀分布。梯度提升树基线模型使用 XGBoost 3.3.0 实现,目标函数 objective = "binary:logistic",评估指标 eval_metric = "logloss",树构建方法 tree_method = "auto",subsample = 1.0,colsample_bytree = 1.0,reg_alpha = 0,reg_lambda = 1,random_state = 42。
为了评估分割后类别平衡的效果,对 QI-HCNN 模型在启用样本加权的情况下重复进行了主要的交叉验证过程。平衡权重仅根据每次折叠中训练/测试分割后的训练部分计算得出,而未根据相应的独立测试部分计算。
通过重复完整的预处理、训练和评估流程四次,同时仅修改量子电路中的两个纠缠层,来进行电路组件消融实验。这四种电路变体包括:(i)包含两个纠缠层的完整电路;(ii)移除第一个纠缠层但保留第二个纠缠层的电路;(iii)保留第一个纠缠层但移除第二个纠缠层的电路;以及(iv)两个纠缠层均被移除的电路。所有四次实验均保持相同的折叠划分、随机种子和训练配置,以确保观察到的任何性能差异 solely 归因于纠缠层的结构配置。
为评估模型的稳健性,采用以参与者为分组的交叉验证方法,将31名参与者(而非195条记录)均分为五组,每组包含六至七名参与者。在每次迭代中,模型使用来自其中四组参与者的记录进行训练,并使用剩余一组参与者的记录进行评估,以确保任一参与者的数据不会同时出现在同一折次的训练集与测试集中。针对QI-HCNN模型、经典多层感知机以及四特征梯度提升基线模型,报告了五次以参与者分组的交叉验证折次中准确率、精确率、召回率、F1分数和AUC–ROC的均值±标准差。以参与者为分组的交叉验证通过GroupKFold类(n_splits=5)实现,其中参与者标识符作为分组变量。由于GroupKFold不进行组间打乱,参与者按照该实现默认的确定性顺序进行分配,从而形成每组包含六或七名参与者的折次。
采用配对 Wilcoxon 符号秩检验对主要评估模型与基线模型的每折 AUC–ROC 值进行统计显著性分析。由于当折数较少时该检验的统计效能受限,因此报告了精确的 p 值及相应的配对观测数。预先定义了四组配对 AUC–ROC 比较:(1)QI-HCNN 与经典多层感知机;(2)QI-HCNN 与 PCA 匹配的梯度提升树基线模型;(3)经典多层感知机与 PCA 匹配的梯度提升树基线模型;(4)不平衡的 QI-HCNN 模型与分拆后平衡的 QI-HCNN 模型。未进行多重比较校正,因为分析属于探索性质,且折数有限显著降低了统计效能。
采用基于完整22个特征表示训练的梯度提升树分类器进行特征重要性分析。提取并排序所有原始声学特征的基于增益的特征重要性得分。此外,仅出于报告目的,对完整数据集拟合主成分分析(PCA),但在模型评估过程中未使用PCA。对于每个原始声学特征,计算其在保留的前四个主成分上的绝对载荷值之和,并根据这些值对特征进行排序。报告了两种排序方法及其重叠情况。在基于增益的特征重要性分析中,梯度提升树实现生成了唯一的浮点型增益值,未出现并列情况。在主成分载荷排序中,若特征的绝对载荷值之和存在并列,则依据数据集中原始特征列的顺序进行排序处理。
访问受限。请登录或开始试用以查看此内容。
结果
文中报告的所有数值均与图2–8和表2–4中呈现的数据一致且完全相同。每张图均直接根据补充代码文件1中提供的代码生成,而非手动绘制,从而确保报告的数值与绘图数据之间的一致性。
初级交叉验证性能
在非平衡训练协议下,QI-HCNN 模型达到了 0.759 的准确率 ± 0.007,精确度为0.774 ± 0.029,召回率为0.966 ± 0.048,F1分数为0.858 ± 0.003,受试者工作特征曲线下面积(AUC–ROC)为 0.782 ± 0.022,基于三次分层交叉验证折表2). 图 2 展示了相应的每折结果。由于数据集中存在75.4%/24.6%的类别不平衡,召回率和F1分数可能与一个退化的始终预测正类的分类器结果相似(参见 数据集获取与参与者水平数据处理
访问受限。请登录或开始试用以查看此内容。
讨论
本方案详细描述了一种完全可复现的用于从语音记录中进行帕金森病分类的QI-HCNN架构,其中每个门控机制、参数初始化选择、预处理步骤以及评估流程均被充分阐明,足以支持独立实现。所提出的电路结构在相同的输入特征和相同的交叉验证折分划分条件下,与结构匹配的经典多层感知机和梯度提升树基线模型进行了基准对比。该基准测试设计结合了受控的电路组件消融实验、按患者分组的鲁棒性评估以及明确的统计显著性检验,旨在推动该子领域的方法论实践进步——因为在当前研究中,量子标记架构并不总是与资源相当的经典方法进行比较,也未充分检验小规模生物医学队列相关的特定失效模式10。方案中的关键步骤包括按折预处理以防止信息泄露、以参与者为单位进行验证以最小化来自同一受试者重复录音所引起的偏差,以及使用维度匹配的经典基线模型,从而实现直接的架构间比较,符合基于机器学习的帕金森病分类最佳实践标准1,5,6。
访问受限。请登录或开始试用以查看此内容。
披露
利益冲突:
作者声明,他们不存在与本工作相关的任何经济或非经济利益冲突。
致谢
本工作未获得任何机构或组织的技术或资金资助。作者感谢加州大学欧文分校机器学习资料库(UCI Machine Learning Repository)的维护人员,提供了本研究中所用语音录音数据集的公开访问权限。
访问受限。请登录或开始试用以查看此内容。
材料
| 姓名 | 公司 | 目录编号 | 评论 |
|---|---|---|---|
| Adam 优化器 | 标准数值优化实现 | 自定义实现;NumPy 2.4.4 | 量子与经典参数的联合优化;模型训练 |
| 二元交叉熵损失函数实现 | 使用 NumPy 自定义实现 | NumPy 2.4.4;每个小批量上的损失取平均值(均值约简) | 训练损失函数;模型训练 |
| 梯度提升树分类器 | XGBoost 开源梯度提升库 | XGBoost 3.3.0;objective="binary:logistic";eval_metric="logloss";tree_method="auto";random_state=42 | PCA 匹配和全特征经典基线;评估协议 |
| 机器学习库 | scikit-learn 开源机器学习库 | scikit-learn 1.8.0 | Min–Max 缩放、主成分分析、分层交叉验证、参与者分组交叉验证、多层感知机基线及评估指标 |
| 数值计算库 | NumPy 开源数值计算库 | NumPy 2.4.4 | 核心数组操作、态矢量模拟、参数初始化和手动梯度计算 |
| Parkinson’s Disease Classification 数据集 | Little, McSharry, Roberts, Costello 和 Moroz 提供;通过 UCI 机器学习知识库发布 | UCI 数据集编号 174;来自 31 名参与者的 195 条记录;访问日期:2025 年 6 月 19 日 | 原始持续元音语音记录数据集;https://archive.ics.uci.edu/dataset/174 |
| 科学计算库 | SciPy 开源科学计算库 | SciPy 1.17.1 | Wilcoxon 符号秩检验用于统计显著性分析;评估协议 |
| 态矢量模拟器 | 自定义态矢量模拟器(补充代码文件 1;qhcnn.py) | 纯 NumPy 实现;complex128(双精度);无需外部后端 | 四量子比特量子电路的执行;量子电路构建 |
| 表格数据处理库 | Pandas 开源数据分析库 | Pandas 3.0.2 | 数据集加载、检查和表格操作 |
| 工作站计算环境 | 本地 CPU 工作站(云托管 Linux 容器) | x86_64 CPU;Ubuntu Linux;Python 3;未使用 GPU 或量子硬件;每折近似实际训练时间为 30–60 秒 | 所有训练与评估所用的计算环境;基于 CPU 的态矢量模拟;无需 GPU 或量子硬件 |
参考文献
- Rabie H, Akhloufi MA. A review of machine learning and deep learning for Parkinson's disease detection. Discov Artif Intell. 2025;5:24.
- Devi SVA, et al. Hybrid deep learning methods for enhancing Parkinson's disease early detection [conference presentation]. Presented at: 4th International Conference on Smart Applications, Data and Living (ICSADL); 2025; Bhimdatta, Nepal. IEEE. p. 1462-1469. Available from: https://doi.org/10.1109/ICSADL65848.2025.10933259.
- Little MA, et al. Exploiting nonlinear recurrence and fractal scaling properties for voice disorder detection. Biomed Eng Online. 2007;6:23.
- Costantini G, et al. Artificial intelligence-based voice assessment of patients with Parkinson's disease off and on treatment. Sensors (Basel). 2023;23(4):2293.
- Gunduz H. Deep learning-based Parkinson's disease classification using vocal feature sets. IEEE Access. 2019;7:115540-115551.
- Naeem I, et al. Voice biomarkers as prognostic indicators for Parkinson's disease using machine learning techniques. Sci Rep. 2025;15:12129.
- Ebrahimzadeh E, et al. Explainable machine learning for early detection of Parkinson's disease in aging populations using vocal biomarkers. Front Aging Neurosci. 2025;17:1672971.
- Alishah S. An explainable ensemble and deep learning framework for accurate and interpretable Parkinson's disease detection from voice biomarkers. Diagnostics (Basel). 2025;15(22):2892.
- Mitarai K, Negoro M, Kitagawa M, Fujii K. Quantum circuit learning. Phys Rev A. 2018;98(3):032309.
- Alissa M, et al. Parkinson's disease diagnosis using convolutional neural networks and figure-copying tasks. Neural Comput Appl. 2022;34(2):1433-1453.
- Kumari GRP, Ravi Kanth M, Kamal MV. Parkinson's disease early detection using hybrid attentive CNN-transformer model. Neural Comput Appl. 2025;37(32):26523-26543.
- Palakayala R, Kuppusamy P. AttentionLUNet: a hybrid model for Parkinson's disease detection using MRI brain. IEEE Access. 2024;12:91752-91769.
- Wang X, et al. A light-weight CNN model for efficient Parkinson's disease diagnostics [conference presentation]. Presented at: IEEE International Symposium on Computer-Based Medical Systems (CBMS); 2023; L'Aquila, Italy. IEEE. p. 616-621. Available from: https://doi.org/10.1109/CBMS58004.2023.00289.
- Haq I, et al. Lung nodules localization and report analysis from computerized tomography (CT) scan using a novel machine learning approach. Appl Sci. 2022;12(24):12614.
- Alzaidi A, et al. Comparative study of deep learning models for Parkinson's disease detection using the UCI vocal dataset. TBench. 2025;5(2):10021
访问受限。请登录或开始试用以查看此内容。